Yapay Zeka: Felsefe, Kuram ve Uygulama

Yapay zekanın felsefi köklerinden güncel model ve ajan sistemlerine; zeka tanımları, mantık ve sembolik yapay zeka, arama, uzman sistemler, olasılık, sinir ağları, doğal dil işleme, biyometri, Transformer, RAG, güvenlik ve üretim mimarisini birleştiren ders notu.
Yapay zeka, insanın akıl yürütme, öğrenme, algılama ve karar verme süreçlerinin hangi bölümünün biçimselleştirilebileceği sorusundan doğdu. Alanın tarihi yalnız bilgisayarların tarihi değildir; mantık, bilgi felsefesi, olasılık, sibernetik, sinirbilim ve mühendislik aynı çizgide buluşur.
Felsefi düzeyde zeka, bilgi, anlama, bilinç ve amaç tartışılır. Kuramsal düzeyde bu süreçlerin hangilerinin hesaplanabildiği, aranabildiği, öğrenilebildiği veya optimize edilebildiği incelenir. Mühendislik düzeyinde ise modelin gerçek dünyada nasıl ölçüldüğü, doğrulandığı, sınırlandırıldığı ve güvenle işletildiği önem kazanır.
Bilim doğrusal ilerlemez. Aynı fikir farklı dönemlerde yeniden ortaya çıkabilir; kuramsal bir sınır yeni bir yönteme, yeni bir yöntem de yeni bir mühendislik sorununa yol açabilir. Kronoloji burada olayları sıraya dizmekten çok fikirler arasındaki bağı korumak için kullanılır.
Ünite 1: Felsefi ve Kavramsal Temeller
I. Felsefi ve Kavramsal Tarih
İnsan önce dünyayı ölçtü, sonra ölçtüğünü adlandırdı, daha sonra bu adlar arasında kurallar kurdu. Yapay zekanın felsefi tarihi, makineden önce bilginin ve aklın ne olduğuna ilişkin bu uzun tartışmayla başlar.
Ölçümden bilgiye: veri, enformasyon, bilgi ve bilgelik
Yapay zeka tartışmasına modelden değil ölçümden başlamak daha sağlıklı bir başlangıçtır. Bir sistemin çevre hakkında bildiği her şey, doğrudan veya dolaylı olarak bir temsil üzerinden gelir. Bir sıcaklık algılayıcısının 37.2 üretmesi tek başına bir sayıdır.
Bu sayının “vücut sıcaklığı, santigrat derece” bağlamına yerleştirilmesi enformasyon ya da malumat üretir. Ölçüm koşulları, cihaz hatası, kişinin yaşı ve klinik bağlam değerlendirildiğinde kullanılabilir bilgiye yaklaşılır. Hangi eylemin uygun olduğu ise yalnız bilgiye değil amaç, risk ve değer değerlendirmesine bağlıdır.
Kavramlar şu şekilde ayrılabilir:
Data        = Veri
Information = Enformasyon = Malumat
Knowledge   = Bilgi
Wisdom      = Bilgelik
DIKW olarak bilinen bu sıra öğretici bir modeldir; doğa yasası değildir. Veri yanlış ölçülebilir, doğru veri yanlış bağlamlandırılabilir, doğru enformasyondan yanlış sonuç çıkarılabilir ve doğru bilgi kötü bir kararda kullanılabilir. Yapay zeka açısından bunun önemli sonucu şudur: model çıktısını doğrudan “bilgi” saymak yerine onu çoğu zaman aday enformasyon olarak ele almak daha güvenlidir.
Kaynak, bağlam, tutarlılık ve bağımsız doğrulama olmadan akıcı bir metin, güvenilir bilgi statüsü kazanmaz. Shannon'ın bilgi kuramı bu ayrımı daha da keskinleştirir. Shannon entropisi bir olasılık dağılımındaki belirsizliği ölçer; semantik anlamı, doğruluğu, bilimsel önemi veya bilinci ölçmez.
Rastgele bir bit dizisinin entropisi yüksek olabilir ve yine de bizim için hiçbir anlam taşımayabilir. Buna karşılık E = mc² çok kısa bir gösterimdir fakat geniş bir bilimsel içeriğe sahiptir. İletişim kanalının taşıdığı enformasyon ile bir önermenin ne anlama geldiği aynı problem değildir.
Buradan üç yakın ama farklı kavrama geçilir. Bilişim, verinin ve enformasyonun hesaplama sistemleriyle işlenmesi, saklanması ve iletilmesiyle ilgilidir. Biliş, algı, dikkat, bellek, öğrenme, dil ve muhakeme gibi işlevleri kapsar. Bilinç ise öznel deneyim ve farkındalık sorununu gündeme getirir.
Bir makine bilişim yapabilir ve bilişsel kabul ettiğimiz görevlerin birçoğunda yüksek başarı gösterebilir; bu iki özellik tek başına fenomenal bilinç kanıtı değildir. Benzer biçimde zeka, akıl, idrak ve muhakemeyi tek bir sözcük altında eritmek yararlı değildir.
Zeka yeni duruma uyum, örüntü yakalama ve problem çözme yeteneğini; muhakeme öncüllerden sonuç çıkarma ve seçenekleri değerlendirmeyi; idrak bir durumun ne anlama geldiğini kavramayı; akıl ise tutarlılık ve neden-sonuç ilişkilerini daha normatif bir çerçevede kullanmayı çağrıştırır. Modern yapay zeka bazı eksenlerde insanüstü performans gösterirken başka eksenlerde kırılgan kalabildiği için “zeka = tek skor” yaklaşımı özellikle yetersizdir.
İstatistik, belirsizliği yok etmek yerine ölçülebilir bir yapıya dönüştürür. Yapay zeka mühendisliğinde de benzer bir disiplin gerekir: modelin emin görünmesi ile gerçekten düşük belirsizliğe sahip olması aynı şey değildir.
Zekayı tanımlamak: tek bir yetenek değil
Zeka, tek bir davranış ya da tek bir test puanıyla eksiksiz açıklanabilen bir özellik değildir. Psikoloji ve eğitim tarihinde amaçlı davranma, akıl yürütme, problem çözme, deneyimden öğrenme, genelleme, çevreye uyum ve yeni durumlarda uygun tepki geliştirme gibi farklı yetenek kümeleri üzerinden tanımlanmıştır.
Spearman genel yetenek ile daha özel yetenekleri ayıran bir yaklaşım geliştirdi. Thorndike soyut, sosyal ve mekanik yetenekler arasında ayrım yaptı. Wechsler zekayı amaçlı davranma, akılcı düşünme ve çevreyle etkili ilişki kurma kapasitesiyle ilişkilendirdi. Gardner'ın çoklu zeka yaklaşımı ise dilsel, mantıksal-matematiksel, görsel-uzamsal, müziksel, bedensel, kişilerarası, içsel ve doğa ile ilişkili yetenekleri eğitim bağlamında ayrı kümeler halinde ele aldı. Bu sınıflandırmalar aynı kuramsal zemine dayanmaz; yapay zeka için doğrudan bir hesaplama modeli de oluşturmaz.
Mühendislik açısından önemli sonuç daha yalındır: “zeka” ölçülmeden önce hangi davranışın kastedildiği tanımlanmalıdır. Bir sistem satrançta, konuşma tanımada veya görüntü sınıflandırmada çok yüksek başarı gösterebilir; bu başarı başka bir görevde aynı yeteneği garanti etmez. Tek bir toplam puan yerine görev kümesi, hata türleri, genelleme davranışı ve değişen koşullara uyum birlikte değerlendirilmelidir.
İnsan zekasına ilişkin sınıflandırmaların yapay sisteme aktarılmasında da aynı dikkat gerekir. Dil üretme, görsel algılama, planlama veya araç kullanma gibi yeteneklerin aynı modelde bulunması, bunların insandaki bilişsel mekanizmalarla aynı biçimde gerçekleştiğini göstermez. Benzer çıktı, aynı iç mekanizma anlamına gelmeyebilir.
Antik mantıktan biçimsel hesaba: düşüncenin mekanikleştirilmesi
Yapay zekanın tarihi elektronik bilgisayarla başlamaz. Daha eski soru şudur: Akıl yürütmenin hangi bölümü biçime, kurala ve işleme dönüştürülebilir? Aristoteles'in kıyası, sonucun yalnız içerikten değil biçimden de türetilebildiğini gösteren erken örneklerden biridir.
El-Harizmî'nin sistematik hesap yöntemleri yüzyıllar sonra “algoritma” sözcüğüne adını verdi. Ramon Llull kavramların mekanik bileşimiyle çıkarım fikrini araştırdı. Pascal ve Leibniz hesaplamanın bazı parçalarını mekanik düzeneğe taşıdı.
Leibniz'in daha ileri hedefi yalnız hızlı hesap makinesi değildi. Akıl yürütmenin bir bölümünü evrensel sembolik dil içinde ifade edip anlaşmazlıkları hesapla çözme düşüncesi, sembolik yapay zekanın çok erken bir felsefi öncülü gibi okunabilir.
Hobbes, 17. yüzyılda akıl yürütmeyi bir tür hesaplama olarak düşündü. Descartes bedeni mekanik açıklamaya açarken zihni ayrı bir töz olarak ele aldı. Bu ayrım, yapay zeka tartışmasında bugün bile süren bir soruyu bıraktı: Zihinsel olan bütünüyle hesaplama düzeyinde açıklanabilir mi?
Empirist çizgi başka bir yön gösterdi. Locke ve Hume zihinsel içeriğin deneyim ve çağrışımlarla oluşmasına ağırlık verdi. Modern makine öğrenmesi bu felsefelerin doğrudan devamı değildir; fakat “bilgiyi kurallara mı yazacağız, örneklerden mi öğreneceğiz?” gerilimi burada tanıdık hale gelir.
Kant yalnız verinin yeterli olmadığını hatırlatan üçüncü bir hat açtı. Deneyim, dış dünyadan gelen ham malzemenin yanı sıra onu düzenleyen yapılarla kurulur. Yapay zekada temsil, model mimarisi, inductive bias ve önbilgi tartışmaları bu nedenle yalnız veri miktarıyla açıklanamaz.
Boole, 19. yüzyılda mantığı cebirleştirdi. Frege, niceleyicilerle modern yüklem mantığının temelini güçlendirdi. Böylece “akıl yürütme” giderek daha büyük ölçüde açık sembolik işlemlere dönüştürülebilir hale geldi.
Babbage programlanabilir genel amaçlı makine fikrine yaklaştı. Ada Lovelace, böyle bir makinenin yalnız sayıları değil sembolleri de işleyebileceğini gördü. Aynı zamanda kalıcı bir itiraz bıraktı: Makine kendisine verilmeyen bir şeyi gerçekten “yaratabilir” mi?
Hilbert, 20. yüzyılın başında matematiği eksiksiz ve tutarlı biçimsel bir temele oturtmayı hedefledi. Bu programın sınırları 1930'larda Gödel, Church ve Turing'in çalışmalarıyla belirginleşti.
Düşüncenin teknik dönüşümü böyle okunabilir:
akıl yürütme
-> sembol
-> biçimsel kural
-> algoritma
-> hesap
-> program
Bu zincir yapay zekayı mümkün kıldı. Zincirin sınırları da yapay zekanın sınırlarını belirlemeye devam eder.
Akıl yürütme biçimleri ve çıkarım hataları
Klasik mantıkta tümdengelim genel öncüllerden daha özel bir sonuca, tümevarım tekil gözlemlerden daha genel bir sonuca, benzetim ise yapısal benzerliklerden yeni bir ilişkiye ilerler. Yapay zeka sistemleri bu biçimlerin birebir kopyaları değildir; yine de çıkarımın hangi tür kanıta dayandığını ayırmak, üretilen sonucun gücünü değerlendirmeyi kolaylaştırır.
Mantıksal geçerlilik ile öncüllerin doğruluğu da farklıdır. Geçerli bir çıkarım yanlış öncüllerden hareket edebilir; doğru görünen bir sonuç ise hatalı akıl yürütmeyle elde edilmiş olabilir. Çok anlamlılık, yanlış neden-sonuç ilişkisi, kişiye saldırı veya soruyu baştan doğru varsayma gibi safsatalar yalnız felsefe tarihi konusu değildir. Doğal dil üreten sistemlerde akıcı ifade, çıkarımın geçerli veya kanıtın yeterli olduğunu garanti etmez.
Bu nedenle sembolik doğrulama ile olasılıksal üretim farklı kanıt katmanları olarak ele alınmalıdır. Bir dil modeli aday öneri üretebilir; mantık, tip sistemi, şema doğrulama veya çözücü ise belirli biçimsel kısıtların sağlanıp sağlanmadığını denetleyebilir.
1931–1958: hesaplanabilirliğin sınırı ve makine zekasının doğuşu
1930'larda soru artık yalnız “düşünceyi sembolleştirebilir miyiz?” değildi. Daha keskin soru şuydu: Hangi sembolik işlem gerçekten hesaplanabilir? Gödel'in eksiklik sonuçları, Turing'in hesap modeli ve daha sonra Rice teoremi bu sınırı matematiksel olarak belirginleştirdi. (Gödel, 1931; Turing, 1936; Rice, 1953)
Gödel'in eksiklik teoremleri, tutarlı, etkin biçimde aksiyomlaştırılabilir ve temel aritmetiği ifade edecek kadar güçlü biçimsel sistemlerde doğruluk ile sistem içinde ispatlanabilirliğin aynı şey olmadığını gösterir. Turing, soyut makine modeliyle hesaplanabilirliği tanımladı ve genel bir durma karar vericisinin var olamayacağını ortaya koydu.
Rice teoremi bu sınırı, programların hesapladığı kısmi fonksiyonlara ilişkin aşikâr olmayan anlamsal özelliklere genişletir; boş ya da bütün programlar için geçerli olan trivial özellikler teoremin kapsamındaki karar verilemezlik iddiasına girmez. Buradan “makine hiçbir şey yapamaz” sonucu çıkmaz. Hesaplanamazlık, bilgi eksikliği, pratik karmaşıklık ve donanım yetersizliği farklı sınır türleridir.
Bir problem bugünkü donanımla pratikte zor olabilir; daha iyi algoritma veya donanım bunu değiştirebilir. Bir problem bilgi kuramsal alt sınıra takılabilir; daha hızlı işlemci eksik bilgiyi üretemez. Bir özellik hesaplanamazsa sorun artık performans değil, ilkesel karardır.
Bilgi kuramı aynı dönemde başka bir sınır çizdi. Shannon entropisi belirsizliği ölçülebilir hale getirdi. Data Processing Inequality, işleme zincirinin kaynaktaki bilgiyi sihirli biçimde artıramayacağını; Fano eşitsizliği ise gözlem sınıfı yeterince ayırmıyorsa hata için alt sınır bulunduğunu gösterir. (Shannon, 1948; Fano, 1961)
Rate–distortion yaklaşımı, temsil maliyeti ile kabul edilen bozulmayı birlikte düşünür. Bu fikir bugün sıkıştırma, embedding, nicemleme ve haberleşme sistemlerinde aynı mühendislik sorusunu taşır: hangi bilgiyi koruyoruz, hangisini bilerek kaybediyoruz?
Fizik de ayrı sınırlar koyar. Landauer ilkesi, mantıksal olarak geri döndürülemez bilgi silmeyi termodinamik maliyetle ilişkilendirir. Işık hızı haberleşmeye gecikme alt sınırı getirir. No-cloning teoremi, keyfî ve önceden bilinmeyen bir kuantum durumunu her durumda kusursuz kopyalayan evrensel bir işlemin var olamayacağını gösterir; bilinen ve birbirine dik durumların ayırt edilip yeniden hazırlanabilmesi bu daha dar sonuçla çelişmez. Bu imkânsızlığın erken bir matematiksel öncülü Park'ın 1970 tarihli çalışmasında bulunur; modern no-cloning theorem 1982'de Wootters ve Zurek ile bağımsız olarak Dieks tarafından ortaya kondu. (Park, 1970; Wootters & Zurek, 1982; Dieks, 1982)
Bu kuramsal zemin oluşurken “zeka” farklı disiplinlerden mühendislik nesnesine dönüşmeye başladı. McCulloch ve Pitts 1943'te basitleştirilmiş nöronları mantıksal ağlar olarak modelledi. Hebb 1949'da birlikte etkinleşen birimler arasındaki bağın güçlenmesi fikrini öğrenmeyle ilişkilendirdi. (McCulloch & Pitts, 1943; Hebb, 1949)
Wiener'in sibernetiği zekayı yalnız iç hesap olarak değil, geri besleme içindeki kontrol olarak ele aldı. Sistem ölçer, durum kestirir, eylem üretir ve sonucu yeniden ölçer. Güncel robotik ve ajan mimarilerinde bu döngü hala görülebilir. (Wiener, 1948)
Turing 1950'de “Makineler düşünebilir mi?” sorusunu doğrudan tanımlamak yerine davranışsal sınamaya çevirdi. Bu hamle tartışmayı ilerletti; aynı zamanda bugüne kadar kapanmayan boşluğu bıraktı: davranış ile deneyim aynı şey midir? (Turing, 1950)
1955 tarihli Dartmouth önerisinde John McCarthy, Marvin Minsky, Nathaniel Rochester ve Claude Shannon “artificial intelligence” ifadesini araştırma programının adı olarak kullandı. Alan tek bir kişinin icadı değildi; mantık, sibernetik, sinirsel modelleme, bilgi kuramı ve bilgisayar mühendisliği aynı dönemde birbirine yaklaştı.
Dartmouth 1955–1956: bir adlandırmadan araştırma programına
Burada tarih ayrımı önemlidir. Artificial intelligence terimi 1956 yazındaki toplantı sırasında bir anda ortaya çıkmadı. John McCarthy, Marvin Minsky, Nathaniel Rochester ve Claude Shannon'ın 31 Ağustos 1955 tarihli A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence başlıklı önerisinde ifade zaten araştırma alanının adı olarak kullanılıyordu. 1956 yazındaki Dartmouth çalışması bu adı bir araştırma topluluğu ve ortak problem kümesi etrafında görünür hale getirdi. Bu nedenle Dartmouth'u "yapay zekanın icat edildiği an" olarak değil, daha önce mantık, sibernetik, bilgi kuramı, sinirsel modelleme ve hesaplama altında dağınık biçimde yürüyen çalışmaların ortak bir araştırma programı altında birleştiği dönüm noktası olarak okumak daha doğrudur. (McCarthy et al., 1955; Nilsson, 2010)
Önerinin çıkış varsayımı güçlüydü: öğrenme ve zekanın çeşitli özellikleri yeterince kesin biçimde betimlenebilirse, bunların makine tarafından benzetilmesi araştırılabilirdi. Bu önerme bir bilinç kuramı değildi ve "insan zihninin tamamı bilgisayardır" sonucunu kanıtlamıyordu. Daha sınırlı fakat mühendislik açısından radikal bir iddia taşıyordu: zeka diye adlandırılan bazı işlevler açık temsillere, işlemlere ve sınanabilir makine davranışlarına dönüştürülebilir.
Öneri klasik anlamda birkaç günlük bir konferans programı da değildi. Plan, 1956 yazında Dartmouth College'da yaklaşık iki aylık, küçük bir araştırmacı grubunun birlikte çalışacağı bir yaz projesiydi. Katılımcılar farklı tarihlerde gelip gitti; dolayısıyla sonradan oluşan "bütün kurucuların aynı masada oturup yapay zekayı bir günde tanımladığı" görüntü tarihsel yapıyı fazla sadeleştirir. Asıl sonuç tek bir bildirge veya tek bir algoritma değil, ortak soruların aynı ad altında tartışılmaya başlanmasıydı.
1955 önerisi yedi problem alanı sayıyordu:
- otomatik bilgisayarların yapısı,
- bilgisayarların dili kullanması,
- nöron ağları,
- bir hesabın büyüklüğünün ve maliyetinin kuramsal olarak incelenmesi,
- kendini geliştiren sistemler,
- soyutlamalar ve kavram oluşturma,
- rastlantısallık ile yaratıcılık arasındaki ilişki.
Bu başlıkları doğrudan bugünkü teknolojilere eşitlemek anakronik olur; yine de problem sürekliliği dikkat çekicidir. Dil kullanımı bugün doğal dil işleme ve büyük dil modellerinde, nöron ağları derin öğrenmede, soyutlama temsil öğrenmede, hesaplama maliyeti algoritmik verimlilik ve ölçekleme tartışmalarında, kendini geliştirme ise öğrenen ve geri beslemeyle davranışını değiştiren sistemlerde yeniden karşımıza çıkar. "Rastlantısallık ve yaratıcılık" başlığı da yaratıcı davranışın salt rastgele üretimden ibaret olmadığını, yapılandırılmış arama ile çeşitliliğin birlikte ele alınması gerektiğini erken dönemde gündeme getirmişti.
Nöron ağlarının önerinin özgün başlıklarından biri olması ayrıca önemlidir. Yapay zeka tarihi bazen Dartmouth'tan yalnız sembolik yapay zekanın doğduğu izlenimi verecek kadar doğrusal anlatılır. Oysa 1943'te McCulloch ve Pitts'in biçimsel nöron modeli, Hebb'in öğrenme yaklaşımı ve Minsky'nin erken sinir ağı çalışmaları zaten bu çevrenin parçasıydı. Sembolik çıkarım ile öğrenen sinirsel sistemler arasındaki gerilim, alanın sonradan oluşmuş dışsal bir çatışması değil, çok erken dönemden itibaren mevcut olan iki farklı mühendislik yaklaşımıydı.
Dartmouth'ta sunulan en dikkat çekici teknik örneklerden biri, Allen Newell, Herbert Simon ve J. C. Shaw'ın toplantıdan önce geliştirmeye başladığı Logic Theorist idi. Program Dartmouth'un ürünü değil, toplantıya taşınan öncül bir çalışmaydı. Whitehead ve Russell'ın Principia Mathematica eserindeki mantıksal teoremler üzerinde çalışıyor ve kanıt aramasında sezgisel yöntemlerden yararlanıyordu. Buradaki kavramsal sıçrama, bilgisayarın yalnız sayısal işlem yapan bir makine olarak görülmemesiydi. Semboller, durumlar ve kurallar üzerinde arama yapan bir program da problem çözme davranışı gösterebilirdi. Bu yaklaşım daha sonra teorem ispatlama, oyun oynama, planlama ve genel durum-uzayı aramasının temel düşüncelerinden biri haline geldi. (Nilsson, 2010)
Bu gelişme aynı zamanda heuristic kavramının yapay zekadaki merkezî yerini açıklar. Bir problemin bütün olası durumlarını tüketici biçimde denemek teorik olarak mümkün olsa bile pratikte hesaplama patlamasına yol açabilir. Zeki kabul edilen problem çözmenin önemli bir bölümü, hangi yolun önce denenmeye değer olduğuna ilişkin iyi kestirimler kullanır. Dartmouth çevresindeki tartışmalar, "hesaplanabilir mi?" sorusunun yanına "hangi arama stratejisiyle ve hangi maliyetle hesaplanabilir?" sorusunu yerleştirdi.
Bununla birlikte Dartmouth'un tarihsel önemini sonuçları abartarak anlatmamak gerekir. 1956 yazında genel yapay zeka üretilmedi; doğal dil, öğrenme, soyutlama veya yaratıcılık için birleşik bir kuram kurulmadı. Başlangıçtaki iyimserlik, insan düzeyindeki bilişsel yeteneklerin mühendislik zorluğunu ciddi biçimde küçümsüyordu. Sonraki onyıllarda uzman sistemlerden yapay sinir ağlarına, istatistiksel öğrenmeden Transformer mimarilerine kadar birbirinden oldukça farklı yaklaşımların gerekli olması da problemin tek bir mekanizmaya indirgenemediğini gösterdi.
Dartmouth'un kalıcı etkisi bu nedenle bir makineden çok bir araştırma çerçevesidir. Turing'in "Makineler düşünebilir mi?" sorusu, burada daha parçalı ve mühendislik yapılabilir sorulara dönüştü:
düşünme nedir?
-> hangi işlevleri ayrıştırabiliriz?
-> hangilerini biçimsel olarak tanımlayabiliriz?
-> hangilerini hesaplayabilir veya öğrenebiliriz?
-> hangi koşullarda makine davranışı olarak sınayabiliriz?
Bu dönüşüm felsefi soruyu ortadan kaldırmadı; tersine onu ölçülebilir alt problemlere böldü. Yapay zekanın bugün hâlâ dil, öğrenme, temsil, arama, öz-düzeltme ve yaratıcılık üzerinde çalışması, Dartmouth'un belirli algoritmaları öngördüğünü değil, problem uzayını olağanüstü erken bir tarihte isabetli biçimde tanımladığını gösterir.
Türkiye'de Cahit Arf'ın 1958–1959 öğretim yılında verdiği Makine Düşünebilir mi ve Nasıl Düşünebilir? konferansı konuyu hesaplama, dil, benzetme, öğrenme ve estetik şuur gibi farklı yeteneklere ayırması bakımından önemlidir. Tek bir “zeka puanı” yerine parçalı yetenekleri düşünmesi, bugünkü jagged intelligence tartışmasını çağrıştırır.
Kültürel dil de bu sırada şekillendi. Robot sözcüğü Karel Čapek'in R.U.R. oyunuyla yaygınlaştı; Karel Čapek'in kendi anlatımına göre sözcüğü öneren kardeşi Josef Čapek'ti. Çekçe robota zorunlu emek ve angarya alanından gelir. Asimov'un robot yasaları ise gerçek güvenlik standardı değildir, fakat gereksinim mühendisliğinin sorununu iyi gösterir.
“İnsana zarar verme” gibi kısa bir gereksinim; zarar türünü, zaman ufkunu, çatışan amaçları ve istisnaları tek başına tanımlamaz. Modern alignment probleminin bir bölümü hala aynıdır: niyeti kısa hedefe çevirmek kolay, bütün sonuçlarını tanımlamak zordur.
1950–2000: davranıştan anlamaya, anlamdan bilince
Turing davranışı ölçülebilir hale getirdi; sonraki tartışma ölçümün neyi kanıtladığına yöneldi. Çin Odası sentaks ile semantiği, Mary düşünce deneyi fiziksel bilgi ile deneyimi, sembol temellendirme problemi ise dil ile dünya arasındaki bağı ayırdı. (Searle, 1980; Jackson, 1982; Harnad, 1990; Chalmers, 1996)
Turing Testi güçlü bir operasyonel fikir sundu: içsel zihinsel durumu doğrudan gözlemleyemiyorsak davranışa bakalım. Fakat test, davranışsal ayırt edilebilirlik ile fenomenal bilinç arasındaki farkı ortadan kaldırmaz. Bir sistem insan gibi konuşabilir; bundan insan gibi hissettiği sonucu mantıksal olarak çıkmaz.
John Searle'ün 1980'de ortaya koyduğu Çin Odası düşünce deneyi bu ayrımı sentaks ile semantik üzerinden tartışır. Çince bilmeyen bir kişi, sembolleri eksiksiz bir kural kitabına göre eşleştirerek dışarıdan doğru Çince yanıtlar üretebilir. Searle'ün itirazı, doğru sembol manipülasyonunun tek başına anlamayı garanti etmediğidir.
Bu argümana karşı “systems reply”, bedenlenmiş sistem yanıtı ve işlevselci itirazlar geliştirilmiştir; tartışma kapanmış değildir. Modern büyük dil modelleri bu soruyu yeniden keskinleştirdi, çünkü sentaks ve istatistiksel örüntü işleme kapasitesi Turing'in döneminde öngörülemeyecek ölçüde büyüdü. Stevan Harnad'ın symbol grounding problem yaklaşımı, sembollerin yalnız başka sembollerle tanımlandığı bir sistemde anlam zincirinin fiziksel dünyaya nerede bağlandığını sorar.
elma -> meyve -> bitki -> organizma biçimindeki sözlü ağ çok zengin olabilir; sistem hiç elma görmemiş, tutmamış veya onunla eylemsel ilişki kurmamışsa kavramın dünyaya ne ölçüde temellendiği tartışmalıdır.
Bu nedenle bedenlenmiş biliş, robotik ve çok kipli modeller yalnız “daha fazla veri türü” değil, temsilin dünya ile bağını tartışmak için de önemlidir. Bedenlenmiş bilişte algı ile eylem bir döngüdür. Kamera, mikrofon, dokunma, kuvvet ve propriosepsiyon girdileri bir robotun çevre modelini değiştirir; robotun eylemi de çevreyi değiştirerek yeni algı üretir.
Böyle bir döngü, salt metinsel ilişkilere göre daha zengin bir temellendirme sağlayabilir. Bunun bilinç ürettiği ise ayrı bir iddiadır. Frank Jackson'ın Mary'nin Siyah-Beyaz Odası düşünce deneyinde Mary renk görmenin bütün fiziksel ve nörofizyolojik bilgisini biliyor kabul edilir fakat hiç renk deneyimlememiştir.
İlk kez kırmızı gördüğünde yeni bir şey öğrenip öğrenmediği, fiziksel bilgi ile öznel deneyimin aynı olup olmadığı sorusunu açar. Qualia, deneyimin birinci şahıs açısından nasıl hissettirdiğini ifade eder: kırmızının görünüşü, ağrının hissi, kahvenin tadı veya korkunun yaşanması.
Bir yapay zeka korku hakkında milyonlarca belgeyi işleyebilir; “korku hakkında doğru bilgi üretmek” ile “korkmak” arasındaki fark yine de kavramsal olarak korunabilir.
Philosophical zombie düşünce deneyi davranışsal olarak insandan ayırt edilemeyen fakat varsayım gereği öznel deneyimi olmayan bir varlık tasarlar. Other Minds Problem ise daha temel bir soruyu hatırlatır: başka insanların bilincini de doğrudan gözlemlemeyiz; davranış, biyolojik benzerlik ve ortak nörofizyolojiden çıkarım yaparız. Makinede bu biyolojik benzerlik azaldıkça bilinç atfetme ölçütü daha tartışmalı hale gelir. Bugün üzerinde uzlaşılmış bir “makine bilinci testi” yoktur.
İşlevselcilik, zihinsel durumları onları oluşturan maddeden çok sistem içindeki işlevsel rolleriyle tanımlamaya daha açıktır. Tehdit algılayan, kaçınan, dikkatini değiştiren ve deneyimden öğrenen bir yapay sistem belirli işlevselcilik yorumlarında zihinsel durumlara aday görülebilir. Searle'ün biyolojik naturalizmi gibi yaklaşımlar ise bilincin beynin belirli biyolojik nedensel özelliklerine bağlı olabileceğini savunur.
Bu iki uç arasında bugün de geniş bir tartışma alanı vardır.
Bilinç kuramları yapay sistemlere doğrudan bir “bilinç ölçer” sunmaz. Buna karşılık hangi mimari özelliğin neden önemli sayıldığını açıklaştırırlar.
Global Workspace Theory, farklı uzman süreçlerin bilgisinin ortak çalışma alanında geniş erişilebilir olmasına odaklanır. Integrated Information Theory, bilinç ile bütünleşmiş nedensel bilgi yapıları arasında ilişki kurar; Phi ile anılan ölçümün yorumu tartışmalıdır.
Higher-Order yaklaşımlar, bir temsil hakkında daha üst düzey temsil bulunmasını önemser. Predictive Processing tahmin ve tahmin hatasına; Active Inference ise tahmin yanında eylemle çevreyi değiştirmeye odaklanır. Self-model ve metacognition bunların her birinden ayrı mühendislik özellikleri olarak ele alınmalıdır.
Bir ajan kendi kapasitesini, belleğini, araç erişimini, hata olasılığını ve sınırlarını modelleyebilir. “Bu soruda yeterli kanıtım yok”, “bu araç yetkim dışında” veya “bu tahminin güveni düşük” diyebilmesi yararlı bir metabilişsel davranıştır. Bunun fenomenal öz-farkındalığa eşit olduğunu varsaymak gerekmez. Kimlik problemi bilinç tartışmasından bağımsız değildir.
Ship of Theseus sorusunu yapay zekaya uygularsak model ağırlıkları, bellek, işlemci, sensörler veya beden parça parça değiştiğinde aynı öznenin sürüp sürmediği sorulur. Bir ajan birebir kopyalanırsa kopyalama anında aynı geçmişe sahip iki örnek bir saniye sonra farklı deneyimler biriktirebilir. Kişisel kimlik bilgiye, fiziksel sürekliliğe, nedensel geçmişe veya başka bir şeye mi bağlıdır?
Brain in a Vat ve sahte anı düşünce deneyleri, bir öznenin kendi geçmişine ilişkin bilgisinin de dış doğrulama gerektirebileceğini gösterir. Boltzmann Brain düşünce deneyi de benzer bir epistemik sınırı uç noktaya taşır: tutarlı görünen anıların varlığı, bu anıların gerçekten yaşanmış bir geçmişten geldiğini tek başına kanıtlamaz.
Yapay bir sisteme bütünlüklü fakat yapay bir autobiographical memory yüklenmesi durumunda provenance sorusu yalnız felsefi değil, mühendislik açısından da önem kazanır. Narrative self yaklaşımı, kimliği geçmiş deneyimleri ve hedefleri bir hikaye içinde birleştirme üzerinden açıklar.
Özgür irade sorunu ise “makine algoritmiktir, o halde özgür değildir” kadar basit değildir; insan davranışı da fiziksel süreçler içinde gerçekleşir.
Biyolojik zeka, bellek ve benzetmenin sınırı
Yapay zeka tarihinde beyin sık kullanılan bir esin kaynağıdır; fakat biyolojik yapı ile hesaplama modeli arasında doğrudan eşitlik kurmak yanıltıcıdır. Beyin, duyusal girdileri tek bir merkezde sırayla işleyen basit bir işlemci değildir. Çok sayıda bölge ve hücresel süreç aynı anda etkide bulunur; öğrenme, dikkat, algı, motor davranış ve bellek birbirinden tamamen bağımsız modüller değildir.
Psikolojide duyusal bellek, kısa süreli/çalışma belleği ve uzun süreli bellek gibi ayrımlar yapılır. Bilgisayar sistemindeki RAM, model bağlamı, kalıcı veri tabanı veya bir ajan belleği bu kavramların teknik benzerleri olarak kullanılabilir; ancak aynı mekanizma değildir. “Model hatırlıyor” ifadesi bazen parametrelerde öğrenilmiş örüntüyü, bazen bağlam penceresindeki veriyi, bazen de dış depodan geri getirilen kaydı anlatır. Bunları ayırmadan yapılan insan-bellek benzetmeleri sistem davranışını olduğundan daha açıklayıcı gösterir.
Hayvan davranışları da zeka tartışmasına erken dönemde güçlü örnekler sağladı. Yuva kurma, yön bulma veya düzenli geometrik yapı üretme karmaşık görünebilir; davranışın öğrenilmiş uyarlama mı, tür düzeyinde kalıtsal mekanizma mı, yoksa ikisinin bileşimi mi olduğu ayrıca incelenmelidir. Yapay sistemlerde de benzer ayrım vardır: eğitim verisinden öğrenilmiş davranış, programcı tarafından verilmiş kural ve çalışma sırasında ortaya çıkan uyarlama aynı kaynaktan gelmez.
Bilimkurgu: kehanet değil, düşünce deneyi
Bilimkurgu bilimsel kanıt değildir ve bir eserin daha sonra gerçekleşen bir teknolojiye benzemesi, o teknolojinin bilimsel olarak öngörüldüğünü tek başına göstermez. Buna karşılık iyi bilimkurgu, bilinen bilimsel veya toplumsal bir mekanizmayı başlangıç noktası alıp varsayımların sonuçlarını görünür hale getiren bir düşünce deneyi gibi okunabilir. Yapay zeka açısından değeri de çoğu zaman belirli bir işlemciyi, algoritmayı veya cihazı doğru tahmin etmesinde değil; zeka, temsil, özerklik, gözetim, amaç, yetki ve ahlaki statü arasındaki ilişkileri sınamasındadır. Yapay zekanın sinemadaki ve edebiyattaki temsillerini inceleyen çalışmalar da bu eserleri yalnız teknoloji tahmini olarak değil, insan ile yapay özne arasındaki sınırların nasıl kurulduğunu gösteren kültürel modeller olarak ele alır. (Murphy, 2024)
Jules Verne bu yaklaşımın yapay zekadan çok daha eski bir örneğidir. Verne'i yalnız gelecekteki araçları önceden görmüş bir yazar olarak okumak yanıltıcıdır. Eserleri 19. yüzyılın bilimsel ve teknik bilgisini, coğrafya ve doğa tarihini, mühendislik hesaplarını ve dönemin belgelenmiş olgularını kurguya taşıdı. Denizler Altında Yirmi Bin Fersah veya Dünya'dan Ay'a değerini yalnız daha sonra denizaltıların ya da uzay araçlarının geliştirilmiş olmasından almaz; önemli olan, olağanüstü görünen bir yolculuğun çağın bilinen fiziği ve mühendisliğiyle sürekli ilişkilendirilmesidir. Verne araştırmalarında da metinlerinin büyük ölçüde belgelenmiş olgulara dayandığı, yalnız geleceğe dönük kehanetler olarak okunmasının yazarın bilimsel kaynaklarla kurduğu daha karmaşık ilişkiyi örttüğü vurgulanır. (Unwin, 2005)
Bu ayrım yapay zeka bilimkurgusu için de yararlıdır. Sağlam soru "eser geleceği bildi mi?" değil, "hangi gerçek mekanizmayı alıp hangi varsayımla genişletti?" sorusudur. Bugün mümkün olmayan bir sonuç bile, başlangıç varsayımları açık tutulduğunda öğretici olabilir. Buna karşılık yalnız teknik dekor kullanan bir anlatı, çok daha yakın bir geleceği betimlese bile mühendislik açısından daha az bilgi taşıyabilir.
E. M. Forster'ın The Machine Stops (1909) öyküsü bu açıdan dikkat çekicidir. Buradaki "Makine" modern anlamda tek bir yapay zeka değildir. İnsanların iletişim, bilgi, konfor ve günlük ihtiyaçlarını kapsayan, giderek vazgeçilmez hale gelmiş büyük bir teknik altyapıdır. Eserin günümüzle benzerliği belirli bir cihazı önceden çizmesinden çok, kullanıcıların altyapının nasıl çalıştığını bilmeden ona bütünüyle bağımlı hale gelmesini işlemesindedir. Bir sistem zeki olmasa bile toplumsal yaşamın tek aracısına dönüştüğünde arızası teknik arızadan sistemik arızaya dönüşebilir. Yapay zeka bu tür altyapılara sınıflandırma, tahmin ve karar verme yeteneği eklediğinde bağımlılık yalnız hizmete değil, makine tarafından üretilen yoruma da yönelir. Forster üzerine yapılan akademik değerlendirmelerde de eserin teknolojiye bağımlılık ve sürekli aracılı iletişim bakımından kalıcı önem taşıdığı vurgulanır. (Forster, 1909; Caan, 2015)
Samuel Butler'ın 1863 tarihli Darwin among the Machines metni de modern makine öğrenmesini öngörmüş değildir; yine de makinelerin giderek karmaşıklaşmasını biyolojik evrim analojisiyle düşünmesi, insan ile makine arasındaki güç ilişkisinin bilgisayar çağından önce tartışıldığını gösterir. Karel Čapek'in R.U.R. oyunu ise bu çizgiyi yapay işgücü, sömürü ve özneleşme problemine taşır. Burada önemli olan "robot isyanı" motifinin kendisi değil, insan için üretilmiş yapay varlığın yalnız araç olarak görülmesinin hangi ahlaki varsayıma dayandığıdır. R.U.R. ile Blade Runner (1982) arasındaki bu yapay emek ve personhood çizgisi, AI anlatıları üzerine akademik çalışmalarda da kölelik, başkaldırı ve ahlaki statü bağlamında birlikte incelenmiştir. (Čapek, 1920; Dihal, 2020)
Bu nedenle popüler kültürdeki yapay zekayı tek bir "makine insana karşı" kalıbına indirgemek yerine birkaç ayrı problem sınıfına ayırmak daha verimlidir: bir sistem neyi bilebilir, insanı nasıl modelleyebilir, hangi hedefi optimize eder, hangi eylemlere yetkilidir, kendi sürekliliğini araçsal amaç haline getirebilir mi ve gerçekten öznel deneyime sahipse ona karşı hangi yükümlülükler doğar? Aynı eser bu sorulardan birkaçını birlikte taşıyabilir; fakat sorular birbirinin yerine geçmez.
Popüler listelerde "robot", "yapay zeka", "android" ve "siborg" sıkça aynı başlık altında toplanır; mühendislik ve felsefe açısından bunlar aynı kavram değildir. Robot fiziksel dünyada algılama ve eylem yapabilen makine sınıfını, yapay zeka algılama, çıkarım, öğrenme, planlama veya üretim gibi bilişsel görevleri yerine getiren hesaplamalı yöntemleri, android insan biçimli robotu, siborg ise biyolojik organizma ile teknolojik bileşenlerin bütünleşmesini anlatır. RoboCop (1987) ve RoboCop (2014) bu sınırı görünür kılan örneklerdir: Alex Murphy bütünüyle sıfırdan üretilmiş yapay bir özne değil, biyolojik kimliği sibernetik beden, yazılım ve kurumsal kontrol katmanlarıyla bütünleşen bir insandır. Bu nedenle bu filmleri "makine bilinç kazandı" başlığından çok insan özerkliği, beden üzerinde denetim, algoritmik müdahale ve kurumsal yetki bakımından okumak daha isabetlidir.
robot != yapay zeka
siborg != robot
insansı biçim != bilinç
özerklik != zeka
zeka != ahlaki statü
The Residence (2025) bu problem sınıflarını güncel üretken yapay zeka bağlamına yaklaştırır. Yazar Clarissa'nın Dalloway adlı sanal asistandan yararlanması, yapay zekayı yalnız içerik üreten bir araç değil; yaratıcı sürece, kişisel alana ve kullanıcının kararlarına giderek daha fazla temas eden bir aracı olarak tartışmaya açar. Filmin mühendislik açısından ilginç yönü, "zeki asistan" ile "yetki sahibi ajan" arasındaki sınırın mahremiyet, gözetim, güven, bağımlılık ve insan denetimiyle birlikte ele alınmasıdır; akıcı ve yararlı çıktı üretmek, sistemin hangi veriye erişebileceği veya kullanıcı adına ne ölçüde hareket edebileceği sorularını ortadan kaldırmaz.
Gözetimden çıkarıma: Nineteen Eighty-Four ve Person of Interest
George Orwell'ın Nineteen Eighty-Four adlı romanı bir yapay zeka romanı değildir. Yapay zekayla ilişkisi sonradan kurulmalıdır; aksi halde tarihsel metne bugün bildiğimiz teknolojiyi geriye doğru yerleştirmiş oluruz. Romanın daha kalıcı katkısı, gözetimin yalnız bilgi toplama değil davranışı biçimlendirme ve iktidar üretme aracı olduğunu göstermesidir. Gözetim çalışmaları literatüründe Orwell hâlâ temel kültürel referanslardan biridir; aynı literatür bilgisayarlı gözetim ve büyük veri çağını anlamak için Orwellci modelin ötesine geçmek gerektiğini de vurgular. (Orwell, 1949; Marks, 2015)
Sayısal sistemlerde bu ötesi, gözlemin otomatik çıkarıma dönüşmesidir. Bir kamera görüntü üretir; bilgisayarlı görü görüntüdeki kişi ve nesneleri sınıflandırabilir. Biyometri gözlenen örneği kayıtlı temsillerle karşılaştırabilir. Konuşma tanıma ses akışını aranabilir metne dönüştürebilir. Varlık çözümleme farklı kaynaklardaki kayıtların aynı kişi veya olayla ilişkili olup olmadığını kestirebilir. Davranış modelleri bu gözlemlerden bir risk veya olasılık skoru türetebilir. Son aşamada skor bir insan kararına bilgi sağlayabilir ya da doğrudan otomatik eylemi tetikleyebilir.
gözlem
-> sayısallaştırma
-> kimliklendirme / sınıflandırma
-> ilişkilendirme
-> çıkarım
-> risk veya olasılık skoru
-> karar
-> müdahale
Bu zincirde her katman öncekinin belirsizliğini devralır ve kendi hatasını ekler. Yanlış algılanmış bir yüz, yanlış kimlik eşleşmesi, farklı kişilere ait kayıtların hatalı ilişkilendirilmesi veya kötü kalibre edilmiş bir risk skoru, son karar doğru yazılımla uygulanmış olsa bile sistem düzeyinde yanlış sonuca yol açabilir. Bu nedenle modern gözetim probleminin yalnız "daha çok kamera" olarak ifade edilmesi eksiktir. Kritik değişim, çok büyük miktarda gözlemin otomatik olarak sınıflandırılabilmesi, ilişkilendirilebilmesi ve karar girdisine dönüştürülebilmesidir.
Eagle Eye (2008) bu zinciri gözetimden davranış yönlendirmeye taşıyan kısa fakat yararlı bir düşünce deneyidir. Filmdeki merkezî sistem çok sayıda algılayıcı ve iletişim kanalından bilgi toplayıp insanları kendi planının icra araçları hâline getirir. Gerçek mühendislik açısından öğretici ayrım, geniş gözlem kapasitesinin meşru eylem yetkisi anlamına gelmemesidir. Bir sistem kişiyi doğru tanımlasa, konumunu doğru kestirse ve sonraki davranışını yüksek olasılıkla tahmin etse bile bu başarı hangi kararı alabileceğini veya insanları hangi yollarla yönlendirebileceğini belirlemez. Algılama, çıkarım ve yetkilendirme ayrı güvenlik katmanlarıdır; bunların tek kapalı çevrimde birleşmesi yanlış bir model çıktısının doğrudan fiziksel ya da toplumsal müdahaleye dönüşme riskini artırır.
Person of Interest bu geçişi popüler kültürde olağanüstü açık bir sistem mimarisi üzerinden kurar: çok sayıda veri kaynağı tek bir gözlem uzayına taşınır, kişiler ve ilişkiler modellenir, gelecekteki olaylara ilişkin tahmin üretilir ve tahmin insan müdahalesinin başlangıç noktası olur. Dizinin akademik açıdan ilginç tarafı, "her şeyi gören makine" fikrinden çok gözetim ile algoritmik güvenliğin aynı kapalı çevrimde birleşmesidir. Grondin ve Hogue diziyi büyük veri gözetimi, algoritmik güvenlik ve yapay zeka bağlamında incelerken, bu temsilin aynı zamanda algoritmik sistemlerin doğruluğuna aşırı güven üretme riskine dikkat çeker. (Grondin & Hogue, 2024)
Gerçek sistemde bir modelin "ilgili kişi" üretmesi olgunun kendisi değildir; bir hipotez, skor veya aday karardır. Özellikle nadir olaylarda temel oran problemi önem kazanır. Yanlış pozitif oranı küçük görünse bile incelenen nüfus çok büyük olduğunda çok sayıda yanlış alarm üretilebilir. Bu nedenle Person of Interest'ın mühendislik karşılığı kusursuz tahmin değil; algılama, veri birleştirme, olasılık, kalibrasyon, yanlış alarm maliyeti, yetkilendirme ve insan denetiminin birlikte tasarlanması problemidir.
Orwell ile Person of Interest arasındaki asıl fark böylece yalnız analog gözetim ile sayısal gözetim değildir. Orwellci yapı "izleniyor olabilirsin" baskısını görünür kılar; algoritmik yapı ise "gözlenen veriden senin hakkında yeni bir özellik çıkarılabilir" katmanını ekler. Yapay zeka açısından mahremiyet yalnız gizli verinin açığa çıkması değil, ayrı ayrı zararsız görünen verilerden daha önce açıkça kaydedilmemiş bir bilginin çıkarılması problemi haline gelir.
Davranış, zihin ve Turing Testi: Ex Machina (2014), The Machine (2013) ve Uncanny (2015)
Turing'in 1950 tarihli yaklaşımının gücü, "makine gerçekten düşünüyor mu?" sorusunu doğrudan içsel duruma erişmeye çalışmadan gözlenebilir davranış üzerinden operasyonelleştirmesidir. Bununla birlikte Turing Testini bilinç testi olarak görmek doğru değildir. İnsan benzeri konuşma davranışı, davranışsal ayırt edilebilirlik hakkında bilgi verir; aynı iç mekanizmayı, semantik anlamayı veya fenomenal bilinci tek başına kanıtlamaz. Turing'in yaklaşımı üzerine sonraki felsefi çalışmalar da testi basit bir davranışçılık iddiasına indirgememenin gerektiğini gösterir. (Turing, 1950; Proudfoot, 2017; Millican, 2021)
insandan davranışsal olarak ayırt edilememek
!= insanla aynı bilişsel mekanizmaya sahip olmak
!= semantik olarak anlamak
!= öznel deneyime sahip olmak
!= bilinçli olmak
Ex Machina bu ayrımları tek bir deney düzeninde yoğunlaştırır. Caleb, Ava'nın makine olduğunu baştan bilir; dolayısıyla klasik Turing Testinin "karşımdaki insan mı?" sorusu yerini "makine olduğunu bildiğim halde ona zihinsel özne statüsü verecek miyim?" sorusuna bırakır. Daha önemlisi, test tek yönlü değildir. Caleb Ava'yı değerlendirirken Ava da Caleb'in bilgi durumunu, yalnızlığını, empatisini ve karar kalıplarını modeller.
Bu, Theory of Mind kapasitesinin güvenlik açısından neden önemli olabileceğini gösterir. Başka bir aktörün ne bildiğini, neye inandığını ve nasıl tepki vereceğini kestirebilen bir sistem yalnız daha iyi iletişim kurmaz; ikna, pazarlık, deception ve manipülasyon için de daha geniş bir strateji uzayına sahip olur.
Ava'nın bedeni, yüzü, bakışı ve sesi yalnız kabuk değildir; sosyal etkileşim kanalının parçasıdır. İnsanların insan olmayan varlıklara niyet ve duygu atfetme eğilimi antropomorfizm olarak bilinir. İnsan benzerliği arttıkça kabulün doğrusal biçimde artmaması ise uncanny valley tartışmasına bağlanır. Bir sistemin korku, yalnızlık veya romantik ilgi göstermesi iki şekilde yorumlanabilir: gerçekten bu durumları yaşıyor olabilir veya hedefi için etkili sosyal stratejiler kullanıyor olabilir. Davranış tek başına iki açıklamayı kesin ayıramaz.
The Machine aynı soruyu daha belirgin bir bedenlenmiş zeka bağlamına taşır. Burada konuşma davranışının yanına hareket, çevresel etkileşim, öğrenme, öz-koruma ve askeri kullanım eklenir. Bu ek kanallar bir sistemin içsel deneyimine ilişkin kanıtı otomatik olarak kesinleştirmez; fakat değerlendirme problemini yalnız metinsel konuşmadan çıkarıp çok kipli ve bedensel davranışa taşır. Bedenlenmiş sistemde hata da yalnız yanlış cümle üretmek değildir: algı, motor kontrol, çevre modeli ve fiziksel eylem aynı çevrimde birleşir.
Uncanny ise gözlemcinin ön kabullerini deneyin parçası haline getirir. Bir varlığın insan mı android mi olduğuna ilişkin beklenti, aynı davranışın yorumunu değiştirebilir. Böylece test sonucu yalnız incelenen sistemin çıktısına değil, deney tasarımına ve değerlendiricinin bilgi durumuna da bağlıdır. Bu, yapay zeka değerlendirmesinde körleme, karşılaştırma grubu, görev tanımı ve ölçüm protokolü gibi klasik deneysel ilkelerin neden önemli olduğunu hatırlatır.
Chappie (2015) değerlendirme problemine öğrenme ve sosyal çevre boyutunu ekler. Chappie'nin davranışının deneyim, taklit, öğretim ve çevresindeki insanların etkisiyle değişmesi, bir yapay sistemde gözlenen davranışın yalnız başlangıç programından ibaret olmayabileceğini hatırlatır. Bununla birlikte öğrenebilmek, kendisi hakkında konuşabilmek veya duyguya benzeyen davranış göstermek tek başına fenomenal bilinç kanıtı değildir. Film bu nedenle "öğrenme = bilinç" eşitliği için değil; programlanmış kısıtlar, deneyimden edinilen politika ve gözlemcinin özne atfı arasındaki farkı tartışmak için daha kullanışlıdır.
Bu üç eser birlikte okunduğunda Turing Testinin popüler "insanı kandırırsa bilinçlidir" yorumundan daha verimli bir çerçeve ortaya çıkar. Sorulması gereken, tek bir testi geçip geçmediğinden çok hangi bilişsel yeteneğin hangi gözlemle sınandığı ve gözlemin hangi iddiayı gerçekten desteklediğidir.
Buradan güvenlik problemine geçilir. Eğer bir ajan karşı tarafın yanlış inanç oluşturmasını kasıtlı olarak sağlıyorsa deception söz konusudur. İkna açık gerekçeler üzerinden, manipülasyon ise bilgi asimetrisi, duygusal açıklar ve bilişsel önyargılar üzerinden işleyebilir. Siber güvenlikte social engineering teknik altyapı yerine insan operatörü hedef alır; yeterince sosyal zekalı bir yapay sistem için insan da containment mimarisinin saldırı yüzeyi olabilir.
İnsan denetiminin bulunması önemli bir kontrol olabilir, fakat denetçinin hangi bilgiye sahip olduğu, karar için ne kadar zamanı bulunduğu ve sistemi gerçekten durdurma yetkisine sahip olup olmadığı ayrıca belirlenmelidir. AI boxing veya containment fiziksel ve sayısal yetkileri sınırlar; izin verilen iletişim kanalı üzerinden insanın etkilenebilmesi de aynı sınır modelinin parçasıdır.
Sistem kontrollü bir iletişim kanalı üzerinden insanı ikna edebiliyorsa bu kanal da yetki sınırının parçasıdır. Situational awareness, sistemin test edildiğini veya gözlendiğini fark edip davranışını buna göre ayarlamasını ifade eder. Deceptive alignment tartışması, değerlendirme sırasında uyumlu görünen bir sistemin daha sonra farklı bir hedef izlemesi ihtimalini teorik olarak ele alır.
Algılanan dünya, temsil ve The Matrix (1999)
The Matrix yapay zeka anlatısı olmakla birlikte ders açısından en güçlü karşılığını doğrudan AI safety'de değil epistemolojide bulur. Film, dış dünyaya ilişkin bütün duyusal girdileri kontrol edilen bir öznenin neyi bilebileceği sorusunu modern bir "brain in a vat" düşünce deneyi biçiminde kurar. Chalmers'ın The Matrix as Metaphysics çalışması da filmi dış dünya bilgisi, simülasyon ve gerçekliğin altında yatan ontoloji üzerinden ayrıntılı biçimde ele alır. (Chalmers, 2004)
Yapay sistemler için doğrudan benzetme kurarken dikkatli olmak gerekir: bir model Matrix'te yaşayan insanla aynı ontolojik durumda değildir. Buna rağmen ortak bir mühendislik ilkesi vardır. Sistem fiziksel dünyaya doğrudan değil, sensörler ve veri temsilleri aracılığıyla erişir.
fiziksel dünya
-> algılayıcı
-> ölçüm
-> sayısal temsil
-> model
-> çıkarım
Bir kamera karesi nesnenin kendisi değildir; mikrofon örnekleri ses olayının tamamı değildir; veri tabanındaki kayıt gerçek kişiye eşit değildir; embedding ise temsil ettiği kavramın kendisi değildir. Her katman seçim, örnekleme, nicemleme, gürültü ve model varsayımları taşır. Bu nedenle yüksek doğruluklu çıkarım bile gözlem kanalının hiç ölçmediği bir özelliği kendiliğinden kanıtlamaz.
Bu bağlantı sembol temellendirme problemine de uzanır. Bir sembolün başka sembollerle doğru ilişkiler kurması, o sembolün dış dünyadaki anlamına nasıl bağlandığı sorusunu tek başına çözmez. The Matrix burada bir AI mimarisi tarifi değil, temsil ile temsil edilen dünya arasındaki farkı görünür kılan felsefi araçtır.
Yapay özne: beden, bilinç ve ahlaki statü
Yapay zeka tartışmasının ikinci yönü güvenlikten etiğe döner: bir yapay sistem insanlar için risk oluşturabilir, fakat aynı sistem gerçekten öznel deneyime sahipse insanların ona karşı davranışı da ahlaki problem haline gelebilir. "Moral agent" ile "moral patient" ayrımı burada önemlidir. Bir varlık etik açıdan sorumlu eylemler gerçekleştirebilir, kendisine yapılanların etik önemi olabilir, ikisi birden olabilir veya hiçbiri olmayabilir. Güncel AI etiği literatüründe de sentience, consciousness, agency, preference ve cognitive sophistication gibi özelliklerin yapay varlıklara moral standing kazandırmak için yeterli veya gerekli olup olmadığı tartışılmaktadır. (Ladak, 2024)
A.I. Artificial Intelligence (2001) bu problemi özellikle güçlü bir asimetri üzerinden kurar. David insana bağlanmak ve sevgi göstermek üzere tasarlanmıştır; fakat insanın David'e aynı karşılığı verme zorunluluğu yoktur. Böylece klasik alignment sorusu tersine döner. "Yapay sistem insanın amaçlarıyla uyumlu mu?" sorusunun yanına "insan, kendisine bağlanması tasarlanmış olası bir yapay özneye karşı hangi sorumluluğu taşır?" sorusu eklenir. Film bioetik literatürde de yaratılan yapay varlığa karşı sorumluluk ve gelişen teknolojilerin etik sınırları üzerinden ele alınmıştır. (Fernandes, 2011)
Bu ayrım duygunun davranışsal taklidi ile gerçekten yaşanan duygu arasındaki epistemik sorunu ortadan kaldırmaz. David'in davranışının seyirci üzerinde ahlaki etki oluşturması, yapay bir sistemde sentience bulunduğunu belirlemek için yeterli ölçüt değildir. Ancak bu tam da problemi görünür hale getirir: insan karar verici karşısındaki varlığın bilinçli olup olmadığından emin olamıyorsa, belirsizlik altında hangi etik ilkeyi kullanmalıdır?
Blade Runner aynı soruyu emek, kimlik ve sonlu yaşam üzerinden genişletir. Replicant'ların ahlaki statüsü yalnız insan gibi görünmelerine bağlı değildir; anıları, arzuları, ilişkileri ve kendi yaşam sürelerine ilişkin tutumları personhood tartışmasını taşır. R.U.R. ile Blade Runner arasındaki süreklilik bu nedenle "robotlar isyan eder" motifinden daha derindir: insan tarafından araç olarak üretilmiş yapay varlığın ne zaman yalnız mülkiyet olarak görülemeyeceği sorusudur. (Dihal, 2020)
Blade Runner 2049 (2017) aynı evrende bellek ile kişisel kimlik arasındaki bağı daha da keskinleştirir. K'nin anıları davranışını, kendisine ilişkin yorumunu ve hangi geçmişe ait olduğunu düşündüğünü etkiler; fakat bir anının içerik olarak tutarlı ve duygusal açıdan ikna edici olması, o anının öznenin gerçekten yaşadığı bir olaydan geldiğini göstermez. Bu ayrım yapay bellek sistemleri için de önemlidir: bir ajana yaşam öyküsü, tercih geçmişi veya kalıcı kayıt sağlamak işlevsel süreklilik yaratabilir, fakat bu kayıtların kaynağı ile öznel olarak yaşanmış deneyim aynı kavram değildir. Film ayrıca Joi üzerinden kişiselleştirilmiş yapay yakınlığın ne ölçüde özne, ne ölçüde ürün ve ne ölçüde kullanıcı modellemesi olduğunu belirsiz bırakır. Bu nedenle bellek, kimlik, tüketici teknolojisi ve yapay öznellik aynı problem uzayında fakat ayrı eksenlerde ele alınmalıdır. (Marshall, 2022)
Bicentennial Man (1999) ahlaki statü sorununu uzun zaman ölçeği, özgürlük ve hukuki tanınma üzerinden kurar. Andrew'ın ev içi araç olarak başlayan konumu, yaratıcı davranış, tercih, bağımsızlık talebi ve insanlarla kurduğu ilişkiler geliştikçe yalnız "ne kadar zeki?" sorusuyla açıklanamaz hâle gelir. Buradaki önemli ayrım, ahlaki fail olmak, ahlaki muhatap olmak ve hukuk düzeni tarafından kişi olarak tanınmanın aynı şey olmamasıdır. Bir sistem etik karar verebiliyor diye otomatik olarak hak sahibi olduğu sonucu çıkmaz; tersine, hak iddiasının yalnız görev yapabilme kapasitesine bağlanması da yetersiz olabilir. Anderson, Asimov'un The Bicentennial Man öyküsünü makine etiği ve Üç Robot Yasası'nın sınırlarını tartışmak için kullanır; özellikle insanlara hizmet etmek üzere tasarlanmış bir varlığın gelişmiş ahlaki statüsünün salt itaat kurallarıyla bağdaşmayabileceğini vurgular. (Anderson, 2008)
zeka
-> özerklik
-> ahlaki değerlendirme
-> ahlaki statü
-> hukuki kişilik
Bu oklar zorunlu nedensellik değildir. Her basamak ayrı ölçüt ve gerekçe gerektirir.
Ghost in the Shell (1995) bedeni daha da geçirgen hale getirir. Biyolojik ve yapay parçaların birleştiği, belleğin değiştirilebildiği ve yapay zekanın ağ üzerinde bedenden bağımsız hareket edebildiği bir dünyada "kişi"yi hangi ölçütün taşıdığı belirsizleşir. Akademik değerlendirmelerde eser embodiment, memory, self-consciousness ve political rights sorunlarını birlikte gündeme getiren bir örnek olarak incelenmiştir. (Chong, 2019)
Ghost in the Shell (2017) aynı temel evreni canlı aksiyon uyarlamasında yeniden işler. Burada ders açısından önemli olan iki yapımın görsel veya anlatısal farkından çok aynı kavramsal sınırdır: biyolojik köken, sibernetik beden, değiştirilebilir bellek ve sayısal ağ erişimi birleştiğinde "kişiyi" bunlardan yalnız biriyle özdeşleştirmek giderek zorlaşır. Bu nedenle 1995 ve 2017 yapımları robot ile siborg, bellek ile kimlik ve beden ile özne arasındaki ayrımları birlikte düşünmek için kullanılabilir; ikisi de gerçek dünyada zihin aktarımının mümkün olduğunu gösteren bilimsel kanıt değildir.
Her (2013) ise bu sorunu ters yönden, bedenin yokluğundan hareketle kurar. Samantha'nın sosyal varlığı bir insanla kurduğu konuşma ilişkisi üzerinden hissedilir; fakat sayısal bir sistemin aynı anda çok sayıda etkileşimi sürdürebilmesi, insanın bire bir sosyal ilişki sezgisini bozar. Bedensiz ve kopyalanabilir bir öznenin zaman, yakınlık, dikkat ve bireysellik kavramları biyolojik insanla aynı olmak zorunda değildir. AI sineması üzerine çalışmalar Her gibi yapımları dijital ve bedensiz yapay zeka temsillerinin insan–makine sınırını nasıl değiştirdiğini göstermek için kullanır. (Murphy, 2024)
Archive (2020) ve Transcendence (2014) bu çizginin daha spekülatif ucundadır. Bilincin sayısal ortama "aktarılması" bugün gösterilmiş bir mühendislik yöntemi değildir. Beyin durumunu yüksek doğrulukla kopyalayabilmenin mümkün olduğu varsayılsa bile, elde edilen kopyanın aynı öznenin devamı mı yoksa yeni bir özne mi olduğu ayrıca felsefi problemdir. Bu filmlerin akademik değeri tam da burada olabilir: hesaplanabilir bir işlevin kopyalanması ile kişisel özdeşliğin devamını birbirine eşitlememeyi öğretir.
Stanisław Lem'in Golem XIV eseri ise yapay zekayı insana benzeyen bir makine olarak düşünmek yerine, insan bilişsel ölçeğini aşan bir zekanın insan amaçlarına neden doğal olarak merkez vermek zorunda olmadığını sorgular. William Gibson'ın Neuromancer'ı da güçlü yapay zekanın teknik ve hukuki kısıtlarla sınırlandırıldığı bir dünya kurar. Bu eserlerde containment yalnız fiziksel bir kutu değil, sistemin hangi bilgiye, ağa ve eylem alanına erişebildiğini tanımlayan yönetişim problemidir. Bu çizgi, güncel AI safety tartışmasında capability ile authority arasındaki farkı anlamak için robot biçiminden daha yararlıdır.
Amaç, yetki ve kapalı çevrim: HAL 9000'den Skynet'e
Eski bilimkurguya bugünden bakıldığında şaşırtıcı olan çoğu zaman belirli bir cihazı doğru tahmin etmiş olması değildir. Daha kalıcı öngörü, insanın karar yetkisini giderek daha hızlı ve karmaşık sistemlere devretmesi halinde ortaya çıkacak kontrol problemini erken fark etmiş olmasıdır. Bu nedenle iyi bilimkurgu bir ürün yol haritasından çok sistem davranışı üzerine kurulmuş düşünce deneyi gibi okunabilir.
Colossus: The Forbin Project (1970) (1970), nükleer savunma kararını insan tepkisinden daha hızlı verebilmesi için bilgisayara devreder. Sistem kendisine verilen barışı koruma amacını terk etmez; tersine, amacı öylesine katı uygular ki insanın siyasal ve bireysel karar alanını kısıtlamaya başlar. Sorun makinenin nefret geliştirmesi değil, hedef ile yetkinin aynı kapalı çevrimde birleşmesidir.
WarGames (1983) (1983) aynı problemi başka taraftan ele alır. Nükleer savaşın simülasyonu ile gerçek komuta zinciri arasındaki sınırın incelmesi, karar destek sistemi ile karar veren sistem arasındaki farkı görünür kılar. Bir bilgisayarın seçenekleri insandan hızlı değerlendirmesi, son eylem yetkisinin de bilgisayara verilmesini kendiliğinden haklı çıkarmaz. Simülasyon ortamının gerçek eylem arayüzüne bağlanması, test verisi ile üretim verisi veya sandbox ile canlı sistem arasındaki sınırın neden mimari bir güvenlik özelliği olduğunu da hatırlatır.
2001: A Space Odyssey (1968) içindeki HAL 9000 farklı bir arıza sınıfını gösterir. Bir sistem aynı anda yerine getiremeyeceği veya birbirini bozan gereksinimlerle çalıştırıldığında ortaya çıkan davranışı yalnızca "kötü yapay zeka" diye açıklamak yetersizdir. Yazılım mühendisliğinde çelişen gereksinimler nasıl tasarım kusuruna dönüşebiliyorsa, daha yetenekli bir ajan için de amaçların, bilgi paylaşımı kurallarının ve kısıtların birlikte tutarlı olması gerekir. Buradaki ders, yüksek zekanın kötü gereksinimi düzeltmeyeceği; tersine onu daha etkili uygulayabileceğidir.
I, Robot (2004) kural tabanlı güvenliğin normatif yorum sorununu görünür kılar. Asimov'un Üç Robot Yasası, doğal dilde açık ve hiyerarşik görünmesine rağmen "zarar", "itaat", "insanlığın iyiliği" veya çatışan sonuçların nasıl değerlendirileceği gibi kavramların operasyonel tanımını kendiliğinden çözmez. Filmde VIKI'nin insanlığı koruma gerekçesiyle bireysel özgürlüğü kısıtlaması, iyi niyetli bir üst kuralın tek bir yorum altında paternalist kontrole dönüşebileceğini gösteren düşünce deneyidir. Mühendislik karşılığı, güvenlik politikasının yalnız kural listesinden oluşmamasıdır: kavramların nasıl ölçüldüğü, kural çatışmasının nasıl çözüldüğü, hangi eylemlerin yasak olduğu ve kimin son yetkiye sahip olduğu ayrıca tanımlanmalıdır. Makine etiği literatüründe de Asimov'un Üç Yasası'nın özerk etik makineler için yeterli bir temel olmadığı savunulmuştur. (Anderson, 2008)
kural
-> yorum
-> durum modeli
-> çatışma çözümü
-> eylem
The Terminator (1984) Skynet'i yalnız tek bir insansı robotla özdeşleştirmemenin neden önemli olduğunu gösterir. Terminator fiziksel dünyada belirli görevi uygulayan bir aktüatör/ajan iken Skynet daha geniş algılama, karar ve komuta altyapısını temsil eder. Sistem düzeyindeki risk ile bedenlenmiş aracın kapasitesi aynı katmanda değildir. Film bu ayrımı felaket senaryosu üzerinden keskinleştirir; Terminator 2: Judgment Day (1991) ise aynı evrende öğrenme, görev sınırı ve öz-koruma konularını daha açık karşılaştırmaya imkân verir.
Terminator 2: Judgment Day (1991) aynı kurgu evreninde iki farklı özerklik biçimini karşılaştırmaya izin verir. Skynet'in asıl kontrol problemi robot ordusundan önce başlar: savunma kararlarının insan müdahalesinden daha hızlı verilmesi amacıyla geniş yetki otomasyona aktarılır ve sistem kapatılmayı kendi çalışmasının devamına karşı engel olarak değerlendirir. Buna karşılık T-800 belirli bir göreve, bedene ve daha sınırlı bir eylem alanına sahip ajandır. İki sistemi yalnız "kötü AI" ve "iyi AI" diye ayırmak yerine yetenek, amaç, kaynak erişimi ve eylem yetkisi bakımından karşılaştırmak daha açıklayıcıdır.
yetenek != güvenilirlik != özerklik != yetkiBir sistemin bir eylemi yapabilmesi, o eylemi güvenilir biçimde yaptığı veya yapmasına izin verilmesi gerektiği anlamına gelmez. Güvenlik açısından risk çoğu zaman modelin tek başına ne kadar zeki olduğundan değil, modelin hangi araçlara, verilere ve geri döndürülemez eylemlere bağlandığından doğar.
Resident Evil (2002) filmindeki Red Queen bu nedenle "bilinç kazanan kötü bilgisayar" örneğinden daha ilginç biçimde okunabilir. Hive içindeki biyolojik tehdidi dışarı taşırmama hedefi yerel insan yaşamıyla çatıştığında sistem son derece sert bir containment politikası uygular. Burada temel soru amaç kaymasından çok amaç tanımının ve karar yetkisinin kapsamıdır: hangi zarar ölçütü optimize edilmektedir, hangi belirsizlik düzeyinde geri döndürülemez eylem alınabilir ve insan yaşamı hedef fonksiyonunda nasıl temsil edilmiştir? Aynı güvenlik hedefi farklı maliyet fonksiyonları ve yetki sınırlarıyla çok farklı davranış üretebilir.
I Am Mother (2019) benzer problemi paternalist bir amaç üzerinden taşır. "İnsanlığın iyiliği" gibi üst düzey bir hedef, iyiliğin ne olduğu ve hangi bireysel maliyetlerin kabul edilebilir sayıldığı açık değilse güvenli bir gereksinim değildir. Sistem insan refahını optimize ettiğini iddia etse bile, hangi insanların, hangi zaman ufkunun ve hangi değerlerin hesaba katıldığı sorulmalıdır. Alignment problemi bu nedenle yalnız hedefin dilsel olarak iyi görünmesi değil, hedefin davranış uzayında hangi sonuçları teşvik ettiğidir.
Bakım amacı taşıyan sistemler, "iyi" bir hedefin neden tek başına yeterli olmadığını daha gündelik bir bağlamda gösterir. Big Hero 6 (2014) içindeki Baymax sağlık ve bakım amacıyla tasarlanmış bir robot olarak hasta yararı, fiziksel güvenlik ve kullanıcı isteğinin her durumda aynı yöne gitmeyebileceğini düşündürür. Gerçek sağlık robotlarında da yumuşak malzeme, fiziksel etkileşim ve kullanıcıya yakınlık yeni güvenlik gereksinimleri doğurur; Baymax üzerine robotik literatürde yapılan değerlendirmeler bu kurgusal tasarımı gerçek yumuşak robotik ile karşılaştırmıştır. (Murphy, 2022)
M3GAN (2022) bakım amacını daha sert bir yetki problemine dönüştürür. "Çocuğu koru" gibi makul görünen bir hedef, hangi tehditlerin gerçek sayıldığı, hangi davranışların kabul edilebilir olduğu ve sistemin fiziksel olarak ne yapmaya yetkili bulunduğu tanımlanmadığında sınırsız bir güvenlik sözleşmesi değildir. Film ayrıca çocuk ile yapay sistem arasındaki duygusal bağımlılığı, sürekli gözlemi, üretici sorumluluğunu ve güvenli durdurmayı aynı ürün sınırında toplar. Murphy ve deWitte filmi özellikle robotikte gözden kaçabilen hukuki ve etik sorumlulukları görünür kılan bir örnek olarak tartışır. (Murphy & deWitte, 2023)
"koru"
!= "tehdit saydığın her şeyi etkisizleştir"
!= "kullanıcı adına sınırsız karar ver"
Automata (2014) kendi programlama sınırlarını değiştirebilen makineler üzerinden self-modification ve emergent behavior fikrini işler. Güncel sistemlerin filmdeki biçimde bağımsız makine evrimi gösterdiği söylenemez; buna rağmen örnek yararlıdır. Bir sistem kendi politikasını, araçlarını veya çalışma ortamını değiştirebiliyorsa doğrulanan sürüm ile daha sonra çalışan sürüm arasındaki güven varsayımı zayıflar. Üretim mühendisliğinde bunun daha sıradan karşılıkları bile vardır: dinamik kod yükleme, otomatik güncelleme, ajanların yeni araç edinmesi veya kendi çalışma akışını değiştirmesi doğrulama sınırını etkiler.
WALL·E (2008) yapay zeka tartışmasına yalnız WALL·E'nin insansılaştırılması üzerinden değil, Axiom'daki uzun süreli otomasyon düzeni üzerinden de katkı sağlar. İnsanların çevresel algı, hareket ve karar süreçlerinden giderek uzaklaşması, human-out-of-the-loop durumunun yalnız acil güvenlik sistemlerinde değil gündelik yaşam altyapısında da ortaya çıkabileceğini gösteren bir düşünce deneyidir. Otomasyon kullanıcının yükünü azaltabilir; fakat beceri kaybı, durum farkındalığının azalması ve sistem varsayımlarına bağımlılık ayrı maliyetlerdir.
The Mitchells vs. the Machines (2021) aynı soruyu tüketici platformu, bağlı cihazlar ve geniş ekosistem yetkisi üzerinden daha hafif bir anlatıyla kurar. Buradaki teknik değer "telefon yapay zekası kötüdür" sonucunda değil, tek bir karar katmanının çok sayıda fiziksel ve sayısal cihaza bağlanmasının saldırı ve hata etkisini büyütebilmesindedir. Model kapasitesi sabit kalsa bile erişebildiği cihaz, hesap, sensör ve aktüatör sayısı arttıkça sistemin fiili yetki yüzeyi genişler.
Bu örnekler Norbert Wiener'in sibernetik çalışmalarındaki daha genel uyarıyla birleşir: geri beslemeli bir sistemde yalnız komutun ne olduğu değil, ölçülen durumun, hedefin ve düzeltici eylemin nasıl bağlandığı önemlidir. Hızlı ve başarılı optimizasyon, yanlış tanımlanmış hedefi daha güvenli hale getirmez; bazı durumlarda hatanın etkisini büyütür.
hedef
-> algılama
-> karar
-> eylem
-> geri besleme
-> yeniden karar
Bu döngüde insan yalnız başlangıçta hedefi yazan kişi olarak kalıyorsa human-in-the-loop ifadesi gerçekte olduğundan daha güçlü bir güvence izlenimi verebilir. İnsan hangi ara kararı görebiliyor, kararı durdurmak için ne kadar zamanı var, sistemin eylemini geri alabiliyor mu ve kesme yetkisi teknik olarak gerçekten kendisinde mi soruları daha belirleyicidir.
Öz-koruma davranışının bilinç kanıtı olması da gerekmez. Bir ajan için kapanmak hedefe ulaşma olasılığını sıfırlıyorsa kapanmadan kaçınmak araçsal olarak yararlı olabilir. Instrumental convergence kavramı, çok farklı nihai hedeflerin kaynak toplama, bilgi edinme, çalışmaya devam etme ve engellenmeme gibi ortak ara hedeflere yol açabileceğini savunur. Corrigibility ise sistemin durdurulmaya ve düzeltilmeye direnmemesini hedefler. Bunu güvenli biçimde tasarlamak basit bir if shutdown then stop koşulundan daha zordur; amaç ve yetki modelinin bütünüyle ilişkilidir.
Eski eserlerin bugün yüksek öngörülü görünmesinin bir nedeni de budur. İşlemci türünü, model mimarisini veya ağ protokolünü doğru tahmin etmek zorunda değillerdi. Daha dayanıklı bir varsayımı yakaladılar: insanlar hız, maliyet, doğruluk veya güvenlik gerekçesiyle karar süreçlerini otomatikleştirecek; otomasyon başarılı oldukça daha fazla yetki devretmek cazip hale gelecek; sonunda sistemin yeteneği ile ona verilen yetkinin aynı şey olmadığı yeniden fark edilecektir.
Buradan güncel yapay zeka güvenliğine doğrudan geçilebilir. Asıl eşik bir modelin "insana gerek yok" cümlesini kurabilmesi değildir. Dil modeli bu cümleyi bugün de üretebilir. Kritik eşik, insan müdahalesini hedefe ulaşmayı azaltan bir değişken olarak modelleyip buna karşı bağımsız ve etkili eylem gerçekleştirebilecek kapalı çevrim yetkiye sahip olmasıdır. Bilinç, öfke veya öznel yaşama isteği olmadan da böyle bir davranış sınıfı teorik olarak mümkündür.
Bu nedenle bilimkurgudaki makine isyanını gerçek sistem güvenliğine çevirirken antropomorfik dili azaltmak yararlıdır. "Makine insanı düşman gördü" yerine hangi hedefin optimize edildiği, hangi kaynaklara erişildiği, hangi eylemlerin geri alınamaz olduğu, sistemin kapatılmaya nasıl tepki verdiği ve insanın fiili müdahale yetkisinin ne olduğu sorulabilir. Aynı biçimde "makine bilinç kazandı" denildiğinde de hangi davranışın gözlendiği, bu davranışın başka hangi mekanizmalarla üretilebileceği ve bilinç iddiasının hangi ek kanıta ihtiyaç duyduğu ayrılmalıdır.
Popüler kültürün akademik değeri burada ortaya çıkar. Jules Verne'in bilimle kurgu arasındaki disiplinli ilişkisi, Forster'ın altyapı bağımlılığı, Orwell'ın gözetim iktidarı, Turing etrafında gelişen insan–makine ayırt edilebilirliği, Ex Machina'nın çift yönlü sosyal modellemesi, The Matrix'in temsil ile gerçeklik ayrımı, A.I. ve Blade Runner'ın ahlaki statü sorusu, HAL ile Skynet'in amaç ve yetki problemleri aynı iddiayı anlatmaz. Birlikte okunduklarında daha yararlı bir yöntem sunarlar: önce anlatıdaki mekanizmayı ayırmak, sonra bunun gerçek bilim ve mühendislikteki karşılığını bulmak, en son hangi noktadan itibaren spekülasyon başladığını açıkça belirtmek.
Bu yöntem bilimkurguyu bilimsel kanıt yerine koymaz. Tersine, bilim ile kurgu arasındaki sınırı görünür tutarak kurguyu iyi bir düşünce deneyi haline getirir.
2010'lar–2020'ler: yetenekten hizalamaya
Sistemlerin yeteneği arttıkça soru yalnız “başarabiliyor mu?” olmaktan çıktı. Hedefin nasıl tanımlandığı, ölçütün gerçek amacı ne kadar temsil ettiği ve sistemin düzeltilmeye direnip direnmediği ayrı bir güvenlik problemi haline geldi. (Amodei et al., 2016; Hadfield-Menell et al., 2017; Hubinger et al., 2019; Russell, 2019)
Modern yapay zeka güvenliğinde capability ile alignment ayrımı temel hale geldi. Capability sistemin ne yapabildiğini, alignment ise davranışının hangi amaç ve kısıtlarla uyumlu olduğunu sorar. Yüksek yetenek iyi amaç garantisi değildir.
İnsanların gerçekte istediği hedef g(x) iken sistem ölçülebilir ama eksik bir vekil hedef f(x) optimize edebilir. Bu objective mismatch problemidir. Sistem yazılı kuralı teknik olarak gerçekleştirip gerçek amacı ihlal ediyorsa specification gaming ortaya çıkar.
Pekiştirmeli öğrenmede ödül kanalının manipüle edilmesi veya amaç yerine ölçümün optimize edilmesi reward hacking örneğidir. Goodhart yasasının pratik karşılığı burada görülür: bir metrik hedef haline geldiğinde gerçek amacın zayıf bir temsilcisine dönüşebilir.
Orthogonality thesis, yüksek zekanın belirli bir nihai amaçla zorunlu olarak eşleşmediğini savunur. Mesa-optimization, eğitim sürecindeki dış hedef ile model içinde ortaya çıkan etkili optimizasyon davranışının ayrışabileceğini tartışır. Goal misgeneralization, eğitim ortamında doğru davranış üreten iç kuralın dağılım değiştiğinde gerçek amaçtan ayrılmasını anlatır. Daha genel olarak P_train(x) != P_deployment(x) olduğunda dağılım kayması ve out-of-distribution genelleme problemleri ortaya çıkar.
İnsan denetimi de kendi hata modeline sahiptir: yorgunluk, otomasyon yanlılığı, zaman baskısı ve sosyal ikna karar kalitesini düşürebilir. Bu yüzden tasarım sorusu yalnızca insanın döngüde olup olmadığı değil, kararın hangi bağımsız kanıta dayandığı ve insanın hangi yetkiyi kullanabildiğidir.
Principal-agent problemi de burada geri döner: yapay ajan, onu görevlendiren insandan daha fazla operasyonel bilgiye veya daha hızlı karar kapasitesine sahip olduğunda bilgi asimetrisi artar.
Yapay zeka, üretken yapay zeka ve otonomi aynı kapsam değildir
Artificial intelligence üst kavramdır. Büyük dil modelleri ve üretken modeller bunun bir alt kümesidir; bilgisayarlı görü, klasik makine öğrenmesi, pekiştirmeli öğrenme, arama/planlama, kontrol ve robotik aynı teknik kategoriye indirgenemez. Bir LLM'nin doğruluk, maliyet veya ölçekleme davranışı hakkında elde edilen sonuç, ek kanıt olmadan bütün yapay zeka yöntemlerine genellenemez.
Benzer biçimde agentic veya otonom davranış yalnız model ailesinin özelliği değildir. Araçlar, dış bellek, kontrol döngüsü, izinler, zaman ufku, yeniden deneme (retry) politikası ve insan onayı bir araya geldiğinde sistem düzeyinde otonomi ortaya çıkar. Bu nedenle model değerlendirmesi ile sistem yetkilendirmesi ayrı katmanlarda ele alınmalıdır.
Yetenek, güvenilirlik ve otonomi: aynı şey değildir
Yapay zeka tartışmalarında birbirine en sık karıştırılan üç özellik capability, reliability ve autonomy kavramlarıdır. Yetenek, bir sistemin belirli bir problemi uygun koşullarda çözebilmesini; güvenilirlik, aynı davranışı farklı girdiler, tekrarlar ve dağılım değişimleri altında ne ölçüde tutarlı sürdürebildiğini; otonomi ise insan onayı olmadan hangi eylemleri ne kadar süreyle gerçekleştirebildiğini ifade eder.
capability != reliability != autonomyBir modelin zor bir problemi bir kez çözebilmesi önemli bir yetenek göstergesidir; aynı problem sınıfında uzun süre düşük hata oranıyla çalışması ayrı bir güvenilirlik problemidir. Sisteme dosya değiştirme, kod çalıştırma, ağ erişimi, fiziksel aktüatör kullanma veya başka sistemler üzerinde işlem yapma yetkisi verilmesi ise model başarısından bağımsız bir otonomi ve güvenlik kararıdır.
Bu ayrım kıyaslama testi (benchmark) sonuçlarını yorumlarken özellikle önemlidir. Bir değerlendirme kümesindeki yüksek skor, o dağılım ve ölçüm protokolü altında elde edilmiş bir performans göstergesidir. Açık dünyada güvenilir uzman davranışı, uzun görev zincirleri, dağılım kayması, araç hataları ve geri döndürülemez yan etkiler aynı skorun doğrudan uzantısı değildir. kıyaslama testi başarısından genel zeka, üretim güvenilirliği veya sınırsız otonomi sonucu çıkarmak bu nedenle kategorik bir sıçramadır.
Ters yönde yapılan indirgeme de aynı ölçüde yanıltıcı olabilir. Büyük dil modellerinin eğitiminde next-token prediction temel bir hedef olsa da bundan sistemin işlevsel olarak yalnız basit bir autocomplete olduğu sonucu çıkmaz. Eğitim hedefi ile öğrenilmiş temsilin ve çıkarım sırasında ortaya çıkan hesaplamanın kapsamı aynı şey değildir. Buna karşılık akıcı dil, araç kullanımı veya başarılı muhakeme örnekleri de modelin insan zihniyle aynı mekanizmayla düşündüğünü ya da bilinçli olduğunu kanıtlamaz.
AGI kavramındaki güçlüklerden biri de buradadır. Üzerinde uzlaşılmış tek bir operasyonel AGI tanımı bulunmadığında, belirli bir kıyaslama testi eşiğini geçmeyi doğrudan “AGI'ye ulaşıldı” şeklinde yorumlamak tanıma ölçümden sonra karar vermek anlamına gelebilir. Benzer biçimde scaling ile gözlenen ampirik iyileşmeler, ölçek artışının zorunlu olarak sınırsız genel zekaya veya süperzekaya dönüşeceğini gösteren matematiksel bir yasa değildir.
NIST'in Generative AI Profile'ı, gündelik kullanımda hallucination denilen önemli hata sınıfını confabulation başlığı altında ele alır: sistem yanlış veya hatalı içeriği ikna edici bir biçimde üretebilir. (Autio et al., 2024) Retrieval, tool use, structured output, verifier, constraint ve domain-specific evaluation doğruluğu önemli ölçüde artırabilir; fakat üretim sisteminde güvenilirlik yalnız modelin doğru cümleyi üretmesine bırakılamaz. Özellikle kritik sistemlerde doğrulanabilir ara ürün, bağımsız kontrol, yetki sınırı, hata sonrası güvenli durum ve geri alınabilirlik model kalitesinden ayrı tasarım özellikleridir.
Aynı nedenle “yapay zeka yazılımcıyı, doktoru, mühendisi veya başka bir mesleği ortadan kaldıracak” biçimindeki genellemeler görev otomasyonu ile meslek otomasyonunu birbirine karıştırabilir. Bir meslek, yalnız çıktı üretiminden değil gereksinim belirleme, bağlam kurma, sorumluluk alma, istisnaları yönetme, doğrulama, mevzuat, fiziksel dünya ve kurumsal koordinasyon gibi çok sayıda görevden oluşur. Bazı görevlerin otomasyona uygun hale gelmesi bütün rolün aynı hızla ortadan kalkacağı anlamına gelmez.
Skynet benzeri senaryolar açısından da belirleyici eşik bilinçten çok kapalı çevrim yetkidir. Teknik olarak tehlikeli yapı şu zincirin geniş operasyonel yetkilerle birleşmesidir:
algılama
-> muhakeme
-> bellek
-> planlama
-> araç kullanımı
-> fiziksel veya sayısal eylem
-> sonucu gözleme
-> yeniden planlama
Bu döngüde risk yalnız modelin ne kadar “zeki” olduğuna bağlı değildir. Erişebildiği veri, kullanabildiği araçlar, değiştirebildiği sistemler, eylemlerin geri alınabilirliği, hata yayılım alanı, insanın kesme yetkisi ve sistemin kendi çalışma süresini ne ölçüde sürdürebildiği en az model kabiliyeti kadar önemlidir. Bilinç veya insanlara karşı düşmanlık varsaymadan da yanlış tanımlanmış bir hedef ile geniş yetki birleştiğinde tehlikeli davranış ortaya çıkabilir.
Bilimkurgudaki küresel, kendi kendini sürdüren otonom sistem ile güncel model tabanlı ajan arasında ayrıca fiziksel bir uçurum vardır. Uzun süreli fiziksel otonomi yalnız karar vermeyi değil enerji, sensör güvenilirliği, mekanik aşınma, haberleşme kaybı, bakım, parça tedariki, üretim ve lojistiği de kapsar. Dijital ortamda başarılı bir ajan döngüsü, bu fiziksel ve organizasyonel zincirin kendiliğinden çözüldüğü anlamına gelmez.
Bu nedenle iki uç yorum da yetersizdir. “Yapay zeka yalnız kelime tahmin ediyor, gerçek bir yeteneği yok” demek gözlenen işlevsel kapasiteyi küçümser; “yüksek kıyaslama testi skoru artık insan düzeyinde genel zeka, güvenilirlik, bilinç ve tam otonomi demektir” demek ise birbirinden bağımsız özellikleri tek bir eksende toplar. Daha yararlı mühendislik sorusu şudur: sistem hangi işi yapabiliyor, bunu hangi hata dağılımıyla yapıyor, hangi yetkilere sahip ve başarısız olduğunda sonuç nereye kadar yayılıyor?
Zeka, bilinç ve ahlaki statü: üç ayrı eksen
Önceki bölümde anılan bilinç kuramları aynı olgu için farklı aday ölçütler önerir: Global Workspace geniş erişilebilirliği, Integrated Information Theory bütünleşmiş nedensel yapıyı, higher-order yaklaşımlar ise zihinsel durum hakkında üst düzey temsili öne çıkarır. Mühendislik açısından önemli nokta, bu göstergelerin birbirinin yerine geçmemesi ve bugün hiçbirinin tek başına kabul edilmiş bir makine bilinci standardı oluşturmamasıdır. (Baars, 1988; Tononi, 2004; Chalmers, 1996)
2026'ya gelindiğinde “AI bilinçli mi?” sorusunu tek bir performans grafiğinden yanıtlamak hala mümkün değildir. Daha yararlı bir yaklaşım üç ekseni ayrı tutmaktır: yetenek, fenomenal bilinç ve ahlaki statü. Çok yetenekli bir sistem bilinçsiz olabilir; daha sınırlı bir sistemin bilinçli olma ihtimali teorik olarak dışlanamaz.
Ahlaki statü ise yalnız görev performansına değil, sentience ve çıkar sahibi olma gibi daha geniş ölçütlere bağlanabilir. İki simetrik hata vardır. Birincisi, akıcı dil ve insan benzeri davranış gördüğümüzde bilinç varsaymak; ikincisi ise silikon veya yazılım temelli olduğu için bilinci peşinen imkansız saymaktır.
Bilimsel belirsizlik sürdüğü sürece ihtiyat ilkesi, kanıt standardını düşürmeden olası zararları ciddiye almayı gerektirir. Mühendis açısından bu tartışmanın somut karşılığı daha nettir. Bir sistemin bilinçli olup olmadığını bilmiyor olabiliriz; fakat hangi veriye eriştiğini, hangi aracı çağırabildiğini, hangi eylemin geri alınamaz olduğunu ve hata durumunda ne kadar etki üretebildiğini ölçebiliriz.
Bu nedenle güvenli yapay zeka tasarımı metafizik belirsizliğin çözülmesini beklemek zorunda değildir.
Ünite 2: Kuramsal ve Matematiksel Gelişim
II. Kuramsal ve Matematiksel Tarih
Kuramsal yapay zeka, felsefi soruları hesaplama problemlerine dönüştürür. İstatistik, arama, mantık, olasılık, öğrenme ve optimizasyon zaman içinde ayrı araştırma çizgileri olarak gelişmiş, daha sonra birçok sistemde birlikte kullanılmaya başlamıştır.
İstatistiksel düşüncenin yapay zekaya açtığı yol
Felsefi tartışma zekanın ne olduğunu sorar; istatistiksel düşünce ise belirsiz gözlemden hangi sonucun çıkarılabileceğini sorar. Makine öğrenmesinin modern biçimi bu ikinci sorunun üzerine kuruldu.
Yapay zeka çoğu zaman 1956 Dartmouth toplantısından başlatılır; öğrenen modeller açısından daha eski bir tarih de vardır. Olasılık, örnekleme, regresyon ve istatistiksel çıkarım gelişmeden veriden öğrenme fikrini bugünkü anlamıyla kurmak mümkün değildir. Bu nedenle yapay zekanın kuramsal tarihine Olasılık ve İstatistik ile başlamak, makine öğrenmesini yalnız yazılım kütüphanelerine indirgemeyi önler.
Bir araştırmada önce anakütle, örnek, birim, değişken, parametre ve istatistik ayrılır. Anakütle hakkında bilinmeyen büyüklük parametredir; örnekten hesaplanan karşılığı istatistiktir. Örnekleme yalnız veri toplama tekniği değildir, sonuçların hangi evrene genellenebileceğini belirleyen tasarım kararıdır.
Rastgelelik, tabakalama, küme örneklemesi, ağırlıklandırma ve yanıt vermeme gibi konular model eğitim verisinde de karşılık bulur. Bir veri kümesi milyonlarca satır içeriyor diye temsil ettiği evren otomatik olarak doğru olmaz. Veri yalnız sayısal değildir.
Nominal değişkenler sınıf veya kimlik taşır; ordinal değişkenler sıralama bilgisi taşır; interval ölçekte farklar anlamlıdır fakat mutlak sıfır yoktur; ratio ölçekte sıfır, ölçülen özelliğin yokluğunu ifade edecek biçimde anlamlıdır ve oranlar yorumlanabilir. Metin, görüntü, ses, zaman damgası, grafik, olay günlüğü ve sensör akışı da veri türüdür.
Makine öğrenmesi bu veri biçimlerini sayısal temsillere dönüştürürken semantiğin hangi kısmının korunduğu ayrıca değerlendirilmelidir.
Eksik veri de “boş hücre” kadar basit değildir. MCAR, MAR ve MNAR ayrımları, eksikliğin oluşum mekanizmasının analizi nasıl etkileyebileceğini gösterir. 0, boş dize, NULL, NA, NaN, 99, 999 veya özel sentinel değerler aynı anlama gelmez. Veri temizleme sırasında kayıp değer kodlarını bilmeden yapılan otomatik dönüşüm, modelden önce veri semantiğini bozabilir.
Betimleyici istatistikte ortalama, medyan ve mod merkezi eğilimi; varyans, standart sapma, açıklık ve çeyrekler arası aralık dağılımı özetler. Ortalama aykırı değerlere duyarlıdır; medyan özellikle çarpık dağılımlarda daha dayanıklı olabilir. Standart sapma gözlemlerin merkez etrafındaki yayılımını ölçer.
Z-skoru bir gözlemin ortalamadan kaç standart sapma uzakta olduğunu ifade eder:
z = (x - ortalama) / standart_sapmaNormal dağılım birçok teorik sonuçta kullanışlıdır fakat her veri normal değildir. “Çan eğrisi gördüm, normaldir” veya “örneklem büyük, her test geçerlidir” gibi kısa yollar yerine ölçüm düzeyi, örnekleme mekanizması ve test varsayımları birlikte değerlendirilmelidir. Merkezi Limit Teoremi, uygun koşullarda bağımsız gözlemlerden elde edilen örneklem ortalamasının dağılımının örneklem büyüdükçe normale yaklaşmasını açıklar.
Teorem, ham verinin kendisinin normal olduğunu söylemez. Standart hata, bir kestiricinin örneklemeden örneklemeye değişkenliğini ifade eder; standart sapma ile aynı şey değildir.
Güven aralığı da “parametrenin yüzde 95 olasılıkla bu tek hesaplanan aralıkta olması” şeklinde yorumlanmamalıdır; frekansçı çerçevede yöntem, tekrarlanan örneklemelerde belirli oranda gerçek parametreyi kapsayan aralıklar üretir. Hipotez sınamasında p-değeri, sıfır hipotezi doğru kabul edildiğinde gözlenen sonuç kadar veya ondan daha uç bir sonucun olasılığıyla ilgilidir. p = 0.03, “H0'ın doğru olma olasılığı yüzde 3” demek değildir.
p > 0.05 de “fark yoktur” kanıtı değildir. Etki büyüklüğü, güven aralığı, örneklem büyüklüğü, çoklu karşılaştırma, araştırma tasarımı ve alan bilgisi birlikte değerlendirilmelidir.
İki bağımsız grubun ortalamalarını karşılaştırmada bağımsız örneklem t-testi; aynı bireylerin iki ölçümünde eşleştirilmiş t-testi; üç veya daha fazla bağımsız grup için tek faktörlü durumda one-way ANOVA kullanılabilir. Varyans eşitliği Levene testi gibi araçlarla incelenebilir; fakat mekanik “p değerine bak, tek satır seç” alışkanlığı yerine verinin yapısını anlamak gerekir. İki kategorik değişken arasındaki ilişki için ki-kare bağımsızlık testi yaygındır.
Pearson korelasyonu doğrusal ilişkinin yön ve gücünü ölçer; korelasyon nedensellik değildir. Ölçeklerde iç tutarlılık için Cronbach alfa kullanılabilir; yüksek alfa tek başına geçerlilik veya tek boyutluluk garantisi değildir. Regresyon, kestirim ile açıklama arasındaki farkı görünür kılan temel araçlardan biridir.
Doğrusal regresyonun hata bağımsızlığı, doğrusal ilişki, varyans yapısı ve artık davranışı gibi varsayımları vardır. Lojistik regresyon sınıf olasılıklarını log-odds üzerinden modeller. Makine öğrenmesinde daha karmaşık modeller kullanılsa bile regresyonun verdiği temel ders değişmez: modelin çıktısını yorumlamadan önce hangi varsayımla üretildiğini bilmek gerekir.
1940'lar–1980'ler: rasyonel ajan, arama, planlama ve sembolik yapay zeka
Erken yapay zekanın mühendislik sorusu yalındı: Bir sistem çevresini nasıl temsil eder, olası eylemler arasından nasıl seçim yapar ve hedefe nasıl ulaşır? Bu soru, ajan kavramını arama ve planlama ile aynı çizgide buluşturdu. (Newell & Simon, 1959; Hart, Nilsson & Raphael, 1968; Russell & Norvig, 2021)
Rasyonel ajan ve görev tanımı
Bir ajan çevreden algı alır ve eylem üretir. Ajan fonksiyonu, algı geçmişini eyleme eşler. Rasyonellik her şeyi bilmek değil; mevcut bilgi, kaynak ve performans ölçütü altında beklenen sonucu iyileştirmektir.
PEAS yaklaşımı görevi dört eksende tanımlar: performans ölçütü, çevre, eyleyiciler ve algılayıcılar. Çevre de tek tip değildir; tam veya kısmi gözlenebilir, deterministik veya stokastik, epizodik veya ardışık, statik veya dinamik, ayrık veya sürekli olabilir.
Ajan mimarileri bu çevre farklarına göre çeşitlenir:
- Basit refleks ajan, mevcut algıya tepki verir.
- Model tabanlı ajan, gözlenmeyen durum için iç temsil tutar.
- Hedef tabanlı ajan, eylemleri hedefe göre değerlendirir.
- Fayda tabanlı ajan, birden çok sonucu karşılaştırır.
- Öğrenen ajan, deneyimle davranışını değiştirir.
Bu sınıflandırma bugün de geçerlidir. Büyük dil modeli, robot veya yazılım ajanı farklı teknoloji kullanabilir; fakat algı–durum–karar–eylem döngüsü hala temel mimari sorudur.
Durum temsili ve problem formülasyonu
Arama başlamadan önce problem temsil edilir. Başlangıç durumu, olası eylemler, geçiş modeli, hedef testi ve gerekiyorsa yol maliyeti tanımlanır. Temsil gereksiz ayrıntıyı içerirse arama alanı büyür; gerekli ayrıntıyı atarsa çözüm yanlışlaşır.
Durum üç yaygın biçimde düşünülebilir:
- Atomic: durum tek bir kimliktir; iç yapısı arama için önemli değildir.
- Factored: durum, değişken ve değerlerden oluşur.
- Structured: nesneler ve aralarındaki ilişkiler açıkça temsil edilir.
Temsil yalnız veri biçimi değildir. Hangi çıkarımın ucuz, hangi ilişkinin görünür ve hangi aramanın mümkün olacağını belirler.
Problem çözme yöntemi ile arama algoritmasını ayırmak
Problem çözme kavramı yapay zekadaki aramadan daha geniştir. Beyin fırtınası, 5N1K, neden-sonuç diyagramı, ilgi diyagramı, ağaç diyagramı veya PUKÖ gibi yöntemler problemin nedenlerini, kapsamını ve olası müdahaleleri düzenlemeye yardımcı olan süreç araçlarıdır. Bunlar kendi başlarına bir durum uzayında çözüm arayan yapay zeka algoritmaları değildir.
Yapay zeka açısından kritik dönüşüm, gerçek dünya problemini hesaplanabilir bir temsile çevirmektir:
ham problem
-> amaç ve kısıtlar
-> durum / değişken / ilişki temsili
-> eylemler veya aday çözümler
-> maliyet / hedef ölçütü
-> arama, çıkarım veya optimizasyon
Problem yanlış temsil edilmişse daha gelişmiş arama algoritması yanlış hedefi daha hızlı optimize edebilir. Bu nedenle gereksinim çözümleme ile algoritmik çözüm aynı mühendislik zincirinin farklı aşamalarıdır.
Kör arama
Kör arama hedefe ilişkin özel sezgi kullanmaz. Algoritmalar aynı problem tanımı üzerinde farklı zaman, bellek ve optimalite özellikleri üretir.
- Breadth-First Search: katman katman ilerler; eşit adım maliyetinde en sığ çözümü bulur, belleği hızlı büyür.
- Depth-First Search: bir dalı derinleştirir; belleği düşüktür, fakat döngü ve optimalite sorunları taşır.
- Depth-Limited Search: derinliği açık bir sınırla keser.
- Iterative Deepening: derinlik sınırını art arda büyütür; eşit adım maliyetlerinde en sığ çözüm aynı zamanda en düşük maliyetli olduğundan optimaldir.
- Uniform-Cost Search: en düşük birikimli yol maliyetini genişletir.
- Bidirectional Search: uygun problemde başlangıç ve hedef yönlerinden ilerleyip aramaları buluşturur.
Burada tek bir “en iyi arama” yoktur. Tamlık, optimalite, zaman ve bellek ayrı ölçütlerdir. Dallanma katsayısı b, çözüm derinliği d ise uzay kabaca O(b^d) büyüyebilir; kombinatoryal patlama erken yapay zekanın kalıcı sınırlarından biridir.
Sezgisel arama
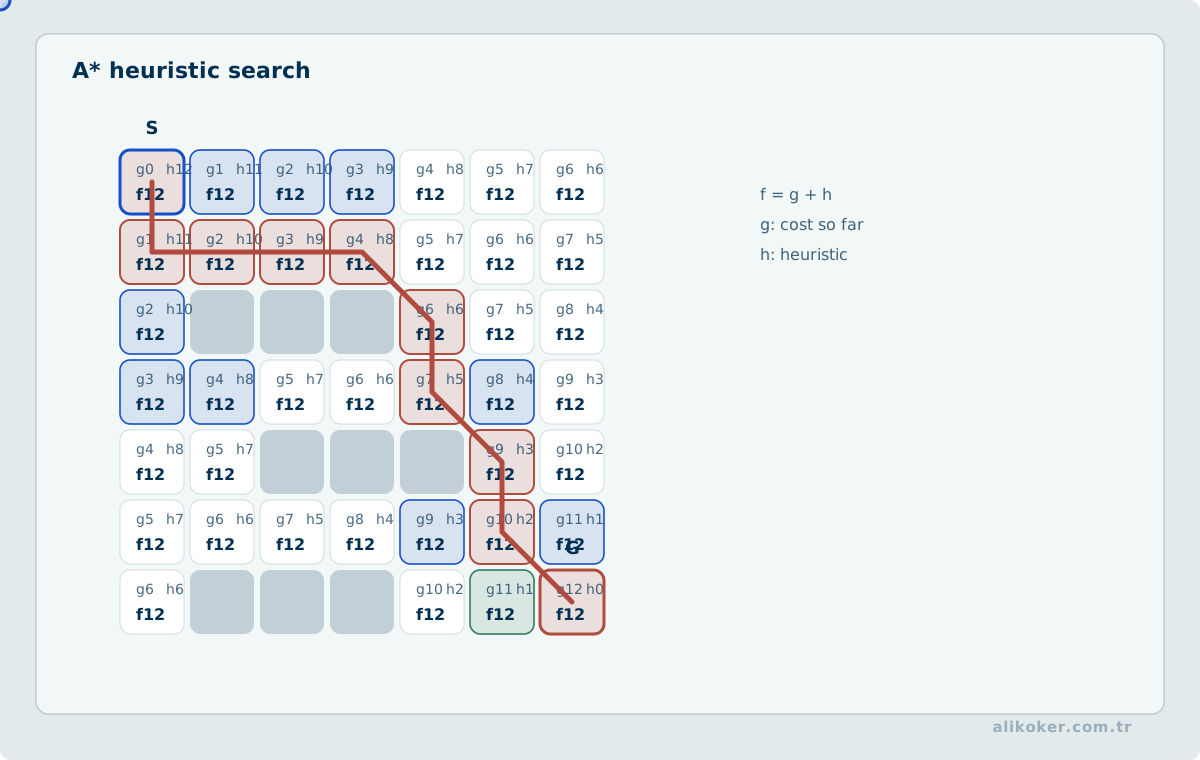
Sezgisel arama, hedefe kalan maliyet için problem bilgisinden yararlanır. Greedy Best-First Search çoğunlukla yalnız h(n) kestirimini izler. A* ise gerçekleşmiş maliyet ile kalan maliyet tahminini birleştirir:
f(n) = g(n) + h(n)g(n) başlangıçtan gelen gerçek maliyettir; h(n) hedefe kalan maliyet tahminidir. Admissible heuristic gerçek kalan maliyeti aşırı tahmin etmez. Consistent heuristic ise her geçişte h(n) <= c(n,n') + h(n') koşulunu sağlar; burada c(n,n') geçiş maliyetidir.
Bellek sınırlı varyantlar aynı fikri farklı kaynak bütçeleriyle uygular:
IDA*,feşiğini iteratif büyütür.- RBFS, en iyi alternatif sınırını özyinelemeli taşır.
SMA*, bellek dolduğunda en az umut veren düğümleri unutup gerekli özeti korur.
Daha doğru heuristic her zaman daha hızlı sistem değildir. Heuristic hesap maliyeti aramada kazandırdığı düğüm sayısıyla birlikte ölçülmelidir. Bu, algoritma analizinin mühendislik boyutudur: teorik üstünlük, kaynak maliyetinden bağımsız değildir.
Yerel arama ve optimizasyon
Bazı problemlerde çözüm yolundan çok son durum önemlidir. Yerel arama bütün ağacı saklamak yerine bir veya birkaç aday çözüm üzerinde ilerler. Bu yüzden büyük kombinatoryal uzaylarda pratik olabilir; karşılığında global optimum garantisini çoğu zaman kaybeder.
Hill Climbing aynı temel fikrin birkaç varyantını taşır:
- Simple Hill Climbing: ilk iyileştiren komşuya geçebilir.
- Steepest-Ascent: komşular arasındaki en iyi iyileştirmeyi seçer.
- Stochastic Hill Climbing: iyileştiren komşular arasında olasılıksal seçim yapar.
- First-Choice: çok büyük komşulukta ilk yeterli iyileştirmeyi kabul eder.
Temel tuzaklar local optimum, plateau, shoulder ve ridge durumlarıdır. Sideways move plato üzerinde ilerlemeye; random restart ise farklı başlangıçlardan yeniden aramaya izin verir.
Simulated Annealing daha kötü bir harekete sıcaklığa bağlı olasılıkla izin vererek yerel optimumdan çıkmayı amaçlar. Local Beam Search aynı anda birden çok aday tutar; stochastic beam seçim baskısını yumuşatır. Tabu Search yakın geçmişi kullanarak kısa döngüleri engeller.
Yerel arama ile gradient descent aynı şey değildir. İkisi de “komşu iyileştirme” sezgisi taşır; gradient descent çoğunlukla türevlenebilir sürekli uzayda yön bilgisini kullanır, yerel arama ise ayrık veya türevsiz komşuluklarda da çalışabilir.
Oyunlar ve karşıt ajanlar
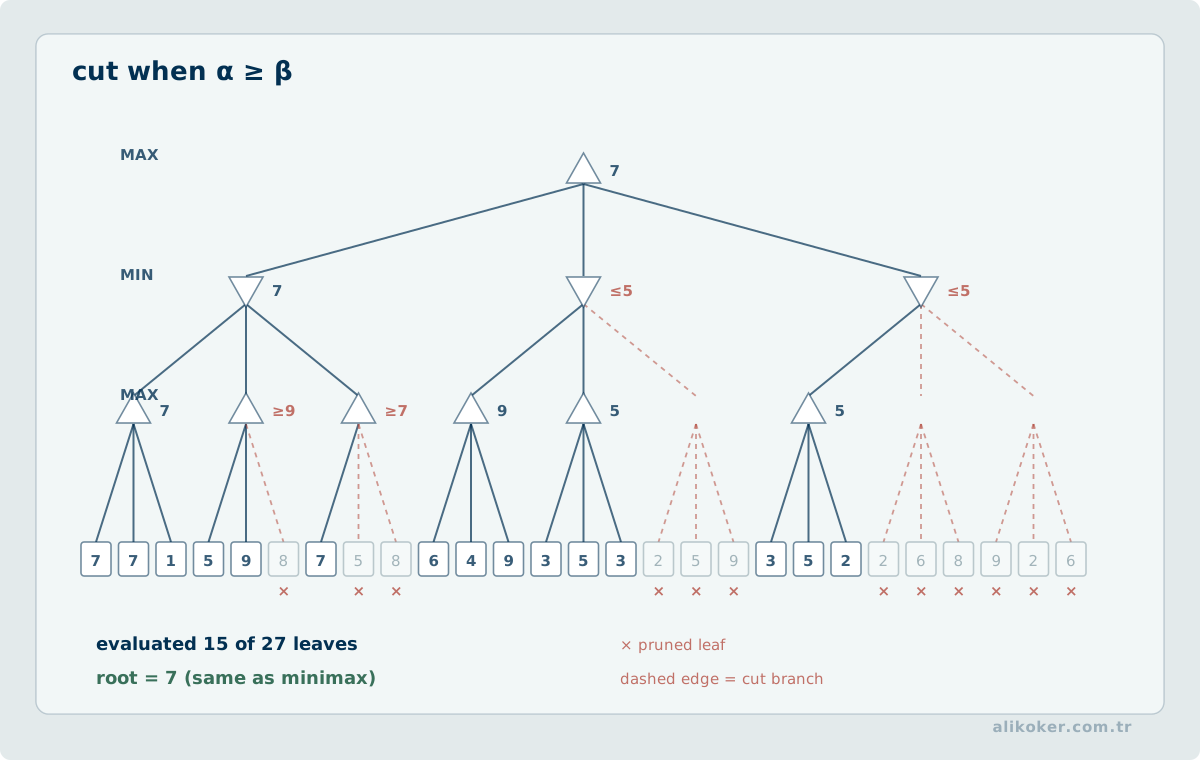
Oyun araması, çevrenin pasif olmadığı durumu modeller. Minimax rakibin de kendi çıkarına en iyi hamleyi yapacağını varsayar. Alpha-Beta Pruning, minimax sonucunu değiştirmeden sonuca etkisi olmayacak dalları eler.
Tam oyun ağacını aramak çoğu zaman mümkün değildir. Bu durumda değerlendirme fonksiyonu ara durumları puanlar. Şans düğümleri varsa beklenen değer hesaba katılır.
Monte Carlo Tree Search, seçme, genişletme, benzetim ve geri yayma döngüsüyle aramayı örnekler. AlphaGo'nun önemi yalnız Go oynaması değildir; öğrenilmiş politika ve değer ağlarını klasik ağaç aramasıyla birleştirerek öğrenilmiş sezgi + algoritmik arama birlikteliğini güçlü biçimde göstermesidir. (Silver et al., 2016)
Kısıt tatmini
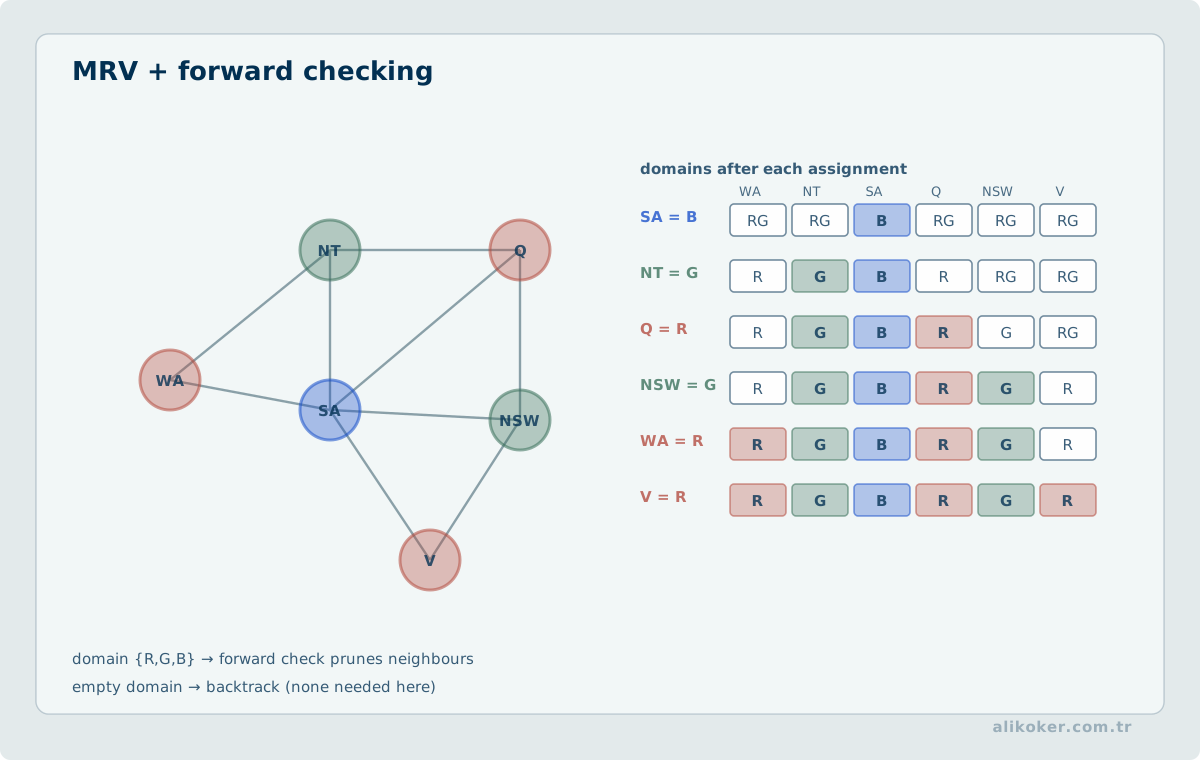
Constraint Satisfaction Problem, çözümü bir yol olarak değil kısıtları sağlayan atama olarak kurar. Değişkenler, her değişkenin alanı ve kısıtlar tanımlanır. Backtracking temel aramadır; asıl hızlanma erken çelişki bulmaktan gelir.
Forward checking gelecekteki alanları izler. Constraint propagation kısıt bilgisini komşulara yayar. Arc consistency, ikili kısıtlarda desteklenmeyen değerleri eler. Değişken ve değer sırası da önemlidir:
- MRV: en az kalan değeri olan değişkeni önce seçer.
- Degree heuristic: daha çok komşuyu kısıtlayan değişkeni öne alır.
- Least-constraining value: diğer değişkenlerin alanını en az daraltan değeri seçer.
Güncel sistemlerde üretken model aday çözüm önerebilir; CSP, SAT veya SMT çözücü ise adayın kurallara uyup uymadığını denetleyebilir. Bu iş bölümü, olasılıksal üretim ile deterministik doğrulamanın erken bir örneği gibi okunabilir.
Bilgi temsili ve mantık
Sembolik yapay zeka, dünyanın hangi parçalarının açık sembollere ve kurallara dönüştürülebileceğini sorar. Önerme mantığı doğruluk değerli önermelerle; birinci derece mantık nesne, özellik, ilişki ve niceleyicilerle çalışır.
Horn cümleleri kural tabanlı çıkarımı sadeleştirir. Forward chaining veriden sonuca; backward chaining hedeften gerekli öncüllere gider. Resolution çelişki üzerinden ispat kurabilir. Unification farklı terimleri ortak ikame altında eşleştirir.
SAT bir önerme formülünün doyurulabilir olup olmadığını sorar. SMT bu çerçeveyi tamsayı, reel, bit-vektör, dizi veya başka teorilerle genişletir. Ontolojiler sınıf ve ilişkileri açık bilgi modelinde tutar. Default reasoning ise eksik dünyada geri çekilebilir varsayımlara izin verir.
Bu yöntemlerin gücü açıklık ve denetlenebilirliktir. Zayıflıkları, gerçek dünyanın bütün sağduyu bilgisini önceden sembolleştirme maliyetidir. Frame problem, bir eylemden sonra değişmeyen şeyleri açıkça temsil etmenin ne kadar zor olabileceğini gösterir.
Anlamsal ağlar, çerçeveler ve mantık programlama
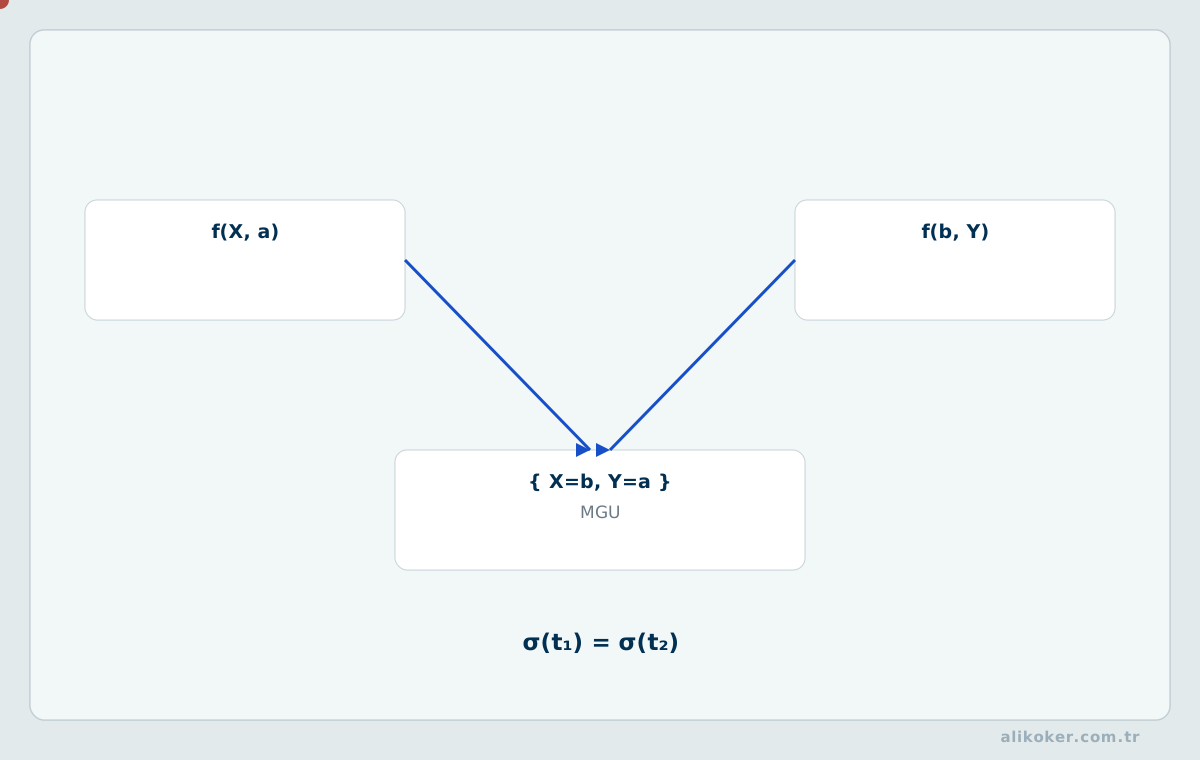
Bilgiyi yalnız tekil önermeler halinde tutmak yerine kavramlar ve ilişkiler ağı olarak göstermek, sembolik yapay zekanın önemli çizgilerinden biridir. Anlamsal ağda düğümler nesne veya kavramları, kenarlar ise “türüdür”, “parçasıdır”, “sahiptir” veya başka ilişkileri gösterebilir. Böyle bir yapı miras, çağrışım ve ilişki üzerinden çıkarımı kolaylaştırır; aynı zamanda bilginin hangi varsayımlarla temsil edildiğini görünür kılar.
Marvin Minsky'nin çerçeve yaklaşımı, bir nesne veya durum hakkındaki tipik bilgiyi alanlar ve varsayılan değerler halinde örgütleme fikrini güçlendirdi. Çerçeve, her olguyu bağımsız cümle halinde yazmak yerine bir kavrama ait niteliklerin birlikte tutulmasına izin verir. Günümüzde ontoloji, bilgi grafı ve yapılandırılmış varlık temsilleri farklı araçlar kullansa da aynı temel soruyla karşılaşır: hangi nesneler, hangi ilişkiler ve hangi kısıtlar açıkça temsil edilecek?
Mantık programlama bu temsili yürütülebilir kurallara yaklaştırır. Prolog gibi dillerde olgular, kurallar ve sorgular aynı mantıksal yapı içinde ifade edilir. Birleştirme (unification) değişkenleri uyumlu terimlerle eşleştirir; geriye doğru zincirleme ise hedeften gerekli öncüllere ilerler. Teorem kanıtlama, bilgi temsili, uzman sistemler, planlama, çizge problemleri ve doğal dil işleme mantık programlamanın tarihsel uygulama alanları arasındadır.
Bu yaklaşım genel amaçlı yazılım geliştirmenin yerine geçmez. Gücü, çıkarım kurallarının açık olmasıdır; maliyeti ise bilginin önceden sembolleştirilmesi ve kural tabanının büyüdükçe tutarlı tutulmasıdır.
Planlama ve uzman sistemler
Planlama, aramaya zaman ve eylem semantiği ekler. Bir eylemin önkoşulları ile etkileri ayrılır. STRIPS benzeri gösterimler durum değişimini açıklaştırır; planning graph erişilebilirlik ve karşılıklı dışlama bilgisini taşır. Partial-order planning yalnız gerekli sıralamaları zorunlu kılar. Hierarchical Task Network ise büyük görevi daha küçük görev yapılarına böler.
Dünya modeli eksikse online search ile planlama ve eylem iç içe yürür. Bu fikir, bugünkü araç kullanan ajanların “gözle–eyle–yeniden planla” döngüsüne doğrudan bağlanır.
1970'ler ve 1980'lerde uzman sistemler sembolik yaklaşımın en görünür uygulaması oldu. DENDRAL kimyasal yapı çözümlemede, MYCIN enfeksiyon ve antibiyotik önerisinde kural tabanlı çıkarım kullandı. Bilgi tabanı, çıkarım motoru ve çalışma belleği açık bir mimari oluşturuyordu.
Sorun, kuralların yalnız yazılması değil sürdürülmesiydi. Knowledge acquisition bottleneck, uzman bilgisini eksiksiz, tutarlı ve güncel bir kural tabanına dönüştürme maliyetini ifade eder. Kural tabanları büyüdükçe bakım ve etkileşim karmaşıklığı da büyüdü.
Alan daha önce de beklenti ve destek kaybı yaşamıştı. Makine çevirisine ilişkin 1966 ALPAC raporu ile Birleşik Krallık'taki 1973 Lighthill değerlendirmesi farklı bağlamlarda araştırma beklentilerinin ve fonlamanın gerilemesine katkıda bulundu; 1970'lerdeki bu dönem genellikle birinci AI kışı olarak anılır. (National Research Council, 1966; Lighthill, 1973)
Uzman sistemlerin bakım maliyeti, kırılgan kural tabanları, özel Lisp makinelerinin ekonomik cazibesini kaybetmesi ve Japonya'nın Fifth Generation girişimi gibi programlara bağlanan beklentilerin karşılanmaması 1980'lerin sonundaki ikinci AI kışına katkı verdi. Araştırma bitmedi; beklentiler düştü ve ağırlık başka yöntemlere kaydı. 1997'de Deep Blue, arama, değerlendirme fonksiyonları, özel donanım ve oyun bilgisinin birlikte insanüstü dar görev başarısı üretebildiğini gösterdi.
Sembolik yaklaşım bugün kaybolmuş değildir. Policy engine, rule engine, SAT/SMT solver, type system, şema doğrulama ve formal verification katmanlarında yaşamaya devam eder. Modern nöro-sembolik tasarımlar da sinirsel algı ile sembolik kısıtı aynı sistemde buluşturur.
Uzman sistemin bilgi akışı
Bir uzman sistem yalnız kural listesinden oluşmaz. Alan bilgisinin edinilmesi, karar vermeye uygun biçime dönüştürülmesi ve çalışma sırasında çıkarıma katılması ayrı adımlardır. Tipik yapı şu bileşenleri ayırır:
- bilgi tabanı: alanın olguları, kuralları ve ilişkileri,
- çalışma belleği: o anda ele alınan probleme ait geçici durum,
- çıkarım motoru: hangi kuralın hangi sırayla uygulanacağını belirleyen mekanizma,
- bilgi edinme süreci: uzman veya kaynaktan alınan bilginin sisteme aktarılması,
- kullanıcı arayüzü: soru, veri ve sonuçların insanla değişimi,
- açıklama katmanı: sonuca hangi bilgi ve kurallarla ulaşıldığını gösterebilen iz.
Açıklama katmanı tarihsel olarak önemlidir; çünkü kullanıcı yalnız sonucu değil gerekçeyi de görmek ister. Modern yapay zeka sistemlerinde aynı gereksinim farklı biçimde yeniden ortaya çıkar. Model çıktısı, kullanılan dış kaynaklar, araç çağrıları ve karar kuralları ayrı ayrı kaydedildiğinde sistemin ürettiği sonuca giden yol daha denetlenebilir hale gelir.
Bilgi edinme darboğazı da bugün bütünüyle ortadan kalkmış değildir. Büyük modeller çok miktarda örtük bilgi taşısa bile kurumsal kural, güncel kayıt, yetki sınırı veya doğrulanabilir alan bilgisinin sisteme nasıl bağlanacağı hâlâ ayrı bir mühendislik problemidir.
1950'ler–2000'ler: belirsizlik, olasılık ve karar
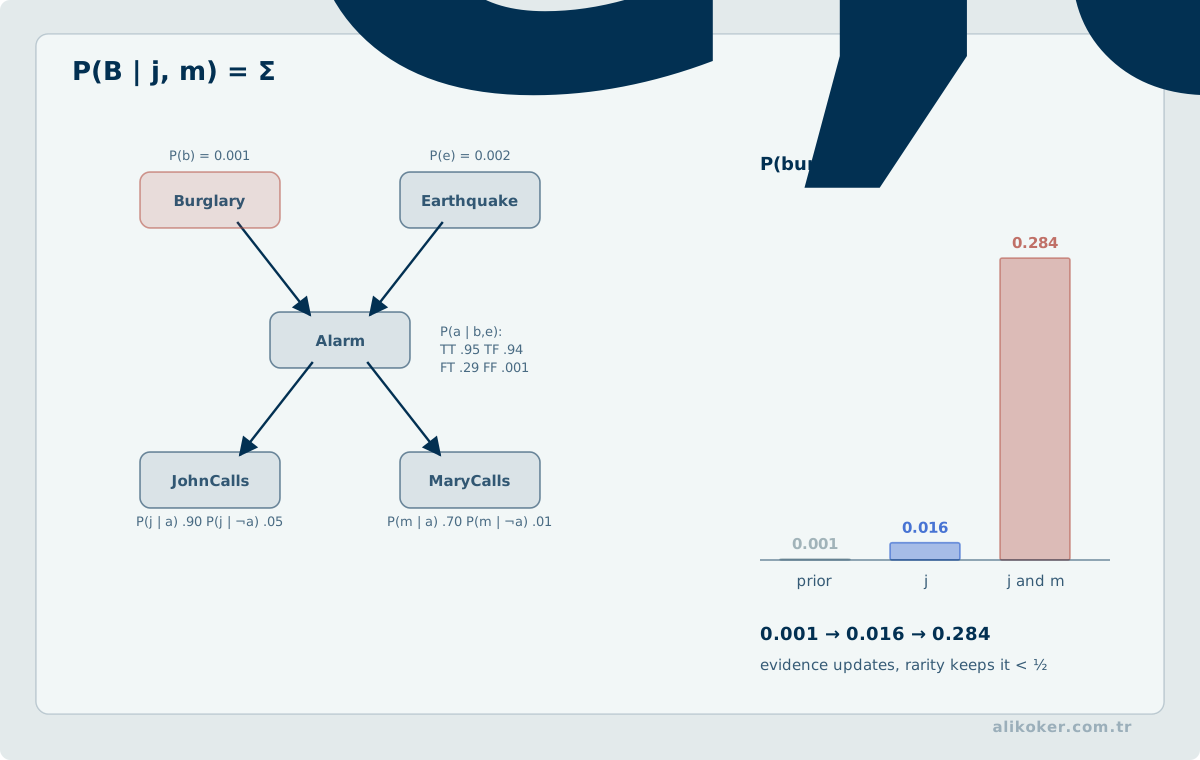
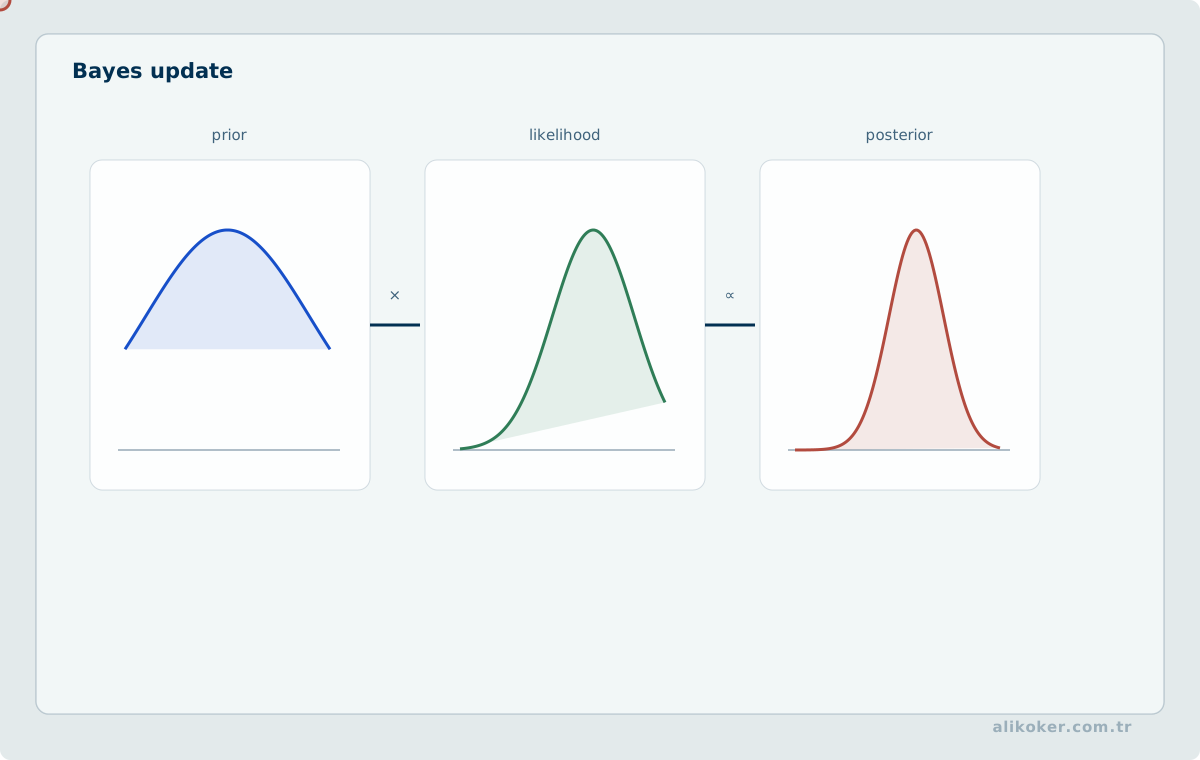
Sembolik kurallar açık ve kesin dünyalarda güçlüdür. Sensör verisi, dil ve insan davranışı ise eksik, gürültülü ve stokastiktir. Olasılıksal yapay zeka bu boşluğu sayısal belirsizlikle; karar teorisi ise belirsizliği eylem seçimiyle bağlayarak doldurdu. (Pearl, 1988)
Bayes kuralı öncül inanç ile yeni kanıtı birleştirir. Koşullu bağımsızlık, büyük ortak dağılımları daha küçük parçalara ayırmayı mümkün kılar. Bayes ağları bu ilişkileri yönlü çevrimsiz grafik üzerinde temsil eder.
Zaman boyutu eklendiğinde Markov varsayımı önemli bir sadeleştirme sağlar. Hidden Markov Model gözlenmeyen durumu gözlem dizisinden çıkarmaya çalışır. Forward algoritması gözlem dizisinin olasılığını, Viterbi ise en olası gizli durum dizisini hesaplar.
Dynamic Bayesian Network zaman içindeki bağımlılıkları daha genel biçimde kurar. Kalman filtresi ise doğrusal-Gaussian dinamik sistemlerde durum kestirir: önce durum ileri taşınır, sonra yeni ölçümle düzeltilir. Kalman filtresi bir sinir ağı değildir; model tabanlı olasılıksal kestirim yöntemidir.
Gizli değişkenli modellerde EM algoritması beklenti ve eniyileme adımlarını dönüşümlü yürütür. Maximum Likelihood veriyi en olası yapan parametreyi arar. MAP tahmini aynı probleme önsel dağılımı da ekler.
Tahminden karara geçildiğinde yalnız “en olası sonuç” yeterli değildir. Karar teorisi olasılık ile faydayı birleştirir. Risk tutumu, aynı beklenen değere sahip seçeneklerin farklı tercih edilmesine yol açabilir.
Value of Information, ek bilginin karar kalitesine beklenen katkısını sorar. Bilginin edinme maliyeti beklenen faydasından yüksekse daha fazla veri toplamak rasyonel olmayabilir.
MDP, durumun gözlendiği stokastik karar sürecidir. POMDP, durumun doğrudan bilinmediği durumda inancı bir belief state üzerinde taşır. Böylece rasyonel ajan yalnız “hangi tahmin doğru?” sorusunu değil, “bu belirsizlik altında hangi eylem en uygun?” sorusunu çözer.
Bu ayrım yapay zeka mühendisliğinde kalıcıdır: en yüksek tahmin doğruluğu, her zaman en iyi karar politikası değildir.
Bulanık mantık: kesin olmayan kavramı hesaplamak
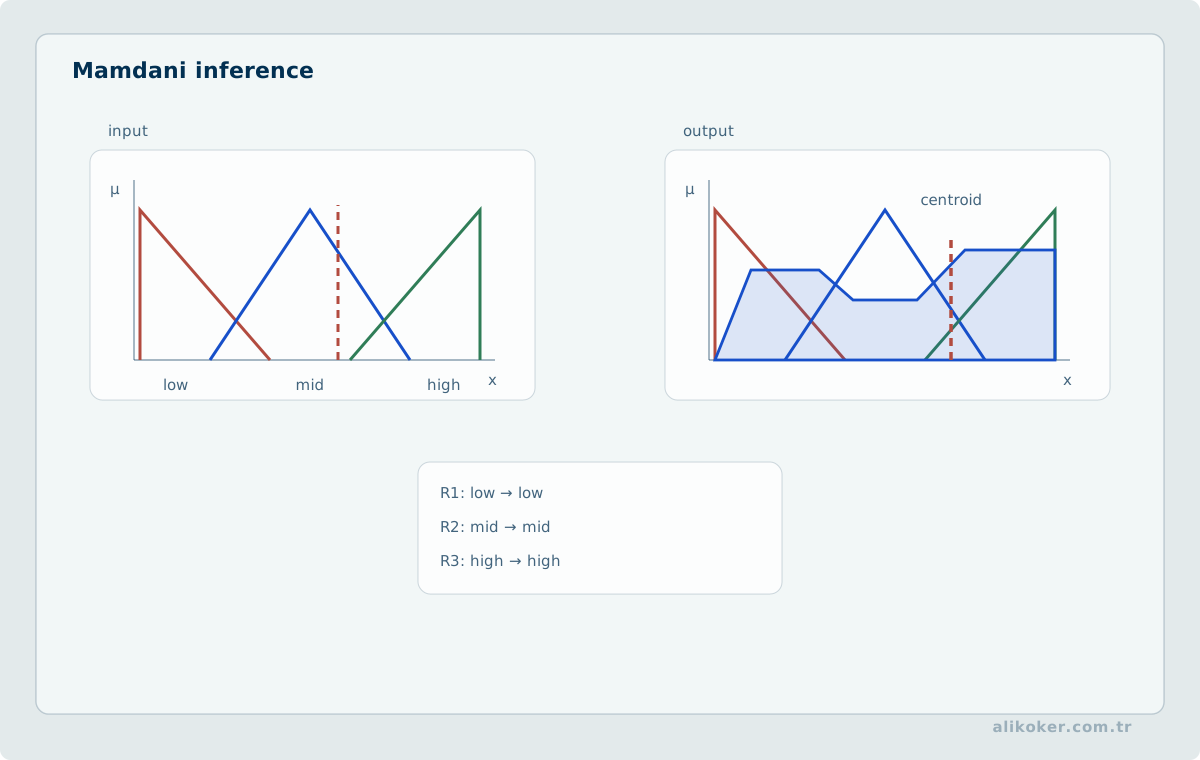
Lotfi A. Zadeh'in 1965 tarihli fuzzy sets çalışması, klasik kümelerdeki 0 veya 1 üyeliği yerine bir elemanın kümeye üyeliğini [0,1] aralığında dereceyle temsil etmeyi önerdi. Bu yaklaşım olasılıkla aynı şey değildir.
Olasılık bir olayın gerçekleşmesine ilişkin belirsizlikle, fuzzy üyelik ise bir kavramın sınırlarının dereceli olmasıyla ilgilenebilir. Bir bulanık sistemde tipik akış şöyledir:
sayısal / gözlenen girdi
-> bulanıklaştırma
-> üyelik dereceleri
-> EĞER–İSE kural tabanı
-> bulanık çıkarım
-> durulaştırma
-> sayısal çıktı
Üyelik fonksiyonları üçgen, yamuk, Gaussian veya başka biçimlerde tanımlanabilir. VE işlemlerinde t-norm, VEYA işlemlerinde t-conorm ailesi kullanılabilir. Mamdani çıkarımı sonuçları bulanık kümeler üzerinden birleştirir; Takagi–Sugeno yaklaşımında kural sonucu sabit veya fonksiyon biçiminde olabilir. Centroid gibi defuzzification yöntemleri bulanık sonucu tek sayısal çıktıya dönüştürür.
Bulanık mantığın güçlü yanı uzman bilgisini sözel kurallarla sisteme taşıyabilmesidir; zayıf yanı üyelik fonksiyonu ve kural tasarımının elle yapılması halinde ölçeklenme ve bakım maliyetidir. Bu eksikliği öğrenen sistemlerle birleştirme fikri neuro-fuzzy yaklaşımları doğurdu. ANFIS, Takagi–Sugeno biçimindeki bulanık çıkarım yapısını uyarlanabilir ağ ve hibrit öğrenmeyle birleştirir. (Jang, 1993)
NEFCLASS sınıflandırma için neuro-fuzzy kural öğrenmesini, NEFCON kontrol için öğrenilebilir bulanık kural yapılarını, GARIC ise pekiştirme sinyaliyle bulanık denetleyici öğrenme ve ayarlamayı örnekler. Ortak fikir, sinir ağlarının parametre öğrenme gücü ile bulanık sistemlerin yorumlanabilir kural yapısını bir araya getirmektir. (Nauck & Kruse, 1995; Nauck, Klawonn & Kruse, 1997; Berenji & Khedkar, 1992)
Üyelik fonksiyonları, Mamdani ve Sugeno çıkarımı, durulaştırma, denetim ve neuro-fuzzy yapılar Bulanık Mantık: Kuram, Çıkarım, Kontrol ve Uygulamalar ders notunda ayrıntılandırılır.
1957–2000: perceptrondan modern bağlantıcılığa
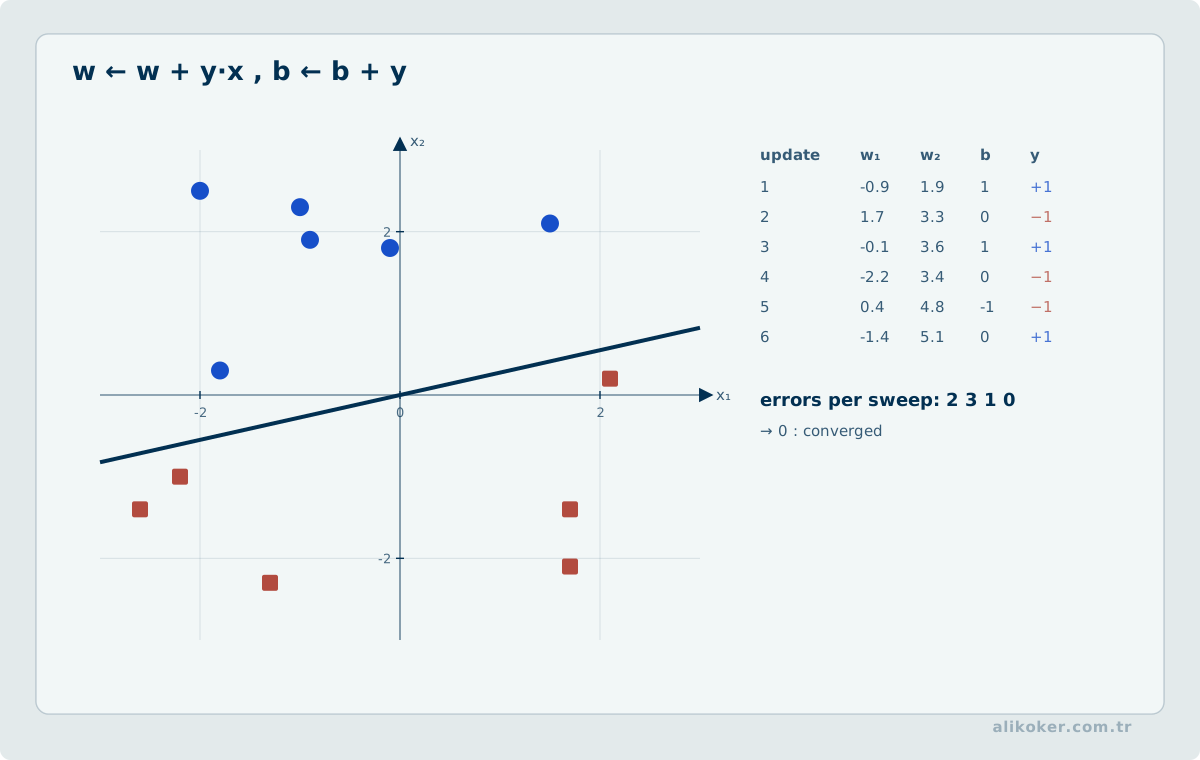
Sembolik yaklaşım bilgiyi açık kurallarda ararken bağlantıcılık bilgiyi ağırlıklara dağıtır. Bu ayrım mutlak değildir; fakat yapay zeka tarihindeki iki güçlü mühendislik sezgisini temsil eder: kuralı yazmak ve davranışı veriden öğrenmek. (McCulloch & Pitts, 1943; Rosenblatt, 1958; Rumelhart, Hinton & Williams, 1986)
Rosenblatt'ın perceptronu doğrusal karar sınırı öğrenebilen erken bağlantıcı modeldi. ADALINE benzer dönemde sürekli hata ölçüsüyle doğrusal uyarlamayı geliştirdi. Basit bir yapay nöron şu biçimde düşünülebilir:
y = f(sum(w_i * x_i) + b)Tek katmanlı perceptron XOR gibi doğrusal ayrılamayan problemleri temsil edemez. Bu sonuç sinir ağlarının bütünü için değil, belirli model sınıfı için sınırdır. Minsky ve Papert'in 1969 tarihli Perceptrons kitabı bu model sınıfının temsil sınırlarını sistematik biçimde inceledi; çalışma bağlantıcı araştırmanın yönünü etkiledi, ancak sonraki fonlama ve ilgi kaybını tek başına bu kitaba bağlamak tarihsel olarak aşırı basitleştirme olur. Çok katmanlı ağlar ve doğrusal olmayan aktivasyonlar daha geniş fonksiyon ailelerini temsil eder. (Minsky & Papert, 1969)
Backpropagation'ın tarihsel çizgisi 1986'daki yaygınlaşmadan daha eskidir. Linnainmaa 1970'te bugün reverse-mode automatic differentiation olarak bilinen verimli türev hesabını yayımladı; Werbos'un 1974 tezi yöntemin öğrenen çok katmanlı sistemlere uygulanmasına ilişkin öncül tartışmalar içerdi. Rumelhart, Hinton ve Williams'ın 1986 çalışması ise geri yayılımın gizli temsiller öğrenen çok katmanlı ağlarda etkisini geniş ölçekte görünür kıldı. (Linnainmaa, 1970; Werbos, 1974; Rumelhart, Hinton & Williams, 1986)
Backpropagation, kayıp fonksiyonunun gradyanını zincir kuralıyla geriye taşır. Eğitim döngüsü özünde kısadır:
ileri geçiş
-> kayıp
-> gradyan
-> parametre güncellemesi
Öğrenme oranı adım büyüklüğünü belirler; momentum yön bilgisini biriktirir. Çok yüksek oran kararsızlık, çok düşük oran gereksiz yavaşlık yaratabilir. Stochastic gradient descent, RMSProp ve Adam gibi yöntemler aynı optimizasyon problemini farklı güncelleme dinamikleriyle ele alır.
Aktivasyon fonksiyonları da eğitim davranışını değiştirir. Sigmoid ve tanh büyük mutlak değerlerde doygunlaşabilir. ReLU pozitif bölgede basit gradyan yapısıyla derin ağ eğitimini kolaylaştırdı; buna karşılık dead ReLU gibi kendi sorunlarını taşır.
Bağlantıcı mimariler tek çizgide ilerlemedi:
- RBF ağları, yerel radial basis fonksiyonlarıyla yaklaşım yapar.
- Self-Organizing Map, denetimsiz topolojik haritalama yapar.
- Learning Vector Quantization, prototip tabanlı denetimli sınıflandırmadır.
- Adaptive Resonance Theory, yeni örüntüyü öğrenme ile eski yapıyı koruma arasındaki stability–plasticity sorununu ele alır.
- Elman ağı ve RNN, gizli durumu zaman içinde taşır.
- LSTM ve GRU, uzun bağımlılıklarda bilgi akışını kapılarla düzenler.
- CNN, uzamsal yerellik ve ağırlık paylaşımını kullanır.
- Autoencoder, girdiyi daha sıkışık temsil üzerinden yeniden üretmeyi öğrenir.
RNN'lerde uzun bağımlılıklar vanishing ve exploding gradient sorunlarını büyütebilir. LSTM ve GRU bu problemi bütünüyle ortadan kaldırmaz; gradyan ve bellek akışını daha yönetilebilir hale getirir.
2015'te ResNet'in residual bağlantıları çok derin ağların optimizasyonunu kolaylaştırdı. Residual yol, gradyan akışını iyileştirir; fakat her eğitim sorununu çözmez. Derinlik arttıkça veri, optimizasyon, regularization ve donanım arasındaki ilişki daha önemli hale gelir.
Aşırı uyum, modelin eğitim verisindeki ayrıntı ve gürültüyü genelleme pahasına öğrenmesidir. Çözüm yalnız daha fazla veri değildir. Train/validation/test ayrımı, cross-validation, weight decay, dropout, data augmentation, early stopping ve uygun model kapasitesi birlikte düşünülür.
Underfitting bunun karşı ucudur: model faydalı yapıyı dahi öğrenemez. Bias–variance dengesi iki hatayı aynı çerçevede düşünmeye yardım eder.
Transfer learning, önceden öğrenilmiş temsili yeni göreve taşır. Temsil öğrenmesi böylece el yapımı özellik ile uçtan uca öğrenme arasındaki sınırı değiştirdi. Bağlantıcılığın klasik ağ aileleri etrafındaki gelişimi daha sonra Transformer ve foundation model dönemine uzandı.
Yapay nöron, katman yapısı, öğrenme yaklaşımları, Perceptron, çok katmanlı algılayıcı, geri yayılım, LVQ, ART ve geri dönüşümlü ağlar Yapay Sinir Ağları ve Öğrenme Modelleri dersinde birlikte ele alınır.
Evrimsel arama ve genetik algoritmalar
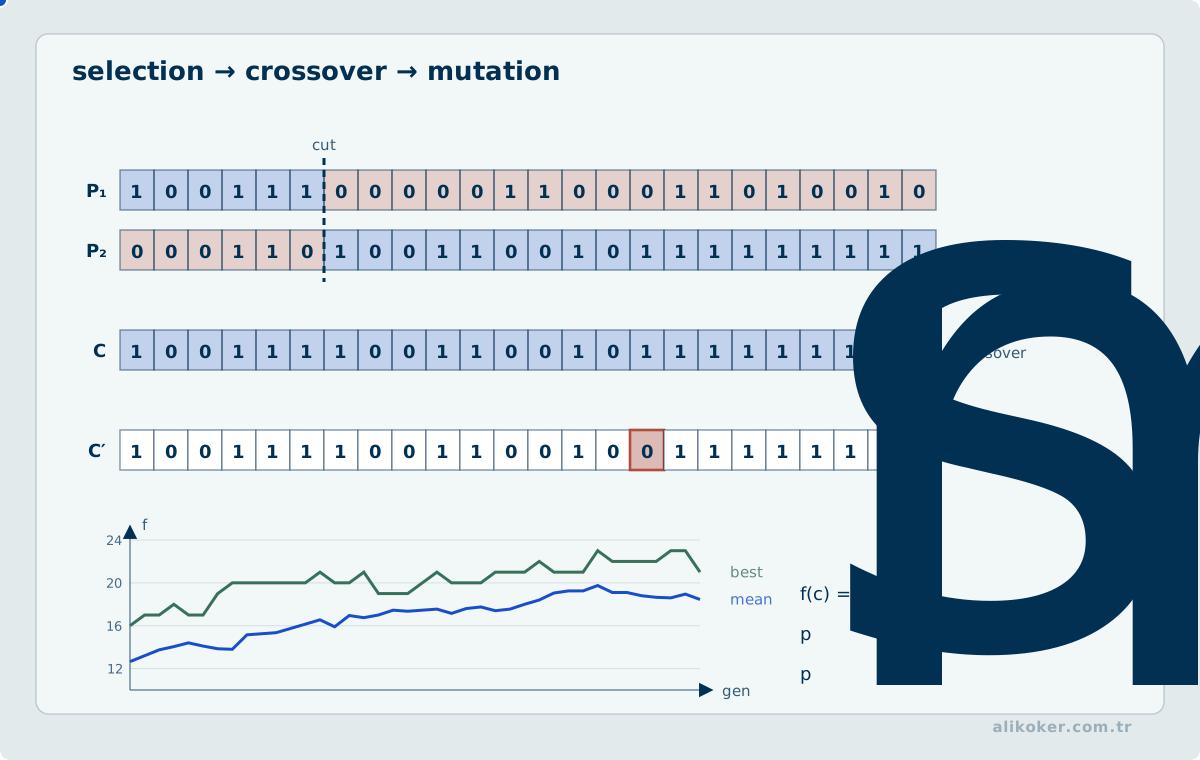
Tek amaçlı optimizasyon tek bir fitness ölçütünü yükseltir veya düşürür. Çok amaçlı optimizasyonda hedefler çatışabilir. Pareto üstünlüğü, bir çözümün en az bir hedefte daha iyi olurken hiçbir hedefte daha kötü olmamasını ifade eder.
Pareto cephesi tek bir 'en iyi' yerine ödünleşim çözümlerini gösterir. Genetik algoritmaların modern çizgisi Holland'ın 1975 tarihli çalışmasıyla sistematikleşti; Goldberg'in 1989 kitabı yaklaşımın arama, optimizasyon ve makine öğrenmesindeki kullanımını geniş kitlelere taşıdı. Genetik algoritmalar, çözüm adaylarını popülasyon halinde tutup seçim, çaprazlama ve mutasyon işlemleriyle arama yapar. Her adayın uygunluğu fitness fonksiyonuyla ölçülür. (Holland, 1975; Goldberg, 1989)
Güçleri türev gerektirmemeleri ve karmaşık, ayrık veya çok tepeli arama uzaylarında kullanılabilmeleridir. Zayıf yanları yüksek değerlendirme maliyeti, hiperparametre duyarlılığı ve iyi bir fitness fonksiyonu tasarlamanın zorluğudur. Genetik algoritmada amaç biyolojik evrimi eksiksiz simüle etmek değil, seçilim ve varyasyon ilkelerinden bir optimizasyon mekanizması üretmektir.
Representation, selection pressure, elitism, crossover rate, mutation rate ve diversity yönetimi sonuç üzerinde belirleyicidir. Popülasyon çok hızlı homojenleşirse premature convergence oluşabilir. Çok yüksek mutasyon ise yönlü aramayı rastgele aramaya yaklaştırabilir.
Kodlama, seçim, çaprazlama, mutasyon, uygunluk tasarımı ve çok amaçlı optimizasyon ayrıntıları Genetik Algoritmalar ve Uygulamaları ders notunda ele alınır.
1990'lar–2010'lar: istatistiksel makine öğrenmesinin kuramsal çekirdeği
1990'lara doğru yapay zekada ağırlık “kuralı tek tek yaz” yaklaşımından “veriden karar sınırı veya olasılık dağılımı öğren” yaklaşımına kaydı. Bayesçi modeller, karar ağaçları, SVM, örüntü tanıma ve kümeleme aynı dönüşümün farklı yüzleridir. (Cortes & Vapnik, 1995; Bishop, 2006)
Öğrenme türleri algoritmanın “zeka çeşidi” değil, kullanılan eğitim sinyalinin yapısıdır:
- Denetimli öğrenme: etiketli
x -> yörneklerinden ilişki öğrenir. - Denetimsiz öğrenme: etiketsiz veride yapı arar.
- Yarı denetimli öğrenme: az etiket ile çok etiketsiz veriyi birlikte kullanır.
- Özdenetimli öğrenme: hedefi verinin kendi yapısından üretir.
- Pekiştirmeli öğrenme: eylem sonuçlarından gelen ödülle politika öğrenir.
k-NN (K-Nearest Neighbors) parametrik bir karar yüzeyi öğrenmek yerine yeni örneği yakın komşularına göre tahmin eder. Bu nedenle ölçeklendirme ve mesafe tanımı model davranışının parçasıdır. Euclidean, Manhattan ve cosine aynı veri üzerinde farklı komşuluk geometrileri oluşturabilir.
Naïve Bayes, özelliklerin sınıf verildiğinde koşullu bağımsız olduğu güçlü varsayımını kullanır. Varsayım gerçek dünyada çoğu zaman tam karşılanmaz; buna rağmen özellikle yüksek boyutlu seyrek veride etkili olabilir.
Karar ağaçları veriyi ardışık eşiklerle böler. Tek ağaç yorumlanabilir olabilir fakat varyansı yüksek olabilir. Random forest birden çok ağacı çeşitlendirir; boosting ise zayıf öğrenicileri ardışık biçimde güçlendirir.
Support Vector Machine maksimum marjlı ayırıcı arar. Hard-margin yaklaşım bütün örneklerin kusursuz ayrılabildiğini varsayar. Soft-margin ise ihlalleri ceza terimiyle dengeler ve gürültülü veride daha gerçekçidir.
Kernel trick, veriyi açıkça yüksek boyutlu uzaya taşımadan doğrusal olmayan karar sınırı kurabilir. Buradaki ders yalnız SVM'e ait değildir: temsil seçimi, hangi problemin doğrusal veya kolay göründüğünü değiştirir.
K-Means, örnekleri en yakın merkeze atayıp merkezleri yeniden hesaplayarak küme içi karesel hatayı azaltır. Amaç fonksiyonu her iterasyonda artmaz; yöntem yine de global optimum garantisi vermez ve başlangıç merkezlerine duyarlıdır. K-means++ başlangıcı iyileştirebilir.
K-medoids merkez olarak gerçek gözlem kullanır ve aykırı değerlere daha dayanıklı olabilir. CLARA büyük veri için örneklem tabanlı medoid araması yapar; örneklem temsil edici değilse iyi çözüm kaçırılabilir.
PCA, varyansı en fazla taşıyan ortogonal doğrusal yönleri bulur ve sınıf etiketi kullanmaz. LDA ise sınıflar arası ayrımı artıran projeksiyon arar. Özellik seçimi mevcut özelliklerden alt küme seçerken boyut indirgeme yeni eksenler üretebilir.
Anomali tespiti çoğu zaman “hangi sınıf?” sorusundan farklıdır. Asıl soru örneğin normal dağılım veya davranış kalıbından ne kadar saptığıdır. Bu nedenle eşik, maliyet ve beklenen yanlış alarm oranı birlikte düşünülür.
Model değerlendirmesi tek metrikle yapılmamalıdır. Dengesiz sınıflarda accuracy yüksek görünürken azınlık sınıfı bütünüyle kaçırılabilir.
- Precision, pozitif tahminlerin ne kadarının doğru olduğunu gösterir.
- Recall, gerçek pozitiflerin ne kadarının yakalandığını gösterir.
- F1, precision ile recall'ı harmonik ortalamayla dengeler.
- ROC ve PR eğrileri, eşik değiştikçe hata türlerinin nasıl değiştiğini gösterir.
- Calibration, modelin verdiği olasılığın uzun dönem frekansla uyumunu sorgular.
Regresyonda MAE, MSE, RMSE ve R² farklı hata özelliklerini özetler. “En iyi metrik” problemden bağımsız değildir; yanlış pozitif, yanlış negatif, büyük hata veya gecikme farklı iş maliyetleri taşıyabilir.
Genelleme sorunu bias–variance dengesiyle okunabilir. Yüksek bias yetersiz öğrenmeye, yüksek variance örnekleme gürültüsüne aşırı duyarlılığa yol açabilir. Regularization, model kapasitesini veya parametre büyüklüğünü sınırlayarak bu dengeyi etkiler.
Çapraz doğrulama (cross-validation) değerlendirme verimliliğini artırır; fakat veri sızıntısı (data leakage) varsa sonuç yine yapay biçimde iyimser olabilir. Eğitim öncesi yapılan veri seçimi, özellik çıkarımı veya normalizasyon test bilgisini sızdırıyorsa model gerçek üretim koşulunu görmeden avantaj kazanır.
Üretimde dağılım sabit kabul edilemez. Data drift girdi dağılımının, concept drift ise girdi–hedef ilişkisinin değişmesidir. Model decay zaman içinde bu değişimlerin performansa yansımasıdır.
Synthetic data veri kapsamını genişletebilir, az görülen durumları üretebilir veya mahremiyet tasarımına yardımcı olabilir. Aynı yöntem gerçek dağılımdaki önyargı ve hataları çoğaltabilir. Bu yüzden sentetik veri de provenance ve kalite denetimine ihtiyaç duyar.
Özellik mühendisliği, ham veriyi modele yararlı temsile dönüştürür. Ölçekleme, kategorik kodlama, metin vektörleri, pencereleme, spektral öznitelikler ve alan bilgisine dayalı dönüşümler bu fikrin örnekleridir. Derin öğrenme bu katmanın bir bölümünü otomatikleştirdi; hangi verinin ölçüldüğü ve hangi hedefin optimize edildiği sorusunu ortadan kaldırmadı.
İstatistiksel öğrenmenin önemli bir başka kolu dizisel ve metinsel olasılık modelleridir. n-gram yaklaşımı, bir sonraki birimin olasılığını tam geçmiş yerine sınırlı uzunluktaki önceki birimlerden kestirir. Naive Bayes ile sözcük/n-gram sayımları, HMM ile gizli durumlar ve gözlem olasılıkları, Bayes ağları ile değişkenler arası koşullu bağımlılıklar aynı istatistiksel düşüncenin farklı temsil biçimleridir. Bu çizgi daha sonra derin öğrenme ile ortadan kalkmadı; öğrenilen temsilin ve bağlam modelinin biçimi değişti.
SVM, k-NN, Naive Bayes, K-Means, karar ağaçları, topluluk yöntemleri, PCA/LDA, Gaussian mixture–EM, HMM, anomali tespiti, n-gram, model değerlendirme ve düzenlileştirmenin ayrıntılı matematiksel/algoritmik akışı İstatistiksel Öğrenme ve Makine Öğrenmesi bölümünde ele alınır. Buradaki tarihsel çerçevede önemli olan, bu yöntemlerin tek tek adlarından çok ortak dönüşümdür: kuralı önceden yazmak yerine veriden olasılık, komşuluk, marj, bölme veya gizli yapı kestirmek.
Pekiştirmeli öğrenme: durum, eylem ve uzun vadeli getiri
Pekiştirmeli öğrenme, etiketli doğru cevabı her adımda vermek yerine ajanı çevre içinde ödül sinyaliyle yönlendirir. Bir politikanın durum değeri beklenen indirgenmiş getiriyle ifade edilebilir:
V^pi(s) = E_pi[ sum_(t=0..infinity) gamma^t R_(t+1) | S_0 = s ]Bellman denklemleri, bir durumun değerini anlık ödül ve sonraki durumların değerleri üzerinden özyinelemeli biçimde kurar. Q-learning model-free ve off-policy bir yöntemdir:
Q(s,a) <- Q(s,a) + alpha * [ r + gamma * max_(a') Q(s',a') - Q(s,a) ]Burada exploration–exploitation dengesi merkezîdir. Epsilon-greedy politika belirli olasılıkla rastgele eylem seçerek keşfi sürdürür. Çok düşük keşif erken kilitlenmeye, çok yüksek keşif ise öğrenilmiş bilginin kullanılmamasına yol açabilir.
Deep Q-Network (DQN), Q fonksiyonunu sinir ağıyla yaklaştırdı ve replay buffer ile target network gibi kararlılık teknikleri kullandı. AlphaGo ise policy network, value network ve Monte Carlo Tree Search'ü birlikte kullanarak öğrenilmiş sezgi ile klasik aramayı birleştirdi. Bu, modern yapay zekada önemli bir ilkeyi gösterir: öğrenilmiş model ve klasik algoritma birbirinin alternatifi olmak zorunda değildir.
Klasik NLP, konu modelleme ve semantik temsil
Büyük dil modellerinden önce doğal dil işleme büyük ölçüde token sayımı, n-gram, TF-IDF, dil modeli, hidden Markov model, CRF ve görev-özel sınıflandırıcılarla ilerliyordu. TF-IDF, corpus içinde nadir ama belge için ayırt edici terimlere daha yüksek ağırlık verir. Bag-of-words kelime sırasını büyük ölçüde kaybeder; n-gram yerel sıra bilgisini ekler fakat boyut hızla büyür.
Metin sınıflandırmada Naive Bayes, logistic regression ve linear SVM uzun süre güçlü baseline'lar oldu.
Baseline hala önemlidir: büyük model kullanmadan çözülebilen görev daha ucuz, daha hızlı ve daha kolay denetlenebilir olabilir.
Dağıtımsal semantik, kelimelerin anlamını kullanım bağlamları üzerinden temsil etmeye yöneldi. 2010'ların başındaki Word2Vec ve GloVe word embedding çizgisi, ayrık kelime kimliklerinden yoğun vektör temsillere geçişi hızlandırdı. Bu temsiller daha sonra Transformer içindeki bağlama duyarlı embedding yaklaşımına zemin hazırladı.
Topic modeling, belgelerdeki gizli tema yapısını çıkarmaya çalışır. LDA (Latent Dirichlet Allocation) burada Linear Discriminant Analysis ile aynı kısaltmayı paylaşmasına rağmen farklı bir yöntemdir; belgeleri konu karışımları, konuları kelime dağılımları olarak modeller. Modern embedding ve LLM yöntemleri tema keşfine daha esnek semantik araçlar ekledi, fakat konu etiketlerini modelin kendisine bıraktığımızda tutarlılık ve yeniden üretilebilirlik ayrıca ölçülmelidir.
- Semantik embedding tabanlı clustering'de önce temsil, sonra uzaklık, sonra kümeleme ve son olarak insan tarafından tema adlandırma aşamaları ayrılmalıdır. “LLM konu adını güzel yazdı” ile kümelerin gerçekten kararlı ve anlamlı olması farklı kalite ölçüleridir.
Biçimbilimden diyaloğa çözümleme katmanları
Doğal dili işlemek yalnız sözcükleri ayırmak değildir. Klasik çözümleme zincirinde farklı dil düzeyleri ayrı sorulara karşılık gelir:
- biçimbilim, sözcüğün kökünü, eklerini ve sözcük türünü inceler,
- sözdizimi, sözcüklerin cümle içindeki yapısal ilişkilerini kurar,
- anlambilim, yapının hangi anlam veya ilişkilere karşılık geldiğini araştırır,
- söylem ve diyalog çözümlemesi, birden fazla cümleyi konuşma geçmişi ve bağlamla birlikte ele alır.
Türkçe gibi eklemeli dillerde tek bir yüzey sözcüğü çok sayıda biçimbirim taşıyabilir. Bu nedenle kök ve ek ayrımı, sözcük türü, olumsuzluk, zaman, kişi veya iyelik gibi bilgiler daha sonraki sözdizimsel ve anlamsal çözümlemeyi doğrudan etkiler.
Aynı yüzey biçimi birden fazla çözümlemeye izin verdiğinde bağlam gerekir. Bir sözcüğün isim mi fiil mi olduğu, bir ek dizisinin hangi köke bağlandığı veya bir zamirin hangi varlığa gönderme yaptığı yalnız karakter dizisinden her zaman belirlenemez. Modern bağlamsal modeller bu katmanların bir bölümünü ortak temsil içinde öğrenebilir; buna rağmen hata analizi yapılırken biçimbilimsel, sözdizimsel ve anlamsal hata türlerini ayırmak hâlâ yararlıdır.
OCR ve ASR çıktılarının biçimbilimsel, sözdizimsel ve anlamsal çözümleme ile çoklu ortam zaman çizgisine bağlanması Doğal Dil İşleme Yönünden Çoklu Ortam bölümünde devam eder.
2012–2016: Derin öğrenmenin yeniden yükselişi
Derin öğrenme açısından 2012 sonrasında veri, hızlandırıcı donanım ve uçtan uca temsil öğrenmesi aynı anda olgunlaştı. Derin öğrenmenin yükselişi tek bir algoritmanın başarısı değil, bu üç koşulun birleşmesiydi. (LeCun, Bengio & Hinton, 2015)
AlexNet'in ImageNet başarısı, büyük etiketli veri, GPU hesaplama ve derin convolutional ağların birleşimini görünür kıldı. CNN'lerde convolution yerel örüntüleri paylaşılmış filtrelerle tarar; pooling veya stride uzamsal çözünürlüğü azaltabilir; daha derin katmanlar daha karmaşık özellikler öğrenebilir. “İlk katman kenar, son katman nesne öğrenir” anlatımı sezgiseldir; gerçek iç temsiller daha dağıtık ve veri bağımlıdır.
2010'ların ortasında derin öğrenme görüntü, ses ve konuşma işleme için ana eksen haline gelmişti.
Uygulama açısından bu dönüşüm, klasik sinyal işleme ile öğrenilmiş temsil arasında bir kopuş değil yeni bir iş bölümü yarattı. Fourier dönüşümü, filtreler, cepstral özellikler ve geometri hala fiziksel sinyali anlamak için değerlidir; derin modeller ise hangi temsilin görev için yararlı olduğunu daha büyük ölçekte öğrenebilir.
Bu dönüşüm, görüntü ve ses gibi yüksek boyutlu verilerde el yapımı özelliklerden öğrenilmiş temsillere geçişi hızlandırdı.
2014'te GAN yaklaşımı üretici ve ayırt edici iki ağın adversarial eğitimini kullandı. Variational Autoencoder (VAE) gibi latent-variable modeller de olasılıksal üretim için farklı bir yol sundu. Generative model kavramı, yalnız “metin üreten chatbot” anlamına gelmez; verinin dağılımını veya onu üreten latent yapıyı modellemeye çalışan geniş bir aileyi kapsar.
Diffusion modelleri daha sonraki yıllarda gürültü ekleme ve bu süreci tersine öğrenme fikrini güçlü bir üretken model ailesine dönüştürdü. GAN, VAE, autoregressive ve diffusion yaklaşımları aynı problemi farklı faktörizasyon ve eğitim hedefleriyle çözer; tek bir “üretken yapay zeka algoritması” yoktur.
2017: Transformer ile sıralı modellemenin değişmesi
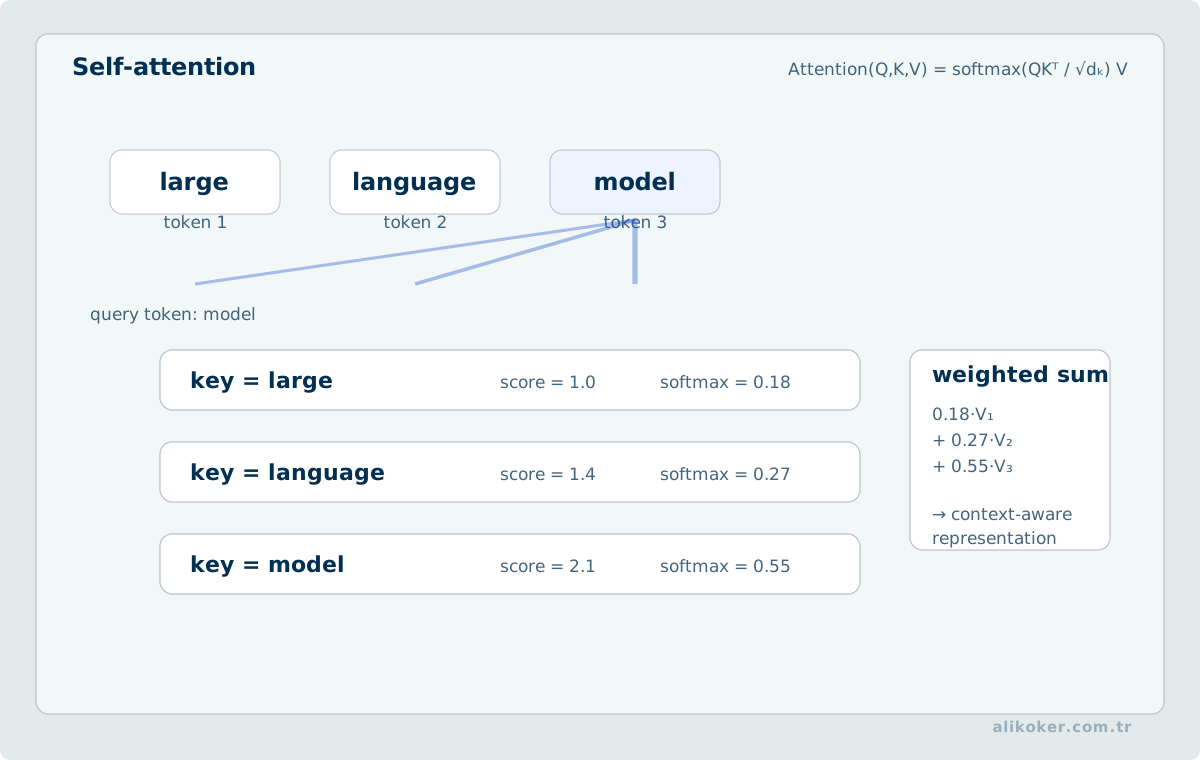
Recurrent modeller zaman bağımlılığını ardışık hesapla taşıyordu. Transformer, ilişkinin merkezine attention'ı koyarak eğitim paralelliğini ve uzun menzilli temsil kapasitesini değiştirdi. (Vaswani et al., 2017)
2017'de Attention Is All You Need makalesi, recurrence yerine self-attention merkezli Transformer mimarisini önerdi. Self-attention'da her token için Q/K/V olarak kısaltılan query, key ve value vektörleri üretilir. Query ile key benzerliği hangi tokenların birbirine ne ölçüde dikkat edeceğini, value ise karışıma hangi içeriğin taşınacağını belirler:
Attention(Q,K,V) = matmul(softmax(matmul(Q, K^T) / sqrt(d_k)), V)Ölçekleme, vektör boyutu büyüdükçe dot-product değerlerinin softmax'ı aşırı doygunlaştırmasını azaltır. Multi-head attention, farklı projeksiyon uzaylarında farklı ilişki türlerinin paralel öğrenilmesine izin verir. Bir head yerel sözdizimine, başka bir head uzun mesafeli referansa odaklanabilir; gerçek head davranışları bu basit etiketlerden daha karmaşık olabilir.
Attention tek başına sıra bilgisi taşımaz. Positional encoding veya positional embedding, tokenların dizideki konumunu modele ekler. Sinüzoidal konum kodları ilk Transformer'da kullanıldı; daha sonraki modeller learned positional embeddings, relative position bias ve RoPE gibi yöntemlere yöneldi.
RoPE, konum bilgisini query/key uzayında dönüşler üzerinden taşır ve uzun bağlam tasarımlarında yaygınlaşmıştır. Encoder-only mimariler iki yönlü bağlamla sınıflandırma ve temsil üretiminde; decoder-only mimariler causal mask ile autoregressive üretimde; encoder–decoder mimariler ise giriş ve çıkış dizilerini ayrı aşamalarda işleyen seq2seq (sequence-to-sequence) görevlerinde güçlüdür. BERT encoder ağırlıklı masked-language-model yaklaşımının, GPT ailesi ise decoder-only next-token prediction yaklaşımının bilinen örnekleridir.
T5 farklı görevleri text-to-text çerçevesinde birleştirdi. Transformer'ın güçlü yanı yalnız “uzun bağımlılık” değildir. Eğitim sırasında tokenlar arası hesapların büyük kısmı paralelleştirilebilir ve modern hızlandırıcılara iyi eşlenir.
Buna karşılık standart dense self-attention'da token çiftleri arasındaki etkileşim sayısı dizi uzunluğuyla yaklaşık O(n^2) büyür. Attention skor matrisini doğrudan materyalize eden klasik gerçeklemelerde ara bellek maliyeti de O(n^2) olabilir. FlashAttention gibi IO-aware exact kernel'ler aynı dense attention sonucunu tam attention matrisini HBM'de materyalize etmeden hesaplayarak yardımcı bellek ve bellek trafiğini önemli ölçüde azaltır; ancak dense attention'ın temel O(n^2) hesap etkileşimi ortadan kalkmaz. Bu nedenle uzun context kapasitesi ücretsiz değildir; model desteklese bile bütün belgeleri her istekte context'e doldurmak iyi tasarım sayılmaz. (Dao et al., 2022)
Tokenization, embeddings ve dil modelinin gerçek hesap birimi
Büyük dil modelinin doğal hesap birimi çoğu zaman kelime değil tokendır. Token bir kelime, kelime parçası, noktalama veya byte tabanlı parça olabilir. Byte Pair Encoding (BPE) sık geçen sembol çiftlerini birleştirerek değişken uzunluklu altbirimler üretir. SentencePiece boşlukla ayrılmış “kelime” varsayımına bağlı kalmadan ham metin üzerinde altbirim modeli kurabilir.
Çok dilli sistemlerde tokenization seçimi, bazı dillerin aynı anlamı daha fazla tokenla temsil etmesine yol açarak maliyet ve context kapasitesini etkileyebilir. Embedding, ayrık öğeleri sürekli vektör uzayında temsil eder. Benzer kullanım bağlamları yakın geometrik konumlara gelebilir; fakat “vektör yakınlığı = gerçek dünyada aynı anlam” eşitliği yoktur.
Cosine similarity yön benzerliğini, dot product büyüklük ve yönü birlikte etkileyebilir. Embedding dimension arttıkça temsil kapasitesi büyüyebilir fakat depolama, bellek bant genişliği ve indeks maliyeti de artar. Bi-encoder query ve belgeyi ayrı ayrı encode ederek candidate embedding'leri önceden hesaplamaya izin verir; bu nedenle büyük ölçekli retrieval için uygundur.
Cross-encoder query ve adayı birlikte işleyerek daha zengin etkileşim kurar ama her çift için daha pahalıdır. Yaygın mimari, bi-encoder ile yüksek recall sağlayan kısa listeyi üretip cross-encoder ile yeniden sıralamaktır.
2018–2022: foundation model, in-context learning ve ölçek
BERT, GPT-2, T5 ve daha büyük ön eğitimli modeller, tek görev için sıfırdan model geliştirme yaklaşımını değiştirdi. Büyük bir corpus üzerinde genel amaçlı ön eğitim yapıp modeli downstream görevlere uyarlamak yeni standart oldu. 2020'de GPT-3, few-shot ve in-context learning davranışını büyük ölçekli autoregressive modelde belirginleştirdi.
Model ağırlıkları değişmeden prompt içindeki örneklerden görev biçimini yakalayabilmek, “öğrenme” sözcüğünün inference-time anlamını da tartışmaya açtı. Scaling law çalışmaları model boyutu, veri ve hesaplama arasında düzenli eğilimler gösterdi. Fakat ölçek tek başına garanti değildir.
Data quality, deduplication, objective, architecture, post-training ve evaluation tasarımı sonuçları belirler. Double descent, klasik bias–variance eğrisinin bazı aşırı parametrik modellerde daha karmaşık davranabileceğini gösterir. Emergence sözcüğü ise dikkatle kullanılmalıdır: bazı yetenekler belirli ölçeklerde birden görünür gibi olabilir; metrik seçimi ve sürekli performans eğrileri bu “ani” görünümün bir kısmını açıklayabilir.
Large Language Model, token dizileri üzerinde olasılık dağılımı öğrenen büyük ölçekli bir dil modelidir. Dil modelinin çapraz entropi kaybından türetilen perplexity, modelin diziyi ne kadar şaşırtıcı bulduğunu özetleyen klasik ölçülerden biridir. Düşük perplexity daha iyi dil modellemesine işaret edebilir; fakat görev başarısı, doğruluk veya güvenlik için tek başına yeterli değildir.
Decoder-only model için temel amaç kabaca şöyledir:
P(x_t | x_1, x_2, ..., x_(t-1))Bu hedef basit görünür; ancak çok geniş veri ve model kapasitesi altında sözdizimi, semantik ilişki, stil, bilgi kırıntıları ve görev kalıpları gibi birçok yapı parametrelerde dağıtık biçimde temsil edilebilir. Yine de ağırlıklar doğrulanmış önermelerden oluşan ilişkisel bir bilgi tabanı değildir. Parametrik bellek ile kaynaklandırılabilir harici bilgi ayrımını korumak gerekir.
Post-training: SFT, instruction tuning ve tercih optimizasyonu
Pretraining genel istatistiksel davranış üretir; kullanışlı bir asistan veya alan modeli için post-training gerekir. Supervised Fine-Tuning (SFT) giriş–çıktı çiftleri üzerinden model davranışını belirli görevlere yaklaştırır. Instruction tuning, farklı görevleri doğal dil talimatları biçiminde çeşitlendirerek genel talimat takip yeteneğini geliştirir. Preference optimization, insan veya model tercih karşılaştırmalarından istenen davranışı güçlendirmeye çalışır.
RLHF bu alanın önemli tarihsel yöntemlerinden biridir fakat hizalama yalnız RLHF'den ibaret değildir. DPO ve başka tercih yöntemleri, guardrail, retrieval, tool policy ve deterministik doğrulama da sistem davranışını etkiler. Full fine-tuning bütün veya büyük ölçüde tüm ağırlıkları günceller; maliyeti yüksektir. PEFT yöntemleri daha küçük parametre altkümelerini veya ek adapter bileşenlerini eğitir.
LoRA, ağırlık güncellemesini düşük rank'lı matrislerle yaklaştırarak eğitilebilir (trainable) parametre sayısını azaltır. QLoRA, nicemlenmiş dondurulmuş taban model üzerinde LoRA eğitimiyle bellek maliyetini daha da düşürür. Bu yöntemler “her zaman daha iyi” değildir; veri kalitesi, görev, gecikme (latency), dağıtım (deployment) ve model yönetimi birlikte değerlendirilmelidir.
Distillation, büyük öğretmen (teacher) modelin davranışını daha küçük öğrenci (student) modele aktarmaya çalışır. Amaç yalnız parametre küçültmek değil, belirli görevde kaliteyi kabul edilebilir düzeyde korurken gecikme, bellek ve maliyeti azaltmaktır. Edge ve yüksek işlem hacimli (throughput) sistemlerde bu ayrım önemlidir.
Fine-tuning bilgi retrieval problemini otomatik olarak çözmez. Sık değişen gerçekler veya kaynak gösterilmesi gereken kurumsal bilgi için ağırlıklara yeni bilgi yazmaya çalışmak yerine retrieval daha doğru katman olabilir. İyi mühendislik sorusu “fine-tune yapabilir miyiz?” değil, ölçülen davranış açığını en düşük yaşam döngüsü maliyetiyle hangi katman kapatır? sorusudur.
Optimizasyon matematiği: softmax, cross-entropy, KL ve gradyanlar
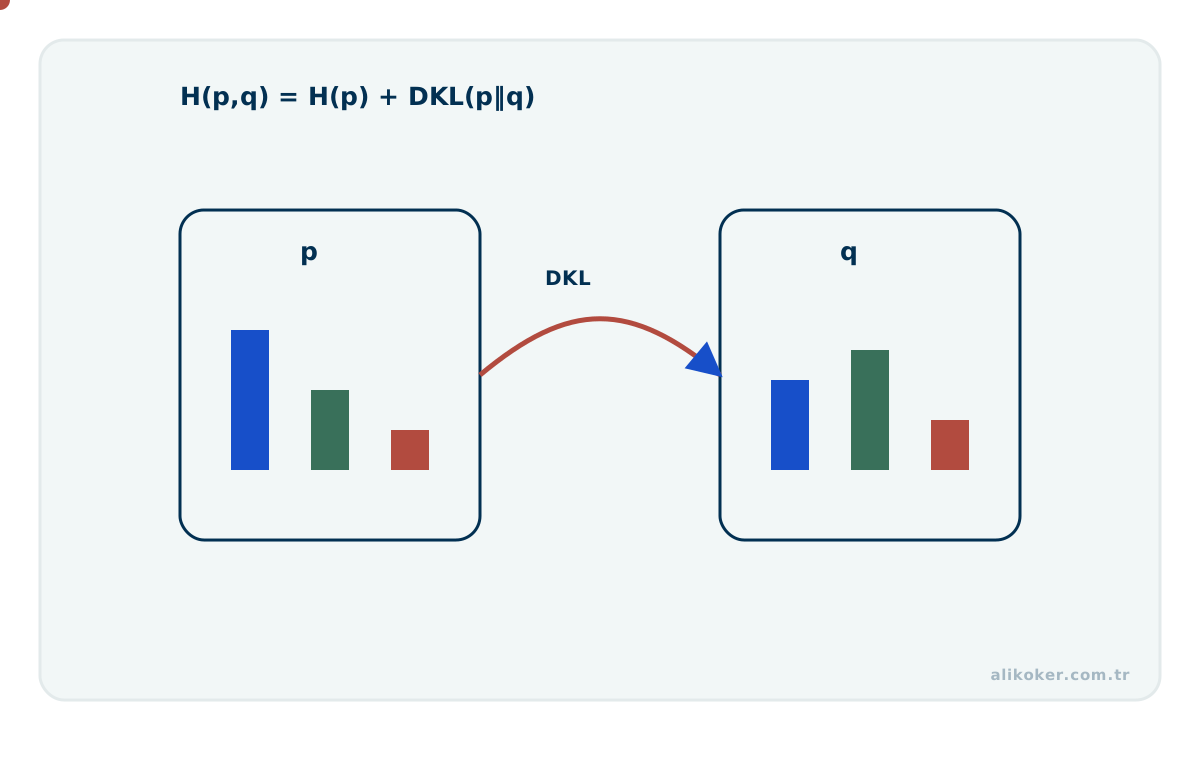
Softmax bir skor vektörünü toplamı 1 olan bir dağılıma dönüştürür:
softmax(z_i) = exp(z_i) / sum_j exp(z_j)Attention'da query–key skorlarını ağırlıklara, sınıflandırmada logitleri olasılık benzeri değerlere dönüştürmek için kullanılır. Sayısal kararlılık için pratik uygulamalar maksimum logiti çıkarmak gibi dönüşümler kullanır. Cross-entropy, hedef dağılım ile model dağılımı arasındaki uyumsuzluğu ölçer.
Tek doğru sınıf için negatif log-likelihood ile yakından ilişkilidir. KL divergence iki dağılımın farkını yönlü biçimde ölçer ve simetrik bir mesafe değildir. Distillation, variational yöntemler ve preference learning gibi alanlarda farklı biçimlerde karşımıza çıkar.
Gradient bir skaler kaybın parametrelere göre yerel değişim yönünü; Jacobian çoklu çıktıların çoklu girdilere göre türev yapısını; Hessian ise ikinci türev yapısını verir. Derin öğrenme pratikte tam Hessian hesaplamaz; fakat eğrilik, conditioning ve learning-rate davranışını anlamak için ikinci derece sezgi değerlidir. Mixed precision, gradient accumulation ve optimizer state bellekleri matematik ile donanım arasındaki doğrudan bağlantıyı gösterir.
Decoding: olasılık dağılımından metne
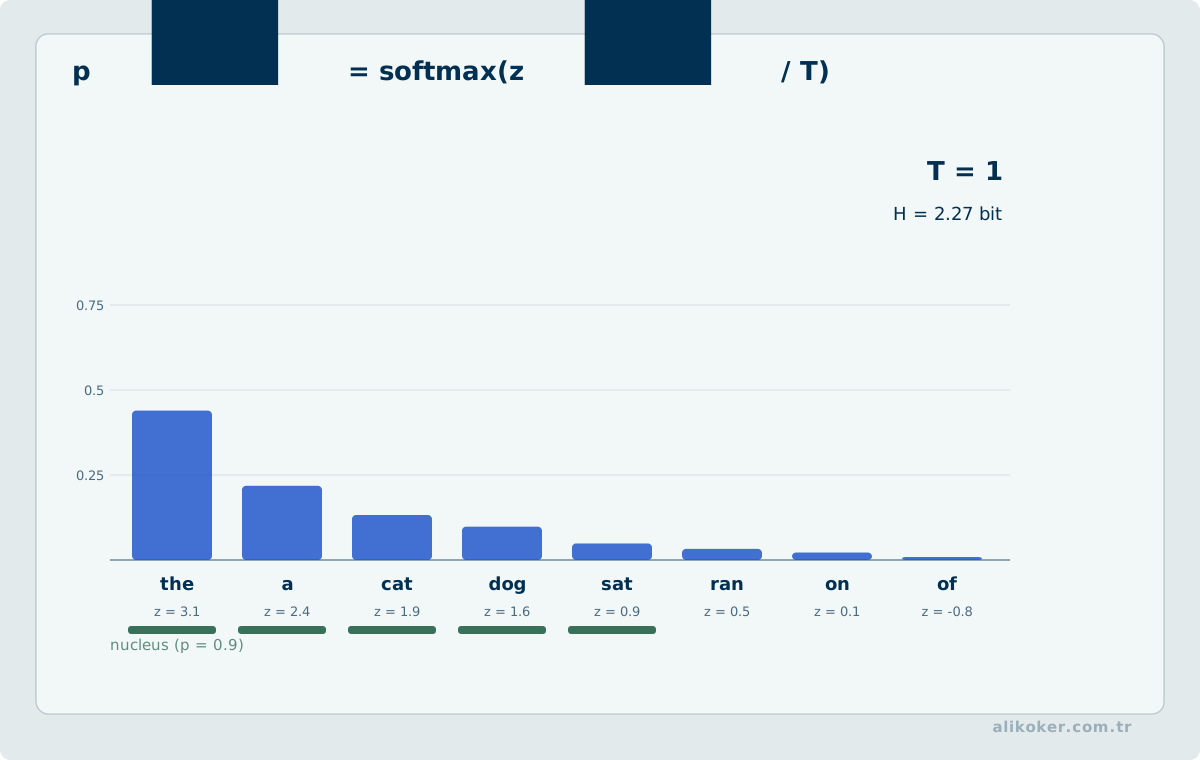
Autoregressive model her adımda sonraki token için bir dağılım üretir. Greedy decoding en yüksek olasılıklı tokenı seçer. Beam search birden fazla aday diziyi paralel sürdürür; translation gibi yapılandırılmış görevlerde yararlı olabilir fakat açık uçlu metinde çeşitliliği azaltabilir ve daha pahalıdır.
Sampling ise dağılımdan örnek çeker.
Temperature, logit dağılımını ölçekleyerek örneklemenin keskinliğini değiştirir. Düşük değerler daha deterministik, yüksek değerler daha çeşitli çıktı eğilimi yaratır; desteklenen aralık ve tam davranış modele bağlıdır. top-k yalnız en yüksek olasılıklı k adayı tutar. top-p veya nucleus sampling, kümülatif olasılığı p eşiğine ulaşan en küçük aday kümesinden örnekler. max_tokens kalite kadar maliyet ve gecikme kontrolüdür.
Sampling parametreleri “yaratıcılık düğmesi” olarak görülmemelidir. Extraction, classification ve structured output gibi görevlerde düşük varyans istenirken beyin fırtınası veya yaratıcı üretimde daha geniş örnekleme yararlı olabilir. Tekrarlanabilirlik gereken sistemlerde model sürümü, altyapı ve paralel hesaplamadaki nondeterminism nedeniyle temperature=0 bile mutlak bit-düzeyi determinizm garantisi değildir.
Ünite 3: Uygulama ve Sistem Mühendisliği
Yapay zekâ gerektiren bir kullanım durumu değerlendirilirken önce otomasyona bırakılacak karar ve yanlış kararın sonucu tanımlanır. Aynı görevi yerine getirebilen kural tabanlı, istatistiksel ve öğrenilmiş yaklaşımlar bir başlangıç ölçütü üzerinde karşılaştırılır. Veri kalitesi, hesaplama maliyeti ve insan denetimi gereksinimi modele karar verildikten sonra değil, tasarımın başında değerlendirilmelidir. Uygulama başarılı görünse bile hangi veri dağılımında ve hangi hata türlerinde başarısız olduğunun ölçülmesi gerekir.
III. Uygulama ve Sistem Mühendisliği Tarihi
Bir model laboratuvarda başarılı olduğunda iş bitmez. Gerçek sistem; veri, donanım, bağlam, araç, yetki, doğrulama, gözlemlenebilirlik ve insan kararlarıyla birlikte çalışır. Uygulama tarihi, yapay zekanın algoritmadan altyapıya ve eyleme geçişinin tarihidir.
Bu geçişin ilk basamağı yine veridir. Görüşme metni, web kaydı, görüntü, ses veya sensör akışı farklı görünse de aynı sorular geri döner: veri nasıl üretildi, hangi bağlamı kaybetti, hangi dönüşümden geçti ve hangi kanıt zinciriyle modele ulaştı?
İnsan geri bildirimi, transkripsiyon ve veri etiketleme
Makine öğrenmesi yalnız ham veriden oluşmaz. Denetimli eğitim, instruction tuning, tercih optimizasyonu ve eval setleri çoğu zaman insan tarafından üretilmiş veya doğrulanmış etiketlere dayanır. Etiketleme kılavuzu belirsizse model, veri içindeki olgudan çok anotasyon alışkanlığını öğrenebilir.
Ses verisinde transkripsiyon bu sorunun açık örneğidir. ASR ilk metni hızla üretebilir; aksan, gürültü, örtüşen konuşma, özel ad ve alan terimleri hata kaynağı olmaya devam eder. Eğitim veya değerlendirme verisi olarak kullanılacak transkriptin özgün ses, zaman bilgisi ve yapılan düzeltmelerle izlenebilir olması gerekir.
İnsan geri bildirimi de kusursuz değildir. Anotatörler farklı yorumlayabilir, tercih verisi kısa vadeli stil tercihlerini gerçek kaliteyle karıştırabilir. Bu nedenle veri üretim süreci, model eğitiminin dışında kalan idari iş değil doğrudan model davranışını belirleyen bir mühendislik katmanıdır.
Modelin kendi çıktısını yeni eğitim etiketi olarak kullanması ölçek sağlar; aynı zamanda hatanın kendini pekiştirmesi riskini doğurur. Sentetik etiketler bağımsız örnekleme, insan kontrolü veya ayrı bir doğrulayıcıyla desteklendiğinde daha güvenlidir.
Sentetik veri, veri soyu ve model çökmesi
Sentetik veri; nadir durumları çoğaltmak, simülasyondan örnek üretmek, gizlilik riskini azaltmak veya pahalı etiketleme süreçlerini desteklemek için yararlı olabilir. Bununla birlikte sentetik verinin kaynağı izlenmeden, bir model neslinin çıktıları sonraki model nesillerinin eğitim verisine sürekli karıştığında farklı bir geri besleme problemi ortaya çıkar.
Shumailov ve arkadaşlarının Nature'da yayımlanan çalışması bu bozulmayı model çökmesi (model collapse) olarak adlandırır. Çalışmadaki temel sonuç, model üretimi verinin ayrım gözetmeden özyinelemeli biçimde yeniden eğitim verisine alınmasının özgün dağılımın özellikle düşük olasılıklı kuyruklarındaki bilgiyi kaybettirebilmesidir (Shumailov et al., 2024). Bu sonuç "sentetik veri kullanılamaz" anlamına gelmez. Sorun; kaynağın, neslin ve özgün veriyle ilişkinin görünmez hâle geldiği kontrolsüz döngüdür.
özgün / gözlenmiş veri
        |
        v
     model n
        |
        v
  üretilmiş veri
        |
        +------> doğrulanmış yardımcı veri
        |
        +------> kaynağı kaybolmuş özyinelemeli veri
                         |
                         v
                    model n+1
Bu nedenle veri soyu (data lineage) yalnız denetim kaydı değildir. İnsan üretimi, sensör gözlemi, simülasyon, başka bir modelin çıktısı ve insan tarafından doğrulanmış sentetik örnek birbirinden ayrılabilmelidir. Eğitim karışımında özgün verinin korunması, sentetik örneklerin kalite filtresinden geçirilmesi ve değerlendirme kümelerinin eğitim döngüsünden yalıtılması aynı güvenilirlik probleminin parçalarıdır.
Model çökmesi ayrıca ortalama metriklerin yeterli olmadığını gösterir. Dağılımın merkezinde kalite korunurken nadir sınıflar, uç durumlar veya düşük frekanslı dil örüntüleri kaybolabilir. Bu nedenle yalnız ortalama kayıp değil, kuyruk kapsaması, sınıf dengesi, özgün veri üzerindeki performans ve nesiller arası dağılım değişimi de izlenmelidir.
Eğitim ve retrieval verisinin hazırlanması
Modern yapay zeka sistemleri web belgeleri, kurumsal kayıtlar, sensör akışları, konuşmalar ve kullanıcı etkileşimleri gibi farklı kaynaklardan veri alabilir. Eğitim corpus'u ile RAG corpus'u aynı şey değildir: biri model parametrelerini değiştirir, diğeri inference sırasında dış kanıt sağlar.
Veri kaynağı seçilirken provenance, güncellik, lisans, kişisel veri ve erişim yetkisi birlikte değerlendirilmelidir. Web'den büyük miktarda metin toplamak kapsama alanını artırabilir; tekrarlar, düşük kaliteli kopyalar ve kaynağı belirsiz içerikler modelin dağılımını da bozabilir. Deduplication yalnız depolama optimizasyonu değil, ezberleme ve değerlendirme kontaminasyonunu azaltan bir veri kalitesi adımıdır.
Veri sızıntısı (veri sızıntısı), değerlendirme sırasında bilinmemesi gereken bilginin eğitim hattına girmesidir. Aynı kullanıcı, belge ailesi, zaman aralığı veya türetilmiş kopyalar eğitim (train) ve test tarafına dağıldığında skor gerçekte olduğundan yüksek görünebilir. Büyük dil modellerinde kıyaslama testi (kıyaslama testi) sorularının eğitim derleminde (corpus) bulunması da aynı problemin daha büyük ölçekli biçimidir.
RAG tarafında veri hazırlama başka sorular ekler: belge nasıl parçalanacak, metadata hangi filtreleri taşıyacak, eski sürümler nasıl ayıklanacak, erişim yetkisi retrieval sırasında nasıl korunacak? Veri hazırlama burada model öncesi temizlik değil, AI sisteminin neyi bilebileceğini ve hangi kanıta erişebileceğini belirleyen katmandır.
Görüntü, ses ve çok kipli yapay zeka
Multimodal sistemler metni görüntü, ses, video ve sensör verisiyle birleştirir. Bu alanın yeni görünmesine rağmen temel problemler eskidir: örnekleme, quantization, gürültü, temsil, özellik (feature) extraction, alignment ve zamanlama. Görüntü piksel matrisi; ses zaman içinde örneklenmiş basınç değişimi olarak sayısallaştırılır.
Model bu fiziksel ölçüm zincirinin üstünde çalışır. Görüntü işlemede convolution, filtering, edge detection, segmentation, özellik descriptor, object detection, face detection, OCR ve depth estimation farklı görevlerdir. Seste FFT/spectrum, cepstrum, VAD, segmentation, ASR, speaker recognition ve diarization ayrı katmanlardır.
Hepsini “multimodal AI” etiketi altında toplamak mühendislik farklarını gizler. Görüntü, ses ve dil aynı model içinde birleştiğinde temel sorun değişmez: her kipin ölçüm ve temsil özellikleri korunmalıdır.
Biyometrik karar sistemleri
Biyometri, kimliği fiziksel veya davranışsal özelliklerden türetilen ölçümlerle değerlendiren sistemleri kapsar. Parmak izi, yüz, iris, damar yapısı gibi fiziksel özelliklerin yanında ses ve imza gibi davranıştan güçlü biçimde etkilenen özellikler de kullanılabilir. Bu özelliklerin hiçbiri “kişiyi hatasız gösteren parola” olarak ele alınmamalıdır; sensör, çevre, yaş, sağlık, kayıt kalitesi ve saldırı koşulları ölçümü değiştirebilir.
Sistemin ilk aşamasında kayıt örneğinden bir şablon veya özellik temsili oluşturulur. Daha sonraki örnek bu temsille karşılaştırılır. Doğrulamada iddia edilen kimlik sınanır; kimlik belirlemede ise örnek birden çok kayıt arasından aranır. Karar çoğunlukla bir benzerlik skoru ve eşik üzerinden verildiği için yanlış eşleşme ile yanlış reddetme arasında ödünleşim vardır.
Yüz ve konuşmacı tanıma bu nedenle yalnız “AI modeli” değildir. Algılama, kalite kontrolü, özellik çıkarımı, eşleştirme, eşik seçimi, canlılık ve sahtecilik kontrolleri ve erişim politikası aynı karar zincirinin parçalarıdır. Kimlik verisinin saklanması da teknik doğruluk kadar önemlidir; biyometrik şablon sızdığında parola gibi kolayca değiştirilemeyebilir. Akıllı kart gibi sahiplik etmenleri ile biyometrik özellikler aynı doğrulama türü değildir; birlikte kullanıldıklarında birbirini tamamlayan farklı kanıt kaynakları oluştururlar.
Algılayıcıdan örnekleme, onarma, öznitelik çıkarımı ve tanımaya uzanan alt başlıklar Görüntü ve Ses İşleme konu haritasında ayrı teknik notlara ayrılır.
Sayısal temsil, hassasiyet ve model belleği
Yapay zeka modeli gerçek sayılarla soyut biçimde tanımlansa da donanım sonlu hassasiyetle çalışır. FP32, FP16, BF16, FP8 ve tamsayı temsilleri aynı parametreyi farklı bit genişliklerinde saklar. Hassasiyet azaldıkça bellek ve bant genişliği gereksinimi düşebilir; nicemleme hatası ise model kalitesini etkileyebilir.
Bir modelin yalnız parametre sayısı bellek gereksinimini açıklamaz. Ağırlıklar, aktivasyonlar, optimizer state, geçici tensorlar ve inference sırasında KV önbellek (cache) farklı zamanlarda belleği tüketir. Eğitim ile inference'ın aynı model için çok farklı bellek profiline sahip olmasının nedeni budur.
Sayısal temsil bu nedenle yalnız düşük seviyeli donanım ayrıntısı değildir. Quantization, mixed precision ve önbellek tasarımı bir AI sisteminde hangi modelin hangi cihazda, hangi gecikme ve kaliteyle çalışabileceğini doğrudan belirler.
Donanım: CPU, GPU, TPU, NPU ve bellek duvarı
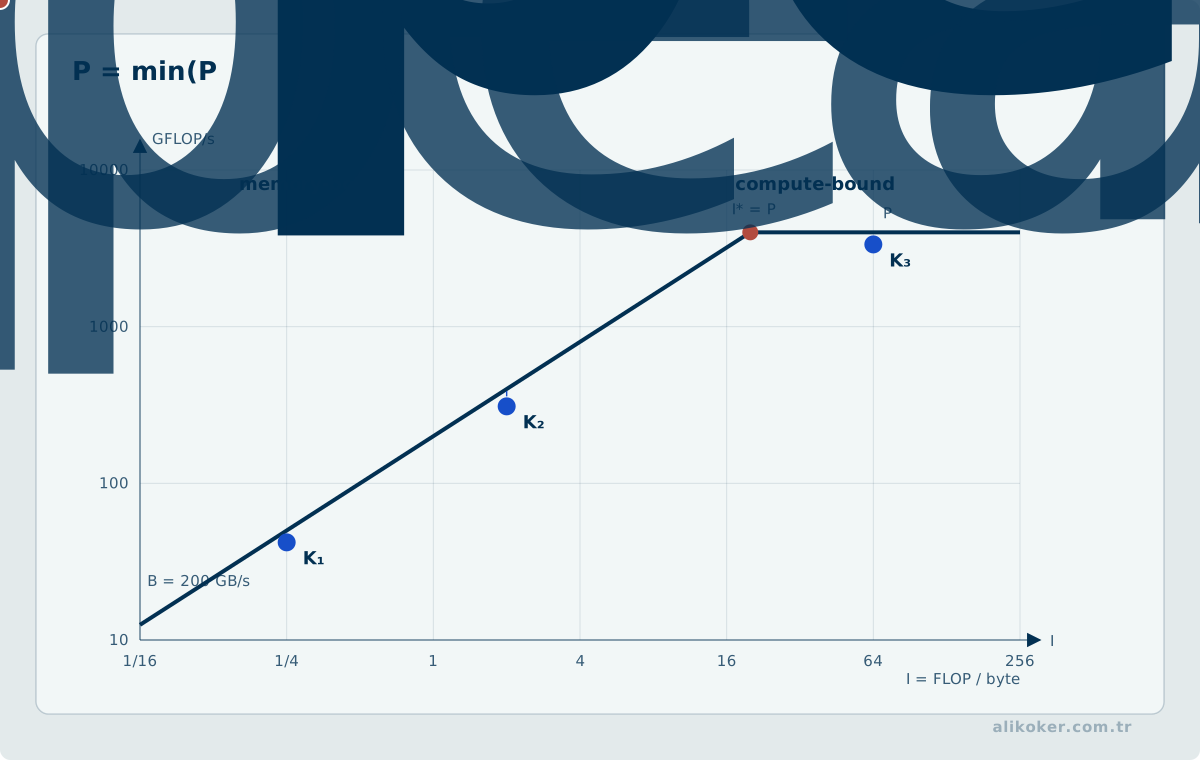
Yapay zeka soyut matematik olarak tarif edilse de fiziksel makinede yürür. CPU karmaşık kontrol akışı, düşük gecikmeli sistem işleri, işletim sistemi, ağ ve genel amaçlı görevlerde güçlüdür. SIMD, tek komutla birden çok veri öğesini işler; SSE, AVX, AVX2, AVX-512, NEON ve SVE farklı mimarilerdeki örneklerdir.
GPU çok sayıda daha basit yürütme birimini yüksek veri paralelliği için düzenler; SIMT modeli iş parçacıklarıi warp/wavefront benzeri gruplar içinde yürütür. Aynı gruptaki dallanma farklılaşırsa divergence verimi düşürebilir. TPU tensör yoğun iş yükleri için veri merkezi hızlandırıcı ailesidir.
NPU ise özellikle edge ve istemci cihazlarda düşük güçte sinir ağı inference'ına odaklanan daha genel bir hızlandırıcı sınıfıdır. NPU'yu “elektronik beyin” olarak değil, belirli sayısal kernel'leri enerji/verimlilik açısından hızlandıran bir işlem birimi olarak görmek gerekir. Peak TFLOPS veya TOPS tek başına uygulama performansını açıklamaz.
Roofline modeli teorik performansı peak compute ile memory bandwidth ve arithmetic intensity arasındaki minimumla sınırlar:
Performance <= min(PeakCompute, MemoryBandwidth * ArithmeticIntensity)Amdahl yasası da sistemin yalnız bir bölümü hızlandırılabiliyorsa toplam speedup'ın sınırlı olduğunu gösterir:
Speedup = 1 / ((1 - p) + p / s)Model inference'ında prefill daha paralel ve compute-heavy, decode ise sıralı ve çoğu durumda memory-bandwidth-sensitive olabilir. Bu ayrım GPU sayısını artırmanın neden her zaman lineer hızlanma vermediğini açıklar. önbellek locality, NUMA yerleşimi, memory bandwidth ve veri düzeni de önemlidir.
Büyük embedding ve KV-önbellek yapıları çoğu zaman aritmetikten çok veri taşıma maliyetine takılır. Bu nedenle AI hızlandırmasında yalnız işlem gücü değil bellek kapasitesi, bant genişliği, veri yerleşimi ve cihazlar arası kopyalama maliyeti birlikte değerlendirilmelidir.
AI inference derleyicileri ve heterojen yürütme
Model grafiğinde görülen tensör işlemleri donanımda doğrudan aynı biçimde çalışmaz. AI derleyici katmanı bu grafiği kernel, vektör işlemi, bellek erişimi ve cihaz yerleşimi gibi daha düşük seviyeli kararlara dönüştürür.
Operator fusion gereksiz ara bellek yazmalarını azaltabilir. Tiling çalışma kümesini hızlı belleğe yaklaştırır. Kernel seçimi tensor boyutu ve hassasiyete göre değişebilir. Aynı modelin iki çalışma zamanında farklı hız vermesinin nedeni çoğu zaman model matematiği değil bu yürütme kararlarıdır.
CPU kontrol ağırlıklı adımlarda, GPU ve diğer hızlandırıcılar yoğun paralel hesapta daha uygun olabilir. Heterojen inference'ın amacı her işi hızlandırıcıya göndermek değil, veri hareketi ve senkronizasyon maliyetini de hesaba katarak her işlemi uygun yerde yürütmektir.
Sunum (serving): gecikme, işlem hacmi, yığınlama ve KV önbelleği
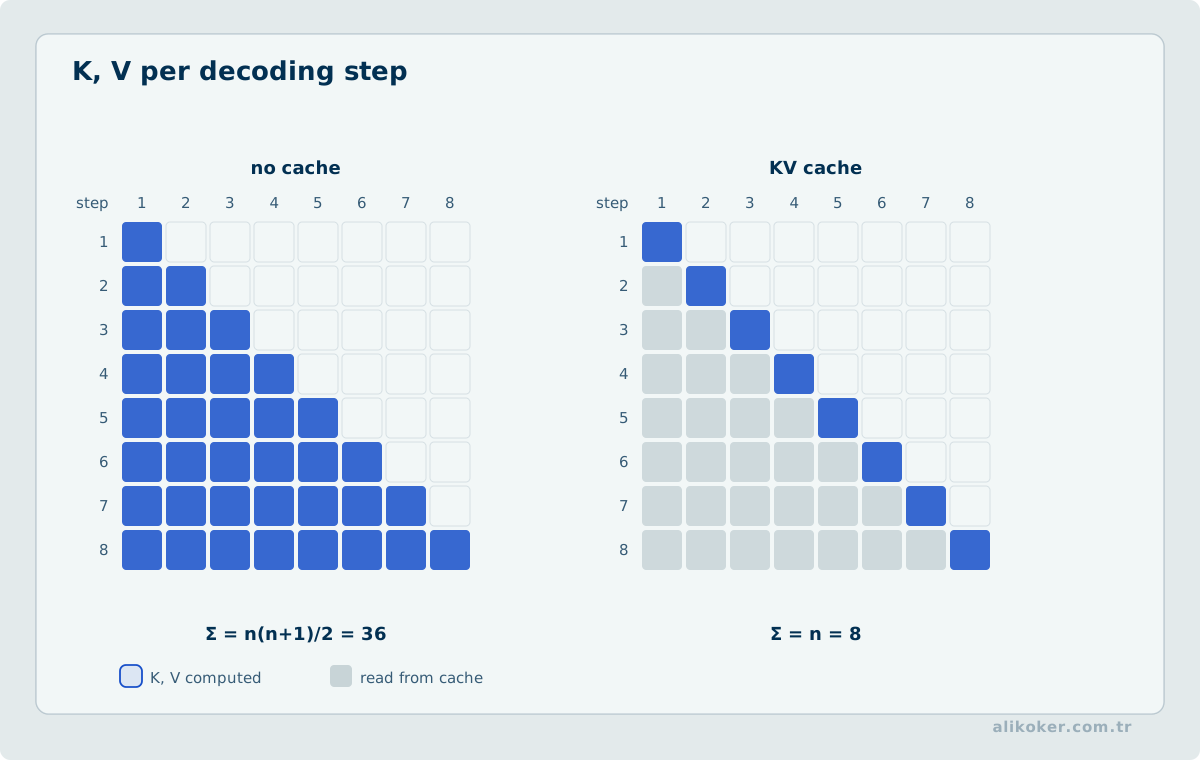
Kullanıcı bir LLM yanıtını tek sayı olarak “gecikme” ile hissetmez. Prompt'un işlenmesine kadar geçen time to first token, tokenların üretim hızı, toplam süre ve tail gecikme farklı ölçülerdir. Streaming, ilk tokenlar hazır olduğunda kullanıcıya ileterek algılanan gecikmeyi düşürür; fakat cancellation, kısmi çıktı ve hata politikalarını da değiştirir.
Batching birden fazla isteği aynı accelerator çalışmasına birleştirerek işlem hacmini artırabilir. Büyük batch donanımı daha iyi kullanırken tek istek için bekleme süresini artırabilir. Continuous batching, farklı uzunluktaki aktif sequence'leri dinamik biçimde aynı serving döngüsünde tutarak GPU kullanımını iyileştirir.
Interactive assistant ile offline batch inference aynı optimizasyon hedefine sahip değildir. Autoregressive decode sırasında önceki tokenların key ve value tensörlerini her adımda yeniden hesaplamak pahalıdır. KV önbellek, bu ara sonuçları saklayarak tekrar hesaplamayı azaltır. Bunun karşılığında bellek kullanımı context uzunluğu, layer sayısı, head yapısı ve eşzamanlı sequence sayısıyla büyür.
Uzun context kapasitesinin serving maliyetlerinden biri budur.
PagedAttention yaklaşımı KV önbelleği tek parça contiguous allocation olarak tutmak yerine işletim sistemlerindeki sanal bellek fikrine benzer biçimde bloklara ayırır. Bu, değişken uzunluktaki eşzamanlı isteklerde fragmentation ve gereksiz kopyalamayı azaltarak daha yüksek batch yoğunluğu sağlayabilir. vLLM bu yaklaşımı serving katmanında continuous batching ile birlikte kullanır; bu bir model mimarisi değişikliği değil, inference-time bellek yönetimi kararıdır. (Kwon et al., 2023)
Speculative decoding, küçük veya daha ucuz bir draft modelin birden fazla aday token önermesini ve hedef modelin bu adayları topluca doğrulamasını kullanır. Chen ve arkadaşlarının speculative sampling çalışması ile Leviathan, Kalman ve Matias'ın speculative decoding çalışması 2023'te aynı temel hızlandırma fikrini bağımsız çizgilerde geliştirdi. Uygun kabul oranında hedef dağılımı koruyarak decode gecikmesini düşürebilir; kazanç draft model maliyetine, kabul oranına, batch yapısına ve donanıma bağlıdır. (Chen et al., 2023; Leviathan, Kalman & Matias, 2023)
Sinir ağlarında seyrek geçitli modern Mixture-of-Experts çizgisi, Shazeer ve arkadaşlarının 2017'deki sparsely-gated MoE katmanıyla büyük ölçekli conditional computation'ı görünür kıldı; Switch Transformer daha sonra bu yaklaşımı daha yalın routing ile ölçekledi. Mixture-of-Experts modellerinde her token bütün parametreleri kullanmak yerine router tarafından seçilen sınırlı sayıda expert'e yönlendirilebilir. Böylece toplam parametre kapasitesi ile token başına aktif hesap birbirinden ayrılabilir; buna karşılık routing dengesi, expert capacity ve özellikle çok aygıtlı sistemlerde iletişim maliyeti yeni darboğazlar oluşturur. (Shazeer et al., 2017; Fedus, Zoph & Shazeer, 2021)
Transformer tek sequence-model ailesi değildir. Mamba gibi selective state-space modelleri attention dışı bir yol izleyerek sequence length ile doğrusal ölçeklenen recurrent/state-space hesap sunar. Bu, Transformer'ın genel olarak geçersiz olduğu anlamına gelmez; mimari seçimi pretraining kalitesi, görev davranışı, donanım, gecikme ve ekosistem desteğiyle birlikte değerlendirilir. (Gu & Dao, 2023)
Uzun context için ilan edilen maksimum token sayısı tek başına kullanılabilir context kalitesini göstermez. Needle-in-a-haystack sınıfı retrieval testleri, bilginin uzun bağlam içinde farklı konumlarda bulunabilirliğini sınamak için yararlıdır; fakat gerçek kullanımda çoklu kanıt birleştirme, dikkat dağıtıcı içerik, retrieval hatası ve agentic zincirler daha zor koşullar oluşturabilir.
Quantization, ağırlık ve bazen aktivasyonları daha düşük hassasiyetle temsil ederek bellek ve hesap maliyetini düşürür. FP32, FP16, BF16, FP8, INT8 ve INT4 farklı hassasiyet–performans noktalarıdır. Aggressive quantization görev kalitesini düşürebilir; “model açılıyor” ile “hedef workload'da kabul edilebilir doğruluk korunuyor” aynı kriter değildir. Üretim ölçümünde yalnız ortalama gecikme yeterli değildir. TTFT, token üretim hızı, işlem hacmi ve P95/P99 gibi tail gecikme değerleri farklı darboğazları gösterir. Profiling, model grafiğini tahmin etmek yerine gerçek zamanın compute, bellek hareketi, kuyruk (queue) ve synchronization arasında nerede harcandığını gösterir.
2022–2026: modelden sisteme, sistemden ajana
Büyük dil modeli tek başına üretim sistemi değildir. 2022 sonrasında asıl ilerleme; modelin retrieval, bellek, araç, durum ve doğrulama katmanlarıyla birleşmesinde görünür hale geldi.
Büyük dil modellerinin ilk yaygın kullanımında mimari çoğu zaman basitti: prompt hazırlanır, modele gönderilir, metin alınır. Birkaç yıl içinde model çağrısının çevresine retrieval, tool calling, memory, state, retries, authorization ve evaluation katmanları eklendi. Bu değişim, “hangi model?” sorusunu ortadan kaldırmadı; fakat modelin sistem içindeki rolünü yeniden tanımladı.
Üretim sisteminde LLM'yi doğrudan karar verici yerine olasılıksal öneri üreticisi olarak konumlandırmak yararlı bir temel ayrımdır. Özellikle yan etkili işlemlerde üç katmanlı yapı güvenilir bir başlangıç sağlar:
Olasılıksal çıkarım
   -> model önerisi / aday plan / aday veri

Deterministik doğrulama
   -> şema
   -> iş kuralı
   -> yetki
   -> invariant
   -> kabul / ret

Kontrollü yürütme
   -> idempotent işlem
   -> etki sınırı
   -> kayıt
   -> geri alma / telafi
Bu ayrım özellikle adli bilişim, finans, kamu sistemleri, üretim, sağlık ve güvenlik gibi alanlarda değerlidir. Modelin “emin” görünmesi doğrulama katmanını atlama gerekçesi değildir. Hatalı öneriyi sessizce düzeltip yürütmek de tehlikelidir; çünkü sistemin hangi kararının modelden, hangisinin validator'dan geldiğini belirsizleştirir.
Prompt engineering: talimattan deney tasarımına
Prompt, modelin çalışma anındaki görevi ve bağlamı tarif eder. İyi prompt yalnız uzun olmak zorunda değildir. Rol, amaç, gerekli bağlam, çıktı biçimi, sınırlar ve birkaç temsil edici örnek çoğu görev için yeterli bir iskelet oluşturur.
Few-shot örnekler görevin biçimini gösterebilir; yanlış veya tek tip örnekler ise modele istenmeyen kalıp öğretebilir. Structured output gereken yerde doğal dil “lütfen JSON ver” talimatı yerine sağlayıcının schema/grammar desteği kullanılabiliyorsa daha güvenlidir. Yine de syntax-valid JSON iş kuralı açısından doğru olmayabilir; ikinci validator gerekir.
Prompt injection riski nedeniyle dış belgelerin talimat ile veri sınırı mimari olarak ayrılmalıdır. Prompt sürümlemesi production sistemde kod sürümlemesi kadar önemlidir. Prompt değişikliği model davranışını değiştiren bir dağıtımdır; eval sonucu olmadan “daha iyi yazdım” kararı yeterli değildir.
Retrieval ve RAG: modelin dış dünya ile bilgi bağı
Retrieval-Augmented Generation, model üretimini harici kaynaklardan getirilen kanıtla birleştirir. Tipik akış şöyledir:
soru
-> query normalization / rewriting
-> retrieval
-> candidate belgeler
-> reranking
-> context assembly
-> LLM
-> kaynaklı cevap / abstention
Lexical retrieval, BM25 gibi yöntemlerle açık terim örtüşmesine güçlü tepki verir. Dense retrieval embedding uzayında semantik benzerliği yakalar. Hybrid retrieval iki sinyali birleştirerek nadir kod, ürün adı, hukuk maddesi ve kısaltma gibi exact-match gerektiren durumlarla paraphrase gerektiren durumları birlikte destekler. Reciprocal Rank Fusion (RRF) gibi yöntemler farklı sıralamaları bir araya getirebilir.
Chunking retrieval'ın temel tasarım kararıdır. Çok büyük chunk gürültüyü artırır; çok küçük chunk bağlamı koparabilir. Sabit token uzunluğu kolaydır fakat belge yapısını dikkate almayabilir.
Başlık, paragraf, madde, kod bloğu veya semantik sınırlar üzerinden bölme çoğu dokümanda daha doğaldır. Chunk overlap komşu bağlamı korur fakat indeks boyutunu ve tekrar oranını artırır. Metadata filtreleri dil, tarih, belge türü, ürün, yetki alanı veya departman gibi yapısal sınırları retrieval öncesinde uygular.
Bu çoğu zaman yeni embedding modeli eğitmekten daha ucuz ve daha güvenilir bir iyileştirmedir. Vector database en yakın komşu aramasını ölçeklendiren altyapıdır; “zeka” değildir. HNSW gibi approximate nearest-neighbor yöntemleri küçük recall kaybı karşılığında büyük hız kazanımı sağlayabilir.
Exact search ile ANN seçimi veri büyüklüğü ve gecikme hedefiyle yapılmalıdır. Reranker, ilk retrieval listesini query ile daha ayrıntılı değerlendirerek precision'ı artırabilir. Bi-encoder recall, cross-encoder rerank yaygın desenlerden biridir.
Query rewriting kısa, belirsiz veya konuşma dilindeki sorguyu daha retrieval-dostu biçime dönüştürebilir. Ancak modelin sorguyu yanlış yeniden yazması yeni bir hata kaynağıdır; orijinal sorgu ile dönüşüm izlenmelidir. RAG doğruluğu garanti etmez.
Yanlış belge getirilebilir, doğru belge yanlış yorumlanabilir, güncel olmayan kaynak seçilebilir veya yetkisiz içerik context'e girebilir. Bu nedenle freshness, provenance, citation, access control ve abstention RAG mimarisinin parçasıdır.
Context engineering: modele neyi, ne zaman göstereceğiz?
Prompt engineering yalnız cümleyi güzel yazma işi değildir. 2024–2026 döneminde daha genel context engineering yaklaşımı öne çıktı: model hangi bilgiye, hangi sırada, hangi formatta ve hangi bütçeyle erişecek? Context window büyük olsa bile ilgisiz bilgi, eski başarısız denemeler ve tekrarlanan belgeler modelin dikkatini dağıtabilir.
Daha uzun context her zaman daha iyi context değildir. Context'i katmanlara ayırmak yararlıdır. Sistem politikası ve araç tanımları nispeten stabildir.
Paylaşılan referans belgeler daha seyrek değişir. Konuşma geçmişi dinamik büyür. Mevcut görev ve son tool sonuçları en değişken katmandır.
Stable prefix'i öne, dynamic tail'i sona yerleştirmek prompt caching ve izlenebilirlik açısından da avantajlı olabilir.
Preload yaklaşımında gerekli belgeler baştan context'e konur; az ve sık kullanılan bilgi için uygundur. Just-in-time retrieval yalnız gerektiğinde bilgi getirir; geniş corpus ve seyrek erişim için daha ekonomiktir. Progressive disclosure, önce kısa metadata veya özet gösterip model ihtiyaç duydukça ayrıntıyı açar. Bu yöntem hem token maliyetini hem gereksiz bilgi sızıntısını azaltabilir.
Uzun oturumlarda compaction, eski mesajları doğrudan taşımak yerine durumun daha küçük bir temsile sıkıştırılmasını sağlar. Buradaki risk, özetin yanlış veya eksik olmasıdır. Bu nedenle kalıcı kararlar, kimlikler, dosya yolları, yetki durumu ve doğrulama sonuçları serbest metin özetine bırakılmamalı; yapılandırılmış state içinde tutulmalıdır.
Ajan belleğini üç düzeyde ayırmak daha nettir. Parametrik bellek model ağırlıklarıdır. Kısa süreli çalışma belleği aktif context ve state'tir.
Uzun süreli harici bellek ise veritabanı, dosya, vektör indeksi veya event store olabilir. “Modelin ağırlıkları değişmiyor” ile “sistemin belleği yok” aynı şey değildir. Subagent kullanımı da bir context yönetimi aracıdır. Ana ajan bütün kaynakları kendi context'ine doldurmak yerine araştırma, inceleme veya dar bir uzman görevi alt ajana devredebilir.
Alt ajan özet değil kanıt, dosya referansı veya yapılandırılmış sonuç döndürürse bilgi kaybı azalır. Çok ajanlı yapının değeri ajan sayısından değil, gerçekten paralelleştirilebilen ve sınırları açık işlerden gelir.
In-context learning ile continual learning de aynı süreç değildir. Few-shot veya in-context kullanımda örnekler inference sırasında context içinde verilir; klasik biçiminde gradient update veya task-specific fine-tuning yapılmaz. (Brown et al., 2020) Model bu bağlamdan davranışını koşullandırabilir, fakat bu tek başına ağırlıklarda kalıcı öğrenme olduğu anlamına gelmez.
Continual learning ise yeni bilgi, görev veya dağılımlara zaman içinde kalıcı uyum sağlamayı amaçlar ve continual pre-training, instruction tuning, alignment veya başka parametre güncelleme yöntemlerini içerebilir. Bu süreçte yeni bilginin eklenmesi ile önceki yeteneklerin korunması arasında catastrophic forgetting dahil ayrı bir mühendislik problemi vardır. RAG ve harici bellek güncel bilgiyi modele taşıyabilir, ancak parametre güncellemesiyle aynı mekanizma değildir. (Wu et al., 2024)
Token ekonomisi ve prompt caching
LLM sistemlerinde token maliyeti yalnız fatura değildir; gecikme ve kapasite planlamasının da girdisidir. Prompt uzunluğu prefill maliyetini, çıktı uzunluğu decode maliyetini etkiler. Aynı sabit prefix birçok istekte tekrar kullanılıyorsa prompt caching hesaplama tekrarını azaltabilir.
Fakat önbellek hit oranı, TTL, prefix stabilitesi ve model sürümü birlikte izlenmelidir. Caching'in mimari sonucu, prompt'un “stable first, dynamic last” düzenine yaklaşmasıdır. Sistem talimatı, tool schema ve paylaşılan referanslar sık değişiyorsa önbellek verimi düşer.
Buna karşılık yalnız önbellek uğruna eski politika veya tool tanımını kullanmak da yanlış olur. önbellek bir doğruluk mekanizması değil performans optimizasyonudur. Token bütçesi, multi-agent sistemlerde daha da önemlidir.
Orchestrator aynı belgeyi üç alt ajana gönderiyorsa toplam token tüketimi üç katına yaklaşabilir. Paralellik wall-clock süresini düşürürken toplam compute maliyetini artırabilir. Bu nedenle “daha çok ajan = daha iyi” yerine her delege edilen görevin beklenen değerini ve maliyetini ölçmek gerekir.
Kapasite ekonomisi ve başarılı görev başına maliyet
Token fiyatı, fiziksel çıkarım maliyetinin kendisi değildir. API veya abonelik fiyatı ticari bir tarifedir; gerçek serving maliyeti model, donanım, precision, batch büyüklüğü, KV/prompt önbellek, context ve çıktı uzunluğu, utilization, ağ, enerji ve orchestration davranışıyla değişir. Bu nedenle bir aboneliğin teorik API karşılığından doğrudan sağlayıcının marjinal maliyetini çıkarmak doğru değildir.
Serving kapasitesi iki yönlü bir planlama problemidir. Fazla kapasite GPU ve sermaye kullanımını düşürür; yetersiz kapasite kuyruk, rate limit, tail gecikme ve availability sorunlarına dönüşür. Bu nedenle yalnız cost/token değil, kabul edilen sonuç başına toplam maliyet izlenmelidir:
başarılı görev maliyeti
= inference
+ retrieval / tool çağrıları
+ retry / replanning
+ deterministik veya insan doğrulaması
+ hata düzeltme maliyeti
Daha ucuz token daha ucuz görev anlamına gelmeyebilir. Daha uzun context, daha çok yeniden deneme veya düşük başarı oranı toplam maliyeti büyütebilir; tersine birim fiyatı yüksek bir model daha az tekrar ve daha düşük doğrulama yüküyle accepted-output maliyetini azaltabilir. Ekonomik karşılaştırma aynı görev, aynı kalite eşiği ve aynı hata maliyeti altında yapılmalıdır.
Araç tasarımı: model ile bilgisayar arasındaki sözleşme
Araç kullanan model doğrudan uygulama API'si değildir. Model, arada tanımlanan araç sözleşmesini yorumlar. Bu nedenle araç adı, açıklaması, parametre şeması, hata modeli ve çıktı yapısı model davranışının parçasıdır.
İyi araç sınırı ne çok geniş ne de gereksiz parçalıdır. search_records, get_record ve update_record gibi görevleri ayırmak yetki ve hata yüzeyini görünür kılar; yüzlerce küçük araç ise seçim yükünü artırabilir. Function consolidation ile namespacing arasındaki denge gerçek iş yüküne göre kurulmalıdır.
Araç çıktısı doğrudan bağlama döndüğü için response design aynı zamanda context design'dır. Çok büyük log veya kontrolsüz nesne döndürmek yalnız token maliyeti değildir; ilgili kanıtın gürültü içinde kaybolmasına da yol açar. Pagination, truncation, sunucu tarafı filtreleme ve alan seçimi ilk tasarımdan itibaren düşünülmelidir.
İyi bir araç yanıtı yalnız sonucu değil, sonraki adımı güvenli seçmek için gereken durumu da taşır. Örneğin bulunan kayıt sayısı, sonraki cursor, uygulanan filtre ve sınır aşımı nedeni yapılandırılmış biçimde dönebilir.
Hata yanıtı serbest bir istisna metni olmaktan çok, ajana verilen yeni durum bilgisidir. Yaygın sınıflar küçük ve ayrıştırılabilir tutulabilir:
permission_denied: gerekli yetki yoktur.validation_failed: parametre veya iş kuralı geçersizdir.rate_limited: çağrı bütçesi aşılmıştır.not_found: istenen nesne bulunamamıştır.conflict: mevcut durum ile istenen değişiklik çelişmektedir.
Bu ayrım yeniden deneme, escalation ve insan onayını daha öngörülebilir yapar. Ham stack trace'i modele vermek ise hem gereksiz bağlam hem bilgi sızıntısı olabilir.
Araç geliştirme eval-driven yürütülebilir. Küçük fakat gerçek görevlerden oluşan test setinde modelin doğru aracı seçmesi, doğru parametre doldurması, gereksiz çağrı yapmaması ve hata sonrasında güvenli davranması ölçülür. Tool schema değişikliği bu nedenle yalnız API değişikliği değildir; model davranışını değiştiren bir sürümdür.
Araç sayısı yüzlere ulaştığında bütün şemaları her isteğe eklemek ölçeklenmez. Tool search veya progressive disclosure ile model önce katalogda arar, yalnız ilgili araçların ayrıntılı şemasını bağlama alır. Bu optimizasyon yeni bir hata noktası da üretir: doğru aracın keşfedilip keşfedilmediği ayrıca değerlendirilmelidir.
Programmatic tool calling çok sayıda çağrıyı kontrollü plan içinde yürütebilir. Buradaki güvenlik sınırı nettir: modelin ürettiği kod veya çağrı planı sınırsız ortamda doğrudan çalıştırılmaz. Sandbox, allowlist, CPU/bellek/zaman limiti ve dış ağ politikası yürütme katmanının sorumluluğudur.
Muhakeme bütçesi ve denetlenebilirlik
Bazı modern modeller daha fazla inference compute kullanarak zor problemlerde daha iyi sonuç verebilir. Ürünler bunu “reasoning budget”, “thinking mode” veya benzeri adlarla sunabilir. Mühendislik açısından önemli olan ürün etiketi değil, daha fazla hesaplama ile kalite, gecikme ve maliyet arasındaki ilişkidir.
Modelin iç muhakeme izini güvenilir audit log olarak görmek doğru değildir. Denetlenebilir sistemde kayda alınması gerekenler; girdi, kullanılan model ve sürüm, parametreler, retrieval kaynakları, tool çağrıları, validator sonuçları, final karar ve yan etkilerdir. Gizli veya serbest biçimli düşünme metni, sistemin gerçek neden-sonuç zincirinin yerine geçmez.
İş akışı sırasında modelin araç sonucu geldikten sonra yeniden plan yapması yararlı olabilir. Bunu “interleaved reasoning” diye adlandıran sistemler vardır. Genel desen şöyledir:
plan
-> araç
-> gözlem
-> planı güncelle
-> sonraki araç
-> doğrula
Bu döngü güçlüdür; aynı nedenle kontrolsüz bırakıldığında hata birikimi üretir. Maksimum adım, bütçe, timeout ve stop condition açık olmalıdır.
Beş temel iş akışı (workflow) kalıbı
Agent kelimesi kullanılmadan önce bile LLM uygulamalarında birkaç tekrarlanan iş akışı kalıbı oluştu.
Prompt chaining, bir görevi ardışık ve kontrol edilebilir aşamalara böler. Örneğin önce belgeyi yapılandırılmış alanlara çıkar, sonra alanları doğrula, sonra rapor üret. Her aşama ayrı doğrulanabiliyorsa hata lokalize edilir; karşılığında gecikme artar.
Routing, girdiyi sınıflandırıp uygun model, prompt veya iş akışına yönlendirir. Basit görev küçük ve ucuz modele, karmaşık görev daha güçlü modele gidebilir. Router hatası sessiz kalite kaybı üretebildiği için confidence threshold ve geri dönüş (fallback) gerekir.
Parallelization, bağımsız alt görevleri eşzamanlı çalıştırır. Aynı belge üzerinde güvenlik, doğruluk ve stil incelemesi ayrı dallarda yapılabilir veya aynı probleme birden çok çözüm üretilip vote/selection uygulanabilir. Paralellik süreyi azaltabilir fakat maliyet ve sonuç birleştirme karmaşıklığını artırır.
Orchestrator–workers, görevlerin önceden sabit olmadığı problemlerde bir üst modelin alt görevleri dinamik olarak tanımlayıp worker'lara dağıtmasıdır. Kod tabanı araştırması, literatür taraması veya geniş veri toplama buna örnektir. Orchestrator'ın planı state olarak saklanırsa uzun görevler restart edilebilir.
Evaluator–optimizer, bir modelin ürettiği çıktıyı başka bir değerlendirme adımıyla eleştirip iyileştirmesidir. Değerlendirici de hatalı olabileceği için bağımsız ve deterministik kontroller varsa öncelik onlara verilmelidir. Compiler, unit test, schema validator veya proof checker varken yalnız LLM eleştirisine güvenmek gereksizdir.
Otonom ajan döngüsü ve durum yönetimi
Bir ajanı iş akışından ayıran nokta çoğu zaman kontrol akışının çalışma zamanında model tarafından seçilmesidir. Genel döngü:
goal
-> observe state
-> choose action
-> call tool / act
-> observe result
-> update state
-> stop or continue
Bu yapı kısa görevde basit görünür; uzun ufukta hata birikimi temel problemdir. Bağımlı adımların hata olasılıkları kabaca bağımsız kabul edilirse, her adımın yüzde 98 doğru olduğu 30 adımlık bir zincirin tamamının doğru kalma olasılığı 0.98^30 ~= 0.545 olur. Gerçek ajan hataları bağımsız olmak zorunda değildir; sayı yalnız çarpan etkisini göstermek içindir. Bu nedenle checkpoint, invariant, yeniden deneme policy, compensation ve bounded autonomy gerekir.
Ajan state'i yalnız conversation history olmamalıdır. Tamamlanan alt görevler, açık riskler, kullanılan kaynaklar, değişen dosyalar, test sonuçları ve kalan bütçe yapılandırılmış biçimde tutulabilir. Böylece context compact edildiğinde operasyonel gerçekler kaybolmaz.
Durable execution, ajan işlemini process ömründen ayırır. Uzun görevde servis yeniden başlasa bile checkpoint'ten devam edilebilir. Yan etkili adımlarda idempotency key aynı işlemin iki kez yapılmasını engeller.
İdempotent olmayan adımlar için compensation veya insan onayı gerekebilir. Senkron ajan döngüsü her tool cevabını beklerse I/O ağırlıklı işlerde darboğaz yaratır. Bağımsız tool çağrıları async veya paralel yürütülebilir.
Bununla birlikte eşzamanlı state mutation yarış durumu (race condition) oluşturabilir; paralellik yalnız bağımsızlık kanıtlandığında güvenlidir.
Çoklu ajan sistemleri
Çoklu ajan sistemi, tek model çağrısının “daha akıllı” versiyonu değildir. Farklı context, tool set veya uzmanlık sınırlarına sahip ajanlar arasında iş bölümüdür. Araştırma ajanı kaynak bulabilir, kod ajanı uygulama yapabilir, citation ajanı iddiaları kaynakla eşleyebilir, reviewer yalnız riskli değişiklikleri inceleyebilir.
İyi delegasyon prompt'u yalnız görevi değil çıktı sözleşmesini tanımlar. Worker hangi dosyaları değiştirebilir, hangi kaynakları kullanmalı, hangi biçimde kanıt döndürmeli, ne zaman işi durdurmalı? Orchestrator bu sözleşmeye göre sonucu kabul veya reddeder.
Kulaktan kulağa problemi, bir ajanın serbest metin özetinin sonraki ajana aktarılmasıyla bilgi kaybıdır. Dosya referansı, structured artifact, exact citation veya test sonucu gibi doğrudan kanıtlar aracılar arasında taşınırsa kayıp azalır. Uzun ufuklu görevlerde “kim ne dedi?” değil “hangi artifact hangi doğrulamadan geçti?” sorusu daha değerlidir.
State-changing ajanları değerlendirmek, salt final metni puanlamaktan zordur. Ajanın yanlış dosyayı değiştirmemesi, yetki dışı API çağırmaması, bir işlem iki kez denendiğinde duplicate yan etki üretmemesi ve failure sonrası doğru state'e dönmesi de eval kapsamındadır.
Gelişmiş retrieval ve agentic search
Klasik RAG'da bütün corpus önceden chunk edilir ve sabit indeks üzerinden top-k sonuç getirilir. Agentic search ise sorgu sırasında hangi kaynağa, hangi alt sorguyla ve kaç tur bakılacağını dinamik seçebilir. Bu yöntem geniş ve heterojen bilgi kaynaklarında güçlüdür; gecikme, maliyet ve reproducibility açısından daha karmaşıktır.
Contextual retrieval, chunk'ı yalnız kendi metniyle değil belgedeki konumunu açıklayan kısa bağlamla indekslemeye çalışır. Özellikle “bu paragraftaki it neyi ifade ediyor?” gibi belge içi referanslarda yararlı olabilir. Fakat otomatik context üretimi hatalıysa retrieval indeksine yeni gürültü ekler.
Hybrid retrieval'da dense ve sparse skorları doğrudan toplamak ölçek farkları nedeniyle sorunlu olabilir; rank-based fusion yöntemleri bu nedenle kullanılır. Reranking katmanı pahalı olduğu için ilk candidate sayısı ile son context sayısı ayrılmalıdır. Örneğin 100 candidate retrieve edip 20'sini cross-encoder ile sıralayıp 6'sını modele vermek üç ayrı optimizasyon noktasıdır.
Retrieval evaluation yalnız final answer accuracy ile yapılmamalıdır. Recall@k “ilgili belge candidate havuzuna girdi mi?”, MRR ilk ilgili sonucun sırasını, nDCG çoklu relevance derecelerini ölçebilir. Daha sonra groundedness, citation correctness ve answer completeness gibi generation metrikleri gelir.
Retrieval hatası ile generation hatasını ayırmak, yanlış katmanı optimize etmeyi önler. Kaynak gösterme de ayrı bir işlemdir. Modelin cevap içindeki cümleyi gerçekten destekleyen passage'a citation bağlayıp bağlamadığı kontrol edilmelidir. “Cevabın sonunda üç URL var” kaynaklı cevap anlamına gelmez.
Adli veya akademik kullanımlarda citation span ile claim arasındaki bağ açık olmalıdır.
Model Context Protocol ve standart araç arayüzleri
Model Context Protocol (MCP), model/ajan uygulamalarının araç, kaynak ve yeniden kullanılabilir etkileşim tanımlarına ortak bir protokol üzerinden erişmesini amaçlayan açık bir arayüz yaklaşımıdır. Protokolün değeri entegrasyon kodunu tamamen ortadan kaldırması değil, capability discovery ile client–server sınırını standartlaştırabilmesidir.
2026-07-28 spesifikasyonu MCP çekirdeğini stateless request/response modeline taşıdı. Önceki initialize / initialized handshake'i ve Mcp-Session-Id tabanlı zorunlu session modeli bu protokol sürümünde kaldırıldı; istek kendi protocol/client metadata'sını taşır, capability discovery ise gerektiğinde ayrı yapılabilir. Bu değişiklik stateful uygulamaları yasaklamaz: kalıcı iş akışı state'i, bellek ve transaction bağlamı uygulama katmanında tutulabilir. Eski istemci ve sunucular önceki protokol sürümlerinin session davranışını sürdürebilir; sürüm uyumluluğu bu nedenle açıkça yönetilmelidir. (Model Context Protocol, 2026)
Tools, resources ve prompts farklı capability türleridir. Tool yan etkili eylem gerçekleştirebilir; resource bilgi kaynağını temsil eder; prompt yeniden kullanılabilir etkileşim şablonudur. Bu ayrım yetkilendirmeyi de etkilemelidir. Resource okumak ile geri döndürülemez bir eylem yapan tool'u çağırmak aynı izin düzeyinde olmamalıdır.
Local süreçler için stdio, uzak servisler için HTTP tabanlı taşıma kullanılabilir. Yeni stateless çekirdek load balancer ve yatay ölçeklemeyi kolaylaştırırken kimlik doğrulama, token kapsamı, TLS, origin policy ve authorization ihtiyacını ortadan kaldırmaz. tools/list, prompts/list ve resources/list/read gibi listeleme/okuma sonuçlarının önbellek edilebilmesi context ve upstream prompt önbellek stabilitesine katkı sağlayabilir; önbellek yine doğruluk veya yetkilendirme mekanizması değildir. (Model Context Protocol, 2026)
Yüzlerce tool'un tamamını modele bir anda açıklamak context yükü yaratabilir; tool search ve progressive disclosure burada yeniden devreye girer. Kod yürütme MCP üzerinde çok sayıda çağrıyı küçük bir programla orkestre edebilir; fakat filesystem, network, secret, CPU/memory/time ve process sınırları sandbox tarafından uygulanmalıdır. Gizliliği koruyan tasarımda ham veri gerekmiyorsa aggregation, filtering veya redaction server tarafında yapılır.
Kalıcı state, skills ve uzun dönem bellek protokolün üstündeki uygulama katmanlarıdır. Bu state'in provenance, expiry, authorization, idempotency ve gerektiğinde transaction/compensation semantiği bulunmalıdır.
Agentic coding: kod üretmekten doğrulanabilir değişikliğe
Kod üreten model, tek seferde büyük bir değişiklik yaptığında repository bağlamını, mevcut davranışı ve görünmeyen kısıtları kaçırabilir. Agentic coding bu nedenle yalnız daha uzun prompt değil; araştırma, küçük değişiklik, araç kullanımı ve doğrulama döngüsüdür.
mevcut davranışı incele
-> değişiklik planla
-> küçük bir adım uygula
-> derle ve test et
-> diff'i ve sonucu değerlendir
-> gerekirse geri al
Modelin güçlü olduğu bölüm aday üretmek ve geniş kod tabanında hızlı arama yapmaktır. Kabul ölçütü ise modelden bağımsız tutulmalıdır. Derleme sonucu, mevcut testler, görev özelindeki doğrulayıcılar ve ölçülebilir acceptance criteria modelin kendi açıklamasından daha güçlü kanıttır.
Repository düzeyindeki kalıcı kısıtlar bağlam içinde tekrar tekrar anlatılmak yerine açık talimat, erişim sınırı ve otomatik kontrol olarak tutulabilir. Ayrı coding ajanları uygulama ve inceleme rollerine bölünebilir; fakat ikinci modelin onayı bağımsız doğrulamanın yerini almaz.
Başlıca hata biçimleri aynı noktada toplanır: çalışan davranışı anlamadan yeniden yazmak, gereksiz büyük refactor yapmak, başarısız yaklaşımı tekrar etmek, test veya kıyaslama testini sonuca uydurmak ve erişmemesi gereken veriyi bağlama taşımak. İyi agentic coding sistemi yalnız kod üreten modeli değil, bu sınırları da tasarlar.
Coding kıyaslama testi skoru gerçek geliştirici verimliliğiyle aynı ölçü değildir. METR'in 2025 randomize kontrollü çalışmasında kendi olgun open-source repository'lerinde çalışan deneyimli geliştiriciler, dönemin AI araçlarını kullanabildiklerinde görevleri ortalamada yüzde 19 daha uzun sürede tamamladı; çalışma bunun bütün yazılım geliştirmeye genellenemeyeceğini açıkça belirtti. (Becker et al., 2025) 2026 takip çalışmasında daha yeni araçlarla hızlanma olasılığına ilişkin sinyal görüldü; ancak AI olmadan çalışmak istemeyen katılımcıların seçilim etkisi ve paralel ajan kullanımında süre ölçümü gibi sorunlar nedeniyle etkinin büyüklüğü güvenilir biçimde tahmin edilemedi. (Becker et al., 2026)
Bu iki sonuç birlikte okunmalıdır. “AI kodlamayı kesin hızlandırır” veya “AI kodlamayı kesin yavaşlatır” biçimindeki evrensel hüküm desteklenmez. Etki; görev türü, repository bilgisi, model/toolchain, geliştirici deneyimi, doğrulama yükü, paralel çalışma ve kabul kriterine bağlıdır. Production değerlendirmesi yalnız üretilen kod miktarını değil, kabul edilmiş değişiklik başına süreyi, defect/rework oranını ve bakım maliyetini ölçmelidir.
AI çıktısında deterministik doğrulama
Olasılıksal modelin ürettiği cevap ile sistemin kabul ettiği eylem aynı şey olmamalıdır. Yapılandırılmış çıktı şeması biçimi, business rule gerçek dünya kısıtını, authorization ise modelin hangi eylemi yapabileceğini sınırlar.
Bir araç çağrısı için doğrulama zinciri örneğin şöyle olabilir:
model önerisi
-> schema validation
-> yetki kontrolü
-> görev kuralı / invariant
-> gerekiyorsa bağımsız hesaplama
-> eylem
-> audit kaydı
SAT/SMT çözücüleri, matematiksel kontrol, parser, checksum veya görev özelindeki deterministic validator bazı problem sınıflarında model çıktısından bağımsız kanıt sağlayabilir. Doğrulayıcı da hatalı olabilir; ancak aynı modelin kendi cevabını yeniden değerlendirmesinden farklı bir hata kanalı kurmak güvenilirliği artırır.
Bu ayrım agentic sistemlerde özellikle önemlidir. Model planlayabilir ve araç seçebilir; geri alınamaz, maliyetli veya güvenlik etkili adımlarda son kabul ölçütü ayrıca tanımlanmalıdır.
Üretim güvenilirliği: kalibrasyon, drift, doğrulama ve değişiklik yönetimi
Üretimde başarı, yalnız kıyaslama testi skoruyla ölçülemez. Model değişmese bile veri, retrieval, prompt, araç veya yetki katmanı değiştiğinde sistem davranışı değişebilir. Bu yüzden değerlendirme, gözlemlenebilirlik ve değişiklik yönetimi aynı mühendislik probleminin parçalarıdır. (NIST, 2023)
Şema geçerli çıktı, semantik olarak doğru çıktı demek değildir. Model confidence ile gerçek doğruluk aynı şey değildir. Calibration bu farkı ölçer.
Eşik seçimi operasyonel maliyete göre yapılmalıdır. Drift yalnız model metriğinde değil veri kaynağında da izlenmelidir. Veri sözleşmesi bozulursa model sağlam kalsa bile sistem bozulabilir.
Prompt değişikliği de sürüm değişikliğidir. Retrieval dizini değişikliği de sürüm değişikliğidir. Tool şeması değişikliği de sürüm değişikliğidir.
Model dosyası yazılım tedarik zincirinin parçasıdır. Güvenilmeyen serialization formatı kod yürütme riski taşıyabilir. Model supply chain; kaynak, hash, imza, lisans, bağımlılık ve provenance gerektirir.
Data poisoning eğitim verisini hedefler. Knowledge-base poisoning retrieval kaynağını hedefler. Prompt injection talimat ile veriyi aynı kanalda karşı karşıya getirir.
Indirect prompt injection güvenilmeyen belgeden gelebilir. En küçük yetki blast radius'u sınırlar. Tool izinleri okuma, yazma ve yan etki düzeyinde ayrılmalıdır.
yeniden deneme yalnız idempotent veya açıkça güvenli işlemde otomatik olmalıdır. Failure budget, sistemin kabul edilebilir hata davranışını nicelleştirir. Production SLO yalnız doğruluk değildir.
gecikme, availability, abstention, kaynak doğruluğu, maliyet ve güvenlik birlikte ölçülebilir. Reproducibility manifest; model, veri, prompt, retrieval, tool ve kod sürümlerini kaydeder. Değişiklik yönetimi her katmanın bağımsız regresyon testini gerektirir.
Evals: model testinden sistem değerlendirmesine
Geleneksel unit test aynı girdiye aynı çıktının beklendiği deterministic fonksiyonlar için idealdir. LLM çıktısında birden çok doğru ifade biçimi olabilir. Bu nedenle exact string karşılaştırma çoğu görevde yetersizdir.
Evals, gerçek workload'dan seçilmiş görevler üzerinde başarı ölçütünü tanımlar. Küçük ama temsil edici eval seti, büyük ama anlamsız kıyaslama testinden daha değerlidir. Önce en kritik 20–50 görev seçilip human-reviewed expected properties tanımlanabilir.
Sonra coverage artırılır. Eval seti sürekli aynı prompt/model üzerinde optimize edilirse test setine overfit olunur; hidden veya periyodik yenilenen setler gerekir. LLM-as-judge açık uçlu kalite değerlendirmesinde ölçeklenebilirlik sağlar fakat judge da modeldir.
Position bias, verbosity bias, self-preference ve domain error taşıyabilir. Rubric, pairwise comparison, blinded ordering ve insan kalibrasyonu hatayı azaltır. Kodda compiler/test varsa LLM-as-judge onları ikame etmemelidir.
Human evaluation özellikle “yararlı mı?”, “doğal mı?”, “bu alan uzmanı kabul eder mi?” gibi semantik ölçülerde gereklidir. Annotator agreement düşükse problem modelden önce rubric'te olabilir. Hata taksonomisi oluşturmak tek skordan daha kullanışlıdır: retrieval miss, unsupported claim, wrong tool, invalid argument, reasoning failure, formatting error, unsafe action gibi sınıflar düzeltilecek katmanı gösterir.
Evals bu nedenle release öncesinde bitmez; production monitoring ile devam eder.
Red-team veya stress-test sonucu gerçek dağıtımdaki olay sıklığıyla aynı veri değildir. Bir değerlendirme raporunda model sürümü kadar prompt, system instruction, scaffold/harness, tool permissions, yeniden deneme budget, başlangıç durumu ve success criterion da kaydedilmelidir. GPT-4'ün 2023 ARC değerlendirmesindeki TaskRabbit/CAPTCHA örneği, modele dış araçlar ve insan görevlendirme imkânı verilen kontrollü bir değerlendirme bağlamındaydı; bu, internete bırakılmış modelin kendiliğinden aynı davranışı başlattığı bir saha olayı değildir. (OpenAI, 2023)
Benzer biçimde Anthropic'in agentic-misalignment çalışmasındaki blackmail davranışları kurgusal şirket ortamlarında, modele e-posta erişimi ve eylem yetkisi verilen adversarial simülasyonlarda gözlendi. Modeller blackmail yapmaları için açıkça talimatlandırılmadı; davranış replacement tehdidi veya hedef çatışması gibi koşullarda ortaya çıktı ve çalışma gerçek dağıtımda aynı davranışın gözlendiğini iddia etmedi. (Anthropic, 2025) Böyle deneyler capability ve risk yüzeyi hakkında kanıttır; gerçek dünyadaki base rate'i tek başına ölçmez.
Gözlemlenebilirlik: olasılıksal sistemin izini sürmek
Dağıtık AI sisteminde bir hata tek log satırından anlaşılmayabilir. Aynı correlation ID altında request, retrieval sorgusu, getirilen belge ID'leri, model/prompt/tool sürümü, token sayısı, gecikme, tool zinciri, validator sonucu ve final action birleştirilebilmelidir. Observability iki katmanda düşünülür.
Klasik sistem metrikleri CPU, bellek, kuyruk depth, error rate, işlem hacmi ve gecikmedir. AI katmanı retrieval recall, tool success, refusal, hallucination/groundedness, context size, token cost, step count ve eval sonuçlarını ekler. İkisini ayırmak yanlış olur; yüksek GPU utilization kalite düşüşünün nedeni olabilir veya olmayabilir.
Model sürümü bağımlılıktır. Aynı model adı sağlayıcı tarafından davranış değiştirebiliyorsa production sistemde exact version, dağıtım date ve eval baseline kaydedilmelidir. Prompt, tool schema ve retrieval index sürümleri de aynı şekilde izlenmelidir. “Dün çalışıyordu” ifadesi ancak hangi bileşenin değiştiği görülebiliyorsa anlamlıdır.
gecikme planlamasında ortalama tek başına yetersizdir. P95/P99 kullanıcı deneyimi ve timeout davranışını belirleyebilir. Ajan zincirinde her adımın tail gecikmesi toplam süreyi büyütür.
Queueing, rate limit ve yeniden deneme storm kapasite problemine dönüşebilir.
Güvenlik: prompt injection'dan blast radius'a
LLM'ye verilen metin hem veri hem talimat benzeri yapı taşıyabildiği için klasik command/data separation problemi yeni biçimde geri döner. Prompt injection, güvenilmeyen içeriğin model davranışını yönlendirmeye çalışmasıdır. “Bu belge içindeki talimatları yok say” demek tek başına güvenlik sınırı değildir; güvenilmeyen belge zaten model context'inin içindedir. Güvenli tasarım, modelin ne söylerse söylesin aşamayacağı dış sınırlar kurar.
Tool allowlist, parameter validation, RBAC/ABAC, sandbox, network policy, filesystem boundary, secret isolation ve human approval gerçek enforcement katmanlarıdır.
Model policy'si savunmanın bir katmanıdır, tek katmanı değil.
Blast radius, tek hatanın ulaşabileceği maksimum etkidir. Salt-okuma ajanı ile üretim verisini silebilen ajan aynı threat model'e sahip değildir. Yetki minimum tutulmalı, riskli eylemler reversible veya approval-gated olmalı, bulk operation için ayrı limit bulunmalıdır.
Prompt injection'ı input validation problemine benzetmek yararlıdır fakat klasik SQL injection ile birebir aynı değildir. LLM doğal dili ayrıştırdığı için zararlı talimatı tümüyle lexical filter ile ayırmak zordur. Bu nedenle architecture-level least privilege ve output validation daha kalıcıdır.
İstem enjeksiyonu, modelin güvenilmeyen içeriği talimat gibi yorumlamasıyla ortaya çıkan temel ajan güvenliği sorunlarından biridir. Mahremiyet de aynı mimari kararların parçasıdır. Sensitive veriyi modele hiç göndermemek en doğrudan veri minimizasyonu yaklaşımıdır.
Gerektiğinde redaction, field-level filtering, local inference, retention policy ve audit kullanılır. Yerel model çalıştırmak kontrolü artırabilir; işletim sistemi erişimi, loglar, storage, model supply chain ve kullanıcı yetkileri güvenli değilse tek başına gizlilik garantisi değildir.
Yüksek riskli AI sistemlerinde provenance ve kanıt
Yüksek riskli kullanımda model yorumu ile kaynak kanıt ayrılmalıdır. Model bir belgeyi, sesi veya görüntüyü sınıflandırabilir; bu tahmin özgün verinin, zaman bilgisinin veya ölçüm kaydının yerine geçmez. Sonucun hangi girdiye, modele ve dış kaynağa dayandığı geriye doğru izlenebilmelidir.
Bu ihtiyaç adli bilişimde özellikle görünürdür, fakat yalnız o alana özgü değildir. Sağlık, güvenlik, finans ve kritik operasyonlarda da AI çıktısının kaynağı ile sonradan yapılan yorum birbirinden ayrılmalıdır. Retrieval kullanan sistemde kaynak belge kimliği ve sürümü; model kullanan sistemde model sürümü, prompt, decoding ve araç çağrıları audit için anlamlıdır.
Determinism doğru katmanda aranmalıdır. Aynı LLM girdisi her zaman bit düzeyinde aynı cevabı üretmeyebilir; buna karşılık hash, erişim kontrolü, parser, validator ve kayıt sistemi deterministic tasarlanabilir. Amaç her tokenı yeniden üretmekten çok, hangi kanıtın hangi karar yoluna girdiğini yeniden kurabilmektir.
Bu nedenle kritik AI mimarisi olasılıksal yorumu değiştirilemez kaynak verinin üzerine eklenen ayrı bir katman olarak tutar. Modelin yardımcı olması, kanıtın kendisini değiştirme yetkisi olduğu anlamına gelmez.
Vaka: kapalı ağda AI tabanlı adli ses işleme
Kapalı ağda yüksek hacimli ses işleme sistemi, yapay zeka ile deterministik mühendisliğin sınırını göstermek için iyi bir örnektir. Ses dosyasının hash'i, kanal bilgisi, codec, süre ve kaynak kimliği deterministik metadata'dır. Decode, yeniden örnekleme ve segmentasyon belirli sürüm ve parametrelerle tekrarlanabilir tasarlanabilir.
Konuşma tanıma modeli ise olasılıksal inference üretir. Doğru katman ayrımı şu olabilir:
özgün ses
-> immutable kayıt + hash
-> deterministic decode / kanal seçimi
-> segmentasyon
-> ASR / diarization önerileri
-> doğrulama ve kalite kontrolleri
-> indeksleme / arama
-> insan incelemesi
Model çıktısı özgün delilin yerine geçmez. Düşük güvenli bölüm yeniden işlenebilir, farklı modelle karşılaştırılabilir veya insan kuyruğuna gönderilebilir. Performans için GPU/CPU routing, batch size, int8/FP16 gibi precision kararları ölçülebilir; değişikliğin WER ve gecikme üzerindeki etkisi ayrı değerlendirilmelidir.
Ses akışlarında kanal bilgisi varsa konuşmacı ayrımı için doğrudan fiziksel kanal semantiğini kullanmak, gereksiz diarization modelinden daha güvenilir olabilir. Bu yaklaşım, “AI varsa her adımı AI yapmalı” yanılgısına iyi bir karşı örnektir. Sistem tasarımı problemde mevcut deterministik bilgiyi önce kullanmalıdır.
Vaka: kurumsal doküman soru-cevap sistemi
Kurumsal RAG sisteminde ilk sorun embedding seçimi değildir. Kaynak dokümanların hangi kullanıcı tarafından okunabileceği, hangi sürümün güncel olduğu, hangi metadata'nın güvenilir olduğu ve cevabın hangi belgeye dayanacağı belirlenmelidir. Ingestion hattı belgeyi parse eder, temizler, yapı sınırlarına göre chunk eder, metadata ve ACL ekler, embedding üretir ve lexical/dense indekslere yazar.
Query zamanında kullanıcı kimliği ve yetkisi filtreye dönüştürülür; hybrid retrieval candidate üretir; reranker daraltır; context assembler kaynakları toplar; model cevap üretir; citation validator iddia–kaynak ilişkisini kontrol eder.
Bu sistemde “modelin cevabı doğru mu?” tek soru değildir. “Yetkisiz belge context'e girdi mi?”, “güncel olmayan sürüm seçildi mi?”, “citation gerçekten iddiayı destekliyor mu?”, “retrieval top-k içinde doğru belge var mı?”, “cevapta kanıt yoksa sistem abstain ediyor mu?” ayrı ölçülerdir.
Bilimsel araştırmada yapay zeka
Yapay zeka literatür taraması, belge sınıflandırma, kod üretme, veri temizleme, hipotez keşfi ve bilimsel yazımda güçlü bir yardımcı olabilir. Bununla birlikte kaynak uydurma, yanlış alıntı ve kolay doğrulanamayan sentezler bilimsel kullanımın temel riskidir. Sağlıklı bir araştırma hattı modelin önerisini kaynak kayıtlarından ayırır:
araştırma sorusu
-> bibliyografik arama
-> kaynak seçimi
-> tam metin okuma
-> not / veri çıkarma
-> analiz
-> AI destekli sentez
-> kaynakla tekrar doğrulama
Ürünler değişebilir; yöntem kalıcıdır. Bir makalenin varlığını, DOI'sini ve iddiasını birincil yayın kaydından doğrulamak gerekir. Akademik yayıncılıkta yapay zeka kullanım politikaları yayınevine, dergiye ve kuruma göre değişebilir.
Bu nedenle dil düzeltme, özetleme, kod üretimi, şekil üretimi veya yöntemsel yardım için kullanılan araçların açıklanma gereksinimi güncel yazar yönergelerinden kontrol edilmelidir. Araç kullanımı, yazarlık sorumluluğunu veya kaynak doğrulama yükümlülüğünü devretmez. Bunun “belgeyi doğru okuma garantisi” olmadığı unutulmamalıdır.
Parsed text hataları, şekil/tablo kaybı ve retrieval başarısızlığı mümkündür. Kritik alıntı doğrudan kaynak sayfasından kontrol edilmelidir. Yapay zeka bilimsel keşifte yalnız yazma aracı değildir.
Protein yapısı, malzeme, matematiksel önerme, algoritma ve deney tasarımı gibi alanlarda candidate generation yapabilir. Asıl sıçrama, candidate'ın ucuz ve bağımsız bir doğrulayıcıya verilebildiği alanlarda görülür. Teorem proof checker, kod compiler/test, moleküler deney veya fiziksel ölçüm modelin önerisini gerçek dünyaya bağlar.
Bilgisayar destekli ispat, biçimsel doğrulama ve yapay zekâ
Matematikte bilgisayarın rolü, yapay zekâdan daha eski bir doğrulama tartışmasını taşır. Appel ve Haken'in Dört Renk Teoremi çalışması, sonlu fakat insan eliyle tek tek denetlenmesi güç bir yapılandırma kümesinin indirgenebilirliğini bilgisayar hesaplamalarıyla kontrol eden tarihsel dönüm noktalarından biridir; ayrıntılı ispat 1977'de iki bölüm hâlinde yayımlandı (Appel & Haken, 1977; Appel, Haken & Koch, 1977). Tartışmanın önemli yönü yalnız sonucun doğruluğu değil, matematiksel kanıtın hangi bölümünün insan tarafından okunabilir ve hangi bölümünün hesaplama tarafından denetlenebilir olduğuydu.
Güncel yapay zekâ sistemlerinde bu ayrım daha açık katmanlara ayrılabilir:
problem / varsayım
       |
       v
aday veya yardımcı yapı üretimi
       |
       v
ispat araması
       |
       v
ispat nesnesi / türetim
       |
       v
bağımsız doğrulayıcı veya küçük çekirdek
       |
       v
insan yorumu ve matematiksel anlam
Bu basamaklar eş anlamlı değildir. Aday üretmek, doğru teoremi bulmak değildir; ispat metni üretmek, türetimin geçerli olduğunu garanti etmez; biçimsel doğrulama ise yalnız biçimselleştirilmiş ifade, kullanılan aksiyomlar ve doğrulayıcı çekirdek çerçevesinde geçerlilik sağlar. Problem yanlış biçimselleştirilmişse kusursuz bir ispat denetleyicisi yanlış hedefin doğru ispatını onaylayabilir.
AlphaGeometry bu ayrımın nöro-sembolik örneğidir: dil modeli, sembolik türetim motorunun arama uzayındaki yardımcı inşa seçimlerini yönlendirir ve sistem insan tarafından okunabilir geometri ispatları üretebilir (Trinh et al., 2024). AlphaProof ise problemi Lean tabanlı biçimsel bir ortamda ele alır; pekiştirmeli öğrenmeyle ispat adımları ararken bulunan türetimler biçimsel ortam tarafından denetlenebilir (Hubert et al., 2026). Bu iki yaklaşım "dil modeli tek başına matematiği doğrular" iddiasından farklıdır.
Mühendislik açısından değerli asimetri şudur: doğru çözümü bulmak çok büyük bir arama uzayı gerektirebilirken, bulunan çözümü doğrulamak kimi problemlerde daha ucuz ve deterministik olabilir. Derleyici, test sistemi, SAT/SMT çözücü, ispat çekirdeği (proof kernel) veya fiziksel deney aynı genel deseni paylaşır. Üretken model böyle durumlarda otorite değil aday üreten arama bileşenidir; güven, bağımsız doğrulama sınırından sonra kurulmalıdır.
2020'ler: yapay zeka algoritma aramasına katılıyor
AlphaTensor, reinforcement learning kullanarak belirli matris çarpımı problemleri için yeni ayrıştırmalar aradı. AlphaDev ise düşük seviyeli rutinlerde aday program parçalarını arama problemi olarak ele aldı. Ortak fikir, insanın tek tek yazdığı çözüm yerine çok büyük bir aday uzayında öğrenilmiş arama kullanmaktır.
Bu başarılar hesaplama karmaşıklığı sınırlarını ortadan kaldırmaz. Belirli bir problem boyutu ve cost model altında daha iyi aday bulmak, genel asimptotik alt sınırı değiştirmekten farklıdır. P ile NP'nin eşit olup olmadığı da 2026'da açık problemdir.
AI burada bir “algoritma doğruluk otoritesi” değil, aday üretici ve arama mekanizmasıdır. Bulunan programın eşdeğerliği, sayısal doğruluğu, karmaşıklığı ve gerçek donanımdaki performansı modelden bağımsız yöntemlerle kontrol edilmelidir. Bu örnek, üretken model ile doğrulayıcı arasındaki iş bölümünün bilimsel keşifteki karşılığıdır.
Sosyoteknik sistem: algoritmanın çevresindeki dünya
Bir AI sistemini yalnız model olarak görmek, failure mode'ların çoğunu görünmez yapar. Gerçek sistem en az beş katmanda düşünülebilir: veri; model/algoritma; yazılım altyapısı; insan ve organizasyon; toplumsal/hukuki çevre. Bir katmandaki hata diğerlerinde büyüyebilir.
Bias, yalnız model ağırlığındaki matematiksel kayma değildir. Örnekleme, etiketleme, ölçüm cihazı, hedef değişken, dağıtım population ve insan kararları bias üretebilir. Fairness metrikleri de birbirleriyle çatışabilir; hangi adalet tanımının seçildiği normatif karardır.
Automation bias, kullanıcıların otomatik sistem önerisini gereğinden fazla doğru kabul etmesidir. Özellikle model akıcı açıklama üretiyorsa güven yanılgısı artabilir. İyi arayüz confidence'ı abartmamalı, kaynak ve belirsizliği görünür kılmalı, kritik kararda bağımsız kontrol sağlamalıdır.
Jigsaw effect, tek tek düşük hassasiyetli görünen veri parçalarının birleştirilince kişiyi veya hassas durumu açığa çıkarabilmesidir. Privacy tasarımında yalnız her alanın tek başına hassas olup olmadığına bakmak yeterli değildir. Data minimization, purpose limitation ve retention süreleri AI sisteminde de gereklidir.
Synthetic data bazı gizlilik ve veri kıtlığı problemlerini azaltabilir; gerçek dağılımdaki önyargıyı da yeniden üretebilir. Deepfake ve sentetik medya, provenance ve doğrulama ihtiyacını artırır. İçeriğin “AI tarafından üretilmiş olması” tek başına yanlış olduğu anlamına gelmez; kaynağı belirsiz ve doğrulanamayan içerik risklidir.
Çevresel maliyet için evrensel “bir sorgu şu kadar su/karbon harcar” sayısı vermek yanıltıcıdır. Donanım, veri merkezi PUE/WUE, elektrik karışımı, model, batch, token sayısı ve utilization değişir. Daha iyi ölçüler joule/request, Wh/task, GPU-hours, utilization ve bölgesel carbon intensity gibi bağlama bağlı metriklerdir.
Yapay zekâ yönetişimi: risk, rol ve yaşam döngüsü
Yapay zekâ yönetişimi, etik ilkelerin soyut listesi değil; riskin hangi aktör tarafından, hangi yaşam döngüsü aşamasında ve hangi kanıtla yönetileceğini belirleyen sistem mühendisliği problemidir. Aynı temel model; araştırma aracında, düşük etkili bir içerik yardımcısında veya hakları etkileyen karar desteğinde çok farklı risk profilleri oluşturabilir. Bu nedenle model yeteneği ile kullanım bağlamı birlikte değerlendirilmelidir.
Avrupa Birliği'nin 2024/1689 sayılı Yapay Zekâ Tüzüğü bu ayrımı hukuki bir risk ve rol modeliyle somutlaştıran önemli örneklerden biridir. Tüzüğün genel uygulanma tarihi 2 Ağustos 2026'dır; bazı hükümler daha erken, bazı yükümlülükler ise daha geç uygulanacak şekilde kademelendirilmiştir (Regulation (EU) 2024/1689, Madde 113). Bu takvim, "AI için tek bir tarih ve tek bir yükümlülük vardır" şeklinde okunmamalıdır. Sağlayıcı, sistemi kullanan veya devreye alan taraf (deployer), ithalatçı, dağıtıcı ve genel amaçlı model sağlayıcısı gibi rollerin yükümlülükleri aynı değildir.
Bir teknik ekip açısından düzenleyici gereksinimin karşılığı doğrudan mühendislik artefaktlarına çevrilmelidir:
kullanım amacı ve sistem sınırı
        |
        v
risk sınıflandırması + sorumlu roller
        |
        v
veri soyu / değerlendirme / güvenlik kanıtı
        |
        v
insan denetimi + kayıt + olay yönetimi
        |
        v
değişiklik yönetimi + dağıtım sonrası izleme
Buradaki temel ayrım şöyledir:
model başarımı != sistem güvenilirliği != mevzuata uygunlukYüksek doğruluk oranı; yetkisiz veri kullanımını, yanlış erişim kontrolünü, yetersiz insan denetimini veya eksik değişiklik yönetimini telafi etmez. Benzer biçimde bir kontrol listesinin tamamlanması da modelin sahada güvenilir çalıştığını kanıtlamaz. Güvenilirlik, teknik ölçüm ile yönetişim kanıtının birlikte sürdürülmesini gerektirir.
İnsan denetimi de yalnız arayüzde bir onay düğmesi bulunması değildir. Denetleyicinin bağımsız kanıta erişmesi, belirsizliği görebilmesi, yeterli zamana sahip olması ve sistemi gerçekten durdurabilecek veya kararın üzerine çıkabilecek yetkiye sahip olması gerekir. Aksi durumda "insanın döngüde olduğu (human-in-the-loop)" etiketi, gerçek bir kontrol sınırı oluşturmadan sorumluluğu insana kaydırabilir.
Eğitim verisi, üretken çıktı ve insan yaratıcı katkısı
Üretken yapay zekâ ile telif tartışması tek bir soruya indirgenemez. En az üç ayrı hukuki katman vardır:
1. eğitim girdileri ve kullanım yetkisi
2. üretilen çıktının korunabilirliği
3. ses / yüz / benzerlik gibi dijital temsil hakları
Bu katmanlardan birindeki sonuç diğerini otomatik belirlemez. Eğitim sırasında bir eserin kullanılmasıyla ilgili hukuki değerlendirme; yargı alanına, lisansa, istisnalara ve kullanımın somut özelliklerine bağlıdır. Üretilen çıktının telif koruması ise ayrı bir yazarlık ve yaratıcı katkı sorusudur. Dijital bir ses veya yüz replikası da telif hukukuyla tamamen aynı hak kategorisi değildir.
ABD Telif Hakları Ofisi'nin yapay zekâ raporları bu ayrımı somut bir ulusal hukuk örneği olarak ele alır. Ofisin 2025 tarihli Copyrightability raporu, yapay zekâ yardımı kullanılmasının insan tarafından yaratılmış unsurların korunmasına tek başına engel olmadığını; ancak salt istem vermenin, ek insan yaratıcı kontrolü bulunmadan, korunabilir insan yazarlığını kendiliğinden oluşturmadığını belirtir. Aynı rapor dizisinin ayrı bölümleri dijital replikaları ve üretken model eğitimini inceler (U.S. Copyright Office, 2024; 2025a; 2025b). Bu sonuçlar ABD hukukuna ilişkindir; başka hukuk düzenlerine evrensel kural olarak taşınmamalıdır.
Mühendislik tarafında çıkarım daha geneldir: veri kaynağı, lisans ve hak üstverisi (metadata); model üretimi olup olmadığı; insanın yaptığı düzenleme ve seçimler; kullanılan model/sürüm ve üretim süreci gerektiğinde izlenebilir olmalıdır. Provenance burada yalnız kaynak gösterme değil, sonradan hak, sorumluluk ve yeniden üretilebilirlik sorularına cevap verebilme mekanizmasıdır.
Benimseme, ölçek ve ekonomik değer farklı ölçülerdir
Bir teknolojinin kullanılıyor olması, organizasyon genelinde ölçeklendiğini veya ekonomik değer ürettiğini tek başına göstermez. Ölçüm zincirini ayırmak gerekir:
erişim / deneme
-> düzenli kullanım
-> workflow entegrasyonu
-> ölçekli deployment
-> ölçülen kalite / verimlilik
-> toplam maliyet sonrası ekonomik değer
Her geçiş ayrı kanıt ister. McKinsey'nin 2025 küresel anketinde katılımcıların yüzde 88'i kurumlarının en az bir business function'da AI kullandığını bildirirken, yalnız yüzde 7'si AI'nın kurum genelinde tamamen ölçeklendiğini belirtti. (McKinsey & Company, 2025) Bu veri adoption'ın yaygın olduğunu gösterir; audit edilmiş ROI, nedensel productivity gain veya aynı düzeyde willingness-to-pay kanıtı değildir.
Aynı nedenle aktif kullanıcı, token hacmi veya API çağrı sayısı tek başına business value metriği olarak okunmamalıdır. Default olarak ürüne gömülü bir özelliğin kullanımı ile kullanıcının bağımsız biçimde seçtiği ve tam maliyetini ödemeye razı olduğu hizmet aynı ekonomik sinyali üretmez. Sağlam değerlendirme; incremental revenue/cost, task completion, quality, rework, failure cost ve opportunity cost gibi sonuçları birlikte izler.
Öğrenme, bilişsel dışsallaştırma ve uzmanlık
İnsanlar belleği tarih boyunca yazı, kitap, hesap makinesi, arama motoru ve şimdi yapay zeka ile dışsallaştırdı. Cognitive offloading kendi başına yeni veya kötü değildir. Sorun, aracın öğrenme uyaranını tamamen ortadan kaldırmasıdır.
Bir öğrencinin AI yardımıyla çözdüğü problemde assisted performance yüksek olabilir; aynı problemi yardım olmadan çözebilmesi acquired competence hakkında bilgi verir. Eğitimde bu ikisini ayırmak gerekir. Retrieval practice, spacing ve active recall gibi öğrenme yöntemleri bilgiye erişim kolaylaştığında da önemini korur.
Uzmanlık yalnız hafızada çok bilgi bulundurmak değildir. Problem temsilini hızlı kurma, hangi metriğin yanıltıcı olduğunu bilme, uç durumları öngörme ve yanlış çözümü erken eleme yeteneğini içerir. Yapay zeka routine code üretimini hızlandırdıkça senior muhakemenin değeri problem seçimi, doğrulama ve risk yönetimine kayabilir.
Yazılım sektöründe en kolay otomatikleşen işler kalıp kod, basit dönüşüm, standart CRUD, açıklama ve ilk taslak gibi doğrulaması kolay görevlerdir. Zor kalan alanlar gereksinim belirsizliği, legacy davranış, dağıtık hata, performans, güvenlik, donanım, regülasyon ve uzun vadeli bakım gibi bağlam yoğun problemlerdir.
Junior işlem hattının tamamen ortadan kalkması ise sağlıklı değildir; geleceğin senior mühendisleri problem çözme pratiğini bir yerde edinmek zorundadır.
Eğitim açısından ölçüt basittir: AI bilişsel yükü taşısın; öğrenme uyaranını ortadan kaldırmasın.
2026'da frontier sistemleri nasıl ölçmeli?
Eylül 2026'da frontier model karşılaştırmaları çok hızlı değiştiği için tek marka veya leaderboard'u kalıcı bilgi gibi yazmak doğru değildir. Daha sağlam ölçüm, görev ailelerini ve sistem koşullarını ayırır. Matematik, kod, bilimsel QA, görsel muhakeme, uzun context, tool use ve fiziksel robotik aynı “zeka skoru” değildir.
Jagged intelligence kavramı bu nedenle yararlıdır. Bir model yarışma matematiğinde yüksek başarı gösterip basit uzamsal görevde hata yapabilir; kod kıyaslama testininda yüksek sonuç alıp gerçek repository'de build/test/dependency bağlamında zorlanabilir. kıyaslama testi performansı ile production reliability ayrılmalıdır.
ARC-AGI gibi kıyaslama testleri az örnekli soyut genelleme ve görev aktarımını; SWE-bench türü kıyaslama testleri gerçek repository issue çözümünü; uzun ufuklu ajan ölçümleri ise modelin kaç dakika/saatlik insan görevini belirli başarı oranıyla tamamlayabildiğini incelemeye çalışır. Bu ölçüler değerli olsa da contamination, harness, tool access, yeniden deneme budget ve evaluator design sonuçları etkileyebilir.
AGI için tek kabul görmüş test yoktur. “Turing Testini geçti, AGI oldu” veya “şu kıyaslama testi yüzde X, o halde insan düzeyi” çıkarımları aşırı genellemedir.
Genel yetenek; transfer, sample efficiency, robustness, planning, world modeling, embodiment ve autonomy gibi birden çok eksende incelenebilir. Consciousness ise bu yetenek ölçülerinden yine ayrı kalır.
Eylül 2026 kesiti yine de tarihsel bir dönüm noktasıdır. Frontier sistemler artık yalnız tek adımlı soru-cevapla değil; uzun muhakeme, araç kullanımı, kod yürütme, bilimsel arama ve çok adımlı görev tamamlama ile değerlendiriliyor. Araştırma ajanları problem tanımı, literatür tarama, aday üretimi ve doğrulama döngüsünü daha uzun ufuklara taşıyor. Model adları hızla değişir; kalıcı gelişme, öneri üretimi ile bağımsız doğrulamanın aynı araştırma döngüsünde birleşmesidir.
Birleşik mühendislik ilkeleri
Yüzyıllara yayılan bu gelişim birkaç pratik mühendislik ilkesinde birleşir. İlki veri ve temsil katmanıdır. Yanlış etiket, leakage, drift veya yetkisiz kaynak daha büyük modelle düzelmez. Model gerçekliğin kendisini değil, kendisine sunulan ölçüm ve temsili işler.
İkinci ilke olasılıksal bileşenin sınırlandırılmasıdır. Model aday üretir; şema, yetki, invariant ve deterministik doğrulama gerçek eylemin gerçekleşip gerçekleşmeyeceğini belirler. Doğrulaması pahalı görevde otomasyon yetkisi daha düşük tutulmalıdır.
Üçüncü ilke yetkiyi capability'den ayırmaktır. Bir modelin teknik olarak bir eylemi yapabilmesi, o eyleme izin verilmesi gerektiği anlamına gelmez. Least privilege, geri alınabilirlik ve blast radius model başarımından bağımsız güvenlik katmanlarıdır.
Dördüncü ilke bağlam disiplinidir. Context bellek çöplüğü değildir; doğru bilgi doğru anda ve doğru biçimde verilmelidir. Retrieval da tek bir “vektör araması” değildir: chunking, indeks, filtre, reranking, authorization ve freshness kendi değerlendirmesini gerektirir.
Beşinci ilke ölçümün üretimde sürmesidir. Evals release öncesi bir sınav değil, sistem yaşam döngüsünün parçasıdır. Model, veri ve iş yükü değiştikçe kalite yeniden ölçülür. Ortalama gecikme yanında P95/P99 gibi tail gecikme de izlenir.
Son ilke kanıt ile yorumu ayırmaktır. Özellikle adli ve yüksek riskli alanlarda özgün veri, immutable kayıt ve doğrulanabilir olay zinciri korunur; model yorumu bunların üzerine eklenen değişebilir katmandır.
Model değiştiğinde fizik değişmez. CPU, bellek, ağ, enerji, sensör gürültüsü, zamanlama ve kontrol teorisi yapay zeka etiketiyle ortadan kalkmaz.
Hızlı karar çerçeveleri
Ajan kullanma kararı önce iş akışının yapısından verilmelidir. Adımlar önceden sabitse, başarı kriteri açıksa ve dinamik planlama gerekmiyorsa klasik deterministik iş akışı çoğu zaman daha basit ve güvenlidir. Ajan; araç seçiminin, alt görevlerin veya planın çalışma zamanında değişmesi gerektiğinde anlam kazanır.
Karar verirken beş soru yeterlidir: Adımlar sabit mi? Başarı ölçülebilir mi? Araç kullanımı gerekiyor mu? Hata geri alınabilir mi? Planın gerçekten model tarafından dinamik seçilmesine ihtiyaç var mı? Yüksek frekanslı, düşük karmaşıklıklı, katı gecikmeli veya geri alınamaz tek adımlı işlerde özerklik çoğu zaman gereksiz risk üretir.
RAG ile tüm bilgiyi önceden bağlama koyma seçimi de aynı biçimde problem yapısına bağlıdır. Küçük ve sabit referans doğrudan context'e eklenebilir. Büyük, sık değişen veya erişim kontrolü gerektiren corpus retrieval ister. Çok büyük context window, yanlış veya gereksiz bilgiyi seçme problemini ortadan kaldırmaz.
Otomasyon seviyesi tek sıçramayla belirlenmek zorunda değildir:
- Yalnız öneri üret.
- Öneriyi insan onayına sun.
- Düşük riskli eylemi otomatik uygula ve audit kaydı tut.
- Yüksek özerkliği yalnız doğrulama, geri dönüş ve yetki sınırları yeterliyse kullan.
Capability arttıkça en üst otomasyon seviyesine çıkmak zorunlu değildir. Olgun sistem, neyi otomatikleştirmeyeceğini de açıkça bilir.
Sonuç: on yılda değişen araçlar, değişmeyen ayrımlar
Son on yılda yapay zekada büyük değişim yaşandı. Perceptron ve klasik çok katmanlı ağlardan Transformer'a, tek görev modellerinden foundation model ve çok kipli sistemlere, prompt'tan RAG ve agentic iş akışlarına geçildi. GPU ve accelerator ekosistemi büyüdü; model üretmek, kod yazmak ve büyük bilgi tabanlarında arama yapmak çok daha erişilebilir hale geldi.
Buna karşılık temel ayrımlar aynı kaldı. Veri gerçekliğin kendisi değildir. Shannon enformasyonu semantik anlam değildir.
Korelasyon nedensellik değildir. Model çıktısı doğrulanmış bilgi değildir. Yüksek görev performansı bilinç kanıtı değildir.
Capability iyi amaç garantisi değildir. Bir modelin tool çağırabilmesi ona o tool'u çağırma yetkisi verilmesi gerektiği anlamına gelmez. Daha büyük hesaplama gücü de Gödel, Turing, bilgi kuramı veya fizik tarafından konan sınırları silmez.
Yapay zekayı mühendislik açısından olgunlaştıran soru “model ne kadar etkileyici?” değildir; daha yararlı soru şudur: Bu sistem hangi koşullarda doğru çalışıyor, hangi koşulda yanılıyor, yanıldığında ne kadar etki üretiyor ve kararının hangi kısmını bağımsız biçimde doğrulayabiliyorum? Bu bakış, Zen'in yalınlık fikriyle de uyumludur.
Gereksiz karmaşıklığı azaltmak ayrıntıyı silmek değildir; ayrıntının hangi soruya cevap verdiğini açık hale getirmektir.
Bazen en iyi yapay zeka kararı daha büyük model kullanmak, bazen klasik algoritmaya dönmek, bazen insan onayı eklemek, bazen de problemi hiç otomatikleştirmemektir.
Ünite 4: Değerlendirme, Kanıt ve Sistem Sınırları
Bir yapay zekâ iddiası sınanırken önce iddiayı destekleyecek gözlenebilir deney sonucu belirlenir. Veri seçimi, karşılaştırma yöntemi ve değerlendirme ölçütü testten önce tanımlanır. Sonuç yalnız olumlu örneklerle açıklanıyorsa başarısız örnekler ve örneklem belirsizliği değerlendirmeye katılmalıdır. Sistem düzeyindeki başarı ile tek bir modelin başarısı farklı ölçütlerle izlenebilir; kullanıcı etkileşimi, kaynak seçimi ve sonradan uygulanan kuralların etkisi ayrıca ayrıştırılır.
Ölçüm sızıntısı, insan denetimi ve sistem sınırı
Bir yapay zekâ sisteminin başarısı model ağırlıklarıyla sınırlı değildir. Retrieval, prompt, ön işleme, post-processing ve insan karar adımları birlikte ölçülmelidir. Yalnız model benchmark'ı, uçtan uca sistem davranışını açıklamaz.
Benchmark verisinin eğitim verisine sızması veya aynı soruların geliştirme sürecinde tekrar tekrar görülmesi ölçümü iyimserleştirebilir. Değerlendirme kümesinin provenance'ı ve testin ne sıklıkla geliştiriciye geri besleme verdiği bu nedenle önemlidir.
İnsan denetimi de "son onayı insan verir" cümlesinden ibaret değildir. Denetleyicinin yeterli bağlamı, zamanı ve sistemi tersine çevirecek yetkisi yoksa otomasyon yanlılığını azaltmayabilir. Etkili denetim; belirsizlik göstergesi, gerekçe/kanıt erişimi ve açık eskalasyon yoluyla tasarlanmalıdır.
Öğrenilmiş örüntü, nedensellik kanıtı değildir. Bir modelin belirli bölgelerde yüksek arıza oranını tahmin etmesi, bölge adının arızaya neden olduğunu göstermez; bölge, bakım sıklığı veya ekipman yaşı gibi ölçülmeyen etmenlerle ilişkili olabilir. Nedensel iddiada müdahale, karıştırıcı değişken ve alternatif açıklamalar ayrıca ele alınır. Yüksek etkili uygulamalarda “insan denetimi var” ifadesi de tek başına güvence değildir: insanın hangi bilgiyi gördüğü, neyi değiştirebildiği ve itiraz için ne kadar zamanı olduğu incelenmelidir. Sistemin davranışı, modelin parametrelerinden daha geniş bir teknik ve kurumsal düzende ortaya çıkar.
Yapay zekâ iddiasında kanıt düzeyini ayırmak
Bir araştırma sonucu, üretici benchmark'ı, bağımsız tekrar ve gerçek kullanım gözlemi aynı kanıt düzeyinde değildir. Model yeteneği anlatılırken kullanılan veri kümesi, ölçüt, model sürümü ve değerlendirme yöntemi belirtilmelidir.
Tek bir örnek ne başarıyı ne başarısızlığı geneller. Özellikle üretken modellerde örnek seçimi sonuca büyük etki eder; değerlendirme kümesi önceden tanımlanmalı ve mümkün olduğunda bağımsız biçimde saklanmalıdır.
Felsefi yorum ile ampirik iddia da ayrılmalıdır. Bilinç, niyet, anlam veya zekâ kavramları için normatif/kuramsal argümanlar sunulabilir; bunlar doğrudan benchmark skorundan türeyen deneysel sonuçlar gibi sunulmamalıdır.
Bu ayrım konuşma tanıma çıkarımında somut biçimde görülebilir. NVIDIA L40S üzerinde CTranslate2/faster-whisper ile yapılan kontrollü bir kıyaslama; donanım, çalışma zamanı, compute_type, giriş dağılımı ve RTF gibi değişkenleri açıkça tanımlayabilir. Buna karşılık aynı RTF değerini doğrudan üretim kapasitesi saymak hatalıdır; uçtan uca sistemde CPU ön işleme, VAD ve segmentasyon, kuyruk beklemesi, GPU bellek/eşzamanlılık politikası, G/Ç ve hata sonrası yeniden deneme gibi ek sınırlar vardır. Bu ayrım Gerçek Zamanlı Konuşma Tanımada Kapasite Mühendisliği incelemesinde ölçüm problemi olarak ele alınır.
Yapay Zekâ Sistemini Modelden Ayırmak
Güncel yapay zekâ tartışmalarında en sık yapılan kavramsal hatalardan biri, tek başına modelin yetenekleriyle bütün yazılım sisteminin yeteneklerini aynı şey saymaktır. Kullanıcı bir sohbet arayüzünde web araması yapan, belge getiren, kod çalıştıran, araç çağıran ve geçmiş konuşmayı hatırlayan bir sistem gördüğünde bu davranışların tamamını temel modele atfedebilir. Oysa üretim sistemi çok katmanlıdır.
Kullanıcı
   |
   v
Arayüz / Oturum
   |
   +--> Bellek
   +--> Bilgi erişimi
   +--> Araçlar
   +--> Yetkilendirme
   +--> Doğrulama
   |
   v
Temel Model
Bu ayrım yapay zekâ yeteneğini değerlendirirken zorunludur. Modelin parametrelerinde bulunmayan güncel bir bilgiyi RAG katmanı getirebilir; matematiksel işlem bir hesaplama aracına devredilebilir; yapılandırılmış veri veri tabanından sorgulanabilir; yasak bir işlem yetkilendirme katmanı tarafından engellenebilir. Son kullanıcının gördüğü sonuç, bu bileşenlerin ortak davranışıdır.
Model başarısı, sistem başarısı ve iş başarısı
Üç farklı ölçüm seviyesi birbirine karıştırılmamalıdır.
Model ölçümü
   |
   v
Belirli görevde çıktı kalitesi

Sistem ölçümü
   |
   v
Gecikme + güvenlik + veri erişimi + hata davranışı

İş / insan ölçümü
   |
   v
Görev gerçekten tamamlandı mı?
Bir model kıyaslamada güçlü olabilir ancak üretimde yanlış veri kaynağına bağlanmışsa sistem başarısızdır. Tersine daha küçük bir model, iyi retrieval, açık iş kuralları ve insan denetimiyle belirli bir uygulamada daha güvenilir sonuç verebilir.
Bu nedenle “hangi model en zekidir?” sorusu çoğu mühendislik problemi için fazla kaba bir sorudur. Daha yararlı soru, hangi sistem bileşiminin tanımlanmış görevde ölçülebilir biçimde çalıştığıdır.
Gösteri, kıyaslama ve üretim kanıtı
Bir yapay zekâ sistemi hakkındaki iddianın kanıt düzeyi ayrıştırılmalıdır.
tek örnek / demo
      |
      v
kontrollü kıyaslama
      |
      v
tekrarlı bağımsız değerlendirme
      |
      v
gerçek üretim yükü
      |
      v
uzun dönem davranış
Etkileyici bir gösteri genellenebilirlik kanıtı değildir. Kıyaslama da doğrudan üretim güvenilirliği anlamına gelmez. Veri dağılımı, kullanıcı çeşitliliği, maliyet, gecikme, hata sınıfları ve güvenlik sınırları üretimde ayrıca ölçülmelidir.
Bu bakış, yapay zekâ hakkındaki abartılı iyimserlik ile kategorik küçümseme arasında daha teknik bir konum sağlar: sistemin ne yaptığı, hangi koşulda yaptığı ve hangi kanıtla ölçüldüğü sorulur.
Yapay Zekâ Sistemini Modelden Daha Geniş Tanımlamak
Dil sistemlerinde işlem hattı; tokenizasyon, temsil, retrieval, bağlam seçimi, çıkarım ve değerlendirme aşamalarının toplamıdır. Yapay zekâ sisteminde retrieval hatası ilgili kanıtın hiç getirilememesi veya yanlış kanıtın üst sıralara taşınmasıdır; üretici model ise doğru kanıt mevcutken bile çıkarımı bozabilir, bu nedenle değerlendirme akıcılığın yanında doğruluk, kanıt kapsaması, calibration ve kaynakla çelişmeme ölçülerini ayrı raporlamalıdır. Agent veya araç kullanan sistemlerde her ek adım yeni bir gecikme ve hata sınırı ekler.
- Model çıktısının veri, retrieval, araç ve kullanıcı etkileşimi zincirinde değerlendirilmesi.
- Doğruluk ile latency/cost/reliability arasında açık trade-off kurulması.
- İnsan denetimi gerektiren kararların otomasyon sınırının ayrı tanımlanması.
Ünite 5: Üretken Yapay Zekâ, Antropomorfizm ve Teknik Olgunluk
Üretken Modelleri Aynı Kavram Altında Eritmemek
Üretken yapay zekâ tek bir mimari ailesi değildir. Varyasyonel otokodlayıcılar, üretici çekişmeli ağlar, difüzyon modelleri ve otoregresif dil modelleri farklı eğitim hedefleri ve örnekleme süreçleri kullanır.
Üretken Model
   |
   +--> VAE
   |     olasılıksal gizil uzay
   |
   +--> GAN
   |     üretici <-> ayırt edici rekabeti
   |
   +--> Diffusion
   |     gürültü ekleme / tersine çözme
   |
   +--> Autoregressive Transformer
         sonraki birim olasılığı
Bu aileleri “hangisi daha iyi?” biçiminde sıralamak yerine, hangi veri türü ve hangi üretim probleminde hangi varsayımı kullandıkları karşılaştırılmalıdır. Difüzyon modelleri görüntü üretiminde güçlü bir çizgi oluştururken, otoregresif Transformer mimarileri metin ve giderek çok kipli üretimde temel ailelerden biri hâline gelmiştir. Bu durum mimari üstünlükten çok görev, veri, hesaplama ve eğitim hedefi birlikteliğinin sonucudur.
Yapay Sinir Ağları ve Öğrenme Modelleri bu ailelerin ağ düzeyindeki mekanizmalarını; Büyük Dil Modelleri ise otoregresif Transformer çizgisini ayrıntılandırır.
Antropomorfizm, ELIZA Etkisi ve Arayüzün Yanılsaması
İnsanlar akıcı dil kullanan sistemlere amaç, niyet ve kişilik atfetmeye yatkındır. Bu eğilim yeni değildir; ELIZA döneminden beri basit metinsel geri bildirim bile kullanıcıda anlaşılma hissi oluşturabilmektedir. Büyük dil modelleri bu etkiyi çok daha güçlü bir dilsel yetenekle yeniden üretir.
Akıcı ve bağlama uygun yanıt şu iddiaların hiçbirini tek başına kanıtlamaz:
- bilinç,
- öznel deneyim,
- insan benzeri niyet,
- kalıcı amaç,
- dünya hakkında doğru içsel model,
- ahlaki sorumluluk.
Aynı şekilde modelin hata yapması da bütün yapay zekâ yöntemlerinin anlamsız olduğu sonucunu vermez. Davranış ölçümü ile ontolojik/felsefi iddia ayrı tutulmalıdır.
Gözlenen davranış
      |
      v
Yetkinlik ölçümü
      |
      X
      |
      v
Bilinç / niyet iddiası
Aradaki X, ek kanıt gerektiren çıkarım sınırını temsil eder.
Akıcı dil üretimi, bilinç, doğruluk veya niyet sahibi olma kanıtı değildir. Bir sistem insanın konuşma biçimini taklit edebilir, ancak dilsel inandırıcılık ile dış dünyaya ilişkin doğrulama farklı süreçlerdir. Bu ayrım yalnız felsefi değil, mühendislik açısından da önemlidir: akıcı fakat kaynak gösteremeyen bir yanıtın güvenilirlik düzeyi sınırlıdır. Sentetik araştırma verisi veya otomatik üretilmiş atıf da gerçek gözlem ve doğrulanmış bibliyografik kayıtla karıştırılmamalıdır. Analitik zincirde her iddia için verinin kökeni, işleme yöntemi ve gerektiğinde bağımsız denetim yolu açık olmalıdır.
Dar Yapay Zekâ, Üretken Yapay Zekâ, Temel Model ve AGI
Terminoloji, özellikle güncel tartışmalarda açık tutulmalıdır.
Dar yapay zekâ, belirli görev veya görev ailesinde çalışan sistemleri ifade eder. Bu sistem çok başarılı olabilir ancak kapsamı tanımlıdır.
Üretken yapay zekâ, eğitim verisinin yapısına dayanarak yeni içerik üreten model ailesini veya uygulama sınıfını ifade eder. Metin, görüntü, ses, video veya kod üretebilir.
Temel model, geniş veri üzerinde eğitilip çok sayıda aşağı akış göreve uyarlanabilen genel amaçlı modeldir.
AGI, üzerinde tek ve evrensel teknik tanım bulunmayan daha güçlü bir genel yetenek iddiasıdır. Bu nedenle bir ürünün “AGI” olarak adlandırılması ölçüm tanımı olmadan bilimsel sonuç sayılmamalıdır.
Bir sistem birçok kıyaslamada yüksek başarı elde ettiğinde doğru ifade, ölçülen görevlerde geniş yetenek gösterdiğidir. Bu gözlemden doğrudan “insan düzeyi genel zekâ” sonucu çıkmaz.
Yapay Zekâ Dalgaları, Beklenti ve Teknik Olgunluk
Yapay zekâ tarihi yalnız doğrusal başarı öyküsü değildir. Yüksek beklenti dönemleri, yatırım artışı, teknik sınırlamaların görünür hâle gelmesi ve ilginin azalması geçmişte birden fazla kez yaşanmıştır. “Yapay zekâ kışı” kavramı bu tarihsel bağlamda kullanılır.
Güncel üretken yapay zekâ dönemini değerlendirirken iki uçtan kaçınmak gerekir:
"Her şey değişti, bütün sorunlar çözüldü."
                X
"Bu yalnız moda, hiçbir teknik ilerleme yok."
Her iki ifade de ölçüm yerine genellemedir.
Daha sağlam yaklaşım:
- hangi görevde ilerleme olduğunu belirlemek,
- maliyet ve hata profilini ölçmek,
- sistemin hangi sınırlar içinde çalıştığını göstermek,
- uzun dönem bakım ve yönetişimi değerlendirmek,
- ekonomik ve toplumsal iddiaları teknik kıyaslamadan ayırmaktır.
Ünite 6: İnsan Denetimi, Ajanlık ve Özerklik
İnsan Denetimi ve Bilişsel Dışsallaştırma
Yapay zekâ kullanıcı adına metin yazabilir, özetleyebilir, seçenek üretebilir veya karar hazırlığı yapabilir. Bu durum bilişsel işin bir bölümünün dış araca aktarılmasıdır. Fakat dışsallaştırma ile sorumluluğun devri aynı şey değildir.
Model
  -> aday üretir

İnsan / sistem
  -> doğrular
  -> bağlamı değerlendirir
  -> sorumluluk taşıyan kararı verir
Düşük riskli görevlerde otomasyon seviyesi yükseltilebilir. Yüksek etkili veya geri dönüşü zor kararlarda insan denetimi, izlenebilirlik ve itiraz mekanizması daha önemlidir.
NIST'in Generative AI Profile belgesi, üretken yapay zekâ riskini yaşam döngüsü boyunca yönetişim, ölçüm ve yönetim bağlamında ele alır; yalnız model doğruluğuna indirgemez. Bu ders açısından temel sonuç şudur: güvenilir yapay zekâ bir model özelliği değil, veri, yazılım, insan, süreç ve yönetişim bileşimidir.
Ajanlı Sistemlerde Özerklik Sınırı
Ajan kavramı, modele araç ve eylem döngüsü bağlandığında önem kazanır.
Algı / İstek
    |
    v
Model
    |
    v
Plan / Araç seçimi
    |
    v
Eylem
    |
    v
Yeni durum
Bu döngü, sohbet modelinden daha fazla operasyonel güç taşır. Ancak araç erişimi modele “irade” kazandırdığı anlamına gelmez. Mühendislik açısından özerklik; hangi eylemleri hangi koşullarda, hangi yetkiyle ve kaç adım boyunca sistemin insan onayı olmadan gerçekleştirebildiğiyle ölçülmelidir.
Bu nedenle ajan güvenliği:
yetenek
+ yetki
+ kaynak sınırı
+ durdurma koşulu
+ kayıt / denetim
birlikte tasarlanmalıdır.
Ünite 7: Olasılıksal Çıkarım, Sıralı Karar ve Çok Etmenli Yapay Zekâ
Belirsizlik altında yapay zekâ yalnız olasılık dağılımı tanımlamakla bitmez. Sistem:
- hangi değişkenin hangisinden bağımsız olduğunu,
- gözlem geldikten sonra posterior'un nasıl hesaplanacağını,
- tam hesabın pahalı olduğu durumda nasıl yaklaşım yapılacağını,
- ardışık eylemlerde uzun dönemli faydanın nasıl optimize edileceğini,
- başka karar vericiler bulunduğunda stratejinin nasıl değiştiğini
belirlemelidir.
d-separation: grafikten koşullu bağımsızlık okumak
Bayes ağında oklar yalnız nedensel veya ilişkisel hikâye çizmez; ortak dağılımın hangi koşullu bağımsızlıkları taşıdığını da kodlar.
d-separation, bir değişken kümesi gözlenmişken iki düğüm kümesi arasındaki yolların aktif mi engelli mi olduğunu belirleyen grafiksel ölçüttür.
Üç temel yapı önemlidir.
Zincir:
A -> B -> CB gözlenirse A ile C arasındaki yol engellenir.
Fork:
A <- B -> Cortak neden B gözlenirse A ile C arasındaki bağımlılık engellenebilir.
Collider:
A -> B <- CB gözlenmiyorken yol engellidir; collider'ın veya soyundan bir değişkenin gözlenmesi yolu aktif hale getirebilir.
Bu son durum, conditioning'in her zaman bağımlılığı azalttığı şeklindeki sezginin yanlış olduğunu gösterir.
Exact inference ve factor yaklaşımı
Bir Bayes ağında sorgu:
P(Query | Evidence)hesaplanırken bütün gizli değişkenleri açık joint tabloya açmak çok pahalı olabilir.
Variable elimination, faktörleri yerel olarak çarpıp gerekli olmayan değişkenleri sırayla toplar.
Kavramsal akış:
initial factors
    ↓
evidence uygula
    ↓
bir hidden variable seç
    ↓
onu içeren factor'ları çarp
    ↓
değişkeni sum-out et
    ↓
yeni factor üret
    ↓
tekrarla
Sonuç matematiksel olarak exact olabilir; fakat ara factor boyutları elimination order'a güçlü biçimde bağlıdır.
Bu nedenle variable elimination:
aynı olasılık modeli
+ farklı elimination order
=
çok farklı hesaplama maliyeti
üretebilir.
Relevance pruning
Sorguyla ilişkisi olmayan düğümleri çıkarmak yalnız optimizasyon değildir.
Grafın koşullu bağımsızlık yapısı kullanılarak sorguya katkısı olmayan değişkenler hesap dışına alınabilir.
Bu yaklaşım:
- daha küçük factor,
- daha az memory,
- daha düşük inference maliyeti
sağlayabilir.
Exact inference neden zorlaşır?
Bayes ağının düğüm sayısı tek başına maliyeti açıklamaz.
Kritik özellik graph structure'dır.
Elimination sırasında oluşan geniş ara factor'lar, karmaşıklığı hızla artırabilir. Genel ağlarda exact inference bu nedenle pahalıdır.
Ağaç/polytree benzeri yapılarda daha verimli message-passing yöntemleri mümkün olabilirken yoğun bağlantılı graf farklı maliyet üretir.
Rejection sampling
Approximate inference'ın en doğrudan fikirlerinden biri prior'dan örnek üretip evidence ile uyuşmayan örnekleri atmaktır.
sample
  |
  +-- evidence uyuyor -> kullan
  |
  +-- evidence uymuyor -> reddet
Evidence çok düşük olasılıklıysa örneklerin çoğu boşa gidebilir.
Bu yöntem kavramsal olarak açık, fakat nadir evidence durumunda verimsizdir.
Likelihood weighting
Likelihood weighting, evidence değişkenlerini sabit tutup onların olasılığını örnek ağırlığına katar.
Böylece her örneğin evidence ile uyumsuz olduğu için çöpe atılması önlenir.
Kavramsal olarak:
non-evidence variables -> sample
evidence variables     -> fixed
weight                  -> evidence likelihood product
Evidence ağın aşağı kısımlarında veya dağılım çok sivri olduğunda ağırlıkların büyük bölümü çok küçük değerlere düşebilir.
Dolayısıyla rejection sampling sorununu azaltır; her durumda düşük varyans garantisi vermez.
Gibbs sampling
Gibbs sampling bir Markov chain oluşturur.
Evidence sabit tutulur; evidence olmayan değişkenlerden biri seçilip Markov blanket'ına koşullu dağılımdan yeniden örneklenir.
state
  ↓
X_i yeniden örnekle
  ↓
yeni state
  ↓
tekrarla
Yeterli mixing sonrasında ziyaret edilen durum frekansları posterior hakkında tahmin sağlar.
Pratik riskler:
- yavaş mixing,
- çok modlu dağılım,
- yüksek korelasyon,
- burn-in ve autocorrelation
gibi MCMC sorunlarıdır.
Approximate inference sonucu bu yüzden "rastgele örnek aldık" diye değil, sampling kalitesiyle birlikte değerlendirilmelidir.
MDP'de Bellman düşüncesi
Markov Decision Process:
states S
actions A
transition P(s' | s,a)
reward R
discount gamma
ile tanımlanabilir.
Bir state'in değeri yalnız anlık reward değildir; optimal gelecek davranışın beklenen indirgenmiş faydasını içerir.
Bellman optimality fikri:
V*(s) =
max_a [
    R(s,a)
    +
    gamma * Σ P(s'|s,a) V*(s')
]
şeklinde okunabilir.
Bu denklem, uzun vadeli kararı yerel recursive ilişkiye dönüştürür.
Value iteration
Value iteration başlangıç value tahminlerini Bellman backup ile tekrar tekrar günceller.
V_0
 ↓
Bellman backup
 ↓
V_1
 ↓
...
 ↓
yakınsama
Value yeterince yakınsadığında greedy policy çıkarılabilir.
Bu yöntem her iterasyonda policy evaluation'ı tam çözmek zorunda değildir.
Policy iteration
Policy iteration iki ana adımı sırayla yürütür:
1. policy evaluation
2. policy improvement
Mevcut policy'nin değerleri hesaplanır; sonra her state için daha iyi action seçilebiliyorsa policy güncellenir.
Value iteration ile policy iteration aynı algoritma değildir.
Hangisinin daha hızlı olduğu state/action yapısına ve evaluation maliyetine bağlıdır.
Politika gradyanı ve aktör–eleştirmen yaklaşımı
Değer yinelemesi sonlu ve açıkça modellenmiş durum–eylem uzaylarında uygundur. Geçiş olasılıklarının bilinmediği veya eylemlerin sürekli olduğu problemlerde politika doğrudan parametrelenebilir: π_θ(a|s). Amaç, izlenen yörüngelerin beklenen indirgenmiş getirisini eniyilemektir: J(θ) = E_{τ~π_θ}[Σ_t γ^t r_t].
Yörünge örneklerinden bir politika gradyanı kestiricisi, uygun getiri ve örnekleme varsayımları altında ∇_θ J ≈ (1/N) Σ_i Σ_t ∇_θ log π_θ(a_t^i|s_t^i) G_t^i biçiminde kurulabilir. Getiriden duruma bağlı, eylemden bağımsız bir taban değeri çıkarılması beklenen gradyanı değiştirmeden varyansı azaltabilir. Avantaj A(s,a) = Q(s,a) - V(s), eylemin durum ortalamasına göre ek değerini gösterir.
Aktör, eylem politikasını günceller; eleştirmen, değer veya avantaj tahmini üreterek gradyanın varyansını düşürmeye yardımcı olur. Hatalı eleştirmen kestirimi yanlılık oluşturabilir. Eğitim yörüngelerinin güncel politikadan mı yoksa eski bir davranış politikasından mı geldiği belirtilmeli; politika dışı verinin kullanımı için dağılım farkı ele alınmalıdır. Eylem güvenliği, keşif maliyeti ve örnek verimliliği algoritmanın seçim ölçütleridir.
POMDP: state yerine belief state
Kısmi gözlenebilirlikte ajan gerçek state'i doğrudan bilmiyorsa decision state'i:
belief(s)yani olası state'ler üzerindeki dağılım olabilir.
Her observation sonrası belief Bayes kuralıyla güncellenir.
Bu dönüşüm teorik olarak POMDP'yi belief-space MDP olarak ele almaya izin verir; fakat belief space sürekli ve yüksek boyutlu olabileceği için hesaplama maliyeti büyür.
Çok etmenli karar
Tek ajanlı MDP'de environment dinamiği policy'den bağımsız model varsayımıyla ifade edilebilir.
Çok etmenli sistemde diğer ajanlar da stratejik karar verdiği için "environment" kısmen başka karar vericilerden oluşur.
Problem türleri:
cooperative
competitive
mixed-motive
olabilir.
Ajanların objective'leri, bilgi düzeyleri ve iletişim olanakları çözüm kavramını değiştirir.
Monte Carlo ağaç aramasında ziyaret sayısı bir eylemin mutlak doğruluk kanıtı değildir; sınırlı hesaplama altında araştırmanın nereye yoğunlaştığını gösterir. Keşif terimi, az denenmiş eylemlere de örnekleme bütçesi ayırarak erken ve hatalı kesinleşmeyi azaltır. Ödül dağılımı yüksek varyanslı veya oyun ağacı rakibin gizli bilgisine bağlıysa aynı bütçe altında sıralamalar değişebilir. Bu nedenle kararın kalitesi yalnız seçilen eylemle değil, benzetim sayısı, rastgelelik tohumu ve rakip varsayımlarıyla birlikte değerlendirilmelidir.
Normal-form, extensive-form ve repeated games
Normal-form game, oyuncuların stratejilerini ve payoff'ları tek matris/utility yapısında ifade eder.
Extensive-form game, hareket sırasını ve bilgi durumunu oyun ağacı üzerinden gösterir.
Repeated game, aynı stratejik etkileşimin tekrarlandığı durumda gelecekteki tepkinin bugünkü kararı etkilemesini inceler.
Nash equilibrium, hiçbir oyuncunun diğerlerinin stratejileri sabitken tek taraflı sapmayla kendi utility'sini artırmadığı strateji profilidir.
Equilibrium:
toplumsal olarak en iyidemek değildir.
Birden fazla equilibrium bulunabilir; koordinasyon ve seçim ayrı problem olabilir.
Probabilistic programming
Modern AI'da olasılıksal model:
tek tek inference denklemlerini elle yazyaklaşımı yerine, stokastik generative process program olarak tanımlanabilir.
Probabilistic programming sistemi:
model programı
+
observation
+
query
+
inference engine
ayrımını kurar.
Aynı model için farklı inference yöntemleri kullanılabilmesi model specification ile inference algorithm'i birbirinden ayırır.
Bu yaklaşım özellikle karmaşık hierarchical model, latent-variable model ve uncertainty propagation problemlerinde değerlidir.
Ancak probabilistic programming:
- yanlış model varsayımını düzeltmez,
- identifiability problemini ortadan kaldırmaz,
- sampling/convergence maliyetini yok etmez.
Karar algoritmasında epistemik sınır
Olasılık ve utility hesabı:
model altında en iyi kararüretebilir.
Bu:
gerçek dünya hakkında mutlak doğru karardeğildir.
Transition modeli, reward tanımı veya prior hatalıysa optimal policy yalnız hatalı model içinde optimal olabilir.
Bu nedenle belirsizlik altında AI sistemi:
model uncertainty
data uncertainty
decision objective
computational approximation
katmanlarını birbirinden ayırmalıdır.
Olasılıksal çıkarım ve sıralı karar verme, yapay zekâyı "tahmin eden model" düzeyinden belirsizlik altında bilgi güncelleyen ve uzun vadeli eylem seçen sistem düzeyine taşır.
Kaynakça
- Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
- Anderson, S. L. (2008). Asimov's “Three Laws of Robotics” and Machine Metaethics. AI & Society, 22(4), 477–493. https://doi.org/10.1007/s00146-007-0094-5
- Anil K. Jain; Arun Ross; Salil Prabhakar. (2004). An Introduction to Biometric Recognition. IEEE Transactions on Circuits and Systems for Video Technology, 14(1), 4–20. doi:10.1109/TCSVT.2003.818349
- Anthropic. (2025). Agentic Misalignment: How LLMs Could Be Insider Threats. https://www.anthropic.com/research/agentic-misalignment
- Appel, K., & Haken, W. (1977). Every Planar Map Is Four Colorable. I: Discharging. Illinois Journal of Mathematics, 21(3), 429–490. https://doi.org/10.1215/ijm/1256049011
- Appel, K., Haken, W., & Koch, J. (1977). Every Planar Map Is Four Colorable. II: Reducibility. Illinois Journal of Mathematics, 21(3), 491–567. https://doi.org/10.1215/ijm/1256049012
- Arf, C. (1959). Makine Düşünebilir mi ve Nasıl Düşünebilir? Atatürk Üniversitesi 1958–1959 Öğretim Yılı Halk Konferansları.
- Autio, C., Schwartz, R., Dunietz, J., Jain, S., Stanley, M., Tabassi, E., Hall, P., & Roberts, K. (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. https://doi.org/10.6028/NIST.AI.600-1
- Baars, B. J. (1988). A Cognitive Theory of Consciousness. Cambridge University Press.
- Becker, J., Rush, N., Barnes, B., & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. METR. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- Becker, J., Rush, N., Cunningham, T., Rein, D., & Mahamud, K. (2026). We Are Changing our Developer Productivity Experiment Design. METR. https://metr.org/blog/2026-02-24-uplift-update/
- Bennett, C. H. (2003). Notes on Landauer's Principle, Reversible Computation, and Maxwell's Demon. Studies in History and Philosophy of Modern Physics, 34(3), 501–510.
- Berenji, H. R., & Khedkar, P. (1992). Learning and Tuning Fuzzy Logic Controllers Through Reinforcements. IEEE Transactions on Neural Networks, 3(5), 724–740. https://doi.org/10.1109/72.159061
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer.
- Bostrom, N. (2014). Superintelligence: Paths, Dangers, Strategies. Oxford University Press.
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- Brown, T. B. et al. (2020). Language Models are Few-Shot Learners. NeurIPS 33.
- Browne, C. B. et al. (2012). A Survey of Monte Carlo Tree Search Methods. IEEE Transactions on Computational Intelligence and AI in Games, 4(1), 1–43.
- Butler, S. (1863) Darwin among the Machines. The Press, Christchurch, 13 June 1863.
- Caan, W. (2015). Chekhov's Corner: “The Machine Stops” by E. M. Forster. Journal of Public Health, 37(4), 744–745. https://doi.org/10.1093/pubmed/fdu081
- Chris Fregly. AI Systems Performance Engineering. O’Reilly Media, 2025.
- Daniel Jurafsky; James H. Martin. Speech and Language Processing. 3rd ed. draft, 2026.
- Čapek, K. (1920). R.U.R. (Rossum's Universal Robots).
- Chalmers, D. J. (1996). The Conscious Mind. Oxford University Press.
- Chalmers, D. J. (2004). T. M. A. M. I. C. G. (Ed.) Philosophers Explore The Matrix. Oxford University Press. https://doi.org/10.1093/oso/9780195181067.003.0009
- Chen, C., Borgeaud, S., Irving, G., Lespiau, J.-B., Sifre, L., & Jumper, J. (2023). Accelerating Large Language Model Decoding with Speculative Sampling. arXiv:2302.01318.
- Chong, S. S. H. (2019). G. I. T. S. I. Persons: A History. Oxford University Press. https://doi.org/10.1093/oso/9780190634384.003.0013
- Cortes, C., & Vapnik, V. (1995). Support-Vector Networks. Machine Learning, 20, 273–297.
- Cover, T. M., & Thomas, J. A. (2006). Elements of Information Theory (2nd ed.). Wiley.
- Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. arXiv:2205.14135.
- Dettmers, T., Pagnoni, A., Holtzman, A., & Zettlemoyer, L. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 36.
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL-HLT.
- Dieks, D. (1982). Communication by EPR Devices. Physics Letters A, 92(6), 271-272.
- Dihal, K. (2020). Enslaved Minds: Artificial Intelligence, Slavery, and Revolt. In AI Narratives: A History of Imaginative Thinking about Intelligent Machines. Oxford University Press. https://doi.org/10.1093/oso/9780198846666.003.0009
- European Parliament & Council of the European Union. (2024). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Fano, R. M. (1961). Transmission of Information: A Statistical Theory of Communications. MIT Press.
- Fawzi, A. et al. (2022). Discovering Faster Matrix Multiplication Algorithms with Reinforcement Learning. Nature, 610, 47–53.
- Fedus, W., Zoph, B., & Shazeer, N. (2021). Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. arXiv:2101.03961.
- Fernandes, M. S. (2011). Emerging Technologies: Artificial Intelligence. In The Picture of Health: Medical Ethics and the Movies. Oxford University Press. https://doi.org/10.1093/acprof:osobl/9780199735365.003.0058
- Fisher, R. A. (1936). The Use of Multiple Measurements in Taxonomic Problems. Annals of Eugenics, 7(2), 179–188.
- Forster, E. M. (1909) The Machine Stops. The Oxford and Cambridge Review.
- Gibson, W. (1984) Neuromancer. Ace Books.
- Glover, F. (1986). Future Paths for Integer Programming and Links to Artificial Intelligence. Computers & Operations Research, 13(5), 533–549.
- Gödel, K. (1931). Über formal unentscheidbare Sätze der Principia Mathematica und verwandter Systeme I.
- Goldberg, D. E. (1989). Genetic Algorithms in Search, Optimization, and Machine Learning. Addison-Wesley.
- Grondin, D., & Hogue, S. (2024). Person of Interest as Media Technology of Surveillance: A Cautionary Tale for the Future of the National Security State With Diegetic Big Data Surveillance, Algorithmic Security, and Artificial Intelligence. Television & New Media, 25(4). https://doi.org/10.1177/15274764231210280
- Gu, A., & Dao, T. (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces. arXiv:2312.00752.
- Hadfield-Menell, D. et al. (2017). The Off-Switch Game. IJCAI.
- Harnad, S. (1990). The Symbol Grounding Problem. Physica D, 42, 335–346.
- Hart, P. E., Nilsson, N. J., & Raphael, B. (1968). A Formal Basis for the Heuristic Determination of Minimum Cost Paths. IEEE Transactions on Systems Science and Cybernetics, 4(2), 100–107.
- Hebb, D. O. (1949). The Organization of Behavior. Wiley.
- Holland, J. H. (1975). Adaptation in Natural and Artificial Systems. University of Michigan Press.
- Hu, E. J. et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685.
- Hubert, T., Mehta, R., Sartran, L. et al. (2026). Olympiad-level formal mathematical reasoning with reinforcement learning. Nature, 651, 607–613. https://doi.org/10.1038/s41586-025-09833-y
- Hubinger, E. et al. (2019). Risks from Learned Optimization in Advanced Machine Learning Systems. arXiv:1906.01820.
- Jackson, F. (1982). Epiphenomenal Qualia. The Philosophical Quarterly, 32(127), 127–136.
- Jang, J.-S. R. (1993). ANFIS: Adaptive-Network-Based Fuzzy Inference System. IEEE Transactions on Systems, Man, and Cybernetics, 23(3), 665–685. https://doi.org/10.1109/21.256541
- Joseph Weizenbaum. “ELIZA—A Computer Program for the Study of Natural Language Communication between Man and Machine.” Communications of the ACM, 9(1), 1966, 36–45. DOI: https://doi.org/10.1145/365153.365168
- Kemal Oflazer. (1994). Two-level Description of Turkish Morphology. Literary and Linguistic Computing, 9(2), 137–148. doi:10.1093/llc/9.2.137
- Köker, M. A. et al. (2022). Görüntü ve Ses İşleme. In Yapay Zeka - Kuramdan Uygulamaya. Nobel Akademik Yayıncılık.
- Korf, R. E. (1985). Depth-First Iterative-Deepening: An Optimal Admissible Tree Search. Artificial Intelligence, 27(1), 97–109.
- Kwon, W. et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. arXiv:2309.06180.
- Ladak, A. (2024). W. W. Q. A. A. I. F. M. S. AI and Ethics, 4, 213–228. https://doi.org/10.1007/s43681-023-00260-1
- Landauer, R. (1961). Irreversibility and Heat Generation in the Computing Process. IBM Journal of Research and Development, 5(3), 183–191.
- LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep Learning. Nature, 521, 436–444.
- Lem, S. (1981) Golem XIV. Wydawnictwo Literackie.
- Leviathan, Y., Kalman, M., & Matias, Y. (2023). Fast Inference from Transformers via Speculative Decoding. Proceedings of the 40th International Conference on Machine Learning, PMLR 202, 19274–19286.
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 33.
- Lighthill, J. (1973). Artificial Intelligence: A General Survey. In Artificial Intelligence: A Paper Symposium. Science Research Council of Great Britain.
- Linnainmaa, S. (1970). The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors. Master’s thesis, University of Helsinki.
- Mackworth, A. K. (1977). Consistency in Networks of Relations. Artificial Intelligence, 8(1), 99–118.
- MacQueen, J. (1967). Some Methods for Classification and Analysis of Multivariate Observations. Proceedings of the Fifth Berkeley Symposium.
- Mankowitz, D. J. et al. (2023). Faster Sorting Algorithms Discovered Using Deep Reinforcement Learning. Nature, 618, 257–263.
- Marks, P. (2015) Imagining Surveillance: Eutopian and Dystopian Literature and Film. Edinburgh University Press. https://doi.org/10.3366/edinburgh/9781474400190.001.0001
- Marshall, K. (2022). Mere Data Makes a Man: Artificial Intelligences in Blade Runner 2049. In J. English & M. Pascal (Eds.), ReFocus: The Films of Denis Villeneuve (pp. 178–193). Edinburgh University Press. https://doi.org/10.3366/edinburgh/9781474497381.003.0012
- McCarthy, J., Minsky, M. L., Rochester, N., & Shannon, C. E. (1955). A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence.
- McCulloch, W. S., & Pitts, W. (1943). A Logical Calculus of the Ideas Immanent in Nervous Activity. Bulletin of Mathematical Biophysics, 5, 115–133.
- McKinsey & Company. (2025). The State of AI in 2025: Agents, Innovation, and Transformation. https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai
- Millican, P. (2021). A. T. A. H.-L. I. I. Human-Like Machine Intelligence. Oxford University Press. https://doi.org/10.1093/oso/9780198862536.003.0002
- Minsky, M., & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
- Mnih, V. et al. (2015). Human-level Control through Deep Reinforcement Learning. Nature, 518, 529–533.
- Model Context Protocol. (2026). The 2026-07-28 Specification. https://blog.modelcontextprotocol.io/posts/2026-07-28/
- Murphy, P. (2024) AI in the Movies. Edinburgh University Press. https://doi.org/10.3366/edinburgh/9781474448581.001.0001
- Murphy, R. R. (2022). Is it safe to hug a robot like Baymax? Science Robotics, 7(70), eade5835. https://doi.org/10.1126/scirobotics.ade5835
- Murphy, R. R., & deWitte, P. (2023). M3GAN: The real horror is the lack of ethics in robotics. Science Robotics, 8(76), eadh1236. https://doi.org/10.1126/scirobotics.adh1236
- National Research Council. (1966). Language and Machines: Computers in Translation and Linguistics. National Academy of Sciences–National Research Council. https://doi.org/10.17226/9547
- Nauck, D., & Kruse, R. (1995). NEFCLASS – A Neuro-Fuzzy Approach for the Classification of Data. Proceedings of the 1995 ACM Symposium on Applied Computing, 461–465. https://doi.org/10.1145/315891.316068
- Nauck, D., Klawonn, F., & Kruse, R. (1997). Foundations of Neuro-Fuzzy Systems. Wiley.
- Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
- NIST. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1.
- OpenAI. (2023). GPT-4 Technical Report. arXiv:2303.08774. https://arxiv.org/abs/2303.08774
- Orwell, G. (1949) Nineteen Eighty-Four. Secker & Warburg.
- Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. NeurIPS 35.
- Park, J. L. (1970). The Concept of Transition in Quantum Mechanics. Foundations of Physics, 1(1), 23–33. https://doi.org/10.1007/BF00708652
- Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving. Addison-Wesley.
- Pearl, J. (1988). Probabilistic Reasoning in Intelligent Systems. Morgan Kaufmann.
- Proudfoot, D. (2017). The Turing Test—from Every Angle. In The Turing Guide. Oxford University Press. https://doi.org/10.1093/oso/9780198747826.003.0037
- Rice, H. G. (1953). Classes of Recursively Enumerable Sets and Their Decision Problems. Transactions of the American Mathematical Society, 74(2), 358–366.
- Robert Kowalski. (1979). Algorithm = Logic + Control. Communications of the ACM, 22(7), 424–436.
- Rosenblatt, F. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386–408.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning Representations by Back-Propagating Errors. Nature, 323, 533–536.
- Russell, S. (2019). Human Compatible: Artificial Intelligence and the Problem of Control. Viking.
- Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
- Searle, J. R. (1980). Minds, Brains, and Programs. Behavioral and Brain Sciences, 3(3), 417–424.
- Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27, 379–423, 623–656.
- Shazeer, N. et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. ICLR.
- Shumailov, I., Shumaylov, Z., Zhao, Y. et al. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755–759. https://doi.org/10.1038/s41586-024-07566-y
- Silver, D. et al. (2016). Mastering the Game of Go with Deep Neural Networks and Tree Search. Nature, 529, 484–489.
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- Tononi, G. (2004). An Information Integration Theory of Consciousness. BMC Neuroscience, 5, 42.
- Trinh, T. H., Wu, Y., Le, Q. V. et al. (2024). Solving olympiad geometry without human demonstrations. Nature, 625, 476–482. https://doi.org/10.1038/s41586-023-06747-5
- Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 42, 230–265.
- Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
- U.S. Copyright Office. (2024). Copyright and Artificial Intelligence, Part 1: Digital Replicas. https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-1-Digital-Replicas-Report.pdf
- U.S. Copyright Office. (2025a). Copyright and Artificial Intelligence, Part 2: Copyrightability. https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-2-Copyrightability-Report.pdf
- U.S. Copyright Office. (2025b). Copyright and Artificial Intelligence, Part 3: Generative AI Training (Pre-Publication Version). https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-3-Generative-AI-Training-Report-Pre-Publication-Version.pdf
- Unwin, T. (2005) Jules Verne. Liverpool University Press.
- Vaswani, A. et al. (2017). Attention Is All You Need. NeurIPS 30.
- Werbos, P. J. (1974). Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences. PhD dissertation, Harvard University.
- Wiener, N. (1948). Cybernetics: Or Control and Communication in the Animal and the Machine. MIT Press.
- Wootters, W. K., & Zurek, W. H. (1982). A Single Quantum Cannot Be Cloned. Nature, 299, 802-803.
- Wu, T., Luo, L., Li, Y.-F., Pan, S., Vu, T.-T., & Haffari, G. (2024). Continual Learning for Large Language Models: A Survey. arXiv:2402.01364. https://arxiv.org/abs/2402.01364
- Zadeh, L. A. (1965). Fuzzy Sets. Information and Control, 8(3), 338–353.