


Sesten Konuşmacı Tanıma ve Ayrıştırma

Konuşmacı doğrulama ve kimlik belirleme; metne bağımlı/metinden bağımsız tanıma, GMM-UBM, i-vector, konuşmacı gömmeleri, eşik kalibrasyonu ve konuşmacı ayrıştırma.
Konuşmacı tanıma, ses örneklerinden konuşmacı kimliği hakkında benzerlik skoru üretir. Kimlik belirleme, doğrulama ve konuşmacı ayrıştırma farklı karar problemleridir.
Kimlik Belirleme ve Doğrulama
Konuşmacı tanıma iki farklı karar problemine ayrılır.
Konuşmacı doğrulama, kullanıcının ileri sürdüğü kimliği sınar. Test kaydı çoğunlukla tek bir kayıtlı konuşmacı modeliyle karşılaştırılır; soru “bu kayıt iddia edilen kişiye ait mi?” biçimindedir.
Konuşmacı kimlik belirleme, kaydın bilinen konuşmacılar arasından hangisine ait olduğunu araştırır. Test örneği birden çok adayla karşılaştırılır ve açık küme sisteminde hiçbir aday yeterli skora ulaşmazsa “bilinmeyen konuşmacı” sonucu üretilebilir.
Bu iki problem aynı embedding altyapısını kullanabilir; ancak aday sayısı, eşik kalibrasyonu ve hata maliyetleri farklıdır. Bir doğrulama eşiğinin çok adaylı kimlik belirleme için doğrudan uygun olduğu varsayılmamalıdır.
Metne Bağımlı ve Metinden Bağımsız Tanıma
Metne bağımlı sistemde kayıt ve test sırasında belirli bir sözcük, parola veya ifade beklenir. Sistem hem konuşmacı özelliğinden hem de beklenen içeriğin tutarlılığından yararlanabilir. Bu yaklaşım erişim kontrolü gibi kontrollü senaryolarda kullanılabilir.
Metinden bağımsız sistemde konuşmacının hangi sözcükleri söylediği önceden belirlenmez. Model, değişen fonetik içerik altında konuşmacıya ilişkin daha kararlı özellikleri çıkarmaya çalışır. Serbest konuşma, telefon görüşmesi veya arşiv kaydı gibi içerik denetiminin olmadığı durumlarda bu yaklaşım daha uygundur.
Metne bağımlılık ile konuşma tanıma aynı problem değildir. Bir sistem beklenen ifadenin doğru söylenip söylenmediğini konuşma tanıma ile denetleyebilir; konuşmacı modeli ise ses özelliklerinin kayıtlı kişiyle ne ölçüde uyuştuğunu ayrı skorlar.
Klasik yaklaşımlar
GMM-UBM sistemleri konuşmacı dağılımını evrensel arka plan modeliyle karşılaştırır. I-vector yaklaşımı konuşmayı düşük boyutlu total variability uzayında temsil eder. PLDA gibi yöntemler bu temsiller arasında skor üretir.
Öğrenilmiş temsiller
Güncel sistemler x-vector ve benzeri konuşmacı gömme vektörleri kullanır. Eğitim sırasında aynı konuşmacı örneklerinin yakın, farklı konuşmacıların uzak temsiller üretmesi hedeflenir.
Konuşmacı tanıma sonucunda elde edilen skor, seçilen eşik üzerinden kabul veya red kararına dönüştürülür. Kanal farkı, codec, kayıt süresi ve arka plan gürültüsü skor dağılımını değiştirebilir.
Konuşmacı ayrıştırma
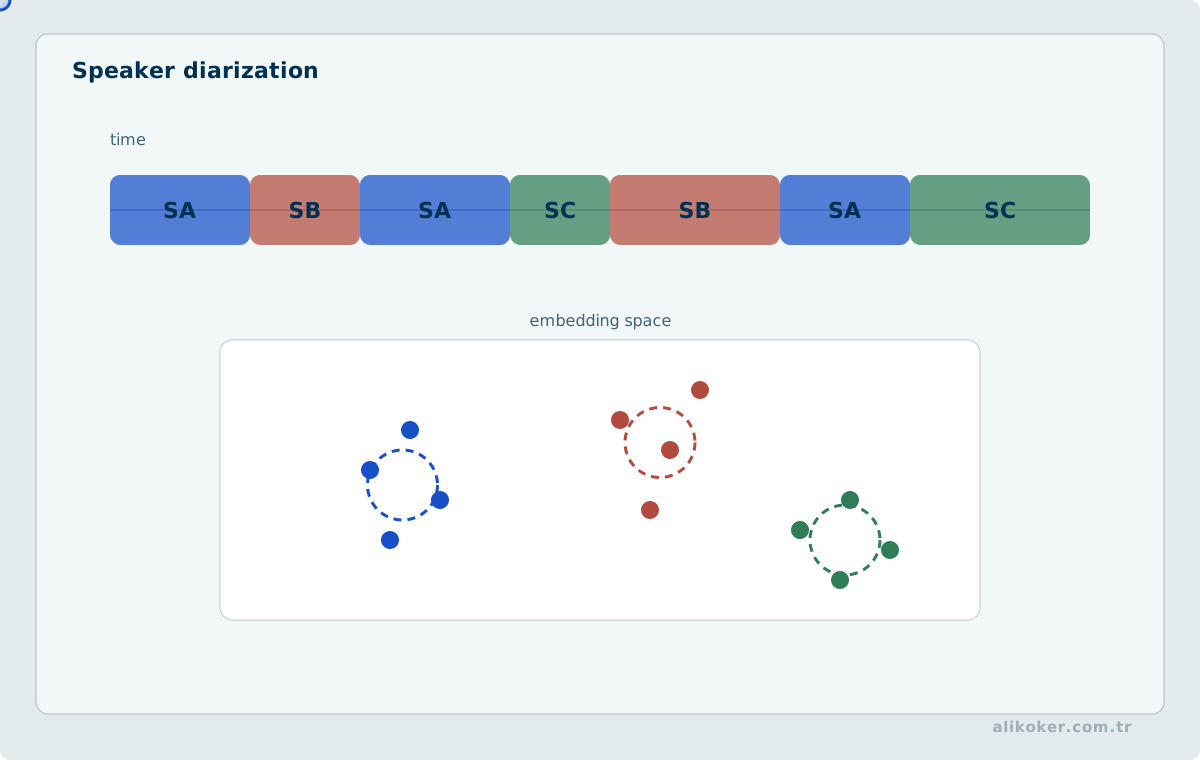
Konuşmacı ayrıştırma, “kim ne zaman konuştu?” sorusunu yanıtlar. VAD, segment embedding'leri ve kümeleme aynı zincirde çalışır. Bilinmeyen konuşmacı sayısı ve örtüşen konuşma zorlayıcı durumlardır.
Konuşmacı skoru deterministik kimlik göstergesi değildir; eşik, kayıt koşulları ve hata oranlarıyla birlikte yorumlanır.
Üst konu: Görüntü ve Ses İşleme
Kaynakça
- David Snyder; Daniel Garcia-Romero; Gregory Sell; Daniel Povey; Sanjeev Khudanpur. X-Vectors: Robust DNN Embeddings for Speaker Recognition. IEEE ICASSP 2018, 2018.
- Lawrence R. Rabiner; Ronald W. Schafer. Theory and Applications of Digital Speech Processing. Pearson, 2011.
