


Veri Yapıları ve Algoritma Analizi

Karmaşıklık analizi, temel veri yapıları, ağaçlar, hash tabloları, graflar, sıralama ve aramanın yanında böl-ve-yönet, greedy, dinamik programlama, amortize/rastgele analiz ve NP-zorluk sınırlarını kapsayan ders notları.
Veri yapıları ve algoritmalar, yapıların tanımı ile her işlemin maliyetini birlikte ele alır. Dizi, bağlı liste, yığın, kuyruk, ağaç, hash ve graf yapıları algoritma analiziyle birlikte değerlendirilir; Big-O yorumlarında en kötü, ortalama ve amortize maliyetler birbirinden ayrılır.
Ünite 1: Giriş ve Temel Kavramlar
1.1. Yazılım ve Program
Bir program, belirli bir problemi çözmek veya belirli bir görevi yerine getirmek için tanımlanmış algoritmanın bir programlama diliyle ifade edilmiş biçimidir. Yazılım ise tek bir programdan daha geniş bir kavramdır. Programların yanında yapılandırma bilgileri, veri dosyaları, kütüphaneler, testler, belgeler ve çalıştırma için gerekli diğer bileşenleri de kapsayabilir.
Veri yapıları ve algoritmalar açısından temel ayrım şudur:
- algoritma, çözümün işlem adımlarını,
- veri yapısı, bu adımlarda kullanılan verinin nasıl düzenlendiğini
belirler.
Aynı problem farklı veri yapılarıyla çözüldüğünde algoritmanın çalışma süresi ve bellek gereksinimi önemli ölçüde değişebilir.
1.2. Donanım ve Bellek
Bilgisayar donanımı işlemci, bellek, depolama birimleri ve G/Ç bileşenlerinden oluşur.
Bir program çalışırken temel olarak:
- komutlar,
- değişkenler,
- veri yapıları,
- çağrı yığını,
- dinamik olarak ayrılan alanlar
bellekte bulunur.
Bellek tek tip değildir. İşlemciye yakınlık ve erişim süresine göre genel hiyerarşi:
Yazmaçlar
    ↓
Önbellek
    ↓
Ana bellek
    ↓
Kalıcı depolama
biçiminde düşünülebilir.
Bir veri yapısının gerçek performansı yalnız teorik karmaşıklığa değil, bellekteki yerleşimine ve erişim örüntüsüne de bağlıdır.
1.3. İşletim Sistemi
İşletim sistemi uygulamalarla donanım arasında kaynak yönetimi ve soyutlama sağlar.
Başlıca görevleri:
- süreç ve iş parçacığı yönetimi,
- bellek yönetimi,
- dosya sistemi,
- aygıt yönetimi,
- güvenlik ve yetkilendirme,
- ağ hizmetleri,
- zamanlama
olarak özetlenebilir.
Veri yapıları uygulama düzeyinde görünse de birçok temel yapı işletim sistemlerinde doğrudan kullanılır. Örneğin:
- kuyruklar zamanlamada,
- ağaçlar dosya sistemlerinde ve sanal bellekte,
- hash tabloları çekirdek içi hızlı aramalarda,
- grafik yapıları bağımlılık ve kaynak ilişkilerinde
kullanılabilir.
1.4. Veri Yapısı ve Veri Modeli
Veri yapısı, verinin bellekte veya başka bir saklama ortamında nasıl düzenlendiğini ifade eder.
Örnekler:
- dizi,
- bağlantılı liste,
- yığın,
- kuyruk,
- ağaç,
- hash tablosu,
- graf.
Veri modeli ise problemdeki nesnelerin ve ilişkilerin nasıl kavramsallaştırıldığını anlatır.
Örneğin bir yol ağı graf modeliyle ifade edilebilir. Bu graf bellekte:
- komşuluk matrisi,
- komşuluk listesi,
- kenar listesi
gibi farklı veri yapılarıyla tutulabilir.
Bu nedenle veri modeli ile veri yapısı aynı kavram değildir.
1.5. Algoritma
Algoritma, belirli girdilerden beklenen çıktıyı üretmek için tanımlanmış sonlu ve açık işlem dizisidir.
Bir algoritmanın temel özellikleri:
- girdileri açık olmalıdır,
- çıktısı tanımlı olmalıdır,
- adımları belirsizlik içermemelidir,
- sonlu sürede tamamlanmalıdır,
- uygulanabilir işlemlerden oluşmalıdır.
Aynı problemi çözen algoritmalar arasında seçim yapılırken yalnız doğruluk değil:
- çalışma süresi,
- bellek gereksinimi,
- veri büyüklüğü,
- veri dağılımı,
- güncelleme sıklığı,
- uygulama ortamı
da değerlendirilir.
1.6. Program Çalışma Hızı ve Bellek Gereksinimi
Bir programın duvar saatiyle ölçülen çalışma süresi:
- işlemciye,
- derleyiciye,
- işletim sistemine,
- önbellek davranışına,
- giriş verisine,
- sistem yüküne
bağlıdır.
Algoritmaları donanımdan daha bağımsız karşılaştırmak için asimptotik karmaşıklık kullanılır.
İki temel ölçüt:
- zaman karmaşıklığı,
- alan karmaşıklığıdır.
Örneğin bir dizinin bütün elemanlarını bir kez dolaşan algoritma:
O(n)zaman karmaşıklığına sahiptir.
İki iç içe tam dolaşım:
O(n^2)olabilir.
1.7. İşlemci, Makine Kodu ve Assembly
İşlemci yalnız kendi komut kümesinde tanımlı makine komutlarını yürütür.
Makine kodu doğrudan işlemci tarafından çözümlenebilen ikili komut gösterimidir.
Assembly dili aynı komutları insan için daha okunabilir simgesel adlarla ifade eder.
Örneğin:
MOV
ADD
SUB
JMP
gibi komut adları assembly gösterimidir.
Modern yüksek düzeyli diller kaynak kodu doğrudan veya ara gösterimler üzerinden makine koduna dönüştürür.
1.8. Programlama Dilleri
Programlama dili algoritmayı yürütülebilir sisteme aktarmanın aracıdır.
Programlama dilleri farklı soyutlama düzeylerine ve çalışma modellerine sahiptir.
Örnekler:
- C ve C++ sistem programlama,
- Java ve C# yönetilen çalışma ortamları,
- Python genel amaçlı ve bilimsel uygulamalar,
- Rust bellek güvenli sistem programlama
alanlarında kullanılabilir.
"Alt düzey", "orta düzey" ve "üst düzey" ayrımı kesin teknik sınıflandırma değildir. Bir dilin uygunluğu problem alanı, performans ihtiyacı, araç ekosistemi ve bakım gereksinimine göre değerlendirilmelidir.
1.9. Veri Tabanı ve SQL
Veri tabanı büyük ve kalıcı veri kümelerinin düzenli biçimde saklanmasını sağlar.
İlişkisel veri tabanlarında SQL:
- veri tanımlama,
- sorgulama,
- ekleme,
- güncelleme,
- silme,
- yetkilendirme
işlemlerinde kullanılır.
Veri tabanının fiziksel iç yapısında da bu derste ele alınan veri yapıları bulunur. Örneğin indekslerde B-tree ailesi, hash yapıları ve farklı sıralı erişim mekanizmaları kullanılabilir.
1.10. Böl ve Yönet
Böl ve yönet yaklaşımı büyük problemi aynı yapıya sahip daha küçük problemlere ayırır.
Genel yapı:
Problemi böl
    ↓
Alt problemleri çöz
    ↓
Sonuçları birleştir
Örnek algoritmalar:
- merge sort,
- quicksort,
- binary search.
Böl ve yönet çoğu zaman özyinelemeli ifade edilir ancak özyineleme zorunlu değildir.
1.11. Ağ Programlama
Ağ programlama farklı süreç veya bilgisayarların protokoller üzerinden veri alışverişinde bulunmasını sağlar.
Günümüzde TCP/IP ailesi genel ağ iletişiminin temelidir.
Veri yapıları açısından ağ yazılımlarında:
- gönderim ve alım kuyrukları,
- bağlantı tabloları,
- yönlendirme grafikleri,
- zaman aşımı listeleri,
- tamponlar
önemli rol oynar.
1.12. Kıyaslama
Başarım ölçümü, bir algoritma veya sistemin belirli iş yükü altında ölçülmesidir.
Sağlıklı kıyaslama için:
- aynı problem,
- aynı veri kümesi,
- aynı donanım,
- aynı derleyici ayarları,
- yeterli tekrar sayısı,
- ısınma etkilerinin denetlenmesi
gerekir.
Asimptotik analiz ile başarım ölçümü birbirinin alternatifi değildir.
Asimptotik analiz büyüme davranışını, başarım ölçümü ise belirli gerçekleştirim ve ortamın gerçek davranışını gösterir.
Ünite 2: Veri Yapıları
Bir veri yapısı seçilirken işlemler önceden tanımlanmalıdır: arama, ekleme, silme, sıralı dolaşma ve rastgele erişim aynı maliyete sahip değildir. Ortalama durum karmaşıklığı yanında en kötü durum süresi ve ek bellek gereksinimi de değerlendirilir. Veri dağılımı veya erişim örüntüsü değiştiğinde seçimin yeniden gözden geçirilmesi gerekebilir. Aynı işlevi sağlayan iki yapıyı karşılaştırırken yalnız küçük test girdilerinin süresine değil, ölçek büyüdüğünde maliyeti belirleyen işlemlere bakılır.
2.1. Ham Veriden Bilgiye
Bellek fiziksel olarak bit dizileri saklar. Bu bitlerin anlamı veri tipine göre belirlenir.
Aynı bit dizisi:
- tamsayı,
- karakter,
- yüzen nokta,
- komut,
- renk,
- adres
olarak farklı yorumlanabilir.
Bu nedenle veri yalnız bit dizisi değildir. Anlam için bir gösterim biçimi gerekir.
2.2. Veri Yapılarının Sınıflandırılması
Temel düzeyde veri yapıları iki grupta düşünülebilir:
Temel veri tipleri
- tamsayı,
- yüzen nokta,
- karakter,
- Boolean.
Bileşik veya kullanıcı tanımlı yapılar
- dizi,
- record/struct,
- union,
- sınıf,
- bağlantılı yapı.
Daha üst düzey soyut veri tipleri ise:
- stack,
- kuyruk,
- set,
- map,
- tree,
- graph
gibi davranış sözleşmeleri tanımlar.
2.3. Bilgisayar Belleği
Modern genel amaçlı sistemlerde bellek bayt adreslidir.
Bir bayt:
8 bitolarak kabul edilir.
Adres:
0
1
2
3
...
şeklinde her bayta erişim sağlar.
Çok baytlı değerlerde byte order önemlidir:
- little-endian,
- big-endian.
Örneğin 32 bit 0x12345678 değeri little-endian bellekte:
78 56 34 12sırasıyla bulunabilir.
Veri yapılarında gerçek bellek tüketimi yalnız alanların toplamından oluşmayabilir. Hizalama ve dolgulama ek alan oluşturabilir.
2.4. Karakter Verisi
ASCII 7 bitlik bir karakter kodlamasıdır ve 128 kod noktası tanımlar.
Modern sistemlerde temel karakter standardı Unicode'dur.
Unicode karakterleri tek bir sabit 16 bit değerle sınırlı değildir. Unicode bir kod noktası uzayı tanımlar. Bu kod noktaları farklı kodlama biçimleriyle saklanabilir:
- UTF-8,
- UTF-16,
- UTF-32.
UTF-8 değişken uzunlukludur ve ASCII ile ilk 128 kod noktasında uyumludur.
Bu nedenle:
karakter sayısı != bayt sayısıolabilir.
Özellikle Unicode metinlerinde indisleme, uzunluk ve kesme işlemlerinde kod noktası ile kullanıcı tarafından algılanan karakter arasındaki fark da önemlidir.
2.5. İşaretsiz Tamsayı
n bitlik işaretsiz tamsayı:
0 ... 2^n - 1aralığındadır.
8 bit için:
0 ... 2552.6. İşaretli Tamsayı
Modern bilgisayarlarda signed integer için temel yöntem ikinin tümleyenidir.
n bit signed aralık:
-2^(n-1) ... 2^(n-1)-132 bit için:
-2^31 ... 2^31 - 1İki'nin tümleyeninin avantajları:
- tek sıfır gösterimi,
- toplama ve çıkarma donanımının sadeleşmesi,
- işaret genişletmenin kolay olmasıdır.
Bir'in tümleyeni ve işaretli-genlik tarihsel gösterimlerdir.
2.7. BCD
Binary Coded Decimal, her onluk rakamı ayrı ikili kodla temsil eder.
Örneğin:
123packed olmayan temel BCD düşüncesinde:
0001 0010 0011olarak kodlanabilir.
BCD özellikle tam onluk davranışın önemli olduğu belirli finansal ve donanımsal uygulamalarda tarihsel ve pratik öneme sahiptir.
2.8. Yüzen Nokta Sayılar
Gerçel sayıların bilgisayardaki yaygın gösterimi IEEE 754 standardına dayanır.
Binary32:
1 bit  sign
8 bit  exponent
23 bit fraction
Binary64:
1 bit  sign
11 bit exponent
52 bit fraction
Normal bir binary32 sayı:
(-1)^s x 1.f x 2^(e-127)biçiminde yorumlanır.
Üs ikinin tümleyeni olarak değil, bias'lı üs olarak tutulur.
IEEE 754 ayrıca:
- pozitif ve negatif sıfır,
- sonsuzluk,
- NaN,
- subnormal sayılar
gibi özel değerleri tanımlar.
Yüzen nokta aritmetiği reel sayı aritmetiğinin tam karşılığı değildir. Yuvarlama hataları oluşabilir.
Örneğin birçok ikili yüzen nokta sisteminde:
0.1 + 0.2matematiksel 0.3 değerinin tam ikili gösterimini üretmez.
2.9. Karakter Dizisi
Bir karakter dizisi, yani string, bir karakterler dizisidir.
C dilinde klasik gösterim sonlandırıcı sıfır karakterini kullanır:
char text[] = "abc";bellekte:
'a' 'b' 'c' '\0'olarak tutulur.
Başka diller:
- uzunluğu ayrıca tutabilir,
- immutable string kullanabilir,
- farklı Unicode kodlamaları uygulayabilir.
Bu nedenle string'in iç gösterimi dile ve çalışma ortamına bağlıdır.
2.10. Diziler
Dizi aynı türdeki elemanları ardışık mantıksal indislerle saklar.
A[0]
A[1]
A[2]
...
Bir boyutlu dizi için eleman adresi yaklaşık olarak:
adres(A[i]) =
taban_adresi + i x eleman_boyutu
olduğundan indisle erişim:
O(1)zamanlıdır.
Dizinin ortasına eleman eklemek veya çıkarmak ise eleman kaydırmayı gerektirebilir:
O(n)2.11. Çok Boyutlu Diziler
Matris:
A[i][j]gibi iki boyutlu yapıdır.
Bellekte çoğunlukla doğrusal alana dönüştürülür.
İki yaygın yerleşim:
- satır-major,
- column-major.
C ailesi dillerde klasik çok boyutlu diziler satır-major yerleşime sahiptir.
2.12. Struct
C dilindeki struct, farklı tipte alanları tek kayıt altında birleştirir.
struct Person {
    int id;
    char name[64];
    double score;
};
Bellek boyutu alanların aritmetik toplamından daha büyük olabilir. İşlemcinin hizalama gereksinimleri dolgulama oluşturabilir.
2.13. Union
union içindeki alanlar aynı bellek bölgesini paylaşır.
union Value {
    int i;
    float f;
};
Union boyutu genel olarak en büyük üyenin gereksinimine ve hizalamaya göre belirlenir.
Union bellek tasarrufu sağlayabilir ancak aynı bellek bölgesinin farklı tiplerle yorumlanması dilin kurallarına uygun yapılmalıdır.
2.14. Bit Alanları
C dilinde bit field kullanılarak bazı alanlar bit düzeyinde tanımlanabilir.
Örnek:
struct Flags {
    unsigned ready : 1;
    unsigned mode  : 3;
};
Bit field yerleşiminin bazı ayrıntıları derleyici ve ABI'ye bağlı olabilir.
Taşınabilir protokol veya dosya biçimlerinde açık bit maskeleri çoğu zaman daha öngörülebilir çözüm sağlar.
Ünite 3: Veri Modelleri
3.1. Liste
Liste, elemanların belirli sırada tutulduğu doğrusal modeldir.
Temel işlemler:
- ekleme,
- silme,
- arama,
- dolaşma,
- güncelleme.
Liste dizi veya bağlantılı listeyle gerçekleştirilebilir.
3.2. Bağlantılı Liste
Bağlantılı listede elemanlar bellekte fiziksel olarak ardışık olmak zorunda değildir.
Her düğüm veri ve bağlantı bilgisi taşır.
Tek yönlü liste:
[veri|next] -> [veri|next] -> [veri|null]Avantajı belirli konuma erişildikten sonra bağlantının değiştirilmesiyle ekleme ve silmenin yapılabilmesidir.
Dezavantajı indisle rastgele erişimin olmamasıdır.
3.3. Ağaç Modeli
Ağaç hiyerarşik ilişkileri temsil eder.
Temel kavramlar:
- kök,
- düğüm,
- kenar,
- ebeveyn,
- çocuk,
- kardeş,
- yaprak,
- alt ağaç,
- derinlik,
- yükseklik.
Dosya sistemi, sözdizim ağacı ve indeks yapıları ağaç modeline örnektir.
3.4. Graf Modeli
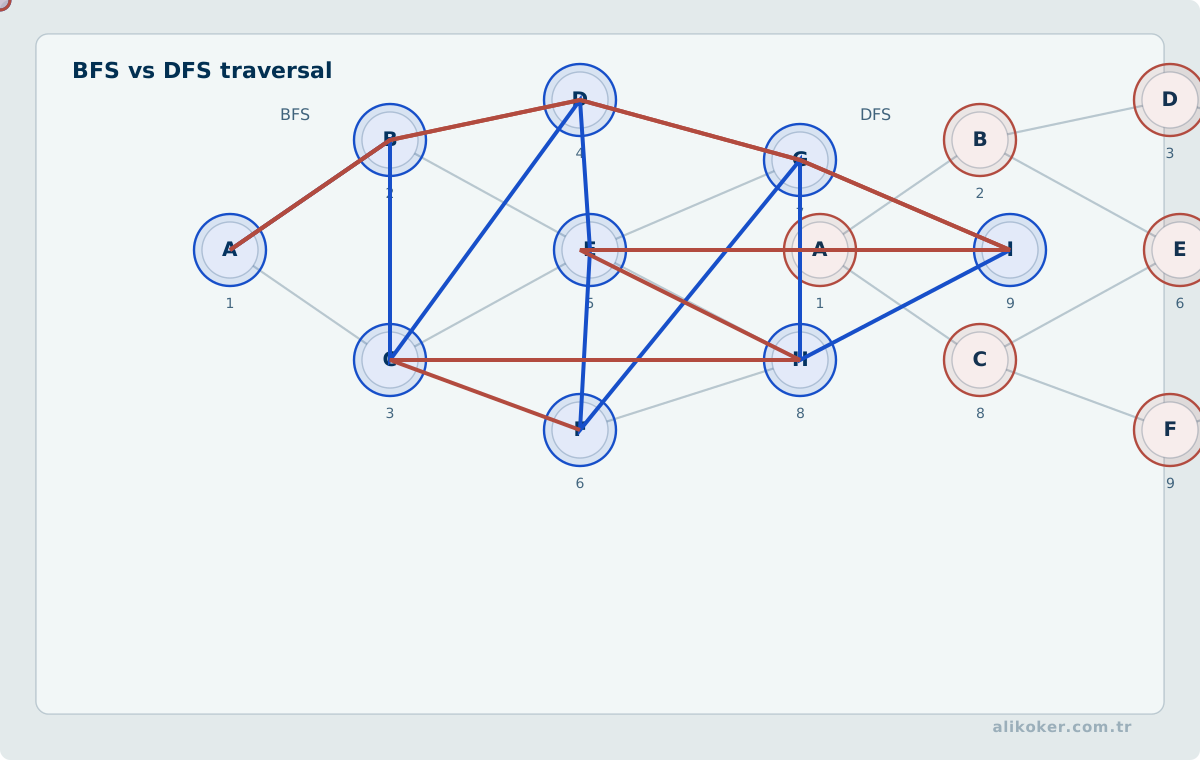
Graf:
G = (V, E)biçiminde düğümler ve kenarlar kümesi olarak tanımlanır.
Graf:
- yönlü,
- yönsüz,
- ağırlıklı,
- ağırlıksız
olabilir.
Yol ağları, sosyal ilişkiler, iletişim ağları ve bağımlılık grafikleri bu modele uygundur.
3.5. Durum Makinesi
Durum makinesi bir sistemin:
- durumlarını,
- girdilerini veya olaylarını,
- durum geçişlerini
tanımlar.
Basit gösterim:
Bekliyor --başlat--> Çalışıyor
Çalışıyor --durdur--> Bekliyor
Çalışıyor --hata--> Hata
Durum makineleri:
- protokol,
- kullanıcı arabirimi,
- gömülü sistem,
- ayrıştırıcı,
- iş akışı
tasarımında kullanılır.
3.6. İlişkisel Veri Modeli
İlişkisel model veriyi tablolar ve bu tablolar arasındaki ilişkiler üzerinden temsil eder.
Bir tablo:
- satırlar,
- sütunlar,
- anahtarlar
üzerinden tanımlanır.
Bu model veri yapısından çok kavramsal ve mantıksal veri modelidir.
3.7. Ağ Modeli
Tarihsel veri tabanı terminolojisindeki network model, kayıtlar arasında birden çok bağlantıya izin veren veri modelidir.
Günümüzde genel amaçlı veri tabanlarında ilişkisel model daha yaygındır. Graf veri tabanları ise bağlantı yoğun problemlerde farklı bir modern yaklaşım sunar.
Ünite 4: Algoritmik Program Tasarımı
Bir algoritmanın doğruluğu için giriş koşulları, sonuç koşulu ve korunacak değişmezler birlikte ele alınır. Böl ve yönet kullanılan bir çözümde alt problemlerin gerçekten daha küçük olduğu ve birleştirme adımının doğru sonucu koruduğu gösterilir. Özyinelemeli çağrılarda taban durumunun erişilebilirliği, yinelemeli çözümlerde ise sonlanmayı sağlayan ilerleme ölçütü incelenir. Zaman karmaşıklığı yalnız baskın işlem sayısından türetilmeli; kullanılan belleğin girdiye göre büyümesi ayrıca belirtilmelidir.
4.1. Program Tasarımı
Program tasarımı doğrudan kod yazmakla başlamamalıdır.
Genel süreç:
- problemi tanımla,
- girdileri ve çıktıları belirle,
- veri modelini seç,
- veri yapısını belirle,
- algoritmayı oluştur,
- doğruluğunu incele,
- karmaşıklığını değerlendir,
- kodla,
- test et.
Veri yapısı seçimi algoritmadan bağımsız değildir.
Örneğin arama problemi:
- sırasız dizide
O(n), - sıralı dizide binary search ile
O(log n), - dengeli arama ağacında
O(log n), - uygun hash tablosunda ortalama
O(1)
davranabilir.
4.2. Sözde Kod
Sözde kod, algoritmayı belirli programlama dilinin sözdizimine bağlamadan ifade eder.
Örnek:
ortalama(A, n):
    toplam <- 0

    her x elemanı için A içinde:
        toplam <- toplam + x

    döndür toplam / n
Sözde kodun amacı çalıştırılabilir kod üretmek değil, algoritmanın mantığını açık hale getirmektir.
4.3. Gerçek Kod
Gerçek kod:
- veri tipleri,
- bellek modeli,
- hata denetimi,
- API kuralları,
- dil sözdizimi
gibi ayrıntıları içerir.
İyi sözde kod ile gerçek kod arasındaki geçiş mekanik olmak zorunda değildir. Gerçekleştirim ayrıntıları algoritmanın performansını değiştirebilir.
4.4. Akış Şemaları
Akış şemaları kontrol akışını görsel olarak ifade eder.
Temel öğeler:
- başlangıç/bitiş,
- işlem,
- karar,
- giriş/çıkış,
- akış oku.
Küçük algoritmalar için anlaşılır olabilir. Büyük yazılımlarda sözde kod, durum diyagramı, UML veya doğrudan kod daha uygun olabilir.
4.5. Koşullu Dallanma
Temel yapı:
eğer koşul:
    işlem A
değilse:
    işlem B
Programlama karşılığı:
if / elsebiçimindedir.
4.6. Döngü
Bir işlemin koşula bağlı tekrarıdır.
Yaygın modeller:
for
while
do-while
Her döngüde:
- başlangıç,
- devam koşulu,
- durum güncellemesi
açık olmalıdır.
4.7. İç İçe Döngüler
İç içe döngüler karmaşıklığı doğrudan etkileyebilir.
Örneğin:
for i = 1..n
    for j = 1..n
        işlem
toplam yaklaşık:
n x n = n^2işlem yapar.
Bu nedenle karmaşıklık:
O(n^2)olur.
4.8. İkinci Derece Denklemin Kökleri
Denklem:
ax^2 + bx + c = 0Diskriminant:
D = b^2 - 4aca != 0 için:
D > 0: iki reel kök,D = 0: tek çift katlı reel kök,D < 0: karmaşık eşlenik kökler
bulunur.
Algoritma yalnız formülü uygulamadan önce a = 0 durumunu da denetlemelidir.
4.9. Aritmetik Ortalama
n eleman için:
ortalama =
(x1 + x2 + ... + xn) / n
Bütün elemanların okunması gerektiğinden zaman karmaşıklığı:
Theta(n)ek alan gereksinimi ise giriş dışında:
Theta(1)olabilir.
4.10. En Küçük Elemanı Bulma
Bir dizide minimum bulmak için:
min <- A[0]

A[1..n-1] üzerinde:
    eğer A[i] < min:
        min <- A[i]
algoritması yeterlidir.
Karşılaştırma sayısı:
n - 1olur.
Dolayısıyla:
Theta(n)zamanlıdır.
Ünite 5: Zaman ve Alan Karmaşıklığı
5.1. Algoritma Analizi
Algoritma analizi belirli makinenin saniye cinsinden süresinden çok, giriş büyüklüğü arttıkça kaynak kullanımının nasıl büyüdüğünü inceler.
n çoğunlukla giriş büyüklüğüdür.
Örneğin:
- dizide eleman sayısı,
- grafta düğüm veya kenar sayısı,
- sayıdaki bit sayısı
olabilir.
5.2. Çalışma Süresi
Bir algoritmanın tam işlem sayısı:
T(n)ile gösterilebilir.
Örneğin:
T(n) = 3n + 5ise büyük n için doğrusal terim baskındır.
Asimptotik olarak:
Theta(n)davranışı gösterir.
5.3. Büyük O
O(g(n)) asimptotik üst sınır ifade eder.
Bir algoritma:
T(n) <= c g(n)koşulunu yeterince büyük n için sağlıyorsa:
T(n) = O(g(n))denebilir.
Büyük O'nun tek başına "tam karmaşıklık" olarak kullanılması yaygındır ancak matematiksel olarak üst sınırdır.
5.4. Büyük Omega
Omega(g(n)) asimptotik alt sınırdır.
5.5. Büyük Theta
Theta(g(n)) hem alt hem üst sınırın aynı büyüme sınıfında olduğunu gösterir.
Bir algoritmanın büyüme hızını daha kesin ifade etmek için çoğu zaman Theta kullanılır.
5.6. Yaygın Büyüme Sınıfları
- Karmaşıklık:
O(1); Örnek: Dizi indis erişimi - Karmaşıklık:
O(log n); Örnek: Binary search - Karmaşıklık:
O(n); Örnek: Doğrusal tarama - Karmaşıklık:
O(n log n); Örnek: Merge sort - Karmaşıklık:
O(n^2); Örnek: Basit çift döngüler - Karmaşıklık:
O(n^3); Örnek: Klasik bazı matris işlemleri - Karmaşıklık:
O(2^n); Örnek: Bazı alt küme aramaları - Karmaşıklık:
O(n!); Örnek: Tüm permütasyonların denenmesi
Girdi büyüdükçe düşük dereceli büyüme sınıfı genellikle büyük avantaj sağlar.
5.7. En İyi, Ortalama ve En Kötü Durum
Algoritma maliyeti veri düzenine göre değişebilir.
Örneğin linear search:
- en iyi: ilk elemanda bulur,
O(1), - en kötü: bütün diziyi tarar,
O(n), - ortalama: veri dağılımına bağlı olarak
Theta(n).
Quicksort:
- beklenen/ortalama:
O(n log n), - kötü pivot seçimlerinde:
O(n^2).
5.8. Amortize Analiz
Bazı işlemler ara sıra pahalı olsa da uzun işlem dizisinin ortalama maliyeti düşük olabilir.
Dinamik dizide kapasite büyütme örneği:
- çoğu ekleme
O(1), - zaman zaman bütün dizi kopyalanır.
Geometrik kapasite artışıyla append işleminin amortize maliyeti:
O(1)olabilir.
5.9. Alan Karmaşıklığı
Algoritmanın kullandığı ek belleğin büyümesini ifade eder.
Örnek:
- minimum bulma:
O(1)ek alan, - merge sort: klasik dizi gerçekleştiriminde
O(n)ek alan, - recursive DFS: çağrı yığını nedeniyle
O(V)düzeyine çıkabilir.
5.10. Kod Belleği
Programın makine kodu da bellek kullanır. Ancak algoritma analizinde çoğunlukla giriş boyutuna göre büyüyen veri alanı daha önemlidir.
5.11. Çağrı Yığını
Her fonksiyon çağrısı:
- dönüş adresi,
- parametreler,
- yerel değişkenler,
- saklanan yazmaçlar
için stack frame oluşturabilir.
Özyinelemeli algoritmalarda çağrı derinliği alan karmaşıklığını etkiler.
Örneğin dengeli binary tree üzerinde recursive traversal:
O(h)çağrı yığını kullanır.
h ağacın yüksekliğidir.
5.12. Başarım Ölçümü ile Analiz Arasındaki Fark
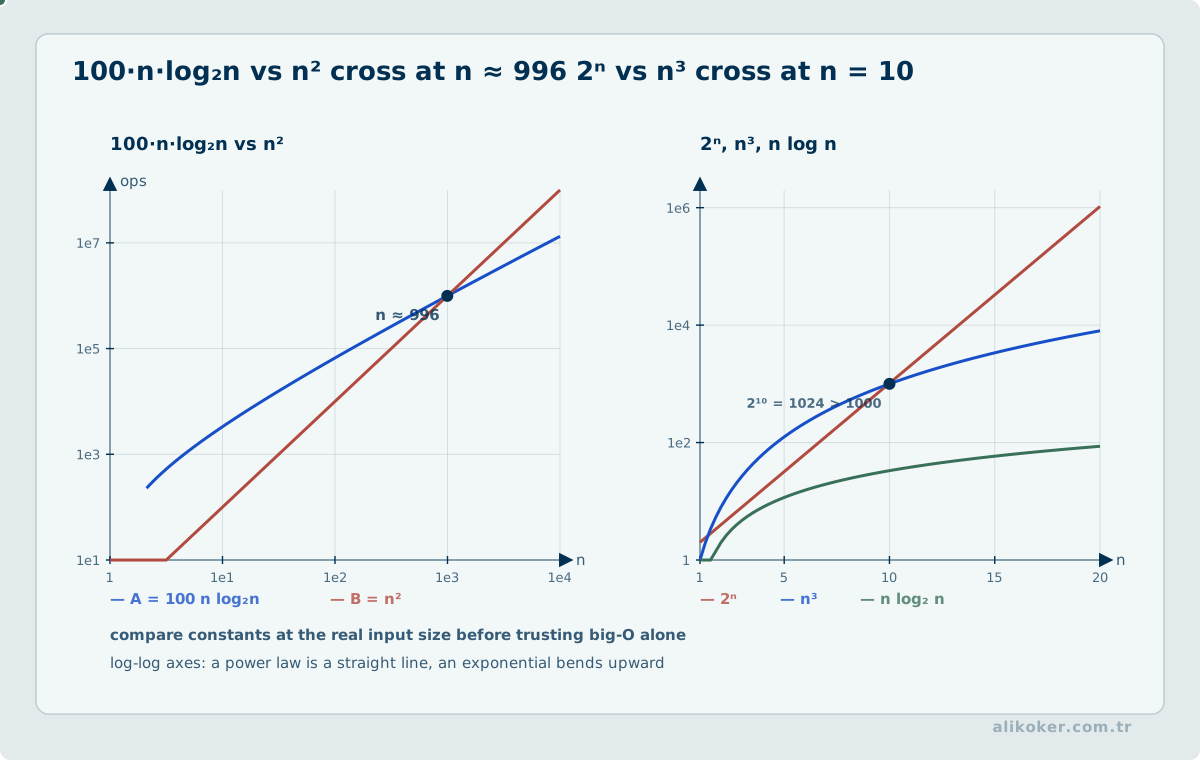
Teorik olarak O(n log n) algoritma küçük veri için O(n^2) algoritmadan daha yavaş olabilir.
Sabit çarpanlar, önbellek davranışı ve veri özellikleri etkilidir.
Bu nedenle mühendislikte:
Asimptotik analiz + gerçek ölçümbirlikte kullanılmalıdır.
Vektörleştirme, döngü maliyetini silmekten çok işlemi farklı bir yürütme katmanına taşır. Bitişik bellekte duran bir milyon elemanın tek geçişte toplanması, nesne başvuruları arasında dolaşan bir milyon öğeli yapıdan daha iyi önbellek yerelliği sunabilir. Ancak geçici büyük diziler üretmek bellek bant genişliğini tüketebilir ve küçük girdilerde çağrı maliyeti kazancı aşabilir. Dilimleme de her veri yapısında sabit maliyetli bir görünüm değildir; kimi uygulamada görünüm, kiminde kopya üretir. Algoritmanın asimptotik karmaşıklığı, bellek yerleşimi, ayırma sayısı ve ölçülen gecikme birlikte değerlendirilmelidir.
Ünite 6: Bağlantılı Listeler
6.1. Bağlantılı Liste Modeli
Bağlantılı listede her düğüm:
- veri,
- bir veya daha fazla bağlantı
içerir.
Tek yönlü düğüm:
+------+------+
| veri | next |
+------+------+
Liste:
head
 ↓
[A|•] -> [B|•] -> [C|null]
biçimindedir.
6.2. Dizi ile Bağlantılı Liste Farkı
- İşlem: İndisle erişim; Dizi:
O(1); Tek yönlü bağlantılı liste:O(n) - İşlem: Baştan ekleme; Dizi:
O(n)olabilir; Tek yönlü bağlantılı liste:O(1) - İşlem: Bilinen düğümden sonra ekleme; Dizi:
O(n)kaydırma; Tek yönlü bağlantılı liste:O(1) - İşlem: Arama; Dizi:
O(n); Tek yönlü bağlantılı liste:O(n) - İşlem: Bellek yerleşimi; Dizi: Ardışık; Tek yönlü bağlantılı liste: Dağınık olabilir
- İşlem: Ek bağlantı belleği; Dizi: Yok; Tek yönlü bağlantılı liste: Vardır
Bağlantılı liste her durumda diziden üstün değildir.
Modern işlemcilerde dizilerin ardışık bellek yerleşimi önbellek açısından önemli avantaj sağlar.
6.3. Tek Yönlü Bağlantılı Liste
Her düğüm yalnız sonraki düğümü gösterir.
head -> A -> B -> C -> nullSondan başa doğrudan hareket edilemez.
6.4. Çift Yönlü Bağlantılı Liste
Her düğüm:
- önceki,
- sonraki
düğümü gösterir.
null <- A <-> B <-> C -> nullAvantajı iki yönde dolaşma ve bilinen düğümün silinmesinde bağlantı düzenlemesinin kolay olmasıdır.
Karşılığında her düğüm ek işaretçi alanı kullanır.
6.5. Çevrimsel Liste
Son düğüm tekrar ilk düğüme bağlanır.
A -> B -> C
^         |
|_________|
Round-robin zamanlama gibi döngüsel dolaşım gereken problemlerde kullanılabilir.
6.6. Dinamik Bellek
C dilinde düğümler:
malloc()ile dinamik ayrılabilir ve:
free()ile serbest bırakılabilir.
Temel hata sınıfları:
- memory leak,
- dangling pointer,
- double free,
- use-after-free.
Yönetilen dillerde garbage collection birçok manuel serbest bırakma sorununu azaltır ancak veri yapısının mantıksal bağlantıları yine doğru yönetilmelidir.
6.7. Listeye Ekleme
Başa ekleme:
yeni.next <- head
head <- yeni
işlemleriyle yapılır.
Zaman:
O(1)Sona ekleme yalnız head tutuluyorsa:
O(n)olabilir.
Ayrıca tail tutulursa:
O(1)olabilir.
6.8. Listeleme
Bütün düğümler:
p <- head

while p != null:
    işle(p)
    p <- p.next
ile dolaşılır.
Karmaşıklık:
Theta(n)6.9. Arama
Sıralı olmayan listede arama:
O(n)zamanlıdır.
Bağlantılı listenin sıralı tutulması karşılaştırmayı bazı durumlarda erken bitirebilir ancak rastgele erişim olmadığı için binary search avantajı elde edilmez.
6.10. Silme
Tek yönlü listede bir düğümü silmek için genellikle önceki düğümün bilinmesi gerekir.
prev.next <- current.nextArdından dinamik bellek kullanılıyorsa current serbest bırakılır.
Düğüm aranarak bulunacaksa toplam maliyet:
O(n)olabilir.
6.11. Çift Yönlü Listede Silme
Düğümün adresi biliniyorsa:
node.prev.next <- node.next
node.next.prev <- node.prev
ile O(1) bağlantı güncellemesi yapılabilir.
Baş ve son durumları ayrıca ele alınmalıdır.
6.12. Sentinel Düğümler
Özel baş veya son sentinel düğümleri sınır durumlarını azaltabilir.
Örneğin:
HEAD <-> A <-> B <-> TAILBu yaklaşım ekleme ve silme kodunu sadeleştirebilir.
Ünite 7: Ağaç Veri Modeli
7.1. Ağaç Kavramı
Ağaç hiyerarşik ve döngüsüz bir yapıdır.
Temel kavramlar:
- root,
- parent,
- child,
- sibling,
- leaf,
- subtree,
- depth,
- height.
Bir ağacın n düğümü varsa bağlı bir ağaçta:
n - 1kenar bulunur.
7.2. Düğüm Derecesi
Bir düğümün çocuk sayısına düğüm derecesi denebilir.
Ağacın derecesi, düğümler arasındaki en yüksek çocuk sayısıyla ilişkilidir.
İkili ağaçta her düğümün en fazla iki çocuğu vardır.
7.3. Ağaçların Bellekte Gösterimi
Genel bir ağaç çeşitli biçimlerde tutulabilir:
- her çocuk için ayrı bağlantı,
- çocuk listesi,
- ilk çocuk/sonraki kardeş,
- indis bağıntılı dizi.
7.4. İlk Çocuk ve Sonraki Kardeş
Genel ağaç iki bağlantıyla tutulabilir:
node.firstChild
node.nextSibling
Bu yöntem değişken sayıda çocuk için sabit sayıda bağlantı alanı kullanır.
7.5. Dizi Tabanlı Ağaç
Tam veya tama yakın ağaçlarda düğümler dizi üzerinde verimli tutulabilir.
İkili öbek için sıfır tabanlı indislerle:
parent(i) = floor((i - 1) / 2)
left(i)   = 2i + 1
right(i)  = 2i + 2
Bu yöntem seyrek ağaçlarda büyük boşluklar oluşturabilir.
7.6. Dengeli Ağaç
Bir arama ağacının yüksekliği performans için kritiktir.
Ağaç tek yönde büyürse:
h ≈ nolabilir ve arama:
O(n)davranışına düşer.
Dengeli yapılarda hedef:
h = O(log n)olmasıdır.
7.7. AVL Ağacı
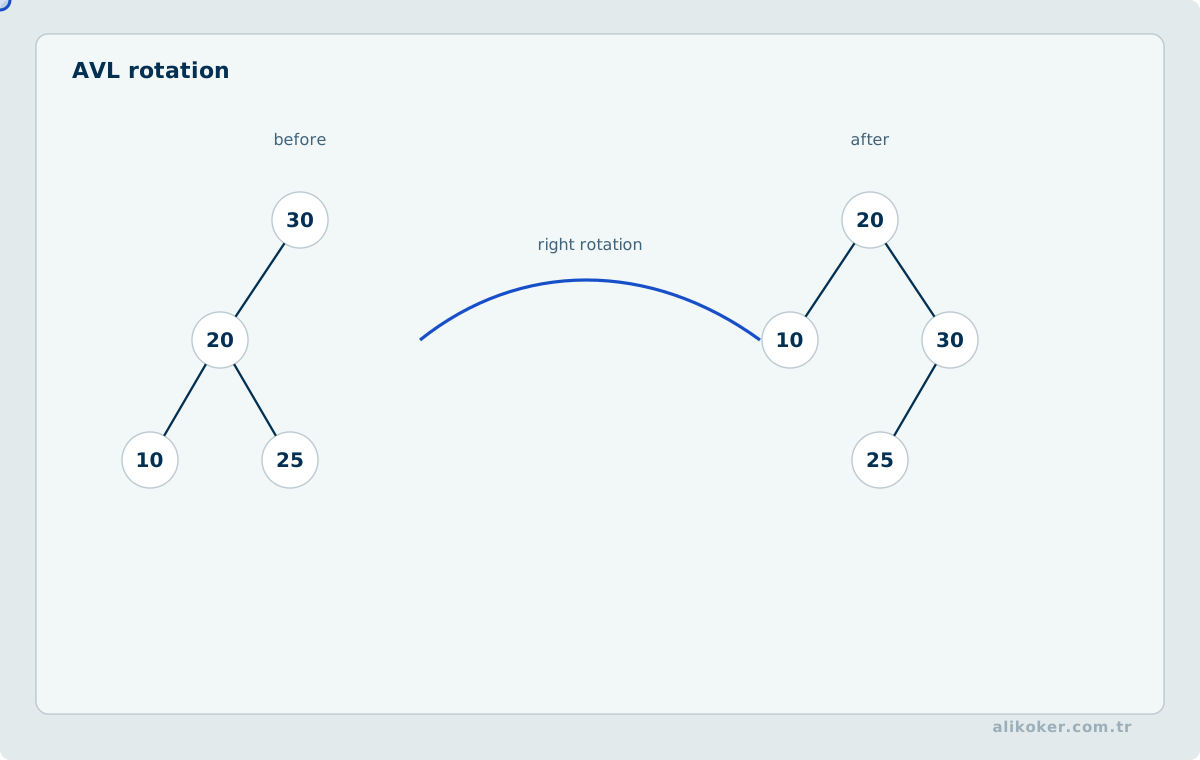
AVL ağacında her düğüm için sol ve sağ alt ağaç yüksekliği farkı en fazla 1'dir.
Denge faktörü:
BF = height(left) - height(right)Geçerli değerler:
-1, 0, +1Ekleme veya silme dengeyi bozarsa rotasyon yapılır.
Temel rotasyonlar:
- sağ rotasyon,
- sol rotasyon,
- sol-sağ,
- sağ-sol.
AVL ağacında arama, ekleme ve silme:
O(log n)zamanında yapılabilir.
7.8. Öbek
Öbek tamamlanmış ikili ağaca dayanan öncelik yapısıdır.
Max-öbek:
parent >= childrenMin-öbek:
parent <= childrenÖbek bütün elemanları tamamen sıralı tutmaz. Yalnız parent-child öncelik özelliğini korur.
Önemli karmaşıklıklar:
- minimum/maksimumu görme:
O(1), - ekleme:
O(log n), - kökü çıkarma:
O(log n), - öbek oluşturma:
O(n).
Öbek, priority kuyruk gerçekleştiriminde yaygın olarak kullanılır.
7.9. Trie
Trie karakter veya simge dizilerini ortak önekler üzerinden saklar.
Örnek:
        kök
       /   \
      c     d
      |
      a
     / \
    t   r
Kelime arama maliyeti veri sayısından çok anahtar uzunluğuyla ilişkilidir.
Yaklaşık:
O(m)m, anahtar uzunluğudur.
Sözlük, otomatik tamamlama ve routing benzeri önek aramalarında kullanılabilir.
7.10. Huffman Kodlama
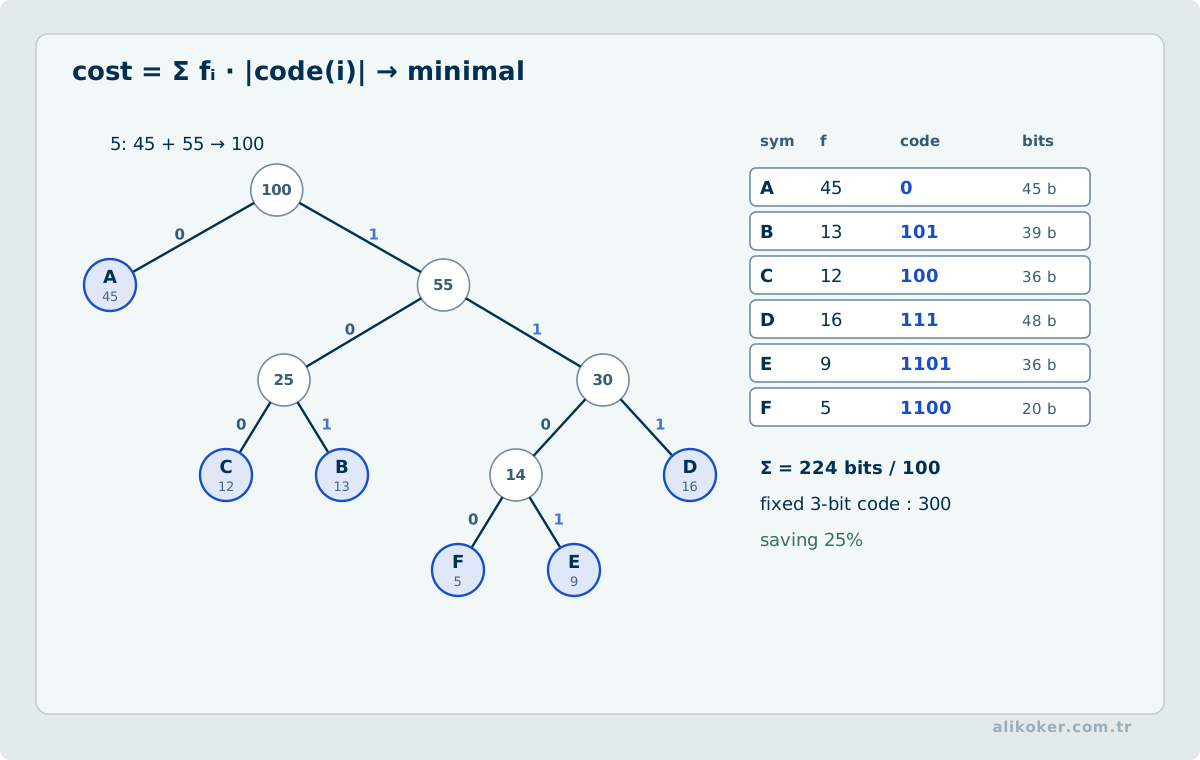
Huffman algoritması simge frekanslarından önek kodu üretir.
Temel süreç:
- her simgeyi frekansıyla min-öbeğe koy,
- en küçük iki frekansı çıkar,
- bunları yeni ortak düğüm altında birleştir,
- toplam frekansla öbeğe geri koy,
- tek kök kalana kadar sürdür.
Üretilen kod prefix-free'dir. Hiçbir kod sözcüğü başka kod sözcüğünün öneki değildir.
Bu sayede ayırıcı kullanmadan bit dizisi çözülebilir.
Huffman kodlamasında her simgenin kod sözcüğü uzunluğu eşit değildir; daha sık görülen simgelere genellikle daha kısa kod atanır. Ön ek koşulu, hiçbir tam kod sözcüğünün başka bir kodun başlangıcı olmamasını sağlar ve sınır işareti olmadan tek anlamlı çözmeyi mümkün kılar. Bir ağacın ortalama kod uzunluğu, her yaprağın derinliğinin o simgenin olasılığıyla ağırlıklandırılmış toplamıdır. Ancak yalnız ortalama uzunluğa bakmak yeterli değildir: çok kısa mesajlarda ağaç bilgisinin iletim maliyeti sıkıştırma kazancını aşabilir. Sembol dağılımı değiştiğinde sabit kod ağacının verimi yeniden ölçülmelidir.
7.11. Shannon-Fano
Shannon-Fano da simge olasılıklarına göre önek kod üretir.
Simgeler olasılıklarına göre sıralanır ve toplam olasılıkları birbirine yakın iki gruba bölünür.
Huffman ile aynı değildir.
Huffman, sembol bazlı ikili prefix kodları bağlamında optimal kod ağacı üretir. Shannon-Fano her zaman Huffman kadar iyi sonuç vermeyebilir.
Ünite 8: İkili Ağaçlar
8.1. İkili Ağaç
İkili ağaçta her düğümün en fazla:
- sol çocuk,
- sağ çocuk
olmak üzere iki çocuğu vardır.
       A
      / \
     B   C
    / \
   D   E
8.2. Tam, Dolu ve Dengeli Ağaç
Terimler kaynaklara göre farklı kullanılabildiği için açık tanım önemlidir.
Full binary tree: Her düğümün ya sıfır ya iki çocuğu vardır.
Complete binary tree: Son seviye dışında seviyeler doludur; son seviye soldan sağa doldurulur.
Perfect binary tree: Bütün iç düğümlerin iki çocuğu vardır ve bütün yapraklar aynı düzeydedir.
Balanced tree: Yüksekliğin O(log n) düzeyinde tutulduğu veya belirli denge koşulunu sağlayan ağaçtır.
8.3. Dolaşma
Üç klasik depth-first traversal:
Preorder
Root
Left
Right
Inorder
Left
Root
Right
Postorder
Left
Right
Root
8.4. Preorder
preorder(node):
    eğer node = null:
        dön

    işle(node)
    preorder(node.left)
    preorder(node.right)
8.5. Inorder
inorder(node):
    eğer node = null:
        dön

    inorder(node.left)
    işle(node)
    inorder(node.right)
Binary search tree üzerinde inorder dolaşma anahtarları sıralı üretir.
8.6. Postorder
postorder(node):
    eğer node = null:
        dön

    postorder(node.left)
    postorder(node.right)
    işle(node)
Alt ağaçların önce işlenmesi gereken silme veya ifade değerlendirme işlemlerinde yararlı olabilir.
8.7. Level-order
Düğümleri seviye seviye dolaşır.
Kuyruk kullanılır:
enqueue(root)

while queue boş değil:
    node <- dequeue()
    işle(node)

    varsa node.left enqueue
    varsa node.right enqueue
Bu, ağaç üzerindeki BFS'dir.
8.8. Infix, Prefix ve Postfix
İfade ağacı:
       *
      / \
     +   c
    / \
   a   b
için:
Infix
(a + b) * cPrefix
* + a b cPostfix
a b + c *Prefix Polonyalı gösterim, postfix ters Polonyalı gösterim olarak da bilinir.
8.9. Binary Search Tree
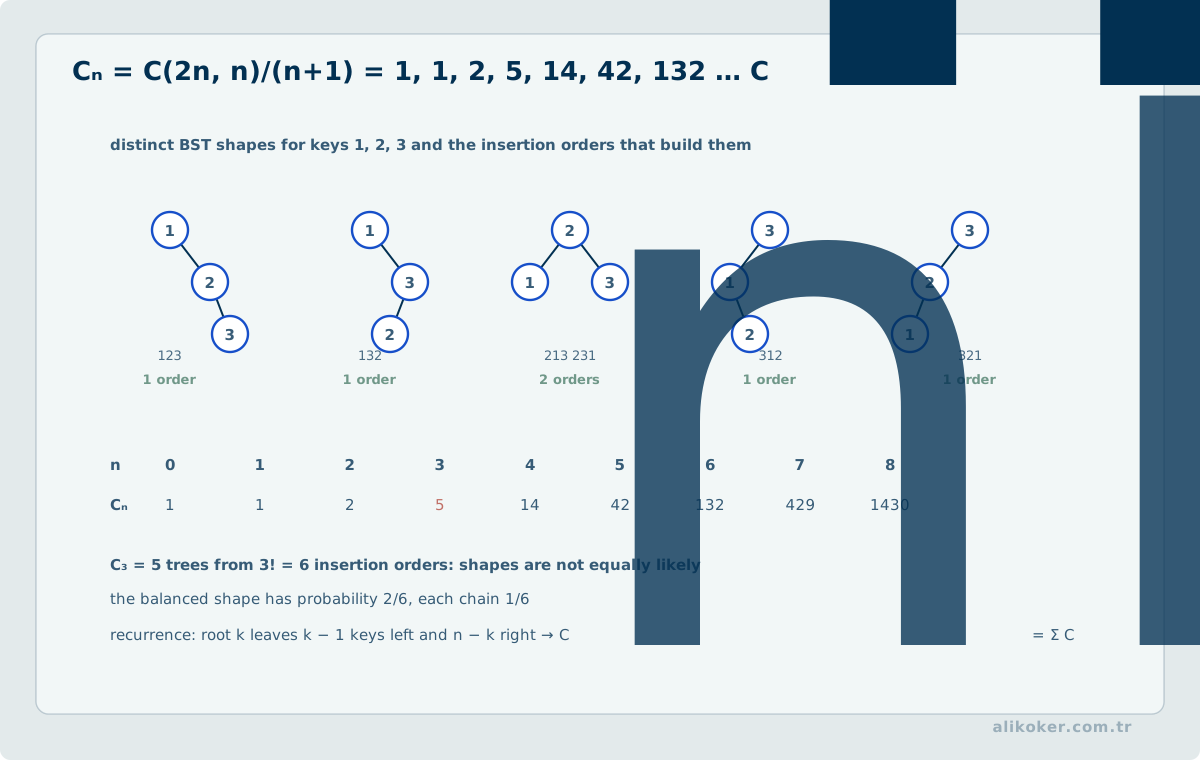
BST için temel kural:
sol alt ağaç < düğüm < sağ alt ağaçeşit anahtarların politikası uygulama tarafından ayrıca belirlenir.
Arama:
search(node, key):
    while node != null:
        eğer key = node.key:
            döndür node
        eğer key < node.key:
            node <- node.left
        değilse:
            node <- node.right

    döndür null
Maliyet:
O(h)h ağacın yüksekliğidir.
Dengeli durumda:
O(log n)kötü durumda:
O(n)8.10. BST Ekleme
Aramayla benzer biçimde uygun boş yaprağa ilerlenir.
Maliyet:
O(h)8.11. BST Silme
Üç durum vardır.
Yaprak düğüm: Doğrudan çıkarılır.
Tek çocuk: Çocuk düğüm silinen düğümün yerine bağlanır.
İki çocuk: Genellikle inorder successor veya predecessor bulunur, anahtar aktarılır ve daha basit silme durumuna indirgenir.
8.12. Dengeli Arama Ağaçları
AVL dışında:
- Red-Black Tree,
- B-tree,
- B+ tree
gibi dengeli yapılar da vardır.
Red-Black Tree birçok standart kütüphane ve çekirdek veri yapısında kullanılmıştır.
B-tree ailesi yüksek fan-out nedeniyle disk ve veri tabanı indekslerinde önemlidir.
Ünite 9: Yığın ve Kuyruk
9.1. Yığın
Stack:
LIFO
Last In, First Out
davranışına sahiptir.
Temel işlemler:
push,pop,peek/top,isEmpty.
Örnek:
push A
push B
push C

pop -> C
pop -> B
9.2. Yığın Kullanım Alanları
- fonksiyon çağrıları,
- expression evaluation,
- undo,
- ayrıştırıcı,
- DFS,
- backtracking.
9.3. Dizi Üzerinde Yığın
top = 0

push(x):
    A[top] = x
    top++

pop():
    top--
    return A[top]
Sabit kapasiteli dizide overflow denetlenmelidir.
Dinamik dizide kapasite büyütülebilir.
Push ve pop:
O(1)amortize veya doğrudan zamanlı olabilir.
9.4. Bağlantılı Liste Üzerinde Yığın
Başa ekleme ve baştan silme kullanılır.
top -> A -> B -> Cpush ve pop:
O(1)zamanlıdır.
9.5. Kuyruk
Kuyruk:
FIFO
First In, First Out
davranışına sahiptir.
Temel işlemler:
- enqueue,
- dequeue,
- front/peek,
- isEmpty.
9.6. Kaydırmalı Dizi Kuyruğu
Her dequeue işleminde bütün elemanları kaydırmak:
O(n)maliyet oluşturabilir.
Bu nedenle doğrudan tercih edilmez.
9.7. Çevrimsel Kuyruk
Dizinin sonundan sonra başına dönülür.
next(i) = (i + 1) mod capacityhead ve tail indisleri tutulur.
Enqueue/dequeue:
O(1)zamanlıdır.
9.8. Bağlantılı Liste Kuyruğu
Hem head hem tail tutulur.
Enqueue sona, dequeue başa yapılır.
İki işlem de:
O(1)olabilir.
9.9. Deque
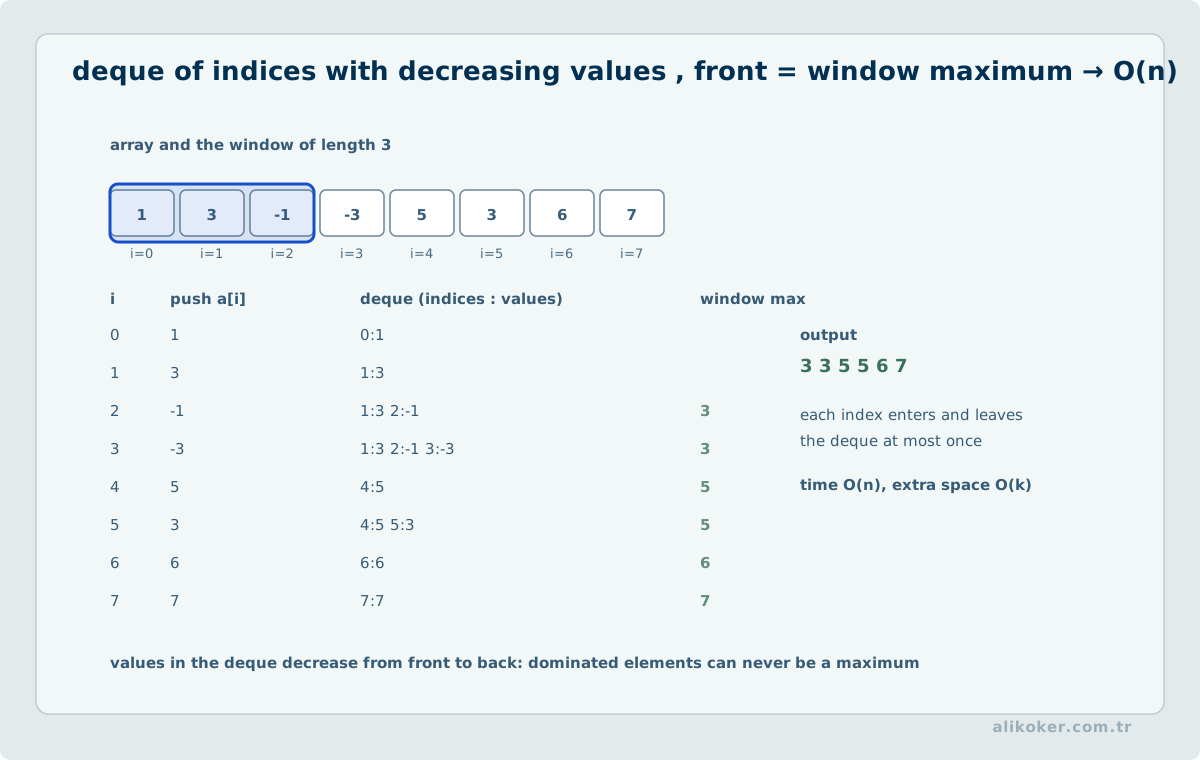
Double-ended kuyruk iki uçtan da ekleme ve çıkarma sağlar.
Temel işlemler:
- push_front,
- push_back,
- pop_front,
- pop_back.
Sliding window ve bazı graph algoritmalarında yararlıdır.
9.10. Öncelikli Kuyruk
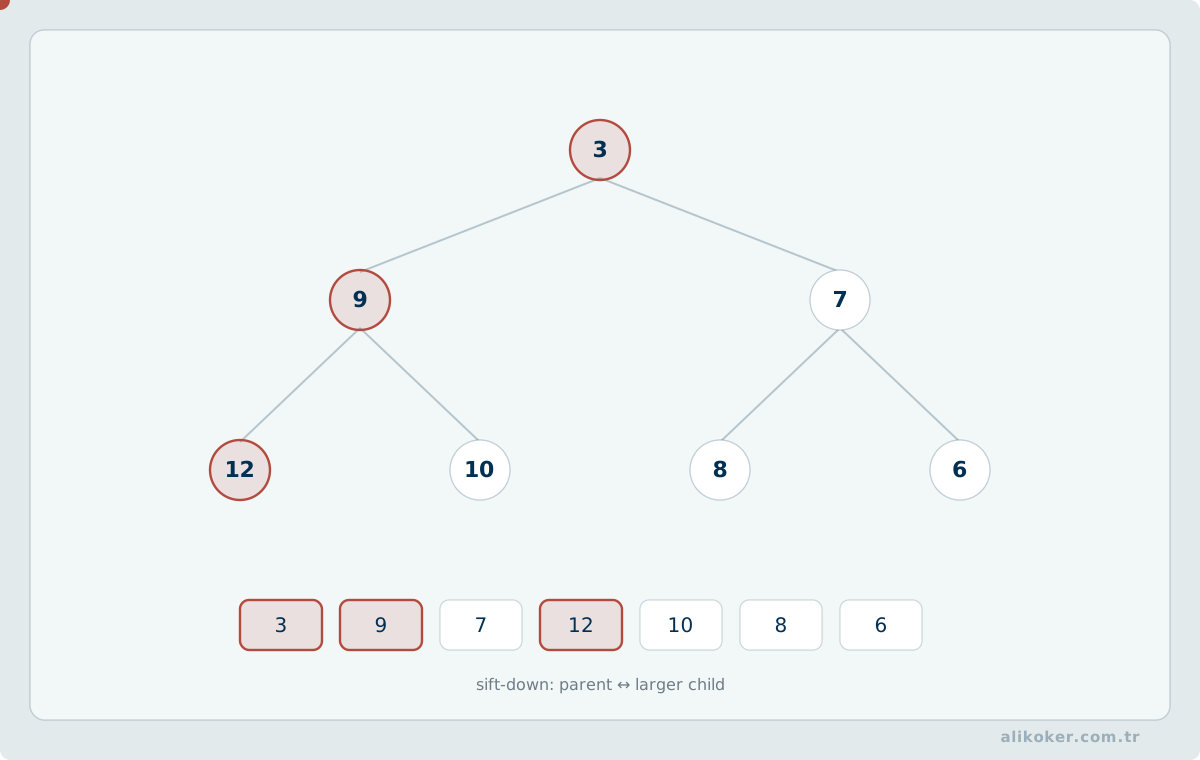
Priority kuyruk FIFO sırasından farklıdır. Eleman seçimi öncelik değerine göre yapılır.
Yaygın gerçekleştirim:
binary heapMin-priority kuyruk:
- minimum:
O(1), - insert:
O(log n), - extract-min:
O(log n).
Dijkstra ve Prim gibi algoritmalar öncelikli kuyruktan yararlanabilir.
9.11. Sınırlı Kuyruklarda Kapasite, Sıralama ve İlerleme Garantisi
Kuyruk veri yapısının FIFO davranışı, sistemin tüm istekleri sınırsız kabul etmesi gerektiği anlamına gelmez. Kapasitesi C olan sınırlı halka kuyruk, bellek tüketimine üst sınır koyar; dolduğunda bloklama, ret, eski kaydı düşürme veya geri basınç gibi politikalar seçilmelidir. Bu kararlar uygulamanın veri kaybı semantiği ve son teslim süreleriyle ilişkilidir.
Eşzamanlı SPSC, MPSC ve MPMC tasarımları, sıradan dizi tabanlı FIFO algoritmasının aynı bellek görünürlüğü garantilerini paylaşmaz. Doğrusal hale getirilebilirlik, işlemlerin eşzamanlı geçmişinde tek bir mantıksal sıraya oturtulabilmesini ifade eder; lock-free ilerleme garantisiyle aynı özellik değildir. Amortize O(1) enqueue/dequeue maliyeti, contention altında p99 gecikmesini veya CPU verimliliğini tek başına sınırlamaz.
Ünite 10: Sıralama Algoritmaları
10.1. Sıralama
Sıralama, elemanların belirli anahtara göre düzenlenmesidir.
Anahtar:
- sayı,
- metin,
- tarih,
- bileşik alan
olabilir.
Örneğin:
öğrenci -> numara
personel -> soyad
dosya -> tarih
10.2. İç ve Dış Sıralama
İç sıralama: Veri ana bellekte işlenebilir.
Dış sıralama: Veri ana belleğe sığmaz ve disk/SSD gibi dış saklama katmanları gerekir.
Dış sıralamada I/O maliyeti CPU karşılaştırma sayısından daha önemli olabilir.
External merge sort bu bağlamda temel algoritmadır.
10.3. Kararlı Sıralama
Stable sort, eşit anahtarlı elemanların göreli sırasını korur.
Örneğin:
(Ali, 80)
(Ayse, 80)
not alanına göre sıralandığında önceki göreli sıra korunuyorsa algoritma kararlıdır.
10.4. Yerinde Sıralama
In-place algoritma büyük ek veri alanı kullanmadan diziyi kendi üzerinde düzenler.
Kesin tanım kaynaklara göre değişebilse de genel olarak ek alan:
O(1)veya çok sınırlı kabul edilir.
10.5. Insertion Sort
Dizinin sol kısmını sıralı tutar ve yeni elemanı uygun konuma sokar.
for i = 1..n-1:
    x = A[i]
    j = i - 1

    while j >= 0 and A[j] > x:
        A[j+1] = A[j]
        j--

    A[j+1] = x
Karmaşıklık:
- en iyi:
O(n), - ortalama:
O(n^2), - en kötü:
O(n^2).
Küçük veya büyük ölçüde sıralı dizilerde etkilidir.
Kararlıdır ve yerinde gerçekleştirilebilir.
10.6. Selection Sort
Her turda kalan bölümün en küçük elemanını seçer.
for i = 0..n-2:
    min = i

    for j = i+1..n-1:
        if A[j] < A[min]:
            min = j

    swap(A[i], A[min])
Karşılaştırma sayısı:
Theta(n^2)olur.
Yer değiştirme sayısı görece azdır.
Klasik gerçekleştirim kararlı değildir.
10.7. Bubble Sort
Komşu elemanları karşılaştırıp ters sıradaysa değiştirir.
repeat:
    swapped = false

    for i:
        if A[i] > A[i+1]:
            swap
            swapped = true
until not swapped
Ortalama ve kötü durumda:
O(n^2)olur.
Eğitim açısından basittir fakat genel amaçlı büyük veri sıralamasında tercih edilmez.
10.8. Merge Sort
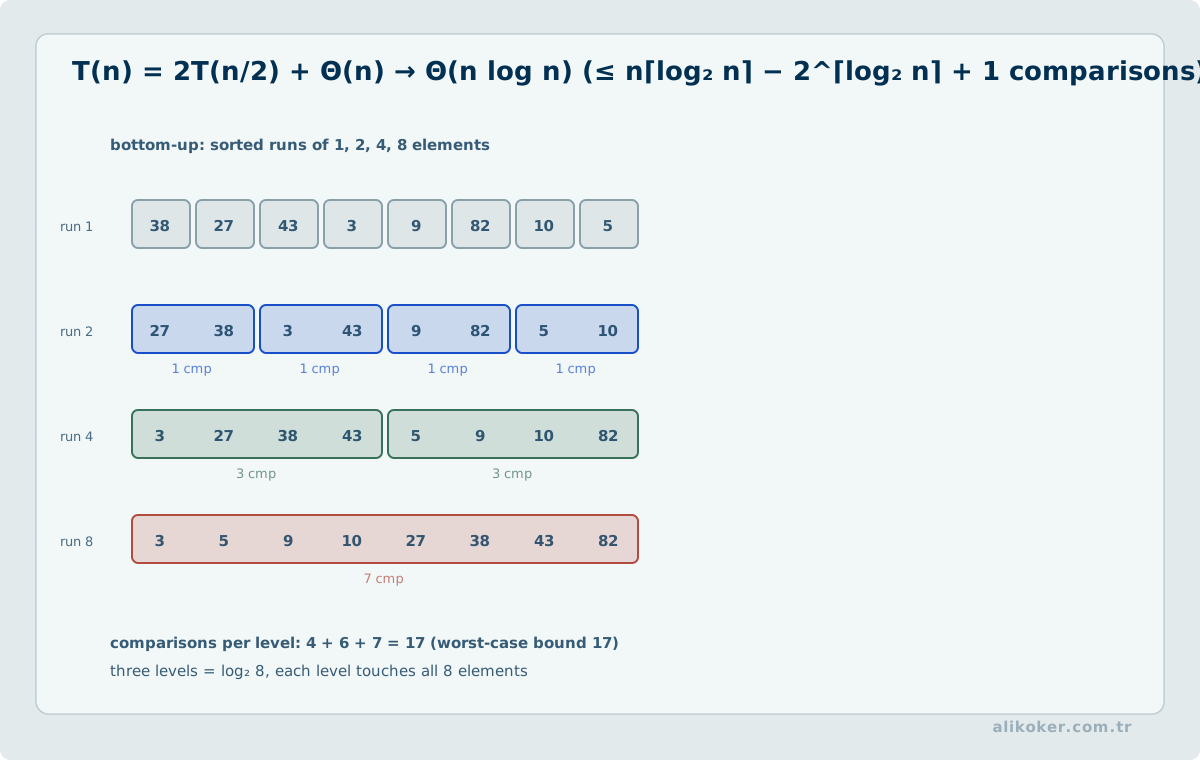
Böl ve yönet yaklaşımını kullanır.
mergeSort(A):
    eğer |A| <= 1:
        dön

    A'yı ikiye böl
    mergeSort(sol)
    mergeSort(sağ)
    merge(sol, sağ)
Zaman:
Theta(n log n)en iyi, ortalama ve kötü durumda aynıdır.
Klasik dizi gerçekleştiriminde ek alan:
O(n)gerektirir.
Kararlı yapılabilir.
Bağlantılı listeler ve dış sıralama için güçlü bir seçenektir.
10.9. Öbek Sort
Önce max-öbek oluşturur. Kök en büyük elemandır.
Her turda:
- kökü son elemanla değiştir,
- öbek boyutunu azalt,
- öbek özelliğini yeniden kur.
Zaman:
O(n log n)Ek alan:
O(1)olabilir.
Klasik öbek sort kararlı değildir.
10.10. Quicksort
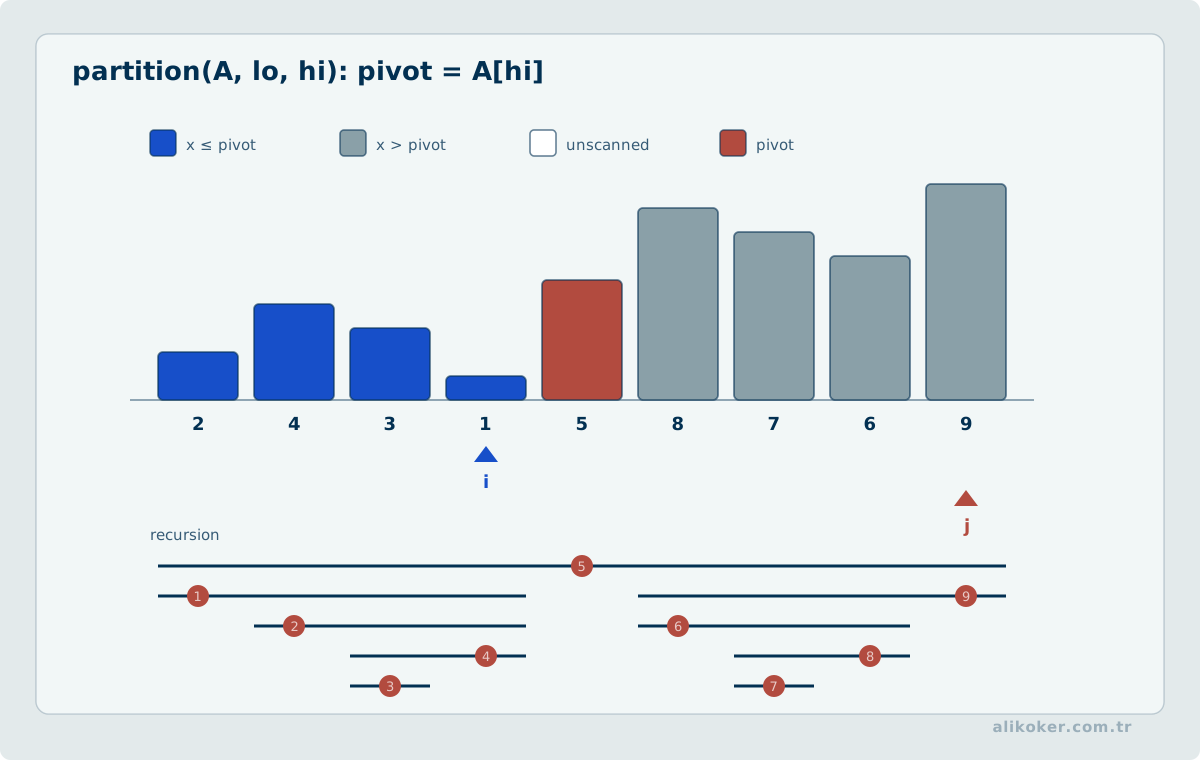
Bir pivot seçilir ve dizi pivot etrafında bölünür.
quicksort(A):
    pivot seç
    A'yı pivot etrafında partition et
    solu sırala
    sağı sırala
Beklenen zaman:
O(n log n)Kötü durum:
O(n^2)Random pivot veya iyi pivot stratejileri kötü durum olasılığını azaltır.
Quicksort pratikte iyi önbellek davranışı ve düşük sabit maliyet nedeniyle çok etkilidir.
10.11. Sıralama Algoritmalarının Karşılaştırılması
- Algoritma: Insertion; En iyi:
O(n); Ortalama:O(n^2); En kötü:O(n^2); Ek alan:O(1); Kararlı: Evet - Algoritma: Selection; En iyi:
O(n^2); Ortalama:O(n^2); En kötü:O(n^2); Ek alan:O(1); Kararlı: Genellikle hayır - Algoritma: Bubble; En iyi:
O(n)optimize; Ortalama:O(n^2); En kötü:O(n^2); Ek alan:O(1); Kararlı: Evet - Algoritma: Merge; En iyi:
O(n log n); Ortalama:O(n log n); En kötü:O(n log n); Ek alan:O(n)dizi; Kararlı: Evet - Algoritma: Öbek; En iyi:
O(n log n); Ortalama:O(n log n); En kötü:O(n log n); Ek alan:O(1); Kararlı: Hayır - Algoritma: Quick; En iyi:
O(n log n); Ortalama:O(n log n); En kötü:O(n^2); Ek alan: çağrı yığını; Kararlı: Genellikle hayır
Karşılaştırma tabanlı genel sıralama için karar ağacı modeli altında alt sınır:
Omega(n log n)olarak bilinir.
Counting sort ve radix sort gibi karşılaştırmasız algoritmalar belirli anahtar varsayımlarında bu sınırın dışında davranabilir.
Sıralamada kararlılığı gereksinim olarak belirtmek. Kayıtlar (kimlik, puan) biçiminde [(A,3), (B,1), (C,3)] olsun. Puan artan sıralandığında doğru sıralama B kaydını başa getirir; ancak eşit puanlı A ve C kayıtlarının kendi aralarındaki sırası iş kuralı gereği korunacaksa sonuç özellikle [(B,1), (A,3), (C,3)] olmalıdır. Bu koşul sıralamanın kararlılığıdır. Kararlı bir yöntem veya puanın ardından özgün konumu bağlayan açık bir ikincil anahtar seçilmediğinde, farklı çalıştırmalarda eşit anahtarlı kayıtların görünür sırası değişebilir. Denetim yalnız sayısal anahtarların artan olup olmadığına bakmamalı; eşit puanlı her ikili için başlangıç sırasının korunduğunu da sınamalıdır. Kararlılık için bellek, zaman ve karşılaştırıcı semantiğinin birlikte değerlendirilmesi gerekir.
Ünite 11: Arama ve Hash Tabloları
11.1. Arama Problemi
Amaç belirli anahtara sahip kaydı veri kümesinde bulmaktır.
Verinin yapısı arama algoritmasını belirler.
11.2. Doğrusal Arama
Sırasız dizide:
for i = 0..n-1:
    if A[i] = key:
        return i

return NOT_FOUND
En iyi:
O(1)En kötü:
O(n)Ortalama:
Theta(n)11.3. Binary Search
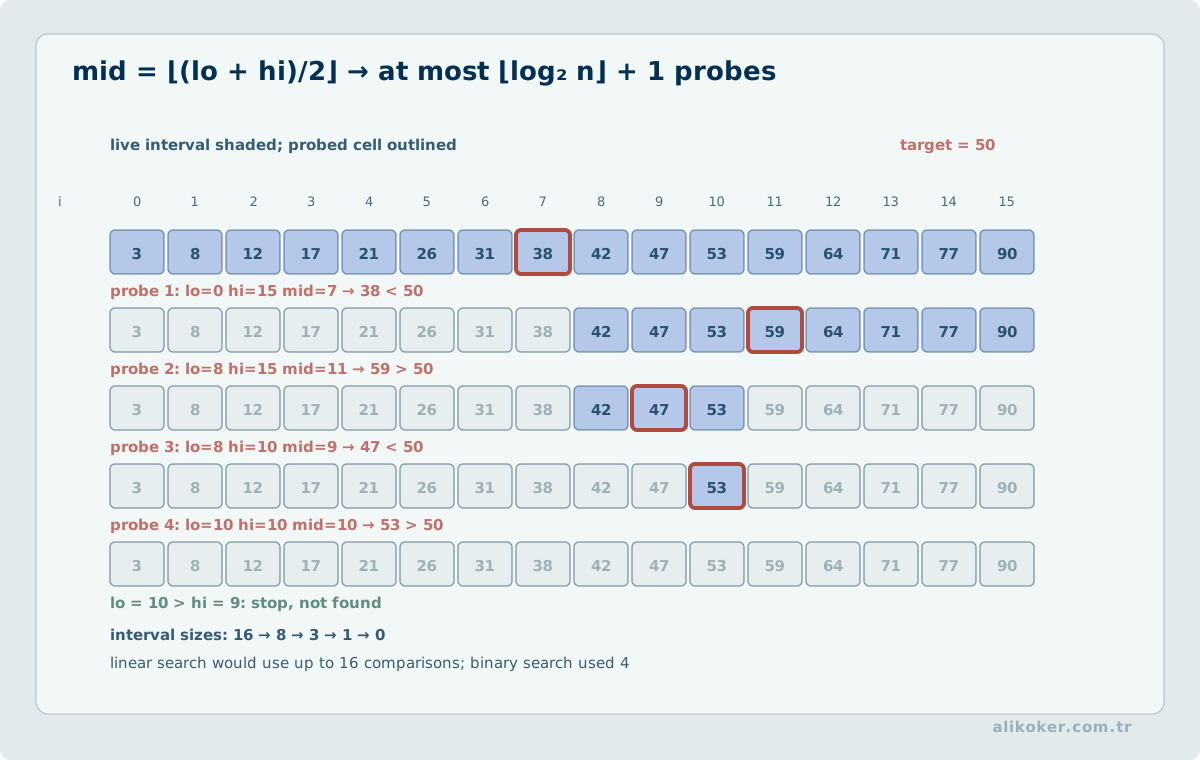
Önkoşul:
Veri arama anahtarına göre sıralı olmalıdır.
Algoritma:
left = 0
right = n - 1

while left <= right:
    mid = left + (right - left) / 2

    if A[mid] == key:
        return mid
    else if A[mid] < key:
        left = mid + 1
    else:
        right = mid - 1
Her adımda arama alanı yaklaşık yarıya iner.
Zaman:
O(log n)11.4. Binary Search Tree Üzerinde Arama
BST araması:
O(h)zamanlıdır.
Dengeli ağaçta:
O(log n)kötü biçimde dengesiz ağaçta:
O(n)olabilir.
11.5. Hash Fonksiyonu
Hash fonksiyonu anahtarı tablo indisine dönüştürür.
h(key) -> [0, m-1]Basit tamsayı örneği:
h(k) = k mod mİyi hash fonksiyonu anahtarları tabloya dengeli dağıtmaya çalışır.
Hash fonksiyonu ile kriptografik hash aynı gereksinimlere sahip değildir.
Veri yapısındaki hash fonksiyonu öncelikle hızlı ve dengeli dağılımlı olmalıdır.
11.6. Hash Tablosu
Hash tablosunda ortalama durumda:
- arama,
- ekleme,
- silme
işlemleri:
O(1)olabilir.
Kötü durumda çok sayıda çakışma oluşursa:
O(n)davranışı görülebilir.
11.7. Çakışma
İki farklı anahtar aynı tablo konumuna eşlenirse çakışma oluşur.
h(k1) = h(k2)çakışmanın yanlış hash anlamına geldiğini göstermez. Sonlu tabloya daha geniş anahtar uzayından eşleme yapıldığında çakışma doğal olarak mümkündür.
11.8. Separate Chaining
Her bucket ayrı liste veya benzeri yapı tutar.
table[3] -> A -> B -> COrtalama performans load factor'a ve hash dağılımına bağlıdır.
11.9. Open Addressing
Bütün kayıtlar tablonun kendi hücrelerinde tutulur.
Çakışmada başka hücre aranır.
Yöntemler:
- linear probing,
- quadratic probing,
- double hashing.
11.10. Linear Probing
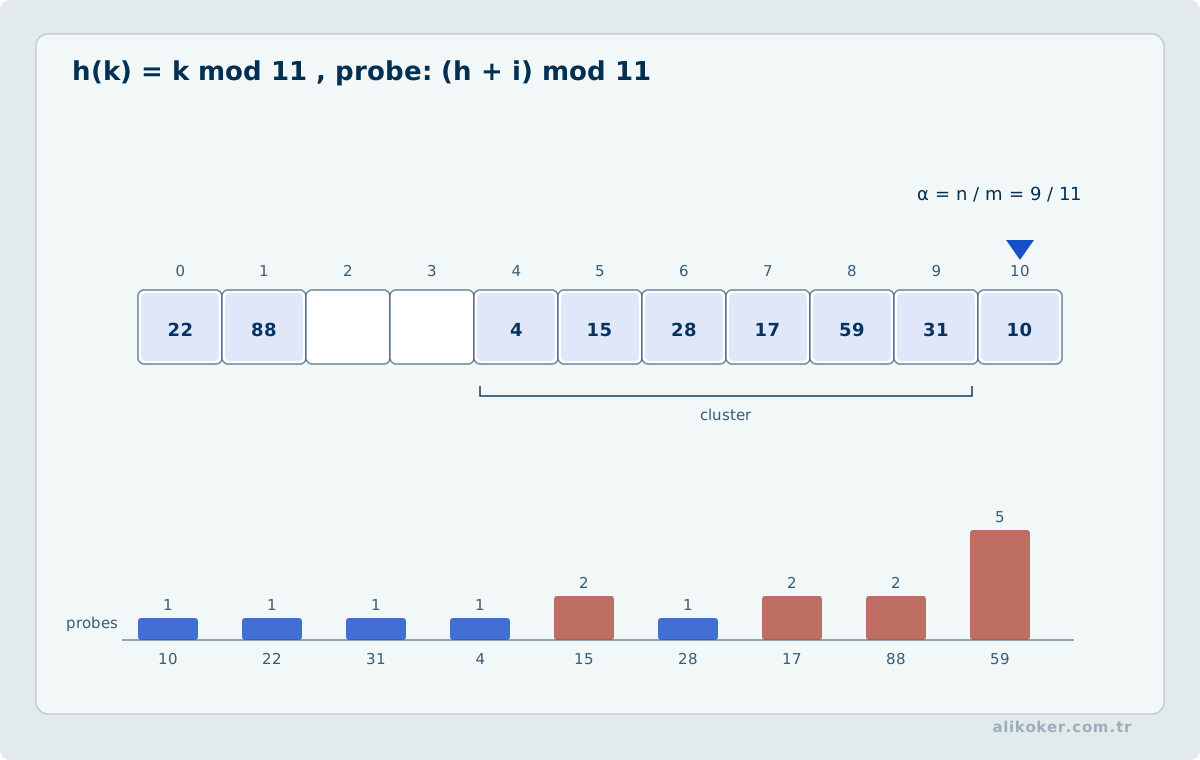
h_i(k) = (h(k) + i) mod mBasittir ve önbellek açısından iyi olabilir.
Dezavantajı primary clustering oluşturabilmesidir.
11.11. Quadratic Probing
Deneme uzaklığı karesel büyür.
h_i(k) =
(h(k) + c1 i + c2 i^2) mod m
Primary clustering etkisini azaltabilir.
11.12. Double Hashing
İkinci hash fonksiyonu adım büyüklüğünü belirler.
h_i(k) =
(h1(k) + i h2(k)) mod m
İyi parametre seçimiyle daha dengeli probe dizileri oluşturur.
11.13. Yük Faktörü
Hash tablosu için:
alpha = n / mn: eleman sayısı,m: bucket veya hücre sayısıdır.
Load factor büyüdükçe çakışma ve probe maliyeti artabilir.
Open addressing'de tablo doluluğunun kontrol altında tutulması özellikle önemlidir.
11.14. Rehash
Tablo belirli yük oranını aşınca:
- daha büyük tablo oluşturulur,
- bütün anahtarlar yeni kapasiteye göre yeniden hash edilir.
Bu işlem tek seferde O(n) maliyetli olsa da geometrik büyüme stratejisinde uzun vadeli ekleme maliyeti amortize olarak düşük kalabilir.
11.15. Hash Tablolarında Çakışma Maliyeti ve Saldırgan Girdi
Bir hash tablosunun beklenen erişim maliyeti, anahtarların yeterince dengeli dağıldığı varsayımına dayanır. Ayrı zincirleme için yük katsayısı \(\alpha=n/m\) (kayıt sayısı / kova sayısı) olduğunda başarılı ve başarısız aramaların beklenen maliyeti ortalama sabit süreye yaklaşabilir; bütün anahtarların tek kovaya düştüğü durumda ise arama \(\Theta(n)\) olur. Açık adreslemede doluluk arttıkça boş konum bulma olasılığı azalır; tombstone olarak bırakılan silinmiş hücreler arama zincirini uzatır. Dolayısıyla tablonun karmaşıklığı tek başına kullanılan hash fonksiyonunun adıyla açıklanamaz; anahtar dağılımı, çakışma giderme yöntemi, büyütme politikası ve silme semantiği birlikte belirtilmelidir.
Çakışma analizi için ölçülebilir bir deney tasarlanabilir: aynı \(n\) anahtar sayısında rastgele, sıralı ve kasıtlı çakıştırılmış anahtar kümeleri kullanılır; arama başına karşılaştırma sayısı, en uzun kova zinciri, yüzde 99 gecikme ve yeniden boyutlandırma sayısı ayrı ölçülür. Ortalama süre tek başına uzun çakışma zincirlerini gizleyebilir. Dışarıdan denetlenebilen anahtarların hash tablosuna yerleştirilmesinde saldırganın çakışma üretmesi de bir hizmet reddi kaynağıdır. Anahtarlı/rasgeleleştirilmiş hashing veya ağaç biçimli kova gibi önlemler, kullanılan dil çalışma zamanının gerçek sözleşmesine göre değerlendirilir; herhangi biri tüm girdiler için sabit en kötü durum maliyeti garantilemez.
Tablo büyütme de maliyet hesabının parçasıdır. Kapasite iki katına çıkarıldığında yeniden yerleştirme bir işlemde \(\Theta(n)\) iş gerektirebilir; fakat ardışık eklemeler boyunca taşınan öğe sayısı geometrik seriyle sınırlandırılır. Böylece tek işlem gecikmesi ile amortize ekleme maliyeti ayrılır. Gerçek zamanlı tasarımda amortize \(O(1)\) sonucu yeterli olmayabilir; en kötü tek işlem süresi ayrıca sınanmalıdır.
Ünite 12: Graflar
12.1. Graf Modeli
Graf:
G = (V, E)olarak tanımlanır.
V: düğümler,E: kenarlar.
Örnek kullanım alanları:
- yol ve rota sistemleri,
- bilgisayar ağları,
- sosyal ağlar,
- bağımlılık analizi,
- görev planlama,
- devreler,
- moleküler yapılar.
12.2. Yönsüz Graf
Kenarın yönü yoktur.
{u, v}ilişkisi u ile v arasında iki yönlü bağlantıyı ifade eder.
12.3. Yönlü Graf
Kenar yön taşır.
(u, v)u düğümünden v düğümüne bağlantıdır.
12.4. Ağırlıklı Graf
Kenarlarda maliyet bulunur.
(u, v, w)Buradaki w:
- mesafe,
- süre,
- ücret,
- kapasite,
- risk
gibi değeri temsil edebilir.
12.5. Derece
Yönsüz grafta düğümün degree değeri bağlı kenar sayısıdır.
Yönlü grafta:
- indegree,
- outdegree
ayrı hesaplanır.
12.6. Yol
Bir düğümden başka düğüme ardışık kenarlar üzerinden gidilebilen düğüm dizisidir.
Yol maliyeti ağırlıklı grafta kenar ağırlıklarının toplamı olabilir.
12.7. Çevrim
Başlangıç düğümüne tekrar dönen yol çevrim oluşturabilir.
Çevrimsiz yönlü graf:
DAG
Directed Acyclic Graph
olarak adlandırılır.
DAG:
- görev bağımlılığı,
- derleme sırası,
- veri işleme hattı
gibi problemlerde önemlidir.
12.8. Komşuluk Matrisi
V düğümlü graf için:
V x Vmatris kullanılır.
Yönsüz ağırlıksız grafta:
A[i][j] = 1ise kenar vardır.
Alan karmaşıklığı:
O(V^2)Yoğun graflarda uygundur.
Kenar varlığına bakmak:
O(1)olabilir.
12.9. Komşuluk Listesi
Her düğüm komşularının listesini tutar.
Alan:
O(V + E)olur.
Seyrek graflarda daha verimlidir.
12.10. Kenar Listesi
Bütün kenarlar:
(u, v, w)kayıtları halinde tutulur.
Kruskal gibi kenar odaklı algoritmalarda doğal gösterimdir.
12.11. Bitişiklik Matrisi
Incidence matrix düğümler ile kenarların ilişkisini gösterir.
Boyut:
V x Eolabilir.
Genel graph algoritmalarında adjacency list kadar yaygın değildir ancak graf kuramında yararlıdır.
12.12. DFS
Depth-First Search mümkün olduğunca derine gider.
Recursive gösterim:
DFS(u):
    visited[u] = true

    her v komşusu için:
        eğer visited[v] değil:
            DFS(v)
Zaman:
O(V + E)komşuluk listesi kullanıldığında.
Kullanım alanları:
- bağlı bileşen,
- çevrim bulma,
- topological sort,
- yol araştırma.
12.13. BFS
Breadth-First Search düğümleri seviye seviye dolaşır.
Kuyruk kullanır.
BFS(s):
    visited[s] = true
    enqueue(s)

    while queue boş değil:
        u = dequeue()

        her v komşusu için:
            eğer visited[v] değil:
                visited[v] = true
                enqueue(v)
Zaman:
O(V + E)Ağırlıksız graf için başlangıçtan en az kenarlı yolları bulur.
12.14. DFS ve BFS Karşılaştırması
- Özellik: Temel yapı; DFS: Stack/özyineleme; BFS: Kuyruk
- Özellik: Dolaşım; DFS: Derinlik; BFS: Seviye
- Özellik: Ağırlıksız en kısa yol; DFS: Doğrudan garanti yok; BFS: Evet
- Özellik: Topological sort; DFS: Uygun; BFS: Kahn yaklaşımıyla BFS de kullanılabilir
- Özellik: Bellek kullanımı; DFS: Yapıya bağlı; BFS: Geniş graflarda yüksek olabilir
12.15. Greedy Yaklaşımı
Greedy algoritma her adımda yerel olarak en uygun görünen seçimi yapar.
Her problemde global optimum garanti etmez.
Doğru greedy algoritma için problemin gerekli yapısal özelliklere sahip olduğu gösterilmelidir.
Örnekler:
- Kruskal,
- Prim,
- Dijkstra'nın negatif olmayan ağırlıklı sürümü,
- Huffman.
12.16. Dijkstra Algoritması
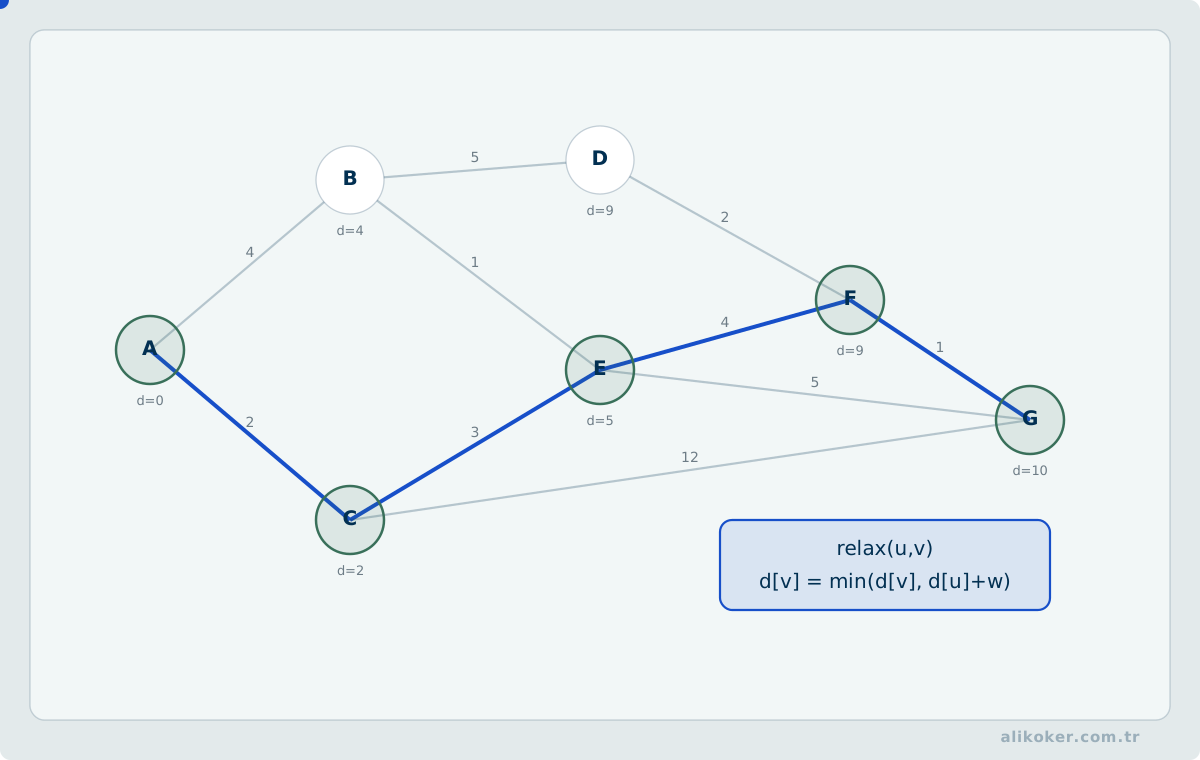
Tek kaynaktan en kısa yolları bulur.
Önkoşul:
Kenar ağırlıkları negatif olmamalıdır.
Temel yapı:
dist[source] = 0
diğer dist = sonsuz

priority queue'ya source ekle

while queue boş değil:
    u = en küçük dist

    her (u,v,w) için:
        eğer dist[u] + w < dist[v]:
            dist[v] = dist[u] + w
            parent[v] = u
Binary öbek ve adjacency list ile tipik karmaşıklık:
O((V + E) log V)olarak ifade edilebilir.
Negatif kenarlar varsa Bellman-Ford gibi başka algoritmalar gerekir.
Bir yol arama algoritmasının doğruluğu, sadece bulunan yolun uzunluğuyla ölçülemez. Dijkstra yönteminde çıkarılan en küçük geçici uzaklığın kalıcı kabul edilebilmesi, kenar ağırlıklarının negatif olmamasına dayanır. Örneğin A→B maliyeti 2, A→C maliyeti 5 ve C→B maliyeti −6 olduğunda A'dan B'ye en ucuz yolun maliyeti −1'dir; B'yi önce 2 maliyetle kesinleştirmek hatalıdır. Ağırlıkların işaret koşulu sağlanmıyorsa Bellman–Ford gibi farklı bir gevşetme düzeni gerekir. Veri kaynağındaki ağırlık sözleşmesini doğrulamak, algoritmayı seçmenin ayrılmaz bir adımıdır.
12.17. Minimum Spanning Tree
Bağlı, yönsüz, ağırlıklı grafta bütün düğümleri bağlayan ve toplam kenar ağırlığı en küçük olan spanning tree aranır.
İki temel algoritma:
- Kruskal,
- Prim.
12.18. Kruskal Algoritması
Kenarları ağırlığa göre sıralar.
kenarları sırala

her kenar (u,v):
    eğer u ve v farklı bileşendeyse:
        kenarı seç
        bileşenleri birleştir
Çevrim denetimi için Disjoint Set Union kullanılır.
Karmaşıklık çoğunlukla sıralama tarafından belirlenir:
O(E log E)12.19. Disjoint Set Union
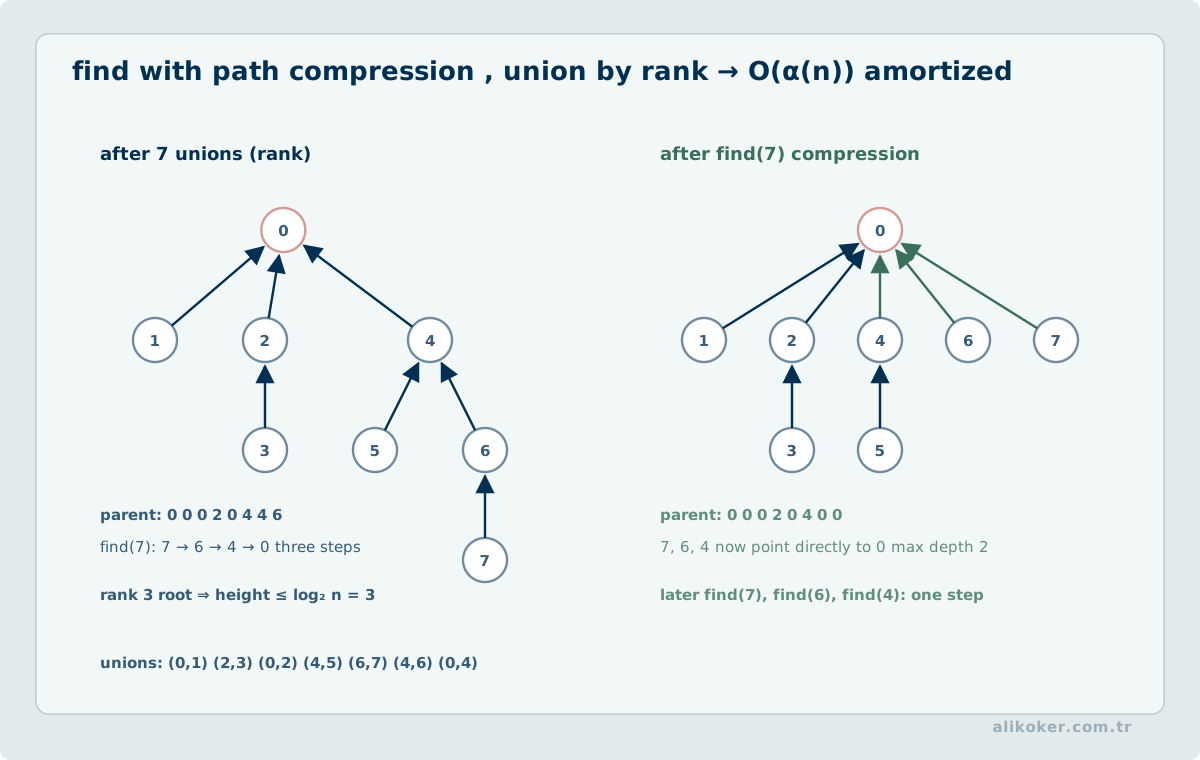
DSU birbirinden ayrık kümeleri yönetir.
İşlemler:
find,union.
Path compression ve union by rank/size ile amortize maliyet çok düşüktür:
O(alpha(n))Buradaki alpha, ters Ackermann fonksiyonudur ve pratik boyutlarda çok yavaş büyür.
12.20. Prim Algoritması
Bir düğümden başlayarak mevcut ağaca en ucuz bağlantıyı ekler.
Priority kuyruk ile:
O(E log V)düzeyinde gerçekleştirilebilir.
Kruskal kenar merkezli, Prim büyüyen ağaç merkezli düşünülebilir.
12.21. Graf Renklendirme
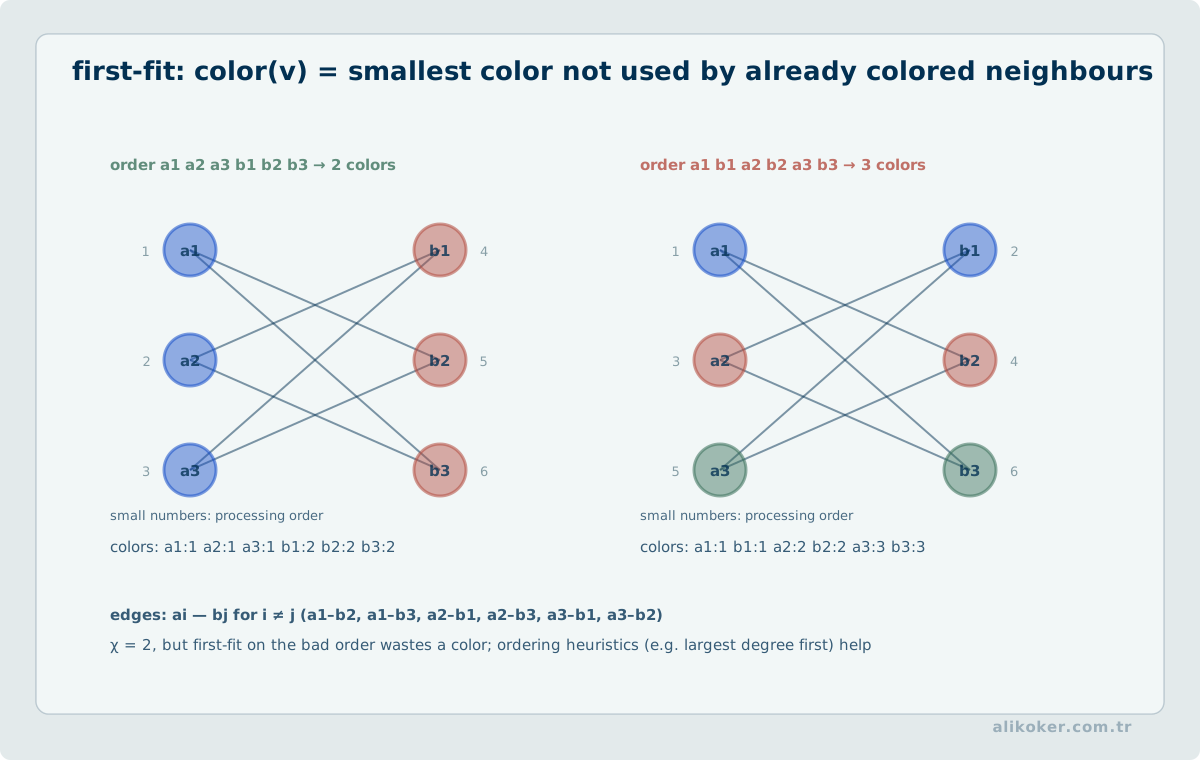
Düğüm renklendirmede komşu düğümlere farklı renkler atanır.
Amaç çoğu zaman renk sayısını en aza indirmektir.
Genel graph coloring problemi zor bir optimizasyon problemidir. Basit greedy coloring hızlı çözüm sağlar ancak minimum renk sayısını garanti etmez.
Kullanım alanları:
- zamanlama,
- register bellek ayırma,
- frekans atama.
12.22. Topological Sort
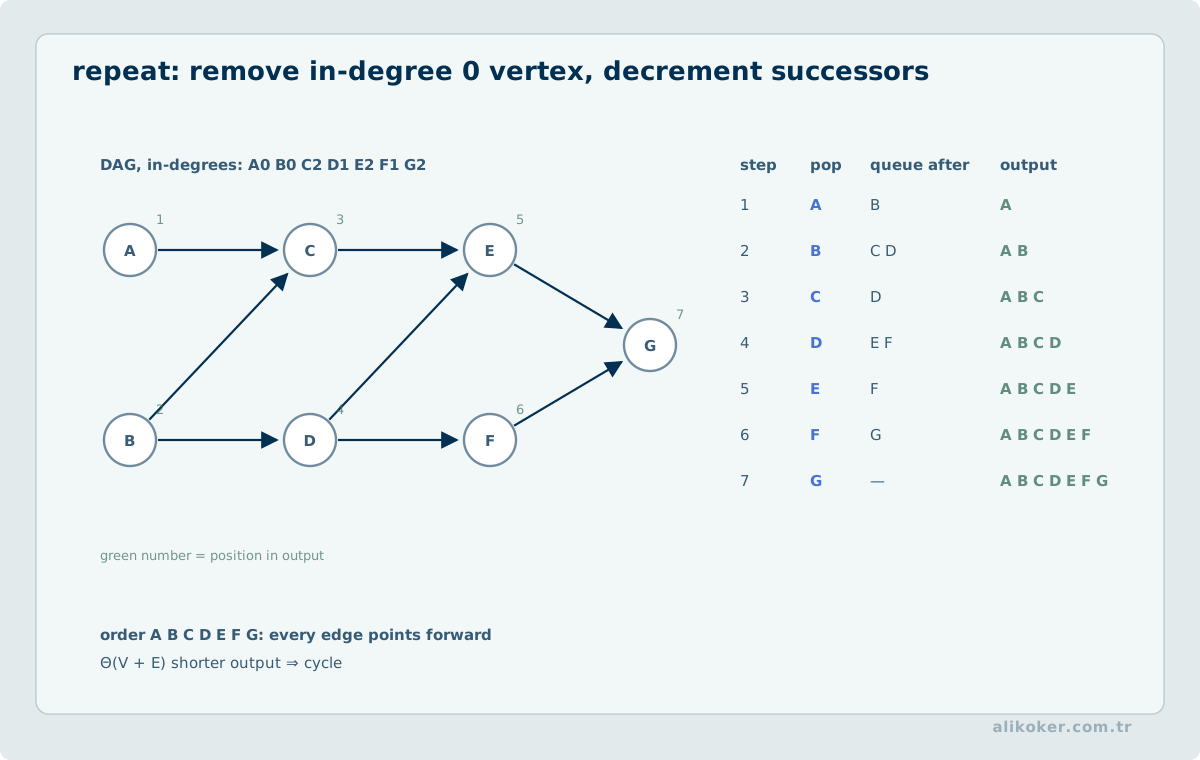
DAG üzerindeki düğümleri:
u -> vkenarı varsa u, v'den önce gelecek biçimde sıralar.
Kullanım alanları:
- bağımlılık çözme,
- ders önkoşulları,
- derleme sistemi,
- iş akışı.
DFS veya indegree tabanlı Kahn algoritmasıyla:
O(V + E)zamanda yapılabilir.
12.23. Seyrek Benzerlik Grafında Merkezilik Hesabı
Cümleleri düğüm, cümleler arasındaki yeterince yüksek benzerliği kenar olarak alan bir graf, uzun belgelerde temsilî ifadelerin seçimine yardımcı olabilir. Bütün düğüm çiftlerinin karşılaştırılması yoğun bir graf oluşturur; cümle sayısı iki katına çıktığında ikili karşılaştırma sayısı yaklaşık dört katına çıkar. Bunun yerine her cümle için sınırlı sayıda aday komşu sözlük veya ters indeks üzerinden bulunabilir ve yalnız bu adaylar için benzerlik hesaplanabilir.
Düğüm önemini belirlemek için kenar ağırlıkları üzerinden yinelemeli merkezilik kullanılabilir. Her yinelemede bir düğüm, komşularının önceki öneminden pay alır; bir sönüm katsayısı, yüksek dereceli küçük çevrimlerin bütün puanı yutmasını engeller. Yakınsama toleransı ve en yüksek yineleme sayısı açık tutulduğunda çalışma süresi kontrol edilebilir. Bağlı bileşenlerin büyüklükleri çok farklıysa yalnız küresel merkezilik, küçük fakat önemli bir bölümün gözden kaçmasına yol açabilir.
Özet seçimi için merkezilik tek ölçüt olmamalıdır. Düğümün sorguyla ilgisi, belgede yer aldığı bölüm ve daha önce seçilmiş cümlelerle tekrar düzeyi ayrı değerlendirilir. Graf hesaplaması metnin anlamını doğrulamaz; yalnız seçilmesi yararlı olabilecek düğümleri sıralar.
Ünite 13: Algoritma Tasarım Paradigmaları ve Zorluk Sınırları
Veri yapısı seçimi ile algoritma tasarım tekniği ayrı kararlardır. Aynı veri modeli farklı problem çözme paradigmalarıyla işlenebilir; doğru yaklaşım problemin alt problem yapısına, optimal alt yapıya ve girdi özelliklerine bağlıdır.
13.1. Böl ve Yönet
Böl ve yönet yaklaşımında problem daha küçük bağımsız alt problemlere ayrılır, alt problemler çözülür ve sonuçlar birleştirilir.
problem
  ↓ böl
alt problemler
  ↓ çöz
kısmi sonuçlar
  ↓ birleştir
sonuç
Merge sort klasik örnektir. Birçok böl-ve-yönet algoritmasının maliyeti recurrence ile ifade edilir:
T(n) = a T(n/b) + f(n)Bu ifade yalnız Big-O sonucu vermek için değil, işin hangi katmanda çoğaldığını görmek için kullanılır.
13.2. Dinamik Programlama
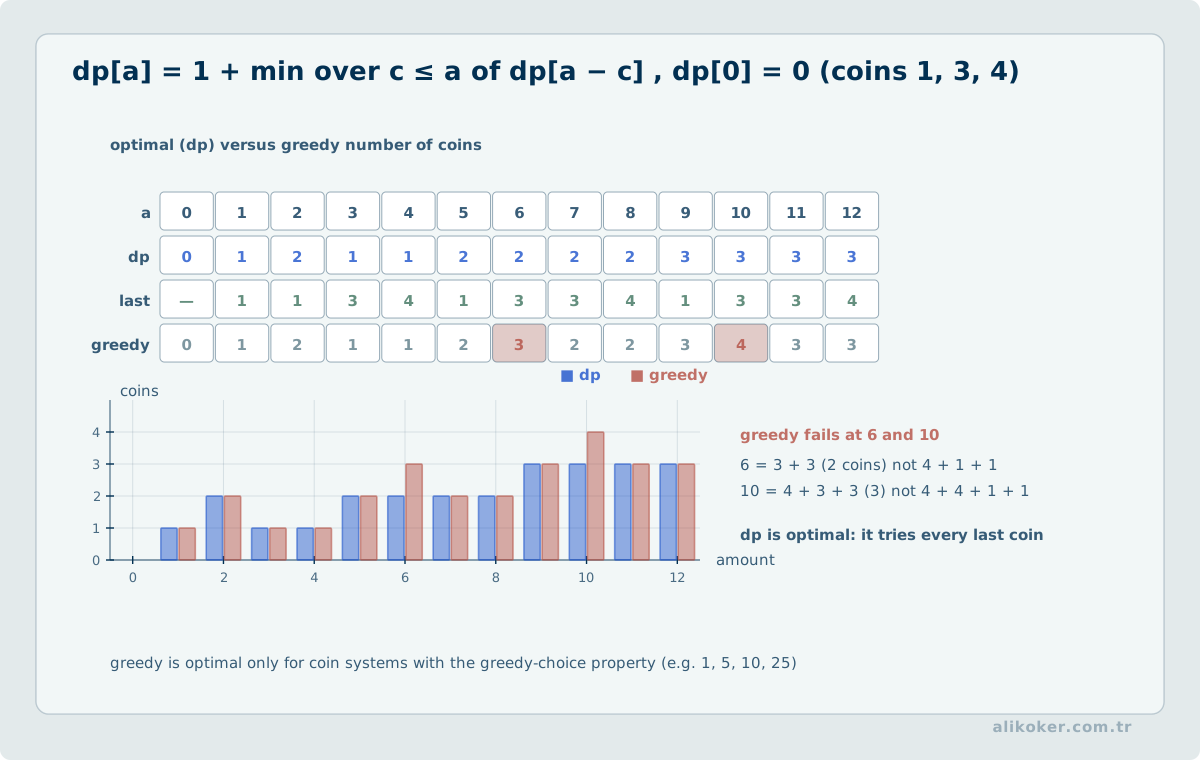
Aynı alt problemler tekrar tekrar çözülüyorsa sonuçlar saklanabilir. Dinamik programlamanın iki temel koşulu örtüşen alt problemler ve optimal alt yapıdır.
Top-down memoization ve bottom-up tablo yaklaşımı aynı bağıntıyı farklı yürütme düzeniyle çözebilir. Ancak her recursive algoritma dinamik programlamaya uygun değildir; alt problemlerin bağımlılık yapısı açıkça kurulmalıdır.
13.3. Açgözlü Yaklaşım
Greedy algoritma her adımda yerel olarak en iyi görünen seçimi yapar. Bu seçimin global optimum verdiği ayrıca kanıtlanmalıdır. "Her adımda en büyük değeri seçmek" tek başına doğruluk gerekçesi değildir.
Exchange argument, cut property veya problem özelindeki invariant'lar greedy doğruluğunu göstermek için kullanılabilir.
13.4. Amortize Analiz
Tek bir işlem pahalı olsa bile uzun bir işlem dizisinin ortalama maliyeti düşük olabilir. Dinamik dizi kapasitesinin geometrik büyütülmesi tipik örnektir.
1, 2, 4, 8, 16, ...Bazı append işlemleri yeniden ayırma nedeniyle O(n) maliyetli olabilir; buna rağmen n eklemenin toplam maliyeti O(n) mertebesinde kalır ve amortize işlem maliyeti O(1) olur.
Bu sonuç olasılıksal "ortalama durum" ile aynı değildir. Amortize analiz belirli bir işlem dizisi üzerindeki toplam maliyeti sınırlar.
13.5. Rastgele Algoritmalar
Randomized algoritmalar rastgele seçimi algoritmanın parçası yapar. Randomized quicksort'ta pivot seçiminin rastgeleleştirilmesi düşmanca veya düzenli girdilere karşı beklenen davranışı iyileştirebilir.
Monte Carlo algoritması sınırlı sürede küçük hata olasılığıyla sonuç üretirken Las Vegas algoritması doğru sonucu garanti eder fakat çalışma süresi rastgele olabilir. Bu ayrım özellikle güvenilirlik gereksinimlerinde önemlidir.
13.6. NP-zorluk ve Yaklaşık Çözüm
Bir problemin optimal çözümünü küçük girdilerde bulmak, büyük girdiler için verimli genel algoritma bulunduğu anlamına gelmez. NP-zor problemler için pratik yaklaşım:
tam çözüm küçük n
   +
özel durum algoritması
   +
yaklaşık / sezgisel çözüm
   +
ölçülebilir kalite sınırı
şeklinde olabilir.
Sezgisel yöntem hızlı sonuç verebilir fakat optimum garantisi sunmayabilir. Approximation algorithm ise problem için matematiksel bir kalite oranı sağlayabilir. Genetik algoritma, tabu arama veya benzeri meta-sezgisel yöntemlerin yeri bu sınırdan sonra değerlendirilmelidir.
Algoritma mühendisliğinde temel soru yalnız "karmaşıklık nedir?" değildir. Doğruluk garantisi, veri boyutu, bellek yerelliği, en kötü durum, tekrar üretilebilirlik ve kabul edilebilir yaklaşık hata aynı tasarım kararının parçalarıdır.
13.7. Veri Yapılarının Birlikte Kullanımı
Veri yapısı seçimi doğrudan işleme bağlıdır.
- Gereksinim: İndisle hızlı erişim; Uygun yapı: Dizi
- Gereksinim: Sık baş/orta ekleme; Uygun yapı: Bağlantılı liste
- Gereksinim: Son giren ilk çıksın; Uygun yapı: Stack
- Gereksinim: İlk giren ilk çıksın; Uygun yapı: Kuyruk
- Gereksinim: Önceliğe göre seçim; Uygun yapı: Öbek / Priority Kuyruk
- Gereksinim: Anahtarla çok hızlı ortalama arama; Uygun yapı: Hash table
- Gereksinim: Sıralı dinamik veri; Uygun yapı: Dengeli arama ağacı
- Gereksinim: Hiyerarşik veri; Uygun yapı: Tree
- Gereksinim: Ağ ve genel ilişkiler; Uygun yapı: Graph
- Gereksinim: Önek araması; Uygun yapı: Trie
Tek bir veri yapısı bütün işlemleri en iyi biçimde gerçekleştirmez.
Mühendislik kararı:
veri özellikleri
+ işlem dağılımı
+ zaman gereksinimi
+ bellek gereksinimi
birlikte değerlendirilerek verilir.
13.8. Eski Optimizasyon Projelerinden Uygulamalı Örnekler
Üstel arama alanının neden yalnız mikro-optimizasyonla çözülemeyeceğini Subset Sum Optimizasyonu projesinde; durum bilgisini yeniden kullanarak arama alanını küçültme fikrini ise Dudley's Hat çözüm algoritması çalışmasında tarihsel uygulama örnekleri olarak koruyorum.
13.9. Algoritma Seçimini Veri ve Sistem Kısıtlarıyla Birleştirmek
Bir algoritmanın Big-O sınıfı önemli olmakla birlikte tek karar ölçütü değildir. Veri boyutu, veri dağılımı, bellek erişim örüntüsü, ek bellek ihtiyacı, kararlılık (stability), çevrim içi/çevrim dışı çalışma ve diske taşan veri gibi özellikler gerçek seçimi belirler.
13.9.1. Sıralama Algoritmalarını Karşılaştırma
- Insertion sort küçük veya büyük ölçüde sıralı dizilerde düşük sabit maliyetle yararlı olabilir; genel durumda
O(n²)zaman alır. - Selection sort da
O(n²)karşılaştırma yapar ve az sayıda swap avantajı sağlayabilir. - Merge sort
O(n log n)worst-case davranış ve kararlı sıralama sunabilir; tipik dizi uygulamasında ek bellek gerekir. - Quicksort ortalamada
O(n log n)ve cache açısından güçlü olabilir; pivot stratejisine bağlı olarak kötü durumdaO(n²)davranış mümkündür. - Heapsort worst-case
O(n log n)veO(1)ek dizi alanıyla çalışabilir; fakat cache locality ve sabit maliyetleri pratik performansı etkiler.
“En hızlı sıralama algoritması” veriden bağımsız tek bir cevap değildir. Standard-library implementasyonları da sıklıkla birden fazla tekniği birleştirir.
13.9.2. Kararlılık ve in-place Özelliği
Kararlı sıralama, eşit anahtarlı elemanların göreli sırasını korur. Bu özellik ardışık çok anahtarlı sıralamalarda önem kazanabilir. In-place terimi ise algoritmanın girişe ek olarak ne kadar yardımcı alan kullandığını ifade eder; kararlılık ile aynı kavram değildir.
13.9.3. Arama ve Veri Yapısı İlişkisi
Binary search O(log n) karşılaştırma sağlar ancak veri sıralı ve random-access yapıda olmalıdır. Hash table ortalama O(1) arama hedefleyebilir fakat hash dağılımı, load factor, collision çözümü ve yeniden boyutlandırma maliyeti vardır. Dengeli arama ağaçları O(log n) sınırıyla sıralı dolaşım ve range query desteği sağlar.
Dolayısıyla arama algoritması veri yapısından bağımsız seçilmez.
13.9.4. Graf Algoritmaları
BFS ağırlıksız bir grafta en az kenar sayılı yolları bulabilir ve queue kullanır. DFS stack/özyineleme ile derinlemesine ilerler; cycle detection, component ve topological işlemlerde temel yapı taşıdır. Dijkstra negatif olmayan kenar ağırlıklarında tek kaynak en kısa yolları çözer; negatif kenar varsa varsayımı bozulur.
Algoritmanın önkoşulu doğrulanmadan yalnız adı uygulanmamalıdır.
13.9.5. Greedy ve Dinamik Programlama
Greedy yaklaşım her adımda yerel olarak uygun seçim yapar; ancak yerel optimumun küresel optimum üreteceği problem özelliği kanıtlanmalıdır. Dinamik programlama örtüşen alt problemleri ve optimal alt yapı özelliğini kullanarak durum sonuçlarını saklar. Memoization top-down, tabulation bottom-up gerçekleştirilebilir.
Her recursion dinamik programlama değildir; her DP çözümü de recursion kullanmak zorunda değildir.
13.9.6. Harici Sıralama
Veri RAM'e sığmadığında CPU karmaşıklığından çok disk/SSD G/Ç maliyeti belirleyici olabilir. External merge sort veriyi belleğe sığan parçalarda sıralar ve sonra sıralı run'ları birleştirir. Bu yaklaşım, algoritma analizinin gerçek sistemde bellek hiyerarşisi ve G/Ç modeliyle birlikte yapılması gerektiğini gösterir.
13.9.7. Öklid Algoritması ve EBOB
İki tamsayının en büyük ortak böleni (EBOB; İngilizce GCD), Öklid algoritmasıyla kalan alma işlemi yinelenerek verimli biçimde hesaplanabilir. Temel bağıntı gcd(a,b) = gcd(b, a mod b) biçimindedir ve ikinci değer sıfır olduğunda kalan değer sonuçtur. Bu örnek, bir problemi tekrar eden daha küçük eşdeğer alt probleme dönüştürmenin klasik örneklerinden biridir.
13.9.8. Ölçüm İlkesi
Teorik karmaşıklık ölçekleme davranışını açıklar; benchmark ise belirli implementasyon, veri dağılımı ve donanımdaki maliyeti ölçer. Biri diğerinin yerine geçmez. Doğru mühendislik önce algoritmik üst sınırı, sonra gerçek darboğazı birlikte değerlendirir.
13.10. Önbellek Yerelliği ve Düşmanca Girdiler
Asimptotik karmaşıklık algoritma karşılaştırmasının temelidir; fakat aynı Big-O sınıfındaki iki yapı gerçek makinede çok farklı davranabilir. Ardışık bellekte tutulan bir dizi, pointer ile dağılmış düğümlerden oluşan yapıya göre daha iyi cache yerelliği ve daha az dolaylı erişim sağlayabilir.
Hash tablosunda beklenen O(1) erişim, hash dağılımı ve yük faktörüne bağlıdır. Düşmanca seçilmiş girdiler çok sayıda çakışma üretebiliyorsa güvenlik açısından yalnız ortalama durum analizi yeterli değildir.
Algoritma seçimi bu nedenle üç katmanda yapılmalıdır: asimptotik sınır, veri dağılımı ve gerçek donanım maliyeti. Mikrobenchmark ancak temsilî veri, doğru ısınma ve optimizasyon koşullarıyla anlamlıdır.
13.11. Karmaşıklık İddiasını Deneyle İlişkilendirmek
Big-O üst sınırı, belirli bir makinedeki çalışma süresinin doğrudan tahmini değildir. Aynı asimptotik sınıftaki iki yapı cache yerelliği, sabit katsayılar ve veri dağılımı nedeniyle farklı sonuç verebilir.
Bir benchmark yapılacaksa veri üretimi ölçüm bölümünden ayrılmalı, ısınma ve tekrar sayısı belirtilmeli, en azından medyan ve dağılım raporlanmalıdır. Rastgele veri ile sıralı, ters sıralı veya çok tekrar içeren veri aynı algoritmayı farklı zorlayabilir.
Doğruluk için invariant ve sınır durumları önemlidir. Boş koleksiyon, tek eleman, yinelenen anahtar, maksimum/minimum değer ve kötü durum girdisi; yalnız “normal” örneklerin sağlayamadığı kanıtı sağlar.
13.12. Veri Yapıları, Arama ve Yapay Zekâ
Yapay zekâ yöntemlerinin önemli bir bölümü, büyük bir olası durum veya aday kümesinden sınırlı maliyetle doğru adaya ulaşmaya çalışır. Bu nedenle veri yapıları ve algoritma analizi ile yapay zekâ arasındaki bağ yalnız “AI kodu da algoritma kullanır” düzeyinde değildir. Arama uzayının nasıl temsil edildiği, hangi adayın önce incelendiği ve ara sonuçların nasıl saklandığı doğrudan yöntemin uygulanabilirliğini belirler.
Klasik durum uzayı araması bunun en açık örneğidir. Bir problem graf olarak modellenebiliyorsa düğümler durumları, kenarlar geçerli geçişleri temsil eder. BFS en az kenarlı yolu; Dijkstra negatif olmayan ağırlıklarda en düşük maliyetli yolu; A* ise maliyet ile sezgisel kestirimi birleştirerek hedefe yönelmiş aramayı sağlayabilir:
f(n) = g(n) + h(n)Burada öncelik kuyruğu yalnız bir uygulama ayrıntısı değildir. En düşük f(n) değerli adayın etkin seçilebilmesi, aramanın pratik maliyetini belirler. Aynı algoritmanın uygun olmayan veri yapısıyla gerçeklenmesi asimptotik ve gerçek çalışma süresini değiştirebilir.
Oyun ağacı ve planlama problemlerinde ağaç/graph ayrımı daha da önemlidir. Aynı duruma farklı yollardan ulaşılabiliyorsa durumu yalnız ağaç düğümü gibi ele almak tekrar hesaplama üretir. Hash table ile ziyaret edilen durumların tutulması veya transposition table kullanılması, aynı durumun yeniden genişletilmesini azaltır. Burada hash fonksiyonunun dağılımı, bellek kullanımı ve collision davranışı doğrudan arama kapasitesine dönüşür.
Makine öğrenmesinde komşuluk tabanlı yöntemler başka bir bağlantı kurar. k-NN kavramsal olarak basittir; ancak her sorguda bütün veri kümesini taramak büyük veri üzerinde pahalıdır. Boyut ve metriğe göre k-d tree, ball tree veya approximate nearest-neighbor indeksleri aday alanını daraltabilir. Yüksek boyutta klasik uzaysal ağaçların etkinliği azalabilir; bu kez yaklaşık arama yapıları ve veri temsili daha önemli hale gelir. Yani veri yapısı seçimi, verinin geometrisinden bağımsız değildir.
Priority queue, heap ve queue yapıları üretim AI sistemlerinde de görülür. İsteklerin önceliklendirilmesi, batch oluşturulması, beam search adaylarının tutulması veya olay akışlarının işlenmesi bunlara örnektir. Fakat aynı yapı her problemde doğru değildir. Beam search'te yalnız en iyi k aday tutulurken eksiksiz aramada eleme yapılmaz; veri yapısı algoritmanın karar politikasını gerçekleştiren araçtır.
Graf yapıları modern öğrenmede de veri modelinin kendisi olabilir. Sosyal ilişkiler, moleküler bağlar, iletişim ağları veya bilgi grafı düğüm ve kenarlarla temsil edilir. Graph Neural Network bu graf üzerinde öğrenme yapabilir; fakat grafın adjacency list, sparse matrix veya edge list biçiminde tutulması bellek ve yürütme maliyetini değiştirir. Öğrenme katmanı graf veri yapısının gereksinimlerini ortadan kaldırmaz.
Algoritma analizi burada temel sınırı koyar. Eğitimde O(n²) görünen bir adım, birkaç bin kayıt için kabul edilebilirken milyonlarca kayıt için baskın maliyet olabilir. Ancak yalnız Big-O yeterli değildir. Cache locality, allocation, branch behavior, paralellik ve veri dağılımı gerçek çalışma süresini etkiler. Yapay zekâ sistemlerinde de önce problem boyutu ve erişim örüntüsü ölçülmelidir.
Bu bağlamda üç katman ayrılmalıdır:
problem temsili → veri yapısı
arama / öğrenme kuralı → algoritma
fiziksel yürütme → sistem ve donanım
Yapay zekâ bu üç katmanın üzerinde çalışır. Veri yapıları ve algoritmalar, “zekâ” kavramını tanımlamaz; arama, komşuluk, planlama ve büyük aday uzaylarının hesaplanabilir biçimde yönetilmesini sağlar. Bu nedenle Ayrık Matematik kuramsal graf ve mantık temelini verirken, bu ders aynı yapıların çalıştırılabilir ve maliyeti ölçülebilir karşılığını kurar.
13.13. Bir Algoritmayı Seçmeden Önce
Bir soruda doğru veri yapısını seçmek, çoğu zaman algoritmanın adını hatırlamaktan daha önemlidir. Önce hangi işlemlerin baskın olduğunu belirlemek gerekir: arama, ekleme, silme, en küçük/en büyük öğeyi alma, sıralı dolaşma ya da komşuluk sorgusu. Aynı veri kümesi için dizi, bağlı liste, yığın, kuyruk, karma tablosu, ağaç veya graf farklı maliyetler üretir.
Asimptotik gösterim büyüme hızını anlatır; küçük girdilerde gerçek çalışma süresini tek başına belirlemez. O(n log n) bir yöntem, sabit maliyetleri veya bellek erişim örüntüsü nedeniyle küçük n değerlerinde O(n^2) bir yöntemden yavaş olabilir. Buna karşılık girdi büyüdükçe baskın terim belirleyici hale gelir. Bu nedenle karmaşıklık hesabında önce hangi işlemin kaç kez çalıştığı çıkarılmalı, ardından baskın terim sadeleştirilmelidir.
Bir graf sorusunda da problem türü ayırt edilmelidir. Ağırlıksız bir grafta en az kenarlı yol için BFS doğal seçimdir; negatif olmayan kenar ağırlıklarında Dijkstra kullanılabilir. Negatif ağırlıklar bulunduğunda Dijkstra'nın temel varsayımı bozulur. Benzer biçimde açgözlü bir yöntem yerel olarak iyi kararlar verse de, çözümün optimal alt yapı ve uygun seçim özelliği yoksa küresel optimumu garanti etmez; bu durumda dinamik programlama gerekebilir.
Kısa bir doğrulama yöntemi, seçilen çözümün değişmezini açıkça yazmaktır. İkili aramada aranan değer varsa her adımın sonunda hâlâ kalan aralıkta bulunmalıdır. Dijkstra'da kesinleştirilmiş düğümün uzaklığı daha sonra küçülmemelidir. Yığın kullanan bir parantez denetiminde ise işlenen önek için açık parantezlerin düzeni korunmalıdır. Karmaşıklık hesabı çözümün ne kadar pahalı olduğunu, değişmez ise neden doğru olduğunu açıklar.
Ünite 14: Algoritmayı Çalıştırmadan Önce Doğrulamak: İzleme, Değişmez ve Shell Sort
Sınav ve mülakat sorularında algoritma çoğu zaman birkaç satır kodla verilir ve "çıktı nedir?" diye sorulur. Güvenilir çözüm, kodu zihinde tahmin etmek yerine durumu adım adım izlemektir.
14.1. Dry-run ve İzleme Tablosu
Bir döngü için ilgili değişkenleri tablo mantığında izlemek hata riskini azaltır:
adım | i | j | değer | sonuçÖrneğin Öklid algoritmasında:
a = 48, b = 18
48 mod 18 = 12
18 mod 12 = 6
12 mod 6  = 0
=> EBOB = 6
izleme; başlangıç, ilerleme ve bitiş koşulunu görünür kılar.
14.2. Loop İnvariant
Döngü değişmezi (loop invariant), her iterasyonun belirli bir noktasında doğru kalan önermedir.
Doğruluk ispatı üç soruyla kurulabilir:
- Initialization: ilk iterasyondan önce doğru mu?
- Maintenance: bir iterasyon doğru varsayımdan sonra özelliği koruyor mu?
- Termination: döngü bittiğinde bu özellik istenen sonucu veriyor mu?
Insertion sort için örnek invariant:
0..i-1aralığı her dış döngü başlangıcında sıralıdır.
Bu fikir yalnız teorik ispat için değil, hatalı indeks veya sınır koşulunu bulmak için de pratiktir.
14.3. Input Sınıfları ve Sınır Değerleri
Bir algoritma yalnız "normal" girişte denenmemelidir.
boş giriş
tek eleman
iki eleman
zaten sıralı
ters sıralı
tüm değerler eşit
tekrarlı değerler
minimum / maksimum temsil edilebilir değer
gibi sınıflar farklı hata yüzeyleri açar.
14.4. Problem Aileleri
Yüzlerce küçük programlama sorusunu tek tek ezberlemek yerine ortak ailelere ayırmak daha değerlidir.
sayı teorisi:
  asal, EBOB/EKOK, basamak, Fibonacci

dizi tarama:
  min/max, toplam, frekans, duplicate

metin:
  palindrome, karakter sayımı, tokenizasyon

matris:
  satır/sütun, diagonal, transpose

arama:
  linear, binary

sıralama:
  bubble, selection, insertion, shell, merge, quick
Yeni soru çoğu zaman bu kalıplardan birinin varyasyonudur.
14.5. Shell Sort
Shell sort, insertion sort'un uzak elemanları erken taşımasını sağlayan gap tabanlı genellemesidir.
Kavramsal akış:
gap = büyük değer
gap ile ayrılan alt dizileri insertion-sort et
gap'i küçült
gap = 1 olduğunda normal insertion sort ile bitir
Örnek gap dizisi:
n/2, n/4, ..., 1olabilir; fakat performans gap dizisine güçlü biçimde bağlıdır.
Shell sort için tek evrensel karmaşıklık değeri vermek doğru değildir. Kullanılan gap dizisi worst-case davranışı etkiler. Bu yönüyle algoritma analizi, yalnız kaynak kodunu değil parametrizasyonu da incelemelidir.
14.6. Linear Search ve Binary Search
Linear search:
ön koşul:
  yok

maliyet:
  O(n)
Binary search:
ön koşul:
  arama anahtarına göre sıralı veri

maliyet:
  O(log n)
Binary search'ün hızlı olması, sıralamanın bedelsiz olduğu anlamına gelmez. Tek arama yapılacak küçük ve sırasız bir diziyi önce sıralamak toplamda daha pahalı olabilir.
14.7. Flowchart ile Executable Correctness Ayrımı
Akış şeması algoritmik niyeti gösterebilir; fakat şu detayları otomatik olarak garanti etmez:
- integer overflow,
- array bounds,
- dilin bölme/mod semantiği,
- Unicode/metin davranışı,
- aliasing,
- null/optional durumları,
- kayan nokta yuvarlama.
Bu nedenle:
algoritmik model
-> pseudocode
-> programlama dili
-> test / ölçüm
zincirinin her katmanında farklı doğruluk soruları vardır.
14.8. Çözüm Stratejisi
Bir algoritma sorusunda:
- girdiyi ve beklenen çıktıyı yazın,
- invariant veya korunacak koşulu belirleyin,
- küçük örneği elle izleyin,
- sınır durumlarını sınayın,
- zaman/alan maliyetini değerlendirin,
- gerekiyorsa daha uygun veri yapısını seçin.
Bu yöntem, yüzlerce soru ezberlemek yerine aktarılabilir algoritmik muhakeme oluşturur.
Ünite 15: Seçim, Order Statistics ve Lineer Zamanlı Sıralama
Sıralama, elemanların tamamını düzenlemek için güçlü bir genel çözümdür; fakat birçok problem yalnız belirli bir sıra istatistiğini (order statistic) ister. En küçük, en büyük, medyan veya i'inci küçük elemanı bulmak için bütün diziyi sıralamak gereksiz maliyet yaratabilir.
15.1. Order Statistic Problemi
n elemanlı bir kümede:
1. order statistic     -> minimum
n. order statistic     -> maximum
ceil(n/2). order statistic -> medyan bölgesi
i. order statistic     -> i'inci küçük eleman
olarak düşünülebilir.
Minimum veya maksimum tek geçişte O(n) zamanda bulunabilir. Hem minimum hem maksimum aranıyorsa elemanları ikili karşılaştırma mantığıyla işlemek, her elemanı ayrı ayrı iki kez kıyaslamaya göre karşılaştırma sayısını azaltabilir.
Bu örnek önemli bir tasarım ilkesini gösterir:
İstenen çıktı sıralı listenin tamamı değilse, önce tam sıralamanın gerçekten gerekli olup olmadığını sorgulayın.
15.2. Quickselect
Quickselect, Quicksort'taki partition fikrini yalnız hedef sıranın bulunduğu tarafta devam ettirir.
partition(A, p)
        ↓
pivot'ın rank'i r

i = r  -> pivot cevap
i < r  -> yalnız sol bölüm
i > r  -> yalnız sağ bölüm
İyi pivot seçimlerinde problem boyutu hızla küçülür ve randomized Quickselect'in beklenen çalışma süresi O(n) olur.
Ancak sürekli kötü pivot seçimi:
n
n-1
n-2
...
gibi alt problemlere yol açabilir ve worst-case maliyet O(n^2) olabilir.
Bu nedenle "Quickselect lineerdir" ifadesi tek başına eksiktir. Hangi pivot politikası ve hangi analiz türünün kullanıldığı belirtilmelidir.
15.3. Randomized Selection
Randomized selection pivot'ı rastgele seçerek belirli kötü giriş düzenlerine sistematik bağımlılığı azaltır.
Beklenen analiz:
input sabit
random choices değişken
şeklinde yapılır.
Bu, "ortalama giriş" varsayımıyla aynı şey değildir. Algoritmanın rastgeleliği, adversarial giriş ile deterministik pivot politikasının tehlikeli etkileşimini azaltabilir.
15.4. Median-of-medians ile Deterministic worst-case Lineer Seçim
Worst-case O(n) selection mümkündür.
Temel fikir:
elemanları küçük gruplara ayır
↓
her grubun medyanını bul
↓
bu medyanların medyanını pivot seç
↓
partition yap
↓
yalnız hedef tarafında devam et
Bu pivot tam medyan olmak zorunda değildir. Kritik özellik, her iki tarafta da sabit oranlı miktarda elemanın elenmesini garanti edecek kadar "iyi" olmasıdır.
Böylece recurrence kabaca:
T(n)
<=
T(n/5)
+
T(7n/10 + sabit)
+
O(n)
biçiminde sınırlandırılabilir ve sonuç worst-case O(n) olur.
Pratikte sabit maliyetleri randomized Quickselect'ten yüksek olabilir. Bu nedenle teorik worst-case garantisi ile gerçek workload maliyeti aynı karar değildir.
15.5. Comparison Sorting için Alt Sınır
Karşılaştırmaya dayalı sıralama, yalnız:
a < b ?gibi ikili sonuçlardan bilgi topluyorsa karar ağacıyla modellenebilir.
n farklı elemanın n! olası sıralaması vardır. Karar ağacının her yaprağı farklı bir sıralama sonucunu ayırt etmek zorundadır.
İkili ağacın yüksekliği en az:
log2(n!)olmalıdır.
Bu büyüklük asimptotik olarak Omega(n log n) olduğundan:
Genel comparison sorting modeli içinde worst-case karşılaştırma sayısını
o(n log n)yapmak mümkün değildir.
Merge sort ve Heap sort bu sınırla aynı asimptotik sınıftadır. Quicksort'un beklenen maliyeti de O(n log n) olsa da worst-case'i O(n^2) olabilir.
Bu alt sınır bütün sıralama algoritmaları için geçerli değildir. Anahtarların yapısı hakkında comparison dışı bilgi kullanılabiliyorsa farklı sonuçlar mümkündür.
15.6. Counting Sort
Counting sort, anahtarların sınırlı bir tamsayı aralığında olduğunu varsayar.
Örneğin:
key ∈ {0, 1, ..., k}ise frekans dizisi oluşturularak sıralama:
O(n + k)zamanda yapılabilir.
Bu algoritmanın gücü aynı zamanda sınırıdır.
k, n'e göre çok büyükse bellek ve zaman maliyeti kötüleşir.
Counting sort comparison-sort alt sınırını ihlal etmez; çünkü yalnız karşılaştırma kullanmaz, anahtar değerini doğrudan indeksleme bilgisi olarak kullanır.
15.7. Kararlılık Özelliğinin Önemi
Stable sorting, eşit anahtarlı öğelerin girişteki göreli sırasını korur.
Örneğin:
(soyad=Kaya, yaş=42)
(soyad=Kaya, yaş=29)
kayıtları önce yaşa sonra soyada stable sort ile sıralanırsa ikinci anahtar düzeni kontrollü biçimde korunabilir.
Radix sort gibi çok basamaklı algoritmalarda iç sıralama adımının stable olması, önceki basamak bilgisinin korunması için kritik olabilir.
15.8. Radix Sort
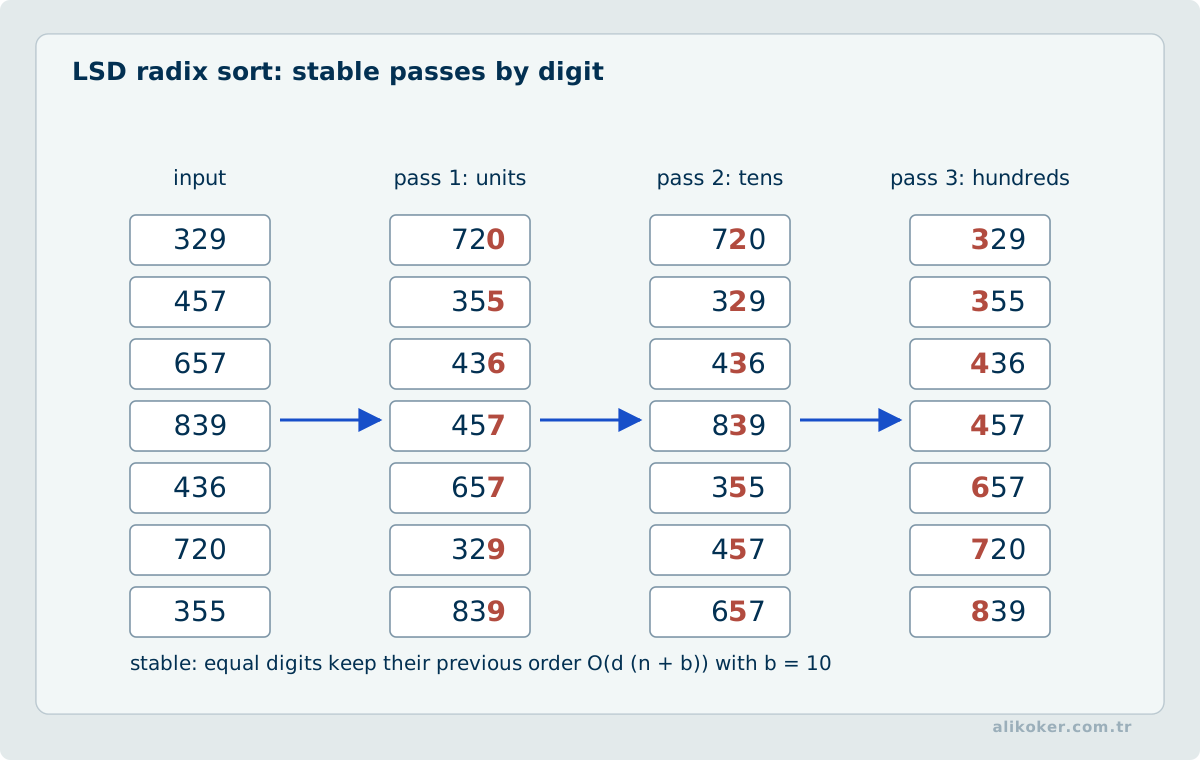
Radix sort anahtarı basamaklara ayırır.
LSD yaklaşımında:
en düşük anlamlı basamak
↓
...
↓
en yüksek anlamlı basamak
sırasıyla stable sort uygulanır.
Eğer d basamak ve her basamak 0..k aralığındaysa tipik maliyet:
O(d * (n + k))olarak düşünülebilir.
Bu ifade ancak basamak gösterimi ve kullanılan iç sıralama yöntemi açıkken anlamlıdır.
15.9. Bucket Sort
Bucket sort, elemanları değer aralıklarına göre kovalara dağıtır ve her kovayı ayrı işler.
Uniform benzeri uygun dağılım varsayımlarında beklenen maliyet lineere yaklaşabilir.
Fakat dağılım çok dengesizse:
çok sayıda eleman
-> aynı bucket
durumu avantajı ortadan kaldırabilir.
Bu nedenle bucket sort'ta yalnız n değil veri dağılımı varsayımı da algoritmanın sözleşmesidir.
15.10. Seçim ve Sıralama Karar Ağacı
Bir mühendislik probleminde:
yalnız min/max mı?
-> tek geçiş

yalnız i'inci eleman mı?
-> selection

küçük integer domain mi?
-> counting/radix aday

dağılım biliniyor mu?
-> bucket aday

genel karşılaştırılabilir nesneler mi?
-> comparison sort
şeklinde karar verilebilir.
Algoritma seçimi yalnız Big-O tablosu değil, istenen çıktı + anahtar sözleşmesi + bellek bütçesi + worst-case gereksinimi problemidir.
Ünite 16: Augmented Trees ve İleri Arama Yapıları
Bir veri yapısını "yeni bir veri yapısı" haline getiren şey her zaman tamamen yeni bir ağaç tasarlamak değildir. Bazen mevcut dengeli yapıya küçük bir özet bilgi (augmentation) eklemek yeni sorguları verimli hale getirir.
16.1. Red-Black Tree İnvariant'ları
Red-Black Tree, ikili arama ağacını yaklaşık dengeli tutmak için düğümlere bir renk biti ekler.
Klasik invariant'lar:
1. Her düğüm red veya black'tir.
2. Root black'tir.
3. NIL yapraklar black kabul edilir.
4. Red düğümün red çocuğu olamaz.
5. Bir düğümden aşağıdaki NIL yapraklara giden
   bütün yollarda aynı sayıda black düğüm vardır.
Bu kurallar mükemmel denge sağlamaz; fakat ağacın yüksekliğini logaritmik sınırda tutar.
Sonuç olarak search, insert ve delete:
O(log n)yüksekliğine bağlı kalabilir.
16.2. Rotation'ın Rolü
Left/right rotation:
- BST sıralama özelliğini korur,
- yalnız yerel bağlantıları değiştirir,
- subtree yüksekliği/özet bilgisini yerel olarak güncellemeye izin verir.
Insert veya delete sonrası Red-Black invariant'ı bozulursa:
recolor
+
rotation
kombinasyonuyla denge geri kurulur.
Rotation'ı yalnız çizim ezberi olarak görmek yerine şu açıdan okumak daha yararlıdır:
Sıralı anahtar ilişkisini bozmadan ağacın yerel geometrisini değiştiren sabit maliyetli dönüşüm.
16.3. Augmentation Tasarım İlkesi
Bir ağaç düğümüne eklenen bilgi, çocukların bilgisinden hızlı biçimde yeniden hesaplanabiliyorsa rotation sonrası güncelleme yerel kalabilir.
Örnek:
size[x] =
size[left[x]]
+
size[right[x]]
+
1
Bu alan subtree'deki düğüm sayısını taşır.
Rotasyonda yalnız birkaç düğümün size değeri yeniden hesaplanır.
Böylece dengeli BST:
order-statistic treehaline gelir.
16.4. Order-statistic Tree
Order-statistic tree iki yeni temel sorguyu destekler.
Select(i):
ağaçtaki i'inci küçük anahtarı bulRank(x):
x kaçıncı sırada?Her düğüm subtree boyutunu tuttuğu için karar:
leftSize + 1ile yapılabilir.
Dengeli ağaçta her iki sorgu da O(log n) olabilir.
Bu yapı:
- dinamik percentile,
- sıralı leaderboard,
- dinamik median yakınsaması,
- rank tabanlı indeksleme
gibi problemlerde faydalıdır.
16.5. Interval Tree
Interval sorgularında yalnız başlangıç anahtarına göre BST tutmak yeterli değildir.
Bir aralık:
[low, high]ile temsil edilsin.
Her düğümde:
maxHigh =
subtree içindeki en büyük high
özeti tutulursa, sorgu aralığıyla overlap etme ihtimali olmayan subtree'ler elenebilir.
Bu yapı özellikle:
- zaman aralığı çakışması,
- rezervasyon,
- geometri,
- takvim/scheduling
problemlerinde kullanışlıdır.
16.6. Augmentation'ın Güvenlik Koşulu
Her ek alan iyi augmentation değildir.
İdeal özet:
- subtree'den hesaplanabilir,
- rotation sonrası az sayıda düğümde güncellenebilir,
- hedef sorguda gerçek pruning veya karar bilgisi sağlar.
Global yeniden hesaplama gerektiren bir metadata:
her update sonrası O(n)maliyeti üretiyorsa dengeli ağacın operasyon avantajını yok edebilir.
16.7. B-tree: RAM Modelinden I/O Modeline Geçiş
Binary search tree CPU/RAM modeli için doğal olabilir.
Disk veya blok tabanlı saklamada asıl maliyet:
tek karşılaştırmadeğil:
bir block/page erişimiolabilir.
B-tree yüksek fan-out kullanarak bir düğümde çok sayıda anahtar ve child pointer tutar.
Sonuç:
daha az tree level
-> daha az block access
olabilir.
Bu nedenle veritabanı ve dosya sistemi indekslerinde B-tree ailesi doğaldır.
16.8. Split ve Merge
Bir B-tree düğümü kapasite sınırını aştığında split edilir; minimum doluluk altına inildiğinde kardeşten ödünç alma veya merge gerekebilir.
Bu işlemler:
- sıralı anahtar sözleşmesini,
- dengeli yaprak derinliğini,
- minimum/maximum doluluk sınırlarını
korur.
Buradaki tasarım farkı önemlidir:
AVL / Red-Black:
çok düşük fan-out, RAM dostu

B-tree:
yüksek fan-out, block-I/O dostu
16.9. B+ Tree'yi Kavramsal Olarak Ayırmak
B+ tree ailesinde asıl kayıt/record pointer'ları çoğunlukla yapraklarda tutulur; iç düğümler yönlendirme anahtarları taşır.
Yaprakların bağlı olması:
range scanişlemlerini verimli hale getirebilir.
Gerçek veritabanı motorunun B+ tree implementasyonu; page size, fill factor, concurrency, WAL ve split politikasıyla birlikte değerlendirilmelidir. Burada amaç ürün implementasyonunu genellemek değil, yüksek fan-out ve sıralı yaprak erişimi fikrini kavramaktır.
16.10. Veri Yapısını Sorgu Ailesinden Türetmek
Bir veri yapısı seçilirken yalnız:
insert kaç?
search kaç?
soruları yeterli değildir.
Daha doğru sözleşme:
exact key?
range?
rank/select?
interval overlap?
ordered iteration?
block I/O?
update frequency?
sorularıyla kurulur.
Augmentation yaklaşımı, veri yapısını hedef sorguya göre biçimlendirmenin sistematik yoludur.
Ünite 17: Dinamik Programlamada State Tasarımı ve Backtracking
Dinamik programlama "tablo doldurmak" değildir. En zor kısım, problemi doğru state ile ifade etmektir.
İyi bir DP tasarımında beş öğe açık olmalıdır:
state
transition / recurrence
base case
evaluation order
solution reconstruction
Bu beşli net değilse kod doğru görünse bile hangi problemi çözdüğü belirsiz kalabilir.
17.1. 0/1 Knapsack
Her öğe:
weight[i]
value[i]
ile tanımlansın ve her öğe en fazla bir kez seçilebilsin.
Bir state:
DP[i][w]
=
ilk i öğe kullanılarak
kapasite w altında elde edilebilen en iyi değer
olarak kurulabilir.
Karar:
öğeyi alma
veya
öğeyi alabilecek kapasite varsa alma
iki dalıdır.
Recurrence:
DP[i][w] =
max(
  DP[i-1][w],
  value[i] + DP[i-1][w-weight[i]]
)
şeklinde ifade edilebilir.
Maliyet O(nW) görünür.
Ancak W sayısal kapasitenin kendisidir; input uzunluğu yaklaşık log W bit olduğundan bu algoritma pseudo-polynomial sınıftadır.
Bu ayrım complexity analizinde önemlidir.
17.2. Longest Common Subsequence
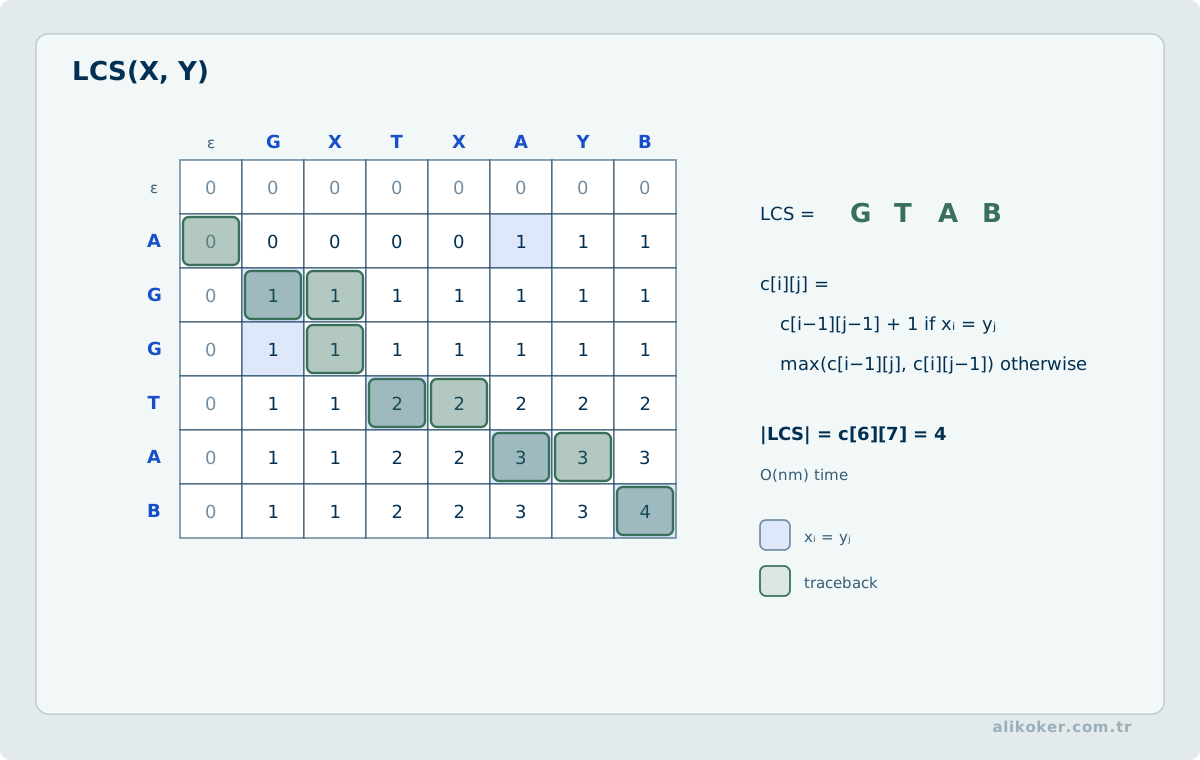
İki dizi/metin:
X[1..m]
Y[1..n]
için state:
L[i][j]
=
X'in ilk i elemanı ile
Y'nin ilk j elemanının LCS uzunluğu
olarak seçilebilir.
Son karakterler eşitse:
L[i][j] = 1 + L[i-1][j-1]değilse:
L[i][j] = max(
  L[i-1][j],
  L[i][j-1]
)
kullanılır.
Buradaki asıl fikir:
Optimal çözüm, iki prefix'in daha küçük optimal çözümlerinden kuruluyor.
Tablo yalnız sayısal uzunluğu verir. Gerçek subsequence isteniyorsa predecessor kararları geriye izlenebilir.
17.3. Edit Distance
Edit distance iki metni dönüştürmek için insert, delete ve replace gibi operasyonların maliyetini optimize eder.
State:
D[i][j]
=
X[1..i] -> Y[1..j]
dönüşümünün minimum maliyeti
olarak kurulabilir.
Son karakterler eşleşmiyorsa adaylar:
delete  -> D[i-1][j] + costDelete
insert  -> D[i][j-1] + costInsert
replace -> D[i-1][j-1] + costReplace
olur.
Bu yapı:
- spell correction,
- sequence alignment,
- fuzzy matching
gibi alanlara temel oluşturur.
Ancak Unicode veya domain-specific tokenization varsa "karakter" biriminin ne olduğu ayrıca tanımlanmalıdır.
17.4. Matrix-chain Multiplication
Aynı matris çarpım zinciri farklı parantezlenebilir.
Matematiksel sonuç aynı olsa da skaler çarpım sayısı dramatik değişebilir.
State:
M[i][j]
=
A_i ... A_j
çarpımının minimum maliyeti
olsun.
Son bölme noktası k denenerek:
i..k
k+1..j
iki alt problem birleştirilir.
Burada DP tablosu:
kısa aralıklar
-> daha uzun aralıklar
sırasıyla doldurulur.
Bu örnek, DP'de traversal order'ın recurrence bağımlılığı tarafından belirlendiğini gösterir.
17.5. Memoization ve Tabulation
Top-down memoization:
recursive specification
+
visited cache
yaklaşımıdır.
Yalnız gerçekten erişilen state'leri hesaplayabilir.
Bottom-up tabulation:
dependency order
+
iterative table
ile çalışır.
Fonksiyon çağrı overhead'i yoktur ve memory layout daha kontrollü olabilir.
Asimptotik state sayısı aynı olsa bile:
- erişilen state oranı,
- cache locality,
- recursion depth,
- reconstruction ihtiyacı
gerçek performansı etkileyebilir.
17.6. State Compression
Bir recurrence yalnız önceki satırı kullanıyorsa:
O(nW)tablo belleği bazen:
O(W)seviyesine indirilebilir.
Ancak reconstruction gerekiyorsa yalnız sıkıştırılmış değer tablosu yeterli olmayabilir.
Bu nedenle memory optimization:
çıktı olarak yalnız optimum değer mi?
yoksa seçilen çözüm de mi?
sorusuna bağlıdır.
17.7. Backtracking Ayrı bir Tasarım Paradigmasıdır
Backtracking tüm çözüm uzayını körlemesine gezmek zorunda değildir.
Temel yapı:
partial solution
    ↓
candidate choice
    ↓
feasible mi?
   / \
 hayır evet
  |    |
prune  recurse
        |
       undo
şeklindedir.
N-Queens, Sudoku-benzeri kısıt problemleri, subset seçimleri ve bazı graph-coloring yaklaşımları bu modeli kullanabilir.
17.8. Backtracking ile Dynamic Programming Farkı
Backtracking:
search tree
+
constraint pruning
üzerinden ilerler.
Dynamic programming:
overlapping subproblems
+
optimal substructure
+
state reuse
üzerinden ilerler.
Aynı problem iki yaklaşımla çözülebilir; fakat state tekrarları büyükse memoization dramatik kazanç sağlayabilir.
17.9. Branch-and-bound ile Fark
Branch-and-bound yalnız feasibility değil objective bound kullanır.
Örneğin minimization probleminde:
current partial cost
+
best possible remaining lower bound
>=
known best solution
ise dal kesilebilir.
Backtracking daha çok:
bu partial solution geçerli bir tam çözüme dönüşebilir mi?sorusuyla pruning yapar.
Gerçek implementasyonlarda iki teknik birlikte kullanılabilir.
17.10. DP Tasarım Kontrol Listesi
Bir DP probleminde:
- State tam olarak neyi temsil ediyor?
- Aynı state'e farklı yollardan ulaşılıyor mu?
- Transition bütün olasılıkları kapsıyor mu?
- Base case nedir?
- Evaluation order dependency'leri koruyor mu?
- State uzayı input büyüklüğüne göre gerçekten polynomial mı?
- Sonuç reconstruction gerektiriyor mu?
- Memory compression semantiği bozuyor mu?
Bu sorular, DP'yi örnek ezberinden çıkarıp tekrar kullanılabilir tasarım metoduna dönüştürür.
17.11. Dinamik Programlamada State, Transition ve Reconstruction
Dinamik programlama problemi dört parçaya ayırmak tasarımı berraklaştırır:
state          -> geçmişten neyi hatırlıyorum?
transition     -> yeni durum hangi önceki durumlardan gelir?
base case      -> hesap nereden başlıyor?
reconstruction -> optimum karar dizisini nasıl geri çıkarıyorum?
Memoization top-down özyinelemeyi önbellekler. Tabulation bağıntıyı bağımlılık sırasına göre bottom-up hesaplar. İkisi aynı matematiksel bağıntıyı farklı yürütme ve bellek modeliyle değerlendirir.
Tüm durum tablosunu saklamak her zaman gerekmez. Bir satır yalnız önceki satıra bağlıysa rolling-array ile bellek azaltılabilir; fakat reconstruction için ek predecessor bilgisi gerekebilir. Bu nedenle zaman ve alan karmaşıklığı birlikte tasarlanmalıdır.
Ünite 18: İleri Graf Algoritmaları: Shortest Paths, SCC, Flow ve Matching
Graf problemlerinde en kritik hata, algoritmayı yalnız "en kısa yol bulur" veya "bağlantıyı inceler" etiketiyle seçmektir. Kenar ağırlıklarının işareti, grafın yönlü olup olmaması, tek kaynak mı tüm çiftler mi istendiği ve problemin yol mu akış mı olduğu algoritmanın önkoşullarını değiştirir.
18.1. Relaxation Ortak Soyutlaması
Birçok shortest-path algoritması aynı temel işlemi kullanır.
Bir kenar:
u -> v
weight = w(u,v)
olsun.
Eğer:
dist[u] + w(u,v) < dist[v]ise:
dist[v] = dist[u] + w(u,v)
parent[v] = u
güncellenir.
Bu relaxation işlemi tek başına algoritma değildir. Dijkstra, Bellman-Ford ve DAG shortest-path yöntemleri relaxation'ı farklı sırada ve farklı önkoşullarla uygular.
18.2. Bellman-Ford
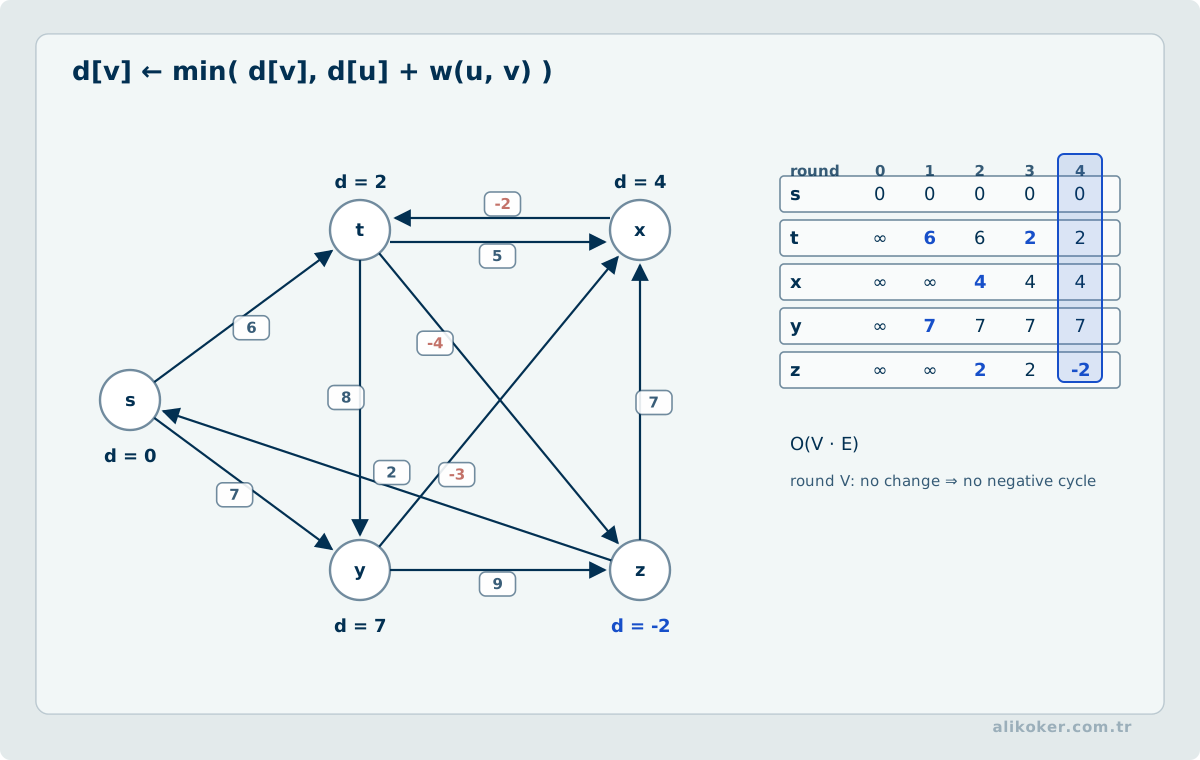
Bellman-Ford:
- negatif ağırlıklı kenarlara izin verir,
- source'tan erişilebilen negatif ağırlıklı cycle'ı tespit edebilir.
Temel mantık:
V-1 kez:
    bütün kenarları relax et
Neden V-1?
Negatif cycle içermeyen basit bir shortest path en fazla V-1 kenar taşır.
Son bir kenar taramasında hâlâ iyileşme mümkünse:
source'tan erişilebilen
negative-weight cycle
vardır.
Maliyet:
O(VE)olur.
Dijkstra'nın kullanılamadığı her problemde Bellman-Ford otomatik olarak en iyi seçim değildir; DAG yapısı veya başka problem özelliği daha ucuz çözüm sağlayabilir.
18.3. DAG Shortest Paths
Graf directed acyclic ise topological order güçlü bir avantaj sağlar.
Düğümler topological sırada işlenir ve çıkan kenarlar bir kez relax edilir.
topological sort
+
single pass relaxation
ile maliyet:
O(V + E)olabilir.
Üstelik DAG'da negatif ağırlıklar problem oluşturmaz; cycle zaten yoktur.
Bu örnek önemli bir ilkedir:
Algoritma seçerken yalnız edge weight'e değil, graph structure'a da bakın.
18.4. All-pairs Shortest Paths
Bütün u, v çiftleri için shortest path isteniyorsa tek-source algoritmayı körlemesine tekrar etmek yerine probleme özel yöntemler düşünülmelidir.
18.5. Floyd-Warshall
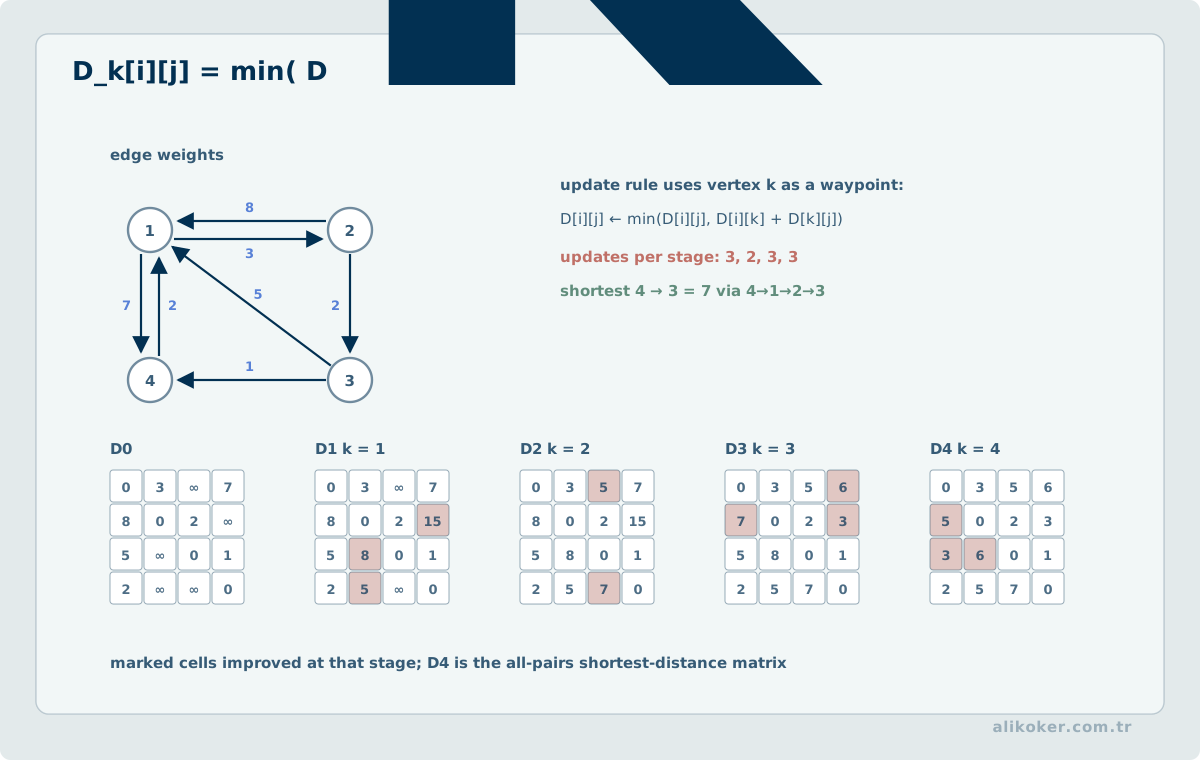
Floyd-Warshall dynamic programming kullanır.
State fikri:
D[k][i][j]
=
yalnız ilk k ara düğümü kullanmaya izin verildiğinde
i -> j shortest-path maliyeti
Transition:
k düğümünü kullanma
veya
i -> k -> j üzerinden kullan
mantığıdır.
Space optimize edilirse tek 2D matris üzerinde güncelleme yapılabilir.
Maliyet:
O(V^3)olur.
Yoğun graflarda ve tüm çiftlerin gerçekten gerektiği durumda sade ve güçlüdür.
Floyd–Warshall yönteminin uzaklık tablosu, yalnız en kısa yolları değil olumsuz çevrim varlığını da sınamak için kullanılabilir. Ara düğümler sırayla serbest bırakıldıktan sonra herhangi bir köşegen elemanının negatif olması, o köşeden başlayıp yeniden aynı köşeye daha düşük maliyetle dönülebildiğini gösterir. Böyle bir çevrim üzerinden erişilebilen iki düğüm arasındaki en kısa yolun sonlu bir alt sınırı yoktur. Negatif kenar bulunması ile negatif çevrim bulunması ayrı durumlardır: ilki tek başına algoritmayı geçersiz kılmaz, ikincisi ilgili yolun optimumunu tanımsız kılar. Bu ayrım, bir uzaklık matrisi üretildiğinde yapılacak geçerleme kontrolünün parçası olmalıdır.
18.6. Johnson Algoritması
Sparse graph'ta all-pairs shortest path için Johnson yaklaşımı:
Bellman-Ford ile potential hesapla
↓
edge reweighting
↓
negative edge'leri nonnegative hale getir
↓
her source için Dijkstra
fikrini kullanır.
Reweighting shortest-path sıralamasını koruyacak biçimde yapılır.
Bu yöntem özellikle:
E << V^2olan sparse graflarda Floyd-Warshall'a göre daha uygun olabilir.
Ancak negative cycle varsa reweighting sözleşmesi geçersizdir; önce bunun tespiti gerekir.
18.7. Strongly Connected Components
Yönlü grafta iki düğüm:
u ->* v
ve
v ->* u
ise aynı strongly connected component içinde olabilir.
SCC ayrıştırması:
- dependency graph,
- module relation,
- call graph,
- state-transition system
gibi yapılarda döngüsel kümeleri bulmak için kullanılır.
Bir graf SCC'lere sıkıştırıldığında oluşan condensation graph her zaman DAG'dır.
Bu, daha karmaşık yönlü grafı:
cycle içeren lokal bloklar
+
cycle içermeyen üst seviye yapı
olarak düşünmeyi sağlar.
18.8. Kosaraju Yaklaşımı
Kavramsal süreç:
DFS ile finishing order
↓
transpose graph
↓
ters finishing order'da DFS
↓
her DFS ağacı bir SCC
şeklindedir.
İki DFS ve transpose oluşturma ile:
O(V + E)maliyet mümkündür.
18.9. Tarjan SCC
Tarjan yaklaşımı tek DFS geçişinde:
- discovery index,
- low-link bilgisi,
- stack membership
tutar.
Bir düğümün:
lowlink == discoveryIndexkoşulu SCC root'u olabileceğini gösterir.
Bu algoritma da lineer zamanda çalışabilir.
Buradaki genel ders şudur:
DFS yalnız traversal değildir; doğru ek state ile grafın yapısal invariant'larını çıkaran bir iskelet olabilir.
18.10. Flow Network
Shortest path ile maximum flow aynı problem değildir.
Flow network'te her directed edge'in kapasitesi vardır:
0 <= flow(u,v) <= capacity(u,v)Ara düğümlerde akış korunur:
incoming flow = outgoing flowKaynak s ve hedef t arasındaki toplam akışı maksimize etmek amaçlanır.
18.11. Residual Graph
Bir edge üzerinde gönderilen akış, yalnız kalan ileri kapasiteyi değil gerektiğinde önceki kararın geri alınabilmesini de etkiler.
Residual capacity:
ileri residual
=
capacity - current flow

geri residual
=
current flow
fikriyle modellenir.
Bu nedenle augmenting-path yöntemi eski akış kararlarını daha sonra yeniden yönlendirebilir.
18.12. Ford-Fulkerson Yöntemi
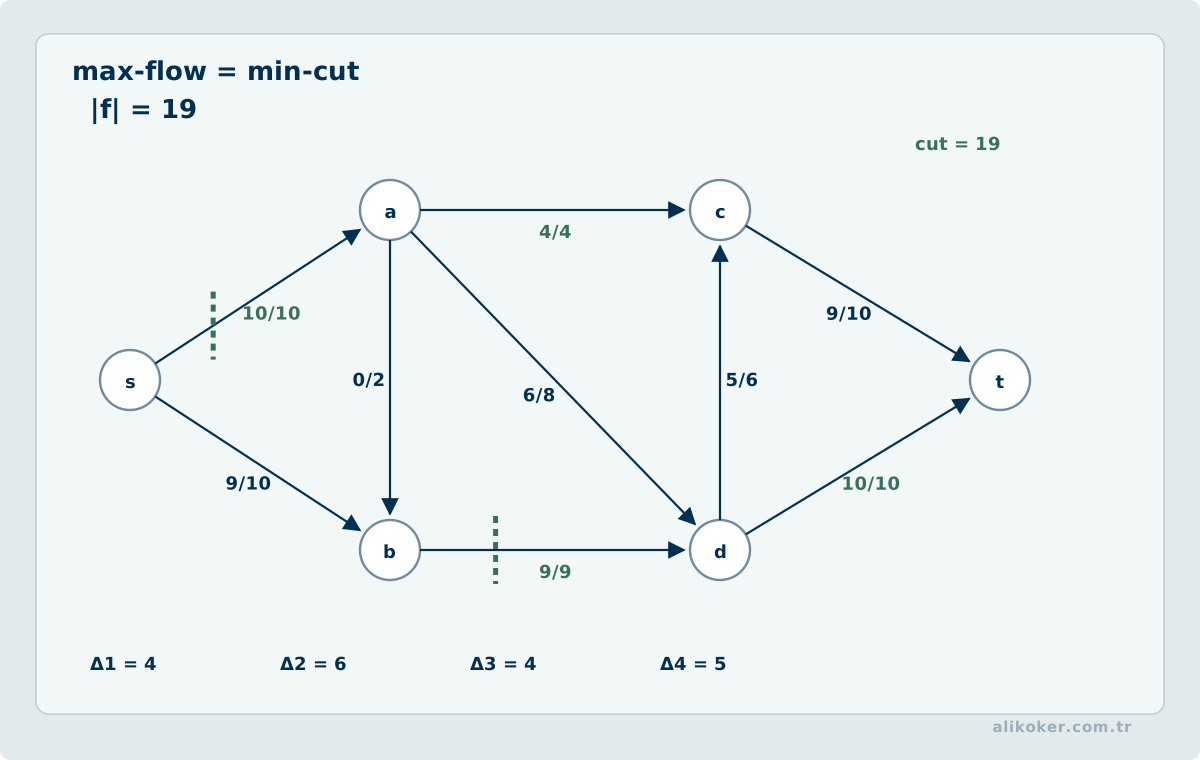
Kavramsal iskelet:
while residual graph'ta s -> t yolu var:
    path bottleneck'i bul
    path boyunca flow artır
şeklindedir.
"Ford-Fulkerson algoritmasının tek complexity değeri" demek yanıltıcıdır; augmenting path'in nasıl seçildiği ve capacity türleri davranışı etkiler.
BFS ile en az edge sayılı augmenting path seçen Edmonds-Karp implementasyonu:
O(V E^2)worst-case sınırına sahiptir.
18.13. Max-flow min-cut
Bir s-t cut, düğümleri:
S
T
olarak iki kümeye ayırır ve s ∈ S, t ∈ T koşulunu taşır.
Cut capacity, S'den T'ye giden edge kapasitelerinin toplamıdır.
Max-flow min-cut teoremi:
Maksimum
s-tflow değeri, minimums-tcut kapasitesine eşittir.
Bu dual bakış, yalnız algoritmanın sonucu değil neden daha fazla akış gönderilemediğinin sertifikasını da sağlar.
18.14. Bipartite Matching
Bipartite graph:
L ∪ Riki ayrık düğüm kümesine sahiptir ve edge'ler yalnız karşı kümeler arasında bulunur.
Matching, hiçbir düğümün birden fazla seçili edge'e incident olmadığı edge kümesidir.
Maximum bipartite matching, unit-capacity flow ağına dönüştürülebilir:
source -> L -> R -> sinkBütün kapasiteler 1 seçilirse integral max-flow sonucu matching verir.
Bu ilişki, problem dönüşümünün gücünü gösterir.
18.15. Hopcroft-Karp
Bipartite matching için genel max-flow çalıştırmak mümkün olsa da probleme özel algoritmalar daha iyi sınır sunabilir.
Hopcroft-Karp, BFS ile birden çok en kısa augmenting path katmanı bulup DFS benzeri aramayla aynı fazda birçok augmentation yapar.
Standart sınır:
O(E * sqrt(V))olarak verilir.
Bu algoritma:
- görev-atama,
- uyumluluk eşleştirme,
- bazı scheduling ve allocation problemleri
için temel araçtır.
18.16. Graf Algoritması Seçme Matrisi
Soru şu sırada daraltılabilir:
tek kaynak mı?
tüm çiftler mi?
negative edge var mı?
negative cycle olabilir mi?
DAG mı?
path mi flow mu?
graph bipartite mı?
sparse mı dense mı?
Bu önkoşullar netleşmeden "en iyi graf algoritması" diye tek cevap yoktur.
18.17. Uniform-cost, A* ve İki Yönlü Arama
Ağırlıklı bir graf üzerinde uniform-cost search, en düşük birikmiş yol maliyetine sahip açık düğümü genişletir. Negatif olmayan kenar maliyetlerinde bu düşünce Dijkstra algoritmasıyla yakından ilişkilidir.
A* araması bir düğüm için iki bilgiyi birleştirir:
f(n) = g(n) + h(n)g(n) başlangıçtan bilinen gerçek maliyet, h(n) ise hedefe kalan maliyetin sezgisel tahminidir. h(n) gerçek kalan maliyeti hiçbir zaman aşmıyorsa admissible; üçgen eşitsizliğine benzer tutarlılık koşulunu sağlıyorsa consistent heuristic olarak adlandırılır.
Heuristic ne kadar bilgilendiriciyse gereksiz düğüm genişletme azalabilir; fakat heuristic hesaplamasının kendisi de maliyetlidir. Heuristic 0 seçilirse A* uniform-cost davranışına geri döner.
Başlangıç ve hedef biliniyorsa iki yönlü arama iki uçtan ilerleyen sınırları buluşturmaya çalışır. Teorik dallanma avantajı uygulamada ters kenar erişimi, durma koşulu ve bellek yönetimiyle birlikte değerlendirilmelidir.
Ünite 19: String Matching, Rolling Hash ve Suffix Yapıları
Metin arama problemi:
text T, uzunluk n
pattern P, uzunluk m
verildiğinde P'nin T içinde geçtiği konumları bulmaktır.
Bu problem basit görünür; ancak preprocessing, alphabet yapısı, tekrar eden pattern'ler, çoklu sorgu sayısı ve collision riski doğru algoritmayı değiştirir.
19.1. Naive Matching
En doğrudan yaklaşım her olası başlangıç konumunu dener.
T[s ... s+m-1]
ile
P[0 ... m-1]
karşılaştır
Worst-case maliyet:
O((n-m+1) * m)olabilir.
Özellikle:
T = aaaaaaaaa...
P = aaaaaaaab
gibi yüksek tekrar içeren girdiler çok sayıda aynı karşılaştırmayı yeniden yaptırabilir.
İleri algoritmaların temel amacı bu tekrar bilgisini yeniden kullanmaktır.
19.2. Rabin-Karp ve Rolling Hash
Rabin-Karp, pattern'i ve text içindeki m uzunluklu pencereyi hash ile karşılaştırır.
Temel avantaj:
window hash
-> bir sonraki window hash
değerinin baştan hesaplanmadan güncellenebilmesidir.
Bu rolling hash fikridir.
Hash eşitse gerçek karakter karşılaştırması yapılmalıdır; çünkü hash collision mümkündür.
Bu nedenle:
hash eşit
!=
metin kesin eşit
olur.
Rabin-Karp:
- çoklu pattern,
- plagiarism-benzeri substring aday üretimi,
- rolling fingerprint
senaryolarında yararlı olabilir.
Hash seçimi ve mod arithmetic performans/güvenilirlik trade-off'udur.
Adversarial girdilerde collision politikasını görmezden gelmek worst-case davranışı bozabilir.
19.3. Finite-automaton Matching
Pattern, state machine olarak temsil edilebilir.
State:
şu ana kadar pattern'in
kaç karakterlik prefix'i eşleşti?
anlamına gelir.
Her yeni karakterde:
state = delta(state, character)geçişi yapılır.
Transition function önceden hazırlanırsa text scan:
O(n)zamanda ilerleyebilir.
Maliyet preprocessing ve alphabet boyutuna kayar.
Bu yaklaşım otomata teorisi ile pratik substring aramasını doğrudan bağlar.
19.4. KMP: Prefix Bilgisini Failure Function'a Dönüştürmek
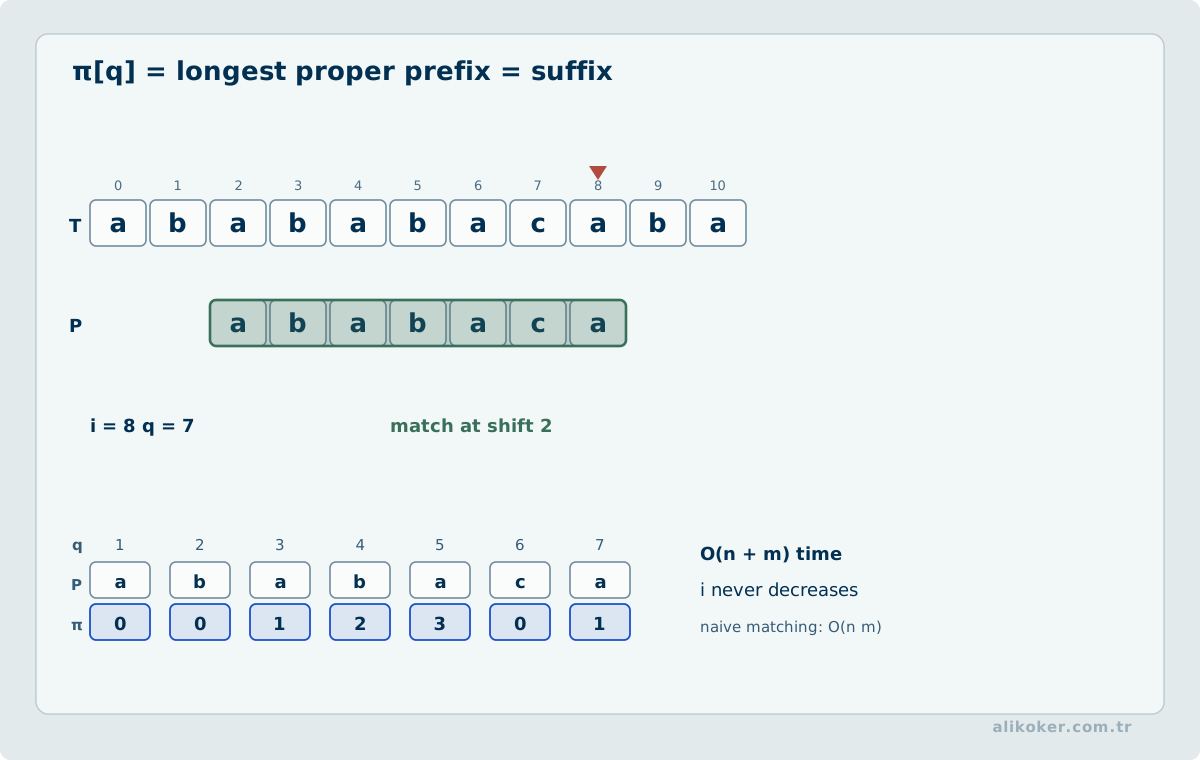
Knuth-Morris-Pratt algoritması, mismatch olduğunda pattern'i başa döndürmek yerine daha önce eşleşen prefix bilgisini kullanır.
Örneğin pattern'in bir prefix'i aynı zamanda mevcut eşleşmiş bölümün suffix'i ise:
tekrar bildiğimiz karakterleri
yeniden karşılaştırma
gereksizdir.
Prefix/failure function:
pi[q]
=
P[0..q] bölümünün
aynı zamanda suffix olan
en uzun proper prefix uzunluğu
bilgisini taşır.
Preprocessing:
O(m)text matching:
O(n)ve toplam:
O(n + m)olabilir.
KMP'nin asıl değeri yalnız bu complexity değil, başarısız eşleşmeden hangi bilginin korunabileceğini sistematikleştirmesidir.
19.5. Boyer-Moore Sezgisi
Boyer-Moore pattern'i çoğu zaman sağdan sola karşılaştırır ve mismatch'te birden fazla karakter atlayabilecek kurallar kullanır.
Klasik iki sezgi:
- bad-character rule,
- good-suffix rule.
Pratikte özellikle büyük alphabet ve doğal metinlerde az sayıda karakter inceleyerek çok hızlı olabilir.
Ancak implementasyon ayrıntıları ve worst-case garantileri kullanılan varyanta bağlıdır.
Bu nedenle Boyer-Moore'u:
her zaman lineerveya:
her zaman KMP'den hızlışeklinde genellemek doğru değildir.
19.6. Tek Pattern ile Çoklu Sorgu Farkı
Tek bir pattern yalnız bir text üzerinde aranıyorsa KMP/Rabin-Karp gibi yöntemler doğal olabilir.
Aynı büyük text üzerinde çok sayıda substring sorgusu yapılacaksa preprocessing'i text tarafına taşımak daha anlamlı olabilir.
Burada suffix yapıları devreye girer.
19.7. Suffix Array
Bir text'in bütün suffix'leri düşünülür:
T[0..]
T[1..]
T[2..]
...
T[n-1..]
Suffix array, bu suffix'leri fiziksel olarak kopyalamak yerine:
lexicographic sıradaki başlangıç indeksleriolarak saklar.
Örnek:
T = bananaiçin array, "a", "ana", "anana", "banana", ... sırasına göre suffix başlangıçlarını taşır.
Bu yapı:
- substring search,
- repeated substring,
- lexicographic rank,
- text indexing
problemlerine temel olabilir.
19.8. Suffix Array Üzerinde Arama
Pattern, lexicographic sıralı suffix listesinde binary search ile aranabilir.
Temel yaklaşım:
lower bound
+
upper bound
ile pattern prefix'ine sahip suffix aralığını bulmaktır.
Basit implementasyonda her karşılaştırma O(m) karakter inceleyebildiği için toplam maliyet yalnız O(log n) değildir.
Daha gelişmiş teknikler:
- LCP bilgisi,
- prefix cache,
- specialized suffix-array construction
ile maliyeti azaltabilir.
19.9. LCP Array
LCP:
Longest Common Prefixarray'i, lexicographic olarak komşu suffix'lerin ortak prefix uzunluğunu taşır.
Bu bilgi:
- longest repeated substring,
- tekrar analizi,
- bazı range-minimum tabanlı substring sorguları
için değerlidir.
Suffix array ve LCP, trie/suffix tree gibi yapılara göre farklı space/cache trade-off'ları sunar.
19.10. Çoklu Pattern için Trie ve Automaton
Çok sayıda pattern aynı text üzerinde aranıyorsa:
patterns
-> trie
-> failure transitions
yaklaşımıyla Aho-Corasick benzeri çoklu pattern automaton'ları kullanılabilir.
Bu dersin temel string-matching omurgası için KMP ve suffix array yeterli olsa da şu tasarım ilkesini görmek önemlidir:
Preprocessing'i pattern tarafına mı, text tarafına mı, yoksa bütün pattern kümesine mi yatıracağınız sorgu dağılımına bağlıdır.
19.11. Unicode ve Normalization Sınırı
Algoritmalar çoğu zaman "character" dizisi varsayar.
Gerçek metinde:
- UTF-8 byte,
- Unicode code point,
- grapheme cluster,
- normalize edilmiş text
aynı şey değildir.
é tek code point olarak veya birleşik iki code point olarak temsil edilebilir.
Bu nedenle substring semantiği:
byte-level mı?
code-point level mı?
normalized text mi?
sorusunu açıkça tanımlamalıdır.
Algoritma doğru olsa bile yanlış temsil katmanında çalıştırılırsa kullanıcı açısından yanlış sonuç üretebilir.
19.12. String Matching Seçimi
küçük tek sorgu
-> naive bile yeterli olabilir

tek pattern + büyük text
-> KMP / Rabin-Karp

hash tabanlı çoklu aday
-> Rabin-Karp

çok sayıda query + sabit text
-> suffix array / text index

çok sayıda pattern
-> trie / multi-pattern automaton
Karar yine yalnız asymptotic complexity değil, preprocessing maliyeti ve sorgu tekrar sayısıyla verilmelidir.
19.13. Edit Distance ile Dizi Hizalama Aynı Problem Değildir
Levenshtein tipi edit distance, iki dizgi arasındaki minimum dönüşüm maliyetini tek bir sayıyla özetler. Dizi hizalama (sequence alignment) ise hangi elemanın hangi elemanla veya boşlukla eşleştirildiğini açık bir yapı olarak üretir. Aynı dinamik programlama ızgarasını paylaşabilseler de amaç fonksiyonları ve skor semantiği farklıdır.
Needleman-Wunsch global hizalama yapar: iki dizinin baştan sona birlikte hizalanmasını optimize eder. Basit skor modelinde state:
F[i][j] = X[1..i] ile Y[1..j] için en iyi global hizalama skoruve geçişler eşleşme/değiştirme ile iki gap seçeneğini karşılaştırır:
F[i-1][j-1] + score(X[i], Y[j])
F[i-1][j]   + gap
F[i][j-1]   + gap
Smith-Waterman yerel hizalama arar. Aynı temel geçişlere 0 adayı eklenir; negatif toplamlar sıfırlanabildiği için en iyi ortak alt-bölge, dizilerin geri kalanından bağımsız biçimde ortaya çıkabilir:
H[i][j] = max(0, diagonal, up, left)Bu ayrım pratik seçimde belirleyicidir:
global alignment -> dizilerin tamamı karşılaştırılacak
local alignment  -> en benzer alt-bölgeler aranacak
edit distance    -> minimum düzenleme maliyeti isteniyor
substring search -> tam/örüntü eşleşmesinin konumu aranıyor
Basit gap maliyeti uzun bir boşluğu çok sayıda bağımsız boşluk gibi cezalandırır. Affine gap modeli gap-open + k*gap-extend ayrımıyla uzun boşlukların yapısını daha gerçekçi ifade edebilir. Biyolojik dizilerde substitution matrix, doğal dilde ise tokenlaştırma ve normalizasyon seçimi skorun anlamını doğrudan değiştirir.
Klasik iki boyutlu tablo O(nm) zaman ve O(nm) alan kullanır. Yalnız skor gerekiyorsa önceki satır/sütun tutularak alan azaltılabilir; gerçek hizalamanın traceback ile üretilmesi ise hangi kararların saklanacağına ilişkin ek tasarım gerektirir.
19.14. Hatalı Yazım için Silme Anahtarları ve Aday Karmaşıklığı
Yaklaşık sözcük aramasında her sorgu için sözlükteki tüm kelimelerin düzenleme uzaklığını hesaplamak pahalıdır. Alternatif yöntem, sözlük sözcüklerinden sınırlı sayıda karakter silinerek elde edilen anahtarları önceden indekslemektir. Yanlış yazılmış sorgudan üretilen benzer silme anahtarları, az sayıda sözlük adayıyla eşleşir; gerçek düzenleme uzaklığı yalnız bu adaylar üzerinde hesaplanır. Böylece pahalı doğrulama bütün sözlük yerine dar bir aday kümesinde yapılır.
Bu yaklaşımda silme uzaklığının üst sınırı belirleyicidir. Sınır büyüdükçe geri çağırım artabilir, fakat indeks boyutu ve yanlış eşleşme sayısı da yükselir. Çok kısa sözcüklerde veya ortak hecelerde çakışma daha sık görülür. Türkçe çekim ekleri de sözlüğün tüm yüzey biçimlerini indislemekle kök ve ek yapılarını ayrı değerlendirmek arasında bellek–kapsama dengesi doğurur.
Aday bulma algoritması, düzeltmenin doğruluğuyla karıştırılmamalıdır. Silme anahtarı yalnız olası eşleşmeyi bulur; sözcüğün cümledeki rolü, olumsuzluk ve korunmuş kimlik alanları ayrıca denetlenir. Sözcük sınırı kaybolmuş ifadelerde ayırma ve birleştirme adayları üretilebilir, ancak hangi biçimin kabul edileceğine bağlamsal kanıtla karar verilir.
Ünite 20: Amortize Analiz: Aggregate, Accounting ve Potential Yöntemleri
Worst-case analiz tek bir operasyonun ne kadar kötü olabileceğini sorar.
Amortize analiz ise:
Uzun bir geçerli operasyon dizisi içinde pahalı işlemlerin maliyeti nasıl dağılıyor?
sorusunu sorar.
Bu average-case analysis değildir.
Amortize analiz için probabilistic input dağılımı gerekmeyebilir. Garanti, her geçerli operasyon dizisi üzerinde toplam maliyet için verilebilir.
20.1. Dinamik Dizi Örneği
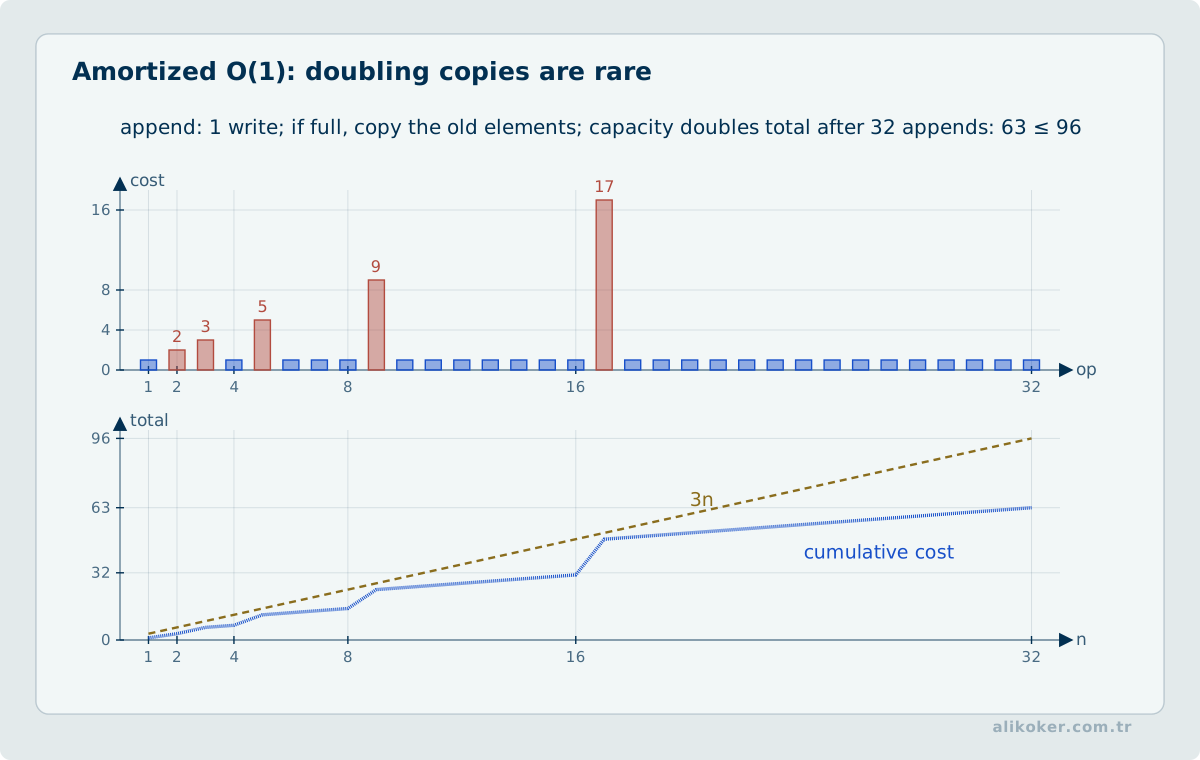
Kapasite dolunca dizi iki kat büyütülsün.
Çoğu append:
1 element writemaliyetindedir.
Resize anında:
eski bütün elemanları kopyala
+
yeni elemanı yaz
gerekir.
Tek bir append O(n) olabilir; ancak kapasite:
1, 2, 4, 8, 16, ...şeklinde geometrik büyüdüğünde bütün copy maliyetleri:
1 + 2 + 4 + ... < 2nile sınırlandırılabilir.
Bu nedenle n append'in toplamı O(n), append başına amortize maliyet O(1) olur.
20.2. Aggregate Analysis
Aggregate yöntemde önce:
n operasyonun toplam gerçek maliyeti T(n)bulunur.
Sonra her operasyona:
T(n) / namortize pay verilir.
Dinamik dizi ve binary counter örneklerinde bu yöntem çok doğaldır.
20.3. Binary Counter Örneği
Binary counter increment:
...01111
->
...10000
geçişinde birçok bit flip edebilir.
Tek increment worst-case:
O(log n)bit flip yapabilir.
Fakat düşük anlamlı bit her increment'te, bir üst bit iki increment'te bir, sonraki bit dört increment'te bir değişir.
n increment boyunca toplam flip sayısı geometrik seriyle O(n) olur.
Bu nedenle amortize increment maliyeti O(1) olarak sınırlandırılabilir.
20.4. Accounting Method
Accounting yaklaşımında her operasyona gerçek maliyetinden farklı bir amortize ücret atanır.
Ucuz operasyonlar fazla ücretlendirilebilir ve kalan kredi veri yapısında gelecekteki pahalı işlem için saklanmış kabul edilir.
Dinamik dizide:
normal append gerçek maliyet: 1

amortize ücret:
1 -> current write
1 -> future move credit
1 -> additional reserve
gibi bir kredi yorumu yapılabilir.
Önemli invariant:
birikmiş kredi asla negatif olmamalıolmalıdır.
Bu sağlanıyorsa toplam amortize ücret, toplam gerçek maliyet için upper bound verir.
20.5. Potential Method
Potential yöntemi accounting fikrini tek tek nesne kredileri yerine veri yapısının global enerjisi gibi ifade eder.
Bir state D_i için:
Phi(D_i) >= 0potential fonksiyonu tanımlansın.
Amortize maliyet:
amortized_i
=
actual_i
+
Phi(D_i)
-
Phi(D_(i-1))
olarak hesaplanır.
Toplamda ara potential değişimleri teleskopik olarak iptal olur:
sum(amortized)
=
sum(actual)
+
Phi(final)
-
Phi(initial)
Eğer başlangıç potential uygun seçilir ve potential negatif olmazsa amortize toplam gerçek maliyeti sınırlar.
20.6. Potansiyel Fonksiyon Seçim İlkeleri
İyi potential:
- gelecekteki pahalı işi temsil eder,
- ucuz operasyonlarda birikir,
- pahalı operasyonda azalır,
- state'ten kolay hesaplanır.
Potential fonksiyonu keyfi "matematik hilesi" değildir.
Yanlış potential doğru üst sınır vermeyebilir veya analizi anlamsız derecede gevşek yapabilir.
20.7. Aggregate, Accounting ve Potential Aynı Sonucu Farklı Dille Anlatabilir
Bu üç yöntem çoğu problemde farklı perspektiflerdir.
aggregate:
toplam maliyeti doğrudan say

accounting:
ucuz işleme kredi yükle

potential:
state içinde birikmiş işi sayısallaştır
Bir problemde en kısa ispat hangi yöntemle çıkıyorsa o tercih edilebilir.
20.8. Amortize ile Expected Cost Farkı
Randomized hash table veya randomized quicksort için beklenen maliyet:
random variable expectationüzerinden hesaplanır.
Amortize maliyet ise:
operation sequence toplamıüzerinden hesaplanabilir.
Bir algoritma:
- randomized ve amortized,
- deterministic ve amortized,
- expected fakat amortized olmayan
özelliklere sahip olabilir.
Bu kavramları aynı "ortalama" başlığı altında birleştirmek hata üretir.
20.9. Worst-case Latency Yine Önemli Olabilir
Bir operasyonun amortize O(1) olması:
her çağrı O(1)demek değildir.
Gerçek zamanlı sistemde tek resize'ın O(n) pause oluşturması kabul edilemeyebilir.
Bu durumda:
- incremental rehash/resize,
- capacity reservation,
- bounded work per operation
gibi teknikler gerekebilir.
Dolayısıyla amortize analiz throughput açısından güçlü bir araçtır; tail-latency gereksinimini tek başına karşılamaz.
20.10. Amortize Analizin Uygulama Koşulları
Şu desenler ipucudur:
nadiren pahalı rebuild
geometrik büyüme
lazy cleanup
path compression
self-adjusting structure
deferred maintenance
Bu durumda tek operasyon worst-case'i tasarımın gerçek maliyetini olduğundan kötü gösterebilir.
Amortize analiz, pahalı işin ne sıklıkta ve hangi invariant altında ortaya çıktığını kanıtlar.
Ünite 21: P, NP, Reduction ve Yaklaşım Garantileri
Algoritmanın "yavaş" olması ile problemin hesaplama açısından zor olması aynı iddia değildir.
Kötü implementasyon kolay problemi yavaş çözebilir. Complexity theory ise problemin bilinen algoritmalardan bağımsız yapısal zorluğunu inceler.
21.1. Decision ve Optimization Problemini Ayırmak
Optimization problemi:
en küçük maliyetli turu bulşeklinde olabilir.
Bunun decision sürümü:
maliyeti <= K olan bir tur var mı?şeklindedir.
NP-completeness çoğunlukla decision problemleri üzerinden tanımlanır.
Optimization sürümü daha fazla bilgi ister; fakat decision oracle kullanılarak optimal değere ulaşmak bazı problem ailelerinde mümkün olabilir.
21.2. P Sınıfı
P, deterministic modelde input boyutunun polinomu zamanda çözülebilen decision problem sınıfıdır.
Örnek:
- graph connectivity,
- shortest path decision biçimleri,
- minimum spanning tree ile ilişkili karar soruları
polynomial-time algoritmalara sahiptir.
"Polynomial" pratikte her zaman hızlı demek değildir; n^100 teorik olarak polynomial olsa da kullanışsız olabilir.
P sınıfı daha çok ölçek davranışındaki temel ayrımı ifade eder.
21.3. NP Sınıfı
NP, "nondeterministic polynomial time" tarihsel adını taşır; pratik sezgi için verifier tanımı daha yararlıdır.
Bir YES instance için polynomial uzunlukta certificate verilebiliyor ve bu certificate polynomial zamanda doğrulanabiliyorsa problem NP içindedir.
Örneğin Hamiltonian cycle decision probleminde certificate:
düğümlerin önerilen sırasıolabilir.
Verifier:
- her düğüm bir kez mi,
- ardışık düğümler bağlı mı,
- son düğüm ilkine dönüyor mu
kontrollerini polynomial zamanda yapabilir.
Bu:
çözümü kolay buluyoruzdemek değildir.
21.4. P ile NP İlişkisi
Açık olan:
P ⊆ NPçünkü hızlı çözülebilen bir problem hızlı doğrulanabilir.
Bilinmeyen temel soru:
P = NP mi?sorusudur.
Bugün genel olarak P != NP olduğuna inanılır, fakat kanıtlanmış değildir.
Ders notunda:
NP = üstel zamanlı problemlerşeklinde tanım yapılmamalıdır.
NP içinde exponential-time algoritmayla çözülen problemler olabilir; sınıfın tanımı verifier/nondeterministic polynomial-time üzerinden gelir.
21.5. Polynomial-time Reduction
Bir problem A, problem B'ye polynomial zamanda dönüştürülebiliyorsa:
A <=p Byazılabilir.
Anlam:
B'yi çözebilen bir algoritma elimizde olsaydı, A'yı da polynomial ek maliyetle çözebilirdik.
Reduction yönü sık karıştırılır.
A'nın zor olduğunu biliyorsak ve:
A <=p Bgösterebilirsek, B'nin en az A kadar zor olduğuna dair kanıt elde ederiz.
Ters yönde reduction göstermek aynı sonucu vermez.
21.6. NP-hard ve NP-complete
NP-hard:
NP'deki her problem bu probleme polynomial reduce edilebiliranlamında en az NP kadar zor sınıfı ifade eder.
Problem NP içinde olmak zorunda değildir; hatta decision problem olması bile gerekmez.
NP-complete:
NP-hard
+
NP içinde
olan decision problemdir.
Bir problemin NP-complete olduğunu göstermek için tipik desen:
1. problem NP içinde
2. bilinen NP-complete problemden yeni probleme reduction
şeklindedir.
21.7. Reduction Zinciri
Tarihsel olarak SAT temel NP-complete problemdir.
Kavramı öğrenmek için küçük zincirler kullanılabilir:
SAT
-> 3-SAT
-> Vertex Cover
-> başka kombinatoryal problemler
Amaç bütün proof gadget'larını ezberlemek değil, şu mantığı anlamaktır:
source instance
-> polynomial transformation
-> target instance

YES iff YES
21.8. NP-Hard Problemlerde Çözüm Yaklaşımları
"NP-hard" etiketi:
vazgeçanlamına gelmez.
Seçenekler:
small n
-> exact exponential / branch-and-bound

small structural parameter
-> parameterized/FPT yaklaşım

special graph / domain restriction
-> polynomial special-case algorithm

near-optimal acceptable
-> approximation

empirical solution acceptable
-> heuristic / metaheuristic

repeated workload
-> preprocessing / decomposition
olabilir.
Complexity sınıfı çözüm stratejisini yönlendirir; tek çözümü dikte etmez.
21.9. Approximation Algorithm ile Heuristic Farkı
Approximation algorithm polynomial zamanda çalışıp çözüm kalitesi için kanıtlanmış bir bound sunabilir.
Heuristic:
- pratikte iyi olabilir,
- fakat genel worst-case kalite garantisi vermeyebilir.
Bu iki kavram karıştırılmamalıdır.
21.10. Vertex Cover için 2-Approximation
Undirected graph'ta vertex cover, her edge'in en az bir ucunu seçilmiş düğüm kümesine dahil eder.
Basit approximation:
C = empty

while uncovered edge (u,v) var:
    u ve v'yi C'ye ekle
    u veya v'ye incident edge'leri kaldır
Seçilen edge'ler birbirini paylaşmayacak şekilde düşünülebilir ve bir matching oluşturur.
Optimal vertex cover, bu matching'deki her edge için en az bir endpoint almak zorundadır.
Algoritma ise her edge için iki endpoint alır.
Bu nedenle:
|C| <= 2 * |OPT|garantisi elde edilir.
Bu kanıt, approximation ratio'nun yalnız deneysel gözlem değil formal bir özellik olduğunu gösterir.
21.11. Metric TSP ve Triangle İnequality
Genel TSP için güçlü approximation garantisi çok zordur.
Ancak distance fonksiyonu triangle inequality sağlıyorsa metric TSP oluşur.
MST üzerinden:
MST
-> tree edges'i iki kez geç
-> Eulerian walk
-> repeated vertices shortcut
fikri 2-approximation sınırına götürebilir.
Shortcut'ın maliyeti artırmamasını sağlayan şey triangle inequality'dir.
Bu örnek:
Approximation garantisi problem varsayımına bağlıdır.
ilkesini açıkça gösterir.
21.12. Exact, Approximation ve Heuristic'i Aynı Benchmark'ta Ayırmak
Bir deney raporunda:
runtime
objective value
optimality gap
proof / bound
random seed
time limit
ayrı tutulmalıdır.
Heuristic'in küçük testlerde optimumu bulmuş olması approximation guarantee oluşturmaz.
Approximation algorithm'in bound'u da her instance'ta bu kadar kötü sonuç vereceği anlamına gelmez; bound worst-case garantidir.
21.13. Complexity Theory'nin Mühendislik Değeri
P/NP ve reduction teorisi yalnız teorik bilgisayar bilimi değildir.
Gerçek bir projede:
Neden daha fazla CPU ekleyerek bu aramayı çözemiyoruz?
sorusuna bazen cevap:
kod yavaşdeğil:
arama uzayı yapısal olarak zorolabilir.
Bu ayrım; doğru problem kısıtını, approximation seviyesini veya heuristic stratejisini seçmeye yardım eder.
21.14. Hesaplanabilirlik ile Karmaşıklık Arasındaki Sınır
Bir problemin hesaplanabilir olması, pratik olarak verimli çözülebileceği anlamına gelmez. Hesaplanabilirlik bir algoritmanın sonlu adımda doğru cevap üretip üretemeyeceğini; karmaşıklık ise gerekli kaynakların girdi boyutuyla nasıl büyüdüğünü inceler.
Bazı karar problemleri için hiçbir genel algoritma yoktur; durma problemi klasik sınır örneğidir. Buna karşılık NP-complete problemler karar verilebilirdir, ancak bilinen genel tam yöntemlerin en kötü durum maliyeti polinom olmayabilir.
Mühendislikte bu ayrım önemlidir: "algoritma yok", "algoritma var ama pahalı" ve "yaklaşık/heuristic çözüm kullanıyoruz" ifadeleri aynı teknik iddia değildir.
21.15. Kesin Algoritmadan Kontrollü Yaklaşıklığa
Büyük veri algoritmalarında her zaman tam sonuç üretmek ekonomik değildir. Veri yapıları açısından MinHash/LSH yaklaşık benzerlik araması için imza ve bucket yapıları kurar, reservoir sampling bilinmeyen uzunluktaki akıştan O(k) bellekle örnek tutar, sketch yapıları ise tam tablo saklamadan frekans veya kardinaliteyi olasılıksal hata sınırlarıyla tahmin eder. Temel mühendislik ayrımı, yaklaşık sonucun hata olasılığı ve bellek maliyeti biliniyorsa bunun kontrolsüz bir kestirim değil, sözleşmesi tanımlı bir algoritma olmasıdır.
- Benzerlik aramasında tam karşılaştırma ile MinHash/LSH maliyetlerinin karşılaştırılması.
- Veri akışında bellek sınırı altında örnekleme ve frekans tahmini yapılması.
- Yaklaşık algoritmada hata payı, bellek ve zaman karmaşıklığının birlikte raporlanması.
Ünite 22: Online Algoritmalar, Competitive Analysis ve Streaming Veri Yapıları
Klasik algoritma analizinde çoğu zaman bütün input baştan bilinmektedir.
Gerçek sistemlerde ise veri:
zaman içinde gelirve karar:
geleceği görmedenverilmek zorundadır.
Bu, online algorithm problem sınıfını oluşturur.
22.1. Online ve Offline Farkı
Offline algoritma input'un tamamını görebilir.
Online algoritma:
request_1 gelir
-> karar ver

request_2 gelir
-> karar ver

...

gelecek request'ler bilinmez
şeklinde ilerler.
Verilen karar geri alınamayabilir veya geri alma maliyetli olabilir.
Örnek alanlar:
- cache eviction,
- job scheduling,
- network routing,
- resource allocation,
- fiyat/rezervasyon benzeri kararlar.
22.2. Competitive Analysis
Online algoritmanın performansı yalnız rastgele workload ortalamasıyla değil, geleceği bilen ideal offline optimum ile karşılaştırılabilir.
Minimization problemi için kavramsal olarak:
cost_online(sequence)
<=
c * cost_OPT(sequence)
+
constant
eşitsizliği bütün request sequence'leri için sağlanıyorsa algoritma c-competitive olarak tanımlanabilir.
Buradaki OPT:
uygulanabilir gerçek sistemdeğil, geleceği bilen karşılaştırma referansıdır.
Competitive ratio online kararın bilgi eksikliği maliyetini ölçmeye çalışır.
22.3. Ski-rental Problemi
Klasik model:
her kullanım için kirala
veya
bir kez satın al
fakat toplam kaç gün kullanılacağı bilinmiyor.
Kiralama maliyeti 1, satın alma maliyeti B olsun.
Deterministic strateji:
B-1 gün kirala
B. gün satın al
yaklaşımıyla worst-case maliyet offline optimumun yaklaşık iki katıyla sınırlandırılabilir.
Bu örnek online algoritmanın temel problemini gösterir:
Gelecek bilinmediği için erken satın almak da sonsuza kadar kiralamak da risklidir.
22.4. Online Caching
Cache kapasitesi sınırlı ve yeni item için yer gerekiyorsa hangi öğenin çıkarılacağı online karardır.
Offline optimum gelecekte hangi item'in en geç kullanılacağını bilse çok güçlü karar verebilir.
Gerçek algoritma bunu bilemez.
LRU:
en uzun süredir kullanılmayanı çıkargibi geçmişe dayalı heuristic kullanır.
Caching online algorithms için doğal bir örnektir çünkü:
- request stream sürekli gelir,
- memory sınırlıdır,
- yanlış eviction gelecekte miss üretir.
Gerçek CPU cache veya database cache davranışı bu teorik modelden daha karmaşık olabilir; competitive model soyutlama düzeyinde kullanılır.
22.5. Competitive Ratio Tek Kalite Metriği Değildir
Worst-case competitive ratio:
- dağılım bilgisini kullanmayabilir,
- gerçek workload locality'sini yansıtmayabilir,
- constant factor ve implementation cost'u gizleyebilir.
Bu nedenle üretimde:
competitive guarantee
+
trace replay
+
latency
+
hit rate
+
memory
birlikte değerlendirilebilir.
Teori güvenlik sınırı; workload benchmark gerçek davranış ölçümü sağlar.
22.6. Streaming Problem Modeli
Streaming algoritmada veri bir veya az sayıda geçişte işlenir.
Amaç çoğu zaman:
input çok büyük
memory << input
koşulunda anlamlı sonuç üretmektir.
Her öğeyi saklamak yerine:
- summary,
- sketch,
- sample,
- probabilistic membership
tutulur.
Bu noktada exact sonucu bırakıp kontrollü approximation kabul etmek gerekebilir.
22.7. Bloom Filter
Bloom filter bir kümede membership adayını çok az bellekle test eden probabilistic veri yapısıdır.
Yapı:
m bitlik array
k hash function
kullanır.
Insert:
her hash -> ilgili biti 1 yapQuery:
hash edilen bitlerden biri 0
-> kesinlikle yok

hepsi 1
-> muhtemelen var
Standart Bloom filter'da:
false positive olabilir
false negative beklenmez
ancak bu garanti doğru implementasyon ve desteklenen operasyon sözleşmesi altındadır.
Klasik Bloom filter'da key silmek doğrudan güvenli değildir; ortak bit başka elemanlara ait olabilir. Counting Bloom filter gibi varyantlar farklı trade-off sunar.
22.8. False-positive Olasılığı
n öğe eklenmiş olsun.
Yaklaşık false-positive davranışı:
p ≈ (1 - exp(-k*n/m))^kbiçiminde modellenebilir.
Sabit m ve n için uygun hash sayısı kabaca:
k ≈ (m/n) * ln(2)çevresindedir.
Amaç bu formülü ezberlemek değil, şu trade-off'u anlamaktır:
daha çok bit
-> daha düşük false positive

çok az veya çok fazla hash
-> kalite / CPU dengesi bozulabilir
22.9. Bloom Filter Kullanım Alanları
Örnek:
diskte pahalı lookup var
↓
Bloom filter önce sor
↓
"kesinlikle yok"
-> disk lookup yapma

"muhtemelen var"
-> gerçek index'e sor
Burada false positive yalnız gereksiz pahalı lookup üretir; yanlış veri sonucu üretmez.
Bu, probabilistic veri yapısını doğru yerde kullanma ilkesidir.
22.10. Reservoir Sampling
Stream'in toplam uzunluğu baştan bilinmiyor ve:
yalnız k adet uniform samplesaklamak istiyoruz.
Basit reservoir yaklaşımı:
ilk k öğeyi reservoir'a al

t = k+1, k+2, ... için:
    [1..t] aralığından random j seç
    eğer j <= k ise:
        reservoir[j] = current item
Bu algoritma yalnız O(k) memory kullanır.
Her t adımından sonra görülen her öğenin reservoir'da bulunma olasılığı:
k / tolacak biçimde korunabilir.
22.11. Reservoir Sampling Yönteminin İşleyişi
t'inci yeni öğe:
k/tolasılıkla reservoir'a girer.
Daha önceki bir öğe, önce reservoir'da k/(t-1) olasılıkla bulunur.
Yeni öğe geldiğinde silinmeme olasılığı:
1 - (k/t)*(1/k)
=
1 - 1/t
=
(t-1)/t
olur.
Çarpım:
k/(t-1) * (t-1)/t
=
k/t
sonucunu verir.
Böylece bütün görülen öğeler eşit sample olasılığı taşır.
22.12. Sampling ile Approximation Aynı Şey Değildir
Reservoir sample üzerinden hesaplanan istatistik:
tam stream sonucudeğildir.
Sample tasarımı unbiased olabilir; fakat tahmin varyansı ve güven aralığı ayrı problemdir.
Bu nedenle:
sampling algorithm
+
statistical estimator
birbirinden ayrılmalıdır.
22.13. Streaming State'e Sınır Koymak
Bir streaming algoritmanın üretim güvenliği yalnız asymptotic memory ile bitmez.
Kontrol edilmesi gerekenler:
- hash adversarial mı?
- counter overflow olabilir mi?
- merge edilebilir summary gerekiyor mu?
- window bounded mı?
- late/out-of-order data var mı?
- restart sonrası state nasıl korunuyor?
- approximation error nasıl raporlanıyor?
Bu sorular, teorik streaming fikrini üretim veri mühendisliğine bağlar.
22.14. Online ile Streaming Aynı Kavram Değildir
İki alan kesişebilir ama farklıdır.
Online algorithm:
geleceği görmeden kararodaklıdır.
Streaming algorithm:
sınırlı memory ile gelen veriyi işleodaklıdır.
Bir algoritma:
- online ama memory-rich,
- streaming ama karar vermeyen summary,
- hem online hem streaming
olabilir.
22.15. Algoritmik Maliyet Modelini Problemle Eşleştirmek
Klasik RAM modeli:
CPU operation countodaklıdır.
Online model:
future knowledge eksikliğiekler.
Streaming model:
memory bound
+
number of passes
ekler.
External-memory modeli:
block I/Oodaklıdır.
Distributed model:
communication / synchronizationmaliyetini ekleyebilir.
Bu nedenle ileri algoritma mühendisliğinde ilk soru:
Hangi cost model gerçek darboğazı temsil ediyor?
olmalıdır.
Aynı matematiksel problem farklı cost model altında farklı "en iyi" algoritmaya sahip olabilir.
22.16. Birleştirilebilir Akış Özetleri
Akış verisinde her kaydı saklamak yerine özet durum tutmak, bellek sınırını öngörülebilir kılar. Ancak bir özetin farklı sunucularda bağımsız hesaplanıp sonradan doğru biçimde birleştirilebilmesi ayrıca kanıtlanmalıdır. Toplam ve sayaçlar birleşim işlemi açısından kolay örneklerdir; ortalamayı birleştirmek için yalnız ortalamalar değil ilgili örnek sayıları da gereklidir. İki yerel ortalamanın ağırlıksız aritmetik ortalaması, bölüm boyutları farklıysa küresel ortalamayı vermez.
Bazı olasılıksal akış algoritmaları hata olasılığı veya yaklaşım hatası için açık sınırlar sunar. Bloom filtresindeki yanlış-pozitif olasılığı, sayılabilir farklı öğe tahmininin bağıl hatası ve reservoir örneklemesinin örnek seçme olasılığı birbirinden farklı garantilerdir. Aynı uygulamada birden fazla özeti zincirlemek, tek tek hata sınırlarının hiçbir koşul olmadan toplam sistem için geçerli olduğu anlamına gelmez.
Dağıtık akış işleme düzeninde gecikmiş veya yinelenen olaylar varsa özetin güncelleme kuralı en az veri yapısı kadar önemlidir. Yinelenen olaya karşı idempotent olmayan sayaç, olayın iki kez taşınması nedeniyle bozulabilir. Çözüm anahtar temelli tekilleştirme, olay zamanı penceresi veya yeniden işleme sözleşmesine bağlıdır. Bellek kullanımı, pencere gecikmesi ve sonuç doğruluğu ortak bir maliyet modeli içinde değerlendirilmelidir.
22.17. Sınırlı Bellekte Kararlı Top-K ve Bölütlü Birleştirme
Tüm kayıtları sıralamadan en yüksek k sonucu seçmek için boyutu k ile sınırlı bir min-heap tutulabilir. n öğe tarandığında zaman karmaşıklığı O(n log k), ek bellek O(k) olur. Aynı puana sahip öğelerin sonuç sırası tanımsız bırakılırsa çalıştırmalar arası sonuçlar farklılaşabilir. Bunun yerine karşılaştırma anahtarı (puan, zaman, kararlı_kimlik) gibi tam bir sıra ilişkisi oluşturmalıdır; kimlik salt bağlama özgü olsa bile her çalıştırmada aynı veri için aynı sırayı üretmelidir.
Paralel bölütlemede her bölüm yalnız yerel en iyi k öğeyi tutabilir; küresel ilk k için bu yerel listelerin birleşimi yeterlidir, çünkü bir bölümde yerel ilk k dışındaki bir öğe küresel ilk k içine giremez. Bu özellik tek başına genel toplulaştırma fonksiyonlarına taşınamaz: örneğin farklı bölümlerdeki aynı anahtarın toplamı hesaplanıyorsa önceden birleştirme gereklidir. Sıralama deterministik olsa da eksik veri kapsamı sonuçta açıkça belirtilmelidir.
Doğruluk testi, küçük sentetik veri kümelerinde tam sıralama referansıyla karşılaştırma ve tüm giriş permütasyonlarında aynı sonuç kümesini bekleme üzerine kurulmalıdır. Eşit puan, boş veri, k=0, k>n ve bölüt sınırı test edilmelidir.
22.18. Artımlı Grafik Hesaplarında Geçersizleştirme Sınırı
Grafik üzerinde yeni bir kenar eklenmesi, bütün özelliklerin yalnız yerel bölgede değişeceği anlamına gelmez. Düğüm derecesi yerel olarak güncellenebilirken bağlantılı bileşen, köprü, shortest path veya PageRank gibi ölçüler daha geniş grafikte etkilenebilir. Hangi metriğin artımlı güncellenebileceği, yalnız performans beklentisine değil matematiksel etki alanına göre seçilmelidir.
Kayıt ekleme/silme, zaman penceresi değişikliği ve ağırlık güncellemesi ayrı olay türleridir. Her sonuç giriş grafiği sürümü, filtre ölçütü ve hesaplama parametreleriyle bağlanmalıdır. Önbelleğin geçersizleştirilmesi hatalıysa hızlı cevap doğru cevap değildir. Tam yeniden hesaplama ile artımlı yol, rastgele küçük grafiklerde diferansiyel testle karşılaştırılabilir.
Kaynakça
- Bloom, Burton H. “Space/Time Trade-offs in Hash Coding with Allowable Errors.” Communications of the ACM, 13(7), 422–426, 1970. DOI: https://doi.org/10.1145/362686.362692
- Borodin, Allan; El-Yaniv, Ran. Online Computation and Competitive Analysis. Cambridge University Press, 1998. ISBN 978-0-521-56392-5.
- Cormen, Thomas H.; Leiserson, Charles E.; Rivest, Ronald L.; Stein, Clifford. Introduction to Algorithms. 4th ed., MIT Press, 2022. ISBN 9780262046305.
- Hopcroft, John E.; Karp, Richard M. “An n^(5/2) Algorithm for Maximum Matchings in Bipartite Graphs.” SIAM Journal on Computing, 2(4), 225–231, 1973. DOI: https://doi.org/10.1137/0202019
- Jure Leskovec; Anand Rajaraman; Jeffrey D. Ullman. Mining of Massive Datasets.
- Karp, Richard M. “Reducibility Among Combinatorial Problems.” In Complexity of Computer Computations, 85–103, Plenum Press, 1972.
- Knuth, Donald E.; Morris, James H., Jr.; Pratt, Vaughan R. “Fast Pattern Matching in Strings.” SIAM Journal on Computing, 6(2), 323–350, 1977. DOI: https://doi.org/10.1137/0206024
- Mark Allen Weiss. Data Structures and Algorithm Analysis in C++. Pearson, 2012.
- Robert Sedgewick; Kevin Wayne. Algorithms. Addison-Wesley, 2011.
- Saul B. Needleman; Christian D. Wunsch. “A General Method Applicable to the Search for Similarities in the Amino Acid Sequence of Two Proteins.” Journal of Molecular Biology, 48(3), 443–453, 1970. DOI: https://doi.org/10.1016/0022-2836(70)90057-4
- Temple F. Smith; Michael S. Waterman. “Identification of Common Molecular Subsequences.” Journal of Molecular Biology, 147(1), 195–197, 1981. DOI: https://doi.org/10.1016/0022-2836(81)90087-5
- Stuart Russell, P. N. Artificial Intelligence: A Modern Approach, 4th ed. Pearson, 2021.
- Tarjan, Robert E. “Amortized Computational Complexity.” SIAM Journal on Algebraic Discrete Methods, 6(2), 306–318, 1985. DOI: https://doi.org/10.1137/0606031
- Tarjan, Robert E. “Depth-First Search and Linear Graph Algorithms.” SIAM Journal on Computing, 1(2), 146–160, 1972. DOI: https://doi.org/10.1137/0201010
- Thomas H. Cormen; Charles E. Leiserson; Ronald L. Rivest; Clifford Stein. Introduction to Algorithms. MIT Press, 2009.
- Vitter, Jeffrey S. “Random Sampling with a Reservoir.” ACM Transactions on Mathematical Software, 11(1), 37–57, 1985. DOI: https://doi.org/10.1145/3147.3165
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.