


Yapay Sinir Ağları ve Öğrenme Modelleri


Yapay sinir ağlarının tarihsel temelleri, nöron modelleri, perceptron ve MLP; geri yayılım, Gauss–Newton, LM ve RLS ile eğitim; LVQ, ART, RNN, CNN, Transformer, üretken modeller, graf ve tensör ağları; sistem tanıma, sıkıştırma ve bilimsel değerlendirme.
Yapay sinir ağları, biyolojik sinir sistemlerinden esinlenen ancak biyolojik beynin birebir kopyası olmayan hesaplama modelleridir. Bir ağ; girdileri sayısal temsillere dönüştüren işlem elemanlarını, bu elemanlar arasındaki ağırlıklı bağlantıları ve ağırlıkları veriden ayarlayan öğrenme yöntemlerini birlikte kullanır. Bu çerçevede “nöron” benzetmesi açıklayıcıdır; gerçek sinir hücresinin bütün biyofiziksel davranışını modele taşıdığı varsayılmamalıdır.
Örüntü tanıma, sınıflandırma, kestirim ve temsil öğrenme gibi işlerde ağın gücü, her problem için elle yazılmış kurallar üretmek yerine parametrelerini örneklerden uyarlayabilmesinden gelir. Bu özellik klasik sayısal yöntemleri geçersiz kılmaz. Diferansiyel denklem, optimizasyon, olasılık modeli veya kural tabanlı yöntem daha uygun olduğunda sinir ağı yardımcı bileşen olarak kalabilir; veri ve problem yapısı uygunsa ise temel çözümleyici hâline gelebilir.
Bilgisayarlar belirli hesaplarda insanı hız ve tekrarlanabilirlik açısından aşabilir; insan öğrenmesi ise algı, deneyim, nedensellik ve bağlamı çok daha geniş bir çerçevede birleştirir. Yapay sinir ağlarının amacı bu biyolojik yeteneği eksiksiz kopyalamak değil, veriden yararlı dönüşümler ve karar sınırları öğrenebilen matematiksel sistemler kurmaktır.
Ünite 1: Tarihsel Gelişim ve Yapay Sinir Ağlarının Hesaplama Temeli
1.1. Tarihçe ve Gelecek
1.1.1. Tarihçe
Yapay sinir ağlarının tarihini tek bir “icat” tarihine indirgemek yanıltıcıdır. Alan; matematiksel nöron modelleri, örüntü tanıma, ilişkisel bellek, optimizasyon, geri beslemeli sistemler ve daha sonra yüksek başarım hesaplama çizgilerinin birbirini beslemesiyle gelişti. Doğrusal ilişkilendirici, korelasyon matris belleği, ART, SOM, Hopfield, Boltzmann, RBF, PNN ve GRNN gibi model aileleri, bugün daha iyi doğrulanabilen kilometre taşlarıyla birlikte tarihsel bağlamda değerlendirilmelidir.
- 1943: Warren McCulloch ve Walter Pitts, basitleştirilmiş sinir hücrelerini mantıksal hesaplama birimleri olarak ele alan matematiksel modeli yayımladı.
- 1958: Frank Rosenblatt, perceptron modelini ve öğrenme yaklaşımını ayrıntılı biçimde tanımladı. Bu çizgi, örneklerden ağırlık ayarlayan sınıflandırıcıların erken ve etkili örneklerinden biri oldu.
- 1960'ların sonu ve 1970'ler: Doğrusal ilişkilendiriciler, korelasyon matris bellekleri ve ilişkisel bellek yaklaşımları üzerinde yoğun çalışmalar yapıldı. Tek katmanlı perceptronların temsil sınırlarının tartışılması, çok katmanlı modellerde etkin öğrenme yöntemlerine duyulan gereksinimi görünür hâle getirdi. Aynı dönemde uyarlanabilir rezonans kuramı (ART) çizgisi de kararlı örüntü öğrenmesi ve sınıflandırma için ayrı bir araştırma yönü oluşturdu.
- 1974: Paul Werbos'un doktora çalışması, türev bilgisinin çok katmanlı yapılarda geriye doğru taşınmasına dayanan yaklaşımın sinir ağı eğitimi bağlamındaki erken sistematik anlatımlarından birini içerdi.
- 1982: John Hopfield, geri beslemeli ağların enerji benzeri bir fonksiyon üzerinden ilişkisel bellek olarak incelenebileceğini gösteren çalışmasını yayımladı. Aynı yıl Teuvo Kohonen'in kendiliğinden örgütlenen haritaları (SOM), danışmansız topolojik temsil öğrenmesinin önemli modellerinden biri hâline geldi.
- 1985: David Ackley, Geoffrey Hinton ve Terrence Sejnowski, Boltzmann makineleri için öğrenme algoritmasını yayımladı. Stokastik ve enerji tabanlı ağlar daha sonra kısıtlı Boltzmann makineleri ve derin inanç ağları gibi çizgilere zemin hazırladı.
- 1986: David Rumelhart, Geoffrey Hinton ve Ronald Williams, geri yayılımı çok katmanlı ağlarda gizli temsillerin öğrenilmesi açısından güçlü ve yeniden üretilebilir bir yöntem olarak yaygınlaştırdı.
- 1980'lerin sonu ve 1990'ların başı: Radyal taban fonksiyonlu ağlar (RBF), olasılıksal sinir ağları (PNN) ve genel regresyon sinir ağları (GRNN) gibi daha özel model aileleri sınıflandırma, kestirim ve fonksiyon yaklaşımı için kullanıldı.
- 1997: Sepp Hochreiter ve Jürgen Schmidhuber, uzun süreli bağımlılıklarda zayıflayan hata akışını hedefleyen Long Short-Term Memory (LSTM) mimarisini yayımladı.
- 1998: Yann LeCun ve çalışma arkadaşları, konvolüsyonel sinir ağlarını gerçek belge ve el yazısı tanıma sistemleri bağlamında ayrıntılı biçimde ortaya koydu; ağırlık paylaşımı ve yerel alıcı alanların görüntü verisindeki yapısal avantajını somutlaştırdı.
- 2012: Alex Krizhevsky, Ilya Sutskever ve Geoffrey Hinton'ın ImageNet üzerinde GPU ile eğittiği derin konvolüsyonel ağ, büyük veri kümeleri, hızlandırıcı donanım ve derin ağların birlikte ölçeklenmesinin etkisini belirginleştirdi.
- 2017: Transformer mimarisi, dizi modellemede yineleme ve konvolüsyon zorunlu olmadan öz-dikkat mekanizmasının kullanılabileceğini gösterdi. Böylece sinir ağı araştırmasının önemli bir bölümü, yalnız nöron bağlantı topolojisinden değil dikkat, temsil ve paralel hesaplama düzeninden de türeyen mimarilere kaydı.
1.1.2. Gelecek
Sinir ağlarının geleceği yalnız “daha büyük model” üretmekten ibaret değildir. Aynı doğruluğu daha düşük gecikme, daha az enerji, daha az bellek ve daha öngörülebilir çalışma süresiyle elde etmek; kritik ve gerçek zamanlı sistemlerde model büyüklüğünden daha önemli olabilir. Bu nedenle düşük duyarlıklı sayı biçimleri, seyrek hesaplama, bellek erişiminin azaltılması, derleyici düzeyi iyileştirmeler ve donanım-yazılım ortak tasarımı araştırmanın kalıcı konuları arasındadır.
GPU ve benzeri hızlandırıcılar bugün olağan hâle gelmiş olsa da FPGA ve ASIC tabanlı gerçeklemeler, belirli ağların veri akışını sabit donanım yollarına taşıyarak gecikme ve enerji açısından farklı bir tasarım noktası sunar. NPU türü özel hızlandırıcılar da aynı eğilimin ürünüdür. Optik hesaplama, analog bellek-içi hesaplama ve nöromorfik devreler ise belirli işlem sınıflarında veri hareketi maliyetini azaltmayı hedefleyen daha araştırma ağırlıklı yönlerdir; bunların genel amaçlı GPU'ların doğrudan yerine geçtiğini varsaymak doğru değildir.
1.2. Model Aileleri ve Öğrenme Algoritmaları
Perceptron, Multilayer Perceptron (MLP), backpropagation, Learning Vector Quantization (LVQ), Adaptive Resonance Theory (ART), recurrent/Elman yapıları, CNN, LSTM/GRU, attention, Transformer, Üretken modeller, düzenlileştirme, optimizasyon, ablasyon, veri kayması ve üretim gözlemi ileri model aileleriyle birlikte değerlendirilir.
1.3. Tarihsel Sıralamayı Yöntem ile Ayırmak
Yapay sinir ağlarının gelişiminde tarihsel öncelik ile güncel kullanım sıklığı aynı şey değildir. McCulloch–Pitts (1943) eşik mantığına dayalı bir hesaplama modeli önerdi; Hebb (1949) ortak etkinlikle ilişkili bağlantı değişimini tartıştı. Rosenblatt'ın perceptronu (1958) öğrenilebilir doğrusal karar sınırını öne çıkardı. Widrow–Hoff LMS kuralı ve ADALINE (1960) karesel hata minimizasyonunu öne çıkardı. Minsky ve Papert'in (1969) tek katmanlı perceptronlara ilişkin sınırlılık analizi, çok katmanlı ağların bütünüyle imkânsız olduğunu göstermedi. Hopfield'ın enerji tabanlı ağları (1982), çok katmanlı ağlarda geri yayılımın yaygınlaşması (1986), evrişimli ağların belge tanımada olgunlaşması (1990'lar), uzun-kısa süreli bellek (1997), derin temsil öğrenmesindeki ilerleme (2000'ler), Transformer (2017) ve sonraki ölçekleme çalışmaları farklı hesaplama gereksinimlerinin ürünüdür.
Bu çizgi, birbirinin yerine geçen tek bir mimariyi değil, farklı veri yapıları için geliştirilen model ailelerini anlatır. Örneğin prototip tabanlı LVQ ve ART sistemleri sınırlı bellek veya açıklanabilir kümeleme gereksinimlerinde öğretici olabilir; bunları evrişimli ya da attention tabanlı ağların doğrudan öncülü veya eşdeğeri olarak ele almak yanıltıcıdır. Her yöntemde temsil biçimi, eğitim amacı, çıkarım maliyeti ve doğrulama problemi ayrı incelenmelidir.
Ünite 2: Biyolojik Esin ve Yapay Nöronun Matematiksel Modeli
2.1. Biyolojik Nöronlar
Sinir ağı terminolojisinin önemli bölümü nörobilimden gelir. Bu benzetmeyi doğru sınırda kullanmak gerekir: dendrit, soma, akson ve sinaps biyolojik hücrenin yapılarıdır; yapay ağdaki girdi, ağırlık, toplama ve etkinlik işlemleri bunların kaba işlevsel karşılıkları olarak düşünülür.
2.1.1. Dendrit
- Dendritler, başka hücrelerden gelen elektrokimyasal sinyallerin alınmasında temel rol oynayan dallanmış yapılardır.
- Yapay nöron benzetmesinde farklı giriş kanallarının aynı işlem elemanında toplanmasına karşılık gelirler.
2.1.2. Akson
- Akson, hücrenin ürettiği elektriksel etkinliğin diğer hücrelere taşındığı uzun iletim yoludur.
- Yapay modelde tek bir işlem elemanının hesapladığı çıktının birden fazla sonraki birime dağıtılabilmesi bu işlevle benzeştirilir.
2.1.3. Bağlantılar
- Biyolojik nöronlar birbirlerine doğrudan tek tip kablolarla değil, farklı kuvvetlere ve dinamiklere sahip bağlantılar üzerinden etki eder.
- Yapay ağlarda bu etki çoğunlukla ağırlık katsayılarıyla temsil edilir. Bir bağlantının modele katkısı, ağırlığın işareti ve büyüklüğü kadar kullanılan etkinlik fonksiyonuna ve ağın geri kalanına da bağlıdır.
2.1.4. Soma
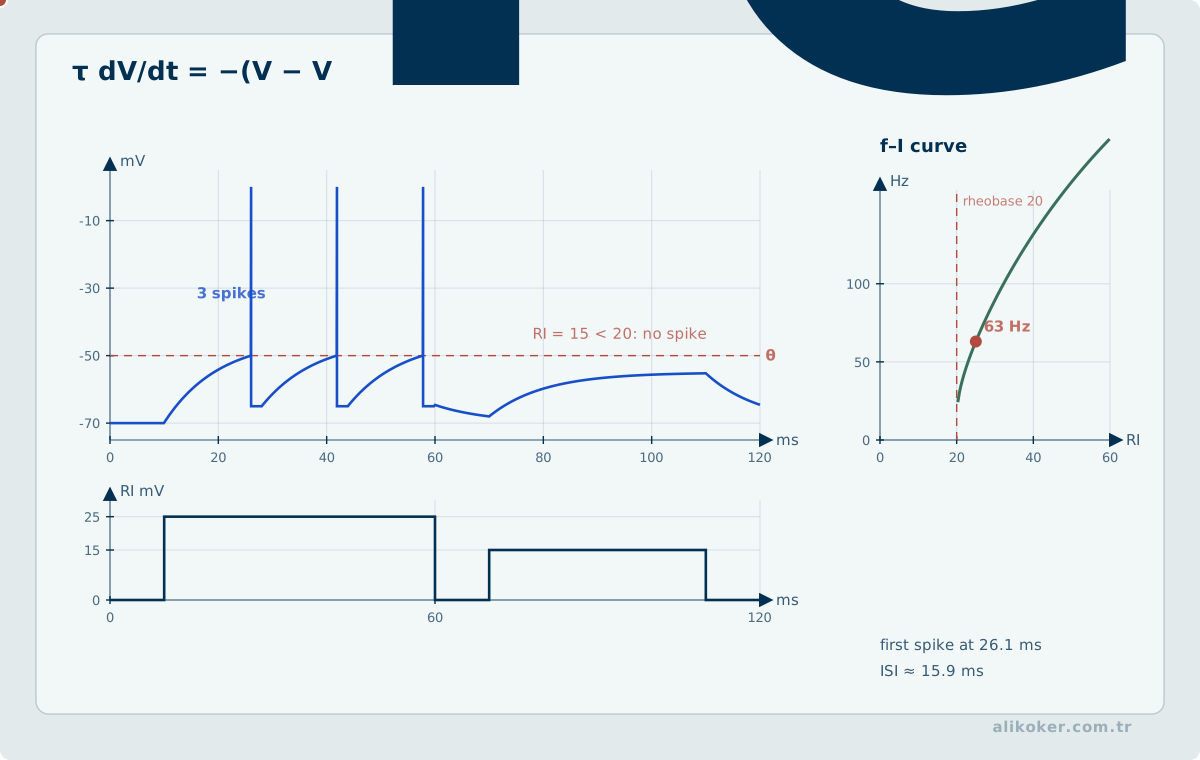
- Soma ya da hücre gövdesi, nöronun metabolik merkezidir ve gelen etkilerin bütünleşmesinde rol oynar.
- Basitleştirilmiş yapay nöron çizimlerinde ağırlıklı girdilerin toplandığı hesaplama bölgesine benzetilir; biyolojik çekirdekle matematiksel toplama işlemini özdeş kabul etmek doğru değildir.
2.1.5. Sinaps
- Sinaps, bir nöronun başka bir hücre üzerindeki etkisini ilettiği bağlantı bölgesidir.
- Öğrenme benzetmesinin en yararlı tarafı burada ortaya çıkar: biyolojik bağlantı kuvvetlerinin değişebilmesi, yapay ağlarda ağırlıkların eğitim sırasında güncellenmesine kavramsal esin sağlamıştır.
2.2. Temel Bileşenler
Yapay nöron, biyolojik hücreden alınmış bir adlandırmaya sahip olsa da özünde parametrik bir hesaplama birimidir. En yaygın gösterimde giriş vektörü ağırlıklarla çarpılır, sonuçlar bir bias veya eşik terimiyle birleştirilir ve doğrusal olmayan bir etkinlik fonksiyonundan geçirilir. Çok sayıda birim katmanlar hâlinde bağlandığında ağın temsil kapasitesi oluşur.
Temel öğeler beşli bir ayrımla açıklanabilir: girdi, ağırlık, toplama fonksiyonu, etkinlik fonksiyonu ve çıktı. Ölçeklendirme ve sınırlandırma ise mimariye göre etkinlikten sonra eklenen dönüşümlerdir.
2.2.1. Girdiler
- Girdiler, ağın işlediği sayısal özelliklerdir. Ham verinin kendisi olabileceği gibi ses çerçevesi, piksel değeri, gömme vektörü veya önceden çıkarılmış bir ölçüt de olabilir.
- Girdinin ölçeği ve dağılımı eğitimi etkilediğinden normalizasyon veya standartlaştırma gerekebilir.
2.2.2. Ağırlıklar
- Her bağlantının modele etkisi bir ağırlık katsayısıyla temsil edilir.
- Büyük mutlak değer, tek başına “önem” anlamına gelmez; giriş ölçeği, sonraki katmanlar ve doğrusal olmayanlıklarla birlikte yorumlanmalıdır.
- Eğitim sırasında optimizasyon algoritması bu katsayıları kayıp fonksiyonunu azaltacak yönde günceller.
2.2.3. Toplama Fonksiyonu
- Klasik yapay nöronda temel işlem
z = Σ(w_i x_i) + bbiçimindeki ağırlıklı toplamdır. - Tarihsel ve özel ağ modellerinde minimum, maksimum, çoğunluk, uzaklık veya normalizasyon tabanlı farklı birleştirme kuralları da kullanılabilir.
2.2.4. Etkinlik Fonksiyonu
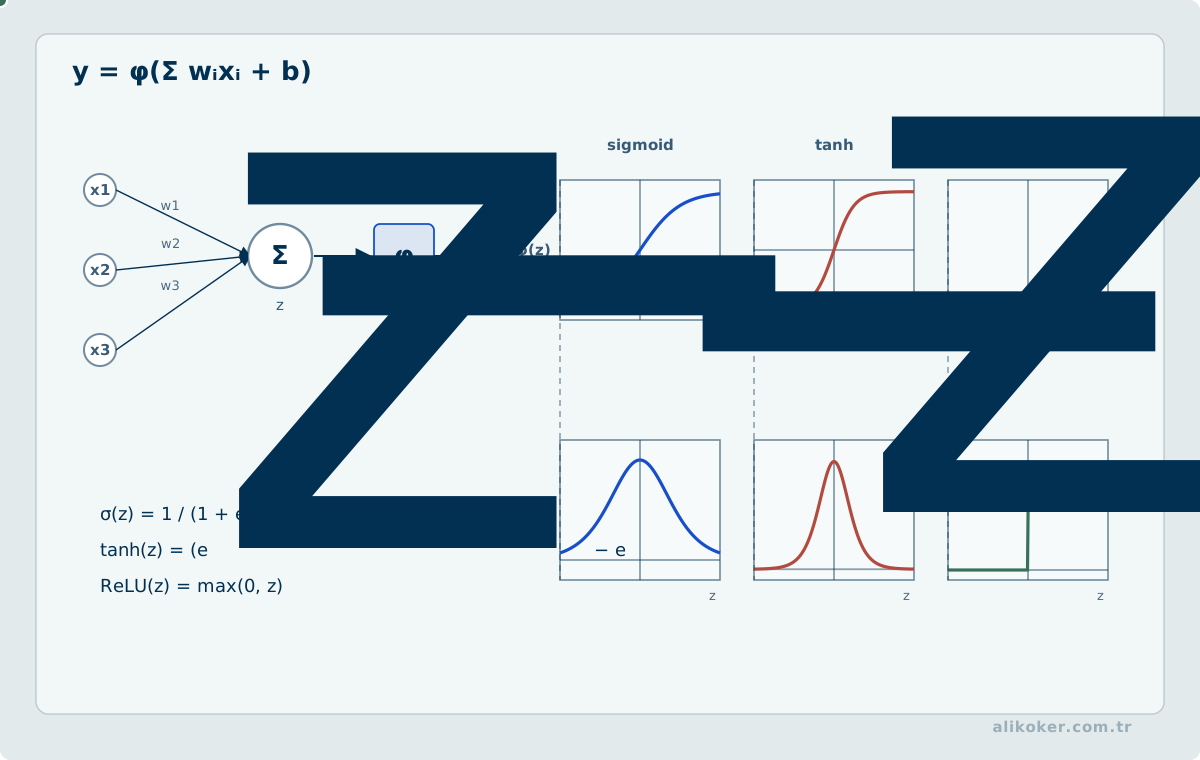
- Etkinlik fonksiyonu, toplama sonucunu nöron çıktısına dönüştürür ve ağa doğrusal olmayan temsil gücü kazandırır.
- Sigmoid, tanh, ReLU ve türevleri farklı dönemlerde ve farklı mimarilerde yaygınlaşmıştır.
Tarihsel modellerde eşik, sigmoid ve hiperbolik tanjant yaygındır.
Sigmoid:
sigmoid(z) = 1 / (1 + exp(-z))
Hiperbolik tanjant:
tanh(z)
Modern derin ağlarda gizli katmanlarda ReLU ve türevleri yaygındır:
ReLU(z) = max(0, z)
Çok sınıflı sınıflandırmanın çıktı katmanında softmax kullanılabilir:
softmax(z_i) = exp(z_i) / sum_j exp(z_j)
Aktivasyon seçimi ağın gradyan akışını ve optimizasyon davranışını etkiler.
2.2.5. Ölçeklendirme ve Sınırlandırma
- Bazı sistemlerde etkinlik çıktısı belirli bir fiziksel veya sayısal aralığa taşınır.
- Ölçeklendirme bir katsayıyla çarpma kadar basit olabilir; sınırlandırma ise değerin tanımlı alt ve üst limitleri aşmasını engelleyebilir.
2.2.6. Çıkış Fonksiyonu
- Bir işlem elemanının ürettiği değer sonraki katmandaki birden fazla birime veya doğrudan model çıktısına bağlanabilir.
- Son katmanın yapısı göreve bağlıdır: regresyonda sürekli değer, ikili sınıflandırmada olasılık benzeri skor, çok sınıflı yapıda ise birden fazla logit veya olasılık üretilebilir.
2.2.7. Katman Yapısı
Klasik ileri beslemeli ağ üç işlevsel katman türüyle açıklanabilir.
Girdi katmanı: Girdi özelliklerini modele sunar.
Gizli katmanlar: Ara temsilleri oluşturur.
Çıktı katmanı: Göreve uygun nihai çıktıyı üretir.
Bir ağda gizli katman sayısı ve her katmanın genişliği model kapasitesini etkiler.
2.2.8. Bağlantı Yönüne Göre Ağ Yapısı
İleri beslemeli ağlarda bilgi girişten çıkışa doğru ilerler ve ağın bağlantı grafında zaman içinde geri dönen kapalı bir durum yolu bulunmaz. Bu yapı sabit boyutlu girdi-çıktı eşlemeleri için temel modeldir.
Geri dönüşümlü ağlarda önceki durum sonraki hesaplamayı etkileyebilir. Bu geri besleme, ağın zamansal veya ardışık bilgiyi iç durumda taşımasına olanak verir. Elman ağı bağlam birimleriyle, Hopfield ağı ise geri dönüşümlü bağlantılar ve kararlı durumlarla bu yaklaşımın klasik örnekleridir.
Bağlantı yönü ile öğrenme yöntemi aynı sınıflandırma değildir. İleri beslemeli bir ağ farklı kayıp ve optimizasyon yöntemleriyle eğitilebilir; geri dönüşümlü yapı ise ağın hesap grafına durum bağı ekler. Elman, Hopfield, LSTM ve GRU gibi modellerin mimari özellikleri, geri dönüşümlü ağlar ve daha sonraki öğrenme modelleri kapsamında ayrıntılandırılır.
2.3. Matematiksel Nöron, Boyut Denetimi ve Öğrenilebilir Parametre
Bir katmanın hesaplaması z = Wx + b, a = f(z) ile verilebilir. x ∈ R^d, W ∈ R^(m×d), b ∈ R^m ise z ve a vektörleri m boyutludur. Tek katmanda (m*d + m) öğrenilebilir ağırlık ve sapma parametresi bulunur. Bu sayı, aktivasyonun doğrusal olup olmamasından bağımsızdır. İki doğrusal katman arasına doğrusal olmayanlık konulmadığında bileşik dönüşüm tek bir afin katmana indirgenebilir; bu nedenle derinlik tek başına ifade gücü sağlamaz.
Sigmoidin türevi σ(z)(1-σ(z)), tanh türevi 1-tanh²(z) biçimindedir. Büyük mutlak girişlerde bu türevlerin küçülmesi, ardışık çarpımlar aracılığıyla gradyanın zayıflamasına yol açabilir. ReLU ise pozitif bölgede türevi bir olsa da negatif bölgede sıfırdır; bu da etkin olmayan birim riskini doğurur. Model seçiminde yalnızca aktivasyon adı değil, başlangıç dağılımı, normalizasyon, sayısal aralık ve hedef kaybın özellikleri belirleyicidir.
Ünite 3: Öğrenme Türleri, Veri ve Temsil
Bir öğrenme problemini sinir ağına dönüştürmeden önce tahmin hedefi ve hata maliyeti belirlenmelidir. Veri kaynakları, etiketleme yöntemi ve eğitim ile değerlendirme kümelerinin ayrılması denetlenir. Ardından basit bir referans yöntem kurulur; daha karmaşık modelin kazanımı aynı test koşullarında ölçülür. Başarı yalnız ortalama doğrulukla değil, hata türleri, dağılım değişimi ve açıklama gereksinimiyle değerlendirilir. Modelin ezberleme olasılığını dışlamayan bir deney, öğrenme başarısına ilişkin yeterli kanıt oluşturmaz.
3.1. Öğrenme
Bir ağın eğitilmesi, örneklerden elde edilen hata sinyaline veya başka bir öğrenme amacına (öğrenme amacı) göre parametrelerinin güncellenmesidir. Eğitim başarısı ile genelleme aynı şey değildir; modelin daha önce görmediği verideki davranışı ayrıca değerlendirilmelidir.
3.1.1. Eğitim, Doğrulama ve Test
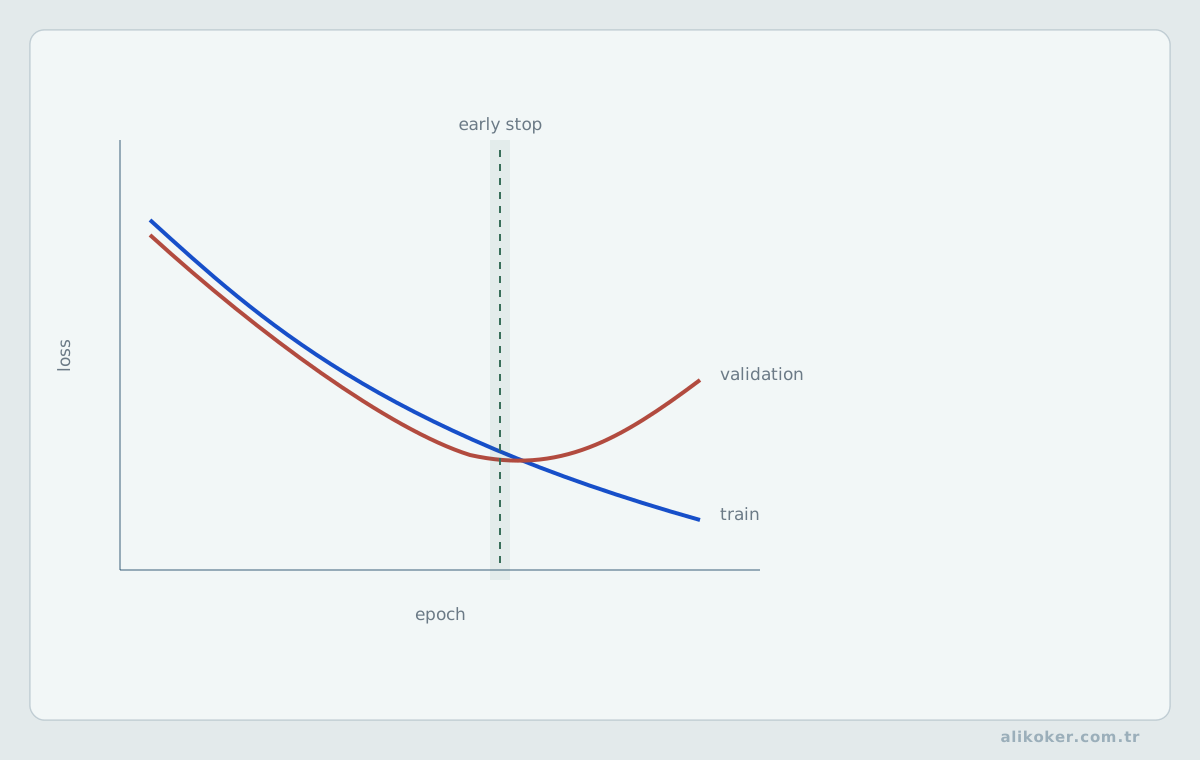
Bir ağın eğitim verisinde düşük hata üretmesi tek başına yeterli değildir. Amaç görülmemiş veride başarılı olmaktır.
Veri çoğunlukla üç bölüme ayrılır:
Eğitim kümesi: Parametrelerin öğrenilmesinde kullanılır.
Doğrulama kümesi: Mimari, öğrenme katsayısı, düzenlileştirme gibi hiperparametrelerin seçiminde kullanılır.
Test kümesi: Son modelin tarafsız biçimde değerlendirilmesinde kullanılır.
Küçük veri kümelerinde çapraz doğrulama da kullanılabilir.
Sabit bir “doğru yüzde” yoktur. Ayrım; örnek sayısı, sınıf dengesi, zaman bağımlılığı ve veri sızıntısı (data leakage) riski gözetilerek yapılmalıdır. Özellikle aynı kişiye, cihaza veya olaya ait çok benzer kayıtların farklı kümelere dağılması ölçülen başarımı yapay biçimde yükseltebilir.
3.1.2. Öğrenme Süreci
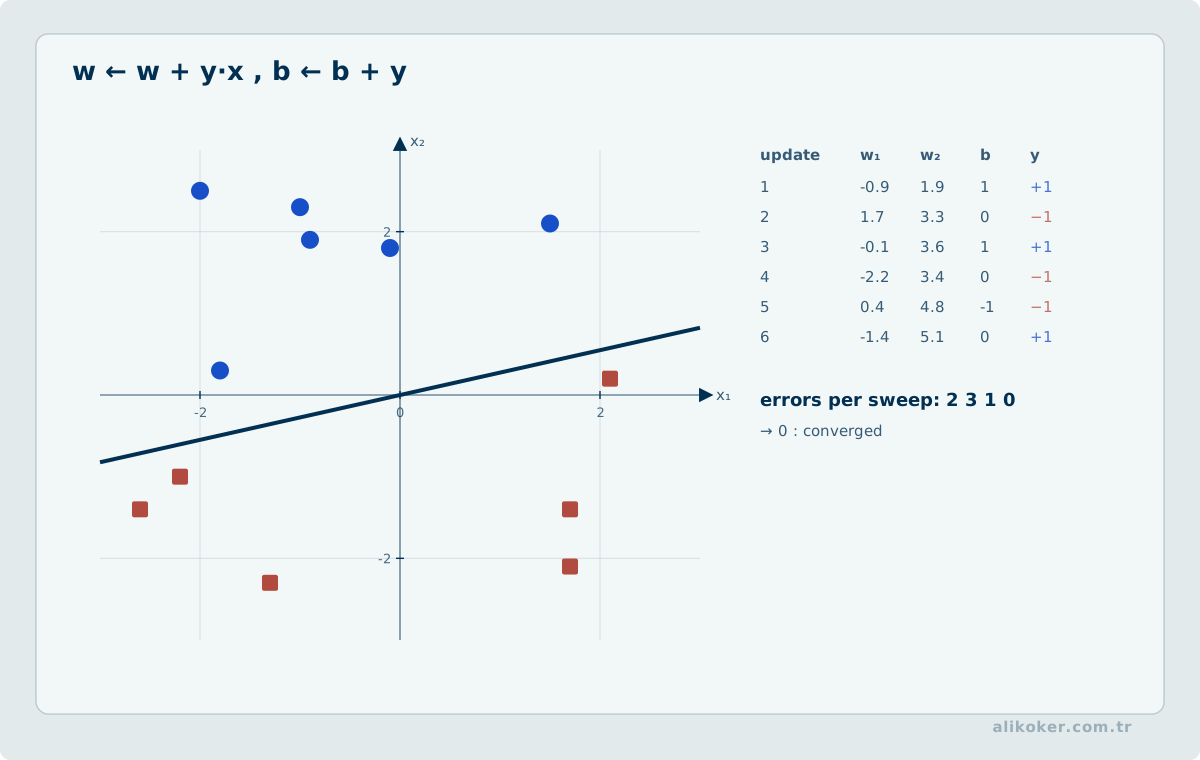
- Problemi temsil eden örnekler ve hedef ölçütü tanımlanır.
- Girdilerin temsili, ağ topolojisi, toplama işlemleri ve etkinlik fonksiyonları seçilir.
- Ağırlıklar ve bias/eşik terimleri uygun bir başlangıç yöntemiyle atanır.
- Eğitim örnekleri tek tek veya mini-batch hâlinde ağa verilir.
- İleri yayılım ile model çıktısı hesaplanır.
- Çıktı, hedef veya öğrenme ölçütüyle karşılaştırılarak kayıp değeri elde edilir.
- Türevlenebilir modellerde geri yayılım, kaybın parametrelere göre gradyanını hesaplar.
- Optimizasyon adımı ağırlıkları günceller; süreç durdurma ölçütüne veya eğitim bütçesine kadar tekrarlanır.
3.1.3. Gözetimli Öğrenme
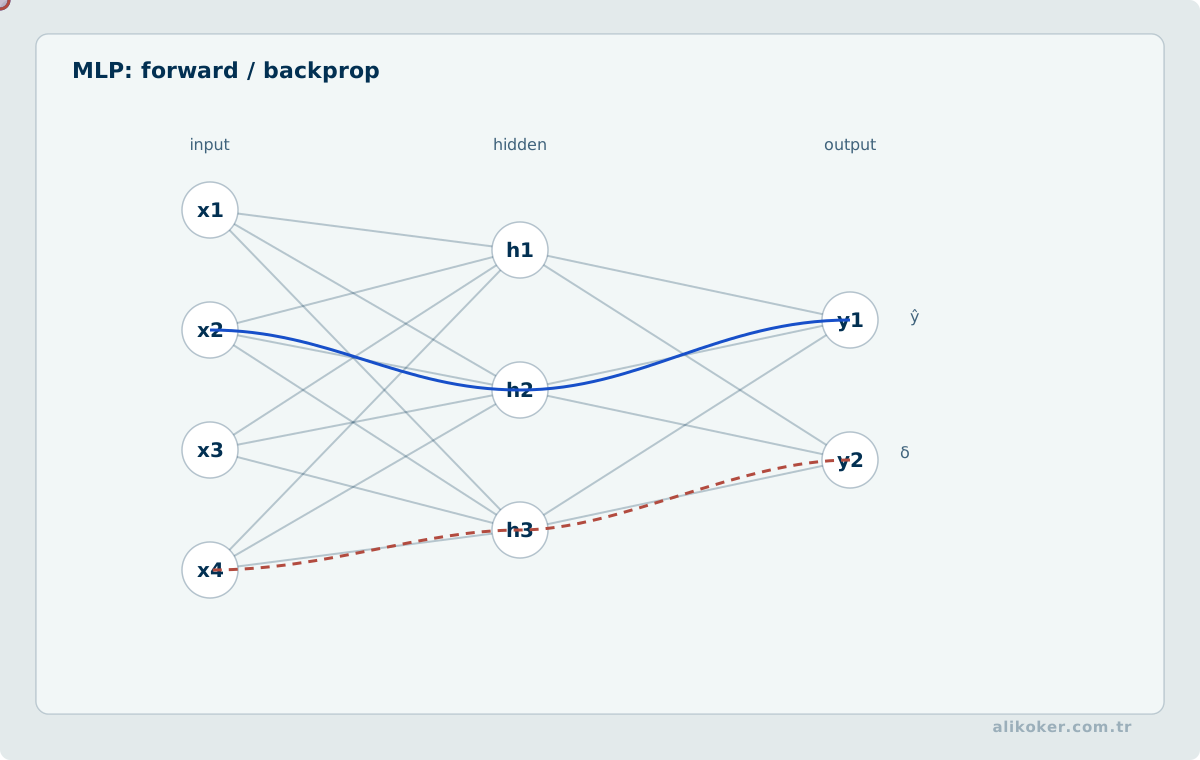
- Danışmanlı öğrenmede her eğitim girdisiyle birlikte beklenen çıktı, sınıf etiketi veya hedef değer bulunur.
- Model tahmini ile hedef arasındaki fark bir kayıp fonksiyonuyla ölçülür ve parametreler bu hatayı azaltacak yönde güncellenir.
- Sınıflandırma ve regresyon bu yaklaşımın yaygın kullanım alanlarıdır.
3.1.4. Gözetimsiz Öğrenme
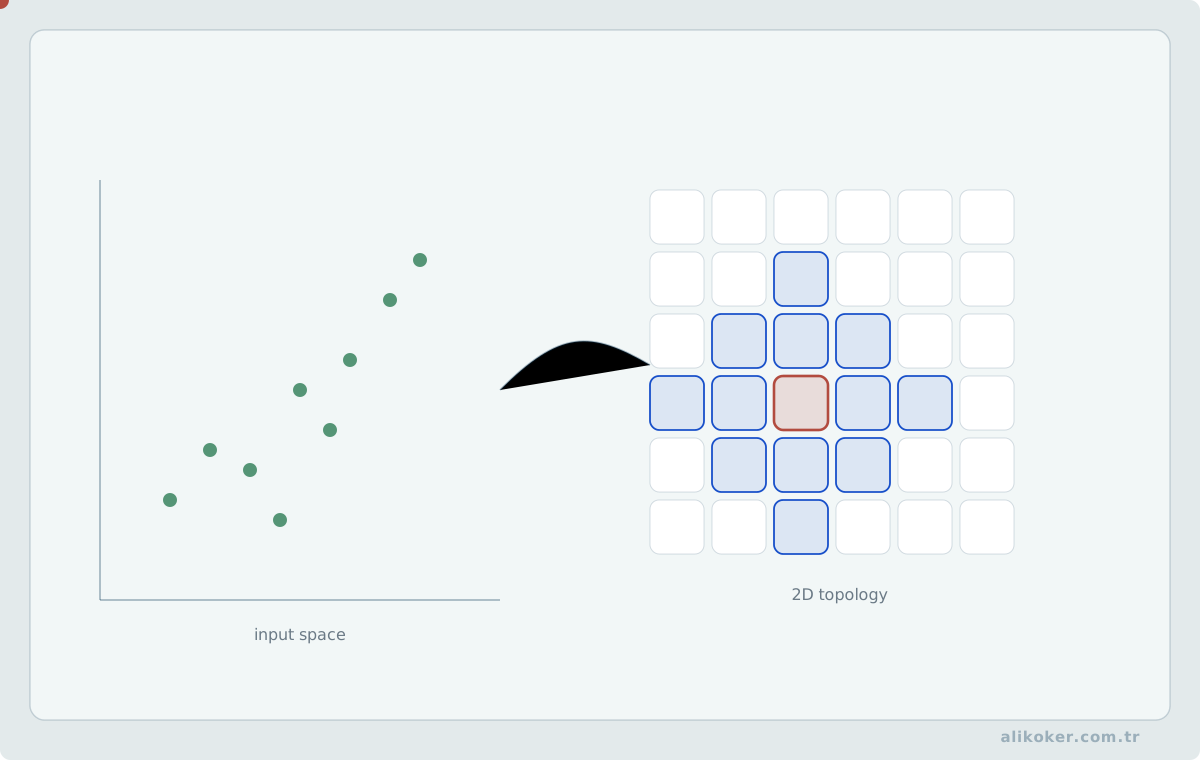
- Danışmansız öğrenmede doğrudan hedef etiketi verilmez; model yalnız girdilerin dağılımından veya aralarındaki ilişkilerden yapı çıkarmaya çalışır.
- Kümeleme, yoğunluk modelleme ve bazı temsil öğrenme yöntemleri bu grupta değerlendirilebilir.
3.1.5. Pekiştirmeli Öğrenme
- Takviyeli öğrenmede model, her adım için tam doğru cevabı almak yerine çevreyle etkileşiminden ödül veya ceza sinyali elde eder.
- Amaç tek tek kararları değil, zaman içinde biriken beklenen getiriyi iyileştiren bir politika öğrenmektir.
- Bu nedenle geri bildirim gecikmeli olabilir ve keşif–sömürü dengesi öğrenmenin ayrı bir parçasıdır.
3.1.6. Kendinden Öğretimli ve Yarı Gözetimli Öğrenme
Self-supervised learning: Supervision sinyali verinin kendisinden türetilir; büyük ölçekli representation learning için temel yaklaşımlardan biridir.
Semi-supervised learning: Az miktarda labeled data ile daha büyük miktarda unlabeled data birlikte kullanılır.
3.1.7. Hetero-association ve Auto-association
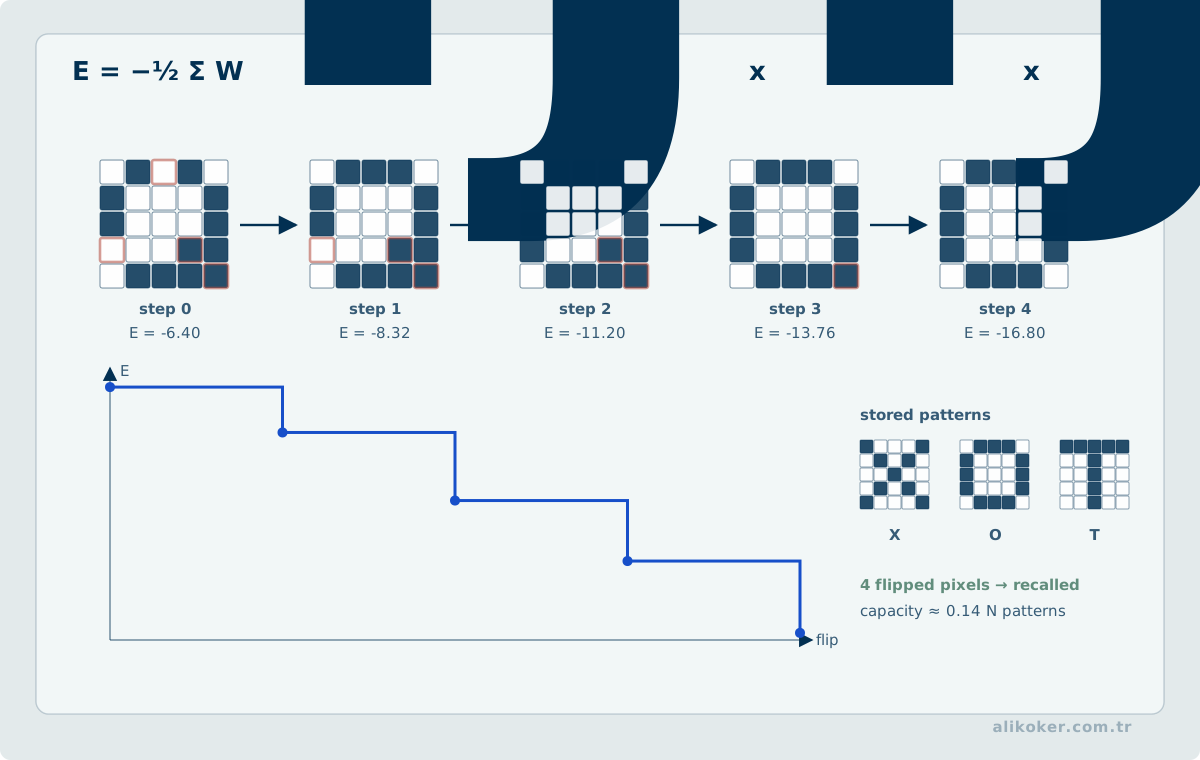
İlişkilendirmeli öğrenmede iki temel durum vardır.
Hetero-association, bir girdi örüntüsünü farklı bir çıktı örüntüsüyle ilişkilendirir. Sınıflandırma ve regresyon bunun doğal örnekleridir.
Auto-association, girdiyi yine kendisiyle ilişkilendirir. Amaç eksik veya gürültülü girdiden özgün örüntüyü yeniden üretmek olabilir. Hopfield ağları ve autoencoder yaklaşımı bu düşünceyle ilişkilidir.
3.1.8. Öğrenme Kuralları
Öğrenme kuralı, model parametrelerinin nasıl değiştirileceğini belirler. Tarihsel sinir ağı çalışmalarında Hebb kuralı önemli bir başlangıç noktasıdır.
Hebb yaklaşımının yalın biçimi şudur:
Delta w_ij = eta * x_i * y_j
Burada eta öğrenme katsayısıdır. Birlikte etkinleşen iki birim arasındaki bağlantı güçlenir.
Modern öğretmenli derin ağlarda ağırlıklar çoğunlukla kayıp fonksiyonunun gradyanına göre değiştirilir:
w <- w - eta * dL/dw
Bu ifade gradyan inişinin temelidir. İleri optimizasyon yöntemlerinin öğrenme dinamiklerine etkisi, parametre güncellemeleri ve yakınsama davranışı üzerinden incelenir.
3.1.9. Uyarlama ve Genelleme
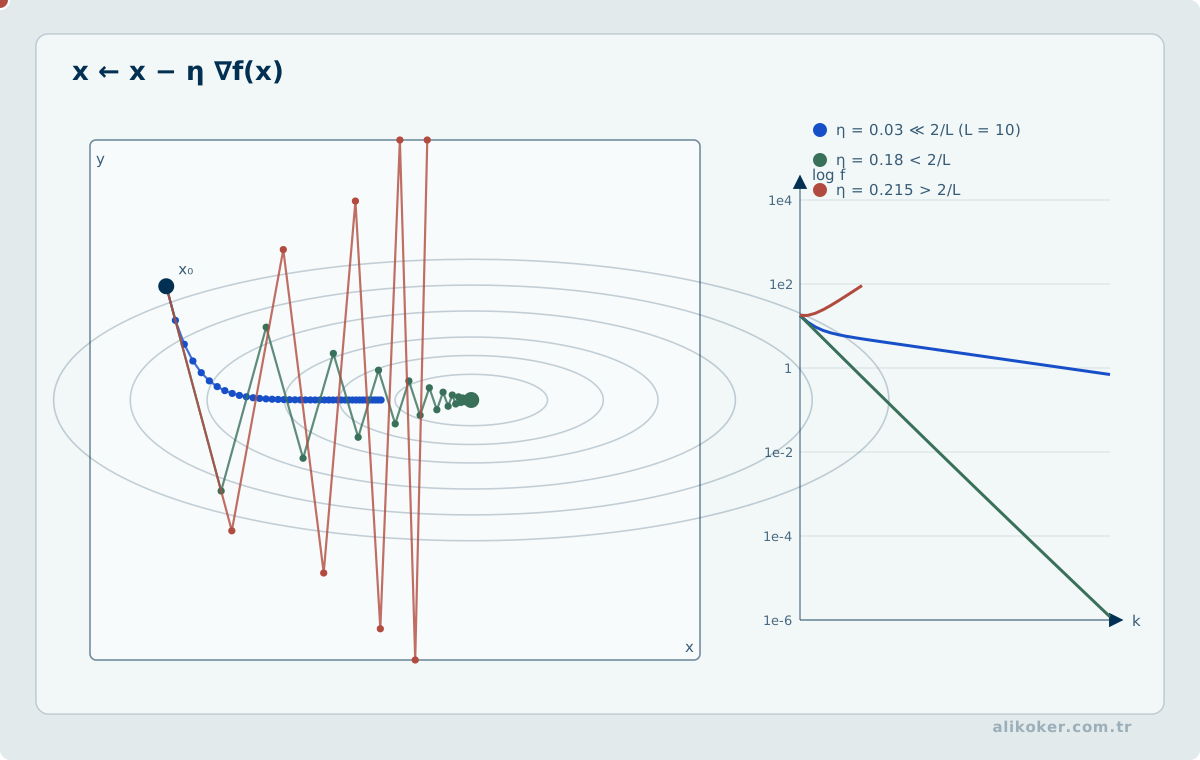
Adaptif sistem, yeni gözlemler geldikçe parametrelerini değiştirebilir. Ancak her çevrim içi güncelleme yararlı değildir. Veri dağılımı değişirse modelin yeniden eğitilmesi veya kontrollü biçimde uyarlanması gerekebilir.
Genelleme, modelin eğitim örneklerini ezberlemek yerine altta yatan düzenlilikleri öğrenmesiyle ilgilidir.
3.2. Temsil, Dayanıklılık ve Açıklanabilirlik
Sinir ağında öğrenilen bilginin nerede ve nasıl temsil edildiği, modelin gürültü ve eksik veri karşısındaki davranışı ile kararların açıklanabilirliği birbirinden ayrı fakat ilişkili mühendislik problemleridir.
3.2.1. Dağıtık Temsil
Klasik sinir ağı anlatımında bilgi ağırlıklara dağılmıştır. Bu ifade genel olarak doğrudur ancak eksiktir. Modern ağlarda bilgi yalnız tek tek ağırlıklarda değil, ağırlıkların ortak oluşturduğu yüksek boyutlu temsillerde ve aktivasyon örüntülerinde ortaya çıkar.
Tek bir parametreye doğrudan tek bir anlam atamak çoğu zaman mümkün değildir. Temsiller dağıtık olabilir.
3.2.2. Eksik ve Gürültülü Veri
Sinir ağları eksik veya gürültülü girdilere karşı otomatik olarak dayanıklı değildir. Dayanıklılık eğitim verisine, veri artırmaya, model mimarisine ve eksik verinin nasıl ele alındığına bağlıdır.
Eksik değerler için maskeleme, imputasyon veya eksikliği açıkça modelleyen mimariler gerekebilir.
3.2.3. Açıklanabilirlik
Sinir ağları özellikle büyük ve derin olduğunda karar gerekçesini doğrudan anlaşılır kurallarla ifade etmez. Bu nedenle açıklanabilirlik önemli bir araştırma alanıdır.
Özellik katkısı (feature attribution), belirginlik (saliency), SHAP benzeri yöntemler, aktivasyon incelemesi (activation probing) ve karşı-olgusal analiz gibi teknikler model davranışını incelemek için kullanılır. Ancak açıklama yöntemlerinin de sınırlılıkları vardır.
3.3. Veri Bölünmesinden Önce Örnekleme Biriminin Tanımlanması
Bir veri kümesinin satırlarını rastgele ayırmak her zaman bağımsız test üretmez. Aynı kişiden, cihazdan, fiziksel parçadan veya sürekli kayıttan gelen örnekler farklı bölmelere düşerse ağ hedef olguyu değil, kaynak kimliğini öğrenebilir. Bu durumda ayırma birimi tek satır yerine kişi, deney, zaman aralığı ya da cihaz olarak tanımlanmalıdır. Zaman serisinde ileriye dönük değerlendirme; aynı sistemin tekrar ölçümlerinde grup bazlı bölme daha uygundur.
Özellik standardizasyonunun ortalama ve ölçeği, özellik seçimi, eksik değer tamamlama ve veri artırmaya ait öğrenilebilir istatistikler yalnız eğitim bölmesinde hesaplanır. Doğrulama verisi hiperparametre kararı için, test verisi ise bir kez son değerlendirme için ayrılır. Bir modelin iyi çalıştığı veri kaynağı, hedef dağılımın da aynı olduğu anlamına gelmez; hedef kullanım aralığı ayrıca belgelenmelidir.
Ünite 4: Perceptron, ADALINE ve İlk Öğrenme Kuralları
Yapay sinir ağlarında model seçimi yalnız ağ mimarisine bağlı değildir. Öğrenme algoritması, kayıp işlevi, düzenlileştirme, veri dağılımı, deney düzeni ve üretim davranışı birlikte değerlendirilir. Perceptron ve ADALINE ile başlayan yapı; çok katmanlı algılayıcı (MLP), geri yayılım, Learning Vector Quantization (LVQ), Adaptive Resonance Theory (ART), geri dönüşümlü ağlar, CNN, LSTM/GRU, dikkat mekanizmaları, Transformer ve üretici modellerle genişler.
4.1. Tek Katmanlı Ağlar
Tek katmanlı ağlarda öğrenilebilir bağlantılar girdiden doğrudan çıktı birimlerine gider. Gizli katman bulunmaz.
Bu tür ağlar doğrusal karar sınırları öğrenebilir. Bir sınıflandırıcı için karar:
w^T x + b = 0
hiperdüzlemiyle ifade edilir.
İki sınıf bu hiperdüzlemle ayrılabiliyorsa problem doğrusal ayrılabilirdir.
4.2. Perceptron
Perceptron, ikili sınıflandırma için temel tarihsel modeldir. Net girdi:
z = w^T x + b
olarak hesaplanır. Çıktı bir eşik fonksiyonuyla belirlenir.
Örnek yanlış sınıflandırılmışsa ağırlıklar hedef sınıfa doğru değiştirilir. Basit güncelleme:
w <- w + eta * (t - y) * x
b <- b + eta * (t - y)
şeklindedir.
Veri doğrusal ayrılabilir ise perceptron öğrenme algoritması sonlu sayıda güncelleme sonunda ayıran bir çözüm bulabilir.
4.3. Perceptronun Sınırlılığı
Tek katmanlı perceptron doğrusal ayrılamayan problemleri çözemez. XOR bunun klasik örneğidir.
XOR doğruluk tablosu:
0 0 -> 0
0 1 -> 1
1 0 -> 1
1 1 -> 0
Bu dört nokta tek bir doğrusal karar sınırıyla ayrılamaz.
Bu sınırlılık yapay sinir ağlarının genel olarak yetersiz olduğunu göstermez. Gizli katman ve doğrusal olmayan aktivasyon kullanıldığında XOR çözülebilir.
4.4. ADALINE
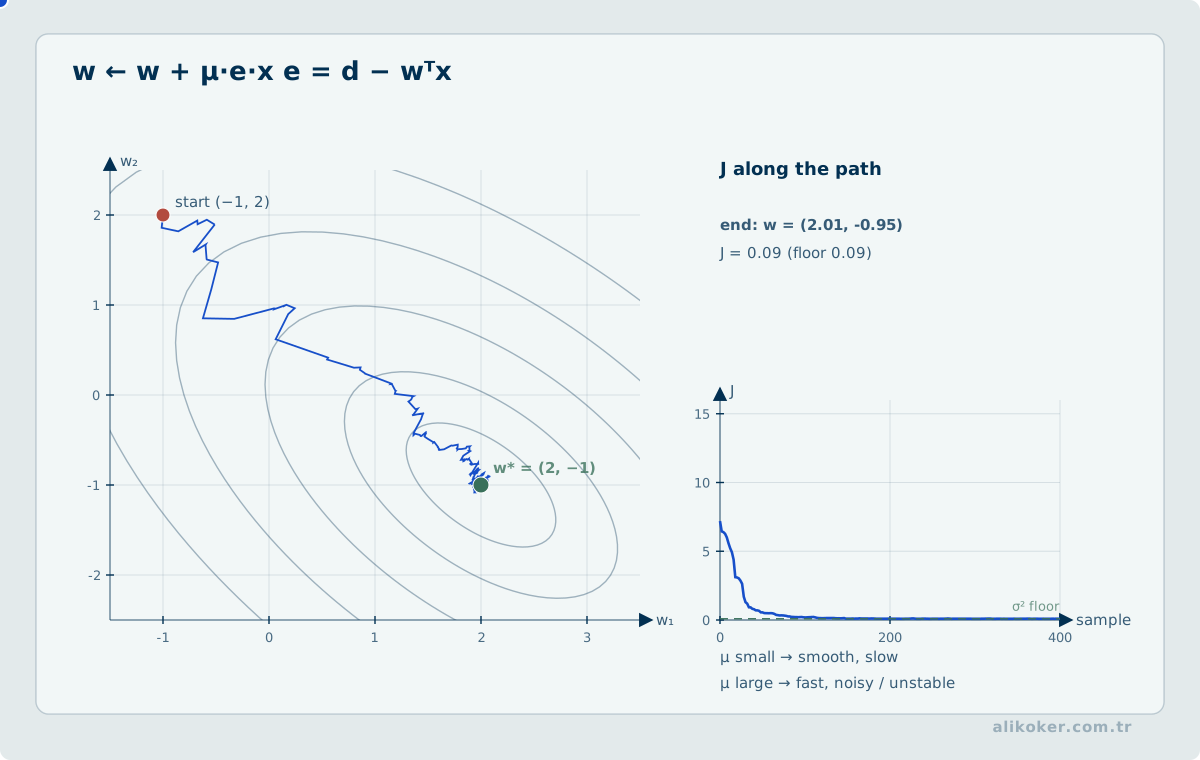
ADALINE, Widrow ve Hoff tarafından geliştirilen adaptif doğrusal birimdir. Perceptrondan önemli farkı, öğrenme sırasında eşiklenmiş sınıf çıktısı yerine nöronun doğrusal çıktısındaki hatayı kullanmasıdır.
Kayıp çoğunlukla karesel hata biçimindedir:
E = 1/2 * (t - y)^2
Ağırlık güncellemesi gradyan inişine dayanır:
w <- w + eta * (t - y) * x
Bu yaklaşım LMS veya Widrow-Hoff kuralıyla ilişkilidir.
4.5. MADALINE
MADALINE, birden fazla ADALINE biriminin birlikte kullanıldığı ağ ailesidir. Tarihsel olarak çok katmanlı adaptif sistemlerin erken örneklerinden biridir.
Bugün MADALINE yaygın bir genel amaçlı mimari değildir. Önemi, çok sayıda öğrenilebilir doğrusal birimin birlikte kullanılması ve adaptif filtreleme düşüncesinin sinir ağlarına taşınmasıdır.
Ünite 5: Çok Katmanlı Ağlar, İleri Yayılım ve Geri Yayılım
Bu ünite, öğretmenli öğrenmede ileri geçiş, kayıp hesabı, geri yayılım ve ağırlık güncellemesini tek bir optimizasyon döngüsü olarak ele alır.
girdi -> gizli katmanlar -> çıktı -> kayıp
  ^                               |
  |                               v
  +---- ağırlık güncelleme <- geri yayılım

ileri geçiş -> hata -> gradyan -> güncelleme -> yeni ileri geçiş
Çok katmanlı algılayıcının eğitimi öncesinde girişlerin ölçeği, hedef değişkenin dağılımı ve kayıp fonksiyonunun problemle uyumu belirlenir. Her yinelemede ileri geçişle tahmin üretilir, kayıp hesaplanır ve türevler zincir kuralıyla geriye taşınır. Güncellemenin yönü ve büyüklüğü öğrenme oranıyla ilişkilidir; azalan eğitim kaybı tek başına genelleme kanıtı oluşturmaz. Eğitim ve doğrulama eğrileri birlikte izlenerek aşırı uyum ve optimizasyon kararsızlığı birbirinden ayrılır.
5.1. Çok Katmanlı Algılayıcı
Çok katmanlı algılayıcı, yani MLP, en az bir gizli katmana sahip ileri beslemeli sinir ağıdır. Gizli katmandaki doğrusal olmayan aktivasyonlar doğrusal ayrılamayan ilişkilerin öğrenilmesini sağlar.
Bir iki katmanlı ağ şöyle yazılabilir:
h = phi(W1*x + b1)
yhat = psi(W2*h + b2)
Burada h gizli temsildir.
5.2. XOR Probleminin Çözümü
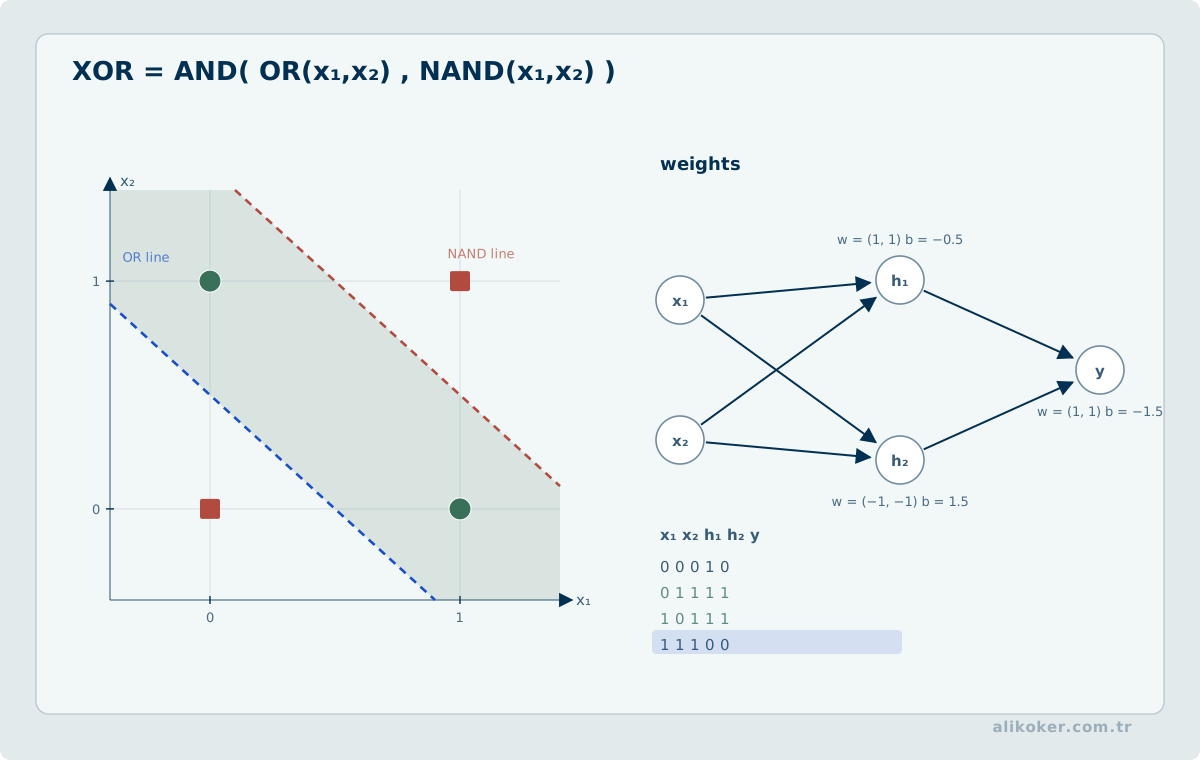
XOR problemi tek doğrusal sınırla çözülemez. Ancak gizli katmandaki birden fazla nöron giriş uzayını farklı yarı uzaylara ayırabilir. Çıktı katmanı bu ara temsilleri birleştirerek XOR kararını oluşturabilir.
Bu örnek, gizli katmanın yalnız daha fazla parametre eklemediğini; yeni bir temsil uzayı oluşturduğunu gösterir.
5.3. İleri Bilgi İşleme
İleri geçişte her katman bir önceki katmanın çıktısını alır:
a^(l) = phi(W^(l) * a^(l-1) + b^(l))
Bu işlem çıktı katmanına kadar devam eder.
Tahmin ile hedef arasındaki fark kayıp fonksiyonuyla ölçülür.
5.4. Geri Yayılım
Geri yayılım, kayıp fonksiyonunun her parametreye göre türevini zincir kuralıyla hesaplar. Temel amaç:
dL/dW^(l)
ve
dL/db^(l)
gradyanlarını verimli biçimde elde etmektir.
Çıktı katmanındaki hata geriye doğru taşınır. Her katman kendi yerel türevi ile bir sonraki katmandan gelen gradyanı çarpar.
Parametre güncellemesi:
W <- W - eta * dL/dW
b <- b - eta * dL/db
biçimindedir.
5.4.1. Zincir Kuralının Sayısal İzlenmesi
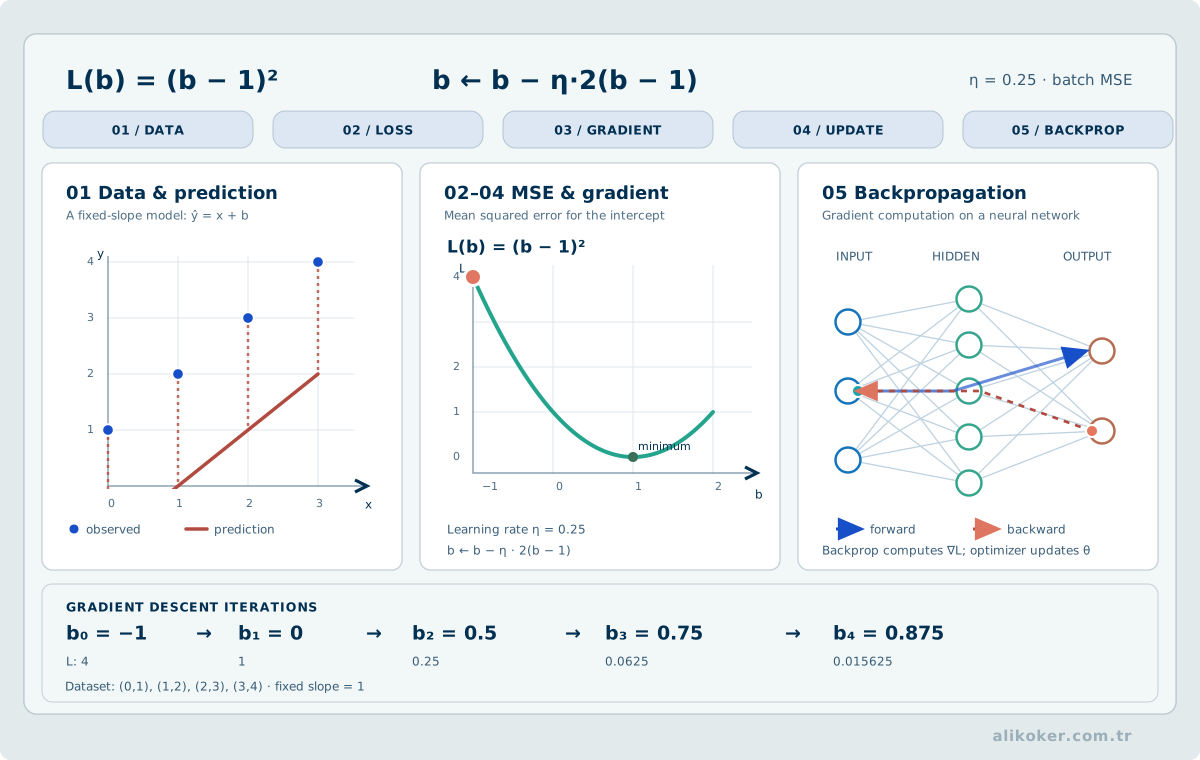
Doğrusal regresyon bölümündeki gradyan inişi örneği, kaybın parametreyle nasıl değiştiğini görünür kılar. Çok katmanlı bir ağda ek işlem, aynı kaybın ara katmanlardaki her ağırlığa göre türevinin hesaplanmasıdır. Geri yayılım bunu hesaplar; ağırlıkların değiştirilmesi ise optimizasyon algoritmasının ayrı adımıdır.
Zincir kuralı, doğrusal aktivasyonlu iki ağırlıklı küçük bir hesaplama grafiğinde tam sayılarla izlenebilir. x = 2, hedef y = 3, başlangıç ağırlıkları w1 = 0.5 ve w2 = 1 olsun. Bu örnek yalnız türev akışını göstermek için doğrusal seçilmiştir; gizli katmanlı doğrusal olmayan ağların temsil gücü hakkında bir iddia içermez.
İleri geçiş:
h = w1 * x = 0.5 * 2 = 1
y_hat = w2 * h = 1 * 1 = 1
L = 0.5 * (y_hat - y)^2 = 2

Geri yayılım (zincir kuralı):
dL/dy_hat = y_hat - y = -2
dL/dw2 = (dL/dy_hat) * h = -2
dL/dw1 = (dL/dy_hat) * w2 * x = -4

Optimizasyon (η = 0.1, eşzamanlı parametre güncellemesi):
w2_yeni = 1 - 0.1 * (-2) = 1.2
w1_yeni = 0.5 - 0.1 * (-4) = 0.9

Yeni ileri geçiş:
h_yeni = 0.9 * 2 = 1.8
y_hat_yeni = 1.2 * 1.8 = 2.16
L_yeni = 0.5 * (2.16 - 3)^2 = 0.3528
İki gradyan da eski ağırlıklarla gerçekleştirilen aynı ileri geçişten türetilir. w2 güncellendikten sonra w1 için yeni w2 kullanılması, burada tanımlanan eşzamanlı gradyan inişi adımını değiştirir. Aktivasyon fonksiyonları doğrusal olmadığında zincir kuralına ilgili φ'(z) çarpanları girer. Bir parametre kayba birden fazla yoldan etki ediyorsa o yolların gradyan katkıları toplanır.
Eğitim döngüsünde sıra; örnek/batch seçimi, ileri geçiş, kayıp hesabı, geri yayılım, optimizasyon güncellemesi ve doğrulama olarak korunur. İleri geçiş ara aktivasyonlarının saklanması bellek kullanımı doğurur; büyük ağlarda aktivasyon yeniden hesaplama bellek ile hesaplama zamanı arasında bir değiş tokuştur. Yoğun katmanlarda tek bir örnek için temel çarpma-toplama iş yükü yaklaşık ağırlık sayısıyla orantılıdır. Minibatch boyutu arttıkça toplam işlem hacmi ve ara tensör belleği ayrıca büyür. Eğitimin amacı yalnız bu sayısal kaybı küçültmek değil, bağımsız veride işe yarayan bir parametre kümesine ulaşmaktır.
Geri yayılım, hata değerinin ağ boyunca geriye gönderilmesinden çok, bileşik fonksiyonun türevini zincir kuralıyla hesaplama yöntemidir. Tek ağırlıklı bir nöronda z = wx, y = z ve kare hata L = (y−t)^2/2 ise gradyan dL/dw = (y−t)x olur. Örneğin x=2, w=3, t=4 için y=6 ve gradyan 4'tür; öğrenme hızı 0,1 ise yeni ağırlık 3−0,1×4 = 2,6 olur. Bu basit hesap, öğrenmenin hedef etiketi doğrudan ağırlığa yazmadığını gösterir. Daha derin ağlarda aynı zincir kuralı, aktivasyonların türevleri ve parametre paylaşımı üzerinden uygulanır.
5.5. Çıktı Katmanı Ağırlıklarının Güncellenmesi
Çıktı katmanında hata doğrudan model tahminiyle hedef arasındaki farka bağlıdır. Sigmoid ve karesel hata için klasik türev yapısı:
delta_k = (t_k - y_k) * y_k * (1 - y_k)
şeklinde yazılabilir.
Güncel sınıflandırma uygulamalarında softmax ile çapraz entropi birlikte kullanıldığında türev daha yalın hale gelir.
5.6. Gizli Katman Ağırlıklarının Güncellenmesi
Gizli nöronun doğrudan hedef değeri yoktur. Hata, kendisinden sonra gelen katmanların hatalarından zincir kuralıyla türetilir.
Klasik sigmoid nöron için:
delta_j = h_j * (1 - h_j) * sum_k(delta_k * w_jk)
Ağırlık güncellemesi daha sonra:
Delta w_ij = eta * delta_j * x_i
olarak yazılabilir.
5.7. Eğitim Prosedürü
Bir MLP'nin temel eğitim çevrimi şöyledir:
- Ağırlıkları başlat.
- Mini-batch seç.
- İleri geçiş yap.
- Kayıp hesapla.
- Geri yayılımla gradyanları bul.
- Optimizer ile parametreleri güncelle.
- Doğrulama başarımını izle.
- Durdurma ölçütü sağlanana kadar sürdür.
Modern uygulamada tek örnekli çevrim yerine mini-batch eğitimi yaygındır.
5.8. Karmaşık Hata Yüzeyleri
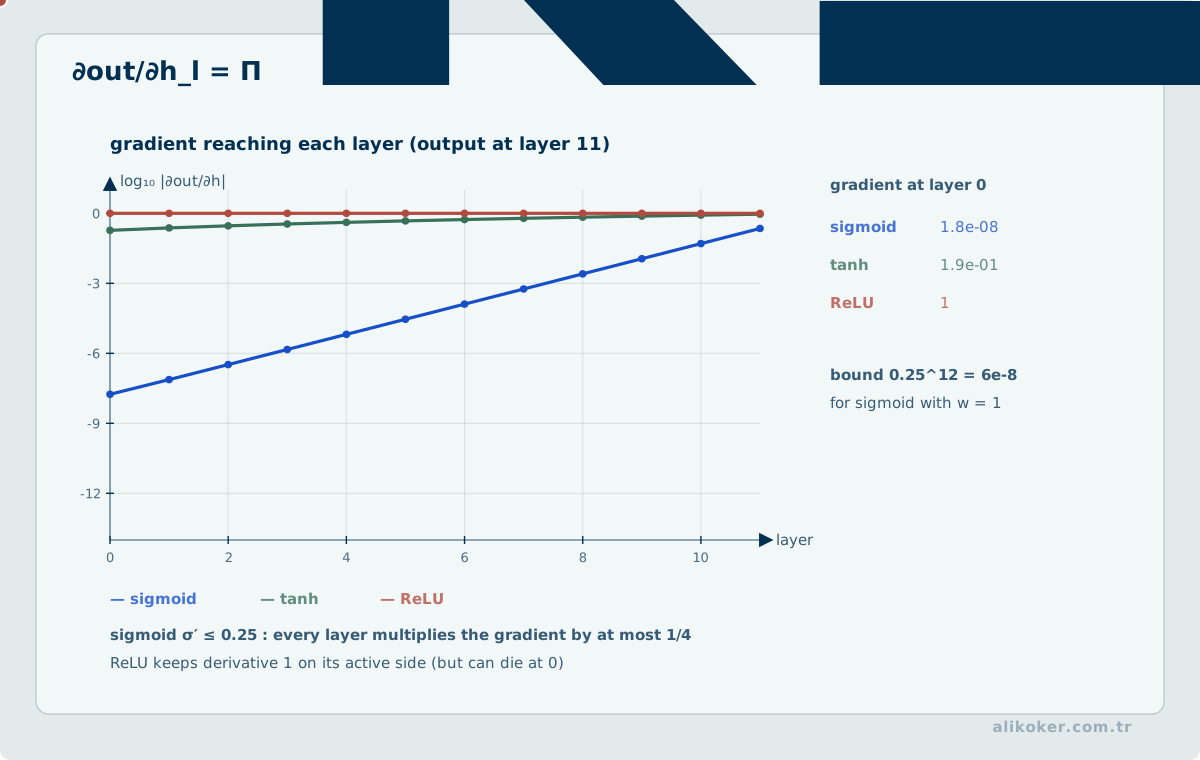
Derin ağların kayıp yüzeyi yüksek boyutlu ve doğrusal değildir. Yerel minimumlar, eyer noktaları, düz bölgeler ve kötü ölçeklenmiş yönler optimizasyonu etkileyebilir.
Ağırlık başlangıcı, normalizasyon, optimizer ve öğrenme katsayısı bu nedenle kritiktir.
5.9. Öğrenme Süresi
Eğitim süresini etkileyen başlıca etkenler şunlardır:
- veri kümesinin büyüklüğü,
- model parametre sayısı,
- batch büyüklüğü,
- donanım,
- sayısal hassasiyet,
- optimizer,
- öğrenme katsayısı,
- veri giriş hattı.
Performans yalnız FLOPS ile belirlenmez. Bellek bant genişliği, veri aktarımı ve paralellik de önemlidir.
5.10. Otomatik Türev, Hesaplama Grafiği ve Geri Yayılım
Sinir ağında geri yayılım, türev formüllerini elle tek tek yazmaktan ziyade hesaplama grafiği üzerinde zincir kuralının sistematik uygulanmasıdır. Her düğüm yerel bir işlem ve yerel türev taşır; toplam türev bu yerel katkıların graf boyunca birleştirilmesiyle elde edilir.
İleri kip otomatik türev giriş yönüyle birlikte türev bilgisini ileri taşır ve JVP hesaplamasına yakındır. Ters kip skaler çıktıdan başlayıp duyarlılığı giriş ve parametrelere geri taşır; VJP yapısına karşılık gelir. Çok parametreli, skaler kayıplı ağlarda geri yayılımın ters kip ile uyumu buradan gelir.
Otomatik türev sembolik türev değildir ve sonlu fark da değildir. Sembolik türev yeni bir ifade üretir; sonlu fark yaklaşık türev hesaplar; otomatik türev ise gerçekleştirilen temel işlemlerin türevlerini zincirleyerek makine hassasiyetine yakın sonuç üretir.
5.11. Gradyan Birikimi, Grafik Yaşam Döngüsü ve Sayısal Güven
Modern eğitimde bir parametre aynı hesaplama grafiğinde birden fazla yoldan kaybı etkileyebilir. Ters kipte bu yolların gradyan katkıları toplanmalıdır. Mini-batch gradyan birikimi de benzer biçimde birden fazla örneğin katkısını bir optimizasyon adımından önce birleştirebilir.
Dinamik hesaplama grafiğinde ara aktivasyonların hangilerinin ters geçiş için saklanacağı bellek maliyetini belirler. Checkpointing, bazı ara değerleri saklamayıp geri geçişte yeniden hesaplayarak bellek-zaman ödünleşimi kurar.
Gradyanın sayısal olarak mevcut olması doğru olduğu anlamına gelmez. Küçük sentetik problemler üzerinde finite-difference gradient check, kayıp ölçeği kontrolü, NaN/Inf izleme ve katman bazında gradyan normları implementasyon hatalarını yakalamaya yardımcı olur. Üretim ölçeğinde tam gradient check pahalıdır; doğrulama küçük ve kontrollü testlerle yapılmalıdır.
5.12. Geri Yayılımın İki Parametreli Sayısal Kontrolü
Tek bir sigmoid nöronda z = wx + b, a = σ(z), L = (a-t)²/2 olsun. x=2, t=1, w=0, b=0 için a=0.5, L=0.125 elde edilir. Zincir kuralı ∂L/∂z = (a-t)a(1-a) = -0.125, ∂L/∂w = -0.25, ∂L/∂b = -0.125 sonucunu verir. Öğrenme oranı 0.1 olan bir gradyan adımı sonunda w=0.025, b=0.0125 olur; yeni logit 0.0625 değerine yükselir. Bu küçük örnek, geri yayılımın parametreyi değil önce gradyanı hesapladığını görünür kılar.
Analitik gradyan, merkezî sonlu farkla denetlenebilir: [L(θ+ε)-L(θ-ε)]/(2ε). Çok büyük ε kesme hatasına, çok küçük ε yuvarlama hatasına yol açar. Kontrol, küçük ve deterministik ağ üzerinde, dropout kapalıyken ve aynı kayan nokta hassasiyetinde yapılmalıdır. Geri yayılımın doğru olması genel amaç fonksiyonunda küresel optimum garantisi vermez.
Ünite 6: Eğitim ve Optimizasyon Algoritmaları
6.1. Modern Optimizasyon
SGD ve momentum temel yöntemlerdir.
Adam, gradyanın birinci ve ikinci moment tahminlerini kullanarak parametre başına uyarlanmış güncelleme büyüklüğü oluşturur.
AdamW, weight decay ile gradyan tabanlı L2 cezasını ayırarak pratik derin öğrenme eğitiminde yaygınlaşmıştır.
Optimizer seçimi tek başına yeterli değildir. Learning-rate schedule, warmup, batch büyüklüğü ve sayısal hassasiyet birlikte eğitim dinamiğini belirler.
6.2. İlk Mertebe, Gauss–Newton ve Levenberg–Marquardt Eğitimi
Parametre vektörü θ için en küçük kareler kaybı F(θ) = (1/2)∑ r_i(θ)² olsun. Artık vektörünün Jacobian'ı J_ij = ∂r_i/∂θ_j olduğunda gradyan g = Jᵀr ve gerçek Hessian H = JᵀJ + ∑ r_i ∇²r_i biçimindedir. Gauss–Newton, ikinci toplamı atarak (JᵀJ) Δθ = -Jᵀr doğrusal sistemini çözer. Levenberg–Marquardt, kötü koşullanma veya aşırı büyük adımlara karşı (JᵀJ + λD) Δθ = -Jᵀr türü sönümlü bir sistem kullanır; D birim matris veya uygun köşegen ölçek olabilir. λ yükseldiğinde adım daha tutucu olur, azaltıldığında Gauss–Newton davranışına yaklaşır. Denklem, matrisin tersini açıkça hesaplamak yerine kararlı ayrıştırma ile çözülmelidir.
Büyük ağlarda p parametrenin yoğun Hessian'ı O(p²) bellek gerektirebildiğinden klasik SGD/Adam türü ilk mertebe yöntemler çoğu kez daha ölçeklenebilirdir. GN/LM, özellikle uygun boyutlu artık vektörü, en küçük kareler kaybı ve hesaplanabilir Jacobian bulunduğunda anlamlıdır. Çapraz entropi üzerinde yöntemi aynı formülü gerekçesiz uygulayarak tanımlamak doğru olmaz; eğrilik yaklaşımı ve kayıp yapısı ayrıca belirtilmelidir.
6.3. RLS ile Çevrim İçi Doğrusal Okuma Katmanı
Sabit özellik çıkarıcının çıktısı φ_t ∈ R^d, hedef y_t ve güncellenecek doğrusal okuma ağırlığı w_t olsun. Unutma katsayısı 0 < ρ ≤ 1 için k_t = P_(t-1) φ_t / (ρ + φ_tᵀ P_(t-1) φ_t), w_t = w_(t-1) + k_t(y_t - φ_tᵀw_(t-1)) ve P_t = ρ^(-1)(P_(t-1) - k_t φ_tᵀP_(t-1)) hesaplanır. Skaler φ=1, başlangıç P=1, w=0, ρ=1 ve ilk hedef y=2 ise k=0.5, w=1, P=0.5 elde edilir. İkinci eşit hedefte k=1/3, w=4/3, P=1/3 olur. Bu adımlar ölçülebilir fakat tam yakınsama değildir; başlangıç düzenlemesi ve yeni gözlemler etkilidir.
RLS'nin O(d²) kovaryans belleği ve sayısal kararlılık maliyeti vardır. Sabit veya doğrusallaştırılmış özellikler için uygun olan bu güncelleme, çok katmanlı ağın tamamına uygulanan geri yayılımla özdeş değildir. Kovaryans simetrisi, pozitif tanımlılık, zayıf uyarım ve veri kayması için izleme gereklidir.
6.4. Gradyan Denetimi ve Sayısal Türev Sınırı
Geri yayılım uygulamasının doğruluğu yalnız eğitim kaybının azalmasıyla kanıtlanmaz. Her ağırlık için analitik türev, merkezi sonlu fark yaklaşımıyla karşılaştırılabilir:
\[ \frac{\partial L}{\partial w_i}\approx\frac{L(w_i+h)-L(w_i-h)}{2h}. \]
Merkezi farkın kesme hatası düzgünlük varsayımları altında \(O(h^2)\) iken çok küçük \(h\), kayan nokta yuvarlama ve birbirine yakın sayıların çıkarılması yüzünden sonucu bozabilir. Bu nedenle tek bir adım büyüklüğüne bağlı kalmak yerine birkaç makul \(h\) değeri kullanılır. Denetim küçük bir ağ, deterministik sabit giriş ve sabit parametreler üzerinde yürütülür; dropout gibi rastgele işlemler kapatılır veya aynı rastgelelik koşulları korunur.
Karşılaştırmada mutlak hata yanında \(\lvert g_a-g_n\rvert/\max(1,\lvert g_a\rvert,\lvert g_n\rvert)\) gibi ölçeklenmiş ölçü kullanılabilir. Sıfıra yakın türevler, doygun etkinleşimler ve türevlenemeyen noktalarda sonuç dikkatle yorumlanır. Sonlu fark yöntemi üretim eğitiminin yerine geçmez; küçük modellerde otomatik türev ve geri yayılım uygulamasının hata ayıklanmasında kullanılır. Türev denetiminden geçen bir modelin genelleme yeteneği ayrıca ölçülmelidir.
Ünite 7: Ağ Tasarımı, Düzenlileştirme ve Genelleme
Bu ünite, eğitim, doğrulama ve test kümelerinin farklı rollerini model seçimi ve genelleme başarımı bağlamında birbirinden ayırır.
veri kümesi
   |
   +--> eğitim ------> ağırlıklar güncellenir
   |
   +--> doğrulama ---> model / eşik / durdurma kararı
   |
   +--> test --------> yalnız nihai genelleme ölçümü
Ağ mimarisi karşılaştırılırken tek bir denemeden sonuç çıkarılmaz. Eğitim ve doğrulama bölümleri sabit tutulur; katman genişliği, düzenlileştirme ve öğrenme oranı kontrollü deneylerle değiştirilir. Performans iyileşmesi gözlendiğinde parametre sayısı, çıkarım süresi ve dağılım dışı örneklerde hata davranışı da karşılaştırılır. Nihai model yalnız en yüksek skorlu seçenek değil, tanımlanan doğruluk, kaynak ve güvenilirlik sınırlarını birlikte karşılayan seçenektir.
7.1. Performansın Ölçülmesi
Model başarımı probleme uygun ölçütlerle değerlendirilmelidir.
Sınıflandırmada sık kullanılan ölçütler:
- accuracy,
- precision,
- recall,
- F1,
- ROC-AUC,
- PR-AUC.
Regresyonda:
- MAE,
- MSE,
- RMSE,
- R².
Dengesiz sınıflarda yalnız accuracy yanıltıcı olabilir. Ölçüt seçiminde hata türlerinin uygulamadaki maliyeti dikkate alınmalıdır.
7.2. Ezberleme ve Aşırı Uyum
Model eğitim verisinde çok başarılı, görülmemiş veride zayıf ise overfitting vardır.
Aşırı uyumun temel nedenleri:
- modele göre az veri,
- fazla model kapasitesi,
- uzun eğitim,
- veri sızıntısı,
- eğitim ve gerçek kullanım dağılımlarının farklı olması.
Karşı önlemler:
- daha fazla ve daha iyi veri,
- veri artırma,
- L1/L2 düzenlileştirme,
- dropout,
- early stopping,
- uygun model kapasitesi,
- çapraz doğrulama.
7.3. Örneklerin Seçilmesi
Eğitim verisi gerçek problem uzayını temsil etmelidir. Yalnız kolay veya benzer örneklerin seçilmesi modelin sahadaki başarımını düşürür.
Veri bölme işlemi rastgele yapılmadan önce bağımlılık yapısı incelenmelidir. Aynı kişi, aynı cihaz, aynı zaman penceresi veya aynı kaynak hem eğitim hem test kümesine dağılırsa veri sızıntısı oluşabilir.
Zaman serilerinde geçmişten geleceğe doğru bölme çoğu zaman rastgele bölmeden daha doğrudur.
7.4. Girdi ve Çıktı Gösterimi
Modelin başarısı yalnız mimariye değil, problemin gösterimine de bağlıdır.
Tablosal veride sayısal ve kategorik özellikler uygun biçimde kodlanmalıdır.
Görüntüde piksel veya öğrenilmiş görsel temsil kullanılır.
Metinde token ve embedding gösterimleri kullanılır.
Seste waveform, spektrogram veya öğrenilmiş özellikler kullanılabilir.
Gösterim, modelin öğrenmesi gereken invariance ve bağımlılıklarla uyumlu olmalıdır.
7.5. Görüntü Tanıma
Görüntülerin doğrudan tam bağlı MLP'ye verilmesi küçük örneklerde öğretici olsa da modern görsel sistemlerde CNN ve Vision Transformer gibi mimariler daha uygundur.
CNN yerel bağlantı ve ağırlık paylaşımı sayesinde görüntünün uzamsal yapısından yararlanır.
7.6. Endüstriyel Kestirim Örneği
Bir üretim prosesinde çok sayıda ayar parametresi ile kalite çıktısı arasında doğrusal olmayan ilişki olabilir. Sinir ağı bu ilişkiyi deney verisinden öğrenebilir ve denenmemiş parametre kombinasyonlarının çıktısını kestirebilir.
Ancak eğitim verisinin kapsamadığı bölgelerde yapılan kestirim extrapolation niteliğindedir ve güvenilirliği düşebilir. Optimizasyon amacıyla ağ kullanılırken bu sınır özellikle dikkate alınmalıdır.
7.7. Zaman Serisi Kestirimi
Döviz kuru gibi zaman serilerinde geçmiş değerlerden gelecek değer tahmin edilebilir. Ancak finansal seriler durağan olmayabilir ve güçlü gürültü içerir. Başarılı görünen sonuçlar veri sızıntısı, yanlış zaman bölmesi veya aşırı uyum nedeniyle yanıltıcı olabilir.
Zaman serisinde değerlendirme kronolojik ayrım, kayan pencere doğrulaması (rolling validation) ve gerçek işlem maliyetleriyle yapılmalıdır.
7.8. Çıktıların Gösterimi
İkili sınıflandırmada tek sigmoid çıkış kullanılabilir.
Çok sınıflı sınıflandırmada sınıf sayısı kadar logit ve softmax yaygındır.
Çok etiketli sınıflandırmada her sınıf için bağımsız sigmoid kullanılabilir.
Regresyonda çıkış çoğu zaman doğrusal bırakılır.
Çıktı aktivasyonu ile kayıp fonksiyonu birlikte düşünülmelidir.
7.9. Ağırlık Başlangıcı
Tüm ağırlıkları aynı değere kurmak simetri sorununa neden olur. Gizli nöronlar aynı gradyanı alabilir.
Bu nedenle rastgele fakat kontrollü başlangıç kullanılır. Xavier/Glorot başlangıcı sigmoid ve tanh ailesiyle, He başlangıcı ReLU ailesiyle yaygın olarak kullanılır.
Başlangıcın amacı aktivasyonların ve gradyanların katmanlar boyunca aşırı büyümemesini veya sönmemesini sağlamaktır.
7.10. Öğrenme Katsayısı ve Momentum
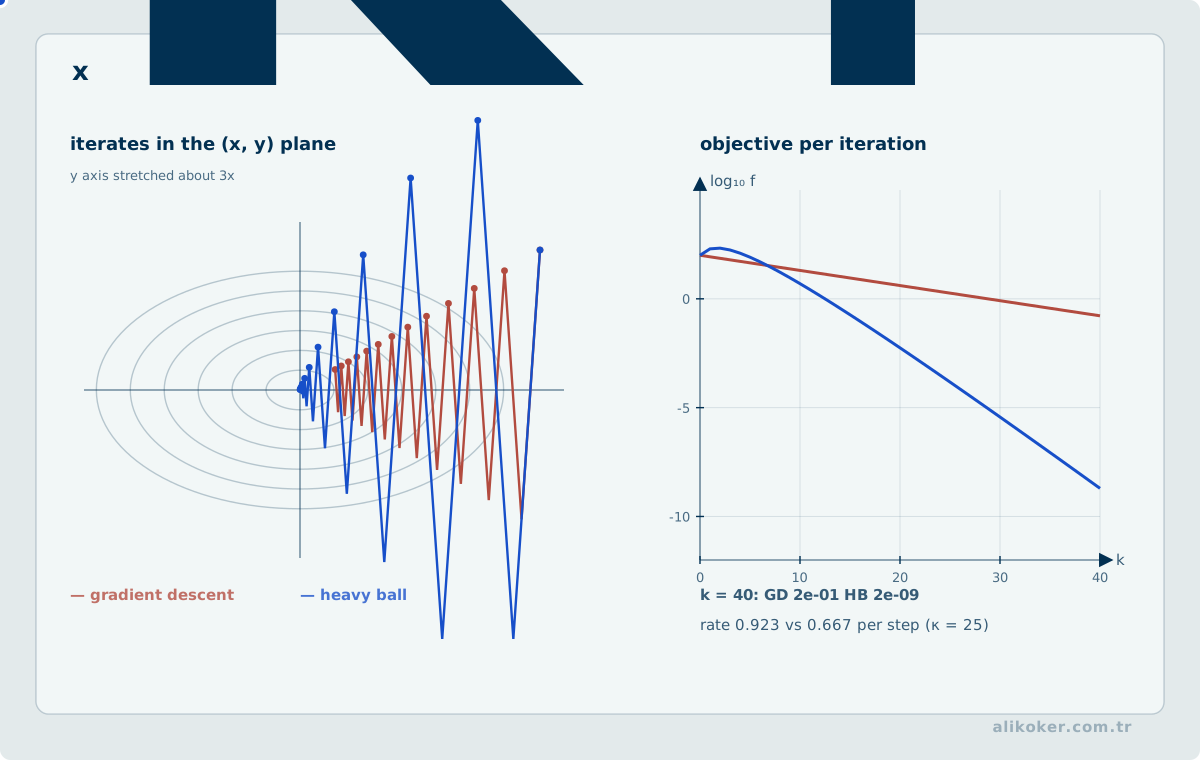
Öğrenme katsayısı çok küçükse eğitim yavaşlar. Çok büyükse kayıp salınabilir veya eğitim kararsız hale gelebilir.
Momentum geçmiş gradyan yönlerini biriktirerek bazı yönlerde ilerlemeyi hızlandırabilir:
v_t = beta * v_(t-1) + g_t
w_t = w_(t-1) - eta * v_t
Modern optimizerlar öğrenme katsayısını parametre bazında uyarlayabilir. Yine de temel öğrenme katsayısı çoğu zaman en kritik hiperparametrelerden biridir.
7.11. Örneklerin Ağa Sunulması
Eğitim örnekleri epoch'lar arasında karıştırılabilir. Mini-batch seçimi gradyan tahminine rastlantısallık katar.
Zaman serisi, sıralı veri veya stateful recurrent ağlarda sıra bilgisi korunabilir. Dolayısıyla "her zaman karıştır" kuralı yoktur.
7.12. Ağırlıkların Değiştirilme Zamanı
Üç temel yaklaşım vardır:
Batch gradient descent: Tüm veri üzerinden tek güncelleme.
Stochastic gradient descent: Her örnekten sonra güncelleme.
Mini-batch gradient descent: Küçük örnek gruplarından sonra güncelleme.
Güncel derin öğrenmede mini-batch yaklaşımı donanım paralelliği ve gradyan istatistikleri nedeniyle yaygındır.
7.13. Girdilerin Ölçeklendirilmesi
Farklı büyüklüklerde özellikler optimizasyonu zorlaştırabilir.
Yaygın yöntemler:
- standardizasyon:
(x - mean) / std, - min-max ölçekleme,
- sağlam ölçekleme.
Ölçekleme parametreleri yalnız eğitim verisinden hesaplanmalıdır. Test verisinin istatistiklerini eğitim aşamasında kullanmak veri sızıntısıdır.
7.14. Çıktıların Ölçeklendirilmesi
Regresyon hedefleri çok geniş aralıktaysa çıktıların ölçeklenmesi eğitimi kolaylaştırabilir. Tahmin kullanım aşamasında özgün ölçeğe geri dönüştürülür.
Sınıflandırmada hedef gösterimi kayıp fonksiyonuna göre belirlenir.
7.15. Durdurma Kriterleri
Yalnız eğitim hatasının belirli değerin altına düşmesi güvenilir bir durdurma ölçütü değildir.
Daha iyi yaklaşım doğrulama kaybını izlemektir. Doğrulama başarımı belirli süre iyileşmiyorsa early stopping uygulanabilir.
Ayrıca maksimum epoch, zaman bütçesi ve hedef ölçüt birlikte kullanılabilir.
7.16. Gizli Katman ve Nöron Sayısı
Her problem için en iyi katman ve nöron sayısını veren kapalı form kural yoktur. Model kapasitesi doğrulama başarımı ve kaynak maliyetiyle seçilir.
Çok küçük model underfitting yapabilir. Gereğinden büyük model daha pahalıdır ve uygun düzenlileştirme yoksa aşırı uyuma açık olabilir.
7.17. Büyütme ve Budama
Model kapasitesi eğitim sırasında veya sonrasında değiştirilebilir.
Büyütme, yetersiz kapasiteyi gidermek için yeni birimler veya katmanlar eklemektir.
Budama, düşük öneme sahip ağırlık veya yapıların kaldırılmasıdır.
Modern budama yöntemleri sıkıştırma ve çıkarım hızlandırma amacıyla da kullanılır. Yapısal budama, donanım üzerinde gerçek hız kazanımı sağlama açısından tek tek ağırlık sıfırlamaktan daha etkili olabilir.
7.18. Uygulama Alanları
MLP özellikle sabit boyutlu vektör girdilerde temel bir modeldir. Sınıflandırma, regresyon ve ara temsil katmanı olarak yaygın biçimde kullanılır.
Görüntü, ses ve uzun dizilerde ise problem yapısını kullanan CNN, recurrent ağ veya Transformer gibi mimariler çoğu zaman daha uygundur.
7.19. Küçük Ağlarda Özellik Birleştirme, Kalibrasyon ve Genelleme
Sınırlı özellikli bir karar probleminde büyük bir sinir ağı zorunlu değildir. Giriş katmanına sözcüksel eşleşme, sınıf adayı farkı, kök/ek uyumu, olumsuzluk ve bağlam geçerliliği gibi ölçeklenmiş özellikler verilebilir. Tek gizli katmanlı ağ doğrusal sınıflandırıcının yakalayamadığı etkileşimleri öğrenebilir; örneğin sesletim benzerliğinin yalnız morfolojik uyum bulunduğunda yararlı olmasını temsil edebilir. Buna karşılık aynı kaynaktan türeyen özelliklerin çokluğu, küçük eğitim kümesinde ezberlemeyi kolaylaştırır.
Modelin eğitiminde sözcük örneklerini rastgele satırlara ayırmak çoğu kez yeterli değildir. Aynı kalıbın farklı eklerle yazılmış biçimleri eğitim ve sınamada birlikte bulunursa sınama başarısı gerçekte olduğundan yüksek görünür. Ayrım ifade ailesi, görev ve gerekiyorsa zaman üzerinden yapılmalıdır. Özellik normalizasyonu, eksik değer doldurma ve sözlük sürümü de model parametreleriyle birlikte saklanır; yalnız ağırlıkları dağıtmak aynı tahmini yeniden üretmeye yetmez.
Ağın üç sayısal çıktı üretmesi, bunların doğrudan olasılık olduğu anlamına gelmez. Kabul, netleştirme ve çekimserlik gibi kararlar için kalibrasyon ve ayrı maliyet matrisi gerekir. Çıkarımda matris–vektör çarpımları sabit ağırlıklarla yürütülebilir; eğitim döngüsü, rastgele başlangıç ve ağırlık güncellemesi üretim akışının parçası olmak zorunda değildir. Ancak öğrenilmiş bir skor, kayıt yetkisi veya işlem olumsuzluğu gibi değişmezlerin yerini alamaz.
7.20. Düzenlileştirme
Modern ağlarda aşırı uyumu azaltmak için birden fazla teknik birlikte kullanılabilir.
Weight decay: Büyük ağırlıkları cezalandırır.
Dropout: Eğitim sırasında bazı aktivasyonları rastgele sıfırlar.
Data augmentation: Eğitim örneklerinin anlamı koruyan dönüşümlerini üretir.
Early stopping: Doğrulama başarımı kötüleşmeden eğitimi durdurur.
7.21. Normalizasyon
Batch Normalleştirme, mini-batch istatistiklerini kullanarak katman aktivasyonlarını normalleştirir ve öğrenilebilir ölçek/kaydırma parametreleri ekler.
Transformer mimarilerinde Layer Normalleştirme daha yaygındır. Normalizasyon seçimi mimariye ve batch yapısına bağlıdır.
7.22. Kapasite, Aşırı Parametreleme ve Genelleme Hakkında Ölçülü Yorum
Parametre sayısının eğitim örneği sayısını aşması, tek başına kötü genelleme hükmü vermez. Genelleme; modelin oluşturduğu fonksiyon sınıfı, eğitim algoritmasının örtük yanlılığı, etiket gürültüsü, veri bağımsızlığı ve düzenlileştirmeyle birlikte değerlendirilir. İyi bir eğitim hatası yalnız optimizasyon başarısını gösterir. Eğitim ve doğrulama kaybı ayrışıyorsa erken durdurma veya model kapasitesinin değiştirilmesi düşünülebilir; test bölmesine bakarak tekrar tekrar karar değiştirmek seçim yanlılığı üretir.
Aynı deneyde üç değer ayrı kaydedilmelidir: parametre sayısı, örnek başına çıkarım maliyeti ve bağımsız doğrulama başarımı. Daha az parametre her zaman düşük gecikme sağlamaz; matris şekilleri, bellek aktarımı, çekirdek seçimi ve kullanılan cihaz da belirleyicidir.
Ünite 8: Çok Katmanlı Ağlarla Endüstriyel Kestirim
8.1. Problemin Tanımlanması
Bir yapay sinir ağı uygulamasında ilk adım ağ seçmek değil, problemi açık biçimde tanımlamaktır. Endüstriyel bir üretim sürecinde amaç çoğu zaman kalite karakteristiğini etkileyen proses değişkenleri ile sonuç arasındaki ilişkiyi öğrenmektir.
Klasik örnekte bir döküm prosesinde tüplerde oluşan sehim miktarını etkileyen yedi üretim faktörü ele alınır. Her faktörün iki düzeyi olduğunda tam faktöriyel deney uzayı:
2^7 = 128
kombinasyon içerir.
Bütün kombinasyonları fiziksel olarak denemek pahalı olabilir. Bu nedenle daha az sayıdaki deneyden elde edilen verilerle bir MLP eğitilip denenmemiş kombinasyonların kalite çıktısı kestirilebilir.
8.2. Deney Tasarımı ile Öğrenme İlişkisi
Sinir ağı fiziksel deneyin yerini otomatik olarak almaz. Ağ yalnız kendisine sunulan veri üzerinden ilişki öğrenir. Bu nedenle deney tasarımı zayıfsa model de zayıf olur.
İyi bir tasarım şu özellikleri taşımalıdır:
- faktör uzayını yeterince kapsamalı,
- etkileşimleri gözlemlemeye imkan vermeli,
- ölçüm gürültüsünü dikkate almalı,
- doğrulama için bağımsız deneyler içermeli.
Az sayıda örnekten çok sayıda kombinasyona kestirim yapmak güçlü bir varsayımdır. Modelin önerdiği optimum nokta bağımsız fiziksel deneyle doğrulanmalıdır.
8.3. Girdi ve Çıktı Tasarımı
Yedi faktörlü örnekte giriş vektörü:
x = [A, B, C, D, E, F, G]
şeklinde tanımlanabilir.
Çıkış ise sehim miktarıdır:
y = sehim
İki seviyeli faktörler 0/1, -1/+1 veya fiziksel değerleriyle gösterilebilir. Kullanılan kodlama eğitim ve kullanım aşamasında aynı olmalıdır.
8.4. Ağın Eğitilmesi
MLP eğitiminde amaç deney sonuçları ile ağ tahminleri arasındaki hatayı azaltmaktır. Eğitim hatasının sıfıra yaklaşması modelin doğru genelleme yaptığı anlamına gelmez.
Bu tür küçük veri problemlerinde özellikle:
- leave-one-out veya k-fold doğrulama,
- tekrarlı fiziksel deney,
- basit regresyon modelleriyle karşılaştırma,
- belirsizlik analizi
gereklidir.
8.5. Optimizasyon için Model Kullanımı
Model yeterince doğrulandıktan sonra aday proses ayarları ağ üzerinden taranabilir. En düşük tahmini kalite kaybını veren kombinasyon aday optimum olarak seçilebilir.
Ancak model yalnız veri dağılımının kapsadığı bölgelerde güvenilir kabul edilmelidir. Eğitim uzayının dışına çıkıldığında ağın ürettiği sayı fiziksel olarak anlamlı olmak zorunda değildir.
Bu yaklaşımın temel değeri, pahalı fiziksel deney sayısını azaltmak ve deney tasarımına yön vermektir.
Ünite 9: Rekabetçi Öğrenme, LVQ ve Örüntü Tanıma
9.1. LVQ Modelinin Amacı
Learning Vector Quantization, kısaca LVQ, prototip tabanlı öğretmenli bir sınıflandırma yöntemidir. Her sınıf giriş uzayında bir veya daha fazla referans vektörüyle temsil edilir.
Yeni örnek, kendisine en yakın prototipin sınıfına atanır.
Bu nedenle LVQ'nun temelinde iki fikir vardır:
- en yakın prototip ile sınıflandırma,
- prototiplerin etiketli eğitim verisine göre uyarlanması.
9.2. LVQ Ağının Yapısı
Bir LVQ sistemi kavramsal olarak şu bileşenlerden oluşur:
Girdi katmanı: Özellik vektörünü alır.
Rekabetçi katman: Prototip vektörlerini tutar ve en yakın prototipi belirler.
Sınıf eşleme katmanı: Kazanan prototipi sınıf etiketine dönüştürür.
Her prototip:
w_i = [w_i1, w_i2, ..., w_in]
şeklinde girişle aynı boyutta bir vektördür.
9.3. Uzaklık Hesabı
Klasik LVQ'da çoğunlukla Öklid uzaklığı kullanılır:
d_i = ||x - w_i||
Kazanan prototip:
c = argmin_i d_i
olarak seçilir.
Özelliklerin ölçekleri farklıysa uzaklık hesabı bozulabilir. Bu nedenle LVQ öncesinde normalizasyon veya standardizasyon önemlidir.
9.4. LVQ1 Öğrenme Kuralı
Kazanan prototip doğru sınıfa aitse girişe yaklaştırılır:
w_c(t+1) = w_c(t) + alpha(t) * (x - w_c(t))
Kazanan prototip yanlış sınıfa aitse girişten uzaklaştırılır:
w_c(t+1) = w_c(t) - alpha(t) * (x - w_c(t))
Diğer prototipler değiştirilmez.
Öğrenme katsayısı alpha(t) zamanla azaltılabilir.
9.5. Karar Bölgeleri
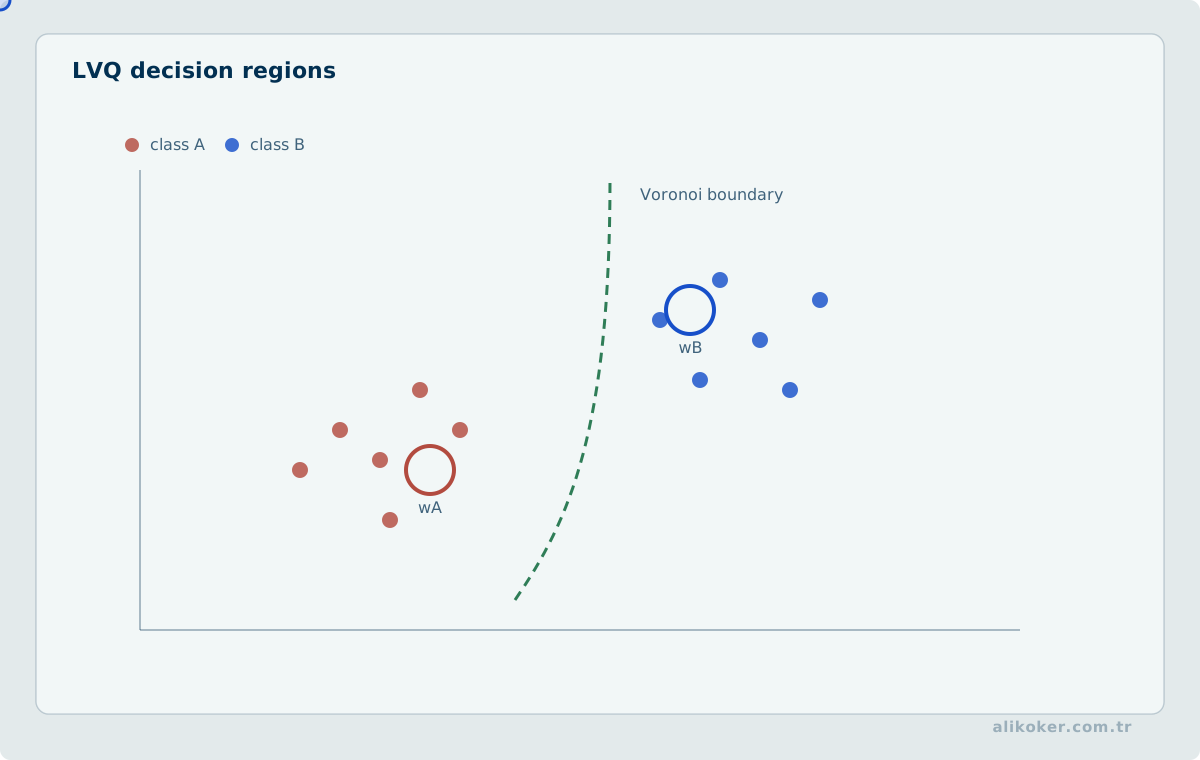
Her prototip giriş uzayında bir Voronoi bölgesi oluşturur. Sınıf sınırları komşu prototiplerin konumlarıyla belirlenir.
Bu yapı LVQ'yu yorumlanabilir kılar. Prototipler gerçek özellik uzayında bulunduğu için sınıfın tipik temsilcileri olarak incelenebilir.
9.6. LVQ2 ve Sınır Düzeltme
LVQ2 ailesi özellikle sınıf sınırına yakın örneklerde iki prototipi birlikte günceller. Doğru sınıfa ait prototip girişe yaklaştırılırken yanlış sınıfa ait prototip uzaklaştırılır.
Amaç sınıf sınırlarını daha iyi konumlandırmaktır.
LVQ2.1 ve LVQ3 gibi varyantlar güncelleme koşullarını değiştirerek kararlılığı ve sınıf sınırı temsilini iyileştirmeye çalışır.
9.7. Cezalandırılmış LVQ
Rekabetçi öğrenmede bazı prototipler sürekli kazanırken bazıları hiç güncellenmeyebilir. Cezalandırma mekanizmaları aşırı kazanan prototiplerin avantajını azaltarak kullanılmayan prototiplere öğrenme şansı vermeyi amaçlar.
Bu fikir rekabetçi öğrenmede prototip kullanımını dengelemeye yöneliktir.
9.8. LVQ-X
LVQ-X, her iterasyonda global ve sınıf içi yerel kazananı birlikte ele alan bir LVQ varyantıdır.
Global kazanan, giriş vektörüne bütün prototipler içinde en yakın olandır.
Yerel kazanan, doğru sınıfa ait prototipler içinde girişe en yakın olandır.
Global kazanan yanlış sınıftaysa bu prototip girişten uzaklaştırılır. Aynı anda doğru sınıftaki yerel kazanan girişe yaklaştırılır. İki kazanan aynı prototipse yalnız bu prototip girişe yaklaştırılır.
Yaklaşımın amacı yanlış sınıf prototipini karar bölgesinden uzaklaştırırken doğru sınıf prototipini aynı örneğe doğru çekmektir.
9.9. LVQ'nun Güçlü ve Zayıf Yönleri
Güçlü yönleri:
- basit karar mekanizması,
- prototiplerin yorumlanabilir olması,
- düşük çıkarım maliyeti,
- doğrusal olmayan sınıf sınırları oluşturabilmesi.
Sınırlılıkları:
- uzaklık metriğine duyarlılık,
- ölçeklendirme gereksinimi,
- prototip sayısının önceden seçilmesi,
- yüksek boyutta Öklid uzaklığının anlamını kaybedebilmesi,
- karmaşık temsilleri kendiliğinden öğrenememesi.
Güncel derin öğrenmede özellikler çoğu zaman ayrı bir ağla öğrenilir. LVQ ise özellikle prototip tabanlı sınıflandırma ve yorumlanabilir modelleme açısından öğretici önem taşır.
9.10. LVQ ile Kalite Kontrol Uygulaması
9.11. İstatistiksel Kalite Kontrol Problemi
İstatistiksel proses kontrolünde amaç yalnız hatalı ürünü ayırmak değil, prosesin olağan dışı davranmaya başladığını erken belirlemektir.
Bir kalite karakteristiğinin zaman içindeki değerleri kontrol grafiğinde izlenebilir. Süreçteki özel nedenler farklı örüntüler oluşturabilir:
- ortalama kayması,
- artan veya azalan trend,
- çevrimsel davranış,
- sistematik değişim,
- olağan dışı varyans.
Bu örüntülerin otomatik tanınması bir sınıflandırma problemine dönüştürülebilir.
9.12. Örnek Vektörlerinin Oluşturulması
Kontrol grafiğinden ardışık n ölçüm alınarak bir giriş vektörü oluşturulabilir:
x = [x1, x2, ..., xn]
Her vektör bilinen bir proses durumuyla etiketlenir.
Örnek sınıflar:
- normal,
- yukarı trend,
- aşağı trend,
- yukarı kayma,
- aşağı kayma.
LVQ prototipleri bu sınıfların tipik şekillerini temsil edecek biçimde öğrenir.
9.13. Eğitim
Eğitim sürecinde her kontrol örüntüsü ağa verilir. En yakın prototip bulunur. Prototipin sınıfına göre yaklaştırma veya uzaklaştırma işlemi uygulanır.
Eğitimin sonunda yeni bir örüntü en yakın prototipe göre sınıflandırılır.
9.14. Değerlendirme
Bir örüntü tanıma sisteminde yalnız eğitim başarımı ölçülmemelidir. Karışıklık matrisi üzerinden hangi proses bozukluklarının birbirine karıştırıldığı incelenmelidir.
Özellikle erken arıza belirlemede iki hata farklı maliyet taşır:
- yanlış alarm,
- gerçek bozukluğu kaçırma.
Bu nedenle precision, recall ve sınıf bazlı hata oranları önemlidir.
9.15. Güncel Yaklaşım
LVQ düşük boyutlu ve önceden çıkarılmış özelliklerde kullanılabilir. Daha karmaşık sensör dizilerinde CNN, recurrent ağ veya Transformer tabanlı zaman serisi modelleri tercih edilebilir.
Yine de problem kurma biçimi değişmez:
- Süreç durumlarını tanımla.
- Gözlem penceresini oluştur.
- Eğitim ve test verisini ayır.
- Modeli eğit.
- Yanlış alarm ve kaçırma maliyetlerini ölç.
- Gerçek üretim koşullarında doğrula.
9.16. Prototip Sınıflayıcının Uzaklık ve Marj Sınırları
LVQ'da her prototipin sınıf etiketi vardır ve tahmin, seçilen uzaklık ölçüsüne göre en yakın temsil üzerinden verilir. Öklid uzaklığında farklı ölçekli özellikler prototip seçimini tek başına belirleyebilir; bu nedenle eğitim bölmesinden öğrenilen standardizasyon veya problem temelli uzaklık matrisi gerekir. Sınıra yakın bir doğru-yanlış prototip çifti öğrenmeye dahil edildiğinde, marj yönetimi önem kazanır; ancak ayarlanmış pencere oranı yalnız doğrulama bölmesinde seçilmelidir.
Örneğin tek boyutlu sınıf A prototipi 0, B prototipi 4 ve sorgu x=1.5 olsun: uzaklıklar sırasıyla 1.5 ve 2.5 olduğundan A seçilir. x=2 sınırında eşit uzaklık oluşur ve bağlayıcı seçim kuralı açıklanmalıdır. Başarı oranı yüksek olsa bile prototiplerin veriyi temsil ettiği bölgeler ve yanlış sınıfa yakınlıklar ayrıca incelenmelidir.
Ünite 10: Adaptif Rezonans Teorisi ve Grup Teknolojisi
10.1. Kararlılık ve Plastisite Problemi
Öğretmensiz öğrenmede önemli sorunlardan biri yeni bilgiyi öğrenirken eski bilgiyi korumaktır.
Sistem çok plastikse yeni örnekler eski sınıfları sürekli değiştirir.
Sistem çok kararlıysa yeni örüntüleri öğrenemez.
Bu gerilim stability-plasticity dilemma olarak bilinir.
Adaptive Resonance Theory, yani ART, bu probleme yönelik bir sinir ağı ailesidir.
10.2. ART'nin Temel Yaklaşımı
ART ağı yeni girdiyi mevcut kategorilerle karşılaştırır.
Yeterli benzerlik varsa girdi mevcut kategoriye atanır ve kategori prototipi güncellenir.
Benzerlik yetersizse mevcut aday reddedilir ve başka kategori aranır. Uygun kategori bulunamazsa yeni kategori oluşturulur.
Bu davranışta vigilance parametresi kritik rol oynar.
Yüksek vigilance daha ince sınıflar üretir.
Düşük vigilance daha geniş örüntüleri aynı sınıfta birleştirir.
10.3. F1 ve F2 Katmanları
Klasik ART mimarisinde iki temel katman vardır.
F1 karşılaştırma katmanı, giriş örüntüsünü ve üstten gelen kategori beklentisini karşılaştırır.
F2 tanıma katmanı, kategori birimlerini içerir. Birimler rekabet eder ve kazanan kategori belirlenir.
F1 ile F2 arasında aşağıdan yukarı ve yukarıdan aşağı bağlantılar bulunur.
10.4. Rezonans ve Reset
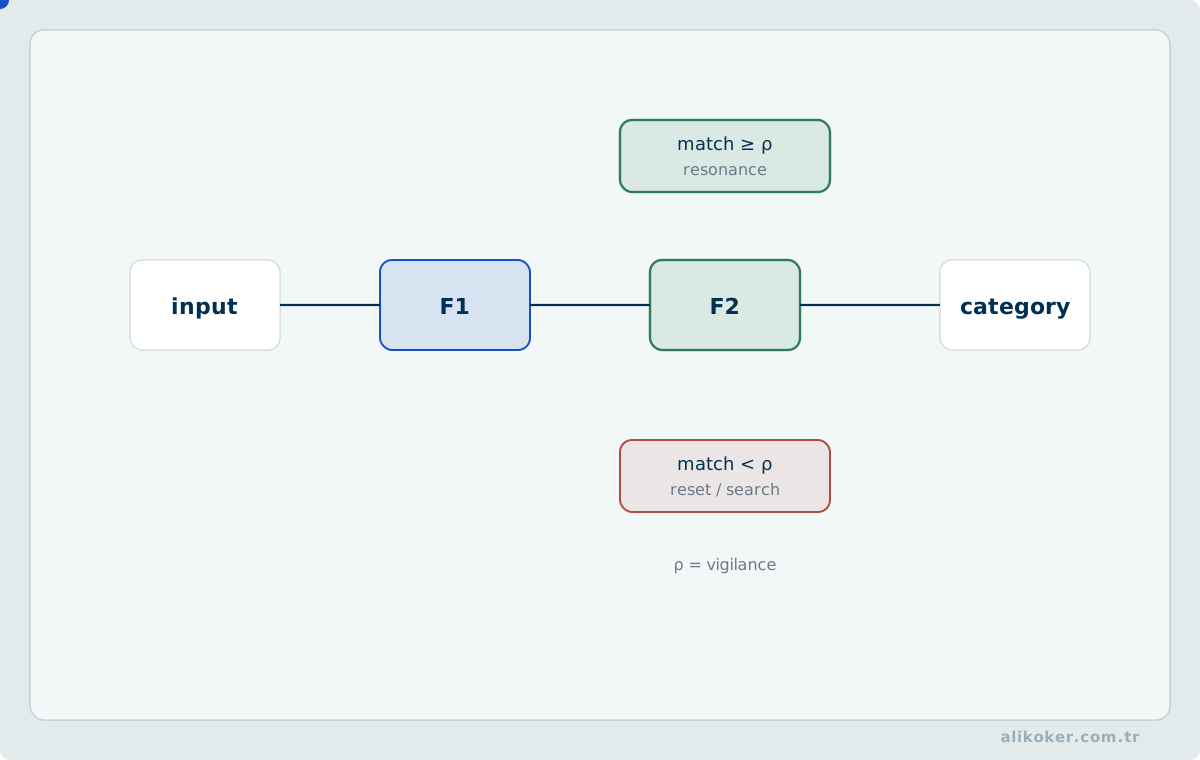
Kazanan kategori girdiyi yeterince iyi açıklıyorsa sistem rezonans durumuna geçer. Ağırlıklar güncellenir.
Benzerlik vigilance eşiğinin altındaysa reset mekanizması bu kategoriyi geçici olarak devre dışı bırakır. Ağ sonraki en uygun kategoriyi dener.
Bu çevrim uygun kategori bulunana veya yeni kategori oluşturulana kadar devam eder.
10.5. ART1
ART1 ikili giriş örüntüleri için geliştirilmiştir.
Girdi:
x in {0,1}^n
şeklindedir.
Kategori benzerliği ortak etkin bitlerin miktarı üzerinden değerlendirilebilir. Kavramsal vigilance koşulu:
match(x, w_j) >= rho
biçimindedir.
rho vigilance parametresidir.
ART1'in amacı benzer ikili örüntüleri çevrim içi biçimde kategorilere ayırmaktır.
10.6. ART2
ART2 sürekli değerli girişler için geliştirilmiştir. Girdi normalizasyonu ve daha ayrıntılı F1 dinamikleri kullanır.
Temel prensip yine aynıdır:
- Girdiyi al.
- Mevcut kategorilerle karşılaştır.
- En uygun kategoriyi seç.
- Vigilance koşulunu sınar.
- Uygunsa öğren.
- Değilse kategoriyi resetle ve yeniden ara.
10.7. ART Ağlarının Özellikleri
ART ailesinin güçlü yönleri:
- çevrim içi kategori oluşturabilme,
- yeni örüntülere uyum,
- mevcut kategorileri tamamen unutmadan öğrenme amacı,
- küme sayısının baştan kesin bilinmesini gerektirmemesi.
Sınırlılıkları:
- vigilance parametresine yüksek duyarlılık,
- örnek sırasına duyarlılık,
- modern yüksek boyutlu temsillerde doğrudan kullanımın sınırlı olması.
ART günümüzde derin öğrenmenin ana akım mimarilerinden biri değildir. Ancak çevrim içi öğrenme, kategori oluşumu ve catastrophic forgetting problemini anlamak için önemlidir.
10.8. ART1 ile Grup Teknolojisi Uygulaması
10.9. Grup Teknolojisi
Grup teknolojisi, benzer üretim gereksinimlerine sahip parçaları ve bu parçaları işleyen makineleri hücreler halinde düzenlemeyi amaçlar.
Amaçlar:
- parça taşıma mesafesini azaltmak,
- ara stokları azaltmak,
- makine kullanımını düzenlemek,
- üretim akışını sadeleştirmek.
Problem ikili makine-parça matrisiyle gösterilebilir.
a_ij = 1 ise parça j, makine i üzerinde işlem görür.
a_ij = 0 ise görmez.
10.10. ART1 ile Sınıflandırma
Her makine, işlediği parçaları gösteren ikili vektörle temsil edilebilir.
Örnek:
M1 = [1, 1, 0, 0, 1]
M2 = [1, 1, 0, 0, 0]
M3 = [0, 0, 1, 1, 0]
ART1 benzer işlem profillerine sahip makineleri aynı kategoriye yerleştirebilir.
Bu kategoriler üretim hücreleri için aday gruplar oluşturur.
10.11. İteratif Çalışma
Her giriş vektörü için:
- En uygun mevcut kategori belirlenir.
- Eşleşme vigilance eşiğiyle karşılaştırılır.
- Eşik sağlanırsa kategori prototipi güncellenir.
- Sağlanmazsa kategori reddedilir.
- Başka kategori denenir veya yeni kategori açılır.
Örnekler ağa tekrar sunulduğunda kategoriler kararlı hale gelebilir.
10.12. Mühendislik Değerlendirmesi
Yalnız sınıflandırma sonucu üretim sistemi için yeterli değildir. Hücre tasarımında ayrıca:
- makine kapasitesi,
- operasyon sırası,
- üretim hacmi,
- taşıma maliyeti,
- darboğazlar,
- bakım planları
gibi kısıtlar bulunur.
Bu nedenle ART1 sınıflandırması karar destek girdisi olarak düşünülebilir. Nihai üretim hücresi tasarımı çok ölçütlü bir optimizasyon problemidir.
10.13. ART'de Kararlılık–Plastisite ve Sıra Duyarlılığı
ART ailesinde yeni örneği var olan kategoriye kabul etme kararı, eşleşme ve vigilance parametresinin birlikte belirlediği bir eşik problemidir. Çok yüksek vigilance, veriyi gereksiz sayıda kategoriye bölebilir; çok düşük değer ayrım gücünü düşürebilir. Kategori oluşumunun gözlem sırasına bağımlılığı ve gürültü altında çoğalması raporlanmalıdır. ART1 ikili girdi varsayımlarıyla, sürekli girdilere yönelik varyantlar ise farklı temsil ve normalizasyon koşullarıyla değerlendirilir.
Grup teknolojisi örneğinde bir parçanın kategorisini değiştiren tek ölçüm hatasını bütün sisteme yeni sınıf olarak eklemek yerine, girdi koşulunu ve eşleşme eşiğini incelemek daha güvenilir sonuç verir. Bu yaklaşım modern gömülü temsil öğrenmenin genel alternatifi değil, belirli çevrim içi sınıflandırma gereksinimlerinin tarihsel ve algoritmik çözümüdür.
Ünite 11: Zamansal Öğrenme, Elman, LSTM ve GRU
Bu ünite, gizli durumun zaman boyunca taşınmasını ve paylaşılan parametrelerle ardışık verinin modellenmesini ele alır.
x(t-1) -> h(t-1) -> y(t-1)
            |
            v
x(t)   ->  h(t)   -> y(t)
            |
            v
x(t+1) -> h(t+1) -> y(t+1)

zaman boyunca açılım, paylaşılan parametreler
11.1. Geri Dönüşümlü Ağ Kavramı
İleri beslemeli ağda çıktı yalnız mevcut girdinin katmanlardan geçirilmesiyle hesaplanır. Zaman bağımlılığı doğrudan temsil edilmez.
Recurrent Neural Network, yani RNN, geçmiş durumu mevcut hesaplamaya dahil eder:
h_t = phi(W_x*x_t + W_h*h_(t-1) + b)
y_t = psi(W_y*h_t + c)
Burada h_t ağın zamana bağlı gizli durumudur.
Bu yapı dizisel verilerde belleğe benzer bir davranış sağlar.
11.2. Elman Ağı
Elman ağı kısmi geri beslemeli klasik RNN yapısıdır. Gizli katmanın bir önceki zamandaki çıktısı context unit adı verilen birimlerde tutulur ve bir sonraki adımda girişe eklenir.
Temel ilişki:
h_t = phi(W_x*x_t + W_c*h_(t-1) + b_h)
y_t = psi(W_y*h_t + b_y)
şeklindedir.
Bu nedenle ağın t anındaki çıktısı yalnız x_t girdisine değil, geçmişten taşınan h_(t-1) durumuna da bağlıdır.
11.3. Çalışma Prensibi
Her zaman adımında:
- Mevcut girdi alınır.
- Önceki gizli durum context girişine eklenir.
- Gizli katman hesaplanır.
- Çıktı üretilir.
- Yeni gizli durum bir sonraki zaman adımı için saklanır.
Başlangıç gizli durumu sıfır veya sabit bir değer olabilir.
11.4. Zaman Boyunca Geri Yayılım
RNN eğitiminde aynı ağ zaman ekseni boyunca açılmış gibi düşünülür. Kayıp gradyanı geçmiş adımlara doğru aktarılır. Bu yöntem Backpropagation Through Time, BPTT olarak bilinir.
Uzun dizilerde gradyanlar tekrar tekrar aynı tür Jacobian çarpımlarından geçtiği için küçülebilir veya büyüyebilir.
Bunlar:
- vanishing gradient,
- exploding gradient
problemleridir.
Gradient clipping büyüyen gradyanları sınırlamak için kullanılabilir.
11.5. LSTM, GRU, Attention ve Transformer
LSTM/GRU, attention ve Transformer tabanlı dizisel modelleme Ünite 11'de ayrıntılandırılır.
11.6. LSTM ve GRU
LSTM ve GRU recurrent ağların uzun dönemli bağımlılık sorununa yönelik kapılı yapılardır.
LSTM'de hücre durumu kontrollü bilgi yolu sağlar. GRU daha kompakt bir kapı yapısına sahiptir.
Bu modeller zaman serisi ve dizisel veriler için halen yararlı olabilir. Özellikle küçük veya çevrim içi sistemlerde recurrence doğrudan ve düşük gecikmeli bir durum modeli sunabilir.
11.7. Zaman Boyunca Türev Akışı ve Çevrim İçi Çıkarım
Bir geri dönüşümlü katmanda h_t = f(W_x x_t + W_h h_(t-1) + b) yazıldığında ∂h_t/∂h_(t-k) Jacobian çarpımlarından oluşur. Uzun dizilerde bu çarpımların normu küçülebilir veya büyüyebilir. Truncated BPTT, hesap grafiğini belirli adımlarda keserek maliyeti sınırlar; bunun bedeli kesilen sınırın öncesindeki tam türev bilgisinin kullanılmamasıdır. LSTM/GRU kapıları gradyan akışını düzenlemeye yardımcı olur, bütün uzun bağımlılık problemlerini kendiliğinden ortadan kaldırmaz.
Gerçek zamanlı kullanımda eğitim penceresi ile çıkarım durumu ayrı tanımlanmalıdır. İki farklı kişiye veya makine oturumuna ait dizilerin gizli durumlarının yanlışlıkla birleştirilmesi veri sızıntısıdır. Olay zaman damgası, örnek kaybı, yeniden sıralama ve durum sıfırlama politikası da modelin matematiksel tanımının parçasıdır.
Ünite 12: Çağrışımsal, Enerji Tabanlı ve Radyal Ağlar
12.1. Hopfield Ağı
Hopfield ağı tamamen bağlı recurrent bir ağdır. Klasik biçiminde simetrik ağırlıklarla çalışır ve bir enerji fonksiyonunu azaltan dinamik sistem olarak yorumlanabilir.
Temel kullanım alanı çağrışımsal bellektir. Eksik veya bozulmuş örüntü ağın kararlı durumlarından birine çekilebilir.
Hopfield ağları modern derin öğrenmenin ana mimarisi değildir. Ancak enerji tabanlı modeller ve çağrışımsal bellek açısından temel tarihsel öneme sahiptir.
12.2. Counterpropagation Ağı
Counterpropagation ağı rekabetçi Kohonen katmanı ile öğretmenli Grossberg çıkış katmanını birleştirir.
Kohonen katmanı giriş uzayında prototip seçimi yapar. Grossberg katmanı kazanan prototipi hedef çıktıyla eşler.
Bu yapı hızlı prototip tabanlı fonksiyon yaklaşımı olarak düşünülebilir.
12.3. Cognitron ve Neocognitron
Fukushima'nın Cognitron ve Neocognitron modelleri görsel örüntü tanıma tarihinde önemlidir.
Neocognitron yerel alıcı alanlar, hiyerarşik özellik çıkarımı ve konum değişimlerine karşı dayanıklılık fikirlerini kullanır. Bu kavramlar daha sonra modern convolutional neural network tasarımında merkezi hale gelmiştir.
12.4. Self-Organizing Map
Kohonen Self-Organizing Map, öğretmensiz rekabetçi öğrenme yöntemidir. Yüksek boyutlu veriyi genellikle iki boyutlu bir harita üzerinde topolojik komşuluğu mümkün olduğunca koruyarak temsil etmeye çalışır.
Kazanan nöron ve komşuları girdiye doğru güncellenir:
w_i <- w_i + alpha * h_ci * (x - w_i)
Burada h_ci kazanan nörona topolojik uzaklığa bağlı komşuluk fonksiyonudur.
SOM kümeleme, görselleştirme ve keşifsel veri analizi için öğretici önem taşır.
12.5. Radyal Tabanlı Ağlar
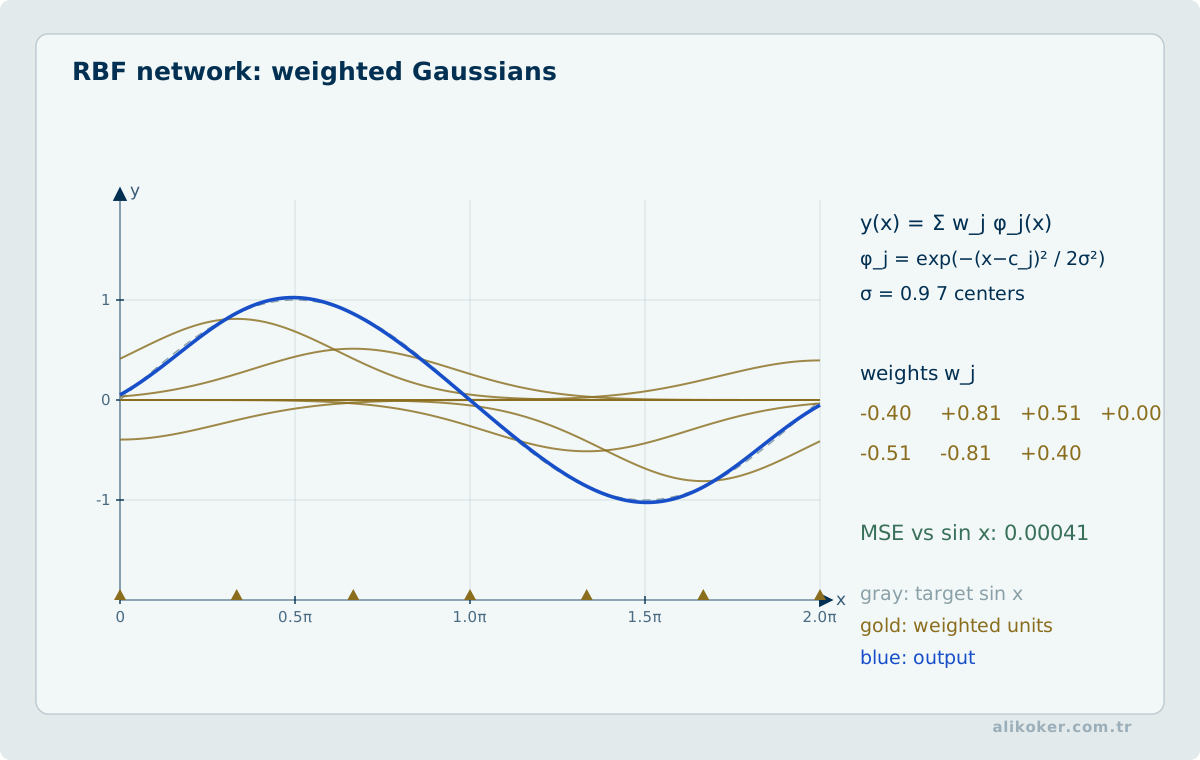
Radial Basis Function Network gizli katmanda giriş ile merkezler arasındaki uzaklığa bağlı aktivasyonlar kullanır.
Gaussian RBF için:
phi_i(x) = exp(-||x-c_i||^2 / (2*sigma_i^2))
Çıkış genellikle bu taban fonksiyonlarının doğrusal birleşimidir.
RBF ağları yerel yaklaşım özellikleri nedeniyle regresyon ve sınıflandırmada kullanılabilir.
12.6. Olasılıksal Sinir Ağları
Probabilistic Neural Network sınıf koşullu yoğunluk kestirimi ve Bayes karar kuralıyla ilişkilidir. Eğitim hızlı olabilir ancak örnek sayısı büyüdükçe çıkarım maliyeti artabilir.
12.7. Boltzmann Makineleri
Boltzmann machine stokastik, enerji tabanlı bir ağ ailesidir. Restricted Boltzmann Machine görünür ve gizli birimler arasında iki parçalı bağlantı yapısı kullanarak öğrenmeyi daha yönetilebilir hale getirir.
Derin öğrenmenin erken dönem yeniden canlanmasında RBM ve Deep Belief Network çalışmaları etkili olmuştur. Güncel büyük ölçekli sistemlerde ise ana akım model ailesi değildir.
Ünite 13: Evrişimli Sinir Ağları ve Görsel Temsil
13.1. Convolutional Neural Network
CNN, görüntü gibi düzenli ızgara verilerinde yerel bağlantı ve ağırlık paylaşımı kullanır.
Bir filtre aynı ağırlıklarla farklı uzamsal konumlarda uygulanır. Böylece parametre sayısı tam bağlı katmana göre azalır ve yerel örüntüler öğrenilebilir.
Modern CNN mimarilerinde:
- convolution,
- nonlinear activation,
- normalleştirme,
- residual connection,
- downsampling
gibi yapılar birlikte kullanılabilir.
ResNet, residual bağlantı kullanarak çok derin ağların optimizasyonunu kolaylaştırmıştır.
Sinir ağında parametre sayısını yalnız katman sayısından çıkarmak yanıltıcıdır. Giriş ve çıkış kanalları sırasıyla 8 ve 16 olan, 3×3 çekirdekli standart bir evrişim katmanı 3×3×8×16=1.152 ağırlık ve kanal başına bias kullanılırsa 16 ek parametre taşır. Aynı katmanın uzamsal işlem sayısı ise çıktı genişliği ve yüksekliğiyle büyür. Bu yüzden parametre belleği ile hesaplama maliyeti ayrı raporlanmalıdır. Derinlikçe ayrılabilir evrişim daha az çarpım gerektirebilir; gerçek çalışma süresi bellek erişimi, çekirdek başlatma maliyeti ve donanıma da bağlıdır.
13.2. Evrişimin Boyutları, Parametre Paylaşımı ve Maliyeti
Bir evrişim katmanında giriş H×W×C_in, çekirdek k_h×k_w, adım s, padding p ve çıkış kanalı C_out olsun. Dilation bir ise çıktı yüksekliği floor((H+2p-k_h)/s)+1, genişlik için benzer formüldür. Öğrenilebilir parametre sayısı, bias kullanıldığında (k_h*k_w*C_in + 1)*C_out olur; görüntü piksellerinin sayısıyla doğrusal artmaz. 32×32×3 girişe, 3×3, s=1, p=1 ve 16 çıktı kanalı uygulandığında çıktı 32×32×16, parametre sayısı (27+1)*16 = 448 olur.
Yerel alıcı alan ve paylaşılan çekirdek, uzamsal yapıya ilişkin yararlı bir tümevarımsal önyargıdır; nesnenin her dönüşümüne otomatik dayanıklılık sağlamaz. Padding, dönüşüm artırma, örnekleme, receptive-field büyüklüğü ve etiketin mekânsal karşılığı ayrı değerlendirilmelidir. Görüntü sınıflamasındaki iyi sonuç, küçük nesne tespiti veya yoğun piksel segmentasyonuna doğrudan taşınamaz.
13.3. Özellik Aktarımı ve Katmanların Uyarlanması
Önceden öğrenilmiş görsel temsil, yeni bir veri kümesinde iki ayrı biçimde kullanılabilir. Özellik çıkarımında omurga katmanlarının ağırlıkları sabit tutulur; yalnız görev başlığı eğitilir. İnce ayarda seçilen omurga katmanları da hedef veriye göre güncellenir. Küçük ve etiket bakımından sınırlı veri kümelerinde önce yalnız başlığın eğitilmesi, ardından gerekirse son katmanların daha düşük öğrenme oranıyla açılması aşırı uyum riskini sınırlayabilir; her görev için üstün olduğu varsayılamaz.
Girişin renk uzayı, kanal normalizasyonu ve çözünürlüğü ön eğitimdeki varsayımlarla uyumlu olmalıdır. Veri artırma, sınıf etiketini değiştirmeyen dönüşümlerle sınırlanır; yön, ölçek veya mekânsal konumun etiketin parçası olduğu görevlerde rastgele dönüşümler geçersiz örnek üretebilir. Katman açma stratejisi, öğrenme eğrileri ve ayrı bir doğrulama kümesi üzerinden değerlendirilir.
13.4. Görsel Görevlerin Çıktı Uzayları
Sınıflandırma görüntüye bir veya birden çok sınıf atar. Nesne tespiti sınıfla birlikte sınırlayıcı kutu üretir. Anlamsal bölütleme her piksele sınıf etiketi verir; aynı sınıftaki farklı nesneleri ayırmaz. Örnek bölütleme her nesneye ayrı maske atar. Panoptik bölütleme, sayılabilir nesne örnekleriyle arka plan bölgelerinin etiketlerini tek ve tutarlı piksel haritasında birleştirir.
Sınıflandırma kaybının nesne tespitine doğrudan uygulanması yeterli değildir. Tespit modelinin sınıf ve konum kayıpları; bölütleme modelinin piksel sınıflandırma ve bölge örtüşmesi kayıpları farklı hedefler taşır. Seyrek nesneler veya küçük ön plan bölgeleri içeren veride salt piksel doğruluğu, arka planın baskınlığı nedeniyle yanıltıcı olabilir. Sınıf ağırlıkları, örnekleme ve uygun kayıp seçimi veri dağılımına göre sınanmalıdır.
13.5. Nesne Tespiti ve Bölütlemede Ölçüm
İki bölgenin kesişim/birleşim oranı IoU = |A ∩ B| / |A ∪ B| olarak tanımlanır. Bölütlemede başka bir örtüşme ölçüsü 2|A ∩ B| / (|A| + |B|) biçimindedir. Her iki ifade de boş bölge ve boş tahmin birlikte ortaya çıktığında önceden belirlenmiş bir değerlendirme kuralı gerektirir.
Nesne tespitinde tahmin–referans eşleştirmesi bir IoU eşiği ve sınıf koşuluyla yapılır. Precision, eşleşen tahminlerin tüm pozitif tahminlere; recall, bulunan referans nesnelerin tüm referans nesnelere oranıdır. Ortalama hassasiyet, güven skoru boyunca oluşan precision–recall eğrisinin özetidir; farklı IoU eşiklerinde ortalama alınırken eşik kümesi açıkça belirtilmelidir. Bölütleme için piksel veya sınıf temelli IoU, nesne tespitindeki kutu temelli sonuçla birbirinin yerine kullanılmaz.
Ünite 14: Attention, Transformer ve Kendinden Öğretimli Öğrenme
Transformer, yapay sinir ağlarından ayrı bir paradigma değildir. Attention, doğrusal dönüşümler, normalizasyon ve ileri beslemeli ağ bloklarından oluşan eğitilebilir sinir ağı mimarisidir.
token representations
      |
self-attention
      |
feed-forward network
      |
next layer
Bu nedenle “sinir ağlarından LLM'lere geçildi” ifadesi tarihsel olarak yanıltıcı olabilir. LLM'lerin büyük bölümü yapay sinir ağlarının Transformer tabanlı büyük ölçekli uygulamalarıdır.
14.1. Attention
Attention mekanizması bir sorgunun diğer temsillerden hangilerine ne ölçüde bakacağını öğrenir.
Scaled dot-product attention temel olarak:
Attention(Q,K,V) = softmax(QK^T / sqrt(d_k)) V
şeklindedir.
Bu mekanizma uzun mesafeli bağımlılıkların doğrudan modellenmesine imkan verir.
14.2. Transformer
Transformer, recurrence yerine self-attention ve feed-forward katmanları kullanır.
Temel bileşenleri:
- token veya patch embedding,
- positional information,
- multi-head attention,
- feed-forward network,
- residual connection,
- normalleştirme.
Transformer mimarisi doğal dil işleme ile başlamış, daha sonra görüntü, ses, zaman serisi ve çok modlu modellemeye yayılmıştır.
14.3. Kendinden Öğretmenli Temsil Öğrenme
Büyük etiketli veri kümeleri pahalıdır. Kendinden öğretmenli öğrenme hedefi verinin kendisinden üretir.
Örnek hedefler:
- maskelenmiş parçayı tahmin etmek,
- sonraki tokenı tahmin etmek,
- farklı görünümlerin aynı örneğe ait olduğunu öğrenmek.
Bu yaklaşım büyük modellerin çok büyük etiketsiz veri üzerinde ön eğitim almasını sağlar.
14.4. Attention Karmaşıklığı ve Mimari Tercih
Tam self-attention, n token için her başta bir n×n ağırlık matrisi oluşturur. Hesaplama, projeksiyonlar dışında yaklaşık O(n²d), attention matrisinin belleği O(n²) mertebesindedir. Bu nedenle uzun dizi problemlerinde pencereleme, akış sırasında durum özetleme, bloklu hesaplama veya yaklaşık attention gibi yöntemler değerlendirilebilir; bunlar bilgi erişim desenini değiştirir ve doğruluk–bellek–gecikme takası doğurur.
Tek bir mimarinin üstünlüğü yalnız parametre sayısıyla belirlenmez. CNN yerel ve düzenli ızgara verilerinde, RNN sınırlı durumu sürdüren akışlarda, Transformer ise öğeler arası esnek ilişkilerde farklı avantajlara sahiptir. Verinin zaman/sıra/geometri yapısı ile hedef cihaz üzerindeki ölçülen maliyet birlikte belirleyici olmalıdır.
Ünite 15: Üretken Öğrenme: Otokodlayıcı, GAN ve Difüzyon
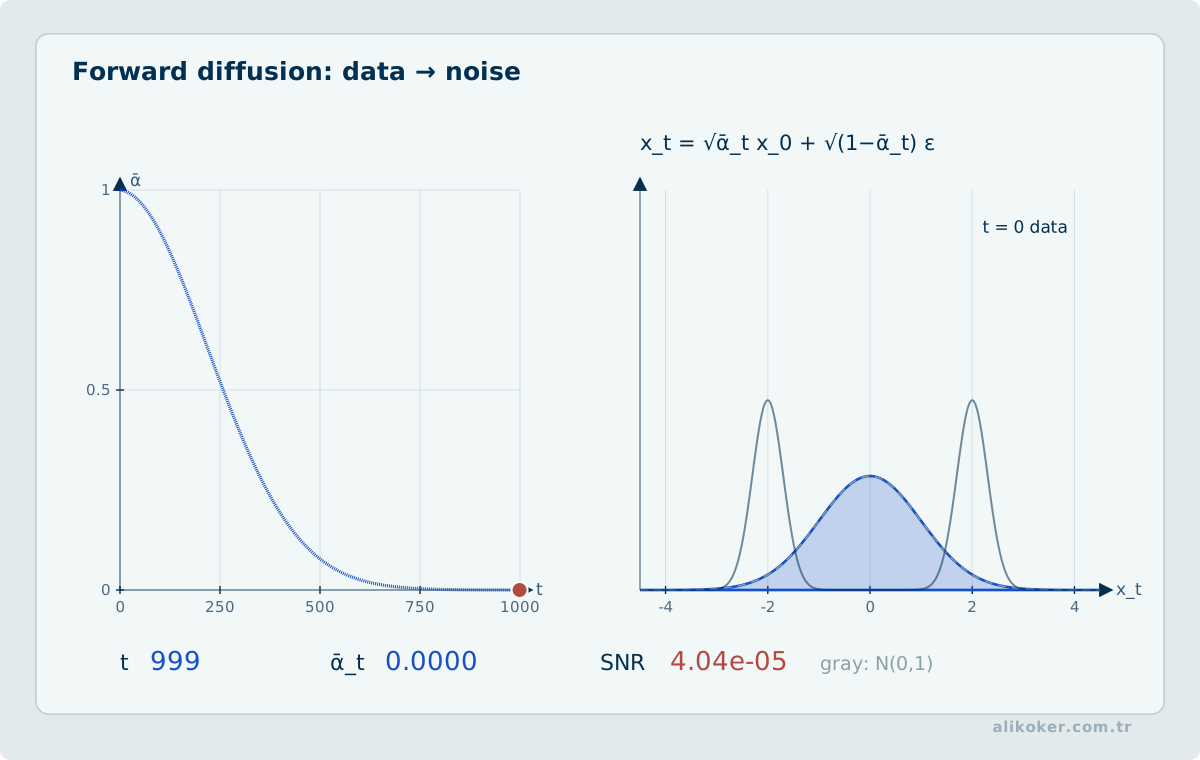
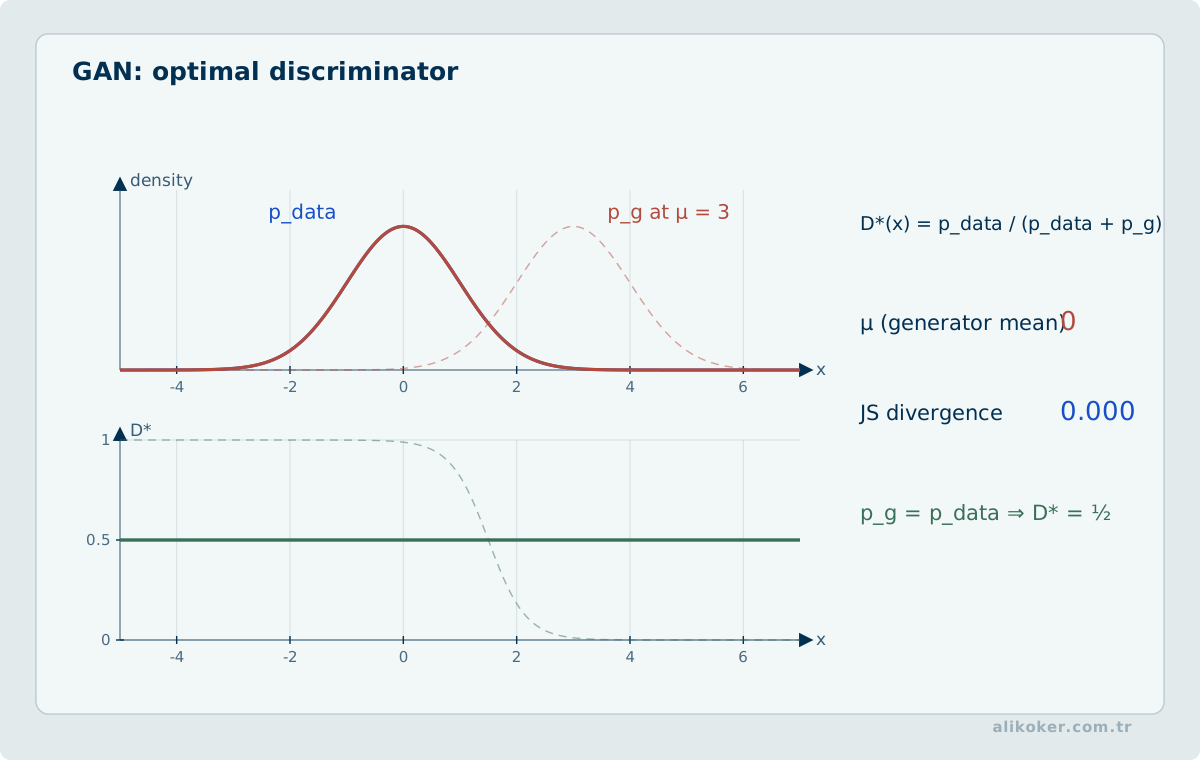
Üretken modeller yalnız büyük dil modellerinden oluşmaz. Yapay sinir ağlarının tarihsel gelişiminde VAE, GAN, difüzyon ve otoregresif Transformer farklı üretim varsayımları geliştirmiştir.
15.1. Varyasyonel Otokodlayıcı
VAE, veriyi olasılıksal bir gizil uzaya kodlayıp bu uzaydan örnek üretir.
x
 |
Encoder
 |
q(z|x)
 |
 z
 |
Decoder
 |
x'
Kayıp yalnız yeniden oluşturma hatasından oluşmaz; gizil dağılımın düzenli bir prior'a yakınlaşmasını teşvik eden terim de bulunur. Böylece gizil uzayda örnekleme yapılabilir.
15.2. Üretici Çekişmeli Ağ
GAN iki ağın rekabetine dayanır.
noise -> Generator -> fake sample
                       |
real sample ------------+--> Discriminator
Üretici gerçekçi örnek üretmeye, ayırt edici gerçek ve üretilmiş örneği ayırmaya çalışır. Eğitim dinamiği güçlü sonuçlar üretebilir ancak kararsızlık ve mode collapse gibi sorunlar doğurabilir.
15.3. Difüzyon Modelleri
Difüzyon yaklaşımı veriye kademeli gürültü ekleyen ileri süreç ile gürültüden veri yapısını geri kurmayı öğrenen ters süreci kullanır.
data -> noise -> noise -> ...
                    |
                    v
              learned reverse
                    |
                  sample
Örnek üretim çoğu zaman birden fazla denoising adımı gerektirir.
15.4. Otoregresif Transformer
Dil modelinde üretim:
x1 -> x2 -> x3 -> x4 ...biçiminde koşullu olasılıkla ilerler.
Bu aileleri tek “üretken yapay zekâ” etiketi altında toplamak mümkündür; ancak eğitim hedefi, örnekleme maliyeti, veri kipleri ve hata türleri farklıdır.
15.5. Autoencoder
Autoencoder girdiyi sıkıştırılmış bir temsil üzerinden yeniden oluşturmaya çalışır.
z = encoder(x)
xhat = decoder(z)
Amaç:
xhat ~= x
olmasıdır.
Autoencoder boyut indirgeme, temsil öğrenme, anomali belirleme ve generative modelleme için temel bir yapıdır.
15.6. Generative Adversarial Network
GAN iki ağın karşıt amaçlarla eğitildiği generative modeldir.
Generator gerçek veri dağılımına benzeyen örnekler üretir.
Discriminator gerçek ve üretilmiş örnekleri ayırt etmeye çalışır.
İki model minimax oyun içinde birlikte gelişir.
GAN'ler yüksek kaliteli sentez üretmiş olsa da eğitim kararsızlığı ve mode collapse gibi sorunlar yaşayabilir.
15.7. Diffusion Modelleri
Diffusion modelleri veriye kademeli gürültü ekleyen bir ileri süreç ve bu gürültüyü öğrenerek tersine çeviren bir üretim süreci kullanır.
Görüntü ve ses üretiminde güçlü generative model ailesi haline gelmiştir.
Temel fikir, karmaşık veri dağılımından doğrudan örneklemek yerine gürültü giderme adımlarını öğrenmektir.
15.8. Üretken Modelin Hedef Fonksiyonu ile Örnek Kalitesi
Varyasyonel otokodlayıcıda eğitim, yeniden kurma terimi ile yaklaşık posteriorun önsel dağılıma uzaklığını dengeler; bu denge latent temsili ve örnek çeşitliliğini etkiler. GAN'da üreteç ile ayırt edici ortak bir tek minimizasyon adımı yerine karşılıklı güncellemelerle öğrenir; mode collapse, bazı veri örüntülerinin hiç üretilememesi anlamına gelir. Difüzyon yaklaşımında ise farklı gürültü düzeyleri üzerinde ters süreci öğrenmek, örnekleme sırasında çok adımlı maliyet oluşturabilir.
Bir üretken modeli yalnız birkaç görsel örneğin etkileyiciliğine göre değerlendirmek doğru değildir. Kapsama/çeşitlilik, eğitim verisini yeniden üretme riski, örnekleme süresi, enerji tüketimi ve görev odaklı ölçütler aynı veri bölmeleri üzerinde ele alınmalıdır. Üretken ağın yakın benzer bir eğitim örneği üretmesi, genellemenin kanıtı değildir.
Ünite 16: Graf Sinir Ağları, Tensör Ağları ve Kuantum-Esinli Temsiller
16.1. Graf Sinir Ağlarında Mesaj Geçirme ve Komşuluk Normalizasyonu
Düğümler arası ilişki açık olduğunda bir katman h_v^(l+1) = σ(W_self h_v^l + AGG_{u∈N(v)} W_msg h_u^l) biçiminde düşünülebilir. Komşu katkısının toplam, ortalama veya öğrenilir ağırlıkla birleştirilmesi farklı derece dağılımlarında farklı davranış üretir. Basit bir komşuluk ortalamasında düğümlerin kendi değerleri de ekleniyorsa dört düğümlü 1–2, 1–3, 3–4 grafında başlangıç özellikleri (1,0,0,1) için 1. düğüm (1+0+0)/3=1/3, 3. düğüm (0+1+1)/3=2/3 değerini alır. Öğrenilebilir dönüşüm içermeyen bu işlem tek başına sınıflayıcı değildir; ilişkisel bilginin aktarımını gösterir.
Katman sayısı büyüdükçe bağlantılı bileşen içindeki temsiller birbirine yaklaşabilir (over-smoothing). Grafik komşuluklarını eğitim ve test arasında yanlış paylaşmak da bağlantı tahmininde sızıntı oluşturabilir. Düğüm, kenar ve tüm grafik düzeyindeki problemler, ayırma birimleri ve başlangıç karşılaştırıcıları ayrı seçilmelidir.
16.2. Tensör Ayrışımı ve kuantum-esinli Klasik Modeller
Bir 4×4×4×4 tensör tam saklandığında 256 skaler gerektirir. Tensor-train ayrışımında ara bağ boyutları 2 seçilirse çekirdek boyutları 1×4×2, 2×4×2, 2×4×2, 2×4×1 olur; toplam 8+16+16+8=48 skaler kullanılır. Azalan saklama maliyeti, düşük-rank varsayımına bağlı bir yaklaşım hatasını beraberinde getirebilir. Gerçek hızlanma için çekirdeklerin kasılma maliyeti ve cihazın bellek erişimi de ölçülmelidir.
Kuantum-esinli ağ, klasik bilgisayarda kuantum matematiğinden hareketle tasarlanmış bir temsil veya arama yöntemi olabilir. Fiziksel kübitler, kuantum ölçüm veya doğrulanmış kuantum üstünlüğü gerektirmez. Kuantum donanımlı varyasyonel devre ise ölçüm ve örnekleme maliyetine tabidir. Her iki aile için de aynı görev, aynı veri erişimi, güçlü klasik baseline ve uçtan uca kaynak maliyeti üzerinden ölçüm yapılmadıkça üstünlük iddiası kurulamaz. Konunun fiziksel temelleri Kuantum Bilgisayarlar dersinde ayrıntılanır.
Ünite 17: Model Küçültme, Yazılım ve Üretime Alma
Üretimde yalnız doğruluk değil bellek, gecikme ve enerji de önemlidir.
Budama (pruning) düşük katkılı ağırlık veya yapıların çıkarılmasıdır.
Damıtma (distillation) büyük öğretmen modelin davranışını küçük öğrenci modele aktarmaya çalışır.
Nicemleme (quantization) sayısal gösterim hassasiyetini düşürür.
Training / Model
    |
    +--> pruning
    +--> distillation
    +--> quantization
    |
    v
Deployment trade-off
Bunlar aynı teknik değildir ve birlikte de kullanılabilir.
Nicemleme modelin öğrenme kuramını değiştirmeden deployment maliyetini düşürebilir; ancak çok düşük hassasiyet bazı katmanlarda kalite kaybı oluşturabilir. 1-bit/1.58-bit araştırmaları ise düşük bit gösterimini eğitim mimarisinin parçası hâline getiren daha ileri bir çizgidir; sıradan post-training quantization ile eşitlenmemelidir.
Model sıkıştırma değerlendirmesi yalnız dosya boyutu üzerinden yapılmamalıdır:
quality
gecikme
işleme kapasitesi
memory
energy
hardware support
birlikte ölçülmelidir.
17.1. Tensör Ayrıştırması ile Ağırlık Sıkıştırma
Tam bağlı bir katmanın ağırlığı matris, evrişim katmanının ağırlığı ise genellikle çıkış kanalı, giriş kanalı ve çekirdek boyutlarını içeren dört boyutlu bir tensördür. Katmanı tek parça bir parametre dizisi olarak saklamak yerine CP veya Tucker ayrıştırmasıyla daha küçük faktörlere ayırmak mümkündür. Tucker yaklaşımında çekirdek tensör, her mod boyunca daha düşük boyutlu faktör matrisleriyle birleştirilir. Bu yapı, farklı modlardaki bilgi kaybını ayrı rank seçimleri üzerinden denetler; CP yaklaşımı ise rank-bir tensörlerin toplamını kullanır.
Bir ağırlık tensörünün düşük rank gösterimi parametre sayısını azaltabilir, fakat teorik sıkıştırma oranı çalışma zamanı hızlanmasıyla aynı değildir. Ardışık küçük evrişimlerin çekirdek başlatma maliyeti, ara tamponları, bellek erişimi ve donanımın desteklediği işlem biçimleri toplam gecikmeyi belirler. Ayrıştırma sonrası modelin yeniden eğitilmesi veya ince ayar yapılması gerekebilir. Sıkıştırma seçimi, tek başına Frobenius normunda küçük ağırlık hatasıyla değil görev başarımı ve uçtan uca kaynak tüketimiyle doğrulanmalıdır.
Budama, nicemleme ve düşük rank ayrıştırma farklı hata mekanizmaları üretir: budama bağlantıları kaldırır, nicemleme sayı gösterimini sınırlar, ayrıştırma ise ağırlıkların ifade edebildiği altuzayı daraltır. İşlemler birlikte uygulanacaksa kalite kaybının toplamsal olduğu varsayılmamalı; bileşimden sonra uçtan uca ölçüm tekrarlanmalıdır.
17.2. Yapay Sinir Ağı Simülatörlerinden Öğrenme Çerçevelerine
Eski yapay sinir ağı araçları belirli ağ modellerini menüler veya sabit simülatörler üzerinden kuruyordu. Güncel yaklaşım genel amaçlı otomatik türev ve tensor hesaplama çerçeveleridir.
Yaygın ekosistemler:
- PyTorch,
- TensorFlow/Keras,
- JAX.
Bu araçlar model tanımından çok daha fazlasını sağlar:
- otomatik türev,
- GPU ve hızlandırıcı desteği,
- dağıtık eğitim,
- mixed precision,
- veri yükleme,
- model serileştirme.
Araç değişse de temel matematik değişmez. Öğrencinin önce ileri geçişi, kayıp fonksiyonunu, gradyanı ve optimizasyonu anlaması gerekir.
17.3. Sıkıştırılmış Model için Dört Ayrı Başarı Ölçütü
Budama, düşük-rank yaklaşımı, nicemleme ve damıtma farklı müdahalelerdir. Müdahale sonrası (1) depolama boyutu, (2) gerçek tepe bellek kullanımı, (3) hedef donanımda uçtan uca gecikme/enerji ve (4) görev kalitesi ayrı raporlanmalıdır. Düşük-rank faktörleştirme parametre sayısını azaltsa bile çok küçük matris işlemleri veya ek veri kopyaları çıkarımı yavaşlatabilir. Nicemlemede ağırlık ve aktivasyon aralığı, kalibrasyon verisi ile taşma davranışı ölçülmelidir.
Aynı sınama kümesinde çalışırken kalite farkı Δmetric olarak verilmeli, deney varyansı gizlenmemelidir. Gecikme ölçümü ısınma aşaması, gerçek batch büyüklüğü, giriş uzunluğu ve CPU/GPU sınırlarıyla birlikte raporlanmadığında modeller karşılaştırılamaz.
17.4. Görsel Çıkarım Hattında Uçtan Uca Gecikme
Canlı görüntü işlemede toplam süre yalnız ağın ileri geçişi değildir: T_toplam = T_alım + T_ön işleme + T_aktarım + T_model + T_son işleme + T_sunum. Veri aktarımı, kutu eleme, maske yeniden boyutlandırma ve görüntü çizimi modelin hesaplama süresini aşabilir. Aşamalardaki örtüşen işlemler varsa bu toplam, tek kareye ait ardışık iş akışı için üst düzey bir muhasebedir; paralel hatların akış kapasitesi ayrı ölçülür.
Saniyedeki işlenen kare sayısı throughput ölçüsüdür; tek karenin gecikmesini doğrudan göstermez. Kuyruk birikimi, atlanan kare oranı, p95/p99 gecikme, hedef çözünürlük ve batch büyüklüğü birlikte kaydedilmelidir. Nicemleme veya budamanın yararı, aynı giriş ve kalite koşullarında son kullanıcıya ulaşan sonuç üzerinden doğrulanır.
Ünite 18: Sistem Tanıma, Zaman Serileri ve Nöroevrim
Yapay sinir ağları yalnız sınıflandırma veya statik regresyon modelleri değildir. Dinamik bir sistemin geçmiş giriş ve çıkışlarından gelecekteki davranışını öğrenmek için de kullanılabilir.
Bu kullanım alanı, klasik sistem tanıma (system identification) yaklaşımı ile sinir ağlarını doğrudan birleştirir.
18.1. Sistem Tanıma Problemi
Sistem tanımada amaç, gözlenen giriş-çıkış verisinden sistem davranışını açıklayan veya kestiren bir model kurmaktır.
Kavramsal olarak:
u(t) ----> [ bilinmeyen sistem ] ----> y(t)
             |
             v
        gözlenen veri
             |
             v
        tahmini model
Model:
y_hat(t) = F(
    y(t-1), y(t-2), ...,
    u(t), u(t-1), ...
)
biçiminde geçmiş durum ve girdilere bağlı olabilir.
Burada kritik ayrım şudur:
statik regresyon:
aynı örneğin özellikleri -> aynı örneğin hedefi

dinamik model:
geçmiş / durum -> sonraki davranış
Bu ayrım, veri hazırlama ve validation yöntemini değiştirir.
18.2. Parametrik Baseline Önce Gelmelidir
Sinir ağı, klasik zaman serisi veya lineer sistem modellerini otomatik olarak gereksiz kılmaz.
AR, MA, ARMA/ARIMA veya giriş bilgisini açıkça kullanan ARX-benzeri modeller:
- daha az parametre,
- daha yüksek yorumlanabilirlik,
- daha düşük eğitim maliyeti,
- daha açık model-order analizi
sağlayabilir.
Sinir ağı ancak nonlinear ilişkiyi veya karmaşık dinamiği gerçekten daha iyi modelliyorsa ek karmaşıklığını hak eder.
Sağlam deney düzeni:
naive baseline
     ↓
linear / autoregressive baseline
     ↓
MLP / RBF / recurrent model
     ↓
gerekirse daha karmaşık mimari
şeklinde ilerleyebilir.
18.3. Model Mertebesi ve Lag Seçimi
Geçmişten kaç adımın girişe verileceği bir hiperparametre değil, doğrudan model kapasitesi ve bilgi varsayımıdır.
Çok kısa pencere gerekli dinamiği kaçırabilir.
Çok uzun pencere ise:
- gereksiz parametre,
- daha zor optimizasyon,
- sahte korelasyon,
- daha yüksek overfitting riski
oluşturabilir.
Klasik modellerde model-order seçimi için AIC gibi bilgi ölçütleri veya prediction-error temelli kriterler kullanılabilir.
Sinir ağında aynı fikir:
lag window
model size
validation error
complexity
arasındaki trade-off olarak sürer.
18.4. Zaman Serisinde Random Split Tehlikelidir
Zamansal veride örnekleri rastgele eğitim/test kümelerine dağıtmak geleceğe ait yapının eğitim tarafına sızmasına neden olabilir.
Daha güvenli örnek:
past
|------ train ------|--- validation ---|--- test ---|
                                                   future
şeklindeki kronolojik ayırımdır.
Rolling-origin veya walk-forward validation da zaman içinde model davranışının değişmesini ölçmeye yardımcı olabilir.
Öğrenilmiş gösterim ile elle tasarlanan öznitelik arasındaki fark, modelin hangi bilgiyi koruyacağının veriden kestirilmesidir; bu, ölçüm hatasını kendiliğinden ortadan kaldırmaz. Aynı makinadan ardışık zaman pencereleriyle üretilen eğitim ve test örnekleri, fiziksel durum değişmediği hâlde farklı satırlar olarak görünebilir. Gerçekte yeni cihazlara genellenebilirlik aranıyorsa cihaz bazında, geleceğe genellenebilirlik aranıyorsa zaman bazında ayrım yapılmalıdır. Veri dengesizliği ve çalışma koşullarındaki kayma için hata oranı tek başına yeterli değildir; grup/dönem kırılımlarında performans, kalibrasyon ve güvenli geri dönüş koşulları birlikte raporlanmalıdır.
18.5. Çalışma Bölgesini Kapsamak
Bir sinir ağı, eğitim verisinin dışında güvenilir extrapolation garantisi vermez.
Sistem tanımada eğitim verisi:
- düşük ve yüksek çalışma noktalarını,
- geçişleri,
- tipik yükleri,
- yeterli giriş uyarımını
kapsamalıdır.
Model yalnız sakin çalışma bölgesini görmüşse ani yük değişimini doğru tahmin etmesi beklenmemelidir.
Bu nedenle veri toplama tasarımı model mimarisi kadar önemlidir.
18.6. One-step Prediction ile free-run Prediction Aynı Test Değildir
Bir adım ileri kestirimde model her adımda gerçek geçmiş çıktıyı kullanabilir:
gerçek y(t-1)
    ↓
model
    ↓
y_hat(t)
Recursive veya free-run kullanımda ise önceki tahmin tekrar modele girdi olur:
y_hat(t-1)
    ↓
model
    ↓
y_hat(t)
    ↓
y_hat(t+1)
Bu ikinci durumda hata birikebilir.
One-step metriği çok iyi olan model uzun ufukta kararsız veya drift eden tahmin üretebilir.
Bu nedenle deployment davranışı recursive ise evaluation da recursive senaryoyu ölçmelidir.
18.7. RBF, MLP ve Recurrent Yapılar
Farklı ağ aileleri sistem tanımada farklı bias taşır.
MLP belirli lag penceresini nonlinear fonksiyona eşleyebilir.
RBF yerel prototiplere/merkezlere göre nonlinear yaklaşım oluşturabilir.
Recurrent ağ geçmiş bilgiyi gizli durum üzerinden taşıyabilir.
Modern LSTM/GRU/Transformer tabanlı sequence modelleri daha uzun bağlamları işleyebilir; fakat küçük sistemlerde daha karmaşık model her zaman daha iyi değildir.
Mimari:
dinamik ihtiyacı
veri miktarı
latency
stability
yorumlanabilirlik
ile birlikte seçilmelidir.
18.8. Residual Analizi Yalnız RMSE Değildir
Model hatası:
e(t) = y(t) - y_hat(t)olarak tanımlandığında yalnız ortalama hata büyüklüğüne bakmak yeterli değildir.
İyi modelde residual'ların yapısı incelenebilir:
- kalıcı bias var mı?
- belirli frekansta tekrar eden örüntü var mı?
- residual autocorrelation yüksek mi?
- residual geçmiş girdilerle hâlâ ilişkili mi?
- hata yalnız belirli çalışma bölgelerinde mi artıyor?
Residual'da açıklanabilir düzen kalıyorsa model sistem bilgisinin bir kısmını öğrenmemiş olabilir.
18.9. Nöroevrim: Yalnız Ağırlıkları Evrimleştirmek Değildir
Nöroevrim (neuroevolution), evolutionary search ile sinir ağı tasarımını birleştirir.
Evrimleştirilebilecek öğeler:
weights
topology
activation / connectivity choices
hyperparameters
learning-rule parameters
olabilir.
Gradyan gerektirmediği için türevlenemeyen objective, ayrık mimari kararı veya doğrudan simülasyon skoru kullanılan problemlerde yararlı olabilir.
Karşılığında model evaluation sayısı çok yüksek olabilir.
18.10. Topoloji Evrimi
Sabit topolojide yalnız ağırlık aramak ile ağ yapısını da evrimleştirmek farklı problemlerdir.
NEAT gibi yaklaşımlar:
- küçük yapıdan başlama,
- yapısal mutasyon,
- farklı topolojilerin anlamlı biçimde karşılaştırılması,
- yeni yapıları kısa süre koruyan speciation
gibi fikirlerle topoloji ve ağırlığı birlikte aramayı hedefler.
Bu yaklaşım her supervised-learning problemi için gradient descent'in alternatifi değildir. Özellikle reward/simulation temelli ve mimarinin de arandığı problem sınıflarında anlamlıdır.
18.11. Hibrit Eğitim
Evolution ve gradient optimization birbirinin rakibi olmak zorunda değildir.
Örnek hibrit süreç:
evolutionary search
    ↓
iyi başlangıç / mimari / hiperparametre
    ↓
gradient-based fine tuning
veya:
gradient training
    ↓
birden çok aday
    ↓
evolutionary population-level search
şeklinde kurulabilir.
Global keşif ile yerel ince ayar farklı optimizasyon rolleridir.
18.12. Yeniden Üretilebilir Nöroevrim
Stokastik arama raporlanırken yalnız en iyi koşu verilmemelidir.
Kaydedilmesi gerekenler:
random seed
population size
selection pressure
mutation / crossover parameters
evaluation budget
fitness definition
number of independent runs
mean / median / variance
best-so-far curve
olabilir.
Sinir ağı ile sistem tanıma ve nöroevrim, aynı temel mühendislik ilkesinde birleşir:
Karmaşık model ancak daha basit baseline'a karşı, doğru validation düzeninde ve tekrar üretilebilir deneyle ölçülürse anlamlıdır.
18.13. Öğrenilmiş Dinamik Modelde Hata Birikiminin Ölçülmesi
Tek adımlı öngörüde ağ, her adımda gerçek ölçümü kullanarak x̂[k+1] = F(x[k],u[k]) üretir. Serbest yürütmede ise x̂[k+1] = F(x̂[k],u[k]) olduğundan önceki tahmin hatası bir sonraki girişe taşınır. Tek adımlı ortalama hatanın küçük olması, uzun süreli benzetimin kararlı veya doğru olacağını göstermez. Örneğin tahmin edilen hız her adımda gerçek hızdan 0,02 m/s büyükse, 0,1 s zaman aralıklı yüz adımlık basit konum integrasyonunda diğer hatalar ihmal edildiğinde 0,2 m konum sapması birikir.
Model karşılaştırmasında tek adım hatası, serbest yürütme hatası ve fiziksel kısıt ihlali ayrı ölçülür. Aynı başlangıç koşulu ile yük, sürtünme ve besleme aralıkları taranır; eğitim dışı koşullarda hatanın ne kadar büyüdüğü raporlanır. Bir sinir ağı dinamikleri iyi kestirebilir fakat enerji işareti, doygunluk veya mekanik sınırı kendiliğinden korumayabilir. Denetim sistemine bağlanacak model, güvenli çalışma bölgesinde bağımsız doğrulama ve gerektiğinde fiziksel modelle sınırlandırma gerektirir.
18.14. UKF ile Durum Kestirimi ve Ağ Parametresi Öğreniminin Sınırı
Durum modeli x_t = f(x_(t-1),u_t)+q_t, ölçüm modeli z_t = h(x_t)+r_t şeklindeyse UKF, doğrusal olmayan dönüşümleri seçilen sigma noktaları üzerinden yaklaşık taşır. Standart ölçekli unscented dönüşümde durum boyutu n için 2n+1 nokta kullanılır; ağırlıklar ve kovaryans yayılımı seçilen ayarlara bağlıdır. Yalnız fiziksel durumu kestirmek için tanımlanan UKF ile sabit olmayan sinir ağı ağırlıklarını genişletilmiş duruma ekleyip öğrenmeye çalışmak farklı modellerdir. İkinci durumda boyut, matris maliyeti ve parametre gözlenebilirliği önemli ölçüde zorlaşabilir.
RLS doğrusal-parametreli ve uyarım koşulları karşılanmış modellerde yararlı olabilir; UKF ise doğrusal olmayan durum/ölçüm haritalarında farklı bir yaklaşım sunar. Eğitim verisini rastgele bölmek yerine fiziksel çalışma aralıkları ve zaman blokları üzerinden değerlendirme yapılmalı, tek adım hata ile serbest koşturma hata birikimi birlikte raporlanmalıdır.
Ünite 19: Uygulama Alanları, Model Seçimi ve Operasyonel Sınırlar
19.1. Kullanım Alanları
Bir sinir ağı eğitim örneklerinden düzenlilik çıkarabildiği için kullanım alanı tek bir mühendislik dalıyla sınırlı değildir. Uygulama seçerken “sinir ağı kullanılabilir mi?” sorusundan önce girdinin nasıl temsil edileceği, hedefin nasıl ölçüleceği, hata maliyetinin ne olduğu ve yeterli verinin bulunup bulunmadığı belirlenmelidir.
Yapay sinir ağlarının başlıca kullanım alanları mühendislik bağlamına göre aşağıdaki gruplarda toplanabilir:
- Adli bilişim ve siber güvenlik: adli bilişim, siber güvenlik, görüntü ve veri karşılaştırma, örüntü tanıma tabanlı incelemeler.
- Görüntü ve biyometri: görüntü işleme, el yazısı tanıma, parmak izi tanıma, plaka tanıma, yüz eşleştirme.
- Ses, dil ve sinyal: ses tanıma, sözcük tanıma, dil tercüme, elektrik işareti tanıma, sinyal işleme.
- Biyomedikal ve mühendislik analizi: biyomedikal uygulamalar, dayanıklılık analizi, sistem modelleme, kalite kontrolü ve maliyet analizi.
- Denetim, robotik ve ulaşım: denetim, robotik, otomatik araç denetimi, otomatik pilot uygulamaları, yol izleme ve uçuş simülasyonları.
- Tahmin ve üretim: hava durumu tahminleme, finansal kestirimler ve üretim işlem kontrolü.
Bu alanların hepsinde aynı ağ mimarisi kullanılmaz. Görüntü, zaman serisi, metin veya tablo verisi farklı önişleme, kayıp fonksiyonu, doğrulama yöntemi ve hesaplama bütçesi gerektirir.
19.2. Avantajlar ve Sınırlılıklar
Sinir ağlarının temel avantajı, açık bir kural kümesi yazmadan örneklerden parametrik bir eşleme öğrenebilmesidir. Aynı özellik önemli bir risk de üretir: sonuç kalitesi model mimarisinden çok veri dağılımına, eğitim yöntemine, doğrulama disiplinine ve çalıştırıldığı ortamın girdilerine bağlı olabilir. Aşağıdaki maddeler bu iki yönü birlikte özetler.
19.2.1. Avantajlar
- Eğitimde görülmeyen fakat aynı dağılımdan gelen örneklerde genelleme yapabilir.
- Doğrusal olmayan ilişkileri temsil edebilen alt birimler içerir.
- Dağıtık temsil nedeniyle bazı mimarilerde tek bir birimin veya bağlantının bozulması tüm bilginin kaybolması anlamına gelmez.
- Benzer örnekler arasında karar sınırları öğrenerek yeni girdilere yanıt üretebilir.
- Klasik yöntemlerden farklı bir hata profiline sahip olduğundan, uygun hibrit tasarımlarda aynı problem için ikinci bir çözüm yolu sağlayabilir.
- Temsilin çok sayıda parametreye dağılması, bilginin tek bir hücreye bağlı olmamasını sağlar.
- Eğitim verisinin miktarı kadar temizliği, çeşitliliği ve problem uzayını kapsaması da yeterliyse yüksek doğruluk elde edilebilir.
- Eksik veya gürültülü girdiler altında anlamlı çıktı verebilen mimariler kurulabilir; bunun derecesi eğitim senaryosuna bağlıdır.
- Her durumda fiziksel süreci kapalı form bir denklemle modellemek gerekmez; veri üzerinden yaklaşık bir eşleme öğrenilebilir.
- Yedeklilik ve dağıtık temsil bazı ağlarda hata toleransını artırabilir.
- Algılama görevleri için uygun özellik temsillerini öğrenebilir.
- Örüntü tanıma problemlerinde doğrudan kullanılabilir.
- Yeterli ve temsil edici veri bulunan sınıflandırma görevlerinde yüksek doğruluk sağlayabilir.
- Danışmansız ve özdenetimli yöntemlerle verinin iç yapısını kısmen kendi başına örgütleyebilir.
- Uygun donanım ve toplu hesaplama altında bazı klasik işlem zincirlerinden daha hızlı çıkarım yapabilir.
- Aynı temel optimizasyon yaklaşımı farklı veri türleri ve ağ aileleri üzerinde yeniden kullanılabilir.
19.2.2. Sınırlılıklar
- Genel bir sinir ağı için klasik kontrol sistemlerindeki anlamda evrensel bir kararlılık analizi yoktur; yalnız belirli mimariler ve varsayımlar altında biçimsel sonuçlar elde edilebilir.
- Yüksek boyutlu ağlarda tek bir kararın nedenini insan tarafından doğrudan izlemek zor olabilir; açıklanabilirlik ayrıca tasarlanmalıdır.
- Gerçek dünyadaki ses, görüntü, metin veya sensör bilgisi modele girmeden önce sayısal ve tutarlı bir temsile dönüştürülmelidir; sayısallaştırma hatası model hatasına taşınır.
- Katman sayısı, öğrenme oranı, düzenlileştirme, başlangıç değerleri ve benzeri hiperparametreler başka bir veri kümesinde aynı sonucu vermeyebilir.
- Eğitimin ne zaman sonlandırılacağı için her probleme uyan tek bir kural yoktur; doğrulama kaybı, erken durdurma, bütçe ve yakınsama ölçütleri birlikte kullanılır.
- Büyük modellerin eğitimi ve kimi zaman çıkarımı yoğun paralel hesaplama, yüksek bellek bant genişliği veya hızlandırıcı donanım gerektirebilir.
- Büyük miktarda ve temsil edici data gereksinimi problem sınıfına göre belirleyici olabilir.
- dağılım kayması, eğitimde ölçülen başarımın üretimde korunmasını engelleyebilir.
- Adversarial inputs, data/model bias, calibration ve uncertainty sorunları ayrıca ele alınmalıdır.
- Büyük modellerde yalnız compute değil memory bandwidth ve enerji tüketimi de sistem sınırı oluşturabilir.
19.3. Öğrenme Modelinden Üretim Çıkarımına
Yapay zekâ sistemlerinde model doğruluğu tek başına üretim performansını tanımlamaz. Batch boyutu, bellek bant genişliği, model/aktivasyon/KV-cache yerleşimi, prefill ve decode evreleri, kuyruklama, paralellik ve iletişim maliyeti latency-throughput eğrisini birlikte belirler. Bu nedenle model düzeyindeki bir optimizasyonun uçtan uca servis gecikmesi ve kaynak başına çıktı üzerinde doğrulanması gerekir.
- Eğitim metriği ile üretim serving metriğinin ayrı tutulması.
- Batching kazancının kuyruk gecikmesi ve bellek tüketimiyle birlikte ölçülmesi.
- Model sıkıştırma veya quantization etkisinin yalnız hızla değil doğruluk kaybıyla da raporlanması.
19.4. Alanlara Göre Model Seçimi
Model değerlendirme ölçütleri uygulama alanına göre değişir. Doğruluk (accuracy) yanında gecikme (latency), hata maliyeti, kalibrasyon (calibration), dağılım kayması (dağılım kayması), kaynak bütçesi ve güvenilirlik birlikte ele alınmalıdır. Genel kullanım alanları, avantajlar ve sınırlılıklar, başlangıçtaki kavramsal çerçeveyle birlikte değerlendirilmelidir.
19.5. Uygulama Seçimi
Bir Artificial Neural Network kullanılmadan önce problemin learning-based bir çözüme gerçekten uygun olup olmadığı belirlenmelidir. Doğrusal olmayan ilişki, yüksek boyutlu data, çok sayıda örnek, elle kural yazmanın güç olması ve karmaşık örüntüler ANN kullanımını anlamlı kılabilir; açık ve doğrulanmış algoritmik çözümü bulunan basit bir problemde ise sinir ağı gereksiz olabilir.
19.6. Endüstriyel Sistemler
Endüstriyel sistemlerde doğruluk (accuracy) kadar gecikme (gecikme), belirlenimci davranış (belirlenimci davranış), dağılım kayması (dağılım kayması) ve hata durumundaki güvenli davranış (güvenli davranış) önemlidir.
19.7. Finansal Sistemler
Finansal veride geçmiş performans gelecekteki performansı garanti etmez. Rejim değişimi, veri sızıntısı (data leakage) ve seçilim yanlılığı (seçilim yanlılığı) model değerlendirmesinde kritik risklerdir.
19.8. Askeri ve Güvenlik Sistemleri
Yanlış pozitif ve yanlış negatif maliyetleri aynı değildir. Model performance; operasyonel koşullar, dağılım kayması ve adversarial effects dikkate alınarak değerlendirilmelidir.
19.9. Sağlık Sistemleri
Klinik kullanımda model doğruluğu (accuracy) tek başına yeterli değildir. Veri temsilinde adalet (data representation fairness), kalibrasyon (calibration), dış doğrulama (external validation) ve insan gözetimi (insan gözetimi) birlikte değerlendirilmelidir.
19.10. Veri Türü ve Model Seçimi
Image, audio, text ve time-series verilerinin yapısal özellikleri farklıdır. Model ailesi veri türüne göre mekanik biçimde değil; temsil yapısı, gecikme, memory, compute budget, hata maliyeti ve doğrulama gereksinimi birlikte değerlendirilerek seçilmelidir.
Mühendislik açısından en iyi model en büyük model değildir. Gereksinimi en düşük toplam maliyetle ve yeterli güvenilirlikle karşılayan modeldir.
19.11. Öğrenmede Aykırı Değer ve Dağılım Kayması
Robust istatistik, modelin ideal varsayımlarından küçük sapmalar olduğunda tahminin ne kadar bozulduğunu inceler. Sinir ağı deneylerinde medyan ve MAD yalnız hata dağılımını özetlemek için değil, etiket gürültüsü veya uç örneklerin sonuçları sürükleyip sürüklemediğini görmek için kullanılabilir; influence function ve breakdown point ise kullanılan tahmin edicinin bu kirlenmeye duyarlılığını daha biçimsel açıklar. Özellikle ağır kuyruklu veya kontamine veride yalnız ortalama ve standart sapmaya dayalı kararlar yanıltıcı olabilir.
- Kayıp fonksiyonunun aykırı örneklere duyarlılığının incelenmesi.
- Train/test dağılım farkının yalnız doğruluk değil calibration üzerinden de izlenmesi.
- Robust ölçekleme ile klasik standardizasyonun kontamine veri üzerinde karşılaştırılması.
19.12. Alan Uygulamasında Başarıyı Yöntem Adıyla Değil Karar Sınırıyla Ölçmek
Bir sınıflandırıcının tanılama, endüstriyel kalite kontrolü veya güvenlik izlemesi için uygunluğu yalnız doğruluk oranına bağlı değildir. Sınıf öncül olasılığı, yanlış alarmın operasyonel maliyeti, kaçırılan olayın bedeli, insan denetimi, veri kökeni ve dağılım kayması uygulamanın gerçek karar eşiğini belirler. Aynı ROC-AUC değerine sahip iki model farklı kalibrasyon nedeniyle farklı iş yükü üretebilir.
Sistem tanıma gibi fiziksel modellerde tahmin edilen çıkışın ölçümle uyuşması, güvenli denetim için tek başına yeterli değildir. Fiziksel sınırlar, belirsizlik aralığı, model dışı durum ve güvenli geri dönüş davranışı ayrıca tanımlanır. Neural çözümün üstünlüğü uygun doğrusal, istatistiksel veya fizik-tabanlı baselines karşısında gösterilmelidir.
Ünite 20: Deney Tasarımı, Ölçüm, Belirsizlik ve Bilimsel Kanıt
Deney tasarımında önce karşılaştırılacak hipotez ve birincil ölçüt belirlenir. Veri bölme işlemi kişi, cihaz veya zaman bağımlılığını sızdırmayacak şekilde düzenlenir; rastgele tohumlar ve model seçimi kuralları kaydedilir. Hiperparametre seçimi için kullanılan sonuçlar nihai test başarısı gibi sunulmaz. Aynı koşullarda yinelenen deneylerin dağılımı ve başarısız alt gruplar incelendiğinde, tek bir yüksek skorun gerçekte ne kadar güçlü kanıt sağladığı anlaşılabilir.
20.1. Deney Düzeni, Belirsizlik ve Veri Kayması
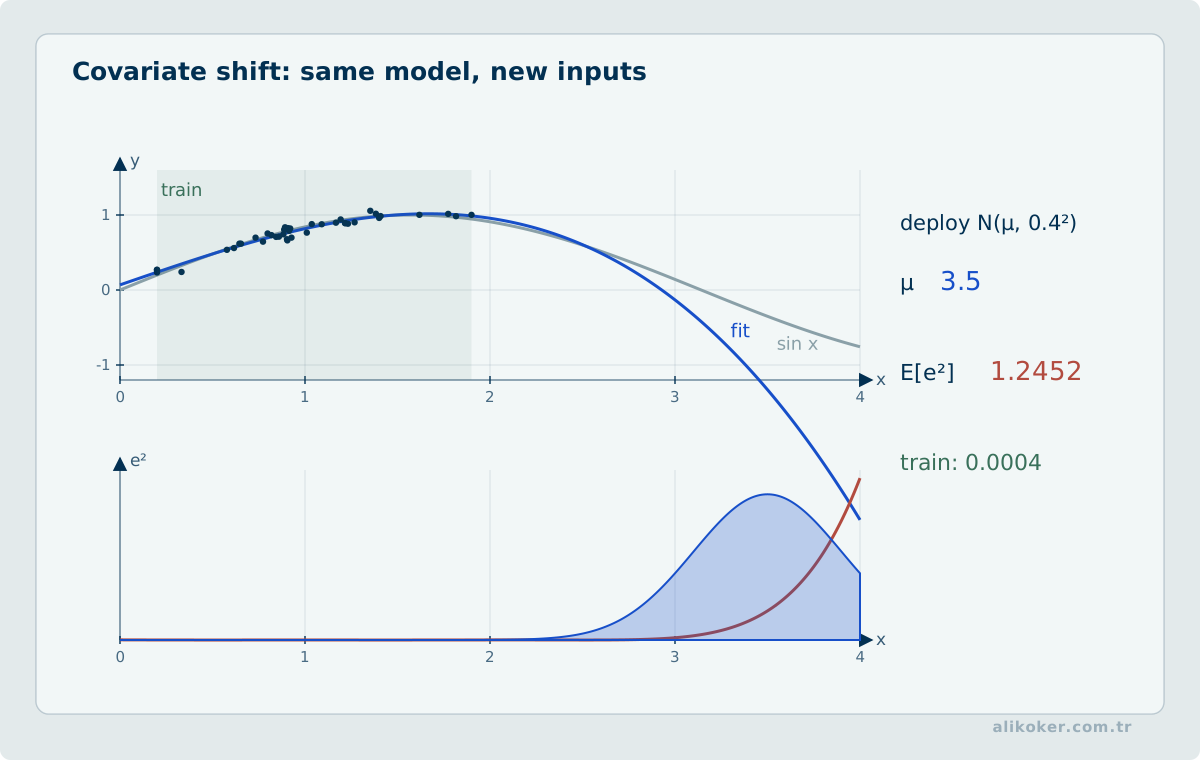
Bir yapay sinir ağının eğitim kaybının düşmesi, modelin gerçek dünyada güvenilir olduğu anlamına gelmez. Eğitim, doğrulama ve test kümelerinin birbirinden ayrılması; aynı kişinin, cihazın veya zaman serisinin farklı parçalarının yanlışlıkla farklı kümelere sızmaması gerekir. Aksi durumda ölçülen başarı, genelleme yerine veri tekrarını yansıtabilir.
Sınıflandırma problemlerinde yalnız doğruluk oranı değil, sınıf dengesine göre precision, recall, F1, ROC-AUC veya PR-AUC; olasılık üreten sistemlerde ise kalibrasyon dikkate alınmalıdır. Belirsizlik yüksekken modelin "bilmiyorum" diyebilmesi, her girdiye yüksek güvenli sınıf atamasından daha değerlidir.
Üretimde veri dağılımı değişebilir. Sensör değişimi, kullanıcı davranışı, yeni cihaz türleri veya örnekleme politikasındaki farklılıklar performansı sessizce düşürebilir. Bu nedenle model değerlendirmesi tek seferlik test değil; veri kayması, hata dilimleri, eşik davranışı ve yeniden eğitim kriterleriyle birlikte ele alınmalıdır.
20.2. Model Sonucunu Kanıta Bağlamak
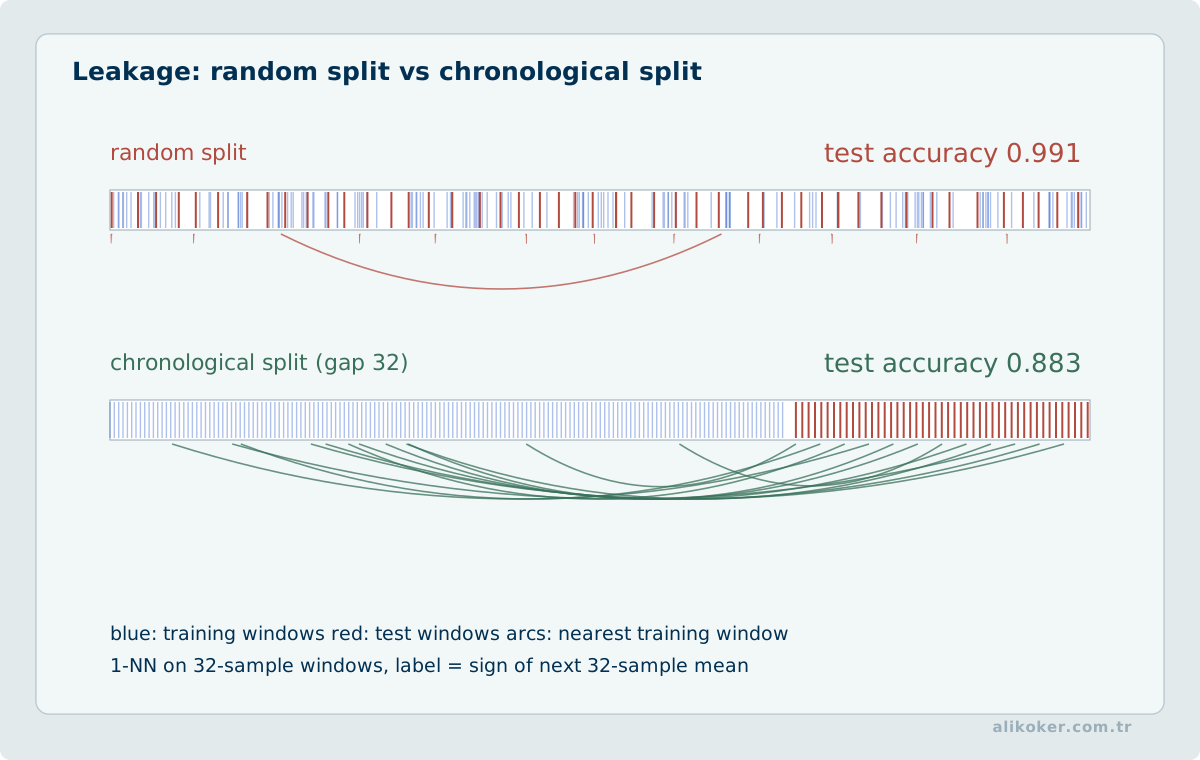
Bir model sonucu yalnız tek bir doğruluk oranıyla değerlendirilmemelidir. Veri kaynağı, bölme yöntemi, sınıf dağılımı ve değerlendirme metriği açık değilse sonuç tekrar üretilemez. Aynı kişi, cihaz veya oturuma ait örneklerin eğitim ve test kümelerine birlikte sızması özellikle görüntü, ses ve zaman serisi çalışmalarında ölçümü iyimser gösterebilir.
Karar eşiği kullanılan senaryoya göre seçilir. Yanlış pozitif ve yanlış negatif maliyetleri farklıysa tek bir “en iyi” eşik yoktur. Confusion matrix, sınıf bazlı recall/precision, kalibrasyon ve hata dilimleri birlikte incelenmelidir.
Üretim kullanımında modelin kapsamı da tanımlanır: hangi veri dağılımında doğrulandı, hangi girişler kapsam dışı, belirsizlik nasıl ele alınıyor ve insan incelemesine hangi koşulda dönülüyor? Bu bilgiler, model çıktısının hangi ölçüde güvenilebileceğini belirler.
20.3. Güncel Mühendislik İlkeleri
Bir sinir ağı sistemi tasarlanırken şu sıra izlenmelidir:
- Problemi ve hata maliyetini tanımla.
- Basit bir baseline kur.
- Eğitim, doğrulama ve test ayrımını doğru yap.
- Veri sızıntısını engelle.
- Uygun model kapasitesini seç.
- Performansı yalnız tek bir ölçütle değerlendirme.
- Dağılım değişimini ölç.
- Gecikme, işlem hacmi, bellek ve enerji maliyetini hesaba kat.
- Modeli üretim verisi üzerinde izle.
- Yeniden eğitim ve sürümleme sürecini tasarla.
Sinir ağı mühendisliğinde asıl başarı yalnız yüksek doğruluk değildir. Modelin gerçek kullanım koşullarında güvenilir, ölçülebilir ve sürdürülebilir davranmasıdır.
Online veya continual learning tasarlanıyorsa backward compatibility, catastrophic forgetting, validation, versioning ve rollback birlikte ele alınmalıdır. Güvenilirlik sınırı ayrıca out-of-distribution inputs, adversarial examples, miscalibration, data poisoning, privacy ve insan gözetimi risklerini kapsar. Bu nedenle ilerleme yalnız yeni model adlarıyla değil; algorithm + data + hardware + validation + operation bütünlüğüyle değerlendirilmelidir.
20.4. Model Deneylerinin Kaydı, Ablation ve Üretim Gözlemi
Bir model geliştirme çalışmasında son metriği kaydetmek deneyin tamamını kaydetmek değildir. Aynı sonucu yeniden değerlendirebilmek için karşılaştırılan baseline, veri sürümü, önişleme, model yapılandırması, hiperparametreler, değerlendirme kümesi ve metrik tanımı birlikte izlenmelidir.
baseline
→ tek kontrollü değişiklik
→ aynı değerlendirme protokolü
→ sonuç
→ yorum
Bu düzen, aynı anda birçok şeyi değiştirip hangi bileşenin kazanç sağladığını belirsiz bırakmaktan daha güçlü kanıt üretir.
20.4.1. Hiperparametre Araması ve Değerlendirme Disiplini
Grid search, rastgele arama veya olasılıksal optimizasyon gibi yöntemler farklı deneme noktaları üretir. Arama yönteminin gelişmiş olması, değerlendirme protokolünün doğru olduğu anlamına gelmez. Hiperparametre seçimi doğrulama verisi üzerinde yapılmalı; nihai test kümesi sürekli seçim döngüsüne katılmamalıdır.
Çok sayıda deney çalıştırıldığında yalnız en yüksek metriği seçmek de yanıltıcı olabilir. Deneyler aynı veri bölünmeleri, aynı ön işleme ve aynı temel ölçütlerle karşılaştırılmalı; mümkün olduğunda değişkenliğin kaynağı ayrıca incelenmelidir.
20.4.2. Ablation Çalışması
Ablation, bir model bileşeninin veya veri/özellik grubunun sonuca katkısını anlamak için o parçayı kaldırıp kontrollü karşılaştırma yapar.
Model A
Model A - bileşen X
Model A - özellik grubu Y
Model A - veri artırma Z
Ablation sıradan yazılım testinin yerine geçmez. Test, belirli davranışın gereksinimi sağlayıp sağlamadığını sınayabilir; ablation ise “bu bileşen gözlenen performansa ne kadar katkı sağlıyor?” sorusuna yaklaşır. İki kanıt türü birbirini tamamlar.
20.4.3. Hata Dilimleri ve Açıklanabilirlik
Tek ortalama skor, modelin hangi veri bölgelerinde hata yaptığını gizleyebilir. Sınıf, zaman, kaynak, cihaz, sinyal kalitesi veya başka anlamlı dilimlerde hata oranını incelemek model davranışını daha görünür kılar. Regresyon problemlerinde artık grafikleri ve sistematik hata örüntüleri, sınıflandırmada confusion matrix ve sınıf bazlı ölçütler benzer amaç taşır.
SHAP gibi açıklanabilirlik yöntemleri model kararına hangi özelliklerin katkıda bulunduğunu incelemek için yararlıdır; fakat özellik katkısı nedensellik kanıtı değildir. Açıklama yöntemi de kendi varsayımları ve yaklaşık hesapları olan ayrı bir analiz katmanıdır.
20.4.4. Üretim Gözlemi ve Drift
Doğrulama kümesindeki başarı üretim davranışının sonsuza kadar aynı kalacağını garanti etmez. Girdi dağılımı, sınıf oranı, sensör veya istemci davranışı değişebilir. Bunun yanında gecikme, bellek ve hata oranı gibi sistem ölçütleri de izlenmelidir.
offline değerlendirme
→ kontrollü dağıtım
→ veri ve model gözlemi
→ drift / hata dilimi analizi
→ yeniden eğitim ya da geri dönüş kararı
Online veya incremental learning yeni veriye daha hızlı uyum sağlayabilir; ancak yanlış etiket, ani dağılım değişimi veya geri döndürülemeyen güncelleme riski getirir. Bu nedenle güncelleme ölçütü, veri kalitesi kontrolü, model sürümü ve geri dönüş yolu açık olmalıdır.
Model yaşam döngüsünün konfigürasyon ve sürümleme tarafı Yazılım Mühendisliği, doğrulama kanıtının kapsamı ise Yazılım Test Mühendisliği derslerinde tamamlanır.
20.5. İlgili Konular
Yapay zekânın sinir ağı dışındaki felsefi ve kuramsal boyutları Yapay Zeka: Felsefe, Kuram ve Uygulama dersinde ele alınır.
20.6. Kalibrasyon, Eşik Seçimi ve Hata Dilimleri
Bir modelin sıralama başarısı ile verdiği olasılıkların anlamlı olması farklı problemlerdir. İyi AUC değerine sahip bir sınıflandırıcı kötü kalibre olabilir; %0,9 çıktısı gerçekten yaklaşık %90 gerçekleşme oranına karşılık gelmeyebilir. Kalibrasyon eğrileri ve Brier skoru bu ayrımı görünür kılar.
Karar eşiği, 0,5 gibi alışkanlıkla seçilmemelidir. Yanlış pozitif ile yanlış negatif maliyeti, kapasite sınırı ve hedef recall/precision dengesi iş problemine göre belirlenmelidir.
Toplam metrik de alt gruplardaki sorunu gizleyebilir. Cihaz türü, veri kaynağı, gürültü seviyesi, coğrafi bölge veya zaman dilimi gibi anlamlı dilimlerde hata dağılımı incelenmeli; küçük örneklemli dilimler belirsizlik aralığıyla raporlanmalıdır.
20.7. Öğrenme Deneyini Yeniden Üretilebilir Kurmak
Ağ mimarisi tek başına deney tanımı değildir. Veri sürümü, normalizasyon, augmentation, seed, optimizer, öğrenme oranı, batch büyüklüğü, erken durdurma ve model seçme ölçütü sonuçla birlikte kaydedilmelidir.
Train/validation/test ayrımı model seçiminden önce belirlenmelidir. Test kümesi hiperparametre ayarlamak için tekrar tekrar kullanılırsa artık bağımsız test işlevini kaybeder. Küçük veri kümelerinde tekrar edilmiş cross-validation veya güven aralıkları, tek bir bölmeden daha anlamlı olabilir.
Bir modelin başarısız olduğu örnekler de sonuçtur. Hata dilimleri; sınıf, kaynak, gürültü, cihaz, aydınlatma veya benzeri anlamlı eksenlerde incelendiğinde toplam metrikte görünmeyen zayıflıklar ortaya çıkar.
20.8. Öğrenme Sonucunu Modelden Ayırmak
Bir sinir ağı sorusunda mimari, eğitim amacı ve değerlendirme ölçütü ayrı katmanlardır. Aktivasyon fonksiyonu katmandaki doğrusal olmayan dönüşümü, kayıp fonksiyonu eğitim sırasında hangi hatanın küçültüldüğünü, metrik ise sonucun nasıl raporlandığını belirler. Örneğin sınıflandırmada çapraz entropi ile eğitim yapılırken başarı oranı ayrı bir değerlendirme metriği olabilir.
Geri yayılım yeni bir tahmin yöntemi değil, zincir kuralı üzerinden gradyanları hesaplama yöntemidir. Ağırlık güncellemesinin yönü ve büyüklüğü ise optimizer ile belirlenir. Öğrenme oranı çok büyük olduğunda iterasyonlar kararsızlaşabilir, çok küçük olduğunda ilerleme aşırı yavaşlayabilir.
Eğitim, doğrulama ve test kümelerinin görevleri de karıştırılmamalıdır. Eğitim verisi parametreleri öğrenir. Doğrulama kümesi model veya hiperparametre seçimine yardım eder. Test kümesi bu seçim sürecinden bağımsız kalabildiği ölçüde son genelleme tahmini verir. Test sonucuna tekrar tekrar bakarak tasarım değiştirmek, test verisini fiilen doğrulama verisine dönüştürür.
Aşırı öğrenme yalnız eğitim hatasının düşük olması değildir; eğitim ve görülmemiş veri davranışı arasındaki farkla ilgilidir. Düzenlileştirme, veri artırma, erken durdurma veya daha uygun model kapasitesi bu farkı azaltmaya çalışabilir. Buna karşılık eğitim hatasının yüksek kalması yetersiz model, kötü optimizasyon, veri sorunu veya yanlış özellik ölçekleme gibi farklı nedenlerden kaynaklanabilir.
Sınıflandırıcı çıktısındaki yüksek skor da otomatik olarak iyi kalibrasyon anlamına gelmez. %90 olarak raporlanan örneklerin gerçekten yaklaşık %90 oranında doğru olması ayrı bir özelliktir. Bu nedenle doğruluk, kalibrasyon ve karar eşiği özellikle dengesiz sınıflarda birlikte incelenmelidir.
20.9. Aynı Veri ve Bütçe Altında Karşılaştırma Protokolü
Bir model değişikliğini test etmek için önce tek ana hipotez belirlenir: örneğin Levenberg–Marquardt'ın uygun küçük bir en küçük kareler probleminde belirli iterasyon bütçesinde daha az kayba erişmesi. Karşılaştırma grupları aynı eğitim/doğrulama/test ayırmasını, hedef metrikleri ve önişleme sürecini kullanır. Rastgele başlangıçlı yöntemler tek koşu yerine birden fazla sabit kayıtlı tohumla ölçülür. Optimizasyon yöntemi karşılaştırılıyorsa yalnız epoch değil duvar saati, belleği ve kayıp/Jacobian değerlendirme sayısı da dikkate alınır.
Raporlanan fark yalnız en iyi koşu değildir: merkezî eğilim, yayılım, başarısız koşular, veri dilimleri ve belirsizlik aralığı belirtilir. Hiperparametre arama bütçesi bir yöntem için geniş, diğerinde dar bırakılırsa yöntemler değil deneme kaynakları karşılaştırılmış olur. Verimlilik iddialarında eğitim kadar ön işleme, veri aktarımı ve çıkarım da uçtan uca hesaba katılır. Böylece yeni mimarinin gereksiz karmaşıklığa değip değmediği ölçülebilir.
20.10. Veri Sızıntısını Önleyen Değerlendirme Protokolü
Model seçimi, eşik ayarı ve nihai ölçüm aynı test kümesinde yapılırsa değerlendirme sonucu iyimserleşir. Eğitim, doğrulama ve test ayrımı örnek düzeyinde yeterli olmayabilir; aynı kişiye, oturuma, cihaza veya veri kaynağına ait gözlemler kümeler arasında taşınırsa bilgi sızıntısı oluşur. Bölme birimi uygulamanın beklenen genelleme hedefine göre tanımlanmalıdır.
Doğruluk veya F1 tek başına sınıf dengesizliğini ya da kalibrasyonu açıklamaz. Hata matrisi, sınıf başına precision/recall, uygun kalibrasyon ölçümleri ve önceden seçilen çalışma eşiği birlikte raporlanır. Model karşılaştırmasında aynı veri bölmeleri, ön işleme sınırları ve hesaplama bütçesi korunur.
Kaynakça
- Alex Krizhevsky; Ilya Sutskever; Geoffrey E. Hinton. (2012). ImageNet Classification with Deep Convolutional Neural Networks. Advances in Neural Information Processing Systems 25. NeurIPS
- Ashish Vaswani; Noam Shazeer; Niki Parmar; Jakob Uszkoreit; Llion Jones; Aidan N. Gomez; Łukasz Kaiser; Illia Polosukhin. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30. NeurIPS
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- Chris Fregly. AI Systems Performance Engineering. O’Reilly Media, 2025.
- David E. Rumelhart; Geoffrey E. Hinton; Ronald J. Williams. (1986). Learning representations by back-propagating errors. Nature, 323, 533-536. doi:10.1038/323533a0
- David H. Ackley; Geoffrey E. Hinton; Terrence J. Sejnowski. (1985). A Learning Algorithm for Boltzmann Machines. Cognitive Science, 9(1), 147-169. doi:10.1207/s15516709cog0901_7
- Frank Rosenblatt. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386-408. doi:10.1037/h0042519
- Hinton, G.; Vinyals, O.; Dean, J. “Distilling the Knowledge in a Neural Network.” 2015. https://arxiv.org/abs/1503.02531
- Ho, J.; Jain, A.; Abbeel, P. “Denoising Diffusion Probabilistic Models.” NeurIPS, 2020. https://arxiv.org/abs/2006.11239
- John J. Hopfield. (1982). Neural networks and physical systems with emergent collective computational abilities. Proceedings of the National Academy of Sciences, 79(8), 2554-2558. doi:10.1073/pnas.79.8.2554
- Kingma, D. P.; Welling, M. “Auto-Encoding Variational Bayes.” 2013. https://arxiv.org/abs/1312.6114
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- Narendra, Kumpati S.; Parthasarathy, Kannan. “Identification and Control of Dynamical Systems Using Neural Networks.” IEEE Transactions on Neural Networks, 1(1), 4–27, 1990. DOI: https://doi.org/10.1109/72.80202
- Naveenkumar, P.; Sharma, V.; Devarajan, G.; Abdullah, A.; Elngar, A. A. (eds.). Handbook of AI-Based Mechatronics Systems and Smart Solutions in Industrial Automation. CRC Press, 2026. DOI: https://doi.org/10.1201/9781032615790.
- Paul J. Werbos. (1974). Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences. Harvard University doctoral dissertation.
- Peter J. Huber; Elvezio M. Ronchetti. Robust Statistics. 2nd ed. Wiley, 2009.
- Sepp Hochreiter; Jürgen Schmidhuber. (1997). Long Short-Term Memory. Neural Computation, 9(8), 1735-1780. doi:10.1162/neco.1997.9.8.1735
- Stanley, Kenneth O.; Miikkulainen, Risto. “Evolving Neural Networks through Augmenting Topologies.” Evolutionary Computation, 10(2), 99–127, 2002. DOI: https://doi.org/10.1162/106365602320169811
- Teuvo Kohonen. (1982). Self-organized formation of topologically correct feature maps. Biological Cybernetics, 43, 59-69. doi:10.1007/BF00337288
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.
- Warren S. McCulloch; Walter Pitts. (1943). A Logical Calculus of the Ideas Immanent in Nervous Activity. Bulletin of Mathematical Biophysics, 5, 115-133. doi:10.1007/BF02478259
- Yann LeCun; Léon Bottou; Yoshua Bengio; Patrick Haffner. (1998). Gradient-Based Learning Applied to Document Recognition. Proceedings of the IEEE, 86(11), 2278-2324. doi:10.1109/5.726791
- Chunwei Zhang, Tianpeng Li, Ying Dai, Li Sun ve Ardashir Mohammadzadeh. Practical Neural Networks in Python and MATLAB. Springer Nature, 2026. DOI: https://doi.org/10.1007/978-3-032-14746-2.
- Cybellium Ltd. Mastering Neural Networks. Cybellium, tarihsiz elektronik baskı (sağlanan nüsha).
- Moolchand Sharma, Nebojsa Bacanin ve Tarik Ahmed Rashid (ed.). Quantum-Inspired Neural Networks: Future Perspectives and Challenges. CRC Press, DOI: https://doi.org/10.1201/9781003682950 (nüshanın telif sayfası ©2027).