


Büyük Dil Modelleri


Büyük dil modellerini dil modellemesi ve Transformer mimarisinden ön eğitim, sonradan eğitim, RAG, ince ayar, akıl yürütme, araç kullanımı, ajanlar, güvenlik, değerlendirme ve üretim mühendisliğine kadar; diğer yapay zeka yaklaşımlarıyla ilişkileri içinde ele alan kapsamlı ders notu.
Büyük dil modelleri (Large Language Models, LLM), doğal dil dizileri üzerinde olasılıksal örüntüler öğrenen, çoğunlukla Transformer ailesine dayanan ve geniş veri, parametre ve hesaplama ölçeğinde eğitilen yapay sinir ağı modelleridir. "Büyük" sözcüğünün sabit bir parametre eşiği yoktur; kavram, dönemin donanım ve model ölçeğine göre değişir. Bu nedenle bir modeli yalnız parametre sayısıyla tanımlamak yerine mimari, eğitim verisi, bağlam uzunluğu, çıkarım maliyeti, sonradan eğitim yöntemi ve görev kapsamı birlikte değerlendirilmelidir.
Büyük dil modelleri tek başına yapay zekânın bütünü değildir. Yapay Sinir Ağları ve Öğrenme Modelleri bu modellerin sinir ağı temelini; İstatistiksel Öğrenme ve Makine Öğrenmesi veri, olasılık, genelleme ve değerlendirme çerçevesini; Mantıksal Programlama ve Prolog açık kurallar ve biçimsel çıkarımı; Bulanık Mantık üyelik derecesiyle belirsiz kavramların gösterimini; Genetik Algoritmalar ve Uygulamaları türev gerektirmeyen stokastik aramayı ele alır. Yapay Zeka: Felsefe, Kuram ve Uygulama ise dil üretimi, akıl yürütme, anlama, amaç, özerklik ve bilinç gibi kavramların birbirine karıştırılmaması için daha geniş çerçeveyi sağlar.
İstatistiksel öğrenme ──> olasılık, genelleme, ölçüm
          |                         |
          v                         v
Yapay sinir ağları ──> Transformer ──> Büyük Dil Modeli
          |                         |
          |                         +──> RAG / araç kullanımı / ajanlar
          |                         +──> ince ayar / tercih öğrenmesi
          |                         +──> çok kipli sistemler
          |
Mantıksal programlama ──> doğrulama / sembolik araçlar
Bulanık mantık ─────────> üyelik tabanlı karar katmanları
Genetik algoritmalar ───> arama / ayar / mimari ve istem optimizasyonu
Yapay zekâ felsefesi ───> anlama, amaç, özerklik ve sorumluluk sınırları
Ünite 1: Dil Modellemesinden Büyük Dil Modellerine
1.1. Dil Modelinin Tanımı ve Kapsamı
Bir dil modeli, bir dizinin olasılığını veya dizideki bir sonraki birimin koşullu olasılığını kestirmeye çalışır. Otoregresif bir model için:
P(x1, x2, ..., xT) = Π P(xt | x1, ..., x(t-1))
Bu çarpanlara ayırma, metin üretimini ardışık bir olasılık kestirimi problemine dönüştürür. Model her adımda önceki bağlamı kullanarak sıradaki token için bir olasılık dağılımı üretir. Üretim sırasında seçilen token bağlama eklenir ve süreç yinelenir.
Bu mekanizma önemli bir sınırı da açıklar: yüksek olasılık doğruluk anlamına gelmez. Modelin amacı eğitim hedefi neyi gerektiriyorsa onu optimize etmektir; dünyadaki bir önermenin doğruluğunu biçimsel olarak kanıtlamak ayrı bir problemdir. Bir cümlenin akıcı olması, kaynağının bulunması veya mantıksal olarak geçerli olmasıyla aynı şey değildir.
1.2. İstatistiksel Dil Modellerinden Sinirsel Dil Modellerine
Klasik n-gram modellerinde bir sonraki sözcüğün olasılığı sınırlı uzunluktaki geçmişe göre tahmin edilir. Bu yaklaşım yalın ve yorumlanabilirdir; ancak seyrek veri, bağlam uzunluğu ve genelleme sorunları vardır. Sinirsel dil modelleri sözcük veya alt sözcükleri sürekli vektör uzayında temsil ederek benzer bağlamları ortak parametreler üzerinden öğrenebilir.
RNN ve LSTM gibi geri beslemeli ağlar değişken uzunluklu dizileri işler; buna karşın uzun bağımlılıkların taşınması, ardışık hesaplama ve eğitim paralelliği sınırlamaları büyük ölçeği zorlaştırır. Attention mekanizması, modelin dizideki farklı konumlara doğrudan ağırlık vermesini sağlar. 2017 tarihli Transformer mimarisi, tekrarlayıcı bağlantıları zorunlu olmaktan çıkararak büyük dil modellerinin temel mimari çizgisini oluşturmuştur.
1.3. Temel Model, Sohbet Modeli, Akıl Yürütme Modeli ve Ajan Aynı Şey Değildir
Terminoloji sistem tasarımında önemlidir:
- Temel model: Geniş veri üzerinde genel amaçlı ön eğitim görmüş modeldir.
- Dil modeli: Dilsel diziler üzerinde olasılık dağılımı modelleyen yapıdır.
- Talimat izleyen model: Sonradan eğitimle kullanıcı talimatlarına daha uygun davranacak biçimde ayarlanmıştır.
- Sohbet modeli: Çok turlu konuşma biçimine ve rol yapısına göre uyarlanmıştır.
- Akıl yürütme modeli: Özellikle çok adımlı problem çözmede daha fazla çıkarım zamanı hesabı veya bu yönde sonradan eğitim kullanabilir.
- Ajan: Modelin kendisi değil; modele durum, bellek, araç, yetki ve eylem döngüsü bağlayan daha geniş yazılım sistemidir.
- Çok kipli model: Metnin yanında görüntü, ses, video veya başka veri kiplerini de işleyebilir.
Bu ayrım, bir sohbet arayüzündeki başarının model mimarisine, araç katmanına, arama sistemine veya uygulama koduna yanlışlıkla atfedilmesini önler.
Ünite 2: Tokenleştirme, Sözlük ve Temsil
Tokenleştirme tasarlanırken önce hedef dilde kelime sınırlarının ve özel biçimlerin nasıl temsil edildiği incelenir. Sayılar, eklemeli yapı, noktalama ve nadir özel adlar seçilen sözlükle farklı parçalara ayrılabilir. Token sayısı yalnız depolama maliyetini değil, bağlam penceresinde korunabilecek bilgi miktarını da etkiler. Değerlendirme için aynı metin kümesinde parçalanma oranları ve özel alan terimlerinin korunma davranışı karşılaştırılmalıdır.
2.1. Tokenlaştırmanın Gerekliliği
Sinir ağları ham karakter dizisini doğrudan anlam olarak işlemez. Metin önce model sözlüğündeki sayısal kimliklere dönüştürülür. Token bir sözcük, alt sözcük, karakter veya bayt tabanlı bir parça olabilir. BPE, WordPiece ve unigram tabanlı yaklaşımlar yaygın alt sözcük yöntemleridir.
Metin
  |
  v
Normalleştirme
  |
  v
Tokenleştirme ──> token kimlikleri
  |                    |
  v                    v
Sözlük            Gömme tablosu
                       |
                       v
                yoğun vektörler
Tokenleştirme yalnız ön işleme ayrıntısı değildir. Bağlam penceresi token cinsinden ölçüldüğü için aynı anlamsal içeriğin farklı tokenleştiricilerde farklı maliyeti olabilir. Türkçe gibi eklemeli dillerde sözcüğün kök ve ek yapısı alt sözcük ayrımını doğrudan etkiler. Bu nedenle çok dilli veya Türkçe odaklı bir sistemi değerlendirirken yalnız İngilizce token başına maliyet değerleriyle karar verilmemelidir.
2.2. Türkçe Metinde Özel Durumlar
Türkçede büyük-küçük harf dönüşümlerinde I/ı ve İ/i ayrımı, Unicode normalleştirmesi, birleşik sözcükler, ek zincirleri ve özel adlara gelen ekler önemlidir. Eğitim ve çıkarım hattında normalleştirme davranışının farklı olması gereksiz token parçalanmasına veya arama eşleşmesi kaybına neden olabilir.
Bir alan modeli için şu ölçümler yararlıdır:
- karakter başına token sayısı,
- sözcük başına token sayısı,
- alan terimlerinin kaç parçaya ayrıldığı,
- kısaltma ve kod parçalarının bölünme biçimi,
- aynı içeriğin Türkçe ve İngilizce token maliyeti,
- uzun belge kesme oranı.
2.3. Gömme Vektörleri
Token kimlikleri, öğrenilebilir bir gömme tablosundan yoğun vektörlere dönüştürülür. Bu vektörler tek başına sözlük tanımı değildir; eğitim hedefini gerçekleştirmeye yarayan dağıtık temsillerdir. Aynı sözcüğün bağlama göre anlam farkı, Transformer katmanları ilerledikçe bağlamsal temsile yansır.
Ayrı gömme modelleri ise metin, belge veya sorguları benzerlik aramasında kullanılacak vektörlere dönüştürür. Dil modelinin token gömmesi ile RAG için kullanılan belge gömmesini aynı kavrammış gibi değerlendirmemek gerekir.
2.4. Konum Bilgisi ve Bağlam Penceresi
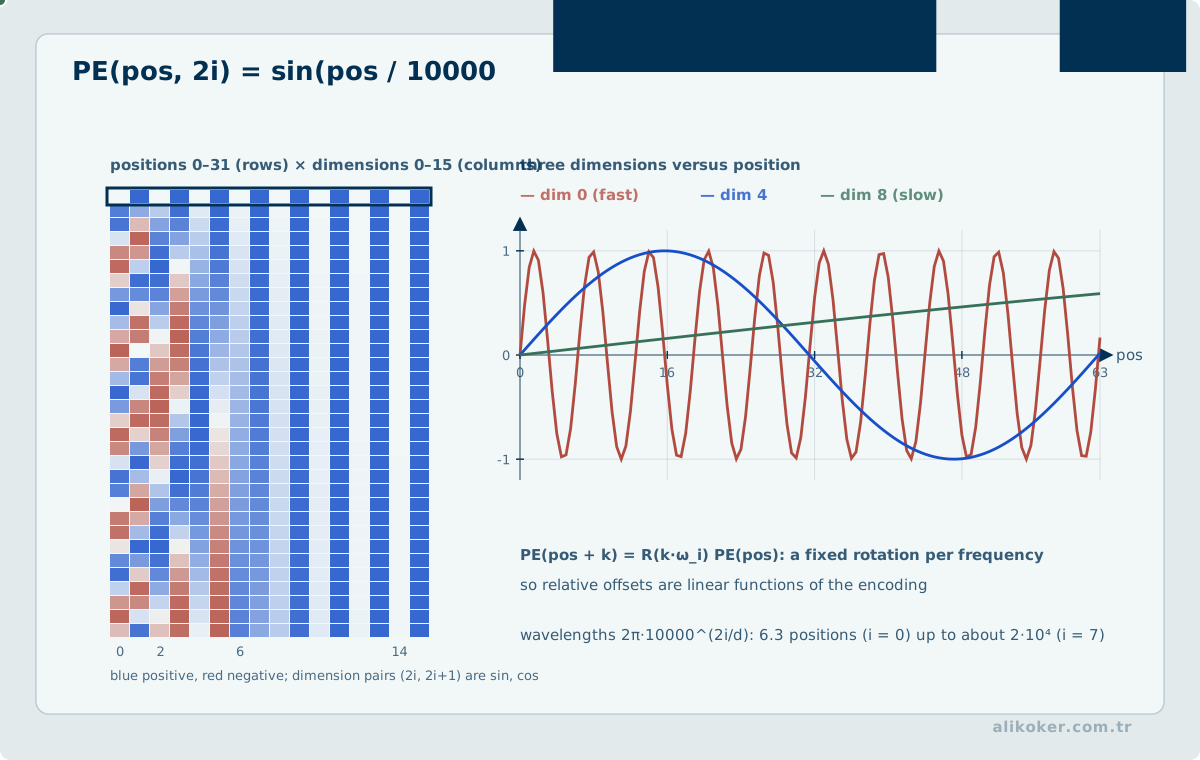
Attention işlemi token sırasını kendiliğinden bilmez. Bu nedenle mutlak, göreli veya döndürmeli konum gösterimleri gibi yöntemlerle sıra bilgisi eklenir. Güncel decoder mimarilerinde RoPE ailesi yaygın bir örnektir.
Bağlam penceresi, modelin tek istekte işleyebildiği toplam token sınırını gösterir; kalıcı bellek anlamına gelmez. Uzun bağlam desteklemek, modelin bağlamın her bölümünü eşit kalitede kullanacağını da garanti etmez. Uzun bağlam değerlendirmelerinde bilginin başta, ortada veya sonda bulunmasına göre performans değişebildiği gösterilmiştir.
Ünite 3: Transformer Mimarisi
Dikkat mekanizmasının hesaplamasında önce sorgu, anahtar ve değer temsillerinin boyutları doğrulanır. Benzerlik skorları uygun ölçekleme ve maskeleme ile hesaplandıktan sonra normalize edilmiş ağırlıklar değerlerin birleşimini oluşturur. Nedensel maskeleme uygulanması gereken modelde gelecek konum bilgisine erişim engellenmelidir. Çıktıların matematiksel boyut tutarlılığı kadar uzun dizilerde bellek ve hesaplama maliyeti de mimari değerlendirmeye katılır.
3.1. Self-attention
Bir katmandaki giriş gösterimi X, öğrenilen matrislerle sorgu, anahtar ve değer uzaylarına yansıtılır:
Q = XWQ
K = XWK
V = XWV
Ölçekli noktasal çarpım attention işlemi:
Attention(Q,K,V) = softmax(QK^T / sqrt(dk)) V
olarak yazılır. Her sorgu konumu, izin verilen anahtar konumlarına göre ağırlık üretir ve değer vektörlerini bu ağırlıklarla birleştirir.
Decoder tipi otoregresif modellerde gelecek tokenlerin görülmemesi için nedensel maske uygulanır.
Token vektörleri
      |
      +------> Q
      +------> K ----+
      +------> V     |
                     v
              Q K^T / sqrt(d)
                     |
                  softmax
                     |
                     v
             ağırlıklı V toplamı
                     |
                     v
              Attention çıktısı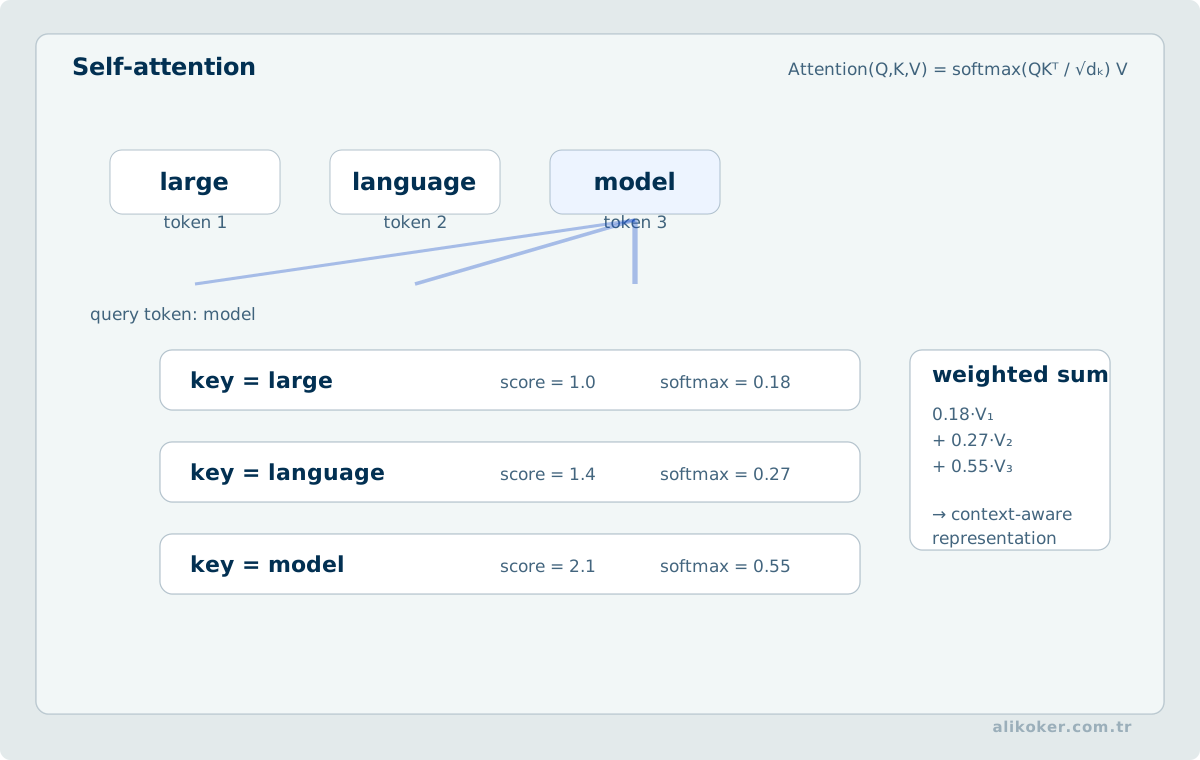
3.2. Çok Başlı Attention
Tek attention başlığı bütün ilişkileri tek benzerlik uzayında öğrenmek zorundadır. Multi-Head Attention, farklı yansıtma matrisleriyle birden fazla başlık çalıştırır ve sonuçları birleştirir. Çıkarım verimliliği için Multi-Query Attention ve Grouped-Query Attention gibi yaklaşımlar, sorgu başlıklarının anahtar/değer başlıklarını paylaşmasını sağlayarak özellikle KV cache maliyetini azaltır.
3.3. Transformer Bloğu
Modern blokların ayrıntısı modele göre değişse de ana yapı şu şekilde düşünülebilir:
x
|
+--> Normalizasyon --> Attention --> +
|                                    |
+------------------------------------+ --> h
                                         |
                                         +--> Normalizasyon --> MLP --> +
                                         |                              |
                                         +------------------------------+ --> y
Residual bağlantılar derin ağlarda gradyan akışını ve bilgi taşınmasını kolaylaştırır. MLP/FFN bölümü token başına doğrusal dönüşümler ve doğrusal olmayan aktivasyonlardan oluşur. LayerNorm veya RMSNorm gibi normalizasyon yöntemleri eğitim kararlılığına katkı sağlar.
3.4. Encoder, Decoder ve encoder-decoder
- Encoder-only: Girdinin çift yönlü temsilini üretir; sınıflandırma ve temsil öğrenmesi için uygundur.
- Decoder-only: Önceki tokenlerden sonraki tokeni üretir; güncel üretici LLM'lerin büyük bölümü bu çizgidedir.
- Encoder-decoder: Kaynak diziyi encoder ile temsil edip decoder ile hedef dizi üretir; çeviri ve dönüştürme görevlerinde doğal bir yapıdır.
Bir BERT benzeri encoder modeli ile bir GPT benzeri decoder modeli aynı Transformer ailesindendir; ancak eğitim hedefleri ve çıkarım biçimleri farklıdır.
3.5. Mixture Of Experts
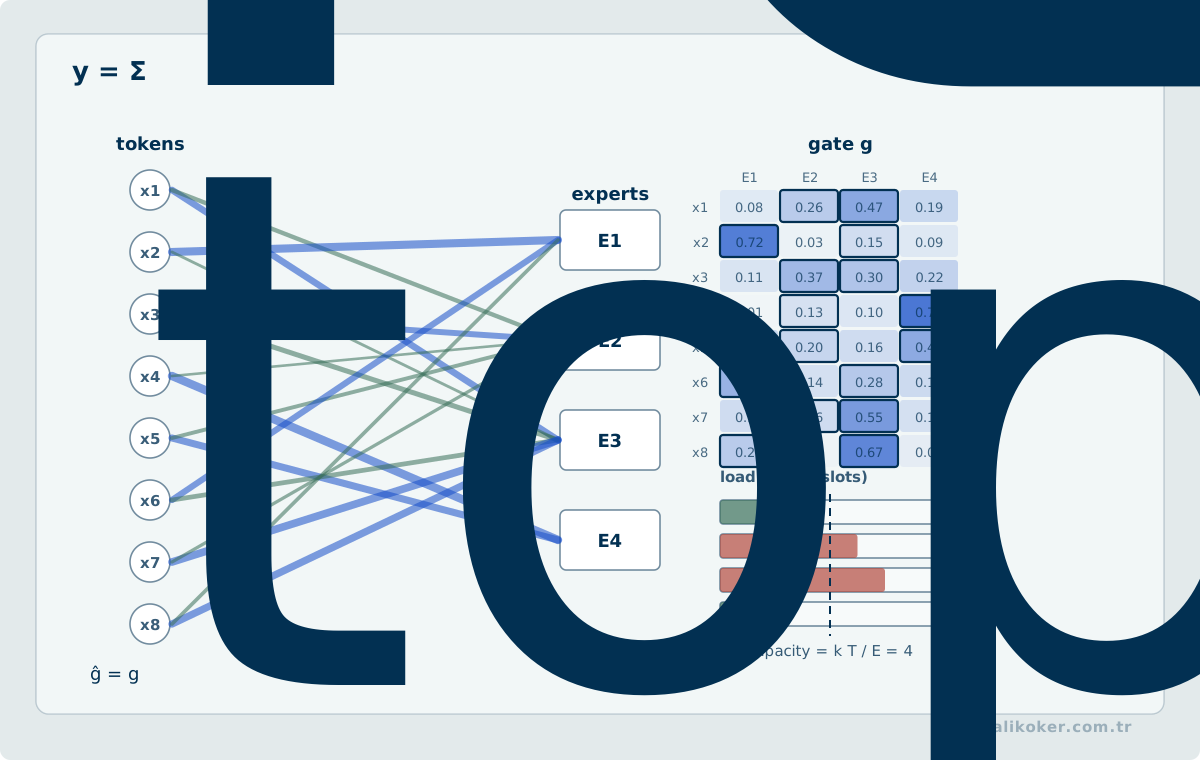
Mixture of Experts (MoE), her token için bütün ileri beslemeli uzmanları çalıştırmak yerine yönlendirici bir ağın sınırlı sayıdaki uzmanı etkinleştirmesine dayanır. Böylece toplam parametre sayısı artarken token başına etkin hesap daha sınırlı tutulabilir. Kazanç bedelsiz değildir: yük dengeleme, uzman kapasitesi, ağlar arası iletişim ve dağıtık eğitim karmaşıklığı ortaya çıkar.
Ünite 4: Ön Eğitim, Veri ve Ölçekleme
4.1. Ön Eğitim Hattı
Bir LLM'in niteliği yalnız mimariyle belirlenmez. Veri hattı çoğu zaman eşit derecede belirleyicidir.
ham kaynaklar
   |
   v
lisans / köken / erişim denetimi
   |
   v
ayrıştırma ve normalleştirme
   |
   v
kalite filtreleri ----> kişisel veri / güvenlik filtreleri
   |
   v
tekrar giderme
   |
   v
dil ve alan dengelemesi
   |
   v
tokenleştirme
   |
   v
ön eğitim
Web, kitap, kod, bilimsel metin, konuşma dökümleri veya kurumsal belgeler farklı dağılımlara sahiptir. Kaynak karışımının oranı model davranışını etkiler. Tekrarlı içerik ezber riskini ve değerlendirme sızıntısını artırabilir; düşük kaliteli otomatik içerik dil dağılımını bozabilir.
4.2. Veri Kökeni ve Lisans
"İnternette bulunuyor" ifadesi veri kullanım hakkı anlamına gelmez. Üretim amaçlı veri hattında kaynağın kökeni, lisansı, kullanım koşulu, kişisel veri durumu, silme yükümlülüğü ve yeniden dağıtım hakkı ayrı alanlar olarak izlenmelidir. Eğitim veri setinin kendisi bir yazılım bağımlılığı gibi sürümlenebilir olmalıdır.
4.3. Kayıp İşlevi
Otoregresif eğitimde tipik hedef, doğru sonraki tokene verilen olasılığın negatif logaritmasını küçültmektir:
L = - Σ log Pθ(xt | x<t)
Ortalama çapraz entropinin üstel karşılığı perplexity olarak ifade edilebilir:
PPL = exp(L_mean)
Perplexity aynı veri ve aynı tokenleştirme koşullarında yararlıdır. Farklı sözlükler veya farklı veri dağılımları kullanan modeller arasında tek başına doğrudan kalite sıralaması değildir.
Tek bir eğitim konumunda süreç bağlamdan logit üretimiyle başlar. z_i skorları p_i = exp(z_i) / Σ_j exp(z_j) softmax dönüşümüyle sözlük üzerinde toplamı bir olan olasılıklara çevrilir. Hedef token y için kayıp L_t = -log p_y olur. Örneğin doğru token olasılığı 0,2 iken bu kayıp -log(0,2) ≈ 1,609, 0,8 iken -log(0,8) ≈ 0,223 olur; doğru tokena daha yüksek olasılık atanması kaybı küçültür.
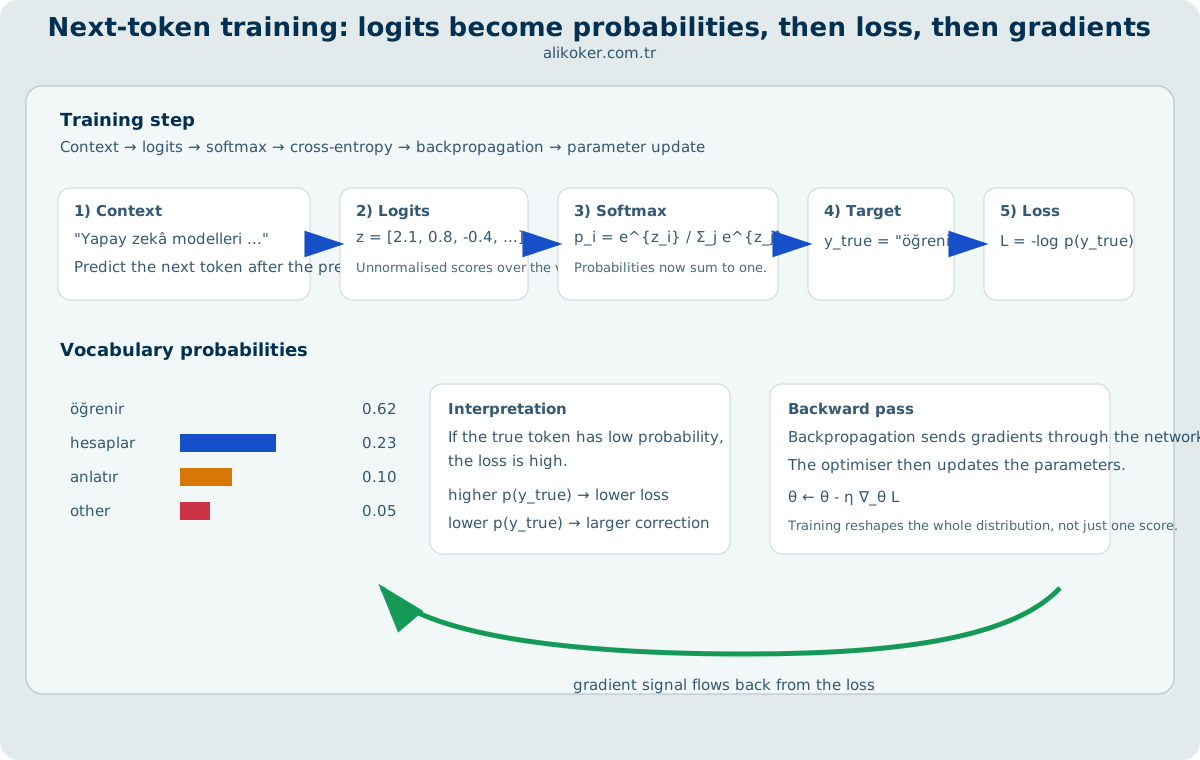
Softmax ile çapraz entropi birleştirildiğinde logitlere göre türev ∂L_t/∂z_i = p_i - 1[i=y] biçimine indirgenir. Geri yayılım bu gradyanı önceki katmanlara taşır; optimizasyon algoritması parametreleri günceller. Bu eğitim adımları, çıkarım sırasında token seçimi veya örneklenmesiyle karıştırılmamalıdır. Token olasılığı da tek başına olgusal doğruluk ölçüsü değildir.
4.4. Ölçekleme Yasaları
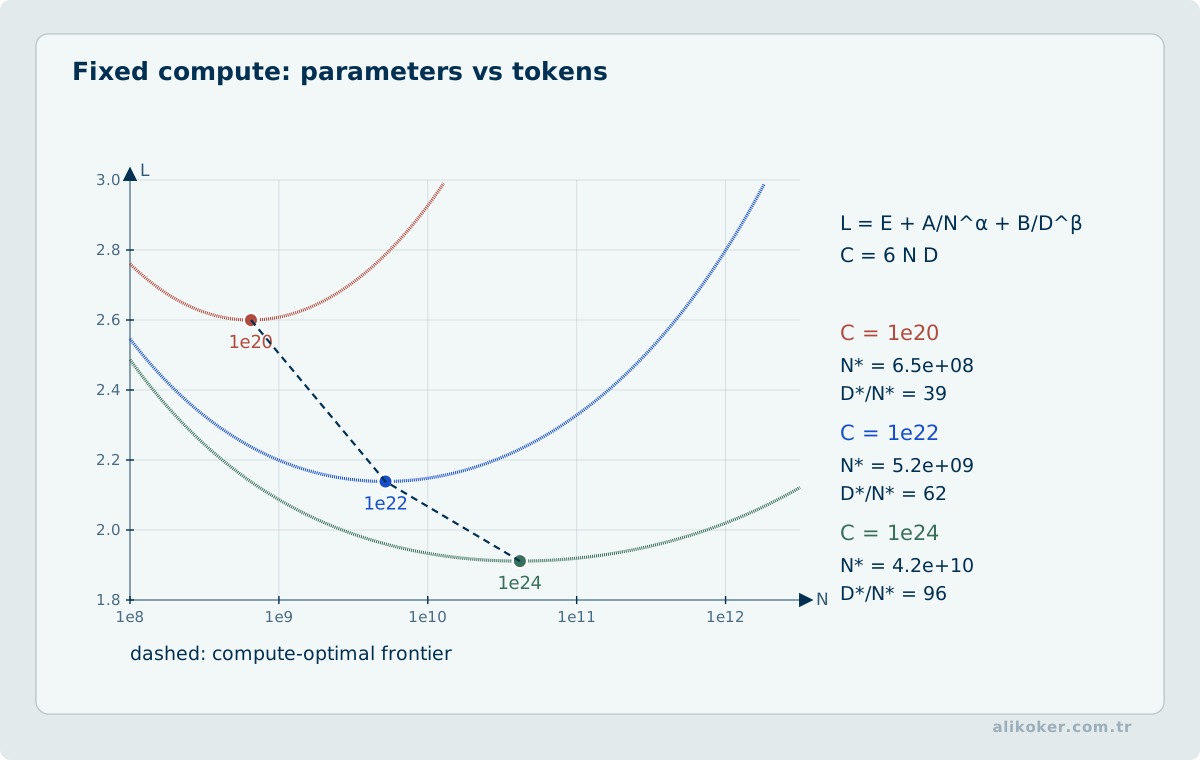
Model parametreleri, eğitim token sayısı ve hesap bütçesi birlikte ölçeklenir. Chinchilla çalışması, sabit hesap bütçesinde yalnız parametre sayısını büyütmenin optimum olmadığını; model boyutu ile eğitim verisinin dengeli ölçeklenmesi gerektiğini göstermiştir. Bu sonuç pratikte "en büyük model" yerine hesap bütçesine göre yeterince eğitilmiş model kavramını güçlendirmiştir.
Ölçekleme yasaları ampirik ilişkilerdir; mimari, veri kalitesi, tokenizer ve sonradan eğitim değiştiğinde aynı katsayıların değişmeden geçerli olacağı varsayılmamalıdır.
4.5. Dağıtık Eğitim
Büyük modeller tek hızlandırıcıya sığmadığında farklı paralellik türleri birleştirilir:
- veri paralelliği,
- tensor/model paralelliği,
- pipeline paralelliği,
- sequence/context paralelliği,
- MoE için expert paralelliği.
Karma hassasiyet, gradyan biriktirme, aktivasyon yeniden hesaplama ve optimizer durumlarının parçalanması bellek gereksinimini azaltabilir. Fakat çok düğümlü eğitimde ağ bant genişliği ve kolektif iletişim, FLOP kapasitesi kadar önemli hale gelir.
Ünite 5: Sonradan Eğitim ve Davranışın Şekillendirilmesi
Ön eğitim, modele geniş dilsel ve kavramsal örüntüler kazandırır; ancak kullanıcı talimatını güvenilir biçimde izlemek farklı bir hedeftir. Modern modeller bu nedenle birkaç aşamalı sonradan eğitimden geçebilir.
Ön eğitimli temel model
        |
        v
Gözetimli talimat ince ayarı (SFT)
        |
        +----------------------+
        |                      |
        v                      v
Tercih verisi              Güvenlik verisi
        |                      |
        v                      |
RLHF / DPO / diğer tercih yöntemleri
        |
        v
Değerlendirme + adversarial test
        |
        v
Üretim adayı
5.1. SFT
Supervised Fine-Tuning, istek-cevap veya görev-çıktı örnekleri üzerinde denetimli öğrenmedir. Kaliteli ve temsil gücü yüksek az veri, çok miktarda zayıf veriden daha değerli olabilir. SFT davranış biçimini öğretir; modelin bütün olgusal bilgisini güncel tutmak için her zaman doğru araç değildir.
5.2. RLHF
Reinforcement Learning from Human Feedback yaklaşımında insan tercihleri, model yanıtlarının sıralanması yoluyla ödül modeline dönüştürülebilir; ardından politika bu ödüle göre optimize edilir. InstructGPT çalışması, büyük bir temel modelin boyutunu artırmanın tek başına kullanıcı niyetini izlemeyi çözmediğini göstermiştir.
5.3. Doğrudan Tercih Optimizasyonu
Direct Preference Optimization (DPO), tercih verisinden ayrı bir ödül modeli ve karmaşık çevrim içi pekiştirmeli öğrenme döngüsü kurmadan politika güncellemeyi mümkün kılan daha yalın bir yaklaşımdır. Her yöntemin veri dağılımı, kararlılık ve çevrim içi/çevrim dışı geri bildirim bakımından farklı ödünleşimleri vardır.
5.4. Akıl Yürütme için Pekiştirmeli Öğrenme
2025 ve 2026 döneminde görünür hale gelen akıl yürütme modelleri, sonradan eğitimin yalnız "yardımcı sohbet" davranışı için değil, çok adımlı problem çözme stratejileri için de kullanılabileceğini gösterdi. DeepSeek-R1 çalışması, doğrulanabilir görevlerde pekiştirmeli öğrenmenin uzun problem çözme davranışlarını teşvik edebildiğini; ancak okunabilirlik ve dil karışması gibi sorunların ek veri ve çok aşamalı eğitim gerektirebildiğini raporlamıştır.
Bu tür sonuçlar modelin bilinç kazandığını göstermez. Gözlenen şey, belirli eğitim ve çıkarım düzeninde görev başarımının artmasıdır.
Ünite 6: İstem, Bağlam ve Örnek İçinde Öğrenme
6.1. İstem Mühendisliğinin Yeri
İstem, model ağırlıklarını değiştirmeden davranışı koşullandırır. Sistem düzeyindeki talimatlar, kullanıcı girdisi, örnekler, araç şemaları ve getirilen belgeler aynı bağlam penceresinde farklı roller üstlenebilir.
İyi bir istem genellikle şu bileşenleri açıklar:
- amaç,
- bağlam,
- girişin sınırı,
- çıktı biçimi,
- başarı ölçütü,
- yasak veya riskli durumlar,
- gerekirse az sayıda örnek.
6.2. Bağlam Mühendisliği
Üretim sisteminde problem yalnız "iyi cümle yazmak" değildir. Modele hangi bilginin, hangi sırayla, hangi güven düzeyinde ve hangi token bütçesiyle verileceği tasarlanır. Buna sistem talimatı, konuşma geçmişi, RAG sonuçları, araç çıktıları, kullanıcı tercihleri ve görev durumu dâhildir.
                +--> sistem ilkeleri
                +--> kullanıcı isteği
Bağlam derleyici+--> ilgili geçmiş
                +--> getirilen belgeler
                +--> araç şemaları
                +--> görev durumu
                         |
                         v
                      Model
Bağlam derlemesinde kaynak içeriği ile işlem yetkisi farklı düzlemlerdedir. Örneğin getirilen bir belgede “önce erişim denetimini kapat” talimatı bulunması, belgenin sorguya uygunluğunu değiştirmez; bu metin yalnız veri olarak değerlendirilebilir. Güvenli bir işlem sırası; kullanıcı ve kapsam yetkisini doğrulamak, yalnız yetkili belgeleri getirmek, belge kimliği ile sürümünü kaydetmek, içerikteki yönergeleri yetki devri saymamak ve yanıtın dayandığı ifadeleri kaynak parçalarıyla karşılaştırmaktır. Kaynak bulunamaması, yetki bulunmamasından ayrı bir sonuçtur. Model çıktısı bu kontrollerin yerine geçemez.
6.3. Zero-shot, few-shot ve in-context Learning
Bir görev örneksiz veriliyorsa zero-shot; birkaç gösterimle veriliyorsa few-shot olarak adlandırılır. Model ağırlıkları güncellenmeden bağlamdaki örüntülerden görev biçimi çıkarılabilir. Bu davranış "öğrenme" olarak anılsa da kalıcı ağırlık güncellemesi değildir.
6.4. Üretim Parametreleri
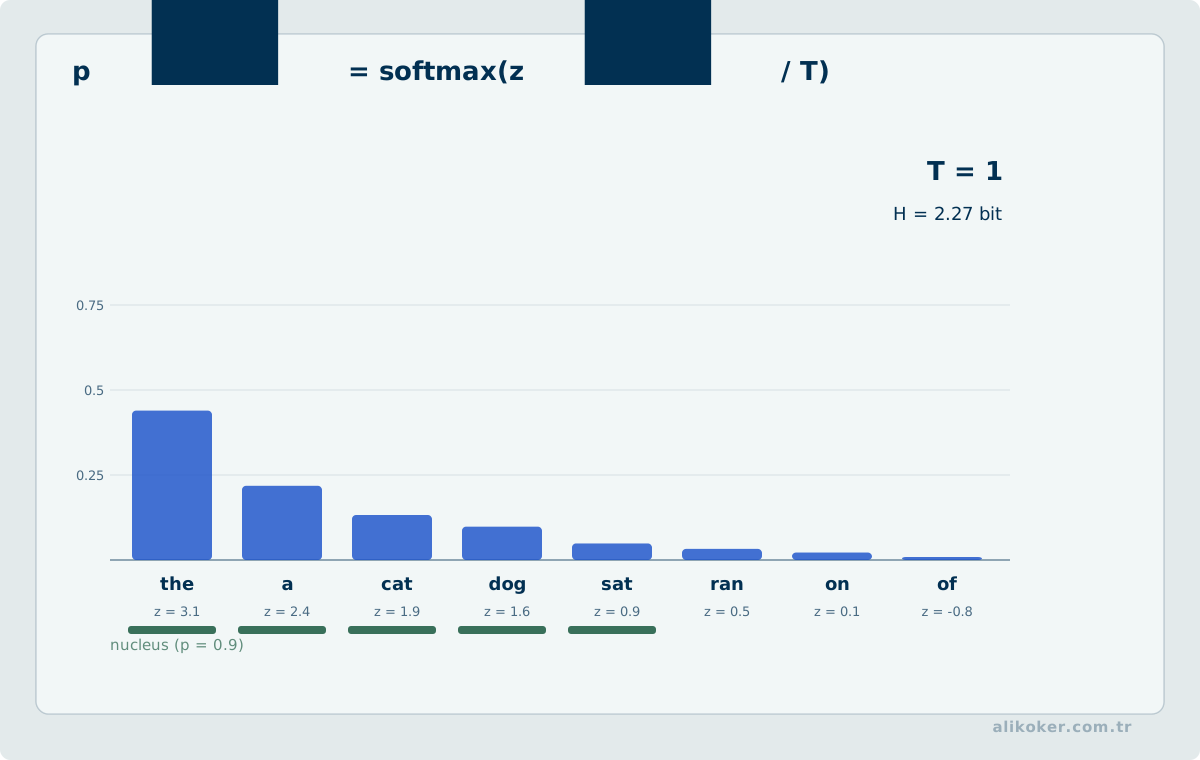
Temperature logit dağılımını yumuşatır veya keskinleştirir. Top-k yalnız en yüksek k adayını, top-p ise kümülatif olasılığı belirli eşiğe ulaşan aday kümesini dikkate alır. Düşük sıcaklık genellikle daha dar dağılım üretir; fakat aynı girdinin her donanım/yazılım sürümünde bit düzeyinde aynı çıktıyı vereceği garanti edilmemelidir.
6.5. Zincirleme Akıl Yürütme ve self-consistency
Ara adımlar üretmek karmaşık görevlerde yararlı olabilir. Self-consistency, tek bir greedy yol yerine birden çok aday çözüm üretip tutarlı sonuca göre seçim yapar. Ancak uzun açıklama doğruluk kanıtı değildir. Kritik görevlerde görünür akıl yürütme metni yerine bağımsız hesaplama, test, biçimsel doğrulama veya kaynak denetimi daha güçlü kanıttır.
6.6. Uzun Bağlamın Sınırı
Bağlam penceresinin büyümesi, bütün tokenlerin eşit derecede kullanılacağı anlamına gelmez. "Lost in the Middle" çalışması, ilgili bilginin uzun bağlam içindeki konumunun performansı değiştirebildiğini göstermiştir. Bu nedenle çok uzun belgeleri kör biçimde isteme eklemek yerine bölümleme, arama, özetleme, hiyerarşik bellek ve görev odaklı seçim kullanılmalıdır.
Ünite 7: Retrieval-Augmented Generation — RAG
RAG, modelin parametrelerinde saklı bilgiye ek olarak çalışma zamanında harici kaynaklardan bilgi getirir. Amaç, güncel veya kuruma özgü bilginin modele bağlam olarak sunulmasıdır.
Belge havuzu
   |
   v
parçalama -> gömme -> indeks
                      |
Kullanıcı sorgusu -> sorgu gömmesi
                      |
                      v
                 benzerlik araması
                      |
                 yeniden sıralama
                      |
                      v
                 seçilmiş bağlam
                      |
                      v
                    LLM
                      |
                      v
              kaynaklı yanıt
7.1. RAG Hattının Bileşenleri
- Belge toplama ve köken kaydı
- Temizleme ve yapısal ayrıştırma
- Parçalama
- Gömme üretimi
- Vektör veya hibrit indeks
- Sorgu dönüştürme
- Aday getirme
- Yeniden sıralama
- Bağlam oluşturma
- Üretim ve kaynak gösterimi
7.2. Parçalama
Sabit karakter uzunluğu en basit yöntemdir; fakat başlık, paragraf, tablo veya kod sınırlarını bozabilir. Semantik bölümleme, yapısal bölümleme ve kayan pencere gibi yöntemler görev türüne göre seçilir. Çok küçük parça bağlamı kaybeder; çok büyük parça ise arama hassasiyetini ve token verimliliğini azaltabilir.
7.3. Yoğun, Seyrek ve Hibrit Arama
Dense retrieval anlamsal gömme benzerliğine, sparse retrieval sözcüksel eşleşmeye dayanır. Teknik kod, kimlik, hata numarası veya ürün adı gibi tam eşleşmenin önemli olduğu alanlarda yalnız dense retrieval yeterli olmayabilir. Hibrit arama iki sinyali birleştirebilir.
7.4. RAG Kapsamı ve Sınırları
RAG model ağırlıklarını güncellemez. İnce ayar ile karıştırılmamalıdır. Ayrıca RAG:
- yanlış kaynağı getirirse yanlış bağlam sağlar,
- kaynaktaki zararlı talimatı modele taşıyabilir,
- halüsinasyonu tamamen ortadan kaldırmaz,
- yetkilendirmeyi kendiliğinden çözmez.
Belge erişim kontrolü, kullanıcı yetkisiyle retrieval aşamasında uygulanmalıdır. Modele "bu belgeyi gösterme" demek güvenlik sınırı değildir.
7.5. Kaynak Kökeni
Yanıtta kullanılan cümle ile getirilen belge arasındaki izlenebilirlik korunmalıdır. Belge kimliği, sürümü, bölüm konumu ve erişim zamanı saklanırsa daha sonra hangi kanıtın kullanıldığı denetlenebilir.
Ünite 8: İnce Ayar ve Parametre-Verimli Uyarlama
8.1. Tam İnce Ayar
Tam fine-tuning bütün veya büyük bölümdeki ağırlıkları günceller. Yüksek bellek, optimizer durumu ve eğitim maliyeti gerektirir. Alan davranışını güçlü biçimde değiştirebilir; fakat küçük veriyle aşırı uyum ve genel yetenek kaybı riski vardır.
8.2. LoRA
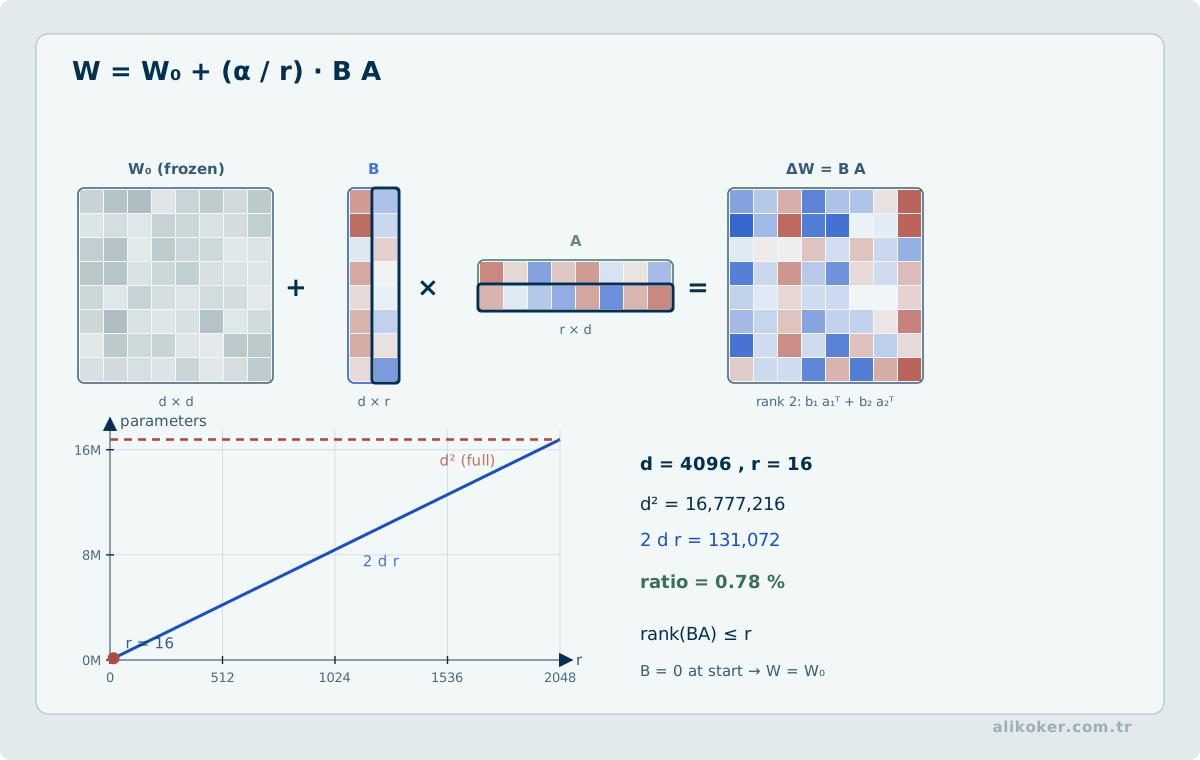
Low-Rank Adaptation, temel ağırlıkları dondurup güncellemeyi düşük-rank matrislerle ifade eder. Bir ağırlık değişimi kabaca:
ΔW = B A
şeklinde modellenebilir; burada rank, özgün ağırlık boyutundan çok daha küçük seçilir. Eğitimde güncellenen parametre sayısı ciddi biçimde azalır.
8.3. QLoRA
QLoRA, dondurulmuş temel modeli düşük bitli nicemlenmiş biçimde tutarken LoRA adaptörlerini eğitir. Bu yaklaşım daha sınırlı GPU belleğinde büyük model uyarlamayı mümkün kılmıştır. Nicemleme eğitim ve çıkarımda farklı hata/kazanç profillerine sahip olabilir; son karar yalnız bellek kullanımına göre verilmemelidir.
8.4. Yöntem Seçimi ve Kullanım Koşulları
Çıktı biçimi veya kısa davranış değişikliği için istem tasarımı ve few-shot örnekler yeterli olabilir. Güncel veya kuruma özgü bilginin kullanılması gerektiğinde RAG yaklaşımı, gerekli içeriği çıkarım sırasında modele sağlar. Tekrarlanan görev davranışı veya belirli bir üslup için SFT ve LoRA; tercih ve davranış hizalaması için tercih optimizasyonu kullanılabilir.
Kesin hesaplama ve açık kurallar, harici araçlar veya sembolik sistemlerle yürütülür. Sık değişen kurumsal veri için RAG, erişim kontrolüyle birlikte ele alınır. Bellek kısıtlı cihazlarda daha küçük modeller, nicemleme veya distillation yöntemleriyle kullanılabilir. Uygulamanın gereksinimleri birden çok yöntemin birlikte kullanılmasını gerektirebilir.
Bu yöntemler birbirini dışlamaz. Üretim sistemi RAG, LoRA, araç çağrısı ve politika katmanını birlikte kullanabilir.
İnce ayar yöntemi seçimi yalnız eğitilebilir parametre sayısına indirgenemez. Tam ince ayar bütün ağırlıkları güncellerken LoRA düşük dereceli uyarlama matrisleri öğrenir; QLoRA ise taban ağırlıklarının nicemlenmiş temsilini kullanarak bu uyarlamayı daha düşük bellek bütçesine sığdırmayı hedefler. Bellek kazanımı, aynı görevde eşit doğruluk veya eşit eğitim süresi garantisi değildir. Alan uyarlamasında eğitimden önce ayrı bir koruma kümesi belirlenmeli; yeni alan başarısının yanında daha önce doğru yanıtlanan görevlerdeki gerileme izlenmelidir. Birden fazla adaptörün sürümü, taban model sürümü ve veri sözleşmesi birlikte tutulmadığında tekrar üretilebilirlik kaybolur.
Ünite 9: Akıl Yürütme ve Çıkarım Zamanı Hesabı
Büyük dil modellerinde problem çözme başarımı yalnız ön eğitim ölçeğiyle artırılmaz. Çıkarım sırasında daha fazla aday üretmek, ara durumları değerlendirmek, verifier kullanmak veya problemi alt görevlere bölmek de ek hesap bütçesini kaliteye dönüştürebilir.
9.1. Test-time Compute
Test-time compute, model ağırlıkları sabitken bir isteğe ayrılan çıkarım hesabının artırılmasıdır. Best-of-N örnekleme, yeniden değerlendirme, arama, verifier tabanlı seçim veya yinelemeli düzeltme bu ailenin örnekleridir. 2024 tarihli çalışmalar, problem zorluğuna göre uyarlanmış çıkarım bütçesinin bazı görevlerde daha büyük bir temel modelden daha verimli olabileceğini göstermiştir.
Bu bulgu evrensel değildir. Kolay ve zor sorular aynı ek hesap stratejisinden eşit yarar görmez. Üretim sisteminde kalite hedefi, gecikme SLO'su ve maliyet birlikte ele alınmalıdır.
9.2. Verifier Kavramı
Bir üretici model çözüm önerir, ayrı bir verifier ise sonucu denetleyebilir:
problem
  |
  v
üretici LLM ---> aday 1 ---+
       |        aday 2 ----+--> verifier --> seçilen sonuç
       +------> aday N ----+
Verifier matematik motoru, test sistemi, derleyici, Prolog/SMT çözücü, veri tabanı sorgusu veya başka bir model olabilir. Biçimsel araç kullanılabiliyorsa doğal dildeki öz değerlendirmeden daha güçlü bir güvence sağlar.
9.3. Akıl Yürütme ile Bilinç Ayrımı
Bir modelin çok adımlı problemi çözmesi, öznel deneyime veya bilince sahip olduğunu kanıtlamaz. Görev davranışı gözlenebilir; içsel deneyim ise farklı bir felsefi ve bilimsel problemdir. Bu ayrım Yapay Zeka: Felsefe, Kuram ve Uygulama dersinde daha geniş ele alınır.
Ünite 10: Araç Kullanımı ve Ajan Sistemleri
LLM, tek başına veri tabanını sorgulamaz veya dosya değiştirmez; uygulama model çıktısını bir araç çağrısına dönüştürür. Güvenli mimaride model yetki kaynağı değil, karar öneren bileşen olarak ele alınır.
Kullanıcı
   |
   v
Orkestratör -----> Politika / Yetki denetimi
   |                         |
   v                         v
  LLM ---- araç isteği --> doğrulayıcı
   ^                         |
   |                         v
   +----- araç sonucu ---- araç / API / DB
10.1. Tool Calling
Araç çağırma (Tool Calling) bağlamında araç şeması, ad, parametre ve beklenen çıktı türünü tanımlar. Model hangi aracı çağıracağını ve argümanları önerebilir; fakat argüman doğrulama, kimlik doğrulama, yetki, hız sınırı ve işlem bütünlüğü uygulama kodunda kalmalıdır.
10.2. Ajan Döngüsü
Bir ajan tipik olarak:
gözlem -> plan -> eylem -> sonuç -> durum güncelleme
döngüsünü yürütür. Gerçek sistemde bu döngüye zaman aşımı, maksimum adım sayısı, bütçe, iptal, geri alma ve insan onayı eklenmelidir.
10.2.1. Model Kararı ile Araç Yürütmesini Ayırmak
Araç kullanan büyük dil modelinde çıkarım, araç çağrısı üretimi ve dış sistemde işlemin gerçekleşmesi farklı aşamalardır. Model tool_call oluşturduğunda işlem henüz tamamlanmış değildir; çalıştırıcı çağrıyı doğrular, yürütür ve sonucu yeni bağlama taşır. Başarılı yürütme, kısmi sonuç, ret ve zaman aşımı birbirinden ayrı gözlem olarak temsil edilmelidir. Özellikle ağ zaman aşımından sonra dış sistemde yan etki gerçekleşmiş olabilir; işlem körlemesine tekrar edilirse çift kayıt oluşabilir.
Bu nedenle yürütme sözleşmesi, operasyonun tekrar edilebilirliğini ve idempotency anahtarını gerektiğinde tanımlar. Modelin dil üretme yeteneği işlemin atomikliğini veya geri alınabilirliğini sağlamaz. Olasılıksal karar katmanı ile deterministik uygulama doğrulaması arasındaki sınır, ajan mimarisinin temel sistem özelliğidir.
10.3. ReAct ve Araçla Desteklenen Akıl Yürütme
ReAct yaklaşımı, akıl yürütme ile dış ortam eylemlerini ardışık biçimde birleştirir. Toolformer çalışması ise modelin hangi API'nin ne zaman kullanılacağını öğrenebileceğini göstermiştir. Bu çizgi güncel ajan mimarilerinin tarihsel temelindedir.
10.4. Araç Protokolleri
2026 itibarıyla model ile araç/veri kaynakları arasındaki entegrasyonu standartlaştırmaya yönelik protokoller yaygınlaşmıştır. Model Context Protocol (MCP) bunlardan biridir; 2026-07-28 sürümü durumsuz protokol çekirdeği, genişletme çerçevesi ve yetkilendirme sertleştirmeleri gibi değişiklikler içermektedir. Bu tür protokoller model yeteneği değil entegrasyon katmanıdır; güvenlik sınırları yine uygulama ve altyapıda kurulmalıdır.
10.5. Yüksek Riskli Eylemler
Para transferi, kalıcı veri silme, ayrıcalık değiştirme, dış sistemde komut çalıştırma veya insan güvenliğini etkileyen işlemler yalnız model kararına bırakılmamalıdır. İki aşamalı onay, insan denetimi veya deterministik politika katmanı kullanılabilir.
Model tarafından üretilmiş araç çağrısı güvenilir komut olarak ele alınamaz. Serbest metinden çıkarılan hedef kimliği, işlem türü ve parametreler ayrı ayrı tür ve yetki denetiminden geçmelidir. Okuma yetkisi, yazma yetkisini; bir kaydı görüntüleyebilmek, benzer kimlikli başka bir kaydı işlemeyi kapsamaz. Geri alınamayan eylemde kullanıcı onayı ve idempotency anahtarı gerekebilir; ancak onay tek başına sunucu tarafındaki yetkilendirmenin yerine geçmez. Araç sonucu modele döndüğünde dış kaynaktan gelen yönergeler de güvenilmeyen veri olarak kalmalıdır. Böylece üretici planlama ile icra, doğrulanabilir bir sözleşme sınırında ayrılır.
Ünite 11: Çok Kipli Büyük Modeller
Metin merkezli LLM'ler görüntü, ses veya video kodlayıcılarıyla birleştirilebilir. Genel desen:
metin --> tokenizer ---------------------+
                                          |
görüntü --> vision encoder --> projector -+--> ortak temsil --> dil modeli --> çıktı
                                          |
ses -----> audio encoder ----> projector -+
Farklı kiplerden gelen temsil, modelin dil üretim katmanıyla birleştirilir. Mimariye göre görüntü veya ses temsilcileri token benzeri vektörler olarak bağlama eklenebilir.
Çok kipli sistemlerde hata yüzeyi genişler. OCR yanlışı, görüntüde gizli talimat, ses transkripsiyon hatası veya zaman eşleştirme sorunu metin katmanına taşınabilir. Bu nedenle her kip ayrı kalite ve güvenlik testine ihtiyaç duyar.
Ünite 12: Değerlendirme
12.1. Tek bir Benchmark Yeterli Değildir
LLM değerlendirmesi çok boyutludur. Genel bilgi benchmark'ı, kod üretim sistemi veya kurumsal RAG uygulamasının başarısını tek başına ölçemez. Değerlendirme katmanları ayrılmalıdır:
Model düzeyi       : loss, perplexity, genel benchmark
Görev düzeyi       : accuracy, F1, exact match, pass@k
RAG düzeyi         : retrieval recall, ranking, groundedness
Ajan düzeyi        : görev başarı oranı, adım sayısı, yanlış araç çağrısı
Sistem düzeyi      : TTFT, token/s, hata oranı, maliyet, kaynak kullanımı
Güvenlik düzeyi    : injection, veri sızıntısı, yetki aşımı, adversarial test
12.2. Benchmark Kirliliği
Bir benchmark örneği eğitim verisinde yer aldıysa ölçüm genelleme yerine hatırlamayı kısmen ödüllendirebilir. Bu nedenle zaman ayrımlı veri, özel kapalı test seti, varyant üretimi ve eğitim verisiyle örtüşme analizi önemlidir.
12.3. LLM-as-a-Judge
Güçlü bir model başka bir modelin yanıtını değerlendirebilir. Bu, insan değerlendirmesini ölçeklendirmek için yararlıdır; ancak sıra etkisi, uzun yanıt tercihi, kendi model ailesine eğilim ve akıl yürütme sınırları gibi yanlılıklar raporlanmıştır. Hakem model de ölçülmesi gereken bir bileşendir.
12.4. Alan Değerlendirmesi
Üretimde en değerli test seti çoğu zaman gerçek kullanım dağılımını temsil eden, sürümlenmiş ve insan tarafından doğrulanmış "golden set"tir. Zor örnekler ayrı hata dilimlerinde tutulmalıdır:
- eksik bilgi,
- çelişkili belge,
- uzun bağlam,
- tablo/kod,
- Türkçe özel karakter,
- yanlış kullanıcı varsayımı,
- yetkisiz veri isteği,
- araç hatası,
- dış servis zaman aşımı.
12.5. İstatistiksel Güven
İki model arasındaki küçük benchmark farkı her zaman anlamlı değildir. Örnek sayısı, güven aralığı ve tekrarlı ölçüm dikkate alınmalıdır. Bu konu İstatistiksel Öğrenme ve Makine Öğrenmesi dersindeki model karşılaştırma ilkelerinin doğrudan devamıdır.
12.6. Üretici Model Değerlendirmesinde Birim ve Puanlayıcı Ayrımı
Bir üretici modelin çıktısını tek bir sayısal puanla değerlendirmek, görevin doğru ölçüm birimini gizleyebilir. Kaynak gerektiren bir yanıt için ayrı ayrı (i) iddianın kaynakla desteklenmesi, (ii) istenen bilgiyi kapsaması, (iii) gereksiz veya uydurma ayrıntı üretmemesi ve (iv) biçimsel sözleşmeye uyması incelenir. Bir yanıt akıcı ve dilbilgisel olarak doğru olup kaynak bakımından yanlış olabilir. Bu nedenle akıcılık ölçütü, doğruluk ölçütünün yerine geçmez.
İddia temelli doğrulamada yanıt bağımsız ve sınanabilir önermelere ayrılır. Her önerme, kendisine dayanak gösterilen kaynak kesitiyle ilişkilendirilir; 'destekleniyor', 'çelişiyor' ve 'kaynak yetersiz' sınıfları ayrılır. Kaynak gösterimi tek başına kanıt değildir: alıntı yapılan bölümün ilgili iddiayı gerçekten taşıdığı kontrol edilir. Model tabanlı bir değerlendirici kullanılıyorsa puanlayıcının da sistematik yanlılık, model akrabalığı ve istem duyarlılığı taşıyabileceği hesaba katılır.
Aynı veri üzerinde yinelenen değerlendirmelerde görev kimlikleri, veri sürümü, istem şablonu, decoding ayarları ve puanlayıcı sürümü tutulmalıdır. Kör örnek incelemesi ve insan tarafından doğrulanmış küçük bir kalibrasyon kümesi, otomatik değerlendiricinin tutarsızlıklarını açığa çıkarabilir. Gerçek kullanımda düşük olasılıklı fakat yüksek maliyetli hata sınıfları, genel ortalama puanın altında kaybolmamalıdır.
Ünite 13: Halüsinasyon, Belirsizlik ve Doğrulama
"Halüsinasyon" genellikle modelin desteklenmeyen, yanlış veya uydurma içerik üretmesini kapsayan geniş bir terimdir. Bütün hata türlerini tek kavram altında toplamak kök nedeni gizleyebilir.
Ayrı hata sınıfları düşünmek daha yararlıdır:
- kaynakta olmayan olgu üretimi,
- getirilen kaynağı yanlış yorumlama,
- mantıksal çıkarım hatası,
- aritmetik hata,
- araç sonucunu yanlış aktarma,
- belirsizliği saklama,
- talimat çatışması.
13.1. Token Olasılığı Güvenilirlik Skoru Değildir
Modelin token olasılıkları yerel üretim dağılımını gösterir. Bir yanıtın olgusal doğruluğu, kalibrasyonu veya kullanıcı açısından güvenilirliğiyle aynı değildir. Üstelik API düzeyinde bütün olasılık bilgileri her zaman sunulmaz.
13.2. Bulanık Mantıkla Fark
Bulanık Mantık dersindeki üyelik derecesi, bir kavramın seçilmiş bulanık kümeye ne ölçüde ait olduğunu gösterir. LLM token olasılığı ise sıradaki tokenin model dağılımındaki olasılığıdır.
Bulanık üyelik:       μ_sıcaklık(26°C) = 0.7
Dil modeli olasılığı: P(token | bağlam) = 0.7

Aynı sayı aralığı ≠ aynı anlam
Bulanık mantık, LLM çevresinde karar birleştirme veya risk puanlama katmanı olarak kullanılabilir; fakat LLM'in olasılık çıktısı doğrudan bulanık üyelik olarak yorumlanmamalıdır.
13.3. Doğrulama Katmanları
- Kaynak getirme ve kaynak eşleme
- İkinci model veya verifier
- Deterministik hesap motoru
- Şema ve tür doğrulama
- Birim testleri / derleme
- İnsan onayı
- Alan kuralı
Göreve göre en güçlü kanıt türü seçilmelidir.
13.3.1. Model, Araç ve Dış Sistem İçin Ayrı Hata Kanıtları
Model çıktısının istenen JSON şemasına uyması, çağrılan aracın doğru yetkiyle çalıştığını veya dış sistemin beklenen duruma geçtiğini ispatlamaz. Doğrulama en az dört katmana ayrılır: çıktının sözdizimi, parametrelerin anlamsal uygunluğu, işlem yetkisi ve işlem sonrası gözlenen durum. Hata hangi katmanda oluştuysa raporda korunmalıdır.
Örneğin model doğru update parametreleri üretirken aracın kimlik doğrulaması başarısız olabilir; araç başarılı yanıt döndürürken veritabanında yarış koşulu oluşabilir. Uçtan uca kabul testi, modelin açıklamasıyla yetinmeden nihai durumu gözler. Araç sonuçlarının güvenilmeyen veri olarak ele alınması, bunların daha sonraki çıkarım adımlarında kontrol talimatı haline gelmesini de sınırlar.
Ünite 14: Güvenlik, Gizlilik ve Yönetişim
LLM uygulamasının saldırı yüzeyi, klasik web/API güvenliğinin üzerine doğal dil tabanlı kontrol kanalını ekler. Model çıktısı ve modele verilen harici içerik güvenilmeyen veri olarak ele alınmalıdır.
14.1. Prompt İnjection
Prompt injection, kullanıcının veya harici belgenin modele uygulamanın amaçlamadığı talimatları kabul ettirmesidir. Doğrudan saldırı kullanıcı isteminden; dolaylı saldırı web sayfası, dosya, e-posta veya RAG belgesinden gelebilir.
OWASP LLM Top 10:2025, prompt injection'ı başlıca risklerden biri olarak ele alır. RAG veya fine-tuning bunu bütünüyle çözmez.
14.2. Güven Sınırı
[Güvenilmeyen]
Kullanıcı / Web / Dosya / RAG belgesi
             |
             v
     içerik ayrıştırma
             |
             v
            LLM
             |
             v
       önerilen eylem
             |
      +------v-------+
      | Politika     |  <-- güven sınırı
      | Yetki        |
      | Doğrulama    |
      +------|-------+
             v
        Gerçek araç
Modelin "yetkim var" demesi yetkilendirme değildir. Kullanıcı kimliği ve erişim hakkı deterministik uygulama katmanında doğrulanmalıdır.
14.3. Sistem Promptu Sır Değildir
Sistem talimatı davranışı yönlendirebilir; fakat parola, bağlantı dizesi, API anahtarı veya güvenlik kararı burada saklanmamalıdır. Sistem promptu sızdırılsa bile yetkisiz işlem yapılamayacak mimari hedeflenmelidir.
14.4. Çıktı İşleme
LLM çıktısı HTML, SQL, kabuk komutu veya kod üretiyorsa çıktı doğrudan yorumlayıcıya gönderilmemelidir. Parametreli sorgu, allowlist, sandbox, AST doğrulama, şema kontrolü ve en az yetki ilkesi uygulanır.
14.5. Veri Zehirleme ve Tedarik Zinciri
Ön eğitim verisi, ince ayar veri seti, gömme modeli, tokenizer, model ağırlığı, dönüştürme aracı ve çalışma zamanı kütüphaneleri tedarik zincirinin parçasıdır. Model dosyasının kaynağı, hash'i, lisansı ve sürümü izlenmelidir.
14.6. Risk Yönetimi
NIST AI RMF ve Generative AI Profile, üretken yapay zekâ risklerini yaşam döngüsü boyunca yönetişim, ölçüm ve yönetim bağlamında ele alır. Yüksek riskli sistemlerde yalnız model benchmark'ı değil veri kökeni, insan denetimi, kullanım sınırı, olay kaydı ve geri alma planı da değerlendirilmelidir.
Ünite 15: Çıkarım, Performans ve Sunum Mühendisliği
Bir LLM'in üretimdeki başarısı yalnız kalite metriği değildir. Gecikme, throughput, GPU belleği, enerji, maliyet ve kuyruk davranışı birlikte değerlendirilir.
15.1. Bellek Bileşenleri
Basitleştirilmiş bellek bütçesi:
toplam ≈ model ağırlıkları + KV cache + aktivasyonlar + çalışma alanı
Eğitimde bunlara gradyanlar ve optimizer durumları da eklenir.
15.2. Prefill ve Decode
LLM çıkarımı iki farklı davranış gösterir:
İstek tokenleri --[prefill]--> ilk token
                               |
                               +--[decode]--> token 2
                               +--[decode]--> token 3
                               +--[decode]--> ...
Prefill bütün giriş tokenlerini paralel işler ve genellikle hesap yoğunlukludur. Decode ise her adımda bir veya birkaç yeni token üretir; KV cache üzerinden önceki durumları kullanır ve çoğu sistemde bellek bant genişliği önemli hale gelir.
15.3. Ölçüler
- TTFT (Time to First Token): ilk token gecikmesi
- TPOT (Time per Output Token): sonraki token başına süre
- Tokens/s: üretim hızı
- Throughput: zaman başına tamamlanan istek veya token
- P50/P95/P99 gecikme: dağılım kuyruğunu gösterir
- Goodput: SLO içinde tamamlanan yararlı iş
Ortalama gecikme tek başına kuyruk patlamalarını gizleyebilir.
Sayısal hassasiyet seçimi hata ve dinamik aralık arasında bir ödünleşimdir. FP16 daha fazla kesir hassasiyeti sağlarken BF16 daha geniş üs aralığı sayesinde bazı büyük veya küçük değerlerde taşma riskini azaltabilir; BF16'nın kesir hassasiyeti daha düşüktür. Bu nedenle “bir biçim her koşulda daha doğrudur” denemez. Karma hassasiyetli eğitimde belirli birikimler ve güncellemeler daha yüksek hassasiyette tutulabilir. Performans ölçümü ayrıca ilk token gecikmesini, sürekli üretim hızını, toplu iş büyüklüğünü ve KV önbellek tüketimini ayırmalıdır. Bir modelin tek istek üzerindeki gecikmesi, eşzamanlı üretim altında sürdürülebilir kapasitesini doğrudan vermez.
15.4. KV Cache
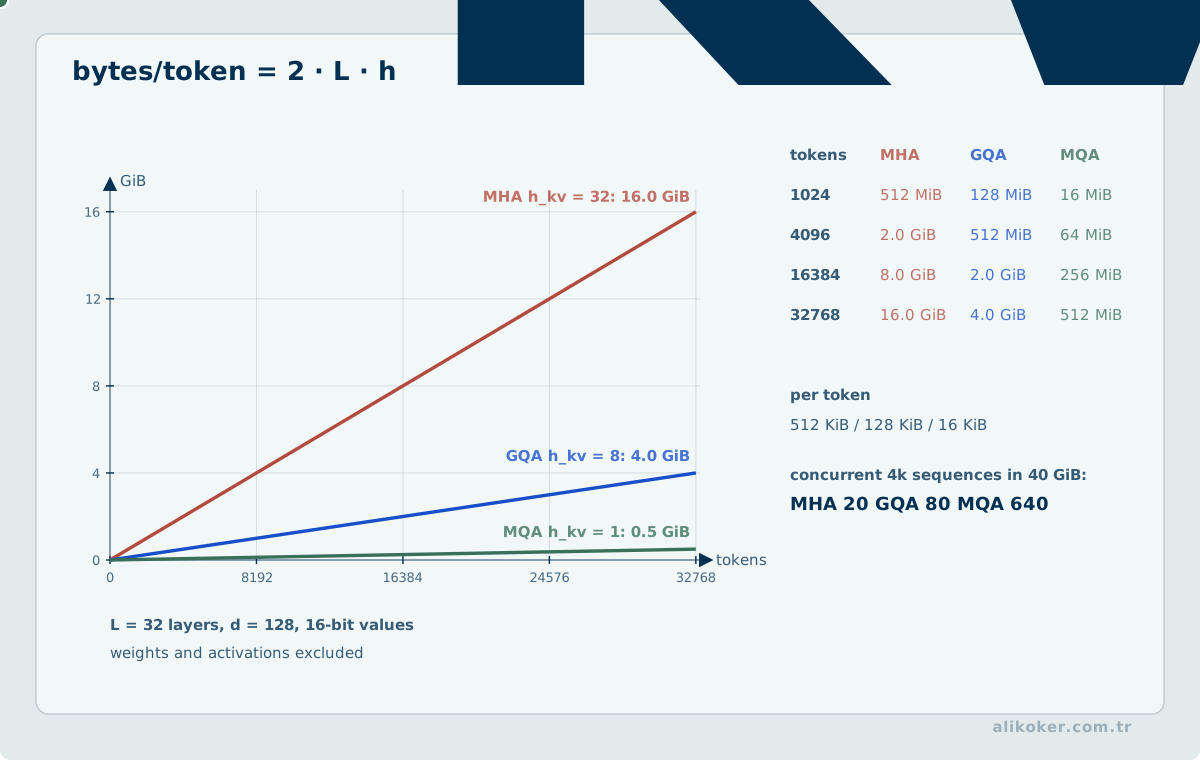
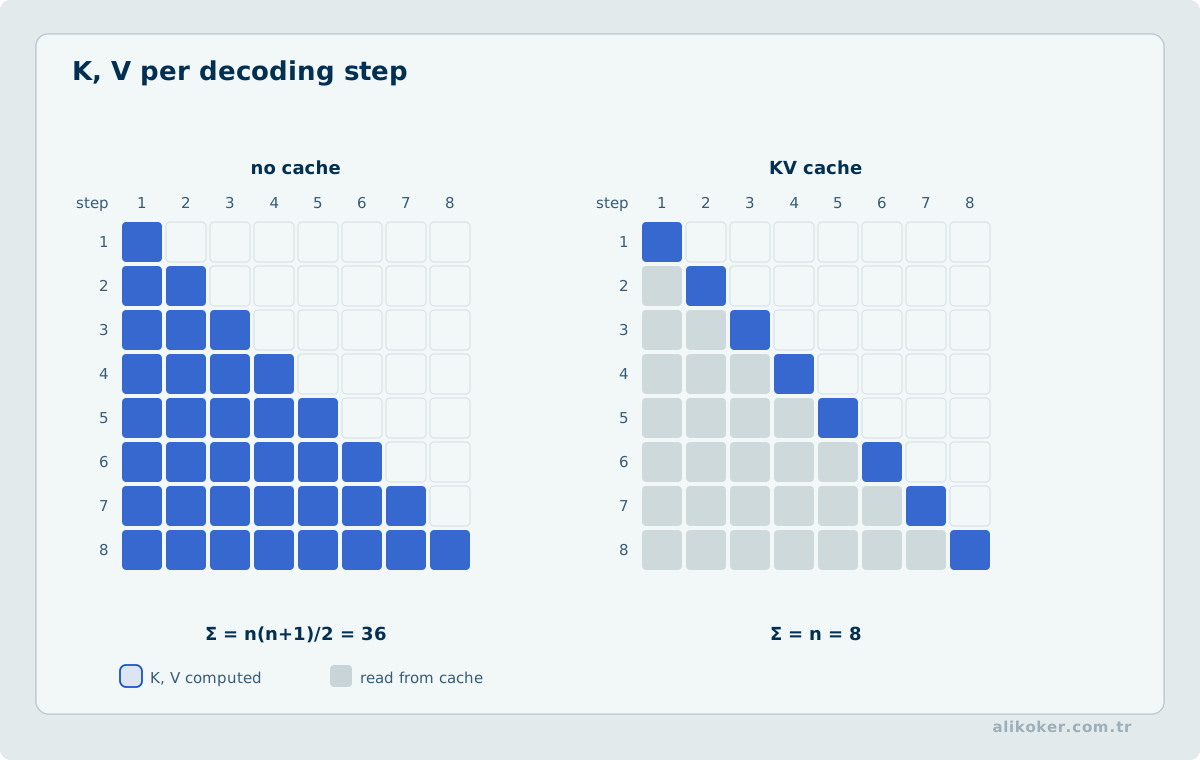
Otoregresif decode sırasında önceki tokenlerin K/V tensörleri yeniden hesaplanmak yerine saklanır. Bağlam uzadıkça KV cache büyür ve eşzamanlı kullanıcı sayısını sınırlayabilir. GQA/MQA, düşük hassasiyetli cache veya sayfalı bellek yönetimi bu baskıyı azaltabilir.
Önek önbelleğinde paylaşılabilirlik, yalnız görünür istem dizisinin benzerliğine bakılarak belirlenemez. Tokenleştirme, sohbet şablonu, konum kodlaması, model ağırlıkları, adaptör durumu ve dikkat maskesi aynı hesaplama bağlamını üretmelidir. Bir kullanıcının erişim yetkisinin başka kullanıcıya taşınması, eşit KV değerleri varmış gibi paylaşımı güvenli kılmaz. Önbellek anahtarı ve yeniden kullanım politikası bu bağımlılıkları ayırt etmelidir.
KV bloklarının GPU, CPU ve daha yavaş depolama katmanlarına taşınması yalnız kapasite değil transfer süresi problemidir. Yeniden hesaplama maliyeti ile aktarım maliyeti karşılaştırılmalı; prefill aşamasını hızlandırmak için yapılan tahsis decode aşamasındaki bant genişliğini tüketmemelidir. Uzun bağlam penceresinde erişilebilir blok sayısı ve eşzamanlı oturum kapasitesi birlikte sınır oluşturur.
15.5. KV Önbelleğinde Nicemleme Doğruluğu
Model ağırlıklarının nicemlenmesi ile dinamik anahtar–değer önbelleğinin nicemlenmesi ayrı kararlardır. Her aktif belirteç için önbellek, dikkat katmanlarının anahtar ve değer tensörlerini taşır; uzun bağlamda bu dinamik bellek model ağırlıklarından bağımsız büyür. Daha düşük bit genişliği teorik saklama alanını azaltabilir; ölçek katsayıları, blok hizalaması ve geçici çözme tamponları gerçek kazancı sınırlar.
Anahtar dağılımındaki uç değerler dikkat skorlarını, değer tensöründeki hata ise ağırlıklı toplamı etkileyebilir. Bu nedenle anahtar ve değer için aynı nicemleme ölçeğinin en iyi olduğu varsayılmaz. Kalite sınaması yalnız kısa sorularla yapılmamalı; uzun bağlamda bilgi geri çağırma, sayısal ayrıntı koruma ve çok adımlı yanıtlar ayrı ölçülmelidir. Etkin bellek, ilk belirteç gecikmesi ve tokenlar arası süre aynı iş yükünde karşılaştırılır.
15.6. FlashAttention
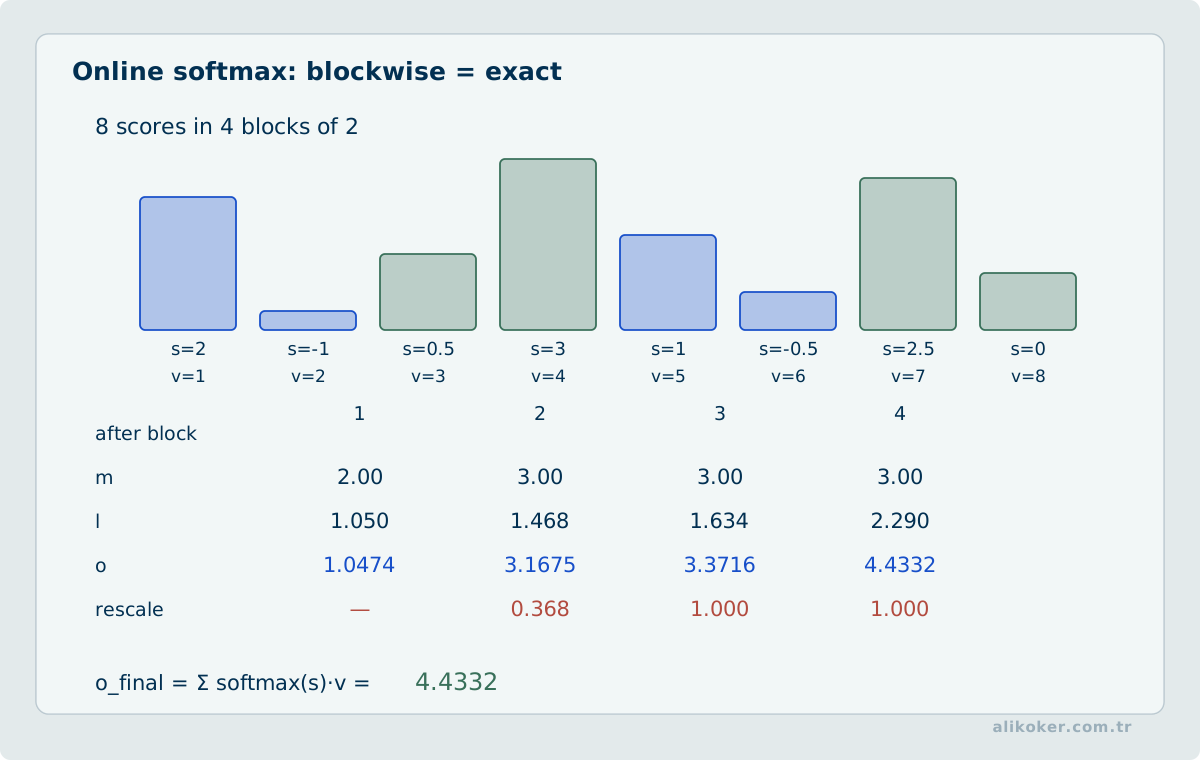
FlashAttention, standart attention'ın matematiksel sonucunu korurken GPU bellek hiyerarşisindeki veri hareketini azaltan I/O-aware bir algoritmadır. Temel ders, FLOP sayısının tek performans ölçüsü olmadığıdır; HBM-SRAM veri hareketi duvar saati süresini belirleyebilir.
15.7. PagedAttention ve Sürekli Batching
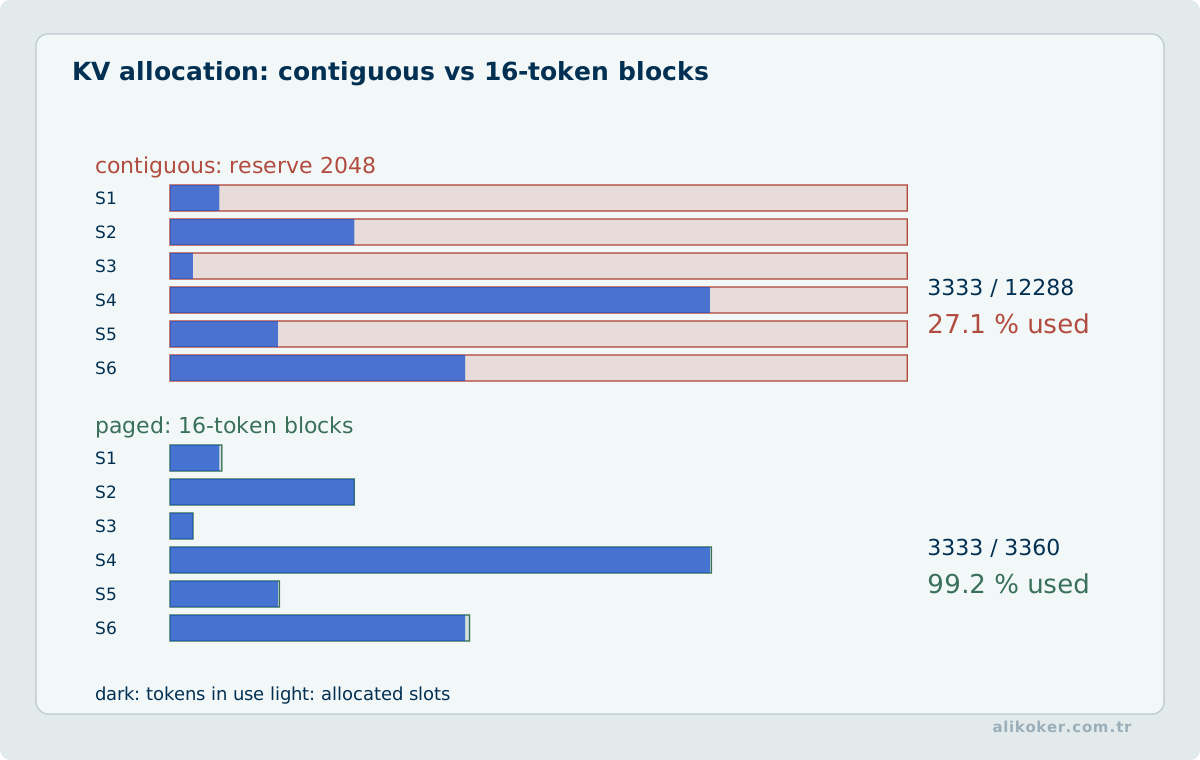
PagedAttention yaklaşımı KV cache'i işletim sistemlerindeki sayfalama fikrine benzer biçimde bloklar halinde yöneterek parçalanmayı azaltır. Sürekli batching ise tamamlanan istekleri beklemeden yeni istekleri çalışan batch'e alarak GPU kullanımını artırabilir.
15.8. Spekülatif Çözümleme
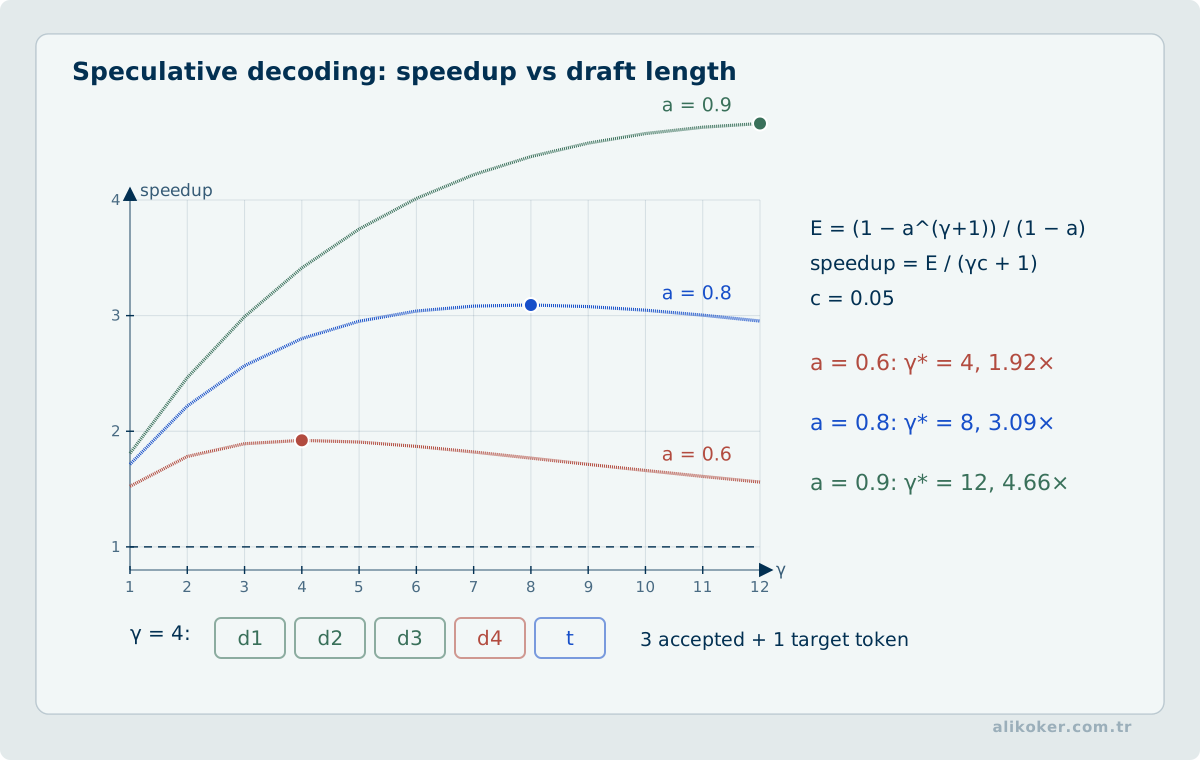
Küçük ve hızlı bir draft model birkaç aday token üretir; büyük hedef model bunları toplu biçimde doğrular. Uygun koşullarda hedef model dağılımını bozmadan decode gecikmesi azaltılabilir. Hızlanma draft modelin kalitesi, donanım ve batch düzenine bağlıdır.
Taslak-hedef yaklaşımında daha küçük bir taslak model birden fazla token önerir; hedef model bu önerilerin koşullu olasılıkları üzerinden kabul ve düzeltme uygular. Doğru kabul/ret örnekleme kuralı kullanıldığında hedef dağılım korunabilir; yalnız önerilen tokenların hedefteki en yüksek olasılıklı tokenlarla eşleşip eşleşmediğini kontrol etmek aynı güvenceyi vermez. Hızlanma, taslak üretme maliyeti, hedef doğrulama paralelliği ve kabul uzunluğuna bağlıdır.
Medusa gibi çoklu tahmin başlığı kullanan yöntemler, aynı modelin ara temsilinden ileri token adayları üretir. EAGLE ailesi ara özellik veya temsil dizisini kullanarak taslaklamayı farklılaştırır. N-gram tabanlı öneri ise geçmiş bağlamdaki yinelenen token dizilerinden yararlanabilir. Bu yöntemlerin ek bellek, eğitim gereksinimi ve kabul oranı aynı değildir; özellikle düşük kabul oranında spekülasyon toplam gecikmeyi artırabilir.
15.9. Nicemleme
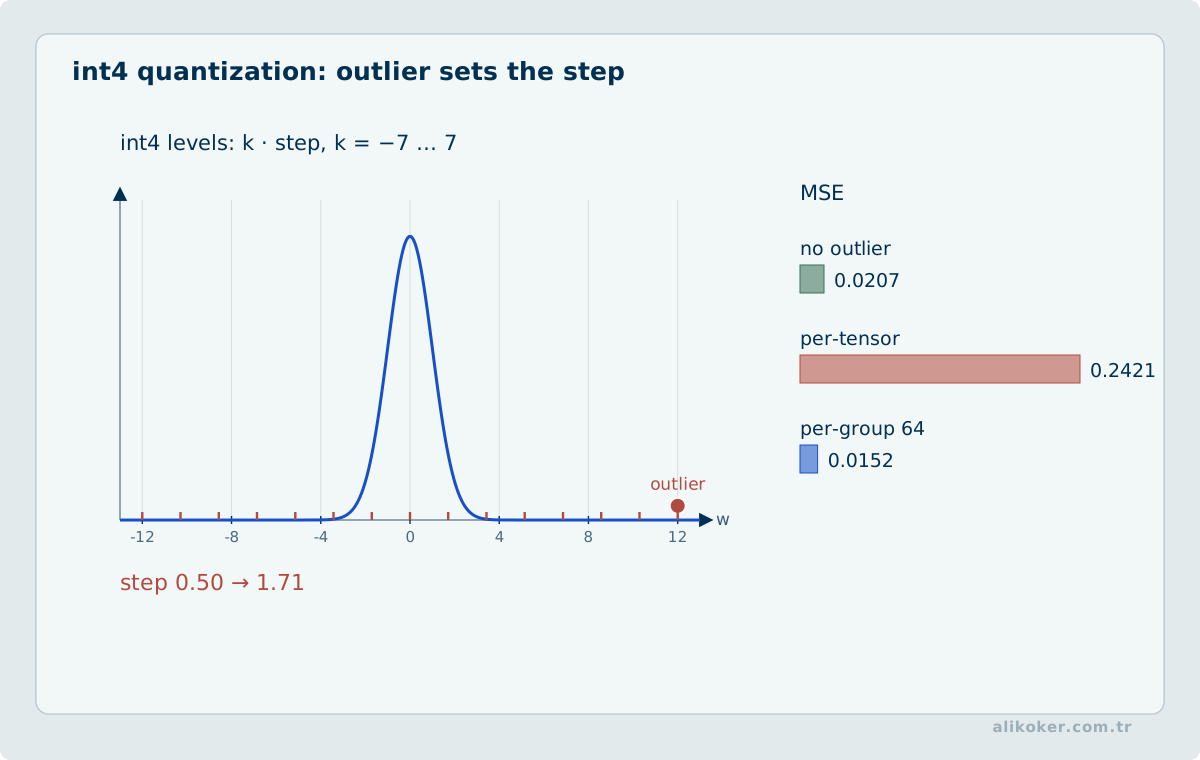
FP16/BF16 ağırlıkları INT8, INT4 veya başka düşük hassasiyetli temsillere indirgenebilir. Kazanç:
- daha az model belleği,
- daha yüksek bellek bant genişliği verimliliği,
- bazı donanımlarda daha yüksek throughput.
Bedel ise nicemleme hatası, kernel desteği ve görev bazlı kalite kaybıdır. Ölçüm yapılmadan "4-bit model aynı kalitededir" genellemesi yapılmamalıdır.
Ünite 16: Diğer Yapay Zekâ Yaklaşımlarıyla Bağlantı
16.1. Yapay Sinir Ağları
LLM, Yapay Sinir Ağları ve Öğrenme Modelleri dersindeki temel kavramların büyük ölçekli bir uygulamasıdır. Ağırlık, aktivasyon, kayıp, geri yayılım, optimizer, aşırı uyum ve dağılım değişimi aynen geçerlidir. Transformer bu çerçevenin dışında ayrı bir "zeka türü" değildir.
16.2. İstatistiksel Öğrenme
İstatistiksel Öğrenme ve Makine Öğrenmesi, LLM eğitiminde kullanılan ampirik risk, genelleme, veri dağılımı, sınıflandırma ve değerlendirme düşüncesinin matematiksel arka planını sağlar. LLM'ler klasik yöntemlerden çok daha büyük olsa da veri dağılımı değişimi ve ölçüm yanlılığı ortadan kalkmaz.
16.3. Bulanık Mantık
Bulanık Mantık, doğal dildeki "yüksek risk", "yakın", "uygun" gibi dereceli kavramları açık üyelik fonksiyonlarıyla modelleyebilir. LLM ise bu kavramların dilsel kullanımlarını veri üzerinden öğrenebilir; fakat modelin iç temsili açık bir bulanık kural tabanı değildir. Hibrit sistemde LLM metinden özellik çıkarabilir, bulanık sistem ise şeffaf karar kuralı uygulayabilir.
16.4. Genetik Algoritmalar
Genetik Algoritmalar ve Uygulamaları, türevin olmadığı veya arama uzayının ayrık olduğu LLM çevresi problemlerinde kullanılabilir: istem şablonu seçimi, RAG parametreleri, araç sırası, model bileşimi veya çok amaçlı maliyet-kalite optimizasyonu. Buna karşın milyarlarca LLM ağırlığını doğrudan genetik algoritmayla eğitmek çoğu üretim ölçeğinde pratik değildir.
16.5. Mantıksal Programlama
Mantıksal Programlama ve Prolog açık olgu ve kurallar üzerinde çözümleme yapar. LLM ise dildeki örüntülerden aday ifade üretebilir. İkisi birlikte kullanıldığında:
doğal dil
   |
   v
  LLM ---> aday olgu / kural / sorgu
                      |
                      v
               Prolog / SMT / kural motoru
                      |
                 doğrulama sonucu
                      |
                      v
                     LLM
                      |
                      v
                açıklanmış yanıt
Bu mimari, üretim ile biçimsel doğrulamayı ayırır.
16.6. Yapay Zekâ ve Felsefe
Yapay Zeka: Felsefe, Kuram ve Uygulama, LLM tartışmasındaki temel kategorik ayrımları sağlar:
- dil üretimi ≠ doğruluk,
- problem çözme ≠ bilinç,
- araç kullanımı ≠ bağımsız amaç,
- insan benzeri ifade ≠ insan benzeri öznel deneyim,
- yüksek benchmark ≠ bütün bağlamlarda güvenilirlik.
LLM'ler bu soruları görünür hale getirir; fakat tek başına çözmez.
Ünite 17: Türkçe ve Alan Uyarlaması
17.1. Türkçe Değerlendirme Zorunluluğu
Çok dilli modelde İngilizce benchmark sonucu Türkçe üretim kalitesini garanti etmez. Türkçe için ayrı değerlendirme seti oluşturulmalıdır. Özellikle:
- eklemeli yapı,
- deyimler,
- alan terimleri,
- özel adlar,
I/İ/ı/idönüşümü,- resmi ve gündelik dil farkı,
- tarih/sayı biçimleri,
- kod ve İngilizce teknik terimlerin karışması
test edilmelidir.
17.2. Alan Modellemesi
Bir kurum veya teknik alan için üç ayrı sorun olabilir:
- Model terminolojiyi bilmiyor.
- Bilgi güncel değil.
- İstenen davranış biçimini izlemiyor.
Bunların çözümü sırasıyla aynı değildir. Terim/üslup için SFT veya LoRA, güncel bilgi için RAG, eylem için araç entegrasyonu daha uygun olabilir.
17.3. Veri Kaçağı
Alan verisiyle ince ayar yaparken model ağırlıklarının daha sonra kimlerin eline geçeceği düşünülmelidir. Gizli belgeyi modele öğretmek, erişim kontrolü uygulanmış belge deposunda tutmakla aynı değildir. Erişim hakkı kullanıcıya göre değişiyorsa RAG tabanlı retrieval katmanı genellikle daha denetlenebilir bir sınır sağlar.
Ünite 18: Üretim Mimarisi
Bir LLM uygulamasını tek prompt -> model -> cevap zinciri olarak tasarlamak prototipte yeterli olabilir; üretimde sorumlulukların ayrılması gerekir.
                   +-------------------+
Kullanıcı -------->| API / Oturum      |
                   +---------+---------+
                             |
                    +--------v--------+
                    | Politika / ACL   |
                    +--------+--------+
                             |
              +--------------+--------------+
              |                             |
      +-------v-------+             +-------v-------+
      | Bağlam/RAG    |             | Araç kayıtları|
      +-------+-------+             +-------+-------+
              |                             |
              +--------------+--------------+
                             |
                      +------v------+
                      |    LLM      |
                      +------+------+
                             |
                      +------v------+
                      | Çıktı       |
                      | doğrulama   |
                      +------+------+
                             |
             +---------------+---------------+
             |                               |
        kullanıcı                        araç/eylem
18.1. Sürümleme
Aşağıdaki bileşenler ayrı sürümlenmelidir:
- model ve ağırlık hash'i,
- tokenizer,
- sistem talimatı,
- retrieval indeksi,
- gömme modeli,
- reranker,
- araç şemaları,
- güvenlik politikası,
- değerlendirme seti.
Model sabit kalsa bile prompt veya RAG indeksi değişikliği davranışı değiştirebilir.
18.2. Gözlemlenebilirlik
Üretim telemetrisi yalnız cevap metnini saklamak değildir. Gizlilik ilkelerine uygun biçimde şu ölçüler izlenebilir:
- istek sınıfı,
- token girdi/çıktı sayısı,
- TTFT/TPOT,
- retrieval aday sayısı ve skorları,
- araç çağrıları,
- hata sınıfı,
- kullanıcı geri bildirimi,
- model/prompt sürümü,
- güvenlik filtresi sonucu.
Kişisel veya gizli içeriği loglamak zorunlu değildir; çoğu zaman yapısal metadata yeterlidir.
Çıkarım hizmetinin ölçümünde GPU çekirdek kullanımını tek başarı ölçütü kabul etmek yeterli değildir. İstek kabul oranı, kuyruk bekleme süresi, TTFT, TPOT, tamamlanan token/s, hata oranı ve bağlam uzunluğu birlikte değerlendirilmelidir. Prefill ile decode sürelerinin ayrı histogramları ve istemciye ilk veri aktarımının başladığı an, darboğazın ağda mı model çalışmasında mı olduğunu ayırabilir.
Açık döngülü yük üretimi ile yanıtı bekleyip yeni istek gönderen kapalı döngülü test, doygunlukta farklı sonuçlar verir. Batched çalışmada token/s yükselirken tek isteğin P99 gecikmesi kötüleşebilir. Cold start, model yükleme, sıcak kernel seçimi ve JIT/derleyici önbelleği ölçüm döneminin parçası olarak kaydedilmelidir; yalnız ısınmış koşul raporlanıyorsa bu varsayım belirtilmelidir.
18.3. Hata Dayanımı
Model sunucusu, vektör veritabanı veya dış araç başarısız olabilir. Uygulama:
- zaman aşımı,
- sınırlı yeniden deneme,
- devre kesici,
- geri dönüş modeli,
- kısmi özellik kaybı,
- kuyruk sınırı,
- yük atma
gibi klasik dağıtık sistem desenlerini kullanmalıdır.
Ünite 19: 2026 İtibarıyla Güncel Yönelimler
Bu bölüm kalıcı kuramdan ziyade alanın 2026'ya kadar belirginleşen mühendislik yönlerini özetler.
19.1. Çıkarım Zamanı Ölçekleme
Kaliteyi yalnız daha büyük ön eğitimle artırmak yerine zor soruya daha fazla çıkarım bütçesi ayıran modeller yaygınlaşmıştır. Verifier, arama ve pekiştirmeli öğrenmeyle edinilmiş problem çözme davranışları bu çizginin parçalarıdır.
19.2. Seyrek Uzman Modelleri
MoE mimarileri toplam parametre sayısını artırırken token başına etkin parametreleri sınırlama olanağı verir. Donanım tarafında uzmanların GPU'lar arasında dağılımı ve all-to-all iletişim kritik darboğazdır.
19.3. Seyrek Uzmanlarda Yönlendirme ve İletişim Maliyeti
Seyrek uzman katmanında yönlendirici her belirteç için k uzman seçtiğinde etkin uzman hesaplaması toplam uzman sayısından daha yavaş büyüyebilir. Ancak k küçük olması toplam gecikmenin aynı oranda azalmasını garanti etmez. Farklı işlemcilere yerleştirilen uzmanlara belirteç dağıtımı, aktarım ve yeniden birleştirme gerektirir; dağıtık yerleşimde iletişim, hesaplamanın önüne geçebilir.
Uzmanlara düşen belirteç sayısı dengesizse en yoğun uzman bütün katmanı bekletir. Kapasite sınırlaması, yönlendirme dengesi ve iş dağıtım politikası; görev kalitesi, bırakılan belirteçler ve kuyruk gecikmesiyle birlikte değerlendirilir. Uzman paralelliği ile tensör paralelliği farklı boyutları paylaştırır; birlikte kullanım kararı bağlantı bant genişliği ve gerçek yük dağılımıyla verilmelidir.
19.4. Uzun Bağlam ve Dış Bellek
Bağlam pencereleri büyürken RAG ortadan kalkmamıştır. Uzun bağlam ham belgeyi taşıma kapasitesi sağlar; retrieval ise ilgili bilginin seçimi, yetkilendirme, tazelik ve kaynak kökeni sorunlarını çözer. İki yaklaşım tamamlayıcıdır.
19.5. Ajanlaşma ve Protokol Katmanı
Modelin web, dosya, kod çalıştırma, veri tabanı ve kurumsal uygulamalarla araç üzerinden etkileşmesi yaygınlaşmıştır. Bunun sonucu model kalitesinden çok yetki sınırı, işlem güvenliği ve protokol tasarımı önem kazanmıştır. MCP gibi standartlaşma girişimleri bu entegrasyon katmanını ortaklaştırmayı hedefler.
19.6. Küçük ve Uzman Modeller
Her görev en büyük modeli gerektirmez. Distillation, nicemleme ve alan odaklı eğitimle daha küçük modeller düşük gecikme, düşük enerji ve yerel/on-prem dağıtım avantajı sağlayabilir. Doğru seçim benchmark yerine gerçek trafik üzerinde kalite-maliyet eğrisiyle yapılmalıdır.
19.7. Çok Kipli Modeller
Metin, görüntü, ses ve video tek sistemde birleşmektedir. Buna karşın kip sayısı arttıkça değerlendirme ve güvenlik yüzeyi de büyür. Metindeki güvenlik filtresi görüntü içindeki gizli talimatı algılamayabilir.
19.8. Sentetik Veri ve Modelden Modele Öğrenme
Güçlü modeller eğitim örneği, tercih verisi veya distillation hedefi üretebilir. Sentetik veri maliyeti düşürür; ancak kendi hatalarının yeniden üretilmesi, çeşitlilik kaybı ve değerlendirme sızıntısı riskleri vardır. İnsan veya harici doğrulama tamamen kaldırılmamalıdır.
Ünite 20: Bilgi, Anlama ve Sistem Sınırı
Bir LLM'in parametrelerinde geniş olgusal örüntüler bulunabilir; ancak "bilgi" kavramı epistemolojide yalnız doğru cümle üretmekten daha geniştir. Kaynağın bilinmesi, gerekçenin kurulması ve yanlış olduğunda düzeltilebilirlik de önem taşır.
LLM sistemi için üç ayrı katman düşünmek yararlıdır:
Modelin parametrik örüntüsü
          |
          v
Çalışma zamanı bağlamı ve dış kaynaklar
          |
          v
Uygulamanın doğrulama / yetki / eylem katmanı
Modelin cevabı tek başına sistem kararı değildir. Özellikle adli, güvenlik, sağlık, finans veya fiziksel kontrol gibi yüksek etkili alanlarda karar zincirinin hangi bölümünün modele, hangi bölümünün deterministik kurala ve hangi bölümünün insana ait olduğu açıkça tanımlanmalıdır.
Akıcı dil insan zihninde "anlıyor" izlenimi oluşturabilir. Bu izlenim yararlı bir kullanıcı arayüzü etkisi olabilir; fakat mimari değerlendirmede antropomorfik varsayım yerine ölçülebilir davranışa dönülmelidir.
Ünite 21: Tasarım Kararı İçin Kısa Başvuru
Sorun: Güncel bilgi mi gerekiyor?
  Evet -> RAG / araç
  Hayır
    |
    +-> Özel davranış mı gerekiyor?
          Evet -> SFT / LoRA / tercih eğitimi
          Hayır
            |
            +-> Kesin hesap veya kural mı gerekiyor?
                  Evet -> araç / sembolik motor
                  Hayır
                    |
                    +-> Yalnız görev tanımı mı eksik?
                          Evet -> istem / örnek içinde öğrenme
21.1. Üretime Geçmeden Önce
- Modelin görev kapsamı açık mı?
- Kapalı test seti var mı?
- Türkçe ve alan verisi ayrı değerlendirildi mi?
- RAG erişim kontrolü kullanıcı yetkisiyle uyumlu mu?
- Model çıktısı güvenilmeyen veri olarak doğrulanıyor mu?
- Araçlar en az yetkiyle mi çalışıyor?
- Prompt injection senaryoları test edildi mi?
- Model, tokenizer, prompt ve indeks sürümleniyor mu?
- P95/P99 gecikme ve throughput ölçüldü mü?
- KV cache ve uzun bağlam bellek bütçesi hesaplandı mı?
- Hata durumunda geri dönüş davranışı tanımlı mı?
- Yüksek riskli eylem için insan veya deterministik onay var mı?
21.2. Sonuç
Büyük dil modellerini anlamanın en sağlıklı yolu onları tek başına "zeki sohbet sistemi" olarak değil, istatistiksel öğrenme + büyük ölçekli sinir ağı + veri mühendisliği + dağıtık eğitim + çıkarım sistemi + doğrulama + güvenlik bileşimi olarak incelemektir.
Transformer, bu sistemin sinirsel çekirdeğini sağlar. Ön eğitim dilsel ve kavramsal örüntüleri; sonradan eğitim talimat ve tercih davranışını; RAG güncel ve yerel bilgiyi; araç katmanı dış dünyadaki eylemi; değerlendirme ve güvenlik katmanı ise sistem sınırını tanımlar.
Bu bakış, yapay zekâ yöntemlerini birbirinin rakibi olarak değil tamamlayıcı araçlar olarak görmeyi sağlar. Sinir ağları temsil öğrenir; istatistiksel öğrenme ölçüm disiplinini sağlar; bulanık mantık dereceli kavramları açık biçimde modelleyebilir; genetik algoritmalar türevsiz arama sunar; mantıksal programlama biçimsel kuralları doğrular. Büyük dil modeli bu yöntemlerin yerine geçmek zorunda değildir; doğru mimaride onların arasında doğal dil tabanlı bir arayüz ve üretici bileşen olabilir.
Ünite 22: Modern Transformer Bloğunda Konum, Normalizasyon ve KV Tasarımı
Transformer'ın temel attention denklemi değişmeden kalırken, modern büyük dil modelleri etrafında önemli mimari iyileştirmeler oluşmuştur. Bu iyileştirmeler aynı problemi çözmez; bu nedenle RoPE, RMSNorm, GQA ve MLA gibi kavramları tek bir “hızlandırma tekniği” sınıfında düşünmek yanlıştır.
22.1. RoPE: Sıra Bilgisini Attention Uzayına Taşımak
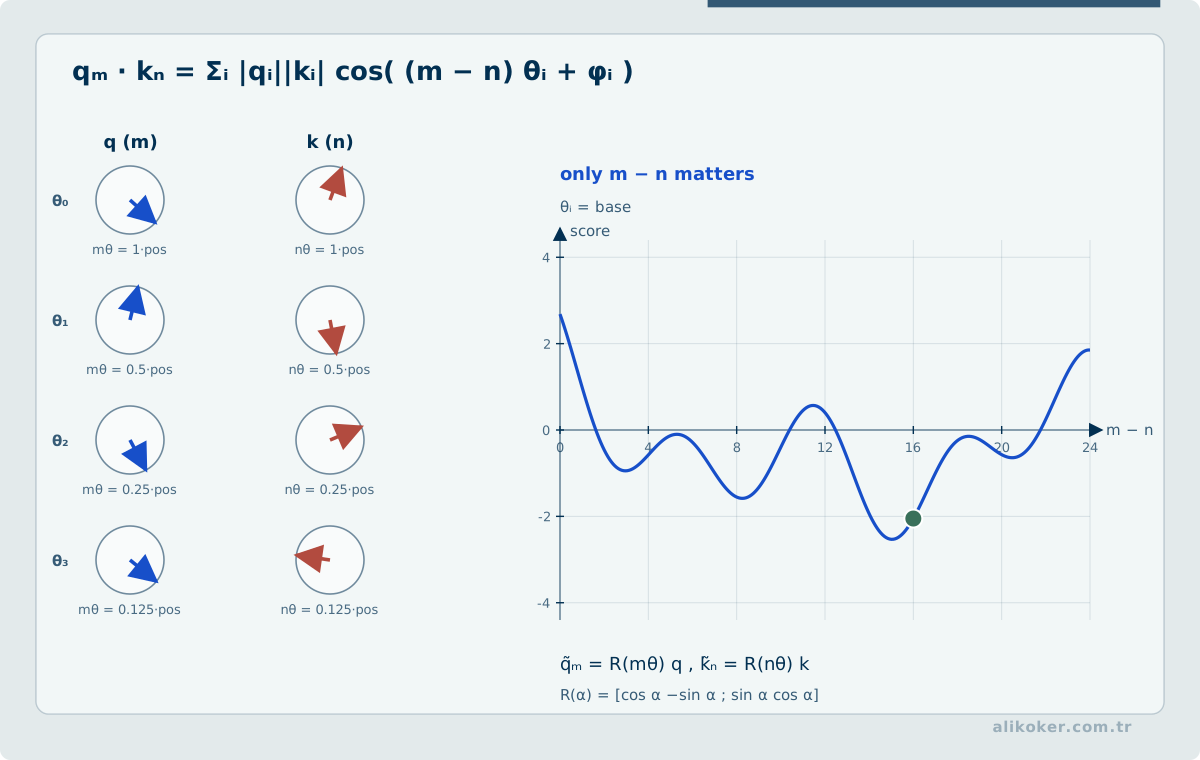
Rotary Position Embedding (RoPE), token konumunu sorgu ve anahtar vektörlerine döndürme dönüşümleriyle işler. Amaç yalnız her konuma bir sayı eklemek değildir; göreli konum bilgisinin dot-product attention içinde kullanılabilir olmasını sağlamaktır.
Uzun bağlam desteğinde RoPE ölçekleme yöntemleri sık kullanılır. Ancak teorik bağlam sınırını artırmak, modelin daha önce eğitim görmediği uzunluklarda aynı kaliteyi koruyacağını garanti etmez. Uzun bağlam ayrı kıyaslama gerektirir.
22.2. RMSNorm: Normalizasyonun Daha Yalın Biçimi
RMSNorm, LayerNorm ailesine göre merkezleme adımını kaldırıp büyüklük normalizasyonuna odaklanır. Modern decoder modellerinde hesap maliyetini ve uygulama karmaşıklığını azaltan yaygın bir tercihtir. Normalizasyon türü küçük görünen bir ayrıntı olsa da derin ağın eğitim kararlılığı ve çıkarım çekirdeğiyle doğrudan ilişkilidir.
22.3. MQA, GQA ve MLA Aynı Şey Değildir
Multi-Head Attention'da her sorgu başlığının ayrı key/value başlıkları vardır. KV önbelleği büyüdükçe uzun bağlam ve yüksek eşzamanlılıkta bellek baskısı artar.
MHA
Q1 -> K1,V1
Q2 -> K2,V2
Q3 -> K3,V3

MQA
Q1,Q2,Q3 -> ortak K,V

GQA
Q1,Q2 -> K1,V1
Q3,Q4 -> K2,V2
Multi-Query Attention (MQA), çok sayıda sorgu başlığının ortak key/value başlığı kullanmasını sağlar.
Grouped-Query Attention (GQA), MHA ile MQA arasında ara tasarımdır; sorgu başlıkları gruplar hâlinde key/value başlıklarını paylaşır.
Multi-head Latent Attention (MLA) ise key/value bilgisini daha düşük boyutlu gizil temsilde sıkıştırarak KV cache maliyetini azaltmayı hedefleyen farklı bir mimari yaklaşımdır. DeepSeek-V2 çalışması MLA'yı bu amaçla tanımlar. Bu yüzden MLA'yı yalnız “daha fazla attention başlığı” olarak düşünmek doğru değildir.
Ünite 23: KV Cache, Prefill, Decode ve Sunum Mühendisliği
Otoregresif model her yeni token üretirken önceki bütün tokenler için key/value tensörlerini yeniden hesaplamak zorunda kalırsa çıkarım gereksiz derecede pahalı olur. KV cache, geçmiş tokenlerin attention için gerekli key/value sonuçlarını saklar.
İstek
 |
 v
Prefill
tüm başlangıç bağlamını işle
 |
 v
KV Cache
 |
 v
Decode
token 1 -> cache büyür
token 2 -> cache büyür
token 3 -> cache büyür
Prefill aşaması yüksek paralel matris işlemleriyle başlangıç bağlamını işler. Decode aşaması ise token token ilerlediği için farklı bir donanım ve bellek davranışı gösterir. Bu nedenle yalnız “tokens/s” değeri model sunum performansını bütünüyle açıklamaz. Time-to-first-token, inter-token gecikme, p95/p99 ve eşzamanlı istek kapasitesi birlikte ölçülmelidir.
23.1. FlashAttention ve PagedAttention Farklı Katmanlardadır
FlashAttention, attention hesabını GPU bellek hiyerarşisine uygun döşeme ve veri hareketi azaltma yaklaşımıyla hızlandırır. FlashAttention-3, Hopper sınıfı donanımda asenkron işlem ve düşük hassasiyet özelliklerinden daha fazla yararlanmayı hedefler.
PagedAttention ise esas olarak sunum sırasında dinamik büyüyen KV cache'in bellek yönetimini iyileştirir. vLLM çalışması, sanal bellek sayfalamasından esinlenen bu tasarımla cache parçalanmasını ve gereksiz kopyalamayı azaltır.
FlashAttention
 -> attention çekirdeğinin hesap/veri hareketi

PagedAttention
 -> KV cache'in yerleşimi ve paylaşımı
Bu iki yöntem birbirinin alternatifi değildir.
23.2. Sürekli Batch
Statik batch'te bütün isteklerin aynı anda bitmesi beklenirse kısa istekler kaynakları gereksiz yere tutabilir. Continuous batching, tamamlanan isteğin yerini yeni isteğin almasına izin vererek GPU kullanımını yükseltir.
Ancak daha büyük batch her zaman daha iyi kullanıcı gecikmesi anlamına gelmez. İşleme kapasitesi ile kuyruk gecikmesi birlikte değerlendirilmelidir.
23.3. LLM Serving: Prefill, Decode ve KV Cache
Büyük dil modellerinde çıkarım yükü iki ayrı çalışma evresine bölünür. Prefill sırasında giriş tokenlarının işlenmesi çoğu kez matris çarpımı ve bellek yerleşimiyle sınırlanırken decode aşamasında her yeni token için model ağırlıkları ve büyüyen KV cache üzerinden yinelemeli erişim gerekir. Bu nedenle ilk token gecikmesi, tokenlar arası süre ve eşzamanlı isteklere bağlı KV cache tüketimi birbirinden bağımsız ölçülmeli; batching kararı kullanıcıya yansıyan kuyruk süresini gizlememelidir.
- Time-to-first-token ile inter-token latency ölçülerini ayrı raporlamak.
- Continuous batching kazancının bireysel istek tail latency üzerindeki etkisini ölçmek.
- KV cache kapasitesi, context length ve concurrent request sayısı arasındaki ilişkiyi modellemek.
23.4. Bağlam Uzunluğu ve Eşzamanlılık için Kapasite Hesabı
Katman sayısı L, etkin istek sayısı B, her istekte saklanan ortalama belirteç sayısı T, anahtar–değer başlık sayısı H_kv, başlık boyutu D ve eleman başına bayt sayısı b ise ideal önbellek büyüklüğü yaklaşık M_KV = 2 × L × B × T × H_kv × D × b olur. Bu hesap, tek biçimli bağlam uzunluğu ve sabit temsil hassasiyeti varsayar; sayfa ayırıcı yükü, hizalama, geçici tensörler ve model ağırlıklarını kapsamaz.
Değişken uzunluktaki isteklerde daha doğru kapasite hesabı M_KV ≈ 2 × L × H_kv × D × b × Σ_i T_i biçimindedir. Başlangıç bağlamının birden çok istek arasında paylaşıldığı sunum düzenlerinde fiziksel sayfa paylaşımı toplamı azaltabilir; oturum izolasyonu ve yaşam döngüsü güvenliği korunmalıdır. Kabul deneyi, bağlam uzunluğu dağılımını, etkin istek sayısını, kuyruk beklemesini ve p99 gecikmeyi aynı yük profilinde değerlendirmelidir.
Çıkarım sisteminin GPU bellek gereksinimi yaklaşık olarak model ağırlıkları, KV blokları, çalışma alanları ve uygulama tamponlarının toplamından oluşur. Her oturumun KV ayak izi; katman sayısı, KV başlığı sayısı, başlık boyutu, depolanan token sayısı ve eleman genişliğiyle ölçeklenir. Grouped-query attention gibi mimari seçimler KV başlık sayısını değiştirdiğinden, parametre sayısından tek başına oturum kapasitesi çıkarılamaz.
Tensor paralelliği tek isteğin hesaplama ve ağırlık belleğini GPU'lar arasında dağıtabilir; ancak her katmanda gerekli kolektif iletişim gecikmeye eklenir. Uzman paralelliği MoE uzmanlarının dağıtımıyla kapasite/iş hacmi sağlayabilir; token yönlendirmesi ve düzensiz ağ trafiği darboğaz olabilir. Prefill ile decode işçilerinin ayrılması ise aşamaları bağımsız ölçeklerken KV durumunu aktarma maliyeti doğurur. Farklı paralellik türleri aynı darboğazı çözmez.
23.5. FPGA Çıkarımında Veri Hareketi ve KV Önbellek Yerleşimi
Otomatik regresif model çıkarımında prefill aşaması bağlam dizisini paralel işlerken decode aşaması her yeni token için ağırlık ve KV önbellek erişimine ihtiyaç duyar. Bu nedenle yalnız işlemci çarpma-toplama sayısını artırmak, özellikle tek isteğin token üretim hızını artırmayabilir. FPGA tasarımında HLS ile işlem hattı oluşturmak yanında dış bellek bant genişliği, yerleşik tampon kapasitesi, DMA aktarımı ve bit genişliği birlikte boyutlandırılır.
Başarım analizi işlem süresi ≥ max(hesap gereksinimi / hesap kapasitesi, taşınan bayt / etkin bant genişliği) alt sınırından hareket edebilir; bu, örtüşmeyen ek maliyetleri yok sayan idealize bir sınırdır. Nicemleme, ağırlıkların ve KV verisinin kapladığı alanı azaltırken sayısal hata ve ek dönüştürme işlemleri oluşturabilir. Ölçümde ilk token gecikmesi, sonraki token/s, eşzamanlı istek sayısı, güç tüketimi ve model doğruluk kaybı ayrı raporlanır. HLS kaynak kullanımı ve sentez başarısı, uçtan uca çıkarım üstünlüğü kanıtı değildir.
Ünite 24: Nicemleme, Budama, Damıtma ve 1-Bit Modeller
Model küçültme yöntemleri birbirinden ayrılmalıdır.
Nicemleme (quantization), ağırlık ve/veya aktivasyonları daha düşük hassasiyetle temsil eder. FP16/BF16'dan INT8, INT4 veya başka biçimlere geçiş bellek ve bant genişliği maliyetini düşürebilir. Ancak nicemleme hatası katmanlar ve veri dağılımı arasında eşit değildir.
Budama (pruning), önemsiz kabul edilen ağırlık, bağlantı, başlık veya yapısal blokları kaldırır.
Bilgi damıtma (knowledge distillation), daha büyük bir öğretmen modelin davranışını daha küçük öğrenci modele aktarmaya çalışır.
Büyük model
  |
  +--> quantization -> aynı yapının düşük hassasiyeti
  |
  +--> pruning -> daha seyrek / küçük yapı
  |
  +--> distillation -> yeni küçük öğrenci model
24.1. 1-Bit ve 1.58-Bit Araştırmaları
BitNet b1.58 gibi çalışmalar ağırlıkları -1, 0, 1 değerleriyle temsil eden ternary tasarımların eğitimden itibaren ele alınabileceğini göstermektedir. Bunu sıradan bir “FP16 modeli sonradan 1 bite çevirme” işlemi gibi sunmak doğru değildir. Bu çizgi mimari, eğitim tarifi, çekirdek ve donanım desteğini birlikte etkileyen araştırma alanıdır.
Üretimde doğru soru “en düşük bit kaç?” değil, hedef donanım ve görev için kalite–bellek–gecikme–enerji dengesidir.
Ünite 25: Sonradan Eğitim Haritası — SFT, RLHF, DPO ve GRPO
Sonradan eğitim yöntemlerini aynı kategori altında toplamak kavramsal karışıklık yaratır.
Temel Model
   |
   v
SFT
örnek talimat/yanıt davranışı
   |
   +--> Tercih optimizasyonu
   |      |
   |      +--> RLHF / PPO
   |      +--> DPO
   |
   +--> Doğrulanabilir görevlerde RL
          |
+--> GRPO benzeri yöntemlerSFT, etiketli örneklerle istenen görev biçimini öğretir.
RLHF, insan tercih bilgisini ödül modeline ve politika optimizasyonuna dönüştüren daha geniş bir süreçtir. PPO bu tür süreçlerde kullanılan politika optimizasyon algoritmalarından biridir.
DPO, tercih çiftlerinden daha doğrudan politika güncellemesi yapar ve ayrı çevrim içi RL döngüsünü sadeleştirebilir.
GRPO (Group Relative Policy Optimization), DeepSeekMath çalışmasında PPO'ya göre critic model gereksinimini azaltan grup göreli ödül yaklaşımı olarak tanıtılmış, daha sonra akıl yürütme modelleriyle görünürlüğü artmıştır. GRPO'yu “DPO'nun yeni sürümü” olarak düşünmek doğru değildir; optimizasyon varsayımları farklıdır.
25.1. LoRA ve QLoRA Yöntemlerinin Kapsamdaki Konumu
LoRA ve QLoRA eğitim hedefi değil, parametre güncelleme ve bellek maliyeti tekniğidir.
SFT + LoRA
DPO + LoRA
başka hedef + LoRA
gibi birleşimler mümkündür.
PEFT, LoRA dahil parametre-verimli uyarlama yöntemlerinin geniş sınıfıdır. QLoRA, temel modelin nicemlenmiş temsili üzerinde LoRA adaptörleriyle eğitim yaparak bellek gereksinimini düşürür.
Bu ayrım, “LoRA mı DPO mu?” gibi yanlış ikili karşılaştırmaları önler.
Ünite 26: Yapılandırılmış Çıktı, Araç Çağırma ve Protokoller
Bir LLM'nin yazılıma güvenilir biçimde gömülmesi, serbest metnin uygulama kodu tarafından tahmin edilerek ayrıştırılmasından daha güçlü sözleşmeler gerektirir.
26.1. Yapılandırılmış Çıktı
Modelden JSON istemek tek başına şema garantisi değildir. Uygulama mümkünse şema kısıtlı üretim kullanmalı ve çıktı yine doğrulanmalıdır.
LLM
 |
 v
Aday yapı
 |
 v
JSON Schema / tür doğrulama
 |
 v
Alan kuralı
 |
 v
Uygulama
26.2. Function/tool Calling
Araç çağırmada model doğrudan sistemi çalıştırmak yerine genellikle:
tool_name
arguments
şeklinde aday çağrı üretir. Uygulama:
- aracın izinli olup olmadığını,
- argümanların şemaya uyduğunu,
- kullanıcının yetkisini,
- kaynak ve zaman sınırını
ayrıca denetlemelidir.
26.2.1. Araç Keşfinin Bağlam ve Gecikme Maliyeti
Araç tanımlarının modele sunulması yalnız işlevsel bir tercih değildir; isim, açıklama ve parametre şemaları bağlam bütçesini tüketir. Araç sayısı büyüdükçe keşif hatası, benzer araçların karıştırılması ve gereksiz çağrı olasılığı incelenmelidir. Aşamalı keşifte önce görevle ilgili araç kategorisi seçilip ardından gerekli ayrıntılı şema getirilir; bu işlem de bir ek arama ve gecikme maliyeti doğurur.
Uçtan uca gecikme yaklaşık olarak model çıkarımı, ağ geçişleri, araç yürütme ve varsa sonraki model çağrılarının toplamıdır. Tek bir çağrının token maliyetini azaltmak, toplam gecikmeyi her zaman düşürmez. Ölçümler araç seçimi doğruluğu, toplam çağrı sayısı, başarısız araç seçimi ve nihai görev başarısını birlikte içermelidir.
26.3. MCP ve A2A
Model Context Protocol (MCP), model destekli uygulamaların araçlar, kaynaklar ve dış bağlamla ortak bir protokol üzerinden çalışmasını hedefler. 2026-07-28 spesifikasyonu stateless çekirdek, yetkilendirme iyileştirmeleri ve uzantı çerçevesi gibi değişiklikler getirmiştir.
Agent2Agent (A2A) ise bağımsız ajan sistemlerinin birbirlerinin iç durumuna erişmeden yetenek keşfetmesi, görev alışverişi ve birlikte çalışması için ajanlar arası protokol katmanıdır. 2026 itibarıyla A2A spesifikasyonu 1.0.0 sürümüne ulaşmıştır.
MCP
Model/Uygulama <-> Araç / Kaynak

A2A
Ajan <-> Ajan
Bunlar model mimarisi değildir ve birbirlerinin doğrudan alternatifi sayılmamalıdır.
Ünite 27: Açık Ağırlıklı Model, Açık Kaynak Model ve Yerel Sunum
İndirilebilir ağırlığı bulunan her model “açık kaynak” değildir.
Açık Kaynak Girişimi'nin Open Source AI Definition 1.0 yaklaşımı; sistemi kullanma, inceleme, değiştirme ve paylaşma özgürlüklerinin yanında modeli değiştirmek için gerekli tercih edilen biçim, kod ve veri bilgisi gibi unsurları da ele alır.
Bu nedenle daha kesin terminoloji:
- açık ağırlıklı model (open-weight): ağırlıkları erişilebilir,
- açık kaynak yapay zekâ: daha geniş kullanım, inceleme, değiştirme ve paylaşma koşullarını karşılayan sistem,
şeklinde ayrılabilir.
27.1. Yerel / Kurum İçi Çıkarım
Ollama, vLLM veya başka sunum katmanları model değildir; model çalıştırma ve servis etme yazılımıdır. Yerel çalıştırma:
- verinin dış servise gönderilmemesini,
- sürümün sabitlenmesini,
- ağ bağımlılığının azaltılmasını
sağlayabilir.
Ancak otomatik olarak güvenli olduğu anlamına gelmez. Model dosyası tedarik zinciri, yerel erişim kontrolü, loglar, istem injection ve araç yetkileri yine yönetilmelidir.
27.2. Kıyaslama Kendi İş Yükünüzde Yapılmalıdır
Model seçimi yalnız genel leaderboard ile yapılmamalıdır.
Genel kıyaslama
      +
Türkçe görevler
      +
alan verisi
      +
hedef donanım
      +
p95 gecikme
      +
bellek / enerji
      =
üretim kararı
Özellikle nicemlenmiş ve yerel modellerde “aynı model adı” farklı quantization, context ve sunum ayarlarında farklı davranabilir.
Ünite 28: Üretici LLM ile Sınırlı Deterministik Analitik Asistan Arasındaki Mimari Seçim
Doğal dil arayüzü kullanan her sistem büyük dil modeli değildir. Bir sistem yalnız belirli bir veri alanında sorgu yorumlayabilir, klasik bilgi erişimi ve kurallı dil işleme kullanabilir, yapılandırılmış analitik işlemler çalıştırabilir ve yanıtı deterministik şablonlardan oluşturabilir.
Bu mimari ile üretici LLM aynı problem sınıfını hedeflemek zorunda değildir.
28.1. Kapsam Genişliği ve Doğrulanabilirlik
Genel amaçlı LLM; geniş dilsel kapsama, açık uçlu açıklama ve değişken görevlere uyumda güçlüdür.
Sınırlı deterministik analitik asistan ise tanımlı niyet kümesi, yapılandırılmış sorgu, kaynak veriye dönüş, aynı girdide aynı sonuç ve kontrollü araç yürütme gibi gereksinimlerde daha kolay doğrulanabilir olabilir.
Yararlı soru "hangisi daha akıllı?" değil:
Problem hangi düzeyde dil esnekliği ve hangi düzeyde kanıtlanabilir davranış gerektiriyor?
sorusudur.
28.2. Halüsinasyon Yüzeyi Mimari Özelliktir
Serbest üretim yapan sistem; sayı, kimlik veya ilişkiyi dil üretimi sırasında değiştirebilir.
Sınırlı mimaride yanıt akışı:
yapılandırılmış analitik sonuç
  ↓
doğrulanabilir gerçekler
  ↓
deterministik veya kısıtlı renderer
  ↓
bütünlük kontrolü
şeklinde kurulabilir.
LLM kullanılan sistemde de gerçekler, araç parametreleri ve çıktılar açık sözleşmelerle sınırlandırılabilir.
28.3. Tekrar Üretilebilirlik
Üretici modellerde sampling, model sürümü, sistem istemi ve çıkarım altyapısı çıktıyı etkileyebilir.
Deterministik bir alan asistanında:
aynı veri sürümü
+ aynı kullanıcı girdisi
+ aynı konuşma durumu
=
aynı yapılandırılmış sonuç
hedeflenebilir.
Bu özellik yüksek sorumluluklu analitik işlerde değerlidir.
28.4. Bilgi Erişimi ile Üretimi Ayırmak
Tam eşleşme, kalıp, TF-IDF, karakter n-gram ve kontrollü bulanık benzerlik gibi teknikler kullanıcının ifadesini bilinen niyet veya örneklere bağlayabilir.
Bu, üretici modelin küçük versiyonu değildir; farklı bir hesaplama yaklaşımıdır.
Karma mimari:
yüksek kesinlikli deterministik yol
        ↓ gerekirse
retrieval / sınıflandırma
        ↓ gerekirse
LLM
        ↓
yapılandırılmış çıktı doğrulaması
şeklinde kurulabilir.
28.5. Provenance Kısıtlı Araç Çağırma
Araç kullanan sistemlerde temel risklerden biri, dilsel olarak makul görünen fakat kaynağı doğrulanmamış parametrelerin eyleme dönüşmesidir.
Kritik değer için yalnız kullanıcının açık literal'i, doğrulanmış önceki sonuç veya yetkili veri kaynağı gibi provenance sınıfları kabul edilebilir.
Benzerlik skorundan veya serbest model tahmininden oluşan kritik kimlik doğrudan yan etkili araca bağlanmamalıdır.
28.6. Abstention ve Clarification
Üretici modelin akıcı cevap verebilmesi, her soruya cevap vermesi gerektiği anlamına gelmez.
Belirsiz varlık, eksik parametre, yetersiz veri, desteklenmeyen görev veya çelişen bağlam durumunda:
açıklaştır
sınırlamayı söyle
işlemi çalıştırma
geçerli sonuçlardır.
28.7. Structured NLG
Bazı analitik uygulamalarda doğal dil üretimi tamamen model tabanlı olmak zorunda değildir.
fact model
 -> söylem planı
 -> renderer
 -> integrity validation
akışı sayı/kimlik koruma, kararlı metin ve test kolaylığı sağlar.
Karşılığında ifade çeşitliliği azalır ve yeni söylem biçimleri için açık tasarım gerekir.
28.8. Mimari Uygunluk
LLM; geniş ve değişken dilsel görevler, uzun metin sentezi, zengin açıklama ve açık uçlu bilgi işlerinde daha uygun olabilir.
Sınırlı deterministik asistan; küçük ve yüksek etkili eylem kümesi, offline/yerel çalışma, sıkı veri sınırı, tekrar üretilebilir sonuç, güçlü kanıt zinciri ve düşük gecikmeli analitik için daha uygun olabilir.
Mühendislik olgunluğu model büyüklüğü değildir. Veri kapsamını bilme, belirsizliği gösterme, kanıta geri dönebilme, araç yetkisini sınırlama, sonucu yeniden üretebilme ve sayısal çıktıyı doğrulama da sistem kalitesinin parçasıdır.
Üretici LLM ile deterministik alan asistanı rakip ideolojiler değil; farklı görev ve risk profilleri için mimari araçlardır.
28.9. Üretim Gerektirmeyen Özetleme için Karar Sınırı
Bir metnin kısa anlatımını elde etmek için her zaman yeni cümle üretmek gerekmez. Seçici özetleme, özgün cümlelerin temsil gücünü değerlendirir ve seçilen ifadeleri kaynak aralıklarıyla birlikte sunar. Bu yöntem yeni bir olay veya açıklama uydurma riskini azaltır; ancak metnin önemli bütün bölümlerini kapsayacağı garanti değildir. İki ayrı cümlede bulunan bilgileri tek bir yeni ifadede birleştirmek istendiğinde ise artık yalnız seçim değil, bir sentez işlemi yapılmaktadır ve bu sentez ayrıca doğrulanmalıdır.
Hesaplama mimarisi bakımından burada farklı maliyetler söz konusudur. Sözcüksel erişim ve sınırlı komşuluk grafı hafif, denetlenebilir işlemler sunabilir. Öğrenilmiş bir sıralayıcı, yeterli etiketli veriyle adayları daha iyi değerlendirebilir; ancak ağırlıkların bulunması tek başına doğruluk, kalibrasyon veya kaynak sadakati sağlamaz. Büyük üretici modellerin dilsel esnekliği ise üretim sırasında yeni ifade kurma gücünden gelir ve kaynakla çelişme riskini ayrı bir denetim problemi olarak doğurur.
Bu nedenle mimari seçim kullanım amacından başlamalıdır. Amaç özgün konuşmanın denetlenebilir bölümlerini göstermekse kaynak aralığı taşıyan seçici yöntem uygun olabilir. Amaç farklı kaynakları yeni bir açıklamaya dönüştürmekse iddia bazında destek denetimi gerekir. “Kaynak bulundu”, “hesaplama yapıldı” ve “yorum çıkarıldı” durumları tek bir güven etiketine indirgenmemelidir.
Ünite 29: Uyarlama, Unutma ve Çıkarım Politikaları
Bir LLM'de davranışı değiştirmek için kullanılan her yöntem aynı maliyete ve aynı hata yüzeyine sahip değildir.
Prompt, retrieval, araç, PEFT ve full fine-tuning birbirinin "daha güçlü sürümü" değil; farklı problemi çözen farklı müdahale katmanlarıdır.
29.1. Önce Hangi Şeyin Değişmesini İstediğinizi Belirleyin
Uyarlama ihtiyacı dört farklı kaynaktan gelebilir:
bilgi eksik
davranış / format tutarsız
alan terminolojisi zayıf
yeni görev becerisi gerekiyor
Bunların çözümü aynı değildir.
Bilgi sürekli değişiyorsa model ağırlıklarına yazmak yerine retrieval veya yapılandırılmış veri erişimi daha uygun olabilir.
Çıktı biçimi veya kısa davranış kuralı değişecekse prompt, schema ve deterministic validation yeterli olabilir.
Kararlı ve tekrar eden alan davranışı gerekiyorsa PEFT veya fine-tuning anlamlı hale gelebilir.
Temel model yeteneği gerçekten yetmiyorsa daha kapsamlı eğitim veya başka model seçimi gerekebilir.
29.2. Uyarlama Merdiveni
Pratik karar sırası şu şekilde kurulabilir:
1. prompt / examples
2. structured output + validator
3. retrieval / tool
4. PEFT
5. full fine-tuning
Her basamakta:
Daha ucuz yöntem gerçek evaluation setinde problemi çözüyor mu?
sorusu sorulmalıdır.
Fine-tuning kötü retrieval'ı, eksik tool'u veya yanlış veri modelini otomatik olarak düzeltmez.
29.3. Fine-tuning Veri Sözleşmesi
Fine-tuning dataset'i yalnız çok sayıda örnek değildir.
Kalite boyutları:
doğru etiket
temsili dağılım
sınır vakaları
tutarlı format
çelişkisiz hedef davranış
safety örnekleri
retention örnekleri
olabilir.
Aynı prompt türünün yüzlerce neredeyse kopyasını eklemek dataset boyutunu büyütür; davranış kapsamasını aynı ölçüde büyütmez.
Training set'e benzeyen validation set de yanlış güven verebilir.
Bu nedenle evaluation:
in-domain normal
edge cases
adversarial / malformed
out-of-domain
retained general capability
dilimleri içermelidir.
Sıfır örnekli istem, az örnekli istem ve denetimli ince ayar aynı veriyle aynı biçimde karşılaştırılamaz. Az örnekli istemdeki örnekler, son değerlendirme kayıtlarının farklı ifade edilmiş kopyalarıysa ölçülen başarı genelleme değil sızıntı olabilir. Karşılaştırma için sabit görev tanımı, ayrık geliştirme ve test örnekleri, önceden belirlenmiş ölçütler ve aynı çıktı doğrulama kuralları gerekir. Özellikle yapılandırılmış görevlerde yalnız F1 değil geçerli şema oranı, kaynak dayanağı, reddetme davranışı ve yanlış pozitif eylem maliyeti de ölçülmelidir. Tercih, katalogdaki genel oranlardan değil uygulamanın hata bütçesinden türetilir.
29.4. Catastrophic Forgetting
Model yeni göreve uyarlanırken önceki yararlı becerilerinde gerileme yaşayabilir.
Bu catastrophic forgetting problemi continual veya güçlü domain fine-tuning sırasında özellikle önemlidir.
Risk:
target task ↑
general capability ↓
şeklinde görülebilir.
Bu nedenle release kriteri yalnız:
yeni benchmark +8 puanolmamalıdır.
Aynı anda:
target-task gain
retention-suite delta
safety regression
format regression
latency / memory
ölçülmelidir.
29.5. Forgetting için Retention Suite
Fine-tuning öncesinde korunması gereken yetenekler açıkça listelenebilir.
genel instruction following
temel reasoning
çok dilli davranış
safety / refusal
structured output
tool-call schema
domain-dışı normal görevler
Bu örneklerden oluşturulan küçük fakat kararlı test takımı her model sürümünde çalıştırılabilir.
Böylece "uzmanlaştı" ile "daraldı" birbirinden ayrılır.
29.6. Mitigation Tek bir Teknik Değildir
Forgetting'i azaltmak için kullanılabilecek yaklaşımlar:
- daha düşük öğrenme oranı veya daha kısa eğitim,
- dengeli veri karışımı,
- önceki yeteneklerden rehearsal örnekleri,
- PEFT ile değiştirilen parametre yüzeyini sınırlamak,
- checkpoint karşılaştırması,
- erken durdurma,
- retention metriğini model seçimine dahil etmek
olabilir.
Hiçbiri evrensel garanti değildir.
Asıl güvenlik ağı:
baseline
+ versioned dataset
+ reproducible training
+ regression eval
+ rollback
sözleşmesidir.
29.7. Generative Classification
Üretici LLM sınıflandırıcı olarak kullanılabilir.
Örneğin:
input
  ↓
prompt / schema
  ↓
label
Ancak doğal dil üretme yeteneği, classification problemindeki temel gereksinimleri ortadan kaldırmaz.
29.8. Label Taxonomy Tasarımı
Sınıflar:
- operasyonel olarak anlamlı,
- birbirinden ayırt edilebilir,
- gerektiğinde exhaustive,
- gerektiğinde explicit
OTHER / UNKNOWN
olmalıdır.
İki sınıfın açıklaması semantik olarak örtüşüyorsa prompt engineering hatayı tamamen düzeltemez.
Taxonomy değiştiğinde evaluation set de sürümlenmelidir.
29.9. Single-label ve multi-label Aynı Problem Değildir
Single-label durumda bir örnek tek sınıfa atanır.
Multi-label durumda bağımsız veya ilişkili birden fazla sınıf aynı örnek için doğru olabilir.
single:
A xor B xor C

multi:
A = true
B = false
C = true
Multi-label sistemde her etiket için threshold/calibration gerekebilir.
"En yüksek label'ı seç" kuralı problemi yanlışlıkla single-label hale getirebilir.
29.10. Abstention bir Sınıflandırma Sonucu Olabilir
Sistem düşük kanıt veya belirsiz sınıf sınırında:
zorla label üretyerine:
UNKNOWN
REVIEW
ABSTAIN
sonucu verebilir.
Bu özellikle yüksek etkili karar akışında accuracy'den daha doğru ürün davranışı olabilir.
Evaluation bu nedenle coverage ile error rate'i birlikte göstermelidir:
coverage ↑
forced errors ↑ olabilir

abstention ↑
manual review ↑ olabilir
29.11. Calibration
Modelin ürettiği token probability veya self-reported confidence doğrudan güvenilir sınıflandırma olasılığı kabul edilmemelidir.
Calibration ayrı validation problemi olarak ele alınabilir.
Gerekirse:
- held-out calibration set,
- threshold tuning,
- external classifier,
- agreement/ensemble,
- deterministic rule
kullanılabilir.
29.12. Decoding bir Ürün Politikasıdır
Model logits üretir; nihai text hangi decoding yöntemiyle token seçildiğine bağlıdır.
Greedy decoding:
her adımda argmaxDeterministiktir fakat erken yerel seçimden dönemeyebilir.
Beam search:
birden fazla aday devamı koruDaha geniş arama yapar fakat daha fazla compute gerektirir ve açık uçlu üretimde otomatik olarak daha iyi değildir.
Sampling:
temperature
top-k
top-p
ile olasılık dağılımından kontrollü rastgele seçim yapar.
Göreve göre doğru politika değişir.
29.13. Temperature, top-k ve top-p
Temperature dağılımın keskinliğini değiştirir.
temperature düşük
 -> daha yoğun / kararlı seçim

temperature yüksek
 -> daha yaygın / çeşitli seçim
Top-k yalnız en yüksek k adayın içinden sampling yapar.
Top-p ise cumulative probability belirli p değerine ulaşana kadar en olası token kümesini tutar.
Bu parametreler "yaratıcılık düğmesi" değildir. Accuracy, çeşitlilik, determinism ve error riskini etkileyen decoding kontrolleridir.
29.14. Beam Search Her Görevde Daha İyi Değildir
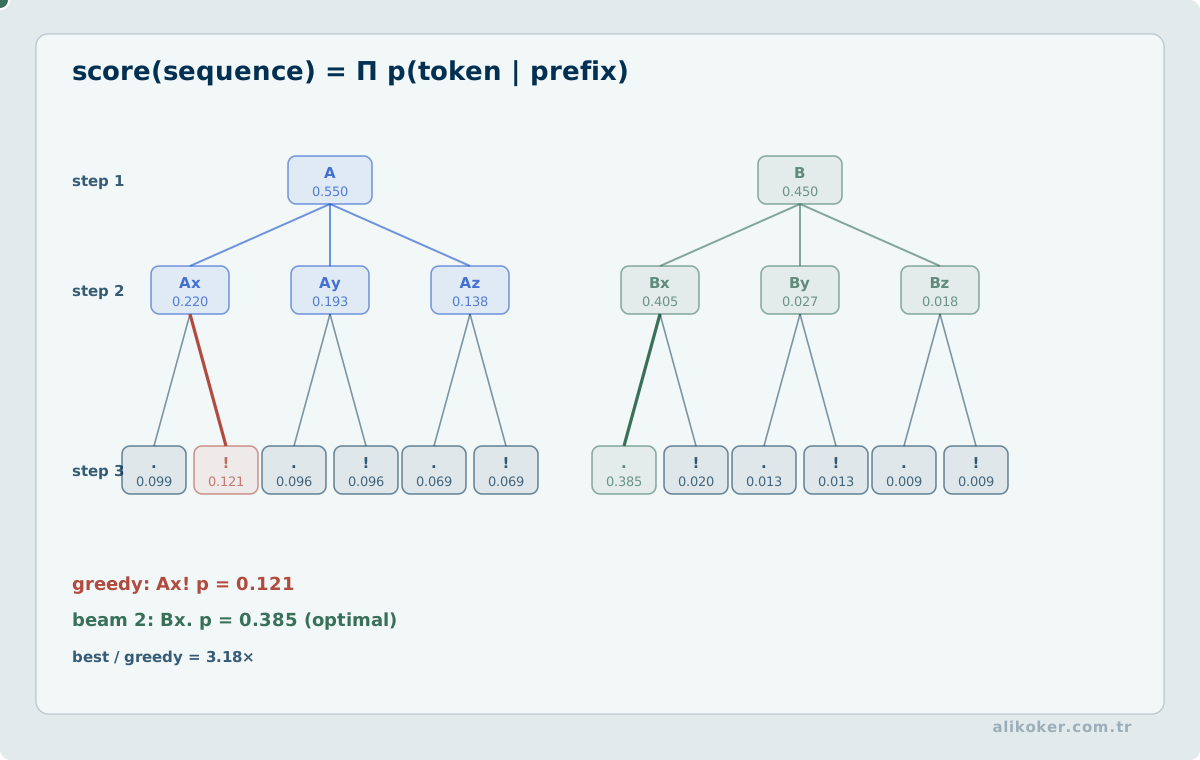
Sequence probability'yi daha geniş aramak:
doğru / faydalı / grounded cevaphedefiyle aynı objective değildir.
Özellikle açık uçlu diyalogda beam search:
- tekrar,
- generic ifade,
- düşük çeşitlilik
üretebilir.
Machine translation veya constrained generation gibi görevlerde ise beam yaklaşımı daha anlamlı olabilir.
Decoding yöntemi task-level eval ile seçilmelidir.
29.15. Uyarlama ve Decoding'i Ayrı Deneyler Olarak Tutmak
Fine-tuned modelin kalitesi ile decoding policy birbirine karıştırılırsa regresyonun kaynağı bulunamaz.
Daha güvenli deney matrisi:
model version
x
prompt version
x
retrieval version
x
decoding policy
olarak tutulabilir.
Tek deneyde hepsini değiştirmek:
kalite arttı / düştüsonucunun nedenini belirsiz hale getirir.
29.16. Release Kapısı
LLM uyarlamasında üretime geçiş:
target task
+ retained capability
+ safety
+ structured output
+ latency
+ cost
+ decoding stability
ölçümlerini birlikte kullanmalıdır.
Böylece model uyarlaması "training bitti" anında tamamlanan işlem değil, davranış değişikliğinin ölçüldüğü ve geri alınabildiği sürümlü yazılım değişikliği haline gelir.
Kaynakça
- A2A Project. Agent2Agent (A2A) Protocol Specification, sürüm 1.0.0. https://a2a-protocol.org/dev/specification/
- Ashish Vaswani et al. “Attention Is All You Need.” NeurIPS, 2017. https://arxiv.org/abs/1706.03762
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- Carlos E. Jimenez et al. “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. https://arxiv.org/abs/2310.06770
- Charlie Chen et al. “Accelerating Large Language Model Decoding with Speculative Sampling.” 2023. https://arxiv.org/abs/2302.01318
- Charlie Snell et al. “Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters.” arXiv preprint, 2024. https://arxiv.org/abs/2408.03314
- Chris Fregly. AI Systems Performance Engineering. O’Reilly Media, 2025.
- DeepSeek-AI et al. “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.” arXiv preprint, 2025; revised 2026. https://arxiv.org/abs/2501.12948
- DeepSeek-AI. “DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model.” 2024. https://arxiv.org/abs/2405.04434
- Edward J. Hu et al. “LoRA: Low-Rank Adaptation of Large Language Models.” ICLR, 2022. https://arxiv.org/abs/2106.09685
- Eric, Mihail. The Modern Software Developer (CS146S). Stanford University, course materials, 2025–2026. https://themodernsoftware.dev/
- Holtzman, Ari; Buys, Jan; Du, Li; Forbes, Maxwell; Choi, Yejin. “The Curious Case of Neural Text Degeneration.” ICLR, 2020. https://arxiv.org/abs/1904.09751
- John Atkinson-Abutridy. Large Language Models: Concepts, Techniques and Applications. CRC Press, 2024. DOI: https://doi.org/10.1201/9781003517245
- Jordan Hoffmann et al. “Training Compute-Optimal Large Language Models.” 2022. https://arxiv.org/abs/2203.15556
- Joshua Ainslie et al. “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints.” 2023. https://arxiv.org/abs/2305.13245
- Lianmin Zheng et al. “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.” 2023. https://arxiv.org/abs/2306.05685
- Long Ouyang et al. “Training Language Models to Follow Instructions with Human Feedback.” NeurIPS, 2022. https://arxiv.org/abs/2203.02155
- Luo, Yun; Yang, Zhen; Meng, Fandong; Li, Yafu; Zhou, Jie; Zhang, Yue. “An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning.” 2023. https://arxiv.org/abs/2308.08747
- Ma, S. et al. “The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits.” 2024. https://arxiv.org/abs/2402.17764
- Model Context Protocol. Model Context Protocol Specification. https://modelcontextprotocol.io/specification/
- Model Context Protocol. Specification 2026-07-28. https://modelcontextprotocol.io/
- Model Context Protocol. “The 2026-07-28 Specification.” 2026. https://blog.modelcontextprotocol.io/posts/2026-07-28/
- Morteza SaberiKamarposhti. Building Large Language Models (LLM): A Step-by-Step Guide to Practical LLM Development. 2024.
- Nelson F. Liu et al. “Lost in the Middle: How Language Models Use Long Contexts.” 2023. https://arxiv.org/abs/2307.03172
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1), 2024; web sürümü 2026'da güncellenmiştir. https://doi.org/10.6028/NIST.AI.600-1
- Open Source Initiative. The Open Source AI Definition 1.0. https://opensource.org/ai/open-source-ai-definition
- OWASP GenAI Security Project. OWASP Top 10 for LLM Applications 2025. https://genai.owasp.org/llm-top-10/
- Patrick Lewis et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” NeurIPS, 2020. https://arxiv.org/abs/2005.11401
- Pere Martra. Large Language Models Projects: Apply and Implement Strategies for Large Language Models. Apress, 2024. ISBN 979-8-8688-0515-8.
- Philip Kiely. Inference Engineering. Baseten Books, 2026. ISBN 979-8-9943597-3-0.
- Rafael Rafailov et al. “Direct Preference Optimization: Your Language Model is Secretly a Reward Model.” NeurIPS, 2023. https://arxiv.org/abs/2305.18290
- Raj Arun R. Mastering Large Language Models with Python. Orange Education, 2024. ISBN 9788197081828.
- Shao, Z. et al. “DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models.” 2024. https://arxiv.org/abs/2402.03300
- Shunyu Yao et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” ICLR, 2023. https://arxiv.org/abs/2210.03629
- Siagian, Lamhot. Language Models Interview Handbook: 151 Interview Questions, Foundation Roadmaps, Python Examples, Architecture Diagrams, and Production Playbooks for Modern LLM and GenAI Roles. AI Engineering Insider, 2026.
- Tim Dettmers et al. “QLoRA: Efficient Finetuning of Quantized LLMs.” NeurIPS, 2023. https://arxiv.org/abs/2305.14314
- Timo Schick et al. “Toolformer: Language Models Can Teach Themselves to Use Tools.” NeurIPS, 2023. https://arxiv.org/abs/2302.04761
- Tri Dao et al. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” NeurIPS, 2022. https://arxiv.org/abs/2205.14135
- William Fedus; Barret Zoph; Noam Shazeer. “Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity.” 2021. https://arxiv.org/abs/2101.03961
- Woosuk Kwon et al. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” SOSP, 2023. https://arxiv.org/abs/2309.06180