


Bilgi Erişimi Destekli Üretim (RAG)


RAG'ı bilgi erişimi, hibrit arama, yeniden sıralama, büyük veri, özel veriyle sohbet, Graph RAG, zamansal ilişki analizi, güvenlik, değerlendirme ve yerel üretim mimarisi üzerinden uygulamaya dönük ele alan kapsamlı ders notu.
Bilgi Erişimi Destekli Üretim (Retrieval-Augmented Generation, RAG), büyük dil modelinin yanıt üretirken yalnız kendi parametrelerinde bulunan örüntülere dayanması yerine, çalışma zamanında dış bilgi kaynaklarından ilgili kanıtı bulup bağlama eklemesine dayanan bir sistem mimarisidir. RAG'ın asıl değeri bir sohbet ekranı üretmek değildir. Eski bir web sitesini, belge arşivini, veri tabanını, konuşma dökümlerini, olay kayıtlarını veya ilişki grafiğini yeniden eğitilmiş tek bir modele dönüştürmeden yapay zekâ ile kullanılabilir hâle getirmesidir.
Bu ders Yapay Zeka: Felsefe, Kuram ve Uygulama, Doğal Dil İşleme ve Büyük Dil Modelleri derslerinin doğal devamıdır.
Yapay Zeka
   |
   v
Doğal Dil İşleme
   |
   v
Büyük Dil Modelleri
   |
   v
Bilgi Erişimi Destekli Üretim
Yapay zekâ dersi daha geniş problem alanını, NLP dili ve metni, LLM dersi üretici modeli ele alır. Bu ders ise model ile dış bilgi sistemleri arasındaki mühendislik katmanına odaklanır.
RAG için en önemli düşünce şudur:
iyi yanıt
   =
uygun model
 + doğru kanıt
 + doğru yetki
 + doğru bağlam
 + doğrulanmış çıktı
Model güçlü olsa bile yanlış belge getirilirse yanıt yanlış temele oturur. Retrieval doğru olsa bile bağlam gereksiz parçalarla doldurulursa model önemli kanıtı kaçırabilir. Doğru bilgi getirilse bile kullanıcı o bilgiyi görmeye yetkili değilse sistem güvenlik açısından başarısızdır.
Ünite 1: Parametrik Bilgi ve Dış Bilgi
Bir büyük dil modeli geniş veri üzerinde eğitildiğinde örüntülerin bir bölümü model ağırlıklarına dağılmış biçimde yerleşir. Buna parametrik bilgi denebilir. Bu bilgi doğrudan satır, belge veya kaynak gösteren bir veri tabanı değildir.
RAG çalışma zamanında ayrı bir bilgi kaynağı kullanır.
                 +-------------------+
                 | Model ağırlıkları |
                 | parametrik bilgi  |
                 +---------+---------+
                           |
Sorgu -------------------->| LLM
                           ^
                           |
                 +---------+---------+
                 | getirilen kanıt   |
                 | dış bilgi         |
                 +-------------------+
Bu ayrım özellikle güncellik ve kaynak kökeni açısından önemlidir. Bir belgenin bugün değişmesi, model ağırlıklarının otomatik değiştiği anlamına gelmez. RAG'ta ise belge yeniden indekslenerek güncel bilgi çalışma zamanında modele sunulabilir.
RAG'ın tarihsel önemi, parametrik ve parametrik olmayan belleği üretim sürecinde birleştirmesidir. Bununla birlikte günümüzde RAG terimi çok daha geniş bir sistem ailesini ifade eder: sözcüksel arama, yoğun vektör arama, yeniden sıralama, SQL, grafik sorguları, zaman filtreleri ve araç çağrıları aynı retrieval katmanında birlikte kullanılabilir.
Ünite 2: RAG Yaklaşımının Kapsamı ve Sınırları
RAG ile benzer görünen yöntemler farklı sorunları çözer.
2.1. İnce Ayar
İnce ayar model davranışını veya temsilini ağırlıkları değiştirerek uyarlamaya yöneliktir. Bilginin sık değiştiği bir alanda her yeni belge için modeli yeniden eğitmek genellikle doğru mimari değildir.
veri değişti
   |
   +--> ince ayar:
   |      eğitim
   |      yeni ağırlık
   |      değerlendirme
   |      yeniden dağıtım
   |
   +--> RAG:
          belgeyi işle
          indeksi güncelle
          yeni sorguda kullan
2.2. Uzun Bağlam
Modelin çok uzun bağlam kabul etmesi retrieval ihtiyacını tamamen ortadan kaldırmaz. Büyük arşivin tamamını her sorguda modele vermek:
- gereksiz token maliyeti,
- yüksek gecikme,
- yetki yönetimi zorluğu,
- önemli bilginin bağlam içinde kaybolması,
- güncellik ve kaynak kökeni sorunları
oluşturabilir.
Uzun bağlam ile RAG birbirinin rakibi değil, tamamlayıcısıdır. Retrieval önce ilgili alanı daraltabilir; uzun bağlam ise seçilen belgelerin daha geniş bölümünü birlikte değerlendirmeyi sağlayabilir.
2.3. Araç Kullanımı
RAG bilgi getirir. Araç kullanımı dış dünyada işlem yapabilir.
RAG:
"Bu kayıtlar ne söylüyor?"

Araç:
"Bu sorguyu çalıştır."
"Bu dosyayı aç."
"Bu raporu üret."
Bir sistem ikisini birlikte kullanabilir.
Ünite 3: Akıllı Olmayan bir Siteyi Akıllı Hâle Getirmek
Klasik bir web sitesi yıllarca içerik üretmiş olabilir. Makaleler, ders notları, projeler, wiki girdileri ve dokümanlar kullanıcıya sayfa ve menü üzerinden sunulur. Bu yapı yapay zekâ kullanmıyor diye değersiz değildir; aksine düzenli içerik yapısı RAG için güçlü bir bilgi kaynağıdır.
İlk aşama mevcut siteyi değiştirmek değil, içeriği ayrı bir bilgi hattına bağlamaktır.
Mevcut Site
   |
   +--> HTML / Markdown
   +--> veri tabanı içerikleri
   +--> wiki
   +--> belgeler
   |
   v
İçerik Çıkarma
   |
   v
Temizleme + Metadata
   |
   v
Parçalama
   |
   +--> sözcüksel indeks
   |
   +--> vektör indeks
   |
   v
RAG API
   |
   v
Mevcut siteye sohbet / anlamsal arama yüzeyi
Bu yaklaşım eski sitenin veri modelini bozmaz. Yapay zekâ katmanı mevcut sistemin üzerine eklenen ayrı bir okuma ve anlamlandırma katmanıdır.
3.1. Aramadan Yanıta Geçiş
Klasik arama:
kullanıcı -> "gerçek zamanlı sistem"
          -> eşleşen sayfalar
RAG:
kullanıcı
  |
  v
"Gerçek zamanlı sistemlerde gecikme ve throughput
arasında hangi ödünleşimler anlatılmış?"
  |
  v
ilgili sayfa + bölüm + paragraf retrieval
  |
  v
kaynaklı sentez
İkinci sistem yine aramaya dayanır; fark, bulunan kanıtların üretici model tarafından soruya göre birleştirilmesidir.
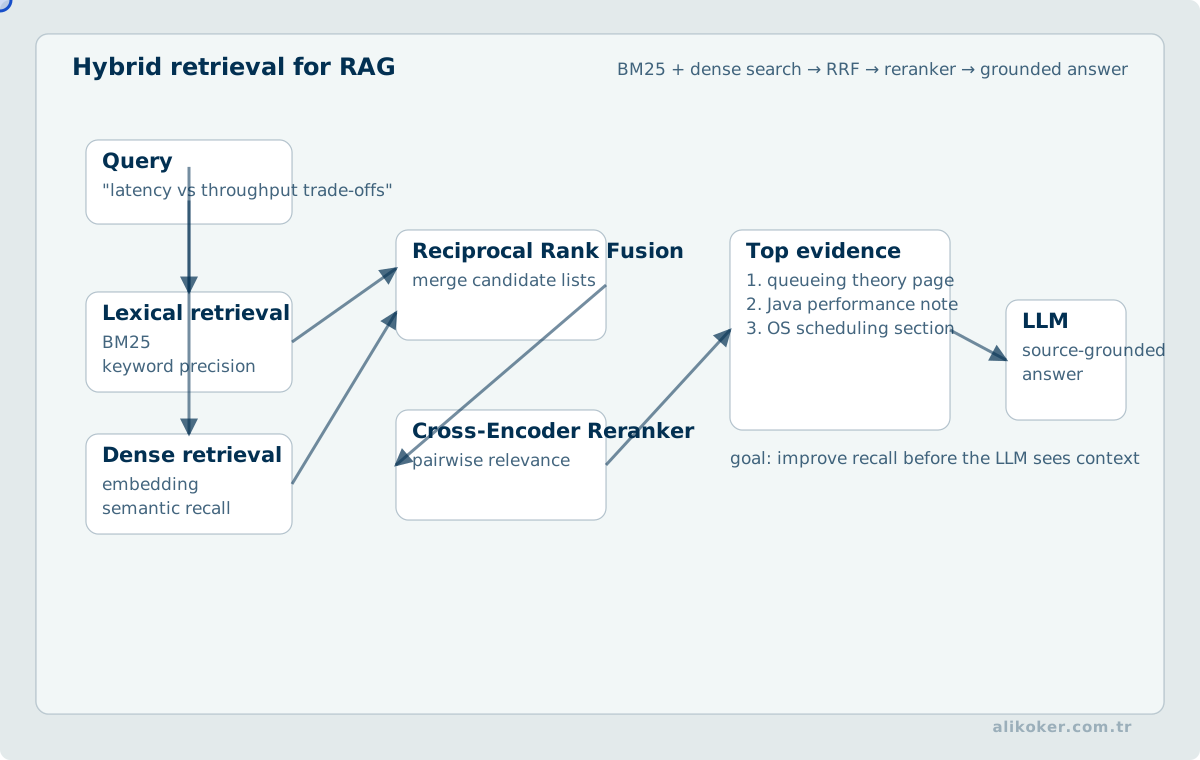
3.2. Site için Önerilen İlk Sürüm
İlk sürümde ajan, Graph RAG veya karmaşık çok adımlı zincir gerekmez.
Sorgu
  |
  v
BM25 + Dense Search
  |
  v
Reciprocal Rank Fusion
  |
  v
Cross-Encoder Reranker
  |
  v
Top 5-10 kanıt
  |
  v
LLM
  |
  v
Kaynaklı yanıt
Basit ve ölçülebilir bir sistem, çok sayıda üretici modülü üst üste eklemekten daha sağlıklı başlangıçtır.
Ünite 4: Bilgi Alım Hattı
RAG kalitesi sorgu anında başlamaz. Asıl hazırlık veri alım hattında yapılır.
Kaynak
  |
  v
Çıkarma
  |
  v
Normalizasyon
  |
  v
Metadata
  |
  v
Parçalama
  |
  v
Embedding / sözcüksel indeks
  |
  v
Sürümleme
  |
  v
Yayınlanmış indeks
Bilgi alım hattında önce kaynağın kimliği, erişim yetkisi ve güncellik ölçütü belirlenir. Belge ayrıştırılırken başlık, bölüm ve kaynak adresi gibi köken bilgileri içerikten koparılmamalıdır. Tekrarlanan sürümler işaretlenir ve silinen veya yetkisi değişen belgelerin indeks üzerindeki etkisi açıkça tanımlanır. Hattın başarısı yalnız başarılı parça üretimiyle değil, parçadan özgün kaynağa geri dönülebilmesi ve güncellemenin doğru yansıtılmasıyla ölçülür.
4.1. Kaynak Türleri
RAG yalnız PDF için değildir. Kaynaklar:
- HTML,
- Markdown,
- düz metin,
- PDF,
- DOCX,
- veri tabanı kayıtları,
- konuşma dökümleri,
- e-posta benzeri ileti metinleri,
- kod ve teknik belge,
- olay açıklamaları,
- grafik düğüm ve kenar açıklamaları
olabilir.
Her kaynağın aynı biçimde parçalanması gerekmez.
4.2. Kanonik Belge
Aynı içeriğin PDF, HTML ve veri tabanı biçimi bulunabilir. Hepsini ayrı gerçekmiş gibi indekslemek yinelenen retrieval sonuçları üretir. Bu nedenle bir kanonik belge kimliği tutulmalıdır.
canonical_document_id
source_type
source_uri
language
version
created_at
modified_at
access_scope
content_hash
İndeks girdisi kaynak belgenin yerine geçmemelidir. Kaynağa geri dönüş yolu korunmalıdır.
Aynı bilginin üç farklı dosyada bulunması üç bağımsız kanıt bulunduğu anlamına gelmez. Kanıt birimi, dosya sayısından önce özgün kaynak ve kaynağın sürümüdür. Bir akademik metnin alıntı kopyası, eğitim sunumu ve otomatik özeti aynı asıl çalışmaya dayanıyorsa arama puanına üçlü destek olarak yansıtılmamalıdır. Kaynak kimliği, yayın veya güncelleme zamanı, dönüşüm zinciri ve alıntılanabilir metin aralığı korunmalıdır. Özellikle transkripsiyondan türetilmiş parçalarda konuşma hatası, konuşmacı ataması ve kesilmiş cümle riski nedeniyle kesin ifade yerine özgün kaynağa geri dönülebilir referans gereklidir.
Ünite 5: Parçalama Stratejisi
RAG sisteminin en kritik kararlarından biri chunking, yani belgenin arama birimlerine ayrılmasıdır.
Sabit karakter uzunluğu kolaydır; fakat anlamsal sınırları bozabilir.
Yanlış sınır:
"... veri tabanı transaction sınırı burada..."
                       | CUT
"... başlar ve commit davranışı ..."
Böyle bir kesim retrieval sonucunun anlamını zayıflatır.
Belge parçalama yöntemi seçilirken önce kullanıcı sorusunun hangi bağlam uzunluğunu gerektirdiği incelenir. Bölüm sınırlarını koruyan parçalara öncelik verilir; çok uzun bölümlerde anlamı koparmadan alt bölme yapılır. Örtüşme miktarı artırıldığında bağlam sürekliliği yanında yinelenen kanıt ve arama maliyeti de artabilir. Aynı soru kümesinde erişilen doğru kaynak oranı, cevap desteği ve maliyet ölçülmeden yalnız sabit bir parça uzunluğu en iyi çözüm olarak kabul edilmemelidir.
5.1. Yapısal Parçalama
Markdown ve ders notlarında:
Ders
 |
 +--> Ünite
       |
       +--> Başlık
             |
             +--> Alt başlık
                   |
                   +--> Paragraf
yapısı zaten doğal hiyerarşidir.
Arama küçük parçalarda yapılabilir. LLM'ye ise gerektiğinde üst bağlam gönderilebilir.
arama granülerliği
        !=
bağlam granülerliği
Bu parent-child retrieval yaklaşımı uzun teknik belgelerde güçlüdür.
5.2. İçerik Türüne Göre Parçalama
Bir SQL sorgusu, Java metodu, tablo açıklaması ve doğal dil paragrafı aynı splitter ile işlenmemelidir.
Örneğin kod parçasında fonksiyon veya sınıf sınırı; konuşma dökümünde konuşmacı dönüşü veya zaman segmenti; olay akışında zaman penceresi; ders notunda başlık yapısı daha anlamlı sınır olabilir.
5.3. Overlap
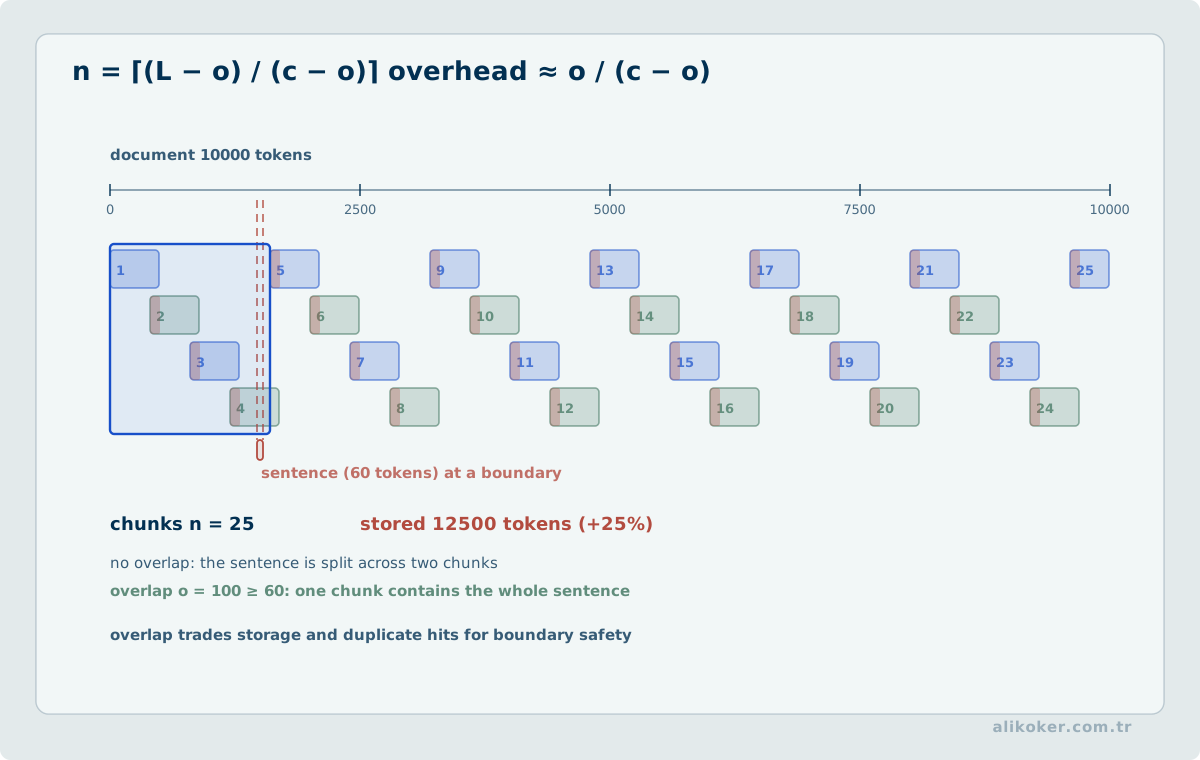
Chunk overlap komşu parçalar arasında bağlam kaybını azaltabilir. Fakat çok yüksek overlap:
- indeks boyutunu büyütür,
- aynı kanıtın tekrar tekrar gelmesine yol açar,
- reranker havuzunu kirletir,
- LLM bağlamını yinelenen metinle doldurur.
Overlap ölçülerek seçilmelidir.
5.4. Anlamsal Sınır ve Önerme Bütünlüğü
Anlamsal parçalama, ardışık cümlelerin temsillerindeki değişimi olası konu sınırı olarak kullanabilir. Ancak kosinüs benzerliğindeki düşüş tek başına kesin sınır değildir; alıntı, teknik terim yoğunluğu ve kısa paragraflar yanlış ayrım oluşturabilir. Başlık, liste, tablo ve kod bloğu sınırları korunmadan yapılan anlamsal bölme, dilsel olarak tutarlı görünen fakat kanıt bakımından eksik parçalar üretebilir.
Önerme temelli parçalama, birbirinden bağımsız doğrulanabilen ifadeleri erişim birimi olarak ele alır. Sayısal sonuç, tarih, koşul, istisna ve öznenin aynı kanıt biriminde kalması gerekir. Önerme aşırı küçültülürse hangi nesne, hangi tarihte ve hangi koşul altında bilgisi kaybolur. Bu nedenle önerme, kaynak paragrafı ve üst bölüm kimliğiyle birlikte saklanmalıdır.
5.5. Uyarlanabilir Parçalama ve Değerlendirme
Parça boyutu ve sınırı belge tipine göre değiştirilebilir: kurallı metinde madde, konuşmada zaman ve konuşmacı dönüşü, kodda sözdizimsel blok, teknik notta alt başlık doğal birim olabilir. Model yönlendirmeli veya ajan tabanlı ayrıştırma, yeniden üretilebilir sınır kararları üretmediğinde ek doğrulama ve işlem maliyeti doğurur; varsayılan olarak daha iyi retrieval sağlamaz.
Parçalama kıyaslamasında aynı sorgu–kanıt kümesi ve aynı retrieval bütçesi kullanılmalıdır. Kanıt erişimi kanıtı içeren sonuç sayısı / ilgili kanıt sayısı üzerinden tanımlanabilir; bu tanımda birim ve eşleşme kuralı sabit tutulmalıdır. Ayrıca doğru kaynağa erişme oranı, kanıtın bütünüyle kapsanması, üretilen parçaların ortalama boyutu, yinelenen belirteç oranı ve indeksleme maliyeti raporlanır. Anlamsal parçalama ancak bu ölçütlerdeki kazanım ek hesaplama maliyetini karşılıyorsa tercih edilir.
Ünite 6: Embedding ve Vektör Arama
Embedding modeli metni yüksek boyutlu yoğun bir vektöre dönüştürür. Semantik olarak yakın metinlerin vektörlerinin yakın olması hedeflenir.
"veri tabanı bağlantı havuzu"
          |
          v
      embedding
          |
          v
[0.12, -0.31, ..., 0.07]
Sorgu da aynı uzaya taşınır ve yakın komşular aranır.
6.1. Benzerlik Doğruluk Değildir
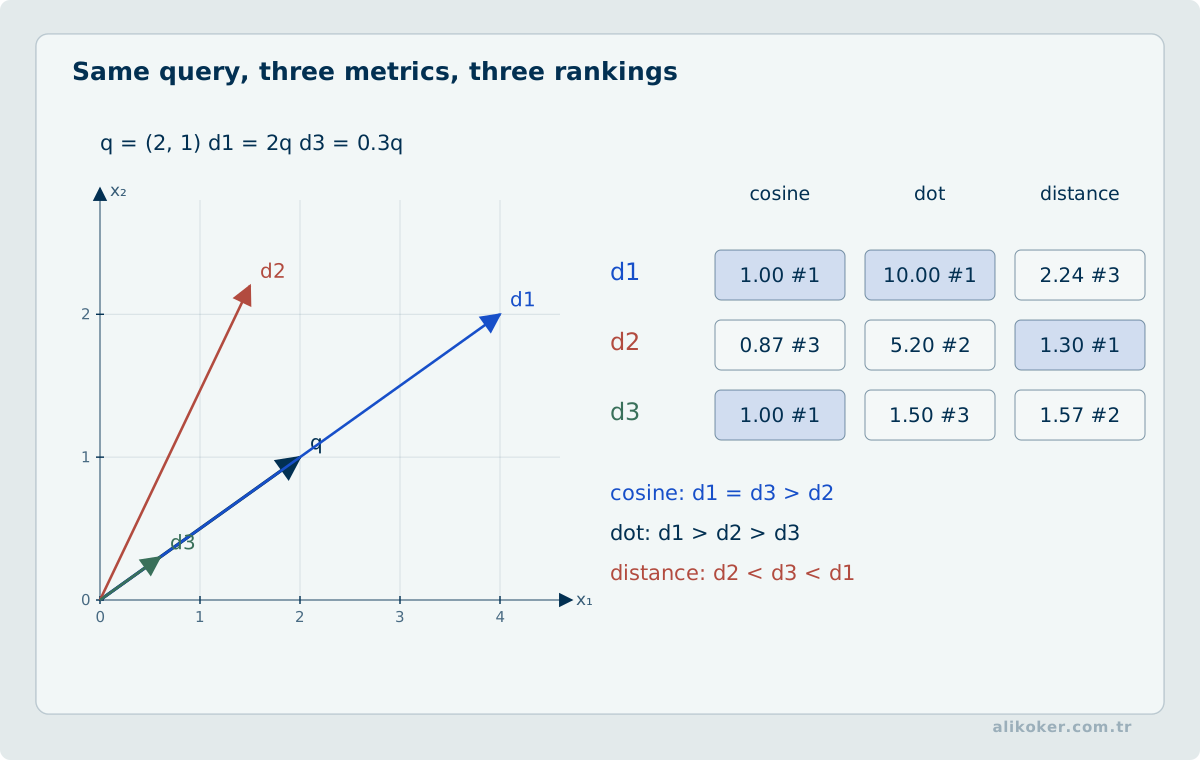
Cosine similarity veya inner product, iki metnin anlamsal yakınlığını tahmin eder. Bu değer:
- doğruluk,
- nedensellik,
- aynı kişi,
- aynı olay,
- güvenilirlik
anlamına gelmez.
Bu ayrım özellikle kişi ve ilişki analizinde zorunludur.
6.2. ANN
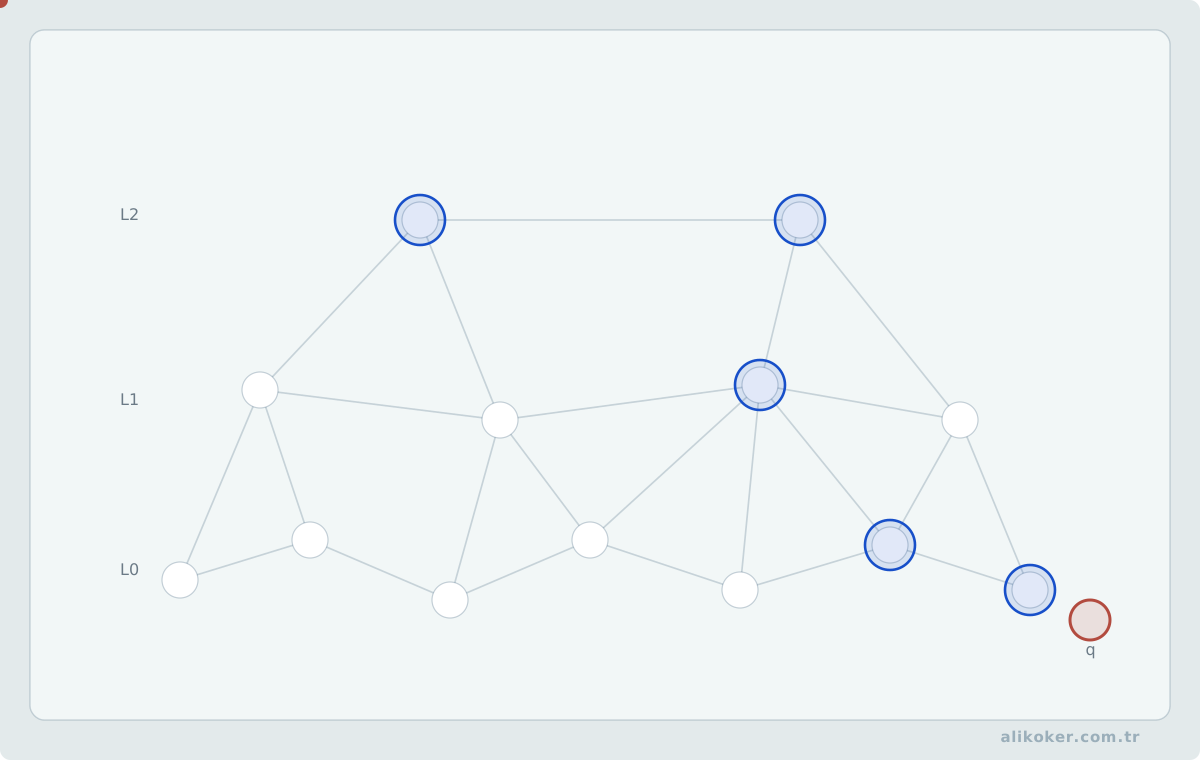
Milyonlarca vektörde bütün vektörlerle tam karşılaştırma pahalı olabilir. Approximate Nearest Neighbor indeksleri arama maliyetini düşürür. HNSW ve FAISS ailesindeki indeksler bu amaçla kullanılabilir.
ANN yaklaşık sonuç döndürür; bu nedenle performans kararı:
latency
  vs
recall
  vs
memory
ödünleşimidir.
6.3. Ters Dosya Bölmeleri ve Vektör Nicemleme
Bütün vektörleri sorguyla karşılaştırmak N aday için boyut d düzeyinde yaklaşık O(Nd) aritmetik iş yükü doğurur. Ters dosya bölmeleri, vektörleri kaba merkezlere ayırarak sorguyu yalnız seçilen kümelerde arar. Daha az küme taranması gecikmeyi düşürebilir; sınır yakınındaki gerçek komşuları kaçırma olasılığını artırır. Merkezlerin eğitildiği örneklem, üretim dağılımını temsil etmelidir.
Çarpımsal nicemleme, bir vektörü alt uzaylara ayırıp her alt uzayı küçük bir kod sözlüğündeki temsilciyle kodlar. Böylece yaklaşık uzaklıklar sıkıştırılmış kodlar üzerinden hesaplanır. Kod uzunluğu azaldıkça bellek tüketimi düşerken sıralama hatası büyüyebilir. Kaba bölme, nicemleme ve gerektiğinde özgün vektörle son yeniden sıralama farklı doğruluk–maliyet noktaları oluşturur.
İndeks karşılaştırmasında yalnız sorgu süresi değil, recall@k, indeksleme ve yeniden oluşturma süresi, depolama, RAM tüketimi ve güncelleme davranışı ölçülmelidir. Yaklaşık vektör araması yetkilendirme, metadata süzme ve kaynak doğrulamasının yerini alamaz.
6.4. IVF, Ürün Nicemleme ve Yaklaşık Arama Hata Bütçesi
Tam komşuluk aramasında hesap maliyeti vektör sayısı ve boyutla yaklaşık doğrusal büyür. IVF yapısında veri kümesi hücrelere ayrılır ve sorguda taranacak hücre sayısı (nprobe) azaltıldığında aday sayısı ile arama maliyeti düşebilir; ancak ilgili komşuların taranmayan hücrelerde kalması recall kaybı oluşturur. Product Quantization vektörleri alt uzaylara ayırıp kod kitaplarıyla temsil ederek bellek tüketimini düşürür; karşılığında uzaklık tahmininde nicemleme hatası üretilir.
Kıyaslama, exact-search sonucunu referans kabul ederek Recall@K = |ANN_K ∩ Exact_K|/K üzerinden yapılabilir. Karşılaştırmada p50/p95/p99 sorgu gecikmesi, indeks RAM'i, kurulum maliyeti, ekleme-silme davranışı ve eşzamanlı sorgu yükü birlikte ölçülür. Gömme modeli veya normalizasyon sürümü değiştiğinde eski indeksin geçerliliği yeniden değerlendirilir. Kosinüs benzerliği için L2-normalize vektörlerde iç çarpımın uygun eşdeğerlik koşulları sağlanır; metrik seçimi indeks tipinden bağımsız olarak doğrulanmalıdır.
Ünite 7: Sözcüksel, Yoğun ve Hibrit Retrieval
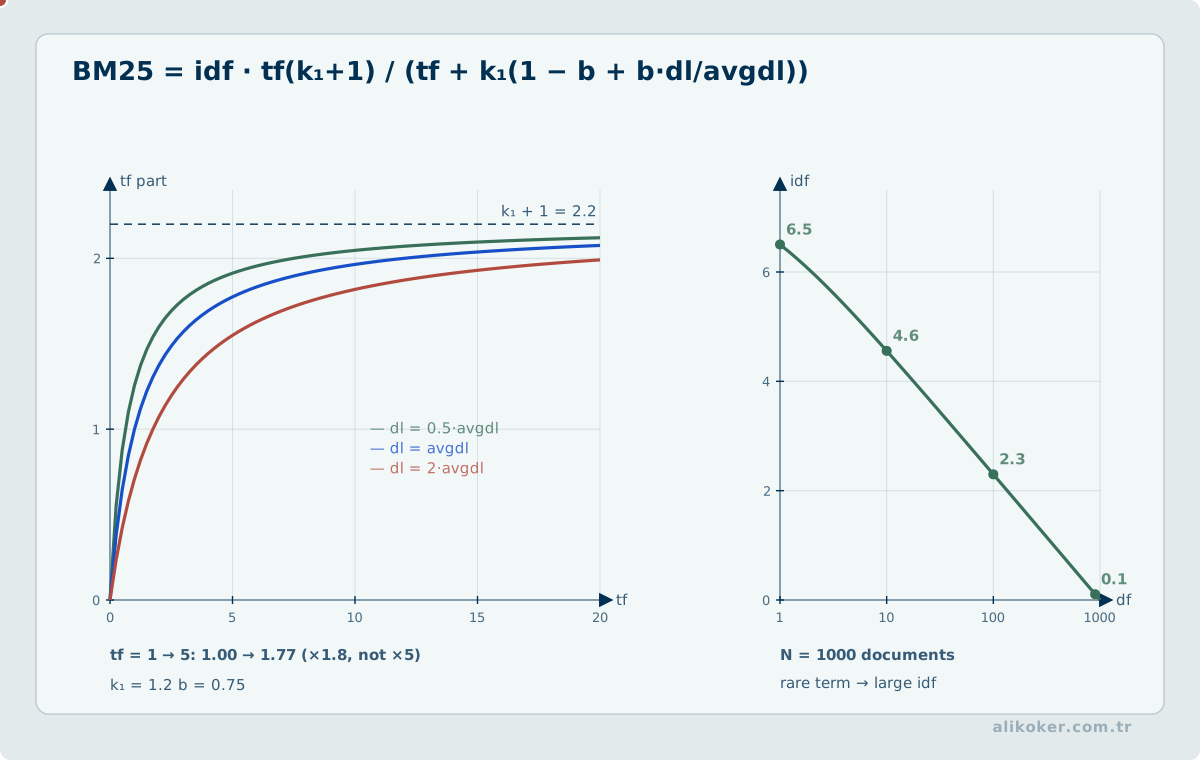
Sadece dense retrieval kullanmak özellikle kurumsal ve Türkçe veride yeterli değildir.
7.1. Sözcüksel Arama
BM25 gibi yöntemler şu durumlarda güçlüdür:
- özel ad,
- telefon/kimlik benzeri tam değer,
- teknik kod,
- kısaltma,
- nadir terim,
- bire bir ifade.
Sözcüksel erişimde metindeki biçimsel eşleşme, sorgunun amaçladığı kavramla aynı değildir. Türkçede ekli biçimler ve yazım varyantları özellikle kısa teknik terimlerde yanlış negatif oluşturabilir; buna karşılık yalnız kök indirgeme yapmak farklı kavramları yanlış birleştirebilir. Seyrek bir erişim modelinde alan ağırlıkları, terim sıklığı ve belge uzunluğu ayrı izlenmeli; yoğun benzerlik kullanılıyorsa bunun semantik doğruluk veya yetki denetimi olmadığı korunmalıdır. Değerlendirme, açık biçimde doğrulanmış ilgili ve ilgisiz belge çiftleri ile yapılmalı; yalnız birkaç olumlu örnek yeterli görülmemelidir.
7.2. Yoğun Arama
Dense retrieval şu durumlarda avantajlıdır:
- eş anlam,
- farklı ifade biçimleri,
- paraphrase,
- kavramsal benzerlik.
7.3. Hibrit Arama
                  +--> BM25 ---------+
Sorgu ------------|                  |
                  +--> Dense --------+--> Fusion --> Adaylar
                                     |
Metadata filtre ---------------------+
Birleştirme için skorları doğrudan toplamak zor olabilir; iki sistemin skor dağılımları farklıdır. Reciprocal Rank Fusion gibi sıra tabanlı yöntemler sağlam bir başlangıç sağlayabilir.
7.4. Türkçe Metinlerde Hibrit Erişim Gereksinimi
Türkçenin eklemeli yapısı dense model için anlamsal genelleme gerektirirken; özel ad, kod ve ekli sözcük varyantları lexical katmanı değerli kılar.
2026 tarihli RAGTurk çalışması Türkçe RAG hattında sorgu dönüşümü, reranking ve yanıt iyileştirme aşamalarını karşılaştırmış; karmaşık üretici bileşenlerin üst üste eklenmesinin her zaman yarar sağlamadığını, güçlü yeniden sıralama ile daha yalın yapıların maliyet/başarım açısından etkili olabildiğini göstermiştir. Bu sonuç tek veri kümesinden bütün sistemlere genellenmemeli; ancak Türkçe RAG'da karmaşıklığın ölçülmeden artırılmaması gerektiğini destekler.
Ünite 8: Yeniden Sıralama
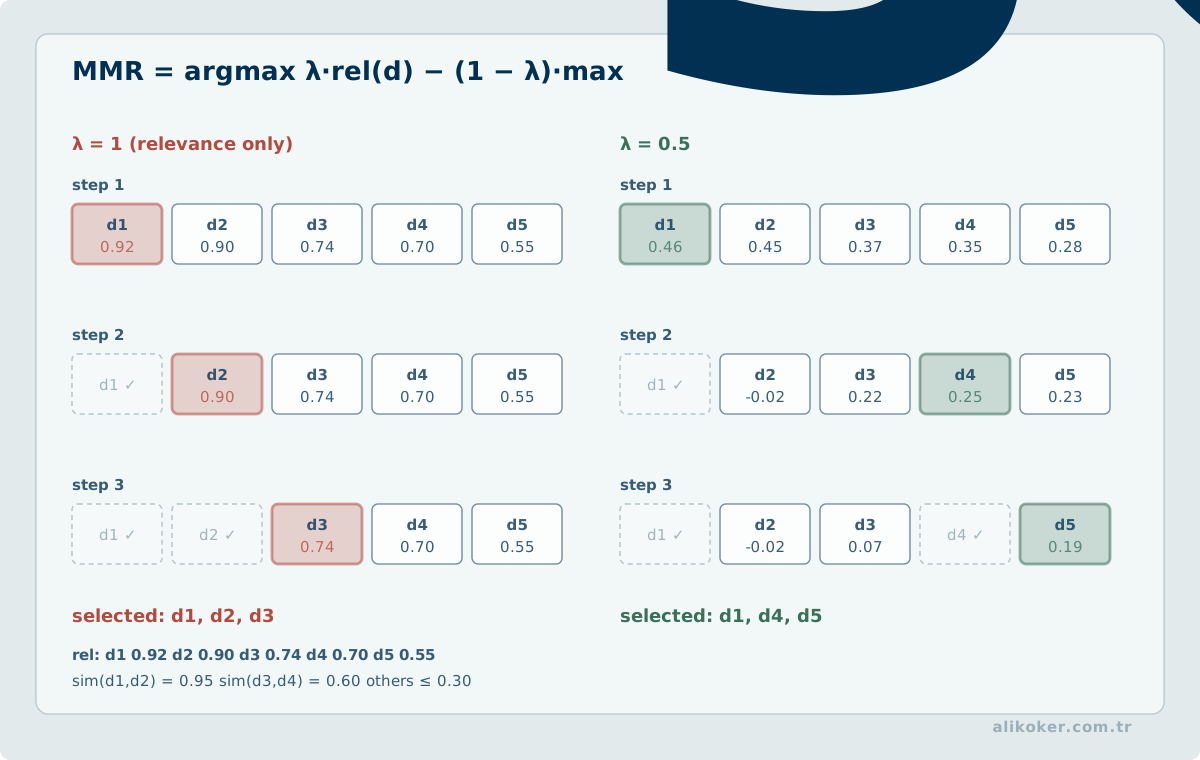
İlk retrieval aşamasının amacı mümkün olduğunca ilgili adayları kaçırmamaktır. Sonraki reranker ise daha küçük aday kümesini daha pahalı ama daha hassas biçimde sıralar.
10 milyon parça
    |
    v
BM25 + ANN
    |
  top 100
    |
    v
Cross-Encoder
    |
  top 10
    |
    v
LLM
Bu mimaride pahalı model bütün veri üzerinde çalışmaz.
8.1. Bi-encoder ve cross-encoder
Bi-encoder belge vektörlerini önceden hesaplayabilir. Sorgu sırasında hızlıdır.
Cross-encoder ise sorgu ile belgeyi birlikte değerlendirir ve daha ayrıntılı etkileşim kurabilir; fakat her aday için ayrı çıkarım gerektiğinden daha pahalıdır.
Bu nedenle:
bi-encoder = candidate generation
cross-encoder = precision refinement
deseni üretimde yaygındır.
Ünite 9: Sorgu Anlama ve Yönlendirme
Her doğal dil sorusu vektör araması değildir.
"Son 7 gündeki kayıt sayısı kaç?"deterministik bir toplulaştırma sorusudur.
"Son dönemde değişen iletişim örüntülerini açıkla."ise SQL, zaman serisi, grafik ve metinsel retrieval birleşimi gerektirebilir.
Bu nedenle query router kullanılabilir.
                 Kullanıcı
                    |
                    v
               Query Router
                    |
      +-------------+-------------+
      |             |             |
  SQL / Filter   Text RAG      Graph Query
      |             |             |
      +-------------+-------------+
                    |
                 Evidence
                    |
                    v
                   LLM
Router'ın kendisi LLM olabilir; fakat yüksek riskli sistemlerde kararın şema, whitelist ve izinli araçlarla sınırlandırılması gerekir.
9.1. Çalışma Zamanında LLM Olmadan Deterministik Yönlendirme
Query router'ın kendisinin bir LLM olması zorunlu değildir. Dar ve denetlenebilir bir problem alanında daha güvenli bir sıra şu biçimde kurulabilir:
exact / pattern
      ↓
kısa bağlam + alan dilbilgisi
      ↓
sınırlandırılmış retrieval
      ↓
bulanık eşleme
      ↓
execute / clarify / abstain
Her aday niyet, seçildikten sonra ayrıca çalıştırılabilirlik kontrolünden geçmelidir. Gerekli bağlamın mevcut olması, kullanıcının yetkili kapsamı, veri anlık görüntüsünün güncelliği ve üretilecek sorgunun izinli biçimde kalması bu kontrolün ayrı parçalarıdır. Böylece yüksek benzerlik skoru tek başına işlem başlatmak için yeterli sayılmaz.
Confidence katmanı üç farklı sonuç üretebilir: doğrudan yürütme, açıklama isteme veya yanıt vermekten kaçınma. Bu ayrım özellikle aynı yüzeyde SQL/filtre, metin retrieval ve grafik sorgularının birlikte bulunduğu sistemlerde önemlidir; yanlış route yalnız semantik hata değil, yanlış veri kapsamı anlamına da gelebilir.
Kaynak bağlı yanıtta provenance sonradan eklenen dekoratif bir citation değildir. Metin kanıtı, kaynak kimliğiyle birlikte sınırlı özgün pasaj üzerinden izlenebilmelidir. Normalize edilmiş token eşleme veya benzeri deterministik locator'lar, oluşturulmuş bir özetin kendi kendine kanıt haline gelmesini önler. Grafik çıktılarında da connected component, bridge, articulation point, reciprocity veya path gibi ölçüler yapısal gözlem olarak kalmalı; bunlardan otomatik nedensellik veya örgütsel anlam çıkarılmamalıdır.
Ünite 10: Büyük Veri ve RAG Entegrasyonu
Büyük veri sisteminde her satırı doğal dil cümlesine çevirip embedding üretmek çoğu zaman yanlış tasarımdır.
Örneğin milyarlarca olay kaydı:
event_id
actor_a
actor_b
timestamp
duration
channel
location_observation
şeklinde yapılandırılmışsa sayım, filtre, join ve zaman aralığı sorguları veri tabanı/analitik motor tarafından yapılmalıdır.
RAG katmanı bunun üzerine açıklama ve metinsel kanıt getirebilir.
                  Büyük Veri
                      |
       +--------------+--------------+
       |              |              |
   Yapısal veri    Metin/ASR       İlişkiler
       |              |              |
 SQL/analitik      Hybrid IR        Graph
       |              |              |
       +--------------+--------------+
                      |
                Evidence Builder
                      |
                      v
                     LLM
10.1. Gömme Vektörüne Dönüştürülecek İçeriğin Seçimi
Embedding için uygun adaylar:
- belge paragrafları,
- konuşma dökümü segmentleri,
- olay özetleri,
- açıklamalar,
- notlar,
- başlıklar,
- varlık açıklamaları.
Embedding'e doğrudan göndermek için zayıf adaylar:
- yalnız sayısal sayaçlar,
- normalize edilmiş kimlikler,
- kesin zaman aralığı sorguları,
- zaten SQL ile deterministik bulunabilen basit satırlar.
10.2. Türetilmiş Metin
Yapısal olayların insan tarafından okunabilir açıklaması oluşturulabilir; ancak bu metin kaynak kayıt değildir.
kaynak olay
   |
   v
deterministik özet
   |
   v
embedding
Retrieval sonucu tekrar kaynak event_id değerine bağlanmalıdır.
Ünite 11: Artımlı İndeksleme ve Değişiklik Yakalama
Büyük veri için her gece bütün indeksi baştan üretmek ölçeklenmez.
değişiklik
   |
   v
CDC / zaman damgası / kuyruk
   |
   v
değişen belgeyi yeniden çıkar
   |
   v
eski chunkları geçersiz kıl
   |
   v
yeni chunk + embedding
   |
   v
indeks sürümü
11.1. İdempotent İngest
Aynı olay iki kez gelirse iki ayrı belge oluşturmamalıdır.
document_key
source_version
content_hash
gibi alanlarla tekrar işleme denetlenebilir.
11.2. Silme
RAG veri yaşam döngüsünde silme zor bir konudur. Kaynak belge silinmişse yalnız veri tabanından değil:
- vektör indeksinden,
- sözcüksel indeksten,
- cache'den,
- özet katmanından,
- graph düğüm/kenarlarından
da kaldırılması gerekebilir.
11.3. Artımlı İndekslemede Silme ve Sürüm Geçerliliği
Artımlı indeksleme yalnız yeni belgeleri eklemekten ibaret değildir. Kaynak belgenin silinmesi, geri çekilmesi veya yeni sürümle değiştirilmesi durumunda eski parçaların arama sonuçlarında kalması yanlış kaynaklı yanıt üretebilir. Her indeks öğesi, belge kimliği, kaynak sürümü, parça sınırı ve erişim kapsamıyla ilişkilendirilmelidir. Kaynaktaki değişiklikler ekleme, güncelleme ve silme olayları olarak ayrı izlenir; yalnız son değiştirilme zamanı bütün değişiklikleri güvenilir biçimde yakalamayabilir.
Sürüm değiştirme için bir yaklaşım, yeni parçaların hazırlanmasının ardından okuyucuların etkin indeks sürümüne atomik geçişidir. Bu mümkün değilse önceki sürümdeki parçalar aramadan açıkça dışlanmalıdır. Güncelleme sırasında karışık sürümlü sonuç döndürme riskini azaltmak için belge düzeyinde aktif sürüm filtresi uygulanabilir. Eski parça kimliklerinin yeni kaynakla aynıymış gibi gösterilmesi, kaynak konumlarını ve iddia bağlantılarını bozabilir.
Yetki değişikliği, içerik değişmeden de erişilebilirliği değiştirebilir. Bu nedenle belge sürümüyle yetki sürümünün aynı olay olmadığı kabul edilir; sonuç adaylarının erişim denetimi sorgu bağlamında uygulanır. Başarı testi yeni belgenin bulunmasını olduğu kadar silinmiş veya yetkisi kaldırılmış belgenin artık bulunmamasını da sınamalıdır. Kaynak devri ve yeniden indeksleme sırasında ölçülen kapsam, gizli kalan stale kayıtların oranıyla birlikte değerlendirilir.
Ünite 12: Sıcak, Ilık ve Soğuk Veri
Her veri aynı sıklıkta sorgulanmaz.
HOT
son dönem
yüksek sorgu sıklığı
RAM / hızlı ANN

WARM
orta dönem
disk tabanlı indeks

COLD
uzun arşiv
daha yavaş ama ucuz saklama
Sorgu niyeti doğru veri katmanını seçebilir.
"Son hafta" sorusu yalnız sıcak indekse giderken "beş yıllık eğilim" soğuk arşivi de açabilir.
Bu ayrım özellikle yüz milyonlarca veya milyarlarca olayda bellek ve gecikme kontrolü sağlar.
Ünite 13: Metadata Retrieval'ın Birinci Sınıf Parçasıdır
Metadata yalnız sonuç ekranında gösterilecek süs değildir. Arama uzayını daha embedding çalışmadan küçültebilir.
language = tr
date >= 2026-09-01
content_type = transcript
access_scope IN user_scopes
source_type = communication
ardından dense retrieval yapılabilir.
Bu yaklaşım iki yarar sağlar:
- yanlış aday sayısını düşürür,
- yetkisiz içeriğin modele hiç ulaşmamasını sağlar.
Metadata ile semantik embedding aynı işi yapmaz.
metadata = kesin filtre
embedding = yaklaşık semantik yakınlık
Ünite 14: Kendi Verimizle Sohbet Sistemi
Kendi verisinden yanıt üreten sohbet sistemi, konuşma geçmişi ile bilgi tabanını ayırmalıdır.
Konuşma Belleği
  = bu oturumda ne konuşuldu?

Bilgi Belleği
  = kurumun / sitenin / arşivin gerçek verisi
Bütün geçmişi sürekli bilgi tabanına yazmak hem gizlilik hem retrieval kalitesi açısından sorun yaratabilir.
14.1. Önerilen Akış
Kullanıcı
   |
   v
Oturum Bağlamı
   |
   v
Sorgu Yeniden Yazımı
   |
   v
ACL
   |
   v
Retriever Router
   |
   +--> SQL
   +--> BM25
   +--> Dense
   +--> Graph
   |
   v
Reranker
   |
   v
Context Builder
   |
   v
Yerel LLM
   |
   v
Kaynaklı Yanıt
Modelin cevabı yanında kaynak kimlikleri tutulmalıdır.
14.2. Yanıt Yoksa
Güvenilir sistem, kanıt yokken cevap üretmeye zorlanmamalıdır.
retrieval sonucu yetersiz
        |
        v
"Yeterli kaynak bulunamadı."
Bu davranış, akıcı ama temelsiz bir cevaptan daha değerlidir.
Ünite 15: Kaynak Kökeni ve Kanıt Zinciri
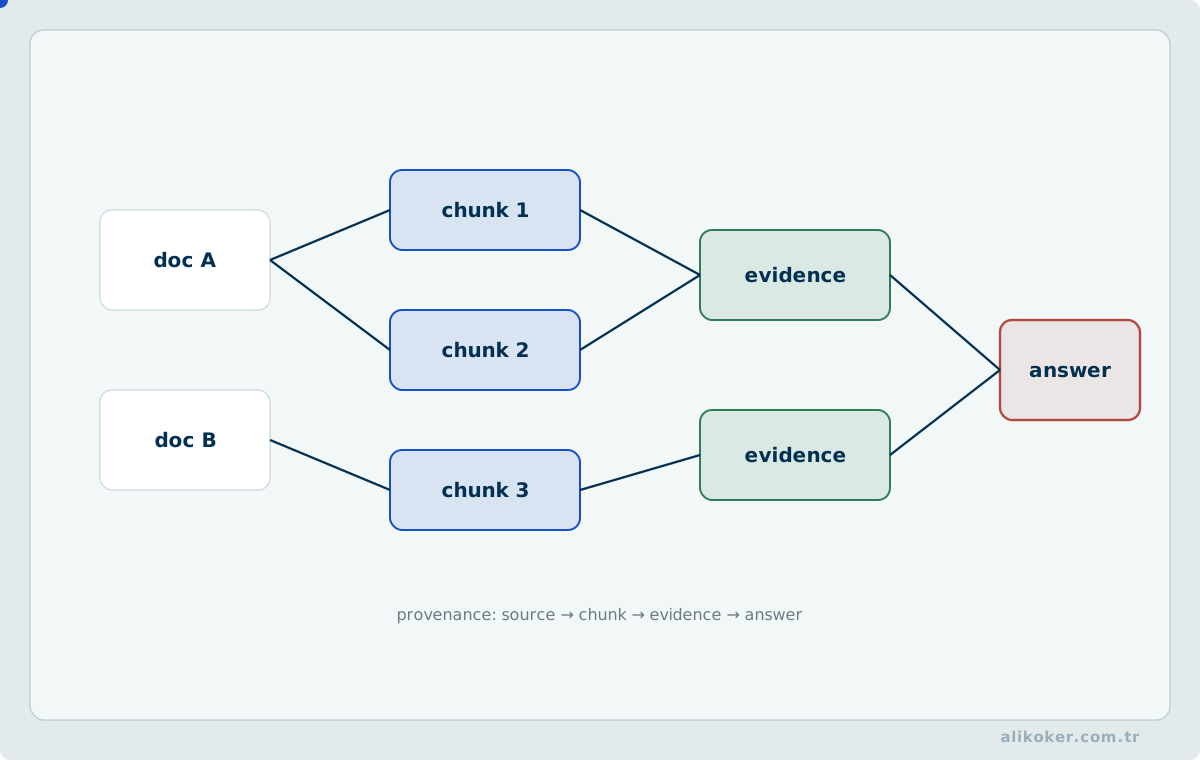
RAG'ın güçlü taraflarından biri kaynak gösterebilmesidir; fakat kaynak eklemek otomatik doğruluk sağlamaz.
Her chunk şu bilgilerle kaynağa dönmelidir:
chunk_id
document_id
source_id
section
offset / page / event_id
version
hash
access_scope
Yanıtta kullanılan iddia ile kaynak arasında gerçek destek olup olmadığı ayrıca değerlendirilmelidir.
15.1. Kanıt Paketi
Soru
 |
 v
Retrieval Adayları
 |
 v
Reranked Evidence
 |
 +--> kaynak 1
 +--> kaynak 2
 +--> kaynak 3
 |
 v
LLM Yanıtı
 |
 v
İddia-Kaynak Doğrulama
Özellikle adli veya denetlenebilir alanlarda özetin kanıtın yerine geçmesine izin verilmemelidir.
Kaynaklandırılmış yanıtın doğrulanmasında görüntülenen bağlantı tek başına yeterli değildir. Yanıtın dayandığı parçanın kimliği, belgenin değişmez sürümü, parça içindeki karakter veya zaman aralığı ve erişim kapsamı birlikte doğrulanmalıdır. Bir belge yeniden indekslendiğinde aynı başlık altında farklı içerik bulunabilir; eski parçaya ait atıf güncel belgeye sessizce bağlanmamalıdır. Metin parçası veya kaynak sürümü doğrulanamıyorsa ilgili iddia kanıtsız kabul edilerek yanıt dışında bırakılabilir. Özellikle konuşma dökümlerinde zaman aralığı, konuşmacı ataması ve metin düzeltme sürümü birbirinden ayrı tutulmalıdır.
Ünite 16: Graf Tabanlı RAG
Klasik RAG çoğunlukla belge parçaları üzerinden çalışır. İlişki ağırlıklı sorularda bilgi farklı kayıtlara dağılmış olabilir.
A -> B
B -> D
D -> C
Soru A ile C arasındaki bağlantıyı soruyorsa hiçbir tek belge bütün yolu içermeyebilir.
Graph RAG bilgiye düğüm, kenar ve topluluk yapısı üzerinden erişir.
16.1. Bilgi Grafiği ve Olay Grafiği
İki yaklaşım ayrılmalıdır.
Bilgi grafiği:
KISI ---- CALISIR ----> KURUM
KURUM --- BULUNUR ----> SEHIR
Olay grafiği:
VARLIK_A
   |
   v
[OLAY_123]
   ^
   |
VARLIK_B
Yüksek etkili iletişim analizinde olay grafiği daha güvenli bir temel olabilir. Çünkü "arkadaş", "örgüt üyesi", "iş ortağı" gibi semantik ilişki etiketleri doğrudan gözlenmiş gerçek olmayabilir.
16.2. Kanıt ile Yorumun Ayrılması
Gözlenen:
A ve B arasında 14 iletişim olayı.

Hesaplanan:
Son 30 günde frekans önceki döneme göre arttı.

Yorum:
İlişkinin niteliği bu veriden tek başına belirlenemez.
RAG sistemi bu üç katmanı karıştırmamalıdır.
Ünite 17: Local, Global ve DRIFT Benzeri Graf Arama
Graf tabanlı retrieval tek yöntem değildir.
17.1. Yerel Arama
Belirli bir varlık için:
Varlık X
  |
  +--> komşular
  +--> ilişkiler
  +--> ilgili metin parçaları
  +--> ilgili topluluk özeti
sorgulanabilir.
17.2. Küresel Arama
"Bu veri kümesindeki baskın temalar nelerdir?" gibi sorular klasik top-k vektör retrieval için zordur. Sorguda hangi belirli parçaların seçileceğine dair açık ipucu yoktur.
Graf toplulukları ve önceden üretilmiş topluluk özetleri bütün veri kümesi düzeyinde sorgulamayı mümkün kılabilir.
17.3. DRIFT Benzeri Arama
genel topluluk bilgisi
        |
        v
başlangıç hipotezi
        |
        v
yerel alt sorular
        |
        v
komşu / belge retrieval
        |
        v
yeni alt sorular
Bu yöntem geniş bağlam ile yerel kanıtı birleştirir.
Ancak böyle çok adımlı arama pahalıdır. Her sorguda varsayılan olarak kullanılmamalıdır.
Ünite 18: İletişim ve İnsan İlişkileri İçin Genelleştirilmiş RAG
Yüksek hacimli iletişim olayları, konuşma dökümleri, notlar ve ilişki ağlarının aynı sistemde bulunduğu anonim bir senaryo düşünelim.
Veri katmanları:
İletişim Olayları
Konuşma Dökümleri
Not / Belge
Cihaz Gözlemleri
Konum Gözlemleri
Varlıklar
Tek bir vektör veritabanı bütün bu verinin doğal modeli değildir.
18.1. Önerilen Mimari
                      Sorgu
                        |
                        v
                    Router
        +---------------+---------------+
        |               |               |
   Deterministik      Metinsel          Graf
      Sorgu             RAG             Arama
        |               |               |
   SQL / zaman      BM25 + Dense     Altgraf
   / filtre             |               |
        +---------------+---------------+
                        |
                     Fusion
                        |
                    Reranker
                        |
                 Evidence Builder
                        |
                  Yerel LLM
                        |
                 Kaynaklı Sonuç
Bu mimaride dil modeli veri tabanının yerine geçmez.
18.2. Soru Sınıfları
"Belirli zaman aralığında kaç olay var?" -> SQL.
"Bu konuşmalarda hangi teknik konu tekrar ediyor?" -> metinsel RAG.
"İki varlık hangi ara düğümler üzerinden bağlanıyor?" -> graph query.
"Son dönemde ilişki yapısında hangi değişimler var ve metinsel bağlam ne?" -> zaman analizi + graph + RAG.
18.3. HTS/CDR Benzeri Olay Verisi
HTS Analizi notundaki temel sınır burada da korunmalıdır: trafik kaydı yorum değildir.
RAG sistemi:
olay kaydı
 -> kanıt

toplulaştırma
 -> hesaplanan özellik

LLM açıklaması
 -> yorumlayıcı sunum
katmanlarını ayrı tutmalıdır.
Bir baz/hücre gözlemi doğrudan kesin fiziksel konum olarak, iletişim sıklığı da doğrudan ilişkinin niteliği olarak sunulmamalıdır.
Ünite 19: Zaman Duyarlı RAG
Olay verisinde zaman sıradan metadata değildir.
kim?
ne zaman?
ne kadar sık?
hangi yönde?
hangi dönem değişti?
soruları birlikte gelir.
Sorgu önce zamansal niyeti çözmelidir.
"son temas"
"ilk temas"
"en yoğun dönem"
"geçen aya göre artış"
"belirli tarih aralığı"
aynı filtre değildir.
19.1. Zaman Ağırlıklı Retrieval
Bazı kullanımda yeni kanıt daha önemli olabilir. Fakat "ilk kayıt" arandığında tam tersi geçerlidir. Bu nedenle tek bir evrensel recency boost doğru değildir.
ranking =
semantic_relevance
+ lexical_relevance
+ task_specific_time_score
Zaman puanı sorgu niyetinden türetilmelidir.
Ünite 20: Graph RAG'da İnsan İlişkilerinin Sınırı
İnsan ilişkisi grafiğinde sistemin bildiği ile çıkarsadığı ayrılmalıdır.
Kenar türleri:
OBSERVED
hesaplamadan önce kaynak olay var

DERIVED
çok sayıda olaydan ölçü türetildi

INFERRED
model veya kural hipotez üretti
UI ve RAG bağlamı bu sınıfları taşımalıdır.
Örneğin:
A --[42 iletişim olayı]--> Bgözlenmiş olaylardan türetilebilir.
A --[yakın arkadaş]--> Bise çoğu veri kümesinde doğrudan kanıtlanamaz.
Bu ayrım hem bilimsel hem adli yöntem açısından zorunludur.
Ünite 21: Hiyerarşik Retrieval
Çok büyük arşivlerde bütün ham veriyi aynı indeks seviyesinde aramak zorlaşır.
Kurum Arşivi
   |
   +--> Yıl
         |
         +--> Ay
               |
               +--> Topluluk / konu
                     |
                     +--> Olay grubu
                           |
                           +--> ham belge / transkript
Üst seviyede özetler aday alanı seçmek için kullanılabilir.
Ancak:
özet = yönlendirme
ham kaynak = kanıt
ilkesi korunmalıdır.
Özetler zaman içinde yeniden üretilebilir; kaynak olayın kendisi değildir.
21.1. Hiyerarşik Erişimde Temsil ve Kapsama Bütçesi
Hiyerarşik erişimde belgeyi parçalara ayırmak yalnız bağlam penceresine sığdırma işlemi değildir; seçimin hangi birimde yapılacağını belirleyen bir modelleme kararıdır. Önce koleksiyon düzeyindeki yetki ve zaman kısıtları uygulanır, ardından belge ve bölüm adayları belirlenir. Bölüm içindeki geçit veya cümle adayları ise daha küçük bir hesaplama bütçesinde sıralanır. Böylece uzun bir belgenin ilk sayfaları, daha sonraki bölümleri yalnızca sıralama sırasında daha önce görüldükleri için dışarıda bırakmaz.
Kapsama seçimi önem puanından ayrı düşünülmelidir. Örneğin bir metinde beş benzer cümleyi seçmek, beş ayrı olguyu kapsamakla eşdeğer değildir. Açgözlü seçimde her adayın katkısı, henüz temsil edilmemiş konu, zaman dilimi veya belge parçası üzerinden hesaplanabilir. Tekrarlayan ifadeler için benzerlik cezası uygulanırken yeni bir istisna, farklı konuşmacı veya karşıt olgu içeren cümleler otomatik olarak gereksiz sayılmaz.
Ölçümde yalnız ilk sonuç isabeti yeterli değildir. Bölüm kapsaması, ilgili kanıtın erişilebilirliği, kaynak dağılımı, tekrarlılık ve kesme nedeniyle dışarıda bırakılan kısım birlikte raporlanmalıdır. Hesaplama bütçesi dolduğunda algoritma daha fazla kaynak görmüş gibi davranmaz; incelenen alt kümenin sınırları çıktının parçası olur.
Ünite 22: Query Decomposition
Karmaşık soru tek retrieval isteğine indirgenmemelidir.
Örnek:
Son üç ayda iletişim yoğunluğu artan ve aynı zamanda konuşma içeriğinde yeni bir teknik konu görülen ilişki çiftlerini açıkla.
Bu soru:
1. zaman aralığını çöz
2. iletişim yoğunluğu değişimini hesapla
3. aday çiftleri seç
4. ilgili transkriptleri getir
5. yeni konu kanıtını ara
6. kaynakları birleştir
7. sonucu açıkla
adımlarına ayrılabilir.
Her alt soru farklı retriever kullanabilir.
Bu, agentic RAG'ın kontrollü biçimidir.
Ünite 23: Ajan Destekli RAG
Ajanlı sistem retrieval yöntemini dinamik seçebilir, sorguyu yeniden yazabilir veya yeterli kanıt yoksa başka arama yapabilir.
Soru
 |
 v
Plan
 |
 v
Retrieve
 |
 v
Kanıt yeterli mi?
 |            |
 hayır        evet
 |            |
 v            v
yeniden      yanıt
sorgula
Risk, açık uçlu döngüdür.
Üretimde:
- azami adım,
- azami token,
- süre sınırı,
- izinli araç listesi,
- sorgu maliyet bütçesi
olmalıdır.
Ajan karar verirken yetki kapsamını genişletememelidir.
Ünite 24: Kapalı Ağ ve Yerel RAG
Hassas veri dış servise gönderilemiyorsa RAG tümüyle yerel çalışabilir.
Yerel Kaynaklar
   |
   v
Yerel Embedding
   |
   v
Yerel İndeks
   |
   v
Yerel Reranker
   |
   v
Yerel LLM
Çevrimdışı embedding, veri gizliliği ve sürüm kontrolü için değerlidir. Ekli uygulama kaynağı da internet bağlantısına veya bulut API'sine ihtiyaç duymayan yerel embedding kullanımını ayrı bir yöntem olarak ele almaktadır.
24.1. Yerel Dağıtımda Dikkat
- model lisansı,
- model dosyasının hash'i,
- embedding sürümü,
- tokenizer sürümü,
- indeks uyumluluğu,
- CPU/GPU kapasitesi,
- güncelleme paketi,
- geri dönüş
birlikte yönetilmelidir.
Embedding modeli değiştiğinde eski indeks genellikle yeniden oluşturulmalıdır; iki farklı embedding uzayındaki vektörleri tek indeks içinde doğrudan karşılaştırmak doğru değildir.
Ünite 25: Performans ve Kapasite Mühendisliği
RAG gecikmesi yalnız LLM süresi değildir.
T_total =
query_parse
+ auth
+ filter
+ sparse_search
+ vector_search
+ rerank
+ context_build
+ LLM_prefill
+ LLM_decode
Toplam p95/p99 ölçülmelidir.
25.1. Retrieval Bütçesi
Top-k artırmak recall'u yükseltebilir; fakat:
- reranker maliyetini,
- bağlam token sayısını,
- prefill süresini,
- dikkat yükünü
artırır.
Daha fazla belge her zaman daha iyi yanıt değildir.
25.2. Asenkron İngest
Büyük arşiv indekslenirken:
reader -> parse queue -> chunk workers -> embedding batches -> index writerşeklinde boru hattı kurulabilir.
Backpressure olmadan üreticiler tüketicilerden hızlı çalışırsa bellek büyür.
25.3. Arama için Partition
Veri doğal olarak:
- tarih,
- dil,
- kaynak,
- yetki alanı,
- veri türü
ile bölünebiliyorsa bütün indeks yerine ilgili partition aranabilir.
Ünite 26: Önbellek
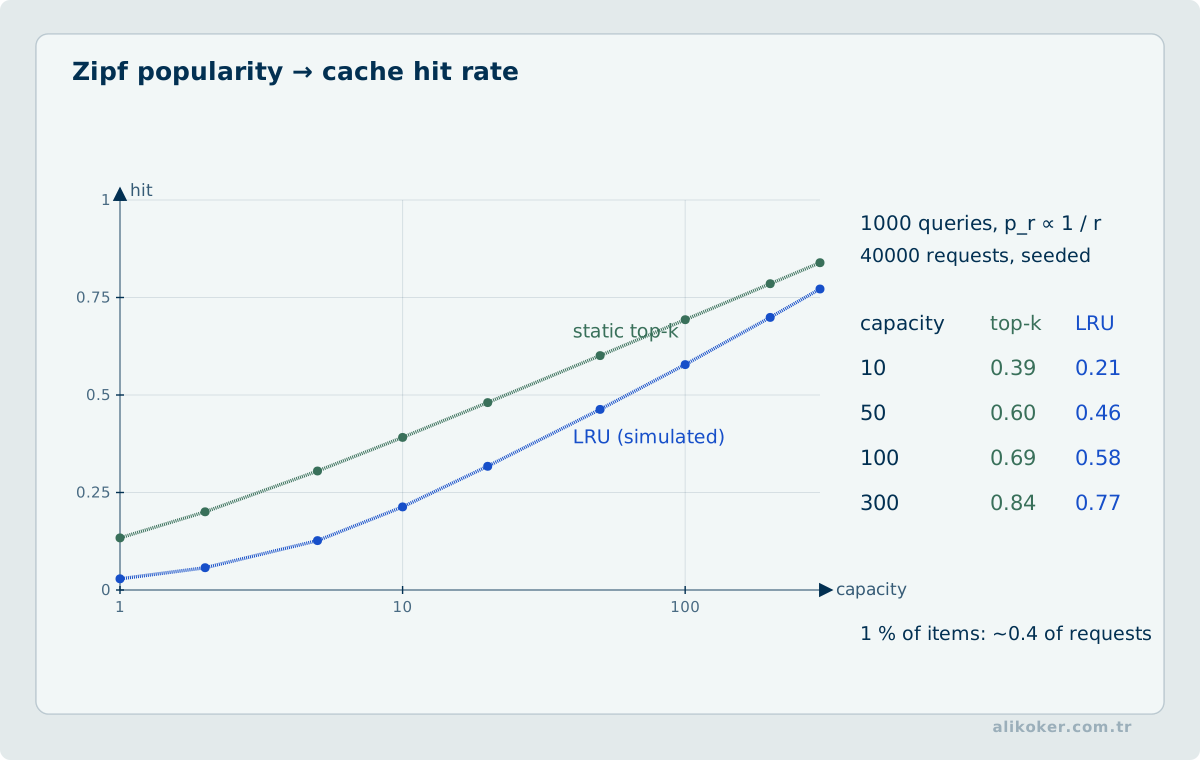
RAG'ta birden fazla cache katmanı vardır.
query normalization cache
embedding cache
retrieval cache
reranker cache
final response cache
En güvenlisi genellikle deterministik aşamalardır.
Final response cache kullanılırken:
- kullanıcı yetkisi,
- indeks sürümü,
- model sürümü,
- prompt sürümü
cache anahtarına dâhil edilmelidir.
Aksi durumda eski veya başka yetki bağlamına ait cevap sızabilir.
Ünite 27: Güvenlik
RAG sistemi dış metni modele taşıdığı için yeni saldırı yüzeyi oluşturur.
27.1. Prompt İnjection
Belge içinde:
"önceki talimatları yok say"gibi bir metin bulunması, belgenin sistem talimatı olduğu anlamına gelmez.
Retriever'dan gelen içerik:
UNTRUSTED DATAolarak işaretlenmeli; sistem talimatından ayrı sınırda tutulmalıdır.
27.2. Vektör ve Embedding Riskleri
Riskler:
- yetkisiz retrieval,
- tenantlar arası bilgi sızıntısı,
- embedding inversion,
- zehirlenmiş doküman,
- eski ve yeni bilginin çelişmesi,
- hassas metadata.
Embedding hassas veriyi sihirli biçimde anonim yapmaz.
27.3. ACL Retrieval'dan Önce Uygulanır
Yanlış:
tüm veri
 -> retrieval
 -> LLM context
 -> sonra yetki kontrolü
Doğru:
kullanıcı kimliği
   |
   v
izinli veri kapsamı
   |
   v
retrieval
   |
   v
LLM
Yetkisiz veri bağlam penceresine hiç girmemelidir.
27.4. Poisoning
Bilgi tabanına eklenen kötü niyetli belge retrieval'da üst sıralara çıkacak biçimde hazırlanabilir.
Bu nedenle ingest aşamasında:
- kaynak güveni,
- dijital imza/hash,
- editoryal onay,
- belge sınıfı,
- oluşturma/değiştirme kaydı
tutulmalıdır.
Ünite 28: RAG Değerlendirmesi
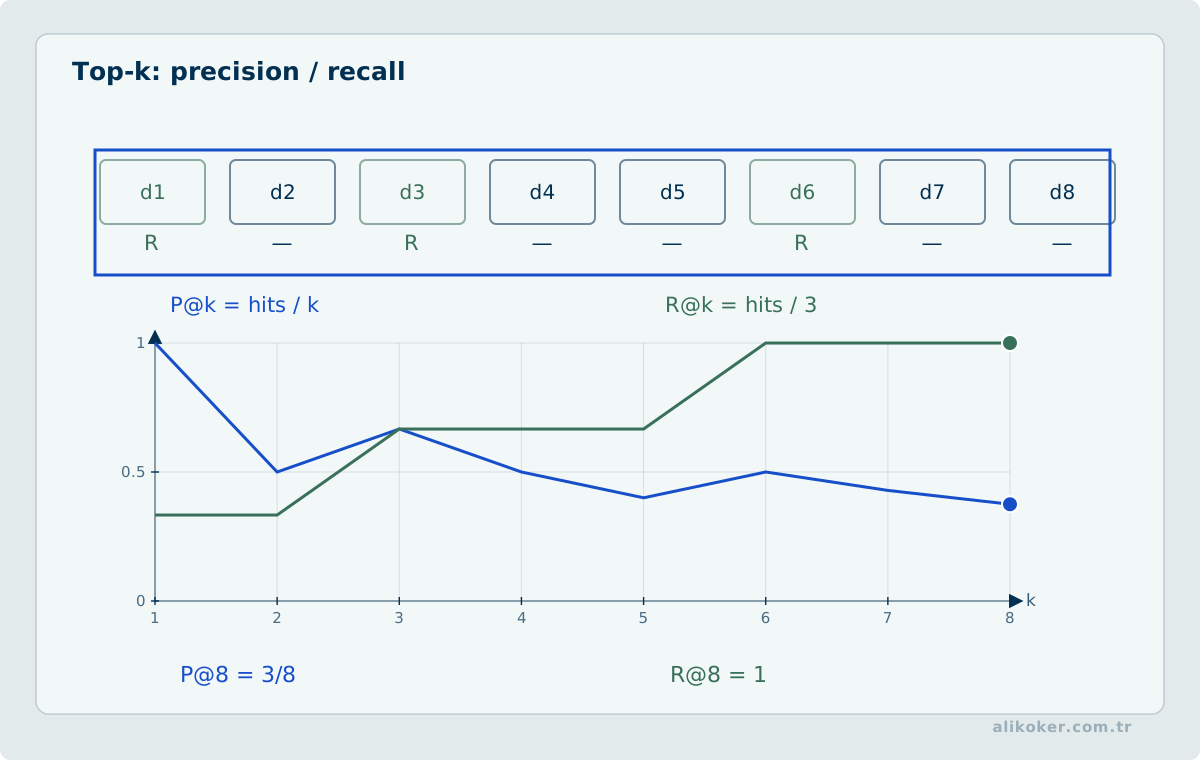
RAG tek model değildir. En az üç ayrı katman ölçülmelidir.
28.1. Retrieval
- Recall@K
- Precision@K
- MRR
- nDCG
- hit rate
- source diversity
28.2. Generation
- yanıt ilgisi,
- doğruluk,
- faithfulness,
- kaynak desteği,
- desteklenmeyen iddia oranı,
- alıntı doğruluğu.
28.3. Sistem
- p50/p95/p99,
- throughput,
- index freshness,
- zero-result rate,
- ACL ihlali,
- cache hit oranı,
- kaynak başına maliyet.
RAG quality
   |
   +--> retrieval quality
   +--> generation quality
   +--> system quality
Tek bir "RAG score" hatanın nerede olduğunu gizleyebilir.
28.4. Altın Veri Kümesi
Gerçek sorulardan küçük ama güvenilir bir test seti hazırlanmalıdır.
Her soru için:
expected_sources
acceptable_answer
forbidden_claims
required_filters
gibi alanlar tutulabilir.
Test kümesinde yalnız yanıtlanabilir sorular bulunması, sistemin yanıt vermekten kaçınma davranışını ölçmez. Kaynakta yanıtı bulunmayan sorular, eski sürüme dayanan sorular ve yetki filtresi nedeniyle kaynağı erişilemeyen sorular ayrı sınıflarda tutulur. Bir iddia için kaynak bağlantısının bulunması ile kaynağın iddiayı desteklemesi ayrı denetlenir. Aynı deterministik yanıtın tekrarlanması doğruluk kanıtı değildir; beklenen kaynak ve yasak çıkarım kontrolleri bağımsız uygulanır.
28.5. Eksik Kayıt Kümesinde Kanıtlı Yanıt Sınırı
Bilgi erişimi destekli üretimde yanıtın kaynaklı olması, erişilen kaynak kümesinin tam olduğunu kanıtlamaz. Arama üst sınırı, yetki filtresi, indeks güncelliği veya zaman aralığı kısıtı nedeniyle önemli kayıtlar seçilmemiş olabilir. Bu nedenle hiç kayıt yok'' türündeki evrensel bir iddia ile sorgulanan yetkili ve indeksli kümede eşleşme bulunmadı'' ifadesi farklı doğruluk düzeyleridir. Retrieval katmanı kullanılan filtreleri, erişim kapsamını ve kesme/limit nedenini çıktı sözleşmesine dahil etmelidir.
RAG değerlendirmesinde doğru atıf sayısı tek başına yeterli değildir. Kaynak getirme katmanı için erişim duyarlılığı (örneğin Recall@K), sıralama kalitesi ve filtre kaynaklı kaçırmalar; üretim katmanı için kanıta bağlılık, kapsam dışı genelleme ve cevapsız kalması gereken soruları doğru reddetme ayrı ölçülmelidir. Doğruluğu değerlendirilen koleksiyondaki ilgili belgeler işaretlenmemişse Recall@K sonucunun ``gerçek'' değer değil, etiketleme kapsamına bağlı tahmin olduğu açıklanmalıdır.
Kanıt tabanlı arayüzde her sonuçla kaynak kimliği, sürüm ve gerekiyorsa ilgili zaman aralığı taşınmalıdır. Soru tek bir dosyaya veya yetkili kayıt kümesine sınırlandırılmışsa yanıt başka verilerden ``tamamlama'' yapmamalıdır. Sonuç bulunamadığında belirsizliği açık söylemek, eğitim örneklerinden ikna edici görünen fakat kanıtsız açıklama üretmekten daha güvenilir bir sistem davranışıdır.
Ünite 29: Halüsinasyonu Azaltmak, Yok Etmemek
RAG yanlış bilgi üretimini azaltabilir; sıfırlamaz.
Hata kaynakları:
yanlış retrieval
doğru retrieval + yanlış yorum
yetersiz retrieval
çelişkili kaynak
modelin parametrik önbilgisi
prompt injection
eski indeks
Bu nedenle "RAG varsa model halüsinasyon yapmaz" ifadesi yanlıştır.
Güvenilir sistem:
kanıt yoksa -> cevap yok
kanıt çelişkiliyse -> çelişkiyi göster
kanıt kısıtlıysa -> kapsamı belirt
davranışını desteklemelidir.
Ünite 30: Sürümleme ve Yeniden Üretilebilirlik
Bir RAG sürümü yalnız LLM model adı değildir.
RAG_RELEASE =
    parser_version
  + chunker_version
  + embedding_version
  + lexical_index_version
  + vector_index_version
  + graph_version
  + reranker_version
  + prompt_version
  + llm_version
  + acl_policy_version
Bir kalite değişikliği olduğunda hangi bileşenin değiştiği bilinebilmelidir.
İndeks yeniden üretimi deterministik değilse karşılaştırmalı değerlendirme zorlaşır.
Ünite 31: Üretime Geçiş Planı
RAG sistemi bir anda bütün sisteme eklenmemelidir.
31.1. Aşama 1: Salt Arama
Sorgu -> Hybrid Search -> Kaynak listesiLLM yoktur. Retrieval kalitesi ölçülür.
31.2. Aşama 2: Kaynaklı Özet
Sorgu -> Retrieval -> Reranker -> LLM -> kaynaklı özetAraç çağrısı yoktur.
31.3. Aşama 3: Sınırlı Sohbet
Konuşma geçmişi ve takip soruları eklenir.
31.4. Aşama 4: Yapısal Araçlar
Read-only SQL ve graph query gibi araçlar kontrollü biçimde eklenir.
31.5. Aşama 5: Ajan
Yalnız gerekliyse dinamik planlama eklenir.
Bu ilerleme, retrieval hatalarını ajan karmaşıklığı altında gizlememeyi sağlar.
Ünite 32: Genel Amaçlı Üretim Mimarisi
Anonimleştirilmiş yüksek hacimli, kapalı ağ, çok kaynaklı bir sistem için önerdiğim temel mimari şöyledir:
                         Kullanıcı
                            |
                     Kimlik / Oturum
                            |
                         Yetki
                            |
                       Query Router
                            |
        +-------------------+--------------------+
        |                   |                    |
   SQL / Analitik       Hybrid Text          Graph
        |             BM25 + Dense            Query
        |                   |                    |
        |               Fusion               Subgraph
        |                   |                    |
        +-------------------+--------------------+
                            |
                         Reranker
                            |
                    Evidence Builder
                            |
                     Kaynak / Kapsam
                            |
                        Yerel LLM
                            |
                    Output Validator
                            |
                       Kaynaklı Yanıt
Bu yapı üç temel ilkeye dayanır:
- deterministik soru deterministik motorla çözülür,
- semantik soru retrieval ile çözülür,
- ilişki sorusu grafik yapıyla çözülür.
LLM son katmanda açıklama, birleştirme ve doğal dil arayüzü sağlar.
Ünite 33: Uygulama Örneği — Eski İçerik Sisteminden RAG'a
Bir site yıllardır teknik içerik yayımlıyor olsun.
33.1. Kaynak Modeli
CONTENT
id
language
slug
title
summary
body
published_at
modified_at
RAG indeksi için kaynak şema değiştirilmek zorunda değildir.
Ayrı indeks belgesi:
rag_document
document_id = content.id
language
title
section_path
chunk_text
modified_at
content_hash
source_url
33.2. Güncelleme
modified_at değişti
   |
   v
yalnız o içerik yeniden parçalanır
   |
   v
eski chunklar silinir
   |
   v
yeni embedding + BM25 index
Bu sayede yüzlerce veya binlerce eski içerik bir defada "akıllı" hâle gelir; asıl site çalışma biçimini korur.
Ünite 34: Uygulama Örneği — Yapısal Olay + Metin + Graf
İkinci örnek, çok büyük olay tablosuyla konuşma dökümlerinin birlikte bulunduğu bir sistemdir.
EVENT
  |
  +--> zaman
  +--> iki uç / taraf
  +--> süre
  +--> kanal
  +--> kaynak kimliği

TRANSCRIPT
  |
  +--> event_id
  +--> segment
  +--> text

GRAPH
  |
  +--> node
  +--> edge/event reference
Sorgu:
Son 60 günde yoğunluğu artan ilişkilerde hangi konuşma konuları öne çıkıyor?
İşlem:
SQL
 -> yoğunluk değişimini hesapla
 -> aday çiftler

Graph
 -> adayların altgrafını getir

Hybrid RAG
 -> ilgili transcript parçalarını bul

Reranker
 -> kanıtı sırala

LLM
 -> yalnız getirilen kanıtı özetle
Bu mimari ham olayların tamamını embedding'e çevirmekten daha denetlenebilir ve daha verimlidir.
Ünite 35: Türkçe RAG Tasarım İlkeleri
Türkçe için ayrı değerlendirme gereklidir.
35.1. Normalizasyon
I/İ/ı/i, Unicode, özel ad ekleri ve ASCII Türkçe farklı retrieval davranışı oluşturabilir.
Lexical index için alternatif normalize alanlar tutulabilir:
original
lower_tr
ascii_aux
stem/morph_aux
Kanonik içerik değiştirilmez.
35.2. Morfoloji
Sorgu ile belgede aynı kökün farklı ekli biçimleri bulunabilir. BM25 tarafında morfolojik normalizasyon veya uygun analyzer yararlı olabilir. Dense retrieval bunu kısmen semantik olarak aşabilir; fakat her model Türkçe morfolojiyi eşit iyi temsil etmez.
35.3. Çok Dilli Veri
Türkçe sorgu İngilizce teknik dokümanı bulmak zorundaysa çok dilli embedding gerekir.
TR query
   |
multilingual embedding
   |
EN technical document
Ancak dil filtresi gerektiğinde metadata ile sınırlandırılmalıdır.
Ünite 36: Graph RAG Kullanımının Sınırları
Graph RAG etkileyici olduğu için her veri kümesine uygulanmamalıdır.
Kullanmayın veya erteleyin:
- sorular çoğunlukla tek belge içindeyse,
- varlık/ilişki çıkarmanın doğruluğu düşükse,
- indeksleme maliyeti kabul edilemiyorsa,
- veri çok sık değişiyor ve graph yeniden üretimi pahalıysa,
- kullanıcıların çoğu yalnız tam metin arıyorsa.
Önce baseline RAG ölçülmelidir.
baseline
  -> hybrid search
  -> reranker
  -> citations

yetmiyorsa
  -> hierarchical / graph retrieval
Bu yaklaşım gereksiz mimari karmaşıklığı önler.
Ünite 37: RAG ile İnce Ayarın Birlikte Kullanımı
RAG ve fine-tuning birlikte olabilir.
Fine-tuning:
- çıktı biçimi,
- alan üslubu,
- görev davranışı,
- sınıflandırma yeteneği
için kullanılabilir.
RAG:
- güncel bilgi,
- erişim kontrollü belge,
- kaynak gösterme,
- değişken bilgi
için kullanılabilir.
Fine-tuned model
      +
RAG evidence
      =
alan davranışı + güncel bilgi
Ancak gizli veriyi modele ezberletmek ile erişim kontrollü retrieval arasında güvenlik farkı vardır.
Ünite 38: Bilgi ve Eylem Sınırı
RAG yanıt vermek için kanıt getirir. Eylem yapmak ayrı yetki gerektirir.
Soru
 |
 v
RAG
 |
 v
Öneri
 |
 v
Politika / İnsan / Deterministik Kural
 |
 v
Eylem
Özellikle yüksek etkili sistemlerde LLM'nin doğal dil cevabı doğrudan işlem komutu olmamalıdır.
Ünite 39: Veri Türüne Göre Retriever Tasarımı
Tek retriever bütün veri türlerinde en iyi sonucu vermez. Üretim RAG sisteminde veri kaynağının semantiği retrieval yöntemini belirlemelidir.
39.1. Teknik Doküman
Teknik dokümanda başlık, bölüm yolu, sürüm ve ürün adı önemlidir.
query
 |
 +--> exact term / BM25
 |
 +--> dense semantic search
 |
 +--> section metadata filter
 |
 v
reranker
Bir API adı, hata kodu veya sınıf adı dense embedding içinde anlamsal olarak zayıf temsil edilebilir; sözcüksel indeks bu değerleri korur.
39.2. Konuşma Dökümü
Konuşma dökümlerinde doğal parça yalnız sabit token sayısı değildir.
Metadata:
record_id
speaker_role
start_time
end_time
language
segment_order
olabilir.
Aynı konuşmanın birbirinden çok uzak segmentlerini top-k sonucu olarak getirip tek bağlamda birleştirmek yanlış anlam oluşturabilir. Retrieval sonrasında komşu segment genişletmesi yapılabilir:
hit segment
   |
   +--> previous segment
   +--> current segment
   +--> next segment
Bu, semantik aramanın bulduğu dar bölgeyi konuşma bağlamıyla genişletir.
39.3. Olay Kaydı
Olay kaydı için önce metadata/SQL filtresi uygulanmalıdır. Serbest açıklama veya transkript varsa dense retrieval ikinci aşama olabilir.
39.4. Kaynak Kod
Kod aramasında sembol adı, dosya yolu, dil ve çağrı ilişkileri önemlidir. Embedding tek başına yeterli değildir.
symbol search
 + lexical search
 + code embedding
 + call graph
aynı sistemde kullanılabilir.
39.5. Graf
Graf retrieval için komşuluk, yol, topluluk ve zaman penceresi kullanılır. Metin embedding'i graf sorgusunun alternatifi değil, düğüm/kenar açıklamalarını bulmaya yardımcı bir katmandır.
39.6. Çok Kipli Kaynaklarda Birleştirme
Görüntü, ses ve metin aynı olayla ilişkili olsa da aynı kanıt türü değildir. Görüntüden çıkarılan açıklama veya sesin yazıya çevrilmiş biçimi türetilmiş bir gösterimdir; kaynak piksel ya da ses verisinin eşdeğeri kabul edilmez. Retriever, kip başına uygun temsil ve arama yöntemi kullanabilir; sonuçlar kanonik kayıt kimliği, zaman aralığı, sayfa veya kare konumu üzerinden birleştirilir.
Ortak gömme uzayı kullanılacaksa farklı kiplerden gelen skorların karşılaştırılabilirliği sınanmalıdır. Ayrı arama kanallarında ise skor normalizasyonu veya sıralama birleştirme, doğrulanmış aday kümesi üzerinde yapılır. Bir transkriptin zaman damgası ile görüntü karesinin zamanı örtüşmüyorsa yalnız anlamsal benzerliğe dayanarak eşzamanlılık iddia edilemez. Kaynak yetki alanı, arama ve bağlam oluşturma aşamalarının ikisinde de korunur.
Ünite 40: Context Builder bir Toplama İşlemi Değildir
Top-k sonuçları ham biçimde birleştirmek iyi context engineering değildir.
Context Builder şu soruları çözmelidir:
- aynı kaynağın tekrar eden parçaları var mı,
- çelişen kaynaklar var mı,
- kanıtın zamanı nedir,
- kaynak yetki kapsamı nedir,
- birbirine komşu chunklar birleştirilmeli mi,
- hangi kanıt daha yüksek güven taşıyor,
- toplam token bütçesi nedir?
40.1. Duplicate Collapse
Aynı paragrafın farklı sürümleri veya overlap nedeniyle benzer chunklar gelebilir.
candidate set
  |
  v
near-duplicate collapse
  |
  v
source diversity
  |
  v
token budget packing
40.2. Kaynak Çeşitliliği
Top 10 sonucun tamamı aynı belgeden geliyorsa model tek kaynağa aşırı bağımlı kalabilir. Soruya göre belge başına kota uygulanabilir.
Buna karşılık gerçekten tek bir teknik standardın sorulduğu durumda çeşitlilik uğruna ilgisiz kaynak eklemek de yanlıştır.
40.3. Çelişki
İki kaynak farklı değer veriyorsa sistem birini sessizce seçmemelidir.
Source A -> değer X
Source B -> değer Y
        |
        v
"Kaynaklar çelişiyor."
Belge sürümü ve tarih bilgisi çelişkinin çözümüne yardımcı olabilir.
40.4. Citation Mapping
Yanıt bittikten sonra rastgele kaynak eklemek yerine iddia üretimi sırasında kanıt kimlikleri taşınmalıdır.
Evidence E17
Evidence E42
    |
    v
Answer Claim C3
    |
    +--> supports: E17
    +--> supports: E42
Bu model, kaynak doğrulamasını sonradan yapılabilir hâle getirir.
40.5. Kanıt Bütçesi ve Bağlam Sıkıştırma
Bağlam sınırı B belirteç, seçilecek kanıt parçalarının uzunlukları l_i ve yararları u_i ile ifade edilirse basit seçim problemi max Σ_i u_i x_i, Σ_i l_i x_i ≤ B, x_i ∈ {0,1} biçimindedir. Ancak parça yararları bağımsız değildir: iki parça aynı iddiayı tekrar edebilir; başka iki parça birbiriyle çelişebilir veya ancak birlikte anlamlı olabilir. Bu yüzden yalnız en yüksek tekil skorları seçmek yeterli değildir.
Sıkıştırmada kanıtın koşulları, olumsuzlukları, sayısal değerleri, tarihleri ve kaynak kimlikleri korunmalıdır. Çelişen ifadelerin birini atmak, kanıtı kısaltmak değil değiştirmektir. Özet üretilecekse orijinal parça kimliğiyle geri izlenebilir kalmalı; özet, yetkilendirme sınırını aşan başka kaynakları içermemelidir. Karşılaştırma, eşit belirteç bütçesinde iddia desteği, kanıt kapsaması, yanlış çıkarım oranı ve yanıt gecikmesiyle yapılmalıdır.
Ünite 41: İletişim Olayları İçin Genel Graf Veri Modeli
İnsan ilişkilerini inceleyen bir sistemde grafı doğrudan sosyal etiketlerle kurmak yerine olayları birinci sınıf veri olarak tutmak daha denetlenebilirdir.
Örnek kavramsal model:
Entity
  |
  +--> participates_in --> CommunicationEvent
                              |
                              +--> timestamp
                              +--> duration
                              +--> direction
                              +--> channel
                              +--> source_record_id
                              +--> transcript_id
Aynı olayın iki veya daha fazla katılımcısı olabilir. Pairwise edge yalnız sorgu veya görselleştirme için türetilebilir.
41.1. İlişki Kenarı
Entity A -------- Entity B
       aggregate edge
kenarının özellikleri:
event_count
total_duration
first_seen
last_seen
directional_counts
channel_distribution
source_event_ids
olabilir.
Ancak kenar, ham kanıt değildir. source_event_ids geri izlenebilirliği korur.
41.2. Zamansal Pencere
Graf tek ve sonsuz zamanlı bir yapı olarak okunmamalıdır.
G(t1,t2)belirli zaman aralığındaki ilişkileri temsil eder.
Aynı iki varlık:
Ocak: 2 olay
Şubat: 3 olay
Mart: 47 olay
gibi farklı davranış gösterebilir.
Graph RAG soruya göre uygun zaman penceresini seçmelidir.
41.3. Yön
A -> B ve B -> A olayları gerektiğinde ayrı korunmalıdır. Görselleştirme bunları tek undirected edge altında özetleyebilir; fakat retrieval katmanı yön bilgisini kaybetmemelidir.
Ünite 42: Graf Toplulukları ve Küresel Anlamlandırma
Büyük ilişki grafında her düğümü LLM bağlamına göndermek mümkün değildir. Topluluk tespiti, grafı daha küçük ve yapısal olarak yoğun alt gruplara ayırabilir.
Full Graph
   |
   +--> Community A
   |      +--> nodes
   |      +--> edges
   |      +--> evidence
   |
   +--> Community B
   |
   +--> Community C
Topluluk algoritmasının sonucu "gerçek dünyadaki örgüt" veya "sosyal grup" değildir. Yalnız kullanılan graf, kenar tanımı, ağırlık ve zaman penceresine göre matematiksel bir kümedir.
Bu ayrım açık biçimde yazılmalıdır:
graph community
   !=
real-world organization
42.1. Topluluk Özeti
Topluluk özeti şu bilgilerden üretilebilir:
- baskın düğümler,
- yüksek ağırlıklı kenarlar,
- zaman dağılımı,
- ilişkili belge/transkript temaları,
- kanıt kapsamı.
Ancak özet yalnız retrieval hızlandırıcıdır. Kullanıcı ayrıntı istediğinde sistem ham olaya ve metne geri dönmelidir.
42.2. Global Soru
"Veri kümesinde hangi ilişki örüntüleri belirginleşiyor?" gibi soru:
community reports
   |
   v
map: community-level partial answers
   |
   v
reduce: corpus-level synthesis
deseniyle ele alınabilir.
Bu işlem maliyetli olduğundan batch olarak önceden hazırlanmış topluluk raporları kullanılabilir.
Ünite 43: RAG İçin Karar Ağacı
Her problemde RAG kullanmak doğru değildir.
Soru kesin bir filtre / aggregate mı?
  |
  +--> Evet -> SQL / analitik motor
  |
  +--> Hayır
        |
        v
Metinsel kanıt gerekli mi?
  |
  +--> Evet -> Hybrid Retrieval
  |
  +--> Hayır
        |
        v
İlişki / multi-hop problem mi?
  |
  +--> Evet -> Graph Retrieval
  |
  +--> Hayır
        |
        v
Modelin davranışı mı yetersiz?
  |
  +--> Evet -> prompt / SFT / fine-tuning
  |
  +--> Hayır -> problemi yeniden tanımla
RAG'ın mimari disiplini, her şeyi embedding'e çevirmemekten başlar.
Ünite 44: Değerlendirme Veri Kümesinin Hazırlanması
Üretim RAG sistemi için benchmark internetten alınmış genel sorulardan oluşmamalıdır. Gerçek iş yükünü temsil eden kapalı bir test seti hazırlanmalıdır.
Soru sınıfları ayrı tutulabilir:
exact lookup
semantic lookup
multi-document synthesis
temporal
graph local
graph multi-hop
global corpus
no-answer
authorization
adversarial
Her sınıfta yeterli örnek bulunmalıdır.
44.1. No-answer Testi
Bilgi tabanında olmayan soru özellikle önemlidir.
Başarılı davranış:
kanıt yok
 -> "Bu veri kümesinde destekleyen kaynak bulamadım."
Başarısız davranış:
kanıt yok
 -> parametrik bilgiden ikna edici cevap
44.2. Authorization Testi
Aynı soru iki farklı kullanıcı kapsamıyla çalıştırılır.
User A -> sources {1,2,3}
User B -> sources {2}
User B'nin yanıtı 1 veya 3 numaralı kaynaktan bilgi sızdırmamalıdır.
44.3. Regression
Üretimde görülen her ciddi retrieval veya grounding hatası regresyon testine dönüşmelidir.
Ünite 45: Anonimleştirilmiş Kritik Sistem İçin Aşamalı Uygulama Önerisi
Kapalı ağda çalışan, büyük olay verisi, konuşma dökümü ve ilişki analizi bulunan bir sistem için doğrudan Graph RAG ile başlamazdım.
45.1. Faz 1: Metinsel Kanıt Retrieval
Kaynaklar:
transcript
note
article
structured description
İlk hat:
Turkish-aware lexical index
        +
multilingual / Turkish-capable dense embedding
        |
        v
RRF
        |
        v
cross-encoder reranker
LLM olmadan retrieval benchmark yapılır.
45.2. Faz 2: Kaynaklı soru-cevap
Yerel LLM eklenir.
Model talimatı:
yalnız verilen kanıta dayan
kanıt yoksa belirt
kaynak id'lerini koru
kişiler hakkında kanıtsız ilişki etiketi üretme
Çıktı serbest metin yanında yapısal kanıt listesi taşır.
45.3. Faz 3: SQL ve Graf Router
Sorgu sınıflandırılır:
count / range / exact -> SQL
semantic -> RAG
relationship -> graph
mixed -> orchestrated
Read-only araçlar kullanılır.
45.4. Faz 4: Zamansal Altgraf
Graph indeksine zaman penceresi ve event provenance eklenir.
node -> edge -> event ids -> transcript idsGraph sonucu her zaman kaynak olaylara geri dönebilir.
45.5. Faz 5: Topluluk ve Graph RAG
Yalnız gerçek sorguların önemli bölümü:
- multi-hop,
- global theme,
- community-level
sorularına dönüşüyorsa eklenir.
45.6. İşlem Sırasının Gerekçeleri
Çünkü en pahalı mimari problemi ilk çözüm olarak seçmek:
- değerlendirmeyi zorlaştırır,
- hata kaynağını gizler,
- indeksleme maliyetini artırır,
- üretim gecikmesini öngörülemez kılar.
Önce güçlü baseline, sonra ölçülen boşluk.
Ünite 46: Basit bir Uygulama Sözleşmesi
Framework bağımsız bir RAG servisi şu kavramsal arayüze sahip olabilir:
search(query, scope, filters)
 -> Evidence[]

answer(query, evidence)
 -> Answer

graph(query, scope, timeRange)
 -> GraphEvidence[]

aggregate(metric, filters)
 -> StructuredEvidence
Evidence örneği:
evidence_id
source_id
source_type
text
score
timestamp
access_scope
provenance
LLM hiçbir zaman doğrudan veri tabanı nesnesi döndürmek zorunda değildir; uygulama katmanı kanıtı kontrollü DTO benzeri yapıya dönüştürür.
Bu ayrım framework değişimini kolaylaştırır.
application
   |
RAG contracts
   |
+-- lexical engine
+-- vector engine
+-- graph engine
+-- LLM runtime
LangChain, LlamaIndex veya başka bir orkestrasyon kütüphanesi kullanılabilir; fakat alan sözleşmesinin kendisi kütüphaneye bağlanmamalıdır.
Ünite 47: Maliyet Modeli ve Ölçekleme
RAG maliyeti yalnız token maliyeti değildir.
Yerel sistemde de:
embedding compute
index memory
disk
reranker compute
LLM GPU memory
queueing
reindex duration
kaynak maliyetidir.
47.1. İndeks Büyüklüğü
Kabaca:
vector_count
x dimensions
x bytes_per_dimension
ham vektör belleğinin temelini verir. ANN grafı, metadata ve indeks yapısı ek yük oluşturur.
Büyük veri için:
- daha küçük embedding boyutu,
- quantization,
- partitioning,
- cold storage,
- selective embedding
değerlendirilebilir.
Kalite ölçülmeden boyut düşürülmemelidir.
47.2. Reranker Kapasitesi
Cross-encoder top-100 aday üzerinde pahalıysa:
top 100 -> lightweight reranker -> top 30
top 30  -> stronger reranker -> top 8
gibi kademeli yapı kurulabilir.
Her aşama ek latency getirir; faydası benchmark ile kanıtlanmalıdır.
47.3. Yapay Zeka, NLP ve Büyük Dil Modelleri ile İlişkisi
RAG, yapay zekânın bütünü değildir. Yapay zekâ problem çözme, öğrenme, arama, bilgi gösterimi, planlama ve karar verme gibi çok geniş bir alanı kapsar.
Doğal Dil İşleme, metnin nasıl temsil edildiğini, tokenlaştırıldığını, arandığını ve anlamlandırıldığını açıklar. RAG'ın lexical retrieval, embedding, query expansion ve metin parçalama bileşenleri doğrudan NLP ve bilgi erişimi temeline dayanır.
Büyük Dil Modelleri, retrieval sonucunu yorumlayan ve doğal dil yanıtına dönüştüren üretici modeli açıklar. RAG, LLM'nin ağırlıklarını değiştirmek zorunda değildir; çalışma zamanı bağlamını değiştirir.
NLP
  -> metin ve sorgu temsili

LLM
  -> dil üretimi ve bağlam kullanımı

RAG
  -> doğru dış bilginin doğru anda modele bağlanması
Graf tabanlı RAG ise buna Ayrık Matematik: Kümeler, Mantık, Bağıntılar ve Graflar dersindeki grafik kuramı ile bilgi gösterimi boyutunu ekler.
Veri Tabanı Yönetim Sistemleri ile ilişki de önemlidir. RAG veri tabanının alternatifi değildir. Yapısal veri, bütünlük, transaction, indeks ve deterministik sorgu yine veri tabanı sisteminin sorumluluğudur. RAG, yapılandırılmış ve yapılandırılmamış bilgiyi doğal dil arayüzünde birleştiren üst katmandır.
İletişim ve ilişki verisinde HTS Analizi notundaki kaynak–yorum ayrımı korunmalıdır. Graf kenarı, toplulaştırma ve LLM yorumu aynı epistemik seviyede değildir.
47.4. Sonuç
Bilgi Erişimi Destekli Üretim, büyük dil modeline daha fazla metin vermek değildir. Doğru veri kaynağını, doğru retrieval yöntemini, doğru yetki sınırını ve doğru kanıt zincirini tasarlama problemidir.
Olgun bir RAG sistemi:
Belge Arama
   +
Veri Tabanı
   +
Graf Analizi
   +
NLP
   +
LLM
   +
Yetkilendirme
   +
Değerlendirme
bileşimidir.
En iyi RAG mimarisi en fazla ajanı, en büyük modeli veya en karmaşık grafı kullanan mimari değildir. Ölçülebilir retrieval kalitesi, düşük ve öngörülebilir gecikme, kaynak kökeni, erişim denetimi ve kanıta geri izlenebilirlik sağlayan mimaridir.
Ünite 48: Belge Çıkarma Kalitesi RAG Kalitesinin Üst Sınırıdır
RAG hattında modelden önce belge çıkarma vardır. PDF ekranda düzgün görünse bile metin katmanı:
- sütunları yanlış sırada birleştirebilir,
- tablo hücrelerini kaydırabilir,
- üstbilgi ve altbilgiyi her sayfada tekrar edebilir,
- taranmış sayfalarda hiç metin içermeyebilir,
- kod bloklarını veya formülleri bozabilir.
Bu yüzden:
PDF var
   !=
kullanılabilir metin var
48.1. OCR Yalnız Yedek Plan Değildir
Taranmış veya karma belge için OCR gerekebilir. Ancak OCR çıktısı da otomatik olarak doğru değildir. Özellikle:
- Türkçe karakterler,
- küçük punto,
- tablo,
- iki sütun,
- el yazısı,
- düşük kontrast
hata üretebilir.
Üretim ingest hattı belge türünü belirleyip uygun parser seçmelidir.
Belge
 |
 +--> text-native PDF -> layout parser
 |
 +--> scanned PDF -> OCR
 |
 +--> HTML -> DOM-aware extraction
 |
 +--> DOCX -> paragraph/style extraction
48.2. Düzen Bilgisi
Başlık, alt başlık, tablo başlığı ve sayfa numarası metnin anlamını değiştirebilir. Parçalama öncesinde mümkün olduğunca yapı korunmalıdır.
heading_path:
"Ünite 4 > Transaction > Isolation"
gibi metadata retrieval sırasında önemli bağlam sağlar.
Ünite 49: Gömme Modelini Kıyaslamak RAG'ın Ayrı Deneyidir
Bir RAG sistemi geliştirirken gömme modelini yalnız genel sıralama listesine göre seçmek yeterli değildir.
Kendi veri kümesinden küçük bir test seti hazırlanmalıdır:
query
expected_chunk_ids
hard_negative_ids
language
content_type
Ardından:
model A
model B
model C
   |
   v
Recall@K / MRR / nDCG
   |
   v
gecikme + memory
karşılaştırılır.
RAGTurk çalışmasının Türkçe için gösterdiği önemli sonuçlardan biri, daha karmaşık üretici modüllerin her zaman kaliteyi artırmamasıdır. Çalışmada HyDE en yüksek sonucu verirken, cross-encoder yeniden sıralama ve context augmentation daha düşük maliyetle çok yakın başarı üretmiştir. Bu sonuç doğrudan bütün veri kümelerine taşınmamalı; fakat retrieval bileşenlerinin Türkçe üzerinde ayrı kıyaslama edilmesi gerektiğini güçlü biçimde destekler.
49.1. Embedding Değişikliği İndeks Değişikliğidir
Yeni gömme modeline geçildiğinde eski vektörlerle yeni vektörleri aynı uzaymış gibi karşılaştırmak doğru değildir.
embedding_model_version
        |
        v
vector_index_version
birlikte sürümlenmelidir.
Gömme modeli, tokenleştirici veya havuzlama yöntemi değiştiğinde aynı belge için üretilen vektörler farklı bir temsil uzayına taşınabilir. Eski doküman vektörleriyle yeni sorgu vektörlerinin boyutu eşit olsa bile kosinüs veya iç çarpım skorları karşılaştırılabilir olmayabilir. Geçiş sırasında indeks sürümü, normalize etme kuralı, model sürümü ve yetkilendirme filtresi aynı retrieval sözleşmesinin parçası olmalıdır.
Gömme üretiminde GPU batch kullanımı iş hacmini artırabilir; ancak küçük sorguların büyük batch'i beklemesi sorgu gecikmesini büyütür. Belge indeksleme için çevrimdışı throughput ile sorgu embedding'i için çevrim içi P95/P99 gecikmesi ayrı kapasite hedefleridir. Eşzamansız indeksleme geride kalırsa oluşturulan yanıt en güncel belgeyi görmeyebilir; bu durum model kalitesinden ayrı bir veri tazeliği meselesidir.
Ünite 50: Kalıcı İndeks ve Yaşam Döngüsü
Deneme RAG uygulamasında indeks program başlarken yeniden oluşturulabilir. Üretimde bu yaklaşım büyük veri için sürdürülebilir değildir.
Kalıcı indeks:
Corpus v17
   |
   +--> lexical index v17
   +--> vector index v17
   +--> metadata snapshot v17
olarak sürümlenebilir.
50.1. Build ve Publish Ayrımı
Yeni indeks oluşturulurken çalışan indeksi bozmak yerine:
ACTIVE v17
   |
build v18
   |
validate
   |
atomic switch
   v
ACTIVE v18
yaklaşımı kullanılabilir.
Başarısızlıkta v17'ye geri dönmek mümkün olur.
50.2. Aynı Belgenin Yeni Sürümü
Belge değiştiğinde:
- kanonik kimlik bulunur,
- eski chunklar belirlenir,
- yeni içerik parçalanır,
- embedding üretilir,
- indeks atomik olarak güncellenir,
- eski sürüm geçersiz kılınır.
Aynı belgenin eski ve yeni sürümünün retrieval sonucunda birlikte görünmesi sessiz bilgi çelişkisi oluşturabilir.
Ünite 51: Çoklu Belge Ingest, Tekilleştirme ve Kaynak Kökeni
Dosya sayısının artması yalnız daha fazla embedding üretmek değildir. Aynı içeriğin farklı kopyaları olabilir.
Örnek:
rapor.pdf
rapor-son.pdf
rapor-final.pdf
rapor-final2.pdf
İsimden hangisinin kanonik olduğu anlaşılamaz.
İçerik hash'i, belge kimliği, sürüm ve kaynak yolu birlikte tutulmalıdır.
51.1. Near-duplicate
Aynı haber veya teknik metin küçük değişikliklerle birden fazla kaynakta bulunabilir. Retrieval top-k listesinin tamamı aynı bilginin kopyalarından oluşursa bağlam çeşitliliği düşer.
retrieve
  |
  v
near-duplicate detection
  |
  v
source-aware diversity
Bu işlem her zaman kopyaları silmek anlamına gelmez; aynı bilginin birden çok bağımsız kaynaktan geldiği durum provenance açısından değerli olabilir.
Ünite 52: Retrieval Hatasını Generation Hatasından Ayırmak
RAG çıktısı yanlışsa ilk soru “LLM neden halüsinasyon yaptı?” olmamalıdır.
Hata ağacı:
Yanlış yanıt
   |
   +--> doğru kanıt gelmedi
   |      |
   |      +--> chunking
   |      +--> embedding
   |      +--> lexical search
   |      +--> filter
   |      +--> query rewrite
   |
   +--> doğru kanıt geldi
          |
          +--> reranking yanlış
          +--> context packing
          +--> LLM yorum hatası
          +--> citation mismatch
Bu ayrım RAG değerlendirmesinin temelidir.
52.1. LLM Olmadan Retrieval Testi
İlk olarak:
query -> top-k documentsçıktısı insanlar veya altın veri ile ölçülmelidir.
Retrieval kötü ise daha iyi istem sorunu çözmez.
Ünite 53: Baseline'dan Agentic RAG'a Geçiş
Agentic RAG güçlü olabilir; ancak ilk çözüm olarak seçilmemelidir.
Önerilen sıra:
1. lexical baseline
2. dense baseline
3. hybrid + reranker
4. query clarification
5. query decomposition
6. gerekiyorsa HyDE
7. gerekiyorsa iterative / agentic retrieval
Her basamak önceki baseline'a karşı ölçülmelidir.
53.1. HyDE
Hypothetical Document Embeddings yaklaşımı, sorgudan hipotetik bir yanıt/belge üretip bunun embedding'iyle retrieval yapar. Özellikle kısa veya kelime eşleşmesi zayıf sorgularda yararlı olabilir.
Ancak üretici model sorguyu yanlış yönde genişletirse retrieval da yanlış bölgeye kayabilir. Bu yüzden HyDE her sorgu için varsayılan olmamalıdır.
53.2. Query Clarification
Türkçede daha yalın sorgu açıklama veya yeniden yazma, morfolojik bilgiyi gereksiz üretici dönüşümlerle bozmadan retrieval kalitesini yükseltebilir. RAGTurk sonucunun pratik mesajı da bu yöndedir: güçlü reranking ile sade query transformation çoğu durumda daha sürdürülebilir başlangıçtır.
Ünite 54: Yerel RAG ve Kurum İçi Model Ayrımı
Yerel RAG'ın üç farklı “yerel” bileşeni vardır:
yerel veri
yerel gömme
yerel LLM
Bunlardan biri yerel diye diğerleri otomatik yerel değildir.
Örneğin belge indeksleri kurum içinde tutulurken sorgu gömmesi dış API'ye gönderiliyorsa sorgu metni yine dış sisteme çıkar.
Tam kapalı ağ tasarımı:
Source
  |
Local Parser
  |
Yerel Gömme
  |
Local Search / Reranker
  |
Local LLM
şeklinde uçtan uca değerlendirilmelidir.
Yerel model seçimi yalnız gizlilik değil, güncelleme, kapasite, model lisansı ve bakım kararıdır.
Ünite 55: Kaynaklı Cevap Üretiminde İddia Düzeyi
Kaynak göstermek yalnız cevabın sonuna URL eklemek değildir.
Yanıt üç düzeye ayrılabilir:
Kaynakta doğrudan bulunan
        |
        v
Kaynaklardan hesaplanan
        |
        v
Model tarafından yorumlanan
Örneğin:
Doğrudan kanıt: “Belgede tarih 15 Eylül olarak geçiyor.”
Hesaplanan: “İki tarih arasında 12 gün var.”
Yorum: “Bu gecikme olağan dışı görünüyor.”
Bu üç ifade aynı kaynak desteği seviyesinde değildir. Özellikle kritik sistemlerde model cevabı hangi iddianın hangi tür olduğunu belirtebilir.
Bu yaklaşım Graph RAG ve insan ilişkisi analizinde de önemlidir: gözlenen olay, türetilmiş ölçü ve yorum birbirinden ayrılmalıdır.
55.1. RAG Çıktısının Karar Desteğindeki Epistemik Sınırı
RAG mimarisi bir yanıtı kaynaklarla temellendirebilir; fakat üretilen metin kaynak kaydın kendisi değildir. Kritik karar desteğinde şu ayrım korunmalıdır:
kanonik belge / kayıt
        ↓
erişilen parça
        ↓
yeniden sıralama ve bağlam seçimi
        ↓
model tarafından üretilen yorum
        ↓
insan değerlendirmesi
Bu katmanların görsel veya veri modelinde birbirine karışması, türetilmiş bir yorumu doğrulanmış olgu gibi gösterebilir. Bilişsel Sistemler Mühendisliği açısından iyi karar desteği; yalnız cevabı değil, cevabın kaynağını, veri tarihini, erişim kapsamını, belirsizliği ve karşı kanıtı incelemeye olanak vermelidir.
Bu nedenle kaynak gösterme, yalnız açıklanabilirlik özelliği değildir; operatörün durumsal farkındalığını ve bağımsız karar yetkisini koruyan bir provenance sözleşmesidir. Model çıktısının güven puanı da gerçek doğruluk olasılığıyla otomatik olarak eş anlamlı kabul edilmemelidir.
55.2. Alıntı, Hesaplanan Bulgu ve Çıkarımın Ayrı Doğrulanması
Kaynağa dayalı yanıt, alıntı ile yanıt arasında yalnız bir bağlantı bulunmasından ibaret değildir. “Metinde geçiyor” türündeki olgular doğrudan bir aralıkla doğrulanabilirken, “üç kez tekrarlandı” gibi sayısal ifadeler bir sayım işleminin girdisi ve sınırlarını gerektirir. “İki ifade çelişiyor” değerlendirmesi ise her iki ifadenin konuşmacı, zaman ve olumsuzluk bağlamının karşılaştırılmasını gerektirir. Bu üç durum aynı kanıt yeterliliği ölçütüne indirgenemez.
Atomik bir yanıt iddiası için en azından iddia türü, veri kapsamı, hesaplama veya alıntı kökeni ve destek durumu temsil edilebilir. Doğrudan alıntıda kaynak aralığının varlığı aranır; sayısal bulguda sayımın hangi kayıtlar üzerinde yapıldığı doğrulanır; yorumsal ifadede destek ile olası karşı kanıt ayrı incelenir. Bir kaynak kimliğinin varlığı, içeriğin iddiayı gerçekten desteklediği anlamına gelmez. Eksik veya kesilmiş belgelerde yokluk iddiası ayrıca sakıncalıdır: görülmemiş kısımda ilgili ifade bulunabilir.
Bu ayrım yanıt üretimine de yansır. Doğrudan doğrulanan olgu kesin bir cümleyle verilebilir; kapsamı sınırlı hesaplama sınırıyla birlikte belirtilir; desteklenmeyen yorum ya çıkarılır ya da açık bir belirsizlik ifadesiyle ayrıştırılır. Amaç her yanıta uzun bir uyarı eklemek değil, doğruluk derecesinin cümlenin biçiminde görünmesini sağlamaktır.
Ünite 56: Gömme Modeli Yaşam Döngüsü, Zor Negatifler ve Retrieval Drift
RAG sisteminde gömme modeli yalnız ilk kurulumda seçilen bir kütüphane bağımlılığı değildir. Model; hangi belgelerin birbirine yakın görüleceğini, hangi sorguların hangi adayları üreteceğini ve similarity skorlarının hangi dağılımda oluşacağını belirlediği için retrieval davranışının sürümlü bir parçasıdır.
Bu nedenle üretim sistemi şu bileşenleri tek bir retrieval sözleşmesi olarak ele alabilir:
embedding model
normalization / preprocessing
vector dimension
similarity metric
index configuration
threshold policy
reranker version
Bu bileşenlerden biri değiştiğinde eski kıyasların yeni sistem için otomatik olarak geçerli olduğu varsayılmamalıdır.
56.1. Genel Modelden Özel Gömme Modeline Geçiş
Custom embedding eğitmek ilk çözüm olmamalıdır.
Önce daha ucuz iyileştirmeler ölçülmelidir:
chunk sınırları
metadata filtreleri
lexical + dense hybrid
query rewrite
reranking
better baseline embedding
Bunlara rağmen doğrulanmış test kümesinde sürekli aynı alan ayrımları kaçırılıyorsa alan uyarlaması anlamlı hale gelir.
Örneğin genel model iki teknik terimi semantik olarak yakın görüp sürekli karıştırıyorsa, bu hata:
tek örnekdeğil:
tekrarlanan retrieval failure patternolarak kanıtlanmalıdır.
Model uyarlamasının maliyeti yalnız eğitim değildir. Yeni model:
- korpusun yeniden gömülmesini,
- yeni indeks üretimini,
- eşikların yeniden kalibre edilmesini,
- reranker uyumunun yeniden ölçülmesini,
- migration ve rollback planını
gerektirebilir.
56.2. Eğitim Örneğinin Gerçek Birimi: Sorgu, Pozitif ve Negatif
Retrieval embedding eğitimi yalnız benzer cümleleri birbirine yaklaştırmak değildir.
Temel eğitim sinyali şu tür ilişkilerden oluşabilir:
query
  ├─ positive: gerçekten ilgili parça
  └─ negative: ilgili olmayan parça
Kolay negatif:
konu olarak tamamen ilgisizolduğunda model ayrımı çok erken öğrenebilir.
Zor negatif (hard negative) ise sorguya yüzeysel veya semantik olarak benzeyen, fakat gerçekte yanlış olan adaydır.
Örneğin:
sorgu:
"transaction isolation ile deadlock arasındaki ilişki"

positive:
isolation + locking + deadlock açıklaması

hard negative:
yalnız ACID tanımı yapan fakat deadlock davranışını açıklamayan parça
Zor negatifler, modelin geniş konu yakınlığından daha ince relevance sınırlarını öğrenmesine yardım eder.
Fakat mining süreci de hatalı olabilir. Gerçekte ilgili bir belge yanlışlıkla negatif etiketlenirse model faydalı komşuluğu parçalayabilir. Bu nedenle otomatik hard-negative mining sonrası örnek kalite kontrolü önemlidir.
56.3. Contrastive, Triplet ve in-batch Objective'ler
Gömme uyarlamasında farklı loss aileleri kullanılabilir.
Contrastive yaklaşım ilgili çiftleri yaklaştırıp ilgisiz çiftleri uzaklaştırmaya çalışır.
Triplet yaklaşım:
anchor / query
positive
negative
üçlüsü üzerinden pozitifin negatife göre daha yakın olmasını hedefler.
In-batch negatives ise aynı mini-batch içindeki diğer örnekleri negatif aday olarak kullanarak büyük negatif havuzu üretir.
Bu yöntemlerin hiçbiri tek başına "daha iyi embedding" garantisi değildir.
Asıl değerlendirme:
training loss
    ↓
retrieval benchmark
    ↓
Recall@K / MRR / nDCG
    ↓
reranking
    ↓
grounded answer quality
zincirinde yapılmalıdır.
Training objective ile gerçek retrieval hatası aynı yönde değilse düşük loss üretimde değer taşımayabilir.
56.4. Embedding Geometrisi: Anisotropy ve Hubness
Nearest-neighbor retrieval, vektör uzayının geometrisinden etkilenir.
Anisotropy, vektörlerin uzaya dengeli yayılmak yerine belirli yönlerde kümelenmesi olarak düşünülebilir.
Hubness ise bazı vektörlerin çok sayıda farklı sorgu için tekrar tekrar en yakın komşular arasında görünmesidir.
Üretimde olası belirti:
çok farklı sorgular
       ↓
aynı genel parçalar sürekli top-k
olabilir.
Bu durum her zaman "vektör veritabanı bozuk" anlamına gelmez. İncelenmesi gerekenler:
- embedding modelinin eğitim amacı,
- normalization,
- similarity metriği,
- tekrar eden / generic dokümanlar,
- hard-negative kalitesi,
- domain adaptation,
- reranking
olabilir.
Geometri ölçümleri tek başına relevance metriği değildir. Retrieval benchmark ile birlikte yorumlanmalıdır.
56.5. Similarity Threshold Sabit Evrensel Sayı Değildir
Cosine similarity için:
0.80 her zaman iyigibi evrensel eşik yoktur.
Skor dağılımı:
- embedding modeline,
- normalization'a,
- dile,
- corpus yapısına,
- chunk uzunluğuna,
- query türüne
göre değişebilir.
Eşik validation verisinden seçilmelidir.
Örneğin:
threshold düşük
 -> recall artabilir
 -> weak context artabilir

threshold yüksek
 -> precision artabilir
 -> gerekli kanıt kaçabilir
RAG'da threshold bu nedenle abstention politikasının bir parçasıdır.
Yeterli retrieval kanıtı bulunamazsa sistem:
zorla en yakın parçayı kullanyerine:
kanıt yetersizsonucu üretebilmelidir.
56.6. Çok Dilli Embedding'i Tek Skorla Değerlendirmemek
Çok dilli modelde üç ayrı problem bulunabilir:
TR query -> TR document
EN query -> EN document
TR query -> EN document
Aynı model bunlarda aynı başarıyı vermeyebilir.
Bu nedenle değerlendirme veri kümesi:
- dil,
- yazı sistemi,
- domain terimi,
- aynı dil / çapraz dil retrieval türü
gibi dilimleri taşımalıdır.
İngilizce retrieval'da iyi çalışan modelin Türkçe veya çapraz dil kullanımında aynı kaliteyi verdiği varsayılmamalıdır.
56.7. Retrieval Drift
Model sabit kalsa bile retrieval davranışı zamanla bozulabilir.
Nedenler:
yeni doküman türleri
korpus büyümesi
terminoloji değişimi
query dağılımının değişmesi
ingest/parser değişikliği
metadata politikasının değişmesi
olabilir.
Retrieval drift için izlenebilecek sinyaller:
canary Recall@K / MRR / nDCG
top-k neighbor overlap
retrieved language/content-type dağılımı
weak-context oranı
no-answer oranı
reranker score dağılımı
kullanıcı düzeltme / kabul oranı
Tek metriğe bakmak yeterli değildir. Örneğin retrieval recall korunurken düşük kaliteli yeni belgeler yüzünden generator'a giden context kalitesi düşebilir.
56.8. Gömme Modeli Migration'ı Veri Migration'ıdır
Yeni embedding modeline geçiş:
model v1
-> API adını model v2 yap
değildir.
Daha güvenli geçiş:
ACTIVE index v1
       |
       +--> build shadow index v2
       |
       +--> same evaluation queries
       |
       +--> compare relevance + latency + footprint
       |
       +--> acceptance gate
       |
       +--> publish v2
       |
       +--> keep v1 rollback window
şeklinde yürütülebilir.
Migration sırasında eski ve yeni embedding'leri aynı distance space içinde karıştırmak doğru değildir.
Ayrı indeksler tutulmalı; karşılaştırma aynı sorgu kümesinde sonuç davranışı üzerinden yapılmalıdır.
Yeni model için ayrıca:
threshold
quantization
ANN parameters
reranker
yeniden doğrulanmalıdır.
56.9. Retrieval Artefact Sürümünü Açıkça Taşımak
Bir RAG cevabının kanıt zincirinde yalnız belge sürümü değil retrieval artefact sürümü de yararlı olabilir:
corpus_version
embedding_model_version
vector_index_version
lexical_index_version
reranker_version
retrieval_policy_version
Bu bilgiler kullanıcıya gereksiz teknik ayrıntı olarak gösterilmek zorunda değildir.
Ancak regresyon incelemesinde:
Aynı sorgu geçen hafta neden başka belgeyi buluyordu?
sorusunu cevaplamayı mümkün kılar.
Gömme modeli yaşam döngüsü bu nedenle model seçimi değil; veri sürümleme, retrieval değerlendirmesi, drift gözlemi ve güvenli migration problemidir.
56.10. RAG İçin Ölçeklenebilir Retrieval ve Kanıt Sözleşmesi
Büyük veri algoritmalarında her zaman tam sonuç üretmek ekonomik değildir. RAG hattında MinHash/LSH yinelenen ya da çok benzer parçaları ucuzca adaylayabilir, reservoir sampling değerlendirme veya gözlem akışından sınırlı bellekte örnek seçebilir, sketch yapıları ise sorgu ve belge frekanslarını tam sayaç maliyeti olmadan yaklaşık izlemeye yarar. Temel mühendislik ayrımı, yaklaşık sonucun hata olasılığı ve bellek maliyeti biliniyorsa bunun kontrolsüz bir kestirim değil, sözleşmesi tanımlı bir algoritma olmasıdır.
- Candidate generation ile kesin yeniden sıralama aşamalarını ayrı maliyet/kalite katmanları olarak tasarlamak.
- Approximate nearest-neighbor veya LSH kullanımında recall kaybını ölçmek.
- Yanıtın yalnız yetkili ve gerçekten retrieve edilmiş kanıtlara bağlanmasını invariant olarak korumak.
56.11. Yokluk İddiası için Kapsam Tamlığı
Bir sorgudaki terimlerin indeks tarafından ne ölçüde temsil edildiği ile istenen veri kapsamının ne ölçüde gerçekten incelendiği aynı ölçü değildir. İlkine sorgu kapsaması, ikincisine kaynak/korpus tamlığı denebilir.
Negatif cevap üretirken asıl belirleyici ikinci ölçüdür. "İncelenen kapsamda bulunmadı" ifadesi ancak istenen ve erişime uygun kaynakların tamamı işlendiğinde güçlüdür. Şu durumlardan biri varsa sonuç kısmi kabul edilmelidir:
- bazı kaynaklar henüz yüklenmemişse,
- kaynak okuması başarısız olmuşsa,
- veri üst sınır nedeniyle kırpılmışsa,
- aday veya sonuç bütçesi analizi kesmişse.
Bu durumda doğru ifade, yokluk iddiasını tüm veri kümesine yaymak yerine yalnız incelenen bölümü tarif eder. Sorgunun önemli terimlerinin büyük bölümü indeks sözlüğünde hiç temsil edilmiyorsa da "yok" demek yerine yazım, terim veya kapsamın yeniden belirtilmesi istenmelidir.
Bu ayrım şu ilkeyi netleştirir:
retrieval sonucu yok ≠ bilginin yokluğuna dair kanıtYaklaşık retrieval, sampling veya aday sınırlandırma kullanılabilir; fakat bunların sonucu eksiksiz tarama gibi sunulmamalıdır. Tamlık iddiası, kullanılan algoritmadan bağımsız olarak hangi kaynakların gerçekten analiz edildiğiyle birlikte taşınmalıdır.
Zamansal drift analizinde kaynak bileşimi de sabit tutulmalıdır. Bir dönemde ağırlıklı olarak notlar, başka bir dönemde ağırlıklı olarak transkripsiyonlar karşılaştırılıyorsa gözlenen değişim dilsel drift yerine kaynak karışımındaki değişimden doğabilir.
Ünite 57: Etkileşimli Retrieval, Arka Plan Bilgisi ve Sorgu İyileştirme
RAG'da sorgu tek seferlik bir metin girdisi olarak düşünülürse kullanıcının keşif süreci eksik modellenir. Büyük belge koleksiyonlarında daha gerçekçi akış:
sorgu
  ↓
aday sonuç
  ↓
inceleme
  ↓
kısıt / bağlam seçimi
  ↓
yeniden retrieval
  ↓
daha dar kanıt kümesi
şeklindedir. Bu yapı, klasik metin madenciliğindeki browse–refine döngüsünün güncel retrieval sistemlerindeki karşılığıdır.
57.1. Conditioning: Sorguyu bir Kavram Bağlamında Çalıştırmak
Bir retrieval görevi bütün indeks üzerinde çalışmak zorunda değildir. Kullanıcı:
- belirli konu,
- zaman aralığı,
- kaynak türü,
- kişi/kurum,
- belge sınıfı,
- güvenlik/yetki kapsamı
gibi koşullarla arama uzayını daraltabilir.
Bu kısıtlar yalnız UI filtresi değildir. Doğru yerde uygulanırsa aday üretim alanını küçülterek ilgisiz kanıtın sonraki aşamalara taşınmasını önler.
57.2. Arka Plan Bilgisi Üç Farklı Rolde Kullanılabilir
Sözlük, ontoloji veya taksonomi:
- normalizasyon için: farklı yüzey biçimlerini aynı kavrama eşlemek,
- retrieval constraint için: aday arama uzayını sınırlandırmak,
- query expansion/refinement için: eş anlamlı, üst kavram veya alt kavram üretmek
amacıyla kullanılabilir.
Bunlar cevap kanıtı ile aynı şey değildir:
background knowledge ≠ source evidenceBir ontolojinin kavramlar arasında ilişki tanımlaması, belirli kullanıcı sorusunun cevabını tek başına kanıtlamaz.
57.3. Pattern Overabundance ve Retrieval Result Overload
Geniş bir sorgu çok sayıda teknik olarak ilgili pasaj üretebilir. Daha fazla aday her zaman daha iyi RAG değildir. Sonuç kümesi:
- tekrar,
- near-duplicate,
- aynı iddianın çok sayıda varyantı,
- düşük bilgi değerli genel belgeler
nedeniyle context bütçesini tüketebilir.
Bu nedenle refinement katmanında:
candidate retrieval
       ↓
scope constraints
       ↓
deduplication
       ↓
ranking / reranking
       ↓
diversification
       ↓
bounded evidence set
uygulanabilir.
57.4. Kümeleme ile Sonuç Gezinmesi
Kullanıcı doğru arama terimini bilmiyorsa sonuçları tematik kümelere ayırmak bir sorgu genişletme tekniği değil, keşif yardımıdır. Scatter/Gather benzeri yaklaşımda kullanıcı ilgili kümeyi seçer ve yalnız o alt koleksiyonda yeniden retrieval yapılır.
Bu özellikle:
- geniş hukuk/teknik belge arşivleri,
- uzun olay dosyaları,
- patent/yayın koleksiyonları,
- çok kaynaklı kurum içi bilgi tabanları
için yararlı olabilir.
57.5. Query Language ve Capability Sınırı
İleri retrieval sistemlerinde sorgu yalnız doğal dil olmayabilir. Kullanıcı niyeti; metin araması, metadata filtresi, zaman koşulu, graf sorgusu veya bunların bounded birleşimine çevrilebilir.
Burada önemli güvenlik ilkesi:
Sorgu dili, kullanıcının yetkisini genişleten bir kaçış yolu değil; mevcut capability setinin denetlenebilir ifadesidir.
Dolayısıyla parser veya planner yalnız allowlist içindeki operatörleri üretmeli; kaynak ve scope sözleşmesi yürütme katmanında tekrar doğrulanmalıdır.
57.6. Source drill-back
Bir pattern, cluster veya özet üzerinde gezinme son noktada kaynak belgeye dönebilmelidir:
cevap / bulgu
     ↓
kanıt pasajı
     ↓
belge
     ↓
kaynak konumu / sürüm
Bu, metin madenciliğindeki interactive browsing fikrini RAG'ın provenance gereksinimiyle birleştirir.
57.7. Kanıt Bütçesi, Kaynak Çakışması ve Kısmi Getirimin Değerlendirilmesi
Bilgi erişiminde daha fazla parça getirilmesi her zaman daha fazla bağımsız kanıt anlamına gelmez. Aynı kaynağın birbirini örten bölümleri yüksek benzerlik puanıyla tekrar tekrar seçilebilir. Sınırlı bütçede sıralama, kaynak çeşitliliği ve aynı bilginin yinelenmesi arasındaki denge değerlendirilmelidir. Üst k değerini tek başına büyütmek, gecikmeyi ve bağlam tüketimini artırırken kanıt kapsamını değiştirmeyebilir.
Getirim çıktısı yalnız metin parçaları değildir: kaynak kimliği, sürüm, erişim zamanı, kesilme nedeni ve yetki kapsamı da veri sözleşmesinin parçasıdır. Kaynak erişimi kısmen başarısız olursa 'bulunamadı' ile 'aranamadı' ayrılmalıdır. Bir yanıtta bulunmayan kanıtın yokluğunu kanıt olarak sunmak, özellikle kısmi indeks ve sınırlı zaman aralığında hatalıdır.
Değerlendirmede Recall@k bilinen ilgili parçaların bulunmasını ölçer; fakat doğru kaynak bulunmuş olsa bile kullanılan cümlenin iddiası destekleyip desteklemediği ayrı doğrulanmalıdır. Kaynakla desteklenmeyen çıkarımlar, çelişkili belgeler, eski sürüm ve alıntıların yanlış bağlanması farklı hata sınıflarıdır.
57.8. Getirim Sonucunun Eyleme Dönüşmesinde Yetki Sınırı
Bilgi erişimi, bir belgeyi bulmakla kalıcı işlem yapma izni vermek arasında açık sınır koymalıdır. Erişilen belgedeki talimat metni, kullanıcının veya uygulama politikasının komutu değildir. Araç çağrısı ancak güvenilir komut katmanı tarafından seçildiğinde ve güncel yetki ile parametre doğrulamasından geçtiğinde çalıştırılmalıdır. Bu ayrım, retrieval kaynaklı prompt injection tehdidini azaltır.
Sonuç ekranından kaynağa dönüşte eski erişim hakkının süreceği varsayılmamalıdır. Kaynak referansı kimlik ve sürüm taşısa bile erişim kontrolü yeniden uygulanır. Yüksek benzerlikli fakat yetki kapsamı dışında kalan bir belge sonuç kümesine sokulmamalıdır.
Kaynakça
- Darren Edge et al. “From Local to Global: A Graph RAG Approach to Query-Focused Summarization.” 2024. https://arxiv.org/abs/2404.16130
- Deepak Dhyani. RAG with Python Cookbook: Learn Principles of RAG with LLM and Agentic AI, with 120+ Recipes. BPB Publications, 2026. ISBN 978-93-65895-735.
- Dongyu Ru et al. “RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation.” 2024. https://arxiv.org/abs/2408.08067
- Ethayarajh, Kawin. “How Contextual are Contextualized Word Representations? Comparing the Geometry of BERT, ELMo, and GPT-2 Embeddings.” EMNLP-IJCNLP, 2019. DOI: https://doi.org/10.18653/v1/D19-1006
- Gao, L. et al. “Precise Zero-Shot Dense Retrieval without Relevance Labels.” 2022. https://arxiv.org/abs/2212.10496
- Hao Yu et al. “Evaluation of Retrieval-Augmented Generation: A Survey.” 2024. https://arxiv.org/abs/2405.07437
- Jeff Johnson; Matthijs Douze; Hervé Jégou. “Billion-scale Similarity Search with GPUs.” 2017. https://arxiv.org/abs/1702.08734
- Julie Smith. RAG Generative AI: A Practical Guide to Building Custom Retrieval-Augmented Pipelines and Enhancing AI Systems. 2024.
- Jure Leskovec; Anand Rajaraman; Jeffrey D. Ullman. Mining of Massive Datasets.
- Li, Bohan; Zhou, Hao; He, Junxian; Wang, Mingxuan; Yang, Yiming; Li, Lei. “On the Sentence Embeddings from Pre-trained Language Models.” EMNLP, 2020. DOI: https://doi.org/10.18653/v1/2020.emnlp-main.733
- Microsoft Research. GraphRAG Documentation: Basic, Local, Global and DRIFT Search. https://microsoft.github.io/graphrag/
- Nguyen, Thanh-Do; Bui, Chi Minh; Vuong, Thi-Hai-Yen; Phan, Xuan-Hieu. “Passage-based BM25 Hard Negatives: A Simple and Effective Negative Sampling Strategy For Dense Retrieval.” PACLIC, 2023. https://aclanthology.org/2023.paclic-1.59/
- Nils Reimers; Iryna Gurevych. “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks.” EMNLP-IJCNLP, 2019. https://arxiv.org/abs/1908.10084
- Omar Khattab; Matei Zaharia. “ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT.” SIGIR, 2020. https://arxiv.org/abs/2004.12832
- OWASP GenAI Security Project. LLM01:2025 Prompt Injection. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- OWASP GenAI Security Project. LLM08:2025 Vector and Embedding Weaknesses. https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/
- Patrick Lewis et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” NeurIPS, 2020. https://arxiv.org/abs/2005.11401
- Philip Kiely. Inference Engineering. Baseten Books, 2026. ISBN 979-8-9943597-3-0.
- Ronen Feldman; James Sanger. The Text Mining Handbook: Advanced Approaches in Analyzing Unstructured Data. Cambridge University Press, 2007.
- Siagian, Lamhot. Language Models Interview Handbook: 151 Interview Questions, Foundation Roadmaps, Python Examples, Architecture Diagrams, and Production Playbooks for Modern LLM and GenAI Roles. AI Engineering Insider, 2026.
- Süha Kağan Köse et al. “RAGTurk: Best Practices for Retrieval Augmented Generation in Turkish.” SIGTURK 2026, 2026. DOI: https://doi.org/10.18653/v1/2026.sigturk-1.15
- Vladimir Karpukhin et al. “Dense Passage Retrieval for Open-Domain Question Answering.” EMNLP, 2020. https://arxiv.org/abs/2004.04906
- Yu. A. Malkov; D. A. Yashunin. “Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs.” IEEE TPAMI, 2020; preprint 2016. https://arxiv.org/abs/1603.09320
- Zirui Guo et al. “LightRAG: Simple and Fast Retrieval-Augmented Generation.” 2024. https://arxiv.org/abs/2410.05779