


Veri Tabanı Yönetim Sistemleri

ER ve ilişkisel model, normalizasyon, ilişkisel cebir, SQL, transaction ve yetkilendirmenin yanında depolama motoru, tampon havuzu, B+ ağaçları, WAL ve çökme sonrası kurtarmayı kapsayan veri tabanı ders notları.
Kapsam önce kavramsal modelleme, ardından ilişkisel model ve SQL, son olarak bütünlük, transaction yönetimi ve erişim denetimi sırasıyla ilerler. Bu sıra, problem alanından mantıksal modele ve oradan çalışan veri tabanı davranışına uzanan bağı korur. Anahtar ve normalizasyon terminolojisinde matematiksel tanım esastır; örneğin BCNF koşulunda belirleyicinin aday anahtar olması gerekmez, süper anahtar olması gerekir.
Ünite 1: Temel Kavramlar
1.1. Klasik Dosya Yapıları
Bir veri tabanı yönetim sistemini anlamanın en kolay yolu, önce klasik dosya yaklaşımının sınırlarını görmektir. Dosya, kalıcı depolama ortamında tutulan veri topluluğudur. Bir dosyanın yapısı uygulamanın gereksinimine göre belirlenir. Muhasebe, stok, personel veya öğrenci işleri gibi farklı uygulamalar kendi dosyalarını oluşturabilir.
Klasik dosya yaklaşımında veri yapısı ile uygulama kodu genellikle sıkı biçimde bağlıdır. Kayıt biçimindeki bir değişiklik uygulamanın da değiştirilmesini gerektirebilir. Aynı veri farklı uygulamalarda tekrar tutulabilir. Bu durum veri tekrarı, tutarsızlık ve bakım maliyeti oluşturur.
1.2. Kayıt ve Alan
Dosya içindeki mantıksal veri birimine kayıt denir. Bir öğrenci, personel veya ürün hakkında tutulan bilgiler tek bir kayıt oluşturabilir.
Kayıt içindeki tekil veri öğelerine alan denir.
Örneğin bir öğrenci kaydı şu alanları içerebilir:
- öğrenci numarası,
- ad,
- soyad,
- doğum tarihi,
- bölüm.
Alanlar veri tabanı terminolojisinde daha sonra sütun veya nitelik kavramlarıyla karşılık bulur.
1.3. Sıralı Dosyalar
Sıralı dosyada kayıtlara belirli bir sıra içinde erişilir. Bütün kayıtların işleneceği uygulamalarda bu yaklaşım yeterli olabilir.
Örneğin bütün öğrencilerin dönem sonu listesini üretmek için kayıtların baştan sona okunması doğal bir işlemdir.
Buna karşılık yalnız tek bir öğrencinin kaydına erişmek gerektiğinde dosyanın tamamını taramak verimsizdir. Kayıt sayısı büyüdükçe erişim maliyeti de artar.
1.4. İndeksli Dosyalar
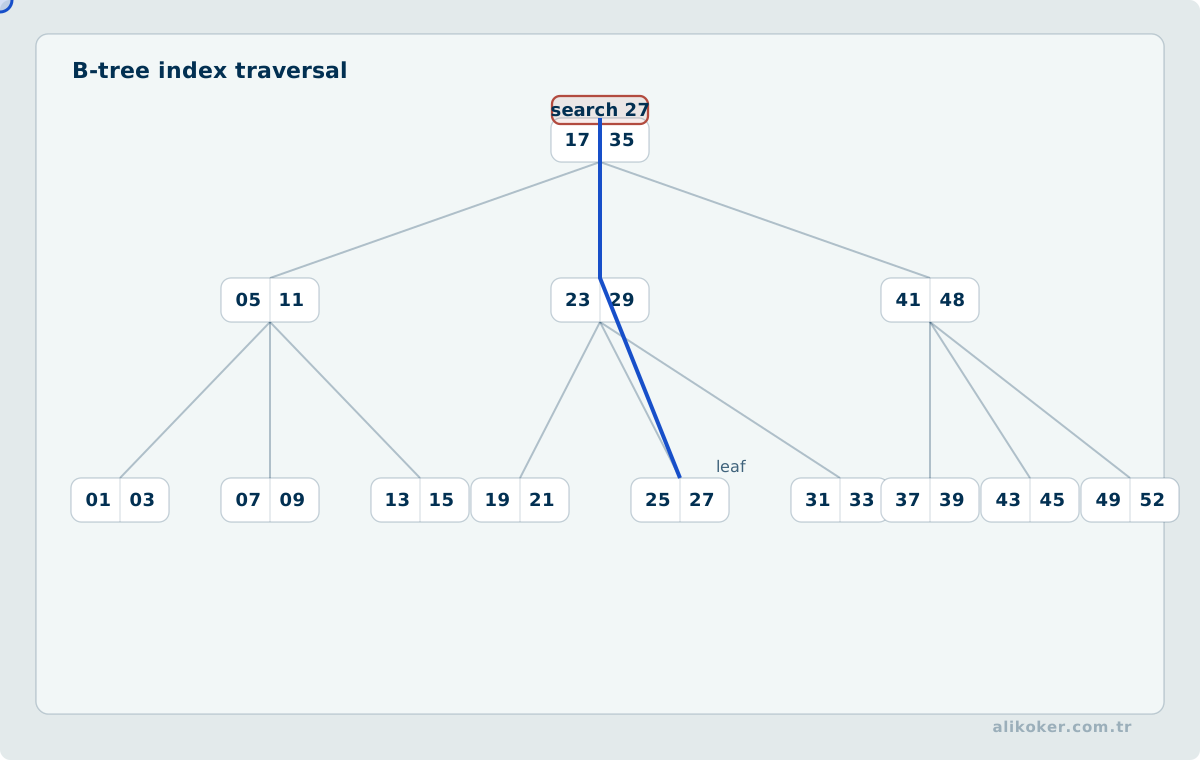
İndeksli dosya yapısında kayıtların konumunu gösteren ayrı bir indeks tutulur. Aranan anahtar önce indekste bulunur. Ardından ilgili kaydın konumuna erişilir.
Bir öğrenci dosyasında öğrenci numarası indeks alanı olarak kullanılabilir.
İndeksin temel amacı arama alanını küçültmektir. Bunun karşılığında indeks için ek depolama gerekir. Ekleme, silme ve güncelleme işlemlerinde indeksin de güncel tutulması gerekir.
Bu ödünleşim modern veri tabanlarındaki indeks mekanizmalarının da temelidir.
1.5. Hesaba Dayalı Dosyalar
Hesaba dayalı dosyalarda bir anahtar değerden kayıt konumuna ulaşmak için bir hash fonksiyonu kullanılır.
Temel düşünce:
anahtar -> hash fonksiyonu -> hedef konumUygun dağılım sağlandığında doğrudan erişim çok hızlı olabilir. Ancak farklı anahtarların aynı konuma düşmesi çakışma oluşturur. Bu nedenle hash tabanlı yapılarda çakışma yönetimi gerekir.
1.6. Veri Tabanı Sistemleri
Veri tabanı, birbiriyle ilişkili verilerin belirli bir mantıksal model altında düzenlenmiş bütünüdür.
Veri Tabanı Yönetim Sistemi, VTYS, verinin:
- tanımlanmasını,
- saklanmasını,
- sorgulanmasını,
- değiştirilmesini,
- bütünlüğünün korunmasını,
- eşzamanlı kullanılmasını,
- yetkilendirilmesini
sağlayan yazılım sistemidir.
VTYS yaklaşımında uygulama, verinin fiziksel yerleşim ayrıntılarından mümkün olduğunca bağımsız çalışır. Bu özellik veri bağımsızlığı kavramının temelidir.
1.7. Veri Tabanı Sistemlerinin Üstünlükleri
Klasik dosya yaklaşımına göre temel üstünlükler şunlardır:
- veri tekrarının azaltılması,
- tutarlılığın korunması,
- ortak verinin birden fazla uygulama tarafından kullanılabilmesi,
- erişim denetimi,
- bütünlük kurallarının merkezi uygulanması,
- eşzamanlı kullanıcı desteği,
- yedekleme ve kurtarma,
- sorgulama dilinin sağladığı esneklik,
- uygulama ile fiziksel veri düzeninin ayrıştırılması.
Bir VTYS veri tekrarını tamamen ortadan kaldırmaz. Ama tekrarın denetimli olmasını ve tutarlılık kurallarıyla yönetilmesini sağlar.
1.8. Veri Modelleri
Veri modeli, verinin mantıksal olarak nasıl temsil edileceğini tanımlayan kavram, yapı ve işlemler bütünüdür.
Tarihsel olarak:
- hiyerarşik model,
- ağ modeli,
- ilişkisel model,
- nesne yönelimli yaklaşımlar
geliştirilmiştir.
Günümüzde genel amaçlı kurumsal veri tabanlarında ilişkisel model temel konumunu korur. Nesne, belge, anahtar-değer, grafik ve sütun ailesi gibi farklı modeller ise belirli iş yüklerinde ayrı çözümler sunar.
Bu dersin temel modeli ilişkisel veri modelidir.
1.9. VTYS'nin İşlevsel Katmanları, Katalog ve Veri Bağımsızlığı
Bir veri tabanı yönetim sistemi yalnız tabloları saklayan bir dosya katmanı değildir. Kullanıcının bildirimsel isteği ile fiziksel depolama arasındaki farkı yöneten bir dizi işlevsel bileşen birlikte çalışır:
DDL / şema tanımları
        ↓
veri sözlüğü / sistem kataloğu
        ↓
sorgu çözümleme ve yetki denetimi
        ↓
mantıksal plan → optimizer → fiziksel plan
        ↓
depolama / buffer / transaction yönetimi
        ↓
fiziksel veri ve günlük kayıtları
Veri sözlüğü (catalog/data dictionary) yalnız tablo ve sütun adlarını değil; anahtarları, kısıtları, kullanıcı ve yetkileri, indeksleri ve optimizer'ın kullandığı istatistikleri de barındırabilen sistem metadata'sıdır. Böylece veri tanımı uygulama kodunun içine dağılmak yerine merkezi ve denetlenebilir hale gelir.
DBMS içindeki başlıca görev kümeleri kavramsal olarak şöyle ayrılabilir:
- DDL işleme: şema ve kısıt tanımlarını doğrulayıp kataloğa kaydeder.
- Sorgu işleyici: sözdizim ve anlam denetimini yapar, nesne ve sütun başvurularını çözümler.
- Sorgu eniyileyici: eşdeğer yürütme seçenekleri arasından maliyet modeline göre fiziksel plan seçer.
- Depolama yöneticisi: sayfa, dosya ve erişim yapılarıyla ikincil depolamayı yönetir.
- Tampon yöneticisi: disk/kalıcı depolama ile ana bellek arasındaki sayfa hareketini yönetir.
- Transaction yöneticisi: eşzamanlılık, atomiklik ve kurtarma mekanizmalarını koordine eder.
Bu katmanlaşmanın temel amacı veri bağımsızlığıdır. Mantıksal şemanın fiziksel depolama düzeninden ayrılması fiziksel veri bağımsızlığı; kullanıcı görünümleri veya dış şemaların kavramsal şemadaki belirli değişikliklerden korunması ise mantıksal veri bağımsızlığı olarak düşünülebilir. Veri bağımsızlığı tam ve sınırsız bir garanti değildir; amaç, uygulama ile fiziksel gerçekleştirim arasındaki gereksiz bağı azaltmaktır.
Kullanıcı rolleri de aynı nedenle ayrılır: DBA şema, güvenlik, kapasite ve işletim sorumluluklarını yönetirken uygulama geliştiricisi veri erişim sözleşmesini kullanır; ad-hoc sorgu kullanan analist ile önceden tanımlı işlemleri kullanan son kullanıcı aynı yetki ve araç düzeyine sahip olmak zorunda değildir.
Tarihsel hiyerarşik ve ağ tipi veri modelleri, veriye çoğunlukla önceden tanımlı gezinme yolları üzerinden ulaşılması fikrini temsil eder. Güncel ilişkisel tasarımın temel odağı bunlar değildir; ancak veri bağımsızlığı ve bildirimsel sorgulamanın neden önemli olduğunu anlamak için yararlı tarihsel karşılaştırmalardır.
Ünite 2: Varlık İlişki Modeli
Varlık-ilişki modeli tasarlanırken önce iş kuralları somut örnek kayıtlar üzerinden sınanır. Varlıklar ve anahtar adayları belirlendikten sonra ilişki çoklukları ile isteğe bağlı katılım ayrı ayrı doğrulanır. Bir bağlantı tablosuna geçiş kararı, ilişkinin çoktan çoğa olup olmadığına ve ilişkinin kendi özniteliklerini taşıyıp taşımadığına göre verilir. Şema tamamlandığında mevcut olmayan kayıt, yinelenen ilişki ve silme gibi sınır durumlarının hangi kısıtla karşılandığı gösterilmelidir.
2.1. Varlık İlişki Modeli
Varlık-İlişki modeli, veri tabanının doğrudan fiziksel tablolarını tanımlamak yerine problem alanındaki varlıkları, nitelikleri ve ilişkileri modellemek için kullanılır.
Model genellikle ER - Varlık Relationship biçiminde anılır.
ER modeli veri tabanı tasarımının kavramsal aşamasında kullanılır. Model tamamlandıktan sonra ilişkisel şemaya dönüştürülebilir.
2.2. Varlık
Varlık, diğer nesnelerden ayırt edilebilen gerçek veya kavramsal bir nesnedir.
Örnekler:
- öğrenci,
- ders,
- personel,
- bölüm,
- hesap,
- ürün.
Tek bir öğrenci bir varlık örneğidir. Öğrenci kavramının tüm örnekleri ise varlık kümesini oluşturur.
2.3. Varlık Kümesi
Aynı türdeki varlıkların oluşturduğu topluluğa varlık kümesi denir.
Örneğin:
OGRENCI = {O1, O2, O3, ...}
DERS    = {D1, D2, D3, ...}
Varlık kümesi veri tabanındaki tablo kavramıyla yakından ilişkilidir ancak kavramsal model ile fiziksel tablo aynı şey değildir.
2.4. İlişki ve İlişki Kümesi
Varlıklar arasındaki anlamlı bağlantıya ilişki denir.
Örneğin:
OGRENCI -- ALIR --> DERSBir öğrencinin bir dersi alması tek bir ilişki örneğidir. Aynı türdeki bütün ilişkilerin toplamı ilişki kümesini oluşturur.
Matematiksel olarak iki varlık kümesi arasındaki ilişki, bu kümelerin Kartezyen çarpımının bir alt kümesi olarak düşünülebilir.
2.5. Nitelikler
Bir varlığı tanımlayan özelliklere nitelik denir.
Bir personel için:
- personel numarası,
- ad,
- soyad,
- doğum tarihi,
- ücret
birer niteliktir.
İlişkisel modele geçildiğinde nitelikler çoğunlukla sütunlara karşılık gelir.
2.6. Etki Alanı
Bir niteliğin alabileceği geçerli değerler kümesine domain, yani etki alanı denir.
Örneğin bir not alanının etki alanı 0 ile 100 arasındaki tamsayılar olabilir.
Etki alanı yalnız veri tipini değil, kavramsal olarak geçerli değerler kümesini ifade eder.
2.7. Türetilen Nitelikler
Başka niteliklerden hesaplanabilen niteliğe türetilen nitelik denir.
Örneğin yaş bilgisi doğum tarihinden hesaplanabilir.
yas = bugunun_tarihi - dogum_tarihiTüretilen verinin ayrıca saklanması gerekmez. Saklanırsa kaynak değer değiştiğinde tutarlılığın korunması gerekir.
2.8. Çok Değerli Nitelikler
Bir varlık için birden fazla değer alabilen nitelik çok değerli niteliktir.
Örneğin bir kişinin birden fazla telefon numarası olabilir.
İlişkisel tasarımda çok değerli nitelikler çoğunlukla ayrı tabloya dönüştürülür.
KISI
----
kisi_id
ad

KISI_TELEFON
------------
kisi_id
telefon
2.9. Birleşik Nitelikler
Alt niteliklerden oluşan özelliklere birleşik nitelik denir.
Örneğin adres:
- ülke,
- şehir,
- ilçe,
- mahalle,
- açık adres
bileşenlerine ayrılabilir.
Birleşik niteliğin nasıl saklanacağı sorgulama ve bütünlük gereksinimlerine göre belirlenir.
2.10. Rol
Aynı varlık kümesinin bir ilişki içinde farklı görevler üstlenmesi durumunda rol kavramı kullanılır.
Örneğin PERSONEL kümesindeki bir kişi yönetici, başka bir kişi çalışan rolünde olabilir.
PERSONEL -- YONETIR --> PERSONELBurada aynı varlık kümesi ilişkinin iki tarafında farklı rollerle bulunur.
2.11. Varlıkların Eşlendirilmesi
İki varlık kümesi arasındaki ilişkinin kardinalitesi temel olarak dört biçimde ele alınır.
2.12. Birden Bire İlişki
Bir A varlığı en fazla bir B varlığıyla, bir B varlığı da en fazla bir A varlığıyla ilişkilidir.
A 1 ----- 1 B2.13. Birden Çoğa İlişki
Bir A varlığı birden fazla B varlığıyla ilişkili olabilir. Her B varlığı en fazla bir A varlığına bağlıdır.
BOLUM 1 ----- N PERSONELİlişkisel tasarımda yabancı anahtar çoğunlukla N tarafında bulunur.
2.14. Çoktan Bire İlişki
Birden çoğa ilişkinin ters yönden görünümüdür.
PERSONEL N ----- 1 BOLUM2.15. Çoktan Çoğa İlişki
Bir A varlığı birden fazla B varlığıyla, bir B varlığı da birden fazla A varlığıyla ilişkili olabilir.
OGRENCI N ----- N DERSİlişkisel modele dönüşümde ara tablo gerekir.
OGRENCI_DERS
------------
ogrenci_id
ders_id
2.16. Varoluş Koşulu
Bir varlığın başka bir varlığın varlığına bağlı olup olmadığı tasarım açısından önemlidir.
Bir alt varlık üst varlık olmadan anlamlı değilse varoluş bağımlılığı söz konusudur.
Bu durum yabancı anahtarların NOT NULL, silme davranışları ve zayıf varlık tasarımı üzerinde etkili olabilir.
2.17. Anahtarlar
Anahtar, bir varlığı diğerlerinden ayırt etmeye yarayan nitelik veya nitelikler kümesidir.
2.18. Süper Anahtar
Bir kaydı benzersiz belirleyen herhangi bir nitelik kümesine süper anahtar denir.
Gereksiz nitelikler içerebilir.
{ogrenci_no}
{ogrenci_no, ad}
{ogrenci_no, ad, dogum_tarihi}
Öğrenci numarası tek başına benzersizse üçü de süper anahtar olabilir.
2.19. Aday Anahtar
İçinden herhangi bir nitelik çıkarıldığında benzersizlik özelliğini kaybeden minimal süper anahtar aday anahtardır.
Bir tabloda birden fazla aday anahtar bulunabilir.
Bunlardan biri birincil anahtar olarak seçilir.
2.20. Zayıf ve Kuvvetli Varlıklar
Kendi nitelikleriyle benzersiz biçimde tanımlanabilen varlık kuvvetli varlıktır.
Kimliği başka bir varlığın anahtarına bağımlı olan varlık zayıf varlık olarak ele alınabilir.
Örneğin sipariş satırı:
SIPARIS(siparis_id, ...)
SIPARIS_SATIR(siparis_id, satir_no, ...)
yapısında satir_no yalnız sipariş kapsamında anlamlı olabilir.
2.21. ER Şemaları
ER şeması varlıkları, nitelikleri, anahtarları, ilişkileri ve kardinaliteleri görsel biçimde ifade eder.
Şema hazırlanırken önce problem alanının kuralları belirlenmelidir. Diyagram, bu kuralların görsel sonucudur.
2.22. ER Modelinin Tablolara Dönüştürülmesi
Genel dönüşüm ilkeleri şöyledir:
- kuvvetli varlık -> tablo,
- basit nitelik -> sütun,
- birincil anahtar -> PRIMARY KEY,
- 1:N ilişki -> N tarafına FOREIGN KEY,
- N:N ilişki -> ara tablo,
- çok değerli nitelik -> ayrı tablo,
- zayıf varlık -> sahibinin anahtarını içeren tablo.
Dönüşüm yalnız mekanik bir işlem değildir. Bütünlük kuralları da tablo tasarımına aktarılmalıdır.
2.23. Genelleme, Özelleştirme, Kümeleme ve Yüksek Dereceli İlişkiler
ER modelinde yalnız varlık, nitelik ve ikili ilişki yeterli olmayabilir. Modelin semantiği aşağıdaki yapılarla daha doğru ifade edilebilir.
Genelleme/özelleştirme, ortak nitelik ve davranışları bir üst varlık türünde toplarken alt türlerin kendilerine özgü nitelikleri korumasını sağlar. İki ayrı kısıt birlikte düşünülmelidir:
- ayrık (disjoint) / örtüşen (overlapping): bir üst tür örneği kaç alt türe ait olabilir?
- tam (total) / kısmi (partial) katılım: her üst tür örneğinin bir alt türe ait olması zorunlu mudur?
Bu yapı ilişkisel modele aktarılırken tek tablo, üst tablo + alt tür tabloları veya yalnız somut alt tür tabloları gibi farklı fiziksel temsiller mümkündür. Seçim, bütünlük kuralı ile sorgu/yazma maliyetini birlikte etkiler.
Kümeleme (aggregation), bir ilişkinin kendisini daha üst düzey bir modelleme nesnesi gibi ele almayı sağlar. Örneğin Personel — ProjedeGörevli — Proje ilişkisine bir denetçinin onay vermesi gerekiyorsa, onay doğrudan yalnız Personel veya yalnız Proje ile değil, belirli görev ilişkisinin bütünüyle ilgili olabilir.
Üçlü veya daha yüksek dereceli ilişki, üç veya daha fazla varlığın aynı olgunun parçaları olduğu durumda kullanılır. Böyle bir ilişkiyi mekanik olarak birkaç ikili ilişkiye ayırmak, hangi üçlünün gerçekten birlikte var olduğu bilgisini kaybettirebilir. İlişkisel modele dönüşümde tipik çözüm, katılan varlıkların anahtarlarını ve ilişkinin kendi niteliklerini taşıyan ayrı bir ilişki/tablo oluşturmaktır.
ER'den ilişkisel şemaya dönüşümde temel eşlemeler şöyledir:
güçlü varlık      → kendi anahtarı olan tablo
zayıf varlık      → sahip anahtarı + ayırt edici nitelik
1:N ilişki        → çoğunlukla N tarafında yabancı anahtar
M:N ilişki        → iki anahtarı taşıyan ilişki tablosu
n-ary ilişki      → katılan anahtarları taşıyan ilişki tablosu
genelleme         → seçilen miras eşleme stratejisi
Dönüşümün amacı yalnız tablo üretmek değil; ER modelindeki kardinalite, varoluş ve kimlik kurallarını ilişkisel kısıtlarla mümkün olduğunca korumaktır.
Ünite 3: İlişkisel Veri Modeli
3.1. İlişkisel Model
İlişkisel model veriyi ilişkiler biçiminde ele alır. Uygulamada bir ilişki çoğunlukla tablo biçiminde gösterilir.
Bir ilişkinin:
- satırları tuple,
- sütunları attribute,
- sütun değer kümeleri domain
kavramlarına karşılık gelir.
İlişkisel modelin önemli özelliği verinin fiziksel yerleşiminden çok mantıksal yapısını temel almasıdır.
3.2. İlişkisel Veri Tabanı
Birbiriyle ilişkili tablolardan oluşan veri tabanına ilişkisel veri tabanı denir.
Örnek:
BOLUM(
    bolum_no,
    bolum_adi
)

PERSONEL(
    personel_no,
    ad,
    ucret,
    bolum_no
)PERSONEL.bolum_no, BOLUM.bolum_no değerine başvurarak iki tablo arasında ilişki kurabilir.
3.3. Tabloların Özellikleri
Kuramsal ilişkisel modelde:
- her satır aynı nitelik kümesine sahiptir,
- her hücre ilgili domain'den bir değer taşır,
- satır sırası anlam taşımaz,
- sütun sırası ilişkisel anlamın parçası değildir,
- yinelenen tuple'lar ilişki kavramında yer almaz.
SQL tabloları kuramsal ilişkiden bazı yönleriyle ayrılır. Örneğin SELECT sonucu DISTINCT kullanılmadıkça yinelenen satırlar içerebilir. Bu nedenle ilişkisel model ile SQL'in pratik davranışı aynı kavram olarak görülmemelidir.
3.4. Veri Tabanı Şeması
Şema, veri tabanının yapısal tanımıdır.
Tablo adları, sütunlar, veri tipleri, anahtarlar, sınırlamalar ve ilişkiler şemanın parçalarıdır.
Verinin kendisi değişebilir. Şema ise verinin hangi kurallara göre tutulacağını tanımlar.
3.5. Veri Tabanı Bütünlüğü
Bütünlük, veri tabanındaki verilerin tanımlanan kurallara uygun kalmasıdır.
Başlıca bütünlük alanları:
- anahtar bütünlüğü,
- varlık bütünlüğü,
- başvuru bütünlüğü,
- domain sınırlamaları,
- işletme kurallarıdır.
Bir ilişkisel tablonun birincil anahtarı, analizde hangi varlığın sayıldığını kendiliğinden anlatmaz. Örneğin işlem tablosunun anahtarı işlem kimliğiyken raporda istenen birim müşteri olabilir; aynı müşterinin birden fazla işlemi vardır. COUNT(*) ile COUNT(DISTINCT musteri_id) farklı soruları yanıtlar. İlişkilerde birden çoğa birleştirme, ölçülerin satır çoğalması nedeniyle yanlış toplanmasına yol açabilir. Rapor tasarımında önce sonuç satırının gözlem düzeyi (grain) yazılır; daha sonra her tablo için anahtar, kardinalite ve izin verilen birleştirme yönü belirlenir. Bu yöntem, aynı kaydın sessizce iki kere sayılmasına karşı yapısal koruma sağlar.
3.6. Birincil Anahtar
PRIMARY KEY, her satırı benzersiz tanımlar.
Birincil anahtar:
- benzersiz olmalıdır,
NULLolmamalıdır.
Örnek:
CREATE TABLE BOLUM (
    BOLUM_NO NUMBER PRIMARY KEY,
    BOLUM_ADI VARCHAR2(100) NOT NULL
);
3.7. Dış Anahtar
FOREIGN KEY, bir tablodaki değerin başka bir tablodaki aday veya birincil anahtarla ilişkilendirilmesini sağlar.
CREATE TABLE PERSONEL (
    PERSONEL_NO NUMBER PRIMARY KEY,
    AD VARCHAR2(100),
    BOLUM_NO NUMBER,
    CONSTRAINT FK_PERSONEL_BOLUM
        FOREIGN KEY (BOLUM_NO)
        REFERENCES BOLUM(BOLUM_NO)
);
Bu yapı başvuru bütünlüğünü sağlar.
3.8. Veri Değeri Sınırlamaları
Bir sütunun kabul edeceği değerler:
- veri tipi,
NOT NULL,CHECK,UNIQUE,- uygulama kuralları
ile sınırlandırılabilir.
UCRET NUMBER CHECK (UCRET >= 0)3.9. İşletme Kuralları
Her bütünlük kuralı yalnız veri tipinden çıkarılamaz.
Örneğin:
- bir öğrencinin dönem başına en fazla belirli sayıda ders alabilmesi,
- bir hesabın kapanması için bakiyesinin sıfır olması,
- belirli görevlerin yalnız belirli bölümlerde tanımlanabilmesi
işletme kurallarıdır.
Bu kurallar mümkün olduğunca uygun veri tabanı sınırlamaları ve uygulama mantığıyla birlikte ele alınmalıdır.
3.10. Nitelikler Arası Bağımlılıklar
Bir niteliğin başka bir niteliği belirlemesi veri tasarımının temel konularındandır.
personel_no -> ad, soyad, bolum_noBu ifade aynı personel_no değerinin tek bir personel bilgisini belirlediğini söyler.
Fonksiyonel bağımlılıklar normalleştirmenin temelidir.
Ünite 4: İlişkisel Veri Tabanı Tasarımı
Bir tablo tasarımının normalleştirilmesi, alanları mekanik biçimde bölmekten ibaret değildir. Önce fonksiyonel bağımlılıklar ve aday anahtarlar belirlenir; ardından ekleme, güncelleme ve silme anomalilerinin hangi bağımlılıktan doğduğu incelenir. Ayrıştırma sonrasında kayıpsız birleştirme ve mümkün olduğunda bağımlılıkların korunması kontrol edilir. Okuma performansı için sonradan yapılan bilinçli denormalizasyon, bu doğrulamanın yerine geçmez; ayrı bir tasarım kararı olarak gerekçelendirilmelidir.
4.1. Normalleştirme
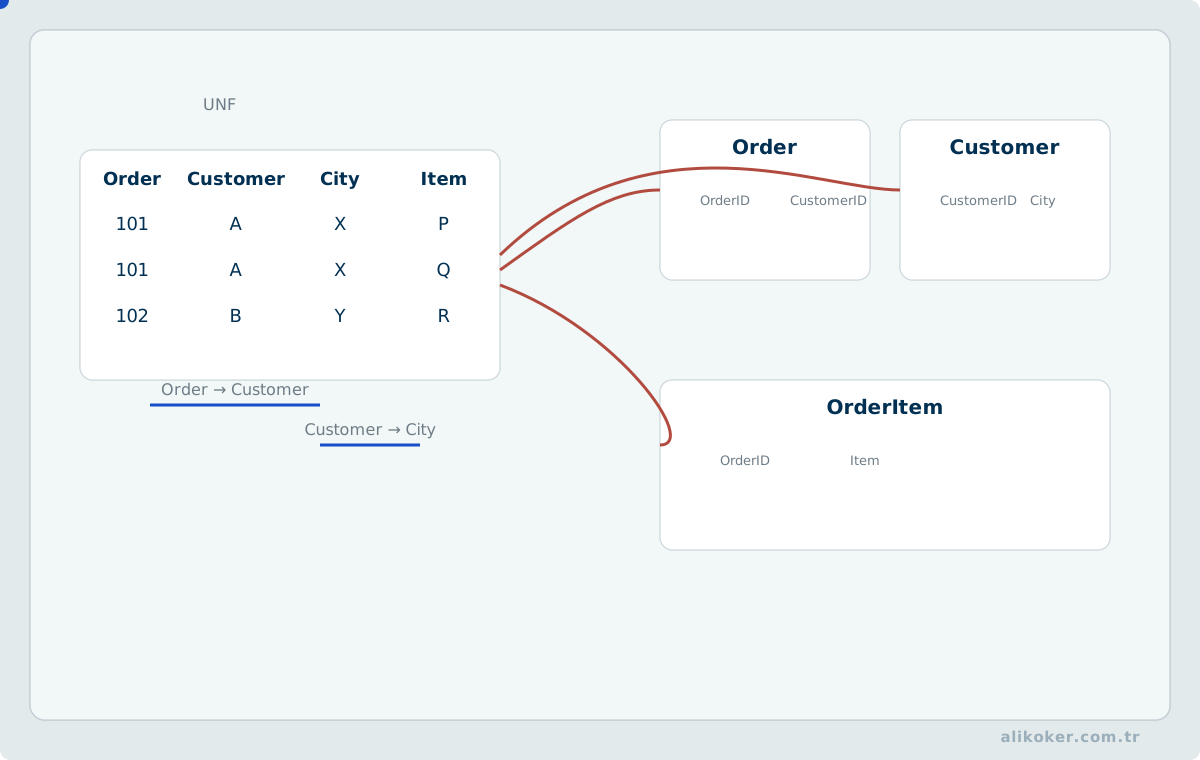
Normalleştirme, ilişkisel şemaları veri tekrarı ve güncelleme anomalilerini azaltacak biçimde düzenleme sürecidir.
Amaç bütün veriyi mümkün olan en fazla sayıda tabloya bölmek değildir. Amaç fonksiyonel ve çok değerli bağımlılıkları doğru temsil eden, kayıpsız ve anlamlı bir şema oluşturmaktır.
Kötü tasarım üç temel anomali üretir:
- ekleme anomalisi,
- silme anomalisi,
- güncelleme anomalisi.
4.2. Fonksiyonel Bağımlılık
Bir R ilişkisinde X niteliği veya nitelik kümesi Y'yi tekil biçimde belirliyorsa:
X -> Yfonksiyonel bağımlılığı vardır.
Örneğin:
personel_no -> ad
personel_no -> bolum_no
Aynı personel numarası iki farklı ad veya bölüm bilgisine karşılık gelmemelidir.
4.3. Tam ve Kısmi Bağımlılık
Bir birleşik anahtarın tamamına bağlı olan nitelik tam fonksiyonel bağımlıdır.
Nitelik birleşik anahtarın yalnız bir bölümüne bağlıysa kısmi bağımlılık vardır.
Örneğin:
KAYIT(ogrenci_no, ders_no, ogrenci_adi, not)anahtar (ogrenci_no, ders_no) ise:
ogrenci_no -> ogrenci_adi
(ogrenci_no, ders_no) -> not
ogrenci_adi birleşik anahtarın yalnız bir parçasına bağlıdır.
4.4. Birinci Normal Form
Bir ilişki 1NF'de ise her sütun konumunda tek bir değer bulunur. Tek hücre içinde tekrarlayan grup veya çoklu değer listesi tutulmaz.
Uygun olmayan:
OGRENCI
ogrenci_no | telefonlar
1          | 555..., 532...
Daha uygun:
OGRENCI(ogrenci_no, ...)
OGRENCI_TELEFON(ogrenci_no, telefon)
4.5. Birinci Normal Formun Sorunları
1NF atomik değer sorununu çözer ancak fonksiyonel bağımlılık sorunlarını tek başına çözmez.
Tekrarlanan bölüm adı, personel bilgisi veya ders bilgisi güncelleme anomalilerine yol açabilir.
4.6. İkinci Normal Form
Bir ilişki 2NF'de olabilmek için:
- 1NF'de olmalıdır.
- Anahtar olmayan her nitelik, her aday anahtarın tamamına bağımlı olmalıdır.
2NF özellikle birleşik anahtarlardaki kısmi bağımlılıkları ortadan kaldırır.
4.7. İkinci Normal Formun Sorunları
2NF'ye ulaşıldığında kısmi bağımlılıklar giderilir. Ancak anahtar olmayan nitelikler arasında geçişli bağımlılıklar kalabilir.
Örneğin:
PERSONEL(
    personel_no,
    bolum_no,
    bolum_adi
)
personel_no -> bolum_no
bolum_no -> bolum_adiBurada bolum_adi, personel_no üzerinden geçişli biçimde belirlenir.
4.8. Üçüncü Normal Form
Bir ilişki 3NF'de olduğunda anahtar olmayan niteliklerin anahtara uygunsuz geçişli bağımlılıkları giderilmiştir.
Yukarıdaki örnek:
PERSONEL(personel_no, bolum_no)
BOLUM(bolum_no, bolum_adi)
biçiminde ayrılabilir.
4.9. Boyce-Codd Normal Formu
BCNF, 3NF'den daha güçlü bir koşuldur.
Her anlamlı fonksiyonel bağımlılıkta belirleyici tarafın bir süper anahtar olması beklenir.
Kısaca:
X -> Ytrivial olmayan bir bağımlılıksa X bir süper anahtar olmalıdır.
BCNF özellikle birden fazla örtüşen aday anahtarın bulunduğu yapılarda 3NF'nin bıraktığı bazı anomalileri giderir.
4.10. Dördüncü Normal Form
4NF çok değerli bağımlılıklarla ilgilidir.
Bir varlığa ait birbirinden bağımsız iki çok değerli bilgi aynı tabloda tutulduğunda gereksiz Kartezyen tekrar oluşabilir.
Örneğin bir öğretim üyesinin:
- uzmanlık alanları,
- konuştuğu yabancı diller
birbirinden bağımsız çok değerli bilgilerse ayrı ilişkilerde tutulmaları daha uygundur.
4.11. Beşinci Normal Form
5NF bir tablonun daha küçük ilişkilere ayrılıp tekrar birleştirilmesiyle oluşan join dependency problemleriyle ilgilidir.
Pratik uygulamalarda 1NF, 2NF, 3NF ve BCNF daha sık karşılaşılan konulardır. 4NF ve 5NF daha özel bağımlılık yapılarını ele alır.
4.12. Normalleştirme ve Performans
Normalleştirme veri bütünlüğü için temel bir tasarım aracıdır. Ancak bazı okuma ağırlıklı sistemlerde bilinçli denormalizasyon uygulanabilir.
Denormalizasyon ancak:
- tekrarın maliyeti biliniyorsa,
- tutarlılık mekanizması tanımlıysa,
- ölçülmüş performans ihtiyacı varsa
yapılmalıdır.
Önce doğru model, sonra ölçüme dayalı optimizasyon yaklaşımı daha güvenlidir.
Mantıksal bütünlük ile fiziksel erişim yolunu karşı karşıya koymamak. Normalizasyon güncelleme anomalilerini azaltan bir veri modeli kararıdır; pahalı bir sorgunun varlığı otomatik olarak denormalizasyon gerektirmez. Önce filtre ve join koşullarının seçiciliği, döndürülen sütun/satır sayısı, uygun indeksler ve istatistikler incelenmelidir. Denormalizasyon düşünülürse tutulan tekrar alanların nasıl güncelleneceği, hangi transaction sınırında tutarlı kalacağı ve geri doldurma (backfill) işleminin nasıl yapılacağı tasarımın parçasıdır.
Aynı sorgunun indeksli ve indekssiz planı karşılaştırılırken yalnız elapsed time yeterli değildir. Okunan sayfa veya buffer sayısı, döndürülen gerçek satır sayısı, cardinality kestirim hatası ve indeksin her INSERT/UPDATE/DELETE işlemine yüklediği maliyet birlikte değerlendirilir. İş yükü ağırlıklı olarak yazma içeriyorsa, tekil SELECT kazancı toplam sistem için kayıp doğurabilir. Dolayısıyla optimizasyon kararı, tek SQL ifadesinden değil okuma/yazma karışımından türetilmelidir.
4.13. İşlevsel Bağımlılıkların Çıkarımı, Kapanış ve Kanonik Örtü
Fonksiyonel bağımlılıkları yalnız örnek veri üzerinden gözlemek normalizasyon için yeterli değildir. Tasarım, alanın değişmez kurallarını bağımlılık biçiminde ifade etmeli ve bu kurallardan hangi başka bağımlılıkların çıkarılabildiğini sistematik olarak belirlemelidir.
Bir bağımlılık kümesi F için **F+ kapanışı**, F'den mantıksal olarak çıkarılabilen tüm fonksiyonel bağımlılıkları ifade eder. Pratikte bütün F+ kümesini üretmek yerine çoğu zaman bir nitelik kümesinin kapanışı hesaplanır:
X+ = F altında X tarafından işlevsel olarak belirlenebilen niteliklerX+ bütün ilişki niteliklerini içeriyorsa X bir süper anahtardır; X'in hiçbir öz altkümesi aynı özelliği taşımıyorsa aday anahtar elde edilir.
Bağımlılık çıkarımının klasik temel kuralları Armstrong aksiyomlarıdır:
- Yansıma (reflexivity):
Y ⊆ XiseX → Y. - Genişletme (augmentation):
X → YiseXZ → YZ. - Geçişlilik (transitivity):
X → YveY → ZiseX → Z.
Bu aksiyomlardan birleşim, ayrıştırma ve sözde geçişlilik gibi türetilmiş kurallar elde edilir.
Bir bağımlılık kümesinin kanonik/minimal örtüsü, aynı kapanışı üreten fakat gereksiz bağımlılık ve gereksiz nitelik içermeyen daha küçük bir temsilidir. 3NF sentezi gibi algoritmalarda bu temsil, şema üretimini daha sistematik hale getirir.
4.14. Ayrıştırmanın Doğruluğu: Yitimsiz Birleştirme ve Bağımlılık Koruma
Normalizasyonun amacı bir tabloyu mümkün olduğunca çok parçaya bölmek değildir. Bir ayrıştırmanın en az iki ayrı doğruluk özelliği değerlendirilmelidir.
Yitimsiz birleştirme (lossless join), ayrıştırılan ilişkiler doğal olarak birleştirildiğinde özgün ilişkinin sahte satırlar üretmeden geri elde edilebilmesini ister. İkili bir ayrıştırma R → R1, R2 için ortak niteliklerin en az bir parçayı işlevsel olarak belirlemesi, sık kullanılan yitimsizlik ölçütlerinden biridir:
(R1 ∩ R2) → R1
veya
(R1 ∩ R2) → R2
Bağımlılık koruma (dependency preservation) ise özgün fonksiyonel bağımlılıkların ayrıştırılmış tablolar üzerinde ayrı ayrı denetlenebilmesini hedefler. Bu özellik yitimsizlikten farklıdır: bir ayrıştırma yitimsiz olduğu halde bazı bağımlılıkların denetimi için tabloların yeniden birleştirilmesi gerekebilir.
Bu ayrım 3NF ile BCNF arasındaki gerçek mühendislik gerilimini açıklar:
- BCNF daha güçlü bir determinant koşulu getirerek güncelleme aykırılıklarını azaltabilir.
- BCNF ayrıştırması yitimsiz yapılabilse de bağımlılık korumayı her durumda garanti etmez.
- 3NF sentezi, uygun biçimde uygulandığında yitimsizliği ve bağımlılık korumayı birlikte sağlayabilir; bunun karşılığında bazı şemalar BCNF kadar sıkı olmayabilir.
Dolayısıyla tasarım kararı yalnız "en yüksek normal forma çık" değildir. Korunması gereken invariant'lar, bunların hangi tabloda denetlenebildiği ve üretim sorgularının maliyeti birlikte değerlendirilmelidir.
Çok değerli bağımlılık da yalnız 4NF tanımının ezberlenmesi için değil, birbirinden bağımsız çok-değerli olguların aynı tabloda tutulmasının neden gereksiz çapraz kombinasyonlar ürettiğini anlamak için kullanılır. 4NF, anlamlı çok-değerli bağımlılıklarda determinantın süper anahtar olmasını isteyerek bu sorunu sınırlar.
İşlevsel bağımlılıktan normal biçim kararına geçmek. SiparişSatırı(SiparişNo, ÜrünNo, MüşteriNo, MüşteriAdı, Miktar) ilişkisinde bir siparişin tek müşteriye ait olduğu, ürünün sipariş içinde tek satırla temsil edildiği varsayılsın. Aday anahtar (SiparişNo, ÜrünNo) iken SiparişNo → MüşteriNo, MüşteriNo → MüşteriAdı ve (SiparişNo, ÜrünNo) → Miktar bağımlılıkları vardır. Müşteri adı bu tabloda tekrarlandığında isim değişikliği birden çok satırın güncellenmesini gerektirir; ayrıca siparişten bağımsız bir müşteri kaydı tutmak güçleşir. Ayrıştırma için Müşteri(MüşteriNo, MüşteriAdı), Sipariş(SiparişNo, MüşteriNo) ve SiparişSatırı(SiparişNo, ÜrünNo, Miktar) tabloları seçilebilir. Doğrulama, yalnız sütun sayısını azaltmak değil; anahtarları, gerekli yabancı anahtarları, kayıpsız birleştirmeyi ve korunması gereken iş kurallarını denetlemektir. Aynı siparişte aynı ürünün birden fazla satırda bulunması gerekiyorsa aday anahtar varsayımı değiştirilmelidir.
Ünite 5: İlişkisel Cebir
5.1. İlişkisel Cebir Kavramı
İlişkisel cebir, ilişkiler üzerinde çalışan ve sonuç olarak yine ilişki üreten işlemler bütünüdür.
SQL'in kuramsal temelini anlamak için önemlidir.
Temel işlemler:
- seçim,
- izdüşüm,
- Kartezyen çarpım,
- birleşim,
- kesişim,
- fark,
- doğal birleştirme,
- bölmedir.
5.2. Seçim
Seçim, belirli koşulu sağlayan satırları elde eder.
sigma kosul (R)SQL karşılığı çoğunlukla WHERE koşuludur.
SELECT *
FROM PERSONEL
WHERE UCRET > 50000;
5.3. İzdüşüm
Atma olarak da adlandırılan işlem, ilişkisel cebirde projection, yani izdüşümdür.
Belirli sütunları seçer.
SELECT AD, UCRET
FROM PERSONEL;
5.4. Kartezyen Çarpım
İki ilişkinin bütün satır kombinasyonlarını üretir.
R ilişkisi m, S ilişkisi n satır içeriyorsa:
|R x S| = m * nolabilir.
Birleştirme koşulu unutulduğunda istenmeyen büyük ara sonuçlar üretilebilir.
5.5. Birleşim
İki uyumlu ilişkinin satırlarını tek sonuçta toplar.
SQL'de:
SELECT ...
FROM A
UNION
SELECT ...
FROM B;
UNION tekrarları kaldırır. UNION ALL tekrarları korur.
5.6. Kesişim
Her iki ilişkide de bulunan satırları üretir.
Oracle SQL'de INTERSECT kullanılır.
5.7. Fark
Birinci ilişkide bulunup ikinci ilişkide bulunmayan satırları üretir.
Oracle SQL'de geleneksel olarak MINUS işleci kullanılır.
5.8. Doğal Birleştirme
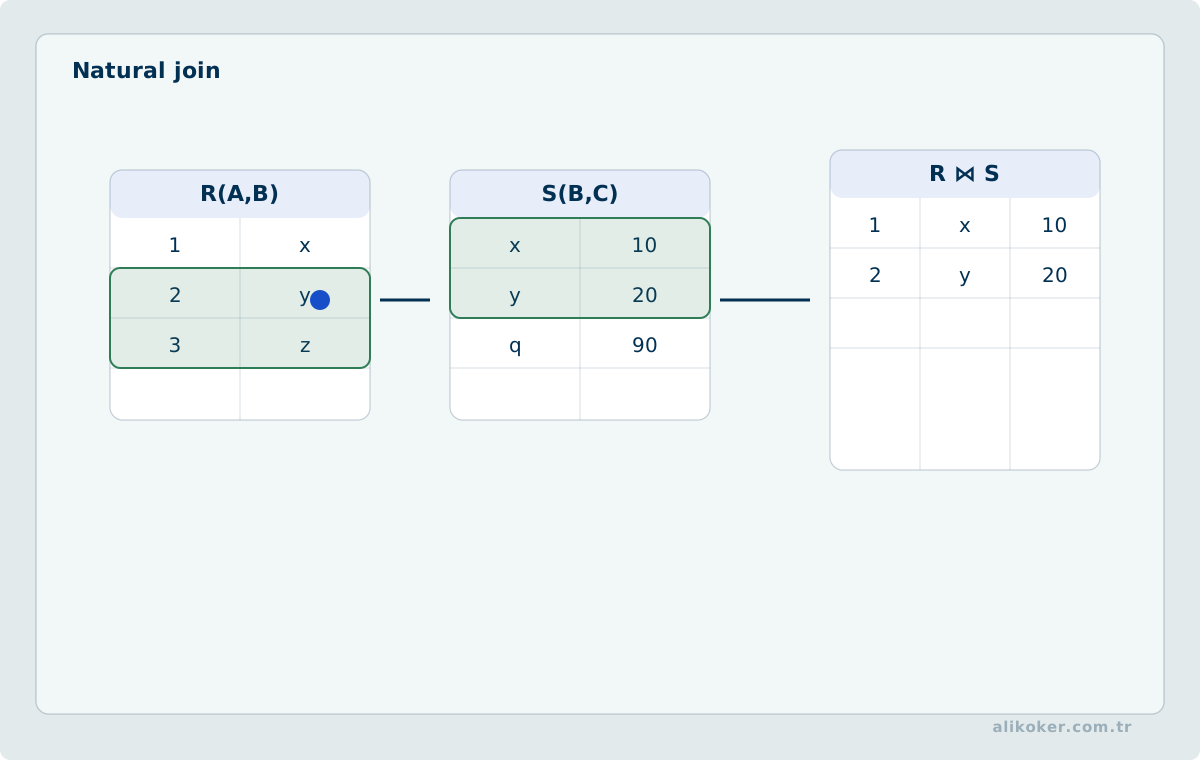
Doğal birleştirme aynı ad ve uyumlu anlamdaki sütunlar üzerinden ilişkileri birleştirir.
Pratik SQL'de birleştirme koşulunun açık yazılması çoğu zaman daha okunabilir ve daha güvenlidir.
SELECT P.AD, B.BOLUM_ADI
FROM PERSONEL P
JOIN BOLUM B
  ON B.BOLUM_NO = P.BOLUM_NO;
5.9. Bölme
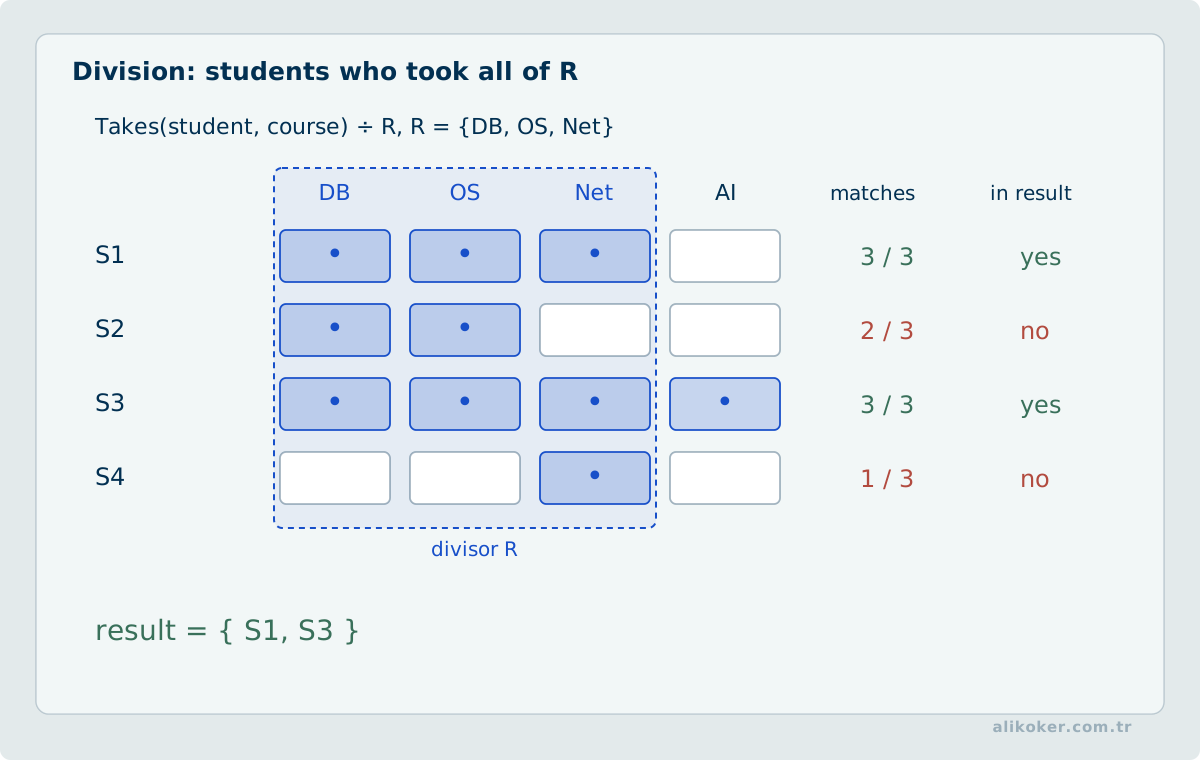
Bölme, "tümüne sahip olanları bul" tipindeki sorguları modellemek için kullanılır.
Örneğin tüm zorunlu dersleri alan öğrencileri bulma problemi bölme düşüncesiyle ifade edilebilir.
SQL'de doğrudan DIVIDE işleci bulunmaz. Problem genellikle NOT EXISTS, gruplama veya alt sorgularla çözülür.
5.10. İlişkisel Hesabın Mantıksal Temeli
İlişkisel cebir sorguyu işlemler dizisi olarak ifade ederken, ilişkisel hesap istenen sonuç kümesini mantıksal bir koşul olarak tanımlar. Bu ayrım SQL'in bildirimsel doğasını anlamak için önemlidir.
İlişkisel hesapta temel mantıksal araçlar şunlardır:
∃— varlıksal niceleyici: koşulu sağlayan en az bir değer vardır.∀— tümel niceleyici: koşul ilgili bütün değerler için sağlanır.¬,∧,∨— değilleme, ve, veya.- bağlı değişken: bir niceleyicinin kapsamındadır.
- serbest değişken: sorgunun sonuç değerini temsil edebilir.
Örneğin "en az bir açık siparişi bulunan müşteriler" varlıksal niceleyiciyle; "zorunlu bütün eğitimleri tamamlayan personel" ise tümel niceleyiciyle ifade edilebilir. İkinci tür sorgular SQL'de çoğu zaman NOT EXISTS ile karşı-örneğin bulunmadığını söyleyerek yazılır.
İlişkisel cebir ile ilişkisel hesap farklı gösterim biçimleri sunar; ilişkisel veri tabanı teorisinin temel sonucu, güvenli/belirli sorgu sınıflarında aynı ilişkisel soruların iki yaklaşımda da ifade edilebilmesidir. Pratik SQL kullanıcısı cebirsel operatörleri fiziksel yürütme planını anlamak, mantıksal niceleyicileri ise sorgunun neyi tanımladığını açıklaştırmak için kullanabilir.
Tarihsel eğitim dillerindeki RANGE ve GET benzeri sözdizimleri, ilişkisel hesabın somutlaştırılması açısından önem taşır; güncel SQL'in yerine geçen taşınabilir bir standart sözdizimi olarak değerlendirilmemelidir.
Ünite 6: SQL Yapısal Sorgulama Dili
6.1. SQL'in Rolü
SQL ilişkisel veri tabanlarında:
- veri tanımlama,
- veri sorgulama,
- veri değiştirme,
- yetkilendirme,
- işlem yönetimi
amaçlarıyla kullanılır.
SQL bildirimseldir. Kullanıcı çoğunlukla hangi sonucu istediğini belirtir. Sonucun fiziksel olarak nasıl elde edileceğine sorgu eniyileyicisi karar verir.
6.2. SELECT Deyiminin Yapısı
Temel yapı:
SELECT [DISTINCT] sutunlar
FROM tablo
WHERE kosul
ORDER BY sutunlar;
Bütün sütunları seçmek için:
SELECT *
FROM PERSONEL;
Belirli sütunları seçmek için:
SELECT PERSONEL_NO, AD, UCRET
FROM PERSONEL;
6.3. SELECT Yazım Kuralları
SQL anahtar sözcükleri çoğu sistemde büyük-küçük harfe duyarlı değildir. Ancak karakter verileri, tırnaklı tanımlayıcılar ve karşılaştırmalar sistem ayarlarına bağlı olarak farklı davranabilir.
Okunabilir sorgularda her ana bölümün ayrı satıra yazılması yararlıdır:
SELECT PERSONEL_NO, AD, UCRET
FROM PERSONEL
WHERE BOLUM_NO = 20
ORDER BY AD;
6.4. Aritmetik İfadeler
Sayısal sütunlar sorgu içinde hesaplamalarda kullanılabilir.
SELECT AD, UCRET * 12 AS YILLIK_UCRET
FROM PERSONEL;
6.5. İşlem Sırası
Aritmetik ifadelerde matematiksel öncelik kuralları geçerlidir.
* ve /
+ ve -
Parantezler değerlendirme sırasını açık hale getirir.
SELECT 12 * (UCRET + 500)
FROM PERSONEL;
6.6. NULL Değeri
NULL:
- sıfır değildir,
- boş metin kavramıyla genel olarak aynı değildir,
- bilinmeyen veya mevcut olmayan değeri temsil eder.
Bir aritmetik işlem NULL içerirse sonuç çoğunlukla NULL olur.
SELECT UCRET + KOMISYON
FROM PERSONEL;
KOMISYON NULL ise sonuç da NULL olabilir.
Oracle'da NVL ile alternatif değer verilebilir:
SELECT UCRET + NVL(KOMISYON, 0)
FROM PERSONEL;
6.7. Sütun Takma Adları
Sorgu sonucu için sütun adı değiştirilebilir.
SELECT UCRET * 12 AS YILLIK_UCRET
FROM PERSONEL;
Takma ad sonuç kümesinin okunabilirliğini artırır.
6.8. Sütun İçeriklerini Birleştirme
Oracle SQL'de karakter birleştirme için || kullanılabilir.
SELECT AD || ' ' || SOYAD AS AD_SOYAD
FROM PERSONEL;
6.9. Yinelenen Satırlar
DISTINCT, aynı sonucu veren tekrar satırlarını kaldırır.
SELECT DISTINCT BOLUM_NO
FROM PERSONEL;
DISTINCT gereksiz kullanılırsa ek sıralama veya hash maliyeti oluşturabilir. Yalnız semantik olarak gerekiyorsa kullanılmalıdır.
6.10. Verinin Sınırlandırılması
WHERE, sonuç kümesine alınacak satırları belirler.
SELECT *
FROM PERSONEL
WHERE UCRET > 50000;
6.11. Karşılaştırma İşleçleri
Temel karşılaştırmalar:
=
<>
>
<
>=
<=
Oracle SQL'de != de eşit olmama amacıyla kullanılabilir.
6.12. BETWEEN
Aralık denetimi:
SELECT *
FROM PERSONEL
WHERE UCRET BETWEEN 40000 AND 60000;
Sınırlar dahildir.
6.13. IN
Bir değerin belirli kümedeki değerlerden biri olup olmadığını denetler.
SELECT *
FROM PERSONEL
WHERE BOLUM_NO IN (10, 20, 30);
6.14. LIKE
Metinsel örüntü araması için kullanılır.
SELECT *
FROM PERSONEL
WHERE AD LIKE 'A%';
Yaygın jokerler:
%: sıfır veya daha fazla karakter,_: tek karakter.
6.15. IS NULL
NULL değeri = ile sınanmaz.
Yanlış:
WHERE KOMISYON = NULLDoğru:
WHERE KOMISYON IS NULLveya:
WHERE KOMISYON IS NOT NULL6.16. Mantıksal İşleçler
Koşullar:
AND,OR,NOT
ile birleştirilebilir.
SELECT *
FROM PERSONEL
WHERE BOLUM_NO = 20
  AND UCRET > 50000;
Karmaşık ifadelerde parantez kullanmak mantıksal önceliği açık hale getirir.
6.17. Sıralama
ORDER BY sonuç kümesinin sırasını belirler.
SELECT AD, UCRET
FROM PERSONEL
ORDER BY UCRET DESC, AD ASC;
İlişkisel modelde satırların doğal sırası yoktur. Belirli sıra gerekiyorsa ORDER BY açıkça kullanılmalıdır.
Ünite 7: SQL Fonksiyonları
7.1. Fonksiyon Kavramı
Fonksiyon, girdiler üzerinde işlem yapıp değer üreten yapıdır.
SQL fonksiyonları:
- tek satır fonksiyonları,
- grup fonksiyonları
olarak ele alınabilir.
7.2. Karakter Fonksiyonları
7.2.1. LOWER ve UPPER
SELECT LOWER(AD), UPPER(SOYAD)
FROM PERSONEL;
Büyük-küçük harf dönüşümü yapar.
7.2.2. LENGTH
Metnin karakter uzunluğunu verir.
SELECT AD, LENGTH(AD)
FROM PERSONEL;
7.3. Sayısal Fonksiyonlar
7.3.1. ROUND
Sayıyı belirtilen basamağa yuvarlar.
SELECT ROUND(123.456, 2)
FROM DUAL;
7.3.2. TRUNC
Oracle'da sayının belirli basamaktan sonrasını kesmek için kullanılabilir.
SELECT TRUNC(123.456, 2)
FROM DUAL;
7.3.3. MOD
Kalan hesaplar.
SELECT MOD(10, 3)
FROM DUAL;
7.4. Tarih Fonksiyonları
Oracle tarih işlemlerinde çeşitli fonksiyonlar sağlar.
SYSDATE, veri tabanı sunucusunun tarih ve zaman bilgisini verir.
SELECT SYSDATE
FROM DUAL;
İki tarih arasındaki ay farkı:
SELECT MONTHS_BETWEEN(SYSDATE, GIRIS_TARIHI)
FROM PERSONEL;
Tarihe ay eklemek:
SELECT ADD_MONTHS(GIRIS_TARIHI, 6)
FROM PERSONEL;
Ayın son günü:
SELECT LAST_DAY(GIRIS_TARIHI)
FROM PERSONEL;
7.5. Dönüştürme Fonksiyonları
7.5.1. TO_CHAR
Sayı veya tarih değerini metne dönüştürür.
SELECT TO_CHAR(GIRIS_TARIHI, 'YYYY-MM')
FROM PERSONEL;
7.5.2. TO_NUMBER
Metinsel sayıyı sayısal değere dönüştürür.
SELECT TO_NUMBER('1250')
FROM DUAL;
7.5.3. TO_DATE
Metni tarih değerine dönüştürür.
SELECT TO_DATE('2014-11-09', 'YYYY-MM-DD')
FROM DUAL;
Tarih dönüşümlerinde örtük dönüşüme güvenmek yerine formatın açık belirtilmesi daha güvenlidir.
7.6. Genel Fonksiyonlar
7.6.1. NVL
Oracle'a özgü NVL, NULL değer yerine alternatif değer döndürür.
SELECT NVL(KOMISYON, 0)
FROM PERSONEL;
7.6.2. DECODE
DECODE, Oracle'a özgü koşullu dönüştürme fonksiyonudur.
SELECT DECODE(BOLUM_NO,
              10, 'YONETIM',
              20, 'TEKNIK',
              'DIGER')
FROM PERSONEL;
Yeni kodlarda standart SQL'e daha yakın olan CASE ifadesi çoğu durumda daha okunabilir bir alternatiftir.
7.7. İç İçe Fonksiyonlar
Fonksiyonların çıktısı başka fonksiyonların girdisi olabilir.
SELECT UPPER(TRIM(AD))
FROM PERSONEL;
İç fonksiyon önce değerlendirilir.
Ünite 8: Verileri Gruplayarak Analiz Etmek
8.1. Grup Fonksiyonları
Grup fonksiyonları birden fazla satırı tek bir özet değere dönüştürür.
Başlıca fonksiyonlar:
AVG,SUM,STDDEV,VARIANCE,MAX,MIN,COUNT.
Toplulaştırma işlemi bilgi kaybını bilinçli olarak yönetmelidir. Örneğin iki birimde 10 örneğin ortalaması 90, 90 örneğin ortalaması 50 ise iki ortalamanın basit ortalaması 70'tir; fakat toplam 100 örnek üzerinden birleşik ortalama (10×90 + 90×50)/100 = 54 olur. Grup ortalamalarını yeniden birleştirirken grup büyüklükleri ya da yeterli özet istatistikler saklanmadıysa doğru toplam her zaman geri kurulamaz. NULL, sıfır ve uygulanamaz değerleri tek kodda birleştirmek de payda anlamını değiştirir. Bu nedenle veri ambarında her gösterge için toplama kuralı, eksiklik semantiği ve yeniden toplulaştırılabilirlik sınırı açık tutulmalıdır.
8.2. AVG
SELECT AVG(UCRET)
FROM PERSONEL;
Ortalama değeri üretir.
8.3. SUM
SELECT SUM(UCRET)
FROM PERSONEL;
Toplamı üretir.
8.4. STDDEV ve VARIANCE
Dağılımın ölçülmesinde standart sapma ve varyans hesaplanabilir.
SELECT STDDEV(UCRET), VARIANCE(UCRET)
FROM PERSONEL;
8.5. MAX ve MIN
SELECT MAX(UCRET), MIN(UCRET)
FROM PERSONEL;
En büyük ve en küçük değerleri verir.
8.6. COUNT
SELECT COUNT(*)
FROM PERSONEL;
Satır sayısını verir.
SELECT COUNT(KOMISYON)
FROM PERSONEL;
yalnız KOMISYON değeri NULL olmayan satırları sayar.
8.7. GROUP BY
Verileri belirli sütunlara göre gruplar.
SELECT BOLUM_NO, AVG(UCRET)
FROM PERSONEL
GROUP BY BOLUM_NO;
Gruplama yapılmış bir sorguda seçilen normal sütunlar genellikle GROUP BY içinde bulunmalıdır.
8.8. Birden Fazla Sütuna Göre Gruplama
SELECT BOLUM_NO, GOREV, AVG(UCRET)
FROM PERSONEL
GROUP BY BOLUM_NO, GOREV;
Her farklı (BOLUM_NO, GOREV) birleşimi ayrı grup oluşturur.
8.9. HAVING
WHERE satırları gruplamadan önce süzer.
HAVING gruplar oluştuktan sonra grup sonuçlarını süzer.
SELECT BOLUM_NO, AVG(UCRET)
FROM PERSONEL
GROUP BY BOLUM_NO
HAVING AVG(UCRET) > 50000;
Ünite 9: Çoklu Tablolar
9.1. Çoklu Tabloların Kullanımı
Veri normalleştirildiğinde bilgi birden fazla tabloya dağılır. Sorgu sırasında bu tablolar yeniden ilişkilendirilir.
9.2. Tabloların Birleştirilmesi
Modern SQL'de açık JOIN sözdizimi tercih edilir.
SELECT P.AD, B.BOLUM_ADI
FROM PERSONEL P
JOIN BOLUM B
  ON B.BOLUM_NO = P.BOLUM_NO;
9.3. Kartezyen Çarpım
Birleştirme koşulu olmadan iki tablonun bütün satır kombinasyonları üretilebilir.
SELECT *
FROM PERSONEL
CROSS JOIN BOLUM;
Çoğu iş sorgusunda bu sonuç istenmez.
9.4. Eşiti Olan Birleştirme
Birleştirme koşulunda eşitlik kullanılır.
ON P.BOLUM_NO = B.BOLUM_NOEn yaygın join türüdür.
9.5. Sütun İsimlerindeki Belirsizlik
İki tabloda aynı isimli sütun bulunuyorsa tablo adı veya takma adı kullanılmalıdır.
SELECT P.BOLUM_NO, B.BOLUM_ADI
FROM PERSONEL P
JOIN BOLUM B
  ON B.BOLUM_NO = P.BOLUM_NO;
9.6. Tablo Takma Adları
Takma ad sorguyu kısaltır ve özellikle self join gibi yapılarda zorunlu hale gelebilir.
PERSONEL P
BOLUM B
9.7. Eşiti Olmayan Birleştirme
Birleştirme koşulu yalnız eşitlik olmak zorunda değildir.
Örneğin ücretin belirli aralığa düştüğü ücret sınıfını bulmak için aralık karşılaştırması yapılabilir.
9.8. Dış Birleştirme
INNER JOIN yalnız eşleşen satırları döndürür.
Dış birleştirmeler eşleşmeyen tarafı da sonuçta tutabilir:
LEFT OUTER JOIN,RIGHT OUTER JOIN,FULL OUTER JOIN.
SELECT B.BOLUM_ADI, P.AD
FROM BOLUM B
LEFT JOIN PERSONEL P
  ON P.BOLUM_NO = B.BOLUM_NO;
Personeli olmayan bölümler de listelenir.
9.9. Kendine Birleştirme
Bir tablo kendisiyle birleştirilebilir.
Örneğin personel-yönetici ilişkisi:
SELECT P.AD AS PERSONEL,
       Y.AD AS YONETICI
FROM PERSONEL P
LEFT JOIN PERSONEL Y
  ON Y.PERSONEL_NO = P.YONETICI_NO;
9.10. UNION ve UNION ALL
UNION iki sorgu sonucunu birleştirir ve tekrarları kaldırır.
UNION ALL tekrarları korur.
Sorguların sütun sayıları ve karşılık gelen veri tipleri uyumlu olmalıdır.
9.11. INTERSECT
İki sorguda ortak olan sonuçları döndürür.
9.12. MINUS
Oracle SQL'de ilk sorguda olup ikinci sorguda olmayan satırları döndürür.
Ünite 10: Karmaşık Sorgular
10.1. Alt Sorgu Kavramı
Başka bir SQL deyimi içinde kullanılan sorguya alt sorgu denir.
SELECT AD, UCRET
FROM PERSONEL
WHERE UCRET > (
    SELECT UCRET
    FROM PERSONEL
    WHERE PERSONEL_NO = 110
);
İç sorgunun sonucu dış sorgunun koşulunda kullanılır.
10.2. Alt Sorgu Düzenleme Kuralları
Alt sorgunun döndürdüğü satır ve sütun sayısı, dış sorgunun kullandığı işleçle uyumlu olmalıdır.
Tek değer bekleyen:
=
>
<
>=
<=
gibi işleçlerin karşısında alt sorgunun birden fazla satır üretmesi hata oluşturur.
10.3. Tek Satır Alt Sorguları
Tek satır alt sorgusu en fazla bir satır döndürür.
WHERE UCRET > (
    SELECT AVG(UCRET)
    FROM PERSONEL
)
Grup fonksiyonu GROUP BY olmadan tek satır üretebilir.
10.4. Grup Fonksiyonlarının Kullanımı
Alt sorgular özet değer üretmek için kullanılabilir.
SELECT AD, UCRET
FROM PERSONEL
WHERE UCRET > (
    SELECT AVG(UCRET)
    FROM PERSONEL
);
10.5. HAVING ile Alt Sorgu
Gruplar başka bir sorgudan elde edilen değerle karşılaştırılabilir.
SELECT BOLUM_NO, MIN(UCRET)
FROM PERSONEL
GROUP BY BOLUM_NO
HAVING MIN(UCRET) > (
    SELECT MIN(UCRET)
    FROM PERSONEL
    WHERE BOLUM_NO = 20
);
10.6. Çok Satırlı Alt Sorgular
Birden fazla satır döndüren alt sorgularda uygun işleç kullanılmalıdır.
10.7. IN
WHERE BOLUM_NO IN (
    SELECT BOLUM_NO
    FROM BOLUM
    WHERE KONUM = 'ANKARA'
)
10.8. ANY
Koşulun alt sorgudan dönen değerlerden en az biriyle sağlanması yeterlidir.
UCRET > ANY (...)10.9. ALL
Koşulun alt sorgudan dönen bütün değerler için sağlanması gerekir.
UCRET > ALL (...)10.10. Çok Sütunlu Alt Sorgular
Birden fazla sütun birlikte karşılaştırılabilir.
SELECT AD, GOREV, UCRET
FROM PERSONEL
WHERE (GOREV, UCRET) IN (
    SELECT GOREV, UCRET
    FROM PERSONEL
    WHERE AD = 'SEZIN'
);
10.11. FROM İçinde Alt Sorgu
Alt sorgu geçici ilişkisel sonuç olarak FROM bölümünde kullanılabilir.
SELECT X.BOLUM_NO, X.ORT_UCRET
FROM (
    SELECT BOLUM_NO, AVG(UCRET) AS ORT_UCRET
    FROM PERSONEL
    GROUP BY BOLUM_NO
) X
WHERE X.ORT_UCRET > 50000;
Bu yapı inline view olarak da anılır.
Ünite 11: DML ve Hareket İşleme
11.1. DML Kavramı
DML, veri tabanındaki satırları değiştiren SQL işlemlerini ifade eder.
Temel deyimler:
INSERT,UPDATE,DELETE.
11.2. Satır Ekleme
INSERT INTO BOLUM (
    BOLUM_NO,
    BOLUM_ADI,
    KONUM
)
VALUES (
    70,
    'EGITIM',
    'ANKARA'
);
Sütun listesi açık yazıldığında sorgu tablo sütun sırasına daha az bağımlı olur.
11.3. NULL Değer Ekleme
Sütun NULL kabul ediyorsa değer açıkça NULL verilebilir veya uygun durumda sütun ekleme listesinden çıkarılabilir.
INSERT INTO PERSONEL (
    PERSONEL_NO,
    AD,
    KOMISYON
)
VALUES (
    100,
    'ALI',
    NULL
);
11.4. Fonksiyonlarla Veri Ekleme
INSERT INTO LOG_TABLOSU (
    ID,
    OLUSTURMA_TARIHI
)
VALUES (
    1,
    SYSDATE
);
11.5. Başka Tablodan Satır Kopyalama
INSERT INTO YONETICILER (
    PERSONEL_NO,
    AD,
    GOREV,
    UCRET
)
SELECT PERSONEL_NO,
       AD,
       GOREV,
       UCRET
FROM PERSONEL
WHERE GOREV IN ('MUDUR', 'SEF');
11.6. Verileri Güncelleme
UPDATE PERSONEL
SET UCRET = 2500
WHERE PERSONEL_NO = 300;
WHERE koşulu unutulursa bütün satırlar güncellenebilir.
11.7. Alt Sorguyla Güncelleme
UPDATE PERSONEL
SET BOLUM_NO = 90
WHERE GOREV = (
    SELECT GOREV
    FROM PERSONEL
    WHERE PERSONEL_NO = 350
);
Alt sorgunun beklenen kardinaliteyi üretmesi gerekir.
11.8. Satır Silme
DELETE FROM BOLUM
WHERE BOLUM_NO = 60;
WHERE kullanılmadan çalıştırılan DELETE, tablodaki bütün satırları hedefler.
Başvuru bütünlüğü ilişkileri silme işlemini engelleyebilir veya tanımlanmış silme davranışını uygulayabilir.
11.9. Hareket Kavramı
Bir veya daha fazla SQL işleminin tek mantıksal bütün olarak ele alınmasına transaction, ders terminolojisinde hareket denir.
Transaction için temel özellikler ACID başlığı altında özetlenir:
- Atomicity,
- Consistency,
- Isolation,
- Durability.
11.10. COMMIT
COMMIT, mevcut transaction içindeki değişiklikleri kalıcı hale getirir.
COMMIT;11.11. ROLLBACK
ROLLBACK, henüz commit edilmemiş değişiklikleri geri alır.
ROLLBACK;Transaction sınırları uygulamanın hata yönetimi ve bütünlük modelinin parçası olmalıdır.
Ünite 12: Veri Tabanı Nesneleri
12.1. Tablolar
Tablo veri tabanındaki temel ilişkisel nesnedir.
Oracle örneği:
CREATE TABLE BOLUM (
    BOLUM_NO NUMBER(4),
    BOLUM_ADI VARCHAR2(100),
    KONUM VARCHAR2(100)
);
12.2. Tablo İsimlendirme
İsimler:
- anlamlı,
- tutarlı,
- kurum veya proje standardına uygun
olmalıdır.
Anahtar kelimeleri nesne adı olarak kullanmamak taşınabilirlik ve okunabilirlik açısından yararlıdır.
12.3. Veri Türleri
Oracle'da yaygın türler:
NUMBER,VARCHAR2,CHAR,DATE,TIMESTAMP,CLOB,BLOB.
Veri türü yalnız saklama biçimi değildir. Karşılaştırma, indeksleme, doğrulama ve sorgu semantiğini de etkiler.
12.4. CREATE TABLE
CREATE TABLE PERSONEL (
    PERSONEL_NO NUMBER PRIMARY KEY,
    AD VARCHAR2(100) NOT NULL,
    UCRET NUMBER(12, 2),
    BOLUM_NO NUMBER
);
12.5. Alt Sorgu ile Tablo Yaratma
Oracle'da CREATE TABLE AS SELECT kullanılabilir.
CREATE TABLE PER20 AS
SELECT PERSONEL_NO,
       AD,
       UCRET * 12 AS YILLIK_UCRET
FROM PERSONEL
WHERE BOLUM_NO = 20;
Bu işlem veri ve belirli sütun yapılarını kopyalar. Kaynak tablodaki bütün sınırlamaların otomatik taşınacağı varsayılmamalıdır.
12.6. Sütun Ekleme
ALTER TABLE PERSONEL
ADD EMAIL VARCHAR2(200);
12.7. Sütun Tanımını Değiştirme
ALTER TABLE PERSONEL
MODIFY EMAIL VARCHAR2(300);
Mevcut veriler yeni tanımla uyumlu olmalıdır.
12.8. Tablo Adını Değiştirme
Oracle'da:
RENAME PERSONEL TO CALISAN;veya sürüme ve bağlama uygun ALTER TABLE ... RENAME TO ... biçimleri kullanılabilir.
12.9. Tabloyu Yok Etme
DROP TABLE PERSONEL;DROP, nesnenin kendisini kaldırır.
12.10. Tabloyu Budama
TRUNCATE TABLE, satırları hızlı biçimde kaldırmak için kullanılan DDL işlemidir.
TRUNCATE TABLE GECICI_VERI;DELETE ile aynı transaction davranışına sahip kabul edilmemelidir.
12.11. Sınırlamalar
Başlıca tablo sınırlamaları:
NOT NULL,UNIQUE,PRIMARY KEY,FOREIGN KEY,CHECK.
12.12. NOT NULL
AD VARCHAR2(100) NOT NULLSütunda NULL bulunmasını engeller.
12.13. UNIQUE
EMAIL VARCHAR2(200) UNIQUETekrarlı değerleri sınırlar. NULL davranışı VTYS semantiğine göre değerlendirilmelidir.
12.14. PRIMARY KEY
CONSTRAINT PK_PERSONEL
PRIMARY KEY (PERSONEL_NO)
Satır kimliğini tanımlar.
12.15. FOREIGN KEY
CONSTRAINT FK_PERSONEL_BOLUM
FOREIGN KEY (BOLUM_NO)
REFERENCES BOLUM(BOLUM_NO)
Başvuru bütünlüğünü tanımlar.
12.16. CHECK
CONSTRAINT CK_UCRET
CHECK (UCRET >= 0)
Satır değerine ilişkin mantıksal koşul tanımlar.
12.17. Var Olan Tabloya Sınırlama Ekleme
ALTER TABLE PERSONEL
ADD CONSTRAINT UQ_PERSONEL_EMAIL
UNIQUE (EMAIL);
Mevcut verinin yeni sınırlamayı sağlaması gerekir.
12.18. Sınırlamayı Kaldırma
ALTER TABLE PERSONEL
DROP CONSTRAINT UQ_PERSONEL_EMAIL;
12.19. Görünümler
View, bir sorgunun adlandırılmış mantıksal görünümüdür.
CREATE VIEW AKTIF_PERSONEL AS
SELECT PERSONEL_NO, AD, BOLUM_NO
FROM PERSONEL
WHERE AKTIF = 1;
Görünüm:
- karmaşık sorguyu soyutlamak,
- belirli sütunları gizlemek,
- kullanıcıya sınırlı veri sunmak,
- uygulama arayüzünü kararlı hale getirmek
için kullanılabilir.
12.20. Görünümün Güncellenmesi
Her görünüm güncellenebilir değildir.
Tek tabloya dayalı basit görünümler belirli koşullarda güncellenebilir. Birleştirme, gruplama, küme işlemleri veya türetilmiş sütunlar güncellenebilirliği sınırlayabilir.
Görünüm tanımı değiştirilecekse Oracle'da:
CREATE OR REPLACE VIEW ...kullanılabilir.
12.21. İndeksler
İndeks, tablodaki satırlara belirli anahtarlar üzerinden erişimi hızlandıran yardımcı veri yapısıdır.
CREATE INDEX IX_PERSONEL_BOLUM
ON PERSONEL(BOLUM_NO);
İndeks okuma performansını artırabilir. Buna karşılık:
- ek depolama kullanır,
INSERT,UPDATE,DELETE
işlemlerinde bakım maliyeti oluşturur.
Bu nedenle "çok indeks daha hızlı veri tabanı" yaklaşımı doğru değildir.
12.22. İndekslerin Yararlı Olduğu Koşullar
Genel olarak:
- seçiciliği anlamlı sütunlarda,
- sık kullanılan filtrelerde,
- join anahtarlarında,
- sıralama veya erişim desenleriyle uyumlu sorgularda
yararlı olabilir.
İndeks seçimi tablo boyutu, veri dağılımı, sorgu planı ve iş yüküyle birlikte değerlendirilmelidir.
Sabit yüzde kurallarına güvenmek yerine gerçek yürütme planı ve ölçüm kullanılmalıdır.
12.23. İndeksi Kaldırma
DROP INDEX IX_PERSONEL_BOLUM;Ünite 13: Kullanıcı Erişiminin Denetlenmesi
13.1. Kullanıcı Erişimi
Bir veri tabanında bütün kullanıcıların aynı yetkilere sahip olması doğru değildir.
Temel ilke:
Kullanıcıya yalnız görevi için gerekli en az yetki verilmelidir.
Bu yaklaşım least privilege ilkesidir.
13.2. Kullanıcı Yaratma
Oracle'da kullanıcı tanımlama:
CREATE USER UYGULAMA_KULLANICISI
IDENTIFIED BY guclu_bir_parola;
Gerçek sistemlerde parola politikası, kimlik doğrulama yöntemi ve hesap yaşam döngüsü kurumsal güvenlik politikasına göre yönetilmelidir.
13.3. Sistem Yetkileri
Kullanıcının veri tabanında belirli işlemleri gerçekleştirebilmesi sistem yetkileriyle denetlenir.
Örneğin:
GRANT CREATE SESSION TO UYGULAMA_KULLANICISI;Tablo veya görünüm yaratma gibi yetkiler ayrıca verilebilir.
13.4. Parola Değişikliği
Oracle'da kullanıcı nitelikleri ALTER USER ile değiştirilebilir.
ALTER USER UYGULAMA_KULLANICISI
IDENTIFIED BY yeni_parola;
Üretim ortamında parolanın SQL metinleri ve kayıt dosyalarında açık biçimde görünmemesine dikkat edilmelidir.
13.5. Roller
Rol, yetkilerin mantıksal grubudur.
CREATE ROLE RAPORLAMA_ROLU;Yetki role atanır:
GRANT CREATE SESSION TO RAPORLAMA_ROLU;Rol kullanıcıya atanır:
GRANT RAPORLAMA_ROLU TO UYGULAMA_KULLANICISI;Roller çok sayıda kullanıcıya ortak yetki yönetimini kolaylaştırır.
13.6. Nesne Yetkileri
Bir kullanıcıya belirli tablo üzerinde belirli yetki verilebilir.
GRANT SELECT
ON PERSONEL
TO RAPOR_KULLANICISI;
Örnek nesne yetkileri:
SELECT,INSERT,UPDATE,DELETE,REFERENCES.
Yetki yalnız ihtiyaç duyulan nesne ve işlemle sınırlandırılmalıdır.
13.7. Yetkilerin Geri Alınması
REVOKE SELECT
ON PERSONEL
FROM RAPOR_KULLANICISI;
Yetki modelinde doğrudan kullanıcıya verilen yetkiler ile roller üzerinden gelen yetkiler ayrı değerlendirilmelidir.
13.8. Veri Tabanı Güvenliğinin Katmanları
Yetkilendirme yalnız GRANT ve REVOKE sözdiziminden ibaret değildir. Veri tabanı güvenliği en az şu soruları birbirinden ayırmalıdır:
- Kimlik doğrulama: bağlanan özne gerçekten kimdir?
- Yetkilendirme: hangi nesne üzerinde hangi işlem yapılabilir?
- En az ayrıcalık: iş için gerekmeyen haklar verilmiş midir?
- Görünürlük: view veya satır/sütun politikasıyla gereksiz veri sınırlandırılabilir mi?
- Denetlenebilirlik: kritik erişim ve değişiklikler sonradan izlenebilir mi?
- Gizlilik ve bütünlük: depolama/iletişim koruması ile veri doğruluğu aynı problem değildir.
Rol tabanlı yetkilendirme, tek tek kullanıcılara dağılmış ayrıcalıkları yönetilebilir hale getirir; view'lar ise belirli sorgu yüzeylerini daraltabilir. Ancak view, rol veya şifreleme tek başına bütün güvenlik gereksinimlerini karşılamaz. Kimlik, yetki, veri bütünlüğü, audit ve işletim güvenliği birlikte tasarlanmalıdır.
Ünite 14: İleri SQL Konularının Bütünleştirilmesi
İleri Veri Tabanı Sistemleri notlarının ilk bölümleri temel dersin SQL konularını tekrar eder. Aynı kavramlar burada ikinci kez çoğaltılmadan temel bölümlerde bütünleştirilmiştir.
İleri düzeye geçmeden önce şu başlıkların bilinmesi gerekir:
SELECT,- filtreleme ve sıralama,
- tek satır fonksiyonları,
- grup fonksiyonları,
GROUP BYveHAVING,- join türleri,
- alt sorgular,
CREATE TABLE,- sınırlamalar,
INSERT,UPDATE,DELETE,- transaction yönetimi.
Bu bilgiler PL/SQL programlamasının doğrudan temelidir.
14.1. Depolama Motoru, Tampon Havuzu (Buffer Pool) ve Kurtarma
SQL ilişkisel bir arayüz sunar; fakat sorgunun gerçek maliyeti sayfa, indeks, bellek, günlük ve depolama katmanlarında oluşur. İlişkisel model ile fiziksel gerçekleştirim arasındaki bu sınırı görmek performans ve dayanıklılık kararlarını daha açıklanabilir hâle getirir.
14.1.1. Sayfa ve Tampon Havuzu (Buffer Pool)
Veri tabanları diskteki her satırı tek tek okumak yerine çoğunlukla sabit veya değişken boyutlu sayfalar üzerinden G/Ç yapar. Sık erişilen sayfalar buffer pool içinde tutulabilir.
SQL
 ↓
executor
 ↓
buffer pool
 ↓ cache miss
storage page
Bir sorgunun "indeks kullanması" tek başına az G/Ç yaptığı anlamına gelmez. İndeks seçiciliği, veri kümelenmesi, erişilen sayfa sayısı ve cache durumu birlikte değerlendirilmelidir.
14.1.2. B+ Ağaç Yapısı
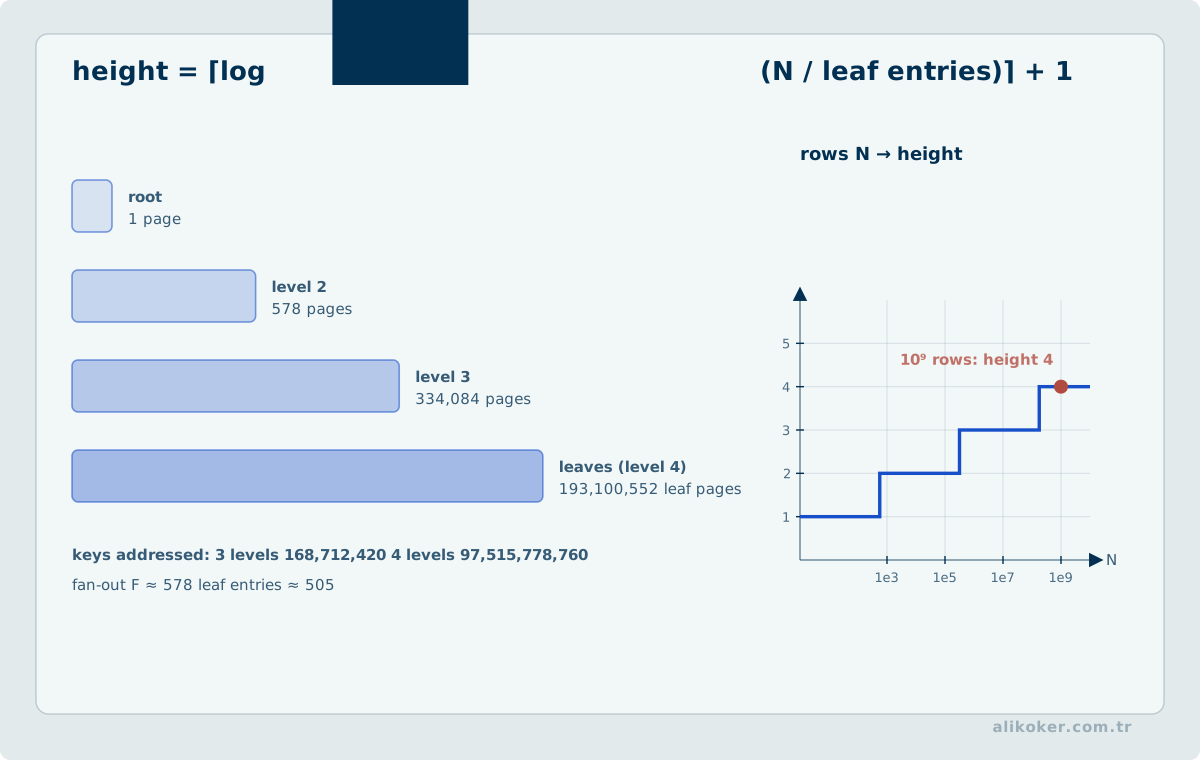
B+ tree ailesi, sıralı anahtar erişimi ile nokta/range sorgularını az sayıda sayfa erişimiyle desteklemek için yaygın kullanılan fiziksel indeks yapılarındandır. İç düğümler yönlendirme anahtarları, yapraklar ise kayıt veya kayıt işaretçileri tutar.
root
 ├─ internal
 │   ├─ leaf
 │   └─ leaf
 └─ internal
     ├─ leaf
     └─ leaf
Ağacın dallanma katsayısı yüksek olduğundan çok büyük kayıt kümelerinde bile yükseklik sınırlı kalabilir. Bununla birlikte rastgele eklemeler page split ve parçalanma maliyeti oluşturabilir.
14.1.3. Write-ahead Logging
Dayanıklı transaction sistemi çoğunlukla veri sayfası ile değişikliğin günlük kaydını ayrı ele alır. Write-ahead logging ilkesinde değişikliği tanımlayan log kaydı, ilgili kirli veri sayfası kalıcı depolamaya gönderilmeden önce güvenli biçimde yazılır.
Bu sıralama crash recovery için temel oluşturur:
transaction change
      ↓
log record
      ↓
durable log
      ↓
data page writeback
Bir commit'in kullanıcıya dönmesi ile bütün veri sayfalarının hemen diske yazılması aynı zorunluluk değildir. Kalıcılık sözleşmesi ürünün logging ve flush modeline bağlıdır.
14.1.4. Crash Recovery
Beklenmeyen kapanmada veri tabanı son checkpoint ve günlük kayıtlarından hangi işlemlerin tamamlandığını, hangilerinin geri alınması veya yeniden uygulanması gerektiğini belirler. Recovery algoritmasının ayrıntısı ürüne göre değişse de temel amaç transaction atomikliği ve dayanıklılığını fiziksel depolama arızalarına karşı korumaktır.
14.1.5. Mantıksal Plan ile Fiziksel Plan
İlişkisel cebir aynı sonucu verebilen birçok işlem sırasına izin verir. Optimizer bu seçenekler arasından istatistik, cardinality tahmini, erişim yolu ve maliyet modeline göre fiziksel plan seçer.
Yanlış cardinality tahmini doğru indekslerin var olduğu bir şemada bile kötü join sırası veya erişim yöntemi üretebilir. Bu nedenle performans incelemesinde sorgu metni kadar gerçek yürütme planı, tahmin-gerçek satır farkı ve fiziksel I/O birlikte değerlendirilmelidir.
14.2. Sorgu İşlemenin Kuramsal Hattı: Eşdeğerlikten Fiziksel Plana
Bir SQL sorgusunun yürütülmesi tek adımlı değildir. Kavramsal olarak süreç:
parse / ad ve tür çözümleme
        ↓
mantıksal sorgu gösterimi
        ↓
cebirsel eşdeğerliklerle dönüşüm
        ↓
fiziksel operatör adayları
        ↓
kardinalite + maliyet kestirimi
        ↓
yürütme planı
şeklinde düşünülebilir.
Buluşsal dönüşümlerin klasik amacı ara sonuçları erkenden küçültmektir. Uygun olduğunda seçimlerin aşağı itilmesi (predicate pushdown), gereksiz sütunların erken elenmesi (projection pushdown), Kartezyen çarpım + seçim kalıplarının join'e dönüştürülmesi ve join sırasının değiştirilmesi bu düşüncenin örnekleridir.
Mantıksal eşdeğerlik tek başına daha hızlı plan garantisi vermez. Aynı mantıksal join için nested-loop, hash join veya merge join gibi farklı fiziksel yöntemler bulunabilir. Optimizer; tablo ve ara sonuç büyüklüğü, seçicilik, mevcut erişim yolları, bellek bütçesi, I/O ve kimi sistemlerde paralellik/iletişim maliyetlerini kestirerek seçim yapar. Bu nedenle "cebirsel olarak eşdeğer" ile "fiziksel olarak aynı maliyetli" ifadeleri birbirinden ayrılmalıdır.
Sorgu planının maliyeti seçiciliğe bağlıdır; yalnız bir sütunda indeks bulunması onun mutlaka kullanılacağı anlamına gelmez. Bir milyon satırlık tabloda neredeyse tüm satırları döndüren koşul için ardışık okuma, çok sayıda rastgele indeks erişiminden ucuz olabilir. Buna karşılık çok az satır seçen ve uygun sırada bulunan bir indeks, veri okuma miktarını azaltabilir. EXPLAIN çıktısı seçilmiş planı gösterir; gerçek süre, okunan satır ve önbellek etkisi ayrıca ölçülmelidir. İndeks oluşturmanın yazma maliyetine ve istatistik güncelliğine etkisi de toplam karara dâhildir.
14.3. Kurtarma Modelleri: UNDO/REDO, Checkpoint ve Gölge Sayfalama
Crash recovery'nin temel sorusu, arıza anında kalıcı depolamadaki veri ile commit edilmiş transaction sözleşmesinin nasıl yeniden uzlaştırılacağıdır.
- UNDO, commit edilmemiş bir transaction'ın kalıcı hale gelmiş etkilerini geri alır.
- REDO, commit edilmiş fakat veri sayfalarına tam yansımamış etkileri yeniden uygular.
- Checkpoint, yeniden başlatmada incelenmesi gereken günlük geçmişini sınırlandırmaya yardımcı olur.
- Gölge sayfalama (shadow paging), mevcut sayfaları yerinde değiştirmek yerine yeni sürümleri ayrı sayfalarda tutup kök/harita değişimiyle görünür hale getiren alternatif bir kurtarma yaklaşımıdır.
Bu kavramlar ürün bağımsız recovery teorisini açıklar. Modern motorların WAL, MVCC ve checkpoint ayrıntıları farklı olabilir; bu nedenle genel UNDO/REDO modeli doğrudan belirli bir ürünün birebir iç algoritması olarak yorumlanmamalıdır.
14.4. İdeal Şema ile Üretimdeki Eski Veri Modeli Arasındaki Fark
Veri tabanı eğitimi doğal olarak aday anahtar, primary key, foreign key, unique constraint ve normalizasyon gibi mekanizmaları ideal tasarım üzerinden anlatır. Üretimde uzun süre yaşamış sistemlerde ise veri modeli her zaman bu ideale uymaz. Tarihsel tekrarlar, eksik constraint'ler, aynı mantıksal varlığın birden fazla fiziksel satırı veya değiştirilemeyen entegrasyon tabloları bulunabilir.
Bu durumda uygulama iki modeli birbirinden ayırmalıdır:
tasarlanmasını istediğimiz veri modeli
                  !=
gerçekte var olan üretim veri davranışı
Örneğin bir alan iş açısından tekil görünse bile veri tabanında unique constraint yoksa uygulamanın findOne() benzeri bir varsayımla hareket etmesi güvenli değildir. Birden fazla satır dönmesi hata, tarihsel gerçeklik veya farklı yaşam döngülerinin sonucu olabilir. Önce gerçek veri davranışı ölçülmeli, sonra deterministik seçim veya açık conflict politikası tanımlanmalıdır.
Şemanın değiştirilemediği sistemlerde bütünlük sorumluluğunun bir bölümü uygulama katmanına taşınabilir. Bu, constraint'lerin gereksiz olduğu anlamına gelmez; tersine şema sahipliği olmayan uygulamanın kaynağın sağlayamadığı garantileri varsaymaması gerektiğini gösterir. Yazma yolu bu nedenle okuma yolundan daha sıkı olabilir: hangi fiziksel satırın değiştirildiği, işlem sırasında verinin yeniden doğrulanması ve beklenen satır sayısının kontrolü önem kazanır.
Fiziksel locator ile domain kimliği de ayrılmalıdır. Oracle ROWID belirli bir satıra ulaşmak için yararlı olabilir; fakat iş anahtarı değildir. Kontrollü kullanım sınırları Oracle Veritabanı ve PL/SQL notunda ayrıca ele alınır.
Bu yaklaşımın temel dersi, uygulamanın ideal şemaya göre değil mevcut veri kaynağının gerçekten sağlayabildiği garantilere göre tasarlanmasıdır. Legacy veriyle güvenli çalışma çoğu zaman daha fazla varsayım yapmak değil, daha az varsayım yapmaktır.
14.5. SQL Sorgusundan Transaction Tasarımına
Veri tabanı kullanımında SQL sözdizimini bilmek ile doğru transaction ve veri modeli kurmak farklı yetkinliklerdir. Aynı SELECT, veri hacmi, indeksler, izolasyon seviyesi ve eşzamanlı yazma davranışına göre çok farklı maliyet ve sonuç üretebilir.
Oracle Database, PostgreSQL, Microsoft SQL Server, MySQL ve IBM Db2 ilişkisel veri tabanı yönetim sistemi ailelerine örnektir. Ürünler SQL ve ilişkisel modelin ortak kavramlarını paylaşsa da veri türleri, DDL/transaction davranışı, optimizer, prosedürel uzantılar, kilitleme/MVCC ayrıntıları ve yönetim araçları bakımından farklılık gösterir. Bir üründe doğru olan sözdizimi veya performans varsayımı diğerine otomatik taşınmamalıdır.
İlişkisel veri tabanı yönetim sistemi için İngilizce RDBMS kısaltması yaygındır. Eski kaynaklarda Microsoft SQL Server için MSSQL adı da görülebilir; ürünün güncel adı Microsoft SQL Server'dır. Kısaltma farkı veri modeli veya SQL standardı farkı anlamına gelmez.
14.5.1. SQL Komut Sınıfları
Kaynaklarda sık görülen DDL, DML, DCL ve TCL ayrımı kavramsal bir sınıflandırmadır. CREATE/ALTER/DROP şema nesnelerini; SELECT/INSERT/UPDATE/DELETE veri erişimini/değişimini; GRANT/REVOKE yetkileri; COMMIT/ROLLBACK/SAVEPOINT transaction kontrolünü temsil eder. Gerçek DBMS'lerde DDL'in transaction davranışı ve sınıflandırma ayrıntıları ürünler arasında değişebilir.
14.5.2. JOIN ve Alt Sorgu Aynı Problemi Her Zaman Aynı Maliyetle Çözmez
INNER, LEFT, RIGHT ve bazı ürünlerde FULL OUTER JOIN farklı satır koruma semantiğine sahiptir. JOIN seçimi “hangisi hızlı?” sorusuyla değil hangi satırların sonuçta bulunması gerektiğiyle başlar. Optimizer fiziksel join algoritmasını ayrıca seçer.
EXISTS, IN, correlated subquery veya JOIN kimi sorgularda eşdeğer sonuç ifade edebilir; fakat NULL semantiği ve çoklama farkları nedeniyle körlemesine birbirine çevrilemez. Önce ilişki kardinalitesi ve beklenen sonuç kümesi doğrulanmalıdır.
14.5.3. GROUP BY, Aggregate ve HAVING
WHERE gruplama öncesi satırları, HAVING ise gruplama sonrası grupları filtrelemek için kullanılır. Aggregate fonksiyonların NULL davranışı önemlidir: örneğin COUNT(*) satır sayarken COUNT(column) ilgili sütunda NULL olmayan değerleri sayar.
14.5.4. İndeksin Gerçek Maliyeti
B-tree indeks aramayı hızlandırabilir; ancak yazma sırasında bakım, ek depolama ve cache/bellek kullanımı getirir. Her sütuna indeks eklemek doğru değildir. Birleşik indekslerde sütun sırası, seçicilik, sorgu predicate'leri, ORDER BY ve DBMS optimizer davranışı birlikte incelenmelidir.
Bir sorgunun indeks kullanması da otomatik olarak daha hızlı olduğu anlamına gelmez. Büyük bir tablo yüzdesi okunacaksa sequential/full scan daha ekonomik olabilir.
14.5.5. ACID ve İzolasyon
Atomicity transaction'ın tümünün uygulanması veya geri alınması; consistency tanımlı bütünlük koşullarının korunması; isolation eşzamanlı transaction'ların birbirine görünürlüğü; durability commit edilen verinin arıza sonrasında korunmasıyla ilgilidir.
İzolasyon seviyesi yükseldikçe her sistemde basitçe “daha güvenli ama daha yavaş” sonucu çıkmaz. Kilitleme veya MVCC modeli, iş yükü ve çatışma oranı önemlidir. Lost update, dirty read, non-repeatable read ve phantom benzeri anomaliler uygulama gereksinimine göre değerlendirilir.
14.5.6. Constraint, Trigger ve Uygulama Kodu
PRIMARY KEY, UNIQUE, FOREIGN KEY, CHECK ve NOT NULL gibi constraint'ler veri bütünlüğünü veriye en yakın noktada tanımlar. Trigger belirli veri değişikliklerinde otomatik davranış sağlayabilir; ancak görünmez yan etki ve bakım maliyeti yaratabilir. İş kuralını trigger'a veya yalnız uygulama koduna koyma kararı, transaction sınırı, birden fazla yazan uygulama ve operasyonel görünürlük dikkate alınarak verilmelidir.
14.5.7. NoSQL Ayrımı
NoSQL tek bir veri modeli değildir. Redis gibi anahtar-değer, belge, Apache Cassandra gibi geniş-sütun ve graf veritabanları farklı erişim desenleri için geliştirilmiştir. Cassandra ilişkisel tablo modelinin doğrudan eşdeğeri değildir; dağıtık geniş-sütun veri modeli ve sorgu kısıtları veri modellemesini erişim desenlerine yaklaştırır. “NoSQL daha hızlıdır” veya “ilişkisel veritabanı ölçeklenmez” genellemeleri doğru değildir. Veri modeli; sorgu, transaction, tutarlılık, dağıtım ve işletim gereksinimine göre seçilmelidir.
14.6. İzolasyon Anomalileri ve İdempotent İşlem Tasarımı
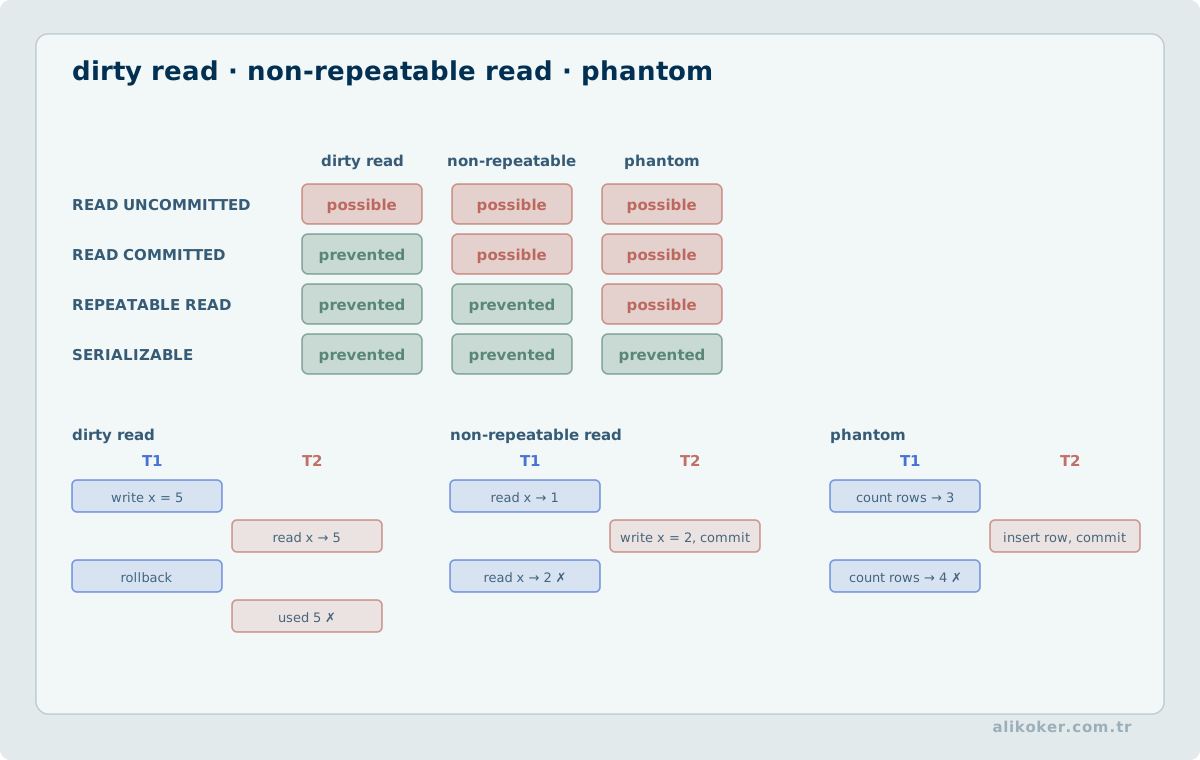
Bir transaction'ın "başarılı" olması, eşzamanlı çalışan transaction'larla birlikte beklenen iş kuralının korunduğu anlamına gelmez. Lost update, write skew, phantom ve non-repeatable read gibi anomaliler kullanılan izolasyon düzeyine ve veritabanı motorunun gerçek semantiğine göre değerlendirilmelidir.
İş kuralı "aynı anda en fazla N kayıt aktif olabilir" gibi birden fazla satırı ilgilendiriyorsa yalnız tek satır kilidi yeterli olmayabilir. Constraint, uygun izolasyon, atomik DML veya açık kilitleme stratejisiyle invariant veritabanına yakın noktada korunmalıdır.
Dağıtık sistemden gelen yeniden denemeler de veri modelini etkiler. Aynı komut ağ hatası nedeniyle iki kez gelebiliyorsa işlemin idempotent anahtar veya tekillik kuralıyla ikinci kez yan etki üretmemesi tasarlanmalıdır. Böylece transaction yönetimi yalnız rollback değil, uçtan uca tekrar yürütme davranışını da kapsar.
14.7. Veri Tabanı Davranışını Sözleşmeyle Doğrulamak
SQL standardı ile belirli bir veritabanı motorunun transaction, kilitleme ve null davranışı aynı düzeyde ele alınmamalıdır. İzolasyon seviyesi adı aynı olsa bile MVCC ve kilitleme ayrıntıları motora göre değişebilir.
Bir sorgu için doğruluk önce sonuç kümesiyle, performans ise ayrıca plan ve gerçek iş yüküyle değerlendirilir. Küçük örnek tabloda hızlı çalışan sorgu, veri dağılımı değiştiğinde farklı plan seçebilir. İndeks önerisi de okuma kazancı kadar yazma, depolama ve bakım maliyetini içerir.
Veri bütünlüğü mümkün olduğunda şema düzeyinde ifade edilir. Primary/unique key, foreign key, check constraint ve transaction sınırları iş kuralıyla uyumlu kurulursa aynı kuralın her istemcide tekrar edilmesine duyulan ihtiyaç azalır.
14.8. Veri Tabanından Yapay Zekâ Veri Katmanına
Makine öğrenmesi modeli yalnız algoritmadan oluşmaz. Eğitim örneklerinin nereden geldiği, hangi sürümün kullanıldığı, özelliklerin nasıl üretildiği ve çıkarım sonucunun hangi kayıtla ilişkilendirildiği de sistemin davranışını belirler. Veri tabanı yönetim sistemleri ile yapay zekâ arasındaki en sağlam bağ bu veri yaşam döngüsünde ortaya çıkar.
İlişkisel veri modeli, eğitim ve değerlendirme verisini açık anahtarlar ve kısıtlarla tanımlamak için güçlüdür. Bir örnek hangi kaynaktan geldi, etiketi kim üretti, hangi zaman aralığına ait, hangi dönüşümler uygulandı gibi bilgiler ayrı tablolar ve ilişkilerle izlenebilir. Bu bilgiler kaybolduğunda yalnız veri yönetimi zorlaşmaz; model sonucu da yeniden üretilemez hale gelir.
Örneğin şu ayrım korunmalıdır:
ham kayıt
≠
özellik / feature
≠
model girdisi
≠
model çıktısı
≠
insan tarafından doğrulanmış sonuç
Bunların tek tabloda belirsiz sütunlarla tutulması kısa vadede kolay görünse de provenance ve denetim zincirini zayıflatır. Veri tabanı tasarımının normalization, constraint ve transaction ilkeleri burada doğrudan mühendislik değeri taşır.
Eğitim verisi ile üretim verisi arasındaki zaman ilişkisi de önemlidir. Bir model geçmiş veriden öğrenirken geleceğe ait bir bilginin yanlışlıkla özellik olarak kullanılması data leakage üretir. SQL sorgusu teknik olarak doğru olabilir; fakat zaman sınırını ihlal ettiği için model değerlendirmesi gerçeği yansıtmaz. Bu nedenle veri hazırlama sorgularında iş zamanı, kayıt zamanı ve etiketin oluşma zamanı açıkça ayrılmalıdır.
Modern yapay zekâ sistemlerinde vektör temsilleri de veri katmanına eklenmiştir. Metin, görüntü veya başka içerikten üretilen embedding; yüksek boyutlu sayısal bir temsildir. Benzerlik araması için kullanılabilir. Ancak embedding ilişkisel anahtarın yerine geçmez:
ID / foreign key → kimlik ve kesin ilişki
vector similarity → yaklaşık anlamsal yakınlık
Bu iki erişim biçimi farklı soruları yanıtlar. Bir belgeyi id ile bulmak deterministik eşleşmedir; benzer embedding'leri bulmak ise seçilen temsil ve mesafe metriğine bağlı yaklaşık bir aramadır. Vector search, ilişkisel bütünlüğün alternatifi değil tamamlayıcı bir erişim yoludur.
Retrieval-augmented generation benzeri yapılarda veri tabanı başka bir sorumluluk daha taşır. Model bağlama alınacak kayıtları kendisi “hatırlamaz”; retrieval katmanı veri deposundan aday içerikleri seçer. Yanlış filtre, eski sürüm veya yetki dışı kayıt seçildiğinde üretici modelin kalitesi bu veri hatasını düzeltemez. Bu nedenle yetkilendirme, zaman filtresi, tenant/scope sınırı ve kaynak sürümü retrieval sorgusunun parçası olmalıdır.
Transaction kavramı da AI sistemlerinde önemini korur. Model çıktısının kaydedilmesi ile bunun kullanıcı tarafından onaylanması farklı iş olaylarıysa aynı durum olarak yazılmamalıdır. Yeniden deneme durumunda idempotency korunmalı; bir inference isteğinin iki kez işlenmesi veri tabanında iki farklı iş sonucu üretmemelidir.
Veri tabanı yapay zekânın öğrenme algoritmasını belirlemez. Buna karşılık modelin beslendiği, doğrulandığı ve üretimde ilişkilendirildiği verinin bütünlüğünü belirler. AI sistemlerinde veri kalitesi yalnız eksik veya hatalı değer sorunu değildir; köken, zaman, sürüm, yetki ve işlem sınırı birlikte veri kalitesinin parçasıdır.
14.9. Sorgu Sonucundan İşlem Semantiğine
Veri tabanı sorularında doğru sonucu üretmek ile doğru eşzamanlı davranışı üretmek aynı şey değildir. Bir SELECT ifadesi tek başına doğru satırları döndürebilir; aynı iş akışı eşzamanlı güncellemeler altında kayıp güncelleme, kirli okuma veya tutarsız tekrar okuma gibi anomaliler üretebilir. Bu nedenle sorgu mantığı ile transaction sınırı birlikte düşünülmelidir.
Birincil anahtar satırı mantıksal olarak tanımlar; indeks ise erişim yoludur. Çoğu sistem birincil anahtar için indeks oluşturur, fakat kavramlar eş anlamlı değildir. Her indeks de ücretsiz değildir: okuma maliyetini azaltabilirken ekleme, güncelleme, depolama ve bakım maliyetini artırır.
Normalleştirme tekrar ve güncelleme anomalilerini azaltır. Buna karşılık analitik veya yoğun okuma senaryolarında bazı türetilmiş veya yinelenmiş yapılar performans amacıyla bilinçli olarak tutulabilir. Bu durumda tutarlılığın nasıl korunacağı açık bir tasarım kararı olmalıdır; normalleştirme ve performans birbirinin mutlak karşıtı değildir.
WHERE satırları gruplamadan önce, HAVING ise gruplama sonucu oluşan kümeleri filtrelemek için kullanılır. LEFT JOIN sonrasında sağ tablonun sütununa WHERE koşulu koymak, NULL ile tamamlanan satırları eleyerek sorgunun davranışını fiilen iç birleşime yaklaştırabilir. Bu nedenle birleşim türü ile filtre konumu birlikte okunmalıdır.
ACID başlıkları da birbirinden ayrılmalıdır. Atomiklik işlemin ya bütünüyle uygulanması ya da uygulanmamasını, tutarlılık tanımlı kuralların korunmasını, izolasyon eşzamanlı işlemlerin görünürlüğünü, dayanıklılık ise commit edilmiş sonucun arıza sonrasında korunmasını ifade eder. Bir özelliğin sağlanması diğer üçünün otomatik olarak sağlandığı anlamına gelmez.
14.10. Dosya Organizasyonu ile Veri Tabanı Motoru Arasındaki Fiziksel Katman
İlişkisel model tablo, satır, sütun ve anahtarlarla düşünmeyi sağlar; depolama aygıtı ise sayfa, blok ve bayt görür. Dosya organizasyonu, bu iki soyutlama arasındaki katmandır. Bazı bilgisayar mühendisliği programlarında ayrı ders olarak okutulmasının nedeni, SQL'in mantıksal sonucuyla bu sonuca ulaşmak için yapılan fiziksel G/Ç'nin aynı şey olmadığını görünür kılmasıdır.
14.10.1. Kayıt, Sayfa ve Boş Alan
Veri tabanı motorları satırları çoğunlukla sabit boyutlu disk sektörleri yerine daha büyük sayfalar veya bloklar içinde yönetir. Değişken uzunluklu satırlarda yaygın yaklaşım, sayfa başlığında satır konumlarını gösteren bir yuva dizisi tutmaktır. Böylece satır sayfa içinde hareket etse bile üst katman doğrudan fiziksel ofsete bağımlı kalmaz.
sayfa
┌─────────────────────────────┐
│ başlık / boş alan bilgisi   │
│ slot 0 → kayıt konumu       │
│ slot 1 → kayıt konumu       │
│ ...                         │
│           boş alan          │
│ kayıtlar ← sondan yerleşir  │
└─────────────────────────────┘
Satır uzunluğu, sayfa doluluk oranı ve güncellemenin satırı büyütmesi yalnız depolama ayrıntısı değildir. Bir sayfada kaç satır tutulabildiğini, kaç sayfanın okunacağını, tampon havuzunun etkinliğini ve indeks erişiminin kaç ek G/Ç üreteceğini etkiler.
14.10.2. Heap, Sıralı ve Hash Organizasyonu
Heap dosya kayıtları belirli bir anahtar sırasına zorlamadan uygun boş alana yerleştirir. Ekleme ucuz olabilir; indeks yoksa belirli bir kaydı bulmak geniş tarama gerektirebilir.
Sıralı dosya kayıtları bir arama anahtarına göre fiziksel veya mantıksal sırada tutmayı hedefler. Aralık taramaları için elverişli olabilir; ancak araya ekleme ve sayfa bölünmesi gibi bakım maliyetleri doğurur.
Hash tabanlı organizasyon anahtarı kovaya eşleyerek eşitlik aramalarını hızlandırabilir. Buna karşılık sıralı aralık sorguları için doğal bir düzen sağlamaz. Bu nedenle erişim yolu, sorgu operatörünün türüyle birlikte seçilmelidir.
WHERE id = ?             → hash veya B+ ağaç uygun olabilir
WHERE tarih BETWEEN ...  → sıralı/B+ ağaç erişimi daha doğaldır
ORDER BY tarih           → mevcut fiziksel/indeks sırası ek işi azaltabilir
14.10.3. B+ Ağaç, Kümelenme ve İkincil Erişim
B+ ağaçta iç düğümler yönlendirme anahtarlarını, yapraklar ise anahtarları ve satıra erişim bilgisini taşır. Yüksek fan-out nedeniyle ağacın yüksekliği küçük kalabilir. Ancak “indeks var” cümlesi tek başına yeterli değildir. Yaprak sırası veri sayfalarının fiziksel sırasıyla ne kadar uyumluysa ardışık erişimin yerelliği o kadar iyi olabilir; ikincil bir indeks çok sayıda dağınık satırı bulduğunda ise her eşleşme ayrı sayfa erişimine dönüşebilir.
Bu, kümelenmiş (clustered) ve kümelenmemiş (unclustered) erişim arasındaki performans farkının özüdür. Ürünlerin terimleri ve uygulama ayrıntıları değişebilir; değişmeyen ilke, mantıksal anahtar sırası ile fiziksel veri yerleşiminin aynı şey olmadığıdır.
14.10.4. Harici Sıralama ve Büyük Ara Sonuçlar
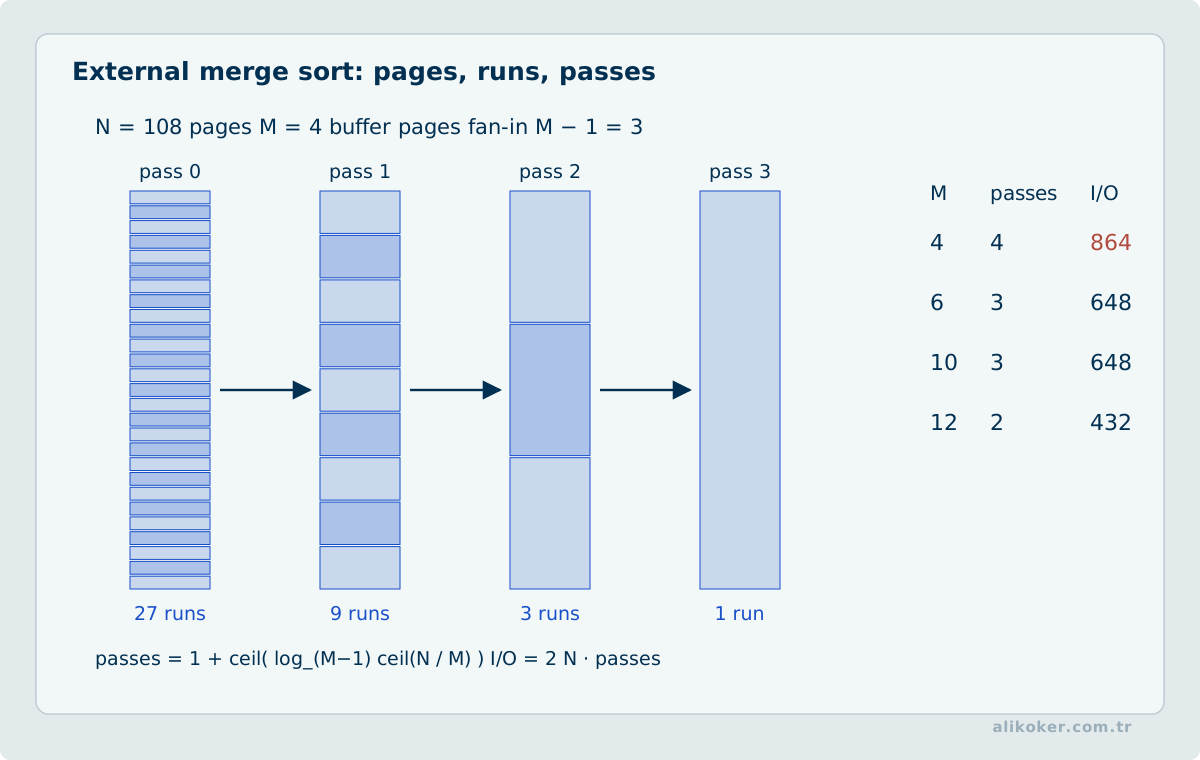
Belleğe sığmayan veri üzerinde sıralama yapıldığında klasik yaklaşım, belleğe sığan parçaları ayrı ayrı sıralayıp diske yazmak ve daha sonra bu parçaları çok yollu birleştirmektir. Harici birleştirmeli sıralama (external merge sort), ORDER BY, GROUP BY, DISTINCT, sort-merge join ve indeks oluşturma gibi işlemlerin disk maliyetini anlamak için temel modeldir.
büyük veri
  ↓
belleğe sığan run'lar
  ↓
her run'ı sırala ve yaz
  ↓
çok yollu merge
  ↓
sıralı sonuç
Benzer biçimde hash join de build tarafının belleğe sığmadığı durumda bölümlere ayrılıp diske taşabilir. Bu noktada sorgunun SQL metni değişmese bile fiziksel davranış ve gecikme dramatik biçimde değişebilir.
14.10.5. Dosya Organizasyonunun Güncel Önemi
Modern DBMS'ler dosya yerleşimini büyük ölçüde kullanıcıdan gizler; ancak sorgu optimizasyonu, indeks seçimi, vacuum/compaction davranışı, write amplification, buffer-cache verimi ve harici sıralama maliyeti bu fiziksel gerçeklerin üzerine kuruludur. Bu yüzden Veri Yapıları ve Algoritma Analizi içindeki B+ ağaç ve hashing bilgisi ile veri tabanı sorgu planı arasında doğrudan bir bağ vardır.
Bir veri tabanı problemini çözerken katmanları ayırmak yararlıdır:
ilişkisel model      → hangi sonuç doğru?
sorgu planı          → hangi operatörler kullanılacak?
erişim yolu          → hangi indeks/tarama seçilecek?
dosya organizasyonu  → satırlar hangi sayfalarda?
depolama             → kaç gerçek G/Ç ve yazma oluşacak?
Bu ayrım, performans optimizasyonunu “indeks ekle” refleksinden çıkarıp ölçülebilir bir veri erişim problemine dönüştürür.
14.11. PostgreSQL 18 Üzerinden MVCC, VACUUM, WAL, İndeks ve Sorgu Planı Derinleşmesi
İlişkisel model DBMS'ten bağımsızdır; fakat transaction görünürlüğü, vacuum, fiziksel indeks türleri ve optimizer ayrıntıları ürün gerçekleştirimidir. PostgreSQL 18, bu ayrımı somutlaştırmak için yararlı güncel bir örnektir.
Buradaki amaç PostgreSQL komut ezberi değil, genel veri tabanı kavramlarının gerçek bir motor içinde hangi fiziksel sonuçları doğurduğunu görmektir.
14.11.1. MVCC: Aynı Satırın Birden Fazla Sürümü
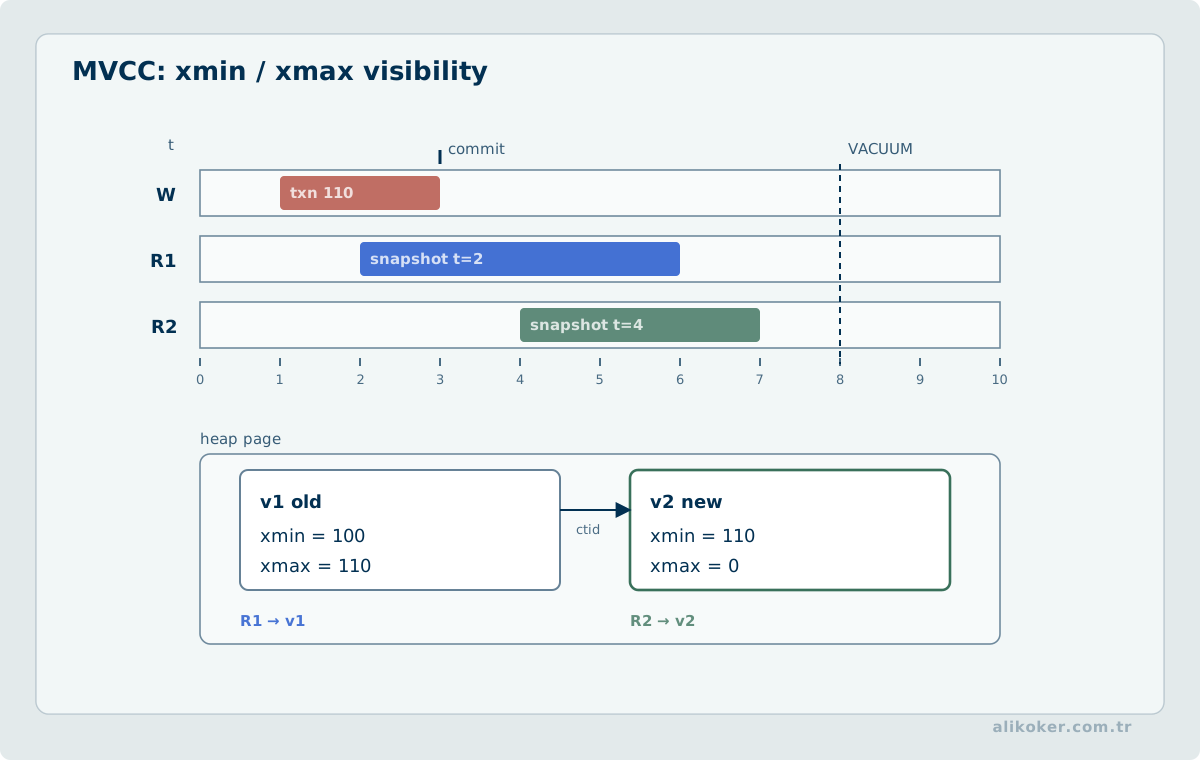
PostgreSQL eşzamanlılığı büyük ölçüde çok sürümlü eşzamanlılık kontrolü (MVCC) üzerinden yönetir.
Bir satır güncellendiğinde kavramsal olarak:
eski row version
        +
yeni row version
bir süre birlikte bulunabilir.
Farklı transaction'lar kendi görünürlük kurallarına göre hangi sürümü göreceğini belirler.
Bu sayede olağan okuma işlemleri ile yazma işlemleri birçok durumda birbirini klasik "her okuma yazarı kilitler" modelindeki kadar engellemez.
MVCC'nin önemli sonucu şudur:
UPDATEveDELETE, eski fiziksel satır sürümünü her durumda anında dosyadan yok etmez.
Bu nedenle görünürlük ile fiziksel alan geri kazanımı ayrı mekanizmalardır.
14.11.2. Snapshot Semantiği ve İzolasyon
Transaction'ın hangi sürümleri gördüğü izolasyon düzeyine bağlıdır.
PostgreSQL'de Read Committed, Repeatable Read ve Serializable aynı snapshot davranışına sahip değildir.
Kavramsal ayrım:
Read Committed
 -> komutlar ilerledikçe daha yeni committed durumu görebilir

Repeatable Read
 -> transaction boyunca daha kararlı snapshot

Serializable
-> yalnız snapshot değil, seri yürütmeye eşdeğer sonuç hedefiSerializable, bütün transaction'ları tek tek sıraya koyan kaba global kilit anlamına gelmez. PostgreSQL bunun için Serializable Snapshot Isolation yaklaşımını kullanabilir ve bazı tehlikeli eşzamanlılık örüntülerini serialization failure ile reddedebilir.
Bu nedenle yüksek izolasyonda doğru uygulama davranışı bazen:
transaction başarısız
 -> güvenli biçimde yeniden dene
sözleşmesini de içerir.
14.11.3. Dead Tuple ve VACUUM
Eski satır sürümü artık hiçbir aktif transaction tarafından görülemiyorsa yeniden kullanılabilir hâle gelmelidir.
PostgreSQL'de standart VACUUM:
- artık gerekli olmayan satır sürümlerini temizlemeye yardımcı olur,
- alanı tablo içinde yeniden kullanılabilir hâle getirir,
- görünürlük bilgilerini günceller,
- transaction kimliği yaşlanmasının yönetimine katkı sağlar.
Ancak standart VACUUM ile VACUUM FULL aynı işlem değildir.
VACUUM
 -> olağan bakım
 -> çoğu alanı dosya içinde yeniden kullanıma açar

VACUUM FULL
 -> tabloyu yeniden yazar / sıkıştırır
 -> daha ağır kilit ve ek disk davranışı
"Disk büyüdü, VACUUM çalıştırınca dosya hemen küçülmeli" beklentisi bu nedenle doğru değildir.
14.11.4. Autovacuum bir Temizlik Robotundan Fazlasıdır
Autovacuum yalnız disk alanı temizliği için değildir.
Aynı zamanda:
- istatistik güncelleme,
- dead tuple yönetimi,
- transaction ID freeze,
- wraparound riskini sınırlama
gibi veritabanı sağlığı için kritik işlevler taşır.
Autovacuum'u yalnız "performansı düşürüyor" gerekçesiyle kapatmak, kısa vadede sessizlik üretip uzun vadede daha büyük doğruluk ve bakım problemi oluşturabilir.
Doğru soru:
çalışsın mı?değil:
iş yüküne göre yeterli sıklık ve kaynakla çalışıyor mu?olmalıdır.
14.11.5. Visibility Map ve index-only Scan İlişkisi
PostgreSQL bir heap sayfasındaki bütün satırların bütün transaction'lar için görünür olduğunu biliyorsa bu bilgiyi visibility map içinde işaretleyebilir.
Bu bilgi bazı sorgularda index-only scan yapılabilmesi için önemlidir.
İndeks aranan kolonları taşısa bile MVCC görünürlüğünü doğrulamak için her zaman heap sayfasına gitmek gerekirse gerçek "yalnız indeks" kazancı azalır.
Bu, vacuum davranışı ile sorgu performansı arasında doğrudan bir bağ kurar.
14.11.6. WAL, Commit ve Checkpoint
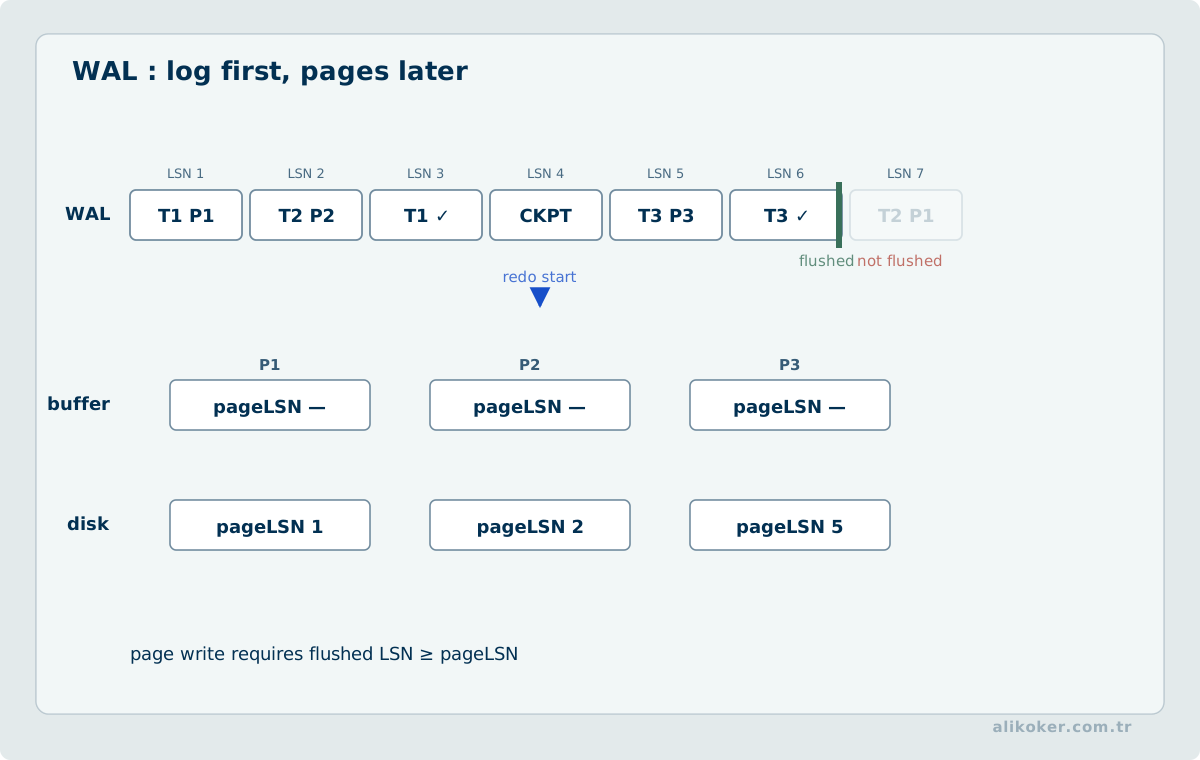
Write-ahead log (WAL), veri sayfası diske yazılmadan önce değişikliğin kurtarma için gerekli kaydının kalıcı hâle getirilmesi ilkesine dayanır.
PostgreSQL WAL konumu LSN (Log Sequence Number) ile ifade edilir.
transaction change
  ↓
WAL record
  ↓
WAL durability
  ↓
data page daha sonra yazılabilir
Commit sırasında bütün kirli heap/index sayfalarının o anda fiziksel dosyalarına yazılması gerekmez. Dayanıklılık sözleşmesi WAL ile kurulabilir.
Checkpoint ise recovery sırasında taranması gereken WAL aralığını ve dirty page yazma davranışını yönetmeye yardımcı olur. Çok sık checkpoint daha fazla write I/O; çok seyrek checkpoint daha uzun recovery ve daha büyük WAL basıncı gibi trade-off'lar doğurabilir.
14.11.7. B-tree Her Sorgunun İndeksi Değildir
PostgreSQL farklı indeks erişim yöntemleri sunar.
B-tree:
- eşitlik,
- sıralı karşılaştırma,
- range,
ORDER BY
gibi klasik düzenli anahtar sorgularında genel amaçlı seçimdir.
GIN (Generalized Inverted Index), tek satır içinde çok sayıda aranabilir öğe bulunan yapılarda güçlüdür:
- full-text token'ları,
- array elemanları,
- belirli JSONB operatörleri.
Okuma için etkili olabilir; fakat çok sayıda index entry nedeniyle yazma maliyeti yüksek olabilir.
GiST (Generalized Search Tree), operator class aracılığıyla geometrik, range, nearest-neighbor ve benzeri özel arama ilişkilerini destekleyebilen genişletilebilir bir altyapıdır.
SP-GiST, veriyi dengeli B-tree biçiminden farklı biçimde uzayı bölerek temsil edebilen trie, radix, quad-tree benzeri problem ailelerinde kullanışlı olabilir.
BRIN (Block Range Index), devasa ve fiziksel olarak sıralamayla ilişkili tablolar için sayfa aralıklarına ait özet tutar. B-tree kadar kesin değildir; çok küçüktür ve zaman gibi append-ağırlıklı korelasyonlu kolonlarda büyük kazanç sağlayabilir.
İndeks seçimi:
veri türü
operatör
dağılım
fiziksel korelasyon
okuma/yazma oranı
tablo boyutu
birlikte değerlendirilerek yapılmalıdır.
14.11.8. Operator Class Önemlidir
"GIN indeksim var" tek başına yeterli bilgi değildir. PostgreSQL'de indeks yöntemi hangi operatörleri nasıl desteklediğini operator class ile belirler.
Örneğin JSONB üzerinde:
hangi operator kullanılıyor?
hangi index operator class seçildi?
hangi sorgu deseni baskın?
soruları indeksin kullanılabilirliğini doğrudan etkileyebilir.
14.11.9. HOT Update: Her UPDATE Aynı İndeks Maliyetini Üretmez
PostgreSQL'in Heap-Only Tuple (HOT) optimizasyonu belirli koşullarda yeni satır sürümü için yeni indeks girdileri oluşturma ihtiyacını azaltabilir.
Genel koşul fikri:
- indekslenen kolonlar değişmemiş olmalı,
- aynı heap sayfasında uygun alan bulunmalı.
Bu durumda güncellemenin indeks write amplification maliyeti azalabilir.
Bu özellik "UPDATE ucuzdur" garantisi değildir. Sayfa doluluğu, indeks sayısı ve değişen kolonlar fiziksel maliyeti etkiler.
14.11.10. Planner Tahmini ile Gerçek Çalışma Aynı Şey Değildir
EXPLAIN optimizer'ın seçtiği planı ve tahminleri gösterir.
EXPLAIN ANALYZE ise sorguyu gerçekten çalıştırır ve gerçek süre/satır davranışını ölçer.
Bu ayrım kritiktir:
estimated rows = 100
actual rows    = 100000
gibi büyük fark, optimizer'ın join sırası veya erişim yolu kararını bozabilir.
İncelemede:
- tahmini ve gerçek satır,
- loop sayısı,
- scan türü,
- join türü,
- sort spill,
- buffer hit/read,
- WAL üretimi
gibi ölçüler birlikte okunabilir.
EXPLAIN ANALYZE sorguyu gerçekten yürüttüğü için INSERT, UPDATE veya DELETE üzerinde yalnız "planı görmek" amacıyla gelişigüzel çalıştırılmamalıdır. Gerekirse kontrollü transaction içinde çalıştırıp geri alma gibi güvenli yöntemler kullanılmalıdır.
14.11.11. İstatistikler Optimizer'ın Veri Modelidir
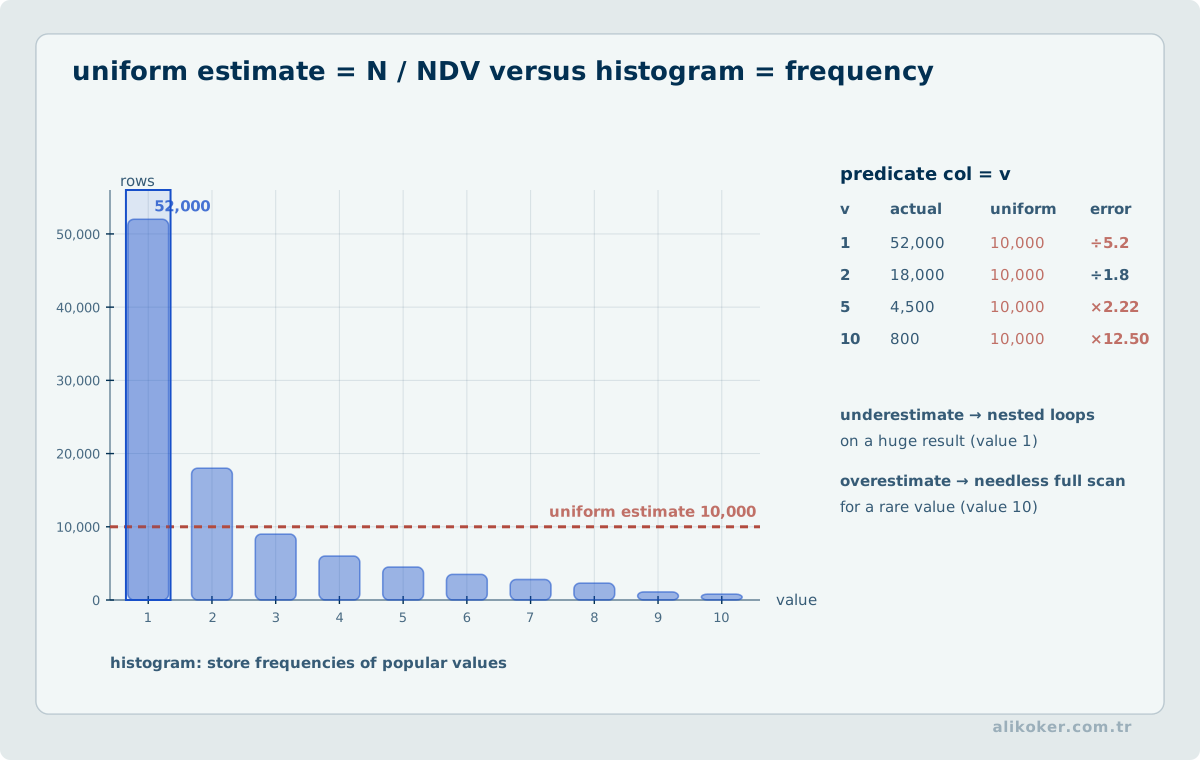
Optimizer gerçek tabloyu her planlamada baştan taramaz. İstatistikler üzerinden:
- cardinality,
- değer dağılımı,
- null oranı,
- distinct sayısı,
- bazı kolonlar arası ilişki
hakkında tahmin yapar.
Veri dağılımı değiştiğinde istatistiğin bayat kalması doğru SQL'in kötü fiziksel plan üretmesine yol açabilir.
Bu nedenle performans problemi:
indeks var mı?sorusuyla başlamamalıdır.
gerçek cardinality ne?
optimizer ne tahmin ediyor?
neden?
soruları daha açıklayıcı olabilir.
14.11.12. Partitioning, Sharding Değildir
Tablo bölümlendirme (partitioning), tek mantıksal tabloyu belirli anahtara göre fiziksel bölümlere ayırabilir.
Faydalar:
- partition pruning,
- büyük tarih aralığı yönetimi,
- bakım ve arşivleme kolaylığı.
Ancak partitioning:
- otomatik yatay ölçekleme değildir,
- tek başına başka sunuculara veri dağıtmaz,
- kötü partition anahtarını düzeltmez,
- çok fazla küçük partition ile planlama maliyeti yaratabilir.
Sharding ve partitioning farklı dağıtım problemleridir.
14.11.13. JSONB İlişkisel Modelin Yerine Geçmek Zorunda Değildir
JSONB, değişken yapılı özellikleri ve belge benzeri alanları ilişkisel tablo içinde saklamak için güçlüdür.
Ancak bütün domain'i tek JSON kolonuna koymak:
- constraint,
- join,
- optimizer istatistiği,
- migration,
- veri tipi garantisi
avantajlarını zayıflatabilir.
JSONB en iyi, yapının gerçekten esnek olduğu ve sorgu deseni uygun olduğu yerde kullanılmalıdır.
14.11.14. Replikasyon Veri Modelini Değiştirmez
Fiziksel veya mantıksal replikasyon:
- yüksek erişilebilirlik,
- okuma ölçekleme,
- felaket kurtarma,
- veri dağıtımı
için kullanılabilir.
Ama replica eklemek:
yanlış transaction semantiğini
kötü sorguyu
yanlış indeksi
belirsiz veri sahipliğini
kendiliğinden düzeltmez.
PostgreSQL örneğinin ana dersi, SQL'in altındaki fiziksel katmanın görünür kılınmasıdır:
ilişkisel semantik
  ↓
transaction görünürlüğü
  ↓
optimizer ve plan
  ↓
indeks / heap
  ↓
WAL / vacuum / storage
Bu katmanlar birlikte okunduğunda veri tabanı performansı "indeks ekle" refleksinden çıkar ve ölçülebilir bir sistem davranışına dönüşür.
Ünite 15: Eşzamanlı İşlemler, Kilitler ve Veri Tabanı Programlama Sınırları
Transaction bilgisi yalnız COMMIT ve ROLLBACK komutlarından ibaret değildir. Birden fazla transaction aynı veriye eriştiğinde schedule, görünürlük, kilit ve tekrar deneme davranışı birlikte değerlendirilmelidir.
15.1. Schedule ve Serializability
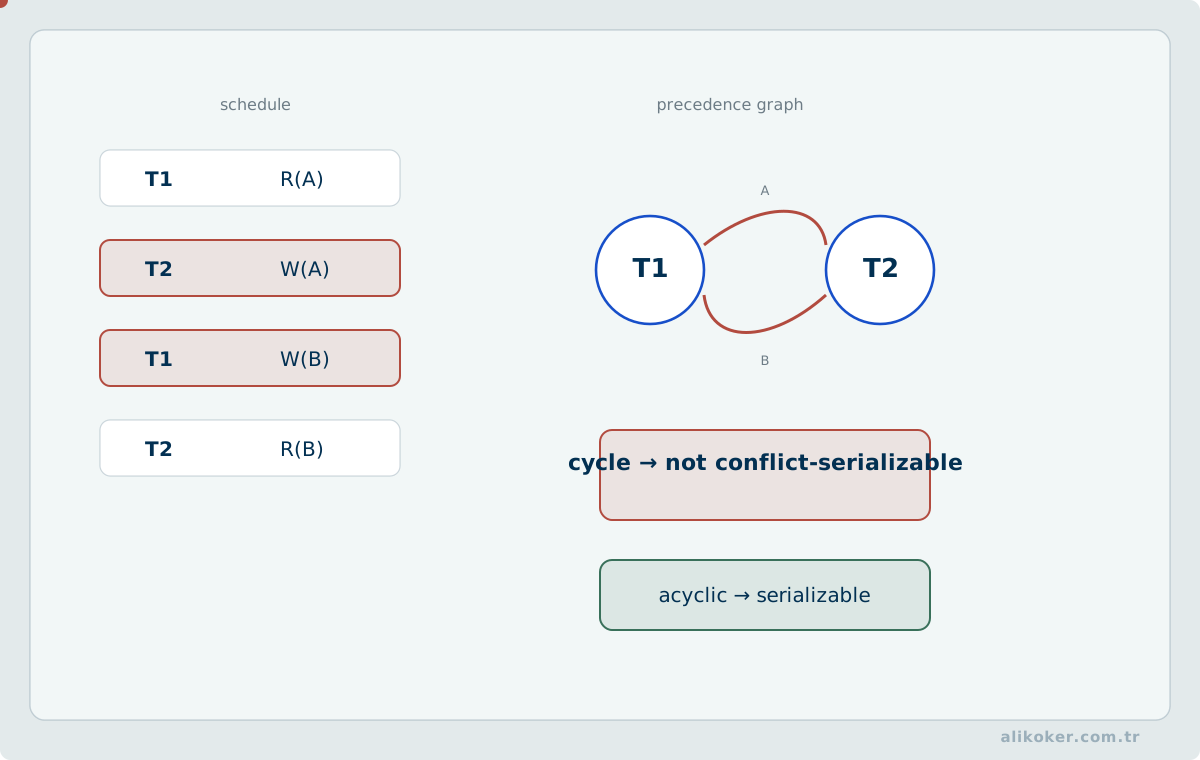
Bir schedule, farklı transaction adımlarının gerçek yürütme sırasıdır.
İki transaction'ın komutları iç içe geçebilir:
T1: read A
T2: read A
T1: write A
T2: write A
Sonucun geçerli olması yalnız her transaction'ın tek başına doğru olmasına bağlı değildir; interleaving de veri kuralını korumalıdır.
Serializable yürütme, eşzamanlı sonucun transaction'ların bir seri sırada çalıştırılmasına eşdeğer olmasını hedefler. Gerçek motor bunu kaba bir global kilitle yapmak zorunda değildir. MVCC, predicate locking veya conflict detection gibi mekanizmalar kullanılabilir.
15.2. Pessimistic ve Optimistic Concurrency
Pessimistic yaklaşım çatışmayı işlem sırasında engellemeye çalışır:
oku
kilitle
değiştir
commit
Optimistic yaklaşım ise çatışmanın seyrek olduğunu varsayıp yazma anında sürüm/koşul doğrular:
version = 7 oku
işle
UPDATE ... WHERE id = ? AND version = 7
Etkilenen satır yoksa veri değişmiştir ve işlem yeniden değerlendirilir.
Hiçbiri evrensel olarak daha iyi değildir. Çatışma oranı, transaction süresi, kullanıcı etkileşimi ve retry maliyeti seçimi etkiler.
15.3. Kilit Granülerliği ve Deadlock
Kilit kapsamı büyüdükçe yönetim kolaylaşabilir fakat paralellik azalabilir.
database
table
page
row
application/advisory resource
gibi farklı granülerlikler bulunabilir.
Deadlock örneği:
T1: A'yı kilitle -> B'yi bekle
T2: B'yi kilitle -> A'yı bekle
Pratik savunmalar:
- kaynakları kararlı sırada kilitlemek,
- transaction'ı kısa tutmak,
- kullanıcı/I/O beklemesini açık transaction içinde bırakmamak,
- deadlock/serialization failure için kontrollü retry politikası tasarlamak.
İki işlemin aynı kaynakları farklı sırada kilitlemesi, tek başına sorgular doğru olsa bile döngüsel bekleme oluşturabilir. Birinci işlem önce A sonra B kaydını, ikinci işlem önce B sonra A kaydını güncellemek isterse işlemler birbirini bekleyebilir. Tüm güncelleme yollarında kararlı bir kilit alma sırası kullanılması bu sınıf kilitlenmeleri azaltır; ancak indeks aralık kilitleri ve veritabanının izolasyon davranışı ayrıca incelenmelidir. Bir kilitlenmenin veritabanı tarafından sonlandırılması normal hata akışının parçasıdır: işlem bütünlüğü korunarak, sınırlı ve güvenli yeniden deneme tasarlanmalıdır.
15.4. View ile Materialized View Ayrımı
Normal view çoğunlukla saklanan sorgu tanımıdır:
SELECT ...ve okuma anında taban veriler üzerinden değerlendirilir.
Materialized view ise sorgu sonucunu fiziksel olarak saklar ve belirli zamanda yenilenir.
Bu nedenle:
view:
  daha güncel
  hesap maliyeti okumaya yakın

materialized view:
  hızlı okuma potansiyeli
  refresh ve bayatlık yönetimi
trade-off'u vardır.
15.5. Stored Procedure, Function, Trigger ve Cursor'ın Yeri
Bu yapılar veri tabanında çalışır fakat aynı sorumluluğa sahip değildir.
Function: değer veya ilişki üretebilen tekrar kullanılabilir veritabanı programı.
Procedure: transaction ve iş akışına göre işlem odaklı sunucu tarafı program.
Trigger: belirli veri olayıyla otomatik tetiklenen davranış.
Cursor: sonuç kümesi üzerinde satır/satır grubu yönelimli ilerleme mekanizması.
Bunların sözdizimi motorlara göre değişir. Oracle PL/SQL ayrıntıları için PL/SQL Programlama Temelleri notu kullanılmalıdır.
Trigger, constraint ile ifade edilebilen basit bütünlük kurallarının varsayılan yerine geçirilmemelidir. Görünmez yan etki ve çalışma sırası bakım maliyetini artırabilir.
15.6. Bütünlük Kuralını En Uygun Katmana Yerleştirmek
Genel tercih şu şekilde düşünülebilir:
tip / NOT NULL / CHECK / PK / FK / UNIQUE
        ↓ mümkünse
declarative database constraint

transactional cross-row rule
        ↓
transaction + locking/isolation

olay tabanlı zorunlu davranış
        ↓ gerektiğinde
trigger / stored program

yalnız UI/iş akışı doğrulaması
        ↓
application validation
Uygulama doğrulaması kullanıcı deneyimi için değerlidir; fakat birden fazla yazan istemci varsa veri tabanı bütünlüğünün tek savunması olmamalıdır.
15.7. İndeks ile Sorgu Operatörü Eşleşmesi
"İndeks var" ifadesi sorgunun hızlı olacağını garanti etmez.
Motorun:
- karşılaştırma operatörü,
- sıralama,
- collation,
- veri dağılımı,
- seçicilik,
- birleşim düzeni,
- erişilen kolonlar
hakkında ne bildiği önemlidir.
B-tree eşitlik ve sıralı aralık sorgularında güçlü olabilir. Metin, uzamsal veri, ters indeks veya çok büyük korelasyonlu tablolar başka indeks aileleri gerektirebilir.
"Clustered / nonclustered" gibi terimler de motor bağımsız evrensel fiziksel gerçekler değildir; ürünün storage ve index mimarisine göre yorumlanmalıdır.
15.8. Eşzamanlılıkta Doğru Soru
Transaction tasarımında şu sorular sorulmalıdır:
- Hangi invariant korunuyor?
- Aynı veriyi kimler yazabilir?
- Okuyucu hangi sürümü görmeli?
- Çatışma beklenen mi nadir mi?
- Hata durumunda transaction tekrar çalıştırılabilir mi?
- Yan etki transaction retry ile iki kez gerçekleşir mi?
- Kilit sırası ve süresi kontrollü mü?
Bu çerçeve ACID bilgisini gerçek eşzamanlı veri mühendisliğine bağlar.
15.9. Transaction Durumları, Recoverability ve İki Evreli Kilitleme
Transaction yürütmesi yalnız başladı → commit şeklinde iki durumlu değildir. Kuramsal modelde bir transaction active, son komutunu yürütmüş fakat kalıcılığı henüz kesinleşmemiş partially committed, başarıyla tamamlanmış committed, hata saptanmış failed veya geri alınmış aborted durumda bulunabilir. Bu durumlar, recovery ve dış yan etkilerin ne zaman güvenli kabul edileceğini anlamaya yardımcı olur.
Eşzamanlı schedule'larda yalnız conflict-serializability yeterli değildir. Bir transaction başka bir transaction'ın yazdığı değeri okuduysa commit sırası recovery davranışını etkiler:
- recoverable schedule: okunan değeri üreten transaction commit etmeden onu okuyan transaction commit etmez.
- cascadeless schedule: transaction'lar yalnız commit edilmiş değerleri okur; zincirleme rollback gereksinimini azaltır.
- strict schedule: bir transaction'ın yazdığı veri öğesi transaction tamamlanana kadar başka transaction tarafından okunmaz/yazılmaz; kurtarma mantığını daha da sadeleştirir.
İki evreli kilitleme (2PL — Two-Phase Locking), serializability sağlamak için kilit alma ve bırakmayı iki evreye ayırır:
genişleme evresi: yeni S/X kilitleri alınabilir, kilit bırakılmaz
küçülme evresi:   kilitler bırakılabilir, yeni kilit alınmaz
Paylaşımlı (S) kilit birlikte okumalara izin verirken dışlayan (X) kilit çakışan okuma/yazmaları sınırlar. Basic 2PL serializability hedefler; strict 2PL yazma kilitlerinin transaction sonuna kadar tutulmasıyla recovery davranışını kolaylaştırır; conservative 2PL gerekli kilitleri başta almaya çalışarak deadlock'u önlemeyi hedefler fakat concurrency'yi azaltabilir.
2PL deadlock'u kendiliğinden ortadan kaldırmaz. Seri hale getirilebilirlik, deadlock özgürlüğü ve yüksek concurrency ayrı özelliklerdir.
Havuz bekleme süresi ile kilit bekleme süresini ayırmak. Bir istemcinin SQL sonucunu geç alması, sorgunun CPU tüketerek uzun çalıştığını göstermez. İstek, daha bağlantı edinmeden uygulama havuzunda, bağlantıyı edindikten sonra başka transaction'ın kilidinde veya depolama erişiminde bekliyor olabilir. Bu sürelerin tek “SQL latency” metriğinde birleştirilmesi yanlış iyileştirme seçimine yol açar. Uygulama düzeyindeki connection acquisition, veritabanı düzeyindeki aktif çalışma ve wait event bilgisi tutarlı zaman pencerelerinde ilişkilendirilmelidir.
Daha büyük connection pool, transaction başına yürütülen SQL sayısını veya kilit kapsamını değiştirmez. Üstelik daha çok transaction'ın aynı kaynağa girmesine izin vererek lock contention'ı büyütebilir. Önce kilidin neden uzun tutulduğu, işlem içindeki harici I/O ve indeks erişim yolu incelenir; havuz boyutu ancak sonraki kapasite deneyiyle belirlenir. Bu kavramsal ayrım PostgreSQL, Oracle ve MariaDB için geçerlidir, fakat kilit türleri ve gözlem araçları motorlara göre değişir.
15.10. Anlık Görüntü Yalıtımında Çok Satırlı Değişmezler
Bir işlem kendi okuduğu sürümlerde tutarlı bir anlık görüntü görse bile, birden fazla satırı kapsayan iş kuralının korunacağı sonucu çıkmaz. Örneğin iki görevli bulunan bir tabloda ``en az bir görevli nöbette kalmalıdır'' kuralı olsun. Eşzamanlı iki işlem başlangıçta iki görevliyi de aktif görüp her biri farklı bir satırı pasifleştirirse, farklı satırlara yazdıkları için satır bazlı yazma çatışması oluşmayabilir; sonuçta kural ihlal edilir. Bu örnek write skew anomalisini gösterir. İlgili izolasyon düzeyinin gerçek garantileri kullanılan VTYS'ye göre doğrulanmalıdır.
Kuralı korumak için yalnızca sorgu içinde toplamı kontrol etmek yeterli değildir. İş kuralının uygun bir veritabanı kısıtıyla ifade edilebildiği durumlarda kısıt tercih edilir; aksi hâlde tüm karar katılımcılarını kapsayan kilitleme, serileştirilebilir yürütme veya atomik güncelleme modeli tasarlanır. Seçilen çözüm, phantom okuma ve kilit kapsamı açısından kullanılan motor üzerinde denenmelidir. Uygulama katmanındaki ``önce SELECT, sonra UPDATE'' sırası tek başına eşzamanlı güvenlik sağlamaz.
Doğrulama deneyinde iki ayrı bağlantı ve iki işlem kontrollü bariyerlerle aynı başlangıç sürümünden başlatılır. Okuma, güncelleme ve commit aşamaları farklı sırayla yürütülerek son durumun iş değişmezini sağlayıp sağlamadığı denetlenir. Test yalnızca hata alınıp alınmadığını değil, iki commit sonrasında ortaya çıkan veri durumunu değerlendirir; izolasyon seviyesi adı bir kanıt yerine geçmez.
15.11. MVCC, İzolasyon Anomalileri ve Yazma Eğriliği
Çok sürümlü eşzamanlılık kontrolü (MVCC), okuma işlemlerinin uygun sürüm görünürlüğü üzerinden çalışmasını sağlar; bunun bütün işlem anomalilerini önlediği sonucu çıkmaz. Snapshot isolation altında iki transaction aynı başlangıç durumunu okuyup farklı satırlara yazabilir ve her biri tek başına geçerli görünen kararlarla ortak iş kuralını bozabilir. Write skew, doğrudan aynı satır üzerinde yazma çakışması bulunmadan oluşabilen bu anomaliyi gösterir.
Bir iş kuralı farklı satır veya tablolar arasındaki değişmezle ifade ediliyorsa doğruluk sınırı yalnız bir satırın atomik güncellenmesi değildir. Veritabanının sağladığı isolation düzeyi, predicate/range kilitlemesi, unique/check constraint olanakları, serileştirilebilir yürütme ve uygulama düzeyindeki çatışma denetimi birlikte değerlendirilir. SELECT ile gözlenen koşulun daha sonra UPDATE sırasında hâlâ geçerli olacağı varsayımı, açık koruma veya yeniden doğrulama bulunmadıkça güvenli değildir.
Ünite 16: Dağıtık ve Genişleyen Veri Tabanı Yaklaşımları
16.1. Dağıtık Veri Tabanları: Konum, Parçalama ve Çoğaltma
Dağıtık veri tabanı, mantıksal olarak ilişkili verinin birden fazla site/düğümde tutulduğu fakat mümkün olduğunca tek bir veri tabanı soyutlaması altında yönetildiği modeldir. Tasarımın temel amacı yalnız veriyi farklı sunuculara koymak değil, dağıtımın hangi yönlerinin kullanıcı ve uygulamadan gizleneceğini belirlemektir.
Önemli saydamlık boyutları:
- konum saydamlığı: verinin hangi düğümde olduğunu uygulamanın bilmek zorunda olmaması,
- parçalama saydamlığı: mantıksal ilişkinin fiziksel parçalara ayrıldığının gizlenmesi,
- çoğaltma saydamlığı: aynı mantıksal verinin birden fazla kopyasının yönetilmesi,
- adlandırma saydamlığı: dağıtım nedeniyle nesne adlarının uygulama sözleşmesini bozmaması.
Yatay parçalama satırları koşullara göre, dikey parçalama nitelikleri anahtar ile birlikte farklı parçalara ayırır; karma yaklaşımlar ikisini birleştirebilir. Doğru parçalama, özgün ilişkinin yeniden kurulabilmesini ve verinin gereksiz kaybı/çoğalması olmamasını gözetmelidir.
Replikasyon okuma yakınlığı, kullanılabilirlik veya yedeklilik sağlayabilir; buna karşılık her yazının birden fazla kopyaya güvenli biçimde yayılması gerekir. Bu nedenle:
okuma yerelliği / kullanılabilirlik ↑
            ↕
yazma koordinasyonu / tutarlılık maliyeti ↑
şeklinde gerçek bir tasarım gerilimi vardır.
16.2. Dağıtık Sorgu İşleme
Merkezi sistemde pahalı olan disk ve CPU işlemlerine dağıtık sistemde iletişim maliyeti ve veri yerelliği de eklenir. Aynı mantıksal sorgu için şu kararlar önem kazanır:
- filtreyi hangi düğümde uygulamak,
- hangi sütunları/ara sonuçları ağ üzerinden taşımak,
- join'in hangi düğümde yapılacağı,
- küçük tarafı taşımak mı yoksa iki tarafı yeniden bölümlemek mi,
- kısmi aggregate sonuçlarını yerelde hesaplayıp birleştirmek mi.
Amaç yalnız SQL'i çalıştırmak değil, büyük ara sonuçların gereksiz ağ hareketini önlemektir. Bu düşünce, tek düğümdeki predicate/projection pushdown'ın dağıtık karşılığıdır.
16.3. İşlemle Tutarlı Olay Yayımlama
Bir veri tabanı satırının güncellenmesi ile dış mesaj kuyruğuna olay gönderilmesi iki ayrı kalıcılık alanını etkiler. Önce veri tabanına COMMIT, sonra mesaja gönderim yapılırsa aradaki çökme olayı kaybettirebilir. Önce mesaj gönderilirse işlem geri alındığında sistem gerçekte var olmayan bir değişimi duyurabilir. Veri tabanı işlemi dış ağ gönderimini kendiliğinden atomik hâle getirmez.
Transactional outbox yaklaşımında iş nesnesi değişikliği ve gönderilecek olay aynı yerel transaction içinde yazılır. COMMIT sonrasında ayrı bir dağıtıcı bu kalıcı olayları okur, gönderir ve teslim durumunu yönetir. Dağıtıcının gönderimden sonra fakat gönderildi bilgisini kaydetmeden çökmesi tekrar gönderime yol açabilir. Bu nedenle tüketicide olay kimliğiyle tekilleştirme veya aynı etkinin yeniden uygulanmasını engelleyen idempotent işlem tasarımı gerekir.
BEGIN -> iş verisini güncelle -> outbox kaydı ekle -> COMMIT
asenkron dağıtıcı -> olayı yayımla -> teslim bilgisini işle
Outbox atomik olarak değişiklik ile olayın kayda alınmasını sağlar; mesaj aracısında ya da tüketicide tam olarak bir kez yan etkiyi tek başına garanti etmez. Bu sınır hem hata sonrası toparlanma hem de dağıtık tutarlılık modelinin bir parçasıdır.
16.4. 2PL ile 2PC Aynı Şey Değildir
İsim benzerliğine rağmen iki mekanizma farklı problemleri çözer:
2PL — Two-Phase Locking
amaç: concurrency control / serializability

2PC — Two-Phase Commit
amaç: birden fazla katılımcıda atomik commit kararı
İki evreli tamamlama (2PC) sürecinde koordinatör önce katılımcılara hazırlık/vote sorusu gönderir. Bütün katılımcılar commit etmeye hazır olduğunu kalıcı biçimde kaydederse ikinci evrede global COMMIT; herhangi biri reddeder veya gerekli koşul sağlanmazsa ABORT kararı verilir.
1. evre: PREPARE / VOTE
2. evre: COMMIT veya ABORT
2PC'nin sağladığı temel özellik dağıtık atomikliktir; yüksek kullanılabilirlik veya conflict-serializability garantisi değildir. Koordinatör/katılımcı arızaları ve belirsiz karar pencereleri protokolün önemli işletim maliyetleridir.
16.5. Etkin Veri Tabanları ve ECA Modeli
Etkin (active) veri tabanı, yalnız açık kullanıcı komutlarına cevap vermekle kalmayıp tanımlı olaylar gerçekleştiğinde kuralları otomatik çalıştırabilir. Klasik model:
Event → Condition → Actionşeklindeki ECA yapısıdır.
SQL trigger'ları bu düşüncenin pratik karşılıklarından biridir. Ancak otomatik davranış; zincirleme tetiklenme, çalışma sırası, recursive etki ve görünmeyen yan etki gibi bakım riskleri oluşturabilir. Bu nedenle basit bütünlük kuralları mümkün olduğunda declarative constraint ile, gerçekten olay güdümlü zorunlu davranışlar ise kontrollü trigger/program mekanizmasıyla ifade edilmelidir.
16.6. Çıkarımsal Veri Tabanları
Çıkarımsal veri tabanları saklanan olguların (facts) yanında kurallar (rules) aracılığıyla yeni sonuçlar türetmeyi hedefler. İlişkisel veri ile mantıksal çıkarımın birleştiği bu yaklaşımda recursive sorgular ve kural bağımlılıkları temel kavramlardır.
Datalog ailesi bu düşünceyi anlatmak için yaygın bir kuramsal araçtır. Buradaki amaç Prolog veya mantıksal programlamayı yeniden öğretmek değil; veri tabanında "saklanan satır" ile "kurallardan türetilen sonuç" arasındaki ayrımı görünür kılmaktır.
16.7. Nesneye Yönelik Veri Tabanı Yaklaşımı ve Güncel Sınırı
Nesneye yönelik veri tabanı yaklaşımı; nesne kimliği, kapsülleme, kalıtım, karmaşık nesneler ve kalıcı nesne durumu kavramlarını veri tabanı modeline taşımayı amaçlar. Bu model ailesi tarihsel ve kavramsal olarak önemlidir; ancak güncel uygulamalarda birkaç farklı kavram birbirine karıştırılmamalıdır:
nesneye yönelik veri tabanı ≠ ORM
nesneye yönelik veri tabanı ≠ object-relational DBMS
nesneye yönelik veri tabanı ≠ document database
ORM, programlama dilindeki nesneler ile ilişkisel şema arasında eşleme katmanıdır; veri modelini otomatik olarak nesneye yönelik veri tabanına dönüştürmez. Object-relational sistemler ise ilişkisel çekirdeği karmaşık/user-defined türlerle genişletebilir.
16.8. Veri Ambarı ve OLTP/OLAP Ayrımı
Operasyonel veri tabanı çoğunlukla güncel iş işlemlerini düşük gecikmeyle ve tutarlı biçimde yürütmeye odaklanır. Veri ambarı ise farklı kaynaklardan gelen tarihsel veriyi analitik sorgular için bütünleştirmeyi hedefler.
OLTP: kısa, seçici, sık transaction
OLAP: geniş tarama, aggregate, tarihsel analiz
Fact/dimension ayrımı ve yıldız şeması, analitik sorgu desenlerini sadeleştirmek için kullanılan modelleme yaklaşımlarıdır. ETL/ELT süreci kaynak verinin çıkarılması, dönüştürülmesi ve analitik katmana yüklenmesini ifade eder. Operasyonel ve analitik iş yüklerini ayırmak, aynı fiziksel yapının her iki kullanım için de ideal olduğu varsayımından kaçınmayı sağlar.
16.9. Veri Madenciliğinin Veri Tabanı İçindeki Yeri
Veri madenciliği; büyük veri kümelerinde örüntü, ilişki veya tahmin yapısı arayan analitik yöntemler ailesidir. DBMS dersi açısından kritik nokta algoritmaların ayrıntısından çok veri hattıdır:
kaynak veri
   ↓
temizleme / bütünleştirme
   ↓
analitik veri kümesi / ambar
   ↓
madencilik / istatistiksel öğrenme
   ↓
doğrulama ve yorumlama
Veri tabanı katmanı; tip, bütünlük, provenance, tekrar üretilebilir sorgu ve tutarlı snapshot sağlayarak analitik sonucun güvenilirliğini doğrudan etkiler.
16.10. Web, Çoklu Ortam, Hareketli, Uzamsal Veri Tabanları ve Sayısal Kütüphaneler
Kaynakta ayrı uygulama aileleri olarak ele alınan bu başlıklar, bugün de farklı veri erişim problemlerini anlamak için değerlidir:
- Web üzerinden veri tabanı erişimi: istemci → uygulama/API → connection pool → DB sınırı; kimlik, yetki, parametreli sorgu ve transaction sınırının uygulama katmanında yönetilmesi.
- Çoklu ortam verisi: büyük ikili nesnenin kendisi ile aranabilir metadata'nın ayrılması; BLOB saklama ile harici nesne depolama arasında boyut, transaction ve erişim deseni temelli seçim.
- Hareketli/offline istemci verisi: kesintili bağlantı, yerel kopya, senkronizasyon, bayat veri ve çakışma çözümü problemleri.
- Coğrafi/uzamsal veri: nokta, çizgi, alan gibi geometri türleri; uzamsal predicate'ler ve sıradan B-tree'den farklı indeksleme gereksinimleri.
- Sayısal kütüphane: belge kimliği, bibliyografik/semantik metadata, tam metin erişimi, sürüm/provenance ve uzun süreli koruma gereksinimleri.
Bu uygulama aileleri yeni bir ilişkisel kuram oluşturmaz. Aynı temel veri yönetimi ilkelerinin farklı veri türü, erişim deseni ve tutarlılık beklentileri altında nasıl değiştiğini gösterir.
16.11. İlişkisel Model, Property Graph ve RDF Arasında Seçim
"Graf veritabanı" tek bir veri modeli değildir. İlişkisel model, property graph ve RDF aynı ilişkiyi farklı kimlik, semantik ve sorgu varsayımlarıyla temsil eder.
İlişkisel model satırları ilişkilere, bütünlüğü anahtar ve constraint'lere dayanarak düzenler. Bağlantılar foreign key ve join ile ifade edilir. Çok sayıda ilişki bulunması tek başına graf veritabanına geçme gerekçesi değildir; bounded ve iyi indekslenen join zincirleri ilişkisel sistemde son derece verimli olabilir.
Property graph yaklaşımında düğüm ve kenarlar birinci sınıf varlıklardır; her ikisi de özellik taşıyabilir. Değişken uzunluklu traversal, komşuluk ve yol soruları veri modelinin merkezindedir:
(node)-[edge {properties}]->(node)RDF ise bilgiyi subject-predicate-object üçlüleriyle ve küresel olarak adlandırılabilir IRI'larla ifade eder:
subject predicate objectRDF'nin güçlü yanı yalnız "graf olması" değil; farklı kaynakların ortak vocabulary üzerinden birleştirilmesi, açık dünya/semantik web ekosistemi ve entailment katmanlarıyla ilişkilendirilebilmesidir. Property graph içindeki yerel id ile RDF içindeki IRI aynı kimlik sözleşmesi değildir.
Model seçimi erişim deseninden başlamalıdır:
yoğun transaction + güçlü tablo bütünlüğü + bounded join   -> relational güçlü aday
değişken uzunluklu yol + edge property + traversal        -> property graph doğal aday
kaynaklar arası semantik entegrasyon + ortak vocabulary    -> RDF doğal aday
Graf modeline geçiş performansı otomatik artırmaz. Traversal derinliği sınırlıysa, veri çoğunlukla tablosalsa ve constraint/transaction yapısı baskınsa yeni model ek operasyonel maliyet üretebilir. Tersine sürekli recursive join ile yol aranan bir ilişkisel şema da problemin doğal yapısını gizliyor olabilir.
Ayrıca aynı gerçek dünya olgusunun birden fazla kaynaktan geldiği sistemlerde source, valid_time, observed_at, sürüm ve provenance alanları ilişki kadar önemlidir. Grafın kenarı "ilişki var" der; ilişkinin hangi kaynağa göre, hangi zaman aralığında ve hangi güven düzeyinde geçerli olduğu ayrı tasarlanmalıdır.
16.12. Veri Sisteminde Doğruluk ve Performansın Birlikte Tasarımı
Veri yoğun sistemlerde güvenilirlik, ölçeklenebilirlik ve bakım yapılabilirlik aynı tasarım kararının farklı sonuçlarıdır. Bir VTYS'de sorgu maliyetini yalnız SQL metni açıklamaz; fiziksel depolama ve erişim yolu, indeks seçimi, veri kodlama biçimi, partition pruning, replikasyon gecikmesi ve transaction sınırı birlikte incelendiğinde optimizer kararının neden hızlı, yavaş veya arıza koşullarına hassas olduğu anlaşılır. Özellikle türetilmiş verinin kaynağı, yeniden üretilebilirliği ve gecikme bütçesi açık tanımlanmalıdır.
- İndeks seçiminin okuma kazancı ile write amplification maliyetinin birlikte ölçülmesi.
- Replikasyon gecikmesi ile okuma tutarlılığı beklentisinin açık bağlanması.
- Batch ve stream türetilmiş verilerinin hangi kaynaktan yeniden üretileceğinin tanımlanması.
Replica üzerinden okumanın tazelik sözleşmesi. Birincilden başarılı commit dönmesi, asenkron çoğaltılan ikincilde değişikliğin hemen görünür olacağını garanti etmez. “Yaz ve hemen oku” akışlarında kullanıcıya kendi yazdığını göstermek gerekiyorsa, o okuma için birincile yönlendirme, replikasyon konumunun izlenmesi veya uygulama düzeyinde tazelik denetimi gerekir. Replica'nın daha fazla okuma kapasitesi sağlaması ancak kabul edilen veri gecikmesi sınırıyla birlikte değerlendirilebilir.
Dağıtık sorgularda taşıma maliyeti kadar sonuç doğruluğu da ele alınmalıdır. Tekrarlı deneme idempotent değilse ağ kopması sonrasında iki kez güncelleme oluşabilir. Veritabanı dışı olay yayımlama da atomik commit'in doğal parçası değildir. Bu nedenle tutarlılık seviyesi, gecikme hedefi, failure mode ve yeniden deneme protokolü birlikte belirlenmelidir.
16.13. Sayfalı Sorgulamada Kararlı Sıralama ve Kesit Tutarlılığı
Sayfalı veri erişiminde ORDER BY tarih gibi eşitlikleri çözmeyen sıralama, aynı kayıtların iki sayfada yinelenmesine veya atlanmasına yol açabilir. Kararlı sıralama, eşit tarihlerin sonunda değişmez ve benzersiz bir anahtar kullanır. Offset tabanlı sayfalama, ön sayfalara yeni kayıt eklendiğinde aynı kesitin korunmasını kendiliğinden sağlamaz. Keyset yaklaşımı son görülen sıralama anahtarına dayanarak ilerler; ancak o da eşzamanlı güncellemelerde tam bir veri tabanı anlık görüntüsü garantisi değildir.
Kayıt kümesinin 'tam' olduğu iddiası için sorgu anındaki görünürlük, filtre, üst sınır ve sayfa devam bilgisi belirtilmelidir. Bir iş akışında ilk sayfa okunduğunda diğer sayfaların aynı sürümü yansıtması gerekiyorsa uygun transaction izolasyonu veya açık snapshot mekanizması değerlendirilmelidir. Uzun süren transaction'ın kaynak maliyeti ayrıca ölçülmelidir.
Örnek olarak aynı tarih-saat değerine sahip sentetik on kayıt, sabit boyutlu üç sayfada okunur. Değişmez, yinelenen kimlik olmaması ve sabit snapshot altında birleşimin tam referans kümesine eşit olmasıdır. Eşzamanlı yazma eklendiğinde testin beklenen davranışı seçilen tutarlılık sözleşmesine göre yeniden ifade edilir.
16.14. Analitik Sonuçlarda Kaynak Tamlığı ve Zaman Kapsamı
Bir sorgunun döndürdüğü N kayıt, her zaman ilgili tüm verinin N kayıt olduğu anlamına gelmez. Yetki filtresi, zaman aralığı, üst satır sınırı ve başarısız sayfa yüklemesi gözlenen kümenin kapsamını değiştirir. Analitik fonksiyon sonuç, gözlenen kayıt sayısı, kesildi mi, başlangıç/bitiş zamanı ve veri sürümü bilgilerini mantıksal olarak birbirinden ayırmalıdır.
Örnekleme veya LIMIT ile kesilmiş veri üzerinde grafik merkeziyeti, oran veya yüzdelik hesaplanacaksa payda ve kapsam belirtilmelidir. Sonuçları 'kesin' gösterme eğilimi yalnız arayüz hatası değil veri mühendisliği hatasıdır. Çoğu durumda eksik kapsamı bildirmek, daha pahalı tam sorguyu otomatik başlatmaktan güvenilir ve performans açısından daha kontrollüdür.
16.15. İlerleme İşaretçisi ve Tekrarlanabilir Veri Doldurma
Büyük bir veri kümesinin geriye dönük doldurulmasında işlem sınırı, sayfalama anahtarı ve yeniden başlatma davranışı birlikte tasarlanır. Yalnız OFFSET kullanmak, eşzamanlı ekleme veya silmeler altında tekrar ve atlama üretebilir; kararlı bir sıralama anahtarı ve anahtar aralığı üzerinden ilerleme çoğu durumda daha öngörülebilirdir. Kaynak satırın değiştirilmesi veya bölüm anahtarının taşınması olasılığı ayrıca modellenmelidir.
Geriye dönük doldurma işlemi için ilerleme işaretçisi, işlenen aralığın commit edilmesiyle tutarlı yönetilir. Hedef yazımı idempotent ise başarısız aralık güvenle tekrar denenebilir; değilse yinelenen yazım ayrı veri bozulması kaynağına dönüşür. İş hacmi sınırlaması, küçük transaction'lar, satır kilidi beklemeleri ve kısmi başarısızlık göstergeleri uzun süreli işin canlı işlem yükünü bozmasını önlemek için izlenir.
Kaynakça
- Abraham Silberschatz; Henry F. Korth; S. Sudarshan. Database System Concepts. McGraw-Hill, 2010.
- Apache Software Foundation. Apache Cassandra Documentation. https://cassandra.apache.org/doc/stable/
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- E. F. Codd. A Relational Model of Data for Large Shared Data Banks. Communications of the ACM, 1970. DOI
- IBM. Db2 Documentation. https://www.ibm.com/docs/en/db2
- Martin Kleppmann. Designing Data-Intensive Applications. 1st ed. O’Reilly Media, 2016.
- Patrick Lewis et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” Advances in Neural Information Processing Systems, 33, 2020.
- Peter P. Chen. The Entity-Relationship Model: Toward a Unified View of Data. ACM Transactions on Database Systems, 1976. DOI
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation — Concurrency Control (MVCC). https://www.postgresql.org/docs/18/mvcc-intro.html
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation — EXPLAIN. https://www.postgresql.org/docs/18/sql-explain.html
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation — Routine Vacuuming. https://www.postgresql.org/docs/18/routine-vacuuming.html
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation — WAL Internals. https://www.postgresql.org/docs/18/wal-internals.html
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation: Concurrency Control. https://www.postgresql.org/docs/18/mvcc.html
- Ramez Elmasri; Shamkant B. Navathe. Fundamentals of Database Systems. Addison-Wesley, 2010.
- Yu. A. Malkov, D. A. Yashunin. “Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs.” IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4), 2020. https://doi.org/10.1109/TPAMI.2018.2889473
- Ünal Yarımağan. Veri Tabanı Sistemleri, 2. Basım. Akademi Yayıncılık, 2010.
- World Wide Web Consortium. RDF 1.2 Concepts and Abstract Data Model. Candidate Recommendation Snapshot, 7 April 2026. https://www.w3.org/TR/rdf12-concepts/