


Doğal Dil İşleme


Türkçe ağırlıklı doğal dil işleme; Unicode ve normalizasyon, tokenlaştırma, biçimbilim, sözdizimi, anlambilim, istatistiksel NLP, Transformer, çok dilli modeller, konuşma, LLM ve üretim mühendisliğini karşılaştırmalı ele alan kapsamlı ders notu.
Doğal dil işleme (Natural Language Processing, NLP), insan dillerinin bilgisayarlarla çözümlenmesi, dönüştürülmesi, aranması, sınıflandırılması, üretilmesi ve başka bilgi temsilleriyle ilişkilendirilmesiyle ilgilenir. Alan yalnızca metin üretmekten veya bir büyük dil modeline soru sormaktan ibaret değildir. Karakter kodlamasından biçimbilime, sözdiziminden anlambilime, bilgi erişiminden konuşma tanımaya ve dil modellerine kadar uzanan çok katmanlı bir mühendislik alanıdır.
Bu ders Türkçe ağırlıklıdır. Bunun nedeni Türkçenin yalnızca örnek dili olarak seçilmesi değildir. Türkçenin eklemeli yapısı, üretken türetme ve çekim sistemi, ünlü uyumu, biçimbilimsel belirsizlik, görece serbest öge dizilişi ve yazı–ses ilişkisi, birçok NLP varsayımını görünür hâle getirir. İngilizce için makul görünen bir sözcük temsili Türkçede veri seyrekliğini büyütebilir; Çince için sözcük sınırı problemi öne çıkarken Arapçada kök–kalıp ilişkisi ve bitişik biçimbirimler farklı bir çözümleme gerektirir. Bu nedenle iyi bir NLP sistemi "dil bağımsız" olduğunu söylemekten önce hangi dilsel varsayımlara dayandığını açıkça belirtmelidir.
Yapay Zeka: Felsefe, Kuram ve Uygulama, Yapay Sinir Ağları ve Öğrenme Modelleri, İstatistiksel Öğrenme ve Makine Öğrenmesi, Mantıksal Programlama ve Prolog ve Büyük Dil Modelleri dersleri doğal dil işlemenin öğrenme kuramı ve model mimarisi bağlamını tamamlar. Buradaki odak, doğal dilin bilgisayarlı işlenmesinde gerekli temsil ve kararları açıklamaktır.
ham dil verisi
     |
     v
kodlama ve normalizasyon
     |
     v
bölütleme / tokenlaştırma
     |
     v
biçimbilim
     |
     v
sözdizimi
     |
     v
anlam ve söylem
     |
     v
görev modeli
     |
     v
değerlendirme ve üretim sistemi
Bu akış zorunlu bir ardışık boru hattı değildir. Modern uçtan uca modeller bu katmanların bir bölümünü örtük olarak birlikte öğrenebilir. Buna karşın hata çözümleme, veri hazırlama ve üretim mühendisliği sırasında aynı ayrımlar yeniden karşımıza çıkar.
Ünite 1: Doğal Dil İşlemenin Problem Alanı
1.1. Doğal Dil İşlemenin Temel Güçlükleri
Programlama dili tasarım gereği belirli bir sözdizimine sahiptir. Doğal dil ise tarihsel, toplumsal ve bilişsel süreçlerle gelişir. Aynı anlam farklı biçimlerde ifade edilebilir; aynı yüzey biçimi farklı bağlamlarda farklı anlamlara gelebilir.
Örneğin:
Yüz lira verdim.
Denizde yüz.
Yüz ifadesi değişti.
Aynı yüz karakter dizisi sayı, eylem veya ad olabilir. Yalnız sözlük araması bu ayrımı çözmez.
Benzer biçimde:
Ali kitabı masaya bıraktı.
Kitabı Ali masaya bıraktı.
Masaya kitabı Ali bıraktı.
Türkçede durum ekleri ve söylem yapısı sayesinde öge sırası değişebilir. Cümlelerin odak ve vurgu özellikleri aynı değildir; ancak temel olay ilişkisi büyük ölçüde korunabilir.
NLP bu nedenle yalnız dizgi işleme değildir. Karakter, sözcük, biçimbirim, tümce, söylem ve dünya bilgisi farklı seviyelerde rol oynar.
1.2. NLP Görevleri
NLP görevleri tek bir sınıflandırma altında toplanamaz. Başlıca problem aileleri şunlardır:
- metin normalizasyonu ve yazım işleme,
- sözcük ve alt sözcük bölütleme,
- kök, gövde ve biçimbirim çözümleme,
- sözcük türü belirleme,
- adlandırılmış varlık tanıma,
- sözdizimsel çözümleme,
- ilişki ve olay çıkarımı,
- anlam benzerliği,
- bilgi erişimi,
- metin sınıflandırma,
- duygu ve tutum çözümleme,
- soru yanıtlama,
- özetleme,
- makine çevirisi,
- konuşmadan metne ve metinden konuşmaya geçiş,
- diyalog sistemleri,
- dil modelleme ve metin üretimi.
Bu görevlerin bir bölümü ayrı modellerle çözülebilir. Bir bölümü ise ortak bir önceden eğitilmiş modelin farklı görev başlıklarıyla uyarlanması yoluyla ele alınabilir.
1.3. Kural, İstatistik ve Öğrenilmiş Temsil
NLP tarihinde üç yaklaşım sürekli birbirine temas etmiştir:
açık kural
  |
  +--> sözlük / dilbilgisi / sonlu durum modeli

istatistiksel model
  |
  +--> n-gram / HMM / Naive Bayes / CRF

öğrenilmiş temsil
  |
  +--> gömme vektörü / RNN / Transformer / büyük dil modeli
Bunlar birbirini bütünüyle ortadan kaldırmaz. Türkçe karakter normalizasyonunda sabit bir dönüşüm tablosu en doğru çözüm olabilirken, adlandırılmış varlık tanımada bağlamsal bir Transformer modeli daha uygun olabilir. Üretim sisteminde iki yaklaşım aynı akışta da bulunabilir.
Ünite 2: Dil Tipolojisi ve NLP Tasarımı
2.1. Dil Bağımsız Algoritmaların Sınırları
Bir algoritma Unicode metin alıp karakter dizisi üzerinde çalışıyorsa teknik olarak çok sayıda dili kabul edebilir. Bu, dilbilimsel olarak aynı doğrulukta çalışacağı anlamına gelmez.
Dil özellikleri şu kararları etkiler:
- sözcük sınırının nasıl belirleneceği,
- söz varlığının büyüklüğü,
- biçimbirimlerin nasıl ayrılacağı,
- özne–nesne ilişkilerinin sözcük sırasından mı eklerden mi çıkarılacağı,
- büyük–küçük harf dönüşümü,
- yazı ve ses arasındaki ilişki,
- bilinmeyen sözcük davranışı,
- alt sözcük sözlüğünün verimliliği,
- değerlendirme ölçütünün neyi cezalandırdığı.
2.2. Türkçe
Türkçe eklemeli bir dildir. Kök veya gövdenin sonuna art arda ekler gelebilir.
Özgün bir örnek:
ev
evler
evlerimiz
evlerimizde
evlerimizdekiler
evlerimizdekilerden
Bu zincirin her aşaması yeni dilbilgisel bilgi taşır. İngilizcede bir bölümünün ayrı sözcüklerle ifade edilmesi gerekir.
Türkçe için NLP açısından önemli özellikler:
- üretken çekim ve türetme,
- ünlü uyumu ve ünsüz değişimleri,
- eklerin çok sayıda yüzey biçimi,
- durum eklerinin sözdizimsel rol taşıması,
- görece serbest öge dizilişi,
- büyük–küçük harfte
i/İveı/Iayrımı, - yabancı köklerin Türkçe eklerle birleşebilmesi,
- apostrof ve özel ad kullanımının biçimbilimle etkileşmesi,
- konuşma dilinde düşme, uzatma ve yazı dışı varyasyonlar.
2.3. İngilizce
İngilizce Türkçeye göre daha sınırlı çekimsel biçimbilime ve daha belirgin sözcük sırasına sahiptir.
The engineer tested the model.
The model tested the engineer.
Sözcüklerin konumu değiştiğinde özne–nesne ilişkisi de değişir. Türkçede durum ekleri bu ilişkinin daha fazla korunmasını sağlayabilir.
İngilizce için boşluk tabanlı ilk bölütleme çoğu zaman kullanılabilir bir başlangıçtır; ancak don't, New York, e-mail, noktalama ve birleşik ifadeler yine özel kararlar gerektirir.
2.4. Almanca
Almanca çekim, cinsiyet ve durum bilgisiyle birlikte üretken birleşik sözcüklere sahiptir. Uzun bileşikler sözlük dışı sözcük oranını artırabilir. Bu nedenle bileşik çözümleme ve alt sözcük temsilleri önem kazanır.
Daten + Verarbeitung + SystemBurada yalnız boşluk aramak anlamlı birimlerin tamamını vermez.
2.5. Arapça
Arapçada kök–kalıp biçimbilimi ve sözcüğe bitişebilen bazı işlevsel parçalar, yüzey biçiminin doğrudan kök olarak kullanılmasını güçleştirir. Kısa ünlülerin çoğu günlük yazıda gösterilmez. Aynı yazılı biçimin birden fazla okuma ve çözümlemeye açık olması bağlamın önemini artırır.
Türkçedeki temel düşünce:
kök + ek + ek + ekiken Arapça için yalnız bu doğrusal şema yeterli değildir. Kök ünsüzler, kalıp ve bitişik parçalar birlikte değerlendirilir.
2.6. Çince
Modern Çince yazıda sözcükler arasında zorunlu boşluk bulunmaz. Karakter dizisini sözcük birimlerine ayırmak başlı başına bir NLP kararıdır.
Bu durum şu önemli sonucu doğurur:
karakter sınırı != sözcük sınırıKarakter tabanlı, sözcük tabanlı ve alt sözcük tabanlı modeller farklı maliyet ve belirsizlik taşır.
2.7. Japonca
Japoncada kanji, hiragana ve katakana aynı metinde birlikte bulunabilir. Sözcük sınırları boşlukla düzenli biçimde işaretlenmez. Biçimbilimsel çözümleme ile bölümleme genellikle birlikte ele alınır.
2.8. Diğer Türk Dilleri
Azerbaycanca, Kazakça, Kırgızca, Özbekçe ve diğer Türk dilleri Türkçeyle yapısal benzerlikler paylaşır; ancak alfabe, ses olayları, ek envanteri, söz varlığı ve kaynak miktarı aynı değildir. Yakın dil olmak doğrudan model aktarımının hatasız olacağı anlamına gelmez.
Çok dilli bir modelde ortak alt sözcükler ve benzer biçimbirim örüntüleri aktarımı kolaylaştırabilir. Buna karşılık farklı yazı sistemleri veya dengesiz eğitim verisi temsil kalitesini sınırlayabilir.
Ünite 3: Unicode, Yazım ve Normalizasyon
Dil verisinin normalleştirilmesinde önce uygulamanın korunmasını istediği ayrımlar belirlenir. Unicode eşdeğerliği, büyük-küçük harf ve noktalama dönüşümleri ayrı ayrı uygulanıp ölçülmelidir; bazı dönüşümler ad, kod veya delil niteliğindeki bilgileri geri döndürülemez biçimde değiştirebilir. Ham metin ile normalize edilmiş gösterim arasındaki ilişki korunduğunda daha sonraki metin eşleştirmelerinin kökeni denetlenebilir. Türkçe harf dönüşümleri genel İngilizce harf kurallarıyla otomatik olarak eşitlenmemelidir.
3.1. NLP'nin İlk Katmanı Karakterdir
Metin ekranda doğru görünse bile bellekte beklenen kod noktalarıyla temsil edilmeyebilir. Unicode normalizasyon biçimleri, birleşik ve ayrık karakter gösterimleri, kontrol karakterleri ve görünmez boşluklar veri eşitliğini etkileyebilir.
Bir NLP hattında şu ayrımlar açık olmalıdır:
bayt
  -> kod çözme
Unicode kod noktaları
  -> normalizasyon
karakter dizisi
  -> dilsel bölümleme
token / biçimbirim / alt sözcük
Bayt seviyesindeki bozukluğu modelin "anlaması" beklenmemelidir.
3.2. Türkçe Büyük–Küçük Harf
Türkçede:
i <-> İ
ı <-> I
eşleşmesi vardır. İngilizce odaklı bir büyük–küçük harf dönüşümü I ile i arasında doğrudan eşleme yapabilir. Bu durum Türkçe arama, indeksleme, ad eşleştirme ve sözlük işlemlerinde hata üretir.
Bu nedenle yerel ayara bağlı dönüşüm ile dil bağımsız casefold aynı sözleşme gibi kullanılmamalıdır.
3.3. ASCII'ye İndirgeme ve Bilgi Kaybı
Türkçe karakterleri ASCII karşılıklarına dönüştürmek bazı arama ve eski sistem uyumluluğu senaryolarında yararlı olabilir:
ç -> c
ğ -> g
ı -> i
ö -> o
ş -> s
ü -> u
Ancak dönüşüm tersinir değildir. sık ve sik gibi farklı diziler aynı ASCII alanına yaklaşabilir. Bu nedenle ASCII'ye indirgeme bir "düzeltme" değil, belirli bilgi sınıflarını bilinçli olarak atan bir gösterim dönüşümüdür.
Bu konu Türkçe Metinlerde Tablo Tabanlı ASCII Dönüşümü çalışmasında deterministik ve düşük maliyetli uygulama açısından ayrıca ele alınır.
3.4. Deasciification
ASCII yazılmış Türkçe metni yeniden Türkçe karakterlere dönüştürmek ters yöndeki dönüşümden daha zordur:
cagri -> çağrı
sag -> sağ
sik -> ?
Son örnekte yalnız karakter ailesi yeterli değildir; bağlam gerekir. C# ile Türkçe Deasciification çalışmamda bağlama dayalı karar listesinin, küçük ve deterministik bir NLP modelinin üretim davranışını nasıl belirlediğini incelemiştim.
Bu örnek, modern sinir ağlarından bağımsız önemli bir NLP ilkesini gösterir: problem dar ve karar sınırı iyi tanımlıysa küçük bir model, genel amaçlı büyük bir modele göre daha denetlenebilir olabilir.
3.5. Unicode Eşdeğerliği ve Türkçe Metin Anahtarları
Görsel olarak aynı görünen iki metin, farklı Unicode kod noktası dizileriyle temsil edilebilir. Örneğin birleşik karakter ile temel harfin ardından gelen birleştirme işareti bazı durumlarda aynı görüntüyü oluşturur; bunların bayt düzeyi eşitliği garanti değildir. Metin karşılaştırma hattında NFC gibi normalizasyon biçimi seçilebilir, ancak özgün metin silinmemelidir. Kimlik belirleme, arama anahtarı üretimi ve kullanıcıya gösterim farklı semantik sorumluluklardır.
Türkçede büyük-küçük harf dönüşümü özellikle I, İ, ı ve i bakımından dil duyarlıdır. Dil bağımsız bir lowercase işleminin Türkçe arama anahtarı için doğru olduğu varsayılamaz. Diğer taraftan fonetik veya ASCII'ye indirgenmiş anahtar da tekil kimlik değildir: farklı sözcükler aynı anahtara dönüşebilir. Tam metin arama, yaklaşık eşleme ve hukuki kimlik alanları aynı normalize edilmiş dizeyle depolanmamalıdır.
Doğrulama kümesi birleşik/ayrışmış kod noktalarını, Türkçe harfleri, karma alfabeleri, boşlukların farklı biçimlerini ve bozuk UTF-8 girişlerini ayrı ayrı içermelidir. Uygulama her dönüşüm için geri döndürülebilirlik özelliğini açıkça belirtmelidir. Birebir özgün metin gerekiyorsa normalize anahtar yalnız türetilmiş sütun veya geçici indeks olarak tutulur. Arama başarısındaki artışın yanlış eşleşme oranını artırıp artırmadığı ölçülmeden yeni bir normalizasyon politikası üretime alınmamalıdır.
3.6. Metin Normalizasyonunda Kaynak Konum Eşlemesi
Unicode normalizasyonu, büyük/küçük harf dönüşümü ve karakter temizliği metnin uzunluğunu veya kod noktası dizisini değiştirebilir. Normalleştirilmiş metinde bulunan bir varlık aralığını doğrudan özgün belgenin karakter indeksleriyle işaretlemek bu yüzden güvenilir değildir. Örneğin tek bir görünür işaret birden fazla Unicode kod noktasından oluşabilir; JavaScript dizgilerinde konumlar UTF-16 kod birimi sayısına göre tutulurken başka bir katman UTF-8 bayt konumu kullanabilir.
Çözüm, normalizasyon sırasında dönüştürülmüş her aralığın kaynak metindeki başlangıç ve bitiş sınırlarını ilişkilendiren bir köken haritası taşımaktır. Çoktan-bire dönüşümde tek kaynak konumu varsaymak yerine aralık veya çoklu kaynak karşılığı saklanır. Kaynağı olmayan sentetik karakterler açıkça işaretlenir. Tokenizer çıktısı, arama vurgusu, NER etiketi ve belge dışa aktarımı aynı ofset sözleşmesini kullanırsa farklı katmanlarda işaretlenen kanıt bölgesi tutarlı kalır.
Doğrulama, birleşik aksanlar, emoji dizileri, Türkçe İ/ı, birden fazla boşluğun sıkıştırılması ve değiştirilmiş satır sonları gibi örnekleri içerir. Normalizasyon arama için yararlı olsa bile saklanan kaynak metnin üzerine geri yazılmamalıdır. İşaretleme, daima özgün metin ve açıkça kayıt altına alınmış dönüşüm zinciri üzerinden yeniden kurulabilmelidir.
3.7. Türkçe Metinde Geri Dönüşümlü ve Bilgi Kaybettiren Normalizasyon
Türkçe metin işleme hattında İ/i, I/ı, diakritik işaretleri, Unicode birleşim biçimleri ve kaynak karakter kodlaması yalnız estetik farklar değildir. ş harfinin s olarak değiştirilmesi veya büyük/küçük harf dönüşümünün yanlış locale ile uygulanması, farklı sözcükleri aynı temsile indirgeyebilir. Bu nedenle normalizasyon fonksiyonunun bire bir, çoktan bire veya bağlama bağımlı olup olmadığı belirtilmelidir.
Arama ve fonetik eşleme için kullanılan kayıplı normalizasyon, adli kanıtın veya özgün belgenin yerine geçemez. Kaynak dize, normalleştirilmiş temsil, uygulanan işlem sırası ve gerekiyorsa karakter ofset eşlemesi ayrı saklanır. Birden fazla dönüşümün bileşkesi her zaman yer değiştirmez: Unicode normalizasyonu, case folding, Türkçe karakter dönüştürme ve tokenleştirme sırası sonucu etkileyebilir. Değerlendirme, normalleştirme başarısı yanında yanlış birleştirilmiş farklı sözcükleri de raporlamalıdır.
Ünite 4: Bölütleme, Tokenlaştırma ve Alt Sözcükler
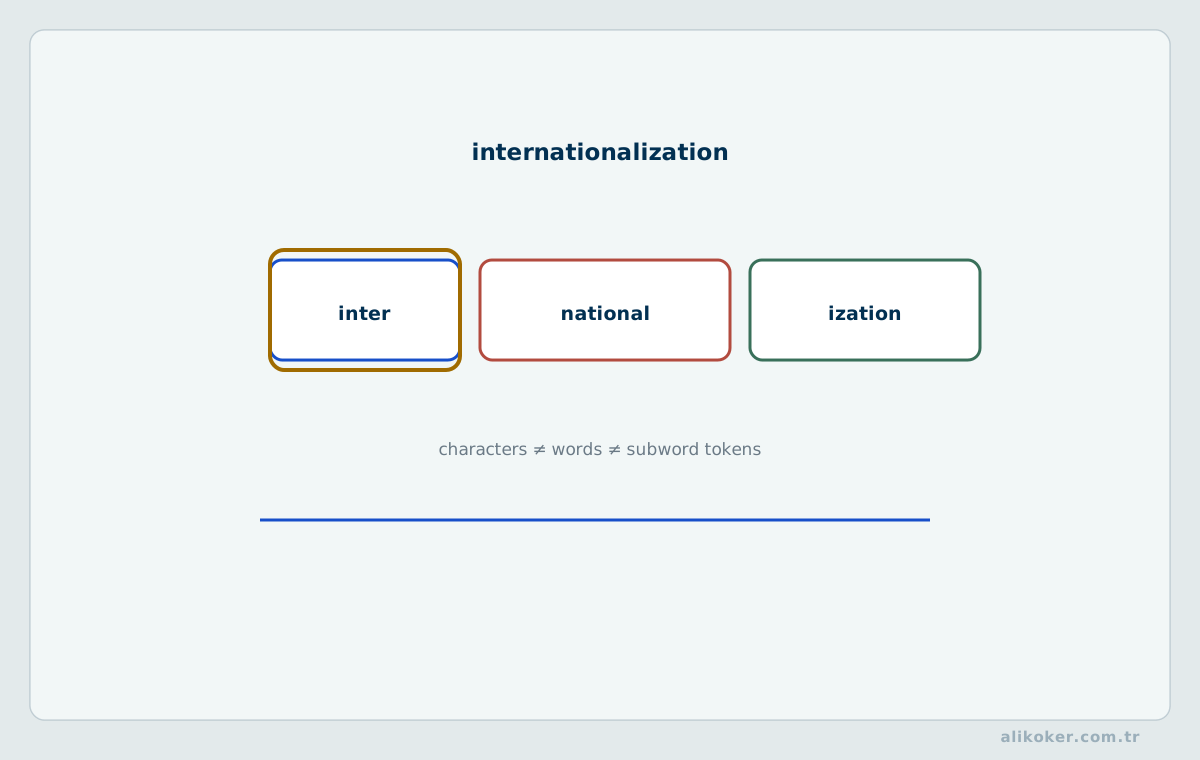
Bölütleme için önce çıktı biriminin sözcük, alt sözcük veya biçimbirim olup olmayacağı göreve göre seçilir. Kısaltmalar, sayılar, birleşik sözcükler ve eklemeli biçimler üzerinde sınır kararları karşılaştırılır. Bir tokenleştiricinin ortalama parça sayısının düşük olması her zaman iyi çözüm değildir; sonraki modelin kullanacağı anlamlı ayrımları kaybetmesi de mümkündür. Değerlendirme, etiketlenmiş sınır örnekleri ve aşağı akış görev başarımıyla birlikte yapılmalıdır.
4.1. Token Doğal bir Gerçeklik Değildir
"Token" çoğu zaman modelin işlediği temel birimdir; dilbilimdeki "sözcük" ile aynı şey olmak zorunda değildir.
metin
  -> karakter
  -> sözcük adayı
  -> alt sözcük
  -> model tokenı
Bir model için tek token olan dizi başka modelde üç parçaya ayrılabilir.
4.2. Boşluk Tabanlı Bölütlemenin Sınırı
Türkçede boşluk sözcük sınırı için güçlü bir ipucudur; ancak:
- sayılar ve birimler,
- kısaltmalar,
- özel adlar,
- URL ve e-posta adresleri,
- emojiler,
- çok sözcüklü ifadeler,
- noktalama,
- hatalı yazım,
- birleşik ve ayrı yazım tercihleri
nedeniyle tek başına yeterli değildir.
4.3. Türkçede Alt Sözcük İhtiyacı
Eklemeli yapı yüzünden sözcük biçimlerinin sayısı hızla büyür. Sözcük düzeyinde sabit bir sözlük kullanıldığında nadir ve görülmemiş biçimler artar.
Şu biçimler aynı kökten türeyebilir:
model
modeli
modelin
modeller
modellerimiz
modellerimizden
Alt sözcük sistemi bu ortaklığı kısmen yakalayabilir.
4.4. BPE, Unigram ve SentencePiece
Byte Pair Encoding benzeri yöntemler sık tekrar eden sembol çiftlerini birleştirerek alt sözcük sözlüğü oluşturur. Unigram yaklaşımı ise olası parçalardan bir sözlük kurup bir dizinin olası bölümlemelerini olasılıksal olarak değerlendirir.
SentencePiece'in önemli mühendislik yaklaşımı, önceden sözcüklere ayrılmış girdi zorunluluğunu kaldırıp ham metin üzerinden alt sözcük modeli eğitebilmesidir.
Ancak alt sözcük sınırları dilbilimsel biçimbirim sınırları olmak zorunda değildir.
dilbilimsel çözüm:
ev + ler + imiz + den

alt sözcük modeli:
evl + erimiz + den
İkinci bölümleme model için yararlı olabilir; fakat "doğru morfolojik çözüm" diye yorumlanmamalıdır.
Bu ayrım SentencePiece ile Metin Parçalama Sınırları çalışmasında normalizasyon ve sözlük tasarımı açısından ayrıca incelenir.
4.5. Karakter ve Bayt Düzeyi Modeller
Karakter veya UTF-8 baytı düzeyinde çalışan modeller açık sözcük sözlüğüne bağımlılığı azaltır. Buna karşılık dizi uzar; model aynı anlamsal içeriği daha fazla zaman adımıyla işlemeye başlayabilir.
Dil, görev ve donanım birlikte düşünülmelidir:
daha küçük birim
  -> daha küçük sözlük
  -> daha uzun dizi
  -> daha fazla sıralı işlem / attention yükü

daha büyük birim
  -> daha büyük sözlük
  -> daha kısa dizi
  -> daha fazla OOV / seyrek temsil riski
Ünite 5: Türkçe Biçimbilim
5.1. Kök, Gövde ve Biçimbirim
Biçimbilim sözcüğün iç yapısını inceler. Türkçede çekim ve türetme ekleri üretken biçimde bir araya gelir.
Örnek:
yaz
yazıcı
yazıcılar
yazıcılarımız
yazıcılarımızdan
Burada yüzey dizisini tek bir sözlük girdisi gibi değerlendirmek, kök ve ekler arasındaki ortaklığı kaybettirir.
5.2. Ünlü Uyumu ve Yüzey Biçimleri
Aynı soyut ek farklı yüzey biçimleri alabilir:
-lar
-ler
veya:
-da
-de
-ta
-te
Bu nedenle dilsel çözümlemede "ek" ile metindeki harf dizisi bire bir aynı kavram değildir. Biçimbirim bir soyut işlev taşır; yüzey biçimi sesbilgisel ve yazımsal bağlama göre değişebilir.
5.3. Türetme ve Sözcük Türü Değişimi
Türetme yalnız yeni harfler eklemez; sözcüğün sözdizimsel kategorisini ve anlam alanını da değiştirebilir.
temiz
temizle
temizleyici
Bu dönüşümler sınıflandırma ve bilgi çıkarımı açısından önemlidir. Model yalnız yüzey benzerliğine güvenirse aynı kökün farklı dilbilgisel görevlerini karıştırabilir.
5.4. Sonlu Durumlu Çözümleme
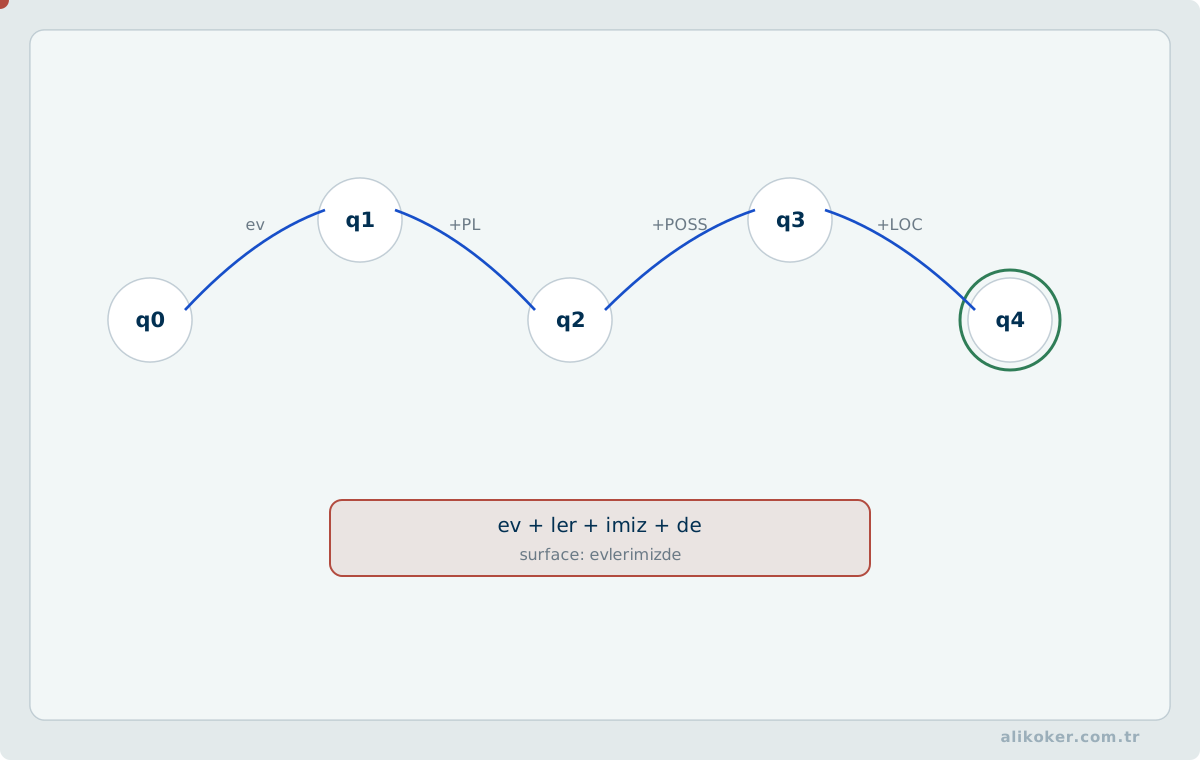
Türkçenin düzenli biçimbilimsel süreçlerinin önemli bir bölümü sonlu durum makineleri ve sonlu durum dönüştürücüleriyle modellenebilir.
kök sözlüğü
    |
    v
biçimbirim geçişleri
    |
    v
ses/yazım dönüşüm kuralları
    |
    v
yüzey biçimi
Çözümleme ters yönde çalıştırıldığında yüzey biçiminden olası kök ve özellik dizilerine gidilebilir.
Bu yaklaşım, Otomatlar Kuramı ve Biçimsel Diller ile NLP arasındaki doğrudan bağlardan biridir.
5.5. Heceleme ile Biçimbilim Aynı Şey Değildir
Hece sınırı ses ve yazı örüntüleriyle ilgilidir; biçimbirim sınırı dilbilgisel yapıyla ilgilidir. İki sınır zaman zaman çakışabilir, fakat aynı problem değildir.
Kendi Sonlu Durumlu Türkçe Heceleme Algoritması ve açık kaynak Turkish Finite-State Syllabifier çalışmalarım bu farkı somutlaştırır. Heceleyici, geniş kapsamlı biçimbilimsel çözümleyici olmadan da düzenli bir durum makinesiyle belirli bir alt problemi çözebilir.
Ünite 6: Biçimbilimsel Belirsizlik ve Sözcük Türü
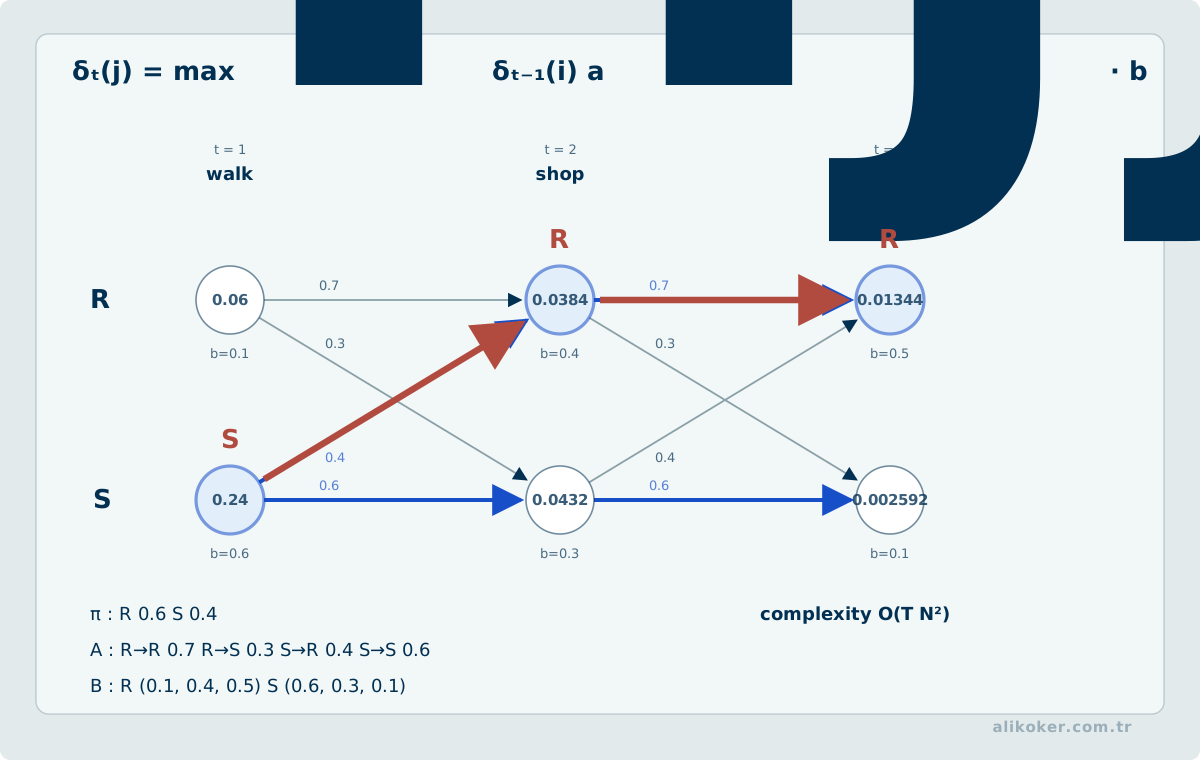
6.1. Bir Yüzey Biçiminin Birden Fazla Çözümü
Bir sözcük biçimi farklı kök veya ek ayrımlarına izin verebilir. Bağlam, olası çözümlemeler arasından uygun olanı seçmek için kullanılır.
Genel akış:
yüzey sözcüğü
     |
     v
morfolojik çözümleyici
     |
     +--> aday 1
     +--> aday 2
     +--> aday 3
     |
     v
bağlamsal belirsizlik giderme
     |
     v
seçilen çözüm
Bu ayrım önemlidir: çözümleyici aday üretir, belirsizlik giderici bağlamla seçim yapar.
6.2. Sözcük Türü Etiketleme
Sözcük türü etiketleme, tokenlara ad, eylem, sıfat, zarf, zamir gibi kategoriler atar. Klasik sistemlerde:
- kural tabanlı etiketleyiciler,
- n-gram etiketleyiciler,
- gizli Markov modelleri,
- dönüşüm tabanlı yöntemler,
- koşullu rassal alanlar,
- perceptron tabanlı modeller
kullanılmıştır.
Modern sistemlerde bağlamsal sinir ağı temsilleri güçlüdür; ancak etiket kümesinin tanımı ve eğitim verisinin tutarlılığı hâlâ temel sorundur.
6.3. Türkçede Biçimbilim ile Sözdiziminin Teması
Türkçede durum, kişi, sayı, iyelik ve zaman gibi bilgiler sözcük içinde yoğunlaşabilir. Bu nedenle biçimbilimsel özellikler sözdizimsel çözümlemenin girdi bilgisini güçlendirir.
İngilizcede ayrı sözcük veya daha sabit sıra ile görülen bazı ilişkiler Türkçede eklerle kodlanabilir. Bu, dil karşılaştırmasının yalnız sözlük düzeyinde yapılamayacağını gösterir.
Ünite 7: Sözdizimi ve Bağımlılık Çözümleme
7.1. Cümle Yapısı Modellemesinin Gerekliliği
Aynı sözcükler farklı ilişkiler kurabilir:
Mühendis modeli test etti.
Model mühendisi test etti.
Kim kimi test etti sorusu yalnız sözcüklerin varlığıyla çözülemez.
7.2. Öbek Yapısı ve Bağımlılık
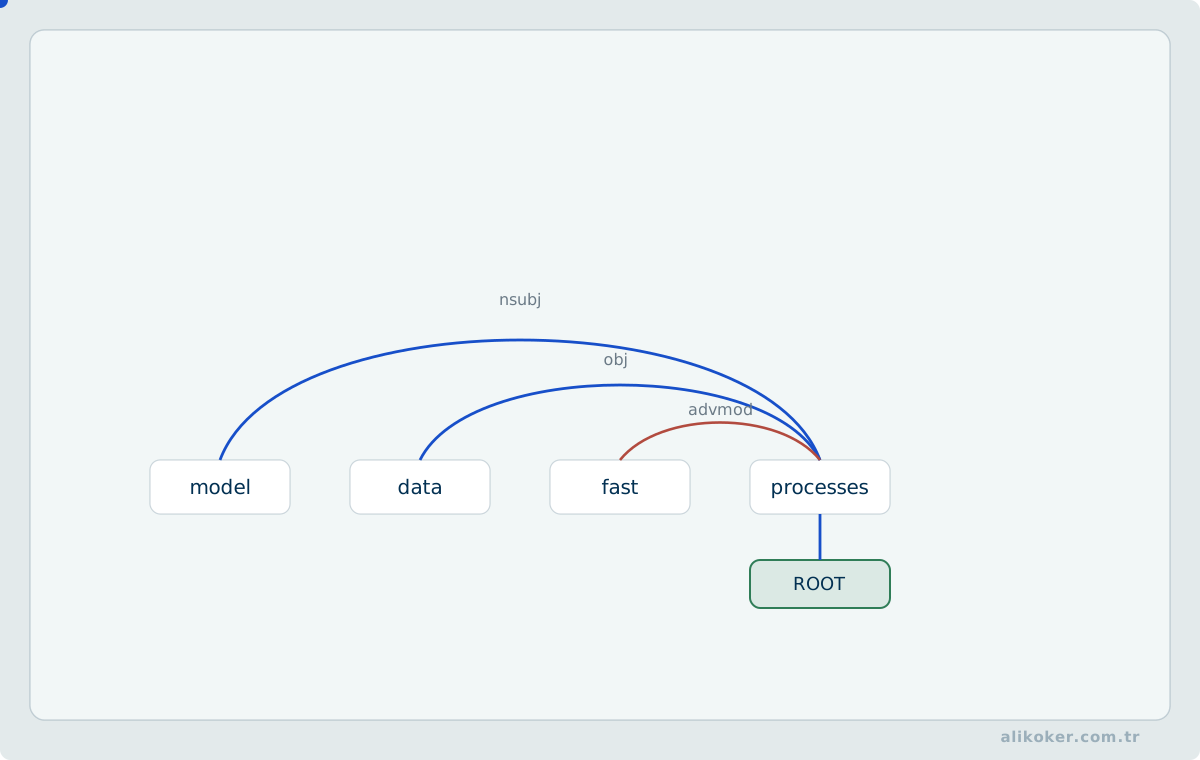
Öbek yapısı dilbilgileri cümleyi iç içe öbeklere ayırır. Bağımlılık yaklaşımı ise sözcükler arasında baş–bağımlı ilişkileri kurar.
Basit bir bağımlılık görünümü:
          test_etti
          /       \
   mühendis       modeli
     özne          nesne
Türkçenin görece serbest öge dizilişi nedeniyle bağımlılık gösterimi birçok görevde doğal bir çerçeve sağlar. Bununla birlikte etiketleme politikası ve biçimbilimsel bilgi sonucu doğrudan etkiler.
7.3. Universal Dependencies
Universal Dependencies, farklı dillerde sözcük türü, biçimbilimsel özellik ve bağımlılık ilişkilerini ortak bir çerçevede göstermeyi amaçlar. Aynı şema Türkçe, İngilizce ve birçok başka dil üzerinde karşılaştırmalı model geliştirmeyi kolaylaştırır.
Ancak "evrensel" etiket kümesi bütün dillerin aynı yapıda olduğu anlamına gelmez. Amaç, farklı dil özelliklerini ortak adlandırma ilkeleriyle karşılaştırılabilir hâle getirmektir.
Türkçe BOUN ve IMST ağaç bankaları, Türkçe bağımlılık çözümleme çalışmalarında önemli veri kaynaklarıdır.
Ünite 8: Sözcüksel Anlam, Varlıklar ve Söylem
8.1. Sözcük Anlamı Bağlama Bağlıdır
Dağıtımsal yaklaşımın temel sezgisi, benzer bağlamlarda bulunan sözcüklerin anlam bakımından ilişkili olabileceğidir.
Fakat anlam benzerliği özdeşlik değildir:
doktor <-> hekim        yakın anlam
doktor <-> hastane      ilişkili kavram
doktor <-> mühendis     aynı üst sınıfta kişi/meslek
Vektör yakınlığı bu farklı ilişki türlerini tek bir geometrik ölçüye sıkıştırabilir.
Örneğin “yüz” sözcüğü sayı, insanın yüz bölgesi veya yüzme eylemiyle ilişkili olabilir. Anlamı çözümlemek için yalnız kökü değil, onunla kurulan söz dizimsel ilişkiler de incelenir: “yüz lira”, “yüzünü yıkadı” ve “havuzda yüzdü” farklı bağlamları temsil eder. Türkçe açısından çekim ekleri de bu bağlamın parçasıdır; yüzey biçimini köke indirgemek yararlı olabilir, fakat anlam çözümlemesi için gerekli dilbilgisel ilişkiyi kaybettirmemelidir.
8.2. Sözcük Anlamı Belirsizliği
Bir yüzey sözcüğünün bağlama göre farklı anlamları olabilir. Sözcük anlamı belirsizliği giderme, doğru anlamı bağlamdan seçmeye çalışır.
Bu problem klasik sözlük/WordNet yaklaşımıyla, gömme vektörleriyle veya bağlamsal modellerle ele alınabilir.
Olumsuzluk ve kip de anlamı değiştirir. “Ali geldi”, “Ali gelmedi” ve “Ali gelecekmiş” cümlelerinde aynı kişi ve hareket fiili bulunmasına rağmen doğruluk koşulları aynı değildir. Bir metin işleme hattı varlıkları çıkardığı kadar iddianın olumsuz, varsayımsal, aktarılmış veya kesin olarak kurulup kurulmadığını da ayırt etmelidir. Bu ayrım yapılmadan üretilen ilişki grafiği, metinde yalnızca sözü edilen bir olayı gerçekleşmiş olgu gibi gösterebilir.
8.3. Adlandırılmış Varlık Tanıma
Adlandırılmış varlık tanıma kişi, kurum, konum, tarih, ürün ve benzeri varlık sınıflarını metinde bulur.
Türkçede ekler varlık sınırını ve yüzey biçimini etkileyebilir:
Ankara
Ankara'da
Ankara'dan
Normalizasyon sırasında eki veya apostrofu kontrolsüzce silmek, daha sonraki çözümlemeyi zayıflatabilir.
Varlık tanıma en az iki ayrı çıktı üretir: metindeki sınır ve varlık türü. Ankara'dan ifadesinde Ankara adının sınırı ile ayrılma eki arasındaki fark, tokenleştirme yöntemine bağlı olarak açıkça tanımlanmalıdır. BIO etiketlemesinde başlangıç (B), devam (I) ve varlık dışı (O) konumları kullanılır; Türkçe eklemeli biçimlerde token düzeyi etiket ile karakter aralığı arasında dönüşüm kayıpsız olmalıdır.
Aynı yüzey biçimini taşıyan iki özel adın aynı gerçek dünya varlığı olması ayrıca bir entity linking problemidir. NER sonucunu doğrudan kimlik eşleştirme sonucuna dönüştürmek yanlış kişilerin birleştirilmesine yol açabilir. Eşleştirme için bağımsız tanımlayıcı veya doğrulanmış bağlam gereklidir.
8.4. İlişki ve Olay Çıkarımı
Varlıkları bulmak yalnız ilk adımdır. Asıl bilgi çoğu zaman ilişkidedir:
KISI ---- çalışır ----> KURUM
KISI ---- doğdu -----> KONUM
OLAY ---- gerçekleşti -> TARİH
İlişki çıkarımı açık kurallarla, istatistiksel sınıflandırıcılarla veya sinirsel modellerle yapılabilir.
İlişki çıkarımında yüklemin öznesi, nesnesi ve olayın zamanı ayrıştırılabilir. “Ayşe, Mehmet'in Ankara'ya gideceğini söyledi” cümlesinde konuşan Ayşe'dir; gitme eyleminin öznesi Mehmet'tir ve ifade gerçekleşmiş bir yolculuğun kaydı değildir. Böyle bir cümleden çıkarılan Mehmet — gitmek — Ankara üçlüsü, konuşma kaynağına bağlı aktarılmış ifade niteliğinde tutulmalıdır. İlişkiyi doğrulanmış olguya yükseltmek için metin dışı dayanak aranır.
8.5. Eş Gönderim ve Söylem
Bir metinde aynı varlığa farklı ifadelerle gönderme yapılabilir:
Ayşe raporu tamamladı.
Mühendis daha sonra onu yöneticisine gönderdi.
Mühendis ile Ayşe, onu ile raporu arasında ilişki kurmak cümle sınırını aşan söylem bilgisi gerektirir.
Eş gönderim çözümü, ad benzerliğinden farklıdır: bir zamirin hangi önceki ifadeye bağlandığını sözdizimi, anlam ve söylem odağı üzerinden belirler. Birden fazla olası gönderge varsa sistem tek bir kesin sonuç üretmek yerine belirsizliği korumalıdır. Özellikle ses dökümünde noktalama hataları veya konuşmacı değişimlerinin belirsiz olması, cümle sınırlarını ve dolayısıyla eş gönderim çözümlemesini etkiler.
Ünite 9: Mantıksal Gösterim ve Mantıksal Programlama ile Bağ
9.1. Dil ile Mantık Arasındaki Köprü
Bir NLP sistemi metni doğrudan serbest biçimli çıktı olarak bırakmak zorunda değildir. Bazı uygulamalarda cümleden açık bir anlamsal yapı çıkarılır:
"Deniz raporu gönderdi."

        |
        v

gonderen = Deniz
nesne    = rapor
eylem    = gönder
Daha biçimsel bir katmanda bu bilgi yüklemlere dönüştürülebilir:
gonderdi(deniz, rapor).9.2. Prolog ve Doğal Dil
Prolog tarihsel olarak doğal dil çözümleme, dilbilgisi ve bilgi gösterimiyle yakın ilişkiye sahiptir. Definite Clause Grammar yaklaşımı, dilbilgisel üretimleri Prolog kurallarıyla ifade etmeye olanak verir.
Basit ve özgün bir örnek:
cumle --> ad_obegi, eylem_obegi.
ad_obegi --> [muhendis].
eylem_obegi --> [geldi].
Bu örnek tam bir Türkçe dilbilgisi değildir. Ama dil kuralının yürütülebilir mantıksal tanıma dönüşebildiğini gösterir.
9.3. Sembolik ve İstatistiksel Katman Birlikte
Modern bir sistem şu biçimde tasarlanabilir:
metin
  |
  v
sinirsel NLP modeli
  |
  v
varlık / ilişki adayları
  |
  v
mantıksal kural ve kısıtlar
  |
  v
doğrulanmış sonuç
Sinirsel katman belirsiz örüntülerden aday üretirken mantıksal katman açık kısıtları uygulayabilir. Bu yaklaşım Mantıksal Programlama ve Prolog dersindeki sembolik çıkarım ile NLP arasındaki en doğrudan bağlardan biridir.
Ünite 10: Derlem, Etiketleme ve Veri Yaşam Döngüsü
10.1. Derlemin Tanımı ve Kapsamı
Derlem, belirli bir amaçla toplanmış ve çoğu zaman üstveriyle birlikte düzenlenmiş dil verisidir. Rastgele toplanmış büyük metin yığını her zaman iyi bir derlem değildir.
Şu özellikler açık olmalıdır:
- kaynak,
- dönem,
- alan,
- dil ve lehçe,
- kullanım izni,
- temizleme yöntemi,
- yinelenen içerik politikası,
- eğitim/doğrulama/test ayrımı,
- etiketleme yönergesi.
10.2. Veri Sızıntısı
Aynı haberin veya belgenin küçük değişikliklerle hem eğitim hem test kümesinde bulunması ölçümü yapay biçimde yükseltebilir. Doküman düzeyi ayırma çoğu NLP görevinde satır düzeyi rastgele ayırmadan daha güvenlidir.
Benzer şekilde aynı konuşmacı, aynı site, aynı şablon veya aynı zaman aralığı bölünmeler arasında kalıyorsa model gerçek genelleme yerine kaynağı ezberleyebilir.
10.3. Etiketleyiciler Arası Uyum
Dilsel görevlerde "doğru etiket" her zaman mutlak değildir. İki uzman sınır veya anlam konusunda farklı karar verebilir. Bu nedenle etiketleme yönergesi, örnekler ve uyuşmazlık çözümü veri kalitesinin parçasıdır.
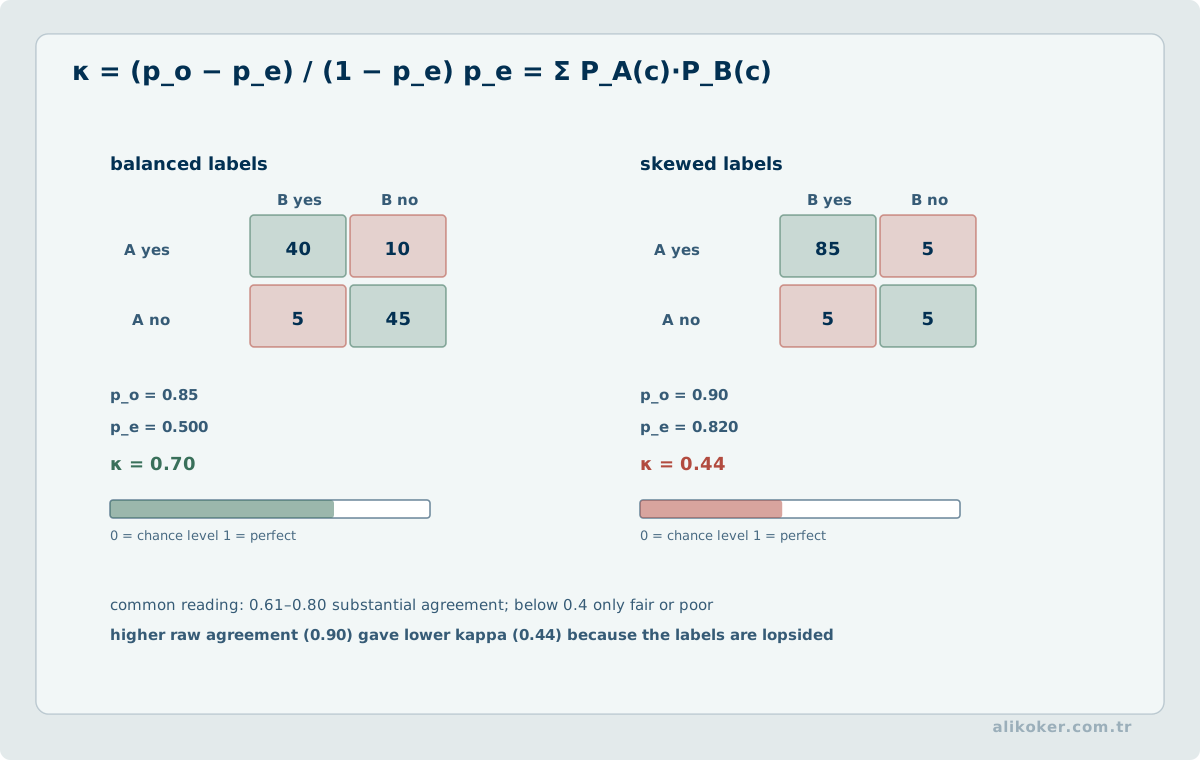
Kodlayıcıların aynı etiket oranı yüksek görünse bile baskın etiket yüzünden yanıltıcı olabilir. İki kodlayıcının örneklerin çoğuna aynı yaygın etiketi vermesi, nadir fakat kritik olaylarda da anlaştıkları anlamına gelmez. Ham uyum oranının yanında şansa göre düzeltilmiş bir katsayı, etiket başına karışıklıklar ve uyuşmazlık nedenleri raporlanmalıdır. Çok etiketli metinlerde etiketlerin birlikte bulunabilmesi, tek sınıflı uyum ölçütlerini doğrudan uygulamayı sakıncalı kılar. Kod kitabı her etiket için olumlu ölçütü, dışlama koşulunu ve sınır örneğini içerdiğinde, modelin öğrenmeye çalıştığı hedef daha yeniden üretilebilir hâle gelir.
10.4. Türkçe Kaynaklar
Türkçe NLP için morfolojik derlemler, bağımlılık ağaç bankaları, ulusal derlem, sözlüksel ağlar, konuşma veri kümeleri ve görev özelinde sınıflandırma veri kümeleri geliştirilmiştir. Kaynağın büyüklüğü kadar lisansı, alanı ve etiketleme kalitesi de önemlidir.
Ünite 11: Klasik İstatistiksel NLP
11.1. N-gram Dil Modelleri
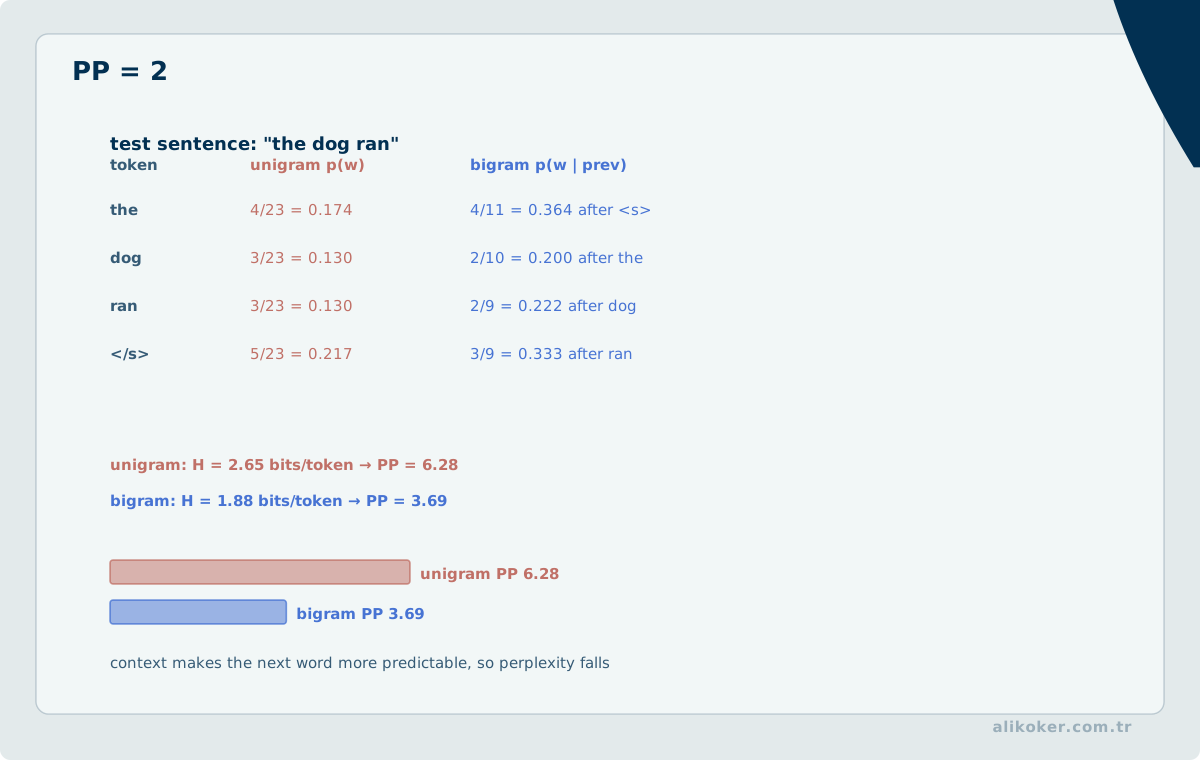
Bir n-gram modeli, sıradaki birimin olasılığını sınırlı geçmiş üzerinden kestirir.
Basit düşünce:
P(sıradaki sözcük | son birkaç sözcük)Modelin gücü, açık ve hızlı olmasındadır. Zayıflığı uzun bağlamı görememesi ve seyrek olaylarda veri ihtiyacının büyümesidir.
Türkçede çok sayıda sözcük biçimi oluşabildiği için sözcük düzeyi n-gram sözlüğü daha hızlı seyrekleşebilir. Kök, biçimbirim veya alt sözcük düzeyi birimler bu sorunu azaltabilir.
11.2. Yumuşatma
Eğitim verisinde görülmeyen n-grama sıfır olasılık vermek yeni metinde kırılgan davranış üretir. Yumuşatma yöntemleri olasılık kütlesinin bir bölümünü görülmeyen olaylara ayırır.
Bu düşünce, "eğitim verisinde yoksa imkânsızdır" varsayımının istatistiksel olarak neden yanlış olduğunu gösterir.
11.3. Naive Bayes ve Metin Sınıflandırma
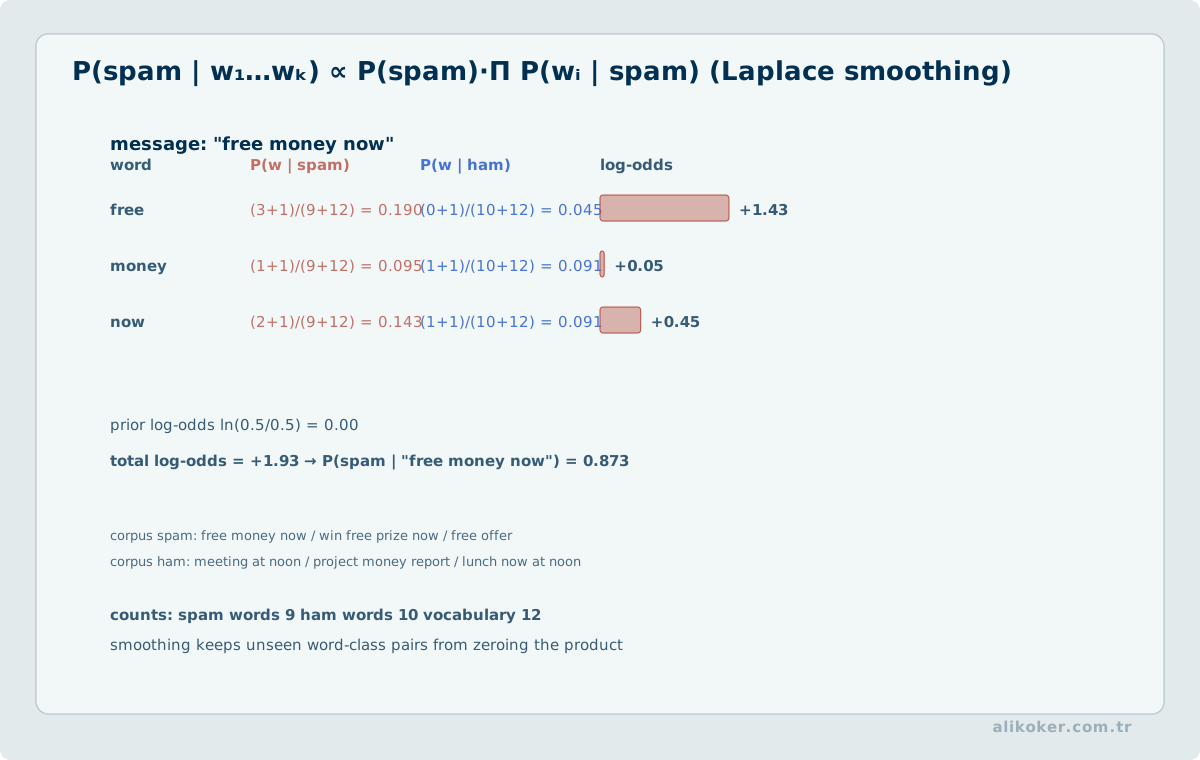
Belge sınıflandırmada sözcük veya n-gram özellikleri Naive Bayes ile güçlü bir klasik temel oluşturabilir. Kendi Veri Madenciliği Teknikleri İle Spam Algılama çalışmamda n-gram ve Naive Bayes yaklaşımını farklı araçlarla gerçekleyerek aynı temel sınıflandırma fikrinin uygulama davranışını karşılaştırmıştım.
Bu tarihsel yaklaşım bugün de değerlidir; çünkü küçük veri, açıklanabilir temel model ve hızlı karşılaştırma gerektiğinde karmaşık modelden önce güçlü bir başlangıç noktası sağlar.
11.4. HMM ve CRF
Gizli Markov modeli dizi içindeki gizli durumları ve gözlemleri olasılıksal olarak modeller. Sözcük türü etiketleme ve konuşma tanımanın klasik mimarilerinde yaygın kullanılmıştır.
Koşullu rassal alanlar ise bütün etiket dizisini gözlem dizisine koşullu olarak modelleyerek özellikle dizi etiketleme görevlerinde etkili olmuştur.
Klasik modelleri bilmek, Transformer'ın neyi değiştirdiğini anlamayı kolaylaştırır.
Ünite 12: Metin Temsili ve Gömme Vektörleri
12.1. Torba Gösteriminden Dağıtımsal Temsile
Torba-sözcük yaklaşımı belgeyi sözcük sayımlarıyla temsil eder. Sözcük sırasının büyük bölümünü kaybeder; buna karşılık basit ve etkilidir.
TF-IDF, her sözcüğün bir belgede sık ama bütün koleksiyonda seyrek olmasını daha ayırt edici kabul eder.
12.2. Yoğun Gömme Vektörleri
Word2Vec ve GloVe gibi yöntemler sözcükleri yoğun vektörlerle temsil eder. Benzer bağlamlarda geçen sözcüklerin vektörleri geometrik olarak yakınlaşabilir.
Türkçe için tek yüzey sözcüğüne tek vektör atamak yine biçimbilimsel seyrekliğe duyarlıdır. FastText gibi karakter n-gramlarından yararlanan yöntemler nadir ve türemiş biçimlerde ek bilgi sağlayabilir.
12.3. Bağlamsal Temsil
Statik gömme vektöründe yüz sözcüğünün tek vektörü vardır. Bağlamsal modelde:
"yüz metre"
"denizde yüz"
"insan yüzü"
örneklerindeki temsil, çevredeki sözcüklere göre değişebilir.
Bu değişim BERT ve benzeri önceden eğitilmiş bağlamsal modellerin temel avantajlarından biridir.
12.4. Jaccard, Dice ve Kosinüs: Önce Temsil, Sonra Benzerlik Ölçüsü
Benzerlik fonksiyonu, temsil modelinden bağımsız seçilmemelidir. Aynı iki belge; küme, frekans vektörü veya yoğun gömme olarak temsil edildiğinde "benzer" kelimesi farklı bir niceliği ifade eder.
İki token kümesi A ve B için Jaccard ortak elemanların birleşime oranıdır:
J(A,B) = |A intersection B| / |A union B|Sørensen-Dice ortak kısmı iki kümenin toplam büyüklüğüne göre ölçekler:
D(A,B) = 2|A intersection B| / (|A| + |B|)Küme gösteriminde ikisi monoton olarak ilişkilidir:
D = 2J / (1 + J)Dolayısıyla aynı adaylar üzerinde yalnız Jaccard yerine Dice kullanmak her zaman yeni bir sıralama bilgisi üretmez; asıl fark skorun ölçeğidir.
Kosinüs benzerliği ise vektörlerin açısal yakınlığını ölçer:
cos(x,y) = dot(x,y) / (norm(x) * norm(y))TF-IDF gibi seyrek vektörlerde terim ağırlıklarını korur; Jaccard/Dice'ın basit küme biçimleri ise tekrar sayısını atar. Yoğun embedding vektörlerinde de cosine kullanılabilir, fakat burada skor artık ortak token oranı değil öğrenilmiş temsil uzayındaki geometrik yakınlıktır. Bu iki kullanım aynı formülü paylaşsa da semantik olarak aynı ölçüm değildir.
Pratik sıra şu olmalıdır:
analiz birimi -> normalizasyon/tokenlaştırma -> temsil -> benzerlik ölçüsü -> eşik/sıralamaBoş küme veya sıfır vektör durumunun nasıl ele alınacağı da sözleşmede açık olmalıdır; paydanın sıfır olduğu örnekleri sessizce 0 veya 1 kabul etmek farklı uygulamalarda farklı sonuçlar doğurabilir.
Ünite 13: Sinirsel Dizi Modelleri
13.1. RNN, LSTM ve GRU
Tekrarlayan sinir ağları diziyi zaman adımları boyunca işler. Uzun bağımlılıkların öğrenilmesindeki güçlükler LSTM ve GRU gibi kapılı yapılara yöneltmiştir.
Genel yapı:
x1 -> h1 -> h2 -> h3 -> ...
      ^     ^     ^
      x2    x3    x4
Her gizli durum önceki durum ve yeni girdinin birleşiminden oluşur.
13.2. Kodlayıcı–Kod Çözücü
Makine çevirisi gibi dizi-dizi görevlerinde bir kodlayıcı kaynak diziyi temsil eder, kod çözücü hedef diziyi üretir.
İlk modeller bütün kaynağı tek sabit vektöre sıkıştırdığında uzun dizilerde bilgi kaybı oluşabiliyordu.
13.3. Dikkat
Dikkat mekanizması kod çözücünün her çıktı adımında kaynak dizinin farklı bölümlerine ağırlık vermesine izin verdi.
kaynak tokenlar
  |  |  |  |
  +--+--+--+
       |
    attention
       |
       v
 hedef token
Bu düşünce daha sonra Transformer mimarisinin merkezine yerleşti.
Ünite 14: Transformer ve Ön Eğitim
14.1. Transformer Mimarisinin Getirdiği Yenilikler
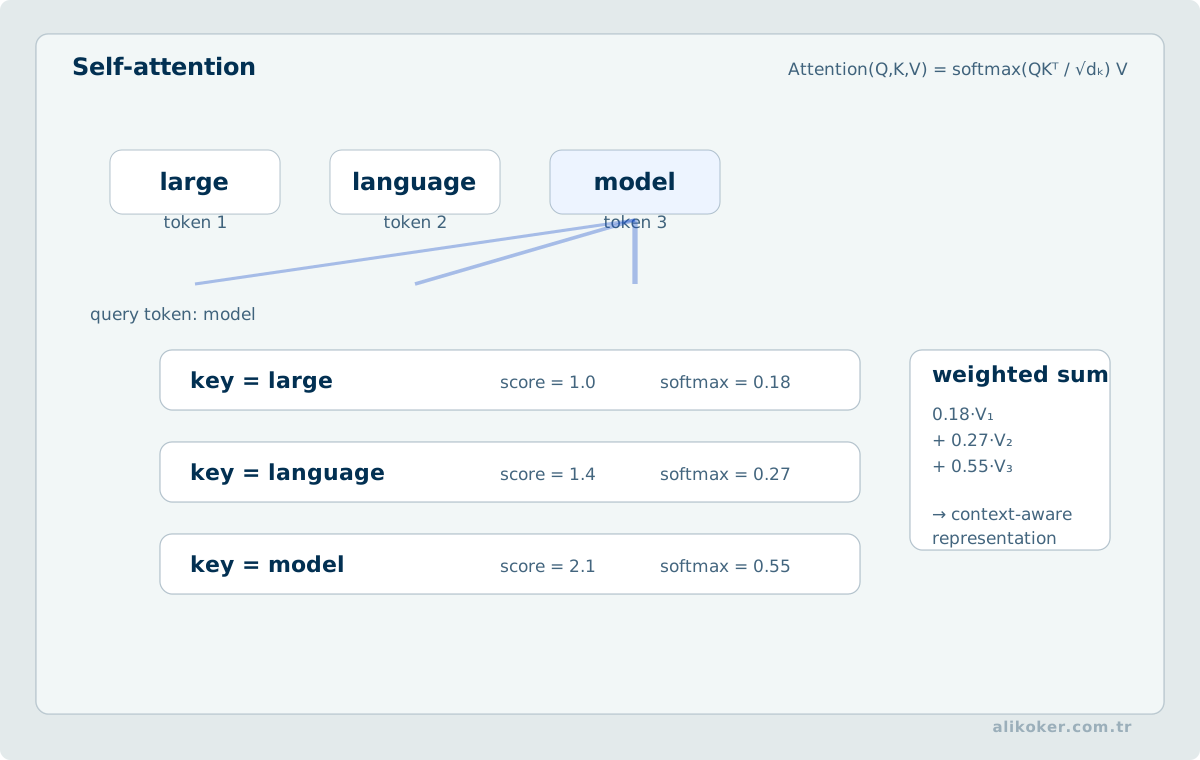
Transformer tekrarlayan durum zinciri yerine tokenların birbirleriyle attention üzerinden ilişki kurmasını sağlar. Eğitimde büyük ölçüde paralel hesaplamaya elverişli olması, çok büyük veri ve model ölçeğine çıkmayı kolaylaştırmıştır.
Ancak Transformer, biçimbilim veya sözdizimini ortadan kaldırmaz. Bu özellikleri açık kurallar olmadan dağıtık temsiller içinde öğrenmeye çalışır.
14.2. Kodlayıcı, Kod Çözücü ve Birleşik Yapılar
Genel olarak:
- kodlayıcı ağırlıklı modeller anlama ve temsil görevlerinde,
- kod çözücü ağırlıklı modeller ardışık üretimde,
- kodlayıcı–kod çözücü modeller giriş dizisinden başka bir dizi üretmede
kullanılır.
Bu ayrım mutlak değildir; görev tasarımı ve eğitim hedefi model davranışını değiştirir.
14.3. Maskeli ve Otoregresif Eğitim
Maskeli dil modelinde girişte saklanan parçaların tahmini öğrenilir. Otoregresif model geçmiş bağlama göre sıradaki tokenı tahmin eder.
maskeli:
Bugün hava [MASK].

otoregresif:
Bugün -> hava -> ...
Modelin eğitim hedefi, hangi bağlam bilgisini doğrudan kullanabildiğini belirler.
14.4. Ön Eğitim ve Görev Uyarlama
Büyük bir genel derlemde öğrenilen temsil, daha küçük görev verisiyle ince ayar yapılabilir. Bu yaklaşım özellikle etiketli verinin sınırlı olduğu dillerde önemlidir.
Bununla birlikte çok dilli ön eğitimde kaynakların eşit olmaması, yüksek kaynaklı dillerin model kapasitesinden daha fazla pay almasına yol açabilir.
Ünite 15: Çok Dilli NLP ve Diller Arası Aktarım
15.1. Ortak Temsil Fikri
Çok dilli modeller farklı dillerin metnini ortak parametre uzayında işler. Ortak alt sözcükler, benzer sözdizimsel yapılar ve paralel veri aktarımı destekleyebilir.
Fakat aynı tokenizer ve aynı model kullanılması diller arasında eşit temsil anlamına gelmez.
15.2. Token Verimliliği
Bir Türkçe cümlenin İngilizce karşılığıyla aynı anlamı taşımasına rağmen daha fazla alt tokena ayrılması mümkündür. Bunun sonuçları:
- daha kısa etkili bağlam,
- daha yüksek çıkarım maliyeti,
- daha fazla attention işi,
- bazı morfolojik ilişkilerin parçalanması
olabilir.
Bu nedenle model kıyaslamasında yalnız "token başına hız" değil, "aynı dilsel içerik başına maliyet" de düşünülmelidir.
15.3. Aktarım ve Yakın Diller
Türkçe ile Azerbaycanca arasında bazı ortak örüntüler bulunabilir. Ancak ortaklık otomatik olarak doğru morfolojik aktarım üretmez. Özellikle yalancı eşdeğer sözcükler, farklı ek kullanımları ve alfabe farklılıkları hata kaynağıdır.
Diller arası aktarımın başarısı şu etkenlere bağlıdır:
- eğitim verisi miktarı,
- yazı sistemi,
- sözcük/parça paylaşımı,
- dil akrabalığı,
- görev benzerliği,
- alan benzerliği.
15.4. Çeviri
Makine çevirisi sözcükleri tek tek başka dile dönüştürmek değildir. Türkçe–İngilizce çeviride öge sırası, eklerin ayrı sözcüklere açılması, zamir düşmesi ve zaman/görünüş bilgisinin yeniden kurulması gerekebilir.
Türk dilleri arasındaki çeviride yapısal benzerlik avantaj sağlayabilir; fakat yüzey benzerliği tek başına güvenilir değildir.
Ünite 16: Bilgi Çıkarma, Sınıflandırma ve Arama
16.1. Metin Sınıflandırma
Belgeye tek veya çoklu etiket atama; spam algılama, konu sınıflandırma, niyet belirleme ve içerik yönlendirme gibi görevlerde kullanılır.
Güçlü bir deney düzeni şunları ayırmalıdır:
veri hazırlama
    |
    v
özellik / temsil
    |
    v
model
    |
    v
eşik / karar
    |
    v
ölçüm
Model ile eşik aynı şey değildir. Özellikle dengesiz sınıflarda doğruluk tek başına yanıltıcı olabilir.
16.2. Duygu Çözümleme
Duygu çözümleme olumlu/olumsuz sınıflandırmadan daha geniştir. Hedefe yönelik duygu, ironi, yoğunluk, karışık duygu ve alan bağımlılığı problem oluşturur.
Türkçe ekler olumsuzluk ve kip bilgisini sözcük içinde taşıyabilir. Normalizasyon sırasında bu yapı kaybedilirse sınıflandırıcının girdi bilgisi azalabilir.
16.3. Arama ve Bilgi Erişimi
Bilgi erişimi yalnız anlamsal vektör araması değildir. Klasik ters indeks, BM25 benzeri sıralama, alan filtreleri ve tam eşleşme birçok sistemde hâlâ kritik önemdedir.
Modern bir karma arama sistemi:
sorgu
  |
  +--> sözcüksel arama --------+
  |                            |
  +--> vektör benzerliği ------+--> yeniden sıralama --> sonuç
Türkçe aramada ekler, yazım varyasyonu, ASCII dönüşümü ve adların fonetik benzerliği aday üretimini etkileyebilir.
16.4. Fonetik Aday Üretimi
Sayısal Soundex ile Türkçe Fonetik Eşleme ve açık kaynak Turkish Numeric Soundex çalışmamda fonetik kodu nihai kimlik kararı olarak değil, pahalı karşılaştırmadan önce aday kümesini daraltan bir ön indeks olarak ele alıyorum.
Bu ayrım genel NLP mimarisi için önemlidir:
ucuz ve yüksek geri çağırım
        |
        v
aday üretimi
        |
        v
daha pahalı ve seçici model
        |
        v
nihai sıralama / karar
Ünite 17: Konuşma, Ses ve NLP Sınırı
17.1. ASR ve NLP Arasındaki Kapsam Sınırları
Otomatik konuşma tanıma ses dalga biçimini metne dönüştürür. Ancak çıktı çoğu zaman doğrudan son kullanıcı metni değildir.
ses
 |
 v
VAD / bölümleme
 |
 v
akustik-dil modeli
 |
 v
ham transkript
 |
 v
noktalama / büyük-küçük harf / sayı normalizasyonu
 |
 v
NLP görevi
Konuşma tanıma ve NLP birbirine bağlanır; fakat aynı problem değildir.
17.2. Türkçede Konuşma Sonrası Metin İşleme
ASR çıktısında:
- noktalama eksik olabilir,
- özel adların yazımı belirsiz olabilir,
- birleşik/ayrı yazım hataları görülebilir,
- ek sınırları yanlış çözülebilir,
- konuşma dili ile yazı dili farkı bulunabilir,
- sayı ve tarihlerin yazımı normalize edilmek zorunda kalabilir.
Bu nedenle WER düşük olsa bile sonraki bilgi çıkarımı hatalı olabilir.
Sesten Konuşma Tanıma, Konuşma Tanıma Sistemlerinde Whisper Mimarisi ve Gerçek Zamanlı Konuşma Tanımada Kapasite Mühendisliği dersleri ses–metin sınırının model ve sistem tarafını ayrı düzeylerde ele alır.
17.3. Ses Bölütleme Gecikmesi ile Çıkarım Maliyetinin Ayrılması
Konuşma etkinliği algılama (VAD), hangi ses aralıklarının konuşma adayı olduğunu belirler; söylenen sözcükleri çözümlemez. Segment başlatma ve sonlandırma kararları sessizlik eşiği, asgari konuşma süresi ve bağlam gereksinimiyle ilişkilidir. VAD çok erken sonlandırırsa sözcük uçları ayrılabilir; çok geç sonlandırırsa sonraki metin işleme için bekleme artabilir. Ses parçasının sonu ile dilbilgisel cümle sonu aynı olay değildir.
Bir tanıyıcının hesaplama yükü real-time factor (RTF) ile özetlenebilir:
RTF = işleme süresi / işlenen ses süresiOn saniyelik kayıt iki saniyede işlenmişse RTF 0.2dir. Bu oran tek başına kullanıcının iki saniye beklediğini göstermez: sesin kaydedilmesi, segmentin tamamlanmasını bekleme, kuyrukta kalma, metin normalizasyonu ve arayüze iletim farklı sürelerdir. Bu ayrım NLP katmanında zaman damgası, konuşmacı dönüşü ve cümle sınırını korumak için de gereklidir; bir cümleyi okunur hâle getirmek, onun özgün ses aralığını değiştirmez.
17.4. Sözcük Hata Oranının Sınırı
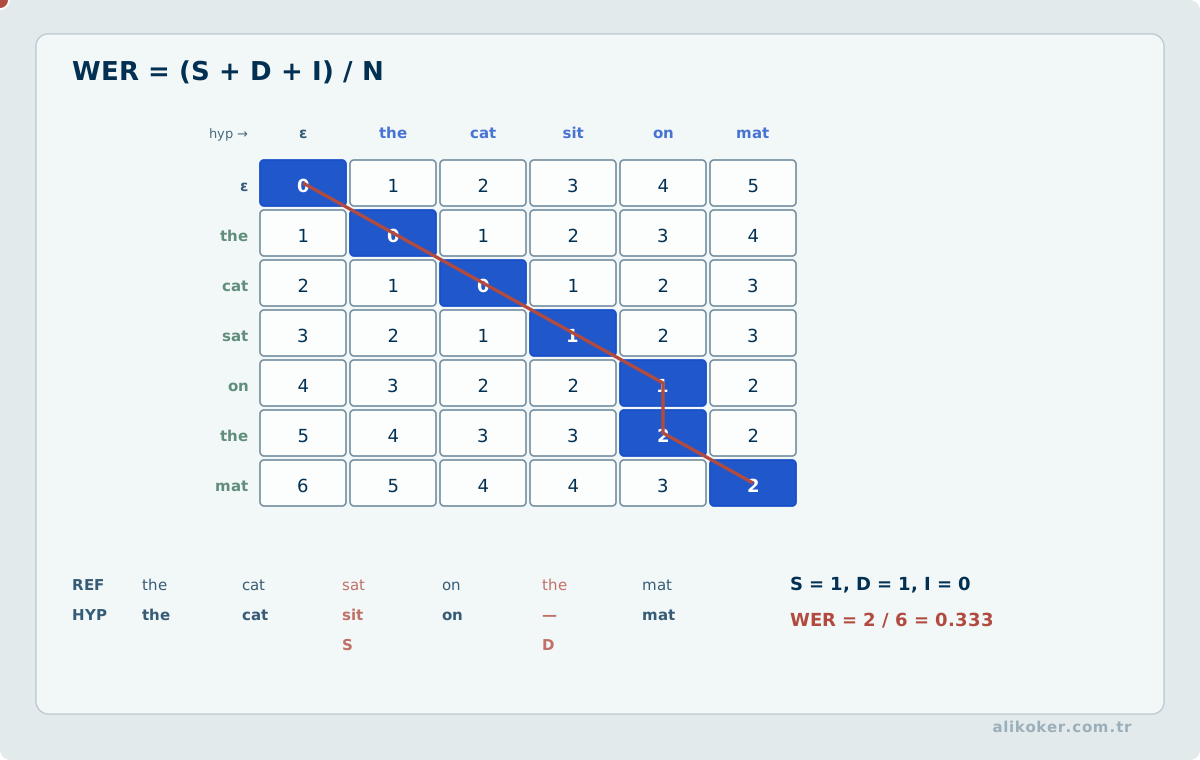
WER, ekleme, silme ve değiştirme hatalarını sözcük düzeyinde sayar. Türkçe gibi üretken biçimbilimli bir dilde tek bir ek hatası bütün sözcüğü yanlış sayabilir. Karakter hata oranı bu nedenle tamamlayıcı bilgi verebilir.
Fakat CER de anlamsal önemi ölçmez. Bir özel addaki tek karakter değişikliği uygulama açısından kritik olabilirken başka bir yerde aynı sayıda karakter farkı önemsiz olabilir.
Konuşmadan metne dönüştürmede toplam sözcük hata oranı düşük olsa da hata dağılımı aşağı akış analiz için kritik olabilir. Örneğin “uygun” ile “uygun değil” ifadeleri arasındaki tek bir olumsuzluk kaybı, niyet veya karar etiketini tersine çevirebilir. Bu nedenle transkripsiyon kalitesi yalnız sözcük bazında değil; kişi adı, sayı, olumsuzluk, alan terimi ve konuşmacı değişimi gibi görev odaklı dilimlerde ölçülmelidir. Ön işleme aşamasında kuşkulu parçayı sessizce düzeltmek yerine zaman kodu ve özgün sesle ilişki korunur. İnsan gözden geçirmesi bütün çıktıyı değil, hata maliyeti yüksek ve belirsizlik içeren parçaları önceliklendirir.
Konuşma tanımada sözcük hata oranı, yer değiştirme, silme ve ekleme hatalarının referans sözcük sayısına oranıdır. Ancak değerlendirilen metnin normalizasyonu bu oranı değiştirebilir: “yirmi beş” ile “25” gösterimleri aynı anlamı taşısa da ham sözcük hizalamasında farklı maliyet üretir. Sayı yazımı, noktalama, özel ad ve konuşmacı dönüşlerinin hangi aşamada değerlendirileceği önceden tanımlanmalıdır. Düşük sözcük hata oranı tek başına doğru konuşmacı ataması veya önemli bir sayının hatasız aktarılması anlamına gelmez; görev açısından kritik varlıkların doğruluğu ayrıca sınanmalıdır.
17.5. Gürültülü Konuşma Dökümünde Cümle ve Konuşma Dönüşü Sınırı
Konuşma tanıma çıktısındaki satır veya segment sınırı, dilbilgisel cümle sınırıyla aynı olmak zorunda değildir. Ses tanıma sistemi kısa bir duraklamada segmenti sonlandırabilir; konuşmacı ise aynı düşünceyi sonraki segmentte sürdürebilir. Tersine, tek bir uzun segment birkaç cümle, soru ve konu geçişi içerebilir. Bu nedenle metne dönüştürme aşamasında üç sınır ayrı modellenir: ses segmenti, konuşmacı dönüşü ve dilbilgisel cümle. Birleştirme kararı sözcük sırası, noktalama, duraklama ve konuşmacı değişimine dayanabilir; fakat doğrulanmamış cümle sonları özgün ses kaydının gerçeği olarak sunulamaz.
Uzun ve noktalamasız bir segment için karakter sayısına göre rastgele kesme yapılması anlamsal bütünlüğü bozabilir. Daha uygun yaklaşım, önce zaman ve konuşmacı açısından güvenli aralıkları belirlemek, ardından bağlaç ve yüklem konumu gibi dilsel ipuçlarıyla aday bölünme yerleri üretmektir. Sınır kesin değilse metin birimi daha büyük tutulur ve özetleme sırasında alt birimlerin aynı bağlama ait olduğu bilgisi korunur. Her türetilmiş cümle, kaynak segment kimlikleri ve özgün karakter aralıklarıyla eşlenir; türetilmiş bir cümle birkaç segmenti kapsıyorsa tek bir uydurma zaman damgası atanmaz.
Bu ayrım değerlendirmede de zorunludur. Cümle sınırı doğruluğu, özetin konu kapsamı ve kaynak sesle eşleşme doğruluğu ayrı ölçülmelidir. Dilsel olarak akıcı görünen bir paragraf, sesin yanlış bölümüne bağlanıyorsa yeterli çıktı sayılmaz. Otomatik paragraf düzenleme, kaynak transkriptin üzerine yazılan bir düzeltme değil, geri alınabilir ve izlenebilir bir sunum katmanıdır.
Ünite 18: Büyük Dil Modellerinin Doğal Dil İşlemedeki Konumu
18.1. LLM, NLP'nin Tamamı Değildir
Büyük dil modelleri doğal dil üzerinde çok geniş görev aralığı gerçekleştirebilir. Buna rağmen NLP'nin:
- veri normalizasyonu,
- morfolojik analiz,
- arama,
- veri lisansı,
- etiketleme,
- değerlendirme,
- üretim gecikmesi,
- mahremiyet,
- dil çeşitliliği
gibi sorunları ortadan kalkmaz.
Büyük Dil Modelleri dersi Transformer, ön eğitim, sonradan eğitim, RAG, araç kullanımı, değerlendirme ve çıkarım mühendisliğine odaklanır. Bu ders ise doğal dil verisinin özelliklerini ve klasik/modern NLP görevlerini temel alır.
18.2. Üretici Model ile Yapılandırılmış NLP
Bir üretici modelden JSON istemek, modelin çıktısının doğrulanmış yapısal bilgi olduğu anlamına gelmez.
Güvenilir bir akış:
metin
  |
  v
LLM / NLP modeli
  |
  v
aday yapı
  |
  v
şema doğrulama
  |
  v
alan kuralları
  |
  v
kalıcı sonuç
Özellikle kritik sistemlerde doğal dil modeli ile deterministik iş kuralı arasındaki sınır açık olmalıdır.
18.3. RAG ve Bilgi Erişimi
Retrieval-Augmented Generation, model üretimini harici bilgi erişimiyle birleştirir. Bu yapı klasik bilgi erişimini geçersiz kılmaz; tersine, doğru belge seçimi RAG sisteminin temelidir.
Türkçe bir RAG sisteminde şu ayrıntılar doğrudan kaliteyi etkiler:
- belge bölütleme,
- ek ve yazım varyasyonları,
- çok dilli gömme modeli,
- sorgu genişletme,
- kaynak başına bağlam bütçesi,
- yeniden sıralama,
- alıntı/kaynak eşleme.
Ünite 19: Değerlendirme
19.1. Görev Ölçütü Görevden Türemelidir
Tek bir evrensel NLP skoru yoktur.
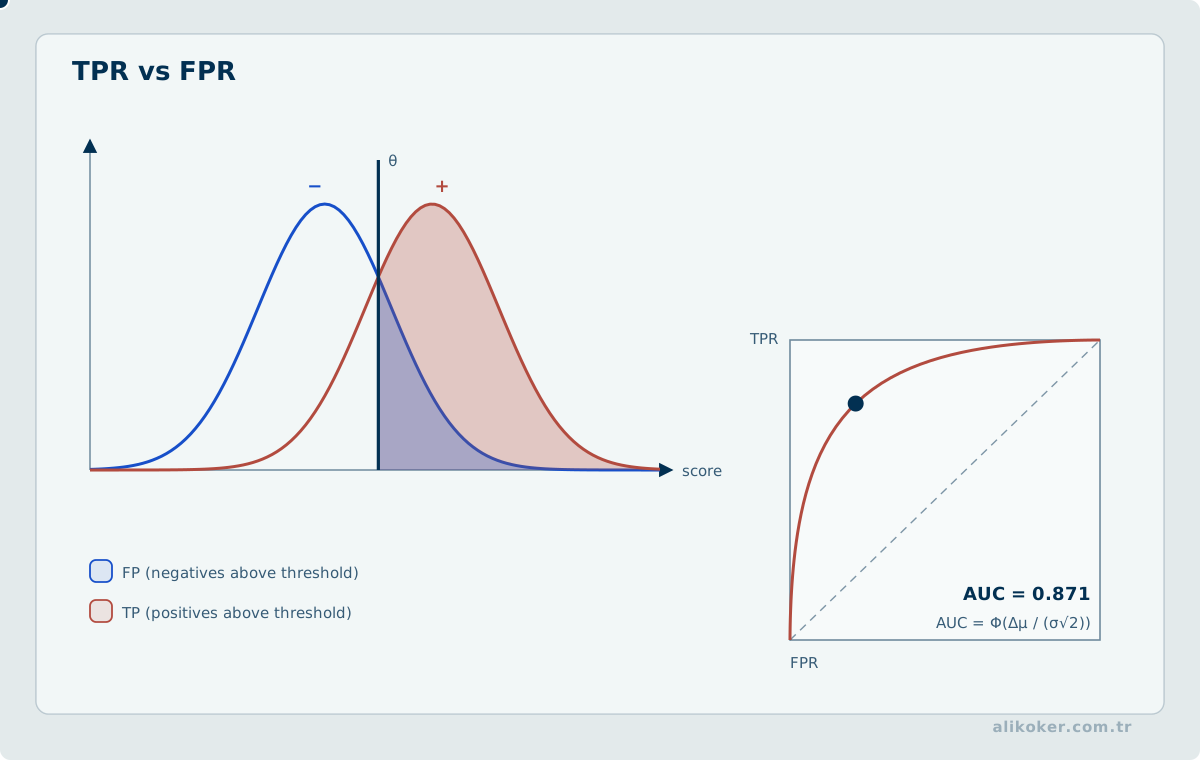
Sınıflandırmada:
- precision,
- recall,
- F1,
- ROC/PR eğrileri,
- kalibrasyon
gibi ölçüler kullanılabilir.
Dizi etiketlemede varlık sınırının tam eşleşmesi ile token düzeyi ölçüm farklı sonuç verir.
Örneğin doğru etiket Ankara Üniversitesi iken yalnız Ankara ifadesini yakalayan sistem token düzeyinde kısmi başarı gösterebilir; fakat tam varlık eşleşmesinde başarısızdır. NER için entity-level precision/recall/F1 değerlendirmesi kullanılırken sınırların tam eşleşme politikası ve iç içe varlıkların nasıl ele alındığı belirtilmelidir. Değerlendirme veri kümesindeki etiket tanımı, gerçek kullanımda beklenen varlık türlerinden farklıysa yüksek F1 operasyonel başarıyı garanti etmez.
Bağımlılık çözümlemede baş ve ilişki etiketlerinin doğruluğu ölçülür.
ASR'de WER ve CER kullanılır.
WER, ikame (S), silme (D) ve ekleme (I) hatalarının referans sözcük sayısına (N) oranıdır:
WER = (S + D + I) / N.
Türkçe gibi eklemeli dillerde tek bir ek farkı sözcük düzeyinde tam hata sayılabilir. Bu nedenle WER, sözcük içeriğinin anlaşılabilirliği veya sonraki görevdeki varlık tanıma başarısıyla özdeş değildir. Konuşma dökümü üzerinde çalışan NER ya da ilişki çıkarımı ayrıca uçtan uca görev ölçütleriyle test edilmelidir: bir tarih, kişi veya olumsuzluk ekinin yanlış tanınması, az sayıda ASR hatasına rağmen analitik sonucu değiştirebilir.
Makine çevirisinde otomatik benzerlik ölçüleri yararlı olabilir; fakat insan değerlendirmesi ve anlam korunumu ayrı konudur.
19.2. Mikro ve Makro Ortalama
Sınıflar dengesizse mikro ortalama büyük sınıfların etkisini büyütür. Makro ortalama her sınıfa eşit ağırlık verir.
Bu nedenle "F1 = 0.92" tek başına yeterli raporlama değildir. Hangi ortalamanın ve hangi karar eşiğinin kullanıldığı belirtilmelidir.
Sınıflandırma skorlarıyla verilen güven değerleri ancak kalibrasyon değerlendirmesi yapıldığında olasılık olarak yorumlanabilir. Çok sınıflı bir sistemin yüksek F1 üretmesi, 0.90 güvenle verdiği tahminlerin gerçekten yaklaşık yüzde doksanının doğru olduğu anlamına gelmez. Özellikle nadir sınıflarda sınıf bazında hata sayıları, precision, recall ve güven aralıkları ayrıca incelenmelidir.
19.3. Dil Varyantlarıyla Test
Türkçe NLP değerlendirmesinde yalnız temiz haber metni kullanmak üretim davranışını göstermeyebilir. Ayrı test kümeleri şu varyantları içerebilir:
- yazım hataları,
- ASCII Türkçe,
- konuşma dökümleri,
- sosyal medya,
- kod değiştirimi,
- farklı alanlar,
- özel ad yoğun metin,
- tarih ve sayı ağırlıklı metin.
19.4. Veri Dağılımı Değişimi
Eğitim ve üretim dağılımları zamanla ayrışabilir. Yeni kurum adları, yeni ürünler, yeni kısaltmalar ve değişen gündem özellikle NER ve sınıflandırmada bozulma üretir.
Bu nedenle üretimde yalnız model dosyası değil, giriş dağılımı da gözlenmelidir.
Regresyon testleri yalnız daha önce başarıyla çözülen örneklerden oluşmamalıdır. Olumsuzluk içeren cümleler, aynı adı taşıyan farklı kişiler, geçersiz tarih ifadeleri, eksik bağlam ve ASR kaynaklı sözcük kaymaları bilinçli hard-negative örnekler oluşturur. Aynı kaynak ve aynı etiket politikası üzerinde değerlendirilen sürümler, genel metriklerin yanı sıra hata sınıflarındaki değişimle karşılaştırılmalıdır.
Ünite 20: Üretim Mühendisliği
20.1. Model Doğruluğu Tek Başına Yeterli Değildir
Bir NLP servisi şu özellikleri birlikte sağlamalıdır:
- doğruluk,
- gecikme,
- throughput,
- bellek sınırı,
- hata izolasyonu,
- tekrar üretilebilirlik,
- veri gizliliği,
- sürümleme,
- gözlemlenebilirlik.
Yüksek doğruluklu fakat beklenmeyen anda birkaç saniye duran bir model, gerçek zamanlı sistem için uygun olmayabilir.
20.2. Boru Hattı Sınırları
Üretimde her aşama açık sözleşmeye sahip olmalıdır:
UTF-8 metin
   |
   v
normalizasyon
   |
   v
tokenlaştırma
   |
   v
model çıkarımı
   |
   v
sonuç doğrulama
   |
   v
alan modeli
Normalizasyon kuralı değiştiğinde modelin eğitim dağılımı da değişmiş olabilir. Ön işleme kodu bu nedenle model sürümünün parçasıdır.
20.3. Toplu İş ve Gerçek Zaman
Toplu belge sınıflandırma throughput odaklı olabilir. Etkileşimli arama ve konuşma sistemi p95/p99 gecikmesine duyarlıdır.
GPU batch büyüklüğünü artırmak toplam throughput'u yükseltebilir; fakat tek isteğin bekleme süresini de artırabilir. NLP servisinde performans kararı görev SLA'sından türetilmelidir.
20.4. Önbellek ve Deterministik Aşamalar
Aynı girdiye aynı çıktıyı veren normalizasyon, biçimbilim veya gömme işlemleri uygun anahtarla önbelleğe alınabilir.
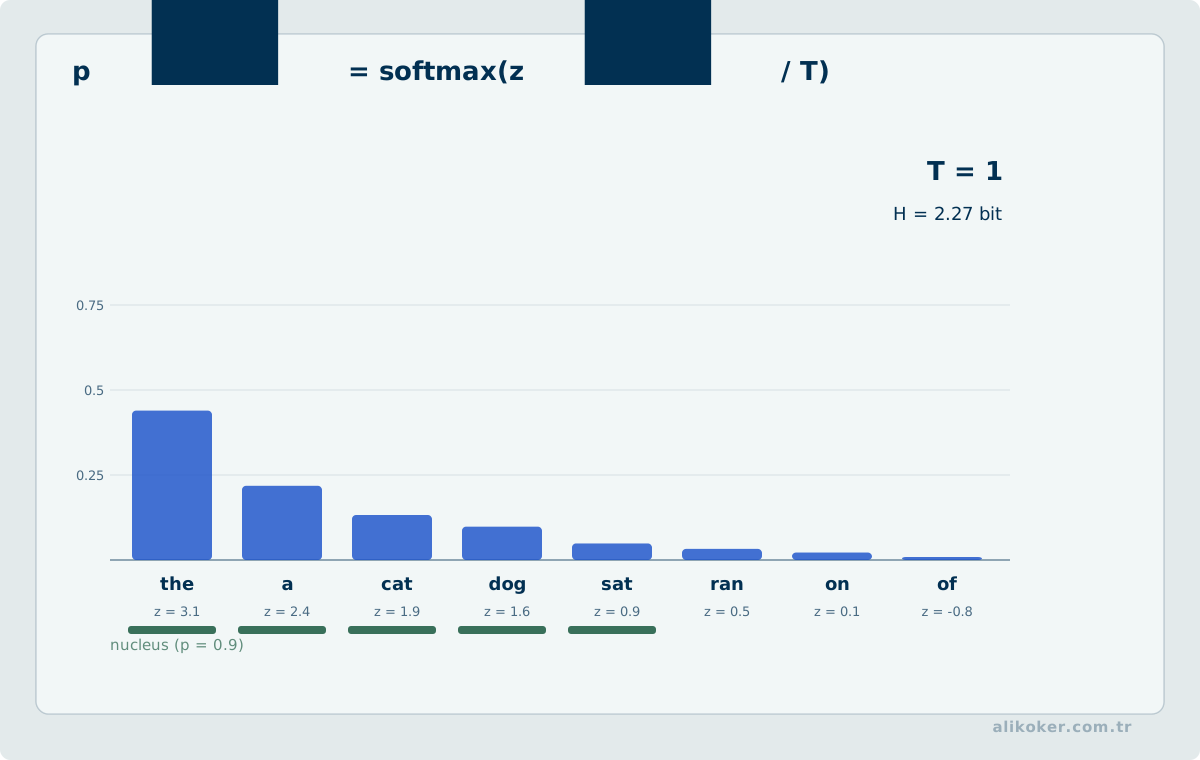
Üretici model çıktısı ise sıcaklık, örnekleme ve model sürümü nedeniyle deterministik olmayabilir. Önbellek sözleşmesi bu farkı dikkate almalıdır.
20.5. Çevrimdışı ve Mahremiyet Duyarlı NLP
Kişisel veya kurumsal metinler dış servise gönderilemeyebilir. Çevrimdışı çalışmada:
- model boyutu,
- CPU/GPU kapasitesi,
- model lisansı,
- güncelleme süreci,
- sözlük/veri paketi,
- loglarda hassas veri
birlikte değerlendirilmelidir.
Ünite 21: Sağlamlık, Güvenlik ve Dil Verisi
21.1. Girdi Güvenilir Değildir
NLP girdisi kullanıcı kontrollü olabilir. Aşırı uzun diziler, Unicode karışıklıkları, görünmez karakterler veya biçim bozucu metinler kaynak tüketimi ve güvenlik sorunu oluşturabilir.
Bir metin servisi:
boyut sınırı
kodlama doğrulama
normalizasyon politikası
zaman aşımı
kaynak kotası
çıktı şeması
gibi teknik sınırlara sahip olmalıdır.
21.2. Prompt İnjection NLP Güvenliğinin Yeni Yüzüdür
LLM destekli uygulamada doğal dil artık yalnız veri değil, davranışı etkileyen talimat taşıyıcısı da olabilir. Harici belgedeki metnin sistem talimatı gibi yorumlanması güvenlik sınırlarını ihlal edebilir.
Bu konu klasik NLP'deki metin temizlemeden farklıdır; güvenlik politikası, yetki modeli ve araç sözleşmesi gerekir.
21.3. Veri Mahremiyeti
Kişi adları, telefonlar, kimlik bilgileri, sağlık veya iletişim verisi metin içinde bulunabilir. Eğitim verisini "anonim" saymak için yalnız dosya adını silmek yeterli değildir.
Varlık çıkarımı, maskeleme ve yeniden tanımlama riski birlikte değerlendirilmelidir.
Ünite 22: Türkçe NLP İçin Uygulama Desenleri
22.1. Arama için Normalizasyon
Bir ad veya kısa metin aramasında tek normalleştirilmiş alan bütün görevleri karşılamaz.
Daha iyi yaklaşım:
orijinal metin
   |
   +--> tam yazım indeksi
   |
   +--> küçük/büyük harf normalize indeks
   |
   +--> ASCII yardımcı indeks
   |
   +--> fonetik aday indeksi
Nihai karar için orijinal veri korunur. Yardımcı gösterimler geri döndürülemezse ana veri yerine kullanılmaz.
Bu yaklaşım Türkçe Metin Normalizasyonu ve Fonetik Eşlemede Yöntem Seçimi notumla doğrudan ilişkilidir.
22.2. Kural Tabanlı Heceleme
Heceleme görevi için geniş bir Transformer çalıştırmak teknik olarak mümkün olsa da her zaman gerekli değildir. Dilin düzenli alt problemi sonlu durum makinesiyle yüksek hız ve deterministik davranış sağlayabilir.
Açık kaynak Turkish Finite-State Syllabifier projem bu tasarım tercihinin örneğidir.
22.3. Fonetik Ön Gruplama
Ad arama probleminde fonetik kod doğrudan "aynı kişi" sonucu vermemelidir. Görevi aday üretmektir.
Açık kaynak Turkish Numeric Soundex projemde kompakt sayısal anahtar bu nedenle bir ön gruplama aracıdır; çakışmalar beklenen davranıştır.
22.4. Çoklu Ortam ile Dil
Metin her zaman klavyeden gelmez. OCR, ASR ve görsel konuşma tanıma gibi kaynaklardan oluşabilir. Bu durumda NLP girdisinin belirsizliği kaynak modelin hatasıyla başlar.
Doğal Dil İşleme Yönünden Çoklu Ortam notum, görüntü/ses işleme ile dil arasındaki bu sınırı daha geniş çoklu ortam bağlamında ele alır.
22.5. Açık Kaynak Araştırma Yazılımlarıyla İlişki
Açık Kaynak Araştırma Yazılımları koleksiyonunda yer alan NLP ilişkili iki proje özellikle bu dersle doğrudan bağlantılıdır:
- Turkish Finite-State Syllabifier: sonlu durumlu, deterministik Türkçe heceleme.
- Turkish Numeric Soundex: Türkçe karakterleri dikkate alan fonetik aday gruplama.
Bu projelerin ortak yönü "NLP = mutlaka büyük sinir ağı" varsayımını reddetmeleridir. Görev küçük ve sözleşme belirliyse en uygun çözüm küçük, hızlı ve açıklanabilir olabilir.
22.6. Fonetik Eşlemede Aday Üretimi ve Yanlış Pozitif Denetimi
Soundex benzeri fonetik kodlar tam bir dil çözümleyici değildir; yazımları yaklaşık olarak aynı ses sınıflarına indirgemek üzere tasarlanmış aday üretim mekanizmalarıdır. Türkçede ünlü uyumu, eklemeli biçimbilim, hece yapısı ve diakritik dönüşümü nedeniyle aynı kodu paylaşan farklı sözcükler oluşabilir. Eşleme akışında karakter normalizasyonu, token sınırı, fonetik kod ve bağlamsal ikinci aşama puanlama birbirinden ayrılır.
Önce güçlü, kesin eşleşmeler korunur; fonetik genişletme yalnız birincil aramada bulunamayan veya belirsiz kalan adaylarda kullanılır. Doğrulama kümesinde precision, recall, aday sayısı ve sorgu gecikmesi birlikte ölçülür. Özellikle kimlik, kişi veya teknik terim aramalarında yanlış pozitif eşleşmenin sonucu sıradan yazım önerisinden farklıdır; fonetik yakınlık kimlik eşitliği olarak yorumlanamaz.
Ünite 23: Diller Arasında Aynı Görevin Farklılaşması
23.1. Tokenlaştırma
Türkçe:
boşluk güçlü ipucu
+ üretken ekler
+ alt sözcük ve morfoloji önemli
İngilizce:
boşluk çoğu durumda iyi başlangıç
+ contraction ve çok sözcüklü ifade sorunları
Çince:
zorunlu sözcük boşluğu yok
+ bölümleme model kararının parçası
Japonca:
çoklu yazı sistemi
+ sözcük sınırı açık değil
+ morfolojik bölümleme önemli
23.2. Biçimbilim
Türkçe:
kök + ardışık üretken eklerArapça:
kök + kalıp + bitişik parçalarİngilizce:
daha sınırlı çekim
+ daha fazla ayrı işlev sözcüğü
Almanca:
çekim
+ üretken bileşik sözcük
Bu farklılıklar aynı "lemmatize et" komutunun dillerde farklı mühendislik işi olacağını gösterir.
23.3. Sözdizimi
İngilizce sözcük sırasına daha fazla bağımlıdır. Türkçe durum ekleri sayesinde daha esnek diziliş gösterebilir. Çince de büyük ölçüde sözcük sırası ve işlevsel yapılar üzerinden ilişki kurar. Diller arası parser aktarımında bu farklar göz ardı edilmemelidir.
23.4. Dil Modeli
Sözcük düzeyi sözlük, Türkçede üretken biçimbilim nedeniyle daha hızlı büyüyebilir. Alt sözcük çözümü bu maliyeti azaltır; ancak biçimbirim sınırlarını her zaman korumaz.
İngilizce odaklı tokenizer bir Türkçe eki gereksiz sayıda parçaya ayırabilir. Çince karakter tabanlı temsil daha doğal görünebilir, fakat karakter ile sözcük/anlam birimi aynı değildir.
Sonuç olarak "aynı model, aynı tokenizer, aynı ayar" çok dilli eşitlik değildir.
Ünite 24: Tasarım İlkeleri
Doğal dil işleme sisteminde aşağıdaki ilkeler güçlü bir başlangıç noktasıdır:
- Dil verisini ham karakter dizisinden ibaret görmeyin.
- Normalizasyonun hangi bilgiyi kaybettiğini belgeleyin.
- Tokenı dilbilimsel sözcükle eşitlemeyin.
- Türkçede biçimbilimi veri seyrekliğinin temel nedenlerinden biri olarak değerlendirin.
- Klasik yöntemleri yalnız "eski" oldukları için elemeden önce görev maliyetini ölçün.
- Büyük model kullanmayı başarı ölçütü saymayın.
- Veri ayrımını belge düzeyinde ve sızıntıya dayanıklı kurun.
- Dil ve alan değişimini ayrı test edin.
- Ortalama doğruluk yanında hata sınıflarını inceleyin.
- Üretimde tokenizer, normalizasyon ve model sürümünü birlikte sürümleyin.
- Hassas metinlerde veri yaşam döngüsünü model mimarisinden önce tanımlayın.
- Açık kuralın daha güvenli olduğu sınırı sinirsel modele devretmeyin.
- Sinirsel modelin belirsizliği yönettiği yerde katı kurallarla gereksiz kırılganlık üretmeyin.
- Çok dilli modelin her dili eşit temsil ettiğini varsaymayın.
- Çıktıyı alan kuralına dönüştürmeden önce doğrulayın.
Ünite 25: NLU Problemini Doğru Tanımlamak
Doğal dil anlama (Natural Language Understanding, NLU), uygulama düzeyinde metin veya konuşmadan bir sistemin kullanabileceği anlamlı yapı üretme problemidir. NLP daha geniş alandır; NLU ise çoğu zaman niyet, varlık, ilişki, olay, anlam sınıfı veya başka bir yapılandırılmış çıktı elde etmeye odaklanan alt problem ailesi olarak düşünülebilir.
Bir NLU projesinin ilk sorusu "hangi modeli kullanalım?" değildir. Önce problemin gerçekten doğal dil gerektirip gerektirmediği belirlenmelidir. Kullanıcının zaten sınırlı sayıdaki seçenekten birini seçmesi bekleniyorsa düğme, menü, form veya doğrudan sorgu daha güvenilir olabilir. Doğal dilin asıl değeri, kullanıcıların aynı amacı çok farklı ifadelerle anlatabildiği durumda ortaya çıkar.
iş gereksinimi
      |
      v
doğal dil gerçekten gerekli mi?
      |
      +---- hayır ----> deterministik arayüz / kural / sorgu
      |
      +---- evet
              |
              v
       NLP görevi nedir?
              |
      +-------+--------+
      |       |        |
   sınıf    varlık   serbest üretim
      |       |        |
      +-------+--------+
              |
              v
        kabul ölçütü
25.1. Görev Sözleşmesi
Bir NLP görevi aşağıdaki unsurlar açıkça tanımlanmadan yeterince belirli değildir:
- giriş birimi,
- beklenen çıktı,
- hata sınıfları,
- kabul edilebilir gecikme,
- başarısızlık durumundaki davranış,
- veri gizliliği sınırı,
- modelin karar veremediği durumda uygulanacak politika.
"Metni anla" ölçülebilir bir gereksinim değildir. Buna karşılık "müşteri iletisinden en fazla bir ana niyet ve sıfır veya daha fazla varlık çıkar; düşük güven durumunda insan incelemesine yönlendir" sınanabilir bir sistem sözleşmesidir.
25.2. Hata Maliyeti Doğruluktan Önce Gelir
İki model aynı F1 değerine sahip olsa da üretim açısından eşdeğer olmayabilir. Yanlış olumlu ile yanlış olumsuzun maliyeti görevden göreve değişir.
Bir arama sistemi bazı ilgili sonuçları kaçırdığında kullanıcı başka sorgu deneyebilir. Buna karşılık bir metinden çıkarılan kimlik veya yetki bilgisinin yanlış kişiye bağlanması daha yüksek maliyetli olabilir.
Bu nedenle değerlendirme zinciri:
model hatası
   |
   v
uygulama kararı
   |
   v
iş etkisi
   |
   v
risk / maliyet
biçiminde düşünülmelidir.
25.3. Türkçe için Problem Sözleşmesi
Türkçe bir görevde "sözcük" kavramı bile sözleşmenin parçasıdır. Örneğin bir adlandırılmış varlık sisteminde:
Ankara
Ankara'da
Ankara'daki
Ankara'dakiler
biçimlerinin varlık sınırına nasıl dâhil edileceği açıkça tanımlanmalıdır. Yalnız model seçimi değil, etiketleme politikası da ölçüm sonucunu belirler.
Benzer şekilde ASCII Türkçe, birleşik/ayrı yazım, konuşma dökümü ve özel ad ekleri üretim verisinin beklenen parçalarıysa bunların test kapsamına başlangıçta alınması gerekir.
Ünite 26: Etkileşimli NLU, Niyet, Varlık ve Diyalog Durumu
Etkileşimli dil uygulaması ile çevrimdışı belge işleme aynı zaman ve hata sözleşmesine sahip değildir. Kullanıcı karşısında çalışan sistem kısa bir isteğe hızlı yanıt vermek zorundadır; çevrimdışı milyonlarca belgeyi sınıflandıran sistem ise tek isteğin gecikmesinden çok toplam iş hacmine odaklanabilir.
26.1. Konuşmalı Sistem Katmanları
Konuşma tabanlı bir sistemde görevler ayrılmalıdır:
ses
 |
 v
ASR
 |
 v
metin
 |
 v
NLU
 | \
 |  +--> niyet
 |  +--> varlıklar
 |  +--> alanlar
 v
diyalog durumu / iş kuralı
 |
 v
yanıt içeriği
 |
 v
NLG
 |
 v
TTS
ASR sesi metne çevirir. NLU metni yapılandırır. Diyalog yöneticisi sistemin ne yapacağına karar verir. Doğal dil üretimi yanıt metnini oluşturur. Metinden konuşmaya dönüştürme ise bu metni sese çevirir.
Bu sınırlar modern uçtan uca modellerle teknik olarak birleşebilir; fakat hata ayıklama ve yetkilendirme açısından kavramsal ayrım hâlâ değerlidir.
26.2. Niyet
Niyet, kullanıcının gerçekleştirmek istediği işi temsil eder.
"Yarın Ankara için hava nasıl?"örneğinde amaç hava bilgisi almaktır. Aynı istek:
Yarın Ankara'da yağmur var mı?
Ankara yarın kaç derece?
Yarın Ankara hava durumu.
gibi farklı yüzey biçimlerinde ifade edilebilir.
İyi bir niyet taksonomisi birbirinden ayrılabilir görevleri temsil eder. Çok benzer niyetler modelin sınıf sınırını yapay biçimde zorlaştırabilir; çok geniş tek sınıf ise sonraki iş mantığını belirsizleştirir.
26.3. Varlık ve Alan Doldurma
Niyet tek başına çoğu işlemi tamamlamaz.
niyet:    bilet_ara
nereden:  Ankara
nereye:   İzmir
tarih:    ?
Eksik tarih varsa sistemin görevi tahmin yürütmek değil, eksik alanı istemek olabilir.
kullanıcı
   |
   v
niyet + bulunan alanlar
   |
   v
zorunlu alan denetimi
   |
   +--> tamam ----> iş kuralı
   |
   +--> eksik ----> açıklayıcı soru
Bu tasarım, serbest üretici bir modelin her eksik bilgiyi kendisinin doldurmasından daha denetlenebilirdir.
26.4. Diyalog Durumu
Birden fazla tur süren etkileşimde yalnız son cümleyi sınıflandırmak yeterli değildir.
K: Ankara'dan İzmir'e bilet bak.
S: Hangi gün?
K: Cuma.
Cuma tek başına bir niyet taşımaz; önceki turun bağlamındaki tarih alanını tamamlar. Diyalog durumu, konuşma geçmişinin ham metnini sınırsız biçimde taşımak yerine görev için gerekli yapılandırılmış bilgiyi tutabilir.
26.5. Gecikme Bütçesi
Etkileşimli sistemde toplam gecikme bileşenlere ayrılmalıdır:
toplam gecikme
 = giriş alma
 + ASR
 + NLU
 + iş servisi
 + NLG
 + TTS
 + ağ / kuyruk
Bir alt modelin tek başına hızlı olması uçtan uca deneyimin hızlı olduğu anlamına gelmez. Özellikle konuşma sisteminde segment kapanışı, ağ beklemesi ve ardışık servis çağrıları model çıkarımından daha pahalı hâle gelebilir.
26.6. Söylem Odağı, Eksiltili İstek ve Düzeltme İşlemleri
Çok turlu konuşmada son cümlenin sözcükleri, kullanıcının amacını belirlemek için tek başına yeterli değildir. “Onların üçüncüsünü göster” isteğindeki işaret edilen küme, yakın zamanda sunulan sonuç listesi olabilir; aynı ifade yeni bir liste gösterildikten sonra başka bir nesneyi seçer. Çözümleyici bu nedenle yalnız son niyeti değil, görünür sonuç kümesini, referans türünü, sıra bilgisini ve bağlam sürümünü birlikte taşır. Söylem odağı son anılan nesneye indirgenmez; özne sürekliliği, açık seçim ve bağlam değişikliği ayrı ipuçlarıdır.
Bir düzeltme işlemi, önceki sorgunun bütün parametrelerini silip yeni soru kurmak yerine tek bir alan üzerinde sınırlı değişiklik olarak modellenebilir. “Hayır, üçüncü kaydı kastettim” ifadesi önceki sonucun sıra numarasını düzeltirken zaman aralığını ve arama koşulunu değiştirmez. “Yalnızca notları incele” ifadesi ise veri kaynağı kapsamını değiştirebilir; ancak böyle bir değişiklik yalnız önceki görevin not kaynağını desteklemesi ve yeni kapsamın yetkili olması durumunda geçerlidir. Gönderim çözülemediğinde benzer görünen başka bir kayda otomatik geçilmez.
Belirsizliği korumak, her cümle için uzun bir alternatif listesi tutmak anlamına gelmez. Olası referanslar türlerine göre sınırlandırılır ve sonuç kümesi değiştiğinde geçersizleşir. Açık komut, bağlamsal gönderim ve fonetik öneri farklı güven düzeyleriyle değerlendirilir; son ikisi yan etkili bir işlemin tek dayanağı olamaz. Başarılı konuşma yönetimi, hem yanlış işlemi engellemesi hem de gereksiz netleştirmeyi azaltmasıyla ölçülür.
Ünite 27: Veri Mühendisliği, Mahremiyet ve Etiketleme
NLP modelinin davranışı yalnız algoritmadan değil, veri yaşam döngüsünden oluşur. Kaynağı bilinmeyen, yinelenen, hatalı ayrılmış veya üretim dağılımını temsil etmeyen büyük bir veri kümesi küçük ama iyi tanımlanmış bir derlemden daha kötü sonuç verebilir.
27.1. Veri Kökeni ve Üstveri
Her veri parçası için mümkün olduğunca şu bilgiler korunmalıdır:
- kaynak,
- toplama zamanı,
- dil,
- alan,
- izin/lisans,
- dönüşüm adımları,
- etiket sürümü,
- anonimleştirme veya maskeleme işlemleri.
ham veri
  |
  v
köken / lisans denetimi
  |
  v
temizleme
  |
  v
etiketleme
  |
  v
bölme
  |
  v
modelleme
Model dosyası yeniden üretilebilir olsa bile ham verinin hangi kurallarla dönüştürüldüğü bilinmiyorsa deney tam olarak yeniden üretilemez.
27.2. Eğitim Verisi ile Çalışma Zamanı Verisi Farklı Güvenlik Alanlarıdır
Eğitim derlemi bir kez hazırlanmış durağan veri gibi görülebilir. Çalışma zamanı girdisi ise sürekli değişen ve çoğu zaman kullanıcı kontrollü veridir.
Eğitimde:
- kullanım hakkı,
- kişisel veri,
- veri saklama süresi,
- veri sızıntısı,
- yinelenen içerik
önemlidir.
Çalışma zamanında ise bunlara ek olarak:
- kötü niyetli giriş,
- aşırı uzun metin,
- kodlama bozukluğu,
- hassas içeriğin günlüğe yazılması,
- istem enjeksiyonu,
- kaynak tüketimi
gibi riskler oluşur.
27.3. Maskeleme, Anonimleştirme ve Takma Adlılaştırma
Bir kişi adını [KISI] ile değiştirmek her durumda anonimleştirme sağlamaz. Metnin geri kalanındaki kurum, tarih, konum veya olay bilgileri kişiyi yeniden tanımlamaya yetebilir.
Bu nedenle:
doğrudan tanımlayıcıyı silmek
        !=
yeniden tanımlamayı imkânsız kılmak
Mahremiyet tasarımı veri alanı ve saldırganın sahip olabileceği ek bilgi birlikte değerlendirilerek yapılmalıdır.
27.4. Sınıf Dengesizliği
Üretimde nadir görülen bir sınıf, iş açısından en kritik sınıf olabilir. Eğitim kümesini üretim frekansıyla bire bir kopyalamak modelin nadir sınıfı öğrenmesini güçleştirebilir; yapay biçimde eşitlemek ise gerçek öncül olasılıkları bozabilir.
Çözüm, yalnız yeniden örnekleme değil; ölçümün sınıf bazında yapılmasıdır.
genel F1
    |
    +--> sınıf A
    +--> sınıf B
    +--> kritik nadir sınıf
27.5. Etiketleme Yönergesi de Model Bileşenidir
Bir varlığın sınırının, ironinin, olumsuzluğun veya çoklu niyetin nasıl etiketleneceği açık değilse etiketleyiciler arasındaki uyuşmazlık modelin erişebileceği üst sınırı düşürür.
Türkçe için özel adlara gelen eklerin varlık sınırına dâhil edilip edilmeyeceği, birleşik eylemlerin nasıl işaretleneceği ve konuşma dökümlerindeki dolgu ifadelerinin nasıl ele alınacağı baştan belirlenmelidir.
Ünite 28: Zayıf Gözetim, Uzak Gözetim ve Etiketsiz Veriden Yararlanma
Etiketli dil verisi pahalıdır. Buna karşılık kurumların elinde çoğu zaman büyük miktarda etiketsiz metin bulunur. Bu veri doğrudan "eğitim verisi" sayılmadan önce hangi öğrenme sinyalini taşıdığı belirlenmelidir.
28.1. Kümeleme ve Konu Keşfi
Etiketsiz belgeler gömme uzayında kümelenerek veri dağılımı hakkında fikir verebilir:
etiketsiz belgeler
      |
      v
temsil
      |
      v
kümeleme
      |
      +--> konu adayı A
      +--> konu adayı B
      +--> aykırı küme
Küme etiketi otomatik olarak gerçek sınıf değildir. Ancak yeni niyetlerin, beklenmeyen alanların veya etiketleme eksiklerinin keşfinde yararlıdır.
28.2. Zayıf Gözetim
Zayıf gözetimde kesin insan etiketi yerine daha ucuz fakat gürültülü etiketleme işlevleri kullanılabilir.
Örneğin bir belge:
- belirli bir sözlük eşleşmesi,
- veri tabanındaki mevcut alan,
- dosya yolu,
- kaynak uygulama,
- başka bir modelin tahmini
üzerinden geçici etiket alabilir.
Birden fazla zayıf kuralın aynı örnek üzerinde çelişebileceği kabul edilmelidir. Amaç gürültüyü yok saymak değil, etiket kaynağının güvenilirliğini modellemektir.
28.3. Uzak Gözetim
Yapılandırılmış bir bilgi kaynağındaki ilişkiler metne yaklaşık etiket taşımak için kullanılabilir. Bu yöntem insan emeğini azaltır; fakat metindeki ilişkinin gerçekten aynı bağlamı ifade ettiğini garanti etmez.
Dolayısıyla uzak gözetim:
ucuz etiket üretimi
    +
yüksek gürültü riski
şeklinde değerlendirilmelidir.
28.4. Etkin Öğrenme
Etkin öğrenmede model en bilgi taşıyan veya en belirsiz örnekleri insan etiketleyiciye seçer. Özellikle uzmanlık gerektiren Türkçe alan verisinde rastgele binlerce örnek etiketlemek yerine sınır durumlarına odaklanmak maliyeti azaltabilir.
Ancak yalnız en belirsiz örnekleri seçmek veri dağılımını bozabilir. Belirsizlik, çeşitlilik ve sınıf kapsaması birlikte kullanılmalıdır.
28.5. Üretici Modellerle Sentetik Veri
Büyük dil modelleri örnek üretmekte kullanılabilir; fakat modelin ürettiği örneğin gerçek kullanıcı dağılımını temsil ettiği varsayılmamalıdır.
Sentetik veri:
- nadir biçimleri çoğaltabilir,
- biçim çeşitliliği sağlayabilir,
- test senaryosu hazırlamayı hızlandırabilir.
Aynı zamanda:
- üretici modelin önyargısını taşıyabilir,
- gerçek yazım hatalarını temizleyebilir,
- dilin doğal frekanslarını bozabilir,
- eğitim ve değerlendirme arasında yapay benzerlik üretebilir.
Bu nedenle sentetik veri ayrı köken etiketiyle tutulmalı ve gerçek veri üzerindeki sonuçtan bağımsız raporlanmalıdır.
Ünite 29: Karma Mimari ve Model Seçimi
Bir NLP sistemini yalnız model ailesine göre sınıflandırmak gerçek üretim mimarisini gizler. Kural, klasik istatistik, sinir ağı ve büyük dil modeli aynı sistemde farklı sorumluluklar üstlenebilir.
29.1. En Karmaşık Model Varsayılan Değildir
Bir e-posta adresini tanımak için büyük dil modeli kullanmak gereksizdir. Düzenli ifade yeterli olabilir. Buna karşılık bağlama göre çok anlamlı bir varlığı ayırmak için yalnız düzenli ifade yetersiz kalabilir.
problem
  |
  +--> biçim kesin mi? ----------> kural / ayrıştırıcı
  |
  +--> sınıf sınırı öğrenilebilir mi? -> istatistik / sinir ağı
  |
  +--> açık uçlu üretim gerekli mi? --> üretici model
Mimari, görev zorluğu kadar hata maliyeti ve kaynak bütçesine göre seçilmelidir.
29.2. Kademeli İşleme
Yüksek trafikli sistemlerde ucuz aşama adayları daraltıp pahalı modeli yalnız gerekli örneklerde çalıştırabilir.
girdi
 |
 v
ucuz doğrulama / kural
 |
 +--> kesin sonuç ------> çıkış
 |
 +--> belirsiz
        |
        v
   küçük model
        |
        +--> yeterli güven --> çıkış
        |
        +--> belirsiz
               |
               v
           büyük model
Bu yapı toplam maliyeti ve gecikmeyi azaltabilir. Ancak erken aşama yanlış eleme yaparsa daha güçlü modelin hatayı düzeltme şansı kalmaz. İlk aşamanın geri çağırımı bu nedenle kritik olabilir.
29.3. Türkçe Biçimbilim + Sinirsel Model
Türkçe için karma mimari şu biçimde kurulabilir:
ham metin
  |
  v
Unicode / yazım normalizasyonu
  |
  v
biçimbilimsel adaylar
  |
  v
bağlamsal sinirsel model
  |
  v
alan kuralı / doğrulama
Her görevde açık morfolojik çözümleyici kullanmak zorunlu değildir. Ancak hata analizi belirli ek ve yüzey biçimlerinde sistematik sorun gösteriyorsa açık biçimbilimsel özellikler yararlı olabilir.
29.4. Model Kapasitesi ile Sistem Kapasitesi Aynı Değildir
Daha büyük model daha yüksek görev skoru verebilir; aynı donanımda eşzamanlı istek sayısını düşürerek kuyruk gecikmesini artırabilir.
Model seçimi şu dört ekseni birlikte ele almalıdır:
görev kalitesi
hesaplama maliyeti
gecikme
işletme / bakım karmaşıklığı
Bir puanlık F1 kazancı üretim kapasitesini yarıya indiriyorsa bu kazancın iş değeri ayrıca gerekçelendirilmelidir.
29.5. Açıklanabilirlik ve Denetlenebilirlik
Kural tabanlı sistemde bir kararın hangi kuraldan çıktığı çoğu zaman doğrudan görülebilir. Sinirsel modelde bu ilişki daha dolaylıdır. Bunun karşılığında kurallar dil çeşitliliğini kapsamakta zorlanabilir.
Karma sistemde kritik kararın son aşaması açık kurala bırakılabilir:
model -> aday
kural -> izin / ret / sınır
Bu, özellikle yetki, mevzuat veya güvenlik politikasının olasılıksal modele devredilmemesi gereken sistemlerde önemlidir.
Ünite 30: Değerlendirmeyi Tek Skordan Çıkarmak
Model geliştirme sırasında en tehlikeli kolaylık tek bir sayıyı bütün sistem başarısı kabul etmektir. NLP ölçümü veri bölme stratejisinden kullanıcı deneyimine kadar çok katmanlıdır.
30.1. Eğitim, Doğrulama ve Test
Eğitim kümesi parametre öğrenir. Doğrulama kümesi model ve eşik seçiminde kullanılır. Test kümesi son değerlendirme için ayrılır.
Test kümesine bakılarak sürekli karar verilirse test kümesi dolaylı olarak eğitim sürecinin parçası hâline gelir.
30.2. Gruplanmış ve Zamansal Bölme
Rastgele satır bölmek bazı veri türlerinde sızıntı üretir.
Aynı konuşmanın farklı cümleleri, aynı belgenin parçaları veya aynı kullanıcının çok benzer iletileri farklı bölmelere düşebilir.
yanlış:
satırlar -> rastgele train/test

daha güvenli:
belge / kullanıcı / konuşma grubu
        |
        +--> train
        +--> validation
        +--> test
Zaman içinde değişen alanlarda geleceği temsil eden test kümesi için zamansal bölme daha anlamlı olabilir.
30.3. Bileşen Çıkarma Deneyi
Bir sistemde yeni bileşen eklenince skor yükselmiş olabilir; fakat artışın gerçekten o bileşenden kaynaklandığı bilinmeyebilir.
Bileşen çıkarma deneyi:
tam sistem
   |
   +--> A bileşenini çıkar -> ölç
   +--> B bileşenini çıkar -> ölç
   +--> C bileşenini çıkar -> ölç
yaklaşımıyla her parçanın katkısını ayrı inceler.
Türkçe NLP'de örneğin:
- biçimbilimsel özellik,
- ASCII normalizasyonu,
- yeniden sıralayıcı,
- alan sözlüğü
ayrı ayrı çıkarılarak gerçek etkileri ölçülebilir.
30.4. İstatistiksel Anlamlılık
İki sistem arasındaki küçük fark her zaman gerçek iyileşme değildir. Test örneği sayısı, hata dağılımı ve kullanılan ölçü farkın rastlantısal olma olasılığını etkiler.
Bu nedenle özellikle araştırma karşılaştırmalarında güven aralığı, yeniden örnekleme veya görev için uygun anlamlılık testi değerlendirilmelidir.
30.5. Kullanıcı Testi
Bir sınıflandırıcının yüksek skoru, kullanıcıların sistemi başarılı bulduğunu garanti etmez.
Etkileşimli sistemde şu ölçüler de önemlidir:
- görevin tamamlanma oranı,
- tekrar ifade etme sayısı,
- insan temsilciye aktarım oranı,
- kullanıcının vazgeçtiği tur,
- uçtan uca gecikme.
Kullanıcı testi model metriğinin alternatifi değil, uygulama metriğinin tamamlayıcısıdır.
30.6. Dil ve Alan Dilimleri
Toplam skor hata dağılımını saklayabilir.
Türkçe için ayrı dilimler:
standart yazı
ASCII Türkçe
ASR dökümü
özel ad yoğun metin
kod değiştirimli metin
uzun ek zincirleri
yazım hataları
üzerinde ölçüm yapılabilir.
Bir model toplamda daha yüksek skor alıp kritik üretim diliminde daha kötü olabilir.
Ünite 31: Dağıtımdan Sonra Kayma, Bakım ve Geri Besleme
NLP modeli üretime alındığında geliştirme bitmez. Dil canlıdır; kullanıcı davranışı, ürün adları, kurum adları, konu dağılımı ve saldırgan davranışlar zamanla değişir.
31.1. Üç Farklı Kayma
Üretimde en az üç değişim türü ayrıştırılabilir.
Girdi dağılımı kayması: Metin biçimi değişir. Yeni kısaltmalar, yeni ürün adları veya başka kanal verisi görülmeye başlanır.
Etiket dağılımı kayması: Sınıfların görülme oranı değişir.
Kavram kayması: Aynı yüzey örüntüsünün hedef etiketiyle ilişkisi değişir.
dün:
örüntü X -> sınıf A

bugün:
örüntü X -> sınıf B
Bu üç durumun çözümü aynı değildir. Her kaymada modeli yeniden eğitmek gerekmeyebilir.
31.2. Üretim Gözlemi
Hassas metni bütünüyle loglamak çoğu zaman doğru gözlem yöntemi değildir. Bunun yerine:
- istek uzunluğu dağılımı,
- dil tahmini,
- bilinmeyen token oranı,
- güven skoru histogramı,
- sınıf frekansı,
- hata kodu,
- gecikme,
- kuyruk yaşı
gibi anonim veya toplulaştırılmış göstergeler izlenebilir.
31.3. Geri Bildirim Verisinin Tuzağı
Kullanıcının düzelttiği örnekler değerli eğitim verisi olabilir. Ancak yalnız hatalı örnekleri toplamak yeni derlemi üretim dağılımından uzaklaştırır.
Geri bildirim havuzu:
hata örnekleri
+
rastgele üretim örneği
+
kritik sınıf örnekleri
birlikte kullanılarak daha dengeli tutulabilir.
31.4. Regresyon Kümesi
Daha fazla yeni veriyle yeniden eğitim eski davranışı bozabilir. Bu nedenle geçmişte düzeltilmiş hatalar kalıcı regresyon kümesine eklenmelidir.
yeni model
   |
   +--> güncel test
   |
   +--> tarihsel regresyon
   |
   +--> kritik güvenlik vakaları
   |
   +--> performans testi
Yalnız ortalama doğruluk geçen sürüm üretime alınmamalıdır.
31.5. Sınırlı Yayına Alma ve Gölge Çalışma
Yeni model doğrudan bütün trafiğe verilmek yerine küçük bir kullanıcı diliminde denenebilir veya eski model karar vermeye devam ederken yeni model aynı girdiler üzerinde gölge biçimde çalıştırılabilir.
Gölge çalıştırmada yeni modelin çıktısı kullanıcı kararını etkilemez; karşılaştırma için kaydedilir. Böylece gerçek dağılımda gecikme ve çıktı farkları daha düşük riskle görülebilir.
31.6. Geri Dönüş
Model, tokenizer, normalizasyon ve alan sözlüğü birlikte sürümlenmelidir.
NLP_RELEASE =
    normalizasyon sürümü
  + tokenizer sürümü
  + model sürümü
  + sözlük sürümü
  + karar eşiği
Bir üretim sorunu çıktığında yalnız ağırlık dosyasını geri almak yeterli olmayabilir. Geri dönüş bir bütün olarak işleme hattını eski sürüme taşımalıdır.
Ünite 32: NLU ile Üretici Modeller Arasında Güven Sınırı
Büyük dil modelleri, niyet belirleme ve bilgi çıkarımı gibi klasik NLU görevlerini doğal dil talimatlarıyla gerçekleştirebilir. Bu kolaylık, üretim sözleşmesinin ortadan kalktığı anlamına gelmez.
32.1. Serbest Metin Yerine Sözleşmeli Çıktı
Bir modelden:
"Bu metni analiz et."istemek yerine beklenen şema tanımlanabilir:
niyet
varlıklar
güven
gerekçe_gerekiyor_mu
Modelin ürettiği yapı yine doğrulanmalıdır.
LLM
 |
 v
aday JSON / yapı
 |
 v
şema denetimi
 |
 v
alan doğrulaması
 |
 v
iş kararı
32.2. Model Önerir, Yetki Katmanı Karar Verir
Araç kullanan bir dil modeli:
"hesabı kapat"gibi bir eylem önerebilir. Kullanıcının bu eyleme yetkili olup olmadığı modelin dil çıktısından çıkarılmamalıdır.
doğal dil
   |
   v
model -> önerilen işlem
   |
   v
kimlik + yetki + politika
   |
   +--> izin
   |
   +--> ret
Bu sınır prompt enjeksiyonu ve hatalı çıkarım riskini doğrudan azaltır.
32.3. RAG, NLU ve Kaynak Güvenilirliği
Belge getirme destekli üretim sisteminde üç ayrı doğruluk vardır:
- doğru belge getirildi mi,
- model belgede olanı doğru yorumladı mı,
- üretilen yanıt kaynak tarafından gerçekten destekleniyor mu?
Bu nedenle tek bir "cevap doğru/yanlış" metriği hata kaynağını bulmak için yetersizdir.
32.4. Türkçe Yapılandırılmış Çıkarım
Türkçede ekler varlık ilişkisini taşıyabilir:
Ali'nin raporu
Ankara'daki toplantı
şirketten gelen yazı
Model varlık gövdesini doğru bulsa bile ekin taşıdığı sahiplik, konum veya ayrılma ilişkisini kaybedebilir. Yapılandırılmış çıkarım şemasında yalnız varlık metni değil, ilişkinin türü de sınanmalıdır.
32.5. Küçük Model, Büyük Model ve Deterministik Katman
Üretim NLP'si tek model yarışı değildir.
deterministik katman
       |
       +--> biçim / güvenlik / sözleşme

küçük görev modeli
       |
       +--> yüksek hacimli rutin sınıflandırma

büyük dil modeli
       |
       +--> açık uçlu ve bağlam yoğun örnekler
Bu bileşenler doğru sınırlarla birlikte kullanıldığında maliyet, gecikme ve hata etkisi daha yönetilebilir olur.
Ünite 33: NLU Sistemi İçin Uçtan Uca Mühendislik Denetimi
Bir NLP/NLU sistemi üretime alınmadan önce yalnız doğruluk raporuna bakmak yerine bütün yaşam döngüsü denetlenebilir.
problem
  |
  v
görev sözleşmesi
  |
  v
veri kökeni ve etiket
  |
  v
temsil / model
  |
  v
çevrimdışı değerlendirme
  |
  v
sınırlı gerçek trafik
  |
  v
üretim
  |
  v
kayma + geri bildirim
  |
  +--------------------+
           yeniden değerlendirme
Temel denetim soruları şunlardır:
- Doğal dil bu problem için gerçekten gerekli mi?
- Giriş ve çıkış sözleşmesi kesin mi?
- Kritik hata türleri ayrı tanımlandı mı?
- Eğitim verisinin kökeni ve kullanım hakkı biliniyor mu?
- Türkçeye özgü normalizasyon ve biçimbilim kararları belgeli mi?
- Eğitim, doğrulama ve test bölmeleri sızıntıya dayanıklı mı?
- Basit bir kural veya klasik model güçlü bir temel olarak ölçüldü mü?
- Yeni bileşenin katkısı bileşen çıkarma deneyiyle görüldü mü?
- Sınıf ve dil dilimleri ayrı raporlandı mı?
- Kullanıcıya dönük sistemde uçtan uca gecikme ölçüldü mü?
- Modelin kararsız kaldığında ne yapacağı belirli mi?
- Yetkilendirme olasılıksal modelin dışında mı?
- Hassas metin günlüklerde gereksiz yere tutuluyor mu?
- Model, tokenizer, normalizasyon ve eşikler birlikte sürümleniyor mu?
- Geçmiş hatalar regresyon kümesinde korunuyor mu?
- Yeni sürüm için geri dönüş yolu var mı?
- Üretim dağılımındaki kayma izleniyor mu?
- Sentetik ve zayıf etiketli veri gerçek veriden ayrıştırılıyor mu?
- Kaynak getiren sistemde getirme ve üretim hataları ayrı ölçülüyor mu?
- Modelin başarısı iş sonucu ve kullanıcı göreviyle birlikte değerlendiriliyor mu?
Bu denetimin amacı her projeyi gereksiz yere ağırlaştırmak değildir. Tam tersine, hangi katmanın gerçekten gerekli olduğunu belirleyerek fazla model, fazla veri ve fazla karmaşıklığı önlemektir.
33.1. Yapay Zeka ile İlişkisi
Doğal dil işleme yapay zekânın en eski ve en sürekli problem alanlarından biridir. Bununla birlikte NLP ile yapay zekâ eş anlamlı değildir. NLP, dil verisinin temsili ve işlenmesiyle ilgilenir; yapay zekâ ise bunun yanında algılama, arama, planlama, kontrol, öğrenme, bilgi gösterimi ve karar verme gibi çok daha geniş problem sınıflarını içerir.
Yapay Zeka: Felsefe, Kuram ve Uygulama açısından doğal dil, "anlama" kavramının sınırlarını görünür hâle getirir. Bir model dilbilgisel ve bağlama uygun metin üretebilir; bu gözlem tek başına modelin bilinç, niyet veya insan benzeri kavrayış taşıdığını kanıtlamaz. Davranışsal başarı ile içsel durum hakkındaki felsefi iddia birbirinden ayrılmalıdır.
Yapay Sinir Ağları ve Öğrenme Modelleri, gömme vektörlerinden Transformer'a kadar modern NLP'nin öğrenilmiş temsil temelini sağlar. NLP ise bu modellerin üzerinde çalıştığı dilsel birimlerin, veri hatalarının ve görevlerin özelliklerini açıklar.
İstatistiksel Öğrenme ve Makine Öğrenmesi, Naive Bayes, HMM, sınıflandırma, genelleme, değerlendirme ve dağılım değişimi gibi NLP'nin klasik ve modern dönemlerinde ortak kalan ilkeleri sağlar. Dil modeli de temelde gözlenen dizilerden olasılıksal düzen öğrenme problemidir.
Mantıksal Programlama ve Prolog, NLP'nin sembolik tarafıyla ilişkilidir. Dilbilgisi, anlamsal çözümleme, bilgi gösterimi ve kural tabanlı çıkarım doğal dil çıktısını açık ilişkilere dönüştürmek için kullanılabilir. Güncel sistemlerde üretici modelin çıkardığı aday ilişkilerin Prolog, kural motoru veya biçimsel doğrulayıcıyla sınanması nöro-sembolik bir mimari oluşturabilir.
Bulanık Mantık dildeki "yüksek", "yakın", "yeterli" gibi dereceli kavramların üyelik temsiliyle modellenebileceğini gösterir. Bir dil modelinin token olasılığı ile bulanık üyelik derecesi aynı kavram değildir; bu iki değer farklı modelleme sorularına cevap verir.
Genetik Algoritmalar ve Uygulamaları doğrudan NLP yöntemi değildir; fakat özellik seçimi, hiperparametre arama, istem veya kural dizisi optimizasyonu gibi dış optimizasyon problemlerinde kullanılabilir.
Büyük Dil Modelleri modern NLP'nin üretici ve genel amaçlı model katmanını ayrıntılandırır. Bu dersin temel ayrımı şudur:
NLP
  = dil verisi + temsil + görev + ölçüm + sistem

LLM
  = NLP görevlerinin büyük bölümünü gerçekleştirebilen
    güçlü bir model ailesi

LLM != NLP'nin tamamı
Doğal dil işleme tarihi kural tabanlı dilbilgilerinden istatistiksel modellere, sinirsel temsillere ve büyük dil modellerine uzanır. En sağlam mühendislik yaklaşımı bu dönemlerden birini ideolojik olarak seçmek değil, problemin hangi bölümünün açık kurala, hangi bölümünün veriden öğrenmeye, hangi bölümünün ise biçimsel doğrulamaya ihtiyaç duyduğunu belirlemektir.
Ünite 34: Gömme Modellerini Göreve Göre Seçmek
Gömme (embedding) modeli, metni sabit boyutlu bir vektöre dönüştürür. Ancak bütün gömme modelleri aynı problem için optimize edilmez. Bir model anlamsal benzerlikte güçlü olup retrieval'da zayıf olabilir; başka bir model kümeleme veya sınıflandırma için daha uygun olabilir.
Bu nedenle “en iyi gömme modeli” ifadesi görev tanımı olmadan eksiktir.
Metin
  |
  v
Gömme modeli
  |
  v
Vektör
  |
  +--> benzerlik
  +--> arama
  +--> kümeleme
  +--> sınıflandırma özelliği
MTEB gibi çok görevli kıyaslamaların önemli sonucu, tek bir gömme yaklaşımının bütün görevlerde baskın olmadığını göstermesidir. Üretim sistemi kendi veri dağılımında ayrıca ölçüm yapmalıdır.
34.1. Bi-encoder ve cross-encoder
Semantik aramada iki önemli modelleme biçimi vardır.
Bi-encoder, sorgu ve belgeyi ayrı ayrı vektöre dönüştürür. Belge vektörleri önceden hesaplanabilir; bu nedenle milyonlarca belge arasında hızlı arama için uygundur.
Query ----> Encoder ----> q
Document -> Encoder ----> d

score = similarity(q,d)
Cross-encoder ise sorgu ve aday belgeyi birlikte işler.
[query ; document]
        |
        v
   Transformer
        |
        v
 relevance score
Daha zengin token-token etkileşimi kurabildiği için yeniden sıralamada güçlüdür; fakat bütün corpus üzerinde çalıştırılması pahalıdır.
Tipik üretim deseni:
bi-encoder / BM25
      |
    top 100
      |
cross-encoder
      |
    top 10
Bu ayrım Bilgi Erişimi Destekli Üretim dersindeki retrieval mimarisinin NLP temelidir.
Ünite 35: BERT, GPT ve T5 Aynı Transformer Ailesinin Farklı Kullanımlarıdır
Transformer tek bir model türü değildir. Attention tabanlı bloklar farklı eğitim hedefleri ve bilgi akışlarıyla farklı görev ailelerine uyarlanabilir.
35.1. BERT Çizgisi
BERT türü encoder modelleri girdinin iki yönlü bağlamını temsil eder. Maskeli dil modelleme gibi ön eğitim hedefleriyle öğrenilen temsil:
- metin sınıflandırma,
- token sınıflandırma,
- adlandırılmış varlık tanıma,
- anlamsal benzerlik,
- özellik çıkarımı
gibi görevlerde kullanılabilir.
35.2. GPT Çizgisi
Decoder-only GPT ailesi nedensel maske kullanarak geçmiş tokenlerden sonraki tokenı tahmin eder.
x1 -> x2 -> x3 -> ?Bu yapı doğal olarak üretim, tamamlama ve çok turlu dil modeli uygulamalarına uygundur.
35.3. T5 Çizgisi
T5 yaklaşımı farklı NLP görevlerini ortak “text-to-text” sözleşmesine dönüştürür.
girdi metni
   |
encoder
   |
decoder
   |
çıktı metni
Sınıflandırma bile hedef etiketin metin olarak üretilmesiyle ifade edilebilir.
Bu üç aileyi:
BERT = anlama
GPT = üretme
T5 = çevirme
gibi kesin sınırlarla tanımlamak fazla basittir. Daha doğru ayrım encoder/decoder yapısı, attention maskesi ve eğitim hedefidir.
Ünite 36: Tokenizer Eğitimi de bir NLP Modelleme Kararıdır
Tokenizer çoğu zaman yalnız model öncesi teknik ayrıntı gibi görülür. Oysa özellikle Türkçe gibi eklemeli dillerde:
- dizi uzunluğunu,
- bağlam maliyetini,
- nadir sözcük davranışını,
- eklerin parçalanmasını,
- model sözlüğü boyutunu
doğrudan etkiler.
36.1. BPE ve Unigram Yaklaşımı
BPE ailesi sık görülen sembol birlikteliklerini birleştirerek sözlük oluşturur. Unigram yaklaşımı ise olası alt parçalar arasından olasılıksal bölümleme yapar.
SentencePiece bu yöntemleri ham Unicode metin üzerinde çalıştırabilecek bir çerçeve sunar.
Türkçe bir tokenizer şu testlerle değerlendirilmelidir:
sözcük başına token
karakter başına token
ek zinciri parçalanması
özel ad davranışı
sayı / kod davranışı
ASCII Türkçe davranışı
İngilizce teknik terim davranışı
Yalnız İngilizce corpus üzerinde verimli olan tokenizer Türkçe için gereksiz uzun token dizileri üretebilir.
36.2. Morfolojik Sınır ile Tokenizer Sınırı Aynı Değildir
Model açısından yararlı bir alt sözcük parçası dilbilimsel biçimbirim olmak zorunda değildir.
dilbilim:
gel + ecek + ler + den

model tokenizer:
gele + cekler + den
Bu durum hata değildir; fakat model tokenlarını morfolojik analiz çıktısı gibi yorumlamak hatadır.
Ünite 37: Çok Dilli Gömme ve Diller Arası Retrieval
Çok dilli gömme modeli, farklı dillerdeki semantik olarak benzer metinleri ortak vektör uzayına yaklaştırmayı hedefleyebilir.
"bağlantı havuzu"
        |
        v
çok dilli gömme modeli
        |
        +---- yakın ----> "connection pool"
Bu yetenek özellikle Türkçe sorguyla İngilizce teknik belge aramak için değerlidir.
Ancak çok dilli olmak şu garantileri vermez:
- bütün dillerde eşit kalite,
- bütün alfabelerde eşit token maliyeti,
- özel adlarda doğru eşleşme,
- alan terminolojisinde doğru transfer.
Bu nedenle değerlendirme çift yönlü yapılmalıdır:
TR sorgu -> TR belge
TR sorgu -> EN belge
EN sorgu -> TR belge
EN sorgu -> EN belge
Sistemin gerçek kullanım senaryosuna göre ağırlıklandırılmalıdır.
Ünite 38: Metin Sınıflandırma ve Token Sınıflandırmayı Ayırmak
Modern Transformer kütüphaneleri benzer bir altyapıyla çok farklı görevler sunabilir. Kavramsal olarak iki görev ayrılmalıdır.
38.1. Metin Sınıflandırma
Tüm cümle veya belge için bir etiket üretilir.
"Bu e-posta ücretsiz ödül vaat ediyor."
           |
           v
          SPAM
38.2. Token Sınıflandırma
Her token veya token grubuna etiket atanır.
"Ali Ankara'ya gitti."
 Ali       -> PERSON
 Ankara    -> LOCATION
Named Entity Recognition token sınıflandırmanın özel uygulamalarından biridir.
Subword tokenizasyonu nedeniyle tek sözcük birden çok model tokenına ayrılabilir. Etiketlerin yeniden sözcük düzeyine birleştirilmesi, özellikle Türkçede ekli özel adlarda dikkat gerektirir.
Ankara'daki
 -> Ankara
 -> '
 -> daki
Model çıktısının kullanıcıya gösterilecek varlık sınırına nasıl geri birleştirileceği açık bir post-processing sözleşmesi olmalıdır.
Ünite 39: Gömme Modelini Kendi Verinizde Kıyaslama Etmek
Genel leaderboard, model seçimi için başlangıçtır; son karar değildir.
Bir kurum içi semantik arama sistemi için küçük bir altın test kümesi hazırlanabilir:
query
expected_relevant_documents
hard_negatives
language
domain
Ölçümler:
- Recall@K,
- MRR,
- nDCG,
- dil bazlı başarı,
- özel ad / teknik terim dilimleri,
- gecikme,
- gömme üretim maliyeti.
Hard negative, sorguya yüzeysel olarak benzeyen fakat yanlış belge olan örnektir. Bu örnekler modelin gerçek ayrım yeteneğini daha iyi sınar.
Türkçe RAG araştırmaları da retrieval ve reranking kararlarının İngilizce merkezli varsayımlardan bağımsız değerlendirilmesi gerektiğini göstermektedir. Bu yüzden gömme modeli seçimi doğrudan RAG sisteminin kalite sınırını belirleyen bir NLP kararıdır.
Ünite 40: Deterministik ve Karma NLU Mimarisi
Doğal dil anlama (NLU) her zaman büyük bir üretici model gerektirmez. Görev alanı sınırlı, eylem kümesi bilinen, gecikme ve denetlenebilirlik gereksinimi yüksek sistemlerde deterministik kurallar, bilgi erişimi, bulanık eşleşme ve konuşma durumu birlikte güçlü bir çözüm oluşturabilir.
Bu yaklaşım özellikle:
- çevrimdışı çalışma,
- mahremiyet duyarlı veri,
- sınırlı ve açık niyet kümesi,
- tekrarlanabilir sonuç,
- düşük gecikme,
- güçlü regresyon testi,
- yetki kontrollü işlem
gerektiren uygulamalarda değerlidir.
40.1. NLU'yu Tek Sınıflandırıcıya İndirgememek
Bir kullanıcı girdisi farklı güvenilirlik düzeylerinde işlenebilir.
Örnek kademeli mimari:
girdi
  ↓
normalizasyon
  ↓
tam eşleşme
  ↓ bulunamazsa
kalıp eşleşmesi
  ↓ bulunamazsa
konuşma bağlamı
  ↓ bulunamazsa
alan dilbilgisi
  ↓ bulunamazsa
TF-IDF / kosinüs erişimi
  ↓ belirsizse
bulanık eşleşme
  ↓
fallback
Bu sıra rastgele değildir. En deterministik ve en açıklanabilir katmanlar önce çalışır; daha esnek eşleştirme katmanları ancak kesin yollar başarısız olduğunda devreye girer.
40.2. Normalizasyon bir Bilgi Kaybı Kararıdır
Türkçe NLU'da normalizasyon:
büyük / küçük harf
Unicode biçimi
fazla boşluk
noktalama
bazı yazım varyantları
üzerinde çalışabilir.
Ancak her normalizasyon geri dönüşsüz bilgi kaybı oluşturabilir.
Örneğin:
I / İ / ı / iayrımı Türkçede anlamsaldır.
Bu nedenle normalizasyon katmanı:
arama için normalize edilmiş biçim
+
kullanıcıya gösterilecek özgün biçim
ayrımını korumalıdır.
40.3. Tam Eşleşme: Yüksek Kesinlikli Niyetler
Bazı kullanıcı ifadeleri ürün dilinin parçasıdır:
"yardım"
"özetle"
"sonraki adım"
"kaynakları göster"
Bu tür ifadelerde tam eşleşme (exact match):
- hızlıdır,
- deterministiktir,
- açıklanabilir,
- regresyon testine uygundur.
Özellikle UI düğmesinde yazan ifade ile kullanıcının aynı ifadeyi yazması aynı niyete gitmelidir.
40.4. Kalıp Eşleşmesi
Düzenli ifadeler veya açık kalıplar, kontrollü varyasyonları yakalayabilir.
Örneğin:
"son 7 günü göster"
"son 30 günü incele"
"ilk 5 sonucu getir"
gibi cümlelerde sayı ve birim değişirken niyet aynıdır.
Kalıp eşleşmesinin avantajı, hangi yüzey biçiminin hangi niyete bağlandığının açık olmasıdır.
Dezavantajı ise kalıp sayısı büyüdükçe çakışma ve bakım maliyetinin artmasıdır.
40.5. Kısa Konuşma Bağlamı
Kullanıcı doğal konuşmada:
"neden?"
"hangisi?"
"biraz aç"
"sınırları ne?"
gibi eksiltili ifadeler kullanır.
Bu ifadeler tek başına yeterli anlam taşımayabilir; önceki konuşma turuna göre çözülür.
Bağlam çözümleme için her zaman genel amaçlı eş gönderim modeli gerekmez. Dar görev alanında:
son niyet var mı?
ifade kısa mı?
önceki bulgu seçili mi?
gibi açık kurallar yeterli olabilir.
Bu yaklaşımın sınırı açık olmalıdır: sistem, genel dilsel eş gönderim çözdüğünü iddia etmez; yalnız önceden tanımlanmış konuşma referanslarını çözer.
40.6. Alan Dilbilgisi
Bazı görevler serbest metinden çok küçük bir komut diline benzer.
Örneğin:
[eylem] + [nesne] + [zaman]
[karşılaştır] + [dönem A] + [dönem B]
[göster] + [ilk N] + [ölçüt]
Bu yapı alan dilbilgisi (domain grammar) olarak modellenebilir.
Avantajları:
- yüksek açıklanabilirlik,
- kolay test,
- hızlı çalışma,
- yanlış pozitif üzerinde doğrudan kontrol.
40.7. TF-IDF ve Kosinüs Benzerliği ile Niyet Erişimi
Kullanıcının ifadesi bilinen örneklere yakınsa, basit bilgi erişimi yaklaşımı güçlü bir ara katman olabilir.
Her niyet için örnek ifadeler bir belge gibi ele alınabilir.
TF-IDF:
tfidf(t, d) = tf(t, d) × log(N / df(t))ile terimlerin belge içindeki ayırt ediciliğini ağırlıklandırır.
Sorgu ve niyet belgeleri vektörleştirildikten sonra kosinüs benzerliği:
cos(q, d) = (q · d) / (||q|| × ||d||)ile karşılaştırılabilir.
Bu yöntem semantik gömme modeli kadar esnek değildir; fakat:
- küçük niyet kümelerinde,
- alan terminolojisi belirgin olduğunda,
- çevrimdışı ve deterministik gereksinimlerde
oldukça kullanışlı olabilir.
40.8. Yalnız top-1 Skora Güvenmemek
Bir sınıflandırıcının en yüksek skorlu adayı üretmesi, adayın yeterince ayırt edici olduğu anlamına gelmez.
Örneğin:
A niyeti: 0.61
B niyeti: 0.59
ile:
A niyeti: 0.61
B niyeti: 0.18
aynı top-1 skoruna sahiptir; fakat belirsizlikleri farklıdır.
Bu nedenle:
top-1 skoru
+
top-1 - top-2 marjı
birlikte kullanılabilir.
Kabul koşulu örneği:
skor yeterince yüksek
VEYA
skor orta düzeyde + marj güçlü
Bu, yakın adaylarda yanlış otomatik yönlendirmeyi azaltır.
40.9. Bulanık Eşleşme Son Güvenlik Ağıdır
Bulanık eşleşme (fuzzy string matching), yazım hataları ve küçük yüzey farklılıkları için yararlıdır.
Ancak bulanık eşleşme ile bulanık mantık (fuzzy logic) aynı şey değildir.
bulanık eşleşme:
  iki metin ne kadar benziyor?

bulanık mantık:
  üyelik dereceleri ve yaklaşık çıkarım
Bulanık eşleşme en esnek katmanlardan biri olduğu için deterministik tam/kalıp eşleşmelerden sonra kullanılmalıdır.
Ayrıca yalnız en iyi skor değil, ikinci adayla fark da kontrol edilmelidir.
40.10. Eşleşme Kökeni (Provenance)
NLU sistemi yalnız:
niyet = Xdemek yerine:
niyet = X
eşleşme kökeni = EXACT
skor = 1.0
veya:
niyet = Y
eşleşme kökeni = RETRIEVAL
skor = 0.73
marj = 0.21
gibi içsel provenance bilgisi taşıyabilir.
Bu bilgi:
- hata ayıklama,
- regresyon analizi,
- eşik ayarlama,
- kullanıcıya açıklama üretme
için değerlidir.
40.11. Varlık Çıkarımı ve Niyet Yönlendirmesi Ayrı Katmanlardır
Bir cümlede:
"son 14 günü karşılaştır"için iki ayrı çıktı vardır:
niyet:
  karşılaştır

varlık:
  dönem = 14 gün
Niyet ve varlık aynı modelde üretilebilir; fakat sistem tasarımında ayrı sorumluluk olarak düşünmek test edilebilirliği artırır.
Dar alanlarda varlık çıkarımı:
- sayı + zaman birimi,
- sıra sayısı,
- tırnak içi ifade,
- açık kimlik biçimi,
- "bu / o / ilk / son" gibi referanslar
üzerinden deterministik yapılabilir.
40.12. Diyalog Durumu
Tek tur NLU ile konuşmalı sistem aynı şey değildir.
Diyalog durumu:
son niyet
son sonuç
seçili öğe
aktif dönem
aktif varlık
cevap biçimi
gibi bilgileri saklayabilir.
Önemli ilke:
Yeni veri üretmeyen bir konuşma turu, kullanıcının önceki seçimini gereksiz yere sıfırlamamalıdır.
Aksi durumda sistem dilsel olarak doğru cevap verse bile konuşma bilişsel olarak kopar.
40.13. Niyet ile Yetkiyi Ayırmak
NLU bir isteği doğru anlamış olabilir:
niyet = kayıt açfakat bu, işlemin yapılabileceği anlamına gelmez.
Mimari:
NLU
 ↓
niyet
 ↓
yetenek / yetki kontrolü
 ↓
araç çağrısı
şeklinde olmalıdır.
Böylece dil katmanı güvenlik sınırını geçmez.
40.14. Araç Sözleşmesi
NLU sistemi araçları rastgele nesne biçimleriyle çağırırsa entegrasyon hızla kırılganlaşır.
Küçük ve sabit bir araç sözleşmesi yararlıdır:
reply    -> doğrudan kullanıcıya gösterilebilecek metin
data     -> yapılandırılmış sonuç
context  -> konuşma durumuna eklenecek bağlam
Bu biçim, farklı araçların konuşma motoruna tutarlı bağlanmasını sağlar.
40.15. Erişim Korpusu ile İş Verisini Ayırmak
Niyet eşleştirme için kullanılan TF-IDF korpusu ile uygulamanın gerçek iş verisi aynı indeks olmak zorunda değildir.
Daha güvenli tasarım:
NLU erişim korpusu:
  niyet örnekleri
  yardım metni
  genel bilgi

iş verisi:
  ayrı yetki sınırı
  ayrı sorgu / analiz katmanı
Bu ayrım:
- mahremiyet,
- yetkilendirme,
- veri yaşam döngüsü,
- yanlış semantik eşleşme
risklerini azaltır.
40.16. Deterministik NLU ile Üretici Model Birlikte Kullanılabilir
Karma mimari:
yüksek kesinlikli deterministik katman
        ↓
gerekirse küçük sınıflandırıcı / retrieval
        ↓
gerekirse üretici model
        ↓
sözleşmeli yapılandırılmış çıktı
        ↓
yetki kontrolü
şeklinde olabilir.
Üretici model, her girdinin varsayılan yolu olmak zorunda değildir.
Özellikle güvenlik veya doğruluk maliyeti yüksek eylemlerde deterministik katman:
- izin verilen niyet kümesini sınırlar,
- kritik komutları açıkça yakalar,
- üretici çıktının doğrudan eyleme dönüşmesini engeller.
40.17. Regresyon Korpusu NLU Modelinin Parçasıdır
NLU sistemi yalnız eğitim verisiyle değil, davranış regresyon kümesiyle de tanımlanır.
Test korpusu en az üç sınıf içermelidir:
pozitif:
  doğru niyete gitmeli

negatif:
  belirli niyete kesinlikle gitmemeli

çakışma:
  iki niyet aynı yüksek kesinlikli ifadeyi sahiplenmemeli
Ayrıca:
- kısa bağlam takipleri,
- yazım hataları,
- yakın niyetler,
- anlamsız ifade,
- eşik sınırları,
- top-1 / top-2 marjı
test edilmelidir.
40.18. Sentetik Örnek
Niyet kümesi:
ÖZETLE
ZAMAN_ANALİZİ
AĞ_ANALİZİ
KANIT_GÖSTER
SONRAKİ_ADIM
Kullanıcı:
"bağlantı ağındaki köprüleri incele"Kalıp veya alan dilbilgisi üzerinden AĞ_ANALİZİ niyetine gidebilir.
Sonraki tur:
"neden?"tek başına yeni bir sorgu değildir. Konuşma durumu üzerinden önceki analitik bulgunun açıklama niyetine çözülebilir.
Kullanıcı:
"xyz qqq"yazdığında sistem en yakın niyeti zorla seçmek yerine fallback üretmelidir.
Bu son davranış özellikle önemlidir:
İyi NLU her girdiyi sınıflandırmak zorunda değildir; gerektiğinde kararsız kalabilmelidir.
40.19. Mühendislik Kontrol Listesi
- Normalizasyon Türkçe karakter bilgisini koruyor mu?
- Yüksek kesinlikli komutlar tam eşleşme ile korunuyor mu?
- Kalıplar birbiriyle çakışıyor mu?
- Bağlam yalnız anlamlı önceki tur varsa kullanılıyor mu?
- Alan dilbilgisi ile serbest retrieval sırası açık mı?
- Retrieval top-1 skorunun yanında marj kullanılıyor mu?
- Bulanık eşleşme düşük kesinlikli girdileri zorla yönlendiriyor mu?
- Niyet ve varlık ayrı test edilebiliyor mu?
- Eşleşme kökeni izlenebiliyor mu?
- Konuşma durumu eski ve yeni sonucu karıştırıyor mu?
- NLU eylem yetkisini kendi başına genişletebiliyor mu?
- İş verisi, niyet retrieval korpusuna gereksiz yere karışıyor mu?
- Araç sonucu standart sözleşmeye sahip mi?
- Aynı girdi ve aynı durum aynı yönlendirmeyi üretiyor mu?
- Negatif ve çakışma testleri pozitif testler kadar güçlü mü?
Bu yaklaşım, NLU'yu yalnız model seçimi problemi olmaktan çıkarır; dil işleme, durum yönetimi, güvenlik ve yazılım doğrulamasının birlikte tasarlandığı bir sistem problemi hâline getirir.
Ünite 41: Türkçede Span-Korumalı ve Bileşimsel NLU
Türkçe doğal dil işleme hattında normalizasyon yararlıdır; ancak aşırı normalizasyon kullanıcının yazdığı kritik parçaları geri döndürülemez biçimde değiştirebilir. Özellikle kimlik, sayı, tarih, süre, bağlantı, dosya adı veya alan terimi içeren görevlerde yalnız normalize edilmiş metni saklamak yeterli değildir.
Daha güvenli token temsili, birden fazla görünümü birlikte taşıyabilir:
raw       = kullanıcının gerçek yazımı
canonical = dilsel eşleştirme için standart biçim
folded    = toleranslı arama için sadeleştirilmiş biçim
start/end = özgün metindeki karakter aralığı
Böylece sistem eşleştirme sırasında esnek, kritik değer bağlama sırasında ise özgün girdiye sadık kalabilir.
41.1. Protected Literal
Her token aynı düzeyde düzeltilebilir olmamalıdır.
Korunan literal kategorileri örneğin:
sayısal kimlik
tarih / saat
URL
dosya yolu
tırnak içi ifade
kod / sürüm değeri
olabilir.
Bu alanlarda fuzzy düzeltme veya morfolojik parçalama, gerçek değeri başka bir değere dönüştürebilir. Dilsel tolerans ile veri bütünlüğü arasında açık sınır gerekir.
41.2. Türkçe Morfolojiyi Alan Bilgisiyle Birleştirmek
Eklemeli yapı nedeniyle aynı kavram çok sayıda yüzey biçiminde gelebilir:
ilişki
ilişkiler
ilişkilerin
ilişkilerinden
ilişkisindeki
Tam kapsamlı morfolojik çözümleyici güçlü bir seçenektir; ancak dar bir alan dilinde tüm dilbilgisel analiz her görev için zorunlu olmayabilir.
Hibrit yaklaşım:
genel Türkçe tokenizasyon
+
gerekirse morfolojik çözümleme
+
alan terimleri sözlüğü
+
kontrollü ek / kök varyantları
şeklinde kurulabilir.
Kütüphane çıktısı doğrudan eylem yetkisi değildir. Morfolojik analiz yalnız dilsel kanıt üretir.
41.3. Informal Türkçe ve ASCII Toleransı
Gerçek kullanıcı girdisi ders kitabı Türkçesi değildir. ASCII toleransı yararlı olabilir; ancak sistem özgün metni kaybetmemelidir. i/ı ve I/İ dönüşümleri Türkçede bilgi taşıdığı için canonical ve folded biçimler ayrı tutulmalıdır.
41.4. Olumsuzluk Yalnız İntent Özelliği Değildir
Türkçede aç/açma, göster/gösterme ve dinle/dinleme yüzey olarak birbirine yakındır; eylem yönünden karşıttır.
Yan etkili komutta:
eylem kökü bulundu
+
olumsuzluk bulundu
=
yan etki için veto
gibi bağımsız bir dilsel güvenlik sinyali üretilebilir.
Bu veto güvenlik katmanının yerini almaz; yanlış olumlu niyet yönlendirmesine karşı ek korumadır.
41.5. Sayı ve Sıra İfadeleri
Konuşmalı analitikte:
ilk
ikinci
son üç
ilk ikisi
üçüncünün kanıtı
gibi sıra ifadeleri önemlidir.
ordinal = 2 tek başına ikinci ne sorusunu cevaplamaz. Gerekli bağ:
ordinal = 2
referenceSet = CURRENT_FINDINGS
şeklinde kurulabilir.
41.6. Anlamsal Bölütleme
Kullanıcı tek cümlede birden fazla bağımlı işlem isteyebilir:
"son dönemi incele, önceki dönemle karşılaştır ve en güçlü iki bulgunun kanıtlarını göster"Bunu tek intent adına sıkıştırmak bilgi kaybına neden olur.
Bileşimsel çözümlemede cümle sınırlı sayıda anlam parçasına ayrılabilir:
ANALYZE(period=current)
COMPARE(period=previous)
RANK(limit=2, metric=strength)
OUTPUT(evidence)
Tek işlemli mesaj daha basit tek-intent yolunda kalabilir.
41.7. Semantic Atom Yaklaşımı
Bölütlerden alan-bağımsız küçük semantik atomlar üretilebilir:
ACTION=COMPARE
SUBJECT=RELATION
QUALIFIER=RECENT
METRIC=STRENGTH
LIMIT=2
OUTPUT=EVIDENCE
Bu atomlar doğrudan çalıştırılabilir kod değil, sonraki planlama katmanının girdisidir.
41.8. Karakter n-gram ve Kelime Bigram Özellikleri
Kelime tabanlı retrieval Türkçe ek varyasyonlarında veya küçük yazım hatalarında zayıflayabilir.
Karakter 3–5 gram özellikleri ek varyasyonlarına, küçük typo'lara ve ASCII/Türkçe karakter farklarına tolerans sağlayabilir.
Kelime bigramları ise yeni ilişki, son hafta, ilk iki gibi tek kelimeden daha belirgin kalıpları korur.
Bu özelliklerin hiçbiri sayısal kimlikleri düzeltmek için kullanılmamalıdır.
41.9. Çok Özellikli Yönlendirme
Bir aday niyet için:
exact işareti
pattern işareti
grammar uyumu
TF-IDF kosinüs skoru
karakter n-gram skoru
kelime bigram skoru
kontrollü fuzzy skoru
context uyumu
birlikte kullanılabilir.
Son karar yalnız en yüksek skora değil top1, top2, marj ve risk sınıfına bakabilir.
Sonuç bölgeleri:
ACCEPT
CLARIFY
ABSTAIN / FALLBACK
olarak ayrılabilir.
Yan etkili eylemlerde kabul eşiği daha muhafazakâr seçilebilir.
41.10. Clarification bir Hata Değildir
Birden fazla varlık aynı adla eşleşiyorsa sistem ilkini rastgele seçmemelidir.
1 aday -> çöz
birkaç aday -> açıklaştır
0 aday -> bulunamadı
yaklaşımı yanlış varlığa bağlanmayı azaltır.
41.11. Bileşimsel Planın Sınırı
NLU çıktısı bir sorgu veya işlem planına dönüşebilir; fakat plan bağımlı adım sayısını, fan-out miktarını ve çalıştırılabilir eylem türlerini sınırsız büyütmemelidir.
Bu konu yalnız performans değil güvenlik ve doğrulanabilirlik problemidir.
Span-korumalı ve bileşimsel NLU, doğal dil esnekliğini korurken kritik literal, olumsuzluk, bağlam ve işlem sınırlarını ayrı sözleşmeler hâline getirir.
41.12. NLP İşlem Hattında Hata Kaynağını Ayrıştırmak
Dil sistemlerinde işlem hattı; tokenizasyon, temsil, retrieval, bağlam seçimi, çıkarım ve değerlendirme aşamalarının toplamıdır. Doğal dil işleme hattında retrieval tabanlı bileşenler recall ve ranking hataları üretirken generative bileşenler desteklenmeyen çıkarım veya çelişki üretebilir; bu nedenle akıcılık skoru, doğruluk, kapsama, calibration ve kaynakla tutarlılık ölçülerinin yerine geçmemelidir. Agent veya araç kullanan sistemlerde her ek adım yeni bir gecikme ve hata sınırı ekler.
- Tokenizasyon hatası, retrieval hatası ve model çıkarım hatasını ayrı değerlendirmek.
- Sınıflandırma veya extraction sonuçlarında macro/micro metrik seçimini veri dağılımına göre yapmak.
- Dilsel evaluation setinde domain shift ve veri sızıntısını kontrol etmek.
Ünite 42: Metin Madenciliği ve Belge Koleksiyonlarından Bilgi Keşfi
Metin madenciliği, doğal dil işlemenin eş anlamlısı değildir. NLP dilsel yapıyı çözümleyen yöntem ailesini; bilgi erişimi ilgili belge veya pasajı bulmayı; makine öğrenmesi örneklerden karar işlevi öğrenmeyi; metin madenciliği ise büyük belge koleksiyonlarından koleksiyon düzeyinde örüntü, ilişki ve eğilim çıkarmayı hedefler. Bu alanlar aynı sistemde birlikte çalışabilir.
42.1. Belge, Koleksiyon ve Ara Temsil
Metin madenciliğinin temel analiz birimi çoğu zaman tek bir cümle değil, belge koleksiyonudur. Koleksiyon:
- statik olabilir; analiz anında belge kümesi değişmez,
- dinamik olabilir; yeni belge eklenir, belge güncellenir veya kapsam zaman içinde değişir.
"Yapılandırılmamış metin" tamamen yapısız değildir. Başlık, paragraf, tablo, noktalama, tarih, yazar, bölüm sınırı ve sözcük sırası örtük veya yarı yapılandırılmış bilgi taşır. Bu nedenle üretim hattında ham metin doğrudan madencilik algoritmasına verilmek yerine açık bir ara temsile dönüştürülür:
ham belge
   ↓
ayrıştırma ve normalizasyon
   ↓
özellik / terim / kavram temsili
   ↓
koleksiyon düzeyinde analiz
42.2. Karakter, Sözcük, Terim ve Kavram Düzeyleri
Belge temsili farklı soyutlama düzeylerinde kurulabilir:
karakter → sözcük → terim → kavramKarakter n-gram'ları yazım varyasyonlarına dayanıklılık sağlayabilir. Sözcük düzeyi yüzey biçimini korur. Terim, tek veya çok sözcüklü anlamlı birimi temsil eder. Kavram düzeyi ise aynı anlam alanına gelen farklı yüzey biçimlerini daha üst bir kimlik altında birleştirebilir.
Metin verisi iki temel hesaplama özelliği taşır:
- yüksek boyutluluk: koleksiyonda çok fazla olası özellik bulunur,
- seyreklik: tek bir belgede bu özelliklerin yalnız küçük bir bölümü görünür.
Bu nedenle daha fazla özellik her zaman daha iyi temsil anlamına gelmez. Semantik kapsama ile hesaplama maliyeti birlikte değerlendirilmelidir.
42.3. Metin Madenciliği Sistem Mimarisi
Genel bir sistem aşağıdaki katmanlara ayrılabilir:
belge kaynakları
      ↓
ön işleme
      ↓
kanonik / ara temsil
      ↓
çekirdek madencilik işlemleri
      ↓
iyileştirme ve sınırlandırma
      ↓
sunum / gezinme
      ↺
kullanıcı sorgusu ve yeni kısıtlar
Önemli nokta, kullanıcıyı yalnız sonucun tüketicisi olarak görmemektir. Büyük koleksiyonlarda keşif çoğu zaman sorgula → incele → daralt → yeniden sorgula döngüsüdür.
42.4. Koleksiyon Düzeyindeki Temel Örüntüler
Metin madenciliğinde tek belgenin anlamından farklı olarak koleksiyon genelindeki dağılımlar incelenir.
Bir kavram kümesi X için basit destek:
support(X) = |{d ∈ D : X ⊆ d}| / |D|şeklinde tanımlanabilir.
Bu çerçevede:
- dağılım: bir kavramın farklı belge alt kümelerindeki görülme yapısı,
- sık kavram kümesi: belirli destek eşiğinin üzerinde birlikte görülen kavramlar,
- yakın-sık kavram kümesi: tam ortaklık yerine yüksek örtüşme veya benzerlik gösteren kümeler,
- ilişkilendirme: bir kavram kümesinin başka bir küme ile birlikte görülme eğilimi
incelenebilir.
Birlikte görülme önemlidir; fakat:
co-occurrence ≠ causalityBir metin koleksiyonunda iki kavramın sıkça birlikte geçmesi nedensel ilişkiyi kanıtlamaz.
42.5. Örüntü Bolluğu ve İlginçlik
Yüksek boyutlu bir korpusta binlerce geçerli örüntü bulunabilir. Bu durumda asıl sorun yalnız örüntü bulmak değil, kullanıcı açısından yönetilebilir ve anlamlı sonuç kümesi oluşturmaktır.
Bu amaçla:
- minimum support,
- sıralama,
- bastırma,
- budama,
- gruplama,
- bağlamsal kısıt,
- sonuç çeşitlendirme
gibi mekanizmalar kullanılabilir. Bir örüntünün hesaplanabilir olması, raporlanmaya değer olduğu anlamına gelmez.
42.6. Dinamik Korpus ve Zamansal Örüntüler
Belgelere güvenilir zaman damgası bağlanabiliyorsa aynı kavram dağılımı farklı dönemlerde karşılaştırılabilir:
D(t1) → kavram dağılımı
D(t2) → kavram dağılımı
           ↓
        değişim
Böylece yükselen, azalan, yeni ortaya çıkan veya kaybolan kavramlar incelenebilir. Dönemsel sapma ve geçici ilişki adayları üretilebilir.
Dinamik koleksiyonda her yeni belge geldiğinde bütün korpusu sıfırdan hesaplamak pahalı olabilir. Artımlı yöntemlerin temel amacı, önceki hesaplamanın güvenli biçimde yeniden kullanılabildiği yerlerde yalnız değişen bölümün etkisini işleyebilmektir. Bu bir doğruluk ödünü değildir; önceki durumun hangi koşullarda geçerli kaldığının açıkça tanımlanmasını gerektirir.
42.7. Alan Bilgisi ve Kontrollü Kavram Uzayı
Sözlük, ontoloji, taksonomi ve kontrollü terim listeleri:
- eş anlamlıları normalize etmek,
- çok anlamlılığı sınırlandırmak,
- kavram hiyerarşisi kurmak,
- bilgi çıkarımını doğrulamak,
- sorguyu bağlamsal olarak daraltmak
için kullanılabilir.
Alan bilgisi, kaynaktaki kanıtın yerine geçmez. Ontoloji bir belgenin söylemediği olguyu doğru kabul ettirmez; yalnız temsil, eşleştirme ve sorgu sınırlarını daha tutarlı kurmaya yardım eder.
42.8. Bilgi Çıkarma: Metinden Yapılandırılmış Olguya
Metin madenciliği için tipik bilgi çıkarma hattı:
token / dilsel özellik
       ↓
varlık çıkarımı
       ↓
eşgönderim çözümleme
       ↓
ilişki / olay çıkarımı
       ↓
normalize edilmiş kayıt
şeklinde düşünülebilir.
Eşgönderim çözümleme kritik bir ara katmandır. Aynı gerçek varlığa gönderme yapan ad, zamir veya tanımlayıcı ifadeler birleştirilemezse ilişki grafı parçalanabilir veya yanlış çoğalabilir.
42.9. Kural Tabanlı, Olasılıksal ve Hibrit Çıkarım
Bilgi çıkarımının tarihsel gelişiminde elle yazılmış örüntüler; HMM, MaxEnt, MEMM ve CRF gibi olasılıksal modeller; daha sonra sinirsel ve Transformer tabanlı modeller kullanılmıştır. Buradaki mühendislik dersi belirli bir modelin "eski" veya "yeni" olması değil, veri ve hata profilinin hangi yaklaşımı gerektirdiğidir.
Hibrit bir sistem:
yüksek kesinlikli kural
        +
istatistiksel skor
        +
alan kısıtı
bileşenlerini birlikte kullanabilir. Bootstrapping ile az sayıda yüksek güvenli örnekten yeni adaylar üretilebilir; ancak yanlış örneklerin iterasyon boyunca çoğalması semantic drift yaratabileceğinden her turda kalite kapısı gerekir.
42.10. Bilgi Çıkarma için Kural DSL'si
Kural tabanlı çıkarım belirli bir ürün diline bağlı olmak zorunda değildir. Genel bir DSL şu sözleşmeleri ifade edebilir:
CONCEPT
  attributes

RULE
  context
  pattern
  constraints
  actions

GUARD
invariantspattern, aday eşleşmeyi; constraints, eşleşmenin kabul koşullarını; guard, üretilen kavram örneğinin merkezi değişmezlerini temsil eder. Bu ayrım, kural tekrarını ve aynı doğrulamanın birden fazla örüntüye dağılmasını azaltır.
42.11. Alan Değişse de Temel İşlem Hattı
Finans, patent, biyomedikal veya güvenlik metinleri farklı sözlük ve ilişki türleri gerektirir; ancak üst düzey mimari çoğunlukla değişmez:
alan korpusu
    ↓
alan sözlüğü / ontoloji
    ↓
varlık ve ilişki çıkarımı
    ↓
örüntü / eğilim analizi
    ↓
graf / görselleştirme
    ↓
insan doğrulaması
Bu nedenle başarılı bir metin madenciliği sistemi yalnız model seçimi değil; temsil, kaynak kökeni, sınırlandırılmış arama, sonuç iyileştirme ve insan incelemesini birlikte tasarlama problemidir.
42.12. Uzun Belgelerde Dengeli Seçici Özetleme
Belge özetlemenin ilk sorusu en yüksek puanlı cümlenin hangisi olduğu değil, hangi bilgi alanlarının özetin dışında kalmaması gerektiğidir. Bir görüşmenin ilk bölümünde sıkça tekrarlanan konu, sonraki bölümde bir kez geçen önemli bir karar veya zaman değişikliğini gölgeleyebilir. Bu nedenle uzun metin önce belge yapısı, konuşma dönüşü veya güvenilir zaman aralıklarıyla bölümlenir. Her bölüm içinde aday cümleler belirlenir; bölümler arası ikinci seçimde hem ilgililik hem de kapsama dikkate alınır.
Seyrek cümle benzerlik grafında her cümlenin tüm diğer cümlelerle karşılaştırılması zorunlu değildir. Önce sözcüksel temsillerle sınırlı komşuluk adayları bulunabilir; merkezilik hesabı bu kenarlar üzerinde yürütülebilir. Çeşitlilik seçimi, yüksek puanlı fakat önceki seçimleri tekrarlayan cümleleri geriye iter. Kullanılan ceza yalnız yüzey benzerliğine dayanırsa birbirine benzeyen fakat olumsuzluk veya zaman yönünden çelişen ifadeler yanlışlıkla birleştirilebilir. Cümle seçimi sırasında kip, olumsuzluk, konuşmacı ve zaman gibi ayrımlar kaybedilmemelidir.
Özetin eksiksizliği, incelenen kaynağın eksiksizliğiyle sınırlıdır. Veri erişimi belirli belge sayısında, karakter sınırında veya süre aralığında kesildiyse sonuç kısmi olarak işaretlenir. Seçilen cümle için özgün alıntı, belge kimliği, karakter aralığı ve varsa gerçek ses zamanları saklanır. Okuyucunun kaynağa dönmesini sağlayan bu bağ, yalnız kaynakça gösteriminden farklıdır: özetin her bilgi birimi denetlenebilir bir aralığa karşılık gelir.
Nitel tematik analiz, sözcük sıklığını konu yorumu ile eşitlemez. Çalışma önce araştırma sorusunu ve analiz birimini sabitler; ardından kısa metin parçalarına açık kodlar atanır, yakın kodlar tanımlanmış kurallarla birleştirilir ve temalar karşıt örneklerle sınanır. Aynı ifadenin iki bağlamda farklı anlamlar taşıyabilmesi, yalnız gömme benzerliğine dayalı otomatik etiketlemeyi yetersiz kılabilir. Bir modelin önerdiği kod araştırmacı kararı yerine geçmez; öneri için metin aralığı, kod tanımı ve gerekçe saklanmalıdır. Kodlama uyuşmazlıkları, yöntemsel hatayı gizlemek yerine kod kitabını geliştiren kanıt olarak değerlendirilir.
42.13. Türkçe Komut Yorumlamada Biçimbirim, Olumsuzluk ve Eylem Ayrımı
Türkçede sözcüğün yüzey biçimi, kök ve birden fazla ekin birleşimiyle oluşabilir. Analitik sorgu yorumlamasında büyük-küçük harf dönüşümü, Unicode normalizasyonu ve biçimbirim çözümleme ayrı aşamalardır. I/ı ile İ/i ayrımı korunmadan yapılan dil-bağımsız case folding, iki farklı sözcüğü aynı anahtarda birleştirebilir. Yazım hatasına tolerans da otomatik olarak eylem yetkisi üretmemelidir.
Niyet çıkarımında adlandırılmış varlığı bulmak, kullanıcının eyleme izin verdiğini göstermez. 'Kaydı açma' ve 'Kaydı aç' sözcelerindeki olumsuzluk, aynı isim ve fiil kökleri bulunsa da ters işleme karşılık gelir. 'Hangi kayıtlar açılmadı?' ise bir durum sorgusudur, yürütülecek açma komutu değildir. Bu yüzden olumsuzluk kapsamı, soru türü ve emir kipi çıkarılmadan eylem yönlendirmesi yapılmamalıdır.
Değerlendirme korpusu, eşit anlamlı yazım varyantlarını ve en küçük karşıt çiftleri içermelidir: olumlu/olumsuz, soru/emir, tekil/çoğul, zamansal bağlam ve mevcut seçimden bağımsız yeni varlık. Başarı oranı tek başına yeterli değildir; yanlış pozitif eylem oranı, kararsız sınıf ve gereksiz geri çekilme oranı ayrı raporlanmalıdır. Belirsiz çözümlemede güvenli varsayılan, kaynak gösteren sorgulama veya açıklama istemektir.
42.14. Deterministik Yönlendirmede Kanıt ve Bağlam Geçerliliği
Bir analitik yönlendirici, dilsel benzerlik skorundan sonra seçilmiş aracı doğrudan yürütmek zorunda değildir. Yürütme planı için varlık çözümlemesi, zaman aralığı, veri kapsamı, geçerli yetki ve işlevin parametre sözleşmesi ayrı kontrollerdir. Kullanıcının önceki sözcesine referans veren zamir veya eksiltili ifade, bağlamda aynı varlığın hâlâ geçerli olduğunu kanıtlamaz.
Bağlam sürümü değiştiğinde eski çözümlemenin kullanılmaması gerekir. Kural tabanlı ve istatistiksel yönlendiriciler aynı test kümesinde yanlış araç seçimi, yanlış varlık bağlama ve belirsizlik yönetimi yönünden karşılaştırılabilir. Sınıflandırıcının güven skoru ile gerçek olasılık kalibrasyonu birbirine karıştırılmamalıdır.
Kaynakça
- Alec Radford et al. “Robust Speech Recognition via Large-Scale Weak Supervision.” 2022. https://arxiv.org/abs/2212.04356
- Alexis Conneau et al. “Unsupervised Cross-lingual Representation Learning at Scale.” 2019. https://arxiv.org/abs/1911.02116
- Ashish Vaswani et al. “Attention Is All You Need.” NeurIPS, 2017. https://arxiv.org/abs/1706.03762
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- Chris Fregly. AI Systems Performance Engineering. O’Reilly Media, 2025.
- Daniel Jurafsky; James H. Martin. Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. 3rd edition online manuscript, August 19, 2026. https://web.stanford.edu/~jurafsky/slp3/
- Deborah A. Dahl. Natural Language Understanding with Python. Packt Publishing, 2023. ISBN 978-1-80461-342-9.
- Dzmitry Bahdanau; Kyunghyun Cho; Yoshua Bengio. “Neural Machine Translation by Jointly Learning to Align and Translate.” ICLR, 2015. https://arxiv.org/abs/1409.0473
- Fernando C. N. Pereira; David H. D. Warren. “Definite Clause Grammars for Language Analysis.” Artificial Intelligence, 13(3), 1980, 231–278.
- Frederick Jelinek. Statistical Methods for Speech Recognition. MIT Press, 1997.
- Haşim Sak; Tunga Güngör; Murat Saraçlar. “Resources for Turkish Morphological Processing.” Language Resources and Evaluation, 45(2), 2011, 249–261. DOI: https://doi.org/10.1007/s10579-010-9128-6
- Ilya Sutskever; Oriol Vinyals; Quoc V. Le. “Sequence to Sequence Learning with Neural Networks.” NeurIPS, 2014.
- Jacob Devlin; Ming-Wei Chang; Kenton Lee; Kristina Toutanova. “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.” 2018. https://arxiv.org/abs/1810.04805
- Jeffrey Pennington; Richard Socher; Christopher D. Manning. “GloVe: Global Vectors for Word Representation.” EMNLP, 2014. https://aclanthology.org/D14-1162/
- John Lafferty; Andrew McCallum; Fernando Pereira. “Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data.” ICML, 2001.
- Kemal Oflazer. “Two-level Description of Turkish Morphology.” Literary and Linguistic Computing, 9(2), 1994, 137–148. DOI: https://doi.org/10.1093/llc/9.2.137
- Kemal Oflazer; Murat Saraçlar (ed.). Turkish Natural Language Processing. Springer, 2018. DOI: https://doi.org/10.1007/978-3-319-90165-7
- Manning, Christopher D.; Raghavan, Prabhakar; Schütze, Hinrich. Introduction to Information Retrieval. Cambridge University Press, 2008. https://nlp.stanford.edu/IR-book/
- Marie-Catherine de Marneffe; Christopher D. Manning; Joakim Nivre; Daniel Zeman. “Universal Dependencies.” Computational Linguistics, 47(2), 2021, 255–308. DOI: https://doi.org/10.1162/coli_a_00402
- Marta R. Costa-jussà et al. “No Language Left Behind: Scaling Human-Centered Machine Translation.” 2022. https://arxiv.org/abs/2207.04672
- Muennighoff, N.; Tazi, N.; Magne, L.; Reimers, N. “MTEB: Massive Text Embedding Benchmark.” 2022. https://arxiv.org/abs/2210.07316
- Piotr Bojanowski et al. “Enriching Word Vectors with Subword Information.” Transactions of the Association for Computational Linguistics, 5, 2017, 135–146. https://aclanthology.org/Q17-1010/
- Raffel, C. et al. “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer.” Journal of Machine Learning Research, 21(140), 2020. https://jmlr.org/papers/v21/20-074.html
- Reimers, N.; Gurevych, I. “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks.” EMNLP-IJCNLP, 2019. https://arxiv.org/abs/1908.10084
- Rico Sennrich; Barry Haddow; Alexandra Birch. “Neural Machine Translation of Rare Words with Subword Units.” ACL, 2016. https://aclanthology.org/P16-1162/
- Ronen Feldman; James Sanger. The Text Mining Handbook: Advanced Approaches in Analyzing Unstructured Data. Cambridge University Press, 2007.
- Stanley F. Chen; Joshua Goodman. “An Empirical Study of Smoothing Techniques for Language Modeling.” Harvard Computer Science Group Technical Report TR-10-98, 1998.
- Steven Bird; Ewan Klein; Edward Loper. Natural Language Processing with Python. O’Reilly Media, 2009. ISBN 978-0-596-51649-9.
- Taku Kudo; John Richardson. “SentencePiece: A Simple and Language Independent Subword Tokenizer and Detokenizer for Neural Text Processing.” EMNLP System Demonstrations, 2018. DOI: https://doi.org/10.18653/v1/D18-2012
- Tomas Mikolov et al. “Efficient Estimation of Word Representations in Vector Space.” 2013. https://arxiv.org/abs/1301.3781
- Universal Dependencies. UD Turkish BOUN. https://universaldependencies.org/treebanks/tr_boun/
- Universal Dependencies. UD Turkish IMST. https://universaldependencies.org/treebanks/tr_imst/
- Utku Türk et al. “Resources for Turkish Dependency Parsing: Introducing the BOUN Treebank and the BoAT Annotation Tool.” Language Resources and Evaluation, 56, 2022, 259–307. DOI: https://doi.org/10.1007/s10579-021-09558-0