


Genetik Algoritmalar ve Uygulamaları


Genetik algoritmaları optimizasyon, temsil, seçilim, çaprazlama, mutasyon, kısıt yönetimi, yakınsama, diferansiyel evrim ve çok amaçlı optimizasyon bağlamında ele alan kapsamlı ders notu.
Ünite 1: Optimizasyon ve Evrimsel Hesaplama
1.1. Optimizasyon Problemi
Optimizasyon, bir amaç fonksiyonunun tanım kümesi içinde en iyi değeri veren parametre kümesini aramaktır. Fonksiyon f(P1, P2, ..., PN) biçiminde matematiksel olabileceği gibi, girişleri fiziksel büyüklükler olan deneysel bir süreç de olabilir.
Aynı fonksiyon bağlama göre maliyet (cost), amaç (objective) veya uygunluk (fitness) fonksiyonu olarak adlandırılır. Minimizasyon ve maksimizasyon problemleri işaret değiştirilerek birbirine dönüştürülür.
1.2. Problem Sınıfları
Optimizasyon problemleri birbirinden kesin sınırlarla ayrılmayan altı eksende sınıflandırılır:
- Deneme-yanılma ile arama veya fonksiyonun analitik biçimi üzerinden arama
- Tek parametreli veya çok parametreli (boyut arttıkça arama uzayı üstel büyür)
- Statik veya dinamik (amaç fonksiyonu zamana bağlı değişiyorsa dinamik)
- Sürekli veya ayrık parametreli (ayrık durum kombinatoryal optimizasyon olarak da adlandırılır)
- Sınırlı veya sınırsız (sınırlı problem uygun değişken dönüşümüyle sınırsız hale getirilebilir; örneğin
-1 ≤ x ≤ 1kısıtıx = sin(u)ile kaldırılır) - Deterministik veya olasılıklı arama
Bu eksenler, kullanılacak arama yönteminin karakterini belirler. Türev tabanlı yerel yöntemler uygun düzgünlük koşullarında hızlı yakınsama sağlayabilir; ancak sonuç başlangıç noktasına ve amaç yüzeyinin yapısına duyarlı olabilir. Olasılıklı ve popülasyon tabanlı yöntemler daha geniş bir arama davranışı sağlayabilir, fakat bunun karşılığında daha fazla amaç fonksiyonu değerlendirmesi gerektirir. Hiçbiri genel durumda global optimum garantisi vermez.
1.3. Saf Rastgele Arama
En basit istatistiksel arama, uzayda rastgele noktalar üretip en iyisini saklamaktır:
1. N adet başlangıç noktası üret: C(g,n), g = 0
2. Her nokta için F(C(g,n)) hesapla
3. C(g,best) = min{ F(C(g,n)) }
4. C(g,best) < C(best) ise C(best) = C(g,best)
5. Kabul edilebilir çözüm veya maksimum iterasyona ulaşıldıysa dur
6. Her noktayı küçük varyanslı gürültü ile bozarak yeniden üret
7. g = g + 1, adım 2'ye dön
Uygulaması kolaydır ve arama uzayı hakkında hiçbir varsayım yapmaz. Zayıf yanı, önceki denemelerden bilgi biriktirmemesidir: her adım geçmişten bağımsızdır, bu yüzden yakınsama süresi kabul edilemeyecek kadar uzayabilir.
1.4. Evrimsel Hesaplama Ailesi
Evrimsel hesaplama, doğal seçimin arama süreci olarak benzetilmesidir. Popülasyon içindeki bireyler aday çözümleri temsil eder; uygunluğu yüksek bireyler daha çok üreme şansı alır ve bilgi nesiller boyunca birikir.
Aile dört ana kola ayrılır: genetik algoritmalar (GA), genetik programlama (GP), evrimsel programlama (EP) ve evrim stratejileri (ES). Ayrım tarihseldir ve pratikte sınırlar bulanıklaşmıştır; GA çaprazlamayı merkeze alır, ES ve EP mutasyon ile kendi kendini uyarlayan parametrelere ağırlık verir, GP ağaç yapılı programları evrimleştirir.
1.5. Biyolojik Terminoloji ve Karşılıkları
- Kromozom: Aday çözümün kodlanmış hali (string, vektör, ağaç)
- Gen: Kromozomdaki tek konum (parametre veya bit)
- Allel: Genin alabileceği değer
- Genotip: Kodlanmış gösterim
- Fenotip: Kod çözüldükten sonraki gerçek parametre değerleri
- Uygunluk: Amaç fonksiyonu değeri
Terminoloji benzetme amaçlıdır. Genetik algoritmadaki kromozom tek zincirlidir, baskın-çekinik ilişkisi genellikle modellenmez ve mutasyon oranları biyolojik değerlerden çok daha yüksektir.
1.6. Arama Uzayı ve Uygunluk Yüzeyi
Uzunluğu l olan ikili kromozomların oluşturduğu arama uzayı 2^l noktadır ve bir hiperküp olarak düşünülür. Uygunluk yüzeyi (fitness landscape) bu uzaydaki her noktaya bir yükseklik atar; tepeler, vadiler, platolar ve yerel optimumlar problemin zorluğunu belirler.
Yüzeyin pürüzlülüğü ile aramanın zorluğu doğrudan ilişkilidir. Tek modlu ve düzgün yüzeylerde klasik gradyan tabanlı yöntemler genetik algoritmadan hızlıdır; genetik algoritma çok modlu, süreksiz, gürültülü veya türevi olmayan yüzeylerde tercih edilir.
1.7. Genetik Algoritmanın Kullanım Koşulları
Genetik algoritma her problem için doğru araç değildir. Birkaç parametreli analitik fonksiyonda klasik yöntemler hem daha hızlı hem daha kesindir.
Uygun koşullar şunlardır: arama uzayı büyük ve tam taranamıyor, yüzey çok modlu veya düzensiz, türev bilgisi yok veya güvenilmez, amaç fonksiyonu deneysel ya da benzetim tabanlı, sürekli ve ayrık parametreler birlikte bulunuyor, birden fazla iyi çözümün elde edilmesi isteniyor.
Bedeli açıktır: genetik algoritma optimum çözümü garanti etmez, çok sayıda uygunluk değerlendirmesi gerektirir ve sonuçları rastgele tohuma bağlı olarak değişir. Aynı tohum ve aynı işlem sırası kullanılmadıkça çalıştırmalar tekrarlanabilir değildir.
1.8. Temsil, Seçim, Varyasyon ve Uygunluk Döngüsünü Birlikte Okumak
Genetik algoritma üç mekanizmanın etkileşimidir ve tüm davranışı bu etkileşimden türer.
Popülasyon paralel örneklemedir. Aynı anda tutulan birden çok aday, arama uzayının farklı bölgelerinden bilgi biriktirir. Tek noktalı yöntemlerin yerel optimuma kilitlenmesinin önündeki temel engel budur.
Seçim sömürüdür. İyi bulunanı çoğaltır ve aramayı umut verici bölgelere yoğunlaştırır. Tek başına çalıştığında popülasyonu en iyi bireyin kopyalarına indirger.
Çaprazlama ve mutasyon keşiftir. Çaprazlama farklı bireylerdeki kısmi çözümleri birleştirir, mutasyon kaybolan çeşitliliği geri getirir. Tek başlarına çalıştıklarında arama rastgele aramaya dönüşür.
Algoritma tasarımının tamamı bu iki kuvvet arasındaki dengeyi ayarlamaktır. Seçim baskısı yöntemleri, operatör oranları, popülasyon büyüklüğü, seçkinlik, nişleme ve ada modeli aynı ekseni farklı yerlerden ayarlayan araçlardır.
Kodlama bu çerçevenin dışında değil, merkezindedir. Operatörlerin ürettiği yavruların anlamlı olup olmadığını kodlama belirler; permütasyon probleminde standart çaprazlamanın geçersiz çözüm üretmesi ile sürekli problemde ikili kodlamanın Hamming uçurumu yaratması aynı hatanın iki görünümüdür: gösterim ile operatörün uyumsuzluğu.
Teorik taraf, bu çerçevenin neden çalıştığının kısmen açıklandığını gösterir. Şema teoremi ve yapı taşı hipotezi bir sezgi verir fakat kesin bir başarı garantisi vermez; Royal Road deneyleri basit tepe tırmanmanın bazı koşullarda genetik algoritmayı geçebildiğini, bedava öğle yemeği sonucu ise hiçbir arama yönteminin evrensel üstünlüğü olmadığını gösterir. Genetik algoritmanın doğru kullanımı, problemin yapısıyla operatörlerin yapısını uyumlu hale getirmektir.
1.9. Genetik Algoritmada Temel Tasarım Kararları
- Genotip != fenotip (biri kodlanmış gösterim, diğeri çözülmüş parametre değerleri)
- Uygunluk fonksiyonu != amaç fonksiyonu (biri seçim için ölçeklenmiş, diğeri problemin kendi ölçüsü)
- Gen != kromozom (biri tek konum, diğeri konumların tümü)
- Allel != gen (biri genin aldığı değer, diğeri konumun kendisi)
- Derece o(H) != tanımlayıcı uzunluk δ(H) (biri sabit konum sayısı, diğeri ilk ve son sabit konum arası uzaklık)
- Şema != kromozom (biri kalıp, diğeri tek bir örnek)
- Örtük paralellik != paralel donanım (biri tek popülasyonun çok sayıda şemayı örneklemesi, diğeri işlemci paralelliği)
- Seçim != çaprazlama (biri var olanı çoğaltır, diğeri var olanı birleştirir; ikisi de tek başına yeterli değil)
- Çaprazlama != mutasyon (biri bireyler arası bilgi karışımı, diğeri kaybolan alleli geri getirme)
- Keşif != sömürü (arama bütçesinin yeni bölgelere mi iyi bölgelere mi ayrılacağı)
- Erken yakınsama != yakınsama (biri çeşitliliğin optimumdan önce tükenmesi, diğeri aramanın tamamlanması)
- Duraklama != erken yakınsama (biri düşük seçim baskısının, diğeri yüksek seçim baskısının sonucu)
- Rulet tekerleği != SUS (ikisi de aynı beklenen değeri verir, SUS örnekleme varyansını kaldırır)
- Sıralama seçimi != orantılı seçim (biri yalnız sırayı, diğeri uygunluk değerini kullanır)
- Seçkinlik != kararlı durum seçimi (biri en iyiyi korur, diğeri nesil değişim oranını düşürür)
- İkili kodlama != Gray kodlama (Gray'de ardışık değerlerin Hamming mesafesi 1'dir)
- Hamming mesafesi != sayısal fark (bit gösterimindeki farklılık ile değer farkı aynı şey değil)
- İkili kodlu GA != gerçek kodlu GA (biri kod çözme adımı ve çözünürlük sınırı taşır)
- Tek düzen çaprazlama != karıştırma çaprazlaması (biri var olan değerleri taşır, diğeri yeni değer üretir)
- İnterpolasyon != ekstrapolasyon (biri ebeveynler arasında, diğeri dışında değer üretir)
- Ceza fonksiyonu != onarım (biri geçersiz çözümü cezalandırır, diğeri geçerli hale getirir)
- Ölüm cezası != ceza fonksiyonu (biri geçersiz bireyi tümüyle atar)
- Epistasis != parametre sayısı (biri parametreler arası etkileşim derecesi)
- Aldatıcı problem != zor problem (aldatıcılık, düşük dereceli şemaların optimumdan uzağa işaret etmesidir)
- Yapı taşı hipotezi != kanıtlanmış teorem (şema teoremi alt sınır verir, başarı garantisi vermez)
- Otostopçuluk != mutasyon (biri yararlı bir bloğa komşu ilgisiz bitlerin birlikte sabitlenmesi)
- Ada modeli != ana-uydu paralelliği (biri algoritmanın davranışını değiştirir, diğeri yalnız değerlendirmeyi dağıtır)
- Doğrudan kodlama != dilbilgisi tabanlı kodlama (biri yapıyı bire bir, diğeri üretim kurallarıyla saklar)
- Baldwin etkisi != Lamarck kalıtımı (Baldwin'de öğrenilen bilgi genoma yazılmaz)
- İçsel uygunluk != sabit uygunluk fonksiyonu (biri popülasyona bağlıdır, yüzey arama sırasında değişir)
- Pareto baskınlığı != ağırlıklı toplam (biri amaçları ölçeklemeden karşılaştırır)
- Global optimum != GA çıktısı (genetik algoritma optimumu garanti etmez, iyi bir yaklaşım verir)
Ünite 2: İkili Kodlu Genetik Algoritma
Bu ünite, ikili kodlu genetik algoritmanın popülasyon oluşturma, uygunluk, seçim, çaprazlama, mutasyon ve durdurma adımlarını yinelemeli bir arama döngüsü olarak ele alır.
başlangıç popülasyonu
        |
        v
uygunluk değerlendirme
        |
        v
seçim -> çaprazlama -> mutasyon
        |                 |
        +------ yeni nesil+
                  |
                  +--> durdurma? -- hayır --> değerlendirme
                          |
                         evet
                          v
                        sonuç
İkili kodlu genetik algoritmada önce kromozomun hangi kararı temsil ettiği ve hangi bit dizilerinin geçerli çözüm olduğu belirlenir. Uygunluk hesabı amaç fonksiyonuyla uyumlu kurulmalı; kısıt ihlallerinin nasıl ele alınacağı açıkça seçilmelidir. Seçim, çaprazlama ve mutasyon adımlarından sonra yeni bireylerin geçerliliği kontrol edilir. Kuşak ilerledikçe yalnız en iyi uygunluğu değil, çeşitlilik kaybını ve farklı rastgele başlangıçların sonuca etkisini de izlemek gerekir.
2.1. Genel Akış
Amaç fonksiyonu, parametreler ve sınırları tanımla
Parametreleri kodla
Başlangıç popülasyonunu rastgele üret
tekrarla:
    uygunluk değerlerini hesapla
    doğal seçim ve eşleştirme
    çaprazlama
    mutasyon
    yakınsama testi
Döngü üç işlemin tekrarıdır: iyi kromozomların seçilmesi, genetik operatörlerin uygulanması, yeni bireylerin eski kötü bireylerle yer değiştirmesi.
2.2. Parametrelerin Tanımlanması
Kromozom, optimize edilecek parametrelerin dizisidir:
Kromozom = [P1, P2, ..., P(Npar)]
F(Kromozom) = F(P1, P2, ..., P(Npar))
Parametre sayısı problemin boyutudur. Sonuca etkisi ihmal edilebilir parametrelerin çıkarılması arama uzayını üstel oranda küçültür; bu nedenle parametre seçimi kodlamadan önce yapılacak ilk mühendislik kararıdır.
Parametreler arasındaki etkileşim genetik algoritma literatüründe epistasis olarak adlandırılır. Epistasis düşük olduğunda problem bileşenlere daha kolay ayrılabilir. Çok yüksek etkileşim ise standart çaprazlama operatörlerinin yararlı yapı taşlarını korumasını güçleştirebilir. Bu nedenle temsil ve operatör seçimi, değişkenler arasındaki bağımlılık yapısıyla birlikte değerlendirilmelidir.
2.3. İkili Kodlama ve Kod Çözme
Her parametre sabit uzunluklu bir bit dizisiyle temsil edilir; kromozom bu dizilerin birleşimidir. m bitlik bir gen 2^m farklı değer ayırt eder ve [a, b] aralığı için çözünürlük (b - a)/(2^m - 1) olur.
Kod çözme:
X(i) = a(i) + decimal(bits(i)) · (u(i) - a(i)) / (2^(m(i)) - 1)a(i) alt sınır, u(i) üst sınır, m(i) gene ayrılan bit sayısıdır. İstenen hassasiyet d ondalık basamak ise gerekli bit sayısı 2^m ≥ (b - a) · 10^d koşulundan bulunur.
2.4. Hamming Uçurumu ve Gray Kodlama
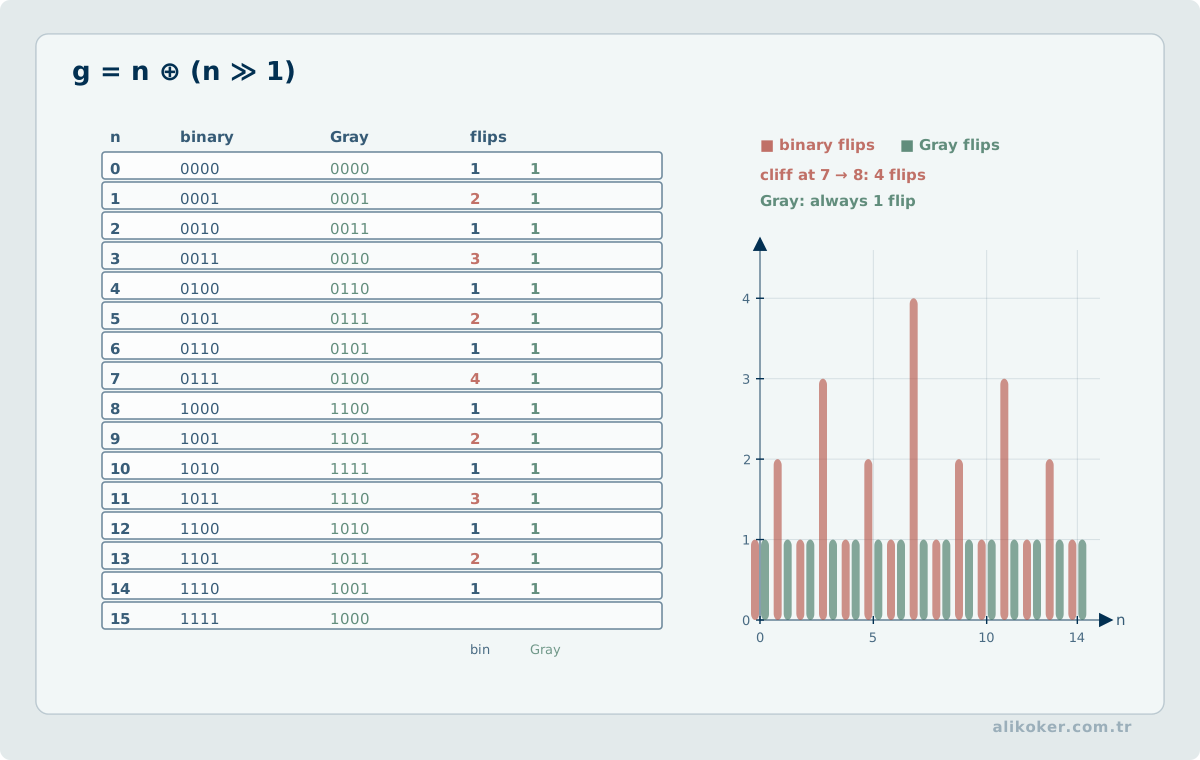
Standart ikili kodlamada komşu sayısal değerlerin bit gösterimleri çok farklı olabilir. Dört bitlik gösterimde 7 = 0111 ve 8 = 1000 arasındaki Hamming mesafesi 4'tür. Fenotipte çok küçük olan bir adım, genotipte dört bitin aynı anda değişmesini gerektirir. Bu Hamming uçurumudur ve mutasyon tabanlı ince ayarı engeller.
Gray kodlamada ardışık değerlerin Hamming mesafesi her zaman 1'dir:
g(1) = b(1)
g(k) = b(k-1) XOR b(k)
b(1) en anlamlı bittir. Gray kodlama yerel aramayı düzgünleştirir fakat problem bağımlı bir iyileştirmedir; her uygunluk yüzeyinde kazanç sağlamaz.
2.5. Başlangıç Popülasyonu
Nipop satır ve Nbit sütunlu rastgele bit matrisi üretilir; her satır bir kromozomdur. Popülasyon büyüklüğü aramanın başlangıç çeşitliliğini belirler: küçük popülasyon arama uzayını yetersiz örnekler ve erken yakınsar, büyük popülasyon nesil başına değerlendirme maliyetini doğrusal artırır.
Problemin uygun çözüm bölgesi hakkında ön bilgi varsa popülasyonun bir bölümü bu bölgeden seçilebilir (tohumlama). Tohumlama yakınsamayı hızlandırır, karşılığında yanlış bölgede yoğunlaşma riski getirir.
2.6. Doğal Seçim
Uygunluk değerleri hesaplandıktan sonra popülasyon sıralanır; en iyi Npop birey tutulur, geri kalanı atılır. Yaygın seçenek popülasyonun yarısını tutmaktır. Tutulan bireylerin bir bölümü eşleştirme havuzunu oluşturur.
Seçim yöntemleri Ünite 4'te ayrıntılandırılmıştır. İkili kodlu temel algoritmada en sık kullanılanlar rastgele eşleştirme, sıra ağırlıklı seçim, değer ağırlıklı seçim, eşik değer seçimi, rulet tekerleği ve turnuva seçimidir.
Sıra ağırlıklı seçimde olasılık yalnız sıralamaya bağlıdır:
P(n) = (Niyi - n + 1) / Σ(k = 1..Niyi) kDeğer ağırlıklı seçimde uygunluk değerlerinin kendisi kullanılır; havuz dışındaki ilk kromozomun değeri referans alınarak normalize edilir:
C(n) = f(kromozom(n)) - f(kromozom(Niyi+1))
P(n) = |C(n) / Σ C(p)|
Kromozomların seçilmesinde kümülatif olasılıklar kullanılır: [0,1] aralığında bir sayı üretilir ve kümülatif olasılığın bu sayıyı ilk aştığı kromozom seçilir. Bir kromozomun kendisiyle eşleşmesi engellenmez; bu durum o bireyin bir sonraki nesilde daha güçlü temsil edilmesi anlamına gelir.
2.7. Çaprazlama
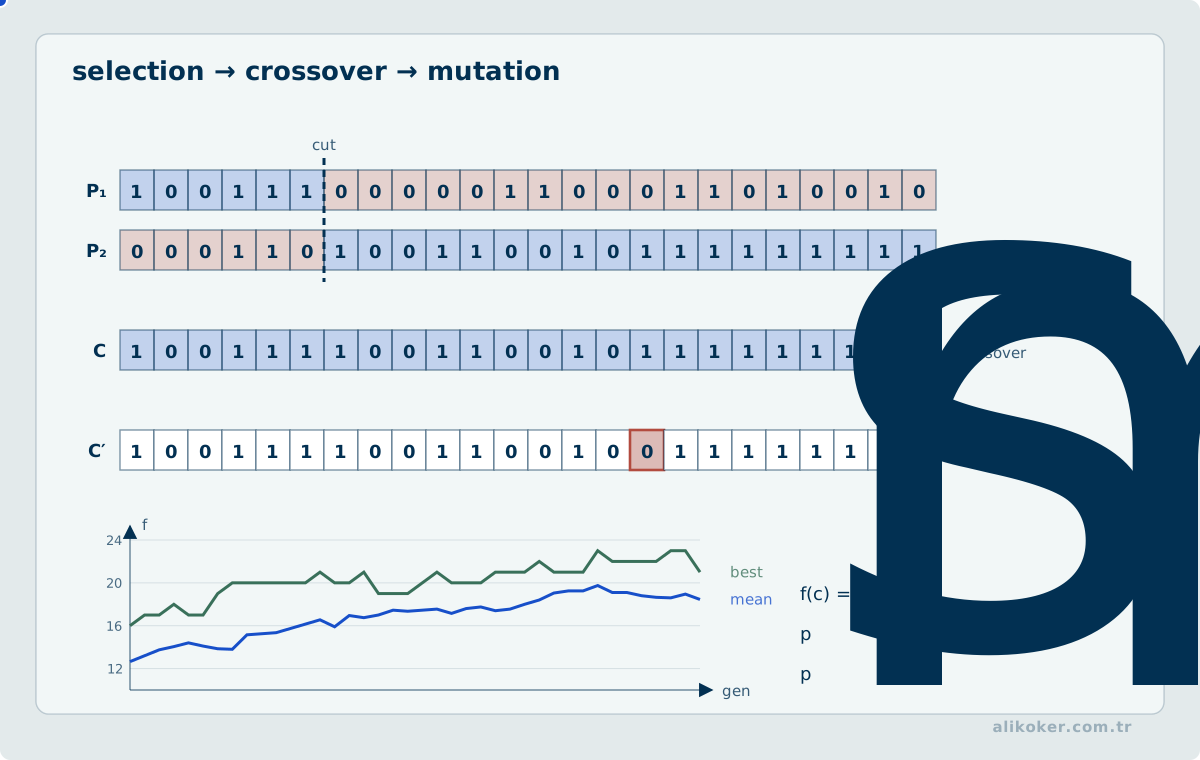
Tek noktalı çaprazlamada kromozomun ilk ve son biti arasında rastgele bir kesme noktası seçilir; iki ebeveynin kesme noktasının bir yanındaki bitleri karşılıklı değiştirilir:
Ebeveyn1 = 00100110011 | 101        Yavru1 = 01010110000101
Ebeveyn2 = 01010110000 | 100        Yavru2 = 00100110011100
Çaprazlama oranı Pc, popülasyonun ne kadarının bu işleme gireceğini belirler; 0.6 ile 0.9 arasındaki değerler yaygın başlangıç noktalarıdır ve evrensel bir optimum değildir. Çaprazlanmayan çiftler yavrulara aynen kopyalanır.
Çok noktalı ve tek biçimli (uniform) çaprazlama, kesme noktası sayısını artırarak ya da her biti bağımsız olarak seçerek bilgi karışımını yoğunlaştırır. Yoğun karışım bit düzeyinde çeşitliliği korur, buna karşılık kromozom üzerinde birbirine yakın konumlanmış işbirlikçi bit gruplarını daha sık bozar.
2.8. Mutasyon
Mutasyon, popülasyon matrisindeki bitlerin küçük bir yüzdesini terslemektir. Mutasyona uğrayacak bit sayısı Pm · Npop · Nbit ile hesaplanır ve satır-sütun konumları rastgele üretilir.
00010110000010 -> 00010110001010İkili kodlu algoritmada yüzde 1 ile yüzde 5 arasındaki oranlar iyi sonuç veren aralık olarak bildirilmiştir; bit başına düşünüldüğünde 1/l mertebesi de yaygın bir başlangıç seçimidir. Oran arttıkça algoritma daha geniş bir uzayı tarar ve rastgele aramaya yaklaşır, azaldıkça erken yakınsama riski büyür.
Mutasyonun işlevi yeni çözüm üretmek değil, seçim ve çaprazlamanın popülasyondan tümüyle sildiği allelleri geri getirebilmektir. Tüm bireyler bir konumda aynı değere sahipse çaprazlama o konumu asla değiştiremez; yalnız mutasyon değiştirebilir.
En iyi bireyin mutasyondan muaf tutulması ve son iterasyonda mutasyon uygulanmaması, elde edilen en iyi çözümün bozulmasını önler.
2.9. Gelecek Nesil ve Yakınsama
Çaprazlama ve mutasyon sonrası uygunluk değerleri yeniden hesaplanır, popülasyon sıralanır ve döngü tekrarlanır. Popülasyon ortalaması nesiller boyunca iyileşir; ortalama uygunluk, algoritmanın yakınsama davranışı hakkında en iyi bireyden daha bilgilendirici bir ölçüttür.
Durma ölçütleri: sabit iterasyon sayısı, hedef uygunluk değerine ulaşma, belirli sayıda nesil boyunca en iyi değerin değişmemesi, popülasyon standart sapmasının eşik altına düşmesi, ayrılan hesaplama bütçesinin dolması.
Bütün kromozomların uygunluk değerleri birbirine eşitlenmişse popülasyon çeşitliliğini yitirmiştir; bu noktadan sonra çaprazlama yeni bilgi üretemez ve algoritmayı sürdürmenin faydası yoktur.
Ünite 3: Gerçek Kodlu Genetik Algoritma
Gerçek kodlu optimizasyonda karar değişkenlerinin alt ve üst sınırları baştan belirlenir. Çaprazlama veya mutasyon bu aralıkların dışına çıktı üretiyorsa onarım, yeniden örnekleme veya ceza yaklaşımından hangisinin kullanılacağı kararlaştırılır. Amaç fonksiyonu gürültülü ise tek değerlendirmeyle bireyleri sıralamak yanıltıcı olabilir; tekrarlı değerlendirme gerekebilir. Çözümün kalitesi bir kuşağın en iyi değeriyle değil, tekrarlı çalışmalardaki dağılım ve kısıtların karşılanmasıyla incelenir.
3.1. İkili Kodlamanın Hassasiyet Sınırı
Sürekli parametreli problemde ikili kodlamanın çözünürlüğü gene ayrılan bit sayısıyla sınırlıdır. Hassasiyeti artırmak kromozom uzunluğunu ve dolayısıyla arama uzayını büyütür. Ayrıca her uygunluk değerlendirmesinden önce kod çözme maliyeti ödenir.
Gerçek kodlu genetik algoritmada parametreler doğrudan ondalık sayı olarak saklanır. Kod çözme adımı ortadan kalkar, bellek kullanımı azalır ve hassasiyet kayan nokta gösteriminin sınırına kadar çıkar. Karşılaştırmalı çalışmalar, sürekli parametreli problemlerde gerçek kodlu sürümün global optimuma daha kısa sürede ulaştığını göstermiştir.
Bu üstünlük problem sınıfına bağlıdır. Doğal olarak ayrık, sıralı veya sembolik problemlerde ikili ya da permütasyon temelli gösterim daha uygundur.
3.2. Başlangıç Popülasyonu
IPOP = (P(H) - P(L)) · rastgele{Nipop, Npar} + P(L)P(H) üst sınır, P(L) alt sınırdır. Üretilen matris Nipop × Npar boyutundadır ve her satır doğrudan bir parametre vektörüdür.
3.3. Gerçek Kodlu Çaprazlama Yöntemleri
Tek düzen (uniform) metot: Ebeveynlerin karşılıklı parametreleri yer değiştirir. Parametre değerleri değişmez, yalnız kromozom içindeki dağılımları değişir. İkili kodlamada iyi çalışan bu yaklaşım gerçek kodlamada zayıftır, çünkü var olan değerlerin dışına çıkarak yeni değer üretemez.
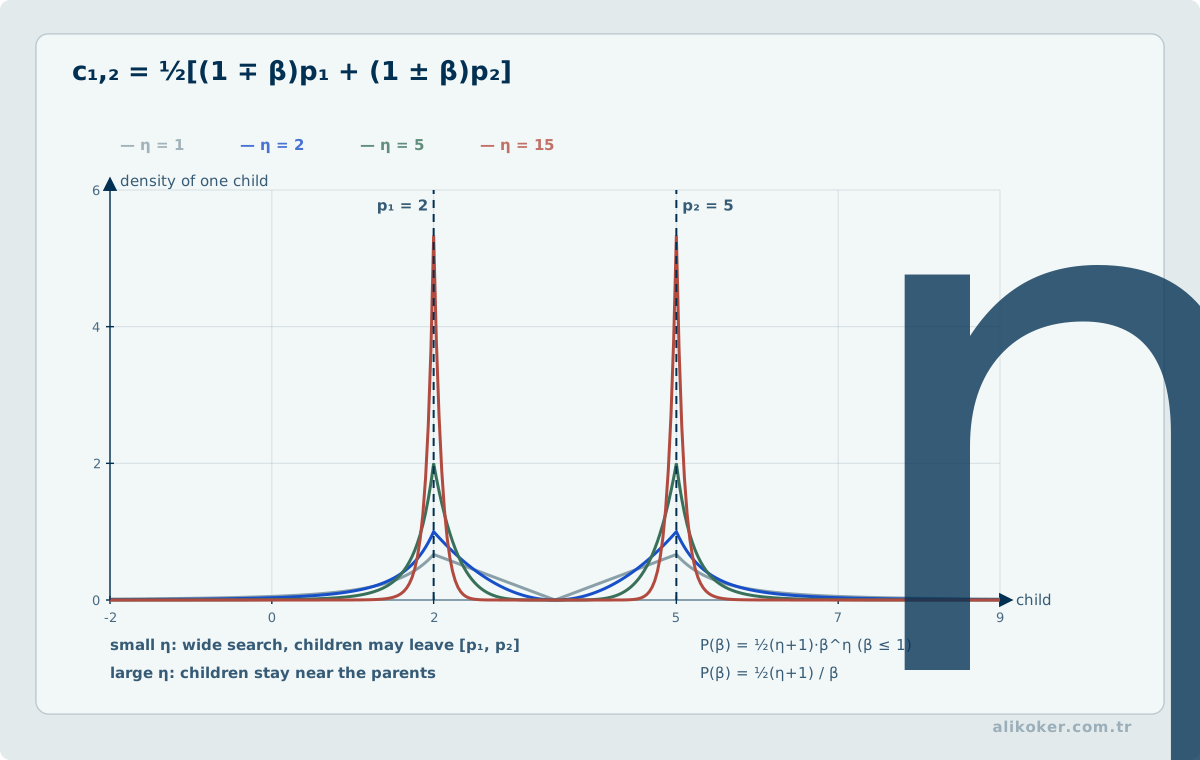
Karıştırma (blend): İki parametrenin doğrusal birleşimi alınır.
P(yeni) = β · P(an) + (1 - β) · P(bn)β rastgele [0,1] sayısıdır. İkinci yavru β yerine 1 - β kullanılarak elde edilir. β = 0 veya β = 1 durumunda bir ebeveyn baskın gelir, β = 0.5 durumunda sonuç iki değerin ortalamasıdır. Yalnız ortalama alan bir operatör popülasyonu hızla merkeze doğru büzer ve çeşitliliği tüketir.
Doğrusal çaprazlama: İki ebeveynden üç aday üretilir, sınır dışındakiler atılır, kalanların en iyi ikisi alınır.
P(yeni1) =  0.5·P(an) + 0.5·P(bn)
P(yeni2) =  1.5·P(an) - 0.5·P(bn)
P(yeni3) = -0.5·P(an) + 1.5·P(bn)
İkinci ve üçüncü ifadeler ekstrapolasyondur; ebeveynlerin dışına çıkarak arama aralığını genişletir.
Sezgisel (heuristic) çaprazlama: Yavru, daha iyi ebeveynden kötü ebeveynin ters yönüne doğru üretilir.
P(yeni) = β · (P(an) - P(bn)) + P(an)Sınır dışında kalan yavru atılır ve yeni bir β ile işlem tekrarlanır.
Karma çaprazlama (BLX-α): Yavru, ebeveyn değerlerinin belirlediği aralığın α oranında genişletilmiş halinden düzgün dağılımla seçilir. d = |P(an) - P(bn)| olmak üzere örnekleme aralığı [min - α·d, max + α·d] olur. α parametresi keşif ile sömürü arasındaki dengeyi doğrudan ayarlar.
Karma yaklaşım: Uygulamada en yaygın olanı, önce rastgele bir çaprazlama noktası seçip o konumdaki parametreleri karıştırma formülüyle üretmek, kalan parametreleri ise ebeveynler arasında değiştirmektir.
α = roundup{rastgele · Npar}
P(yeni1) = P(aα) - β·[P(aα) - P(bα)]
P(yeni2) = P(bα) + β·[P(aα) - P(bα)]
Bu biçimde β ≤ 1 olduğu sürece sınır dışına çıkan parametre üretilmez; hem konum değişimi hem değer karışımı aynı operatörde birleşir.
3.4. Gerçek Kodlu Mutasyon
Mutasyona girecek parametre sayısı Pm · Npop · Npar ile bulunur; seçilen parametre silinir ve tanım aralığında yeni bir rastgele değerle değiştirilir (tek düzen mutasyon). Gerçek kodlu algoritmada mutasyon oranı ikili koda göre daha yüksek tutulur, çünkü tek bir parametrenin değişmesi tek bir bitin değişmesinden daha seyrek bir olaydır.
Alternatif olarak parametreye normal dağılımlı küçük bir sapma eklenir (Gauss mutasyonu). Sapmanın standart sapması nesil ilerledikçe azaltılırsa algoritma önce geniş tarama, sonra ince ayar yapar; bu davranış evrim stratejilerindeki kendi kendini uyarlayan adım büyüklüğünün basitleştirilmiş halidir.
Ünite 4: Seçim Yöntemleri ve Seçim Baskısı
Bu ünite, seçim baskısının çeşitlilik, yakınsama hızı ve erken yakınsama riski arasındaki dengeyi nasıl değiştirdiğini ele alır.
düşük seçim baskısı              yüksek seçim baskısı
       |                                |
       v                                v
çeşitlilik korunur                hızlı yakınsama
arama yavaşlayabilir              çeşitlilik kaybı
                                  erken yakınsama riski
4.1. Seçim Baskısı Kavramı
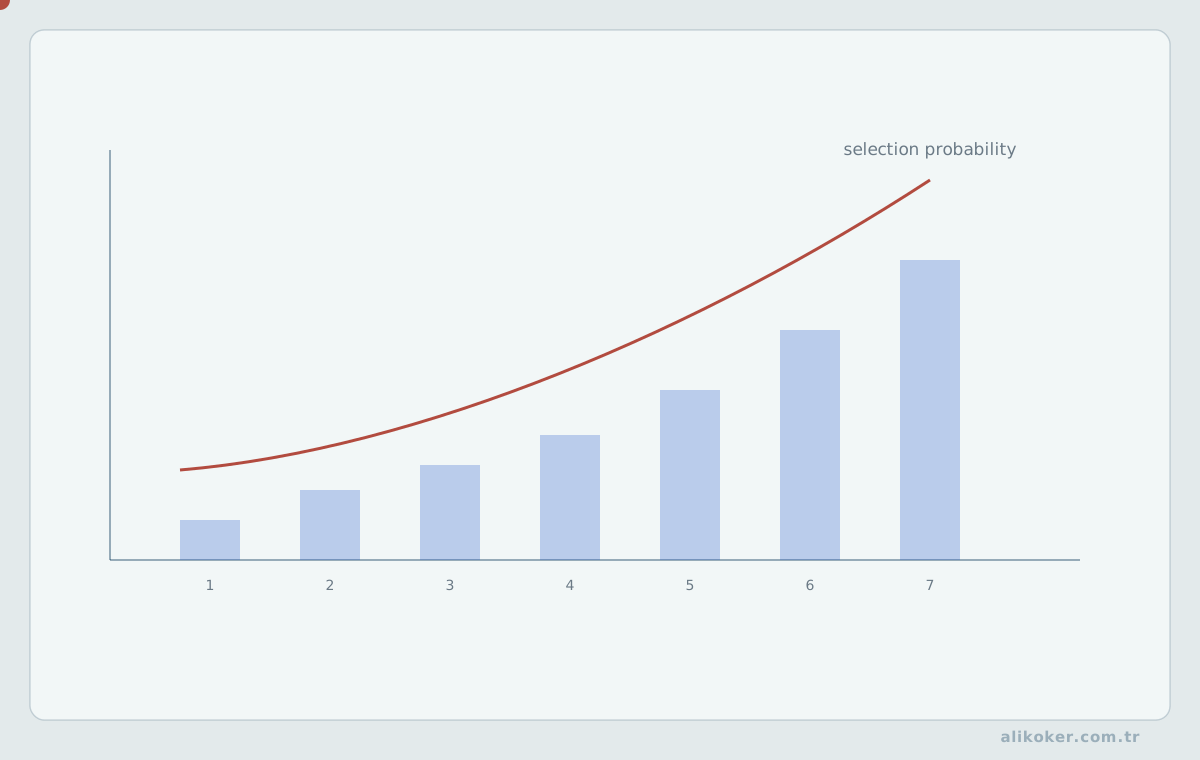
Seçim baskısı, iyi bireylerin popülasyonda ne hızla yayıldığını ölçer. Yüksek baskı hızlı yakınsama sağlar fakat çeşitliliği erken tüketir ve algoritmayı yerel optimumda kilitler. Düşük baskı çeşitliliği korur fakat aramayı rastgele aramaya yaklaştırır. Seçim yönteminin tasarımı bu iki uç arasındaki ayarı yapar.
4.2. Uygunlukla Orantılı Seçim ve Rulet Tekerleği
Bireyin beklenen kopya sayısı f(i)/f̄ oranındadır. Rulet tekerleğinde tekerlek üzerinde her bireye uygunluğuyla orantılı bir dilim ayrılır ve popülasyon büyüklüğü kadar döndürme yapılır.
İki zayıflığı vardır. Başlangıçta uygunluğu çok yüksek tek bir birey popülasyonu hızla ele geçirir (erken yakınsama). Nesiller ilerleyip uygunluk değerleri birbirine yaklaştığında ise seçim baskısı kaybolur ve arama duraklar. Ayrıca tek tek döndürme, beklenen kopya sayılarından ciddi sapmalar üreten yüksek örnekleme gürültüsü taşır.
Rastgele tek biçimli örnekleme (SUS) aynı tekerleği tek seferde N eşit aralıklı gösterge ile okur. Beklenen değerler korunur, örnekleme varyansı ortadan kalkar. Seçim baskısını değiştirmez, yalnız gürültüyü giderir.
4.3. Ölçekleme Yöntemleri
Sigma ölçekleme beklenen kopya sayısını popülasyonun standart sapmasına göre normalize eder:
ExpVal(i) = 1 + (f(i) - f̄) / (2σ),   σ ≠ 0
ExpVal(i) = 1,                        σ = 0
Böylece seçim baskısı, uygunlukların mutlak büyüklüğünden değil dağılımından türetilir; arama boyunca yaklaşık sabit kalır.
Boltzmann seçimi beklenen değeri e^(f(i)/T) ile orantılı alır ve sıcaklık T'yi nesiller boyunca düşürür. Yüksek sıcaklıkta seçim neredeyse tekdüzedir, sıcaklık düştükçe baskı artar. Tavlama benzetimindeki soğutma çizelgesiyle aynı mantığı taşır ve keşiften sömürüye geçişi denetimli hale getirir.
4.4. Sıralama Tabanlı Seçim
Bireyler uygunluğa göre sıralanır ve seçim olasılığı yalnız sıradan hesaplanır. Uygunluk değerlerinin ölçeği ve dağılımı sonucu etkilemez; bir bireyin diğerinden yüz kat iyi olması, sıralamada yalnız bir basamak önde olması anlamına gelir.
Sıralama, ölçekleme gerektirmeden erken yakınsamayı engeller. Bedeli, gerçekten üstün bir çözümün bu üstünlüğünün seçim aşamasında görünmez olmasıdır.
4.5. Turnuva Seçimi
Popülasyondan k birey rastgele çekilir ve en iyisi seçilir. Her ebeveyn için ayrı bir turnuva yapılır. k arttıkça seçim baskısı artar; k = 2 en yaygın kullanımdır.
Turnuva seçiminin işletim üstünlüğü, popülasyonun sıralanmasını ve toplam uygunluğun hesaplanmasını gerektirmemesidir. Karşılaştırma yerel olduğu için paralel ve dağıtık gerçeklemelerde küresel bir azaltma (reduction) adımına ihtiyaç duymaz; bu özellik büyük popülasyonlarda ölçeklenebilirliği doğrudan etkiler.
Kısıtlı problemlerde turnuva, uygunluk yerine uygunluk-ihlal ikilisi üzerinden de yürütülebilir (bkz. Ünite 7).
4.6. Kararlı Durum Seçimi ve Seçkinlik
Kararlı durum (steady-state) seçiminde nesil bir bütün olarak değiştirilmez; her adımda birkaç birey üretilir ve popülasyonun en kötü birkaç bireyiyle yer değiştirir. Nesil boşluğu küçüldükçe iyi bireyler daha uzun yaşar, seçim baskısı ve yakınsama hızı artar.
Seçkinlik (elitism) en iyi bir veya birkaç bireyin operatörlere uğratılmadan doğrudan sonraki nesle aktarılmasıdır. En iyi çözümün kaybolmamasını garanti eder ve pratikte yakınsamayı belirgin biçimde hızlandırır. Aşırı kullanıldığında popülasyonu tek bir bireyin kopyalarına dönüştürür.
Ünite 5: Kodlama Seçimi ve Uyarlanabilir Kodlama
5.1. Kodlama Türleri
İkili kodlama: Klasik ve teorik olarak en çok incelenmiş biçimdir. Sabit uzunluklu ve sabit alfabeli olması şema analizi ve operatör tasarımını basitleştirir. Sürekli parametrelerde çözünürlük sınırı ve Hamming uçurumu getirir.
Çok karakterli ve gerçek değerli kodlama: Parametre doğal biçiminde saklanır. Sürekli optimizasyonda hem daha doğal hem daha hassastır.
Ağaç kodlama: Kromozom değişken boyutlu bir ağaçtır; genetik programlamanın temelidir. Arama uzayı ilkesel olarak sınırsızdır, bu yüzden hiyerarşik ve açık uçlu çözümler üretebilir. Yan etkisi, ağaçların nesiller boyunca işlevsel katkı sağlamadan büyümesidir (bloat); derinlik veya düğüm sayısı sınırı ya da boyut cezası ile denetlenir.
Permütasyon kodlama: Sıralama problemlerinde kromozom bir permütasyondur; standart operatörler geçersiz çözüm ürettiği için özel operatör gerekir (Ünite 8).
5.2. Kodlamanın Uyarlanması
Kromozom üzerinde birlikte çalışan genler birbirinden uzaktaysa çaprazlama onları sık ayırır. Bu, kodlamanın kendisinin de bir tasarım değişkeni olduğu anlamına gelir.
İnversiyon kromozomun bir bölümünü ters çevirerek gen konumlarını yeniden düzenler. Gen kimliğinin korunması için her gen (konum, değer) çifti olarak saklanır. Amaç, işbirlikçi genleri birbirine yaklaştırıp tanımlayıcı uzunluğu küçültmektir.
Çaprazlama sıcak noktaları, çaprazlama olasılığının kromozom boyunca değişken olması ve bu dağılımın kendisinin evrimleşmesidir.
Düzensiz genetik algoritma (messy GA) değişken uzunluklu kromozom kullanır; gen listesi eksik veya fazla belirtilmiş olabilir. Eksik belirtim şablon bir birey üzerinden tamamlanır, fazla belirtimde soldan ilk değer kullanılır. Kesme ve birleştirme (cut and splice) operatörleri sabit uzunluk kısıtını kaldırır. Algoritma önce kısa yapı taşlarını biriktirir, sonra bunları birleştirerek tam çözümler kurar.
Bu yaklaşımların ortak bedeli, arama uzayına yeni bir boyut eklemeleridir: hem çözüm hem de çözümün gösterimi aynı anda aranır ve yakınsama yavaşlar.
Ünite 6: Parametreler, Karmaşıklık ve Yakınsama Davranışı
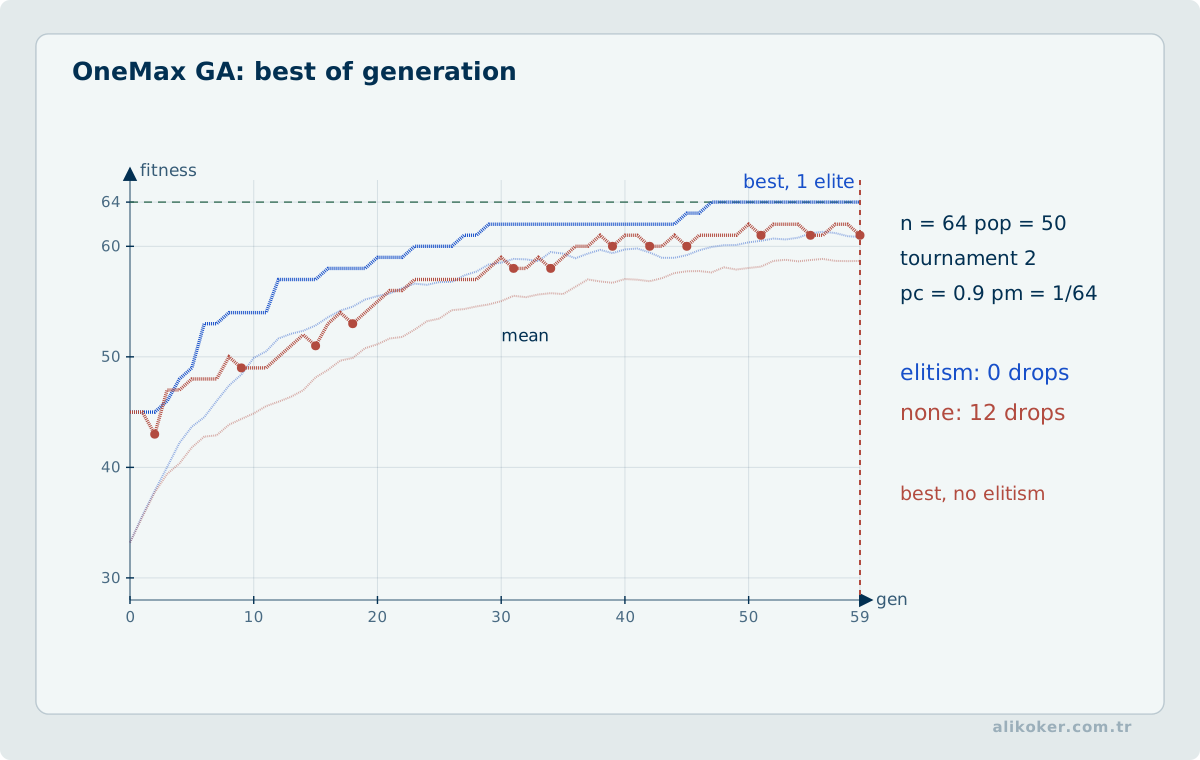
Bu ünite, mutasyon, seçim ve elitizm parametrelerinin keşif-sömürü dengesi ile yakınsama davranışını nasıl belirlediğini ele alır.
keşif <------------------------------> sömürü
çeşitlilik                             iyi bireyleri koruma
mutasyon                               seçim / elitizm

amaç: tek uca kilitlenmeden dengeli arama
6.1. Parametrelerin Etkileşimi
Popülasyon büyüklüğü, çaprazlama oranı ve mutasyon oranı bağımsız değildir. Küçük popülasyon yüksek mutasyon oranıyla, büyük popülasyon düşük mutasyon oranıyla dengelenir. Literatürde yaygın olarak bildirilen Pc ≈ 0.7, Pm ≈ 0.001 ve birkaç yüz büyüklüğünde popülasyon değerleri başlangıç noktasıdır; her problem için ayrıca ayarlanmaları gerekir.
Parametrelerin nesiller boyunca sabit tutulması zorunlu değildir. Uyarlanabilir yaklaşımlarda mutasyon oranı popülasyon çeşitliliği düştükçe artırılır; kendi kendini uyarlayan yaklaşımlarda operatör parametreleri kromozomun parçası haline getirilir ve aynı seçim baskısı altında evrimleşir.
6.2. Hesaplama Maliyeti
Bir neslin maliyeti:
T(nesil) = N · C(f) + O(N · l)N popülasyon büyüklüğü, C(f) tek bir uygunluk değerlendirmesinin maliyeti, l kromozom uzunluğudur. Gerçek problemlerde C(f) bir benzetim, sonlu eleman çözümü veya deneysel ölçüm olduğundan diğer tüm terimlerden mertebelerce büyüktür. Bu nedenle optimizasyon çabası operatörlerin mikro-iyileştirilmesine değil, değerlendirme sayısının azaltılmasına yönelir: tekrar eden kromozomların önbelleklenmesi, vekil (surrogate) model kullanımı ve umutsuz adayların erken elenmesi.
Uygunluk değerlendirmeleri birbirinden bağımsız olduğu için nesil içi paralelleştirme doğaldır. Üç yaygın mimari vardır: ana-uydu (master-slave) modelde yalnız değerlendirme dağıtılır ve algoritmanın davranışı seri sürümle aynı kalır; ada (island) modelde her düğüm kendi popülasyonunu evrimleştirir ve belirli aralıklarla göç yapar; hücresel modelde bireyler bir ızgaraya yerleştirilir ve yalnız komşularıyla eşleşir. Ada ve hücresel modeller çeşitliliği koruma davranışını değiştirdiği için seri sürümün aynısı değildir.
Tekrarlanabilirlik gereken ortamlarda rastgele sayı üretecinin tohumu, üreteç durumunun iş parçacıkları arasında paylaşım biçimi ve kayan nokta toplamalarının sırası sabitlenmelidir; aksi halde aynı girdi aynı sonucu vermez.
6.3. Erken Yakınsama
Erken yakınsama, popülasyonun global optimuma ulaşmadan çeşitliliğini yitirmesidir. Belirtisi, ortalama uygunluğun en iyi uygunluğa yaklaşması ve popülasyon standart sapmasının sıfıra inmesidir.
Karşı önlemler: seçim baskısını düşürmek (sıralama, sigma ölçekleme, düşük k ile turnuva), mutasyon oranını artırmak, popülasyonu büyütmek, aynı kromozomun kopyalarını sınırlamak, nişleme (niching) ve uygunluk paylaşımı ile birbirine benzeyen bireylerin uygunluğunu azaltmak, ada modeliyle alt popülasyonları ayrı tutmak.
Ters uçta duraklama (stagnation) vardır: seçim baskısı çok düşük olduğunda popülasyon çeşitli kalır fakat iyi çözümler yayılmaz. Parametre ayarı bu iki başarısızlık biçimi arasındaki aralığı bulmaktır.
Ünite 7: Kısıtlı Problemler ve Ceza Fonksiyonları
7.1. Kısıt İşleme
Kısıtlı optimizasyonda arama uzayının bir bölümü uygun olmayan (infeasible) bölgedir. Genetik operatörler kısıtları kendiliğinden korumadığından, üretilen bireylerin önemli bir kısmı geçersiz olabilir.
Dört temel yaklaşım vardır: geçersiz bireyi doğrudan atmak (ölüm cezası), onarım işlemiyle uygun bölgeye taşımak, kısıtları sağlayan özel gösterim ve operatör tasarlamak, ceza fonksiyonu ile amaç fonksiyonunu değiştirmek.
Ölüm cezası, uygun bölge çok küçükse neredeyse hiç birey üretemeyeceği için kullanışsızdır. Uygun bölgenin sınırındaki çözümler çoğu problemde optimuma yakın olduğundan, geçersiz bireylerin taşıdığı bilgiyi tümüyle atmak arama açısından da verimsizdir.
7.2. Ceza Fonksiyonu
Kısıtlar g(k)(x) ≥ 0 biçiminde yazılırsa ihlal miktarı amaç fonksiyonuna eklenir:
φ(x, r) = f(x) + Σ(k = 1..K) r(k) · G(k)( g(k)(x) )
G(k)(g) = max(0, -g)^2
r(k) ceza katsayısıdır. İhlalin karesi kullanıldığında küçük ihlaller hafif, büyük ihlaller ağır cezalandırılır ve fonksiyon türevlenebilir kalır.
Ceza katsayısının seçimi kritiktir. Çok küçük katsayı geçersiz bölgeyi cazip hale getirir ve algoritma uygun olmayan bir noktada yakınsar; çok büyük katsayı sınır bölgesini keskin bir duvara çevirir, arama uygun bölgenin içine hapsolur ve sınırdaki optimumu bulamaz. Katsayının nesillere bağlı artırılması (dinamik ceza) başlangıçta serbest arama, sonunda kısıt uyumu sağlar.
Katsayı ayarını tümüyle ortadan kaldıran bir alternatif, ikili karşılaştırmayı doğrudan uygunluk ve ihlar bilgisi üzerinden yapmaktır: iki uygun birey arasında amaç fonksiyonu iyi olan, uygun ile geçersiz arasında uygun olan, iki geçersiz birey arasında toplam ihlali küçük olan seçilir. Turnuva seçimi bu kuralı doğal olarak uygular ve ölçek farklarından etkilenmez.
7.3. Turnuva Seçimiyle Kısıt İşleme
Uygulamada seçim şu üç kurala indirgenir:
- Her iki birey de geçersizse, ceza değeri küçük olan seçilir; uygunluk hesaplanmaz.
- Yalnız biri uygunsa, uygun olan seçilir; diğerinin uygunluğu hesaplanmaz.
- Her ikisi de uygunsa, amaç fonksiyonu değerlerine bakılır.
Bu sıralama gereksiz uygunluk değerlendirmesini de önler; pahalı amaç fonksiyonlarında kayda değer bir kazançtır.
Ceza fonksiyonunun uygunluk üzerindeki sınırı. 0 ≤ x ≤ 8 aralığında f(x) = 12x − x² fonksiyonu x ≤ 5 koşuluyla en büyük yapılmak istensin. Kısıt olmadan tepe noktası x = 6 olur; bu çözüm uygulanabilir değildir. Kısıtlı optimum x = 5 ve f(5) = 35 değerindedir. Karesel ceza ile F(x) = 12x − x² − ρ·max(0,x−5)² tanımlanırsa ρ = 1 seçimi altında uygulanamaz bölgede F'(x) = 12 − 2x − 2(x−5) = 22 − 4x ve durağan nokta x = 5,5 bulunur. Ceza terimi çözümü kısıta yaklaştırmış fakat ihlali tamamen kaldırmamıştır. Sonlu bir karesel ceza katsayısı genellikle kesin uygunluk garantisi vermez; büyük ceza katsayıları da arama yüzeyini kötü koşullu hale getirebilir. Bu nedenle nihai adayın uygunluğu ayrıca sınanmalı, gerekirse onarım veya uygunluğu önceleyen seçim kuralı uygulanmalıdır.
7.4. Uygunluk Onarımı ile Ceza Fonksiyonunu Ayırmak
Kısıtlı optimizasyonda amaç fonksiyonu \(f(x)\) ile yapılabilir bölge \(\mathcal F=\{x:g_j(x)\leq0\}\) ayrı nesnelerdir. Ceza yaklaşımı, kısıt ihlalini sayısallaştırarak adayın sıralamasını değiştirir; onarma operatörü ise adayı \(R(x)\in\mathcal F\) olacak şekilde dönüştürmeye çalışır. Bu iki yaklaşımın arama uzayı üzerindeki etkileri aynı değildir. Sabit büyük ceza çözüm kalitesini bastırabilir; düşük ceza ise geçersiz bireylerin popülasyonu ele geçirmesine izin verebilir.
Örneğin toplam ağırlığı \(W\) sınırını aşmaması gereken bir seçim vektöründe, ceza \(\lambda\max(0,\sum_i w_i x_i-W)\) olarak kurulabilir. Onarma yöntemi ise sınır sağlanana kadar öğe çıkarır. Ancak hangi öğenin çıkarılacağı aramayı belirli çözümlere yönlendirir; onarma tarafsız bir işlem değildir. Uygun adaylar arasında elitizm ve çeşitlilik korunurken, onarma sonrasında kopya birey sayısı ayrıca izlenmelidir.
Deney raporunda yalnız nihai amaç değeri değil, kısıtları karşılayan aday oranı, amaç fonksiyonu değerlendirme sayısı, onarma maliyeti ve çeşitli bağımsız koşuların dağılımı birlikte verilir. Yapılabilirliği garanti eden kodlama mümkünse ceza ve onarım maliyetini azaltabilir; fakat temsil seçimi de çaprazlama ve mutasyonun erişebildiği komşuluğu değiştirir.
Ünite 8: Kombinatoryal Problemler ve Permütasyon Temsili
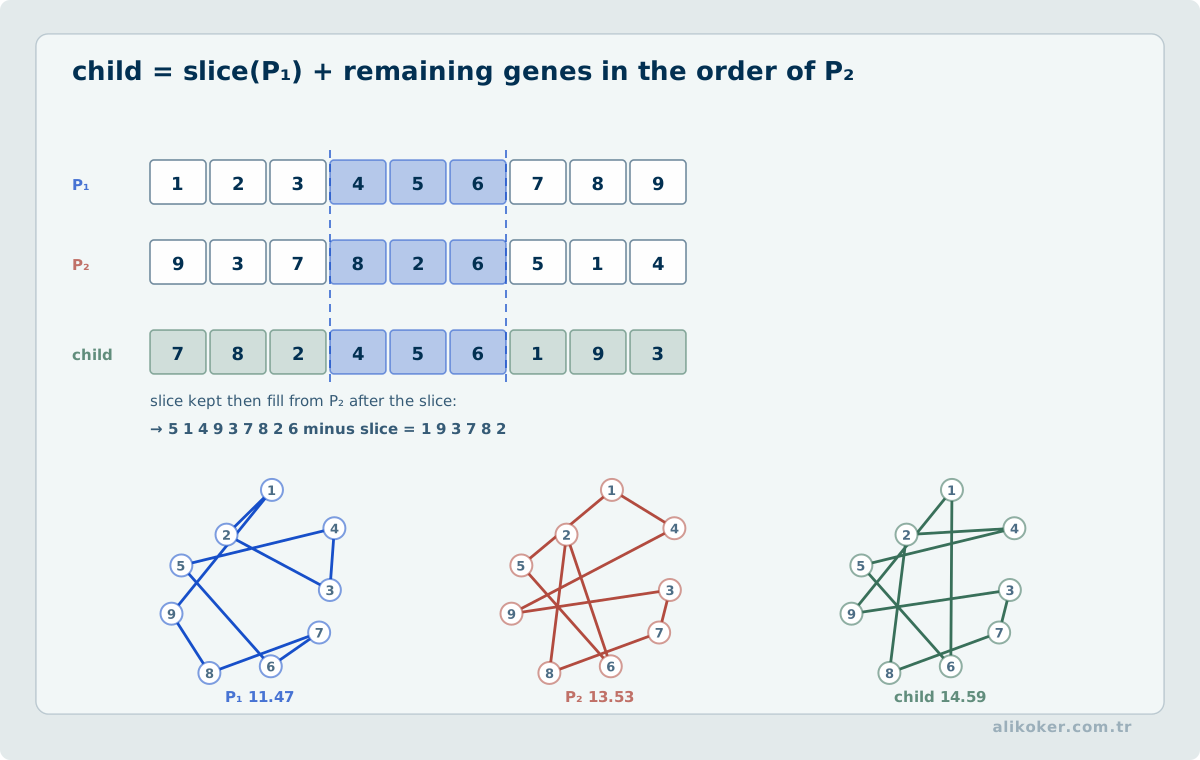
8.1. Gezgin Satıcı Problemi
Şehirler 0 ile n-1 arasında numaralandırılır ve kromozom bir ziyaret sırasıdır. Uygunluk, turun toplam uzunluğudur:
Kromozom: 1 0 2 7 5 4 6 3
Uygunluk: d(1,0) + d(0,2) + d(2,7) + d(7,5) + d(5,4) + d(4,6) + d(6,3)
Kapalı tur isteniyorsa son şehirden ilk şehre dönüş mesafesi de eklenir.
8.2. Standart Operatörlerin Başarısızlığı
Tek noktalı çaprazlama permütasyon üzerinde geçersiz çözüm üretir:
Ebeveyn1 = 24170 | 536        Yavru1 = 24170720
Ebeveyn2 = 41653 | 720        Yavru2 = 41653536
Birinci yavruda 0, 2 ve 7 şehirleri iki kez, 3, 5 ve 6 şehirleri hiç yer almaz. Her şehre tam bir kez uğrama kısıtı ihlal edilmiştir.
En basit çözüm onarımdır: tekrar eden ilk şehir, ziyaret edilmemiş en küçük numaralı şehirle değiştirilir. Kural geçerli bir tur üretir fakat keyfidir; ebeveynlerden gelen sıralama bilgisini rastgele bozar ve çaprazlamanın yapıcı etkisini büyük ölçüde yok eder.
8.3. Permütasyona Özgü Çaprazlama
Gezgin satıcı probleminde asıl bilgi mutlak konumlarda değil, komşuluk ve göreli sıra ilişkilerindedir. Operatörler bu bilgiyi korumak üzere tasarlanır:
- Kısmi eşleştirmeli çaprazlama (PMX): İki kesme noktası arasındaki bölüm doğrudan aktarılır, kalan konumlar bu bölümün kurduğu eşleme ilişkisi izlenerek doldurulur.
- Sıra çaprazlaması (OX): Bir bölüm korunur, kalan şehirler diğer ebeveyndeki görülme sırasına göre yerleştirilir. Göreli sırayı korur.
- Çevrim çaprazlaması (CX): Konum çevrimleri belirlenir ve her konum ebeveynlerden birinden mutlak konumu korunarak alınır.
- Kenar birleştirme: Şehirlerin komşuluk listeleri çıkarılır ve tur bu listelerden kurulur. Komşuluk bilgisini doğrudan hedeflediği için gezgin satıcı probleminde genellikle en iyi sonucu verir.
Mutasyon için yer değiştirme (swap), yerleştirme (insertion) ve ters çevirme (inversion) kullanılır. Ters çevirme, bir alt turun yönünü değiştirdiği için 2-opt yerel arama adımının rastgele halidir ve simetrik mesafelerde tur uzunluğunu yalnız iki kenar üzerinden etkiler.
Genetik algoritmayı yerel arama ile birleştiren melez (memetik) yaklaşımlar, kombinatoryal problemlerde saf genetik algoritmadan belirgin biçimde daha iyi turlar üretir; maliyeti, her birey için ek yerel arama hesabıdır.
Ünite 9: Teorik Temeller
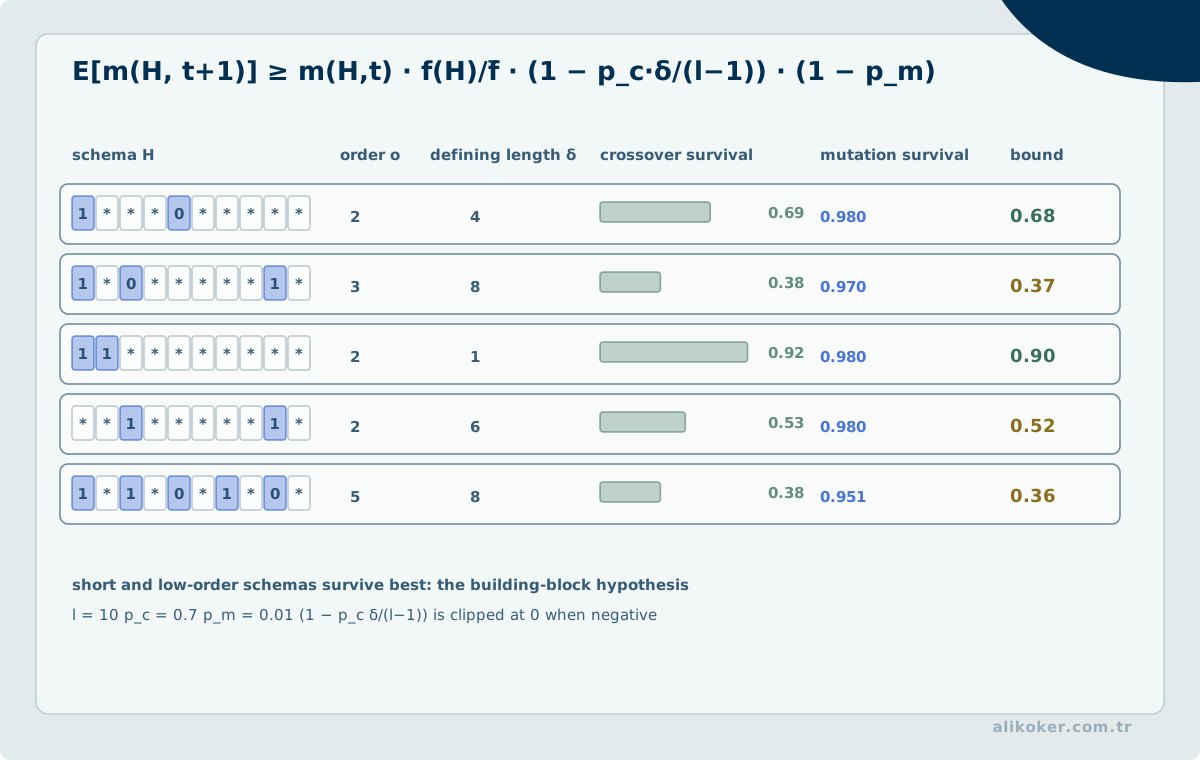
9.1. Şemalar
Şema, {0, 1, *} alfabesi üzerinde yazılmış bir kromozom kalıbıdır; * herhangi bir değeri gösterir. 1**0 şeması, birinci biti 1 ve dördüncü biti 0 olan tüm dizileri temsil eder.
İki niceliği tanımlanır. Derece o(H), sabitlenmiş konum sayısıdır. Tanımlayıcı uzunluk δ(H), ilk ve son sabit konum arasındaki uzaklıktır.
Uzunluğu l olan bir kromozom 2^l şemanın üyesidir. Bu nedenle N bireyli bir popülasyon aslında çok daha fazla sayıda şema hakkında bilgi taşır; Holland bu duruma örtük paralellik adını vermiştir.
9.2. Şema Teoremi
Uygunlukla orantılı seçim, tek noktalı çaprazlama ve bit mutasyonu altında bir şemanın beklenen örnek sayısı:
E[m(H, t+1)] ≥ m(H, t) · (f(H) / f̄) · [ 1 - Pc · δ(H)/(l-1) - o(H) · Pm ]m(H,t) şemanın t neslindeki örnek sayısı, f(H) şema üyelerinin ortalama uygunluğu, f̄ popülasyon ortalamasıdır.
Yorumu şudur: ortalamanın üstünde uygunluğa sahip, kısa tanımlayıcı uzunluklu ve düşük dereceli şemaların örnek sayısı nesiller boyunca üstel olarak artar. Bu şemalar yapı taşı olarak adlandırılır ve yapı taşı hipotezine göre genetik algoritma iyi çözümleri bu parçaları birleştirerek kurar.
Teoremin sınırları kesindir. Eşitsizlik yalnız alt sınır verir ve çaprazlama ile mutasyonun şema üretebilme olasılığını hesaba katmaz. Tek nesillik bir ifadedir; art arda nesiller için tekrarlanan üstel büyüme yorumu, f(H)/f̄ oranının sabit kaldığı varsayımına dayanır ki bu varsayım popülasyon değiştikçe geçerliliğini yitirir. Sonlu popülasyonda örnekleme hatası ihmal edilmiştir.
9.3. İki Kollu Kumar Makinesi ve Aldatıcı Problemler
Holland'ın gerekçelendirmesi, iki kollu kumar makinesi probleminde denemelerin gözlemlenen iyi kola üstel artan oranda ayrılmasının optimale yakın bir strateji olmasına dayanır. Şemaların rakip şema çiftleri olarak ele alınması bu analojiyi kurar.
Aldatıcı (deceptive) problemler bu mantığı tersine çevirmek üzere tasarlanır: düşük dereceli şemaların ortalama uygunlukları optimumdan uzağa işaret eder, böylece yapı taşlarını izleyen bir algoritma sistematik olarak yanlış bölgeye yönlendirilir. Aldatıcılık, genetik algoritmanın zorlandığı problem sınıfını tanımlar; ancak yapay olarak kurulmuş aldatıcı fonksiyonlar gerçek problemlerin zorluğunu tam temsil etmez.
9.4. Royal Road Fonksiyonları ve Tepe Tırmanma Karşılaştırması
Royal Road fonksiyonları, yapı taşı hipotezini sınamak için tasarlanmıştır: kromozom ayrık bloklara bölünür, her tamamlanmış blok uygunluğa sabit katkı yapar. Yapı düşünüldüğünde çaprazlamanın blokları birleştirerek genetik algoritmayı üstün kılması beklenir.
Deney sonucu beklentiyi doğrulamamıştır. Rastgele mutasyonlu tepe tırmanma (RMHC), bu fonksiyonlarda basit genetik algoritmadan hızlı sonuç vermiştir. En dik yükseliş (SAHC) ve sonraki yükseliş (NAHC) varyantları ise her ikisinden de kötü sonuç vermiştir; bloklar arası düz platolarda ilerleyemezler.
Genetik algoritmanın beklenenin altında kalmasının nedeni otostopçuluk (hitchhiking) olarak açıklanmıştır: bir blok popülasyonda hızla yayılırken, aynı kromozom üzerinde ona komşu olan ilgisiz bit değerleri de birlikte sabitlenir. Bu konumlardaki çeşitlilik kaybolduğu için diğer blokların keşfi engellenir.
Bu sonuç, çaprazlamanın yapı taşlarını birleştirme yeteneğinin ancak popülasyon çeşitliliği korunduğunda gerçekleştiğini gösterir. İdealleştirilmiş genetik algoritma analizleri, farklı blokların birbirinden bağımsız örneklenmesi sağlandığında beklenen üstünlüğün ortaya çıktığını doğrular.
9.5. Kesin Matematiksel Modeller
Basit genetik algoritma, popülasyon dağılımları uzayında bir Markov zinciri olarak biçimlendirilebilir. Sonsuz popülasyon varsayımı altında seçim, çaprazlama ve mutasyonun birleşik etkisi tek bir operatörle ifade edilir ve sabit noktaları incelenir. Sonlu popülasyon modelinde her popülasyon durumu bir zincir durumu olur; geçiş olasılıkları tam olarak yazılabilir fakat durum sayısı popülasyon büyüklüğü ve kromozom uzunluğuyla birlikte kombinatoryal büyüdüğü için model yalnız küçük örneklerde sayısal olarak çözülebilir.
İstatistiksel mekanik yaklaşımı ise tek tek bireyleri değil, popülasyon uygunluk dağılımının ortalama ve varyans gibi makroskopik büyüklüklerinin nesiller boyunca nasıl değiştiğini modeller. Ayrıntıyı bırakıp toplu davranışı öngörmesi, gerçek boyutlu problemlerde uygulanabilir olmasını sağlar.
9.6. Bedava Öğle Yemeği Yok
Tüm olası amaç fonksiyonları üzerinde ortalama alındığında, hiçbir arama algoritması bir diğerinden üstün değildir. Genetik algoritmanın belirli bir problem sınıfındaki başarısı, algoritmanın operatörlerinin o sınıfın yapısıyla uyumlu olmasından gelir; genel amaçlı ve her koşulda üstün bir optimizasyon algoritması yoktur.
Pratik sonucu, kodlama ve operatör tasarımının parametre ayarından daha belirleyici olduğudur.
Ünite 10: Uygulama Alanları
10.1. Genetik Programlama
Kromozomlar, fonksiyon ve terminal kümelerinden kurulmuş ağaç yapılı programlardır. Çaprazlama, iki ebeveynden rastgele seçilen alt ağaçların değiştirilmesidir; mutasyon bir alt ağacın rastgele üretilmiş yenisiyle değiştirilmesidir. Uygunluk, programın örnek girdi kümesi üzerindeki davranışıyla ölçülür.
Üstünlüğü, çözümün boyutunun önceden belirlenmesinin gerekmemesidir. Bedeli, arama uzayının çok büyük olması, ağaç büyümesinin denetlenmesi zorunluluğu ve her uygunluk değerlendirmesinin bir program yürütmesi anlamına gelmesidir.
10.2. Hücresel Otomat Kuralları
Tek boyutlu ikili hücresel otomatın geçiş kuralı, komşuluk yapılandırmalarının çıkış bitlerinden oluşan bir dizi olarak kodlanır. Çoğunluk sınıflandırma görevinde otomatın, başlangıç durumundaki hangi değerin çoğunlukta olduğuna tüm hücrelerin ortak durumuyla karar vermesi istenir.
Görev, tek tek hücrelerin yalnız yerel komşuluğu görmesi nedeniyle küresel bilgi taşınmasını gerektirir. Evrimleşen kurallar bu bilgiyi hücre desenleri ve desenler arası sınırların hareketiyle taşır; genetik algoritmanın, tasarımcının doğrudan formüle etmediği bir hesaplama stratejisi keşfettiği örneklerden biridir.
10.3. Veri Çözümleme ve Öngörü
Genetik algoritma, dinamik sistemlerin zaman serisi öngörüsünde model yapısının ve girdi değişken kümesinin seçiminde kullanılır. Protein yapısı öngörüsünde, konformasyon uzayında enerji fonksiyonunu minimize eden katlanmanın aranmasına uygulanır. Her iki durumda da arama uzayı ayrık, çok modlu ve türevsizdir.
10.4. Strateji Evrimi
Yinelenen mahkûm ikilemi oyununda strateji, önceki turların sonuçlarına karşılık gelen hamleler dizisi olarak kodlanır. Uygunluk, stratejinin diğer stratejilere karşı topladığı puandır. Bu düzenekte uygunluk sabit bir fonksiyon değil, popülasyonun kendisine bağlıdır (içsel uygunluk); popülasyon değiştikçe uygunluk yüzeyi de değişir ve durağan bir optimum tanımı ortadan kalkar.
Aynı yapı, sıralama ağlarının evrimleştirilmesinde konak-parazit düzeneğiyle kullanılır: bir popülasyon sıralama ağlarını, diğeri bu ağları başarısız kılacak test girdilerini evrimleştirir. Ortak evrim, test kümesinin aramayla birlikte zorlaşmasını sağlar ve arama alt optimum çözümlerde durmaz.
10.5. Çok Amaçlı Sürücü Ayarını Aynı Deney Bütçesiyle Karşılaştırmak
Bir hız denetleyicisinin Kp ve Ki katsayıları genetik algoritmayla seçilecekse tek uygunluk değeri yalnız izleme hatası olmamalıdır. Örneğin J1 = ∫|e(t)|dt izleme kalitesini, J2 = ∫i(t)²dt akım kaynaklı ısıl yük göstergesini, J3 = max(0, aşma - izinli_aşma) ise aşma kısıtı ihlalini temsil edebilir. Bu nicelikler farklı birimlerde olduğundan gerekçesiz ağırlıklarla toplanmaları bir mühendislik tercihinin gizlenmesine yol açar. Kabul edilemez aşma veya akım koşulları, ödünleşilebilir bir tercih değil doğrudan fizibilite sınırı olarak ayrılabilir.
Stokastik aramanın her adayı aynı yük profilleri, başlangıç koşulları ve süreyle test edilmelidir. Gürültülü modelde aynı aday bağımsız tekrarlarla değerlendirilmeli; yalnız en şanslı koşunun değeri seçim ölçütü olmamalıdır. Genetik yöntem sabit hesap bütçesiyle ızgara araması, yerel optimizasyon veya modelden elde edilmiş makul başlangıç katsayılarıyla karşılaştırılır. Pareto cephesi, hata ile enerji arasındaki seçenekleri sunar; son uygulama kararını fiziksel sınırlar, güvenilirlik ve bakım gereksinimleri belirler.
Ünite 11: Bilimsel Modelleme Aracı Olarak Genetik Algoritma
11.1. Öğrenme ve Evrim Etkileşimi
Baldwin etkisi, birey yaşamı boyunca öğrenilen davranışların, genetik olarak aktarılmadığı halde evrimin yönünü değiştirmesidir. Öğrenme yeteneği olan bireyler hedefe yakın genotipten hedefe ulaşabildiği için uygunluk yüzeyi düzleşir; keskin ve dar tepe, öğrenmenin genişlettiği bir eğime dönüşür ve seçim bu eğimi tırmanabilir.
Klasik benzetim modelinde her gen üç değer alabilir: sabit doğru, sabit yanlış ve öğrenilebilir. Öğrenilebilir konumlar yaşam boyunca rastgele denenir; hedefe daha az denemeyle ulaşan birey daha yüksek uygunluk alır. Sonuçta popülasyon önce öğrenilebilir konumları yayar, sonra bunları yavaş yavaş sabit doğru değerlerle değiştirir. Bu ikinci aşama Lamarck tipi kalıtım gerektirmez; yalnız seçim baskısıyla açıklanır.
Bu model, melez algoritmalardaki yerel aramanın neden işe yaradığının da açıklamasıdır: yerel arama, uygunluk yüzeyini genetik arama açısından daha tırmanılabilir hale getirir.
11.2. Cinsel Seçilim, Ekosistem ve Evrimsel Etkinlik
Cinsel seçilim modellerinde eş seçimi tercihi ile seçilen özellik birlikte evrimleşir; matematiksel modelin öngördüğü kaçak (runaway) davranış benzetimle incelenir. Ekosistem modellerinde birden çok tür aynı ortamda kaynak için yarışır ve uygunluk tümüyle içseldir.
Evrimsel etkinlik ölçütleri, bir sistemde gerçekten yeni ve kalıcı uyarlamaların ortaya çıkıp çıkmadığını niceliksel olarak ölçmeyi amaçlar. Bu ölçütler, benzetimin yalnız rastgele dalgalanma mı ürettiğini yoksa birikimli evrim mi gösterdiğini ayırt etmeye yarar.
Bu çalışmalarda genetik algoritma bir optimizasyon aracı değil, evrimsel varsayımların denetimli koşullarda sınandığı bir modelleme ortamıdır. Modelin çıktısı biyolojik gerçeklik değil, varsayımların mantıksal sonuçlarıdır.
Ünite 12: Genetik Algoritmanın Yakın Akrabaları
12.1. Diferansiyel Evrim
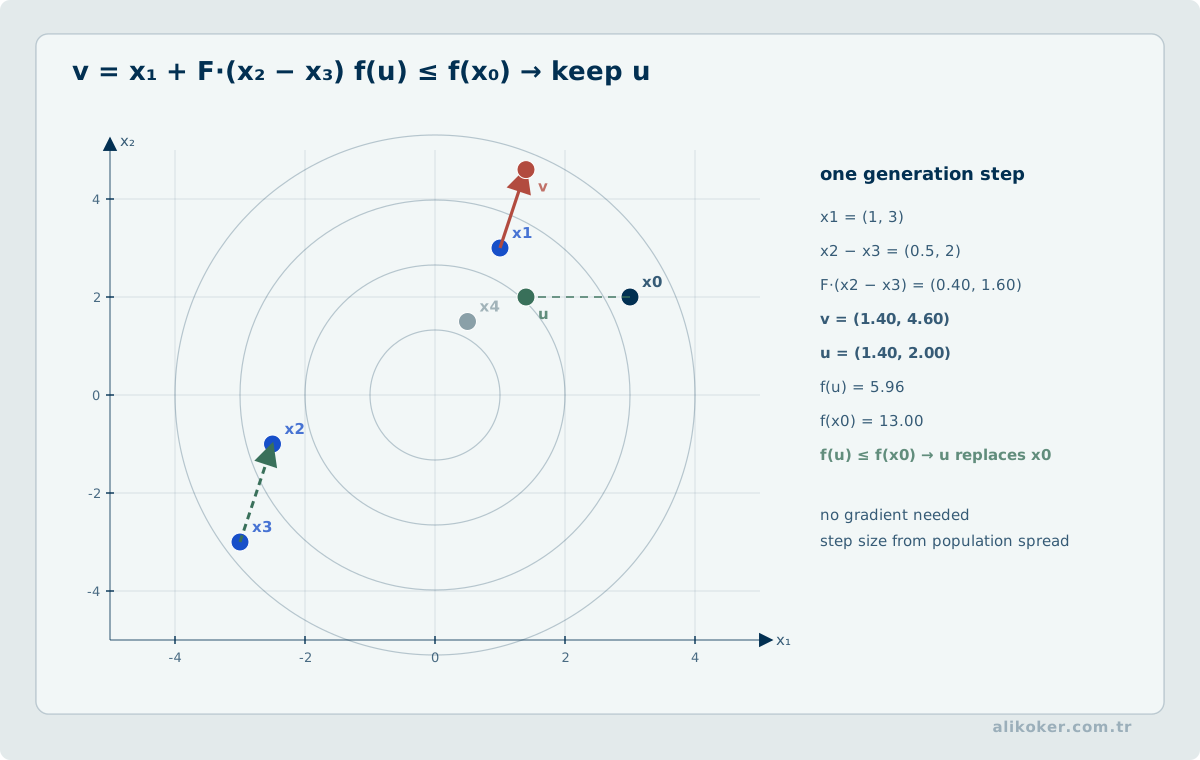
Sürekli parametreli problemler için tasarlanmış popülasyon tabanlı yöntemdir. Yeni aday, popülasyondan seçilen üç bireyin farkı üzerinden üretilir:
v = x(r1) + F · ( x(r2) - x(r3) )F ölçek katsayısıdır. Adım büyüklüğü popülasyonun kendi dağılımından türetildiği için arama ilerledikçe kendiliğinden küçülür; ayrı bir adım ayarı gerektirmez.
12.2. Kovaryans Matrisi Uyarlamalı Evrim Stratejisi
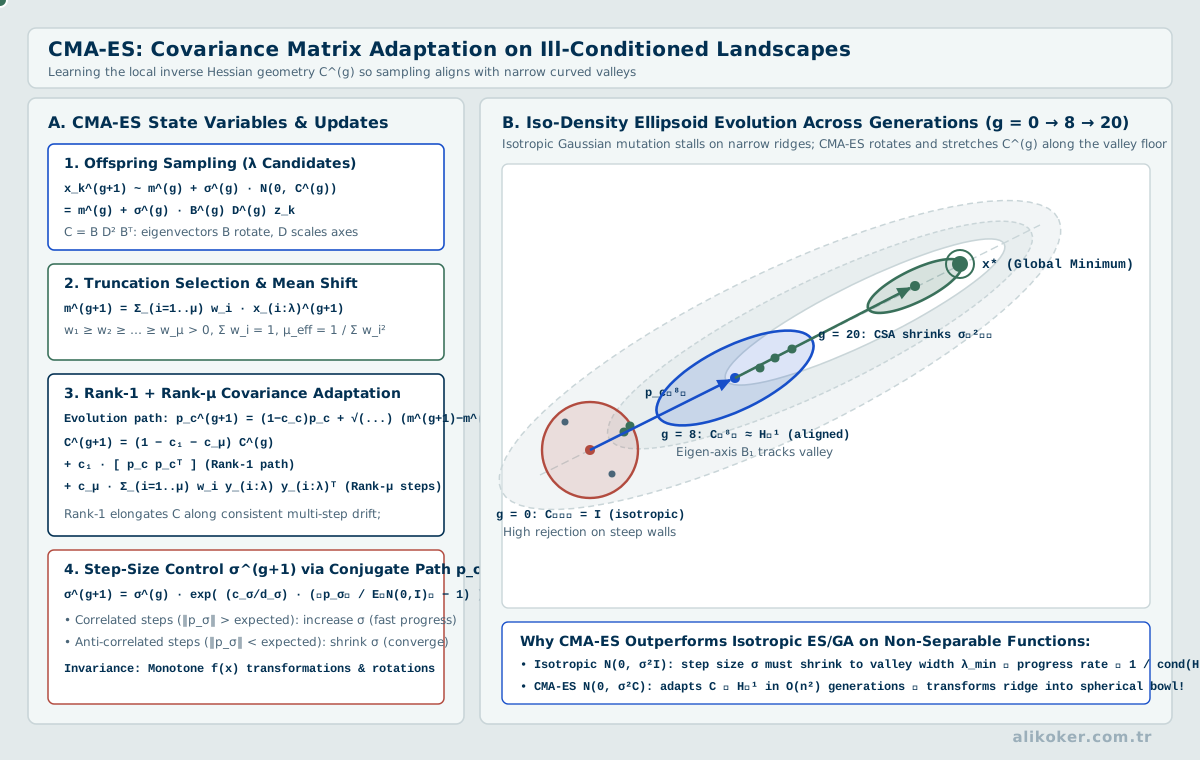
Popülasyon çok değişkenli normal dağılımdan örneklenir; dağılımın ortalaması ve kovaryans matrisi her nesilde başarılı adımlara bakılarak güncellenir. Kovaryans matrisi, değişkenler arası ölçek farklarını ve dönmüş, kötü koşullanmış vadileri öğrenir. Sürekli, orta boyutlu ve türevsiz problemlerde referans yöntem kabul edilir; maliyeti, kovaryans güncellemesinin boyutun karesiyle büyümesidir.
12.3. Çok Amaçlı Optimizasyon
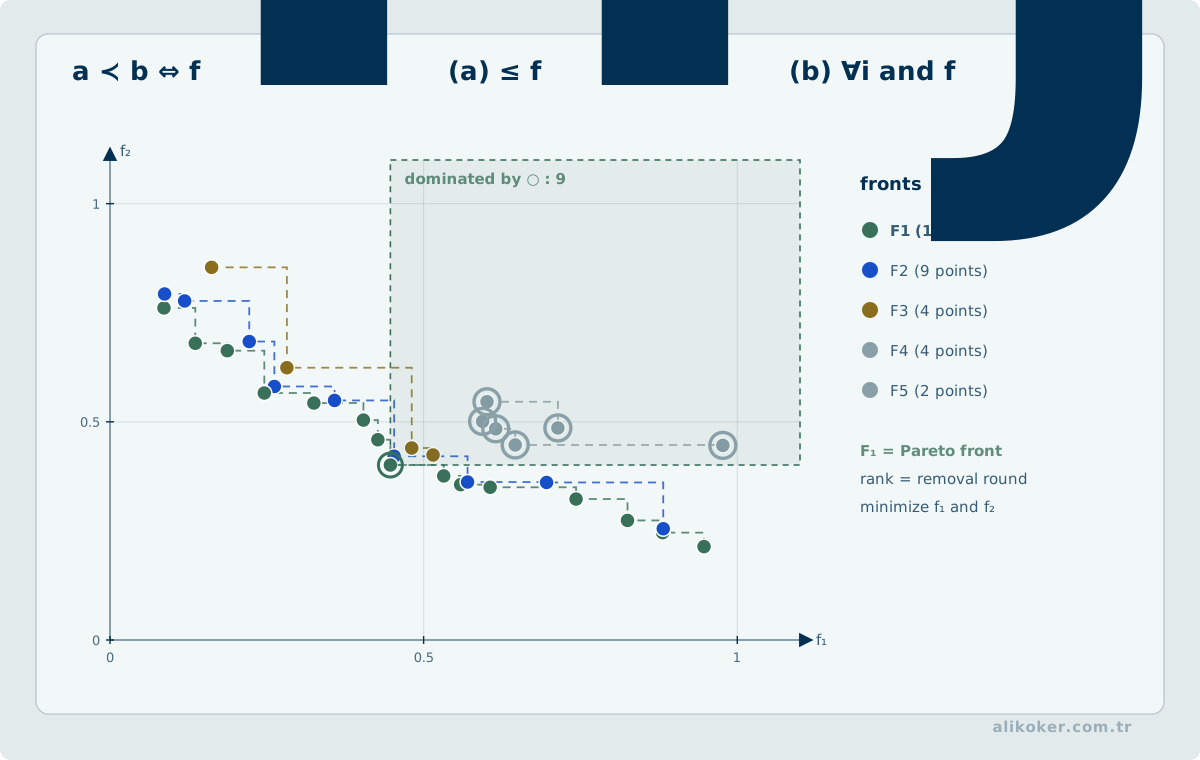
Birden çok çelişen amaç bulunduğunda tek bir optimum yoktur; amaçları ağırlıklandırıp toplamak yerine Pareto baskınlığı kullanılır. Bir çözüm, hiçbir amaçta daha kötü olmadan en az bir amaçta daha iyiyse diğerine baskındır.
Popülasyon tabanlı yöntemler bu problem sınıfına doğal olarak uyar: tek çalıştırmada Pareto cephesinin tamamına yakın bir kümesi elde edilir. Baskınlık sıralaması ve cephe üzerindeki dağılımı koruyan yoğunluk ölçütleri, seçim mekanizmasının bu amaca göre yeniden tanımlanmasını sağlar. Karar verici, seçimini elde edilen cephe üzerinden sonradan yapar.
12.4. Analitik Sistemlerde Eşik ve Ağırlık Optimizasyonu
Genetik algoritma, bir analitik sistemde eşik veya ağırlık seçmek için kullanılabilir; fakat önce neyin "iyi" olduğunun ölçülebilir olması gerekir. Bir anomali, ağ veya karar destek sistemi için yalnız algoritmanın çıktısını büyütmek uygunluk fonksiyonu değildir. Yanlış pozitif, yanlış negatif, uzman iş yükü, hesaplama maliyeti ve kararın kararlılığı aynı anda değerlendirilebilir.
Örneğin aday çözüm:
C = [anomali_eşiği,
     zaman_penceresi,
     benzerlik_eşiği,
     ağırlık_1,
     ağırlık_2]
olsun. Tek amaçlı uygunluk yerine çok amaçlı bir problem kurulabilir:
minimize false_positive_rate
minimize false_negative_rate
minimize analyst_workload
minimize compute_cost
maximize stability
Bu hedeflerin hepsi aynı anda en iyi değere ulaşmayabilir. Pareto cephesi, örneğin daha yüksek yakalama oranı için ne kadar ek yanlış pozitif ve uzman iş yükü ödendiğini görünür kılar. Böyle bir kullanımda genetik algoritmanın değeri "en iyi eşiği sihirli biçimde bulması" değil, açıkça tanımlanmış ödünleşim uzayını taramasıdır.
Ancak fitness fonksiyonu güvenilir değilse optimizasyon da güvenilir değildir. Uzmanlar tarafından doğrulanmış örnekler, sentetik senaryolar veya başka bir kabul edilebilir ground truth bulunmadan yalnız sistemin kendi skorunu fitness olarak kullanmak döngüsel bir optimizasyon üretir:
model kendi skorunu üretir
        ↓
GA aynı skoru büyütür
        ↓
sonuç daha yüksek skor alır
Bu, gerçek performansın arttığını göstermez.
Ayrıca optimizasyon ve doğrulama aynı veri üzerinde yapılmamalıdır. Parametreler bir veri kümesine göre seçilip aynı kayıtlar üzerinde başarı raporlanırsa eşikler de model parametreleri gibi aşırı uyum gösterebilir:
optimization corpus != validation corpusMümkünse zaman, kaynak veya vaka bakımından ayrılmış bir doğrulama kümesi kullanılmalıdır. Üretimde dağılım değiştiğinde daha önce iyi bulunan Pareto çözümü yeniden değerlendirilmelidir.
Bu nedenle küçük, türevlenebilir veya doğrudan taranabilir birkaç parametre için genetik algoritma ilk tercih değildir. Grid search, binary search, doğrusal/konveks optimizasyon veya alan bilgisi daha ucuz ve daha tekrar üretilebilir olabilir. Genetik algoritma; arama uzayı büyük, karma, ayrık ve sürekli parametreleri birlikte içeren, amaç yüzeyi düzensiz ve birden fazla hedefin çatıştığı durumda anlam kazanır. Buradaki seçim de algoritmanın kendisi kadar mühendislik problemidir.
12.5. Evrimsel Optimizasyonun Yapay Zekâdaki Yeri
Sabit mimaride ağırlık evrimi: Ağırlıklar kromozom olarak kodlanır, uygunluk ağın hata değeridir. Türev gerektirmediği için türevlenemez etkinleştirme fonksiyonları ve pekiştirmeli öğrenme benzeri seyrek geri besleme sinyalleriyle çalışabilir. Gradyan tabanlı eğitime göre çok daha fazla değerlendirme gerektirir; büyük ağlarda tek başına rekabetçi değildir.
Mimari evrimi: Katman ve bağlantı yapısı aranır. Doğrudan kodlamada bağlantı matrisi bit bit saklanır; kromozom uzunluğu düğüm sayısının karesiyle büyüdüğü için ölçeklenmez. Dilbilgisi tabanlı kodlamada kromozom, matrisi üreten yeniden yazma kurallarını taşır; kompakt gösterim, düzenli ve modüler mimarilerin ortaya çıkmasını kolaylaştırır.
Bu ayrım genel bir ilkeyi örnekler: genotip-fenotip eşlemesi ne kadar dolaylıysa, arama uzayı o kadar küçülür ve yapısal düzenlilik o kadar kolay üretilir; buna karşılık ince ayar yeteneği azalır.
12.6. Türevsiz Arama Yöntemlerinin Uygunluk Koşulları
Genetik algoritma, objective function'ın türevini gerektirmez. Bu özellik; simülatör, ayrık karar, non-differentiable kural veya yalnız black-box değerlendirme bulunan problemlerde yararlı olabilir. Buna karşılık her adayın fitness hesabı pahalıysa popülasyon tabanlı arama çok yüksek hesap maliyeti üretebilir.
Makine öğrenmesinde bu nedenle genetik algoritma çoğunlukla ana eğitim algoritmasının alternatifi değil, dış optimizasyon katmanı olarak daha anlamlıdır:
özellik alt kümesi
hiperparametre
mimari / kural yapısı
çok amaçlı trade-off
gibi seçimler evrimsel aramayla yapılabilir; modelin iç ağırlıkları daha verimli bir gradient yöntemiyle eğitilebilir.
12.7. Neuroevolution ve Politika Araması
Gradient bilgisinin zayıf, seyrek veya güvenilmez olduğu bazı kontrol ve oyun problemlerinde politika parametreleri doğrudan evrimleştirilebilir. Burada fitness bir bölümün toplam başarısı olabilir. Yöntem paralel değerlendirmeye uygundur; ancak sample efficiency çoğu gradient tabanlı yönteme göre düşük olabilir.
12.8. Çok Amaçlı AI Tasarımı
Üretim modeli yalnız doğrulukla seçilmez. Latency, bellek, enerji veya model boyutu da amaç olabilir. Çok amaçlı evrimsel optimizasyon:
maximize quality
minimize latency
minimize memory
gibi birbiriyle çatışan hedeflerde tek bir skor yerine Pareto cephesi üretebilir. Bu, “en iyi model” kavramının iş yüküne göre değiştiğini açık hale getirir.
Genetik algoritmaların modern AI'daki yeri bu nedenle her neural network'ü evrimle eğitmek değildir. Gradient'in bulunmadığı veya dış tasarım kararlarının birlikte aranması gereken alanlarda güçlü bir black-box optimizasyon aracıdır.
12.9. PSO'nun Genetik Operatörlerden Ayrılması
Parçacık sürü optimizasyonunda her parçacığın konumu x_i ve hızı v_i bulunur. Standart güncelleme v_i <- ωv_i+c1 r1(p_i-x_i)+c2 r2(g-x_i), ardından x_i <- x_i+v_i biçimindedir. p_i parçacığın kendi en iyi konumu, g ise seçilen komşuluk veya sürü en iyi konumudur. Bu işlem GA'daki çaprazlama ve mutasyonla aynı operatör değildir. ω, c1, c2, rastgele katsayılar, hız sınırı ve sınır dışına taşan parçacıkların işlenme kuralı arama davranışını belirler.
PSO, GA ve diferansiyel evrim karşılaştırmasında eşit iterasyon değil, aynı amaç fonksiyonu değerlendirme sayısı daha anlamlı bir ortak bütçedir. Çoklu başlangıç, başarısız koşular, medyan son uygunluk ve çeyrekler arası aralık raporlanmalıdır. Kuantum-esinli sürü varyantı klasik bilgisayarda örnekleme/arama operatörü kullanıyorsa fiziksel kuantum hızlanması iddiası taşımaz.
Ünite 13: Çok Amaçlı Kalite, Gürültülü Uygunluk ve Deney Tasarımı
Genetik algoritmanın mühendislik değeri yalnız iyi bir aday üretmesiyle ölçülmez. Aynı problemde farklı koşuların ne kadar kararlı olduğu, amaç fonksiyonunun gürültü içerip içermediği, değerlendirme bütçesinin nasıl harcandığı ve çok amaçlı problemlerde Pareto cephesinin ne kadar iyi temsil edildiği de sonuç kalitesinin parçasıdır.
13.1. Pareto Cephesinin Kalitesini Ölçmek
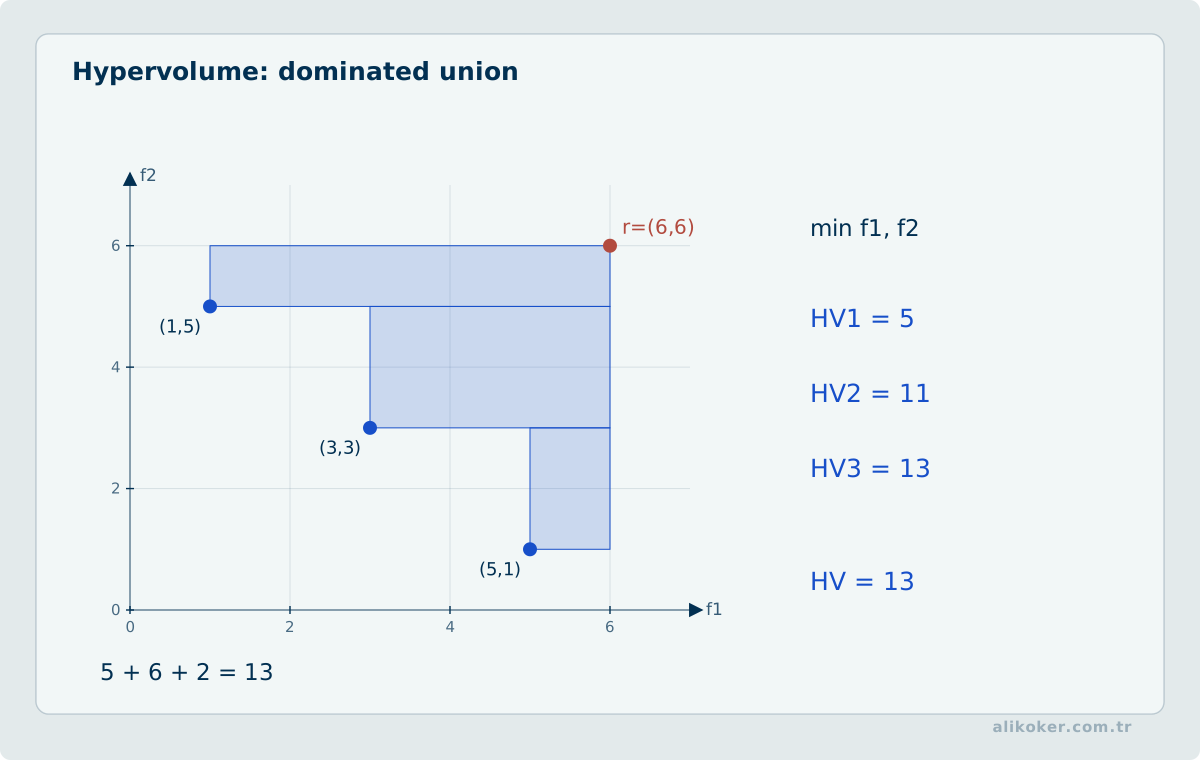
Çok amaçlı optimizasyonda yalnız "kaç adet baskılanmayan çözüm bulunduğu" yeterli bir ölçüt değildir. İki yöntem aynı sayıda çözüm üretirken bunlardan biri gerçek Pareto cephesine daha yakın, daha geniş aralığa yayılmış ve karar verici açısından daha kullanışlı olabilir.
Yaygın değerlendirme yaklaşımlarından biri hiperhacim (hypervolume) ölçüsüdür. Seçilen bir referans noktasına göre Pareto kümesinin baskın olduğu hacmi ölçer; yakınsama ve yayılımı tek değerde birleştirir. Ancak referans noktası ve amaçların ölçekleri sonucu etkilediği için farklı deneyler karşılaştırılırken bunlar sabit tutulmalıdır.
Referans Pareto cephesinin bilindiği yapay test problemlerinde kuşaksal uzaklık (generational distance) gibi ölçüler kullanılabilir. Gerçek mühendislik problemlerinde ise gerçek cephe genellikle bilinmez; bu durumda hiperhacim, kapsama, amaç uzayındaki yayılım ve alan bilgisine dayalı karar ölçütleri birlikte değerlendirilmelidir.
13.2. Gürültülü Uygunluk Fonksiyonları
Uygunluk değeri bir benzetim, fiziksel deney, örnekleme süreci veya rastgele başlangıç içeren başka bir algoritmadan geliyorsa aynı kromozom her değerlendirmede farklı sonuç verebilir. Tek örnek üzerinden seçim yapmak, iyi ve kötü adayların yalnız ölçüm gürültüsü nedeniyle yer değiştirmesine yol açar.
Maliyete bağlı olarak üç yaklaşım kullanılabilir:
- aynı adayı birden çok kez değerlendirip ortalama, medyan veya belirli bir yüzdelik değer üzerinden karar vermek,
- seçim sınırına yakın adaylara ek örnek ayırmak,
- iki adayı aynı rastgele senaryolar altında değerlendirerek ortak rastgele sayılarla (common random numbers) karşılaştırma varyansını azaltmak.
Burada amaç gürültüyü tamamen ortadan kaldırmak değil, seçim kararının belirsizliğini yönetmektir. Tekrar sayısını sabit büyütmek pahalı olabilir; uyarlanabilir yeniden örnekleme, hesaplama bütçesini kararsız karşılaştırmalara yoğunlaştırır.
13.3. Değerlendirme Bütçesi Ortak Para Birimidir
Farklı evrimsel yöntemleri yalnız nesil sayısıyla karşılaştırmak yanıltıcıdır. N=100 popülasyonlu 200 nesil ile N=20 popülasyonlu 200 nesil aynı sayıda amaç fonksiyonu çağrısı yapmaz.
Adil deneyde en az şu üç maliyet ayrı raporlanmalıdır:
amaç fonksiyonu değerlendirme sayısı
duvar saati
kullanılan işlemci / hızlandırıcı kaynağı
Paralel değerlendirme duvar saatini azaltabilir fakat toplam hesap miktarını azaltmayabilir. Asenkron evrimde hızlı değerlendirilen bireyler seçime daha erken girebiliyorsa algoritmanın olasılıksal davranışı senkron sürümden farklılaşabilir. Bu nedenle yalnız "paralelleştirildi" bilgisi değil, seçim ve güncelleme sırası da deney sözleşmesinin parçasıdır.
13.4. Durdurma Koşulu ve Tekrarlanabilirlik
Sabit nesil sayısı en basit durdurma kuralıdır; fakat tek başına çözüm kalitesi hakkında bilgi taşımaz. Uygulamada değerlendirme bütçesi, hedef uygunluk, belirli sayıda nesildir iyileşme olmaması veya çeşitliliğin belirli bir eşiğin altına düşmesi birlikte kullanılabilir.
Tekrarlanabilir bir deney en az şu bilgileri korumalıdır: rastgele sayı üreteci ve tohumu, popülasyon büyüklüğü, operatörler ve parametreleri, durdurma kuralı, değerlendirme kodunun sürümü, kısıt işleme yöntemi ve kullanılan test veri kümesi ya da benzetim senaryosu. Stokastik bir yöntemin tek koşudaki en iyi sonucu, algoritmanın genel başarımını temsil etmez.
13.5. Tek Koşu Yerine Dağılımı Raporlamak
Genetik algoritma stokastiktir; tek bir seed ile elde edilen en iyi sonuç algoritmanın karakterini temsil etmez. Karşılaştırmada bağımsız tekrarlar yapılmalı, medyan/ortalama yanında dağılım ve başarısız koşu oranı da raporlanmalıdır.
Aynı hesap bütçesi korunmadan algoritma karşılaştırmak da yanıltıcıdır. Bir yöntem 10 kat fazla fitness değerlendirmesi yapıyorsa yalnız son skora bakmak adil değildir. Popülasyon büyüklüğü, nesil sayısı ve değerlendirme maliyeti ortak bütçeye çevrilmelidir.
Yakınsama grafiği yalnız en iyi bireyi değil popülasyon çeşitliliğini de izlemelidir. En iyi skor sabitlenirken çeşitlilik hızla sıfıra düşüyorsa premature convergence olasılığı yükselir.
13.6. Stokastik Optimizasyon Sonucunu Raporlamak
Genetik algoritmada tek koşu sonuç değildir. Farklı seed'lerle bağımsız tekrarlar yapılmalı; medyan/ortalama yanında yayılım, en kötü değer ve hedefe ulaşamayan koşu oranı da görülmelidir.
Algoritma karşılaştırması aynı hesap bütçesiyle yapılmalıdır. Popülasyon büyüklüğü veya nesil sayısı yerine toplam fitness değerlendirmesi ya da gerçek işlem süresi ortak bütçe olarak kullanılabilir.
Başarılı örneğin yanı sıra çeşitlilik de izlenmelidir. Popülasyon erken tek tipe çöküyorsa daha iyi sonucun bulunamaması parametre veya temsil sorunu olabilir. Karşılaştırma mümkünse problem için bilinen klasik yöntem veya basit baseline içerir.
13.7. Temsil ile Uygunluk Fonksiyonu Birlikte Tasarlanır
Genetik algoritmada kromozom gösterimi yalnız veri saklama biçimi değildir; arama uzayının komşuluk yapısını da belirler. Aynı problem ikili dizi, tamsayı dizisi, permütasyon veya gerçek değerli vektörle kodlandığında çaprazlama ve mutasyonun ürettiği adaylar farklı olur. Özellikle sıralama problemlerinde sıradan tek noktalı çaprazlama geçersiz tekrarlar oluşturabilir; bu nedenle operatörün temsilin kısıtlarını koruması gerekir.
Uygunluk fonksiyonu da gerçek amacı yaklaşık olarak temsil eder. Ölçülmesi kolay bir vekil hedef seçildiğinde algoritma o vekili çok başarılı biçimde optimize ederken asıl mühendislik amacından uzaklaşabilir. Kısıtların yalnız büyük bir ceza katsayısıyla eklenmesi de çözüm uzayını bozabilir. Bazı problemlerde onarım, uygun temsil veya uygulanabilirlik-korumalı operatörler daha doğal bir çözüm verir.
Seçilim baskısı çok düşükse iyi adayların bilgisi yavaş yayılır; çok yüksekse çeşitlilik hızla azalır ve popülasyon erken yakınsayabilir. Mutasyonun rolü de “rastgeleliği artırmak”tan ibaret değildir: arama uzayında kaybolan varyasyonu yeniden üretir, ancak oran aşırı yükseldiğinde yönlendirilmiş arama rastgele aramaya yaklaşır.
Stokastik bir algoritmada tek bir en iyi koşuyu raporlamak bu nedenle yeterli değildir. Aynı başlangıç koşulları dışında farklı tohumlarla yapılan tekrarların medyanı, dağılımı ve başarısız koşuları görülmelidir. Genetik algoritmanın sonucu yalnız bulunan en iyi uygunluk değeri değil, temsil + operatör + seçilim + rastgelelik + durdurma koşulu bütününün davranışıdır.
13.8. Gürültülü Fitness Fonksiyonlarında Dayanıklılık
Robust istatistik, modelin ideal varsayımlarından küçük sapmalar olduğunda tahminin ne kadar bozulduğunu inceler. Genetik algoritma deneylerinde tek bir en iyi fitness değeri yerine medyan ve MAD kullanmak koşular arası değişkenliği görünür kılar; influence function ve breakdown point de performans özetinin birkaç sıra dışı koşu tarafından ne kadar kolay sürüklenebildiğini daha biçimsel değerlendirmeyi sağlar. Özellikle ağır kuyruklu veya kontamine veride yalnız ortalama ve standart sapmaya dayalı kararlar yanıltıcı olabilir.
- Fitness ölçümü gürültülü olduğunda tek değerlendirme yerine tekrar/robust özet kullanmak.
- Aykırı yüksek fitness değerinin popülasyonu yanlış yönlendirme riskini ölçmek.
- Paralel değerlendirme hızının selection pressure ile karıştırılmamasını sağlamak.
13.9. Gürültülü Uygunlukta Seçim Yanlılığı
Stokastik amaç fonksiyonunda bir kromozomun tek ölçümde yüksek uygunluk göstermesi, beklenen performansının gerçekten daha yüksek olduğunu kanıtlamaz. Çok sayıda aday arasından en büyük gözlenen değeri seçmek, ölçüm gürültüsünün pozitif uçlarından yararlanma eğilimindedir. Bu nedenle uygunluk değerlendirmesi f̂(x) = (1/m) Σ(j=1..m) f(x,ω_j) gibi bağımsız tekrarlara dayanabilir. Değerlendirme bütçesi sınırlıysa bütün adaylara aynı tekrar sayısını ayırmak yerine belirsizlikleri yakın olan güçlü adaylar için tekrar sayısını artırmak düşünülebilir.
İki kromozomun aynı rastgele senaryolarda değerlendirilmesi, uygunluk farkının varyansını azaltabilir. Bunun için kullanılan ortak rastgele sayıların optimizasyon turları boyunca hangi amaçla sabit tutulduğu belirtilmelidir; sabit bir senaryo kümesine aşırı uyum, gerçek dağılımdaki başarıyı olduğundan yüksek gösterebilir. Nihai adayın bağımsız bir senaryo kümesinde yeniden değerlendirilmesi, bu aşırı uyumu ölçmek için gereklidir.
13.10. Sezgisel Arama ve Yakınsama Güvencesi
Genetik algoritmalar geniş ve kesikli arama uzaylarında uygulanabilir çözümler üretebilir; buna karşılık son popülasyondaki en iyi birey, küresel optimum bulunduğunun kanıtı değildir. Belirli evrimsel şemalar için verilen asimptotik sonuçlar, sonlu çalışma bütçesi altında belirli bir hız veya başarı olasılığı garantilemez. Deney karşılaştırmalarında aynı sayıda amaç fonksiyonu değerlendirmesi, birden fazla bağımsız koşu, kalite dağılımı ve durdurma gerekçesi birlikte raporlanmalıdır. Paralel uygunluk hesabı geçen süreyi azaltabilir; daha çok işlemci çekirdeği algoritmik değerlendirme sayısını kendiliğinden azaltmaz.
Kaynakça
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- Peter J. Huber; Elvezio M. Ronchetti. Robust Statistics. 2nd ed. Wiley, 2009.
- Çunkaş, M. Genetik Algoritmalar ve Uygulamaları Ders Notları. Selçuk Üniversitesi Teknik Eğitim Fakültesi, Elektronik-Bilgisayar Eğitimi, Bahar 2006.
- Deb, K.; Pratap, A.; Agarwal, S.; Meyarivan, T. “A Fast and Elitist Multiobjective Genetic Algorithm: NSGA-II.” IEEE Transactions on Evolutionary Computation, 6(2), 182-197, 2002. https://doi.org/10.1109/4235.996017
- Eiben, A. E.; Smith, J. E. Introduction to Evolutionary Computing. Springer.
- Goldberg, D. E. Genetic Algorithms in Search, Optimization, and Machine Learning. Addison-Wesley, 1989.
- Hansen, N.; Ostermeier, A. “Completely Derandomized Self-Adaptation in Evolution Strategies.” Evolutionary Computation, 9(2), 159-195, 2001. https://doi.org/10.1162/106365601750190398
- Holland, J. H. Adaptation in Natural and Artificial Systems. University of Michigan Press, 1975.
- Mitchell, M. An Introduction to Genetic Algorithms. MIT Press, 1996.
- Stanley, K. O.; Miikkulainen, R. “Evolving Neural Networks through Augmenting Topologies.” Evolutionary Computation, 10(2), 2002. https://doi.org/10.1162/106365602320169811
- Storn, R.; Price, K. “Differential Evolution – A Simple and Efficient Heuristic for Global Optimization over Continuous Spaces.” Journal of Global Optimization, 1997.
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.
- Naveenkumar, P.; Sharma, V.; Devarajan, G.; Abdullah, A.; Elngar, A. A. (eds.). Handbook of AI-Based Mechatronics Systems and Smart Solutions in Industrial Automation. CRC Press, 2026. DOI: https://doi.org/10.1201/9781032615790.
- Chunwei Zhang, Tianpeng Li, Ying Dai, Li Sun ve Ardashir Mohammadzadeh. Practical Neural Networks in Python and MATLAB. Springer Nature, 2026. DOI: https://doi.org/10.1007/978-3-032-14746-2.