


Yapay Sinir Ağları ve Öğrenme Modelleri
Perceptron, çok katmanlı algılayıcı, geri yayılım, LVQ, ART ve Elman ağından modern ağ aileleri, kontrollü deney, dağılım değişimi ve üretim gözlemine uzanan kapsamlı ders notu.
Yapay sinir ağlarında model seçimi yalnız ağ mimarisine bağlı değildir. Öğrenme algoritması, kayıp işlevi, düzenlileştirme, veri dağılımı, deney düzeni ve üretim davranışı birlikte değerlendirilir. Perceptron ve ADALINE ile başlayan yapı; çok katmanlı algılayıcı (MLP), geri yayılım, Learning Vector Quantization (LVQ), Adaptive Resonance Theory (ART), geri dönüşümlü ağlar, CNN, LSTM/GRU, dikkat mekanizmaları, Transformer ve üretici modellerle genişler.
Ünite 1: İlk Yapay Sinir Ağları
Tek katmanlı ağlar
Tek katmanlı ağlarda öğrenilebilir bağlantılar girdiden doğrudan çıktı birimlerine gider. Gizli katman bulunmaz.
Bu tür ağlar doğrusal karar sınırları öğrenebilir. Bir sınıflandırıcı için karar:
w^T x + b = 0
hiperdüzlemiyle ifade edilir.
İki sınıf bu hiperdüzlemle ayrılabiliyorsa problem doğrusal ayrılabilirdir.
Perceptron
Perceptron, ikili sınıflandırma için temel tarihsel modeldir. Net girdi:
z = w^T x + b
olarak hesaplanır. Çıktı bir eşik fonksiyonuyla belirlenir.
Örnek yanlış sınıflandırılmışsa ağırlıklar hedef sınıfa doğru değiştirilir. Basit güncelleme:
w <- w + eta * (t - y) * x
b <- b + eta * (t - y)
şeklindedir.
Veri doğrusal ayrılabilir ise perceptron öğrenme algoritması sonlu sayıda güncelleme sonunda ayıran bir çözüm bulabilir.
Perceptronun sınırlılığı
Tek katmanlı perceptron doğrusal ayrılamayan problemleri çözemez. XOR bunun klasik örneğidir.
XOR doğruluk tablosu:
0 0 -> 0
0 1 -> 1
1 0 -> 1
1 1 -> 0
Bu dört nokta tek bir doğrusal karar sınırıyla ayrılamaz.
Bu sınırlılık yapay sinir ağlarının genel olarak yetersiz olduğunu göstermez. Gizli katman ve doğrusal olmayan aktivasyon kullanıldığında XOR çözülebilir.
ADALINE
ADALINE, Widrow ve Hoff tarafından geliştirilen adaptif doğrusal birimdir. Perceptrondan önemli farkı, öğrenme sırasında eşiklenmiş sınıf çıktısı yerine nöronun doğrusal çıktısındaki hatayı kullanmasıdır.
Kayıp çoğunlukla karesel hata biçimindedir:
E = 1/2 * (t - y)^2
Ağırlık güncellemesi gradyan inişine dayanır:
w <- w + eta * (t - y) * x
Bu yaklaşım LMS veya Widrow-Hoff kuralıyla ilişkilidir.
MADALINE
MADALINE, birden fazla ADALINE biriminin birlikte kullanıldığı ağ ailesidir. Tarihsel olarak çok katmanlı adaptif sistemlerin erken örneklerinden biridir.
Bugün MADALINE yaygın bir genel amaçlı mimari değildir. Önemi, çok sayıda öğrenilebilir doğrusal birimin birlikte kullanılması ve adaptif filtreleme düşüncesinin sinir ağlarına taşınmasıdır.
Ünite 2: Öğretmenli Öğrenme ve Çok Katmanlı Algılayıcı
Bu ünite, öğretmenli öğrenmede ileri geçiş, kayıp hesabı, geri yayılım ve ağırlık güncellemesini tek bir optimizasyon döngüsü olarak ele alır.
girdi -> gizli katmanlar -> çıktı -> kayıp
  ^                               |
  |                               v
  +---- ağırlık güncelleme <- geri yayılım

ileri geçiş -> hata -> gradyan -> güncelleme -> yeni ileri geçiş
Çok katmanlı algılayıcı
Çok katmanlı algılayıcı, yani MLP, en az bir gizli katmana sahip ileri beslemeli sinir ağıdır. Gizli katmandaki doğrusal olmayan aktivasyonlar doğrusal ayrılamayan ilişkilerin öğrenilmesini sağlar.
Bir iki katmanlı ağ şöyle yazılabilir:
h = phi(W1*x + b1)
yhat = psi(W2*h + b2)
Burada h gizli temsildir.
XOR probleminin çözümü
XOR problemi tek doğrusal sınırla çözülemez. Ancak gizli katmandaki birden fazla nöron giriş uzayını farklı yarı uzaylara ayırabilir. Çıktı katmanı bu ara temsilleri birleştirerek XOR kararını oluşturabilir.
Bu örnek, gizli katmanın yalnız daha fazla parametre eklemediğini; yeni bir temsil uzayı oluşturduğunu gösterir.
İleri bilgi işleme
İleri geçişte her katman bir önceki katmanın çıktısını alır:
a^(l) = phi(W^(l) * a^(l-1) + b^(l))
Bu işlem çıktı katmanına kadar devam eder.
Tahmin ile hedef arasındaki fark kayıp fonksiyonuyla ölçülür.
Geri yayılım
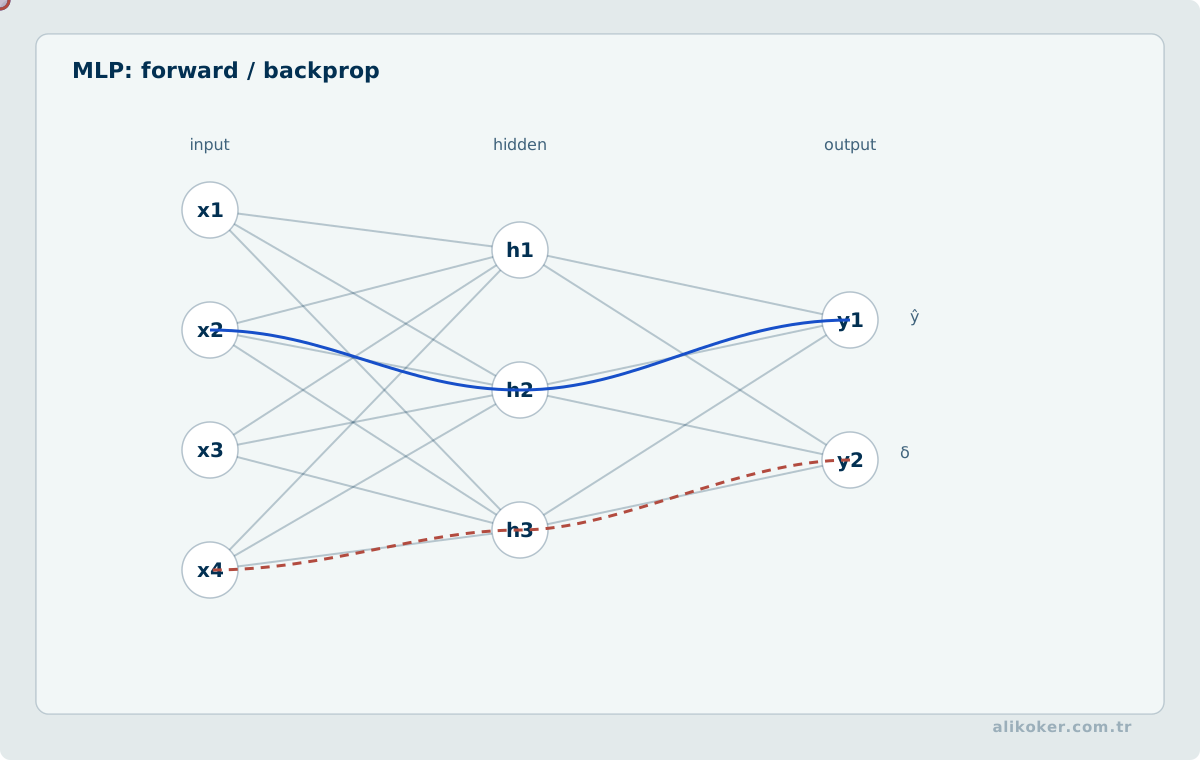
Geri yayılım, kayıp fonksiyonunun her parametreye göre türevini zincir kuralıyla hesaplar. Temel amaç:
dL/dW^(l)
ve
dL/db^(l)
gradyanlarını verimli biçimde elde etmektir.
Çıktı katmanındaki hata geriye doğru taşınır. Her katman kendi yerel türevi ile bir sonraki katmandan gelen gradyanı çarpar.
Parametre güncellemesi:
W <- W - eta * dL/dW
b <- b - eta * dL/db
biçimindedir.
Çıktı katmanı ağırlıklarının güncellenmesi
Çıktı katmanında hata doğrudan model tahminiyle hedef arasındaki farka bağlıdır. Sigmoid ve karesel hata için klasik türev yapısı:
delta_k = (t_k - y_k) * y_k * (1 - y_k)
şeklinde yazılabilir.
Güncel sınıflandırma uygulamalarında softmax ile çapraz entropi birlikte kullanıldığında türev daha yalın hale gelir.
Gizli katman ağırlıklarının güncellenmesi
Gizli nöronun doğrudan hedef değeri yoktur. Hata, kendisinden sonra gelen katmanların hatalarından zincir kuralıyla türetilir.
Klasik sigmoid nöron için:
delta_j = h_j * (1 - h_j) * sum_k(delta_k * w_jk)
Ağırlık güncellemesi daha sonra:
Delta w_ij = eta * delta_j * x_i
olarak yazılabilir.
Eğitim prosedürü
Bir MLP'nin temel eğitim çevrimi şöyledir:
- Ağırlıkları başlat.
- Mini-batch seç.
- İleri geçiş yap.
- Kayıp hesapla.
- Geri yayılımla gradyanları bul.
- Optimizer ile parametreleri güncelle.
- Doğrulama başarımını izle.
- Durdurma ölçütü sağlanana kadar sürdür.
Modern uygulamada tek örnekli çevrim yerine mini-batch eğitimi yaygındır.
Karmaşık hata yüzeyleri
Derin ağların kayıp yüzeyi yüksek boyutlu ve doğrusal değildir. Yerel minimumlar, eyer noktaları, düz bölgeler ve kötü ölçeklenmiş yönler optimizasyonu etkileyebilir.
Ağırlık başlangıcı, normalizasyon, optimizer ve öğrenme katsayısı bu nedenle kritiktir.
Öğrenme süresi
Eğitim süresini etkileyen başlıca etkenler şunlardır:
- veri kümesinin büyüklüğü,
- model parametre sayısı,
- batch büyüklüğü,
- donanım,
- sayısal hassasiyet,
- optimizer,
- öğrenme katsayısı,
- veri giriş hattı.
Performans yalnız FLOPS ile belirlenmez. Bellek bant genişliği, veri aktarımı ve paralellik de önemlidir.
Ünite 3: Çok Katmanlı Algılayıcı Tasarımı ve Performansı
Bu ünite, eğitim, doğrulama ve test kümelerinin farklı rollerini model seçimi ve genelleme başarımı bağlamında birbirinden ayırır.
veri kümesi
   |
   +--> eğitim ------> ağırlıklar güncellenir
   |
   +--> doğrulama ---> model / eşik / durdurma kararı
   |
   +--> test --------> yalnız nihai genelleme ölçümü
Performansın ölçülmesi
Model başarımı probleme uygun ölçütlerle değerlendirilmelidir.
Sınıflandırmada sık kullanılan ölçütler:
- accuracy,
- precision,
- recall,
- F1,
- ROC-AUC,
- PR-AUC.
Regresyonda:
- MAE,
- MSE,
- RMSE,
- R².
Dengesiz sınıflarda yalnız accuracy yanıltıcı olabilir. Ölçüt seçiminde hata türlerinin uygulamadaki maliyeti dikkate alınmalıdır.
Ezberleme ve aşırı uyum
Model eğitim verisinde çok başarılı, görülmemiş veride zayıf ise overfitting vardır.
Aşırı uyumun temel nedenleri:
- modele göre az veri,
- fazla model kapasitesi,
- uzun eğitim,
- veri sızıntısı,
- eğitim ve gerçek kullanım dağılımlarının farklı olması.
Karşı önlemler:
- daha fazla ve daha iyi veri,
- veri artırma,
- L1/L2 düzenlileştirme,
- dropout,
- early stopping,
- uygun model kapasitesi,
- çapraz doğrulama.
Örneklerin seçilmesi
Eğitim verisi gerçek problem uzayını temsil etmelidir. Yalnız kolay veya benzer örneklerin seçilmesi modelin sahadaki başarımını düşürür.
Veri bölme işlemi rastgele yapılmadan önce bağımlılık yapısı incelenmelidir. Aynı kişi, aynı cihaz, aynı zaman penceresi veya aynı kaynak hem eğitim hem test kümesine dağılırsa veri sızıntısı oluşabilir.
Zaman serilerinde geçmişten geleceğe doğru bölme çoğu zaman rastgele bölmeden daha doğrudur.
Girdi ve çıktı gösterimi
Modelin başarısı yalnız mimariye değil, problemin gösterimine de bağlıdır.
Tablosal veride sayısal ve kategorik özellikler uygun biçimde kodlanmalıdır.
Görüntüde piksel veya öğrenilmiş görsel temsil kullanılır.
Metinde token ve embedding gösterimleri kullanılır.
Seste waveform, spektrogram veya öğrenilmiş özellikler kullanılabilir.
Gösterim, modelin öğrenmesi gereken invariance ve bağımlılıklarla uyumlu olmalıdır.
Görüntü tanıma
Görüntülerin doğrudan tam bağlı MLP'ye verilmesi küçük örneklerde öğretici olsa da modern görsel sistemlerde CNN ve Vision Transformer gibi mimariler daha uygundur.
CNN yerel bağlantı ve ağırlık paylaşımı sayesinde görüntünün uzamsal yapısından yararlanır.
Endüstriyel kestirim örneği
Bir üretim prosesinde çok sayıda ayar parametresi ile kalite çıktısı arasında doğrusal olmayan ilişki olabilir. Sinir ağı bu ilişkiyi deney verisinden öğrenebilir ve denenmemiş parametre kombinasyonlarının çıktısını kestirebilir.
Ancak eğitim verisinin kapsamadığı bölgelerde yapılan kestirim extrapolation niteliğindedir ve güvenilirliği düşebilir. Optimizasyon amacıyla ağ kullanılırken bu sınır özellikle dikkate alınmalıdır.
Zaman serisi kestirimi
Döviz kuru gibi zaman serilerinde geçmiş değerlerden gelecek değer tahmin edilebilir. Ancak finansal seriler durağan olmayabilir ve güçlü gürültü içerir. Başarılı görünen sonuçlar veri sızıntısı, yanlış zaman bölmesi veya aşırı uyum nedeniyle yanıltıcı olabilir.
Zaman serisinde değerlendirme kronolojik ayrım, kayan pencere doğrulaması (rolling validation) ve gerçek işlem maliyetleriyle yapılmalıdır.
Çıktıların gösterimi
İkili sınıflandırmada tek sigmoid çıkış kullanılabilir.
Çok sınıflı sınıflandırmada sınıf sayısı kadar logit ve softmax yaygındır.
Çok etiketli sınıflandırmada her sınıf için bağımsız sigmoid kullanılabilir.
Regresyonda çıkış çoğu zaman doğrusal bırakılır.
Çıktı aktivasyonu ile kayıp fonksiyonu birlikte düşünülmelidir.
Ağırlık başlangıcı
Tüm ağırlıkları aynı değere kurmak simetri sorununa neden olur. Gizli nöronlar aynı gradyanı alabilir.
Bu nedenle rastgele fakat kontrollü başlangıç kullanılır. Xavier/Glorot başlangıcı sigmoid ve tanh ailesiyle, He başlangıcı ReLU ailesiyle yaygın olarak kullanılır.
Başlangıcın amacı aktivasyonların ve gradyanların katmanlar boyunca aşırı büyümemesini veya sönmemesini sağlamaktır.
Öğrenme katsayısı ve momentum
Öğrenme katsayısı çok küçükse eğitim yavaşlar. Çok büyükse kayıp salınabilir veya eğitim kararsız hale gelebilir.
Momentum geçmiş gradyan yönlerini biriktirerek bazı yönlerde ilerlemeyi hızlandırabilir:
v_t = beta * v_(t-1) + g_t
w_t = w_(t-1) - eta * v_t
Modern optimizerlar öğrenme katsayısını parametre bazında uyarlayabilir. Yine de temel öğrenme katsayısı çoğu zaman en kritik hiperparametrelerden biridir.
Örneklerin ağa sunulması
Eğitim örnekleri epoch'lar arasında karıştırılabilir. Mini-batch seçimi gradyan tahminine rastlantısallık katar.
Zaman serisi, sıralı veri veya stateful recurrent ağlarda sıra bilgisi korunabilir. Dolayısıyla "her zaman karıştır" kuralı yoktur.
Ağırlıkların değiştirilme zamanı
Üç temel yaklaşım vardır:
Batch gradient descent: Tüm veri üzerinden tek güncelleme.
Stochastic gradient descent: Her örnekten sonra güncelleme.
Mini-batch gradient descent: Küçük örnek gruplarından sonra güncelleme.
Güncel derin öğrenmede mini-batch yaklaşımı donanım paralelliği ve gradyan istatistikleri nedeniyle yaygındır.
Girdilerin ölçeklendirilmesi
Farklı büyüklüklerde özellikler optimizasyonu zorlaştırabilir.
Yaygın yöntemler:
- standardizasyon:
(x - mean) / std, - min-max ölçekleme,
- sağlam ölçekleme.
Ölçekleme parametreleri yalnız eğitim verisinden hesaplanmalıdır. Test verisinin istatistiklerini eğitim aşamasında kullanmak veri sızıntısıdır.
Çıktıların ölçeklendirilmesi
Regresyon hedefleri çok geniş aralıktaysa çıktıların ölçeklenmesi eğitimi kolaylaştırabilir. Tahmin kullanım aşamasında özgün ölçeğe geri dönüştürülür.
Sınıflandırmada hedef gösterimi kayıp fonksiyonuna göre belirlenir.
Durdurma kriterleri
Yalnız eğitim hatasının belirli değerin altına düşmesi güvenilir bir durdurma ölçütü değildir.
Daha iyi yaklaşım doğrulama kaybını izlemektir. Doğrulama başarımı belirli süre iyileşmiyorsa early stopping uygulanabilir.
Ayrıca maksimum epoch, zaman bütçesi ve hedef ölçüt birlikte kullanılabilir.
Gizli katman ve nöron sayısı
Her problem için en iyi katman ve nöron sayısını veren kapalı form kural yoktur. Model kapasitesi doğrulama başarımı ve kaynak maliyetiyle seçilir.
Çok küçük model underfitting yapabilir. Gereğinden büyük model daha pahalıdır ve uygun düzenlileştirme yoksa aşırı uyuma açık olabilir.
Büyütme ve budama
Model kapasitesi eğitim sırasında veya sonrasında değiştirilebilir.
Büyütme, yetersiz kapasiteyi gidermek için yeni birimler veya katmanlar eklemektir.
Budama, düşük öneme sahip ağırlık veya yapıların kaldırılmasıdır.
Modern budama yöntemleri sıkıştırma ve çıkarım hızlandırma amacıyla da kullanılır. Yapısal budama, donanım üzerinde gerçek hız kazanımı sağlama açısından tek tek ağırlık sıfırlamaktan daha etkili olabilir.
Uygulama alanları
MLP özellikle sabit boyutlu vektör girdilerde temel bir modeldir. Sınıflandırma, regresyon ve ara temsil katmanı olarak yaygın biçimde kullanılır.
Görüntü, ses ve uzun dizilerde ise problem yapısını kullanan CNN, recurrent ağ veya Transformer gibi mimariler çoğu zaman daha uygundur.
Ünite 4: Çok Katmanlı Algılayıcı ile Endüstriyel Kestirim
Problemin tanımlanması
Bir yapay sinir ağı uygulamasında ilk adım ağ seçmek değil, problemi açık biçimde tanımlamaktır. Endüstriyel bir üretim sürecinde amaç çoğu zaman kalite karakteristiğini etkileyen proses değişkenleri ile sonuç arasındaki ilişkiyi öğrenmektir.
Klasik örnekte bir döküm prosesinde tüplerde oluşan sehim miktarını etkileyen yedi üretim faktörü ele alınır. Her faktörün iki düzeyi olduğunda tam faktöriyel deney uzayı:
2^7 = 128
kombinasyon içerir.
Bütün kombinasyonları fiziksel olarak denemek pahalı olabilir. Bu nedenle daha az sayıdaki deneyden elde edilen verilerle bir MLP eğitilip denenmemiş kombinasyonların kalite çıktısı kestirilebilir.
Deney tasarımı ile öğrenme ilişkisi
Sinir ağı fiziksel deneyin yerini otomatik olarak almaz. Ağ yalnız kendisine sunulan veri üzerinden ilişki öğrenir. Bu nedenle deney tasarımı zayıfsa model de zayıf olur.
İyi bir tasarım şu özellikleri taşımalıdır:
- faktör uzayını yeterince kapsamalı,
- etkileşimleri gözlemlemeye imkan vermeli,
- ölçüm gürültüsünü dikkate almalı,
- doğrulama için bağımsız deneyler içermeli.
Az sayıda örnekten çok sayıda kombinasyona kestirim yapmak güçlü bir varsayımdır. Modelin önerdiği optimum nokta bağımsız fiziksel deneyle doğrulanmalıdır.
Girdi ve çıktı tasarımı
Yedi faktörlü örnekte giriş vektörü:
x = [A, B, C, D, E, F, G]
şeklinde tanımlanabilir.
Çıkış ise sehim miktarıdır:
y = sehim
İki seviyeli faktörler 0/1, -1/+1 veya fiziksel değerleriyle gösterilebilir. Kullanılan kodlama eğitim ve kullanım aşamasında aynı olmalıdır.
Ağın eğitilmesi
MLP eğitiminde amaç deney sonuçları ile ağ tahminleri arasındaki hatayı azaltmaktır. Eğitim hatasının sıfıra yaklaşması modelin doğru genelleme yaptığı anlamına gelmez.
Bu tür küçük veri problemlerinde özellikle:
- leave-one-out veya k-fold doğrulama,
- tekrarlı fiziksel deney,
- basit regresyon modelleriyle karşılaştırma,
- belirsizlik analizi
gereklidir.
Optimizasyon için model kullanımı
Model yeterince doğrulandıktan sonra aday proses ayarları ağ üzerinden taranabilir. En düşük tahmini kalite kaybını veren kombinasyon aday optimum olarak seçilebilir.
Ancak model yalnız veri dağılımının kapsadığı bölgelerde güvenilir kabul edilmelidir. Eğitim uzayının dışına çıkıldığında ağın ürettiği sayı fiziksel olarak anlamlı olmak zorunda değildir.
Bu yaklaşımın temel değeri, pahalı fiziksel deney sayısını azaltmak ve deney tasarımına yön vermektir.
Ünite 5: Learning Vector Quantization
LVQ modelinin amacı
Learning Vector Quantization, kısaca LVQ, prototip tabanlı öğretmenli bir sınıflandırma yöntemidir. Her sınıf giriş uzayında bir veya daha fazla referans vektörüyle temsil edilir.
Yeni örnek, kendisine en yakın prototipin sınıfına atanır.
Bu nedenle LVQ'nun temelinde iki fikir vardır:
- en yakın prototip ile sınıflandırma,
- prototiplerin etiketli eğitim verisine göre uyarlanması.
LVQ ağının yapısı
Bir LVQ sistemi kavramsal olarak şu bileşenlerden oluşur:
Girdi katmanı: Özellik vektörünü alır.
Rekabetçi katman: Prototip vektörlerini tutar ve en yakın prototipi belirler.
Sınıf eşleme katmanı: Kazanan prototipi sınıf etiketine dönüştürür.
Her prototip:
w_i = [w_i1, w_i2, ..., w_in]
şeklinde girişle aynı boyutta bir vektördür.
Uzaklık hesabı
Klasik LVQ'da çoğunlukla Öklid uzaklığı kullanılır:
d_i = ||x - w_i||
Kazanan prototip:
c = argmin_i d_i
olarak seçilir.
Özelliklerin ölçekleri farklıysa uzaklık hesabı bozulabilir. Bu nedenle LVQ öncesinde normalizasyon veya standardizasyon önemlidir.
LVQ1 öğrenme kuralı
Kazanan prototip doğru sınıfa aitse girişe yaklaştırılır:
w_c(t+1) = w_c(t) + alpha(t) * (x - w_c(t))
Kazanan prototip yanlış sınıfa aitse girişten uzaklaştırılır:
w_c(t+1) = w_c(t) - alpha(t) * (x - w_c(t))
Diğer prototipler değiştirilmez.
Öğrenme katsayısı alpha(t) zamanla azaltılabilir.
Karar bölgeleri
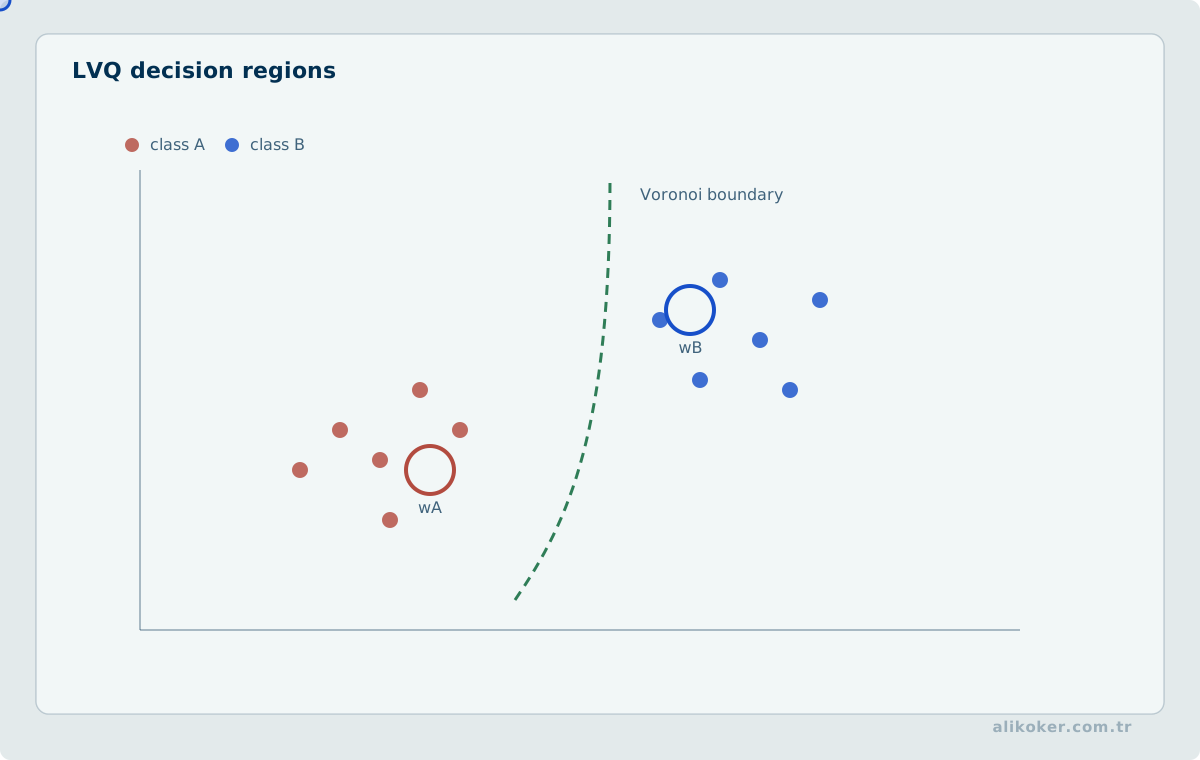
Her prototip giriş uzayında bir Voronoi bölgesi oluşturur. Sınıf sınırları komşu prototiplerin konumlarıyla belirlenir.
Bu yapı LVQ'yu yorumlanabilir kılar. Prototipler gerçek özellik uzayında bulunduğu için sınıfın tipik temsilcileri olarak incelenebilir.
LVQ2 ve sınır düzeltme
LVQ2 ailesi özellikle sınıf sınırına yakın örneklerde iki prototipi birlikte günceller. Doğru sınıfa ait prototip girişe yaklaştırılırken yanlış sınıfa ait prototip uzaklaştırılır.
Amaç sınıf sınırlarını daha iyi konumlandırmaktır.
LVQ2.1 ve LVQ3 gibi varyantlar güncelleme koşullarını değiştirerek kararlılığı ve sınıf sınırı temsilini iyileştirmeye çalışır.
Cezalandırılmış LVQ
Rekabetçi öğrenmede bazı prototipler sürekli kazanırken bazıları hiç güncellenmeyebilir. Cezalandırma mekanizmaları aşırı kazanan prototiplerin avantajını azaltarak kullanılmayan prototiplere öğrenme şansı vermeyi amaçlar.
Bu fikir rekabetçi öğrenmede prototip kullanımını dengelemeye yöneliktir.
LVQ-X
LVQ-X, her iterasyonda global ve sınıf içi yerel kazananı birlikte ele alan bir LVQ varyantıdır.
Global kazanan, giriş vektörüne bütün prototipler içinde en yakın olandır.
Yerel kazanan, doğru sınıfa ait prototipler içinde girişe en yakın olandır.
Global kazanan yanlış sınıftaysa bu prototip girişten uzaklaştırılır. Aynı anda doğru sınıftaki yerel kazanan girişe yaklaştırılır. İki kazanan aynı prototipse yalnız bu prototip girişe yaklaştırılır.
Yaklaşımın amacı yanlış sınıf prototipini karar bölgesinden uzaklaştırırken doğru sınıf prototipini aynı örneğe doğru çekmektir.
LVQ'nun güçlü ve zayıf yönleri
Güçlü yönleri:
- basit karar mekanizması,
- prototiplerin yorumlanabilir olması,
- düşük çıkarım maliyeti,
- doğrusal olmayan sınıf sınırları oluşturabilmesi.
Sınırlılıkları:
- uzaklık metriğine duyarlılık,
- ölçeklendirme gereksinimi,
- prototip sayısının önceden seçilmesi,
- yüksek boyutta Öklid uzaklığının anlamını kaybedebilmesi,
- karmaşık temsilleri kendiliğinden öğrenememesi.
Güncel derin öğrenmede özellikler çoğu zaman ayrı bir ağla öğrenilir. LVQ ise özellikle prototip tabanlı sınıflandırma ve yorumlanabilir modelleme açısından öğretici önem taşır.
Ünite 6: LVQ ile Örüntü Tanıma
İstatistiksel kalite kontrol problemi
İstatistiksel proses kontrolünde amaç yalnız hatalı ürünü ayırmak değil, prosesin olağan dışı davranmaya başladığını erken belirlemektir.
Bir kalite karakteristiğinin zaman içindeki değerleri kontrol grafiğinde izlenebilir. Süreçteki özel nedenler farklı örüntüler oluşturabilir:
- ortalama kayması,
- artan veya azalan trend,
- çevrimsel davranış,
- sistematik değişim,
- olağan dışı varyans.
Bu örüntülerin otomatik tanınması bir sınıflandırma problemine dönüştürülebilir.
Örnek vektörlerinin oluşturulması
Kontrol grafiğinden ardışık n ölçüm alınarak bir giriş vektörü oluşturulabilir:
x = [x1, x2, ..., xn]
Her vektör bilinen bir proses durumuyla etiketlenir.
Örnek sınıflar:
- normal,
- yukarı trend,
- aşağı trend,
- yukarı kayma,
- aşağı kayma.
LVQ prototipleri bu sınıfların tipik şekillerini temsil edecek biçimde öğrenir.
Eğitim
Eğitim sürecinde her kontrol örüntüsü ağa verilir. En yakın prototip bulunur. Prototipin sınıfına göre yaklaştırma veya uzaklaştırma işlemi uygulanır.
Eğitimin sonunda yeni bir örüntü en yakın prototipe göre sınıflandırılır.
Değerlendirme
Bir örüntü tanıma sisteminde yalnız eğitim başarımı ölçülmemelidir. Karışıklık matrisi üzerinden hangi proses bozukluklarının birbirine karıştırıldığı incelenmelidir.
Özellikle erken arıza belirlemede iki hata farklı maliyet taşır:
- yanlış alarm,
- gerçek bozukluğu kaçırma.
Bu nedenle precision, recall ve sınıf bazlı hata oranları önemlidir.
Güncel yaklaşım
LVQ düşük boyutlu ve önceden çıkarılmış özelliklerde kullanılabilir. Daha karmaşık sensör dizilerinde CNN, recurrent ağ veya Transformer tabanlı zaman serisi modelleri tercih edilebilir.
Yine de problem kurma biçimi değişmez:
- Süreç durumlarını tanımla.
- Gözlem penceresini oluştur.
- Eğitim ve test verisini ayır.
- Modeli eğit.
- Yanlış alarm ve kaçırma maliyetlerini ölç.
- Gerçek üretim koşullarında doğrula.
Ünite 7: Adaptif Rezonans Teorisi Ağları
Kararlılık ve plastisite problemi
Öğretmensiz öğrenmede önemli sorunlardan biri yeni bilgiyi öğrenirken eski bilgiyi korumaktır.
Sistem çok plastikse yeni örnekler eski sınıfları sürekli değiştirir.
Sistem çok kararlıysa yeni örüntüleri öğrenemez.
Bu gerilim stability-plasticity dilemma olarak bilinir.
Adaptive Resonance Theory, yani ART, bu probleme yönelik bir sinir ağı ailesidir.
ART'nin temel yaklaşımı
ART ağı yeni girdiyi mevcut kategorilerle karşılaştırır.
Yeterli benzerlik varsa girdi mevcut kategoriye atanır ve kategori prototipi güncellenir.
Benzerlik yetersizse mevcut aday reddedilir ve başka kategori aranır. Uygun kategori bulunamazsa yeni kategori oluşturulur.
Bu davranışta vigilance parametresi kritik rol oynar.
Yüksek vigilance daha ince sınıflar üretir.
Düşük vigilance daha geniş örüntüleri aynı sınıfta birleştirir.
F1 ve F2 katmanları
Klasik ART mimarisinde iki temel katman vardır.
F1 karşılaştırma katmanı, giriş örüntüsünü ve üstten gelen kategori beklentisini karşılaştırır.
F2 tanıma katmanı, kategori birimlerini içerir. Birimler rekabet eder ve kazanan kategori belirlenir.
F1 ile F2 arasında aşağıdan yukarı ve yukarıdan aşağı bağlantılar bulunur.
Rezonans ve reset
Kazanan kategori girdiyi yeterince iyi açıklıyorsa sistem rezonans durumuna geçer. Ağırlıklar güncellenir.
Benzerlik vigilance eşiğinin altındaysa reset mekanizması bu kategoriyi geçici olarak devre dışı bırakır. Ağ sonraki en uygun kategoriyi dener.
Bu çevrim uygun kategori bulunana veya yeni kategori oluşturulana kadar devam eder.
ART1
ART1 ikili giriş örüntüleri için geliştirilmiştir.
Girdi:
x in {0,1}^n
şeklindedir.
Kategori benzerliği ortak etkin bitlerin miktarı üzerinden değerlendirilebilir. Kavramsal vigilance koşulu:
match(x, w_j) >= rho
biçimindedir.
rho vigilance parametresidir.
ART1'in amacı benzer ikili örüntüleri çevrim içi biçimde kategorilere ayırmaktır.
ART2
ART2 sürekli değerli girişler için geliştirilmiştir. Girdi normalizasyonu ve daha ayrıntılı F1 dinamikleri kullanır.
Temel prensip yine aynıdır:
- Girdiyi al.
- Mevcut kategorilerle karşılaştır.
- En uygun kategoriyi seç.
- Vigilance koşulunu sınar.
- Uygunsa öğren.
- Değilse kategoriyi resetle ve yeniden ara.
ART ağlarının özellikleri
ART ailesinin güçlü yönleri:
- çevrim içi kategori oluşturabilme,
- yeni örüntülere uyum,
- mevcut kategorileri tamamen unutmadan öğrenme amacı,
- küme sayısının baştan kesin bilinmesini gerektirmemesi.
Sınırlılıkları:
- vigilance parametresine yüksek duyarlılık,
- örnek sırasına duyarlılık,
- modern yüksek boyutlu temsillerde doğrudan kullanımın sınırlı olması.
ART günümüzde derin öğrenmenin ana akım mimarilerinden biri değildir. Ancak çevrim içi öğrenme, kategori oluşumu ve catastrophic forgetting problemini anlamak için önemlidir.
Ünite 8: ART1 ile Grup Teknolojisi Uygulaması
Grup teknolojisi
Grup teknolojisi, benzer üretim gereksinimlerine sahip parçaları ve bu parçaları işleyen makineleri hücreler halinde düzenlemeyi amaçlar.
Amaçlar:
- parça taşıma mesafesini azaltmak,
- ara stokları azaltmak,
- makine kullanımını düzenlemek,
- üretim akışını sadeleştirmek.
Problem ikili makine-parça matrisiyle gösterilebilir.
a_ij = 1 ise parça j, makine i üzerinde işlem görür.
a_ij = 0 ise görmez.
ART1 ile sınıflandırma
Her makine, işlediği parçaları gösteren ikili vektörle temsil edilebilir.
Örnek:
M1 = [1, 1, 0, 0, 1]
M2 = [1, 1, 0, 0, 0]
M3 = [0, 0, 1, 1, 0]
ART1 benzer işlem profillerine sahip makineleri aynı kategoriye yerleştirebilir.
Bu kategoriler üretim hücreleri için aday gruplar oluşturur.
İteratif çalışma
Her giriş vektörü için:
- En uygun mevcut kategori belirlenir.
- Eşleşme vigilance eşiğiyle karşılaştırılır.
- Eşik sağlanırsa kategori prototipi güncellenir.
- Sağlanmazsa kategori reddedilir.
- Başka kategori denenir veya yeni kategori açılır.
Örnekler ağa tekrar sunulduğunda kategoriler kararlı hale gelebilir.
Mühendislik değerlendirmesi
Yalnız sınıflandırma sonucu üretim sistemi için yeterli değildir. Hücre tasarımında ayrıca:
- makine kapasitesi,
- operasyon sırası,
- üretim hacmi,
- taşıma maliyeti,
- darboğazlar,
- bakım planları
gibi kısıtlar bulunur.
Bu nedenle ART1 sınıflandırması karar destek girdisi olarak düşünülebilir. Nihai üretim hücresi tasarımı çok ölçütlü bir optimizasyon problemidir.
Ünite 9: Geri Dönüşümlü Ağlar ve Elman Ağı
Bu ünite, gizli durumun zaman boyunca taşınmasını ve paylaşılan parametrelerle ardışık verinin modellenmesini ele alır.
x(t-1) -> h(t-1) -> y(t-1)
            |
            v
x(t)   ->  h(t)   -> y(t)
            |
            v
x(t+1) -> h(t+1) -> y(t+1)

zaman boyunca açılım, paylaşılan parametreler
Geri dönüşümlü ağ kavramı
İleri beslemeli ağda çıktı yalnız mevcut girdinin katmanlardan geçirilmesiyle hesaplanır. Zaman bağımlılığı doğrudan temsil edilmez.
Recurrent Neural Network, yani RNN, geçmiş durumu mevcut hesaplamaya dahil eder:
h_t = phi(W_x*x_t + W_h*h_(t-1) + b)
y_t = psi(W_y*h_t + c)
Burada h_t ağın zamana bağlı gizli durumudur.
Bu yapı dizisel verilerde belleğe benzer bir davranış sağlar.
Elman ağı
Elman ağı kısmi geri beslemeli klasik RNN yapısıdır. Gizli katmanın bir önceki zamandaki çıktısı context unit adı verilen birimlerde tutulur ve bir sonraki adımda girişe eklenir.
Temel ilişki:
h_t = phi(W_x*x_t + W_c*h_(t-1) + b_h)
y_t = psi(W_y*h_t + b_y)
şeklindedir.
Bu nedenle ağın t anındaki çıktısı yalnız x_t girdisine değil, geçmişten taşınan h_(t-1) durumuna da bağlıdır.
Çalışma prensibi
Her zaman adımında:
- Mevcut girdi alınır.
- Önceki gizli durum context girişine eklenir.
- Gizli katman hesaplanır.
- Çıktı üretilir.
- Yeni gizli durum bir sonraki zaman adımı için saklanır.
Başlangıç gizli durumu sıfır veya sabit bir değer olabilir.
Zaman boyunca geri yayılım
RNN eğitiminde aynı ağ zaman ekseni boyunca açılmış gibi düşünülür. Kayıp gradyanı geçmiş adımlara doğru aktarılır. Bu yöntem Backpropagation Through Time, BPTT olarak bilinir.
Uzun dizilerde gradyanlar tekrar tekrar aynı tür Jacobian çarpımlarından geçtiği için küçülebilir veya büyüyebilir.
Bunlar:
- vanishing gradient,
- exploding gradient
problemleridir.
Gradient clipping büyüyen gradyanları sınırlamak için kullanılabilir.
LSTM, GRU, Attention ve Transformer
LSTM/GRU, attention ve Transformer tabanlı dizisel modelleme Ünite 11'de ayrıntılandırılır.
Ünite 10: Uygulama Alanlarında Model Seçimi ve Değerlendirme
Model değerlendirme ölçütleri uygulama alanına göre değişir. Doğruluk (accuracy) yanında gecikme (gecikme (latency)), hata maliyeti, kalibrasyon (calibration), dağılım kayması (dağılım kayması), kaynak bütçesi ve güvenilirlik birlikte ele alınmalıdır. Genel kullanım alanları, avantajlar ve sınırlılıklar için Yapay Zeka ve Yapay Sinir Ağları bölümüne bakılabilir.
Uygulama Seçimi
Bir Artificial Neural Network kullanılmadan önce problemin learning-based bir çözüme gerçekten uygun olup olmadığı belirlenmelidir. Doğrusal olmayan ilişki, yüksek boyutlu data, çok sayıda örnek, elle kural yazmanın güç olması ve karmaşık örüntüler ANN kullanımını anlamlı kılabilir; açık ve doğrulanmış algoritmik çözümü bulunan basit bir problemde ise sinir ağı gereksiz olabilir.
Endüstriyel Sistemler
Endüstriyel sistemlerde doğruluk (accuracy) kadar gecikme (gecikme), belirlenimci davranış (belirlenimci davranış), dağılım kayması (dağılım kayması) ve hata durumundaki güvenli davranış (güvenli davranış) önemlidir.
Finansal Sistemler
Finansal veride geçmiş performans gelecekteki performansı garanti etmez. Rejim değişimi, veri sızıntısı (veri sızıntısı (data leakage)) ve seçilim yanlılığı (seçilim yanlılığı) model değerlendirmesinde kritik risklerdir.
Askeri ve Güvenlik Sistemleri
Yanlış pozitif ve yanlış negatif maliyetleri aynı değildir. Model performance; operasyonel koşullar, dağılım kayması ve adversarial effects dikkate alınarak değerlendirilmelidir.
Sağlık Sistemleri
Klinik kullanımda model doğruluğu (accuracy) tek başına yeterli değildir. Veri temsilinde adalet (data representation fairness), kalibrasyon (calibration), dış doğrulama (external validation) ve insan gözetimi (insan gözetimi) birlikte değerlendirilmelidir.
Veri Türü ve Model Seçimi
Image, audio, text ve time-series verilerinin yapısal özellikleri farklıdır. Model ailesi veri türüne göre mekanik biçimde değil; temsil yapısı, gecikme, memory, compute budget, hata maliyeti ve doğrulama gereksinimi birlikte değerlendirilerek seçilmelidir.
Mühendislik açısından en iyi model en büyük model değildir. Gereksinimi en düşük toplam maliyetle ve yeterli güvenilirlikle karşılayan modeldir.
Ünite 11: Diğer Modeller ve Güncel Yaklaşımlar
Hopfield ağı
Hopfield ağı tamamen bağlı recurrent bir ağdır. Klasik biçiminde simetrik ağırlıklarla çalışır ve bir enerji fonksiyonunu azaltan dinamik sistem olarak yorumlanabilir.
Temel kullanım alanı çağrışımsal bellektir. Eksik veya bozulmuş örüntü ağın kararlı durumlarından birine çekilebilir.
Hopfield ağları modern derin öğrenmenin ana mimarisi değildir. Ancak enerji tabanlı modeller ve çağrışımsal bellek açısından temel tarihsel öneme sahiptir.
Counterpropagation ağı
Counterpropagation ağı rekabetçi Kohonen katmanı ile öğretmenli Grossberg çıkış katmanını birleştirir.
Kohonen katmanı giriş uzayında prototip seçimi yapar. Grossberg katmanı kazanan prototipi hedef çıktıyla eşler.
Bu yapı hızlı prototip tabanlı fonksiyon yaklaşımı olarak düşünülebilir.
Cognitron ve Neocognitron
Fukushima'nın Cognitron ve Neocognitron modelleri görsel örüntü tanıma tarihinde önemlidir.
Neocognitron yerel alıcı alanlar, hiyerarşik özellik çıkarımı ve konum değişimlerine karşı dayanıklılık fikirlerini kullanır. Bu kavramlar daha sonra modern convolutional neural network tasarımında merkezi hale gelmiştir.
Self-Organizing Map
Kohonen Self-Organizing Map, öğretmensiz rekabetçi öğrenme yöntemidir. Yüksek boyutlu veriyi genellikle iki boyutlu bir harita üzerinde topolojik komşuluğu mümkün olduğunca koruyarak temsil etmeye çalışır.
Kazanan nöron ve komşuları girdiye doğru güncellenir:
w_i <- w_i + alpha * h_ci * (x - w_i)
Burada h_ci kazanan nörona topolojik uzaklığa bağlı komşuluk fonksiyonudur.
SOM kümeleme, görselleştirme ve keşifsel veri analizi için öğretici önem taşır.
Radyal tabanlı ağlar
Radial Basis Function Network gizli katmanda giriş ile merkezler arasındaki uzaklığa bağlı aktivasyonlar kullanır.
Gaussian RBF için:
phi_i(x) = exp(-||x-c_i||^2 / (2*sigma_i^2))
Çıkış genellikle bu taban fonksiyonlarının doğrusal birleşimidir.
RBF ağları yerel yaklaşım özellikleri nedeniyle regresyon ve sınıflandırmada kullanılabilir.
Olasılıksal sinir ağları
Probabilistic Neural Network sınıf koşullu yoğunluk kestirimi ve Bayes karar kuralıyla ilişkilidir. Eğitim hızlı olabilir ancak örnek sayısı büyüdükçe çıkarım maliyeti artabilir.
Boltzmann makineleri
Boltzmann machine stokastik, enerji tabanlı bir ağ ailesidir. Restricted Boltzmann Machine görünür ve gizli birimler arasında iki parçalı bağlantı yapısı kullanarak öğrenmeyi daha yönetilebilir hale getirir.
Derin öğrenmenin erken dönem yeniden canlanmasında RBM ve Deep Belief Network çalışmaları etkili olmuştur. Güncel büyük ölçekli sistemlerde ise ana akım model ailesi değildir.
Convolutional Neural Network
CNN, görüntü gibi düzenli ızgara verilerinde yerel bağlantı ve ağırlık paylaşımı kullanır.
Bir filtre aynı ağırlıklarla farklı uzamsal konumlarda uygulanır. Böylece parametre sayısı tam bağlı katmana göre azalır ve yerel örüntüler öğrenilebilir.
Modern CNN mimarilerinde:
- convolution,
- nonlinear activation,
- normalleştirme,
- residual connection,
- downsampling
gibi yapılar birlikte kullanılabilir.
ResNet, residual bağlantı kullanarak çok derin ağların optimizasyonunu kolaylaştırmıştır.
LSTM ve GRU
LSTM ve GRU recurrent ağların uzun dönemli bağımlılık sorununa yönelik kapılı yapılardır.
LSTM'de hücre durumu kontrollü bilgi yolu sağlar. GRU daha kompakt bir kapı yapısına sahiptir.
Bu modeller zaman serisi ve dizisel veriler için halen yararlı olabilir. Özellikle küçük veya çevrim içi sistemlerde recurrence doğrudan ve düşük gecikmeli bir durum modeli sunabilir.
Attention
Attention mekanizması bir sorgunun diğer temsillerden hangilerine ne ölçüde bakacağını öğrenir.
Scaled dot-product attention temel olarak:
Attention(Q,K,V) = softmax(QK^T / sqrt(d_k)) V
şeklindedir.
Bu mekanizma uzun mesafeli bağımlılıkların doğrudan modellenmesine imkan verir.
Transformer
Transformer, recurrence yerine self-attention ve feed-forward katmanları kullanır.
Temel bileşenleri:
- token veya patch embedding,
- positional information,
- multi-head attention,
- feed-forward network,
- residual connection,
- normalleştirme.
Transformer mimarisi doğal dil işleme ile başlamış, daha sonra görüntü, ses, zaman serisi ve çok modlu modellemeye yayılmıştır.
Autoencoder
Autoencoder girdiyi sıkıştırılmış bir temsil üzerinden yeniden oluşturmaya çalışır.
z = encoder(x)
xhat = decoder(z)
Amaç:
xhat ~= x
olmasıdır.
Autoencoder boyut indirgeme, temsil öğrenme, anomali belirleme ve generative modelleme için temel bir yapıdır.
Generative Adversarial Network
GAN iki ağın karşıt amaçlarla eğitildiği generative modeldir.
Generator gerçek veri dağılımına benzeyen örnekler üretir.
Discriminator gerçek ve üretilmiş örnekleri ayırt etmeye çalışır.
İki model minimax oyun içinde birlikte gelişir.
GAN'ler yüksek kaliteli sentez üretmiş olsa da eğitim kararsızlığı ve mode collapse gibi sorunlar yaşayabilir.
Diffusion modelleri
Diffusion modelleri veriye kademeli gürültü ekleyen bir ileri süreç ve bu gürültüyü öğrenerek tersine çeviren bir üretim süreci kullanır.
Görüntü ve ses üretiminde güçlü generative model ailesi haline gelmiştir.
Temel fikir, karmaşık veri dağılımından doğrudan örneklemek yerine gürültü giderme adımlarını öğrenmektir.
Kendinden öğretmenli temsil öğrenme
Büyük etiketli veri kümeleri pahalıdır. Kendinden öğretmenli öğrenme hedefi verinin kendisinden üretir.
Örnek hedefler:
- maskelenmiş parçayı tahmin etmek,
- sonraki tokenı tahmin etmek,
- farklı görünümlerin aynı örneğe ait olduğunu öğrenmek.
Bu yaklaşım büyük modellerin çok büyük etiketsiz veri üzerinde ön eğitim almasını sağlar.
Düzenlileştirme
Modern ağlarda aşırı uyumu azaltmak için birden fazla teknik birlikte kullanılabilir.
Weight decay: Büyük ağırlıkları cezalandırır.
Dropout: Eğitim sırasında bazı aktivasyonları rastgele sıfırlar.
Data augmentation: Eğitim örneklerinin anlamı koruyan dönüşümlerini üretir.
Early stopping: Doğrulama başarımı kötüleşmeden eğitimi durdurur.
Normalizasyon
Batch Normalleştirme, mini-batch istatistiklerini kullanarak katman aktivasyonlarını normalleştirir ve öğrenilebilir ölçek/kaydırma parametreleri ekler.
Transformer mimarilerinde Layer Normalleştirme daha yaygındır. Normalizasyon seçimi mimariye ve batch yapısına bağlıdır.
Modern optimizasyon
SGD ve momentum temel yöntemlerdir.
Adam, gradyanın birinci ve ikinci moment tahminlerini kullanarak parametre başına uyarlanmış güncelleme büyüklüğü oluşturur.
AdamW, weight decay ile gradyan tabanlı L2 cezasını ayırarak pratik derin öğrenme eğitiminde yaygınlaşmıştır.
Optimizer seçimi tek başına yeterli değildir. Learning-rate schedule, warmup, batch büyüklüğü ve sayısal hassasiyet birlikte eğitim dinamiğini belirler.
Yapay sinir ağı simülatörlerinden öğrenme çerçevelerine
Eski yapay sinir ağı araçları belirli ağ modellerini menüler veya sabit simülatörler üzerinden kuruyordu. Güncel yaklaşım genel amaçlı otomatik türev ve tensor hesaplama çerçeveleridir.
Yaygın ekosistemler:
- PyTorch,
- TensorFlow/Keras,
- JAX.
Bu araçlar model tanımından çok daha fazlasını sağlar:
- otomatik türev,
- GPU ve hızlandırıcı desteği,
- dağıtık eğitim,
- mixed precision,
- veri yükleme,
- model serileştirme.
Araç değişse de temel matematik değişmez. Öğrencinin önce ileri geçişi, kayıp fonksiyonunu, gradyanı ve optimizasyonu anlaması gerekir.
Güncel mühendislik ilkeleri
Bir sinir ağı sistemi tasarlanırken şu sıra izlenmelidir:
- Problemi ve hata maliyetini tanımla.
- Basit bir baseline kur.
- Eğitim, doğrulama ve test ayrımını doğru yap.
- Veri sızıntısını engelle.
- Uygun model kapasitesini seç.
- Performansı yalnız tek bir ölçütle değerlendirme.
- Dağılım değişimini ölç.
- Gecikme, işlem hacmi, bellek ve enerji maliyetini hesaba kat.
- Modeli üretim verisi üzerinde izle.
- Yeniden eğitim ve sürümleme sürecini tasarla.
Sinir ağı mühendisliğinde asıl başarı yalnız yüksek doğruluk değildir. Modelin gerçek kullanım koşullarında güvenilir, ölçülebilir ve sürdürülebilir davranmasıdır.
Online veya continual learning tasarlanıyorsa backward compatibility, catastrophic forgetting, validation, versioning ve rollback birlikte ele alınmalıdır. Güvenilirlik sınırı ayrıca out-of-distribution inputs, adversarial examples, miscalibration, data poisoning, privacy ve insan gözetimi risklerini kapsar. Bu nedenle ilerleme yalnız yeni model adlarıyla değil; algorithm + data + hardware + validation + operation bütünlüğüyle değerlendirilmelidir.
Model deneylerinin kaydı, ablation ve üretim gözlemi
Bir model geliştirme çalışmasında son metriği kaydetmek deneyin tamamını kaydetmek değildir. Aynı sonucu yeniden değerlendirebilmek için karşılaştırılan baseline, veri sürümü, önişleme, model yapılandırması, hiperparametreler, değerlendirme kümesi ve metrik tanımı birlikte izlenmelidir.
baseline
→ tek kontrollü değişiklik
→ aynı değerlendirme protokolü
→ sonuç
→ yorum
Bu düzen, aynı anda birçok şeyi değiştirip hangi bileşenin kazanç sağladığını belirsiz bırakmaktan daha güçlü kanıt üretir.
Hiperparametre araması ve değerlendirme disiplini
Grid search, rastgele arama veya olasılıksal optimizasyon gibi yöntemler farklı deneme noktaları üretir. Arama yönteminin gelişmiş olması, değerlendirme protokolünün doğru olduğu anlamına gelmez. Hiperparametre seçimi doğrulama verisi üzerinde yapılmalı; nihai test kümesi sürekli seçim döngüsüne katılmamalıdır.
Çok sayıda deney çalıştırıldığında yalnız en yüksek metriği seçmek de yanıltıcı olabilir. Deneyler aynı veri bölünmeleri, aynı ön işleme ve aynı temel ölçütlerle karşılaştırılmalı; mümkün olduğunda değişkenliğin kaynağı ayrıca incelenmelidir.
Ablation çalışması
Ablation, bir model bileşeninin veya veri/özellik grubunun sonuca katkısını anlamak için o parçayı kaldırıp kontrollü karşılaştırma yapar.
Model A
Model A - bileşen X
Model A - özellik grubu Y
Model A - veri artırma Z
Ablation sıradan yazılım testinin yerine geçmez. Test, belirli davranışın gereksinimi sağlayıp sağlamadığını sınayabilir; ablation ise “bu bileşen gözlenen performansa ne kadar katkı sağlıyor?” sorusuna yaklaşır. İki kanıt türü birbirini tamamlar.
Hata dilimleri ve açıklanabilirlik
Tek ortalama skor, modelin hangi veri bölgelerinde hata yaptığını gizleyebilir. Sınıf, zaman, kaynak, cihaz, sinyal kalitesi veya başka anlamlı dilimlerde hata oranını incelemek model davranışını daha görünür kılar. Regresyon problemlerinde artık grafikleri ve sistematik hata örüntüleri, sınıflandırmada confusion matrix ve sınıf bazlı ölçütler benzer amaç taşır.
SHAP gibi açıklanabilirlik yöntemleri model kararına hangi özelliklerin katkıda bulunduğunu incelemek için yararlıdır; fakat özellik katkısı nedensellik kanıtı değildir. Açıklama yöntemi de kendi varsayımları ve yaklaşık hesapları olan ayrı bir analiz katmanıdır.
Üretim gözlemi ve drift
Doğrulama kümesindeki başarı üretim davranışının sonsuza kadar aynı kalacağını garanti etmez. Girdi dağılımı, sınıf oranı, sensör veya istemci davranışı değişebilir. Bunun yanında gecikme, bellek ve hata oranı gibi sistem ölçütleri de izlenmelidir.
offline değerlendirme
→ kontrollü dağıtım
→ veri ve model gözlemi
→ drift / hata dilimi analizi
→ yeniden eğitim ya da geri dönüş kararı
Online veya incremental learning yeni veriye daha hızlı uyum sağlayabilir; ancak yanlış etiket, ani dağılım değişimi veya geri döndürülemeyen güncelleme riski getirir. Bu nedenle güncelleme ölçütü, veri kalitesi kontrolü, model sürümü ve geri dönüş yolu açık olmalıdır.
Model yaşam döngüsünün konfigürasyon ve sürümleme tarafı Yazılım Mühendisliği, doğrulama kanıtının kapsamı ise Yazılım Test Mühendisliği derslerinde tamamlanır.
İlgili Konular
Yapay nöron, activation function, layer structure ve learning paradigms için Yapay Zeka ve Yapay Sinir Ağları bölümüne; Artificial Intelligence (AI) alanının felsefi ve kuramsal çerçevesi için Yapay Zeka: Felsefe, Kuram ve Uygulama bölümüne bakılabilir.
Kalibrasyon, eşik seçimi ve hata dilimleri
Bir modelin sıralama başarısı ile verdiği olasılıkların anlamlı olması farklı problemlerdir. İyi AUC değerine sahip bir sınıflandırıcı kötü kalibre olabilir; %0,9 çıktısı gerçekten yaklaşık %90 gerçekleşme oranına karşılık gelmeyebilir. Kalibrasyon eğrileri ve Brier skoru bu ayrımı görünür kılar.
Karar eşiği, 0,5 gibi alışkanlıkla seçilmemelidir. Yanlış pozitif ile yanlış negatif maliyeti, kapasite sınırı ve hedef recall/precision dengesi iş problemine göre belirlenmelidir.
Toplam metrik de alt gruplardaki sorunu gizleyebilir. Cihaz türü, veri kaynağı, gürültü seviyesi, coğrafi bölge veya zaman dilimi gibi anlamlı dilimlerde hata dağılımı incelenmeli; küçük örneklemli dilimler belirsizlik aralığıyla raporlanmalıdır.
Öğrenme deneyini yeniden üretilebilir kurmak
Ağ mimarisi tek başına deney tanımı değildir. Veri sürümü, normalizasyon, augmentation, seed, optimizer, öğrenme oranı, batch büyüklüğü, erken durdurma ve model seçme ölçütü sonuçla birlikte kaydedilmelidir.
Train/validation/test ayrımı model seçiminden önce belirlenmelidir. Test kümesi hiperparametre ayarlamak için tekrar tekrar kullanılırsa artık bağımsız test işlevini kaybeder. Küçük veri kümelerinde tekrar edilmiş cross-validation veya güven aralıkları, tek bir bölmeden daha anlamlı olabilir.
Bir modelin başarısız olduğu örnekler de sonuçtur. Hata dilimleri; sınıf, kaynak, gürültü, cihaz, aydınlatma veya benzeri anlamlı eksenlerde incelendiğinde toplam metrikte görünmeyen zayıflıklar ortaya çıkar.
Öğrenme sonucunu modelden ayırmak
Bir sinir ağı sorusunda mimari, eğitim amacı ve değerlendirme ölçütü ayrı katmanlardır. Aktivasyon fonksiyonu katmandaki doğrusal olmayan dönüşümü, kayıp fonksiyonu eğitim sırasında hangi hatanın küçültüldüğünü, metrik ise sonucun nasıl raporlandığını belirler. Örneğin sınıflandırmada çapraz entropi ile eğitim yapılırken başarı oranı ayrı bir değerlendirme metriği olabilir.
Geri yayılım yeni bir tahmin yöntemi değil, zincir kuralı üzerinden gradyanları hesaplama yöntemidir. Ağırlık güncellemesinin yönü ve büyüklüğü ise optimizer ile belirlenir. Öğrenme oranı çok büyük olduğunda iterasyonlar kararsızlaşabilir, çok küçük olduğunda ilerleme aşırı yavaşlayabilir.
Eğitim, doğrulama ve test kümelerinin görevleri de karıştırılmamalıdır. Eğitim verisi parametreleri öğrenir. Doğrulama kümesi model veya hiperparametre seçimine yardım eder. Test kümesi bu seçim sürecinden bağımsız kalabildiği ölçüde son genelleme tahmini verir. Test sonucuna tekrar tekrar bakarak tasarım değiştirmek, test verisini fiilen doğrulama verisine dönüştürür.
Aşırı öğrenme yalnız eğitim hatasının düşük olması değildir; eğitim ve görülmemiş veri davranışı arasındaki farkla ilgilidir. Düzenlileştirme, veri artırma, erken durdurma veya daha uygun model kapasitesi bu farkı azaltmaya çalışabilir. Buna karşılık eğitim hatasının yüksek kalması yetersiz model, kötü optimizasyon, veri sorunu veya yanlış özellik ölçekleme gibi farklı nedenlerden kaynaklanabilir.
Sınıflandırıcı çıktısındaki yüksek skor da otomatik olarak iyi kalibrasyon anlamına gelmez. %90 olarak raporlanan örneklerin gerçekten yaklaşık %90 oranında doğru olması ayrı bir özelliktir. Bu nedenle doğruluk, kalibrasyon ve karar eşiği özellikle dengesiz sınıflarda birlikte incelenmelidir.
Ünite 12: Üretken Sinir Ağı Aileleri
Üretken modeller yalnız büyük dil modellerinden oluşmaz. Yapay sinir ağlarının tarihsel gelişiminde VAE, GAN, difüzyon ve otoregresif Transformer farklı üretim varsayımları geliştirmiştir.
Varyasyonel otokodlayıcı
VAE, veriyi olasılıksal bir gizil uzaya kodlayıp bu uzaydan örnek üretir.
x
 |
Encoder
 |
q(z|x)
 |
 z
 |
Decoder
 |
x'
Kayıp yalnız yeniden oluşturma hatasından oluşmaz; gizil dağılımın düzenli bir prior'a yakınlaşmasını teşvik eden terim de bulunur. Böylece gizil uzayda örnekleme yapılabilir.
Üretici çekişmeli ağ
GAN iki ağın rekabetine dayanır.
noise -> Generator -> fake sample
                       |
real sample ------------+--> Discriminator
Üretici gerçekçi örnek üretmeye, ayırt edici gerçek ve üretilmiş örneği ayırmaya çalışır. Eğitim dinamiği güçlü sonuçlar üretebilir ancak kararsızlık ve mode collapse gibi sorunlar doğurabilir.
Difüzyon modelleri
Difüzyon yaklaşımı veriye kademeli gürültü ekleyen ileri süreç ile gürültüden veri yapısını geri kurmayı öğrenen ters süreci kullanır.
data -> noise -> noise -> ...
                    |
                    v
              learned reverse
                    |
                  sample
Örnek üretim çoğu zaman birden fazla denoising adımı gerektirir.
Otoregresif Transformer
Dil modelinde üretim:
x1 -> x2 -> x3 -> x4 ...biçiminde koşullu olasılıkla ilerler.
Bu aileleri tek “üretken yapay zekâ” etiketi altında toplamak mümkündür; ancak eğitim hedefi, örnekleme maliyeti, veri kipleri ve hata türleri farklıdır.
Ünite 13: Transformer da Bir Yapay Sinir Ağıdır
Transformer, yapay sinir ağlarından ayrı bir paradigma değildir. Attention, doğrusal dönüşümler, normalizasyon ve ileri beslemeli ağ bloklarından oluşan eğitilebilir sinir ağı mimarisidir.
token representations
      |
self-attention
      |
feed-forward network
      |
next layer
Bu nedenle “sinir ağlarından LLM'lere geçildi” ifadesi tarihsel olarak yanıltıcı olabilir. LLM'lerin büyük bölümü yapay sinir ağlarının Transformer tabanlı büyük ölçekli uygulamalarıdır.
Ünite 14: Model Küçültmede Budama, Damıtma ve Nicemleme
Üretimde yalnız doğruluk değil bellek, gecikme ve enerji de önemlidir.
Budama (pruning) düşük katkılı ağırlık veya yapıların çıkarılmasıdır.
Damıtma (distillation) büyük öğretmen modelin davranışını küçük öğrenci modele aktarmaya çalışır.
Nicemleme (quantization) sayısal gösterim hassasiyetini düşürür.
Training / Model
    |
    +--> pruning
    +--> distillation
    +--> quantization
    |
    v
Deployment trade-off
Bunlar aynı teknik değildir ve birlikte de kullanılabilir.
Nicemleme modelin öğrenme kuramını değiştirmeden deployment maliyetini düşürebilir; ancak çok düşük hassasiyet bazı katmanlarda kalite kaybı oluşturabilir. 1-bit/1.58-bit araştırmaları ise düşük bit gösterimini eğitim mimarisinin parçası hâline getiren daha ileri bir çizgidir; sıradan post-training quantization ile eşitlenmemelidir.
Model sıkıştırma değerlendirmesi yalnız dosya boyutu üzerinden yapılmamalıdır:
quality
gecikme
işleme kapasitesi
memory
energy
hardware support
birlikte ölçülmelidir.
Kaynakça
- David E. Rumelhart; Geoffrey E. Hinton; Ronald J. Williams. Learning Representations by Back-propagating Errors. Nature, 1986. DOI
- Frank Rosenblatt. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 1958. DOI
- Hinton, G.; Vinyals, O.; Dean, J. “Distilling the Knowledge in a Neural Network.” 2015. https://arxiv.org/abs/1503.02531
- Ho, J.; Jain, A.; Abbeel, P. “Denoising Diffusion Probabilistic Models.” NeurIPS, 2020. https://arxiv.org/abs/2006.11239
- Kingma, D. P.; Welling, M. “Auto-Encoding Variational Bayes.” 2013. https://arxiv.org/abs/1312.6114
- Sepp Hochreiter; Jürgen Schmidhuber. Long Short-Term Memory. Neural Computation, 1997. DOI
- Warren S. McCulloch; Walter Pitts. A Logical Calculus of the Ideas Immanent in Nervous Activity. Bulletin of Mathematical Biophysics, 1943. DOI
