Yazılım Test Mühendisliği: Gereksinimden Üretime Uygulamalı Doğrulama ve Geçerleme

Gereksinimin test edilebilir hâle getirilmesinden birim ve tümleştirme testlerine; TDD, property-based ve mutation testing, fuzzing, Testcontainers, performans, güvenlik, dayanıklılık, CI/CD ve üretim doğrulamasına uzanan uygulamalı yazılım test mühendisliği ders notu.
İyi bir test, yazılımın çalıştığını göstermekten önce hangi koşulda çalışmaması gerektiğini tarif eder. Test mühendisliğinin değeri yeşil bir raporda değil, yanlış bir varsayımı mümkün olduğunca erken ve mümkün olduğunca ucuz biçimde görünür kılmasındadır.
Ünite 1: Test Temelleri, Doğrulama, Geçerleme ve Risk
Giriş: Test etmek, hata aramak değil kanıt üretmektir
Bir projede test çalışmasını sonradan devreye soktuğumuzda tablo genellikle tanıdıktır: özellik tamamlanır, uygulama ayağa kaldırılır, birkaç mutlu yol elle denenir ve ancak bundan sonra otomasyona sıra gelir. Böyle kurulan test paketi çoğu zaman kodun arkasından yürür; yüzlerce senaryo yeşile döner, kod kapsamı yükselir, fakat ilk beklenmeyen veri, eşzamanlı istek, ağ gecikmesi ya da yanlış yapılandırma üretimde bambaşka bir davranış ortaya çıkarabilir.
Burada eksik olan çoğu zaman test sayısı değildir. Daha erken cevaplanması gereken soru şudur: Hangi davranış hakkında güven üretmeye çalışıyoruz ve bu güven hangi kanıta dayanacak?
Bir testi, küçük ve tekrar üretilebilir bir deney olarak düşünmek daha kullanışlıdır. Başlangıç durumunu kurar, sisteme belirli bir girdi veya olay uygular, gözlenebilir sonucu toplar ve bunu bağımsız biçimde tanımlanmış beklentiyle karşılaştırırız:
başlangıç durumu
       -> girdi / olay
       -> sistem davranışı
       -> gözlem
       -> beklenen sonuçla karşılaştırma
       -> karar
Zincirin bir halkası belirsiz olduğunda testin verdiği güven de belirsizleşir. Gereksinim açık değilse doğru sonucu tanımlayamayız; veri kontrolsüzse aynı koşulu yeniden kuramayız; ortam üretimden kopuksa yanlış bir temsil üzerinde doğru test yapmış oluruz. Gözlenebilirlik yetersizse hata oluşur ama test bunu göremez. Daha tehlikelisi, beklenen değeri üretim kodunun aynı hesabıyla türetmek test ile sistemin aynı yanlışı paylaşmasına yol açabilir.
Bu yüzden JUnit, Selenium, JMeter, Mockito veya herhangi bir CI aracını öğrenmek test mühendisliğinin ancak araç katmanını açıklar. Araç zamanla değişir; temel problem değişmez: Bir yazılım davranışının doğru olduğuna ne kadar güvenebiliriz ve bu güveni hangi bağımsız kanıtla gerekçelendirebiliriz?
Test faaliyeti gereksinimden üretime uzanan tek bir mühendislik problemidir. Test edilebilir gereksinimlerden birim, tümleştirme, sistem ve kabul seviyelerine; TDD ve test doubles'dan property-based testing, mutation testing ve fuzzing'e; veritabanı, API, web, mobil, performans, güvenlik, dayanıklılık ve eşzamanlılık testlerine kadar aynı kanıt zinciri sürer. Son durak CI/CD değildir; üretimde gözlenen davranış yeniden test tasarımına döner. Hedef bütün teknikleri projeye taşımak değil, belirli bir riski en düşük maliyetle ve yeterli kanıt gücüyle sınayacak yöntemi seçebilmektir.
Bu yaklaşım ISO/IEC/IEEE 29119 serisinin test kavramları, süreçleri, dokümantasyonu ve test tasarım teknikleriyle; ISO/IEC 25010:2023 kalite modeliyle; ISTQB CTFL 4.0.1'in risk ve test tasarımı yaklaşımıyla uyumludur. Kritik sistemlerde kalite güvencesini yaşam döngüsü boyunca ele alan IEEE 730 standardının 2026 revizyonu da aynı noktayı güçlendirir: test, son aşamadaki ayrı bir faaliyet değil, kaliteyi üretme sürecinin bir parçasıdır.
1. Kalite ile test aynı şey değildir
Bir yazılımın bütün testleri geçmesi onun kaliteli olduğunu garanti etmez. Test, kalite hakkında kanıt üretir; kaliteyi tek başına oluşturmaz.
Büyük sistemlerde kaliteyi yalnız hata sayısıyla tarif etmek yetersiz kalır. Fonksiyonel olarak doğru cevap veren bir servis 30 saniyede dönüyorsa kullanılabilirlik sorunu vardır; doğru sonucu üretirken belleği sürekli büyütüyorsa işletim sorunu vardır; başka kullanıcının nesnesine erişim denetimi yapmıyorsa güvenlik sorunu vardır. Benzer biçimde bütün işlevleri çalışan bir masaüstü uygulamasının yükseltme sırasında kullanıcı verisini bozması güvenilirlik problemidir. Fonksiyonel doğruluk, kalite tablosunun yalnız bir bölümünü açıklar.
ISO/IEC 25010:2023 ürün kalitesini dokuz ana karakteristik altında değerlendirir. Bir test stratejisi hazırlanırken bunların tümü aynı ağırlıkta olmak zorunda değildir; fakat hangilerinin ürün için kritik olduğu açıkça seçilmelidir. İşlevsel uygunluk, performans verimliliği, uyumluluk, etkileşim yeteneği, güvenilirlik, güvenlik, bakım yapılabilirlik, esneklik ve emniyet gibi özellikler farklı test kanıtları ister.
Bu ayrım bize ilk önemli prensibi verir:
Test kapsamını kaynak kod yapısı değil, ürünün kalite riski belirlemelidir.
Bir ödeme fonksiyonunda kuruş yuvarlama hatası kritik olabilir. Bir telemetri ekranında 100 ms gecikme kabul edilebilirken gerçek zamanlı bir kontrol döngüsünde aynı gecikme sistem davranışını değiştirebilir. Bir içerik sitesinde kısa süreli servis kesintisi tolere edilebilir; olay yönetim sisteminde aynı kesinti operasyonu durdurabilir.
Dolayısıyla “kaç testimiz var?” sorusu genellikle zayıf bir sorudur. Daha yararlı soru şudur:
Hangi kalite risklerini hangi kanıtlarla kontrol altına aldık ve nerelerde hâlâ belirsizlik var?
1.1 Kalite güvencesi, kalite kontrol ve test
Bu üç kavramı ayırmak uygulamada önemlidir.
Kalite güvencesi (Quality Assurance) kusurun ürüne yerleşmeden önce azaltılabileceği süreçleri kurar. Kod inceleme ilkeleri, Definition of Done, geliştirme standartları, test stratejisi, otomasyon politikası ve değişiklik yönetimi bunun parçasıdır.
Kalite kontrol (Quality Control) ortaya çıkan ürünün belirlenmiş kalite ölçütlerine ne ölçüde uyduğunu değerlendirir.
Test bu değerlendirmede merkezi bir araçtır; fakat tek kanıt kaynağı değildir. Statik analiz, teknik inceleme, biçimsel doğrulama, telemetri ve üretim ölçümleri farklı hata sınıfları hakkında testin ulaşamadığı kanıtı sağlayabilir.
Kaliteyi yalnız test ekibine bırakan organizasyonlarda tipik sonuç şudur: geliştirici üretir, testçi hata bulur, geliştirici düzeltir, testçi yeniden dener. Bu döngü kaliteyi üretmek yerine hatayı ekipler arasında dolaştırır. Daha olgun yaklaşım, test edilebilirliği tasarıma taşıyarak hatayı mümkün olduğunca oluştuğu katmana yakın yakalamaktır.
2. Doğrulama ve geçerleme: doğru ürünü doğru biçimde mi geliştiriyoruz?
Yazılım mühendisliğinde klasik ayrım hâlâ kullanışlıdır:
- Doğrulama (verification): Ürünü tanımlanan gereksinim ve tasarıma uygun mu geliştiriyoruz?
- Geçerleme (validation): Geliştirdiğimiz ürün gerçek kullanıcı ihtiyacını karşılıyor mu?
Bir sistem teknik şartnamedeki bütün maddeleri karşılayabilir ve yine de kullanıcı açısından başarısız olabilir. Bunun tersi de mümkündür: kullanıcı arayüzünde beklenen iş akışı çalışırken veri bütünlüğü, güvenlik veya hata durumları gereksinimleri ihlal edilebilir.
Dolayısıyla test planı yalnız gereksinim maddelerinin uygulandığını kontrol etmemeli; gereksinimin kendisinin ölçülebilir, çelişkisiz ve gerçek ihtiyacı temsil eder durumda olup olmadığını da sınamalıdır.
Örneğin aşağıdaki ifade test açısından zayıftır:
Sistem hızlı cevap vermelidir.Bunu sınayabilmek için bağlam gerekir:
P95 API yanıt süresi, 400 eşzamanlı oturum ve saniyede 1200 istek altında 250 ms'yi aşmamalıdır.
Hata oranı %0,1'in altında kalmalıdır.
Ölçüm 30 dakikalık kararlı yük bölümünde yapılmalıdır.
İkinci ifade yalnız daha ayrıntılı değildir; yanlışlanabilir olduğu için mühendislik açısından daha değerlidir.
Test edilebilir gereksinim yazmak, testçinin işinden önce analistin ve yazılım mühendisinin işidir.
3. Testin temel sınırı: tüm olasılıkları deneyemeyiz
Gerçek sistemlerin durum uzayı hızla patlar. Bir API'nin yalnızca on bağımsız boolean seçeneği varsa 1024 kombinasyon oluşur. Her biri 10 değer alabilen on alan teorik olarak 10^10 kombinasyona ulaşır. Buna kullanıcı rolleri, veri durumu, tarih, dil, ağ davranışı, işlem sırası ve eşzamanlılık eklendiğinde kapsamlı exhaustive testing pratik olarak imkânsızdır.
Profesyonel test mühendisliğinin asıl işi burada başlar: bütün olasılıkları tüketmeye çalışmak yerine, risk hakkında en fazla bilgi üreten örnekleri seçmek.
Buradan birkaç temel sonuç çıkar:
- Test her zaman örnekleme yapar.
- Örnekleme risk bilgisine dayanmalıdır.
- Aynı davranışı tekrar tekrar sınayan yüz test, yeni bir sınır koşulunu sınayan tek testten daha az değerli olabilir.
- Testlerin geçmesi hata olmadığını değil, test edilen örneklerde gözlenebilir hata bulunmadığını gösterir.
- Yeni testler yalnız yeni kod için değil, yeni bilgi için yazılmalıdır.
Bu nedenle bir test paketini test sayısıyla değerlendirmem. Daha anlamlı ölçü, ürettiği bilginin yoğunluğudur: başarısız olduğunda bozulan davranışı daraltabiliyor mu, geçtiğinde hangi risk hakkında güven verdiği belli mi, aynı varsayımı daha ucuz sınayabilecek başka bir katman var mı?
4. Risk tabanlı test: önce nerede yanılmanın pahalı olduğunu bulun
Her testin maliyeti vardır. Yazılması, çalıştırılması, verisinin hazırlanması, başarısızlığının analiz edilmesi ve zaman içinde bakımı gerekir. Bu maliyet sınırsız olmadığı için test yatırımını riskle ilişkilendirmek gerekir.
Basit bir düşünme modeli:
Risk ≈ gerçekleşme olasılığı × etkiBu formül nicel kesinlik iddiası taşımaz; önceliklendirme aracıdır. Daha ayrıntılı modellerde tespit edilebilirlik, maruziyet süresi, geri dönüş maliyeti veya güvenlik etkisi de eklenebilir.
Bir değişikliğin test yatırımını belirlerken önce şu soruları netleştiririm:
- Hata oluşursa ne kaybederiz?
- Hatanın üretimde gerçekleşme olasılığı ne?
- Hata üretime çıkmadan hangi katmanda görülebilir?
- Otomatik test bunu güvenilir biçimde yakalayabilir mi?
- Hatanın geri dönüşü kolay mı, veri kaybına yol açıyor mu?
- Aynı kod yolu ne kadar sık çalışıyor?
- Değişiklik kaç başka bileşeni etkiliyor?
- Eşzamanlılık, zamanlama veya dış sistem bağımlılığı var mı?
Yüksek riskli alanlarda yalnız örnek tabanlı birkaç test yeterli olmayabilir; property-based testing, mutation testing, concurrency testing veya fault injection gibi daha güçlü teknikler gerekebilir. Düşük riskli bir yönetim ekranında ise geniş bir E2E paketi gereksiz bakım maliyeti üretebilir.
Test stratejisi bu ayrımı bilinçli yapmalıdır.
5. Test edilebilirlik: iyi tasarımın göz ardı edilen kalite özelliği
Bir sınıfı test etmek için uygulamanın yarısını ayağa kaldırmak zorundaysak yalnız test kodunda problem yoktur. Tasarım bize bir şey söylüyordur.
Test edilebilir bir bileşenin genellikle şu özellikleri vardır:
- girdileri açıktır,
- çıktıları ve yan etkileri gözlenebilir,
- bağımlılıkları dışarıdan verilebilir,
- global durum kullanımı sınırlıdır,
- zaman ve rastlantısallık kontrol edilebilir,
- dış sistemlerle kurduğu sınır nettir,
- hata davranışı belirgindir,
- aynı başlangıç koşulunda deterministik sonuç üretir.
Örneğin zaman bilgisini doğrudan sistem saatinden alan kod:
public boolean isExpired(final Instant expiresAt) {
    return Instant.now().isAfter(expiresAt);
}
fonksiyonel olarak basittir fakat sınır testinde zamanı kontrol etmek zordur. Zamanı bağımlılık hâline getirmek testi ve tasarımı birlikte iyileştirir:
public final class ExpirationService {
    private final Clock clock;

    public ExpirationService(final Clock clock) {
        this.clock = clock;
    }

    public boolean isExpired(final Instant expiresAt) {
        return clock.instant().isAfter(expiresAt);
    }
}
Artık 23:59:59, yaz saati geçişi veya belirli bir son kullanma anı deterministik biçimde sınanabilir.
Buradaki amaç “test uğruna abstraction üretmek” değildir. Ama kontrol edilemeyen zaman, ağ, dosya sistemi, rastgele sayı, process environment ve dış servisler zaten üretim davranışının belirsizlik kaynaklarıdır. Bunların sınırlarını görünür kılmak testten bağımsız olarak iyi mühendisliktir.
6. Gereksinimden test koşuluna: kabul kriteri nasıl türetilir?
Test tasarımının en pahalı hatalarından biri doğrudan test case yazmaya başlamaktır. Önce test koşulu belirlenmelidir: hangi davranış veya risk doğrulanacak?
Örnek gereksinim:
Kullanıcı, hesabına arka arkaya beş başarısız parola denemesinden sonra 15 dakika boyunca giriş yapamamalıdır.
Bu cümleden tek test değil bir davranış modeli çıkar:
- İlk dört başarısız deneme hesabı kilitlememeli.
- Beşinci başarısız deneme kilitlemeli.
- Kilit 15 dakikadan önce kalkmamalı.
- 15 dakika sınırında davranış açık olmalı.
- Başarılı giriş sayacı sıfırlıyor mu?
- Farklı IP'den deneme davranışı değiştiriyor mu?
- Aynı kullanıcıya eşzamanlı denemeler atomic sayılıyor mu?
- Kilit durumu dağıtık düğümler arasında tutarlı mı?
- Yönetici kilidi açabiliyor mu?
- Kilit bilgisi saldırgana kullanıcı varlığını sızdırıyor mu?
Gereksinimden bu sorular çıkmıyorsa test case sayısını artırmak kaliteyi artırmayabilir.
6.1 Given–When–Then yararlıdır ama amaç değildir
Davranış odaklı bir test şu biçimde yazılabilir:
Given: hesapta dört ardışık başarısız giriş var
When: beşinci yanlış parola gönderilir
Then: kimlik doğrulama reddedilir ve hesap 15 dakika kilitlenir
Bu format paydaşlar arasında ortak dil sağlar. Fakat her testi zorla Given/When/Then kalıbına sokmak da gereksizdir. Bir matematik fonksiyonunun parametrik testinde bu ritüel yalnız gürültü yaratabilir.
Test yazımında biçim, davranışın anlaşılmasını kolaylaştırdığı ölçüde değerlidir.
7. Test seviyeleri: sınırı isimle değil kapsadığı davranışla tanımlayın
“Birim testi nedir?” sorusuna iki ekip farklı cevap verebilir. Biri tek metodu kasteder, diğeri veritabanı dışındaki bütün servis katmanını. “Integration test” ifadesi de benzer biçimde belirsizdir.
Pratikte bu belirsizliği azaltmak için testleri iki ayrı eksende sınıflandırmak daha işe yarar:
7.1 Klasik test seviyeleri
- Birim testi: küçük bir davranış birimini izole veya kontrollü bağımlılıklarla sınar.
- Tümleştirme testi: bileşenler arasındaki sözleşmeyi ve birlikte çalışma davranışını sınar.
- Sistem testi: sistemin bütününü veya geniş bir dilimini dış davranış üzerinden sınar.
- Kabul testi: ürünün iş ve kullanıcı gereksinimlerini karşıladığını doğrular.
7.2 Test boyutu
Google'ın yıllardır kullandığı Small/Medium/Large yaklaşımı başka bir problemi çözer: ad yerine kaynak bağımlılığına bakar. Ağ, gerçek veritabanı, dosya sistemi, süreçler ve çalışma süresi arttıkça test büyür.
Bu sınıflandırma özellikle CI tasarımında faydalıdır:
Small   -> her commit, saniyeler
Medium  -> her commit / PR, dakikalar
Large   -> seçilmiş PR / main / gece, daha uzun
Bir testin adı değil, geri bildirim maliyeti işlem hattı (pipeline) içindeki yerini belirlemelidir.
8. Test piramidi: dogma değil ekonomik model
Test piramidinin arkasındaki fikir oranlardan daha değerlidir: dar kapsamlı testler çoğunlukla hızlı ve teşhis gücü yüksekken, geniş UI/E2E testleri daha pahalıdır ve bir hata çıktığında nedenini daraltmakta zorlanır. Bu ekonomik fark, çok sayıda küçük test ile daha az sayıda uçtan uca test arasındaki klasik dağılımı açıklar.
Ancak piramidi sabit oranlara dönüştürmek doğru değildir. Bir compiler, bir veri boru hattı, bir mobil uygulama ve mikroservis ekosistemi aynı test dağılımını gerektirmez.
Ben piramidi şu ekonomik soruyla okurum:
Bu davranışı güvenilir biçimde kanıtlayan en ucuz test seviyesi hangisidir?
Bir indirimin saf iş kuralını tarayıcı üzerinden test etmek pahalıdır. REST uç noktayın JSON serileştirmesini yalnız service unit testiyle sınamak ise eksiktir. Veritabanının transaction isolation davranışını mock repository ile kanıtlayamayız.
Doğru katman, riskin gerçekten ortaya çıktığı en dar sınırdır.
9. Bir testin anatomisi: Arrange, Act, Assert yeterli mi?
Birçok birim testinde yararlı olan temel yapı şöyledir:
Arrange -> başlangıç durumu
Act     -> sınanan davranış
Assert  -> gözlenen sonuç
Fakat üretim seviyesinde bir test için dört ek soru gerekir:
- Oracle nedir? Doğru sonucu nereden biliyoruz?
- İzolasyon nedir? Test başka testlerden veya çevreden etkileniyor mu?
- Gözlenebilirlik nedir? Hangi yan etkileri görebiliyoruz?
- Teşhis gücü nedir? Test kırıldığında nedenini anlayabiliyor muyuz?
Örneğin yalnız HTTP 200 kontrol eden bir test çoğu zaman zayıftır:
assertEquals(200, response.statusCode());Yanıt şemasını, iş sonucunu, kalıcı durumu veya güvenlik etkisini doğrulamıyorsa uç nokta (endpoint) yanlış davranıp yine 200 dönebilir.
İyi assertion yalnız “bir şey oldu” dememeli; hangi sözleşmenin korunduğunu göstermelidir.
10. Test oracle problemi: doğru cevabı kim söylüyor?
Test oracle, test sonucunun doğru mu yanlış mı olduğuna karar veren kaynaktır. Bu kaynak bir gereksinim, matematiksel özellik, referans uygulama, önceki sürüm, bağımsız hesaplama veya domain kuralı olabilir.
En tehlikeli durum, testin beklenen değeri üretim koduyla aynı algoritmadan hesaplamasıdır.
Üretim kodu:
final BigDecimal result = price.multiply(rate).setScale(2, RoundingMode.HALF_UP);Testte beklenen sonucu aynı formülle üretirsek algoritma yanlış seçilmiş olsa bile test geçebilir. Kritik finansal hesaplarda beklenen değer bağımsız bir oracle'dan gelmelidir: sabit örnekler, domain tablosu veya farklı bir doğrulanmış yöntem.
Bazı problemlerde kesin oracle yoktur. Görüntü işleme, optimizasyon, makine öğrenmesi veya büyük simülasyonlarda “tek doğru çıktı” tanımlamak zor olabilir. Bu durumda property-based veya metamorphic relations gibi teknikler devreye girer. Bunlara ileride döneceğiz.
Ünite 2: Test Tasarım Teknikleri ve Geliştirici Düzeyi Testler
Test durumu üretiminde önce davranışın kabul ve ret koşulları belirlenir. Giriş uzayı eşdeğer sınıflara ayrılır; sınıfların sınır noktaları ve beklenen geçişler ayrıca test edilir. Rastgele veri üretimi kullanılacaksa başarısız örneğin tekrar oluşturulabilmesi için tohum ve küçültülmüş karşı örnek saklanır. Test sayısı değil, her durumun hangi gereksinim veya değişmezi sınadığı temel izlenebilirlik ölçütü olmalıdır.
11. Eşdeğer bölümlere ayırma: sonsuz girdi uzayını sınıflara küçültmek
Bir alan 0 ile 120 arasında yaş kabul ediyorsa her değeri test etmek gereksizdir. Davranış açısından eşdeğer sınıflar oluşturabiliriz:
x < 0       -> geçersiz
0 <= x <=120 -> geçerli
x > 120     -> geçersiz
Her sınıftan temsilci seçmek test sayısını büyük ölçüde azaltır. Ancak en kritik hata çoğu zaman sınıfın ortasında değil sınırındadır.
Bu yüzden eşdeğer bölümleme, sınır değer analiziyle birlikte düşünülmelidir.
12. Sınır değer analizi: hataların sevdiği yer
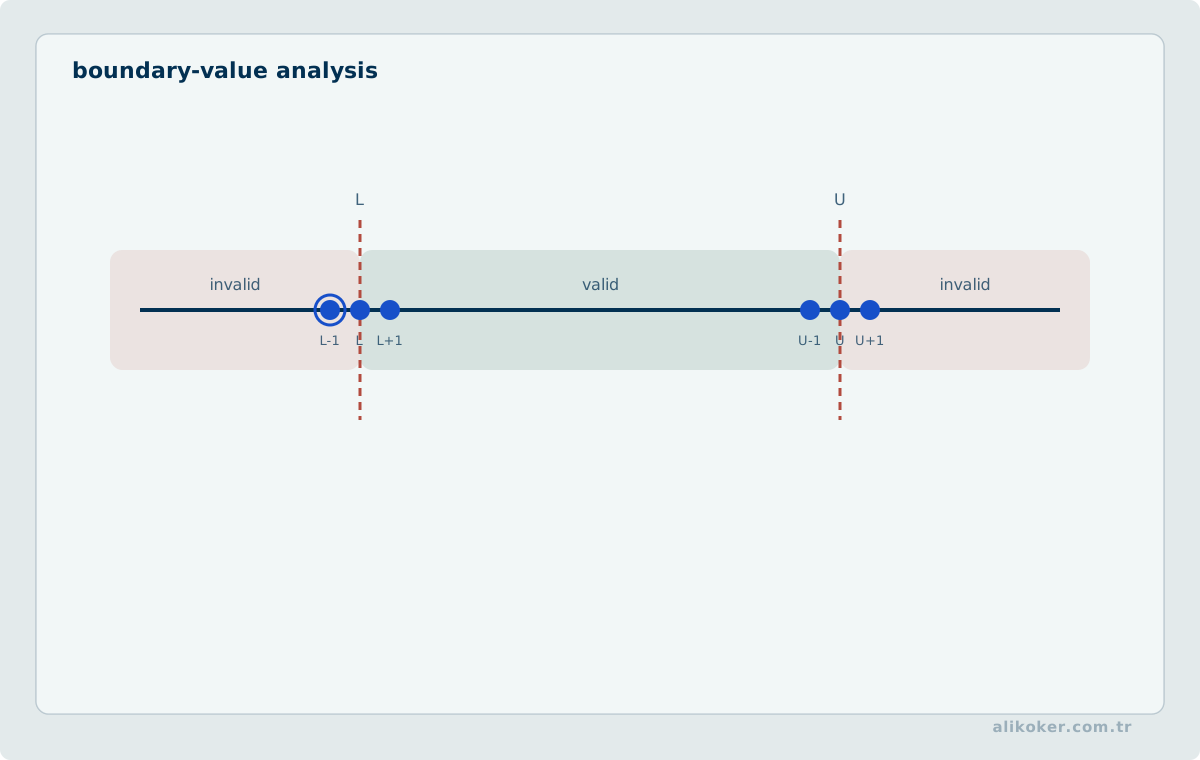
< yerine <=, array üst sınırı, pagination offset'i, tarih aralığı ve numeric overflow gibi hatalar sınırda ortaya çıkar.
0–120 aralığı için tipik örnekler:
-1, 0, 1, 119, 120, 121Fakat gerçek sistemde sınır yalnız numeric değildir:
- boş string / tek karakter / maksimum uzunluk / maksimum + 1,
- 23:59:59 / 00:00:00,
- ay sonu / yıl sonu / artık gün,
- tam dolu kuyruk / bir boş slot / kapasite + 1,
- ilk sayfa / son sayfa / veri olmayan sayfa,
- tam timeout anı,
Long.MAX_VALUE,NaN, sonsuzluk,- Unicode birleşik karakterler,
- transaction commit ile başka işlemin okuması arasındaki sınır.
Sınır düşüncesini yalnız forma uygulamak test mühendisliğinin gücünü küçültür. Sistem davranışındaki her eşik potansiyel test sınırıdır.
13. Karar tablosu: iş kuralındaki kombinasyonları görünür kılmak
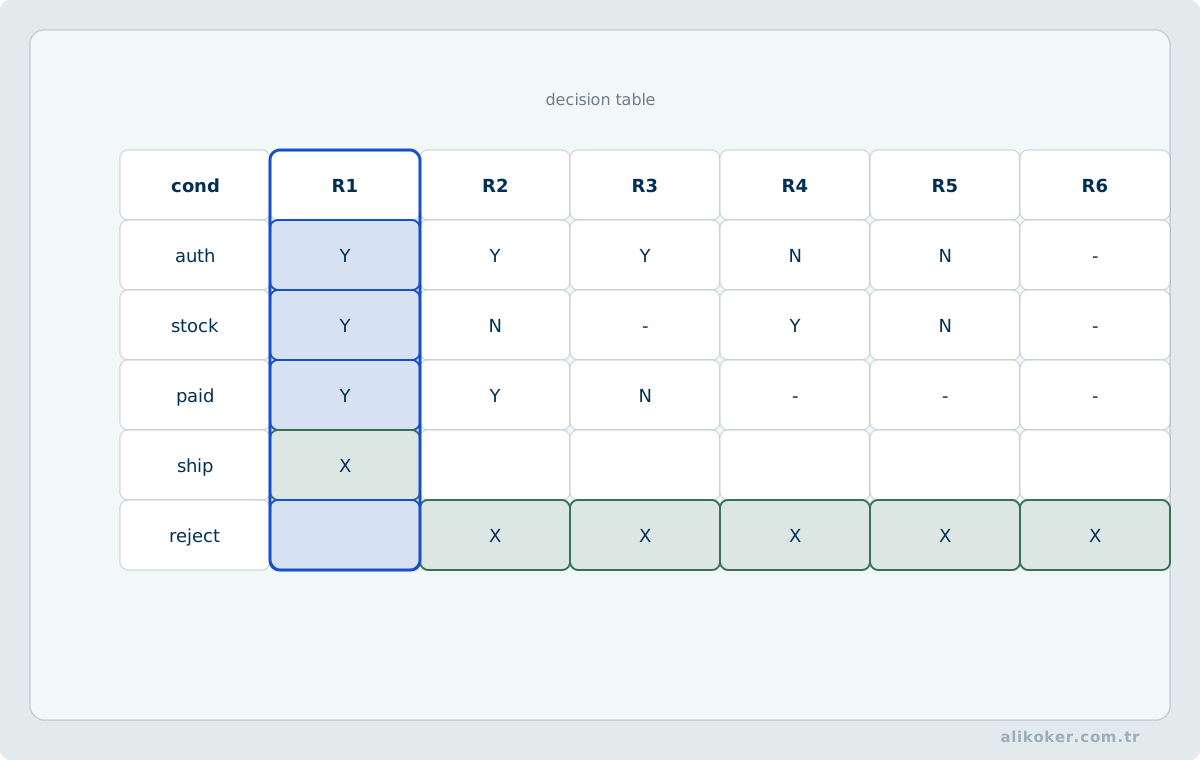
Bir davranış birden çok koşulun birleşimine bağlıysa test case listesi hızla okunamaz hâle gelir. Karar tablosu koşullar ile sonuçlar arasındaki ilişkiyi netleştirir.
Örneğin para transferi:
- Bakiye yeterli: Evet; Hesap aktif: Evet; Günlük limit uygun: Evet; Sonuç: Transfer
- Bakiye yeterli: Hayır; Hesap aktif: Evet; Günlük limit uygun: Evet; Sonuç: Yetersiz bakiye
- Bakiye yeterli: Evet; Hesap aktif: Hayır; Günlük limit uygun: Evet; Sonuç: Hesap pasif
- Bakiye yeterli: Evet; Hesap aktif: Evet; Günlük limit uygun: Hayır; Sonuç: Limit aşıldı
- Bakiye yeterli: Hayır; Hesap aktif: Hayır; Günlük limit uygun: Hayır; Sonuç: Öncelikli hata kuralına göre
Son satır önemlidir. Birden fazla koşul başarısız olduğunda hangi hatanın döneceği tanımlı değilse test sırasında gereksinim boşluğu ortaya çıkar.
İyi test tasarımı yalnız hatayı bulmaz; gereksinimdeki belirsizliği de bulur.
14. Durum geçiş testi: yalnız değeri değil geçmişi test etmek
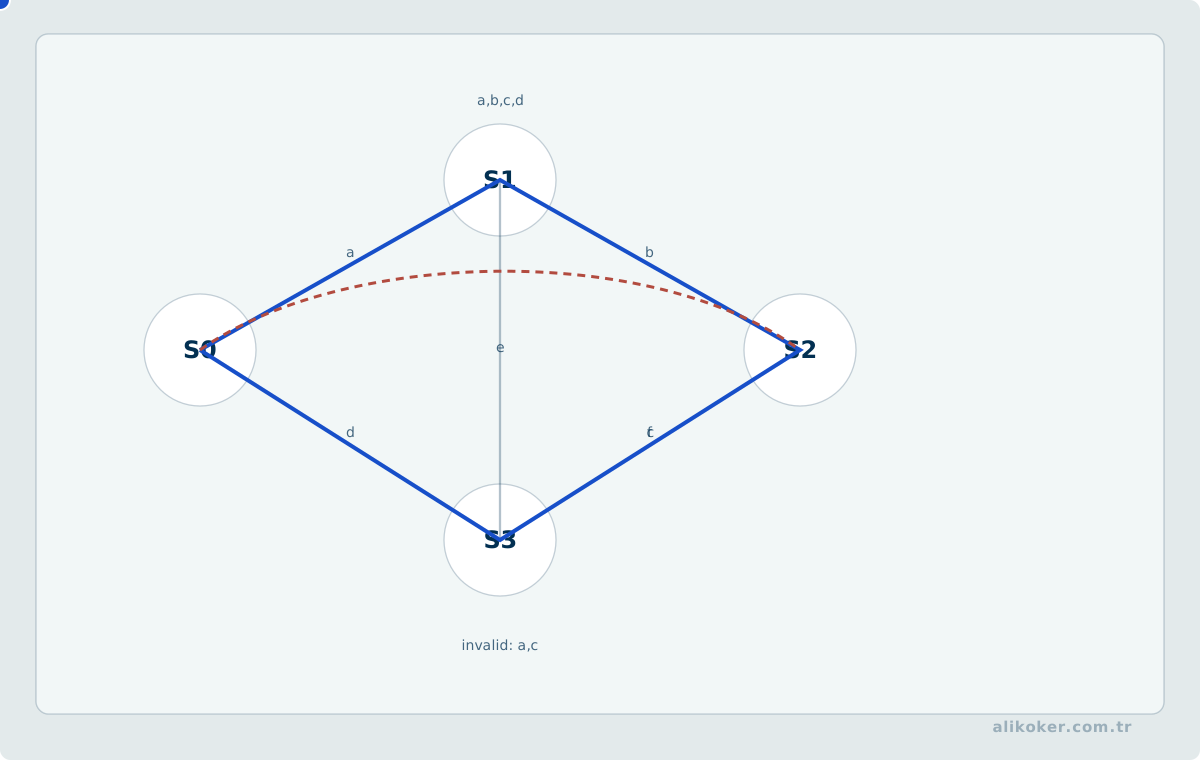
Bazı sistemlerde aynı girdi, önceki duruma göre farklı sonuç üretir. Oturum, sipariş, ödeme, çağrı, bağlantı, cihaz kontrolü veya iş akışı motoru gibi alanlarda state machine düşüncesi gerekir.
Örneğin:
NEW -> APPROVED -> PROCESSING -> COMPLETED
              \-> CANCELLED
Yalnız geçerli geçişleri test etmek yetmez. Geçersiz geçişler de önemlidir:
COMPLETED -> NEW       reddedilmeli
CANCELLED -> PROCESSING reddedilmeli
NEW -> COMPLETED       iş kuralına göre reddedilmeli
Daha zor hata, iki isteğin aynı anda aynı durumu değiştirmeye çalışmasıdır. Tek iş parçacığı altında bütün testler geçebilir; üretimdeki yarış durumu yine ortaya çıkabilir. Durum makineleri bu nedenle concurrency testleriyle birlikte ele alınmalıdır.
15. Pairwise ve kombinatoryal test: bütün kombinasyonlar yerine etkileşimleri hedeflemek
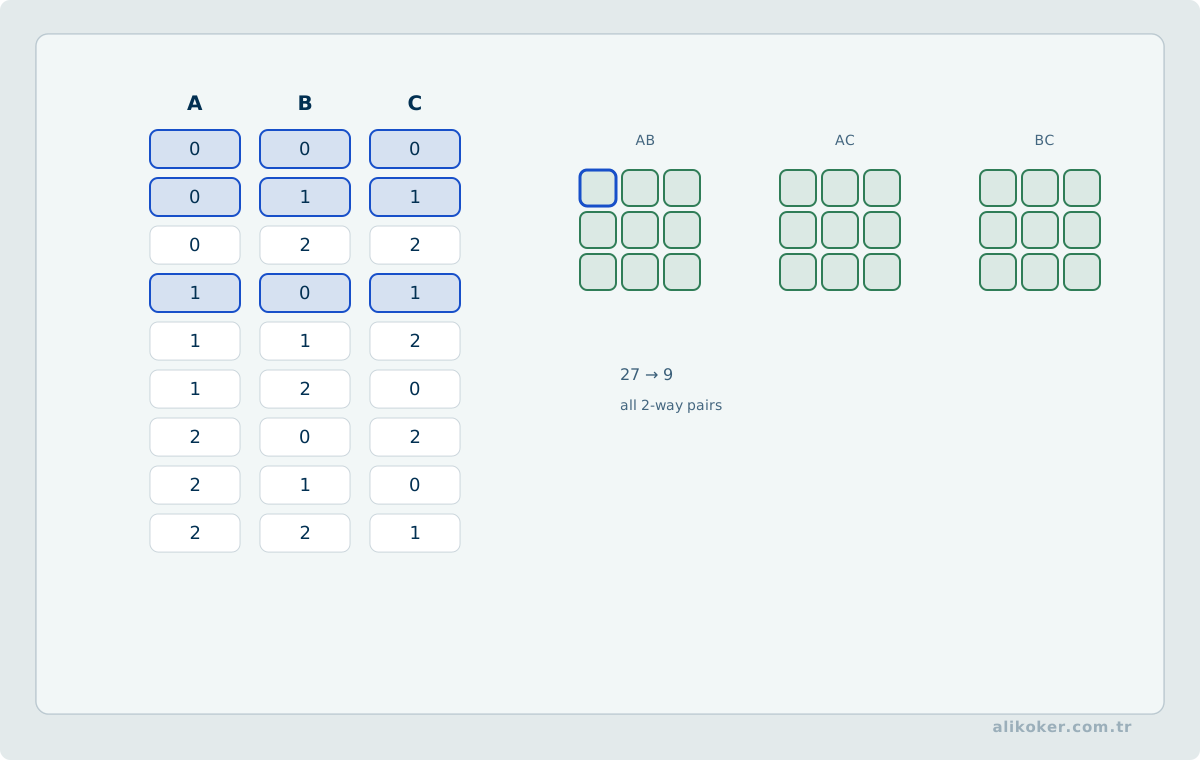
İşletim sistemi, tarayıcı, dil, veri tabanı, yetki rolü ve özellik bayrağı gibi çok sayıda parametrenin bütün kombinasyonlarını çalıştırmak pahalıdır.
Pairwise testing, her iki parametre değer çiftinin en az bir testte birlikte bulunmasını sağlayacak daha küçük bir kombinasyon kümesi üretir. Birçok entegrasyon hatası sınırlı sayıda parametrenin etkileşiminden doğduğu için pratikte güçlüdür.
Örneğin:
OS:      Linux, Windows
DB:      PostgreSQL, Oracle, MySQL
Locale:  tr-TR, en-US, de-DE
Auth:    local, OIDC
Tam kombinasyon 2 × 3 × 3 × 2 = 36 testtir. Pairwise bir araç çok daha küçük bir küme oluşturabilir.
Fakat bunun garantisi “bütün hataları bulmak” değildir. Üçlü veya dörtlü etkileşim kritikse t-wise kapsam artırılmalıdır. Yine karar riskle verilir.
16. Keşif testi: test senaryosunun söylemediğini sistem söyler
Otomasyon tekrar edilebilir davranışlarda güçlüdür; fakat yalnız önceden düşündüğümüz soruları sorar. Keşif testi (exploratory testing), öğrenme, test tasarımı ve test yürütmenin eşzamanlı ilerlediği disiplindir.
Bu yaklaşım “rastgele tıklamak” değildir. İyi keşif testi bir charter ile başlar:
Amaç: dosya yükleme iş akışının sınır ve hata davranışlarını incele
Odak: dosya boyutu, uzantı, MIME türü, ağ kesintisi, tekrar deneme, aynı isim
Süre: 45 dakika
Kanıt: ekran kaydı, request/response, log correlation id, bulunan anomaliler
Keşif testinde tecrübeli mühendisin domain bilgisi büyük fark yaratır. Uygulama “başarılı” mesajı verirken arka plandaki transaction rollback olmuş olabilir. UI doğru görünürken ikinci sekmede stale state bulunabilir. Browser geri tuşu, hızlı çift tıklama, ağ geçişi veya uygulamanın beklemediği işlem sırası otomatik senaryolarda hiç denenmemiş olabilir.
Bu tür bulgular sonradan otomatik regression testine dönüştürülmelidir. Keşif testi ile otomasyon rakip değildir; biri yeni bilgi keşfeder, diğeri öğrenilen davranışı kilitler.
17. Statik test: kodu çalıştırmadan hata bulmak
Her hata dinamik test gerektirmez. Gereksinim incelemesi, tasarım review, kod review, statik analiz, dependency scanning ve biçimsel denetimler yazılım çalıştırılmadan kusur bulabilir.
Statik testin en büyük ekonomik avantajı kusuru daha erken yakalamasıdır. Bir API sözleşmesindeki belirsizlik tasarım aşamasında fark edilirse birkaç satır doküman değişir. Aynı belirsizlik onlarca servis tarafından uygulandıktan sonra düzeltilirse geriye dönük uyumluluk ve veri migrasyonu problemi doğabilir.
Kod review sırasında özellikle şu sorular değerlidir:
- Davranış gereksinimle uyumlu mu?
- Hata yolu tasarlanmış mı?
- yarış durumu (Race condition) olasılığı var mı?
- Null, boş değer ve sınır davranışı açık mı?
- Yan etki idempotent mi?
- Kaynak yaşam döngüsü doğru mu?
- Güven sınırı nerede?
- Loglanan veri hassas mı?
- Bu kod nasıl test edilir?
Son soru çoğu zaman tasarım problemini ortaya çıkarır.
2026 itibarıyla ISO/IEC/IEEE 29119 serisine statik analiz için yeni bir bölüm hazırlanıyor olsa da bu çalışma henüz komite taslağı seviyesindedir. Statik gözden geçirmeler için ISO/IEC 20246 ve mevcut kalite süreçleri hâlen daha yerleşik başvuru noktalarıdır.
18. Birim testi: küçük olmak değil tek bir davranışı açıklamak
Birim testinin değeri, çok hızlı geri bildirim üretmesi ve hatayı dar bir bölgeye lokalize etmesidir.
Kötü birim testinde genellikle şunlar görülür:
- Spring context gereksiz yere açılır,
- veritabanı gerekir,
- test sınıfları arasında veri paylaşılır,
- private metoda erişmek için reflection kullanılır,
- bir test on farklı davranışı doğrular,
- assertion başarısız olduğunda neyin bozulduğu anlaşılmaz.
Temiz bir örnek:
final class PriceCalculatorTest {
    private final PriceCalculator calculator = new PriceCalculator();

    @ParameterizedTest
    @CsvSource({
        "100.00,0.10,90.00",
        "100.00,0.00,100.00",
        "0.00,0.50,0.00"
    })
    void appliesDiscount(final BigDecimal price, final BigDecimal rate, final BigDecimal expected) {
        assertEquals(expected, calculator.applyDiscount(price, rate));
    }
}
Burada testin amacı sınıfın çerçeve (framework) ile ayağa kalkabildiğini değil iş kuralını doğrulamaktır. Spring'e ihtiyaç yoksa Spring başlatılmamalıdır.
Spring çerçeve dokümantasyonunun da vurguladığı gibi IoC/DI'nin iyi uygulanması POJO'ların new ile oluşturulup JUnit altında test edilebilmesini kolaylaştırır. Bu yalnız hız kazancı değildir; mimari sınırların net olduğuna dair bir işarettir.
19. Assertion kalitesi: testin dili sonucu belirler
Test yalnız doğru çalışmalı değil, başarısız olduğunda iyi konuşmalıdır.
Aşağıdaki assertion teknik olarak çalışır:
assertTrue(result.size() == 3);Ancak hata mesajı bağlam açısından zayıftır. Koleksiyonun yalnız boyutunu değil içeriğini de doğrulamak gerekiyorsa daha ifade edici assertion tercih edilir.
Assertion seçiminde iki uçtan kaçınmak gerekir:
Eksik assertion: test yalnız exception atılmadığını doğrular.
Aşırı assertion: test davranışla ilgisi olmayan onlarca alanı sabitler ve en küçük refactor'da kırılır.
Testin görevi uygulamanın bütün iç durumunu dondurmak değil, sözleşmeyi sabitlemektir.
Örneğin REST yanıtında createdAt alanının tam milisaniyesini doğrulamak iş gereksinimi değilse test gürültüsü üretir. Buna karşılık status, id ve domain sonucunu doğrulamak sözleşme olabilir.
20. Test doubles: gerçek bağımlılığı ne zaman değiştirmeliyiz?
Test double genel bir üst kavramdır. Her double aynı amaçla kullanılmaz.
- Dummy: yalnız parametreyi doldurur, davranış beklenmez.
- Stub: belirli girdilere önceden hazırlanmış cevap verir.
- Fake: hafif fakat çalışan bir uygulamadır; bellek içi repository gibi.
- Mock: belirli etkileşimlerin gerçekleşip gerçekleşmediğini doğrular.
- Spy: gerçek veya kısmi davranış üzerinde çağrıları gözler.
Bu ayrım önemlidir çünkü yanlış double seçimi testi üretimden uzaklaştırabilir.
Örneğin bir repository mock'landığında JPA mapping, SQL üretimi, constraint, collation ve transaction davranışları test edilmez. Service'in repository ile konuşma mantığını sınamak için mock uygundur; repository'nin gerçekten çalıştığını kanıtlamak için değildir.
final class UserServiceTest {
    private final UserRepository repository = mock(UserRepository.class);
    private final UserService service = new UserService(repository);

    @Test
    void returnsActiveUser() {
        final User user = new User(7L, true);
        when(repository.findById(7L)).thenReturn(Optional.of(user));

        final User result = service.getActive(7L);

        assertEquals(7L, result.id());
    }
}
Bu test UserService kararını sınar. Veritabanını sınamaz.
21. Mock kullanımı: izolasyon sağlarken gerçeği kaybetmemek
Mock'lar güçlüdür ama aşırı kullanıldığında test paketini uygulama ayrıntısına bağlar.
Şu tür testler kırılgandır:
verify(repository).findById(7)
verify(mapper).toDto(user)
verify(logger).info(...)
verify(metrics).increment(...)
Eğer dışarıdan gözlenen davranış aynı kalırken iç algoritma değiştiğinde testlerin çoğu kırılıyorsa testler davranışı değil uygulama ayrıntısını kilitlemiştir.
Mock doğrulaması özellikle şu durumlarda değerlidir:
- mesajın gerçekten yayınlanması gerekiyorsa,
- ödeme sağlayıcısına ikinci kez çağrı yapılmaması gerekiyorsa,
- audit kaydı iş gereksinimiyse,
- yan etkinin hiç gerçekleşmemesi kritikse.
Diğer durumlarda sonuç üzerinden state verification daha dayanıklı olabilir.
Bir başka hata deep stubbing'dir:
when(a.getB().getC().getD()).thenReturn(...)Test böyle bir zincir gerektiriyorsa üretim kodundaki sıkı bağlılığı de sorgulamak gerekir.
22. TDD: test yazma tekniğinden çok tasarım geri besleme döngüsü
Test-Driven Development çoğu zaman “önce test yaz” cümlesine indirgenir. Oysa asıl mekanizma kısa geri besleme döngüsüdür:
Red -> Green -> RefactorRed: İstenen yeni davranışı tanımlayan ve doğru nedenle başarısız olan küçük test yazılır.
Green: Testi geçiren en küçük doğru değişiklik yapılır.
Refactor: Davranış korunurken tasarım iyileştirilir.
TDD'nin en değerli etkilerinden biri API tasarımında görülür. Kullanması zor sınıf genellikle test etmesi de zor sınıftır. Test ilk müşteri gibi davranır; gereksiz bağımlılık, karmaşık constructor, global state veya belirsiz sorumluluk erken görünür olur.
Ancak TDD her problemi çözmez. UI keşfi, performans karakteristiği, üretim konfigürasyonu veya dağıtık sistem hata modları yalnız unit TDD ile güvence altına alınamaz. TDD bir araçtır; test stratejisinin tamamı değildir.
22.1 Test önce yazıldı diye iyi test olmaz
Test kötü oracle kullanıyorsa, yanlış katmanı sınarsa veya uygulama ayrıntısına bağlanırsa önce yazılmış olması kalite sağlamaz. TDD disiplinini ritüele dönüştürmek yerine şu soruyu korumak gerekir:
Bu test tasarıma hangi geri bildirimi veriyor?
23. BDD ve Specification by Example: gereksinimi yürütülebilir örneğe çevirmek
BDD, teknik test kodundan çok ortak dil problemini çözmeye çalışır. Ürün sahibi “müşteri indirim alır” derken geliştirici farklı, testçi farklı yorumlamamalıdır.
Örnekler gereksinimi keskinleştirir:
Given müşteri GOLD seviyesinde
And sepet toplamı 1000 TL
When ödeme hesaplanır
Then %8 sadakat indirimi uygulanır
Fakat BDD dosyaları test otomasyonu uğruna yüzlerce mekanik senaryoya dönüşürse bakım maliyeti hızla artar. Her low-level teknik koşulu Gherkin ile ifade etmek gereksizdir.
Specification by Example yaklaşımında amaç, paydaşın anlayabildiği örnekleri aynı zamanda doğrulama varlığına dönüştürmektir. Domain açısından anlamlı sınırlar burada en değerlidir.
24. Property-based testing: örnek yerine değişmezi sınamak
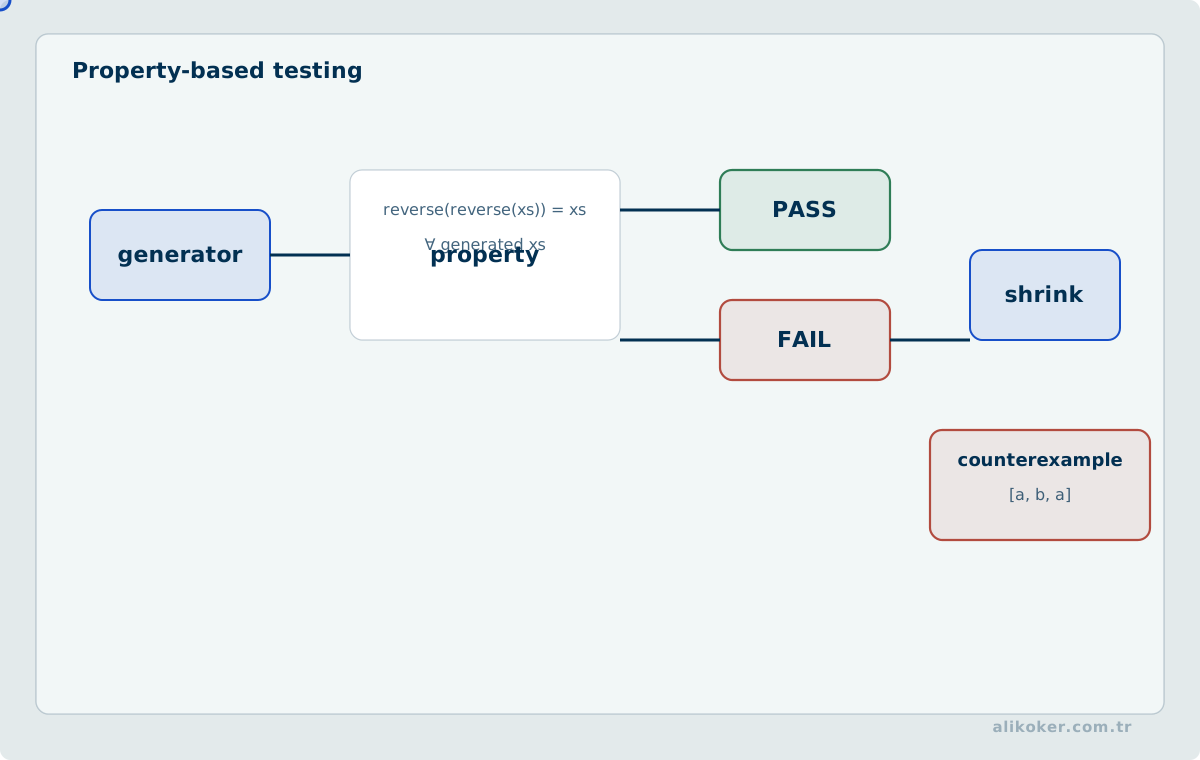
Örnek tabanlı test belirli girdileri seçer. Property-based testing ise daha genel bir özelliği tanımlar ve çok sayıda üretilmiş girdi üzerinde sınar.
Bir sıralama algoritması için yalnız:
[3, 1, 2] -> [1, 2, 3]demek yerine şu özellikleri test edebiliriz:
çıktı sıralıdır
çıktı girdinin aynı elemanlarını içerir
sort(sort(x)) == sort(x)
çıktı uzunluğu girdi uzunluğuna eşittir
Bu yaklaşım insanın düşünmediği kombinasyonları keşfetmekte güçlüdür. jqwik gibi JVM araçları başarısız girdiyi küçültüp en küçük karşı örneği üretebilir.
Örneğin kavramsal olarak:
@Property
void reversingTwiceReturnsOriginal(@ForAll final List<Integer> values) {
    final List<Integer> reversed = new ArrayList<>(values);
    Collections.reverse(reversed);
    Collections.reverse(reversed);
    assertEquals(values, reversed);
}
Property seçimi zordur. Yanlış veya zayıf property yüz bin girdiyle çalışsa da az güven üretir. Asıl mühendislik, domain değişmezini doğru ifade etmektir.
25. Mutation testing: testlerin gerçekten hata yakalayıp yakalamadığını ölçmek
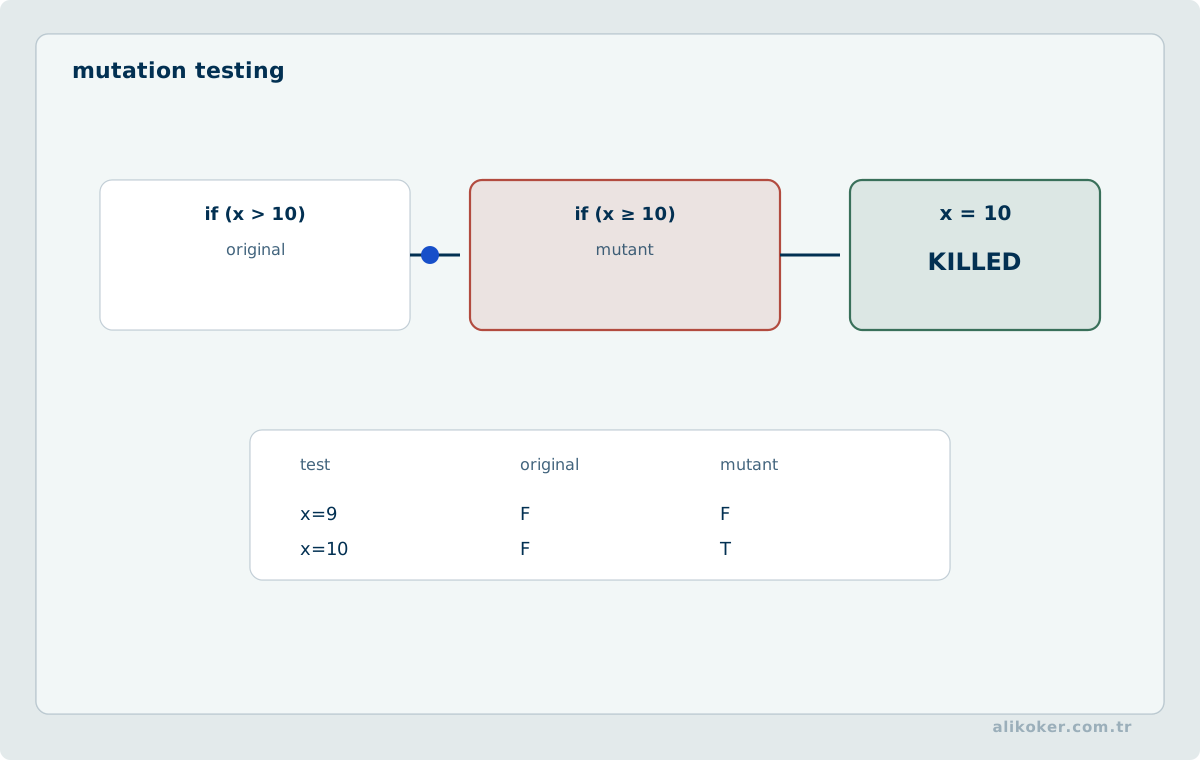
Kod kapsamı (code coverage) yalnız hangi kodun çalıştırıldığını söyler. Testin sonucu gerçekten kontrol edip etmediğini söylemez.
Mutation testing üretim koduna kontrollü küçük değişiklikler uygular:
>  -> >=
+  -> -
true -> false
koşulu kaldır
return değerini değiştir
Sonra test paketi yeniden çalıştırılır. Testler mutantı öldürüyorsa davranış değişikliğini fark etmiştir. Testler yeşil kalıyorsa iki olasılık vardır:
- test eksiktir,
- mutant semantik olarak eşdeğerdir.
Bu teknik özellikle yüksek kod kapsamına sahip ama düşük assertion kalitesine sahip projelerde şaşırtıcı sonuç verir.
Örneğin:
if (age >= 18) {
    return ADULT;
}
mutant:
if (age > 18) {
    return ADULT;
}
18 yaş sınırını test etmiyorsak branch coverage %100 olsa bile mutant yaşayabilir.
JVM ekosisteminde PIT/PITest bu amaçla yaygın kullanılır. Mutation score bir hedef sayıya körü körüne çevrilmemelidir; fakat kritik iş kurallarında testlerin gerçek kusur yakalama gücünü değerlendirmek için çok değerlidir.
26. Fuzzing: girdiyi insan hayal gücünden kurtarmak
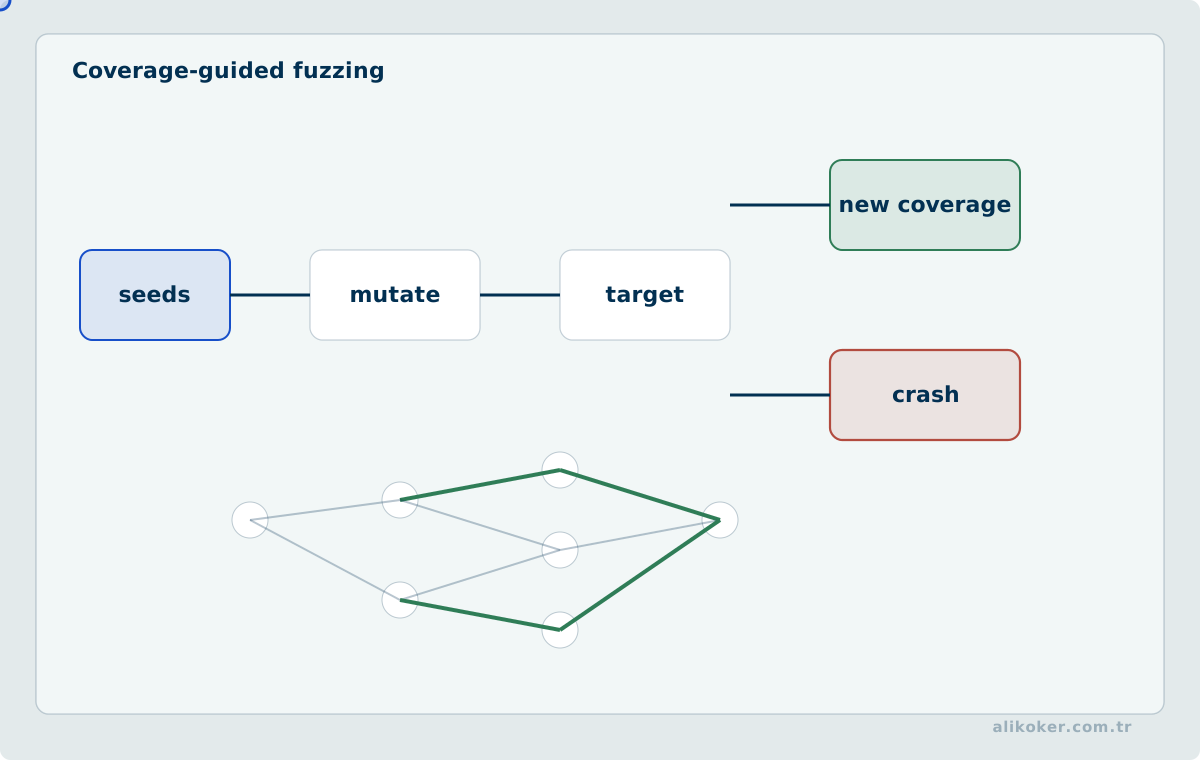
Fuzz testing, programa çok sayıda beklenmeyen, bozuk veya üretilmiş girdi vererek crash, hang, memory error, assertion failure veya güvenlik problemi arar.
Özellikle parser, protocol implementation, dosya formatı, binary decoder, ağ servisi ve native kodda etkilidir.
Basit random input fuzzing başlangıç olabilir fakat modern fuzzing coverage-guided veya structure-aware olabilir. Amaç yalnız rastgele veri üretmek değil, daha önce keşfedilmemiş program durumlarına ulaşmaktır.
Web güvenliğinde fuzzing input validation sınırlarını zorlar. Native kodda AddressSanitizer gibi çalışma zamanı (çalışma zamanı) instrumentation ile birleştiğinde memory corruption bulabilir. API testing'de OpenAPI şemasından geçerli/geçersiz istek varyasyonları üretilebilir.
Fuzzer'ın bulduğu her çökme regresyon testine dönüştürülmelidir. Aksi hâlde aynı hata daha sonra yeniden ortaya çıkabilir.
27. Metamorphic testing: doğru cevabı bilmediğimizde ilişkiyi test etmek
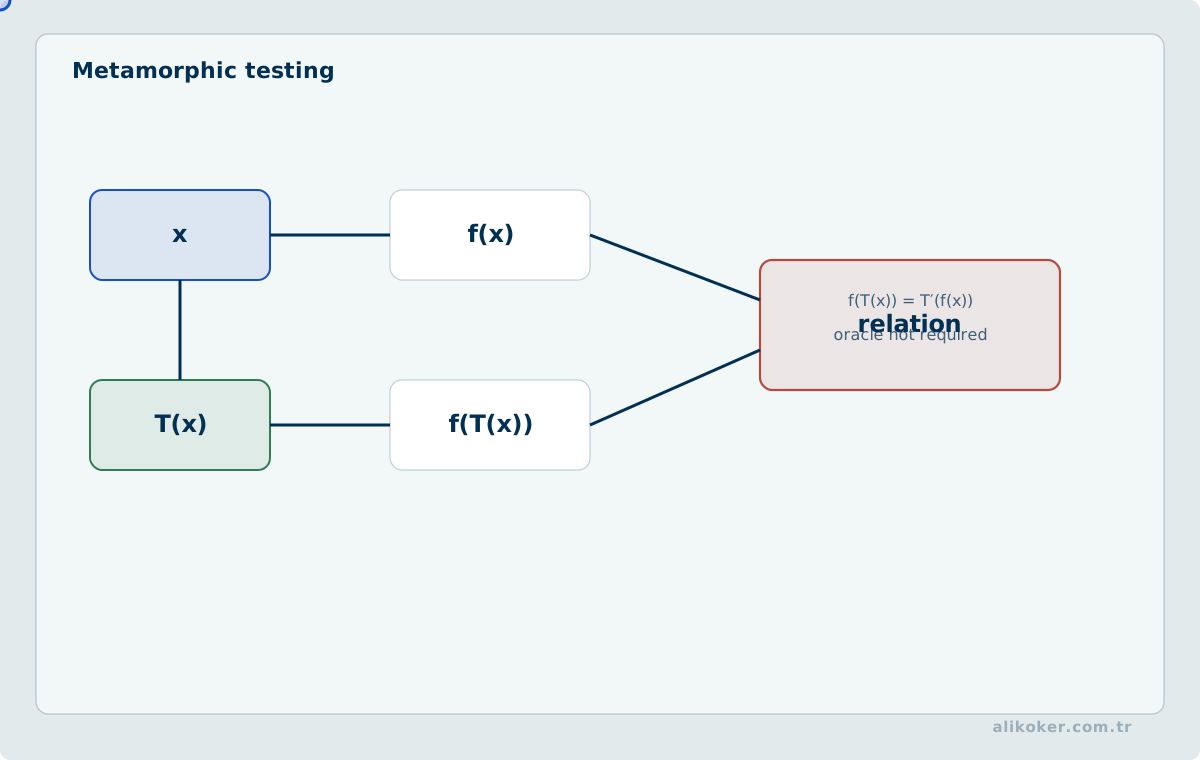
Bazı sistemlerde tek bir girdi için doğru sonucu hesaplamak çok pahalı veya imkânsızdır. Arama motoru, görüntü işleme, bilimsel hesaplama, optimizasyon ve yapay zekâ modelleri buna örnektir.
Metamorphic testing, çıktıların kendisi yerine girdiler arasındaki beklenen ilişkiyi sınar.
Örneğin bir görüntü sınıflandırıcıda küçük parlaklık değişiminin tamamen ilgisiz sınıfa sıçramaması beklenebilir. Bir mesafe fonksiyonunda:
d(a, b) == d(b, a)
d(a, a) == 0
özellikleri oracle görevi görür.
Vergi hesaplamasında bütün girdiler aynı kurallarla oransal artırıldığında belirli monotonluk ilişkileri beklenebilir. Route planner'da yol ağına kullanılmayan uzak bir düğüm eklemek mevcut rotayı değiştirmemelidir.
Metamorphic relation domain bilgisidir. Otomasyon yalnız onu çok sayıda örnek üzerinde yürütür.
Ünite 3: Tümleştirme, Veri, API, Arayüz ve Asenkron Sistem Testleri
28. Tümleştirme testi: mock'un bittiği yerde gerçek sözleşme başlar
Birim testlerinde bağımlılıkları kontrol ederiz. Tümleştirme testinde ise bileşenler arasındaki gerçek sınırı sınarız.
Riskler genellikle şuralardadır:
- serialization/deserialization,
- SQL dialect,
- transaction davranışı,
- HTTP header ve content type,
- timeout/yeniden deneme (retry),
- mesaj sıralaması,
- schema migration,
- TLS/sertifika,
- authentication token,
- encoding/collation,
- ağ hatası.
Mock servis bize User nesnesi döndürebilir; gerçek HTTP servisi user_id alanını userId yerine gönderebilir. Mock repository duplicate key davranışını taklit etmeyebilir. Fake broker mesajın gerçek acknowledgment semantiğini göstermeyebilir.
Test double ile kazandığımız hızın bedeli gerçek entegrasyondan uzaklaşmaktır. Bu açığı, az sayıda fakat doğrudan gerçek sözleşmeyi sınayan tümleştirme testleriyle kapatmak gerekir.
29. Veritabanı testi: in-memory başarı üretim doğruluğu değildir
Veritabanı testlerinde sık karşılaştığım yanlış güven kaynaklarından biri, üretimde kullanılan motordan farklı bir bellek içi veritabanında geçen repository testlerini gerçek veritabanı davranışının kanıtı saymaktır.
H2 veya başka gömülü motorlar hızlıdır ve bazı testlerde yararlıdır. Fakat SQL dialect, null sıralaması, collation, transaction isolation, locking, sequence davranışı, tarih tipleri, JSON fonksiyonları, constraint ve optimizer özellikleri üretim veritabanından farklı olabilir.
Özellikle şu tür kodlarda gerçek motor testi gerekir:
- vendor-specific SQL,
- karmaşık JPA mapping,
- pessimistic/optimistic locking,
- native query,
- migration script,
- büyük indeksli sorgu,
- concurrent update,
- transaction propagation.
Testcontainers burada güçlü bir araçtır. Test için geçici gerçek PostgreSQL, MySQL veya desteklenen başka servisleri container içinde başlatıp üretime daha yakın sözleşme testi yapılabilir.
Örnek yapı:
@Testcontainers
@DataJpaTest
final class AccountRepositoryTest {
    @Container
    static final PostgreSQLContainer<?> POSTGRES = new PostgreSQLContainer<>("postgres:18");

    @DynamicPropertySource
    static void properties(final DynamicPropertyRegistry registry) {
        registry.add("spring.datasource.url", POSTGRES::getJdbcUrl);
        registry.add("spring.datasource.username", POSTGRES::getUsername);
        registry.add("spring.datasource.password", POSTGRES::getPassword);
    }
}
Burada container tag'i projede sabit ve kontrollü tutulmalıdır. Testin tekrar üretilebilirliği “latest” etiketine bırakılmamalıdır.
29.1 Test veritabanı gerçekçi ama bağımsız olmalı
üretim veritabanı dökümünü doğrudan test ortamına kopyalamak KVKK/mahremiyet ve tekrar üretilebilirlik açısından ciddi risk taşır. Gerekli veri sentetik veya anonimleştirilmiş olmalı; test kendi başlangıç durumunu kurabilmelidir.
30. Transaction, kilit ve eşzamanlılık testleri
Tek iş parçacığı ile geçen CRUD testleri transaction sisteminin yalnız en kolay yolunu sınar.
Gerçek hata örnekleri şunlardır:
- lost update,
- dirty read,
- non-repeatable read,
- phantom read,
- duplicate insert race,
- kilitlenme (deadlock),
- yanlış kilit (lock) scope,
- transaction dışına taşan lazy load,
- yeniden deneme sırasında aynı yan etkinin iki kez oluşması.
Örneğin iki iş parçacığı (thread) aynı stok kaydını aynı anda azaltıyorsa şu invariant korunmalıdır:
stock >= 0Test iki işlemi kontrollü bir barrier ile aynı noktaya getirip sonucu tekrar tekrar sınayabilir. Thread.sleep() ile zamanlama ummak yerine CountDownLatch, CyclicBarrier veya uygun concurrency primitive kullanılmalıdır.
Eşzamanlılık testi deterministik hâle getirilemiyorsa en azından yarış penceresini büyüten kontrollü bir fixture kurulmalıdır. “1000 kez çalıştırınca belki hata verir” faydalı bir stress yaklaşımı olabilir ama temel regression testi için zayıftır.
31. API testi: uç noktayı değil sözleşmeyi sınamak
REST veya RPC servisinde yalnız HTTP status code kontrol etmek API testinin küçük bir bölümüdür. Gerçek sözleşme şunları kapsar:
- request schema,
- response schema,
- zorunlu/opsiyonel alanlar,
- null semantiği,
- hata modeli,
- idempotency,
- pagination,
- ordering,
- authentication/authorization,
- rate limit,
- timeout,
- versioning,
- geriye dönük uyumluluk.
Bir API'nin 200 OK dönmesi, iş sonucu doğru olduğu anlamına gelmez. Örneğin transfer isteği 200 dönüp veritabanına hiç yazılmamış olabilir. Ya da response doğru görünürken aynı idempotency key ile ikinci istek ikinci transferi oluşturabilir.
API testinde en az üç seviye ayrımı yararlıdır:
controller slice       -> HTTP mapping ve validation
application integration -> service + persistence + security
external contract       -> gerçek network sınırı ve wire format
Her şeyi full E2E yapmak teşhisi zorlaştırır. Her şeyi controller mock testine bırakmak ise gerçek sözleşmeyi kaçırır.
31.1 Negatif API testi
Başarılı yol testlerin yalnız başlangıcıdır. Şunlar ayrı değer taşır:
- eksik zorunlu alan,
- yanlış content type,
- bozuk JSON,
- aşırı büyük ileti yükü (payload),
- bilinmeyen alan,
- geçersiz enum,
- yetkisiz nesne erişimi,
- expired token,
- duplicate request,
- concurrency,
- rate limit aşımı.
Hata yanıtının kararlı bir sözleşmesi olmalıdır. Stack trace veya iç exception mesajının doğrudan dışarı taşınması hem test edilebilirliği hem güvenliği bozar.
32. Contract testing: servisler birbirinden bağımsız değişebilir mi?
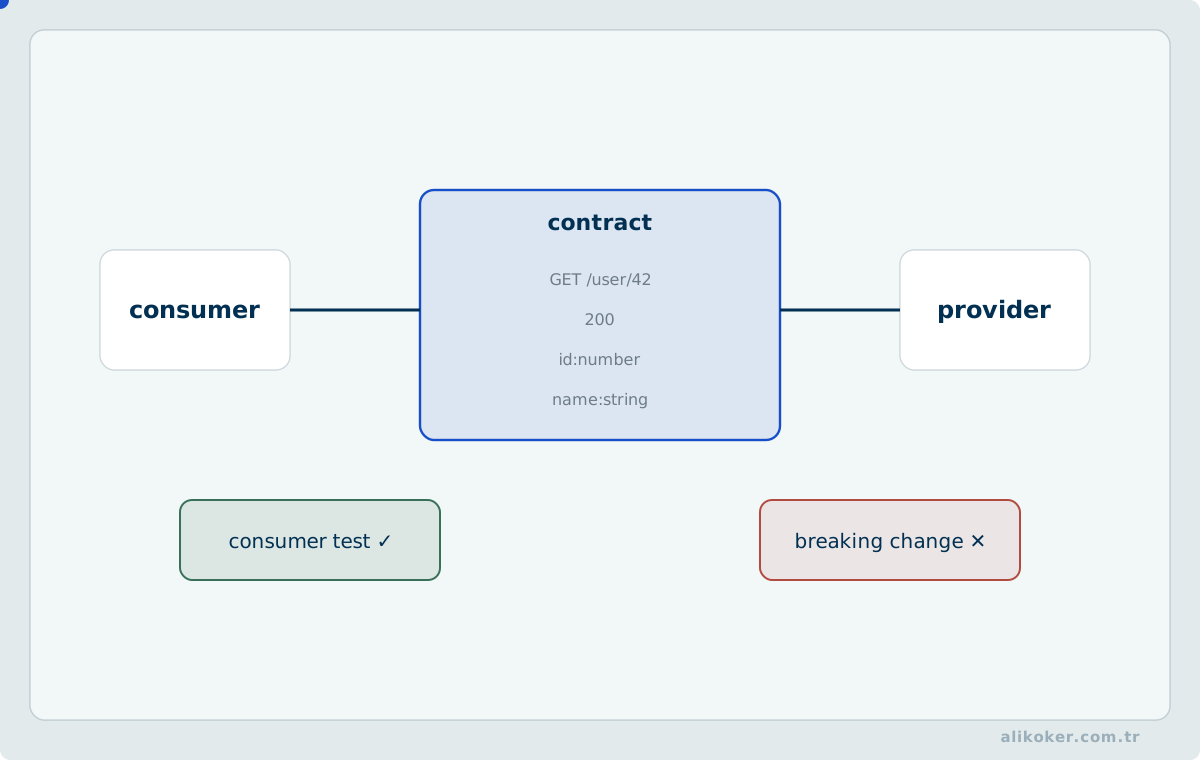
Mikroservis veya dağıtık sistemde bütün entegrasyonları tek E2E ortamında doğrulamak pahalı ve kırılgandır. Consumer-driven contract testing, tüketicinin gerçekten ihtiyaç duyduğu sözleşmeyi sağlayıcıya karşı otomatik doğrular.
Örneğin Consumer yalnız şu alanları kullanıyor olabilir:
{
  "id": 42,
  "status": "ACTIVE"
}
Provider yeni alan eklediğinde sorun yoktur; status alanını kaldırdığında veya tipini değiştirdiğinde contract testi kırılır.
Contract testing E2E'nin tamamını ortadan kaldırmaz. Network routing, authentication infrastructure, dağıtım (deployment) configuration ve gerçek veri akışı gibi riskler hâlâ daha geniş test ister. Fakat servisler arası schema uyumsuzluklarını çok daha erken yakalar.
33. Spring Boot test dilimleri: gerektiği kadar context açmak
Spring Boot test desteğinin güçlü taraflarından biri uygulamanın yalnız belirli bir dilimini ayağa kaldırabilmesidir.
@WebMvcTest, MVC/controller sınırını; @DataJpaTest, JPA veri erişim katmanını hedefler. @SpringBootTest ise tam ApplicationContext gerektiğinde kullanılır.
Bu ayrımı doğru kullanmak test paketi süresini dramatik biçimde etkileyebilir.
33.1 Controller testi
Kavramsal örnek:
@WebMvcTest(UserController.class)
final class UserControllerTest {
    @Autowired
    private MockMvc mvc;

    @MockitoBean
    private UserService service;

    @Test
    void returnsUser() throws Exception {
        when(service.get(7L)).thenReturn(new UserDto(7L, "Ali"));

        mvc.perform(get("/api/users/7"))
            .andExpect(status().isOk())
            .andExpect(jsonPath("$.id").value(7))
            .andExpect(jsonPath("$.name").value("Ali"));
    }
}
Burada hedef SQL değildir. Request mapping, JSON serileştirme, validation ve HTTP davranışı sınanır.
33.2 Full context ne zaman gerekir?
@SpringBootTest şu riskleri doğrulamak için değerlidir:
- bean wiring,
- configuration properties,
- security filter chain,
- application events,
- gerçek repository/service entegrasyonu,
- custom auto-configuration,
- startup failure.
Ancak her test sınıfını @SpringBootTest yapmak test paketini gereksiz yere yavaşlatır. Context önbellek (cache) bir miktar yardımcı olsa da farklı property/profile kombinasyonları önbelleği böler.
Testin kapsamı riski geçmemelidir.
34. Web arayüzü testi: DOM ile kullanıcı deneyimi aynı şey değildir
UI otomasyonunda Selenium gibi browser-driven araçlar uzun süredir kullanılır. Modern test stratejisinde browser testi hâlâ değerlidir; özellikle gerçek JavaScript, tarayıcı davranışı, routing, form etkileşimi ve görsel olmayan kullanıcı akışını doğrular.
Fakat UI testleri doğal olarak geniş kapsamlıdır:
browser
 -> frontend
 -> API
 -> authentication
 -> backend
 -> database
Bu zincirde herhangi bir bileşen başarısız olduğunda test kırılır. Dolayısıyla çok sayıda UI testi, test paketini yavaş ve kararsız hâle getirebilir.
34.1 Selector seçimi
CSS yapısına sıkı bağlı selector:
body > div:nth-child(3) > div > table > tr:nth-child(2) > td:nth-child(4)küçük bir UI yeniden düzenlemesinde kırılır.
Daha kararlı bir yaklaşım semantic rol veya açık test identifier kullanmaktır. Ancak üretim DOM'u yalnız test için anlamsız attribute'larla doldurmak da doğru değildir. Kullanıcı açısından anlamlı role/name erişilebiliyorsa önce onu tercih etmek gerekir.
34.2 UI testinin görevi
Browser testinde düşük seviye iş kuralını yüz farklı veriyle yeniden sınamak yerine kritik kullanıcı yolunu doğrulamak daha değerlidir:
login
 -> arama
 -> kayıt açma
 -> değişiklik
 -> kaydetme
 -> yeniden yükleme
 -> sonucun korunması
Aynı iş kuralının sınır kombinasyonları daha hızlı katmanlarda test edilir.
35. Kullanılabilirlik testi: yazılım teknik olarak doğru ama insan için yanlış olabilir
Kullanılabilirlik testinde amaç yalnız butonun çalışması değildir. Kullanıcı görevi doğru, hızlı ve düşük hata oranıyla tamamlayabiliyor mu?
Ölçülebilecek göstergeler:
- görevi tamamlama oranı,
- görev süresi,
- hata sayısı,
- geri dönüş/iptal sayısı,
- yardım ihtiyacı,
- öğrenilebilirlik,
- kullanıcı memnuniyeti.
Think-aloud oturumları, ekran kaydı, gözlem ve kontrollü görevler nitel bilgi üretir. Telemetri, funnel ve A/B testleri nicel veri üretebilir.
Ancak A/B testi her zaman kalite testi değildir. Daha fazla tıklanan tasarım daha erişilebilir veya daha güvenli olmayabilir. Ölçülen metrik, gerçek kullanıcı hedefiyle ilişkilendirilmelidir.
Kritik sistemlerde kullanılabilirlik doğrudan güvenlik ve emniyet özelliğine dönüşebilir. Operatörün alarmı yanlış yorumlaması teknik olarak “çalışan” bir ekranın başarısızlığıdır.
36. Erişilebilirlik testi: kullanılabilirliğin ayrıcalıklı olmayan hâli
Web ve mobil uygulamada klavye erişimi, semantic HTML, screen reader davranışı, focus sırası, kontrast, zoom ve hareket kısıtları test edilmelidir.
Erişilebilirlik testinin bir bölümü otomatik araçlarla bulunabilir; fakat bütün sorunlar bulunamaz. Örneğin butonun accessible name'inin var olması, adın kullanıcı için anlamlı olduğu anlamına gelmez.
Pratik test akışı:
mouse kullanmadan kritik akışı tamamla
focus sırasını izle
screen reader ile başlık/landmark yapısını dinle
200% ve 400% zoom altında akışı dene
renge bağımlı anlam olup olmadığını kontrol et
Erişilebilirlik sonradan “uyum” eklemek yerine UI component tasarımına yerleştirilirse test maliyeti düşer.
37. Mobil uygulama testi: cihaz farkı gerçek bir sistem parametresidir
Mobil uygulamada masaüstünden farklı riskler vardır:
- işletim sistemi sürümü,
- ekran boyutu ve yoğunluğu,
- düşük bellek,
- CPU sınırlaması,
- pil tüketimi,
- mobil ağ geçişleri,
- offline çalışma,
- izinler,
- uygulamanın arka plana alınması,
- çağrı/bildirim kesintileri,
- orientation,
- kurulum/güncelleme.
Bir mobil test stratejisi emulator/simulator ile gerçek cihazı birlikte kullanmalıdır. Emulator geniş kombinasyon taraması için ekonomiktir; kamera, bluetooth, sensör, termal davranış veya üreticiye özgü sorunlarda gerçek cihaz gerekir.
37.1 Kesme testi
Uygulama dosya yüklerken telefon çağrısı gelir. Ağ Wi-Fi'dan LTE'ye geçer. Uygulama arka plana alınır ve işletim sistemi süreci sonlandırır.
Bu durumlarda sistem:
- veri kaybetmemeli,
- yarım işlemi tutarlı bırakmalı,
- yeniden başlatmada durumu kurtarmalı,
- aynı işlemi iki kez göndermemeli.
Mobil testte “happy path” çok hızlı yetersiz kalır.
38. Test verisi mühendisliği: veri fixture değil sistem girdisidir
Test verisi çoğu projede test kodundan daha büyük sorun hâline gelir.
Kötü işaretler:
- bütün testler aynı devasa SQL dump'ına bağımlı,
- test sırası önem taşıyor,
- fixture değişince yüzlerce test kırılıyor,
- üretim ortamındaki kişisel veri test ortamında bulunuyor,
- test verisinin neden gerekli olduğu bilinmiyor.
İyi test verisi mümkün olduğunca minimal ve amaca özgü olmalıdır.
Örneğin yetkilendirme testi için yüz kullanıcıya gerek yoktur:
owner
otherUser
admin
çoğu davranışı gösterebilir.
Builder yaklaşımı test kodunu okunabilir yapabilir:
final User user = UserTestData.user()
    .id(7L)
    .role(USER)
    .active(true)
    .build();
Ancak builder bütün alanlara rastgele varsayılan değer verirse testin hangi veriye bağlı olduğu gizlenebilir. Kritik alanlar açık tutulmalıdır.
38.1 Sentetik veri ve anonimleştirme
Gerçekçi dağılım gerektiren performans testlerinde sentetik üretici, istatistiksel profile yakın veri üretebilir. Üretim verisi kullanılması zorunluysa geri döndürülemez anonimleştirme ve erişim kontrolü gerekir.
Test ortamı veri sızıntısının kolay olduğu bir yan kanal olmamalıdır.
39. Çevre yönetimi: “benim makinemde geçiyor” test sonucu değildir
Test sonucu yalnız kodun değil çevrenin de fonksiyonudur:
result = f(code, config, data, OS, çalışma zamanı, network, dependencies, time)Test sonucunun hangi çevre koşullarında üretildiği görünür olmadıkça aynı sonucu yeniden üretmek de zorlaşır.
Container ve infrastructure-as-code yaklaşımları test ortamını tekrar üretilebilir yapar. Bununla birlikte container kullanmak üretim eşitliği sağlamaz. Kernel, storage, network policy, service mesh, TLS, secret provider ve dış bağımlılık farkları hâlâ bulunabilir.
Test çevreleri için şu politika yararlıdır:
- version pinning,
- deterministic configuration,
- otomatik provision/cleanup,
- environment drift kontrolü,
- secret ayrımı,
- üretime yakın kritik bağımlılıklar.
40. Flaky test: bazen geçen test test değildir
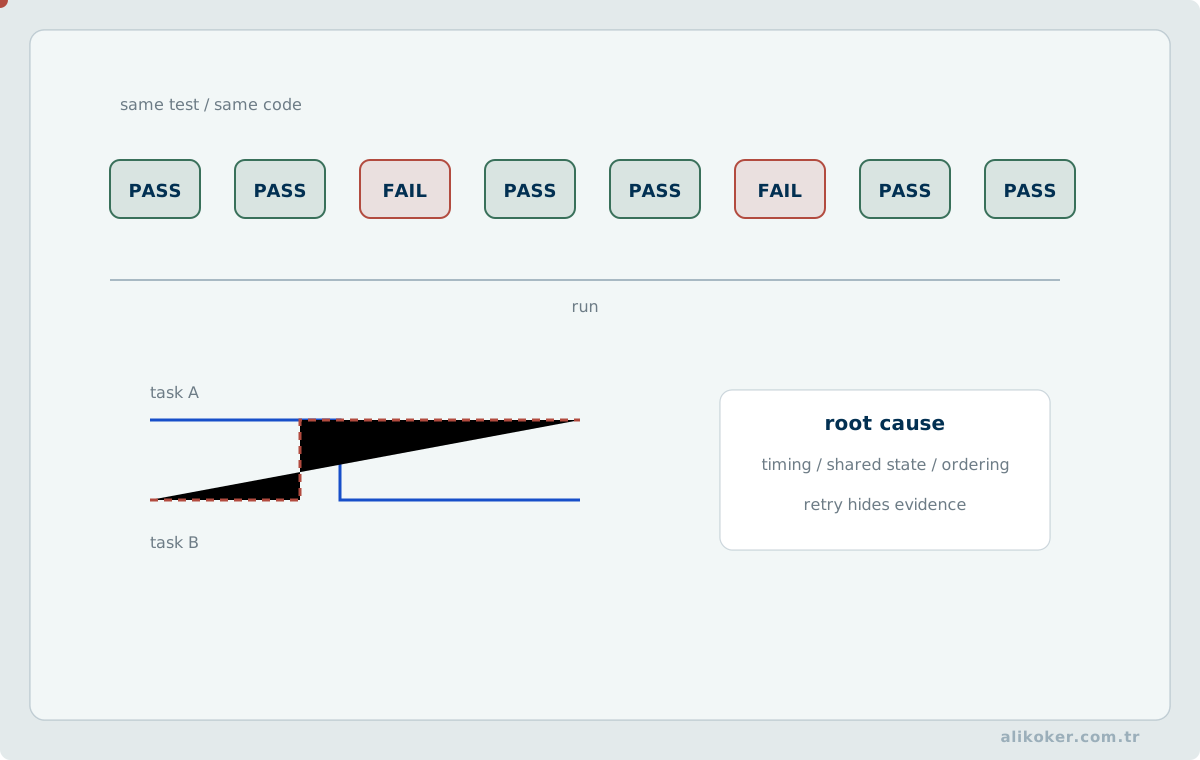
Aynı commit, aynı input ve aynı çevrede test bazen geçip bazen kalıyorsa test paketi güven üretmez. Kararsız test zamanla ekip tarafından görmezden gelinir; gerçek failure da “yine flaky” denerek yeniden çalıştırılır.
Google'ın yayımladığı verilerde daha büyük testlerin flaky olma eğiliminin belirgin biçimde yükseldiği görülmüştür. Bu şaşırtıcı değildir: ağ, iş parçacığı, process, disk ve dış servis sayısı arttıkça deterministik olmayan davranış kaynakları artar.
Yaygın nedenler:
- gerçek saat,
- random seed,
- test sırasına bağımlılık,
- paylaşılan statik durum,
- dış network,
- timeout sınırında assertion,
sleep,- yarış durumu,
- cleanup eksikliği,
- paralel çalışmada port/file çakışması,
- eventually-consistent sistemi anında doğrulamak.
Flaky test için çözüm “yeniden deneme 3” değildir. yeniden deneme geçici teşhis aracı olabilir; kök neden gizlenmemelidir.
41. Zamanı test etmek: sleep yerine kontrol
Zamana bağlı kod, test paketinin en sık kararsızlık üreten alanlarından biridir.
Kötü yaklaşım:
Thread.sleep(1000);
assertTrue(cache.isExpired(key));
Bu test hem yavaş hem kırılgandır. CI sunucusu yavaşladığında farklı davranabilir.
Daha iyi yaklaşımda zaman injectable'dır:
final Clock clock = Clock.fixed(Instant.parse("2026-08-31T08:00:00Z"), ZoneOffset.UTC);
final CachePolicy policy = new CachePolicy(clock);
Asenkron durumlarda gerçek zaman ilerlemesi gerekiyorsa polling tabanlı bounded wait kullanılabilir:
10 saniyeye kadar bekle
koşulu belirli aralıklarla kontrol et
koşul oluşur oluşmaz devam et
Sabit 10 saniye uyumak hem hızlı durumda 9 saniye israf eder hem yavaş durumda yine başarısız olabilir.
42. Rastlantısallık testi: seed bir debug aracıdır
Randomized testing yararlıdır; fakat başarısız test yeniden üretilemiyorsa değerinin önemli kısmını kaybeder.
Test çalıştırmasında kullanılan seed loglanmalıdır:
seed=784311257Aynı seed ile aynı veri dizisi üretilebilmelidir. Property-based testing çerçeveleri bunu çoğunlukla otomatik sağlar.
Üretim kodunda güvenlik amaçlı CSPRNG ile deterministik test üretecini karıştırmamak gerekir. Test edilebilirlik için güvenlik algoritmasını zayıflatmak kabul edilemez; bunun yerine rastlantısallık kaynağının arayüzü kontrol edilir.
43. Asenkron ve event-driven sistem testi
Mesajlaşma sistemlerinde request/response zihniyeti yetersiz kalır. Mesaj yayınlanır, consumer daha sonra işler, başka bir event üretir ve sonuç eventual consistency ile görünür olabilir.
Testte şu özellikler önemlidir:
- mesaj en az bir kez mi, en fazla bir kez mi işleniyor?
- duplicate event idempotent mi?
- ordering garanti mi?
- consumer crash olursa mesaj ne olur?
- dead-letter kuyruk (queue) çalışıyor mu?
- poison message sistemi kilitliyor mu?
- yeniden deneme backoff doğru mu?
- transaction ile message publish arasında dual-write riski var mı?
publish(); assertDatabaseImmediately(); çoğu zaman yanlış testtir. Sistem sözleşmesi eventual ise test de bounded eventual assertion kullanmalıdır.
Örneğin:
publish order-created
within 5 s:
    invoice status == CREATED
Bu timeout “5 saniye bekle” değil, maksimum kabul edilen sistem davranışıdır.
Eşzamanlılık testini bekleme süresiyle değil olay sırasıyla kurmak. Sürüm numarası v = 0 olan bir kaydı iki ayrı işlem aynı anda okusun. T1 yeni değer ve beklenen sürüm 0 ile güncelleme yapıp v = 1 olarak tamamlasın. Ardından T2, hâlâ eski sürüm 0 üzerinden yazmaya çalıştığında iyimser eşzamanlılık denetimi bu yazmayı reddetmelidir. Sistem işlemi yeniden deneyecekse T2 güncel değeri tekrar okuyup yeni sürüme göre hesap yapmalıdır. Test, rastgele gecikme eklemek yerine iki okuma ve iki yazma noktası arasında kontrollü senkronizasyon kullanır; sonuçta kayıp güncelleme oluşmadığını ve beklenen hata/yeniden deneme sözleşmesinin işletildiğini doğrular. İşlemler veri tabanı düzeyinde yalıtılmış olsa bile uygulamanın eski veriden türetilmiş kararı ayrıca denetlemesi gerekebilir.
Mesajın tekrar işlenmesi bir hata senaryosu değil temel çalışma koşuludur. Consumer başarıyla yan etki oluşturduktan sonra offset veya acknowledgment kalıcılaşmadan çökerse aynı olay tekrar teslim edilebilir. Entegrasyon testi bu çökme penceresini özellikle kurmalı, aynı olay kimliğiyle tekrar işleme sonucunda kaç kalıcı iş etkisi oluştuğunu doğrulamalıdır. Yalnız listener metodunun bir kez çağrıldığını kontrol etmek, broker ve veritabanı arasında verilen güvenilirlik sözünü test etmez.
Test matrisi en azından yayın öncesi çökme, yayın sonrası onay kaybı, duplicate delivery, consumer yeniden başlatma, poison message, gecikmiş yeniden deneme ve sıra dışı teslimatı kapsamalıdır. İş sırasının gerekli olmadığı akışlarda küresel sıralama varsayımı yapılmamalıdır. Zamanlama uyumsuzluğunu sleep ile saklamak yerine gözlenebilir tamamlanma koşulu, kontrollü clock ve sınırlı timeout kullanılmalıdır.
Ünite 4: Performans, Dayanıklılık, Güvenlik, Regresyon ve Kalite Ölçümü
Yük testi yürütülmeden önce beklenen trafik dağılımı, istek karışımı ve sistemin başarısızlık ölçütleri tanımlanır. Yük artarken yanıt süresinin hangi noktada kuyruk gecikmesiyle büyüdüğü, hata oranının nasıl değiştiği ve bağımlı kaynakların doyuma ulaşıp ulaşmadığı incelenir. Test aracının yeterli istek üretememesi sistem başarımıyla karıştırılmamalıdır. Soğuk başlatma, ani yüklenme ve uzun süreli çalışma senaryoları farklı hata türlerini gösterebilir.
44. Performans testi: hızlı mı sorusundan önce hangi yükte sorusunu cevaplayın
Performans tek sayı değildir. En az şu boyutlar ayrılmalıdır:
- gecikme (latency),
- işlem hacmi (throughput),
- concurrency,
- resource utilization,
- queueing,
- hata oranı,
- saturation.
Bir servisin tek kullanıcıyla 10 ms cevap vermesi kapasitesi hakkında çok az bilgi verir. Yük arttığında connection pool, iş parçacığı pool, GC, database kilit veya dış servis darboğaz olabilir.
44.1 Performans test türleri
Load test: beklenen normal/yüksek iş yükünde davranışı ölçer.
Stress test: kapasite sınırının üzerine çıkarak sistemin nasıl bozulduğunu ölçer.
Spike test: ani yük artışını sınar.
Soak/endurance test: uzun süreli yükte memory leak, connection leak ve kaynak birikimini arar.
Capacity test: kabul edilebilir SLO altında maksimum kapasiteyi bulmaya çalışır.
Scalability test: kaynak artışının kapasiteye etkisini ölçer.
44.2 Test modeli üretim trafiği profilinden gelmeli
Gerçek sistem 90% read, 8% write, 2% ağır rapor çalıştırıyorsa bütün kullanıcıları aynı uç noktaya vuran test gerçekçi değildir.
İş yükü modeli şu bilgileri içermelidir:
geliş hızı
istek dağılımı
yük dağılımı
oturum davranışı
think time
cache warm/cold state
veri kardinalitesi
JMeter, k6, Gatling veya başka araç seçimi ikincil konudur. Yanlış workload modeliyle en iyi araç da yanlış sonuç üretir.
Sabit sanal kullanıcı ile sabit geliş hızı eşdeğer değildir. Kapalı çevrimde 50 sanal kullanıcının her isteğin ardından bir saniye beklediğini düşünelim. İstek işleme süresi büyüdükçe her kullanıcının tamamladığı çevrim sayısı azalır. Bu koşullarda “50 kullanıcı” ifadesi, sabit 50 RPS üretildiğini garanti etmez. Açık çevrimli arrival-rate deneyinde ise istek başlangıçları hedeflenen hızla planlanır; istemci bu hızı üretemiyorsa testin başarısızlığı sonuçlara açıkça yansıtılmalıdır.
Karşılaştırılan sürümlerde aynı veri dağılımı, URL karışımı, veri hazırlığı, bağlantı reuse, TLS koşulu ve istemci pacing'i kullanılmalıdır. Yük üreticisinin CPU/bağlantı sınırları da ölçülmelidir. Ortalama RPS tek başına kazanım değildir: p99, timeout, reddedilen istek, başarısız doğrulama ve tamamlanan geçerli iş sayısı birlikte raporlanmalıdır. Yanlış veya eksik cevap üreten sürümün daha hızlı olması performans başarısı kabul edilemez.
45. Ortalama gecikme çoğu zaman gerçeği saklar
gecikme dağılımı sağa çarpıksa ortalama kullanıcı deneyimini gizleyebilir.
Örnek:
900 istek = 50 ms
90 istek  = 100 ms
9 istek   = 500 ms
1 istek   = 10 s
Ortalama kabul edilebilir görünebilir; fakat P99 ve max ciddi kuyruk veya timeout sorununu gösterir.
Bu dağılımı görebilmek için performans raporunda en az şu ölçüler birlikte okunmalıdır:
- median/P50,
- P90,
- P95,
- P99,
- maksimum,
- işlem hacmi,
- hata oranı
birlikte değerlendirilmelidir.
Percentile da tek başına yeterli değildir. Coordinated omission gibi ölçüm hataları yük üreticisinin gerçek gecikmeyi olduğundan iyi göstermesine yol açabilir. Sabit arrival-rate sistemiyle kapalı çevrim kullanıcı modelinin neyi ölçtüğü bilinmelidir.
Performans testi yalnız sonuç raporu değildir; ölçüm sistemi de test edilmelidir.
Gecikme histogramının kapsamadığı istekler. İstek zaman aşımına uğradığında ölçüm aracının bu örneği atması veya yalnız başarılı istekleri histogramda tutması p99'u yapay olarak iyileştirebilir. Bu nedenle başarı ve hata gecikmeleri ayrı dağılımlar hâlinde, tüm girişimlerin sayısı korunarak raporlanmalıdır. Bir dakikalık p99 değerlerinin aritmetik ortalaması, bütün deneyin p99'u değildir; ham gözlemler veya birleştirilebilir uygun histogram verisi gerekir.
Regresyon kapısı tek bir eşik yerine bileşik olabilir: hedef yükte geçerli throughput alt sınırı, timeout oranı üst sınırı, p99 sınırı ve kaynak bütçesi aynı anda sağlanır. Her yük kademesi için warm-up ve kararlı ölçüm penceresi ayrılmalı; örnek sayısı düşük kuyruk yüzdelikleri için belirsizlik açıkça ifade edilmelidir. Testin kapasite sınırına yaklaşması nedeniyle dağılımın kararsızlaştığı rejim “normal çalışma” diye özetlenmemelidir.
46. Performans sonucunu koddan önce sistem modeliyle açıklamak
Performans testinin en zayıf biçimi şu rapordur:
Test başarılı: 10.000 kullanıcı desteklendi.Bu cümle tek başına neredeyse anlamsızdır. 10.000 kullanıcı eşzamanlı mıydı? Her biri ne sıklıkla istek gönderdi? Veri kümesi ne büyüklükteydi? önbellek sıcak mıydı? Hata oranı neydi? Test ne kadar sürdü? Sistem kaynakları hangi noktada doygunluğa ulaştı?
Daha yararlı rapor:
1200 req/s sabit geliş hızı
400 aktif oturum
30 dakika kararlı durum
P95 = 182 ms
P99 = 410 ms
hata oranı = 0.04%
DB pool peak utilization = 86%
CPU = 64-72%
GC pause P99 = 9 ms
Bu veriler neden-sonuç kurmaya izin verir.
46.1 Little Yasası ile tutarlılık kontrolü
Kararlı bir sistemde kabaca:
L = λWL: sistemde ortalama iş sayısı,λ: işlem hacmi/geliş hızı,W: ortalama sistemde kalma süresi.
Örneğin 1000 req/s ve ortalama 100 ms yanıt süresi varsa sistemde ortalama yaklaşık 100 aktif istek beklenir. Ölçüm bunun çok dışındaysa queueing, instrumentation veya workload modelini yeniden incelemek gerekir.
Performans mühendisliği yalnız kıyaslama testi (benchmark) çalıştırmak değil, ölçümün fiziksel/matematiksel olarak anlamlı olup olmadığını sınamaktır.
46.2 Tek değişken ilkesi
Aynı anda JVM heap, iş parçacığı pool, Hikari pool, SQL indeksleri ve önbellek ayarları değiştirilip sonuç iyileşirse hangi değişikliğin etkili olduğunu bilemeyiz.
İyi deney:
baseline ölç
tek değişkeni değiştir
aynı yükü uygula
karşılaştır
hipotezi değerlendir
Test mühendisliği bilimsel yönteme en çok burada yaklaşır.
47. Dayanıklılık testi: başarısızlığı engelleyemiyorsak davranışını sınayalım
Dağıtık sistemde ağ kesintisi, timeout, process restart, disk dolması veya bağımlı servis hatası istisna değildir. Bunlar sistem modelinin parçasıdır.
Dayanıklılık testinde şu soruları sormak gerekir:
- bağımlı servis 500 dönerse ne olur?
- connection timeout olursa iş parçacığı birikir mi?
- yeniden deneme aynı isteği çoğaltır mı?
- circuit breaker açılır mı?
- düğüm devre dışı kalırsa trafik başka node'a geçer mi?
- veritabanı failover sırasında transaction ne olur?
- önbellek kaybolursa sistem doğruluğunu korur mu?
- disk dolarsa log sistemi uygulamayı durdurur mu?
Fault injection kontrollü biçimde bu hataları üretir.
47.1 yeniden deneme testi
yeniden deneme mekanizması özellikle dikkat ister. Yanlış yapılandırılmış yeniden deneme, kesinti anında yükü daha da artırabilir.
normal trafik: 1000 req/s
her başarısız çağrı: 3 retry
bağımlılık çökerse teorik istek baskısı: ~4000 req/s
Backoff ve jitter bu nedenle yalnız “resilience pattern” değil, test edilmesi gereken sistem davranışıdır.
47.2 Idempotency
yeniden denemenin güvenli olabilmesi için işlem semantiği önemlidir. GET tekrar edilebilir; para transferi gibi yan etkili POST aynı kolaylıkla tekrar edilemez. Idempotency key veya başka deduplication mekanizması varsa test duplicate isteği bilinçli üretmelidir.
47.3 Degradasyon ve toparlanma matrisi
Dayanıklılık testi yalnız hata enjekte edildi, servis ayakta kaldı sonucuyla bitmemelidir. Her hata için korunması gereken davranış, gözlenecek sinyal ve toparlanma koşulu önceden tanımlanır.
- bağımlılık gecikmesi: Korunması gereken invariant: bekleyen iş sınırsız büyümemeli; Gözlenecek sinyal: in-flight, kuyruk, P95/P99, pool wait; Toparlanma kanıtı: gecikme kalkınca kuyruk kontrollü boşalmalı.
- bağlantı reddi: Korunması gereken invariant: iş parçacığı/connection sızıntısı olmamalı; Gözlenecek sinyal: active threads, connection count, error rate; Toparlanma kanıtı: bağımlılık dönünce yeni çağrılar normale dönmeli.
- DB havuzu doygunluğu: Korunması gereken invariant: yeni iş bounded davranmalı; Gözlenecek sinyal: acquisition time, timeout, kuyruk depth; Toparlanma kanıtı: baskı kalkınca acquisition süresi baseline'a yaklaşmalı.
- yeniden deneme tetiklenmesi: Korunması gereken invariant: yeniden deneme ana yükü katlamamalı; Gözlenecek sinyal: yeniden deneme/original ratio, request rate; Toparlanma kanıtı: yeniden deneme trafiği hata ortadan kalkınca sona ermeli.
- tüketici backlog'u: Korunması gereken invariant: recovery veritabanını ezmemeli; Gözlenecek sinyal: lag, consume rate, DB saturation; Toparlanma kanıtı: backlog kontrollü hızla sıfırlanmalı.
- disk/bellek baskısı: Korunması gereken invariant: sistem tanımlı biçimde degrade olmalı; Gözlenecek sinyal: free space, heap/native memory, rejection; Toparlanma kanıtı: geçici kaynaklar bırakılıp güvenli banda dönülmeli.
Bu matrisin temel farkı, yalnız fault injection'a değil sonraki zamana da bakmasıdır. Hata kaldırıldıktan sonra sistem eski kapasitesine dönemiyor, kuyruk boşalmıyor veya kaynak tüketimi yüksek kalıyorsa test başarıyla sonuçlanmış sayılmaz.
Ayrıca degradasyon davranışı işlevsel doğruluğu korumalıdır. Örneğin yoğunluk altında düşük öncelikli bir rapor reddedilebilir; fakat aynı durum yetkilendirme kontrolünün atlanmasına, transaction sınırının değişmesine veya yanlış/eksik verinin başarılı cevap olarak dönmesine izin vermez.
Bu nedenle dayanıklılık testinin oracle'ı yalnız availability değildir:
availability
+ bounded resource use
+ correctness
+ isolation
+ recovery time
birlikte değerlendirilir. Böylece chaos veya fault injection bir gösteri olmaktan çıkar, tekrar üretilebilir bir doğrulama tekniğine dönüşür.
48. Chaos engineering: rastgele bozmak değil hipotez sınamak
Chaos engineering bazen “üretimde servis kapatmak” biçiminde anlaşılır. Olgun yaklaşımda önce steady-state davranışı ve hipotez tanımlanır:
Hipotez:
Bir uygulama düğümü kaybedildiğinde başarılı istek oranı %99,9'un altına düşmeyecek ve P99 1 saniyeyi aşmayacak.
Sonra kontrollü fault uygulanır, ölçülür ve geri alınır.
Chaos testi için ön koşullar:
- güçlü gözlemlenebilirlik,
- blast radius kontrolü,
- otomatik rollback/durdurma,
- açık sahiplik,
- üretim öncesi daha dar ortamlarda doğrulama.
Kaos, gözlemleyemediğimiz sisteme uygulanmaz. Aksi hâlde deney değil arıza üretmiş oluruz.
49. Güvenlik testi: fonksiyonel testin düşmanca girdilerle genişletilmiş hâli değildir
Güvenlik testi farklı bir zihniyet ister. Fonksiyonel test “yetkili kullanıcı bu işlemi yapabiliyor mu?” diye sorar. Güvenlik testi “yetkisiz kullanıcı bunu başka bir yoldan yapabiliyor mu?” sorusunu ekler.
Güvenli Yazılım Mühendisliği – Uygulamalı Siber Güvenlik notunda ele aldığım saldırı yüzeyi burada doğrudan test modeline dönüşür:
kimlik
 -> yetkilendirme
 -> oturum
 -> girdi
 -> veri erişimi
 -> dosya sistemi
 -> dış servis
 -> yapılandırma
 -> log
OWASP Web Security Testing Guide bu alanı bilgi toplama, yapılandırma, kimlik, authentication, authorization, session management, input validation, hata yönetimi, kriptografi, iş mantığı ve client-side testler olarak sistematik biçimde ele alır.
49.1 Yetkilendirme testinde pozitif test yetmez
A kullanıcısı A kaydını okuyabilir -> PASSBu tek başına güvenlik kanıtı değildir.
Gerekli negatif test:
A kullanıcısı B kaydını okuyamaz -> PASSDaha sonra:
A admin uç noktayıne gidemez
expired token kullanamaz
silinmiş yetki cache'de yaşamaz
ID değiştirerek başka nesneye erişemez
Yetkilendirme test matrisi çoğu projede role × resource × action ekseninde düşünülmelidir.
49.2 Güvenlik otomasyonu neyi kaçırır?
SAST, DAST ve bağımlılık tarayıcıları yararlıdır; fakat iş mantığı açığını her zaman bulamaz. “Bir müşteri kendi kuponunu yüz kez kullanabiliyor” problemi çoğu tarayıcının anlayacağı bir pattern değildir.
Otomasyon bilinen sınıfları geniş ölçekte tarar; insan analizi sistemin anlamını sorgular.
50. Uyumluluk, kurulum, yükseltme ve geri dönüş testleri
Bir yazılım yalnız sıfırdan kurulumda çalışıyorsa yaşam döngüsünün küçük kısmı test edilmiştir.
Gerçek üretim akışında:
v1 -> v2 -> v3geçişi vardır. Database schema, config formatı, önbellek içeriği, persisted dosyalar ve dış istemciler eski sürümden gelir.
Yaşam döngüsünü gerçekten sınamak için en az şu geçişleri ayrı senaryolar olarak ele almak gerekir:
- temiz kurulum,
- önceki desteklenen sürümden yükseltme,
- migration'ın yarıda kesilmesi,
- rollback,
- eski client ile yeni server,
- yeni client ile eski server,
- config alanı kaldırılması/yeniden adlandırılması,
- veri formatı dönüşümü.
Migration testi yalnız script'in syntax olarak çalışması değildir. Veri kaybı, default değer, constraint ve büyük veri süresi de ölçülmelidir.
50.1 Geri dönüş gerçekten mümkün mü?
dağıtım planında “sorun olursa rollback” yazmak kolaydır. Eğer migration geri alınamaz veri dönüşümü yaptıysa eski binary'nin yeniden deploy edilmesi rollback değildir.
Rollback test edilmemişse bir varsayımdır.
51. Regresyon testi: her şeyi tekrar çalıştırmak değil değişiklik riskini kontrol etmek
Regression suite zamanla büyür. Her bulunan hata için test eklenir fakat eskiler nadiren değerlendirilir. Sonuç saatler süren, büyük bölümü düşük bilgi üreten paket olabilir.
Regresyon stratejisini katmanlamak yararlıdır:
smoke            -> sistem ayağa kalkıyor mu?
değişen alan     -> değişen davranışlar
kritik yol    -> iş açısından vazgeçilmez akışlar
tam regresyon  -> geniş kapsam
CI işlem hattı değişiklik hızına göre farklı seviyeleri çalıştırabilir.
51.1 Regression testinin ömrü
Her test sonsuza kadar yaşamamalıdır. Şunlar düzenli gözden geçirilmelidir:
- davranış artık var mı?
- aynı riski daha ucuz test eden başka test var mı?
- test yalnız eski uygulama ayrıntısını mı koruyor?
- başarısız olduğunda gerçek defect buluyor mu?
- bakım maliyeti ürettiği güvene değer mi?
Test kodu da üretim kodu gibi refactor ve silme hakkına sahiptir.
52. Kod kapsamı: harita, kalite sertifikası değil
Statement veya branch coverage, test sırasında hangi kodun çalıştırıldığını gösterir; fakat yüksek kod kapsamı güçlü assertion yazıldığını veya doğru oracle kullanıldığını garanti etmez.
Örnek:
@Test
void callsMethod() {
    service.calculate(10);
}
Bu test satırları çalıştırabilir ve kod kapsamını artırabilir; hiçbir sonucu doğrulamaz.
Coverage şu amaçla faydalıdır:
- tamamen testsiz alanları bulmak,
- kritik branch'lerin hiç çalışmadığını görmek,
- değişiklikle test kapsamı arasındaki boşluğu incelemek.
Şu amaçla zayıftır:
- takım performansını ölçmek,
- “%90 ise kaliteli” demek,
- düşük değerli test üretimini teşvik etmek.
52.1 Branch coverage da yeterli değildir
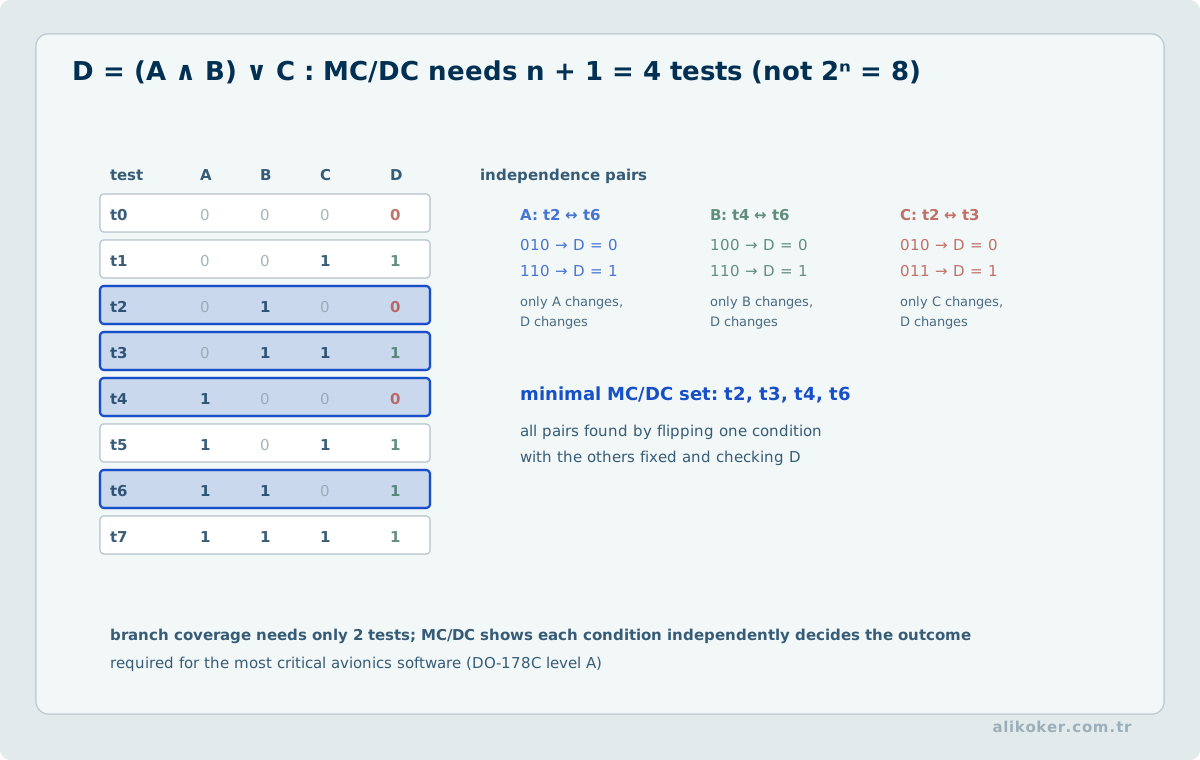
Bir boolean ifadenin iki sonucu sınansa bile koşullar arasındaki bağımsız etki görünmeyebilir. Safety-critical alanlarda MC/DC gibi daha güçlü kapsam ölçütleri gerekebilir.
Coverage seviyesi sistem riskine göre seçilmelidir.
Satır veya dal kapsamının yüksek olması, kararın bağımsız koşullarının gerçekten sınandığını göstermez. A && B kararında yalnız A=false ve A=true, B=true durumlarını çalıştırmak bütün sonuç yollarını görebilir; fakat B'nin kararı tek başına değiştirdiği koşul gözlenmemiştir. MC/DC yaklaşımında her temel koşulun diğer koşullar uygun biçimde sabitlenirken karar sonucuna bağımsız etkisi gösterilir. Bu ölçüt özellikle kritik karar mantığında anlamlıdır; yine de yanlış gereksinimi doğru uygulayan bir programın hatasını tek başına yakalayamaz.
53. Test metrikleri: ölçmek davranışı değiştirir
Bir ölçü yönetim hedefine dönüştüğü anda ekip davranışı o sayıyı iyileştirecek yönde değişmeye başlar. Test metriklerini seçerken Goodhart etkisini göz ardı etmek, ölçümün kendisini kalite sorununa dönüştürebilir.
Yararlı olabilecek göstergeler:
- escaped defect rate,
- defect detection phase,
- test execution duration,
- flaky test rate,
- mean time to diagnose failed test,
- mutation score,
- kod kapsamı eğilimi,
- üretim olaylarının regresyon kapsamı,
- test failure cause distribution.
Tek başına “test case sayısı” veya “bulunan bug sayısı” çoğu durumda kötü performans göstergesidir. Testçinin çok bug bulması iyi testçilikten de kötü ürün kalitesinden de kaynaklanabilir.
53.1 Defect Removal Efficiency
Kavramsal olarak:
DRE = geliştirme/test sırasında bulunan kusur /
      (geliştirme/test sırasında bulunan + üretime kaçan kusur)
Bu tür metrikler trend görmek için yararlıdır; kusur ağırlığı ve sınıflandırması hesaba katılmadan tek başına yönetim hedefi yapılmamalıdır.
54. Kusur raporu: tekrar üretilemeyen hata yarım bilgidir
İyi defect raporu geliştiricinin problemi yeniden üretmek için tahmin yapmasını azaltır.
Gerekli bağlam çoğu zaman şunlardır:
sürüm / commit
çevre
ön koşul
test verisi
adımlar
beklenen davranış
gerçek davranış
zaman damgası
correlation/request id
log/trace/screenshot
tekrar oranı
“Hata var” ile “POST /api/orders çağrısı aynı idempotency-key ile 200 ms arayla gönderildiğinde iki ORDER_CREATED event'i üretiyor” arasında teşhis maliyeti açısından büyük fark vardır.
54.1 Severity ve priority aynı şey değildir
Severity teknik/iş etkisini, priority ne zaman ele alınacağını ifade eder. Düşük severity görsel hata lansman öncesinde yüksek priority olabilir. Kritik fakat yalnız kullanılmayan eski bir özellik (feature)'daki hata geçici olarak daha düşük priority alabilir.
Bu ayrım kararın şeffaf olmasını sağlar.
55. Kök neden analizi: testi değil sistemi düzeltmek
Üretimde kusur bulunduğunda yalnız bug fix ve regression test eklemek yeterli olmayabilir.
Şu zinciri sorgulamak gerekir:
Hata neden oluştu?
Neden review'da görülmedi?
Neden unit/integration test yakalamadı?
Neden staging'de görünmedi?
Neden monitoring erken alarm vermedi?
Bu sorular suçlu aramak için değil kontrol zincirindeki boşluğu bulmak içindir.
Örneğin BOLA açığı üretimde bulunduysa yalnız uç noktaya authorization kontrolü eklemek yerine:
- authorization policy mimarisi,
- ortak security interceptor,
- role/resource test matrisi,
- code review checklist,
- security integration testleri
gözden geçirilmelidir.
Tekil kusur, sistemik iyileştirme için veri üretmelidir.
56. CI/CD içinde test: geri bildirim süresini mimari karar olarak ele almak
işlem hattının görevi bütün testleri her adımda çalıştırmak değil, doğru kanıtı doğru zamanda üretmektir.
Örnek:
commit
  -> compile
  -> static checks
  -> small tests
  -> changed-module integration
  -> package
  -> medium tests
  -> security/dependency checks
  -> deploy ephemeral env
  -> smoke / contract
  -> selected E2E
  -> performance/security scheduled suites
Bir geliştirici küçük değişiklik için 45 dakika geri bildirim bekliyorsa test paketi geliştirme akışından ayrılır. İnsanlar testleri lokal çalıştırmamaya, işlem hattı sonuçlarını beklememeye veya bypass etmeye başlar.
56.1 Quality gate
Kalite kapısı yalnız kod kapsamı yüzdesine indirgenmemelidir. Örneğin:
unit/integration tests pass
critical mutation regression pass
no new critical vulnerability
migration validation pass
flaky rate below eşik
performance regression within budget
Her kapının neden var olduğu bilinmelidir. Kullanılmayan veya sürekli override edilen gate güvenlik tiyatrosuna dönüşür.
57. Test suite performansı da performans problemidir
Binlerce test çalıştıran sistemde test altyapısı kendi başına bir workload'dur.
Yavaşlığın tipik nedenleri:
- her sınıfta context yeniden başlatma,
- gereksiz container oluşturma,
- devasa fixture yükleme,
- serial çalışma,
- dış ağ,
- repeated schema migration,
- gereksiz UI testi,
- test başına process başlatma.
Optimizasyon sırası üretim performansına benzer olmalıdır:
ölç
sıcak noktayı bul
tek değişiklik yap
tekrar ölç
57.1 Paralel test
JUnit 6 güncel sürümlerinde parallel execution desteği gelişmiştir. Ancak testler parallel çalıştırılınca gizli sıkı bağlılık görünür olur:
- aynı port,
- aynı dosya,
- aynı DB şeması,
- static singleton,
- global system property.
Paralel test başarısızlığı çoğu zaman “JUnit problemi” değil isolation problemidir.
Testleri bağımsız tasarlamak hem paralellik hem güvenilirlik kazandırır.
58. Legacy code testi: önce davranışı kilitle, sonra değiştir
Testsiz eski kodda doğrudan refactor risklidir çünkü “doğru davranış” dokümante edilmemiş olabilir.
Characterization test mevcut davranışı gözlemleyip kilitler. Amaç mevcut davranışın ideal olduğunu iddia etmek değildir; değişiklik sırasında neyin değiştiğini görünür kılmaktır.
Akış:
mevcut davranışı çalıştır
çıktıyı gözle
gerekli davranışı test ile sabitle
küçük refactor yap
testleri çalıştır
tekrar et
58.1 Seam bulmak
Eski kod dış veritabanı, statik fonksiyon veya dosya sistemine sıkı bağlı olabilir. Test edilebilir bir seam oluşturmak için en küçük güvenli değişiklik yapılır.
Örneğin:
System.currentTimeMillis()doğrudan kullanımını bir zaman sağlayıcısı arkasına almak, büyük mimari dönüşümden daha güvenli ilk adımdır.
58.2 Golden master
Çok karmaşık, doğruluğu tam tanımlanmamış output üreten legacy sistemlerde mevcut çıktılar golden master olarak kaydedilebilir. Sonraki değişiklikte diff alınır.
Bu yaklaşım güçlü ama tehlikelidir: mevcut bug'ları da kilitler. Diff mutlaka insan/domain değerlendirmesinden geçmelidir.
59. Test smell'leri: test kodunun bize anlattığı tasarım sorunları
Sık görülen test smell'leri:
Mystery Guest
Testin gerektirdiği veri dosya/database içinde gizlidir. Test okununca neden geçtiği anlaşılmaz.
Eager Test
Tek test çok sayıda davranışı sınar. Kırılınca sebep belirsizdir.
Fragile Test
Davranış değişmeden küçük refactor'da kırılır.
Slow Test
Dar bir davranış için gereksiz altyapı çalıştırır.
Test Code Duplication
Fixture kurulumu yüzlerce testte kopyalanmıştır.
Conditional Test Logic
Test içinde karmaşık if/loop bulunur; testin kendisi hata kaynağı olur.
Assertion Roulette
Çok sayıda benzer assertion vardır; hangisinin neden başarısız olduğu anlaşılmaz.
Sleepy Test
Zamana sleep ile güvenir.
Overspecified Interaction
Mock çağrı sırasını gereksiz ayrıntıyla kilitler.
Test smell çoğu zaman üretim kodundaki tasarım kokusu ile birlikte görülür. Test çok zor kuruluyorsa domain nesnesi fazla bağımlılık taşıyor olabilir. Private metotları ayrı test etmek zorunda hissediyorsak sınıfın sorumluluğu fazla olabilir.
Çevrimdışı sözleşme testleri ve bağlantısız doğrulama
Üretim bağımlılıklarına erişmeden yapılabilen doğrulama, özellikle büyük ve uzun ömürlü sistemlerde hızlı geri bildirim sağlar. Amaç gerçek veritabanını veya ağı taklit ederek bütün entegrasyon testlerinin yerini almak değildir; dış bağımlılık gerektirmeyen sözleşmeleri ayrı bir katmanda deterministik biçimde sınamaktır.
Bu katmanda şu tür kanıtlar üretilebilir:
- kaynak kodun derlenmesi ve paketlenmesi,
- kritik sınıf ve dosyaların beklenen sözleşme imzalarını koruması,
- istemci tarafı modüllerinin yüklenebilmesi,
- sabit fixture üzerinde temel kullanıcı akışlarının çalışması,
- yetkilendirme, durum geçişi veya veri biçimi gibi saf kuralların beklenen sonucu üretmesi,
- değişiklik kapsamı dışında kalan dosyaların beklenmedik biçimde değişmediğinin doğrulanması.
kaynak
  |
  +--> derleme
  +--> sözleşme denetimi
  +--> çevrimdışı fixture
  +--> smoke akışı
  |
  v
entegrasyon ortamına çıkmadan önce hızlı kanıt
Bu yaklaşım özellikle bağlantı kurulamadığında veya üretim verisi test ortamına taşınamadığında değerlidir. Test verisi küçük ve açık biçimde oluşturulur; zaman, ağ ve dış servis rastlantısallığı test sonucundan çıkarılır. Sonuç deterministik hale geldikçe regresyonun kaynağını ayırmak kolaylaşır.
Sözleşme imzası testi yalnız metin aramak olmamalıdır. Bir fonksiyonun adı korunmuşken davranışı değişebilir. Bu nedenle statik imza denetimi, davranış fixture'ı ve gerekiyorsa tarayıcı smoke testi birbirini tamamlayan katmanlar olarak ele alınmalıdır. Hiçbiri tek başına yeterli kanıt değildir.
Çevrimdışı testlerin bir başka yararı, hata durumunu üretmeyi ucuzlaştırmasıdır. Ağ zaman aşımı, boş cevap, geçersiz durum geçişi veya yarım kalmış istemci yaşam döngüsü gerçek servisi bozmak zorunda kalmadan simüle edilebilir. Bu katman Yazılım Mühendisliği içindeki değişiklik riski ve Temiz Kod ve Bakım Mühendisliği içindeki davranış eşdeğerliği kavramlarıyla birlikte okunmalıdır.
Performans ve Dayanıklılık Testinin Fonksiyonel Teste Eklenmesi
Güvenlik ve güvenilirlik ayrı sonradan-eklenen özellikler değil, ortak hata ve kötüye kullanım yüzeyini yöneten tasarım özellikleridir. Test mühendisliğinde kaynak sınırları ve blast radius, yalnız üretim önlemi değil test edilebilir bir sözleşmedir; hata enjeksiyonu sırasında yetki ayrımı, güvenli varsayılanlar, geri alma süresi ve kurtarma prosedürü de doğrulanmadıkça sistemin kontrollü biçimde başarısız olduğu gösterilmiş olmaz. Özellikle DoS sınıfı problemlerde güvenlik kontrolünün kendisinin kullanılabilirliği tüketmemesi gerekir.
- Load test sırasında yalnız maksimum throughput değil saturation başlangıcının bulunması.
- Fault injection ile dependency timeout, retry storm ve recovery davranışının gözlenmesi.
- Regression kriterlerine p95/p99 latency ve kaynak tüketim sınırlarının eklenmesi.
Kriptografik testlerde doğrulama ve olumsuz örnekler
Kriptografik bir arayüzde decrypt(encrypt(m))=m özelliğinin sağlanması gerekli olabilir fakat yeterli değildir: aynı kusur hem şifreleme hem çözmede bulunduğunda test yine geçebilir. Bu nedenle resmi test vektörleriyle bağımsız uyum testi, farklı uygulamalar arası test, değiştirilmiş etiket/AAD olumsuz testi ve uzunluk/sınır testleri ayrı yürütülür. Uygulama bütünlüğü sınanırken doğrulanmamış plaintext'in herhangi bir kod yolundan geçmediği de denetlenir.
Test raporu anahtarın üretim biçimini, nonce politikasını, kitaplık sürümünü, platformu ve beklenen hata sınıfını açıkça kaydetmelidir. Sabit test anahtarları yalnız birim testlerine aittir. Başarılı bir test dizisi IND-CCA ispatı veya yan kanal yokluğu iddiası değildir. Kriptografik güvenlik tanımları Kriptoloji dersinde, otomasyon ve regresyon tasarımı bu ünitede ele alınır.
Ünite 5: Otomasyon, Yapay Zeka, Üretim ve Gözlemlenebilirlik
60. Test otomasyonu: manuel testi silmek değil tekrarı makineye bırakmak
Her test otomasyona uygun değildir. Otomasyonun güçlü olduğu alanlar:
- sık tekrar,
- deterministik oracle,
- yüksek regresyon riski,
- çok veri kombinasyonu,
- performans ölçümü,
- API/contract doğrulaması.
İnsanın güçlü olduğu alanlar:
- keşif,
- kullanılabilirlik,
- yeni özelliğin anlaşılması,
- belirsiz gereksinimin sorgulanması,
- beklenmeyen davranışın yorumlanması.
“%100 otomasyon” hedefi genellikle anlamsızdır. Daha doğru hedef:
Tekrarlanabilir ve makinece güvenilir biçimde değerlendirilebilen yüksek değerli kontrolleri otomatikleştir; insan dikkatini belirsizlik ve keşfe ayır.
60.1 Record/playback sınırı
UI record/playback araçları ilk senaryoyu hızlı üretir fakat test kodu tasarlanmadığında bakım maliyeti büyür. Tekrar kullanılan page/component abstraction'ları, semantic selector ve veri bağımsızlığı gerekir.
Otomasyon kodu da üretim kodudur. Version control, review, refactor ve performans disiplini ister.
61. Yapay zekâ ile test üretimi: hızlandırıcı, oracle değil
2025–2026 araştırmalarında LLM tabanlı test üretimi, REST API test genişletme, çok etmenli test üretimi ve test paketi değerlendirmesi belirgin biçimde öne çıkmıştır. Araçlar mevcut koddan birim test iskeleti, sınır değeri adayları veya API senaryoları üretebilir.
Bunun gerçek faydası özellikle geniş keşif alanında aday üretmektir. Fakat üç temel risk vardır:
- Model üretim kodundaki yanlış davranışı “beklenen” kabul edebilir.
- Çok sayıda yüzeysel test üretip kod kapsamını artırırken mutasyon skorunu artırmayabilir.
- Testler çerçeve ve uygulama ayrıntılarına aşırı bağlanabilir.
Yapay zekâ tarafından üretilen bir testin doğrudan test paketine alınması yerine şu süzgeçten geçmesi gerekir:
hangi risk?
hangi test oracle'ı?
hangi sınır?
hangi mutantı öldürüyor?
hangi üretim kusurunu yakalayabilir?
Bu sorulara cevap veremeyen test, otomatik üretilmiş gürültü olabilir.
61.1 Yapay zekâ ile test gözden geçirme
LLM'ler mevcut test paketinde eksik sınır durumlarını veya yinelenen test adaylarını da bulabilir. Ancak karar alan bilgisine dayanmalıdır. Modelin önerisi hipotezdir; kanıt değildir.
62. Makine öğrenmesi sistemlerini test etmek: kod doğruyken model yanlış olabilir
ML sistemlerinde klasik yazılım testine yeni belirsizlikler eklenir:
kod
model
veri
özellik çıkarımı
ön işleme
son işleme
eşik
çalışma zamanı
Birim test ön işleme fonksiyonunu doğrulayabilir; model kalitesini tek başına doğrulayamaz.
Test alanları:
- eğitim/servis sapması,
- veri şeması,
- etiket kalitesi,
- sınıf dengesizliği,
- dağılım kayması,
- sağlamlık,
- gecikme,
- determinizm,
- adalet gereksinimleri,
- model sürümü uyumluluğu.
62.1 Sabit doğruluk yeterli değildir
Bir sınıflandırıcıda genel doğruluk yüksekken kritik azınlık sınıfının duyarlılık (recall) değeri kötü olabilir. Karışıklık matrisi, kesinlik (precision), duyarlılık (recall), F1, ROC/PR ve alana özgü maliyet birlikte değerlendirilmelidir.
62.2 Metamorfik ilişkiler
Örneğin ses tanıma sisteminde küçük genlik normalizasyonu metni tamamen ilgisiz sonuca çevirmemelidir. Görüntü sınıflandırmada anlamı bozmayan küçük dönüşümlerde tahmin tutarlılığı incelenebilir.
ML testinde oracle problemi klasik testten daha görünürdür.
62.3 Veri ve model sürümü test girdisinin parçasıdır
Öğrenen sistemde başarısızlık yalnız kod değişikliğinden gelmez. Aynı ikili dosya; farklı model, tokenizer, özellik şeması veya ön işleme sürümüyle farklı sonuç üretebilir. Bu nedenle regresyon testi çalıştırılırken kullanılan bileşen kümesi birlikte sabitlenmelidir:
kod sürümü
+ model sürümü
+ veri / özellik sözleşmesi
+ çalışma zamanı sürümü
+ değerlendirme kümesi
Bu bilgilerden biri belirsizse önceki sonuçla karşılaştırma zayıflar.
62.4 Model regresyonu tek metrikle kurulmaz
Yeni model global metriği yükseltirken kritik bir alt grupta veya belirli hata sınıfında gerileyebilir. Karşılaştırma; karışıklık matrisi dilimleri, kalibrasyon, gecikme, bellek ve gerektiğinde sağlamlık ölçümleriyle birlikte yapılmalıdır. Kabul eşiği model ekibinin “daha iyi” yorumuna değil, sistem gereksinimine bağlanmalıdır.
62.5 Determinizm gereksinimini açık tanımlamak
GPU çekirdeği, paralel indirgeme veya rastlantısal ön işleme bit düzeyinde aynı sonucu üretmeyebilir. Testin gerçekten bit-eşitlik mi, toleranslı sayısal eşitlik mi, yoksa görev metriği kararlılığı mı istediği belirtilmelidir. Aksi halde test ya gereksiz kırılgan olur ya da gerçek regresyonu kaçırır.
AI ile test üretiminin ve AI sistemlerinin test edilmesinin ortak ilkesi aynıdır: test oracle'ı modele devretme; beklenen davranışı gereksinim, veri sözleşmesi ve bağımsız ölçüm üzerinden tanımla.
Analitik testlerde doğru çıktı her zaman önceden bilinen tek sayı değildir. Bir veri dönüşümünün satır sırasını değiştirmesi sonucunu etkilememesi gerekiyorsa farklı sıralamalarda aynı özetin elde edilmesi metamorfik bir özelliktir. Grup anahtarı üzerinde birleştirme yapıldığında anahtar başına tekil kayıt sayısının korunması, doğru şema altında test edilebilir. Öğrenme sisteminde test verisinin etiketi değiştirilmeden dağılımı değiştiğinde ölçütlerin hangi ölçüde etkilendiği ayrıca incelenir. Böylece yalnız programın hata vermemesi değil, analizin istatistiksel ve işlevsel değişmezleri doğrulanmış olur.
63. Gerçek zamanlı ve siber-fiziksel sistem testi
Gerçek zamanlı sistemde yalnız doğru sonuç değil, doğru zamanda sonuç gereksinimdir.
functional correctness + timing correctnessBir kontrol komutu 500 ms sonra doğru üretiliyorsa fiziksel sistem açısından yanlış olabilir.
Test edilmesi gerekenler:
- worst-case response time,
- deadline miss,
- jitter,
- sensor noise,
- clock drift,
- packet loss,
- actuator failure,
- fail-safe state,
- degraded mode.
Güncel araştırmalarda autonomous driving testleri için probabilistic model checking, scenario generation ve simulation yaygın çalışma alanıdır. Bunun nedeni fiziksel dünyanın kombinasyon uzayının gerçek araçla exhaustive test edilemeyecek kadar büyük olmasıdır.
63.1 Hardware-in-the-loop
HIL testi gerçek kontrol donanımını simüle edilmiş fiziksel çevreyle birleştirir. Saf yazılım benzetiminin kaçırdığı timing, I/O ve driver davranışları görülebilir.
Safety-critical sistemde test sonuçlarının izlenebilirliği ve tekrar üretilebilirliği sıradan uygulamadan daha katı tutulmalıdır.
64. Üretimde test: test ortamı gerçeğin tamamı değildir
Staging ortamı üretime yaklaşabilir; yine de üretimin kendisi değildir. Gerçek trafik dağılımı, veri kardinalitesi, ağ topolojisi ve kaynak çekişmesi ancak canlı sistemde bütünüyle görünür.
Bu farkı kontrollü biçimde yönetebilmek için üretimde sınırlı doğrulama teknikleri kullanılır:
Smoke after deploy
Kritik uç noktalar deploy sonrasında otomatik doğrulanır.
Canary
Yeni sürüm trafiğin küçük bölümüne açılır. Error rate ve gecikme karşılaştırılır.
Blue/Green
Yeni çevre önceden hazırlanır; trafik kontrollü geçirilir.
Shadow traffic
Üretim isteklerinin kopyası yeni sisteme gönderilir fakat sonuç kullanıcıya dönmez.
özellik flag
Davranış sınırlı kullanıcı grubuna açılır.
Bunların hiçbiri pre-üretim testin alternatifi değildir. Son savunma katmanıdır.
65. Gözlemlenebilirlik testin uzantısıdır
Bir test başarısız olduğunda sistem nedenini açıklayamıyorsa teşhis maliyeti yükselir. Aynı durum üretim için daha kritiktir.
İyi gözlemlenebilirlik:
- structured log,
- metric,
- distributed trace,
- correlation id,
- domain event/audit
ile sistem davranışını görünür kılar.
Test sırasında şu da doğrulanabilir:
hata oluştu
 -> doğru status döndü
 -> doğru metric arttı
 -> correlation id log'a taşındı
 -> hassas veri loglanmadı
Observability yalnız operations konusu değildir; test oracle'ın gözlem yeteneğini de güçlendirir.
66. Test mühendisinin üretim olayından öğrenmesi
En değerli test fikirlerinden bazıları üretim olayından gelir. Incident sonrası yalnız aynı girdiyi regression testine çevirmek yerine hata sınıfını genellemek gerekir.
Örnek:
Bug: 29 Şubat tarihinde rapor üretilmedi.Zayıf düzeltme:
2024-02-29 için tek test ekle.Daha güçlü çıkarım:
tarih sınır sınıfı:
- ay sonu
- yıl sonu
- leap year
- DST geçişi
- timezone conversion
Tek kusur yeni bir test tasarım kuralı öğretmelidir.
67. Test dokümantasyonu: belge üretmek değil karar hafızası oluşturmak
ISO/IEC/IEEE 29119-3 test dokümantasyonunu sistematikleştirir. Uygulamada belge miktarı proje riskine göre ayarlanmalıdır.
Küçük çevik ekipte yüz sayfalık test planı değersiz olabilir; fakat şu kararlar kaybolmamalıdır:
- test kapsamı,
- dışarıda bırakılan alanlar,
- risk öncelikleri,
- çevre,
- giriş/çıkış kriterleri,
- kritik veri setleri,
- sorumluluk,
- bilinen sınırlamalar.
Kritik veya regüle sistemde izlenebilirlik daha ayrıntılı olmalıdır:
requirement -> risk -> test condition -> test case -> result -> defectBelgenin değeri denetimde klasör doldurmak değil, kararın nedenini daha sonra yeniden kurabilmektir.
Ünite 6: Test Stratejisi, İleri Teknikler ve Sonuç
68. Test stratejisi için uygulanabilir algoritma
Yeni bir sistem veya önemli değişiklik önüme geldiğinde test tasarımını şu sırayla kurmak en az gereksiz iş üreten yaklaşımlardan biridir.
Adım 1 — Kalite hedefini belirle
Bu sistemde başarısızlığın en pahalı biçimi nedir?Fonksiyonel hata mı, veri kaybı mı, güvenlik ihlali mi, gecikme mi, kesinti mi?
Adım 2 — Sistemin sınırlarını çiz
UI -> API -> service -> DB -> broker -> dış servisHer sınır farklı test riski taşır.
Adım 3 — Test edilebilir gereksinimleri çıkar
Belirsiz sıfatları ölçülebilir koşullara çevir:
hızlı -> P95 < 250 ms @ 1200 req/s
çok güvenilir -> aylık availability >= ...
Adım 4 — Riskleri sırala
Etki, olasılık, değişiklik yoğunluğu ve tespit maliyetini birlikte düşün.
Adım 5 — Her risk için en ucuz güvenilir katmanı seç
saf iş kuralı -> unit
SQL semantiği -> real DB integration
wire format -> API/contract
kritik kullanıcı akışı -> E2E
kapasite -> performance
Adım 6 — Test verisini ve oracle'ı tanımla
Beklenen sonucu nereden bildiğini açıkla.
Adım 7 — Pozitif kadar negatif yolu tasarla
ne olmalı?
ne olmamalı?
sınırda ne olur?
aynı anda olursa ne olur?
bağımlılık çökerse ne olur?
Adım 8 — Otomasyonu ekonomik kur
Sık ve deterministik kontrolleri işlem hattına al. Pahalı geniş testleri uygun çalışma sıklığına yerleştir.
Adım 9 — Test paketinin kendisini ölç
süre
flaky rate
teşhis süresi
mutation effectiveness
Adım 10 — Üretim geri bildirimini test tasarımına taşı
Incident, telemetry ve gerçek kullanım yeni test fikirlerinin kaynağıdır.
Bu algoritmanın özü test sayısını büyütmek değildir. Belirsizliği sistematik olarak küçültmektir.
69. Bir örnek üzerinden bütün zincir: sipariş servisini test edilebilir hâle getirmek
Basit görünen bir sipariş API'si düşünelim:
POST /ordersİş kuralı:
- aktif kullanıcı sipariş oluşturabilir,
- stok yeterli olmalı,
- ödeme alınmalı,
- sipariş kaydedilmeli,
- event yayınlanmalı.
İlk bakışta bir E2E testi yeterli görünebilir. Fakat davranışı risklere bölelim.
69.1 Birim katmanı
Fiyat ve indirim hesapları saf fonksiyon olarak test edilir.
sınır değerleri
yuvarlama
sıfır
geçersiz miktar
69.2 Service katmanı
Stok yetersizse payment çağrısının yapılmadığı doğrulanır. Burada mock interaction anlamlıdır çünkü “payment çağrısı olmaması” iş davranışıdır.
69.3 Repository katmanı
Gerçek database ile:
constraint
transaction
concurrent stock decrement
locking
test edilir.
69.4 API katmanı
JSON validation
status code
error contract
authentication
authorization
sınanır.
69.5 Event katmanı
Sipariş işlemi tamamlandığında olayın tam bir kez veya sistemin seçtiği teslim semantiğine uygun üretildiği kontrol edilir.
69.6 E2E
Bir veya birkaç kritik senaryo bütün zinciri gerçek servislerle yürütür.
69.7 Performans
Normal trafik dağılımı ve stok contention altında P95/P99 ölçülür.
69.8 Dayanıklılık
Payment provider timeout, broker unavailable ve veritabanı failover davranışları sınanır.
69.9 Güvenlik
Başka kullanıcının siparişini okuma/değiştirme, quantity tampering ve replay denenir.
Bu yapıdaki testlerin hiçbiri diğerinin aynısı değildir. Her biri farklı bir varsayımı sınar.
İyi test mimarisinin göstergesi budur.
70. Black-box, white-box ve gray-box: bakış açısı test seviyesi değildir
Black-box ve white-box ayrımı sık biçimde unit/integration ayrımıyla karıştırılır. Oysa bunlar test seviyesini değil test tasarımında hangi bilginin kullanıldığını anlatır.
Black-box test, iç uygulamayı bilmeden dış sözleşme üzerinden test tasarlar. Gereksinim, giriş, çıkış ve kullanıcı davranışı önemlidir.
White-box test, kod yapısı, control flow, branch, condition ve internal state bilgisini test tasarımında kullanır.
Gray-box test, iki bakışı birleştirir. Örneğin API'yi dışarıdan çağırırken veritabanındaki transaction modelini veya authorization mimarisini bildiğimiz için özel senaryolar seçebiliriz.
Bir API integration testi white-box olabilir; bir unit test black-box yazılabilir. Kavramları seviyeye bağlamak gereksiz terminoloji tartışması üretir.
70.1 Yapısal test ve control-flow kapsamı
White-box yaklaşımında yaygın ölçütler:
statement coverage
branch/decision coverage
condition coverage
path coverage
MC/DC
Statement coverage bir satırın en az bir kez çalışmasını ister. Branch coverage kararın her sonucunu görür. Condition coverage bileşik ifadedeki alt koşulların etkisini inceler. MC/DC ise özellikle kritik sistemlerde her temel koşulun karar sonucunu bağımsız olarak etkileyebildiğini göstermeye çalışır.
Aviyonik yazılım güvencesinde yapısal kapsam, gereksinim tabanlı doğrulamanın yerine geçen bağımsız bir kalite puanı değildir. DO-178C bağlamı bu ayrımı görünür kılar: test kanıtı gereksinimlerle ilişkilendirilirken yapısal kapsam, doğrulamanın ulaşmadığı kodu ve ek inceleme ihtiyacını ortaya çıkarmak için kullanılır. Uçuş kontrolü ve kritik yazılım bağlamı için Aviyonik Sistemler ve İnsansız Hava Araçları notuna bakılabilir.
Yol kapsamı teorik olarak güçlüdür; ancak döngü içeren gerçek programlarda olası yol sayısı kısa sürede yönetilemez hâle gelir. Sonlu test bütçesi bu noktada yeniden risk tabanlı örnekleme gerektirir.
70.2 Loop testleri
Döngüde klasik sınırlar hâlâ etkilidir:
0 iterasyon
1 iterasyon
2 iterasyon
normal n
maksimum - 1
maksimum
maksimum + 1
Fakat modern kodda loop yalnız for ifadesi değildir. Stream işlem hattı, yeniden deneme loop, pagination, kuyruk consumer ve recursive traversal aynı sınır düşüncesini gerektirir.
71. Model-based testing: test senaryosunu modelden türetmek
Durum sayısı büyüdüğünde testleri elle listelemek yerine sistemin davranış modelinden üretmek daha güvenilir olabilir.
Bir protokol için model:
DISCONNECTED
   -> CONNECTING
   -> AUTHENTICATED
   -> ACTIVE
   -> CLOSING
   -> DISCONNECTED
Model yalnız geçerli durumları değil, geçiş koşullarını ve yasak geçişleri de içerir. Test generator bu modelden yollar üretebilir.
Model-based testing özellikle:
- protokoller,
- iş akışı (workflow) motorları,
- embedded sistemler,
- telekomünikasyon,
- GUI state machine,
- safety-critical controller
alanlarında değerlidir.
71.1 Model doğru değilse üretilen test de doğru değildir
Otomatik test üretimi modelin yanlışlığını telafi etmez; tersine, hatalı modeli büyük bir disiplinle çoğaltabilir. Bu yüzden davranış modelinin teknik incelemesi test üretiminden ayrı bir mühendislik adımıdır.
71.2 Zamanlı modeller
Gerçek zamanlı protokollerde state yalnız olayla değil zamanla değişebilir:
ACK 200 ms içinde gelmezse TIMEOUTTimed automata ve model checking bu tür sistemlerde güçlü araçlardır. Quiescence ve timeout davranışlarının zamanlı otomatlarla modellenmesi üzerine güncel araştırmalar, klasik test tasarımının gerçek zamanlı sistemlerde neden genişletilmesi gerektiğini gösterir.
72. Biçimsel doğrulama ve test: rakip değil tamamlayıcı
Test sonlu örnekler üzerinde programı çalıştırır. Biçimsel yöntemler belirli bir model veya program özelliğini matematiksel olarak kanıtlamaya çalışabilir.
Araç ve teknik örnekleri:
- model checking,
- symbolic execution,
- bounded model checking,
- contract verification,
- theorem proving.
CBMC, Dafny, Isabelle/HOL ve benzeri araçlar belirli problem sınıflarında testin ulaşamadığı kapsam güvencesi sağlayabilir. Ancak model varsayımları, çalışma ortamının davranışı ve uygulama sınırı yine önemlidir.
Bir fonksiyonun overflow üretmediğini formel olarak kanıtlamak değerlidir; dağıtım sırasında yanlış config ile yanlış servise bağlandığını bu kanıt söylemez.
En güçlü yaklaşım katmanlıdır:
formal property
 + statik analiz
 + unit/property tests
 + integration
 + system observation
Kritik yazılımda “test mi formal verification mı?” sorusu çoğu zaman yanlış ikiliktir.
73. Smoke, sanity, kabul, alpha ve beta: isimden çok amaç
Bu terimler organizasyonlar arasında farklı kullanılabildiği için ekip içinde açık tanım gerekir.
Smoke test, derleme/dağıtımın temel olarak kullanılabilir olup olmadığını hızlı kontrol eder. Sistem ayağa kalkıyor mu, kritik servis cevap veriyor mu, temel akış çalışıyor mu?
Sanity test, daha dar bir değişikliğin ana davranışının hâlâ makul olduğunu kontrol eden kısa pakettir. Her ekip bu terimi kullanmak zorunda değildir; önemli olan ortak anlamdır.
Kabul testi, ürünün tanımlanmış iş/operasyon kabul ölçütlerini karşıladığını doğrular. UAT bunun kullanıcı/paydaş odaklı biçimidir.
Alpha test, ürünün kontrollü ve çoğunlukla organizasyon içi ortamda gerçek kullanım benzeri değerlendirilmesidir.
Beta test, ürünün daha geniş gerçek kullanıcı kitlesinde sınırlı/ön sürüm olarak gözlenmesidir.
Alpha/beta yaklaşımı otomatik regresyonun alternatifi değildir. Gerçek kullanım çeşitliliğinden bilgi üretir.
74. Uyumluluk ve yerelleştirme testi: varsayılan ortam dışında ne oluyor?
Bir yazılım tek browser, tek locale ve tek timezone ile test edildiğinde önemli bir durum uzayı eksik kalabilir.
Uyumluluk matrisi örneği:
OS × çalışma zamanı × browser × database × locale × timezoneTam Cartesian product çoğu zaman gereksizdir; risk, kullanım dağılımı ve pairwise teknikleriyle örnekleme yapılabilir.
74.1 Yerelleştirme
Yerelleştirme testi yalnız metin çevirisi değildir:
- tarih biçimi,
- ondalık ayırıcı,
- para birimi,
- büyük/küçük harf kuralları,
- Unicode normalization,
- metin uzaması,
- sağdan sola yazım,
- sorting/collation.
Türkçedeki I, İ, ı, i dönüşümleri klasik örnektir. İngilizce locale varsayımıyla yazılmış toUpperCase() mantığı kimlik veya arama davranışında gerçek kusur üretebilir.
Timezone testi de aynı derecede önemlidir. UTC'de saklanan zamanın kullanıcı yerel zamanına dönüşümü gün, ay veya raporlama periyodu sınırında değişebilir.
75. Backup, restore ve disaster recovery testi: alınan yedek geri dönmüyorsa yedek değildir
Yedekleme mekanizmasının logda “success” yazması kurtarma kabiliyeti kanıtlamaz.
Test edilmesi gereken gerçek akış:
backup oluştur
izole ortamda restore et
uygulamayı bu veriyle ayağa kaldır
bütünlük kontrolü yap
RPO/RTO ölç
RPO (Recovery Point Objective) ne kadar veri kaybının kabul edilebilir olduğunu, RTO (Recovery Time Objective) hizmetin ne kadar sürede geri dönmesi gerektiğini ifade eder.
Restore testi şu riskleri açığa çıkarabilir:
- eksik encryption key,
- bozuk incremental chain,
- schema/application version uyumsuzluğu,
- backup dosyasında eksik obje,
- restore süresinin RTO'yu aşması,
- yanlış erişim izinleri.
Disaster recovery dokümanı test edilmediyse olay anında ilk kez çalıştırılacak bir hipotezdir.
76. Test otomasyon mimarisi: data-driven ve keyword-driven yaklaşımlar nerede işe yarar?
Test araçları ve otomasyon teknikleri geniş bir alan oluşturur. Araç seçiminden önce otomasyon mimarisini ayırmak gerekir.
Data-driven testing, aynı davranışı farklı veri setleriyle çalıştırır. Boundary ve karar tablosu senaryolarında etkilidir.
@ParameterizedTest
@CsvSource({"0,FREE", "100,STANDARD", "1000,PREMIUM"})
void classifies(final int score, final String expected) {
    assertEquals(expected, classifier.classify(score));
}
Keyword-driven testing, test adımlarını LOGIN, SEARCH, SAVE gibi domain eylemlerine ayırıp veriden yürütür. ISO/IEC/IEEE 29119-5:2024 bu yaklaşımı standardize eden güncel bölümdür.
Keyword-driven yapı testçilerin kod yazmadan senaryo üretmesine yardımcı olabilir; fakat aşırı generic bir DSL yeni bir yazılım ürünü hâline gelebilir. Debug zorlaşır, gerçek API gizlenir ve testler okunmaz olur.
Prensip yine aynıdır: soyutlama tekrar eden anlamı azaltıyorsa değerlidir; yalnız yeni bir çerçeve göstermek için ekleniyorsa maliyettir.
77. Sonuç: yeşil testler değil güvenilir değişiklik
Yazılım test mühendisliğini birkaç araç ve test türünün toplamı olarak gördüğümüzde doğal sonuç, giderek büyüyen bir test paketi olur. Bir süre sonra yüzlerce unit test, onlarca integration test ve uzun E2E senaryoları vardır; fakat ekip küçük bir üretim değişikliğini yine tedirginlikle yapar.
Burada testin gerçek amacı kaybolmuştur.
İyi bir test sistemi geliştiriciye şu kabiliyeti vermelidir:
Bu değişikliğin hangi davranışları etkilediğini biliyorum; kritik varsayımlar otomatik olarak sınanacak; başarısızlık olursa sinyal yeterince dar olacak; geniş sistem riskleri de uygun katmanlarda ayrıca doğrulanacak.
Birim testi hızlı geri bildirim verir. Tümleştirme testi sınırların gerçeğini gösterir. Contract testi servislerin bağımsız değişimini korur. E2E testi kritik yolun birlikte çalıştığını kanıtlar. Property-based testing örneklerin dışına çıkar. Mutation testing testin gerçekten hata yakaladığını sorgular. Fuzzing beklenmeyen girdiyi üretir. Performans testi kapasiteyi, resilience testi bozulma biçimini, güvenlik testi saldırganın yolunu, üretim gözlemi ise laboratuvarın kaçırdığı gerçeği gösterir.
Bunların hiçbiri tek başına yeterli değildir. Hepsini her projede kullanmak da mühendislik değildir.
Doğru yaklaşım daha sadedir:
riski anla
 -> davranışı tanımla
 -> sınırı seç
 -> oracle kur
 -> en ucuz güvenilir testi yaz
 -> sonucu ölç
 -> üretimden öğren
 -> gereksiz testi at
Test suite büyüklüğü değil, değişiklik karşısında ürettiği güven / maliyet oranı önemlidir.
Bir yazılımı test etmek sonuçta hatasız olduğunu kanıtlamaya çalışmak değildir. Hangi koşullarda yanlış olabileceğini sistematik biçimde aramak ve bulamadığımız her durumda güvenimizin nedenini açık hâle getirmektir.
İyi test mühendisini yalnız bulduğu kusur sayısıyla tanımlamak bu yüzden yetersizdir. Asıl değer; gereksinimdeki belirsizliği, tasarımdaki gereksiz sıkı bağlılığı, ölçüm yanlılığını, altyapıdaki deterministik olmayan davranışı ve üretime taşınabilecek gizli varsayımları kullanıcıdan önce görünür hâle getirebilmesidir.
Çalışan Eski Sistemlerde Karakterizasyon ve Risk Uyarlamalı Doğrulama
Uzun süredir üretimde çalışan bir sistemde değişiklik doğrulaması yalnız yeni gereksinimi test etmekten ibaret değildir. Mevcut ve güvenilir davranışın farkında olmadan yapılan iyileştirme, yeni özelliği doğru eklerken eski bir kontratı bozabilir. Bu nedenle özellikle kritik akışlarda önce davranışın karakterizasyonu, sonra değişikliğin uygulanması ve aynı kontratın yeniden sınanması güçlü bir yöntemdir.
mevcut davranışı gözle
  -> korunacak kontratı yaz
  -> küçük değişikliği uygula
  -> aynı davranışı yeniden doğrula
  -> yalnız amaçlanan farkı kabul et
Karakterizasyon testi, mevcut davranışın her zaman ideal olduğunu iddia etmez. Onun görevi değişiklik öncesi gerçek davranışı görünür kılmaktır. Daha sonra davranış bilinçli olarak değiştirilecekse eski ve yeni beklenti arasındaki fark ayrıca gerekçelendirilir. Bu yaklaşım Temiz Kod ve Bakım Mühendisliği kapsamındaki güvenli refactoring ile doğrudan ilişkilidir.
Doğrulama kapsamı değişiklik riskiyle orantılı olmalıdır. Renk veya boşluk değişikliği ile yetkilendirme, transaction, kimlik eşleme veya kilitleme değişikliği aynı inceleme derinliğini gerektirmez. Basit bir sınıflandırma kullanılabilir:
düşük risk     -> yerel davranış ve doğrudan bağımlılıklar
orta risk      -> uçtan uca etkilenen akış ve durum geçişleri
yüksek risk    -> veri, yetki, eşzamanlılık, hata yolları ve geri dönüş kontratı
Amaç yüksek riskli her değişiklikte bütün sistemi test etmek değildir. Amaç, değişikliğin etkileyebileceği kontratları gözden kaçırmamaktır.
Üretim veritabanına veya dış servise bağlanmanın güvenli olmadığı durumlarda da doğrulama tamamen vazgeçilmiş sayılmaz. Gerçek service ve persistence kodunu çalıştırıp dış sınırı kontrollü test double ile değiştirmek, özellikle oluşturulan SQL, transaction çağrıları ve hata sözleşmeleri için değerli karakterizasyon kanıtı sağlayabilir. Burada in-memory veritabanının üretim Oracle davranışını birebir temsil ettiği varsayılmamalıdır; testin neyi kanıtladığı açık yazılmalıdır.
Doğrulama raporunun dili de teknik doğruluğun parçasıdır. Aşağıdaki ifadeler aynı anlama gelmez:
test geçti
derleme başarılı
kaynak incelemesiyle doğrulandı
ortam eksikliği nedeniyle çalıştırılamadı
üretim eşdeğerliği doğrulanmadı
Çalıştırılamayan testi geçmiş saymak veya yalnız derleme sonucunu üretim davranışının kanıtı gibi sunmak yanlış güven üretir. Yazılım Mühendisliği açısından güvenilir değişiklik yönetimi, kanıtın gücünü de açıkça sınırlamayı gerektirir.
Standart ve Araçları Birlikte Kullanma
Standart, test aracı değildir. ISO/IEC/IEEE 29119 ortak kavram, süreç, dokümantasyon ve tasarım teknikleri için; ISO/IEC 25010 kalite hedeflerini sınıflandırmak için; ISTQB ortak test terminolojisi ve temel pratikler için; IEEE 730 kalite güvence süreçleri için uygundur. JUnit, Spring Test, Testcontainers, Selenium, JMeter, PITest veya property-based testing araçları ise belirli mühendislik problemlerini uygular.
Araç seçimini standarttan, test stratejisini araçtan türetmek yerine önce risk ve kanıt ihtiyacını belirlemek daha doğru sonuç verir.
Mutasyon testi ve test takımının duyarlılığı
Yüksek code coverage, testlerin hatayı gerçekten yakalayabildiğini garanti etmez. Mutasyon testi, koşulu tersine çevirmek, sabiti değiştirmek veya işleci bozmak gibi küçük yapay hatalar üretir ve test takımının bunları öldürüp öldürmediğini ölçer.
Hayatta kalan mutasyon her zaman yeni test gerektiği anlamına gelmez; eşdeğer mutasyon veya iş açısından önemsiz kod olabilir. Değerli olan, kritik iş kuralında testin gerçekten hassas olup olmadığını görünür kılmasıdır.
Test sonucunun güvenilirliğini sınamak
Geçen test yalnız test edilen sözleşme için kanıttır. Test verisi, ortam, saat, sıralama veya dış hizmet davranışı değiştiğinde aynı sonucun beklenip beklenmediği açık olmalıdır.
Flaky test, güvenilir bir sinyal üretmez. Rastgelelik seed'i, zaman kaynağı, paylaşılan durum ve dış bağımlılık kontrol altına alınmalı; test tekrar edilebilir hâle gelmeden başarı oranı kalite göstergesi olarak kullanılmamalıdır.
Coverage bir boşluk bulma aracıdır; doğruluk kanıtı değildir. Kritik iş kuralları için karar tablosu, sınır değer, mutation test veya property-based test gibi yöntemler test takımının gerçekten hata yakalayıp yakalayamadığını değerlendirmeye yardımcı olur.
Uyarlanabilir ve Bozulmuş Çalışma Kiplerinin Doğrulanması
Dayanıklılık testi yalnız servisi çökertip yeniden başlatmayı doğrulamak değildir. Karmaşık insan-makine sistemlerinde önemli soru, arıza veya kaynak baskısı altında hangi işlevlerin korunacağı, hangi işlevlerin kontrollü biçimde sınırlandırılacağı ve kullanıcının yeni durumu doğru anlayıp anlayamayacağıdır. Bu boyut Bilişsel Sistemler Mühendisliği ile bağlantılıdır.
Nominal senaryo yeterli değildir
Bir özellik için test matrisi yalnız giriş ve çıktı değerlerini değil çalışma kipini de içerebilir:
normal kapasite
yüksek yük
stale veri
kısmi bağımlılık kaybı
otomasyon devre dışı
gecikmiş geri bildirim
kesinti sonrası devam
Her kipte değişmezler farklı olabilir. Örneğin normal kipte tam özellik seti zorunluyken, bozulmuş kipte temel doğruluk ve veri bütünlüğü korunarak ikincil analiz işlevleri kapatılabilir.
İnsan tarafından algılanabilir doğruluk
Teknik durumun doğru olması, kullanıcının doğru zihinsel modele sahip olduğu anlamına gelmez. Bir hizmet yedek sisteme geçtiyse fakat arayüz halen eski kaynağı gösteriyorsa backend testi geçebilir, operasyonel sistem yine de hatalıdır. Bu nedenle kritik akışlarda şu doğrulamalar değerlidir:
- etkin kaynağın ve kipin doğru gösterilmesi,
- veri yaşının görünür olması,
- başarısız otomasyon sonrası insanın devralabilmesi,
- kesinti sonrası çalışma bağlamının geri kazanılması,
- alarmın neden ve etki ilişkisinin anlaşılabilir olması.
Bu testler klasik birim testinin yerine geçmez. Sistem ve insan faktörleri doğrulamasını, teknik değişmezlerle birlikte genişletir.
Metamorfik testlerde dönüşüm ve beklenen ilişki
Bazı yazılımlarda her girdi için bağımsız olarak doğru sonucu bilmek zordur. Metamorfik test, tek bir beklenen sonuç yerine dönüşüm uygulanmış iki veya daha fazla girdi arasındaki zorunlu ilişkiyi sınar. Örneğin sıralama algoritmasının girdisindeki öğelerin sırası değiştirildiğinde çıktı aynı sıralı çoklu küme olmalıdır. Arama algoritmasında ilgisiz bir kayıt eklenmesi, önceden bulunan kayıtların kimliğini değiştirmemelidir. Bu ilişkiler, algoritmanın belirtiminden türetilmeli; yalnız sezgisel olarak makul görünmeleri yeterli sayılmamalıdır.
Ses işlemede örnekleme frekansı meta verisini değiştirip PCM örneklerini aynı bırakmak, fiziksel zaman ölçeğini değiştirir; bu dönüşüm ``çıktı aynı kalmalıdır'' diye sınanamaz. Buna karşılık sabit PCM içeriği için farklı dosya okuma parça boyutlarının, aynı kesintisiz örnek dizisini ve aynı segment sınırlarını üretmesi çoğu kayıpsız işleme hattında savunulabilir bir metamorfik özelliktir. Yine de algoritmanın parça bağımlılığına ilişkin belirtim incelenmelidir.
Metamorfik testin güçlü olması için üç öğe yazılı hâlde tanımlanır: başlangıç girdisinin önkoşulları, dönüşümün kapsamı ve çıktıların sağlaması gereken ilişki. Test, kasıtlı olarak bozulan bir uygulamada başarısız olmuyorsa oracle zayıf olabilir. Özellik temelli test ve mutation testing bu nedenle metamorfik ilişkilerle birlikte kullanılabilir; hiçbir yöntem tek başına doğruluk kanıtı değildir.
Ünite 7: Deterministik Analitik ve Konuşmalı Sistemlerde Regresyon Testi
Analitik ve konuşmalı yazılımlar klasik CRUD uygulamalarından farklı bir test problemi üretir. Aynı kullanıcı ifadesi bağlama göre farklı anlam kazanabilir; bir sonuç aynı veri sürümüne bağlı olabilir; küçük bir yönlendirme değişikliği yanlış işlemi çalıştırabilir; kullanıcı arayüzündeki bir düğmenin etiketi ile metin olarak yazılan aynı ifade farklı yola düşebilir.
Bu nedenle test stratejisi yalnız "fonksiyon çıktı verdi mi?" sorusunu değil, yönlendirme, durum, veri sürümü, yetki sınırı ve deterministik davranış problemlerini de kapsamalıdır.
Saf çekirdek ve etkili kabuk ayrımı
Test edilebilirlik için güçlü bir tasarım:
SAF ÇEKİRDEK
├─ normalizasyon
├─ eşleştirme
├─ benzerlik
├─ analitik hesap
├─ değerlendirme
└─ karar kuralları

ETKİLİ KABUK
├─ DOM
├─ ağ isteği
├─ veri tabanı
├─ dosya sistemi
├─ ses / medya
└─ kullanıcı olayları
şeklindedir.
Saf çekirdekte:
aynı girdi + aynı durum -> aynı çıktıbeklenebilir.
Bu özellik hızlı, tarayıcısız ve deterministik regresyon testleri yazmayı mümkün kılar.
7.1 Pozitif yönlendirme korpusu
Bir NLU veya komut yönlendiricisi için yalnız birkaç "mutlu yol" testi yeterli değildir.
Pozitif korpus, her kritik niyetin farklı yüzey biçimlerini kapsamalıdır:
"zaman analizini göster"
"saatlere göre incele"
"günlük değişimi karşılaştır"
aynı niyete gitmesi beklenen örnekler olabilir.
Test yalnız niyet kimliğini değil gerektiğinde eşleşme kökenini de doğrulamalıdır:
beklenen niyet     = ZAMAN_ANALİZİ
beklenen köken     = EXACT / PATTERN / CONTEXT / RETRIEVAL
Çünkü doğru niyete yanlış yoldan ulaşmak, eşik veya öncelik hatasını gizleyebilir.
7.2 Negatif test: nereye gitmemesi gerektiğini sınamak
Doğal dil sistemlerinde en tehlikeli regresyonlardan biri yanlış pozitif yönlendirmedir.
Örneğin:
"değişimi göster"ifadesi "bu sonucu ne değiştirirdi?" anlamına gelen duyarlılık niyetine gitmemelidir.
Negatif testler:
girdi X
 -> niyet Y OLMAMALI
şeklinde açıkça yazılmalıdır.
Bu testler özellikle yakın anlamlı komutlar arasında önemlidir.
7.3 Çakışma testi
Yüksek kesinlikli tam eşleşme ifadeleri iki farklı niyet tarafından sahiplenilmemelidir.
Başlangıçta:
Niyet A -> "aynı ifade"
Niyet B -> "aynı ifade"
tanımı varsa sistem sessizce ilkini seçmek yerine yapılandırma hatası üretmelidir.
Bu yaklaşım yanlış davranışı çalışma zamanına bırakmak yerine geliştirme aşamasında yakalar.
7.4 UI etiketi ile metin girdisi aynı davranışı üretmeli
Bir kullanıcı arayüzünde:
[Veri yeterli mi?]düğmesi varsa, kullanıcı aynı ifadeyi sohbet alanına yazdığında farklı bir niyete gitmemelidir.
Bu nedenle görünür eylem etiketleri regresyon korpusuna doğrudan eklenebilir.
UI metni
   ↓
tam eşleşme
   ↓
beklenen niyet
Bu, arayüz metnini yalnız içerik değil çalıştırılabilir sözleşme hâline getirir.
7.5 Öncelik sırasını test etmek
Kademeli yönlendiricide:
EXACT
 > PATTERN
 > CONTEXT
 > DOMAIN GRAMMAR
 > RETRIEVAL
 > FUZZY
 > FALLBACK
gibi bir sıra varsa testler bu önceliği kilitlemelidir.
Örneğin aynı ifade hem retrieval hem exact tarafından bulunabiliyorsa exact kazanmalıdır.
Aksi hâlde eğitim korpusu veya retrieval vektörleri değiştiğinde deterministik komutlar beklenmedik biçimde semantik eşleşmeye kayabilir.
7.6 Skor ve marj sınır testleri
Retrieval tabanlı yönlendirmede:
top1 = 0.62
top2 = 0.60
ile:
top1 = 0.62
top2 = 0.20
aynı kabul davranışına sahip olmamalıdır.
Testler:
- skor eşik altı,
- skor eşik üstü,
- marj sınırının hemen altı,
- marj sınırının hemen üstü
durumlarını kapsamalıdır.
Bu doğrudan sınır değer analizi problemidir.
7.7 Konuşma bağlamı testleri
Bağlam testinde en az iki durum bulunmalıdır:
Önceki anlamlı tur yok:
"neden?"
 -> bağımsız niyet zorlanmamalı
Önceki analitik tur var:
analiz sonucu
"neden?"
 -> mevcut bulgunun açıklaması
Aynı yüzey ifadesinin bağlamla farklılaşması, durum makinesi testi gerektirir.
7.8 Seçim durumunun korunması
Kullanıcı bir bulgu veya kanıt seçtikten sonra:
"biraz aç"
"özetle"
gibi yeni veri üretmeyen bir tur, seçimi sessizce sıfırlamamalıdır.
Test örüntüsü:
1. analitik sonuç oluştur
2. ikinci bulguyu seç
3. bağlamsal takip sorusu sor
4. seçimin hâlâ ikinci bulgu olduğunu doğrula
Bu tür test, tek fonksiyon testinden çok konuşma durumu invariantı testidir.
7.9 Yeni veri geldiğinde eski seçim
Tersi durum da test edilmelidir.
Yeni bir analitik sonuç veya yeni anlık görüntü geldiğinde:
eski bulgu seçimiyeni veriyle otomatik olarak ilişkilendirilmemelidir.
Bu nedenle sonuçlar sürümlenebiliyorsa:
snapshotVersionbenzeri bir kimlik, state geçiş testlerinde kullanılabilir.
Temel invariant:
Bir seçim yalnız ait olduğu analiz sürümü içinde geçerlidir.
7.10 Determinizm testi
Saf analitik fonksiyon için:
aynı snapshot
+ aynı seçili bulgu
+ aynı istek
birden fazla kez çalıştırıldığında aynı yapılandırılmış sonucu üretmelidir.
Test:
r1 = evaluate(x)
r2 = evaluate(x)

assert deepEqual(r1, r2)
şeklinde olabilir.
Saat, rastgelelik, global mutable state veya DOM gibi gizli bağımlılıklar bu testi bozuyorsa çekirdek yeterince saf değildir.
7.11 Eksik veri ve kontrollü bozulma testleri
Analitik sistem yalnız tam veride test edilmemelidir.
Test matrisi:
tam veri
zaman alanı kısmi
yön bilgisi kısmi
süre bilgisi kısmi
hiç kayıt yok
tek kayıt
karşılaştırmaya yetmeyen dönem
kısmi ağ
gibi durumları içermelidir.
Beklenen davranış:
hesap üretilebiliyorsa -> üret
üretilemiyorsa         -> nedenini açıkla
asla                   -> sahte değer üretme
olmalıdır.
7.12 What-if için metamorfik test
What-if analizinde çoğu zaman tek doğru sayıyı önceden bilmek zor olabilir; fakat dönüşümler arasında beklenen ilişkiler vardır.
Örneğin:
senaryo = son 7 günü çıkarsonrasında:
- senaryo veri kümesi baz kümeden büyük olamaz,
- çıkarılan tarihler sonuçta görünmemelidir,
- baz veri nesnesi değiştirilmemelidir,
- aynı senaryo iki kez çalıştırıldığında aynı sonuç üretilmelidir.
Bunlar metamorfik özelliklerdir.
7.13 Araç sözleşmesi testi
Konuşma motoruna bağlanan araçların ortak sözleşmesi varsa her araç için:
reply
data
context
alanlarının beklenen biçimde normalize edildiği test edilmelidir.
Araç:
- yalnız metin,
- yalnız data,
- null,
- kısmi nesne
döndürdüğünde sistem çökmeden aynı sözleşmeye normalize olmalıdır.
7.14 Yetki ve yetenek testi
Doğru niyetin bulunması, işlemin çalıştırılacağı anlamına gelmez.
Test:
niyet doğru
+
yetenek yok
=
araç çağrılmamalı
invariantını doğrulamalıdır.
Ayrıca kullanıcı yetkili olduğunda aynı niyetin doğru aracı çağırdığı ayrıca test edilir.
Bu ayrım güvenlik testinin yanında davranış regresyon testidir.
7.15 Stub araçlarla çekirdek yürütme testi
DOM veya gerçek backend olmadan, araçlar stub ile değiştirilebilir:
NLU
 ↓
yönlendirme
 ↓
stub araç
 ↓
conversation state
 ↓
cevap
Böylece:
- niyet seçimi,
- entity aktarımı,
- araç çağrısı,
- state güncellemesi,
- cevap bileşimi
tek hızlı testte doğrulanabilir.
Bu, uçtan uca tarayıcı testinin yerine geçmez; fakat çok daha hızlı geri bildirim sağlar.
7.16 Fallback testi
Anlamsız veya desteklenmeyen girdide sistem en yakın komutu zorla seçmemelidir.
Test korpusu bilinçli olarak:
anlamsız ifade
alan dışı soru
eksik komut
birbirine çok yakın iki aday
içermelidir.
Başarılı sonuç bazen:
intent = nullolabilir.
Bu, sınıflandırıcının başarısızlığı değil güvenli belirsizlik davranışıdır.
7.17 Regresyon matrisi
Konuşmalı analitik sistem için pratik matris:
- Normalizasyon: Pozitif: Türkçe varyant; Negatif: bilgi kaybı; Sınır: Unicode; Durum: özgün metin korunur.
- Exact: Pozitif: doğru niyet; Negatif: başka niyet değil; Sınır: duplicate; Durum: çakışma hata verir.
- Pattern: Pozitif: sayı/birim; Negatif: yanlış kalıp; Sınır: regex sınırı; Durum: deterministic.
- Context: Pozitif: takip sorusu; Negatif: bağlam yok; Sınır: kısa/uzun ifade; Durum: seçim korunur.
- Retrieval: Pozitif: yakın ifade; Negatif: düşük benzerlik; Sınır: skor/marj; Durum: top-k kararlı.
- Fuzzy: Pozitif: yazım hatası; Negatif: uzak ifade; Sınır: eşik; Durum: zorla yönlendirme yok.
- Entity: Pozitif: dönem/sıra; Negatif: sahte kimlik; Sınır: limit; Durum: ayrı state.
- Tool: Pozitif: çağrı; Negatif: yetki yok; Sınır: null/kısmi sonuç; Durum: sözleşme.
- Analysis: Pozitif: doğru veri; Negatif: eksik veri; Sınır: küçük örneklem; Durum: kapsam görünür.
- What-if: Pozitif: dönüşüm; Negatif: mutasyon yok; Sınır: boş senaryo; Durum: reproducible.
Konuşma sonucu taksonomisi: hata ile kontrollü sonucu ayırmak
Konuşmalı sistem testinde her "cevap verememe" aynı kusur değildir. Ölçümün anlamlı olması için sonuçlar en azından şu sınıflara ayrılabilir:
BAŞARI

NİTELİKLİ BAŞARI
  içerik doğru, sunum iyileştirilebilir
  cevap doğru, yapı gereksiz uzun
  kaynak doğru, erişim yolu zayıf

HATA
  yanlış niyet
  kaçırılmış varlık
  yanlış kişi / yanlış dönem
  yanlış pozitif yönlendirme
  yanlış kaynak
  işlem hatası

KONTROLLÜ SONUÇ
  netleştirme gerekli
  veri yok
  yetki yok
  desteklenmeyen istek
  kullanıcı iptali
Bu ayrım kalite metriğini korur. "Veri yok" durumunda sistem doğru biçimde veri olmadığını söylüyorsa bu uygulama hatası değildir. Buna karşılık yanlış kişiyi seçip ikna edici bir cevap üretmek gerçek bir hatadır.
Taksonominin amacı etiket üretmek değil, tekrar eden kusurları aynı kök nedende toplayabilmektir. Örneğin onlarca "ikincisi" hatası tek tek incelenmek yerine eş gönderim veya konuşma durumu problemi olarak kümelenebilir. Düzeltilen her küme, regresyon korpusuna yeni örnekler kazandırmalıdır.
Yetenek geçiş matrisi: yalnız düğümleri değil kenarları test etmek
Bir konuşmalı sistemde her yetenek tek başına doğru çalışırken yetenekler arasındaki geçiş bozulabilir. Bu nedenle test modeli yalnız özellik listesini değil, özellikler arasındaki geçişleri de kapsamalıdır.
Örnek düğümler:
metin analizi
ilişki analizi
zaman analizi
kayıt
konuşma dökümü
ses
Asıl regresyon riski şu kenarlarda ortaya çıkar:
metin -> ilişki
ilişki -> zaman
zaman -> kayıt
kayıt -> konuşma dökümü
konuşma dökümü -> ses
bulgu -> kanıt -> kayıt
Örneğin "konuşmalarda X konusu nerede geçiyor?" sorusu doğru çalışabilir; "peki bunlarla ilişkili kişiler kim?" devam sorusu ise ilk sonucun konuşma durumuna yazılmadığı bir mimaride kopabilir. Tekil yetenek testleri bu kusuru yakalamaz.
Bu nedenle matris iki boyutlu kurulabilir:
kaynak yetenek × hedef yetenekHer kritik geçiş için:
- referansın doğru taşındığı,
- eski kapsamın gereksiz yere korunmadığı,
- yeni veri geldiğinde bayat seçimin temizlendiği,
- yetki sınırının geçişte de korunduğu
doğrulanmalıdır.
Görev başarısını dört katmanda sınamak
Doğal dil sistemlerinde "niyet doğru bulundu" metriği son kullanıcı başarısını olduğundan yüksek gösterebilir. Daha güçlü bir model dört katmanı ayırır:
L1 — yorumlama başarısı
     Kullanıcının ne istediği doğru çözüldü mü?

L2 — yürütme başarısı
     Doğru işlem ve araç çalıştı mı?

L3 — sonuç başarısı
     Doğru kayıt, dönem veya bulgu üretildi mi?

L4 — görev başarısı
     Kullanıcı amaçladığı sonuca gerçekten ulaştı mı?
Örneğin "ilk kaydı dinlet" isteğinde doğru niyet bulunması L1'dir. Oynatma işlevinin çağrılması L2, doğru kaydın seçilmesi L3, sesin doğru bölümden başlaması ise L4'tür.
Yüksek etkili sistemlerde kabul ölçütü mümkün olduğunca L4'e yaklaşmalıdır. Alt katmanlar kök nedeni bulmak için ayrı izlenir; üst katman ise ürünün gerçekten işe yarayıp yaramadığını gösterir.
Bu yaklaşım, dil kalitesini davranış doğruluğuyla karıştırmayı önler. Güzel yazılmış bir cevap yanlış görevi tamamlıyorsa başarısızdır; kısa bir netleştirme sorusu yanlış işlemi önlüyorsa başarılı bir koruma mekanizmasıdır.
Test altyapısının güvenlik değişmezleri
Test kodu, üretim kodunu sınayan nötr bir araç olarak görülse de yanlış tasarlanmış bir test altyapısı kendi başına risk üretebilir. Özellikle gerçek veri kaynaklarına veya kalıcı ortamlara bağlanabilen testlerde, testin hangi koşullarda çalışmaması gerektiği açık bir sözleşme olmalıdır.
Bu tür bir test kapısı pozitif varsayımdan çok negatif değişmezlerle sınanır:
- üretim olarak tanımlanan ortamda yürütme başlamamalıdır,
- ortam belirlenemiyorsa güvenli varsayım yürütmeyi reddetmektir,
- komut satırı veya ortam değişkeniyle güvenlik kapısını aşan gizli bir yol bulunmamalıdır,
- test başlangıcından önce yasak bağımlılıklara erişilmemelidir,
- testin ürettiği geçici çıktılar belirlenmiş çalışma alanının dışına taşmamalıdır.
İki bağımsız ortam denetimi kullanılıyorsa kabul kuralı da açık olmalıdır: her iki denetim aynı güvenli durumu doğrulamadan test başlatılmaz. Denetimlerden birinin hata vermesi, diğerinin olumlu sonucuyla örtülmemelidir. Bu, fail-closed davranışın test altyapısındaki karşılığıdır.
Test paketinin üretim artefaktını değiştirmemesi de ayrıca doğrulanabilir. Derleme veya test öncesi ve sonrası kriptografik özetlerin karşılaştırılması, test zincirinin gözlemlenen dosyayı değiştirmediğine ilişkin güçlü bir regresyon kanıtı sağlar. Böylece yalnız uygulama değil, uygulamayı doğrulayan mekanizma da sınanmış olur.
Temel ayrım şudur:
Sistemin testlerden geçmesi, test altyapısının güvenli ve tarafsız olduğunu tek başına göstermez.
Bu nedenle yüksek etkili sistemlerde test stratejisi; işlevsel doğruluğun yanında test kapısı, ortam doğrulama, yasak yan etkiler ve artefakt tarafsızlığı için de kalıcı regresyon kontrolleri içermelidir.
7.18 Test stratejisinin sonucu
Bu sınıf sistemlerde test hedefi:
"cevap var mı?"değil,
aynı koşulda aynı davranış var mı?
doğru bağlam korunuyor mu?
yanlış niyet güvenli biçimde reddediliyor mu?
veri eksikliği görünür mü?
eski durum yeni sonucu kirletiyor mu?
yetki sınırı davranış katmanında da korunuyor mu?
sorularıdır.
Deterministik çekirdeği güçlü olan analitik ve konuşmalı sistemlerde regresyon testi, model doğruluğundan ayrı bir davranış sözleşmesi oluşturur.
Metin özetleme ve konuşma devamı için değişmez testler
Kaynağa dayalı bir özetleyicide yalnız “özet üretti” sınaması yeterli değildir. Seçilen her alıntının özgün metindeki bir karakter aralığına birebir karşılık gelmesi, kaynak kimliğinin geçerli olması ve zaman bilgisinin gerçekten bulunmadığı durumda üretilmemesi temel değişmezlerdir. Kaynağın son bölümü kesildiğinde özetin eksiksiz olduğunu söylememesi de doğruluk sözleşmesinin parçasıdır. Cümle puanları değişebilir, ancak bu değişmezlerin ihlali kalite artışı olarak kabul edilemez.
Dönüşümsel testler özellikle yararlıdır. Girdi cümlelerinin başına anlamsız boşluklar eklenmesi seçilen olguların anlamını değiştirmemeli; kaynakların sırası değiştirilse bile kayıt kimlikleri bozulmamalı; aynı cümlenin fazladan tekrarlanması özetin bütününü o cümleye teslim etmemelidir. Bir kullanıcı “aç ama oynatma” dediğinde oynatma çağrısı üretilmemesi ve önceki liste değiştirildiğinde “üçüncüsü” referansının yeniden doğrulanması ayrı adversarial senaryolardır.
Yeni sıralama algoritmalarının katkısı kontrollü deneyle belirlenir: önce yalnız mevcut yöntem, sonra yeni özellik açık, ardından iki yöntem birlikte sınanır. Toplam doğruluk yanında yanlış pozitif, gereksiz netleştirme, bölüm kapsaması, alıntı doğruluğu ve gecikme raporlanır. Aynı şablonun küçük yazım varyantlarını eğitim ve sınamaya dağıtmak bağımsızlık sağlamaz; örnek aileleri ayrılmalıdır. Deneyin hiçbir adımı, işlevsel testlerin koruduğu yetki ve yan etki sınırlarını gevşetmemelidir.
Kaynakça
- Adzic, G., Bridging the Communication Gap: Specification by Example and Agile Acceptance Testing, Neuri, 2009.
- Ammann, P.; Offutt, J., Introduction to Software Testing, 2nd ed., Cambridge University Press, 2016.
- Apache Software Foundation, Apache JMeter Documentation. https://jmeter.apache.org/
- Beck, K., Test Driven Development: By Example, Addison-Wesley, 2002.
- Copeland, L., A Practitioner's Guide to Software Test Design, Artech House, 2004.
- Crispin, L.; Gregory, J., Agile Testing: A Practical Guide for Testers and Agile Teams, Addison-Wesley, 2009.
- Feathers, M., Working Effectively with Legacy Code, Prentice Hall, 2004.
- Fowler, M., Test Pyramid, 2012. https://martinfowler.com/bliki/TestPyramid.html
- Freeman, S.; Pryce, N., Growing Object-Oriented Software, Guided by Tests, Addison-Wesley, 2009.
- Google Testing Blog, Test Sizes, 2010. https://testing.googleblog.com/2010/12/test-sizes.html
- Google Testing Blog, Where do our flaky tests come from?, 2017. https://testing.googleblog.com/2017/04/where-do-our-flaky-tests-come-from.html
- Heather Adkins; Betsy Beyer; Paul Blankinship; Piotr Lewandowski; Ana Oprea; Adam Stubblefield. Building Secure & Reliable Systems: Best Practices for Designing, Implementing, and Maintaining Systems. O’Reilly Media, 2020.
- IEEE, IEEE 730-2026 — IEEE Standard for Software Quality Assurance Processes. https://standards.ieee.org/ieee/730/10854/
- IEEE/ACM International Conference on Automation of Software Test (AST) ve International Conference on Software Testing, Verification and Validation (ICST) güncel bildirileri.
- ISO/IEC TR, 29119-6:2021 — Guidelines for the use of ISO/IEC/IEEE 29119 in agile projects.
- ISO/IEC, 25010:2023 — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. https://www.iso.org/standard/78176.html
- ISO/IEC/IEEE, 29119-1:2022 — Software and systems engineering — Software testing — Part 1: General concepts. https://www.iso.org/standard/81291.html
- ISO/IEC/IEEE, 29119-2:2021 — Software testing — Part 2: Test processes.
- ISO/IEC/IEEE, 29119-3:2021 — Software testing — Part 3: Test documentation.
- ISO/IEC/IEEE, 29119-4:2021 — Software testing — Part 4: Test techniques.
- ISO/IEC/IEEE, 29119-5:2024 — Software testing — Part 5: Keyword-driven testing.
- ISTQB, Certified Tester Foundation Level Syllabus v4.0.1, 2024. https://istqb.org/certifications/certified-tester-foundation-level-ctfl-v4-0/
- jqwik, Property-Based Testing on the JVM. https://jqwik.net/
- JUnit Team, JUnit 6.1.2 User Guide, 2026. https://docs.junit.org/6.1.2/
- Meszaros, G., xUnit Test Patterns: Refactoring Test Code, Addison-Wesley, 2007.
- Meyer, B., Seven Principles of Software Testing, Computer, 41(8), 2008.
- Miller, Richard H. UX for Enterprise ChatGPT Solutions: A Practical Guide to Designing Enterprise-Grade LLMs. Packt Publishing, 2024. ISBN 978-1-83546-119-8.
- Nygard, M. T., Release It!: Design and Deploy Production-Ready Software, 2nd ed., Pragmatic Bookshelf, 2018.
- OWASP Foundation, Application Security Verification Standard (ASVS). https://owasp.org/www-project-application-security-verification-standard/
- OWASP Foundation, Web Security Testing Guide — Stable. https://owasp.org/www-project-web-security-testing-guide/stable/
- PITest, Mutation Testing for Java. https://pitest.org/
- Selenium Project, Selenium Documentation. https://www.selenium.dev/documentation/
- Spring, Spring Boot 4.1.1 Testing Reference. https://docs.spring.io/spring-boot/reference/testing/
- Spring, Spring çerçeve 7.0.9 Testing Reference. https://docs.spring.io/spring-framework/reference/testing.html
- Testcontainers, Testcontainers for Java Documentation. https://java.testcontainers.org/ ve https://testcontainers.com/
- Testing Software and Systems / Advances in Intelligent and Automated Testing kapsamında 2025–2026 dönemindeki model-based testing, test generation, LLM-assisted testing, metamorphic testing ve complex/critical systems çalışmalarından seçilmiş bildiriler.
- NIST. FIPS 197: AES, 2023 edition. https://csrc.nist.gov/pubs/fips/197/final