


İstatistiksel Öğrenme ve Makine Öğrenmesi: Sınıflandırma, Regresyon ve Kümeleme

SVM, k-NN, K-Means, Naive Bayes, karar ağaçları, regresyon, PCA/LDA, HMM, n-gram, anomali tespiti, değerlendirme ve model seçimini ortak istatistiksel öğrenme çerçevesinde ele alan ders notu.
İstatistiksel öğrenme, gözlenen örneklerden bir ilişki, karar sınırı, olasılık dağılımı veya veri yapısı kestirmeye dayanır. Yapay zekânın kural tabanlı yaklaşımlarından farklı olarak bütün kararları önceden tek tek yazmak yerine, verideki düzenlilikleri bir model üzerinden ifade eder. Bu yaklaşımın matematiksel zemini Olasılık ve İstatistik ile kurulur; burada amaç o zeminin sınıflandırma, regresyon, kümeleme, boyut indirgeme ve anomali tespitine nasıl dönüştüğünü birlikte görmektir.
Ünite 1: İstatistiksel Öğrenmenin Temeli
1.1. Veri, Model ve Öğrenme
Bir öğrenme problemi en yalın biçimiyle gözlemler, özellikler ve hedefler üzerinden tanımlanır. Gözlem x, modele verilen özellik vektörünü; y ise varsa hedefi veya etiketi gösterir.
veri
↓
özellik temsili
↓
model ailesi
↓
amaç / kayıp fonksiyonu
↓
parametre kestirimi veya arama
↓
görülmemiş veri üzerinde tahmin
Öğrenmenin amacı eğitim örneklerini ezberlemek değil, örneklerin üretildiği sürece ilişkin yeterince kararlı bir düzeni yakalayıp yeni veriye genelleyebilmektir. Bu nedenle eğitim başarısı ile gerçek kullanım başarısı aynı ölçü değildir.
1.2. İstatistiksel Çıkarım ve Tahmin
Klasik istatistik çoğu zaman bir parametre, etki veya belirsizlik hakkında çıkarım yapmaya odaklanır. Makine öğrenmesinde ise ağırlık sıklıkla görülmemiş örnekler için doğru tahmin üretmeye kayar. İki alan keskin biçimde ayrılmaz; regresyon, Bayesçi kestirim, örnekleme, olabilirlik ve düzenlileştirme her iki tarafta da kullanılır.
Bir modelin iyi açıklama yapması onun her zaman iyi tahmin yapacağı; yüksek tahmin başarısı da modeldeki ilişkinin nedensel olduğu anlamına gelmez.
1.3. Parametrik ve Parametrik Olmayan Yöntemler
Parametrik yöntemde modelin temel biçimi önceden seçilir ve sonlu sayıda parametre kestirilir. Doğrusal ve lojistik regresyon buna örnektir.
Parametrik olmayan yöntemlerde sabit ve küçük bir parametre kümesiyle sınırlı bir biçim varsayımı daha zayıftır. k-En Yakın Komşu, çekirdek yoğunluk kestirimi ve bazı ağaç yöntemleri bu grupta düşünülebilir. Parametrik olmayan, “varsayımsız” demek değildir; uzaklık, komşuluk, düzgünlük veya ağaç bölme ölçütü yine bir indüktif önyargıdır.
1.4. Üretici ve Ayırt Edici Modeller
Üretici model ortak dağılımı veya sınıfa göre veri üretimini modellemeye çalışır:
p(x, y)
veya
p(x | y) p(y)
Naive Bayes bu bakışa yakındır.
Ayırt edici model doğrudan hedefi ya da karar sınırını modellemeye odaklanır:
p(y | x)
veya
f(x) -> y
Lojistik regresyon ve SVM bunun tipik örnekleridir.
1.5. Öğrenme Türleri
- Denetimli öğrenme:
x -> yeşleşmeleri bilinir; sınıflandırma ve regresyon temel görevlerdir. - Denetimsiz öğrenme: hedef etiketi yoktur; kümeleme, yoğunluk kestirimi ve bazı boyut indirgeme yöntemleri yapıyı verinin içinden arar.
- Yarı denetimli öğrenme: az miktarda etiketli, çok miktarda etiketsiz veri birlikte kullanılır.
- Özdenetimli öğrenme: hedef, verinin kendi yapısından türetilir.
- Özdenetimli öğrenme: hedef, verinin kendi yapısından türetilir. / - Pekiştirmeli öğrenme: bir ajanın çevreyle etkileşiminden doğan ödül üzerinden politika öğrenilir; ayrıntısı farklı bir sıralı karar problemi oluşturur.
Sınıf dengesizliğinde tek başarı oranına güvenmemek. 1200 örnekli bir test kümesinde 200 gerçek pozitif ve 1000 gerçek negatif bulunsun. Sınıflandırıcı TP = 160, FN = 40, FP = 100, TN = 900 üretiyorsa doğruluk (160+900)/1200 ≈ %88,33 görünür. Ancak pozitif kestirimlerin isabeti precision = 160/(160+100) ≈ %61,54, pozitifleri bulma oranı recall = 160/(160+40) = %80, özgüllük specificity = 900/(900+100) = %90 olur. Her zaman negatif diyen bir yöntem bile bu dağılımda %83,33 doğruluk elde edebilir. Model seçimi bu yüzden olayın maliyetine uygun ölçüt, karar eşiği ve kalibrasyon analiziyle yapılmalıdır. Eşik veri üzerinde ayarlanıyorsa son değerlendirme verisi model seçimi sırasında kullanılmamalı; aynı kişilerden veya olaylardan gelen ilişkili kayıtlar eğitim ve test bölmelerine sızmamalıdır.
Ünite 2: Veri Temsili, Ölçek ve Uzaklık
Ölçek ve uzaklık kullanan öğrenme yöntemlerinde önce değişkenlerin birimleri ve dağılımları incelenir. Normalizasyon parametreleri yalnız eğitim verisinden hesaplanmalı, doğrulama ve test örneklerine aynı dönüşüm uygulanmalıdır. Kategorik alanların kodlanması, uzaklık kavramının anlamını değiştirebilir; bu nedenle seçilen temsil ile hedef problem arasındaki uyum kontrol edilir. Boyut sayısı arttığında komşuluk yapısının zayıflaması, yalnız daha fazla veri eklemekle otomatik olarak çözülmez.
2.1. Veri Matrisi
Bir veri kümesi çoğu zaman satırlarda gözlemler, sütunlarda özellikler olacak biçimde gösterilir:
X ∈ R^(n×p)n gözlem sayısını, p özellik sayısını gösterir. Hedef değişken varsa y ayrı tutulur.
Kategorik bir değişken sayıyla kodlanmış olsa bile bu kodun aritmetik büyüklük taşıması gerekmez. 1=Ankara, 2=İstanbul kodlaması İstanbul'un Ankara'nın iki katı olduğu anlamına gelmez. Ölçüm düzeyi, kullanılabilecek uzaklık ve model varsayımlarını etkiler.
2.2. Ölçekleme
Uzaklığa ve marja dayalı yöntemler değişken ölçeklerine duyarlıdır. Bir özellik kilometre, diğeri 0–1 aralığında ölçülüyorsa ham Öklid uzaklığında büyük ölçekli değişken baskın olabilir.
Standartlaştırma sık kullanılan dönüşümdür:
z = (x - μ) / σMin–max ölçekleme ise bir aralığa taşır. Dönüşümün parametreleri yalnız eğitim verisinden hesaplanmalı, doğrulama ve test verisine aynı dönüşüm uygulanmalıdır. Tüm veri üzerinde önceden ölçekleme yapmak veri sızıntısı oluşturabilir.
Standartlaştırma işleminde ortalama ve standart sapma yalnız eğitim altkümesinden kestirilmelidir. Örneğin veri bütününden hesaplanan ortalama 50, eğitim verisinden hesaplanan ortalama 40 ise doğrulama satırının (x−50)/s ile ölçeklenmesi, henüz görülmemesi gereken gözlemlerden bilgi taşır. Aynı sızıntı eksik veri doldurma, kategorik kodlama, özellik seçimi ve PCA için de geçerlidir. Çapraz doğrulamanın her katında ön işlem parametreleri yeniden yalnız eğitim katında öğrenilir. Ayrıca sayısal sütunların benzer ölçeğe getirilmesi, bu sütunların aynı bilimsel öneme sahip olduğu anlamına gelmez; uzaklık ölçüsünün hangi değişkenlerden etkilendiği problem bağlamıyla sınanmalıdır.
2.3. Benzerlik ve Farklılık
Sayısal veride Minkowski uzaklığı:
d(x,y) = (Σ |x_i-y_i|^p)^(1/p)p=2 için Öklid, p=1 için Manhattan uzaklığı elde edilir.
Metin ve yüksek boyutlu seyrek vektörlerde kosinüs benzerliği sık kullanılır:
cos(x,y) = (x·y) / (||x|| ||y||)Nominal özelliklerde eşleşme/eşleşmeme temelli ölçüler, ikili özelliklerde Jaccard benzerliği gibi ölçüler daha anlamlı olabilir. Uzaklık seçimi algoritmadan bağımsız bir ayrıntı değildir; modelin “yakın” ve “benzer” kavramlarını doğrudan tanımlar.
2.4. Boyut Arttıkça Komşuluk
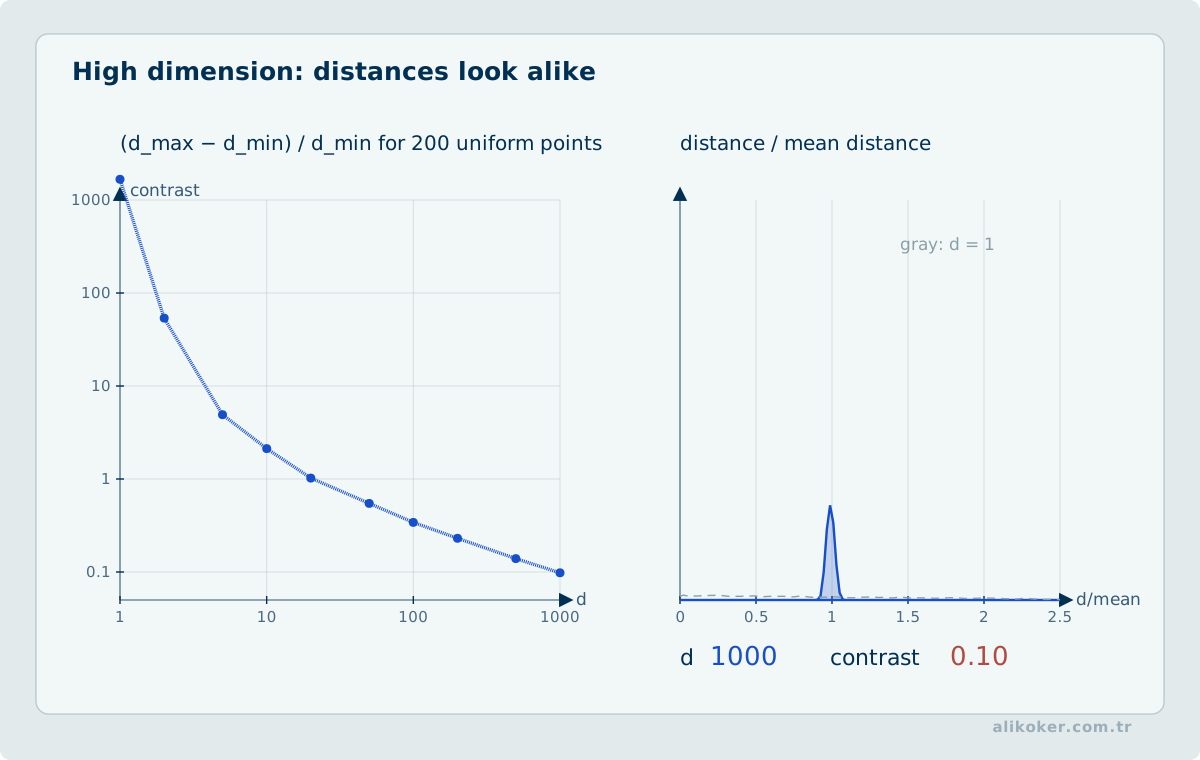
Yüksek boyutta noktalar arasındaki uzaklıkların birbirine yaklaşması, seyrekleşme ve örnek gereksiniminin hızlı büyümesi “boyutluluk laneti” başlığı altında incelenir. k-NN, yoğunluk kestirimi ve kümeleme bu etkiden özellikle zarar görebilir. Özellik seçimi ve boyut indirgeme bu nedenle yalnız hız optimizasyonu değildir; modelin geometrisini değiştirebilir.
Ünite 3: Amaç Fonksiyonu, Olabilirlik ve Genelleme
Öğrenme amacı belirlenirken önce hangi hata türünün operasyonel açıdan daha maliyetli olduğu ortaya konur. Amaç fonksiyonu bu öncelikle tutarlı seçilir; düzenlileştirme, örnek ağırlıkları ve eşik kararı farklı etkiler oluşturabilir. Model seçimi için kullanılan veri ile nihai değerlendirme verisi ayrılmalıdır. Aynı doğruluk değerini üreten iki modelin kalibrasyon, alt grup hataları ve veri kaymasına dayanıklılık bakımından farklı sonuç vermesi mümkündür.
3.1. Ampirik Risk
Bir model f_θ, örnek başına kayıp L ile değerlendirilsin. Eğitimde sık kullanılan temel amaç:
R_emp(θ) = (1/n) Σ L(y_i, f_θ(x_i))ifadesini küçültmektir. Ancak eğitim kaybını en aza indirmek tek başına yeterli değildir; modelin görülmemiş veri üzerindeki beklenen hatası önemlidir.
3.2. En Çok Olabilirlik Kestirimi
Model p(x | θ) ya da p(y | x, θ) biçiminde olasılıksal ise, en çok olabilirlik kestirimi parametreleri gözlenen veriyi en olası kılacak şekilde seçer:
θ_MLE = argmax_θ Π p(z_i | θ)Sayısal kararlılık için çoğunlukla log-olabilirlik kullanılır:
θ_MLE = argmax_θ Σ log p(z_i | θ)3.3. MAP Kestirimi
Parametre hakkında önsel bilgi p(θ) ile ifade ediliyorsa maksimum sonsal kestirim:
θ_MAP = argmax_θ p(data | θ) p(θ)şeklindedir. Düzenlileştirmenin bazı biçimleri Bayesçi bakışta parametre önselleriyle ilişkilendirilebilir.
3.4. Negatif log-olabilirlik, cross-entropy ve KL Ayrışımı
Olabilirlik tabanlı eğitimde parametreler gözlenen hedefleri olası kılacak biçimde seçilir. Çarpım biçimindeki olabilirliği log uzayına taşımak hem sayısal kararlılık hem de toplamsal amaç fonksiyonu sağlar:
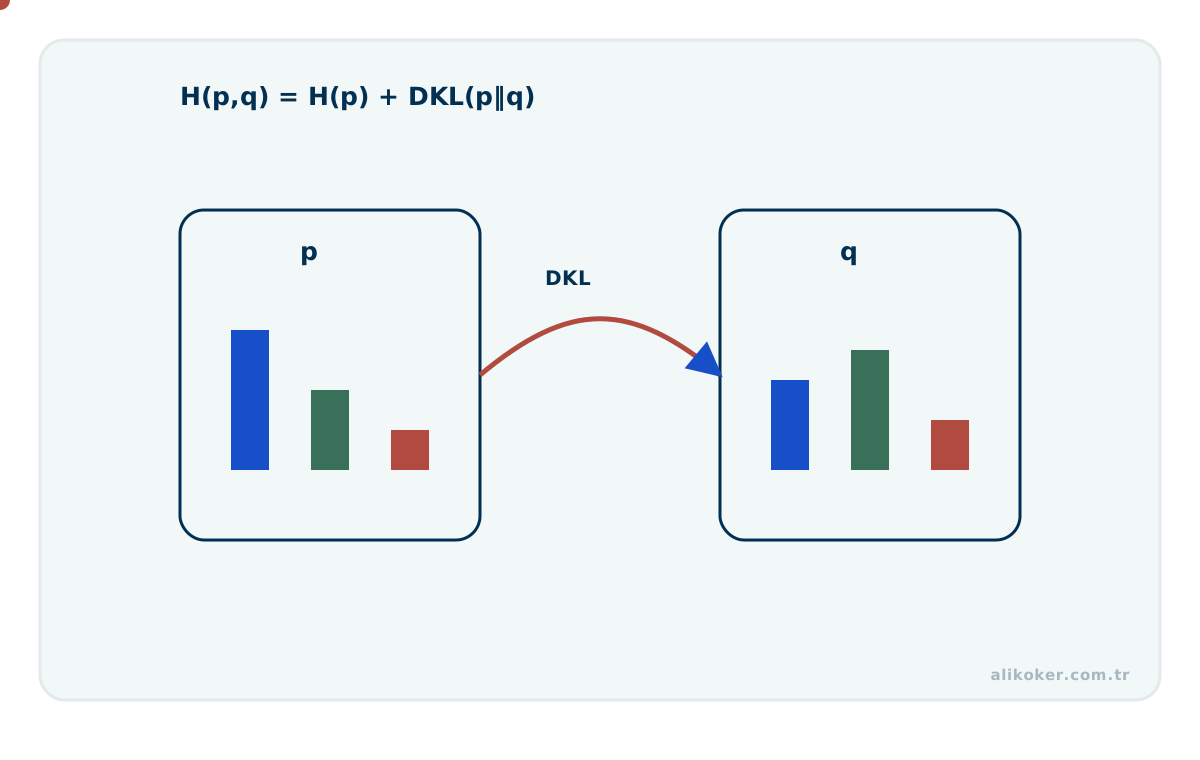
NLL(theta) = - sum_i log p(y_i | x_i, theta)Sınıflandırmada kategorik negatif log-olabilirlik, uygun hedef gösteriminde cross-entropy kaybıyla aynıdır. Veri dağılımı p ve model dağılımı q için:
H(p,q) = H(p) + KL(p || q)olduğundan, veri dağılımı sabitken cross-entropy minimizasyonu KL(p||q) ayrışmasını da minimize eder. Bu eşitlik, loss adının keyfi olmadığını; olasılıksal model varsayımından geldiğini gösterir.
3.5. Bias–Variance Dengesi
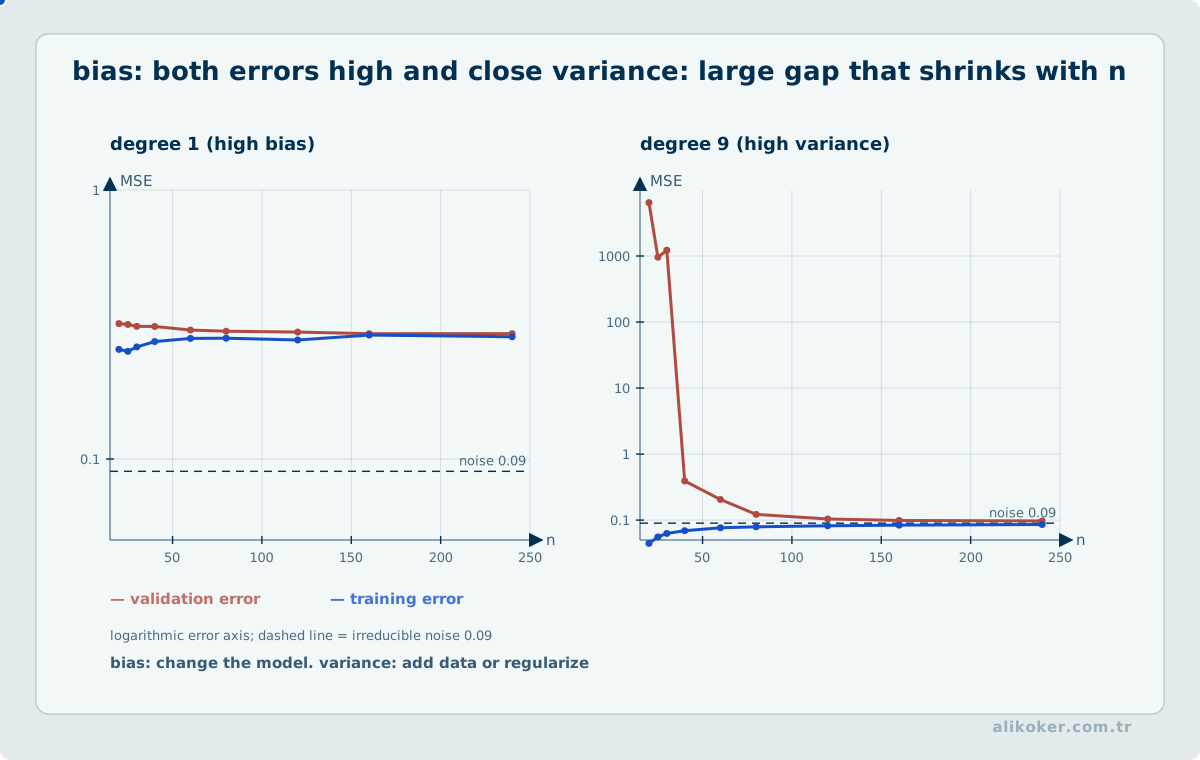
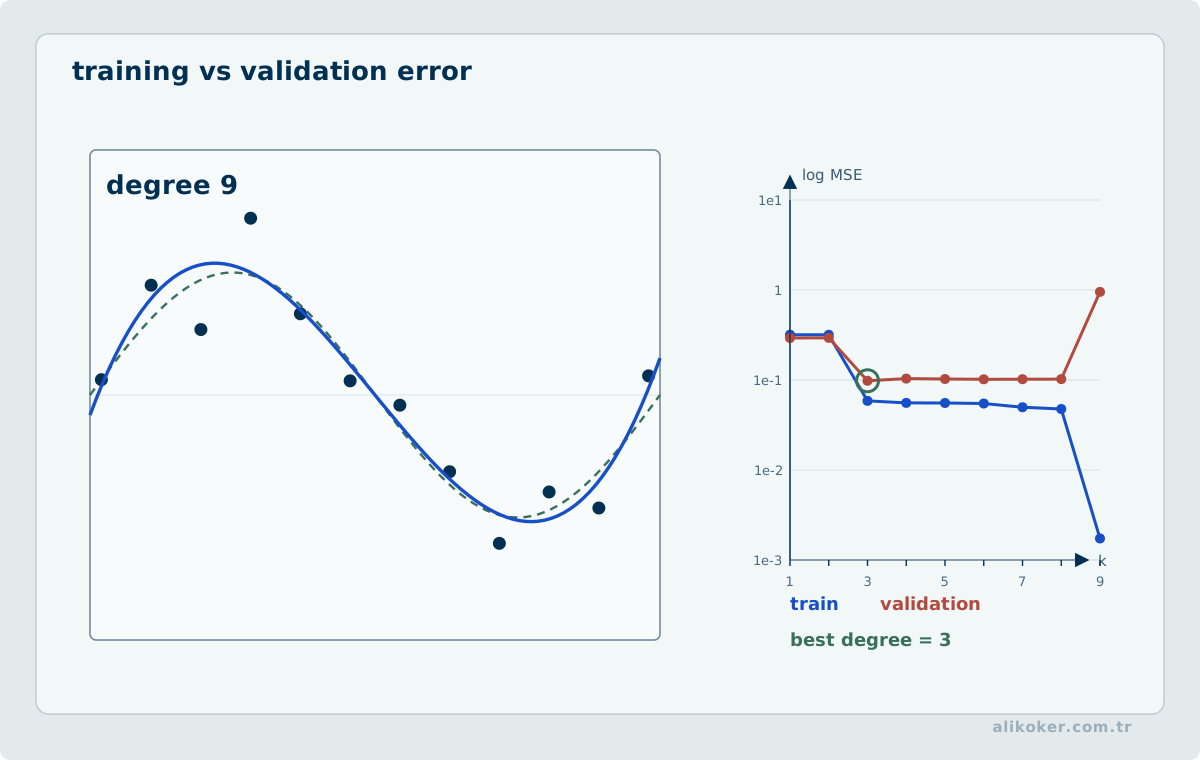
Çok basit model gerçek yapıyı yakalayamayabilir; bu yüksek bias davranışıdır. Çok esnek model örnekleme gürültüsüne aşırı uyabilir; bu yüksek variance davranışıdır. Model seçiminin ana sorularından biri bu iki hata kaynağını uygun veri hacmi ve görev maliyeti altında dengelemektir.
3.6. No Free Lunch
Her problem için evrensel olarak en iyi tek öğrenme algoritması yoktur. Bir yöntemin başarısı, taşıdığı varsayımların verinin gerçek yapısıyla uyuşmasına bağlıdır. Model karşılaştırması bu nedenle aynı veri bölmesi, aynı ölçütler ve aynı hesaplama bütçesi altında yapılmalıdır.
Ünite 4: Regresyon ve Olasılıksal Sınıflandırma
4.1. Doğrusal Regresyon
Basit doğrusal model:
Y = β0 + β1 X + εçoklu regresyonda:
Y = β0 + β1X1 + ... + βpXp + εşeklinde genişler. En küçük kareler yöntemi artıkların kareleri toplamını küçültür:
min_β Σ (y_i - ŷ_i)^2Regresyonda katsayı yorumu, artık yapısı, çoklu doğrusal bağlantı, aykırı ve etkili gözlemler Olasılık ve İstatistik notundaki çıkarımsal çerçeveyle birlikte değerlendirilmelidir.
4.1.1. Kayıp Fonksiyonundan Parametre Güncellemesine
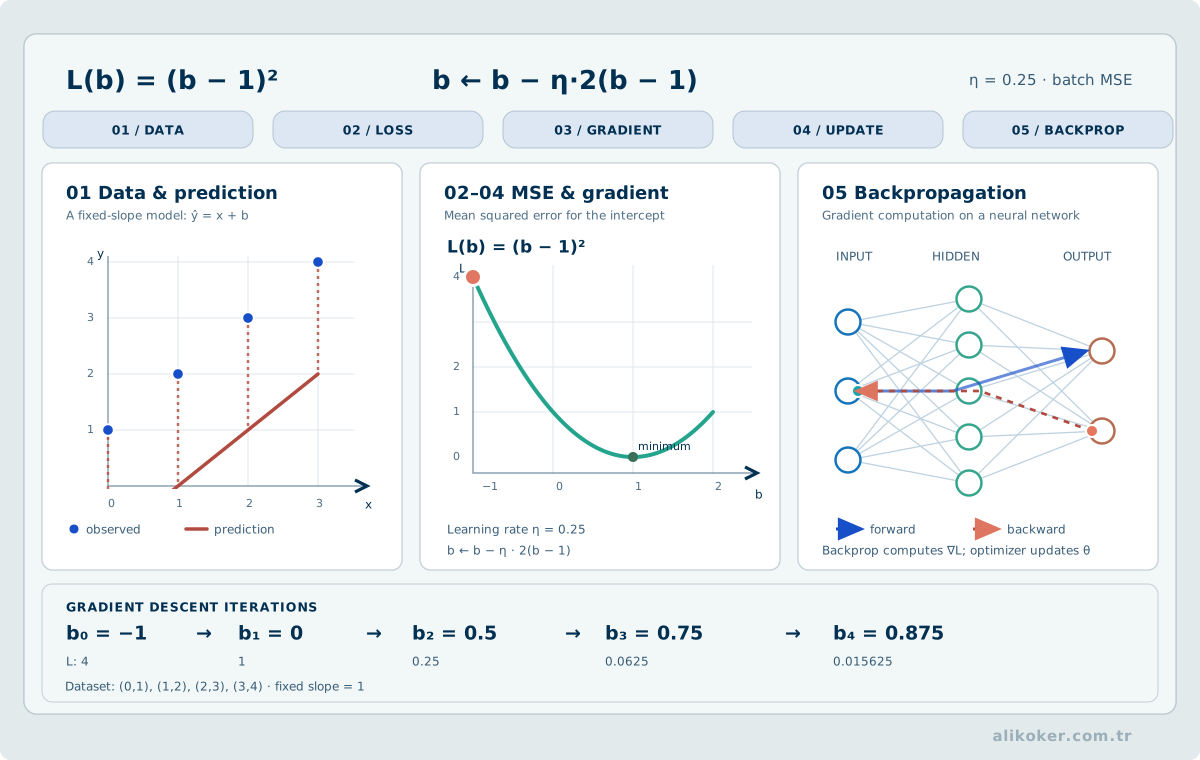
Öğrenme algoritmasının yaptığı işlem, önce tahminin nasıl üretildiğini, ardından tahminin neden yanlış sayıldığını tanımlamayı gerektirir. Doğrusal regresyonda f(x) = m*x + b modeli için m eğim, b sabit terimdir. Gerçek gözlem y_i ile tahmin f(x_i) arasındaki işaretli farkları doğrudan toplamak doğru bir hata ölçüsü oluşturmaz: pozitif ve negatif artıklar birbirini götürebilir. Ortalama karesel hata (MSE), bu iptali önler.
L(m,b) = (1/n) * Σ_i (m*x_i + b - y_i)^2

g_m = ∂L/∂m = (2/n) * Σ_i x_i * (m*x_i + b - y_i)
g_b = ∂L/∂b = (2/n) * Σ_i       (m*x_i + b - y_i)

m_yeni = m - η*g_m
b_yeni = b - η*g_b
Türev, parametredeki küçük bir değişikliğin kaybı yerel olarak nasıl değiştirdiğini belirtir; g_m ve g_b birlikte gradyan vektörünü oluşturur. Negatif gradyan yönü, yeterince küçük bir adım için kaybın en hızlı azaldığı yerel yöndür. Öğrenme katsayısı η, yönü değil adım uzunluğunu belirler.
Animasyondaki sayılar, iki parametrenin etkisini karıştırmamak için eğimi **sabit m = 1** tutan küçük bir veri kümesinden hesaplanmıştır: (x,y) = (0,1), (1,2), (2,3), (3,4). Böylece yalnız b eğitilir ve kayıp tam olarak L(b) = (b - 1)^2 olur. Başlangıç değeri b = -1 seçildiğinde dört tahmin -1, 0, 1, 2, MSE ise 4 tür. Türev dL/db = 2(b - 1) olduğundan η = 0.25 ile bir güncellemenin sonucu aşağıdaki gibidir:
adım     b         dL/db      L(b)
0       -1        -4         4
1        0        -2         1
2        0.5      -1         0.25
3        0.75     -0.5       0.0625
4        0.875    -0.25      0.015625
Her satırdaki türev, o satırın mevcut b değerinde hesaplanır; bir sonraki satır için b_yeni = b - 0.25 * dL/db uygulanır. Bu veri kümesinde hata her adımda dörtte bire düşer. Bu davranış her kayıp fonksiyonu ve öğrenme katsayısı için garanti değildir: örnekte η = 1 seçilirse parametre en küçük değerin iki yanında salınır ve hata azalmaz. İki parametre birlikte eğitildiğinde kayıp m,b üzerinde konveks bir ikinci dereceden yüzey oluşturur; çözümün tekliği ayrıca veri matrisinin tam sütun rütbesine bağlıdır.
Optimizasyonun hedefi eğitim kaybını azaltmaktır; görülmemiş örneklere genelleme yapıldığı sonucu bundan tek başına çıkmaz. Doğrulama verisi, model karmaşıklığı ve eğitim süresinin seçimi için ayrı tutulur. Türevle güncellenmeyen yöntemler de makine öğrenmesinin parçasıdır; gradyan inişi bütün algoritmaların ortak işleyişi değildir.
4.2. Polinom Regresyon
Doğrusal regresyondaki “doğrusal” ifadesi girdinin kendisine değil parametrelere göre doğrusallığı ifade eder. Örneğin:
Y = β0 + β1X + β2X^2 + εparametreler bakımından hâlâ doğrusal bir regresyon modelidir. Derece yükseldikçe esneklik artar, fakat eğitim verisine aşırı uyum riski de büyür.
4.3. Lojistik Regresyon
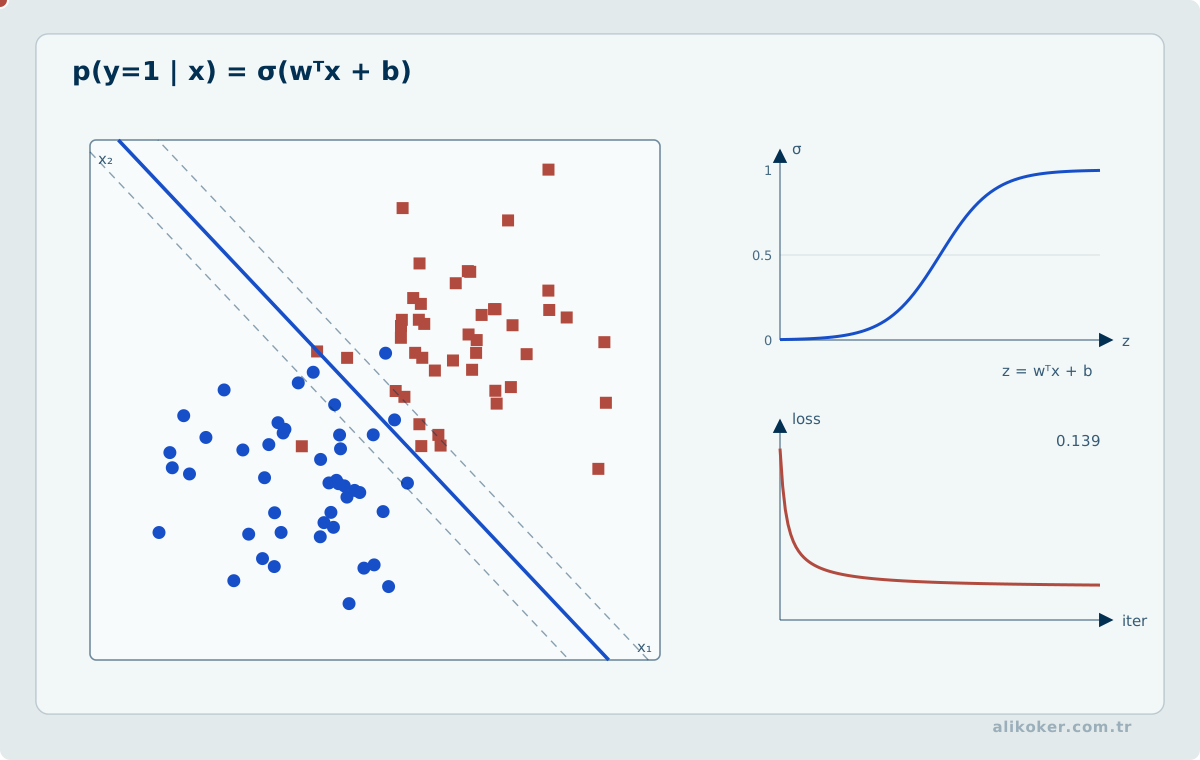
İkili sınıflandırmada doğrusal skor:
z = β0 + β^T xsigmoid ile olasılığa çevrilebilir:
p(y=1|x) = 1 / (1 + e^(-z))Karar için 0.5 eşiği zorunlu değildir; eşik yanlış pozitif ve yanlış negatif maliyetlerine göre seçilebilir. Lojistik regresyon adında “regresyon” bulunsa da temel kullanım alanı sınıflandırmadır.
4.4. Logit, Sigmoid ve Softmax Arasındaki Matematiksel İlişki
Lojistik regresyondaki z, doğrudan olasılık değildir; ikili modelde olasılık oranının logaritmasıdır. p pozitif sınıf olasılığı olmak üzere:
logit(p) = ln(p/(1-p)) = z
sigmoid(z) = 1/(1+exp(-z))
p=0.8 için odds 4, logit ise ln(4) olur. Olasılık 0 veya 1 sınırına yaklaştıkça logit büyüklüğü sınırsız artar; bu nedenle logit ile olasılık aynı sayısal ölçekte karşılaştırılmaz. İkiden fazla ve birbirini dışlayan sınıfta skor vektörü z_i softmax ile normalize edilebilir:
softmax(z_i) = exp(z_i-m) / sum_j exp(z_j-m)
m = max_j z_j
Her skordan aynı m değerinin çıkarılması sonucu değiştirmez; büyük pozitif skorlarda taşma riskini azaltır. Sigmoid tek bir ikili skor için, softmax ise birbirini dışlayan sınıfların ortak normalizasyonu için kullanılır. Çok etiketli sınıflandırmada her etiketin bağımsız sigmoid çıktısı gerekebilir. Bu çıktılar model skorlarından türetilen olasılık tahminleridir; kalibrasyonları ayrıca sınanmalıdır.
4.5. Ridge, Lasso ve Elastic Net
Ridge:
min_β SSE + λ Σ β_j^2Lasso:
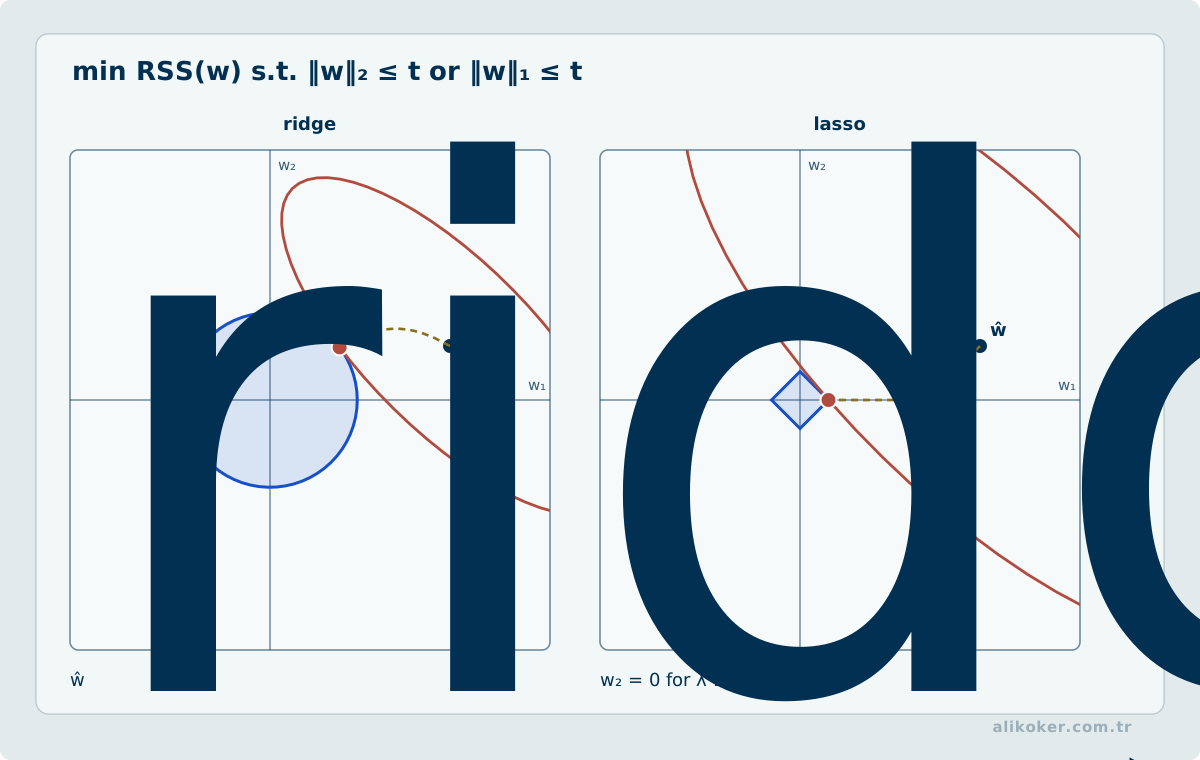
min_β SSE + λ Σ |β_j|Elastic Net iki cezayı birlikte kullanır. Ridge katsayıları küçültür; Lasso bazı katsayıları sıfıra iterek seyrek çözüm üretebilir. Ceza büyüklüğü eğitim verisine bakılarak keyfî seçilmemeli, doğrulama veya çapraz doğrulama ile değerlendirilmelidir.
4.6. PCR ve PLS
Principal Components Regression önce açıklayıcı değişkenleri PCA bileşenlerine dönüştürür, ardından regresyon yapar. PCA hedef y bilgisini kullanmadığı için en yüksek varyanslı yönler her zaman en iyi tahmin yönleri olmayabilir.
Partial Least Squares ise bileşenleri üretirken hedefle ortak değişimi de hesaba katar. Çok sayıda ve ilişkili özellik bulunan veri kümelerinde iki yöntem yararlı olabilir.
4.7. Diğer Regresyon Aileleri
- Support Vector Regression (SVR): SVM'in marj fikrini sürekli hedeflere taşır.
- Gaussian Process Regression (GPR): fonksiyon değerlerini ortak Gauss dağılımı altında modelleyerek tahminle birlikte belirsizlik de üretir; çekirdek seçimi kovaryans yapısını belirler.
- Ordinal regresyon: doğal sırası olan kategorik hedefler için kullanılır.
- Poisson regresyon: sayım verileri için uygundur.
- Negatif binom regresyonu: Poisson varsayımındaki ortalama-varyans eşitliği ciddi biçimde bozulduğunda aşırı saçılımı modelleyebilir.
Model ailesi hedef değişkenin dağılımı ve hata mekanizmasıyla uyumlu seçilmelidir.
Ağırlıklı en küçük karelerde hata terimlerinin varyansları eşit değilse uygun ağırlık seçimi farklı gözlemlerin katkısını değiştirebilir. Ağırlıkların bilinmeyen varyans yapısından tahmin edilmesi ek belirsizlik doğurur; ağırlıklandırma, yanlış koşullu ortalama modelini kendiliğinden düzeltmez. Kuantil regresyon, koşullu ortalamayı değil seçilen τ kuantilini, asimetrik mutlak kayıp üzerinden kestirir; böylece dağılımın farklı bölgelerindeki etkiler karşılaştırılabilir.
Genelleştirilmiş toplamsal modelde (GAM) bağ fonksiyonu üzerinden doğrusal kestiriciye düzgün fonksiyonlar eklenir: g(E[Y|X]) = β₀ + f₁(X₁) + … + fₚ(Xₚ). Düzgünlük cezası ve etkin serbestlik derecesi, esneklik ile aşırı uyum arasındaki dengeyi belirler. GAM, GLM'nin yalnızca başka bir isimle yazılmış hâli değildir; doğrusal varsayım yerine kısıtlanmış düzgün fonksiyonlar kullanır.
4.8. Genelleştirilmiş Doğrusal Modeller
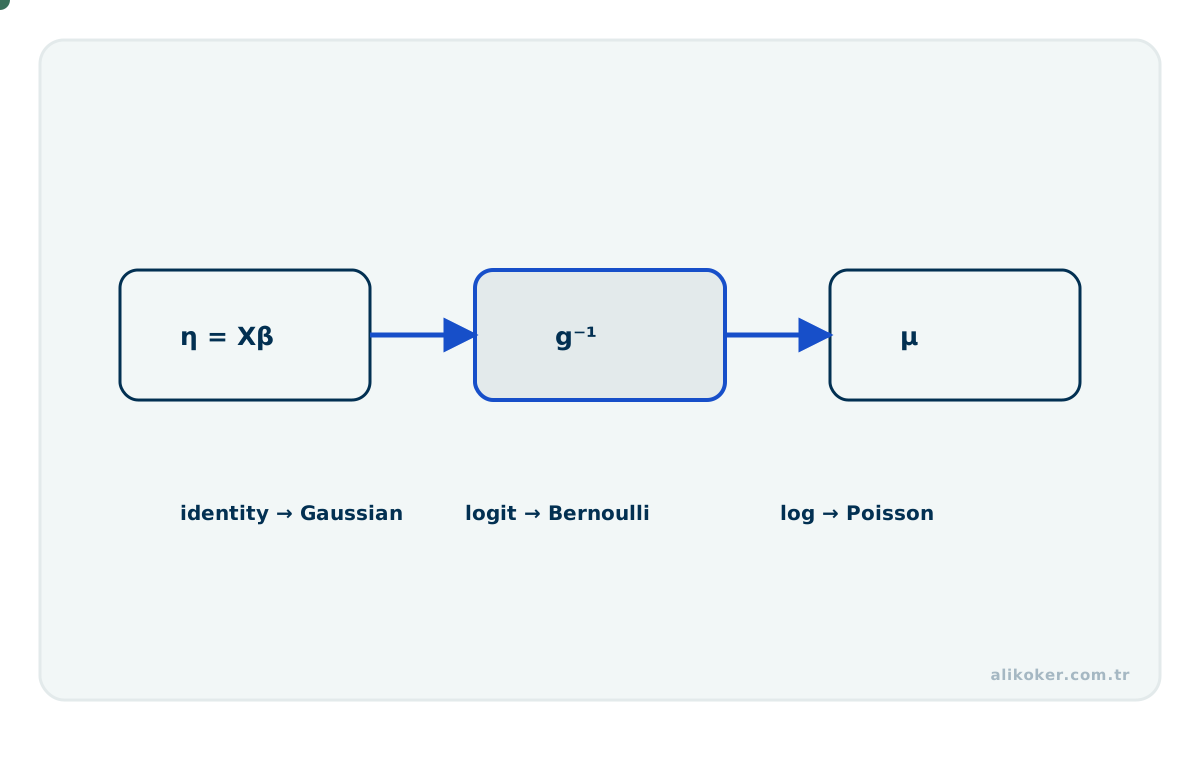
Doğrusal regresyon ve lojistik regresyon ayrı ezber kalıpları yerine genelleştirilmiş doğrusal model (GLM) ailesinde birlikte okunabilir. GLM üç bileşeni ayırır: dağılım ailesi, doğrusal kestirici ve ortalamayı doğrusal kestiriciye bağlayan link fonksiyonu.
- Gaussian yanıt ve identity link doğrusal regresyona,
- Bernoulli yanıt ve logit link lojistik regresyona,
- Poisson yanıt ve log link sayım regresyonuna
doğal örneklerdir. Poisson modelinde ortalama ile varyansın eşitliği veriye uymuyorsa overdispersion ortaya çıkabilir; negatif binom ailesi ek saçılımı modellemek için kullanılabilir.
GLM çerçevesi model seçimini "hangi algoritma?" sorusundan önce "hedef değişkenin dağılımı ve link yapısı nedir?" sorusuna bağlar.
4.9. L1 ve L2 Düzenlileştirmenin Geometrisi
L2 cezası katsayı vektörünün Öklid normunu sınırlar; L1 cezası ise mutlak değerlerin toplamını kullanır. Aynı veri uyumu konturları farklı kısıt geometrileriyle kesiştiğinde L1'in köşeli geometrisi bazı katsayıların tam sıfıra ulaşmasını daha olası hale getirir.
Bu nedenle Lasso'nun seyrek çözüm üretmesi yalnız algoritmik tesadüf değildir. Ridge ise korelasyonlu özelliklerde katsayıları birlikte küçültme eğilimindedir. Özellik ölçekleri düzenlileştirme cezasını doğrudan etkilediği için standardizasyon kararı modelleme boru hattının parçasıdır.
Ünite 5: k-En Yakın Komşu
5.1. Temel Fikir
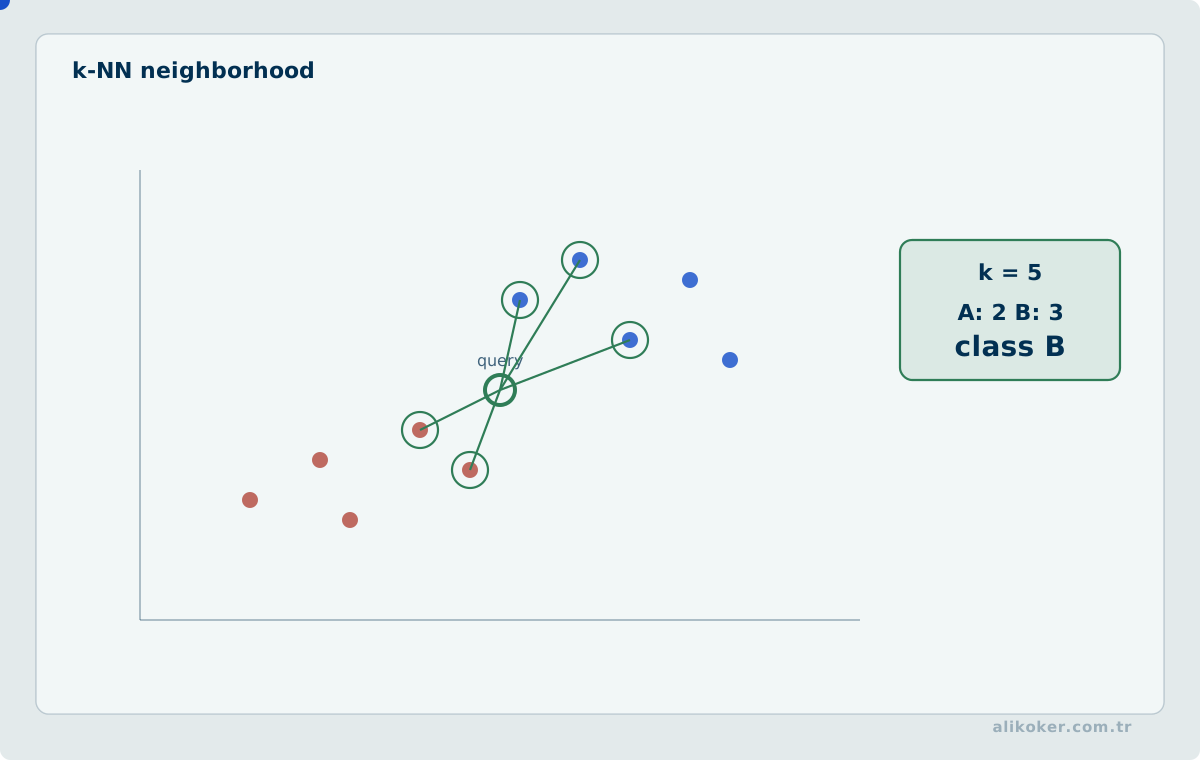
k-En Yakın Komşu (k-NN), yeni gözlemi eğitim kümesindeki en yakın k örneğe bakarak tahmin eder. Eğitim aşamasında karmaşık bir parametrik model kurmadığı için örnek tabanlı veya tembel öğrenme yöntemi olarak anılır.
Sınıflandırmada:
ŷ = en yakın k komşu içindeki çoğunluk sınıfıregresyonda ise komşu hedeflerinin ortalaması veya ağırlıklı ortalaması kullanılabilir.
5.2. K Seçimi
k=1 karar sınırını çok yerel hale getirir; gürültüye duyarlılık artabilir. Büyük k tahmini daha düzgün hale getirir fakat küçük ve gerçek yerel yapıları silebilir. k bir hiperparametredir ve doğrulama verisiyle seçilmelidir.
İkili sınıflandırmada eşitlik riskini azaltmak için tek sayılı k kullanmak pratik olabilir; çok sınıflı problemlerde bu tek başına eşitliği garanti etmez.
5.3. Ağırlıklı Oylama
Yakın komşunun daha etkili olması için örneğin:
w_i = 1 / (d_i + ε)şeklinde uzaklığa ters ağırlık kullanılabilir. Uzaklık sıfır olduğunda bölme hatasını önlemek için özel durum yönetimi gerekir.
5.4. Hesaplama Maliyeti
Naif uygulamada her sorgu için tüm eğitim örnekleriyle uzaklık hesaplanır. KD-tree ve ball tree düşük/orta boyutta hız sağlayabilir; çok yüksek boyutta indeks yapıları etkinliğini kaybedebilir. Yaklaşık en yakın komşu yöntemleri büyük vektör uzaylarında farklı bir hız-doğruluk dengesi sunar.
5.5. Güçlü ve Zayıf Yönleri
k-NN basit, açıklanabilir ve doğrusal olmayan karar sınırlarını temsil edebilir. Buna karşılık:
- ölçeklemeye duyarlıdır,
- alakasız özelliklerden etkilenir,
- yüksek boyutta komşuluk zayıflar,
- sorgu maliyeti büyüyebilir,
- sınıf dengesizliği çoğunluk oyunu bozabilir.
Bu nedenlerle veri ön işleme algoritmanın ayrılmaz parçasıdır.
Ünite 6: Bayesçi Sınıflandırma ve Naive Bayes
6.1. Bayes Teoremi
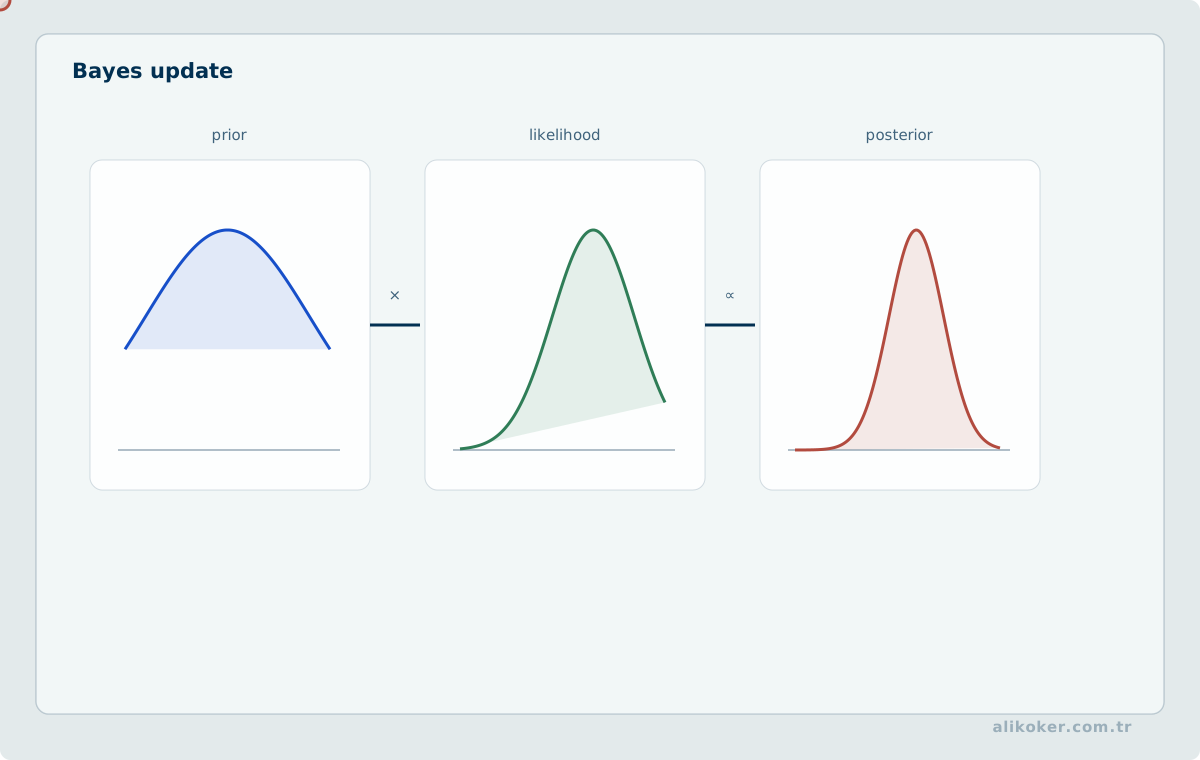
Sınıf C, gözlenen özellikler x olsun:
P(C | x) = P(x | C) P(C) / P(x)Sınıflar karşılaştırılırken P(x) tüm sınıflar için ortak olduğundan:
P(C | x) ∝ P(x | C) P(C)yeterlidir.
P(C) önsel olasılık, P(x|C) olabilirlik, P(C|x) sonsal olasılıktır.
6.2. Naive Bayes Varsayımı
Naive Bayes, özelliklerin sınıf verildiğinde koşullu bağımsız olduğunu varsayar:
P(x1,...,xp | C) = Π P(x_j | C)Bu varsayım gerçek veride çoğu zaman tam doğru değildir; buna rağmen özellikle seyrek, yüksek boyutlu metin verilerinde etkili bir başlangıç modeli olabilir.
Naive Bayes modelindeki koşullu bağımsızlık, özniteliklerin genel olarak bağımsız olduğu iddiası değildir: varsayım, sınıf etiketi bilindiğinde özniteliklerin ortak olabilirliğinin tekil olabilirliklerin çarpımıyla yaklaşık modellenmesidir. Aynı kökten gelen iki sözcüğün birbirine güçlü biçimde bağlı olması bu yaklaşımın olasılık kalibrasyonunu bozabilir; buna rağmen karar sınırı bazı görevlerde kullanışlı olabilir. Bir sınıfta hiç görülmeyen özelliğin olasılığının sıfırlanması da bütün çarpımı sıfıra sürükler. Sayım temelli modellerde düzgünleştirme bu sayısal sorunu azaltır; düzgünleştirme katsayısı, sınıf dengesizliği ve olasılık kalibrasyonu ayrı ayrı doğrulanmalıdır.
6.3. Gaussian, Multinomial ve Bernoulli Naive Bayes
- Gaussian Naive Bayes: sürekli özellikleri sınıf içinde normal dağılımla modeller.
- Multinomial Naive Bayes: sözcük veya olay sayımları gibi negatif olmayan sayım özelliklerinde kullanılır.
- Bernoulli Naive Bayes: bir özelliğin var/yok biçimindeki ikili temsilini kullanır.
Model seçimi verinin nasıl temsil edildiğine bağlıdır.
6.4. Sıfır Olasılık ve Laplace Düzeltmesi
Eğitim kümesinde hiç görülmeyen bir sözcük için doğrudan sıfır olasılık kullanılırsa çarpımdaki bütün sınıf olabilirliği sıfıra düşebilir. Additive/Laplace smoothing:
P(w|C) = (count(w,C) + α) / (Σ count(.,C) + α|V|)ile sıfır sayımlarını yumuşatır. α=1 klasik add-one düzeltmesidir.
6.5. Log Uzayında Hesaplama
Çok sayıda küçük olasılığı çarpmak sayısal taşma-altı üretebilir. Bunun yerine:
log P(C|x) ∝ log P(C) + Σ log P(x_j|C)hesaplanır.
6.6. Spam Sınıflandırması
Metin vektörleri ve Naive Bayes birlikteliği spam filtrelemenin klasik örneklerindendir. Veri Madenciliği Teknikleri ile Spam Algılama çalışmasında Bayesçi sınıflandırma, n-gram temsilleri ve sınıflandırma ölçütleri uygulama bağlamında ele alınır.
Ünite 7: Destek Vektör Makineleri
7.1. Maksimum Marj
İkili sınıflandırmada doğrusal karar yüzeyi:
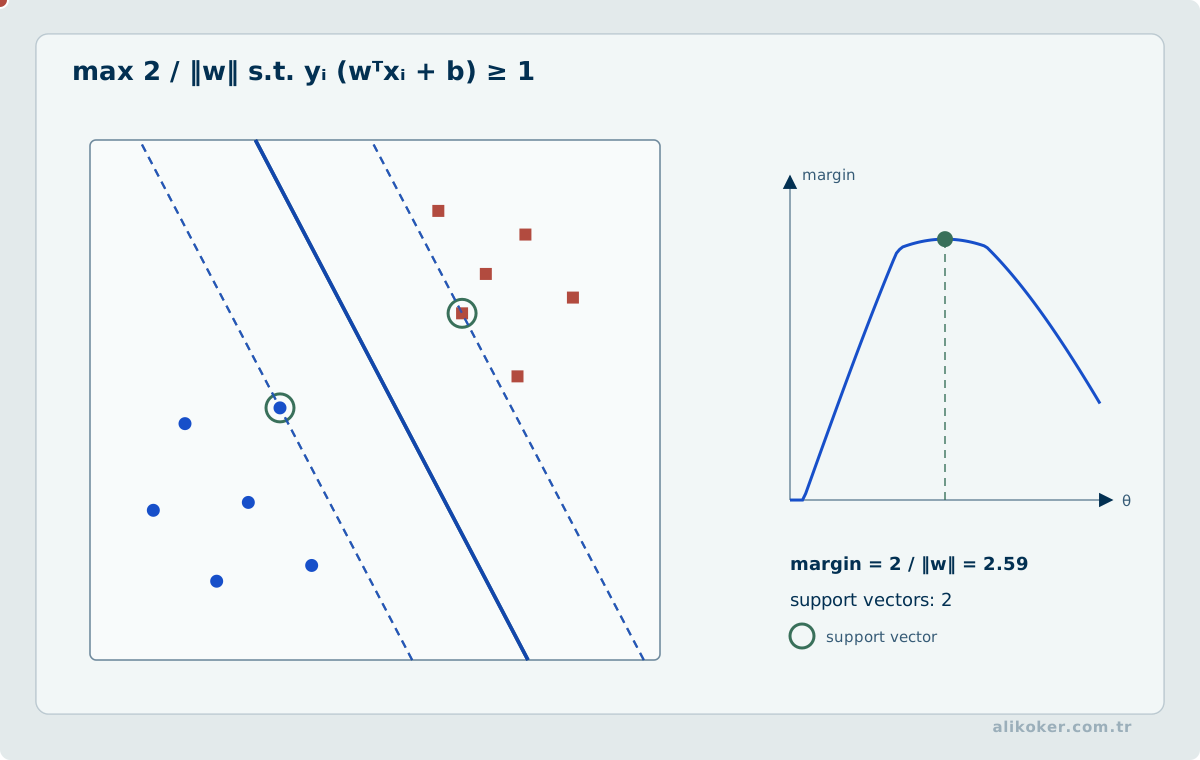
w^T x + b = 0şeklindedir. SVM yalnız sınıfları ayıran bir yüzey bulmak yerine, iki sınıfa en yakın örneklerle arasındaki marjı mümkün olduğunca genişletir. Karar yüzeyini belirleyen kritik örnekler destek vektörleridir.
7.2. Hard Margin
Veri kusursuz doğrusal ayrılabiliyorsa:
y_i (w^T x_i + b) >= 1kısıtları altında:
min 1/2 ||w||^2çözülür. Gerçek veride ölçüm hatası ve sınıf örtüşmesi bulunduğundan hard margin çoğu zaman fazla katıdır.
7.3. Soft Margin ve C
Slack değişkenleri ξ_i ile ihlallere izin verilir:
min 1/2 ||w||^2 + C Σ ξ_iC büyüdükçe eğitim ihlalleri daha ağır cezalandırılır; küçük C daha geniş marj ve daha fazla ihlale izin verebilir. C doğrudan “yüksek daha iyi” biçiminde seçilemez.
Yumuşak marjlı destek vektör makinesinde C büyüdükçe eğitim örneklerinin marj ihlallerine uygulanan ceza artar; bu, her zaman daha iyi genelleme demek değildir. Aykırı bir etiket hatasını sınıra sığdırmak uğruna karar düzlemi keskinleşebilir. C küçüldüğünde daha fazla ihlale izin verilebilir, fakat model de gereğinden fazla basitleşebilir. Çekirdek parametreleri ve öznitelik ölçeği bu ödünleşimi değiştirir. Parametre seçimi yalnız eğitim verisindeki doğruluğa bakılarak yapılmamalı; grup/zaman ayrımını koruyan doğrulama üzerinde ve ayrı tutulan sınama kümesini açmadan kararlaştırılmalıdır.
7.4. Çekirdek Yöntemi
Doğrusal olmayan örüntülerde özellik dönüşümü φ(x) ile daha uygun bir uzay düşünülebilir. Çekirdek:
K(x,z) = φ(x)^T φ(z)ifadesini dönüşümü açıkça oluşturmadan hesaplamaya imkân verir.
Yaygın çekirdekler:
- doğrusal,
- polinom,
- RBF/Gaussian,
- sigmoid.
RBF çekirdeğinde γ komşuluğun ölçeğini belirler. Çok büyük γ çok yerel karar bölgeleri oluşturabilir; çok küçük γ model esnekliğini azaltabilir.
7.5. Çok Sınıflı SVM
SVM'in temel formu ikili sınıflandırmadır. Çok sınıflı görevler one-vs-rest veya one-vs-one gibi stratejilerle kurulabilir. Kullanılan kütüphanenin hangi stratejiyi uyguladığı değerlendirme sırasında bilinmelidir.
7.6. SVR
Support Vector Regression, belirli bir ε tüpü içindeki hataları cezasız kabul ederek regresyon yapabilir. Böylece marj fikri sürekli hedeflere taşınır.
Ünite 8: Karar Ağaçları ve Topluluk Öğrenmesi
8.1. Karar Ağacı
Karar ağacı veriyi ardışık sorularla böler. İç düğüm bir özelliği ve bölme kuralını, yaprak düğüm nihai tahmini taşır. Elde edilen yol çoğu durumda okunabilir bir kural olarak ifade edilebilir.
8.2. Entropi ve Bilgi Kazancı
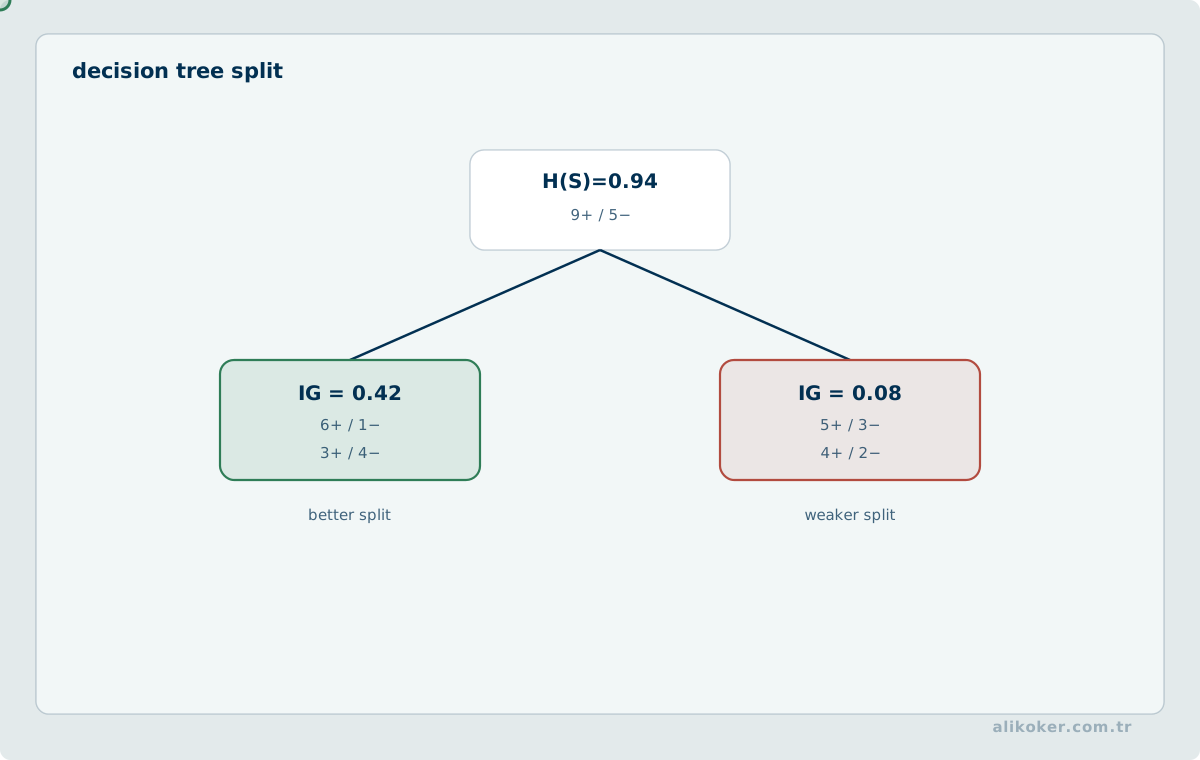
Bir düğümde sınıf olasılıkları p_k ise entropi:
H = -Σ p_k log2 p_kşeklindedir. Bölme sonrası belirsizlik azalması bilgi kazancı olarak kullanılabilir. ID3 klasik olarak information gain ile ilişkilidir.
C4.5, çok sayıda farklı değer alan özelliklere eğilimi azaltmak için gain ratio kullanır.
8.3. Gini Ölçütü
CART sınıflandırma ağaçlarında yaygın safsızlık ölçüsü:
Gini = 1 - Σ p_k^2şeklindedir. Regresyon ağacında karesel hata gibi sürekli hedef ölçütleri kullanılabilir.
8.4. Aşırı Uyum ve Budama
Ağaç yeterince derin büyütülürse eğitim verisini çok ayrıntılı parçalayabilir. Bu durum varyansı artırır. Maksimum derinlik, minimum yaprak örneği, minimum kazanç ve budama gibi kontroller genelleme için kullanılır.
8.5. Bagging ve Random Forest
Bagging, bootstrap örnekleri üzerinde birçok model eğitip çıktıları birleştirir. Random Forest buna ek olarak her bölmede özelliklerin rastgele bir alt kümesini değerlendirerek ağaçlar arasındaki korelasyonu azaltmaya çalışır.
Sınıflandırmada çoğunluk oyu, regresyonda ortalama sık kullanılan birleştirme yöntemidir.
8.6. Boosting
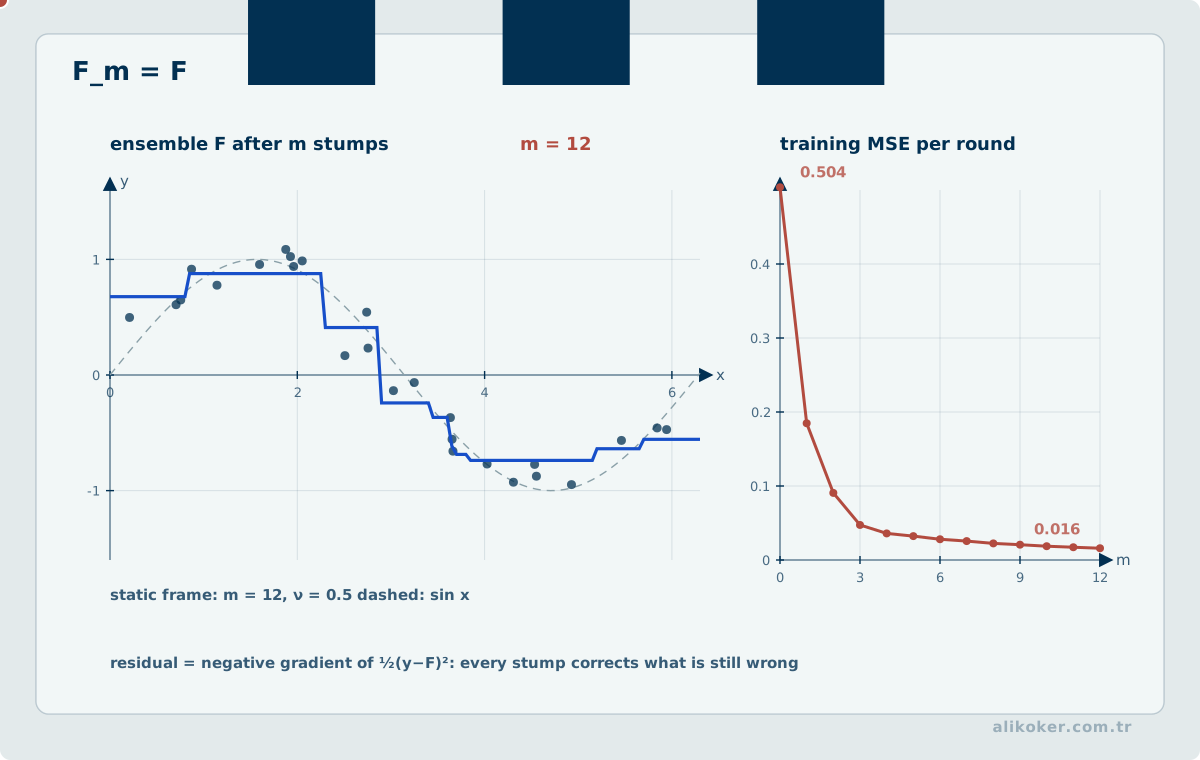
Boosting modelleri bağımsız ortalamak yerine ardışık biçimde kurar; sonraki öğrenici önceki hatalara daha fazla odaklanır. AdaBoost ve gradient boosting aynı genel fikrin farklı gerçekleştirimleridir.
Topluluk yöntemi her durumda tek modeli geçmez; veri boyutu, gürültü, hiperparametreler ve değerlendirme protokolü belirleyicidir.
8.7. Rastgele Ormanlarda Değişken Etkisi ve Etkileşim Seçimi
Rastgele orman, ağaçların kestirimlerini birleştirerek tek bir ağacın yüksek varyansını azaltabilir; buna karşılık modelde kullanılan bir değişkenin önemli sayılması, değişkenin hedef üzerinde nedensel etkisi bulunduğu anlamına gelmez. Düğüm safsızlığındaki toplam azalmadan hesaplanan önem ölçüleri, çok sayıda olası bölünme noktası bulunan değişkenleri kayırabilir. Permütasyon önemi de kuvvetli korelasyona sahip değişkenlerde tek başına yorumlanmamalıdır: bir değişkenin rastgele karıştırılması eğitim verisindeki ortak dağılımı bozabilir ve diğer değişkenlerin taşıdığı bilgi aynı kalır.
Etkileşim ararken bir özelliğin tek başına zayıf, başka bir özellik koşulunda güçlü olabileceği dikkate alınır. Yalnız marjinal etkileri sıralayıp ilk birkaç değişkeni seçmek bu tür ilişkileri kaçırabilir. Etkileşim amaçlı ağaç topluluklarında değişken çiftlerinin sonuç üzerindeki ortak etkisi, örneklem dışı değerlendirme ve mümkün olduğunda karıştırıcı değişkenlere duyarlılık analiziyle birlikte incelenmelidir. Gözlemsel veride böyle bir etkileşim, ayrıca bir nedensel tanımlama stratejisi kurulmadıkça müdahalenin etkisi olarak yorumlanamaz.
Bayesçi toplamsal regresyon ağaçları (BART), yanıtı tek büyük ağaç yerine düzenlileştirilmiş küçük ağaç katkılarının toplamıyla modeller. Ağaç yapısı ve yaprak değerleri üzerindeki öncül dağılımlar esnekliği denetler; sonsal örnekleme tahmin belirsizliğinin değerlendirilmesine olanak tanır. Random Forest, gradient boosting ve BART aynı karar ağacı ailesini paylaşsa da eğitim hedefleri ve belirsizlik yorumları aynı değildir.
Ünite 9: Kümeleme ve Karışım Modelleri
9.1. Kümeleme Problemi
Kümeleme etiketsiz veride benzer örnekleri gruplamaya çalışır. “İyi küme” fikri kullanılan benzerlik ölçüsüne ve beklenen geometrik yapıya bağlıdır. Bir algoritmanın ürettiği kümelerin fiziksel anlamını model kendiliğinden bilmez; yorum alan bilgisiyle yapılır.
Kümeleme başarısı tek bir içsel puanla hükme bağlanamaz. Silhouette gibi bir ölçüt, seçilen uzaklık geometrisine ve kümelerin şekline duyarlıdır; iç içe geçmiş fakat doğal biçimde ayrılan yapıları yanlış değerlendirebilir. K-ortalama, Öklid uzaklığında kümelerin merkez etrafında görece toplu olmasını ödüllendirirken yoğunluk temelli algoritmalar farklı biçimlerde kümeler bulabilir. Aynı veri üzerinde özellik ölçeği değiştirilerek küme üyeliklerinin ne kadar kararlı kaldığı, tek seferlik skorun ötesinde bir testtir. Etiketlerin sonradan verilmesi de ayrı bir anlamlandırma problemidir.
9.2. K-Means
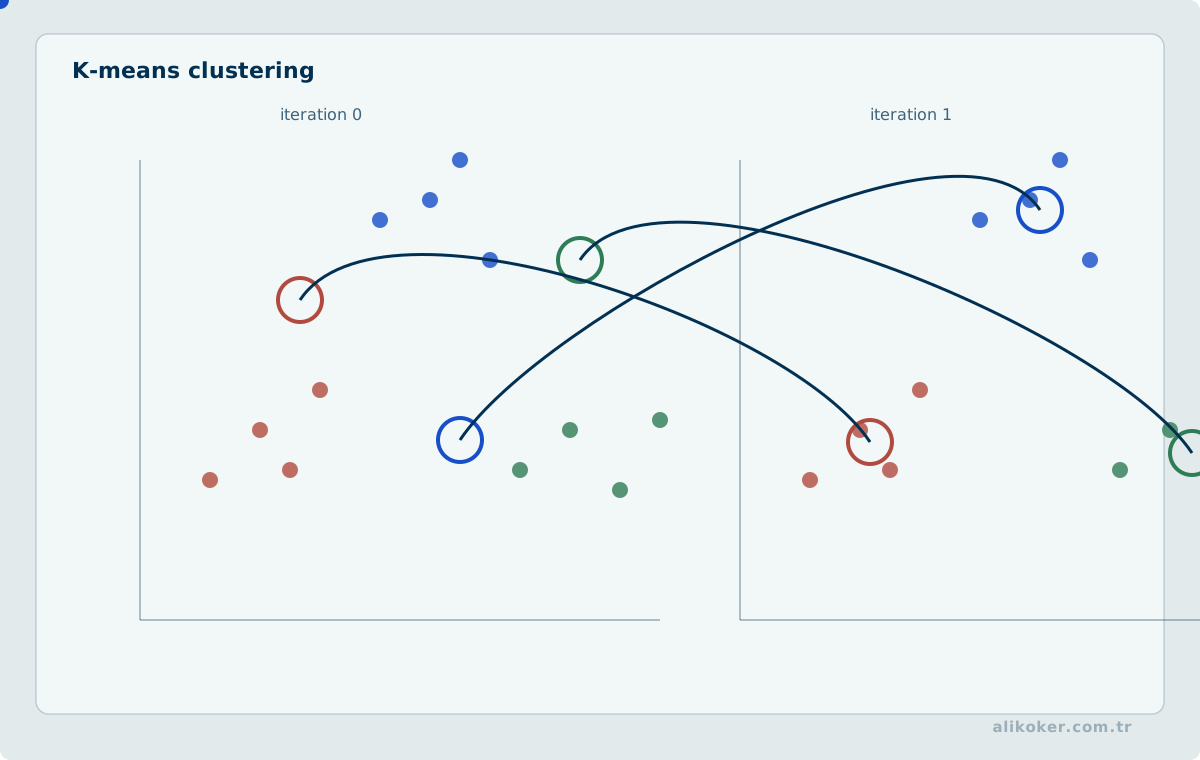
K-Means'in amacı gözlemleri K kümeye ayırarak küme içi kareli uzaklık toplamını azaltmaktır:
J = Σ_k Σ_{x_i ∈ C_k} ||x_i - μ_k||^2Lloyd algoritması:
Kmerkez başlatılır.- Her gözlem en yakın merkeze atanır.
- Her kümenin yeni merkezi aritmetik ortalamayla hesaplanır.
- Atamalar/merkezler kararlı hale gelene kadar 2–3 tekrarlanır.
Amaç değeri iterasyonlarda artmaz; buna rağmen bulunan çözüm global optimum olmak zorunda değildir. Başlangıç merkezleri sonucu etkiler.
9.3. K-Means++ ve K Seçimi
K-Means++ başlangıç merkezlerini birbirinden uzak seçme olasılığını artırarak kötü başlangıç riskini azaltır.
K seçimi için dirsek yöntemi yalnız görsel bir sezgidir. Silhouette skoru bir gözlemin kendi kümesine uyumu ile en yakın alternatif kümeye uzaklığını birlikte değerlendirir. Tek bir “doğru K” her veri kümesinde bulunmayabilir.
K-means aynı veride başlangıç merkezlerine göre farklı yerel çözümler üretebilir. Örneğin birbirinden uzak iki yoğun küme ile bunların arasında küçük bir üçüncü küme varsa, yalnız toplam kare hata azaltımı az sayıdaki kümeyi ayrı tutmayabilir. Birden fazla başlangıç, ölçek duyarlılığı ve küme sayısı için kararlılık incelenmelidir. Silhouette veya dirsek grafiği tek başına gerçek sınıf sayısını kanıtlamaz; kümeleme keşif amaçlıysa sonuç, yeni veri üzerindeki kararlılık ve alan bilgisindeki anlamlı ayrımlarla tartışılmalıdır. Özellikle seyrek metin temsillerinde Öklid uzaklığının uygunluğu, vektör normalizasyonu ve kosinüs benzerliği ilişkisi ayrıca değerlendirilir.
9.4. K-Medoids, PAM, CLARA ve CLARANS
K-Medoids merkez olarak gerçek bir gözlemi kullanır. Bu, ortalamaya dayalı K-Means'e göre aykırı değerlere daha dayanıklı olabilir ve ortalamanın anlamlı olmadığı bazı uzaklıklarla çalışabilir.
PAM klasik medoid arama yöntemidir. CLARA büyük veri için örneklem üzerinde PAM çalıştırır. CLARANS medoid çözümleri arasında örneklenmiş komşuluk araması yapar. Ölçeklenebilirlik kazanımı çözüm kalitesiyle dengelenir.
9.5. Bulanık C-Ortalamalar
Fuzzy C-Means her gözlemi yalnız tek kümeye atamak yerine kümelere üyelik dereceleri verir. Bir noktanın iki küme arasında kalması böylece 0/1 karar yerine dereceli temsil edilir. Üyelik fonksiyonu ve bulanık kümelerin matematiksel temeli Bulanık Mantık notunda ele alınır.
9.6. Hiyerarşik Kümeleme
Birleştirici (agglomerative) yaklaşım tekil gözlemlerden başlayıp kümeleri birleştirir; bölücü (divisive) yaklaşım bütün veri kümesinden başlayıp parçalar. Bağlantı ölçütleri—single, complete, average veya Ward—oluşan dendrogramı ciddi biçimde değiştirebilir.
AGNES ve DIANA klasik hiyerarşik ailelerdir. BIRCH büyük veri üzerinde özet yapı kullanarak ölçeklenebilir kümeleme hedefler; CURE/CAMELEON gibi yöntemler farklı şekil ve yoğunluklara uyum için temsil ve bağlantı fikirlerini genişletir.
9.7. DBSCAN
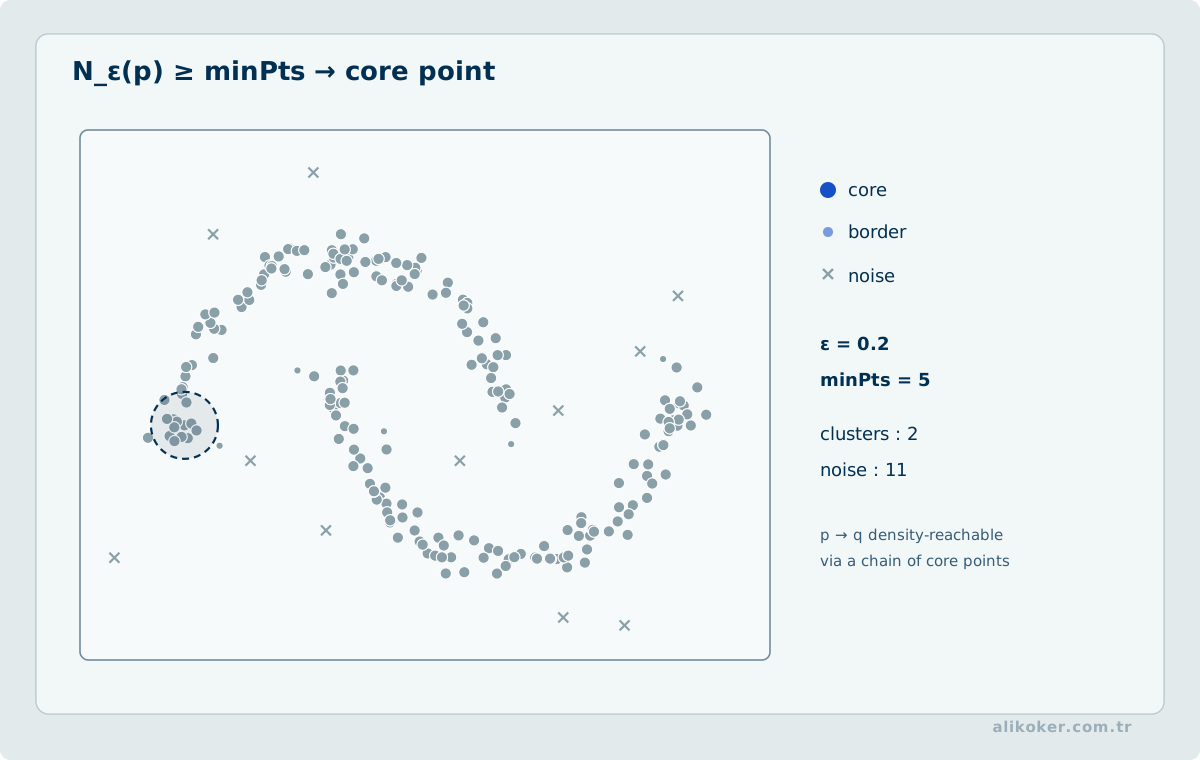
DBSCAN merkez sayısını baştan istemez. ε komşuluğu ve minPts üzerinden yoğun bölgeleri kümeye, seyrek bölgeleri gürültüye ayırır. Küresel olmayan küme şekillerini yakalayabilir; ancak farklı yoğunlukların aynı veri kümesinde bulunması parametre seçimini zorlaştırır.
9.8. Gaussian Mixture ve EM
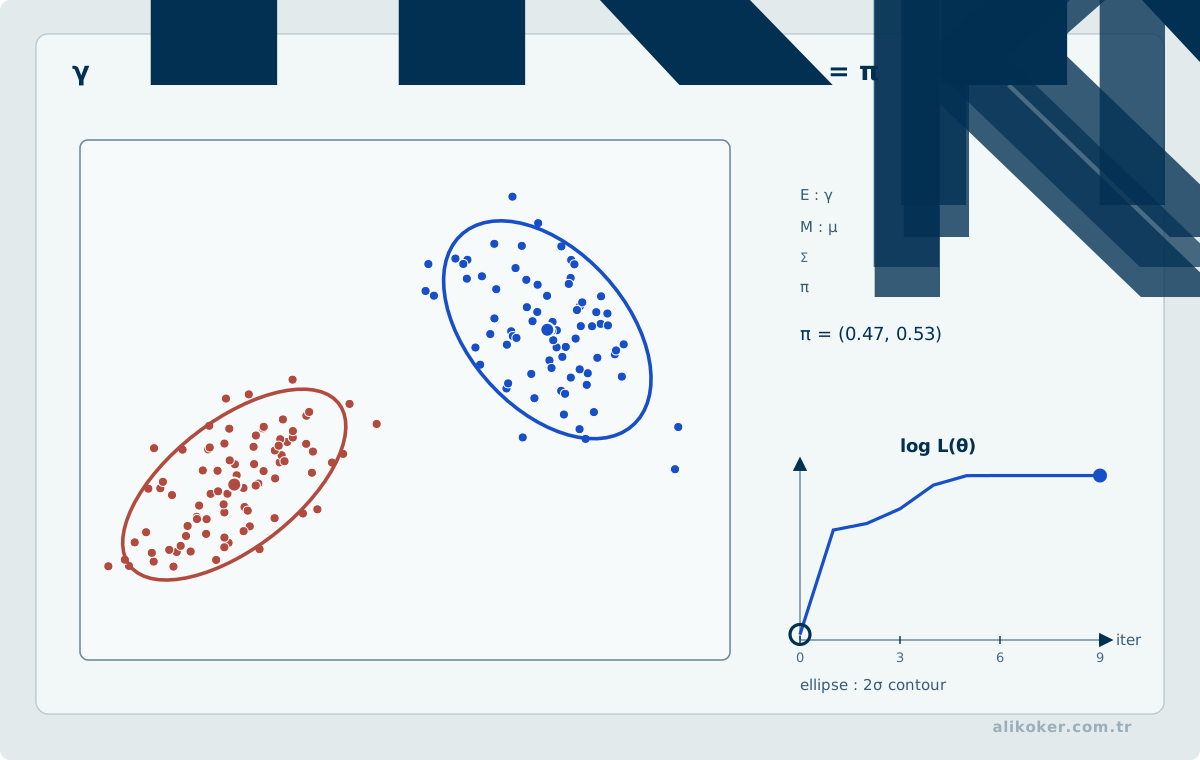
Gaussian Mixture Model veriyi tek merkezli kümeler yerine Gauss bileşenlerinin olasılıksal karışımıyla temsil eder:
p(x) = Σ_k π_k N(x | μ_k, Σ_k)Bir gözlem her bileşen için bir sorumluluk/olasılık değeri taşır. Expectation-Maximization (EM) algoritması:
E adımı: bileşen sorumluluklarını hesapla
M adımı: parametreleri bu sorumluluklarla güncelle
döngüsünü kullanır. K-Means'in sert atamasına karşılık GMM yumuşak olasılıksal üyelik verir.
9.9. EM Algoritmasını Gizli Değişken Açısından Okumak
Karışım modellerinde hangi gözlemin hangi gizli bileşenden geldiği doğrudan gözlenmez. Expectation-Maximization (EM) bu gizli değişkenleri açıkça optimize etmek yerine iki adımı sırayla yineler:
- E adımı mevcut parametrelerle gizli üyeliklerin beklenen dağılımını hesaplar.
- M adımı bu beklenen tam-veri amacı altında parametreleri günceller.
EM her iterasyonda olabilirliği düşürmemeyi hedefler, fakat genel olarak küresel optimum garantisi vermez. Başlatma, bileşen sayısı ve yerel optimumlar sonucu etkileyebilir. K-Means de uygun limit varsayımları altında benzer alternating-assignment/update düşüncesiyle ilişkilendirilebilir.
Ünite 10: Boyut İndirgeme ve Özellik Seçimi
10.1. Özellik Seçimi ve Özellik Dönüşümü
Özellik seçimi mevcut sütunlardan bir alt küme seçer. Boyut indirgeme ise çoğunlukla yeni eksenler üretir. İki işlem aynı değildir.
10.2. PCA
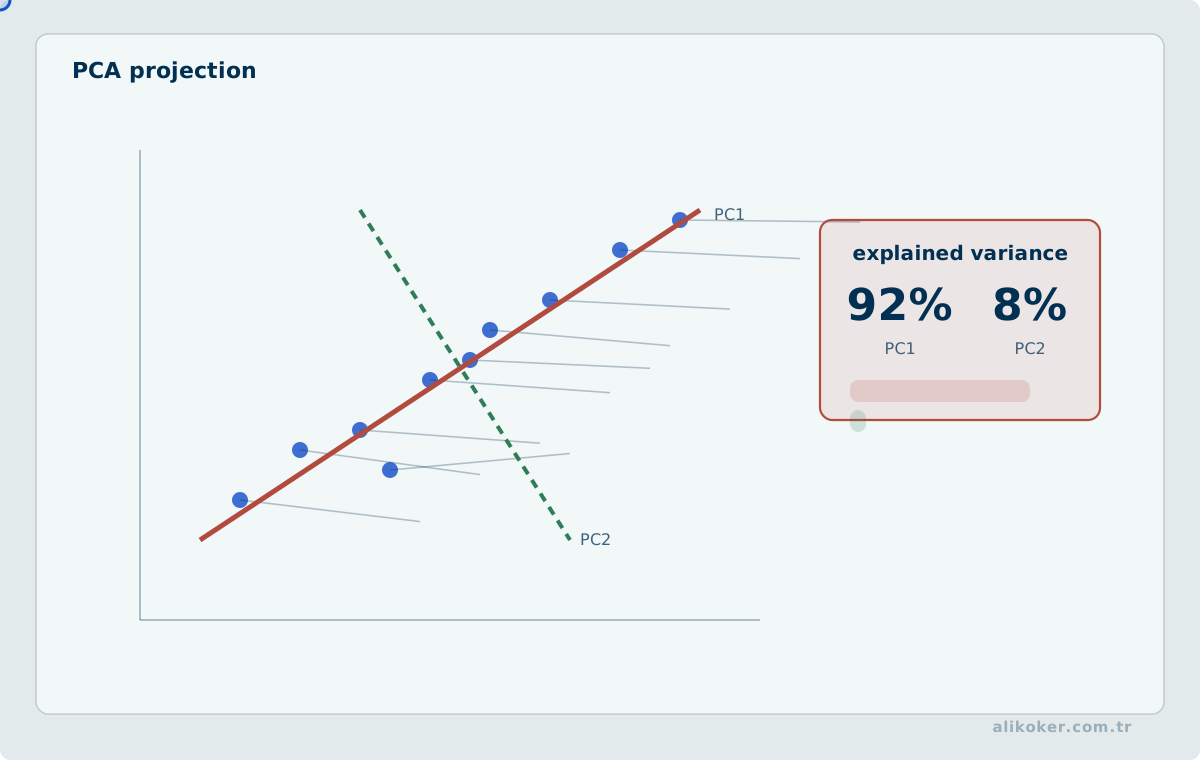
Temel Bileşen Analizi (PCA), verideki en yüksek varyansı taşıyan birbirine dik doğrusal yönleri bulur. Merkezlenmiş veri için kovaryans matrisinin özvektörleri veya SVD kullanılarak hesaplanabilir.
PCA etiket kullanmaz. Bu nedenle en yüksek varyanslı yönün sınıflandırma için en ayırt edici yön olması gerekmez. Özelliklerin farklı birimlerde olduğu veri setlerinde ölçekleme sonuçları belirgin biçimde değiştirebilir.
PCA'nın koruduğu yönler etiketle değil girdinin varyansıyla seçilir. İki boyutlu bir ölçümde birinci değişkenin varyansı 100, ikinci değişkenin varyansı 1 olsun. Hedef sınıf yalnız ikinci değişkendeki küçük fakat tutarlı farka bağlıysa en büyük varyans yönünü koruyan tek bileşenli PCA, sınıflandırma açısından en değerli ayrımı atabilir. Merkezleme ve gerektiğinde ölçekleme PCA modelinin parçasıdır; eğitim ve sınama verisi üzerinde ayrı ayrı yeniden öğrenilmez. Açıklanan varyans oranı bir sıkıştırma ölçüsüdür, hedef görevde tahmin başarısının doğrudan vekili değildir.
10.3. SVD
Bir matris:
X = U Σ V^Tbiçiminde tekil değer ayrışımına uğratılabilir. Düşük dereceli yaklaşım, en büyük tekil değerlerle veri yapısının önemli bölümünü daha az boyutta temsil edebilir. PCA hesaplamasıyla yakın matematiksel ilişkiye sahiptir.
10.4. LDA
Linear Discriminant Analysis sınıf etiketlerini kullanır. Amaç sınıflar arası ayrımı büyütürken sınıf içi saçılımı küçülten doğrusal izdüşüm bulmaktır. İki sınıf için Fisher ölçütü kavramsal olarak:
J(w) = (w^T S_B w) / (w^T S_W w)şeklindedir.
C sınıf için doğrusal ayırt edici alt uzayın boyutu en fazla C-1 olabilir.
PCA ile LDA'nın “hangi varyans önemlidir?” sorusuna cevapları farklıdır: PCA etiketsiz toplam varyansa, LDA sınıf ayrımına bakar.
10.5. Özellik Seçimi
Filtre yöntemleri korelasyon, bilgi kazancı veya istatistiksel test gibi modelden bağımsız ölçüler kullanabilir. Wrapper yöntemleri özellik alt kümelerini model başarısıyla değerlendirir. Embedded yöntemlerde seçim model eğitiminin parçasıdır; Lasso ve ağaç tabanlı önem ölçüleri buna örnektir.
Seçim süreci yalnız eğitim verisi içinde yapılmalıdır. Test setine bakılarak özellik seçmek değerlendirmeyi kirletir.
Ünite 11: Anomali ve Aykırı Değer Tespiti
11.1. Aykırının Bağlama Bağlı Olması
Aykırı değer diğer gözlemlerden önemli ölçüde farklı görünen örnektir. Fakat “farklı” her zaman “hatalı” anlamına gelmez. Üç temel durum ayrılabilir:
- Noktasal aykırı: tek örnek genel dağılımdan sapar.
- Bağlamsal aykırı: örnek yalnız belirli zaman, yer veya bağlam altında sıra dışıdır.
- Toplu aykırı: tek tek normal görünen bir grup birlikte olağan dışı örüntü oluşturur.
Gürültü ölçüm belirsizliği veya rastgele bozulma olabilir; anomali ise alan açısından anlamlı bir olay da olabilir.
11.2. İstatistiksel Yöntemler
Dağılım biliniyorsa düşük olasılıklı bölgeler anomali adayı olarak tanımlanabilir. Normal dağılım altında z-skoru, Grubbs testi ve benzeri yöntemler belirli varsayımlarla çalışır. Boxplot/IQR ve histogram gibi yöntemler dağılımı daha az modelleyerek keşifsel işaret sağlar.
Parametrik model yanlışsa “düşük olasılık” kararı da yanlış olabilir. Aykırılar parametre kestirimini bozabileceği için dayanıklı istatistik önemlidir.
11.3. Regresyon Tabanlı Yöntem
Bir gözlemin model tahmini ile gerçek değeri arasındaki büyük artık anomali işareti olabilir:
r_i = y_i - ŷ_iAncak model yetersizse büyük artık anomali değil model hatasıdır.
11.4. Yakınlık ve Yoğunluk Tabanlı Yöntemler
k-NN uzaklığı gibi ölçüler, komşularından çok uzakta kalan noktaları işaretleyebilir. Local Outlier Factor (LOF), bir noktanın yerel yoğunluğunu komşularının yoğunluğuyla karşılaştırır. Yaklaşık LOF≈1 benzer yerel yoğunluk, belirgin biçimde >1 daha seyrek yerleşim anlamına gelebilir.
Yüksek boyutta uzaklık ve yoğunluk kavramları zayıfladığından bu yöntemler özellik temsiline duyarlıdır.
11.5. Kümeleme Tabanlı Yöntemler
- Merkezden çok uzak gözlemler,
- çok küçük kümeler,
- seyrek kümeler,
- DBSCAN tarafından gürültü olarak bırakılan noktalar
anomali adayı olabilir. Fakat normal veri doğal kümeler oluşturmuyorsa bu varsayım başarısız olur.
11.6. Sınıflandırma Tabanlı Yöntemler
Etiketli normal/anormal örnekler varsa sıradan ikili sınıflandırma kullanılabilir. Anomali örneği az olduğunda one-class SVM gibi yalnız normal sınıfın sınırını öğrenmeye çalışan yöntemler de kullanılabilir.
Anomali tespiti siber saldırı, dolandırıcılık, sensör arızası, tıbbi gözlem, görüntü ve metin gibi çok farklı alanlarda kullanılır; “anomali”nin operasyonel tanımı her alanda yeniden kurulmalıdır.
11.7. Aykırı Değer Puanlarının Kalibrasyonu ve Olay Ölçütleri
Isolation Forest, LOF ve tek sınıflı modeller aynı nicelikte puan üretmez; bir modelin büyük puanının olay olasılığı olduğu varsayılmaz. Karar eşiği, ayrı doğrulama verisinde olay sıklığı, yanlış alarm maliyeti ve inceleme kapasitesine göre seçilir. Kaydırmalı pencerelerde noktasal F1 ile olay başlangıç gecikmesi birlikte raporlanmalıdır. Aynı olaya ait örtüşen pencereler eğitim ve sınama kümelerine dağılırsa veri sızıntısı oluşabilir. Kuramsal ayrımlar ve alarm politikası için Anomali Algılama dersine bakılabilir.
Ünite 12: n-gram ve İstatistiksel Dil Modelleri
12.1. Diziyi Yerel Bağlamla Modellemek
Bir n-gram, bir dizide art arda gelen n birimin oluşturduğu parçadır. Birim sözcük, karakter, hece, token veya uygulamaya özgü başka bir sembol olabilir.
1-gram = unigram
2-gram = bigram
3-gram = trigram
n-gram = n uzunluklu ardışık parça
“gram” ağırlık anlamına gelmez; burada parça/dizi birimini ifade eden adlandırmanın parçasıdır.
12.2. Zincir Kuralı ve Markov Yaklaşımı
Bir sözcük dizisinin tam olasılığı:
P(w1,...,wT) = Π_t P(w_t | w1,...,w_{t-1})ile yazılabilir. Tam geçmişi kestirmek veri açısından zordur. n-gram dil modeli yalnız son n-1 birimi bağlam kabul eder:
P(w_t | geçmiş) ≈ P(w_t | w_{t-n+1},...,w_{t-1})Bigram için:
P(w_t | w_{t-1})kullanılır.
12.3. Sayım Tabanlı Kestirim
Bigram için en çok olabilirlik kestirimi:
P(w_i | w_{i-1}) = count(w_{i-1}, w_i) / count(w_{i-1})şeklindedir. Görülmemiş diziler sıfır olasılık üretebileceğinden yumuşatma (smoothing), geri çekilme (backoff) ve enterpolasyon (interpolation) gibi yöntemler kullanılır.
12.4. Karakter ve Sözcük n-gram'ları
Sözcük n-gram'ları yerel sözdizim ve sözcük birlikteliklerini taşır. Karakter n-gram'ları yazım varyasyonları, ekler, dil tanıma ve gürültülü metin için yararlı olabilir. Türkçe gibi eklemeli dillerde karakter/parça temsilleri seyrek sözcük sorununu kısmen azaltabilir.
12.5. Naive Bayes ile İlişki
Metin sınıflandırmada n-gram sayımları Multinomial Naive Bayes'in özellikleri olarak kullanılabilir. Unigram yalnız tekil sözcük sıklığını, bigram ise “çok iyi”, “iyi değil” gibi yerel sıralama bilgisinin bir bölümünü taşır. n büyüdükçe bağlam zenginleşirken veri seyrekliği ve özellik uzayı büyür.
12.6. Konuşma Tanıma
Klasik otomatik konuşma tanıma sistemlerinde akustik model aday sözcük dizilerinin sese uyumunu, n-gram dil modeli ise dizinin dilsel olasılığını değerlendirir. Bu ilişki Sesten Konuşma Tanıma bölümünde sistem mimarisi içinde ele alınır.
12.7. Modern Dil Modelleriyle Fark
n-gram modeli sabit ve kısa bağlama dayalı sayım istatistiğidir. Transformer tabanlı dil modelleri bağlamı dağıtık vektör temsilleri ve attention üzerinden işler. Her ikisi de dizisel olasılık kestirebilir, fakat temsil kapasitesi ve genelleme mekanizması aynı değildir.
Ünite 13: Olasılıksal Grafik Modeller ve Gizli Markov Modelleri
13.1. Bayes Ağları
Bir Bayes ağı, rassal değişkenler arasındaki koşullu bağımlılıkları yönlü çevrimsiz bir graf üzerinde gösterir. Her düğüm kendi ebeveynlerine koşullu bir olasılık dağılımı taşır. Ortak dağılım:
P(X1,...,Xn) = Π_i P(X_i | Parents(X_i))şeklinde çarpanlara ayrılır. Grafik, hangi değişkenlerin doğrudan koşullu ilişki taşıdığını görünür kılar; fakat gözlemsel bir Bayes ağı tek başına nedensel grafik değildir.
Naive Bayes bu bakışın özel ve çok kısıtlı bir örneği gibi düşünülebilir: sınıf düğümü özelliklerin ortak ebeveynidir ve özellikler sınıf verildiğinde birbirinden bağımsız kabul edilir.
13.2. Markov Zinciri
Markov varsayımı geleceğin, seçilen durum tanımı verildiğinde daha eski geçmişten bağımsız olduğunu söyler:
P(S_t | S_1,...,S_{t-1}) = P(S_t | S_{t-1})Bu yapı Olasılık ve İstatistik notundaki stokastik süreç ve geçiş matrisi kavramlarını dizisel öğrenmeye bağlar.
13.3. Gizli Markov Modeli
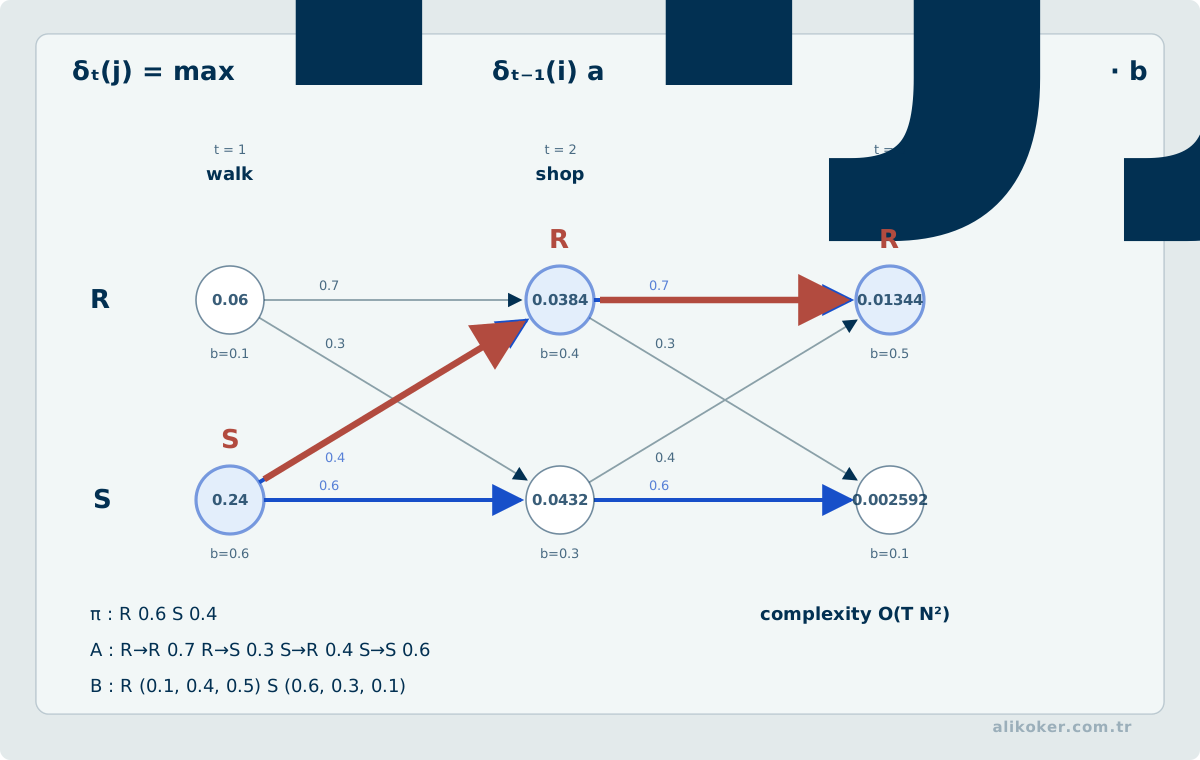
Hidden Markov Model (HMM), doğrudan gözlenmeyen durum dizisini ve bu durumların ürettiği gözlemleri birlikte modeller:
gizli durum S_t
   ↓ emission
 gözlem O_t
Model üç temel bileşen taşır:
- başlangıç durum olasılıkları,
- durumlar arası geçiş olasılıkları,
- her durumun gözlem/emission dağılımı.
Temel problemler şunlardır:
- değerlendirme: belirli bir gözlem dizisinin olasılığını hesaplamak,
- kod çözme: en olası gizli durum dizisini bulmak,
- öğrenme: model parametrelerini veriden kestirmek.
Forward–backward, Viterbi ve Baum–Welch/EM ailesi bu problemlerin klasik çözümleridir.
13.4. Konuşma ve Zaman Dizileri
Klasik konuşma tanımada HMM durumları zamansal akışı, akustik model gözlem olasılıklarını, n-gram ise sözcük dizisinin dilsel önselini taşır. Bu mimari Sesten Konuşma Tanıma bölümünde uygulama hattı içinde gösterilir.
Bayes ağları ve HMM'ler, “makine öğrenmesi yalnız karar sınırı çizmektir” anlayışının yetersizliğini gösterir: bazı görevlerde esas problem değişkenler arasındaki olasılıksal bağımlılık ve gizli durum yapısını modellemektir.
13.5. Markov Rastgele Alanları ve Belief Propagation
Bayes ağları bağımlılıkları yönlü çevrimsiz grafikle ifade ederken Markov Random Field (MRF) yönsüz bir graf üzerinden ortak dağılımın yerel etkileşimlere ayrıştırılmasını sağlar. Yönsüz kenar "A, B'ye neden olur" anlamına gelmez; iki değişkenin aynı olasılıksal faktörde doğrudan etkileşebildiğini gösterir.
Pozitif dağılımlar için Hammersley-Clifford teoremi, grafın Markov özellikleri ile clique potansiyelleri üzerinden Gibbs faktörleşmesi arasındaki bağı kurar. Bu gösterim şu biçimde yazılabilir:
P(x) = (1 / Z) * product_C psi_C(x_C)psi_C negatif olmayan bir potential fonksiyonudur; tek başına normalize edilmiş olasılık olmak zorunda değildir. Z partition function bütün konfigürasyonlar üzerindeki toplamı 1'e getirir. Bu ayrım önemlidir: yerel skorların olasılık gibi okunması hatalı olabilir.
Pairwise MRF özel durumunda faktörler düğüm ve kenarlara indirgenebilir. Graf ayırma yapısı, hangi değişkenlerin diğerleri verildiğinde koşullu bağımsız olduğunu okumaya yardım eder. HMM'deki yönlü zaman akışından farklı olarak MRF, komşuluk ilişkisini simetrik etkileşim olarak temsil etmek istediğimiz problemlerde daha doğal olabilir.
Belief propagation, graf üzerinde yerel mesajlarla marjinal dağılımları hesaplama yaklaşımıdır. Ağaç yapısında sum-product mesajı kavramsal olarak şöyledir:
m(i -> j, x_j) =
    sum over x_i [
        local_potential(i)
        * edge_potential(i,j)
        * product of messages from neighbors of i except j
    ]
Ağaçlarda uygun mesaj sırasıyla exact inference elde edilir. Döngülü graflarda aynı güncellemenin iteratif uygulanması loopy belief propagation olarak kullanılır; ancak yakınsama ve doğruluk artık genel olarak garanti değildir. Bu ayrım, "aynı formülü daha çok kez çalıştırmak" ile exact inference arasındaki sınırı görünür kılar.
Ünite 14: Model Değerlendirme
14.1. Eğitim, Doğrulama ve Test
Verinin temel rolleri ayrılmalıdır:
- eğitim: model parametrelerini öğrenir,
- doğrulama: hiperparametre ve model seçimini destekler,
- test: seçim tamamlandıktan sonra nihai genelleme tahmini verir.
Test setini tekrar tekrar model seçmek için kullanmak onu fiilen doğrulama setine dönüştürür.
14.2. Hata Matrisi
İkili sınıflandırmada:
                 Gerçek +   Gerçek -
Tahmin +            TP          FP
Tahmin -            FN          TN
Bu dört sayı birçok ölçütün temelidir.
14.3. Accuracy
Accuracy = (TP + TN) / (TP + TN + FP + FN)Sınıflar dengesizse yanıltıcı olabilir. %99 normal veri içeren bir problemde her örneğe normal diyen model %99 accuracy elde eder fakat hiçbir anomalinin yakalanmasını sağlamaz.
14.4. Precision, Recall, Specificity ve F1
Precision = TP / (TP + FP)
Recall    = TP / (TP + FN)
Specificity = TN / (TN + FP)
F1 = 2 * Precision * Recall / (Precision + Recall)
Yanlış pozitif maliyeti yüksekse precision, yanlış negatif maliyeti yüksekse recall daha kritik olabilir. Tek ölçüt seçmek iş maliyetlerini görünmez hale getirmemelidir.
Pozitif sınıfın yaygınlığı değiştiğinde, duyarlılık ile özgüllük aynı kalsa bile pozitif kestirim değeri değişebilir. Duyarlılığı %90, özgüllüğü %90 olan bir tarama sisteminde olay prevalansı %1 ise 10.000 bağımsız örneğin yaklaşık 100'ü pozitif, 9.900'ü negatiftir. Beklenen doğru pozitif 90, yanlış pozitif 990 olur; kesinlik 90/(90+990) ≈ %8,3 düzeyindedir. Bu örnek, yüksek sınıflandırma oranının karar bağlamında yeterli olmadığını gösterir. Karışıklık matrisi örnekleme oranına göre raporlanmalı; eşik seçimi, yanlış alarm maliyeti ve gerçek dağılımdaki prevalansla birlikte değerlendirilmelidir.
14.5. ROC ve PR Eğrileri
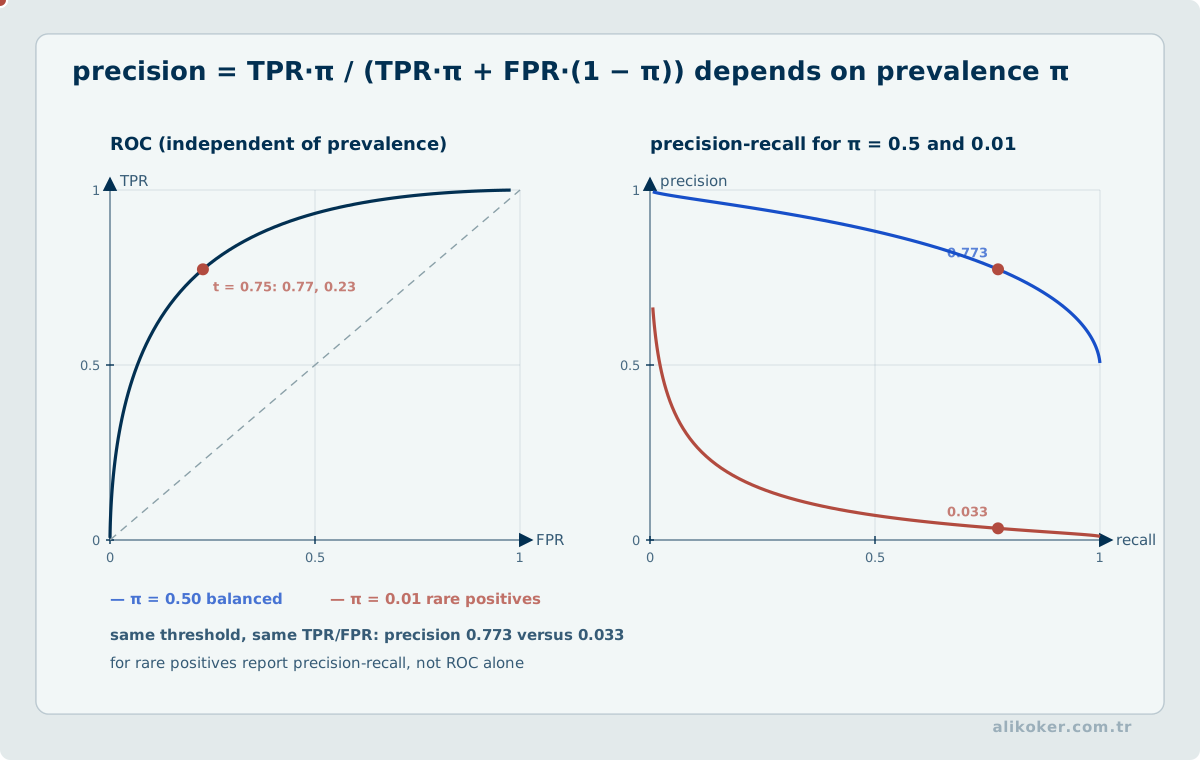
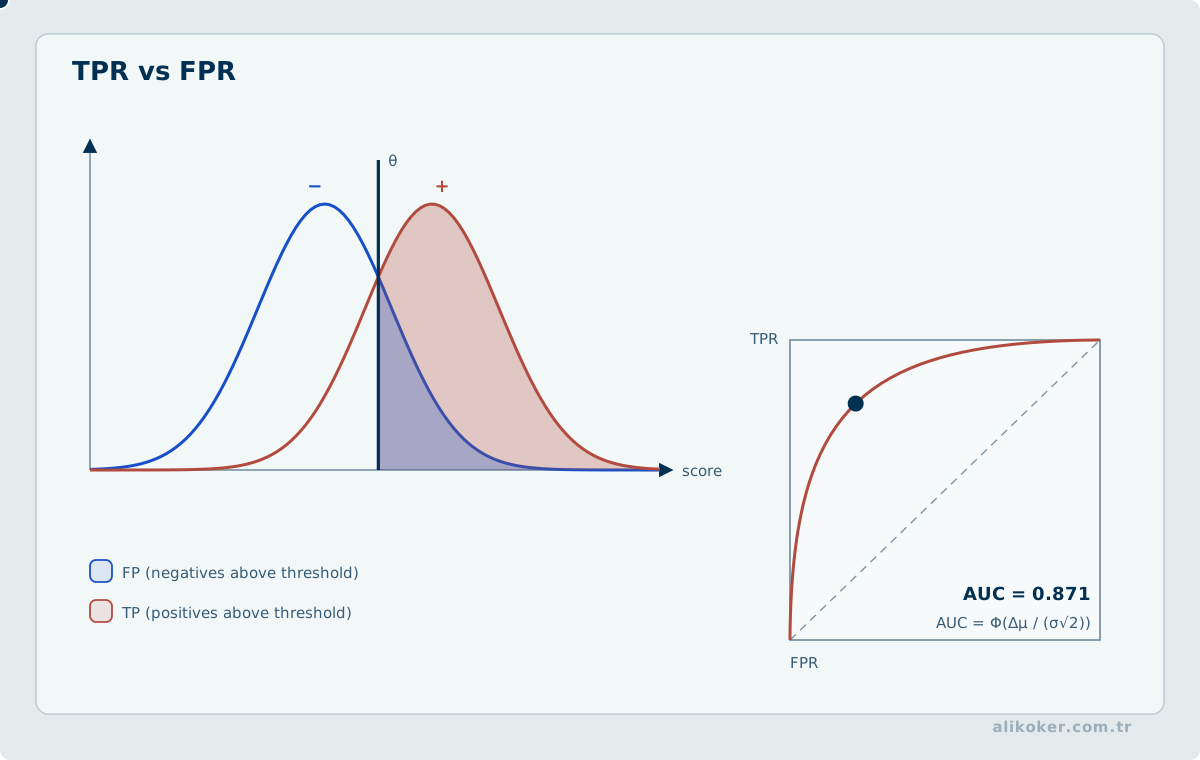
Karar eşiği değiştikçe TPR/FPR ilişkisi ROC eğrisini oluşturur. Pozitif sınıf çok seyrek olduğunda precision–recall eğrisi model farklarını daha görünür kılabilir. AUC tek başına belirli bir operasyon eşiğinin maliyetini göstermez.
14.6. Kalibrasyon
Bir model “0.8 olasılık” verdiği örneklerin yaklaşık %80'i gerçekten pozitif oluyorsa bu aralıkta iyi kalibre edilmiş sayılabilir. Ayrım gücü ve kalibrasyon farklı özelliklerdir; yüksek AUC iyi kalibrasyonu garanti etmez.
14.7. Regresyon Ölçütleri
MAE  = mean(|y-ŷ|)
MSE  = mean((y-ŷ)^2)
RMSE = sqrt(MSE)
R²   = 1 - SSE/SST
MSE/RMSE büyük hataları daha ağır cezalandırır. MAE aykırı büyük hatalara daha az duyarlıdır. R² yüksek olsa bile hata büyüklüğü uygulama için kabul edilemez olabilir.
14.8. Kümeleme Ölçütleri
Etiket yoksa değerlendirme daha zordur. Inertia küme içi yayılımı, silhouette hem kendi kümesine yakınlığı hem alternatif kümelere uzaklığı özetler. Gerçek sınıf etiketleri varsa adjusted Rand index gibi dışsal ölçüler kullanılabilir; fakat “küme” ile “sınıf” aynı kavram değildir.
14.9. Duyarlılık, Özgüllük ve Karar Eşiği Aynı Şey Değildir
Sensitivity/recall ve specificity hata matrisinden hesaplanır; ancak bu değerler modelin skorunu hangi karar eşiğinde sınıfa çevirdiğimize bağlıdır. Pozitif sınıfın yüksek skor aldığı bir modelde eşik yükseldikçe tipik davranış:
eşik yükselir -> daha az pozitif karar -> sensitivity düşme eğiliminde
                                      -> specificity yükselme eğiliminde
Bu bir model sıralama metriği değil, operasyon politikasıdır. Aynı skor modeli farklı kullanım alanlarında farklı eşiklerle çalıştırılabilir.
Sınıf prevalansı ayrıca precision/positive predictive value üzerinde doğrudan etkilidir. Pozitif sınıf oranını pi ile gösterirsek:
PPV = sensitivity * pi /
      (sensitivity * pi + (1 - specificity) * (1 - pi))
Sensitivity ve specificity değişmeden kalsa bile pi çok düştüğünde precision ciddi biçimde azalabilir. Bu nedenle laboratuvar veya dengeli test kümesindeki precision değerini, gerçek üretim prevalansı farklıyken doğrudan taşımak güvenli değildir.
Eşik seçimi için tek doğru sayı yoktur. Yanlış pozitif/yanlış negatif maliyeti, insan inceleme kapasitesi, alarm bütçesi, güvenlik veya sağlık riski ve downstream otomasyon etkisi birlikte düşünülmelidir. ROC-AUC modelin bütün eşiklerdeki sıralama davranışını özetleyebilir; fakat hangi eşikte üretime çıkılması gerektiğini tek başına söylemez.
14.10. Seçici Sınıflandırma ve Risk–Kapsama Eğrisi
Bir sınıflandırıcının her girdiye cevap vermesi zorunlu değildir. Hata maliyeti yüksek uygulamalarda model, güvenilir biçimde ayıramadığı örnekleri netleştirme veya insan değerlendirmesine bırakabilir. Bu yaklaşımda kapsama, otomatik karara bağlanan örnek oranı; seçici risk ise yalnız bu örnekler üzerindeki hata oranıdır. Bir eşik yükseltildiğinde kapsama azalırken seçici riskin de azalıp azalmadığı gözlenir. Tek bir genel doğruluk değeri, reddedilen örneklerin sayısını ve bunların hangi sınıflardan geldiğini gizler.
Özellikle sözcüksel benzerliğe dayanan çok sınıflı sistemlerde en yüksek skorun büyüklüğü güven olasılığıyla karıştırılmamalıdır. Adaylar arasındaki fark, metnin alan içi olup olmadığı ve gerekli parametrelerin açıkça bulunup bulunmadığı birlikte değerlendirilebilir. Bununla birlikte aynı sözcük n-gramlarından türeyen birden fazla benzerlik puanını bağımsız kanıt gibi toplamak, yanlış kesinlik üretebilir. Eşikler, bağımsız değerlendirme örneklerinde sınıf ve risk dilimi bazında kalibre edilmelidir.
Örneğin “kaydı aç” ve “kaydı açma” ifadelerinin ayırt edilmesi gereken bir veri kümesinde yalnız toplam F1 değeri yeterli değildir. Olumsuz komutun yanlışlıkla olumlu işlem olarak etiketlenme oranı ayrı bir hata metriği olmalıdır. Değerlendirme kümesinin aynı şablonlardan türetilmiş yakın tekrarlarla doldurulması da yanıltıcıdır; eğitim ve test, ifade aileleri ve görev türleri bakımından ayrılmalıdır.
14.11. Kestirimci Bakım Verisinde Cihaz ve Zaman Bağımlılığı
Titreşim verisinden ardışık 1 s pencereler çıkarılarak arıza sınıflandırması yapılabilir. Ancak aynı rulmanın komşu pencerelerini rastgele eğitim ve test kümelerine dağıtmak, modele donanımın kendine özgü çalışma izlerini ezberleme fırsatı verir. Altı makineden veri toplandığını varsayalım: dört makine eğitimde, biri model seçiminde, sonuncusu hiç görülmemiş testte tutulabilir. Bu ayrım tek başına genellenebilirliği garanti etmez; özellikle makine sayısı azsa test belirsizliği de raporlanmalıdır.
Testte gerçek arızaya ait 10 pencere bulunduğunu, sistemin 20 alarm ürettiğini ve bunların 8'inin doğru olduğunu varsayalım. Pencere düzeyinde kesinlik 8/20 = %40, duyarlılık 8/10 = %80 olur. Fakat bakım kararında aynı arızanın yüz kez üst üste alarm üretmesi yüz bağımsız olay değildir. Olay düzeyindeki erken uyarı süresi, makine başına yanlış alarm oranı ve planlı/plansız duruş maliyeti ayrıca değerlendirilmelidir. Kalan yararlı ömür kestirimi, arızalı/sağlam sınıflandırmasından farklı hedef değişkeni ve sansürlenmiş çalışma ömrü verisi gerektirir.
14.12. Dengesiz Sınıflandırmada Eşik, Kalibrasyon ve Güven Aralığı
Bir tehdit tespit modelinde 1.000 olayın 20 tanesi gerçek pozitif olsun. Model 18 olayı yakalayıp 82 yanlış alarm üretirse duyarlılık 18/20=0.90, kesinlik 18/100=0.18 olur. Duyarlılığın yüksek olması operasyonel iş yükünü ortadan kaldırmaz. PR eğrisi, sınıf öncül olasılığına ROC-AUC'den daha duyarlıdır; olasılık kalibrasyonu ve karar maliyetine göre eşik seçimi ayrıca ölçülmelidir.
Model karşılaştırmasında aynı örnek üzerinde oluşan farkların örneklem belirsizliği dikkate alınır. Test kümesinin etiketleri, hiperparametre veya eşik seçimi için tekrar kullanılırsa raporlanan nihai başarı iyimserleşir. Çoklu tohum, zamansal veri kesiti ve güven aralığı gibi unsurlar tek bir skorun yanlış yorumlanmasını azaltır.
14.13. Eşleştirilmiş Model Karşılaştırması ve Belirsizlik
İki sınıflandırıcı aynı test örneklerinde sınandığında sonuçlar bağımsız örneklemler değildir. Model A ile B'nin hatalarının hangi örneklerde ortaklaştığı önemlidir. Eşleştirilmiş karşılaştırmada her örnek için başarı farkı \(d_i=s_A(i)-s_B(i)\) tanımlanabilir. Ortalama fark \(\bar d=n^{-1}\sum_i d_i\) model çiftinin aynı veri üzerindeki ayrışmasını ölçer; fakat örneklerin bağımlılık yapısına göre belirsizlik ayrıca hesaplanmalıdır.
Eşleştirilmiş bootstrap yaklaşımında aynı test indisleri tekrar seçilerek her yeniden örneklemede iki model birlikte değerlendirilir. Böylece model farkına ilişkin ampirik dağılım elde edilir. Zaman serisi veya aynı kişiye/cihaza ait yinelenen gözlemler varsa tek tek satırları bağımsız örneklemek belirsizliği olduğundan küçük gösterebilir; grup veya zamansal blok düzeyinde yeniden örnekleme gerekir. Test verisiyle model seçimi yapıldıktan sonra aynı kümeden güven aralığı raporlamak da seçilim etkisini ortadan kaldırmaz.
Bir metrikteki küçük artışın mühendislik anlamı, yalnız istatistiksel belirsizliğe bağlı değildir. Gecikme, bellek, veri dilimlerinde hata, yanlış pozitifin maliyeti ve kabul edilebilir risk birlikte ele alınır. Çok sayıda model, eşik ve özellik alt kümesi denendiyse yalnız en iyi sonucun raporlanması iyimser seçilim üretir. Deney protokolü, karşılaştırma başlamadan önce sabitlenmelidir.
İki modelin aynı test örnekleri üzerinde karşılaştırılmasında bağımsız iki standart hata hesaplamak yerine örnek başına kayıp farkı temel alınabilir. Yeniden örnekleme, model seçimi ve ön işleme adımlarının hangi aşamada yeniden eğitildiğine bağlı olarak yalnız test kümesi belirsizliğini veya tüm eğitim sürecinin değişkenliğini ölçer. Gruplu ve zamansal gözlemlerde veri bağımlılığı korunmadan yapılan bootstrap, güven aralığını olduğundan dar gösterebilir.
Küçük performans farklarında güven aralığının genişliği, etki büyüklüğü ve operasyonel maliyet birlikte değerlendirilmelidir. Birden çok model ve ölçüt tekrar tekrar denenmişse raporlanan en iyi sonucun seçime bağlı iyimserliği ayrıca açıklanmalıdır.
Ünite 15: Model Seçimi, Düzenlileştirme ve Veri Sızıntısı
15.1. Çapraz Doğrulama
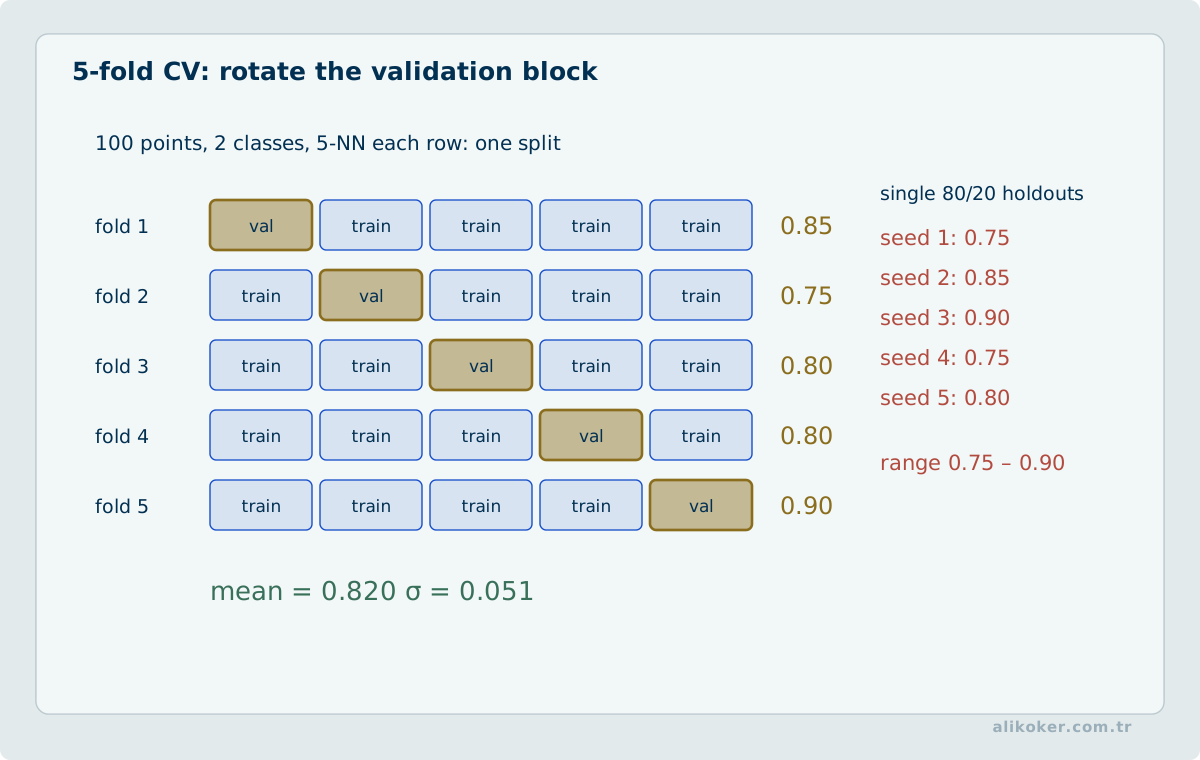
k-fold çapraz doğrulamada veri k parçaya ayrılır; her turda bir parça doğrulama, diğerleri eğitim için kullanılır. Sonuçlar ortalanır. Küçük veri kümelerinde değerlendirme varyansını azaltabilir.
Sınıflandırmada sınıf oranlarını koruyan stratified bölme; zaman serisinde geleceğin geçmişe sızmasını önleyen zamansal bölme gerekir. Rastgele k-fold her problem için doğru değildir.
Zaman serisinde çapraz doğrulama, gelecekteki gözlemin geçmişe sızmaması koşuluyla tasarlanmalıdır. Rastgele bölme, aynı makinenin art arda gelen ve birbirine çok benzeyen ölçümlerini hem eğitim hem test kümesine taşıyarak gerçek tahmin başarımını olduğundan yüksek gösterebilir. İleri kayan değerlendirmede model yalnız geçmiş tarihlerden öğrenir ve daha ileri bir zaman aralığında ölçülür. Özellik çıkarımındaki normalizasyon parametreleri, eksik değer doldurma istatistikleri ve hedefe dayalı dönüşümler de her eğitim penceresinde yeniden öğrenilmelidir. Aksi hâlde zaman bölmesi yapılmış olsa bile sızıntı sürer.
15.2. Hiperparametre Seçimi
k komşu sayısı, SVM C/γ, ağaç derinliği, K-Means K, regularization katsayısı gibi değerler eğitim sırasında doğrudan öğrenilmeyen hiperparametrelerdir. Grid search, random search veya daha uyarlanabilir arama yöntemleri kullanılabilir.
Hiperparametre araması test verisine bakmamalıdır. Yoğun arama yapılacaksa iç içe çapraz doğrulama (nested cross-validation) tarafsız performans kestirimi için yararlı olabilir.
15.3. Arama Bütçesi ve Ardışık Hiperparametre Seçimi
Izgara araması her eksendeki ayrık değerlerin Kartezyen çarpımını dener; d boyutta her eksende m aday varsa m^d kombinasyon oluşur. Rastgele arama, az sayıda etkili hiperparametre bulunan geniş uzaylarda bütçeyi farklı boyutlara daha iyi dağıtabilir. Ardışık model tabanlı aramada ise tamamlanan denemelerden bir yanıt modeli elde edilir; sonraki yapılandırma beklenen iyileşme veya belirsizlik gibi bir edinim ölçütüyle seçilir.
Deneme başına eğitim maliyeti farklıysa hedef yalnız en yüksek doğrulama skoru değildir; bulunan iyileşme ile harcanan hesaplama süresi birlikte ölçülür. Erken durdurma, farklı bütçelerde eğitilen adayların skorlarını karşılaştırırken yanlılık oluşturabilir. Arama algoritması, parametre aralıkları, deney bütçesi ve başarısız koşular kaydedilir; nihai test kümesi edinim sürecine dahil edilmez.
15.4. Veri Sızıntısı
Sızıntı yalnız hedef sütununun yanlışlıkla girişe eklenmesi değildir. Şunlar da sızıntı oluşturabilir:
- tüm veriyle ölçekleyici fit etmek,
- test verisine bakarak özellik seçmek,
- aynı kişinin kayıtlarını eğitim ve testte bulundurmak,
- geleceğe ait bilgiyi geçmiş tahminine taşımak,
- veri çoğaltmadan türetilen neredeyse aynı örnekleri iki bölmeye dağıtmak.
Doğru değerlendirme, üretimde tahmin anında gerçekten erişilecek bilgi sınırını taklit etmelidir.
Zamana bağlı veya kişi bazlı verilerde rastgele satır bölme, teknik olarak birbirinden farklı görünen örnekler arasında güçlü bağımlılık bırakabilir. Aynı konuşmacıya ait iki kesit, aynı cihazın art arda ürettiği ölçümler veya aynı belgeden türetilen metin parçaları eğitim ve test kümelerine dağılırsa ölçülen başarı bağımsız örneklere genellenmeyebilir. Bölme birimi satır değil, tahmin anında bilinmeyecek bilgiyi taşıyan en geniş bağımlılık grubu olmalıdır. Dönüşüm, özellik seçimi ve normalizasyon parametreleri de yalnız eğitim bölümünde öğrenilir; test verisinin dağılımı bu aşamalarda kullanılmaz.
Rastgele kayıt düzeyinde eğitim–test ayrımı, aynı kişi, cihaz veya üretim partisinden gelen bağımlı gözlemleri iki kümeye dağıttığında gerçekte olmayan genelleme başarısı gösterebilir. Bir cihazdan ardışık saniyelerde üretilen 1.000 ölçümü rastgele bölmek yerine cihaz kimliğiyle gruplanmış bölme veya geleceği öngörme görevi için kronolojik ayırma gerekir. Eşik, öznitelik ve hiperparametre seçimi de test kümesi üzerinde yinelenirse test kümesi fiilen eğitim döngüsüne katılır. Değerlendirme birimi, üretimde modelin karşılaşacağı yeni kişi, cihaz, dönem veya kurum birimiyle aynı olmalıdır.
15.5. Sınıf Dengesizliği
Azınlık sınıfı nadir olduğunda:
- sınıf ağırlığı,
- kontrollü yeniden örnekleme,
- uygun eşik,
- PR tabanlı ölçütler,
- maliyet duyarlı öğrenme
değerlendirilebilir. SMOTE gibi sentetik örnekleme yöntemleri yalnız eğitim bölmesinde uygulanmalıdır.
15.6. Model Karmaşıklığı ve Öğrenme Eğrileri
Eğitim ve doğrulama hatalarının veri miktarıyla değişimi yetersiz uyum, yüksek varyans veya daha fazla verinin potansiyel etkisi hakkında bilgi verir. “Daha fazla veri her zaman sorunu çözer” doğru değildir; yanlış hedef, etiket hatası veya dağılım uyumsuzluğu veri hacmiyle düzelmeyebilir.
15.7. Yüksek Boyutta Değişken Seçiminin Kararlılığı
Özellik sayısı p gözlem sayısına yaklaştığında veya onu aştığında, küçük örneklem değişiklikleri aynı kestirim başarımına sahip farklı değişken kümeleri üretebilir. Lasso'nun ℓ₁ cezası seyrek bir çözüm teşvik eder; korelasyonlu değişkenlerden hangisinin seçileceği veri bölmesine duyarlı olabilir. Ridge katsayıları küçültür fakat genel olarak tam sıfır üretmez. Bu nedenle değişken seçiminin başarısı yalnız tahmin hatasıyla değil, yeniden örneklemede seçimlerin ne kadar tekrarlanabildiğiyle de sınanmalıdır.
Bir etkileşim değişkeni x_j x_k modele alındığında ana etkiler x_j ve x_k için seçilecek hiyerarşi kuralı açıkça tanımlanmalıdır. Etkileşimlerin sayısı p(p−1)/2 mertebesinde büyüdüğünden bütün çiftleri körlemesine üretmek bellek ve çoklu karşılaştırma yükünü artırır. Ön eleme gerekiyorsa elemenin, ölçeklemenin ve ceza katsayısı seçiminin tamamı çapraz doğrulamanın her eğitim katında yeniden yapılmalıdır; dışarıda tutulan katın bilgisi özellik seçimine karışmamalıdır.
15.8. Zamansal Ayrım, Sızıntı ve Model Seçim Yanlılığı
Bağımsız ve özdeş dağılımlı gözlem varsayımı zamansal veride çoğu zaman zayıftır. Rastgele eğitim-test bölmesi, aynı olayın ardışık ölçümlerini veya aynı varlığa ait tekrarları iki kümeye dağıtarak gerçek kullanımda erişilemeyecek bilgi sızıntısı oluşturabilir. Zaman bağımlı bir tahmin görevinde eğitim penceresi gelecekteki örnekleri içermemeli; özellik çıkarımının kullandığı tüm bilgiler tahmin anında gerçekten erişilebilir olmalıdır. Örneğin sonradan hesaplanan ``toplam günlük olay'' değeri, gün başında yapılan tahmin için yasal bir özellik değildir.
Model ayarı ve nihai değerlendirme veri kümeleri farklı sorumluluklar taşır. Hiperparametre araması sırasında kullanılan doğrulama kümesinin başarımı tekrar tekrar gözlenirse aynı kümeye dolaylı uyum meydana gelir. Nihai test kümesi, model mimarisi ve eşik seçimi dondurulduktan sonra kullanılmalıdır. Zamanla değişen verilerde ileriye doğru kayan eğitim pencereleriyle yapılan rolling-origin değerlendirme, tek bir rastgele bölmeden daha gerçekçi olabilir; ancak az veri bulunan dönemlerde belirsizlik artar.
İkili sınıflandırmada doğruluk oranı tek başına yeterli değildir. Az görülen olumlu sınıfta precision, recall ve yanlış alarm oranı karar eşiği boyunca birlikte incelenmelidir. Eşik, test kümesine bakarak seçilirse rapor edilen performans iyimserleşir. Model puanı, kalibre edildiği bağımsız olarak gösterilmedikçe olayın gerçekleşme olasılığı diye sunulmamalıdır. Karşılaştırma, veri dilimi ve zamansal kayma etkileriyle birlikte raporlanmalıdır.
AIC, en yüksek log-olabilirliği model karmaşıklığı için cezalandırarak belirli varsayımlar altında beklenen kestirimsel uyum kaybını yaklaşıklar: AIC = 2k − 2log L̂. BIC = k ln(n) − 2log L̂ biçimi ise farklı asimptotik varsayımlara ve model seçimi amacına dayanır. Burada k serbest parametre sayısı, n örneklem büyüklüğüdür. Bu ölçütlerin sayısal karşılaştırması aynı veri ve uygun tanımlanmış olabilirlik üzerinden yapılır; çapraz doğrulama tahmin hatasıyla özdeş değildir.
Aynı veriyle değişken seçip ardından seçilmemiş bir model üzerinde çalışılıyormuş gibi güven aralığı raporlamak, seçim sonrası çıkarım yanlılığı doğurabilir. Model ortalaması, seçilen tek modelin koşullu belirsizliği yerine alternatif modellerin ağırlıklandırılmış katkısını hesaba katabilir; ancak aday model kümesine ve ağırlıkların nasıl belirlendiğine duyarlıdır. Hiperparametre veya özellik seçimi yeniden örnekleme içinde tekrarlanmıyorsa değerlendirme iyimser kalabilir.
Ünite 16: Üretimde İstatistiksel Öğrenme
16.1. Eğitim ile Tahmin Hattı Aynı Olmalıdır
Üretim sistemi yalnız model dosyasından oluşmaz. Özellik çıkarımı, ölçekleme, kategori sözlüğü, eksik değer politikası ve karar eşiği modelle birlikte sürümlenmelidir.
ham veri
→ doğrulama
→ ön işleme
→ özellikler
→ model
→ skor
→ eşik / karar
→ izleme
Eğitimde kullanılan bir dönüşüm üretimde farklı uygulanırsa model matematiksel olarak aynı olsa bile sistem davranışı değişir.
16.2. Dağılım Değişimi
Data drift girdi dağılımının değişmesidir. Concept drift girdi ile hedef arasındaki ilişkinin değişmesidir. Bir modelin üretim başarısının zamanla düşmesi yalnız kod hatası değil, veri üretim sürecinin değişmesi olabilir.
İzleme yalnız ortalama skora değil:
- özellik dağılımlarına,
- sınıf oranlarına,
- calibration'a,
- hata türlerine,
- gecikmeye,
- eksik veri oranına
bakmalıdır.
16.3. Tekrarlanabilirlik
Deney kayıtlarında en azından:
- veri sürümü,
- bölme yöntemi,
- rastgele tohum,
- ön işleme parametreleri,
- model/kitaplık sürümü,
- hiperparametreler,
- değerlendirme ölçütleri
saklanmalıdır. Aynı kod farklı veri veya bölme ile farklı sonuç verebilir.
16.4. Deney Kökeni ve Yeniden Üretilebilir Model Paketi
Üretime alınan tahmin davranışı model ağırlıkları + özellik tanımları + dönüşüm parametreleri + karar eşiği birleşimidir. Deney kaydı, eğitim veri kümesinin içerik kimliği, satır/grup bölme manifesti, özellik sözlüğü, etiket tanımı, rastgelelik ayarları ve değerlendirme protokolünü birbirine bağlamalıdır. Dosya adı veya yalnız kod sürümü, değişen ham veriyle aynı sonucu garanti etmez.
Ön işlemede kullanılan ortalama, varyans, kategori eşlemesi ve eksik değer politikası eğitimden bağımsız yeniden hesaplanmamalıdır. Tekrar eğitim gerekli olduğunda yeni model ayrı sürüm olarak doğrulanır; eski üretim kararları o tarihte kullanılan sürüm ve girdi anlık görüntüsü üzerinden yeniden açıklanabilmelidir. Sayısal çekirdeklerin ve paralel yürütmenin tam bit düzeyi determinizm sağlamadığı koşullar ayrıca belirtilir.
16.5. Açıklanabilirlik
Lineer model katsayıları, karar ağacı yolları ve komşu örnekler belirli düzeyde doğrudan yorumlanabilir. Ancak “yorumlanabilir” ile “nedensel” aynı değildir. Ağaçtaki bir eşik veya lojistik regresyondaki katsayı gözlemsel verideki ilişkiyi açıklar; müdahale etkisini tek başına kanıtlamaz.
16.6. Çevrim İçi Öğrenme, Artımlı Güncelleme ve Zamansal Doğrulama
Veri bir kez toplu gelmek zorunda değildir. Artımlı öğrenme model durumunu yeni mini-batch veya örneklerle günceller; çevrim içi öğrenme ise karar ve güncellemenin veri akışıyla birlikte ilerlediği daha sıkı bir çalışma modelidir.
Zamansal veride rastgele çapraz doğrulama geleceğin geçmişe sızmasına neden olabilir. Rolling-origin veya forward-chaining değerlendirme, eğitim penceresinin test zamanından önce kalmasını sağlar. Drift bulunan sistemlerde metrik yalnız global ortalama değil, zaman dilimleri boyunca da izlenmelidir.
Model güncellemesinin güvenilirliği için veri sürümü, eğitim aralığı, özellik sözleşmesi, model sürümü ve değerlendirme penceresi birlikte izlenebilir olmalıdır.
16.7. Parametre Belirsizliği ile Tahmin Belirsizliğini Ayırmak
Bir modelin tek bir nokta tahmini vermesi belirsizliğin olmadığı anlamına gelmez. Aleatorik belirsizlik gözlem sürecindeki indirgenemez değişkenliği, epistemik belirsizlik ise model veya parametre bilgisinin sınırlılığını ifade etmek için kullanılan yararlı bir ayrımdır.
Klasik regresyonda güven aralığı ortalama ilişkinin belirsizliğine, prediction interval ise yeni bir gözlemin ek gözlem gürültüsünü de içeren belirsizliğine yönelir. Bayesçi modelde posterior predictive dağılım parametre belirsizliğini doğrudan bütünleştirebilir.
Üretimde belirsizlik metriği karar eşiğinden ayrı tasarlanmalıdır. Yüksek güven skoru kalibrasyon yoksa gerçek doğruluk olasılığı olarak yorumlanamaz.
Ünite 17: Yapay Zeka Yöntemleri Arasındaki Yer
İstatistiksel öğrenme yapay zekanın tamamı değildir. Yöntem aileleri farklı problem varsayımları taşır:
Yapay zeka
├─ sembolik arama, mantık ve planlama
├─ istatistiksel öğrenme
│  ├─ regresyon / Bayesçi modeller
│  ├─ k-NN / SVM / karar ağaçları
│  ├─ kümeleme / boyut indirgeme
│  └─ n-gram / klasik örüntü tanıma
├─ yapay sinir ağları ve derin öğrenme
├─ bulanık mantık
├─ evrimsel hesaplama ve genetik algoritmalar
└─ pekiştirmeli öğrenme
Yapay Sinir Ağları ve Öğrenme Modelleri, temsillerin ve ağ parametrelerinin örneklerden öğrenilmesini, mimari ve öğrenme algoritmaları düzeyinde ele alır.
Bulanık Mantık, olasılıktan farklı olarak bir kavrama üyelik derecesini modeller. Fuzzy C-Means bu iki dünyanın kesiştiği örneklerden biridir: kümeleme istatistiksel/örüntüsel bir görevken üyelik 0–1 yerine derecelidir.
Genetik Algoritmalar ve Uygulamaları, model parametrelerini doğrudan olasılıksal kestirimle öğrenmek yerine popülasyon, seçim ve varyasyon üzerinden arama yapar. Bir SVM'in hiperparametreleri veya özellik alt kümesi genetik algoritmayla da aranabilir; yöntem ailelerinin birbirini dışlaması gerekmez.
Üst düzey tarihsel ve felsefi çerçeve Yapay Zeka: Felsefe, Kuram ve Uygulama bölümünde yer alır. Buradaki ayrım, hangi yöntemin “daha zeki” olduğu değil, hangi varsayım, veri yapısı, hata maliyeti ve hesaplama bütçesi altında hangi öğrenme mekanizmasının uygun olduğudur.
17.1. Aynı Problem için Yöntem Ailesi Seçmek
Bir görev “AI problemi” diye adlandırıldığı için en karmaşık model ailesi seçilmemelidir. Veri hacmi, özellik yapısı, hata maliyeti, gecikme ve açıklanabilirlik ihtiyacı yöntem seçimini belirler. Küçük ve tablosal veri üzerinde iyi düzenlileştirilmiş lineer model veya gradyan artırmalı ağaç, daha büyük yapay sinir ağından daha güvenilir olabilir.
problem → veri → temel model → ölçüm → gerekirse daha karmaşık modelBu sıra, karmaşıklığı varsayılan değil kanıtla gerekçelendirilen bir tasarım kararı haline getirir.
17.2. Temsil Öğrenmesi ile Klasik Özellik Mühendisliği Arasındaki Fark
Klasik istatistiksel öğrenmede özellikler çoğu zaman alan bilgisiyle açıkça hazırlanır. Derin öğrenmede temsilin önemli bölümü model tarafından öğrenilebilir. Bu fark, “feature engineering bitti” anlamına gelmez; veri toplama, normalizasyon, örnekleme ve etiket semantiği hâlâ insan tasarımıdır.
İstatistiksel öğrenmenin modern AI içindeki yeri bu nedenle tarihsel bir ara aşama değildir. Kalibrasyon, belirsizlik, küçük/orta ölçekli tablosal veri, açıklanabilir temel model ve kontrollü deney tasarımı gibi alanlarda temel yöntem ailesi olmaya devam eder.
17.3. Olasılık Kalibrasyonu ve Dağılım Dışı Veri
Bir sınıflandırıcının doğru sınıfı ilk sıraya koyması ile verdiği olasılığın güvenilir olması farklı özelliklerdir. Sigmoid/softmax çıktısını doğrudan "gerçek olasılık" kabul etmek yerine reliability diagram ve Brier skoru gibi araçlarla kalibrasyon kontrol edilmelidir.
Model, eğitim dağılımının çok dışındaki veriye de yüksek güven verebilir. OOD tespiti tek bir evrensel algoritmayla çözülmez; girdi kalite kontrolleri, embedding uzaklığı, ensemble belirsizliği veya domain'e özgü kurallar birlikte kullanılabilir.
Üretimde en önemli karar bazen sınıf seçmek değil işlem yapmamaktır. Belirsizlik eşiği üzerinde insan incelemesine yönlendirme veya ek veri isteme, yanlış otomasyonu azaltan geçerli bir sistem davranışıdır.
17.4. Model Karşılaştırmasını Adil Kurmak
SVM, KNN, ağaç veya kümeleme yöntemleri aynı ön işleme ve veri bölmesi altında karşılaştırılmalıdır. Özellikle standardizasyon veya özellik seçimi bütün veri üzerinde yapılırsa test bilgisi eğitime sızabilir.
Hiperparametre seçimi validation veya nested cross-validation içinde yapılmalıdır. Test kümesi yalnız son değerlendirme için tutulduğunda yöntem karşılaştırması daha tarafsız olur.
Modelin açıklaması yalnız ortalama skora dayanmaz. Sınıf dengesizliği, kalibrasyon, hata dilimleri, öğrenme eğrisi ve veri miktarına duyarlılık; hangi yöntemin hangi koşulda tercih edileceğini daha iyi gösterir.
Ünite 18: Gömme Benzerliği bir Olasılık Değildir
Modern yapay zekâ sistemlerinde cosine similarity gibi vektör benzerlikleri sık kullanılır. Bu skorların istatistiksel anlamı doğru yorumlanmalıdır.
İki vektör arasındaki cosine benzerliği:
yakın yön
 -> yüksek benzerlik
ölçer. Ancak 0.92 cosine skoru:
%92 doğru
%92 aynı anlam
%92 aynı kişi
anlamına gelmez.
Skor dağılımı gömme modeli, derlem ve görevle değişir.
Cosine benzerliği, sıfırdan farklı iki vektör için
cos(x, y) = (x · y) / (‖x‖₂ ‖y‖₂)
biçiminde tanımlanır. Bu değer, vektörlerin yönsel yakınlığını ölçer; tek başına eşleşme olayının koşullu olasılığı değildir. Gözlenen bir skorun anlamı, ilgili ve ilgisiz çiftlerin skor dağılımlarına bağlıdır. Örneğin aynı sistemde ilgili çiftlerin skorlarının çoğu 0.70–0.90, ilgisiz çiftlerin önemli bir bölümü 0.65–0.80 aralığındaysa 0.75 eşiği iki sınıfı güvenilir biçimde ayıramaz. Skor aralıklarının örtüşmesi eşik seçiminin yanlış pozitif ve yanlış negatif sonuçlarını belirler.
Bir skoru olasılığa dönüştürmek ayrı bir öğrenme ve kalibrasyon problemidir. Etiketli ve temsili bir doğrulama kümesi üzerinde kalibrasyon yöntemi öğrenilse bile elde edilen olasılık, yalnızca o veri dağılımı ve etiket tanımı altında yorumlanabilir. Özellikle aynı kişi, aynı konu ve ilgili belge etiketleri farklı hedef değişkenlerdir. Bir belge eşleştirme skorundan kişi özdeşliği çıkarılamaz.
Bir eşik kullanılacaksa:
development set
  |
  v
score distributions
  |
  v
threshold selection
  |
  v
precision / recall trade-off
üzerinden seçilmelidir.
Eşik seçimi geliştirme kümesinde yapılmalı, nihai değerlendirme eşiğin seçilmesinde kullanılmamış bir test kümesine bırakılmalıdır. Pozitif çiftlerin seyrek olduğu uygulamalarda ROC eğrisinin yanında precision–recall eğrisi incelenir: aynı yanlış pozitif oranı, aday sayısının büyüklüğüne bağlı olarak çok farklı sayıda hatalı eşleşme doğurabilir. Eşik ve kullanılan normalizasyon, model sürümüyle birlikte raporlanmadığında aynı sayısal skor farklı deneylerde karşılaştırılabilir değildir.
Bu ayrım Bilgi Erişimi Destekli Üretim ve Doğal Dil İşleme derslerindeki semantik retrieval için temel istatistiksel ilkedir.
Ünite 19: Baseline Olmadan Model İyileştirmesi Ölçülemez
Karmaşık bir modelin iyi skor alması, karmaşıklığın gerekli olduğunu göstermez.
Önce güçlü ve basit baseline kurulmalıdır.
majority baseline
linear model
BM25 / lexical
simple tree
   |
   v
complex candidate
Karşılaştırmanın hedefi yalnızca en yüksek doğruluk değildir. Örneğin iki arama yönteminin aynı sorgu kümesinde değerlendirilmesi gerekir; bir yöntem için kolay, diğeri için zor sorgular seçilirse fark modelden değil veri bölmesinden kaynaklanabilir. Eğitim, geliştirme ve test kümeleri zaman, kullanıcı, belge veya varlık düzeyinde birbirine bağımlı örnekler taşıyorsa veri sızıntısı da kıyaslamayı iyimserleştirir.
Yeni model yalnız nihai skorda değil:
- hata sınıflarında,
- gecikmede,
- bellek maliyetinde,
- bakım maliyetinde,
- dağılım değişiminde
karşılaştırılmalıdır.
Eşleştirilmiş karşılaştırmada her sorgu için Δᵢ = mᵢ(B) − mᵢ(A) farkı hesaplanabilir; burada m_i sorgu düzeyindeki uygun başarı ölçütüdür. Ortalama farkın belirsizliği, bağımlılık birimi korunarak yapılan eşleştirilmiş bootstrap ile tahmin edilebilir. İlgili bütün belgeler aynı sorguya bağlıysa bağımsız yeniden örnekleme birimi belge değil sorgudur. Sadece ortalama farkı raporlamak; hangi sorgularda ve hangi hata sınıflarında gerileme yaşandığını gizler.
Üretime alma kararı gecikme dağılımını da kapsamalıdır. Ortalama yanıt süresi aynı olan iki modelin p95/p99 gecikmeleri, geçici bellek tahsisleri veya en kötü durum davranışları farklı olabilir. Kalite kazanımı istatistiksel olarak ölçülebilir olsa bile, kabul edilebilir gecikme ve kaynak sınırlarının dışında kalıyorsa aday operasyonel açıdan üstün değildir.
Aynı test kümesinde iki model arasındaki küçük fark, örnekleme gürültüsü olabilir. Güven aralığı, bootstrap veya görev için uygun eşleştirilmiş testler farkın belirsizliğini göstermeye yardımcı olur.
Ünite 20: Sıralama Problemlerinde Değerlendirme
Sınıflandırma ölçüleri retrieval sıralamasını tek başına açıklamaz.
Bir arama sisteminde:
query
 |
ranked documents
üretilir.
Yararlı ölçüler:
- Recall@K: ilgili belgelerin ne kadarı ilk K sonuçta?
- Precision@K: ilk K sonucun ne kadarı ilgili?
- MRR: ilk doğru sonucun sırası nedir?
- nDCG: ilgili sonuçların sıralamadaki konum ve dereceli ilgisini nasıl değerlendiriyoruz?
Bu ölçüler tek başına kullanıcı deneyimi değildir; fakat retrieval modelinin generation katmanından bağımsız ölçülmesini sağlar.
K sonuçtan oluşan bir liste için precision ve recall farklı paydalar kullanır:
P@K = |R ∩ Tₖ| / K, Recall@K = |R ∩ Tₖ| / |R|.
Burada R sorgunun bütün ilgili belgelerini, T_K ilk K sonucu gösterir; R boşsa recall için açık bir değerlendirme politikası gerekir. Örneğin toplam dört ilgili belgeden ikisi ilk beş sıradaysa P@5=2/5, R@5=2/4 olur. İlk ilgili belgenin üçüncü sırada bulunduğu bir sorguda reciprocal rank 1/3 değerindedir; MRR bu değerlerin sorgular üzerinden ortalamasıdır.
Dereceli alaka etiketlerinde kullanılan nDCG@K, sıralı kazanımı aynı sorgunun ideal sıralamasına böler. Yaygın bir tanımda DCG@K=Σ_{i=1}^{K}(2^{rel_i}-1)/log_2(i+1) kullanılır. İdeal kazanç sıfırsa nDCG'nin nasıl ele alınacağı önceden kararlaştırılmalıdır. Sorguların eşit ağırlıkla ortalanması ile bütün sonuçların tek havuzda toplanması aynı soruyu ölçmez. Ayrıca yinelenen belgeler, eşit skorların sırası ve erişilemeyen ilgili sonuçlar için deterministik değerlendirme kuralları gereklidir.
Ünite 21: Kıyaslama, Veri Dilimi ve Dağılım
Genel kıyaslama ortalaması üretim dağılımını saklayabilir.
Örneğin Türkçe semantik aramada ayrı dilimler:
standart Türkçe
ASCII Türkçe
özel ad
teknik terim
uzun ek zinciri
TR sorgu -> EN belge
olarak ölçülebilir.
Bir model genel ortalamada daha iyi olup hedef dilimde gerileyebilir.
Veri dilimi yalnız bir dil veya yazım biçimi değildir; etiket sıklığı, sorgu uzunluğu, belge türü, zaman dönemi ve kaynak kimliği de dilim tanımlayabilir. Her dilimde n örnek sayısı, başarı ölçütü ve belirsizlik birlikte verilmelidir. On örneklik küçük bir dilimde görülen büyük yüzdelik artış, binlerce örnek içeren dilimdekinden daha oynak olabilir.
Üretim dağılımına benzer test yapmak için aynı kişinin, aynı belgenin tekrarlarının veya birbirine yakın zamanlı çok benzer kayıtların eğitim ve test arasında bölünmesi engellenmelidir. Zamanla yeni özel adlar ve terminoloji çıktığında yalnız genel skor değil, ilgili dilimlerin hata profili izlenmelidir. Düşük hacimli dilimlerde hata örneklerinin nitel incelemesi, tek başına yüzdelik karşılaştırmadan daha bilgilendiricidir.
MTEB gibi çok görevli kıyaslamalar da gömme modellerinde tek bir yöntemin bütün görevlerde baskın olmadığını göstermektedir. İstatistiksel öğrenme açısından sonuç açıktır: model seçimi “leaderboard kazananı” değil, hedef dağılımda ölçülen genelleme problemidir.
Ünite 22: Sağlam Zamansal Sinyal Tespiti ve Alarm Birleştirme
Zaman serisinde alışılmadık gözlemi bulmak, yalnız ortalama ve standart sapmadan uzaklığa bakmak değildir. Özellikle seyrek, patlamalı veya ağır kuyruklu veride klasik z-skoru birkaç uç değer tarafından kolayca sürüklenebilir.
Daha sağlam bir başlangıç merkezi olarak medyan, yayılım için medyan mutlak sapma kullanılabilir:
merkez = median(x)

MAD = median(|x_i - merkez|)

robustScale ≈ MAD / 0.6745
MAD sıfır olduğunda yöntem kör biçimde bölme yapmamalıdır. Yeterli varyasyon varsa örnek standart sapması gibi kontrollü fallback kullanılabilir; veri gerçekten sabitse sapma yorumunun anlamsız olduğu belirtilmelidir.
22.1. EWMA
Üstel ağırlıklı hareketli ortalama son gözlemlere daha fazla ağırlık verir:
S_t = λ X_t + (1-λ) S_(t-1)λ büyüdükçe yöntem yeni gözleme daha hızlı tepki verir.
EWMA tek başına anomali sınıflandırıcısı değil, süreç değişimini görünür kılan istatistiksel izleme aracıdır.
22.2. CUSUM
Birikimli toplam yaklaşımı, küçük fakat aynı yönde devam eden sapmaları biriktirir.
pozitif birikim =
    max(0, önceki + sapma - tolerans)

negatif birikim =
    min(0, önceki + sapma + tolerans)
Eşik aşıldığında kalıcı kayma adayı oluşur.
Parametreler veri ölçeğine ve hedeflenen değişim büyüklüğüne göre kalibre edilmelidir.
22.3. Birden Çok Yöntemi Tek Olaya Birleştirmek
Aynı zaman dilimi robust-Z, EWMA ve CUSUM tarafından aynı anda işaretlenebilir.
Bunları üç farklı olay gibi göstermek alarm çoğalması üretir.
Daha doğru yapı:
temporalCandidate(date)
├─ ROBUST_DEVIATION
├─ EWMA_SHIFT
└─ CUSUM_SHIFT
şeklinde aynı tarih veya yakın dönem sinyallerini tek aday altında birleştirir.
Yöntem sayısı güven olasılığı değildir; farklı istatistiksel bakışların aynı bölgeyi işaretlediğini gösterir.
22.4. Eksik Aralık Sıfır Gözlem Değildir
gerçek 0:
  sistem gözleyebildi ve olay sayısı sıfırdı

eksik aralık:
  dönem için güvenilir gözlem yok
Bu ikisini karıştırmak ortalamayı, varyansı, CUSUM'u ve dönem karşılaştırmalarını bozabilir.
Coverage-aware analiz hangi zaman kovalarının gerçekten değerlendirilebilir olduğunu önce belirlemelidir.
22.5. Dönem Bölme ve İlişki Değişimi
İki dönem arasındaki değişim yalnız toplam hacim farkı değildir.
A = ilk dönem ilişkileri
B = ikinci dönem ilişkileri
Jaccard benzerliği:
J = |A ∩ B| / |A ∪ B|ile çevrenin ne kadar korunduğunu gösterebilir.
Devam eden, yeni gözlenen ve artık gözlenmeyen ilişkiler ayrı sayılabilir.
Buradaki yeni, yalnız seçili gözlem penceresinde yenidir; tarihsel olarak ilk kez oluştuğu anlamına gelmez.
22.6. Anomali Adayının Semantik Sınırı
İstatistiksel sapma olağandışı demektir.
Tek başına şüpheli, hatalı, zararlı veya nedensel olarak önemli anlamına gelmez.
22.7. Deterministik Eşitlik Çözümü
İki aday aynı skora sahip olduğunda rastgele sıra regresyon testini zorlaştırır.
Kararlı sıra:
birincil skor
ikincil skor
kanıt sayısı
kararlı kimlik
gibi açık tie-break ile kurulabilir.
Sağlam zaman serisi analizi; baseline, veri kapsaması, yöntem çeşitliliği, alarm birleştirme ve semantik yorum sınırlarını birlikte yönetme problemidir.
22.8. Makine Öğrenmesinde Robust Değerlendirme
Robust istatistik, modelin ideal varsayımlarından küçük sapmalar olduğunda tahminin ne kadar bozulduğunu inceler. İstatistiksel öğrenmede medyan ve MAD, ağır kuyruklu hata dağılımları ve aykırı örnekler için temel dayanıklı özetlerdir; influence function yerel kirlenme duyarlılığını, breakdown point ise tahmin edicinin artan kirlenme altında ne zamana kadar kararlı kaldığını daha biçimsel tanımlar. Özellikle ağır kuyruklu veya kontamine veride yalnız ortalama ve standart sapmaya dayalı kararlar yanıltıcı olabilir.
- Cross-validation sonuçlarını yalnız ortalama değil dağılım ve güven aralığıyla raporlamak.
- Aykırı örneklerin model katsayıları/decision boundary üzerindeki etkisini incelemek.
- Accuracy yüksek olsa bile class imbalance ve calibration hatasının ayrı ölçülmesi.
Ünite 23: Metin Sınıflandırma ve Kümelemeyi İstatistiksel Öğrenme Problemi Olarak Kurmak
Metin verisi genel sınıflandırma ve kümeleme algoritmalarına uygulanabilir; ancak problem geometrisi tablo verisinden farklıdır. Belge temsilleri çoğu zaman yüksek boyutlu ve seyrektir. Aynı anlam farklı yüzey biçimleriyle, aynı sözcük de farklı anlamlarla görünebilir. Bu nedenle algoritma adından önce temsilin ve değerlendirme tasarımının doğru kurulması gerekir.
23.1. Metin Sınıflandırmada İki Yaklaşım Ailesi
Metin kategorileri iki temel yöntem ailesiyle tanımlanabilir:
- bilgi mühendisliği: alan uzmanının kuralları, sözlükleri ve kavram ilişkileri,
- istatistiksel öğrenme: etiketli örneklerden karar sınırı veya sınıf skoru öğrenme.
Bunlar zorunlu olarak birbirinin alternatifi değildir. Yüksek kesinlikli kurallar ile öğrenilmiş model aynı pipeline içinde farklı hata türlerini karşılayabilir.
SVM, k-NN, lojistik modeller veya sinir ağları mevcut genel sınıflandırma ilkelerinden sapmaz. Metne özgü fark; özellik uzayının büyüklüğü, seyrekliği, sınıf dengesizliği, etiket belirsizliği ve çok etiketli örneklerin sık görülmesidir.
23.2. Etiketsiz Verinin Rolü
Belge koleksiyonlarında etiketlenmemiş veri çoğu zaman etiketli veriden çok daha fazladır. Yarı denetimli veya özdenetimli yöntemlerin değeri buradan gelir. Ancak etiketsiz veri kendiliğinden doğru etiket sağlamaz; pseudo-label veya bootstrapping hataları iterasyonlar boyunca büyüyebilir.
Bu nedenle:
seed / gold labels
      ↓
candidate expansion
      ↓
confidence filter
      ↓
manual or held-out validation
      ↓
next iteration
gibi kontrollü bir döngü kullanılmalıdır.
23.3. Metin Kümelemede Cluster Hypothesis
Metin erişiminde klasik varsayımlardan biri, ilgili belgelerin birbirine ilgisiz belgelere göre daha benzer olma eğilimidir. Bu cluster hypothesis mutlak bir yasa değildir; kullanılan temsil ve benzerlik ölçüsüne bağlı bir çalışma varsayımıdır.
Kümeleme iki farklı hedefe hizmet edebilir:
- arama sonucunu konu kümelerine ayırarak kullanıcı gezinmesini kolaylaştırmak,
- önceden tanımlı etiket olmadan koleksiyonun baskın yapısını keşfetmek.
23.4. Scatter/Gather: Kümelemeyi Etkileşimli Aramaya Dönüştürmek
Scatter/Gather yaklaşımında kullanıcı bütün korpusu tek seferde tüketmek yerine:
koleksiyon
   ↓ scatter
aday kümeler
   ↓ seçim
alt koleksiyon
   ↓ gather / yeniden kümeleme
döngüsüyle ilerler.
Bu yaklaşım, kümelemeyi yalnız model çıktısı değil, insan yönlendirmeli keşif operatörü haline getirir.
23.5. Küme Türü ve Benzerlik
Metin kümeleme:
- düz veya hiyerarşik,
- hard veya soft
olabilir. Vektör uzayında kosinüs benzerliği metin için yaygın bir ölçüttür; ancak temsil değiştiğinde geometri de değişir. Embedding tabanlı uzay ile klasik seyrek TF-IDF uzayında aynı eşiklerin beklenmesi doğru değildir.
23.6. Küme Etiketi Ayrı bir Problemdir
Matematiksel olarak iyi ayrılmış bir küme kullanıcı açısından anlamsız bir etiket taşıyabilir. Cluster labeling için:
- medoid belgenin başlığı,
- centroid üzerinde baskın terimler,
- diğer kümelerden ayırıcı terim veya terim öbeği
kullanılabilir.
İyi etiket, kümenin içindeki bütün belgeleri tekrar etmek yerine onu diğer kümelerden ayıran küçük bir kavram seti vermelidir.
23.7. Kümeleme Değerlendirmesi
Etiketli referans sınıflar varsa purity gibi dışsal ölçüler kullanılabilir:
Purity(C_i) = max_j |C_i ∩ L_j| / |C_i|Entropy ve mutual information da küme–etiket uyumuna farklı açılardan bakabilir. Bununla birlikte, kümelemenin gerçek amacı arama sonucu gezinmesini veya sonraki analizi iyileştirmekse en önemli değerlendirme downstream görev yararıdır.
Dolayısıyla:
iyi objective ≠ iyi kullanıcı sonucuBir kümeleme yöntemi içsel metriği iyileştirirken arama precision/recall dengesini veya kullanıcı görev süresini kötüleştirebilir.
23.8. Çok Etiketli Niyet ve Aday Yeniden Sıralama Deney Düzeni
Bir metin birden fazla sınıflandırma hedefi taşıyabilir. “Son haftayı karşılaştır ve kaynakları göster” ifadesinde karşılaştırma, dönem seçimi ve kaynak gösterimi ayrı etiketler olarak çıkarılabilir. Çok etiketli öğrenme, her etiketi bağımsız ikili problem olarak ele alabilir; fakat etiketler arası bağıntılar kaybolur. Özellikle birlikte yürütülemeyen işlemler ve zorunlu parametreler, model çıktılarını işlem planına çeviren doğrulama katmanında denetlenmelidir.
Kısa metinde öğrenilmiş bir aday sıralayıcıyı değerlendirmek için önce aynı aday havuzunun bütün karşılaştırılan modellere sunulması gerekir. Başka bir yöntem daha fazla aday üretiyorsa sıralama iyileşmesi ile aday bulma başarısı karışır. Sözcüksel eşleşme, düzenleme uzaklığı, morfolojik uyum ve bağlam uygunluğu gibi özellikler sabit bir şemada hazırlanır. Doğrusal ve doğrusal olmayan modeller aynı gruplandırılmış holdout üzerinde karşılaştırılır; olumsuzluk, alan dışı cümle ve çok turlu düzeltmeler ayrı test dilimleridir.
Bileşik başarının tek çıktısı sınıf etiketi değildir. Tam etiket kümesi doğruluğu, planın eksiksizliği, yanlış netleştirme ve yetkisiz eylem oranı birlikte incelenir. Öğrenilmiş model daha fazla doğru etiket bulsa bile yanlış bir parametre ekliyorsa görev başarısı yükselmiş sayılmaz. Karar verici olmayan bir modelin başarıyla çalıştırılması da kendi başına üretim kazanımı değildir.
Kaynakça
- Arthur P. Dempster; Nan M. Laird; Donald B. Rubin. “Maximum Likelihood from Incomplete Data via the EM Algorithm.” Journal of the Royal Statistical Society: Series B, 1977.
- Chandola, Varun; Banerjee, Arindam; Kumar, Vipin. “Anomaly Detection: A Survey.” ACM Computing Surveys, 41(3), 2009. https://doi.org/10.1145/1541880.1541882
- Christopher D. Manning; Prabhakar Raghavan; Hinrich Schütze. Introduction to Information Retrieval. Cambridge University Press, 2008.
- Christopher M. Bishop. Pattern Recognition and Machine Learning. Springer, 2006.
- Corinna Cortes; Vladimir Vapnik. “Support-Vector Networks.” Machine Learning, 1995.
- Daniel Jurafsky; James H. Martin. Speech and Language Processing. Prentice Hall, 2009.
- Ethem Alpaydın. Introduction to Machine Learning. MIT Press, 2010.
- Gareth James; Daniela Witten; Trevor Hastie; Robert Tibshirani. An Introduction to Statistical Learning. Springer, 2013.
- Göran Kauermann; Helmut Küchenhoff; Christian Heumann. Statistical Foundations, Reasoning and Inference: For Science and Data Science. Springer, 2021. https://doi.org/10.1007/978-3-030-69827-0
- J. MacQueen. “Some Methods for Classification and Analysis of Multivariate Observations.” Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1967.
- Kevin P. Murphy. Machine Learning: A Probabilistic Perspective. MIT Press, 2012.
- Leo Breiman. “Random Forests.” Machine Learning, 2001.
- Leonard Kaufman; Peter J. Rousseeuw. Finding Groups in Data: An Introduction to Cluster Analysis. Wiley, 1990.
- Markus M. Breunig; Hans-Peter Kriegel; Raymond T. Ng; Jörg Sander. “LOF: Identifying Density-Based Local Outliers.” SIGMOD, 2000.
- Martin Ester; Hans-Peter Kriegel; Jörg Sander; Xiaowei Xu. “A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise.” KDD, 1996.
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- Muennighoff, N.; Tazi, N.; Magne, L.; Reimers, N. “MTEB: Massive Text Embedding Benchmark.” 2022. https://arxiv.org/abs/2210.07316
- NIST/SEMATECH. CUSUM Control Charts. e-Handbook of Statistical Methods. https://www.itl.nist.gov/div898/handbook/pmc/section3/pmc323.htm
- NIST/SEMATECH. EWMA Control Charts. e-Handbook of Statistical Methods. https://www.itl.nist.gov/div898/handbook/pmc/section3/pmc324.htm
- Peter J. Huber; Elvezio M. Ronchetti. Robust Statistics. 2nd ed. Wiley, 2009.
- Peter J. Rousseeuw. “Silhouettes: A Graphical Aid to the Interpretation and Validation of Cluster Analysis.” Journal of Computational and Applied Mathematics, 1987.
- Reimers, N.; Gurevych, I. “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks.” EMNLP-IJCNLP, 2019. https://arxiv.org/abs/1908.10084
- Ronen Feldman; James Sanger. The Text Mining Handbook: Advanced Approaches in Analyzing Unstructured Data. Cambridge University Press, 2007.
- Stuart Lloyd. “Least Squares Quantization in PCM.” IEEE Transactions on Information Theory, 1982.
- Thomas M. Cover; Peter E. Hart. “Nearest Neighbor Pattern Classification.” IEEE Transactions on Information Theory, 1967.
- Trevor Hastie, Robert Tibshirani, Jerome Friedman. The Elements of Statistical Learning, 2nd ed. Springer, 2009.
- Trevor Hastie; Robert Tibshirani; Jerome Friedman. The Elements of Statistical Learning. Springer, 2009.
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.
- Naveenkumar, P.; Sharma, V.; Devarajan, G.; Abdullah, A.; Elngar, A. A. (eds.). Handbook of AI-Based Mechatronics Systems and Smart Solutions in Industrial Automation. CRC Press, 2026. DOI: https://doi.org/10.1201/9781032615790.
- Chunwei Zhang, Tianpeng Li, Ying Dai, Li Sun ve Ardashir Mohammadzadeh. Practical Neural Networks in Python and MATLAB. Springer Nature, 2026. DOI: https://doi.org/10.1007/978-3-032-14746-2.
- Cybellium Ltd. Mastering Neural Networks. Cybellium, tarihsiz elektronik baskı (sağlanan nüsha).
- Charu C. Aggarwal. Outlier Analysis, 2nd ed.. Springer, 2017. https://doi.org/10.1007/978-3-319-47578-3