


Olasılık ve İstatistik: Dağılımlar, Örnekleme ve Regresyon


Betimsel istatistik, olasılık, dağılımlar, örnekleme, regresyon, stokastik süreçler ve Markov zincirlerini; bootstrap, permutation, Monte Carlo, güç analizi ve istatistiksel öğrenmeye geçişle birleştiren ders notları.
Ünite 1: İstatistiğe Giriş
İstatistiksel bir araştırmada önce hedef değişken, gözlem birimi ve örnekleme düzeni belirlenir. Ölçme düzeyi bilinmeden ortalama veya korelasyon gibi özetlerin seçilmesi yanıltıcı olabilir. Merkezi eğilim ve dağılım birlikte raporlanır; uç değerler görüldüğünde bunların veri hatası mı gerçek gözlem mi olduğu araştırılır. Sonuçlar yalnız örneklemi betimliyorsa evrene yönelik çıkarım yapılmaz; çıkarım isteniyorsa seçilim mekanizması ve belirsizlik ayrıca değerlendirilir.
1.1. Temel Kavramlar
İstatistik, veriyi toplama, düzenleme, çözümleme ve yorumlama yöntemlerinin bütünüdür.
Anakütle, hakkında bilgi edinilmek istenen birimlerin tümüdür.
Örnek, anakütleden seçilen alt kümedir.
Tamsayım, anakütledeki bütün birimlerin incelenmesidir.
Örnekleme, anakütleden belirli bir yöntemle örnek seçme işlemidir.
Birim, incelemeye konu olan tek gözlemdir.
Değişken, birimlerin ölçülen veya sınıflandırılan özelliğidir.
Anakütleyi tanımlayan sayısal büyüklüğe parametre, örnekten hesaplanan karşılığına istatistik denir. İstatistiksel çıkarım, örnekten anakütle hakkında sonuç üretir.
1.2. Ölçme Düzeyleri
- Sınıflayıcı (nominal): yalnız sınıf belirtir; doğal sırası yoktur.
- Sıralayıcı (ordinal): sıralama vardır; düzeyler arasındaki farkın eşit olduğu söylenemez.
- Aralık (interval): eşit farklar anlamlıdır; mutlak sıfır yoktur.
- Oran (ratio): eşit farklara ek olarak gerçek sıfır vardır; oranlar anlamlıdır.
Bir kategorinin 1, 2, 3 gibi sayılarla kodlanması onu nicel değişken yapmaz. Kodlama ile ölçme düzeyi farklı kavramlardır.
Veri hangi düzeyde toplulaştırıldıysa yorum da o düzeyde yapılmalıdır. İl, birim veya dönem düzeyinde bulunan ilişkinin tek tek gözlemler için de geçerli olduğunu varsaymak ekolojik yanılgıdır.
Bir değişkenin depolama türü ölçme düzeyini belirlemez. Örneğin üç ürün sınıfının 1, 2 ve 3 kodlarıyla kaydedilmesi, sınıflar arasında iki katlık bir fark bulunduğu anlamına gelmez. Aynı şekilde birden çok sıralı sorunun toplam puanı, her koşulda kendiliğinden eşit aralıklı ölçüm sayılmaz; ölçeğin yapısı ve kullanılacak modelin varsayımları ayrıca incelenir. Gözlem birimi de tanımın parçasıdır: her satır bir kişi yerine bir bölgeyi temsil ediyorsa bölgesel ortalamadan bireysel ilişki çıkarmak ekolojik yanılgıya yol açabilir. Karar sırası; gözlem birimini tanımlamak, değişkenin neyi ölçtüğünü belirlemek, kodlama ile ölçümü ayırmak ve ancak bundan sonra istatistiksel işlemi seçmektir.
Birden fazla sorudan oluşturulan ölçekte ters anlamlı maddenin yeniden kodlanması yalnız biçimsel bir işlem değildir. Beşli cevap düzeyinde ters kodlama x_yeni = 6 − x_eski biçimindeyse 1 değeri 5, 2 değeri 4 olur ve orta nokta 3 kalır. Yönler eşitlenmeden hesaplanan toplam puan tutarsızlaşabilir. İç tutarlılık katsayısı, farklı soruların gerçekten aynı kuramsal kavramı geçerli biçimde ölçtüğünü tek başına kanıtlamaz. Güvenirlik ölçümün tutarlılığı, geçerlik ise hedeflenen çıkarımın dayanağıdır; bir ölçek tutarlı fakat yanlış kavramı ölçüyor olabilir. Ölçek puanını modelde kullanmadan önce madde yönleri, eksiklik kuralları, puanlama ve geçerlik kanıtı incelenmelidir.
1.3. Betimleyici ve Çıkarımsal İstatistik
Betimleyici istatistik, eldeki veriyi özetler.
Çıkarımsal istatistik, örnekten anakütle hakkında belirsizlik içeren sonuçlar üretir.
Bu ayrım merkezîdir: ortalama ve standart sapma veriyi betimler; standart hata ve güven aralığı örnekleme belirsizliğini ölçer.
1.4. Frekans Tablosundan Sınıflı Dağılıma
Frekans tablosu, bir değerin kaç kez gözlendiğini gösterir. Gözlem sayısı n, i değerinin mutlak frekansı f_i ise göreli frekans r_i = f_i / n olur; eksik veri dışarıda tutulmuşsa paydadaki n geçerli gözlem sayısıdır. Örneğin 1, 1, 2, 2, 2, 3, 4, 4 örnekleminde 2 değerinin frekansı 3, göreli frekansı 3/8 ve kümülatif frekansı 5tir. Kümülatif değerlerin anlamlı biçimde yorumlanması için sınıf veya değerlerin sıralı olması gerekir.
Sürekli değişkenlerde gözlemler sınıf aralıklarına ayrılır. Bir gözlemin iki sınıfa birden girmemesi için aralıklar örneğin [a,b) biçiminde tanımlanır; son üst sınırın dahil edilip edilmediği açıkça belirtilir. Sturges yaklaşımı k = ceil(1 + log2(n)) ile sınıf sayısına başlangıç tahmini verir. n=100 için k=8 elde edilir; bu, verinin mutlaka sekiz sınıfa ayrılması gerektiği anlamına gelmez. Dağılım çarpıksa, uç değerler fazlaysa veya çok sayıda gözlem aynı değerde birikiyorsa sınıf sınırları ayrıca incelenir. Eşit olmayan aralık genişliklerinde histogram yüksekliği doğrudan frekans değil, frekans yoğunluğu olmalıdır; alanlar gözlem paylarını temsil eder.
1.5. Merkezi Eğilim Ölçüleri
1.5.1. Aritmetik Ortalama
x̄ = Σxᵢ / n
x̄ = Σ(fᵢ·xᵢ) / Σfᵢ
Gruplanmış seride xᵢ sınıf orta noktasıdır.
Aritmetik ortalama bütün gözlemleri kullanır ve aykırı değerlere duyarlıdır.
1.5.2. Geometrik Ortalama
G = ⁿ√(x₁·x₂·...·xₙ)
log G = Σ(log xᵢ) / n
Pozitif değerlerde oransal değişim, büyüme ve bileşik getiri için kullanılır.
1.5.3. Harmonik Ortalama
H = n / Σ(1/xᵢ)Oran ve hızların uygun biçimde ortalanmasında kullanılır.
1.5.4. Kareli Ortalama
K = √(Σxᵢ² / n)İşaretten bağımsız büyüklük ölçümünde kullanılır.
Pozitif değerlerde:
H ≤ G ≤ x̄ ≤ K1.5.5. Medyan
Sıralanmış dizinin ortasındaki değerdir. Aykırı değerlere ortalamadan daha dayanıklıdır.
Gruplanmış seride:
Md = L + [ (n/2 − F) / f ] · cL medyan sınıfının alt sınırı, F önceki birikimli frekans, f medyan sınıfının frekansı, c sınıf genişliğidir.
1.5.6. Mod
En sık gözlenen değerdir. Bir dağılımın modu olmayabilir veya birden çok modu olabilir.
Gruplanmış seride:
Mo = L + [ Δ₁ / (Δ₁ + Δ₂) ] · cSimetrik tek modlu dağılımda:
x̄ = Md = Mo1.6. Dağılma Ölçüleri
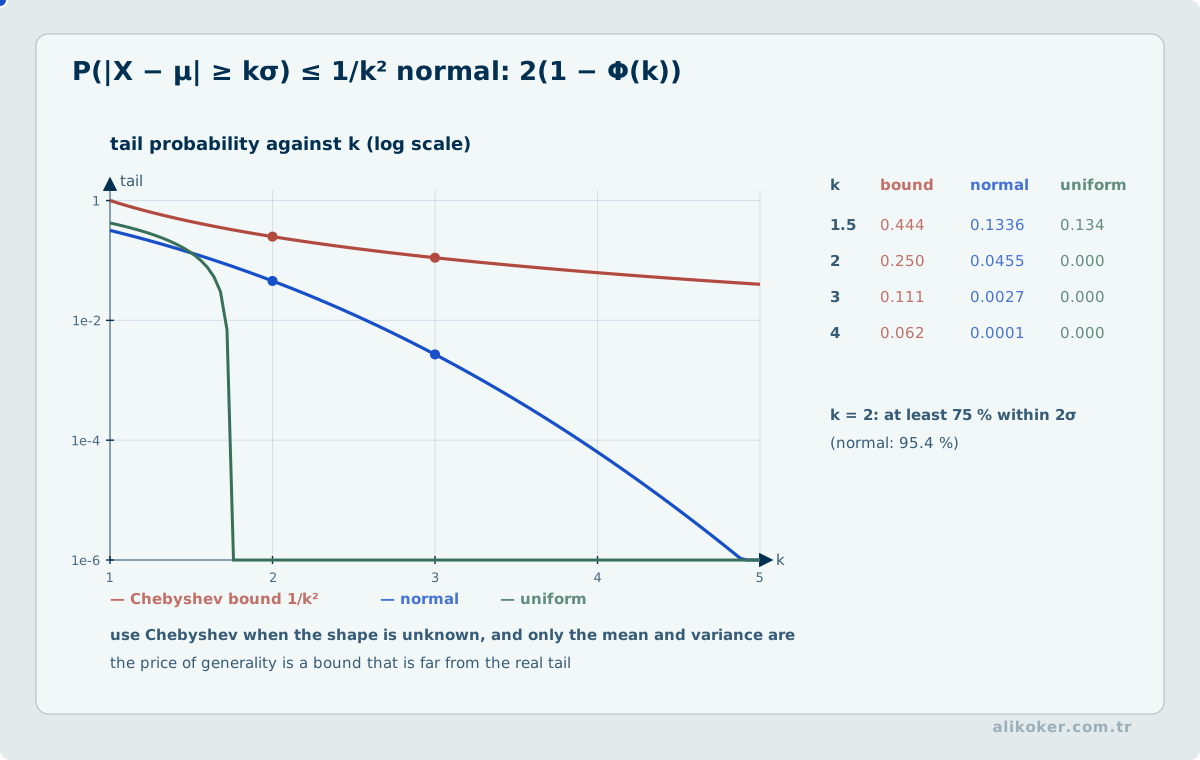
Değişim aralığı:
R = x_max − x_minYalnız en küçük ve en büyük değeri kullandığı için aykırı değerlere duyarlıdır.
Kartiller arası açıklık:
IQR = Q₃ − Q₁Ortadaki yüzde 50'lik bölgenin yayılımını gösterir ve uç değerlere daha dayanıklıdır.
Anakütle varyansı:
σ² = Σ(xᵢ − μ)² / NÖrnek varyansı:
s² = Σ(xᵢ − x̄)² / (n − 1)Standart sapma:
s = √s²Standart sapma gözlemlerin yayılımını, standart hata ise bir tahmin edicinin örnekten örneğe değişkenliğini anlatır.
Bağımsız gözlemlerde örnek ortalamasının tahmini standart hatası:
SE(x̄) = s / √nDeğişim katsayısı:
DK = (s / x̄) · 100Farklı ölçeklerdeki pozitif niceliklerin göreli değişkenliğini karşılaştırmak için kullanılabilir. Ortalama sıfıra yakınsa kararsızlaşır.
1.7. Yüzdelikler ve Kuantiller
Medyan 50. yüzdeliktir. Q₁, Q₂, Q₃ sırasıyla yüzde 25, 50 ve 75 noktalarını gösterir.
P90, P95 ve P99 üst kuyruk davranışını özetler. Örneğin P95, gözlemlerin yaklaşık yüzde 95'inin bu değerde veya altında kaldığı eşiği gösterir.
Yüzdelik algoritmaları, özellikle küçük örneklerde sıra konumu ve iç değer bulma yöntemine göre farklı sonuç verebilir. Karşılaştırmalarda aynı yöntem kullanılmalıdır.
1.8. Dayanıklı İstatistikler
Aykırı değerlerin ortalama ve standart sapmayı bozduğu serilerde medyan ve medyan mutlak sapması kullanılabilir:
MAD = medyan(|xᵢ − medyan(x)|)Değiştirilmiş z-puanı:
Mᵢ = 0,6745 · (xᵢ − medyan(x)) / MADBu puan olağandışı gözlemi işaretler; tek başına kanıt değildir. MAD = 0 ise formül doğrudan uygulanamaz.
Klasik z-puanı:
zᵢ = (xᵢ − x̄) / s1.9. İstatistiksel Yöntem ve Araştırma Sorusu Eşleştirmesi
Bir veri kümesini özetlemek ile anakütle hakkında çıkarım yapmak aynı işlem değildir. Ortalama, medyan, varyans ve çeyrekler eldeki gözlemleri betimler. Güven aralığı, hipotez testi ve regresyon ise örnekten daha geniş bir yapı hakkında belirsizlik altında sonuç üretir. Bu ayrım kurulmadan seçilen formül doğru olsa bile yorum yanlış olabilir.
Koşullu olasılık yönlüdür:
P(A|B) = P(A ∩ B) / P(B)P(A|B) ile P(B|A) genellikle aynı değildir. Bayes kuralı bu yön değişimini önceki olasılık ve olabilirlik üzerinden yapar. Özellikle düşük taban oranlı olaylarda yalnız testin doğruluğuna bakmak yeterli değildir; olayın başlangıçtaki görülme sıklığı son olasılığı belirgin biçimde etkiler.
Beklenen değer uzun dönemli ağırlıklı ortalamadır; varyans ise sonuçların bu merkezin çevresinde ne kadar yayıldığını ölçer. İki dağılım aynı ortalamaya sahip olup çok farklı risk profilleri gösterebilir. Standart sapmanın değişkenle aynı birimde olması yorumlamayı kolaylaştırır. Çarpık veya aykırı değer içeren örneklerde medyan ve çeyrekler arası açıklık, ortalama ve standart sapmadan daha sağlam olabilir.
Bir güven aralığı ile tek bir gelecek gözlem için tahmin aralığı da ayrılmalıdır. Güven aralığı parametrenin belirsizliğini, tahmin aralığı ise buna ek olarak yeni gözlemin doğal değişkenliğini taşır; bu yüzden tahmin aralığı genellikle daha geniştir.
Korelasyon doğrusal ilişkinin yönü ve gücü hakkında bilgi verir, nedensellik kanıtlamaz. Benzer biçimde küçük bir p değeri etkinin büyük veya pratik olarak önemli olduğunu söylemez. İstatistiksel sonuç; örnekleme biçimi, etki büyüklüğü, belirsizlik ve problem bağlamıyla birlikte okunmalıdır.
Ünite 2: Kümeler Kuramı
2.1. Küme ve Alt Küme
Bir nesne topluluğuna küme, içindeki nesnelere eleman denir.
A kümesinin bütün elemanları B içinde bulunuyorsa:
A ⊆ Bn elemanlı bir kümenin alt küme sayısı:
2ⁿ2.2. Kesişim, Birleşim, Tümleyen
A ∩ B = {x : x ∈ A ve x ∈ B}
A ∪ B = {x : x ∈ A veya x ∈ B}
A' = {x ∈ E : x ∉ A}
A \ B = A ∩ B'
De Morgan kuralları:
(A ∪ B)' = A' ∩ B'
(A ∩ B)' = A' ∪ B'
İçerme-dışlama ilkesi:
|A ∪ B| = |A| + |B| − |A ∩ B|Kümeler kuramı olasılığın dilidir: örnek uzay bir küme, olay onun alt kümesidir.
Ünite 3: Permütasyon ve Kombinasyon
3.1. Sayma İlkeleri
Ayrık seçenekler için sayılar toplanır; ardışık aşamalar için çarpılır.
3.2. Permütasyon
Sıranın önemli olduğu seçimdir.
P(n,r) = n! / (n−r)!
P(n,n) = n!
Tekrarlı seçim:
nʳÖzdeş elemanlar varsa:
n! / (n₁!·n₂!·...·nₖ!)3.3. Kombinasyon
Sıranın önemli olmadığı seçimdir.
C(n,r) = n! / [r!·(n−r)!]Tekrarlı kombinasyon:
C(n+r−1,r)Özellikler:
C(n,r) = C(n,n−r)
C(n,r) = C(n−1,r−1) + C(n−1,r)
Σ C(n,r) = 2ⁿ
Seçim ölçütü basittir: sıra sonucu değiştiriyorsa permütasyon, değiştirmiyorsa kombinasyon kullanılır.
Ünite 4: Olasılığa Giriş
Bir olasılık problemi çözüleceğinde önce örnek uzay ve olaylar açık biçimde tanımlanır. Olayların ayrık olup olmadığı, bağımsızlık varsayımının gerçekten gerekçelendirilip gerekçelendirilmediği belirlenir. Koşullu olasılıkta pay ve payda aynı koşul evrenine göre hesaplanmalıdır. Toplam olasılık veya Bayes kuralı kullanıldıktan sonra bulunan değerlerin sıfır ile bir arasında olması ve ilgili olaylara göre toplamlarının tutarlı çıkması bir ilk kontrol sağlar.
4.1. Temel Kavramlar
Sonucu önceden kesin bilinmeyen işleme rastgele deney, bütün olası sonuçların kümesine örnek uzay, örnek uzayın alt kümelerine olay denir.
4.2. Olasılık Tanımları
Eşit olasılıklı sonuçlarda klasik tanım:
P(A) = elverişli durum sayısı / mümkün durum sayısıFrekans yaklaşımında olasılık, çok sayıda tekrar sonunda göreli frekansın yaklaştığı değerdir.
Kolmogorov aksiyomları:
0 ≤ P(A) ≤ 1
P(S) = 1
A ve B ayrık ise P(A ∪ B) = P(A) + P(B)
Temel sonuçlar:
P(∅) = 0
P(A') = 1 − P(A)
P(A ∪ B) = P(A) + P(B) − P(A ∩ B)
Üç olay için:
P(A∪B∪C)
= P(A)+P(B)+P(C)
− P(A∩B)−P(A∩C)−P(B∩C)
+ P(A∩B∩C)
4.3. Koşullu Olasılık
P(A|B) = P(A ∩ B) / P(B), P(B) > 0Çarpma teoremi:
P(A ∩ B) = P(B)·P(A|B)
         = P(A)·P(B|A)
4.4. Bağımsızlık
P(A|B) = P(A)eşdeğer olarak:
P(A ∩ B) = P(A)·P(B)Ayrıklık ve bağımsızlık aynı şey değildir. Olasılıkları sıfırdan farklı iki ayrık olay bağımsız olamaz.
4.5. Toplam Olasılık
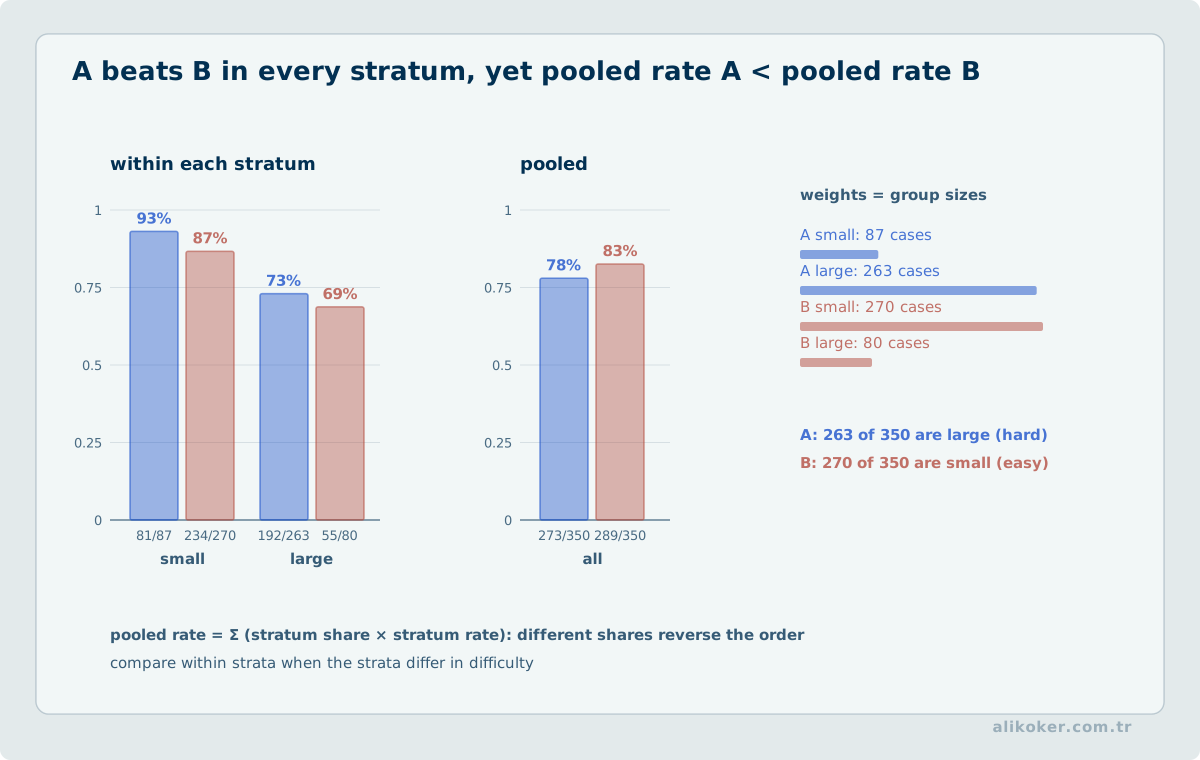
B₁, ..., Bₙ örnek uzayı ayrık biçimde bölüyorsa:
P(A) = Σ P(Bᵢ)·P(A|Bᵢ)4.6. Bayes Teoremi
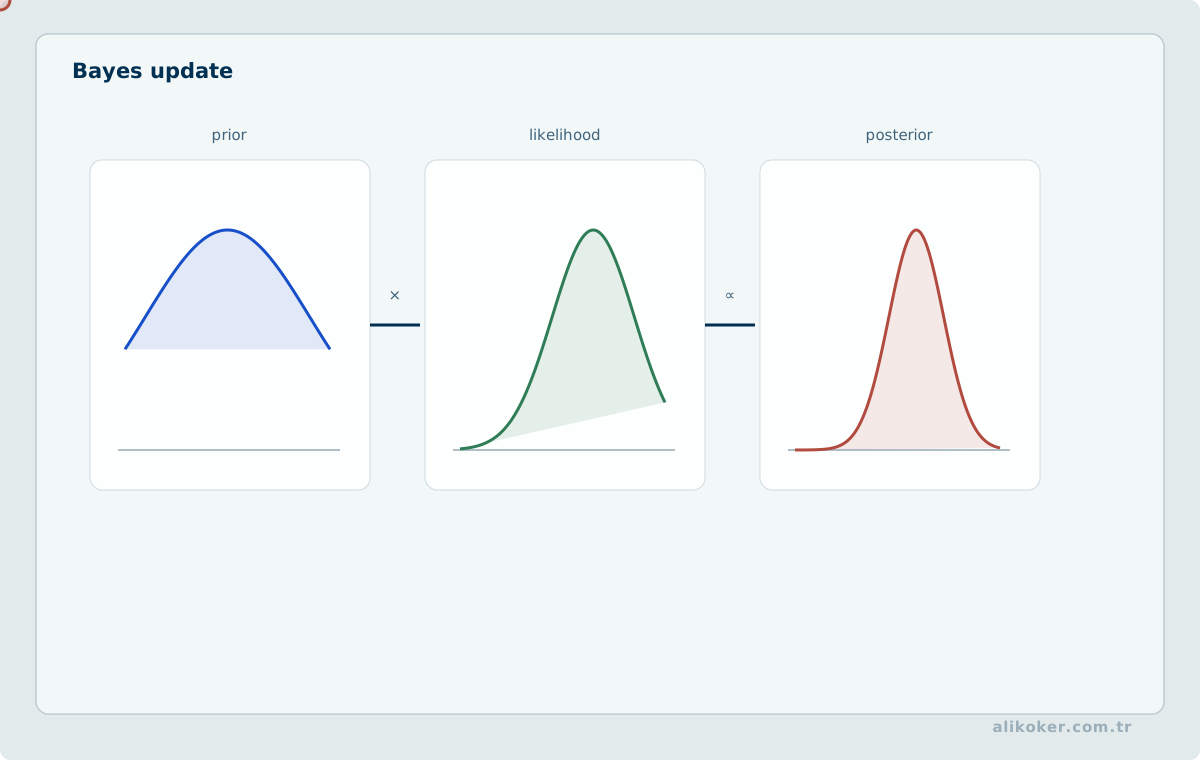
P(Bₖ|A)
= P(Bₖ)·P(A|Bₖ) / Σ[P(Bᵢ)·P(A|Bᵢ)]
P(Bₖ) önsel, P(Bₖ|A) sonsal olasılıktır. Yeni gözlem, önceki olasılık bilgisini günceller.
Bayes hesabını karar eşiğiyle birleştirmek. Bir cihaz grubunda gerçek arıza oranı %2, alarmın arızayı yakalama olasılığı %95 ve sağlam cihaza yanlış alarm verme olasılığı %4 olsun. Alarm görüldüğünde arıza olasılığını yalnız duyarlılık üzerinden %95 kabul etmek temel oranı göz ardı eder. Bayes hesabı P(arıza | alarm) = (0,02·0,95) / (0,02·0,95 + 0,98·0,04) = 0,019/0,0582 ≈ 0,3265 verir. Dolayısıyla alarm alınan bir cihazın gerçekten arızalı olma olasılığı yaklaşık %32,65 düzeyindedir. İnceleme kararının doğru kurulabilmesi için yanlış alarm maliyeti, kaçırılan arızanın maliyeti ve ikinci doğrulama testinin doğruluğu da değerlendirilmelidir. Hesabın geçerliliği, duyarlılık ve yanlış alarm olasılıklarının aynı cihaz popülasyonunda ölçülmüş olmasına bağlıdır.
Ünite 5: Rastgele Değişkenler
5.1. Kesikli ve Sürekli Değişken
Kesikli rastgele değişken sayılabilir değerler alır.
Sürekli rastgele değişken bir aralıktaki değerleri alabilir.
5.2. Kesikli Dağılım
p(xᵢ) = P(X = xᵢ)
p(xᵢ) ≥ 0
Σp(xᵢ) = 1
Birikimli dağılım:
F(x) = P(X ≤ x)Beklenen değer:
E(X) = μ = Σxᵢ·p(xᵢ)Varyans:
Var(X) = E[(X−μ)²]
       = E(X²) − [E(X)]²
Özellikler:
E(aX+b) = aE(X)+b
E(X+Y) = E(X)+E(Y)
Var(aX+b) = a²Var(X)
Genel olarak:
Var(X+Y)
= Var(X)+Var(Y)+2Cov(X,Y)
5.3. Sürekli Dağılım
Yoğunluk fonksiyonu:
f(x) ≥ 0
∫f(x)dx = 1
P(a ≤ X ≤ b) = ∫[a,b] f(x)dx
Sürekli dağılımda tek noktanın olasılığı sıfırdır.
F(x) = ∫(−∞,x] f(t)dt
E(X) = ∫x·f(x)dx
Var(X) = ∫(x−μ)²f(x)dx
5.4. Ortak, Marjinal ve Koşullu Dağılımlar
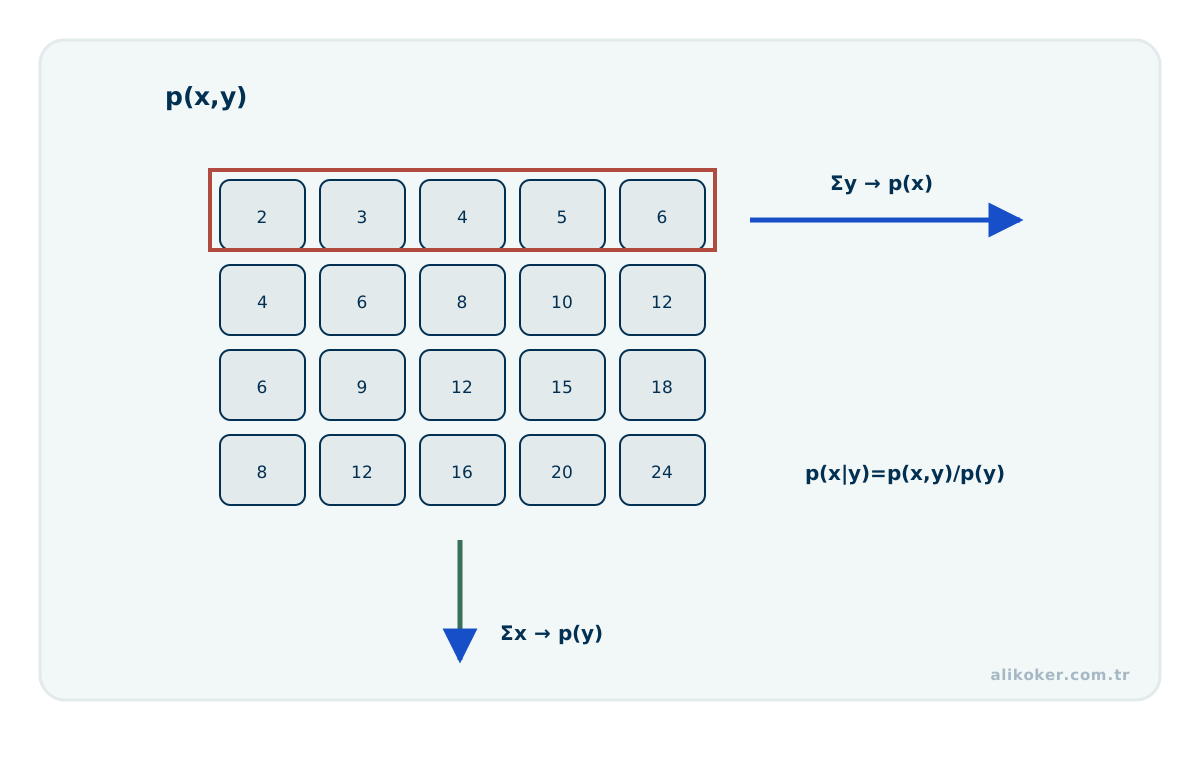
İki rastgele değişken birlikte incelendiğinde tek tek dağılımlar tüm bağımlılık bilgisini taşımaz. Ortak dağılım X ve Y değerlerinin birlikte nasıl gerçekleştiğini tanımlar. Ortak yoğunluk veya olasılık kütlesinden bir değişkenin etkisi toplanarak ya da integre edilerek marjinal dağılım elde edilir.
Koşullu dağılım ise bir değişken hakkında bilgi edinildiğinde diğerinin dağılımının nasıl değiştiğini gösterir. Ayrık durumda:
P(X=x | Y=y) = P(X=x, Y=y) / P(Y=y)uygun pozitif payda için kullanılır. Bağımsızlık, koşullamanın dağılımı değiştirmemesi biçiminde de okunabilir.
Veri biliminde bu ayrım önemlidir: iki sütunun ayrı histogramları aynı görünse bile ortak davranışları farklı olabilir. Bağımlılık yapısını yalnız marjinal dağılımlarla değerlendirmek bilgi kaybına yol açar.
5.5. Kovaryans, Koşullu Beklenti ve Toplam Beklenti Yasası
Kovaryans iki değişkenin doğrusal birlikte değişimini ölçer:
Cov(X,Y) = E[(X-E[X])(Y-E[Y])]Korelasyon kovaryansı ölçeklerden arındırır; ancak bağımsızlıkla eş anlamlı değildir. Bağımsız değişkenlerin kovaryansı sıfırdır, fakat sıfır kovaryans genel olarak bağımsızlığı garanti etmez.
Koşullu beklenti E[X|Y], Y bilgisi verildiğinde X için ortalama davranışı temsil eder. Toplam beklenti yasası:
E[X] = E[E[X|Y]]şeklindedir. Toplam varyans yasası ise değişkenliği iki parçaya ayırır:
Var(X) = E[Var(X|Y)] + Var(E[X|Y])İlk terim grup içi belirsizliği, ikinci terim koşullu ortalamalar arasındaki değişimi temsil eder. Bu ayrım hiyerarşik veri, hata bütçesi ve model açıklamalarında güçlü bir düşünme aracıdır.
Ünite 6: Kesikli Olasılık Dağılımları
6.1. Bernoulli Dağılımı
İki sonuçlu tek deneme:
P(X=1) = p
P(X=0) = 1−p = q
E(X) = p
Var(X) = p·q
6.2. Binom Dağılımı
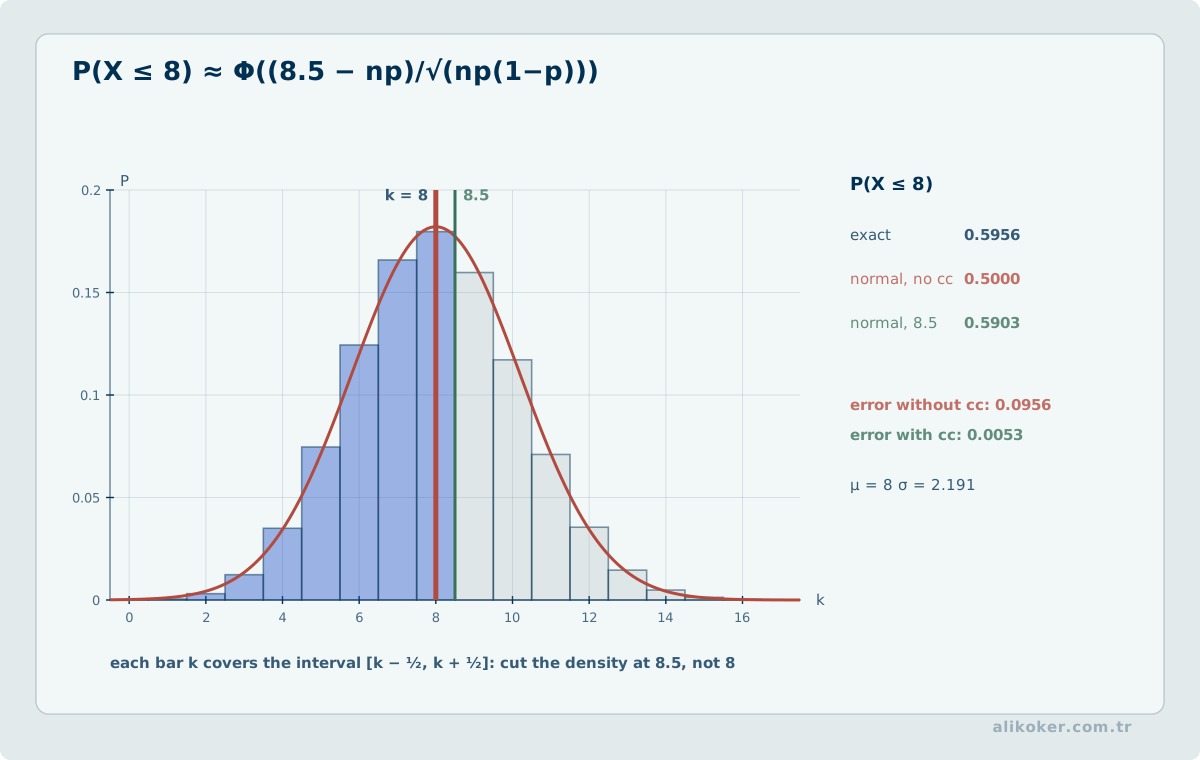
n bağımsız Bernoulli denemesindeki başarı sayısı:
P(X=k) = C(n,k)·pᵏ·q^(n−k)
E(X) = n·p
Var(X) = n·p·q
Koşullar: sabit deneme sayısı, iki sonuç, sabit başarı olasılığı ve bağımsız denemeler.
6.3. Çok Terimli Dağılım
Binomun ikiden çok sonuçlu genişlemesidir:
P(X₁=n₁,...,Xₖ=nₖ)
= [n!/(n₁!·...·nₖ!)] · p₁^n₁ · ... · pₖ^nₖ
6.4. Poisson Dağılımı
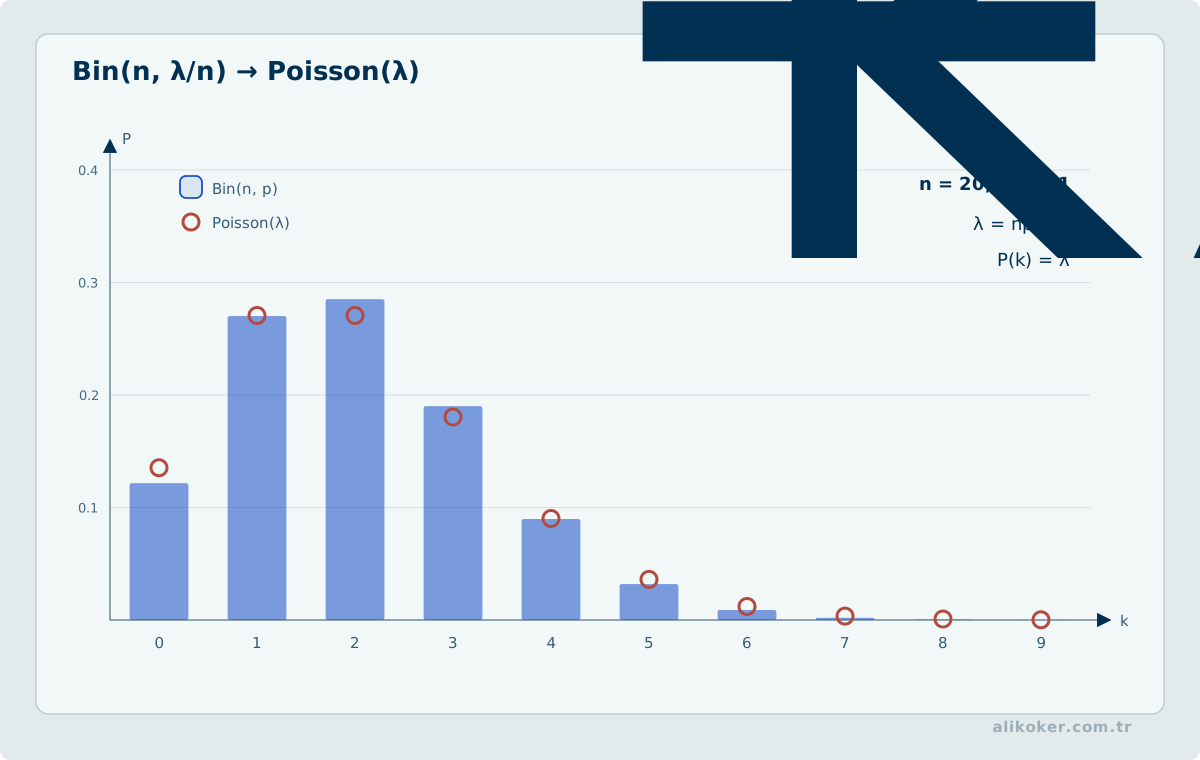
Sabit bir zaman veya alan aralığındaki olay sayısını modeller:
P(X=k) = e^(−λ)·λᵏ/k!
E(X) = λ
Var(X) = λ
Kuramsal Poisson modelinde ortalama ve varyans eşittir. Örnek veride belirgin aşırı veya az saçılım model uygunluğunun incelenmesini gerektirir.
Binom için n büyür, p küçülür ve λ=n·p sınırlı kalırsa Poisson yaklaşımı kullanılabilir. Sabit eşikler yalnız pratik kuraldır.
6.5. Geometrik Dağılım
İlk başarıya kadar geçen deneme sayısı:
P(X=k) = q^(k−1)·p
E(X) = 1/p
Belleksizdir.
6.6. Negatif Binom Dağılımı
r başarının gerçekleşmesine kadar geçen deneme sayısını modeller. Geometrik dağılım r=1 özel durumudur.
Ünite 7: Sürekli Olasılık Dağılımları
7.1. Normal Dağılım
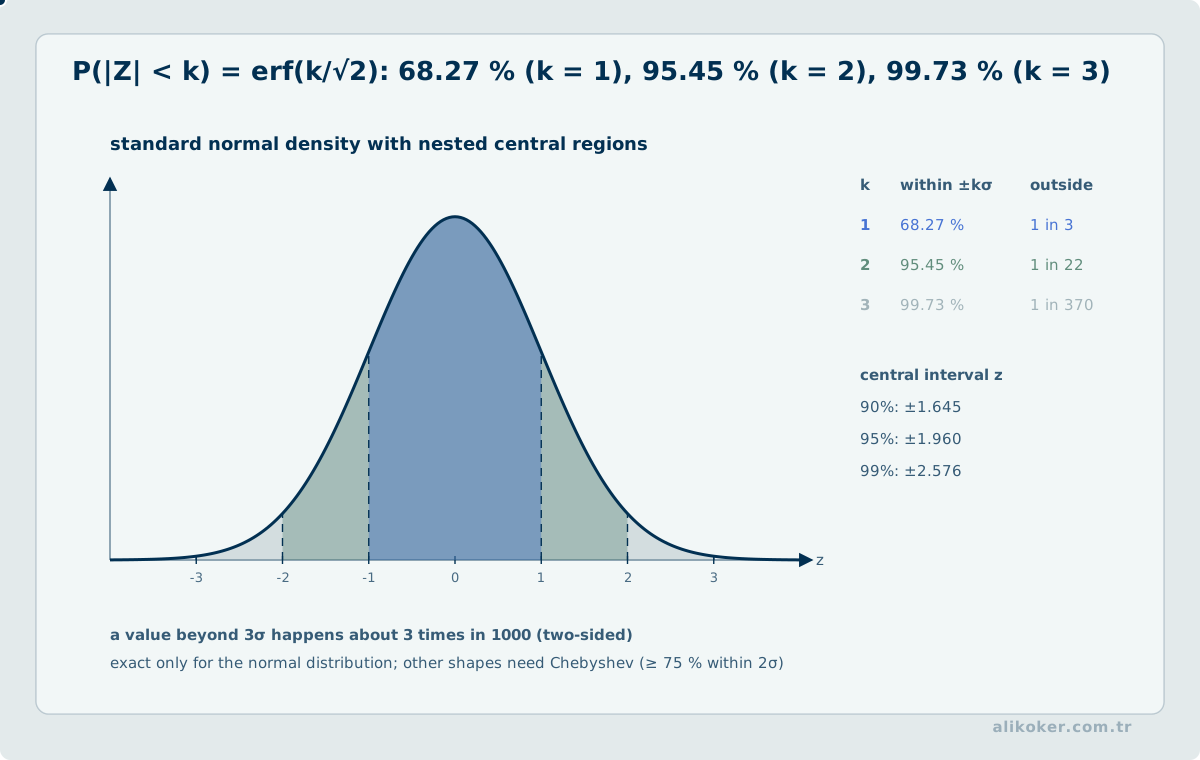
f(x)
= [1/(σ√(2π))]
  · e^(−(x−μ)²/(2σ²))
μ konumu, σ yayılımı belirler.
Özellikleri:
μçevresinde simetriktir.- Ortalama, medyan ve mod çakışır.
- Eğri altındaki alan 1'dir.
- Dönüm noktaları
μ ± σkonumundadır.
Yaklaşık ampirik kural:
μ ± σ   → %68
μ ± 2σ  → %95
μ ± 3σ  → %99,7
7.2. Standart Normal Dağılım
Z = (X−μ)/σZ, gözlemin ortalamadan kaç standart sapma uzakta olduğunu gösterir.
7.3. Merkezî Limit Teoremi
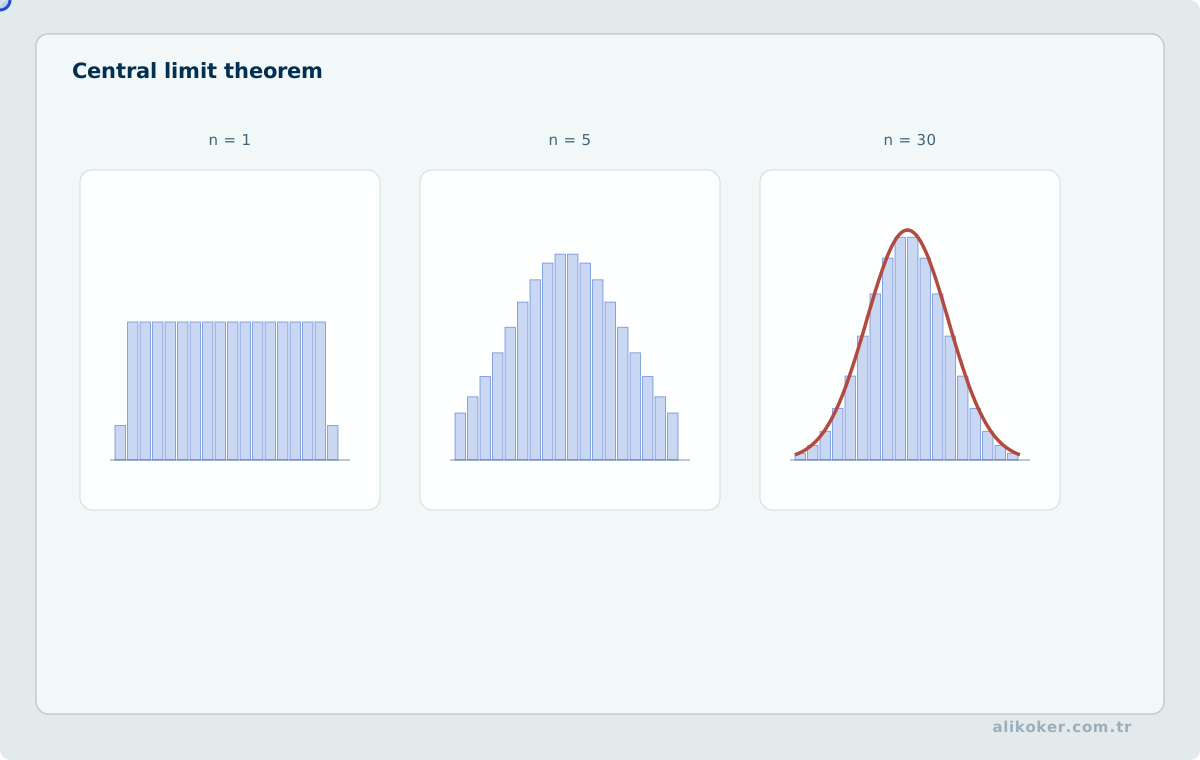
Uygun bağımsızlık ve düzenlilik koşullarında örnek büyüklüğü arttıkça örnek ortalamasının standartlaştırılmış dağılımı normale yaklaşır:
X̄ ≈ N(μ, σ²/n)Ham gözlemlerin normalleştiğini söylemez. Yakınsama hızı dağılımın çarpıklığına, kuyruklarına ve bağımlılık yapısına bağlıdır.
Merkezî limit teoremini ham verinin normal dağıldığı iddiasına dönüştürmek yanlıştır. Teorem, uygun koşullarda standartlaştırılmış toplamların veya ortalamaların dağılımına ilişkindir. Bağımsız ve aynı dağılımlı, sonlu varyanslı gözlemler klasik örneği oluşturur; güçlü bağımlılık, ağır kuyruklar veya sonsuz varyans altında aynı yakınsama otomatik değildir. Başka bir sınır da örneklemin temsiliyetidir: çok büyük fakat seçilim yanlılığı bulunan bir örneklem, rastlantısal örnekleme eksikliğini büyüklüğü sayesinde gidermez. Analizde önce veri toplama mekanizması ve bağımlılık yapısı, ardından örneklem istatistiğinin dağılımı, standart hata hesabı ve gerekli sağlamlık denetimleri değerlendirilmelidir.
7.4. Üstel Dağılım
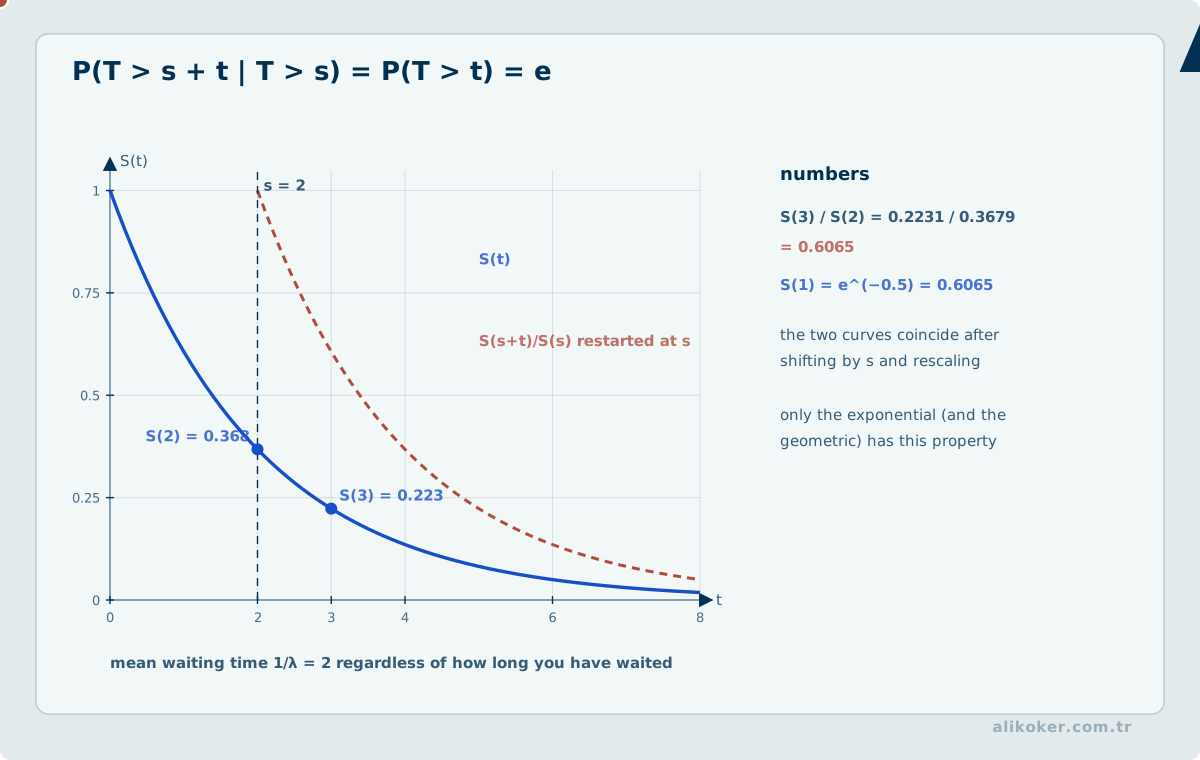
Olaylar arası bekleme süresini modeller:
f(x) = λe^(−λx),   x ≥ 0
F(x) = 1−e^(−λx)
E(X) = 1/λ
Var(X) = 1/λ²
Belleksizlik:
P(X>s+t | X>s) = P(X>t)7.5. Gamma Dağılımı
r. olaya kadar geçen süre için:
E(X) = r/λ
Var(X) = r/λ²
r=1 olduğunda üstel dağılıma indirgenir.
7.6. Beta Dağılımı
Tanım aralığı [0,1] olan esnek bir dağılımdır. Oran ve olasılık modellemesinde kullanılır.
7.7. Ki-kare Dağılımı
χ² = Z₁² + Z₂² + ... + Zₖ²k serbestlik derecesidir. Varyans çıkarımı ve bağımsızlık testlerinde kullanılır.
7.8. F Dağılımı
F = (χ₁²/k₁) / (χ₂²/k₂)Varyans karşılaştırması ve varyans analizinde kullanılır.
7.9. Student T Dağılımı
t = Z / √(χ²/k)Normal dağılıma göre daha kalın kuyrukludur. Serbestlik derecesi arttıkça standart normal dağılıma yaklaşır.
Anakütle standart sapmasının bilinmediği ortalama çıkarımlarında, varsayımlar sağlandığında uygun serbestlik derecesiyle kullanılır.
7.10. Büyük Sayılar Yasası ve Merkezî Limit Teoremi Ayrımı
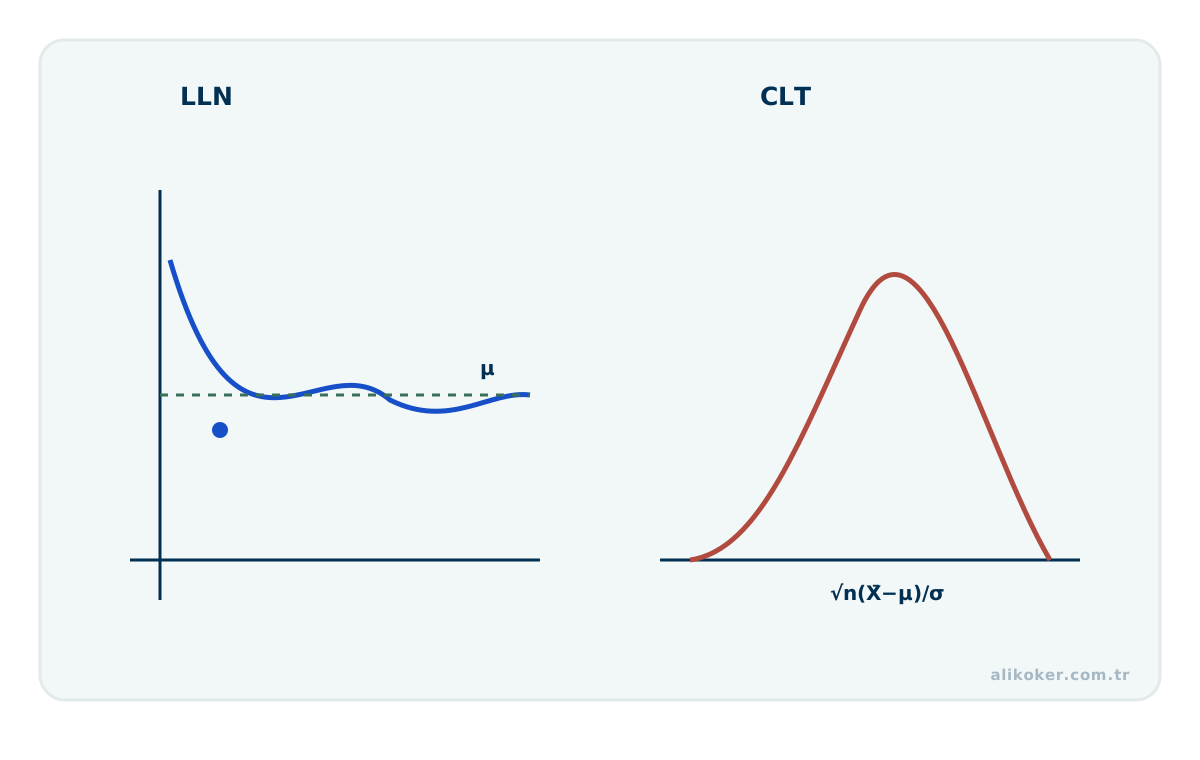
Büyük Sayılar Yasası (LLN), uygun koşullarda örneklem ortalamasının örneklem büyüdükçe gerçek beklenen değere yaklaşmasını açıklar. Merkezî Limit Teoremi (CLT) ise uygun koşullarda standartlaştırılmış toplam veya ortalamanın dağılımının yaklaşık normal hale gelmesini açıklar.
Bunlar aynı sonuç değildir:
- LLN yakınsamayı, yani tahminin hedefe yaklaşmasını anlatır.
- CLT dalgalanmanın yaklaşık dağılımını ve ölçeğini anlatır.
Örneklem ortalamasının standart hatası tipik bağımsız ve aynı dağılımlı durumda sigma/sqrt(n) ölçeğindedir. Bu nedenle daha çok veri belirsizliği azaltır, fakat yanlı örnekleme veya değişen veri üretim sürecini kendi başına düzeltmez.
Ünite 8: Örnekleme ve Kestirim
8.1. Örnekleme Çerçevesi
Örnekleme çerçevesi, anakütlede seçilebilecek birimlerin listesidir. Eksik çerçeve, temsil hatası üretir.
Örnekleme planı; anakütle, çerçeve, yöntem, örnek büyüklüğü, veri toplama biçimi ve tahmin edicileri tanımlar.
8.2. Nokta ve Aralık Tahmini
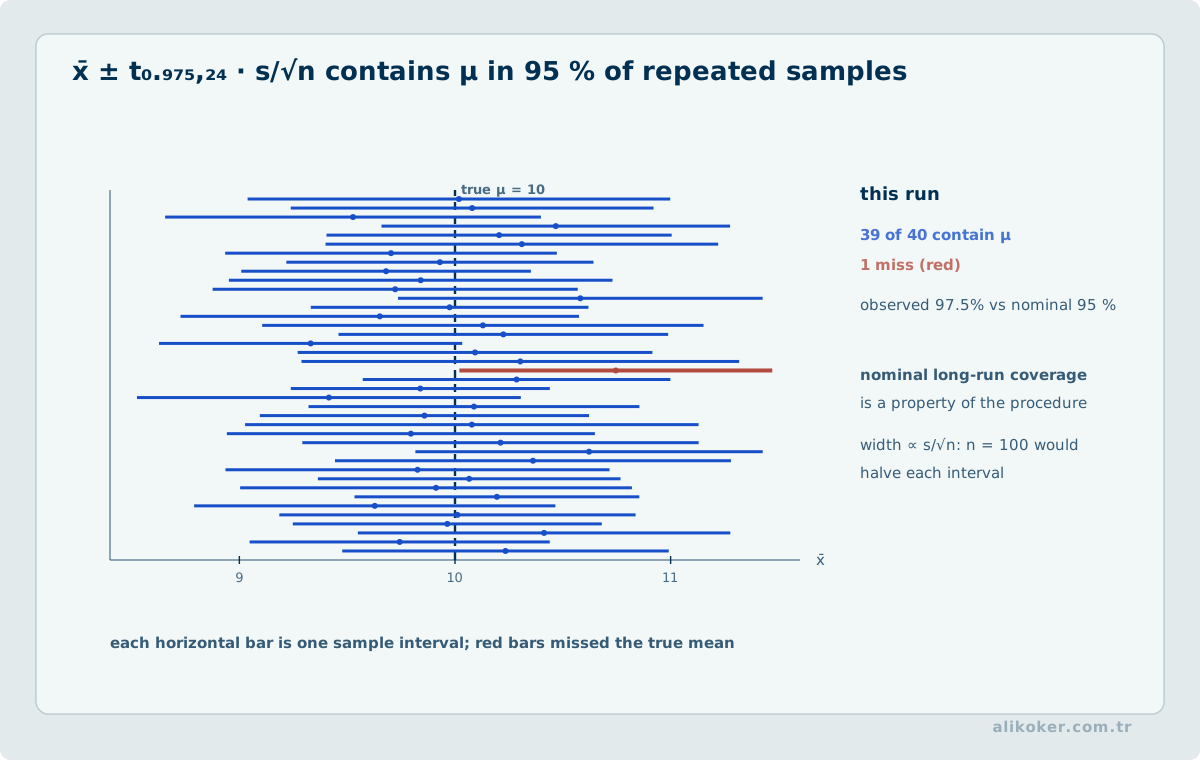
Nokta tahmini, parametre için tek değer üretir.
Güven aralığı, örnekleme belirsizliğini aralıkla gösterir.
Anakütle standart sapması biliniyorsa:
x̄ ± z(α/2)·σ/√nBilinmiyor ve normal model uygunsa:
x̄ ± t(α/2,n−1)·s/√nFrekansçı yorumda yüzde 95 güven düzeyi, aynı yöntem çok kez uygulandığında oluşturulan aralıkların uzun dönemde yaklaşık yüzde 95'inin sabit fakat bilinmeyen parametreyi kapsamasıdır.
8.3. Tahmin Edicinin Yanlılığı, Tutarlılığı ve Etkinliği
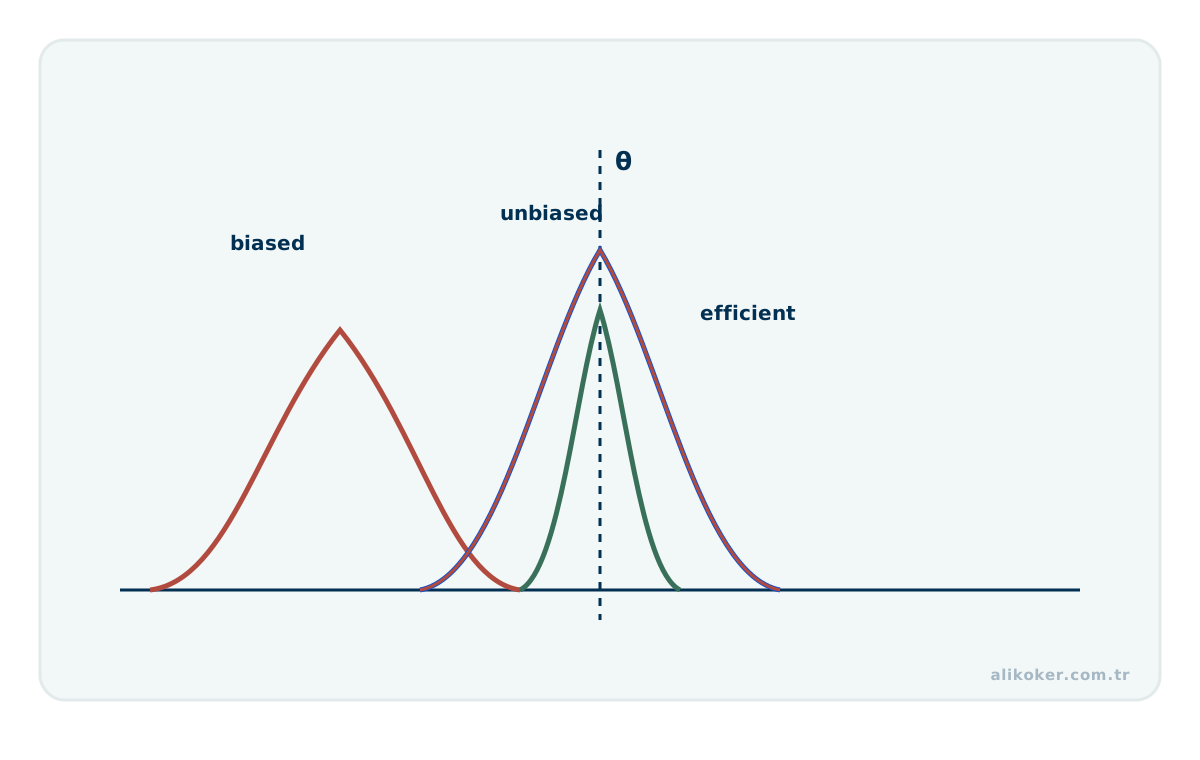
Bir parametreyi veriden hesaplayan kural tahmin edicidir. İyi tahmin ediciyi tek bir veri kümesindeki sonuca bakarak değerlendirmek yerine tekrar örnekleme davranışı düşünülür.
- Yanlılık:
E[theta_hat] - thetafarkıdır. - Tutarlılık: örneklem büyüdükçe
theta_hatdeğerinin gerçekthetadeğerine yakınsamasıdır. - Varyans: tahmin edicinin örnekten örneğe ne kadar değiştiğini gösterir.
- Ortalama karesel hata: yanlılık ve varyansı birlikte taşır.
- Etkinlik: aynı hedef için daha düşük belirsizlikle kestirim yapabilme fikridir.
Yanlı olmayan tahmin edici her zaman en iyi tahmin edici değildir. Küçük kontrollü bir yanlılık varyansı ciddi biçimde azaltabiliyorsa toplam hata daha düşük olabilir. Bu düşünce düzenlileştirme ve bias-variance dengesiyle istatistiksel öğrenmeye bağlanır.
Bir kestiricinin yeterliliği, örneklemin parametre hakkında taşıdığı bilginin seçilen istatistikte kaybolmamasıyla ilgilidir. Yeterli bir T(X) istatistiği verildiğinde örneklemin koşullu dağılımı bilinmeyen θ parametresine bağlı değildir. Fisher–Neyman çarpanlara ayırma ölçütü, olabilirlik fonksiyonunun T(X) üzerinden ayrıştırılabildiği uygun modellerde bu özelliği denetlemeye yarar. Yeterlilik, kestiricinin otomatik olarak yanlılıksız veya minimum varyanslı olduğu anlamına gelmez.
Bir kestiricinin asimptotik etkinliği, karşılaştırıldığı model ve düzenlilik koşullarına bağlıdır. Fisher bilgisi I(θ) = E[(∂ log L(θ;X)/∂θ)²] ifadesiyle, beklenen skor karesi üzerinden tanımlanabilir; uygun koşullarda aynı büyüklük negatif beklenen ikinci türeve eşittir. Tek parametreli düzenli bir modelde yanlılıksız kestiricinin varyansı için Cramér–Rao alt sınırı Var(θ̂) ≥ 1/I(θ) olur. Bu eşitsizlik her dağılıma, yanlı kestiriciye veya sınırda kalan parametre durumuna koşulsuz uygulanamaz.
8.4. Sonlu Anakütle Düzeltmesi
İadesiz örneklemede örnekleme oranı yüksekse:
√[(N−n)/(N−1)]kullanılır.
8.5. Örnek Büyüklüğü
Basit durumda hedef hata payı d için:
n = [z(α/2)·σ/d]²Standart hata yaklaşık 1/√n ile azalır; hata payını yarıya indirmek için örnek büyüklüğünü yaklaşık dört katına çıkarmak gerekir.
8.6. Basit Rastgele Örnekleme
Her birimin seçilme olasılığı eşittir. Kuramsal olarak basittir; küçük alt grupların örnekte temsil edilmesini garanti etmez.
8.7. Sistematik Örnekleme
k = N/nİlk k birim arasından rastgele başlangıç seçilir, ardından her k. birim alınır. Veri sırasındaki dönemlilik yanlılık üretebilir.
8.8. Tabakalı Örnekleme
Anakütle kendi içinde benzer tabakalara ayrılır ve her tabakadan örnek çekilir.
N = N₁ + ... + Nₖ
n = n₁ + ... + nₖ
Tabaka içi değişkenliğin düşük, tabakalar arası farkın yüksek olması yöntemin etkinliğini artırır.
Dağıtım eşit, orantılı veya Neyman dağıtımıyla yapılabilir.
8.9. Küme Örneklemesi
Anakütle doğal kümelere ayrılır ve kümelerin bir bölümü seçilir. Coğrafi maliyeti azaltabilir; aynı kümedeki gözlemlerin benzerliği etkin örnek büyüklüğünü düşürebilir.
Küme örneklemesinde aynı kümeden seçilen birimler çoğu zaman birbirine benzer; örneklem büyüklüğü tek başına bağımsız bilgi miktarını açıklamaz. Eşit büyüklükte kümeler için kullanılan yaklaşık tasarım etkisi DEFF ≈ 1 + (m−1)ρ biçimindedir; burada m ortalama küme büyüklüğü, ρ küme içi korelasyondur. Örneğin her kümede 10 gözlem ve ρ=0,2 varsa DEFF ≈ 2,8 bulunur. Bu yaklaşık değer, basit rastgele örneklem varsayımıyla hesaplanan varyansın gerçekte ne ölçüde farklılaşabileceğine ilişkin bir uyarıdır; tabakalama, eşit olmayan ağırlıklar ve karmaşık seçilim planında tam varyans kestiriminin yerine geçmez. Örnekleme birimi ile gözlem birimi ayrı kaydedilmelidir.
8.10. Ağırlıklandırma
Farklı seçilme olasılıklarında:
x̄_w = Σ(wᵢxᵢ) / Σwᵢkullanılabilir.
Karmaşık örnekleme tasarımında yalnız ortalama değil standart hata hesabı da tasarımı dikkate almalıdır.
Örneklem ağırlığı farklı anlamlar taşıyabilir: birimin seçilme olasılığının tersi, yanıtlamama düzeltmesi veya bilinen nüfus toplamlarına kalibrasyon. Bu anlamlar birbirinin yerine kullanılamaz. Dört gözlemin değerleri 10, 20, 30 ve 40; ağırlıkları 1, 1, 2 ve 2 ise ağırlıklı ortalama (10 + 20 + 2×30 + 2×40) / 6 = 28,33 olur; ağırlıksız ortalama 25'tir. Ancak ağırlıklı nokta kestirimi üretmek, belirsizlik hesabını tamamlamaz. Tabaka, küme ve sonlu nüfus bilgisi yok sayılırsa standart hata olduğundan küçük hesaplanabilir. Analiz protokolü hangi ağırlığın neden kullanıldığını, hedef evreni ve varyans kestirim yöntemini birlikte belirtmelidir.
8.11. Eksik Veri
Eksik veri mekanizmaları:
- MCAR: eksiklik gözlenen ve gözlenmeyen değerlerden bağımsızdır.
- MAR: eksiklik gözlenen değişkenlerle açıklanabilir.
- MNAR: eksiklik gözlenmeyen değerin kendisiyle de ilişkilidir.
Eksik satırları doğrudan silmek veya ortalamayla doldurmak her durumda tarafsız değildir.
Eksik değerin neden oluştuğu, nasıl doldurulacağından önce gelir. Eksikliğin tamamen rastlantısal olması (MCAR), gözlenen değişkenlere koşullu rastlantısal olması (MAR) ve gözlenmeyen değere bağlı kalması (MNAR) farklı varsayımlar gerektirir. Örneğin maliyet bilgisinin yalnız pahalı ürünlerde saklanmaması, gözlenen ürün türleriyle açıklanamıyorsa ortalamayla doldurulması maliyet tahminini aşağı çekebilir. Bir sorunun uygulanmadığı kişideki boşluk ise ölçüm hatası değildir; uygulanamazlık ile yanıtlamama farklı kodlanmalıdır. Silme, çoklu atama ve duyarlılık analizi ancak hedef kestirim, eksiklik mekanizması ve belirsizlik aktarımı birlikte değerlendirilerek seçilebilir.
Eksik veri mekanizmasının tanımlanması, gözlenmeyen değerin neden gözlenmediği hakkında bir varsayımdır. MCAR, eksikliğin hem gözlenen hem gözlenmeyen değerlerden bağımsız olduğunu; MAR, gözlenen değişkenler koşullandığında eksikliğin gözlenmeyen değere artık bağlı olmadığını; MNAR ise bu koşullamadan sonra da bağımlılığın sürdüğünü ifade eder. Bu mekanizmalar yalnız eksik hücre sayılarından kesin olarak belirlenemez.
Çoklu atama yönteminde eksik değerler tek bir kesin değerle doldurulmaz; atama modelinden birden fazla tamamlanmış veri kümesi üretilir. Her veri kümesinin kestirimi ve varyansı daha sonra hem veri içi hem atamalar arası belirsizliği taşıyacak biçimde birleştirilir. Atama modelinin uyumsuzluğu, eksiklik mekanizmasının yanlış varsayılması veya tanımsız parametreler, çoklu atama uygulanmış olsa bile geçerli çıkarımı garanti etmez. Ölçüm hatası ve sansürlenmiş gözlem de eksik veriden ayrı gözlem modelleridir.
8.12. Ağır Kuyruklar, Robust Tahmin ve Performans Verisi
Robust istatistik, modelin ideal varsayımlarından küçük sapmalar olduğunda tahminin ne kadar bozulduğunu inceler. Dayanıklı istatistikte medyan ve MAD pratik özetlerdir; influence function küçük bir kirlenmenin tahmin edici üzerindeki marjinal etkisini, breakdown point ise kirlenme oranı büyüdüğünde tahmin edicinin anlamlılığını hangi noktaya kadar koruduğunu tanımlayan ayrı kavramlardır. Özellikle ağır kuyruklu veya kontamine veride yalnız ortalama ve standart sapmaya dayalı kararlar yanıltıcı olabilir.
- Ortalama gecikmenin medyan ve yüksek yüzdeliklerle birlikte raporlanması.
- Aykırı değerin hata mı gerçek nadir olay mı olduğunun veri bağlamında incelenmesi.
- Influence function ve breakdown point kavramlarının tahmin edici seçimine bağlanması.
8.13. Frekans, Sınıflama ve Örnekleme Arasındaki Bağ
İstatistiksel özetleme ile sinyal örnekleme aynı "örnek" sözcüğünü kullansa da farklı problemleri çözer. Frekans Tablosu gözlemleri değer veya sınıf tekrarlarıyla özetler; Sturges Kuralı sınıf sayısı için yaklaşık bir başlangıç değeri verir. Örnekleme Frekansı ise zaman eksenindeki bir işaretin saniyede kaç örnekle temsil edildiğini açıklar.
Bu ayrım önemlidir: istatistikte örneklem büyüklüğü gözlem sayısıyla, sayısal sinyal işlemede sampling rate ise zaman başına ölçüm sayısıyla ilgilidir. Örnekleme Teoremi ikinci bağlamın bant sınırlı işaret koşulunu tamamlar.
8.14. Güven Aralığında Örnekleme Tasarımının Rolü
Bir güven aralığı, gözlenen örneklemden hareketle bilinmeyen parametreyi tahmin etme yöntemidir; belirli bir hesaplanmış aralığın parametreyi içerme olasılığı olarak koşulsuz yorumlanmamalıdır. Klasik sıkçı çerçevede güven düzeyi, aynı prosedür bağımsız örneklemler üzerinde yinelendiğinde oluşturulan aralıkların uzun dönem kapsama oranıdır. Bu yorumun geçerliliği rastgele örnekleme, uygun dağılım varsayımları ve hesaplanan standart hataya bağlıdır.
Örneğin bağımsız gözlemlerde örneklem ortalamasının standart hatası \(s/\sqrt{n}\) olarak tahmin edilebilir; ancak aynı kullanıcının bin olayını bin bağımsız gözlem saymak varyansı yapay biçimde küçültebilir. Küme içi bağımlılık, zaman serisi otokorelasyonu ve seçim yanlılığı daha fazla veri bulunmasına rağmen yanıltıcı dar aralıklar üretir. Bağımlılık yapısına uygun kümelemeli veya blok-temelli yeniden örnekleme yöntemleri düşünülmelidir; bunların seçimi de veri üretim sürecine bağlıdır.
Rapor, nokta tahmini, güven düzeyi, kullanılan standart hata yöntemi, etkin örneklem birimi ve eksik veri politikasıyla birlikte verilmelidir. İstatistiksel anlamlılık ile uygulama açısından önemli etki büyüklüğü aynı kavram değildir. Dar güven aralığı örnekleme çerçevesindeki sistematik kapsama hatasını kendiliğinden gidermez.
8.15. Frekans Sınıfları, Bilgi Kaybı ve Dağılımı Temsil Etme
Sürekli nicel gözlemleri frekans tablosuna dönüştürürken sınıf sayısı ve aralık genişliği histogramın görünümünü değiştirir. Sturges kuralı k ≈ 1 + log2(n) gibi bir başlangıç noktası sağlayabilir; ancak çok büyük, ağır kuyruklu veya çok tepeli veri kümelerinde tek uygun seçim değildir. Eşit genişlikli sınıflar uç değerleri bastırabilir, eşit frekanslı sınıflar ise fiziksel ölçekte farklı çözünürlükler yaratır.
Sınıflandırılmış veriden hesaplanan ortalama, varyans veya yüzdelikler çoğu durumda ham verideki değerlerin yaklaşık karşılıklarıdır. Özellikle dağılım kuyruğundaki nadir olaylar kritik sistemlerde önem taşıdığından p95/p99 ve aşım olasılığı analizi mümkün olduğunca kaynak gözlemler üzerinden yapılır. Grafik sunumu için kullanılan bin seçimi, istatistiksel tahmin yönteminin kendisiyle karıştırılmaz.
Ünite 9: Regresyon, Korelasyon ve Hipotez Sınaması
9.1. Saçılım Diyagramı
İki nicel değişken arasındaki ilişkiyi incelemenin ilk adımı saçılım diyagramıdır. Doğrusal olmayan yapı, aykırı gözlem ve değişen yayılım çoğu zaman burada görülür.
9.2. Doğrusal Regresyon
Y = a + bX + εEn küçük kareler kestirimleri:
b = Σ[(xᵢ−x̄)(yᵢ−ȳ)] / Σ(xᵢ−x̄)²
a = ȳ − b·x̄b, X bir birim arttığında Y için beklenen doğrusal değişimi verir.
Sayım verisinde doğrusal regresyon kullanmak, negatif tahminler ve ortalama arttıkça değişen varyans nedeniyle sorun yaratabilir. Poisson modelinde koşullu ortalama ile varyans eşittir; gözlenen varyans ortalamadan sistematik biçimde büyükse aşırı saçılma araştırılmalıdır. Örneğin bir vardiyadaki olay sayısının ortalaması 4, örnek varyansı 19 ise Poisson varsayımı sorgulanmalıdır; fakat bu iki özet tek başına negatif binom modelinin doğru olduğunu kanıtlamaz. Sıfır fazlalığı, kayıt sürelerinin farklılığı ve ortak etkiler ayrıca incelenmelidir. Model seçimi yalnız uyum metriğine değil, verinin nasıl üretildiğine dayanır.
9.3. En Küçük Kareler Ölçütünün Türetilmesi
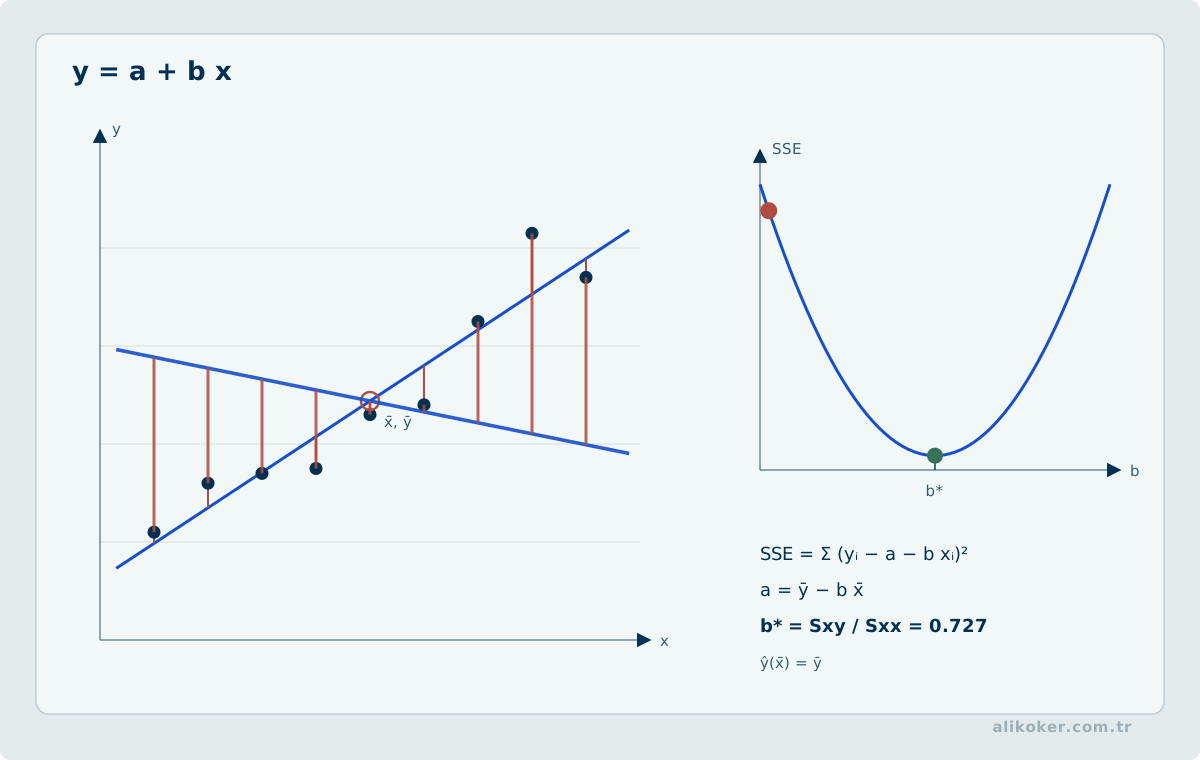
Doğrusal regresyon katsayıları yalnız hazır formüller olarak değil, açık bir optimizasyon probleminden türetilebilir. Gözlem çifti (xᵢ,yᵢ) için model
ŷᵢ = a + b xᵢve artık
eᵢ = yᵢ − ŷᵢolsun. En küçük kareler yöntemi
S(a,b) = Σ eᵢ²
       = Σ [yᵢ − (a + b xᵢ)]²
amaç fonksiyonunu küçültür.
Artıkların doğrudan toplamını küçültmek uygun değildir; pozitif ve negatif artıklar birbirini götürebilir. Kare alma işareti ortadan kaldırır, büyük artıkları daha güçlü cezalandırır ve türevlenebilir bir konveks amaç fonksiyonu üretir. Bu tercih her veri üretim süreci için zorunlu tek kayıp fonksiyonu olduğu anlamına gelmez; yalnızca klasik doğrusal en küçük karelerin tanımıdır.
İç noktadaki minimum için kısmi türevler sıfırlanır:
∂S/∂a = −2 Σ [yᵢ − a − b xᵢ] = 0
∂S/∂b = −2 Σ xᵢ[yᵢ − a − b xᵢ] = 0
Bunlar normal denklemleri verir:
n a + b Σxᵢ       = Σyᵢ
a Σxᵢ + b Σxᵢ²    = Σxᵢyᵢ
xᵢ değerlerinde değişkenlik varsa sistemin çözümü
b = Σ[(xᵢ−x̄)(yᵢ−ȳ)] / Σ(xᵢ−x̄)²
a = ȳ − b x̄
biçimindeki bilinen katsayılara indirgenir.
Bir sabit terim bulunan sıradan en küçük kareler çözümünde birinci mertebe koşulları şu iki ortogonallik sonucunu da verir:
Σeᵢ = 0
Σxᵢeᵢ = 0
Dolayısıyla artıkların örneklem toplamı sıfırdır ve artık vektörü sabit sütun ile açıklayıcı değişken sütununa diktir. Ayrıca uydurulan doğru (x̄,ȳ) noktasından geçer. Bunlar sonuçtan sonra kullanılabilecek güçlü cebirsel kontrol koşullarıdır.
Matris biçiminde
y = Xβ + ε
S(β) = ||y − Xβ||²
yazılır ve gradyanın sıfırlanması
XᵀX β = Xᵀynormal denklem sistemini verir. X tam sütun rankına sahipse çözüm tektir. Teorik olarak β=(XᵀX)⁻¹Xᵀy yazılabilse de sayısal uygulamada XᵀX matrisini açıkça kurup terslemek koşulluluğu kötüleştirebilir. Büyük veya kötü koşullu problemlerde QR ya da SVD tabanlı çözüm daha güvenilir olabilir; bu ayrıntı Lineer Cebir ve Nümerik Analiz ile doğrudan bağlantılıdır.
9.4. Optimizasyon Ölçütü ile İstatistiksel Modelin Ayrımı
En küçük kareler katsayılarının hesaplanabilmesi ile bu katsayılara ilişkin istatistiksel çıkarım aynı problem değildir. S(β) amaç fonksiyonunu minimize etmek için hataların normal dağılması gerekmez. Buna karşılık standart hata, güven aralığı ve klasik küçük örneklem t/F sonuçlarının yorumlanması kullanılan olasılıksal modelin varsayımlarına bağlıdır.
Klasik doğrusal modelde sıklıkla
E[ε | X] = 0koşulu ile bağımsızlık veya uygun bağımlılık modeli ve sabit varyans gibi varsayımlar ayrıştırılır. Koşullu hataların sabit varyanslı normal dağıldığı özel durumda en küçük kareler katsayıları aynı zamanda Gaussian olabilirlik altında maksimum olabilirlik kestirimidir.
Bu nedenle şu iki cümle eşdeğer değildir:
- "En küçük kareler doğrusu hesaplandı."
- "Modelin istatistiksel varsayımları doğrulandı."
İkinci ifade için artık yapısı, değişen varyans, bağımlılık, etkili gözlemler, örnekleme süreci ve model belirtimi ayrıca incelenmelidir.
9.5. Korelasyon
Pearson korelasyon katsayısı:
r = Σ[(xᵢ−x̄)(yᵢ−ȳ)]
    / √[Σ(xᵢ−x̄)² · Σ(yᵢ−ȳ)²]
−1 ≤ r ≤ 1.
r≈0, doğrusal ilişkinin zayıf olduğunu gösterir; doğrusal olmayan ilişkiyi dışlamaz.
Aykırı değerlere veya sıralı yapıya duyarlılık önemliyse Spearman sıra korelasyonu değerlendirilebilir.
Korelasyon nedensellik değildir.
Korelasyon katsayısı ilişkinin yönünü ve doğrusal biçimdeki gücünü özetler; müdahale etkisi veya nedensel mekanizma ortaya koymaz. Örneğin üretim yoğunluğu arttığında hem elektrik tüketimi hem de arıza kaydı artabilir. İki son değişken arasındaki pozitif korelasyon, elektrik tüketimindeki artışın doğrudan arızayı oluşturduğu sonucunu vermez; yoğunluk ortak neden olabilir. İki değişken arasındaki ilişkiyi çoklu regresyonda başka kovaryatlara göre düzeltmek de ölçülmemiş karıştırıcıları otomatik ortadan kaldırmaz. Bilimsel raporda hipotez, veri üretim mekanizması, olası alternatif açıklamalar ve gözlemsel bulgu ile müdahale iddiası arasındaki sınır açık tutulmalıdır.
9.6. Belirlilik Katsayısı
Basit doğrusal regresyonda:
R² = 1 − SSE/SSTModelin gözlenen değişkenliğin ne kadarını açıkladığını özetler. Yüksek R², modelin doğru, nedensel veya genellenebilir olduğunu tek başına göstermez.
9.7. Artıklar
eᵢ = yᵢ − ŷᵢArtıkların sistematik örüntü göstermesi model sorununa işaret edebilir.
- Eğrilik: doğrusal model yetersiz olabilir.
- Yayılımın değişmesi: değişen varyans olabilir.
- Zaman boyunca düzenlilik: otokorelasyon olabilir.
Aykırı gözlem ile etkili gözlem aynı değildir. Kaldıraç ve Cook uzaklığı, regresyon katsayılarını güçlü biçimde etkileyen gözlemleri incelemeye yardım eder.
9.8. Çoklu Regresyon
Y = β₀ + β₁X₁ + ... + βₖXₖ + εBir katsayı, diğer açıklayıcı değişkenler modelde sabit tutulduğunda ilgili değişkenle bağlantılı koşullu doğrusal değişimi ifade eder.
Açıklayıcı değişkenler arasındaki güçlü doğrusal ilişki çoklu doğrusal bağlantı oluşturabilir. Varyans şişirme faktörü bu yapıyı inceleyen tanı ölçülerindendir; tek başına otomatik değişken eleme kuralı değildir.
9.9. Hipotez Sınaması
Boş hipotez H₀, test edilen temel varsayımı; alternatif hipotez H₁, karşı seçeneği gösterir.
p-değeri, H₀ ve kullanılan model doğru kabul edildiğinde gözlenen test istatistiği kadar veya daha uç bir sonucun elde edilme olasılığıdır.
p-değeri:
P(H₀ | veri)değildir.
Küçük p-değeri etkinin büyük, önemli veya nedensel olduğunu göstermez. Büyük p-değeri de eşitliği kanıtlamaz.
Bir p değeri, sıfır hipotezi ve model varsayımları altında gözlenen kadar veya daha uç bir sınama istatistiğinin elde edilme olasılığına dayanır; sıfır hipotezinin doğru olma olasılığı değildir. Örneğin büyük bir örneklemde çok küçük bir ortalama farkı istatistiksel olarak anlamlı bulunabilir, fakat uygulamada önemsiz kalabilir. Bu nedenle raporda sınama istatistiği, etki büyüklüğü, güven aralığı, örnekleme tasarımı ve önceden belirlenmiş karar eşiği birlikte yer almalıdır. %95 güven aralığının frekansçı yorumu, aynı yöntem tekrar uygulandığında elde edilen aralıkların uzun dönemde yaklaşık %95'inin sabit parametreyi kapsamasıdır; hesaplanmış belirli bir aralığa sonradan %95 parametre olasılığı atanmaz.
Wald testi parametre kestiriminin standart hataya göre standartlaştırılmasına; score testi sıfır hipotezi altındaki olabilirlik eğimine; olabilirlik oranı testi ise kısıtlı ve kısıtsız modellerin en yüksek log-olabilirlik değerlerinin farkına dayanır. Üç test, uygun düzenlilik koşullarında büyük örneklemde benzer sonuçlara yaklaşabilir; küçük örneklemde, sınır parametrelerinde veya model yanlış tanımlandığında eşdeğer olmaları beklenmez.
Neyman–Pearson yaklaşımı, belirlenmiş iki basit hipotez arasında seçilen anlamlılık düzeyinde güçlü bir test kurar; her bileşik hipotez problemi için tek bir evrensel en güçlü test sunmaz. Test gücü, örneklem büyüklüğü ve etkinin yanında varyansa ve sınama kuralına da bağlıdır. Bayes faktörü hipotezler altındaki marjinal olabilirlikleri karşılaştırır; p-değeriyle aynı olasılığın farklı gösterimi değildir. Nedensel yorum için ayrıca müdahale, karıştırıcı ve seçim mekanizmalarının varsayımları gerekir.
9.10. Etki Büyüklüğü
İstatistiksel anlamlılık ile etkinin büyüklüğü ayrıdır.
İki grup için standartlaştırılmış ortalama farkının temel biçimi:
d = (x̄₁ − x̄₂) / s_pooledHam fark, etki büyüklüğü ve güven aralığı birlikte daha anlamlıdır.
9.11. t-testi ve Varyans Analizi
İki bağımsız grubun ortalamaları için t-testi kullanılır. Varyans eşitliği güvenle varsayılamıyorsa Welch t-testi tercih edilebilir.
Üç veya daha fazla grubun ortalamaları için tek yönlü varyans analizi:
F = gruplar arası değişkenlik / grup içi değişkenlikAnlamlı F, bütün grup ortalamalarının eşit olduğu modelle uyuşmaz; hangi grupların farklı olduğunu tek başına göstermez.
Bağımsız gruplarla aynı kişilerin önce–sonra ölçümleri farklı veri üretim süreçleridir. Eşleştirilmiş t sınaması, iki ölçümün bağımsız olduğunu değil kişi içi farkların dağılımına ilişkin koşulları inceler. Bağımsız iki grupta varyansların eşit kabul edilmesi gerekmediğinde Welch yaklaşımı yararlıdır; Levene sınaması tek başına bütün yöntem seçimini otomatikleştiren anahtar değildir. Ki-kare bağımsızlık sınamasında beklenen hücre frekansları ve gözlemlerin bağımsızlığı, Pearson korelasyonunda doğrusal ilişki ile aykırı gözlemlerin etkisi ayrıca değerlendirilir. Test seçimi veri dosyasının uzantısından veya yalnızca değişkenlerin ekranda sayısal görünmesinden türetilemez.
9.12. Ki-kare Bağımsızlık Testi
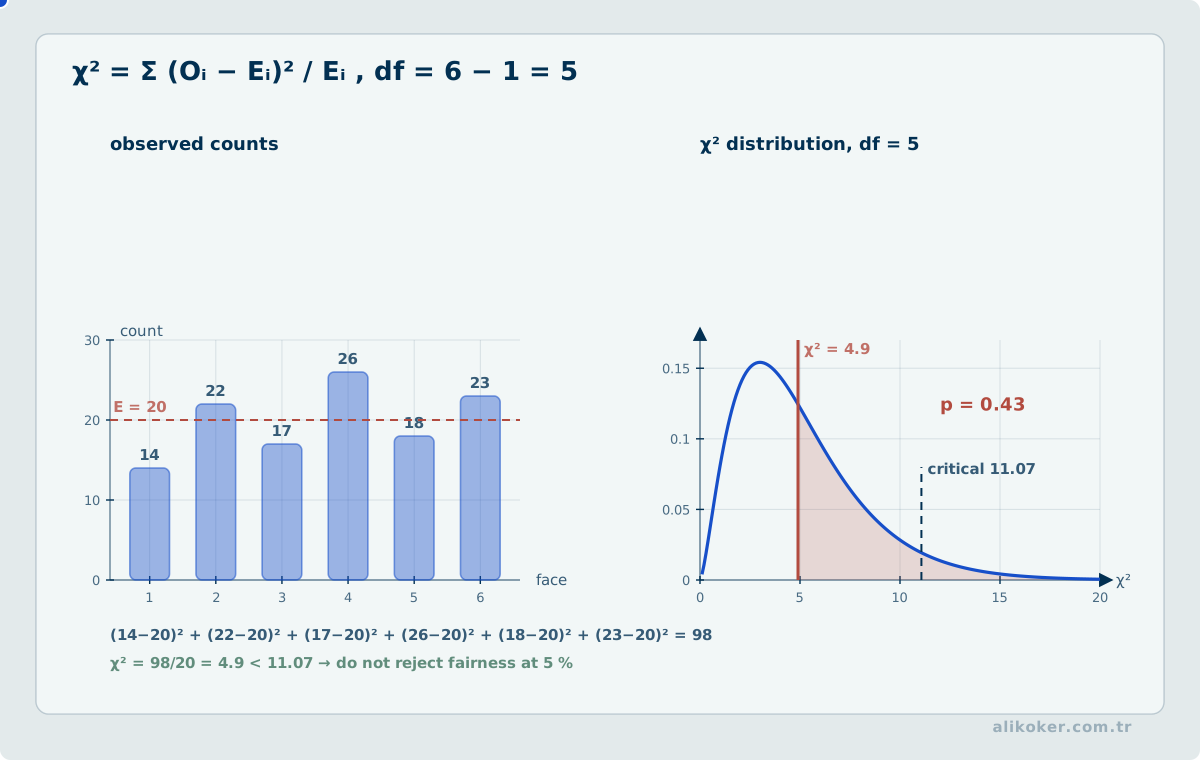
İki kategorik değişken için beklenen hücre frekansı:
Eᵢⱼ = (satır toplamıᵢ · sütun toplamıⱼ) / genel toplamPearson ki-kare istatistiği:
χ² = Σ (Oᵢⱼ − Eᵢⱼ)² / Eᵢⱼİlişkinin gücü için Phi veya Cramér V kullanılabilir.
Tetrakorik korelasyon, yalnız ikili gözlemlerin altta yatan sürekli ve birlikte normal gizli değişkenlerin eşiklenmiş biçimi olarak modellenmesi anlamlıysa uygundur.
9.13. Çoklu Sınama
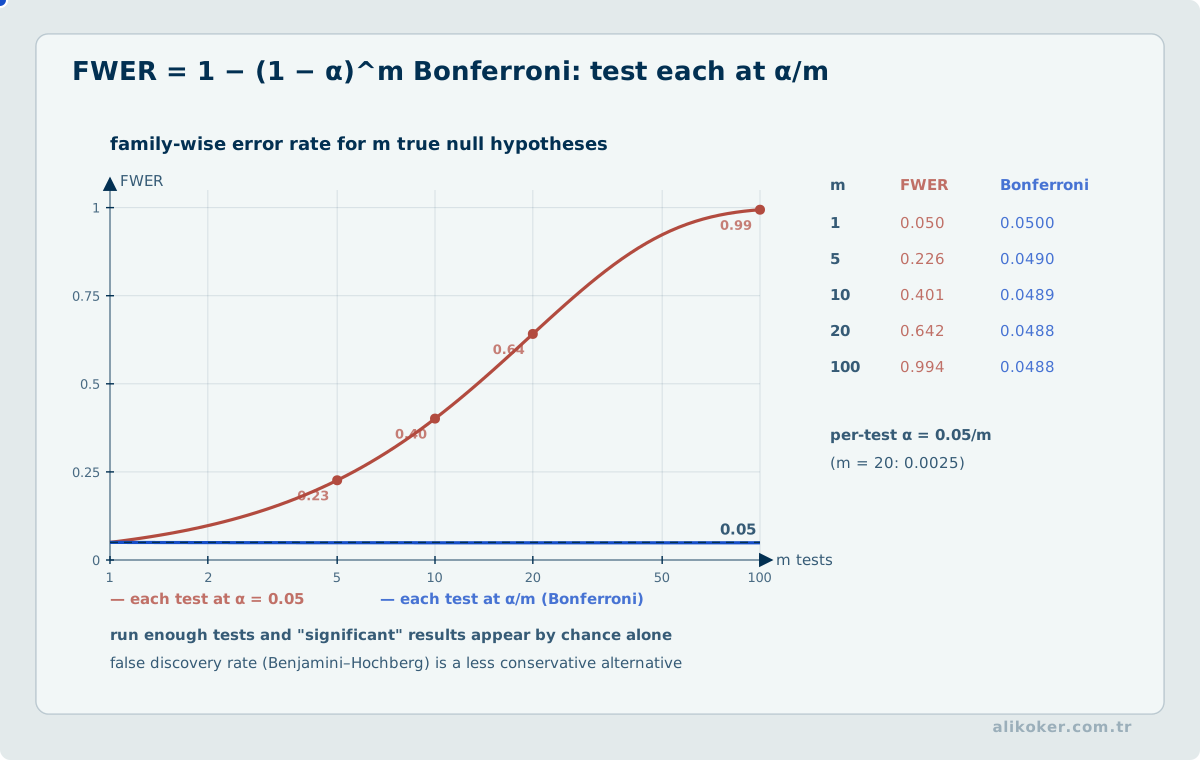
Aynı veri üzerinde çok sayıda hipotez sınamak yanlış pozitif olasılığını artırır. Bonferroni aile düzeyi hata oranını, Benjamini-Hochberg yanlış keşif oranını denetlemek için kullanılan yöntemlerdendir.
9.14. Tip I, Tip II Hata ve Parametrik Olmayan Testler
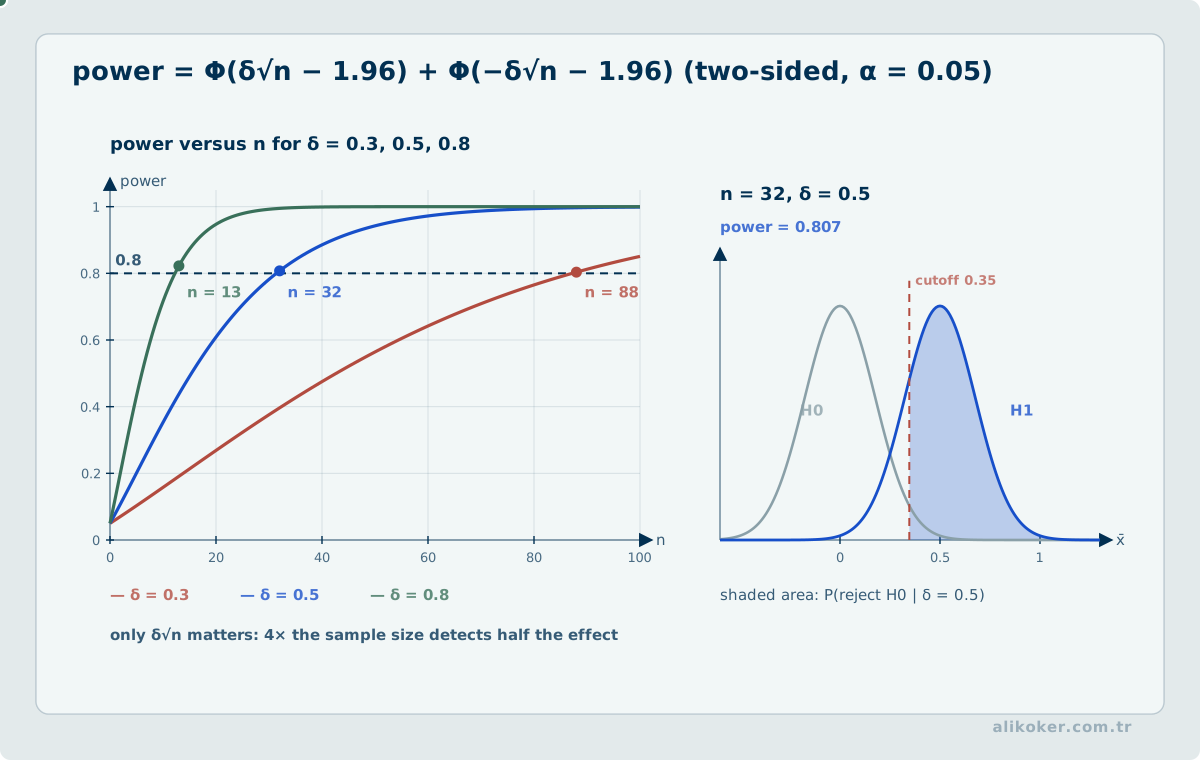
Hipotez testinde iki farklı hata vardır. Tip I hata, doğru sıfır hipotezini reddetmek; Tip II hata, yanlış sıfır hipotezini reddedememektir. alpha Tip I hata kontrolüyle, test gücü ise gerçek bir etkiyi yakalama olasılığıyla ilişkilidir.
p değeri, sıfır hipotezinin doğru olma olasılığı değildir. Sıfır hipotezi ve test varsayımları altında gözlenen kadar veya daha uç bir test istatistiğinin olasılığıyla ilgilidir.
Parametrik varsayımlar uygun değilse sıra veya ampirik dağılım temelli yöntemler kullanılabilir. Mann-Whitney iki bağımsız grubun, Wilcoxon eşleştirilmiş ölçümlerin, Kruskal-Wallis ikiden fazla grubun ve Kolmogorov-Smirnov dağılım farkının incelenmesinde kullanılan yöntem ailelerindendir. Test seçimi yalnız "normal değil" kararına değil, örnek bağımlılığına, ölçüm ölçeğine ve test edilen hipoteze göre yapılmalıdır.
9.15. Yeniden Örnekleme ve Benzetim
Analitik dağılımın bilinmediği veya kapalı form hesabın zor olduğu durumlarda verinin kendisinden yeniden örnekleme yapmak ya da rastgele benzetim kullanmak belirsizliği nicel olarak incelemeye yardımcı olur.
9.15.1. Bootstrap
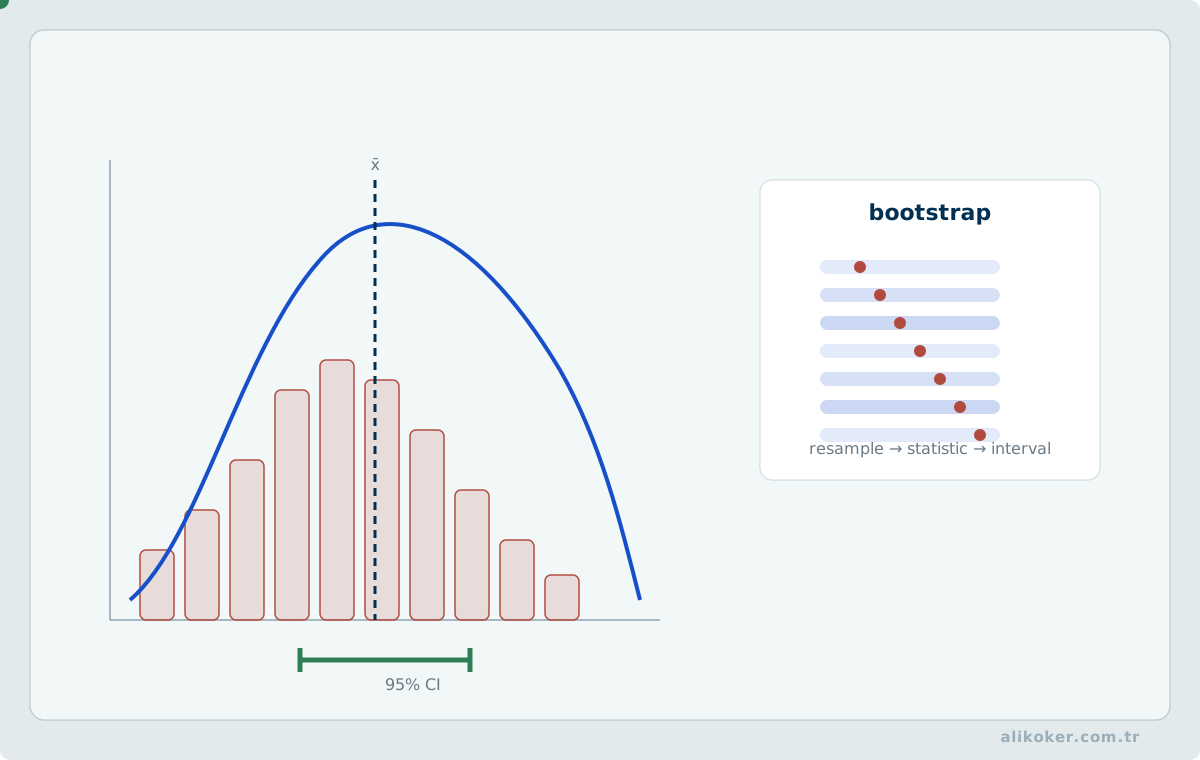
Bootstrap, gözlenen n örnekten yerine koyarak tekrar n gözlem seçer ve ilgilenilen istatistiği her yeniden örnek üzerinde hesaplar.
orijinal örnek
   ↓ yerine koyarak örnekle
bootstrap örneği 1 -> θ1
bootstrap örneği 2 -> θ2
...
bootstrap örneği B -> θB
θ dağılımı standart hata veya güven aralığı hakkında ampirik bilgi sağlar. Bootstrap veri üretim sürecindeki sistematik yanlılığı ortadan kaldırmaz; örneğin örnek temsil edici değilse yeniden örnekleme bu eksikliği çoğaltır.
Parametrik bootstrap, seçilen olasılık modelinden yeniden örnekler; parametrik olmayan bootstrap ise çoğunlukla gözlenen birimleri iade ederek örnekler. Birbirinden bağımsız ve aynı dağılımlı gözlem varsayımı geçerli değilse, örnekleme birimi doğru seçilmelidir. Zaman serilerinde blok bootstrap, kümeli veride küme bazlı örnekleme, tekil gözlemleri bağımsız kabul eden sıradan yeniden örneklemeden farklı belirsizlik sonuçları verir.
Bootstrap dağılımından standart hata, yanlılık ve güven aralığı hesaplanabilir. Yüzdelik, studentized veya yanlılık-düzeltilmiş güven aralıkları farklı varsayım ve doğruluk özelliklerine sahiptir; uçta kalan kestiricilerde ya da çok küçük örneklemlerde hepsi güvenilir değildir. Model seçimi veri üzerinde gerçekleştirildiyse yalnız son modeli yeniden örneklemek, seçim aşamasının belirsizliğini eksik değerlendirebilir.
9.15.2. Permütasyon Testi
İki grup arasında fark olmadığı sıfır hipotezi altında grup etiketleri değiştirilebilir kabul ediliyorsa etiketler karıştırılarak test istatistiğinin null dağılımı oluşturulabilir.
Bu yaklaşım parametrik dağılım varsayımını azaltabilir; fakat exchangeability koşulu sağlanmıyorsa geçerli değildir.
9.15.3. Monte Carlo Benzetimi
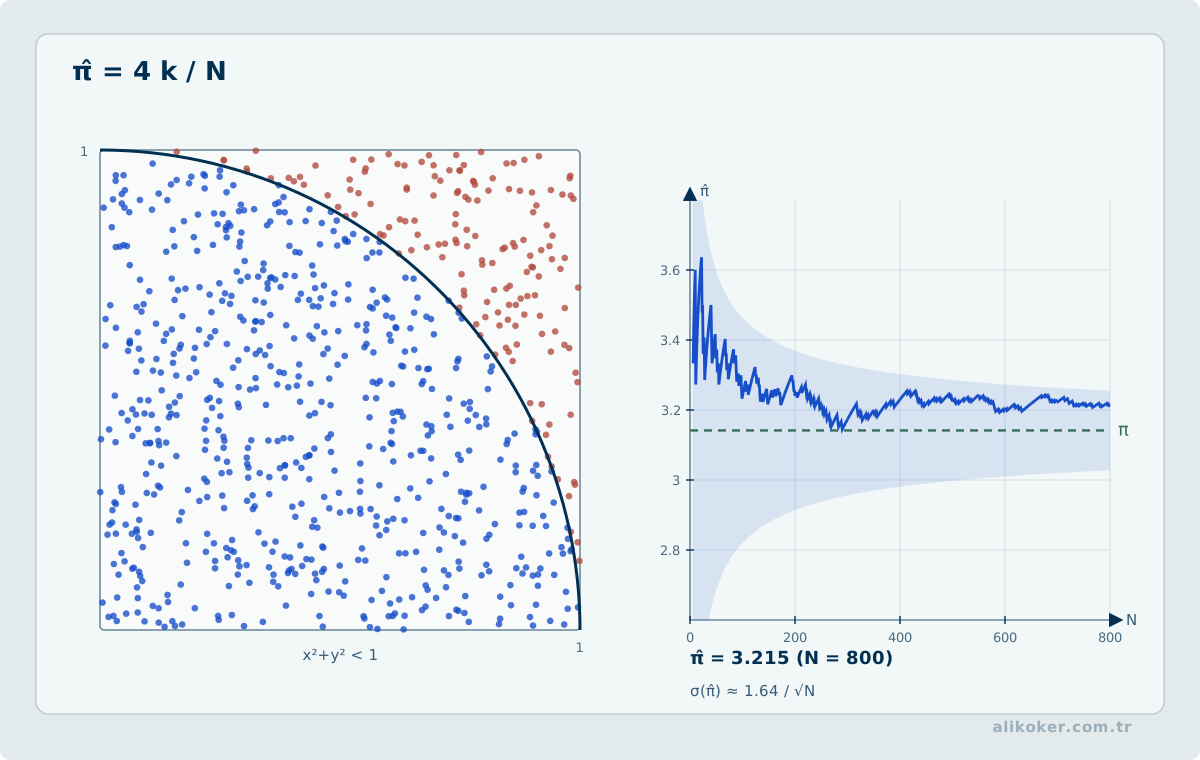
Bir çıktı birçok rastgele girdiye bağlıysa analitik dağılım yerine tekrar eden benzetim kullanılabilir:
girdileri dağılımlarından örnekle
        ↓
modeli çalıştır
        ↓
çıktıyı kaydet
        ↓
N kez tekrarla
Sonuç dağılımı başarısızlık olasılığı, beklenen değer veya kuyruk davranışı gibi niceliklerin yaklaşık hesabında kullanılabilir.
Monte Carlo hatası örnek sayısıyla azalır; fakat model hatası örnek sayısı artırılarak giderilemez. Çok sayıda simülasyon yanlış modeli yalnız daha hassas biçimde simüle eder.
9.15.4. İstatistiksel Güç
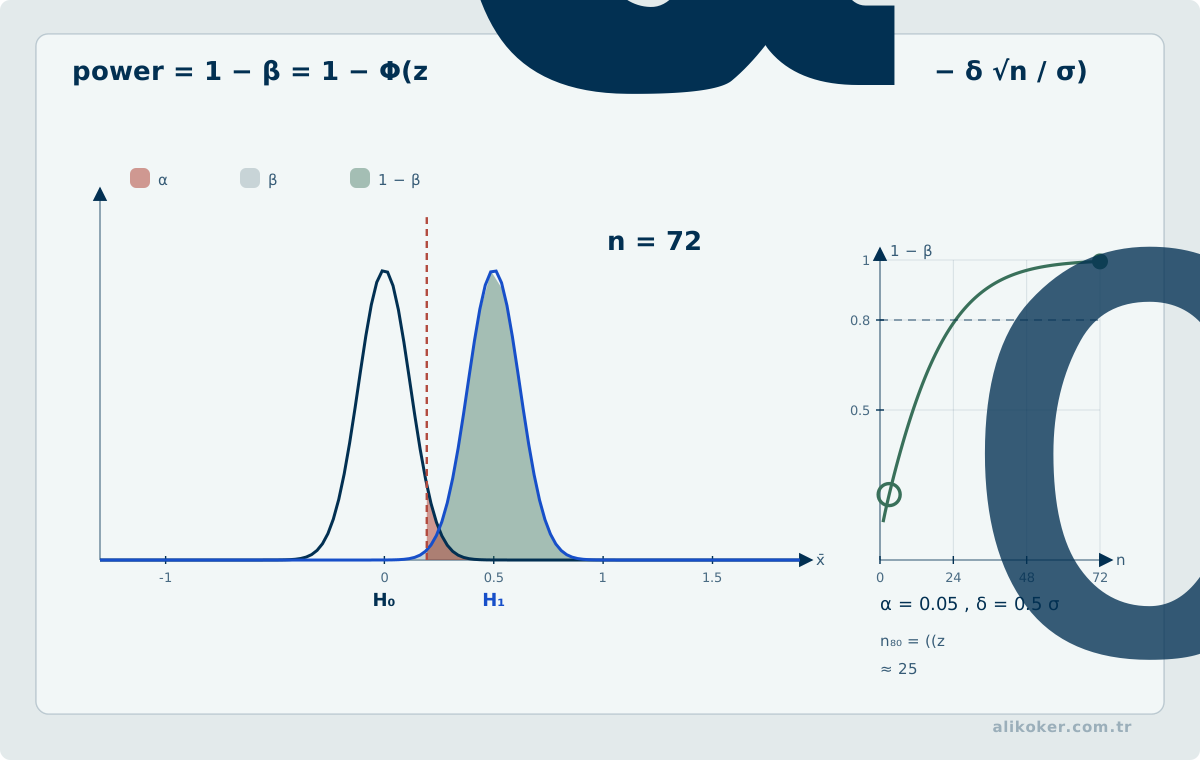
Bir testin anlamlı sonuç üretmemesi "etki yok" ile eş anlamlı değildir. Örnek sayısı, etki büyüklüğü, varyans ve seçilen anlamlılık düzeyi testin gerçek bir etkiyi saptama olasılığını belirler.
Çalışma tasarımında:
etki büyüklüğü
+ gürültü/varyans
+ örnek sayısı
+ alfa
-> güç
ilişkisi birlikte düşünülmelidir.
Yeniden örnekleme ve benzetim, klasik formüllerin yerine otomatik olarak geçmez. Ama varsayımların kırılgan olduğu veya türetilmiş istatistiğin dağılımının zor olduğu durumlarda belirsizliği görünür kılan güçlü doğrulama araçlarıdır.
Ünite 10: Stokastik Süreçler ve Markov Zincirleri
10.1. Rastgele Değişkenden Rastgele Sürece
Tek bir rastgele değişken bir deneyin tek bir sayısal sonucunu modeller. Zaman, konum veya başka bir indis boyunca gelişen belirsiz davranışta ise tek değişken yeterli değildir. Stokastik süreç, aynı olgunun farklı indislerdeki rastgele değişkenlerinden oluşan bir ailedir.
X0, X1, X2, ...İndis zaman olduğunda Xt, sistemin t anındaki durumunu veya ölçümünü temsil edebilir. İndis ayrık ya da sürekli, durum uzayı da kesikli ya da sürekli olabilir. Bu iki ayrım birbirinden bağımsızdır.
Mühendislikte stokastik süreçler; kuyruk uzunluğu, arıza durumu, ağ yükü, kullanıcı oturumu, sensör ölçümü ve talep gibi zaman içinde belirsizlik taşıyan büyüklükleri modellemek için kullanılır.
10.2. Markov Özelliği
Bir süreçte gelecek durumun koşullu dağılımı, geçmişin tamamı bilindiğinde yalnız mevcut duruma bağlı kabul ediliyorsa Markov özelliği kullanılır.
gelecek | bugün, geçmiş = gelecek | bugünBu eşitlik fiziksel dünyanın evrensel bir yasası değildir. Modelleme varsayımıdır. Gerçek sistemde geçmişin etkisi mevcut durumda yeterince temsil edilmiyorsa Markov modeli bilgi kaybeder. Böyle bir durumda durumu genişletmek veya daha zengin bir zaman modeli kullanmak gerekir.
10.3. Geçiş Olasılıkları ve Geçiş Matrisi
Sonlu durumlu ayrık zamanlı Markov zincirinde bir durumdan diğerine geçiş olasılıkları bir matrisle gösterilebilir. Üç durumlu bir örnek:
          sonraki durum
          A     B     C
şimdiki A 0.80  0.15  0.05
        B 0.20  0.60  0.20
        C 0.10  0.25  0.65
Her satır, mevcut durum sabitken sonraki durumların olasılık dağılımıdır ve toplamı 1 olmalıdır. Bu nedenle geçiş matrisi satır-stokastiktir.
Başlangıç durum dağılımı bir satır vektörüyle gösterildiğinde bir adım sonraki dağılım:
pi_next = pi_current * Pşeklinde bulunur. İki veya daha fazla adımlı geçişler aynı matrisin ardışık uygulanmasıyla elde edilir:
iki adım  -> P * P
dört adım -> P * P * P * P
Bu gösterim tek bir geleceği kesin olarak tahmin etmez; olası durumların dağılımını taşır.
10.4. Durağan Dağılım
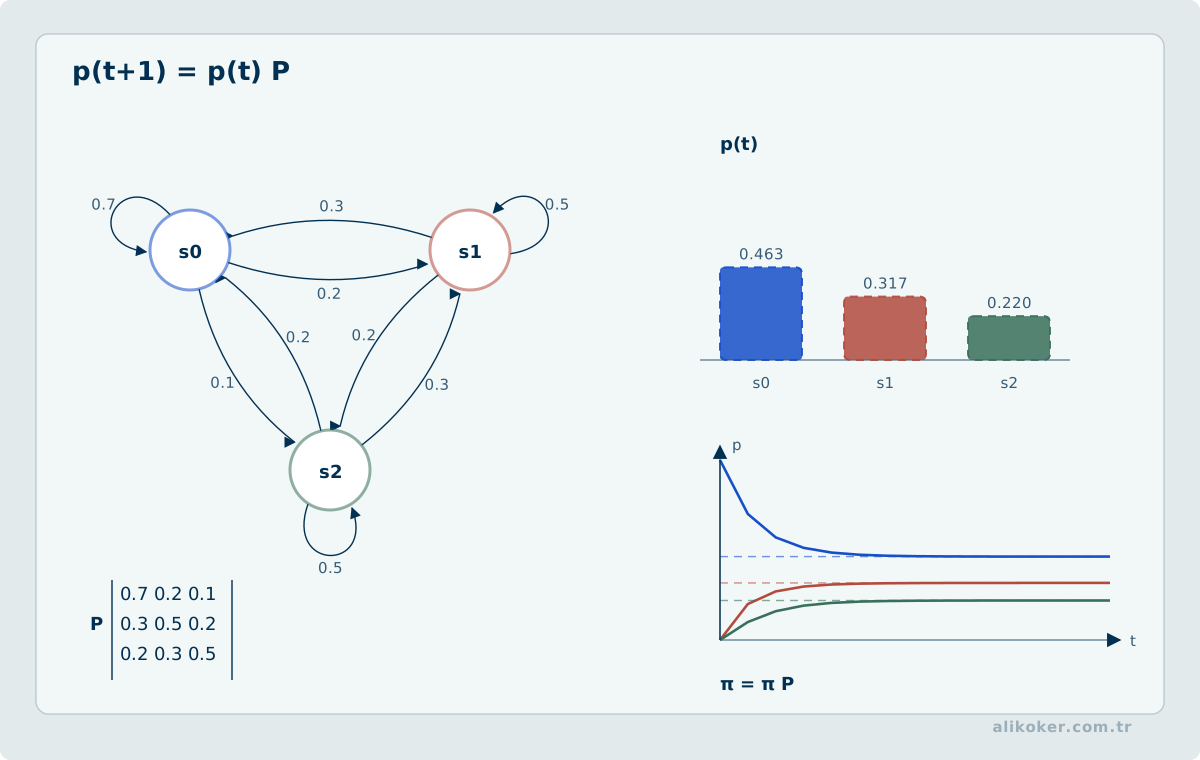
Bir dağılım geçişten sonra değişmiyorsa durağan dağılımdır:
pi = pi * PDurağan dağılım uzun dönem davranışını özetlemek için yararlıdır; ancak her zincirin tek bir durağan dağılıma yakınsayacağı varsayılmamalıdır. Erişilebilirlik, indirgenebilirlik ve periyodiklik gibi yapısal özellikler yakınsama davranışını belirler.
Bir zincirde bütün durumların birbirine uygun sayıda adımla ulaşabilmesi indirgenemezlik fikrini, dönüşlerin tek bir ortak dönem tarafından zorlanmaması ise aperiyodiklik fikrini verir. Bu özellikler sonlu zincirlerde uzun dönem davranışını değerlendirirken önemlidir.
10.5. Soğurucu Durumlar
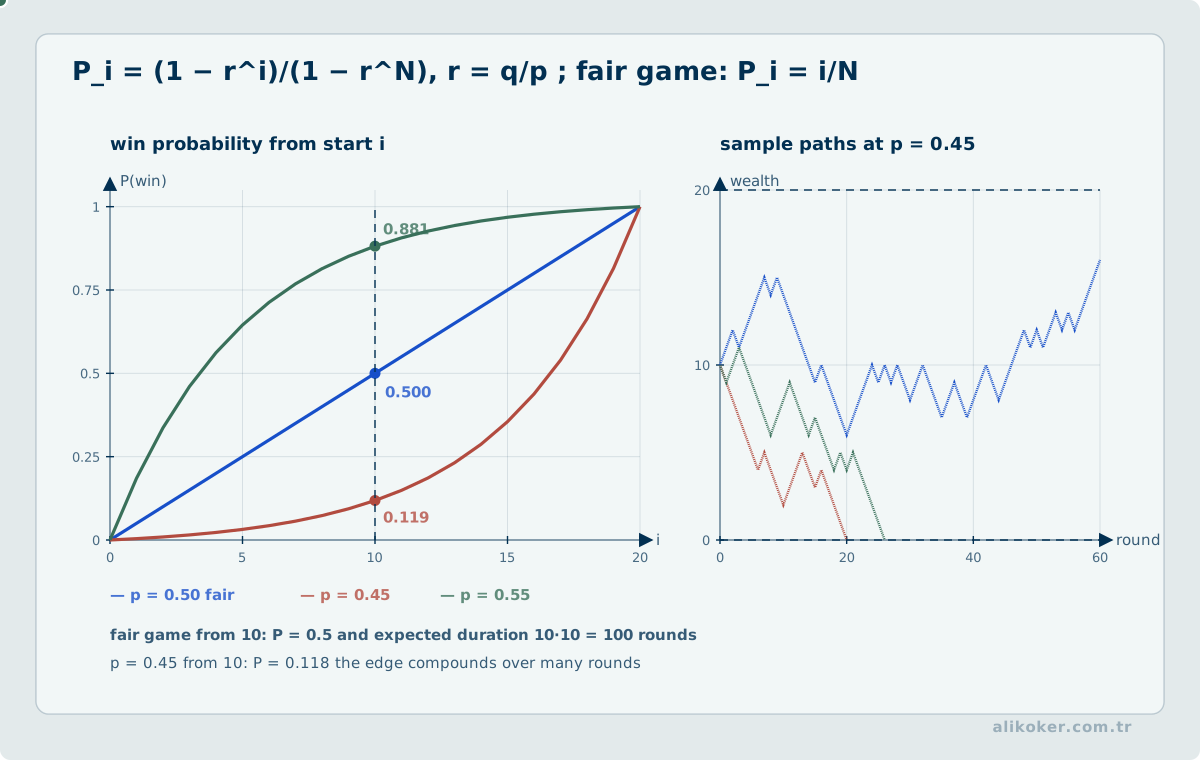
Kendisine girildiğinde çıkış olasılığı sıfır olan durum soğurucu durum olarak ele alınabilir:
A -> A olasılığı = 1Arıza, tamamlanma, iptal veya geri dönülmeyen başka bir durum bu biçimde modellenebilir. İncelenen soru yalnız son durumun ne olduğu değil, o duruma ulaşma olasılığı ve beklenen geçiş sayısı da olabilir.
10.6. Modelleme Sınırı
Markov zinciri gözlenen sıralı veriye geçiş yüzdeleri hesaplayıp isim vermekten ibaret değildir. Önce durumların neyi temsil ettiği, gözlemlerin hangi zaman çözünürlüğünde üretildiği ve süreçteki bağımlılığın mevcut durumla gerçekten temsil edilip edilemediği açıklanmalıdır.
Aynı veri farklı durum tanımlarıyla farklı zincirler üretir. Bu nedenle güvenli sıra şöyledir:
durum tanımı
→ gözlem ve zaman ölçeği
→ geçişlerin sayılması
→ geçiş olasılıklarının kestirimi
→ yapısal özelliklerin denetimi
→ uzun dönem veya soğurma analizi
→ alan bilgisiyle yorum
Markov modeli betimleyici veya kestirimsel bir araç olabilir; tek başına nedensellik kanıtı değildir.
10.7. Veri Analizinde Dağılım, Zaman ve Yoğunlaşma
10.7.1. Frekans ve Ampirik Dağılım
Kategori frekansı:
pᵢ = fᵢ / ΣfᵢAmpirik birikimli dağılım:
Fₙ(x) = (1/n)·ΣI(Xᵢ ≤ x)Histogram, dağılımın biçimini sınıf aralıklarıyla gösterir. Görünüm sınıf genişliğine bağlıdır.
10.7.2. Kümülatif Pay ve Yoğunlaşma
Kategori payı:
pᵢ = xᵢ / Σxⱼİlk k kategorinin kümülatif payı:
Cₖ = Σ(i=1..k) pᵢPareto yaklaşımı kümülatif yoğunlaşmayı görmeye yarar; 80/20 oranı evrensel yasa değildir.
Herfindahl-Hirschman endeksi:
HHI = Σpᵢ²Shannon entropisi:
H = −Σpᵢln(pᵢ)Etkin çeşitlilik:
Dₑ = eᴴGini katsayısı eşitsizliği ölçer. HHI, Gini ve entropi farklı özellikleri ölçer; birbirlerinin yerine kullanılmaz.
10.7.3. Zaman Serisi Özetleri
Mutlak değişim:
Δₜ = xₜ − xₜ₋₁Göreli değişim:
rₜ = (xₜ − xₜ₋₁) / xₜ₋₁Payda sıfırsa göreli değişim tanımsızdır.
Hareketli ortalama:
MAₜ = (1/m)·Σ(i=0..m−1)xₜ₋ᵢPencere büyüdükçe seri daha düzgün görünür ancak ani değişime tepki gecikir.
Ardışık farkların standart sapması kısa dönemli oynaklığın basit bir göstergesidir:
jitter = SD(xₜ − xₜ₋₁)Zaman indeksine göre doğrusal eğim:
xₜ = a + b·t + εₜb yönü ve doğrusal değişim hızını özetler; nedensellik göstermez.
Günlük, saatlik ve haftanın günlerine göre profiller takvim kaynaklı dönemsel yapıları ayırmaya yardım eder.
10.7.4. Tekil Sapma, Yerel Düzey ve Kalıcı Değişim
Bir zaman serisinde tek bir yüksek değer, yakın dönemde yükselen genel düzey ve kalıcı bir rejim değişimi aynı problem değildir. Bunları tek bir "anomali puanı" altında toplamak yorum kolaylığı sağlıyor gibi görünse de hangi davranışın ölçüldüğünü belirsizleştirir.
Aykırı değerlere dayanıklı bir başlangıç için merkez medyanla, yayılım ise medyan mutlak sapmayla ölçülebilir:
m = median(x)
MAD = median(|x_i - m|)
Normal dağılımla karşılaştırılabilir bir ölçek gerektiğinde robust standart sapma yaklaşık olarak:
sigma_r = MAD / 0.6745ve tek bir gözlemin robust sapması:
z_r = (x_t - m) / sigma_rbiçiminde yazılabilir. Bu ölçü özellikle birkaç uç gözlemin ortalama ve standart sapmayı sürüklediği serilerde yararlıdır. Ancak MAD = 0 olması mümkündür. Bu durumda formül körlemesine uygulanmamalı; veri yapısına göre daha uzun geçmiş, alternatif yayılım ölçüsü veya açıkça belirtilmiş bir geri dönüş (fallback) yöntemi kullanılmalıdır.
Yakın dönem düzeyini izlemek için üstel ağırlıklı hareketli ortalama (EWMA), en yeni gözleme daha yüksek, eski gözlemlere geometrik olarak azalan ağırlık verir:
E_t = lambda * x_t + (1 - lambda) * E_(t-1)
0 < lambda <= 1
lambda büyüdükçe seri yeni gözleme daha hızlı tepki verir; küçüldükçe daha fazla yumuşar. Örneğin lambda = 0.30, son gözlemi önemli tutarken geçmişi tamamen silmeyen bir yerel baseline üretir. EWMA bir tahmin modeli olmak zorunda değildir; yalnızca serinin yakın dönem seviyesini görünür kılmak için de kullanılabilir. Geometrik hareketli ortalama kontrol yaklaşımının klasik kaynaklarından biri S. W. Roberts'ın 1959 tarihli çalışmasıdır: https://doi.org/10.1080/00401706.1959.10489860
Tek tek büyük sıçramalardan çok küçük fakat sürekli kaymaları ararken CUSUM farklı bir soru sorar. Robust merkez ve ölçekle standartlaştırılmış değer:
z_t = (x_t - m) / sigma_rolsun. İki yönlü birikim:
S+_t = max(0, S+_(t-1) + z_t - k)
S-_t = min(0, S-_(t-1) + z_t + k)
biçiminde izlenebilir. k, önemsiz küçük dalgalanmaların ne kadarının tolere edileceğini; h ise sinyal eşiğini belirler. Böylece tek bir uç değer kısa süre sonra unutulabilirken aynı yönde art arda gelen orta büyüklükte sapmalar birikerek görünür hale gelir. CUSUM'un klasik başlangıç noktası E. S. Page'in 1954 tarihli Continuous Inspection Schemes çalışmasıdır: https://doi.org/10.1093/biomet/41.1-2.100
Bu yöntemlerin cevapladığı sorular ayrıdır:
Robust MAD   -> Son gözlem tipik dağılımdan ne kadar uzak?
EWMA         -> Yakın dönem düzeyi nereye yerleşti?
CUSUM        -> Küçük sapmalar aynı yönde birikiyor mu?
Regresyon    -> Uzun dönem doğrusal yön ne kadar belirgin?
Bir sistemde aynı anda dört sonucun da tutulması tek bir birleşik skordan daha açıklanabilirdir. Örneğin son değer robust olarak olağandışı olmayabilir; buna rağmen EWMA yükselmiş ve CUSUM kalıcı artış sinyali üretmiş olabilir. Tersine tek günlük büyük bir sıçrama robust sapma üretirken CUSUM kısa sürede başlangıç düzeyine dönebilir.
Zaman ekseninin kurulması da sonuç kadar önemlidir. İncelenen tarih aralığı biliniyorsa hiç olay gerçekleşmeyen günleri veri kümesinden tamamen çıkarmak yerine 0 gözlem olarak seriye katmak çoğu operasyonel sayım probleminde daha doğrudur. Yalnız aktif günlerden hesaplanan baseline, sessiz dönemleri görünmez hale getirerek tipik düzeyi yapay biçimde yükseltebilir. Buna karşılık sistemin gerçekten veri üretmediği, eksik aktarılan veya kapsam dışında kalan günler 0 sayılmamalıdır; sıfır gözlem ile eksik gözlem aynı şey değildir.
10.7.5. Dönem Paylarının Doğru Hesaplanması
Günlük yüzdelerin basit ortalaması, gün toplamları farklıysa dönem payını vermez.
Doğru dönem payı:
P = Σ(kategori değeri) / Σ(genel toplam)Oranlar, ham paydaları dikkate alınmadan toplanamaz veya doğrudan ortalanamaz.
10.7.6. Veri Kalitesi ve Payda
Ayrı tutulması gereken üç sayı:
fiziksel kayıt sayısı
mantıksal gözlem sayısı
analize uygun gözlem sayısı
Aynı olayı temsil eden yinelenen fiziksel kayıtları doğrudan saymak paydayı büyütebilir. Gerçekten ayrı olayları yanlış tekilleştirmek ise bilgi kaybettirir.
0, eksik değer, kayıt yokluğu ve yayımlanmamış veri aynı şey değildir. Eksik bir zaman noktasını sıfır kabul etmek yapay düşüş ve yükseliş üretebilir.
10.7.7. Betimleme, Anomali ve Kanıt
Betimleyici istatistik eldeki veriyi özetler. Keşifsel analiz örüntüleri görünür kılar. Anomali puanı incelemeye değer gözlemleri sıralar. Hiçbiri tek başına nedensellik veya kanıt oluşturmaz.
Sağlam sıra:
gözlem tanımı
→ veri kalitesi
→ doğru payda
→ betimsel özet
→ dağılım ve zaman örüntüsü
→ ilişki veya anomali göstergesi
→ varsayım denetimi
→ alan bilgisi
→ gerekiyorsa çıkarım
10.8. Etki Büyüklüğü, Çoklu Test ve Yeniden Üretilebilirlik
İstatistiksel anlamlılık ile pratik önem aynı değildir. Çok büyük örneklemde küçük ve önemsiz bir etki düşük p-değeri üretebilir. Sonuç raporunda etki büyüklüğü ve güven aralığı, yalnız hipotez testi kararından daha fazla bilgi verir.
Aynı veri üzerinde çok sayıda hipotez denenirse yanlış pozitif olasılığı büyür. Bonferroni gibi aile-düzeyi düzeltmeler veya false discovery rate yaklaşımı, probleme göre çoklu test riskini kontrol etmek için kullanılabilir.
Analiz planının veri görüldükten sonra sürekli değiştirilmesi sonuçları iyimserleştirebilir. Değişken tanımı, dışlama kriteri ve ana hipotezin önceden belirlenmesi; mümkün olduğunda bağımsız doğrulama verisi kullanılması yeniden üretilebilirliği güçlendirir.
10.9. İstatistiksel Sonucu Bağlamıyla Raporlamak
Bir p-değeri, etkinin büyüklüğünü veya pratik önemini söylemez. Etki büyüklüğü, güven aralığı, örneklem büyüklüğü ve kullanılan varsayımlar birlikte raporlandığında sonuç daha yorumlanabilir hâle gelir.
Model varsayımları artık grafiklerinden ve tanı testlerinden kontrol edilmelidir. Regresyonda doğrusal ilişki, bağımsızlık, varyans yapısı ve etkili gözlemler; kullanılan modele göre ayrı ayrı incelenir. Varsayım ihlali otomatik olarak modeli geçersiz kılmaz, fakat yorum sınırını değiştirir.
Çoklu hipotez testinde yanlış pozitif riski artar. Hangi düzeltmenin kullanılacağı araştırma amacına bağlıdır; düzeltme seçimi sonuç görüldükten sonra değil analiz planının parçası olarak belirlenmelidir.
10.10. Vurma Zamanı ve İlk Geçiş Zamanı
Bir stokastik süreçte yalnız "hangi duruma geçilir?" değil, belirli bir duruma ilk kez ne zaman ulaşılır? sorusu da önemlidir. Bir durum kümesi A için vurma zamanı:
T_A = inf { t >= 0 : X_t in A }olarak tanımlanır. Başlangıç durumu zaten A içindeyse T_A = 0 olabilir. Aynı duruma yeniden dönme problemi inceleniyorsa genellikle t >= 1 şartıyla first return time tanımlanır. Bu küçük tanım farkı, beklenen sürenin yorumunu değiştirir.
Sonlu bir Markov zincirinde A kümesine beklenen ulaşma süresi h_i için, uygun koşullarda şu lineer denklem sistemi kurulabilir:
h_i = 0                                  if i in A
h_i = 1 + sum_j P[i,j] * h_j            if i not in A
Böylece simülasyon yapmadan da beklenen ilk geçiş süresi çözülebilir. Ancak iki nicelik ayrı tutulmalıdır:
P(T_A < infinity)    -> A'ya sonunda ulaşma olasılığı
E[T_A]               -> ulaşma süresinin beklenen değeri
Sonsuz durum uzaylı zincirlerde ulaşma olasılığının 1 olması, beklenen vurma zamanının mutlaka sonlu olduğu anlamına gelmez. Bu ayrım güvenilirlik ve kuyruk analizinde özellikle önemlidir.
Vurma zamanı; bir kuyruğun ilk kez kapasite sınırına gelmesi, sistemin hata durumuna ulaşması, bir stok seviyesinin alt eşiğe inmesi veya bir rastgele yürüyüşün hedef bölgeye ilk giriş süresi gibi problemlere doğrudan uygulanabilir.
10.11. Çoklu Sınama ve Seyrek Olayların Yanlış Alarm Etkisi
Kayıtlardaki uç değerleri tek tek α düzeyinde sınamak, geniş hacimli veride çok sayıda yanlış alarm üretebilir. Bütün sıfır hipotezleri doğruysa m sınamada beklenen yanlış ret sayısı mα olur; bu beklenti bağımsızlığı gerektirmez. Yanlış keşif oranını denetleyen Benjamini–Hochberg yaklaşımı, aile bazlı hata denetimiyle aynı hedefi taşımaz. Gerçek olay sıklığı düşükse Bayes kuralı uyarınca yüksek özgüllükteki bir testin pozitif öngörü değeri bile düşük kalabilir. Risk göstergelerinin karar maliyeti ve doğrulanması Anomali Algılama dersinde ayrıntılandırılır.
Ünite 11: İstatistikten İstatistiksel Öğrenmeye
11.1. Çıkarımdan Tahmine
Örnekleme, olasılık dağılımları, Bayes teoremi ve regresyon yalnız klasik istatistiksel çıkarımın değil, istatistiksel makine öğrenmesinin de temelidir. Ayrım kullanılan matematikten çok sorunun ağırlık merkezindedir. Çıkarımsal istatistik bir parametre veya etki hakkındaki belirsizliği açıklamaya çalışırken, istatistiksel öğrenme çoğu zaman görülmemiş gözlem için tahmin hatasını azaltmayı hedefler.
örneklem
↓
olasılıksal / geometrik model
↓
parametre veya karar fonksiyonu
↓
görülmemiş veri
↓
tahmin + belirsizlik / hata ölçümü
Bir tahmin modelinin yüksek başarısı nedensellik göstermez; bir katsayının istatistiksel olarak anlamlı olması da modelin yeni veride en iyi tahmini vereceğini garanti etmez.
11.2. Olabilirlik ve Parametre Kestirimi
Gözlenen veri z_1,...,z_n ve parametre θ için olabilirlik:
L(θ) = Π p(z_i | θ)şeklinde yazılabilir. En çok olabilirlik kestirimi (MLE), bu ifadeyi en büyük yapan parametreyi seçer. Hesaplamada çarpım yerine çoğunlukla log-olabilirlik kullanılır:
log L(θ) = Σ log p(z_i | θ)Bayesçi yaklaşımda parametreye ilişkin önsel dağılım da modele girer. Maksimum sonsal kestirim (MAP):
θ_MAP = argmax p(data | θ) p(θ)biçiminde düşünülebilir. Böylece Bayes teoremi yalnız olay olasılığı hesabı değil, model parametrelerinin kestirimi için de doğrudan kullanılır.
11.3. Kayıp Fonksiyonu
Tahmin ile hedef arasındaki fark bir kayıp fonksiyonuyla ölçülür. Regresyonda karesel veya mutlak hata, sınıflandırmada log-loss/cross-entropy gibi ölçüler kullanılabilir. Farklı kayıp fonksiyonları aynı veri üzerinde farklı “en iyi” modeli tanımlayabilir.
İş maliyeti matematiksel kayıptan farklı olabilir. Yanlış negatifin çok pahalı olduğu bir sağlık/güvenlik probleminde en yüksek doğruluğu veren eşik en iyi karar eşiği olmayabilir.
11.4. Düzenlileştirme ve Genelleme
Örnek üzerindeki hatayı küçültmek modelin anakütlede de iyi davranacağını garanti etmez. Çok esnek model örnek gürültüsünü öğrenebilir. Düzenlileştirme model katsayılarını veya kapasitesini sınırlandırarak bu riski azaltmaya çalışır.
Ridge ve Lasso gibi cezalı regresyonlar, bu fikrin doğrusal model üzerindeki açık örnekleridir. Aynı genelleme sorunu karar ağacında derinlik, k-NN'de k, SVM'de C/γ, K-Means'te başlangıç ve küme sayısı gibi farklı hiperparametrelerle görünür.
11.5. Eğitim, Doğrulama ve Test
Model geliştirmede verinin rollerini ayırmak gerekir:
- eğitim kümesi parametreleri öğrenir,
- doğrulama kümesi model ve hiperparametre seçimini destekler,
- test kümesi seçim bittikten sonra genelleme başarısını ölçer.
Çapraz doğrulama küçük/orta veri kümelerinde değerlendirme verimliliğini artırır. Ancak ölçekleme, özellik seçimi veya eksik veri tamamlama gibi adımlar bütün veri üzerinde önceden uygulanırsa test bilgisi eğitim sürecine sızabilir.
11.6. İstatistiksel Öğrenme Yöntemleri
Bu temelin üzerinde farklı varsayımlar kullanan yöntem aileleri bulunur:
- olasılık tabanlı: Naive Bayes, Gaussian mixture, Bayes ağları ve HMM,
- uzaklık tabanlı: k-En Yakın Komşu,
- marj tabanlı: Support Vector Machine,
- bölme tabanlı: karar ağaçları ve topluluk yöntemleri,
- kümeleme: K-Means, K-Medoids, DBSCAN ve bulanık C-Ortalamalar,
- boyut indirgeme: PCA, SVD ve LDA,
- dizisel istatistik: n-gram dil modelleri.
Bu yöntemlerin matematiği, değerlendirmesi ve uygulama sınırları İstatistiksel Öğrenme ve Makine Öğrenmesi ders notunda devam eder.
11.7. Kalibrasyon, Belirsizlik ve Karar Eşiği
Sınıflandırıcının ürettiği skor ile gerçek olasılık aynı kavram değildir. Eğer p̂=0.8 verilen örneklerin yaklaşık yüzde 80'i gerçekten pozitif çıkıyorsa model o bölgede kalibre kabul edilebilir. Doğruluk yüksek olsa bile olasılık tahminleri kötü kalibre olabilir. Bu ayrım, skorun insan kararına veya maliyet hesabına girdiği sistemlerde önemlidir.
Karar eşiği de modelden bağımsız bir iş kararıdır:
skor → eşik → kararEşik değiştiğinde yanlış pozitif ve yanlış negatif dengesi değişir; model parametreleri aynı kalabilir. Bu nedenle eşik, doğrulama verisi ve gerçek hata maliyeti üzerinden seçilmelidir.
11.8. Dağılım Değişimi ve Örnekleme Sınırı
İstatistiksel öğrenmenin varsayımı çoğu zaman eğitim ve gelecek verisinin yeterince benzer dağılımdan gelmesidir. Üretimde popülasyon, ölçüm cihazı, kullanıcı davranışı veya veri toplama süreci değiştiğinde bu bağ zayıflar. Modelin eğitildiği örneklem artık hedef popülasyonu temsil etmeyebilir.
Bu durum klasik örnekleme bilgisini yeniden merkezi hale getirir. Büyük veri kümesi tek başına temsil güvencesi değildir; yanlış mekanizmayla toplanmış milyonlarca kayıt da yanlı örnek olabilir.
11.9. İstatistik ile Öğrenme Arasındaki Süreklilik
Regresyon, likelihood, regularization ve Bayesçi kestirim hem istatistikte hem makine öğrenmesinde kullanılır. Keskin bir sınır çizmek yerine sorunun ağırlık merkezini belirlemek daha doğrudur:
parametre / etki belirsizliği ← istatistik → tahmin / genellemeGüvenilir uygulamada iki taraf birlikte kullanılır: model yalnız iyi tahmin etmeli değil, değerlendirme örneklemi ve belirsizlik yorumu da savunulabilir olmalıdır.
Ünite 12: Çok Değişkenli, Bayesçi ve Zamansal İstatistik
12.1. Çok Değişkenli Normal Dağılım ve Kovaryans Matrisi
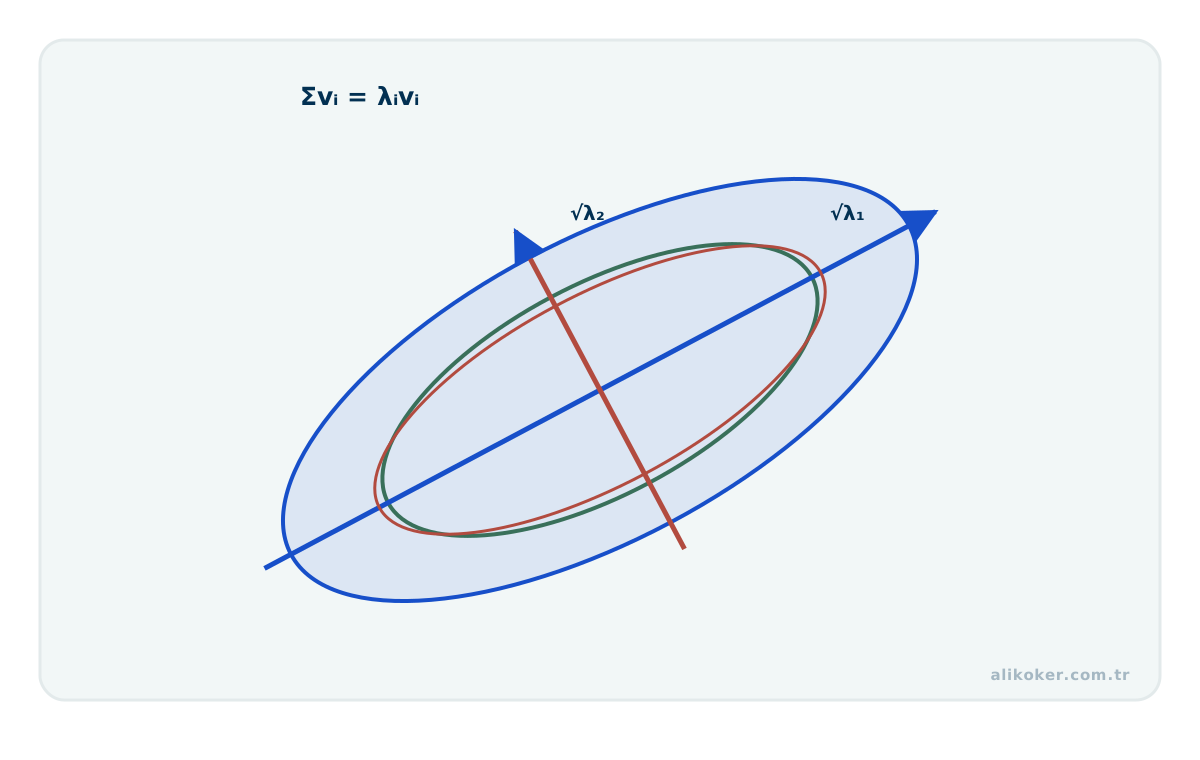
Birden fazla sürekli değişken birlikte ele alındığında ortalama bir vektör, değişkenlik ise kovaryans matrisi ile temsil edilebilir. Çok değişkenli normal modelde kovaryans matrisi yalnız tek değişkenli varyansları değil, değişkenler arası doğrusal bağımlılığı da taşır.
Öklid uzaklığı her ekseni aynı ölçek ve bağımsızlık varsayımıyla ele alır. Mahalanobis uzaklığı kovaryans yapısını hesaba katar:
d_M(x,mu)^2 = (x-mu)^T Sigma^(-1) (x-mu)Bu ölçü, güçlü korelasyonlu veya farklı ölçekli özelliklerde geometrinin veri dağılımına göre yeniden okunmasını sağlar. Sigma kötü koşullu veya rank eksikse tersin doğrudan hesaplanması yerine uygun sayısal yöntem gerekir.
Ortak çok değişkenli dağılım, her değişkenin marjinal davranışını ve aralarındaki bağımlılığı birlikte belirler. Kopula gösteriminde sürekli marjinal dağılımlar F₁,…,Fₚ için ortak dağılım F(x₁,…,xₚ) = C(F₁(x₁),…,Fₚ(xₚ)) biçiminde ifade edilebilir. Böylece marjinal dağılımları değiştirmeden bağımlılık yapısına ilişkin ayrı bir model kurulabilir. Pearson korelasyonunun sıfır olması, genel olarak bağımsızlık veya kuyruk bağımsızlığı anlamına gelmez.
Uç değer analizinde blok maksimumları ile yüksek eşik üzerindeki aşım büyüklükleri farklı örnekleme yaklaşımlarıdır. Genelleştirilmiş uç değer ve genelleştirilmiş Pareto aileleri belirli limit koşullarından doğar; uygun dağılım seçimi, durağanlık, eşik veya blok seçimi ve parametre belirsizliği denetlenmeden nadir olay olasılığı güvenilir kabul edilemez.
12.2. Bayesçi Çıkarım ve Posterior Predictive Dağılım
Bayesçi çıkarımda parametre de belirsiz bir nicelik olarak modellenir:
posterior ∝ likelihood * priorÖnsel dağılım veri öncesi bilgiyi, olabilirlik gözlenen verinin parametre altında ne kadar uyumlu olduğunu, sonsal dağılım ise ikisinin birleşiminden sonra parametre belirsizliğini temsil eder.
Tek bir MAP noktası tüm sonsal bilgiyi taşımaz. Yeni bir gözlem için posterior predictive dağılım, parametre belirsizliğini de entegre eder. Klasik güven aralığı ile Bayesçi credible interval aynı matematiksel nesne değildir; olasılık yorumları farklıdır.
Bernoulli gözlemlerinde bilinmeyen başarı olasılığı θ için Beta(α, β) önseli seçildiğinde olabilirlik ile önselin çarpımı yine Beta ailesinde kalır. h başarı ve t başarısızlık içeren veri sonrası dağılım Beta(α+h, β+t) olur. Örneğin Beta(2,2) önseli üzerine üç başarı ve bir başarısızlık gözlenirse Beta(5,3) sonsalı elde edilir; posterior ortalama 5/8 = 0,625 olur. Bu güncelleme, tek bir tahminin değil, parametre üzerindeki belirsizliğin nasıl değiştiğini gösterir.
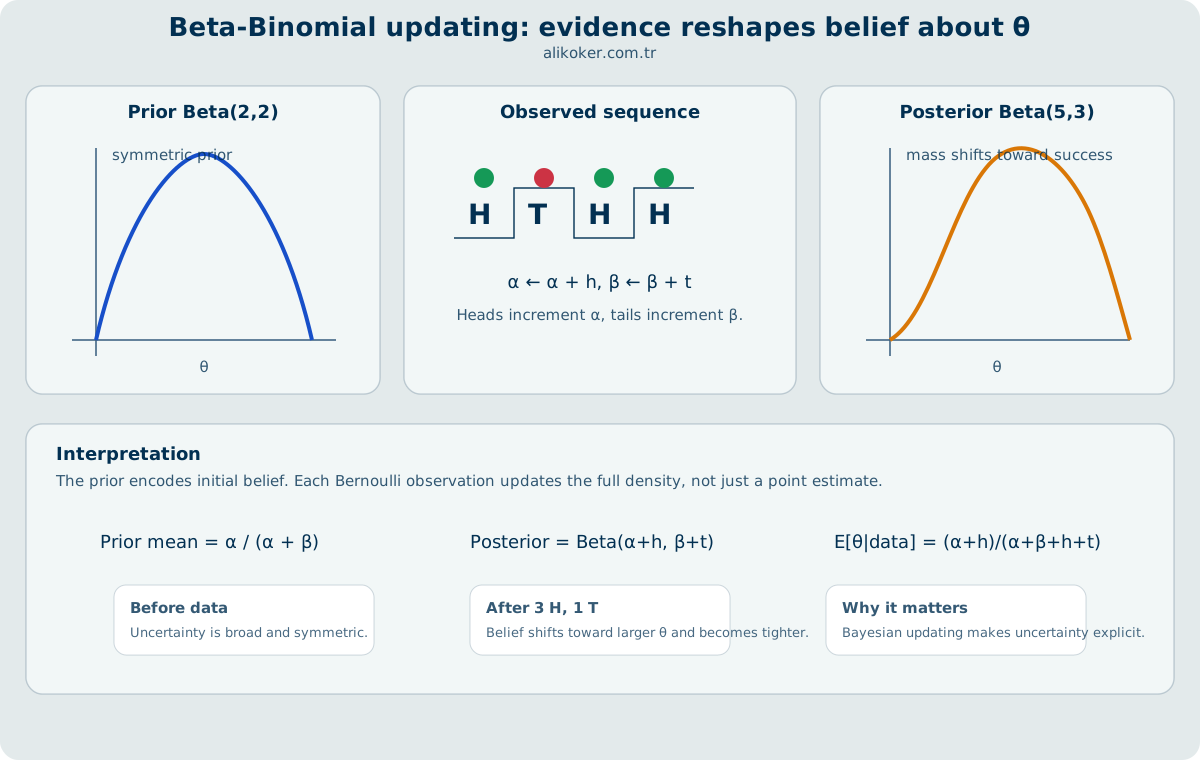
Gelecekteki yeni bir Bernoulli denemesi için öngörü olasılığı posterior üzerinde integrasyonla hesaplanır ve bu örnekte P(X_yeni=1 | veri) = E[θ | veri] = 5/8 olur. Bu sonuç, posterior parametre dağılımı ile posterior predictive dağılımın farklı nesneler olduğunu somutlaştırır.
Önsel dağılım seçimi, özellikle az verili ve zayıf tanımlanabilir modellerde posterior sonucu etkiler. Jeffreys önseli uygun düzenli modellerde Fisher bilgisi üzerinden π(θ) ∝ √I(θ) biçiminde tanımlanır; parametre dönüşümü karşısındaki özelliği, her problemde uygun veya öz önsel olduğu anlamına gelmez. Ampirik Bayes, önselin bazı parametrelerini veriden tahmin ederken hiyerarşik Bayes, gruplar arası değişkenliği üst düzey olasılık modeliyle temsil eder.
Posterior integrali doğrudan hesaplanamıyorsa Laplace yaklaşımı mod çevresinde ikinci dereceden yerel yaklaşım kullanır; varyasyonel çıkarım ise seçilmiş dağılım ailesi üzerinde bir optimizasyon problemi çözer. Monte Carlo yöntemlerinde sayısal hata örnekleme ile azaltılabilir. Bu tekniklerin yakınsama ölçütü, belirsizliği temsil etme yeteneği ve çok modlu posteriorlara duyarlılığı farklıdır.
12.3. MCMC Yöntemlerinin Gerekliliği
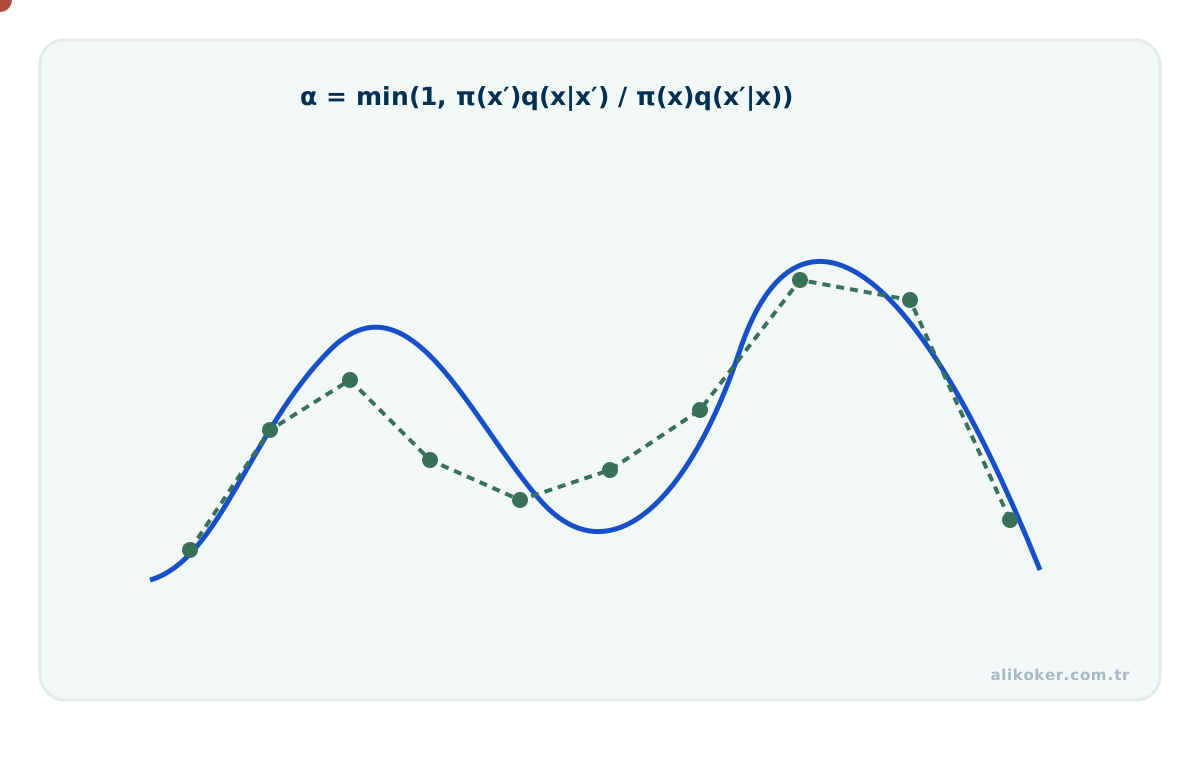
Sonsal dağılımın normalizasyon sabiti veya beklenen değerleri kapalı biçimde hesaplanamıyorsa, dağılımdan yaklaşık örnekler üretmek için Markov Chain Monte Carlo yöntemleri kullanılabilir. Amaç bağımsız rastgele örnek üretmek değil, hedef dağılımı durağan dağılım olarak taşıyan bir Markov zinciri kurmaktır.
Metropolis-Hastings kabul/red mekanizmasıyla genel bir çerçeve sunar. Gibbs örneklemesi ise uygun koşullu dağılımlardan sırayla örnek alır. MCMC çıktısı sıradan i.i.d. örnek gibi yorumlanamaz; burn-in, otokorelasyon, etkili örnek büyüklüğü ve birden çok zincirle yakınsama kontrolü önemlidir.
12.4. Durağanlık, Otokorelasyon ve Değişim Noktası
Zamansal veride örnek sırası bilgi taşır. Durağanlık, dağılım özelliklerinin zamana göre hangi anlamda değişmediğini tanımlar; zayıf durağanlıkta ortalama sabit, kovaryans ise yalnız gecikmeye bağlıdır.
Otokorelasyon, bir serinin gecikmeli kopyalarıyla doğrusal bağımlılığını inceler. Güçlü otokorelasyon bulunan veride rastgele train-test bölmesi veya klasik bağımsızlık varsayımı yanıltıcı olabilir.
Değişim noktası, veri üretim sürecinin ortalama, varyans, ilişki veya başka bir parametresinde kalıcı yapısal değişim adayını ifade eder. Tek bir uç değer değişim noktası değildir. Zamansal istatistik, sinyal işleme ve üretim izleme burada ortak bir matematiksel zeminde buluşur.
Zaman dizisinde değişim noktası, tek bir büyük sapmayla aynı şey değildir. Ani ortalama kayması, varyans değişimi veya bağımlılık yapısındaki kırılma farklı hipotezler gerektirir. Bir sensörün ilk 50 ölçümü yaklaşık 20, sonraki 50 ölçümü yaklaşık 24 çevresinde dalgalanıyorsa önce saat, kalibrasyon ve çalışma rejimi değişiklikleri araştırılır; ancak sonra istatistiksel kırılma testi yorumlanır. Kırılma zamanını veriye bakarak seçip aynı veri üzerinde düzeltilmemiş bir anlamlılık testi uygulamak yanlış pozitifliği artırabilir. Ayrılmış doğrulama aralığı veya seçim etkisini hesaba katan yöntem bu yanlılığı sınırlar.
12.5. MCMC Çıktısının Sayısal Güvenilirliği
Bir Markov zincirinden elde edilen örnekler, aynı dağılımdan bağımsız çekilmiş gözlemler değildir. Zincirin durağan dağılıma sahip olması, sonlu sayıda iterasyondan hesaplanan ortalamanın güvenilirliğini kendiliğinden kanıtlamaz. h(θ) fonksiyonunun sonsal beklentisi için μ̂_N = (1/N) Σ(t=1..N) h(θ_t) kestiricisi kullanıldığında, yeterli düzenlilik koşulları altında asimptotik varyans yalnız marjinal varyansa değil gecikmeli kovaryanslara da bağlıdır:
Var(μ̂_N) ≈ [γ₀ + 2 Σ(k≥1) γ_k] / N
γ_k = Cov(h(θ_t), h(θ_(t+k)))
Köşeli parantez içindeki uzun dönem varyansı kestirilmeden bağımsız örnek varsayımıyla standart hata hesaplamak, pozitif otokorelasyonlu zincirlerde belirsizliği olduğundan küçük gösterebilir. Monte Carlo standart hatası (MCSE), sonsal dağılımın yayılımını değil, aynı algoritmanın sonlu çalıştırılmasından doğan sayısal belirsizliği ölçer. Etkin örneklem büyüklüğü bu ilişkiyi bağımsız örnek karşılığı olarak özetler; zincirin toplam iterasyon sayısıyla karıştırılmamalıdır.
Çoklu zincirlerin farklı başlangıçlardan çalıştırılması ve zincir içi/zincirler arası değişkenliğin karşılaştırılması yakınsama tanılamasına yardımcı olur. Bununla birlikte tek bir tanı ölçütü, özellikle çok modlu veya geçişleri zor sonsal dağılımlarda, bütün modların yeterince araştırıldığını kanıtlamaz. Ön ısınma örneklerini çıkarmak da kötü karışan bir zincirin sorununu tek başına gidermez. Durdurma kararı, ilgilenilen parametre ve fonksiyonel için MCSE, etkin örneklem büyüklüğü ve bağımsız zincirlerin davranışı birlikte değerlendirilerek verilmelidir.
12.6. Önem Örneklemesinde Ağırlık Yoğunlaşması
Hedef yoğunluk p(x) için doğrudan örnek üretmek güç olduğunda, q(x) > 0 koşulunu hedefin ilgili destek bölgesinde sağlayan bir öneri dağılımından örnek alınabilir. Normalleştirilmemiş önem ağırlığı w_i = p(x_i) / q(x_i) ile öz-normalize kestirim
Î = Σ(i=1..N) w_i f(x_i) / Σ(i=1..N) w_ibiçimindedir. Ağırlıkların birkaç gözlemde toplanması örnek sayısı yüksek olsa bile kestirimi kırılganlaştırır. N_eff,w = (Σ_i w_i)² / Σ_i w_i² yaygın bir ağırlık yoğunlaşması tanısıdır; bağımlı MCMC zincirlerinin etkin örneklem büyüklüğüyle aynı nicelik değildir. Öneri dağılımının destek kapsamı ve ağır ağırlık kuyrukları incelenmeden yalnız örnek sayısını artırmak güvenilir bir çözüm sayılmaz.
Kaynakça
- Christopher M. Bishop. Pattern Recognition and Machine Learning. Springer, 2006.
- Douglas C. Montgomery, George C. Runger. Applied Statistics and Probability for Engineers, 7th Edition. Wiley, 2018.
- George Casella, R. L. B. Statistical Inference, 2nd Edition. Duxbury, 2002.
- Göran Kauermann; Helmut Küchenhoff; Christian Heumann. Statistical Foundations, Reasoning and Inference: For Science and Data Science. Springer, 2021. https://doi.org/10.1007/978-3-030-69827-0
- Kevin P. Murphy. Probabilistic Machine Learning: An Introduction. MIT Press, 2022.
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- Morris H. DeGroot, Mark J. Schervish. Probability and Statistics, 4th Edition. Pearson, 2012.
- NIST/SEMATECH. e-Handbook of Statistical Methods. National Institute of Standards and Technology.
- Peter J. Huber; Elvezio M. Ronchetti. Robust Statistics. 2nd ed. Wiley, 2009.
- Sheldon M. Ross. A First Course in Probability, 10th Edition. Pearson, 2018.
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.
- William G. Cochran. Sampling Techniques, 3rd Edition. Wiley, 1977.
- Charu C. Aggarwal. Outlier Analysis, 2nd ed.. Springer, 2017. https://doi.org/10.1007/978-3-319-47578-3