


Bilgisayar Mimarisi: Komut Kümesi, Boru Hattı ve Bellek Sistemi
Bilgisayar mimarisini başarım ve güçten RISC-V, veri yolu, aritmetik, boru hattı, sıralama dışı yürütme, vektör/GPU, G/Ç, önbellek, sanal bellek, NUMA, tutarlılık, CXL/UCIe ve ölçüme kadar ele alan kapsamlı ders notları.
Konu omurgası 2015 dönemindeki bilgisayar mimarisi ve organizasyonu derslerinin CISC/RISC ayrımı, komut sınıfları, program denetimi, boru hattı, vektör işleme, bilgisayar aritmetiği, G/Ç, bellek ve çok işlemcili sistem başlıklarına dayanır. RISC-V, modern sıralama dışı yürütme, sanal bellek, NUMA, GPU ve hızlandırıcılar, yonga parçacıkları, CXL ve UCIe bu temelin güncel uzantıları olarak ele alınır.
Ana eksen belirli bir işlemci ailesi değil, programın makine komutuna dönüşmesinden verinin yazmaç, önbellek, ana bellek ve G/Ç aygıtları arasında hareketine kadar uzanan zincirdir. ISA, işlem hattı (pipeline) ve bellek kararlarını performans, güç, güvenilirlik ve yazılım üzerindeki etkileriyle birlikte okumak bu zinciri daha anlaşılır hâle getirir.
Bu kavramların AltiVec/VSX, NUMA ve CPU-GPU bağlantısı üzerindeki pratik karşılığı IBM POWER9 AC922 üzerindeki çalışmalarımda görülebilir.
Ünite 1: Bilgisayar Mimarisi, Başarım ve Tasarım Sınırları
Mimari ile organizasyon arasındaki ayrım
Bilgisayar mimarisi yazılımın gördüğü sözleşme ile bu sözleşmeyi gerçekleştiren donanımın tasarımını birlikte inceler.
Komut kümesi mimarisi (ISA) programcıya ve derleyiciye görünen sınırdır. Komutlar, yazmaçlar, veri tipleri, adresleme biçimleri, ayrıcalık düzeyleri, bellek modeli ve istisna davranışı bu sözleşmenin parçalarıdır.
Mikro mimari aynı ISA'nın içeride nasıl gerçekleştirildiğini anlatır. Işlem hattı derinliği, yürütme genişliği, önbellek düzeni, branch predictor, reorder buffer, fiziksel yazmaç sayısı ve ön getirme mekanizmaları mikro mimari kararlarıdır.
Aynı ISA'yı kullanan iki işlemci çok farklı performans ve güç karakteristiğine sahip olabilir. ISA uyumluluğu aynı mikro mimari anlamına gelmez.
Bilgisayarın temel bileşenleri
Bir bilgisayarı parça listesinden çok veri akışı ve durum değişimi üzerinden düşünmek daha yararlıdır. Girdi sisteme veri taşır; bellek komutları ve veriyi saklar; işlemci bunları dönüştürür; çıktı sonucu dış dünyaya taşır. İşlemcinin içinde iki ana sorumluluk ayrılır:
veri yolu   → değerleri taşır ve dönüştürür
denetim     → hangi işlemin ne zaman yapılacağını belirler
Veri yolunda ALU, yazmaç öbeği, çoklayıcılar ve ara bağlantılar bulunur. Denetim mantığı komutun anlamını bu kaynakları süren sinyallere çevirir.
Bugünkü bir SoC bu yalın modelin ölçeklenmiş halidir. CPU çekirdekleri, GPU/NPU, önbellek katmanları, bellek denetleyicileri, PCI Express kök kompleksi, DMA motorları ve NoC aynı sistemde bulunabilir. Mimariyi okurken üç soru yol gösterir: veri şu anda nerede, hangi birim onu işleyecek ve işlemden sonra hangi durum değişecek?
Von Neumann, Harvard ve değiştirilmiş Harvard
Von Neumann mimarisinde komutlar ve veriler aynı adres alanı ve bellek sistemi içinde tutulur. Esnektir, ancak aynı yolun komut ve veri trafiği tarafından paylaşılması Von Neumann darboğazını doğurur.
Harvard mimarisinde komut ve veri bellekleri ayrıdır. İki trafik türü bağımsız hareket edebilir.
Güncel genel amaçlı işlemciler çoğunlukla değiştirilmiş Harvard yaklaşımı kullanır: ana bellek birleşiktir; L1 seviyesinde komut ve veri önbellekleri ayrılabilir, daha alt seviyeler yeniden birleşebilir.
Programın donanıma kadar inişi
Kaynak kod doğrudan işlemcide çalışmaz. Arada farklı sözleşmeler kullanan birkaç katman vardır:
C/C++ kaynak
   ↓ derleyici ve eniyileme
assembly / ara gösterim
   ↓ assembler
nesne dosyası
   ↓ linker
çalıştırılabilir dosya
   ↓ loader + işletim sistemi
sanal adres alanı
   ↓ ISA
mikro mimaride yürütüm
Derleyici bu zincirde yalnız dil çevirisi yapmaz. Register bellek ayırma, sabit yayma, dead-code elimination, inlining, loop unrolling, vectorization ve instruction scheduling gibi dönüşümler dinamik komut sayısını ve bellek erişim örüntüsünü değiştirebilir.
Bu nedenle kaynak koddaki tek bir ifade ile işlemcinin gördüğü iş miktarı arasında bire bir ilişki yoktur. Mimari çözümleme gerektiğinde assembly, nesne dosyası, sanal adres yerleşimi ve mikro mimari birlikte okunur.
Getir-çöz-yürüt döngüsü
En yalın komut döngüsü:
PC'deki komutu getir
↓
komutu çöz
↓
operandları oku
↓
işlemi yürüt
↓
gerekirse belleğe eriş
↓
sonucu yaz
↓
PC'yi güncelle
Modern işlemciler bu adımları çok sayıda komut için üst üste bindirir, bazılarını sırasız yürütür ve henüz kesinleşmemiş kontrol akışında spekülatif çalışabilir. Buna rağmen mimari olarak emekli edilen sonuç program sırasının tanımladığı davranışı korumalıdır.
Yonga üretimi ve maliyet
Mikro mimari üretilebilir bir yonga üzerinde yaşar. Wafer alanı, kusur yoğunluğu, die büyüklüğü, paketleme, test ve soğutma; mimari seçimin ekonomik ve fiziksel sınırlarını belirler.
Die büyüdükçe daha fazla çekirdek veya önbellek yerleştirilebilir; aynı anda wafer başına elde edilen die sayısı azalır ve tek kusurun daha geniş bir alanı kullanılmaz hale getirme olasılığı yükselir. Bu ilişki yalnız maliyeti değil, hangi blokların aynı die üzerinde tutulacağını da etkiler.
Chiplet yaklaşımı bu nedenle yalnız paketleme biçimi değildir. Farklı işlevler farklı süreçlerde üretilebilir, daha küçük die'larla verim artırılabilir ve ürün ailesi modüler kurulabilir. Karşılığında die-to-die bağlantı gecikmesi, güç, paket karmaşıklığı ve tutarlılık yeni tasarım değişkenleri olur.
"Teknoloji düğümü" adı da artık tek bir geometrik ölçü değildir. Yoğunluk, güç, frekans, SRAM davranışı, analog yetenekler, yield ve maliyet birlikte değerlendirilmelidir.
Moore Yasası, Dennard ölçeklemesi ve güç duvarı
Moore Yasası uzun yıllar yonga üzerindeki transistör sayısındaki hızlı artışı özetledi. Dennard ölçeklemesi döneminde daha küçük transistörler daha yüksek frekansı benzer güç yoğunluğunda mümkün kılıyordu.
Bu ilişki bozulduğunda frekansı sürekli artırmak sürdürülemez hale geldi. Güç duvarı çok çekirdek, heterojen işlem ve özel hızlandırıcıların yaygınlaşmasının temel nedenlerinden biridir.
CMOS'ta devingen güç kabaca:
P_dynamic ≈ α C V² file ilişkilidir.
Burada etkinlik oranı α, anahtarlanan kapasitans C, besleme gerilimi V, frekans f'dir. Gerilimin karesi nedeniyle voltaj önemli bir güç aracıdır.
Durağan güç ise özellikle kaçak akımlarla ilişkilidir. Teknoloji küçüldükçe yalnız devingen güç düşünmek yeterli değildir.
Güç yönetimi
Yaygın yöntemler:
- DVFS ile gerilim ve frekans değiştirme,
- clock gating ile kullanılmayan blokların saatini kesme,
- power gating ile bloğun gücünü kapatma,
- kullanılmayan çekirdek veya hızlandırıcıyı uyutma,
- heterojen çekirdeklerle işi uygun güç sınıfına yerleştirme,
- termal sınıra yaklaşıldığında throttling uygulama.
En yüksek saat frekansı her zaman en iyi performans/watt noktası değildir.
Başarımın temel eşitliği
İşlemci yürütme zamanı:
CPU zamanı = komut sayısı × CPI × çevrim süresiveya:
CPU time = IC × CPI / clock rateolarak düşünülebilir.
Üç terimin biri iyileşirken diğeri kötüleşebilir. Daha karmaşık bir komut kümesi komut sayısını azaltıp çevrim süresini veya CPI'ı artırabilir. Daha derin boru hattı frekansı artırıp yanlış branch tahmininin cezasını büyütebilir.
Gecikme ve işlem hacmi
Gecikme, tek işin tamamlanma süresidir. Işlem hacmi, birim zamanda tamamlanan iş miktarıdır.
Işlem hattı işlem hacmini yükseltebilir fakat tek komutun baştan sona gecikmesini aynı oranda düşürmez. GPU yüksek işlem hacmi için tasarlanırken tek iş parçacığı gecikmesi CPU kadar düşük olmayabilir.
MIPS, FLOPS ve ölçüm tuzakları
MIPS:
milyon komut / saniyeölçer. Farklı ISA'lar aynı işi farklı sayıda komutla yaptığı için tek başına güvenilir karşılaştırma değildir.
FLOPS kayan nokta iş yükü için değerlidir; fakat bellek bağlı bir programda tepe FLOPS gerçek performansı göstermez.
Başarım ölçümü seçimi iş yüküne benzemelidir. SPEC CPU genel amaçlı CPU karşılaştırmasında, MLPerf yapay zeka eğitim/çıkarımında örnek standart kümelerdir. Sonuçlar derleyici, bellek, güç sınırı ve başarım ölçümü kurallarıyla birlikte okunmalıdır.
Birden çok oranı birleştirirken geometrik ortalama, farklı referans ölçeklerinin aritmetik ortalamayı bozmasını azaltır.
Amdahl ve Gustafson
Bir programın P oranı hızlandırılabiliyor ve o bölüm S kat hızlanıyorsa Amdahl:
Speedup = 1 / ((1-P) + P/S)der.
Hızlandırılamayan küçük bölüm toplam kazancı sınırlar.
Gustafson yaklaşımı, işlemci sayısı arttıkça problem boyutunun da büyüyebileceğini vurgular. Sabit iş yerine ölçeklenen iş yükü düşünüldüğünde paralel sistemlerin değeri farklı görünür.
Bellek duvarı
İşlemci yürütme kapasitesi DRAM gecikmesinden daha hızlı gelişmiştir. Bu nedenle bir önbellek kaçırması yüzlerce çekirdek çevrimine mal olabilir.
Çözüm tek değildir:
- çok seviyeli önbellek,
- prefetch,
- daha çok bellek düzeyi paralellik,
- geniş bellek kanalları,
- HBM,
- veri yerleşimini iyileştiren yazılım,
- NUMA farkındalığı,
- hesaplama ile veriyi birbirine yaklaştıran hızlandırıcılar.
Güvenilirlik
Üç kavram ayrılır:
- fault: fiziksel veya mantıksal bozukluğun kök nedeni,
- error: sistem durumunun yanlış hale gelmesi,
- failure: dışarıdan görülen hizmetin şartnameyi karşılamaması.
Arızalar geçici, aralıklı veya kalıcı olabilir.
Parite hata saptayabilir. ECC daha güçlüdür. Sunucu belleğinde yaygın SECDED kodları tek bit hatasını düzeltebilir, çift bit hatasını saptayabilir.
Güvenilir bir mimari yalnız hata oluşmamasını değil, hata oluştuğunda saptama, sınırlama, raporlama ve kurtarma davranışını da tasarlar.
Ünite 2: Komut Kümesi Mimarileri, CISC/RISC ve RISC-V
CISC ve RISC
CISC ile RISC'i iki değişmez kutu gibi değil, tarihsel ISA tasarım eğilimleri olarak okumak gerekir. CISC tarafı kod yoğunluğunu ve bir komutta daha fazla işi; RISC tarafı düzenli decode'u, load/store ayrımını ve daha yalın veri yollarını öne çıkarmıştır.
- Özellik: Kodlama; CISC eğilimi: değişken olabilir; RISC eğilimi: düzenlidir
- Özellik: Bellek operandı; CISC eğilimi: birçok komutta olabilir; RISC eğilimi: load/store ile ayrılır
- Özellik: Decode; CISC eğilimi: karmaşık olabilir; RISC eğilimi: daha düzenlidir
- Özellik: Kod yoğunluğu; CISC eğilimi: yüksek olabilir; RISC eğilimi: sıkıştırılmış uzantılarla artırılabilir
- Özellik: Mikro mimari; CISC eğilimi: ISA'dan bağımsız olarak gelişmiş olabilir; RISC eğilimi: ISA'dan bağımsız olarak gelişmiş olabilir
Bu ayrım bugün tek başına işlemci davranışını açıklamaz. Modern x86 çekirdekleri karmaşık komutları iç mikro işlemlere ayırabilir; RISC-V ve AArch64 da vektör, kriptografi, atomik ve bit işleme uzantılarıyla zenginleşmiştir. Performansı belirleyen asıl yapı; frontend, yürütme kaynakları, önbellek, branch prediction, bellek sistemi ve güç bütçesinin birlikte davranışıdır.
Power ISA, Arm, x86, MIPS ve SPARC
x86-64 güçlü geriye dönük uyumluluk ve değişken uzunluklu komut kodlamasıyla genel amaçlı bilgisayarlarda önemlidir.
AArch64 düzenli 64 bit RISC yaklaşımını mobil, gömülü ve sunucu sistemlerine taşır.
Power ISA sunucu ve yüksek performanslı sistemlerde önemli RISC ailesidir. Vektör ve sayısal yetenekleri geniştir.
MIPS bilgisayar mimarisi eğitiminde ve tarihsel RISC gelişiminde önemlidir.
SPARC register window yaklaşımıyla bilinir.
RISC-V açık standart, modüler ve genişletilebilir bir ISA ailesidir.
ISA karşılaştırmasında yalnız komut sayısına değil; ABI, yazılım ekosistemi, privilege modeli, vector/atomic yetenekleri, sanallaştırma, code density ve gerçekleştirim serbestliğine bakılır.
Yazmaç pencereleri
SPARC'ın register window yaklaşımında çağıranın çıkış yazmaçlarının bir bölümü çağrılanın giriş yazmaçlarıyla örtüşebilir.
çağıran:  global | local | out
                          |||
çağrılan:          in | local | out
Amaç her yordam çağrısında yazmaçları belleğe dökme maliyetini azaltmaktır.
Pencere sayısı sonludur. Derin çağrılarda spill/fill gerekir. RISC-V ve AArch64 genel olarak register window kullanmaz; ABI ile caller-saved ve callee-saved yazmaçlar tanımlanır.
RISC-V neden önemlidir?
RISC-V'in ayırt edici yanı yalnız "az komut" değildir. Temel ISA ile isteğe bağlı uzantıları açıkça ayıran modüler sözleşme önemlidir. RV32I/RV64I tabanına gereksinime göre çarpma-bölme, atomik işlemler, kayan nokta, sıkıştırılmış kodlama, bit manipülasyonu, vektör ve kriptografi yetenekleri eklenebilir.
Bu yapı aynı ISA ailesinin küçük bir denetleyicide de yüksek performanslı bir işlemcide de kullanılabilmesini sağlar. Uygulama alanı değiştikçe zorunlu donanım kümesi de değişebilir.
Açık ISA ile açık çekirdek aynı kavram değildir. Bir üretici RISC-V uyumlu fakat kapalı bir mikro mimari geliştirebilir; başka bir üretici aynı yazılım görünümünü farklı boru hattı, önbellek ve yürütme kaynaklarıyla gerçekleştirebilir. Ortak olan yazılımın gördüğü ISA sözleşmesidir.
RISC-V yazmaçları
RV32I/RV64I genel amaçlı x0–x31 yazmaçlarını tanımlar.
x0 her zaman sıfırdır. Yazılan değer atılır. Bu özellik mv, nop, karşılaştırma ve sabit üretimi gibi birçok sözde komutun basit gerçek komutlara dönüştürülmesini kolaylaştırır.
ABI isimleri mimari numaralara anlam verir:
x0       zero
x1       ra
x2       sp
x5-x7    t0-t2
x8       s0/fp
x10-x17  a0-a7
...
ABI adı ile fiziksel register numarası aynı katman değildir: ISA registerı tanımlar, ABI kullanım sözleşmesini tanımlar.
RISC-V'te bayrak yazmacı neden yok?
Bazı ISA'lar arithmetic flags üretir. RISC-V temel tamsayı tasarımında genel bir flags registerına dayanmaz. Dallanma komutları operandları doğrudan karşılaştırır.
Bu yaklaşım:
- gizli durum bağımlılığını azaltır,
- out-of-order tasarımda bağımlılık izlemeyi sadeleştirebilir,
- branch semantiğini komutta açık tutar.
Başka ISA'larda bayraklar çok yararlı olabilir; tasarım tercihi mutlak üstünlük değildir.
Komut biçimleri
RISC-V temel kodlamasında R, I, S, B, U ve J biçimleri bulunur.
R: register-register
I: immediate, load, jalr
S: store
B: conditional branch
U: upper immediate
J: jump
Alanların yerleşimi immediate üretimini ve donanım decode'unu kolaylaştıracak biçimde düzenlenmiştir.
Sabit uzunluklu temel kodlamaya rağmen RISC-V'de sıkıştırılmış komut uzantısı code density sağlayabilir. Bu, "RISC her zaman bütün komutları aynı uzunluktadır" genellemesinin modern ISA'lar için mutlak olmadığını gösterir.
Komut sınıfları
Genel sınıflar:
- veri transferi,
- arithmetic,
- logic/bit manipulation,
- shift,
- compare,
- control transfer,
- atomic/synchronization,
- floating point,
- vector/SIMD,
- system/privileged,
- cryptographic operations.
Load/store ISA'da bellek erişimi aritmetikten ayrılır.
Adresleme biçimleri
Yaygın kipler:
- immediate,
- register,
- direct,
- register indirect,
- base + offset,
- indexed,
- PC-relative.
RISC-V yükleme/saklamada temel olarak base+offset kullanır:
lw t0, 16(sp)Efektif adres:
EA = sp + 16PC-relative yapı position-independent code ve linkleme için önemlidir.
Hizalama ve bayt sırası
Bir nesnenin doğal sınırına yerleşmesi alignment'dır. Hizasız erişim bazı mimarilerde donanımca desteklenebilir, bazı sistemlerde trap üretebilir veya daha pahalı olabilir.
Little-endian gösterimde düşük anlamlı bayt düşük adreste, big-endian gösterimde yüksek anlamlı bayt düşük adrestedir.
Bayt sırası register içindeki sayının matematiksel değerini değil, bellekte baytların adres sırasını etkiler.
Program kontrolü
Kontrol komutları PC'yi değiştirir:
- conditional branch,
- unconditional jump,
- call,
- return,
- trap/system call.
RISC-V'te jal dönüş adresini yazar ve hedefe atlar. jalr register tabanlı hedef kullanır.
Sözde komut
Assembler kullanışlı bir sözdizimini bir veya daha çok gerçek komuta çevirebilir.
Örneğin:
mv a0, a1temel ISA'da uygun bir addi biçimine çevrilebilir.
Performans incelerken kaynak assembly satırı ile gerçek makine komutu sayısı karıştırılmamalıdır.
Durum bitleri ve PSW
Bazı ISA'lar arithmetic sonucunda durum bitleri üretir:
Z  zero
N/S sign
C  carry
V  signed overflow
Bu bitler koşullu branch, çok duyarlıklı arithmetic veya sistem durumunun parçası olabilir. RISC-V'in temel integer tasarımı genel bir condition-code registerına dayanmaz; x86 ve birçok tarihsel ISA ise bayrakları yoğun kullanır.
Klasik Processor Status Word (PSW) terimi program sayacı dışındaki execution state'in bir bölümünü; condition code, privilege, interrupt mask ve control bitlerini birlikte ifade edebilir. Güncel ISA'larda aynı işlev farklı control/status registerlarına dağılmış olabilir.
Alt yordam, yığın ve ABI
Çağrı sırasında:
- argümanlar yerleştirilir,
- dönüş adresi korunur,
- gerekli caller/callee-saved yazmaçlar saklanır,
- yerel alan için stack frame ayrılır,
- yordam çalışır,
- durum geri yüklenir.
Özyineleme her çağrıya ayrı stack frame verdiği için doğal biçimde desteklenir.
ABI:
- argument registerlarını,
- return value yerini,
- caller-saved/callee-saved kümelerini,
- stack alignment'ını,
- veri tipi yerleşimini,
- çağrı sözleşmesini
tanımlar.
Derleme, assembly, link ve yükleme
Nesne dosyası yalnız machine code değildir. Kod, veri, sembol ve relocation bilgisi içerir.
Tipik bölümler:
.text
.rodata
.data
.bss
Linker sembolleri çözer ve relocation uygular. Dinamik linker paylaşılan kütüphaneleri süreç adres alanına bağlayabilir.
Loader sanal adres alanını oluşturur, segmentleri eşler ve başlangıç noktasına kontrol verir.
Sistem çağrıları, istisna ve ayrıcalık
Interrupt çoğunlukla dış ve asenkron olaydır.
Istisna yürütülen komutla ilişkili senkron olaydır.
Trap terimi mimariye göre istisna ailesini veya bilinçli yazılım geçişini kapsayabilir.
RISC-V ayrıcalık modeli temel olarak:
U  User
S  Supervisor
M  Machine
düzeylerini tanımlar; sanallaştırma için hypervisor uzantıları bulunabilir.
ecall, daha ayrıcalıklı yazılımdan hizmet ister. mepc, mtvec ve neden kayıtları gibi CSR'lar trap yönetiminde kullanılır.
Ayrıcalık, işletim sistemi izolasyonunun donanım temelidir.
Ünite 3: RISC-V Programlama, Derleyici ve Bellek Düzeni
Assembly okumak
Assembly yazabilmek yararlıdır; derleyici çıktısını okuyabilmek daha geneldir.
Bir optimizasyon incelemesinde:
gcc -O0
gcc -O2
objdump -d
gibi araçlarla kaynak kodun makine komutlarına nasıl dönüştüğü görülebilir.
-O0 kaynak yapıya yakın kod üretir. -O2 constant folding, dead-code elimination, inlining, common subexpression elimination, loop transformations ve register bellek ayırma gibi çok sayıda eniyileme uygulayabilir.
Yazmaç ile aritmetik
RISC-V load/store olduğundan arithmetic operandlar çoğunlukla registerdadır.
add t0, t1, t2
addi t0, t1, 16
sub t3, t4, t5
Immediate genişliği sınırlıysa assembler daha büyük sabit için birden çok komut üretebilir.
Bellek erişimi
Yükleme/saklama veri genişliğini ve signed/unsigned yorumunu belirtir.
lb   t0, 0(a0)
lbu  t0, 0(a0)
lh   t0, 0(a0)
lw   t0, 0(a0)
sw   t0, 0(a0)
Signed load üst bitleri sign-extend eder; unsigned load zero-extend eder.
Dizi ve erişim kalıbı
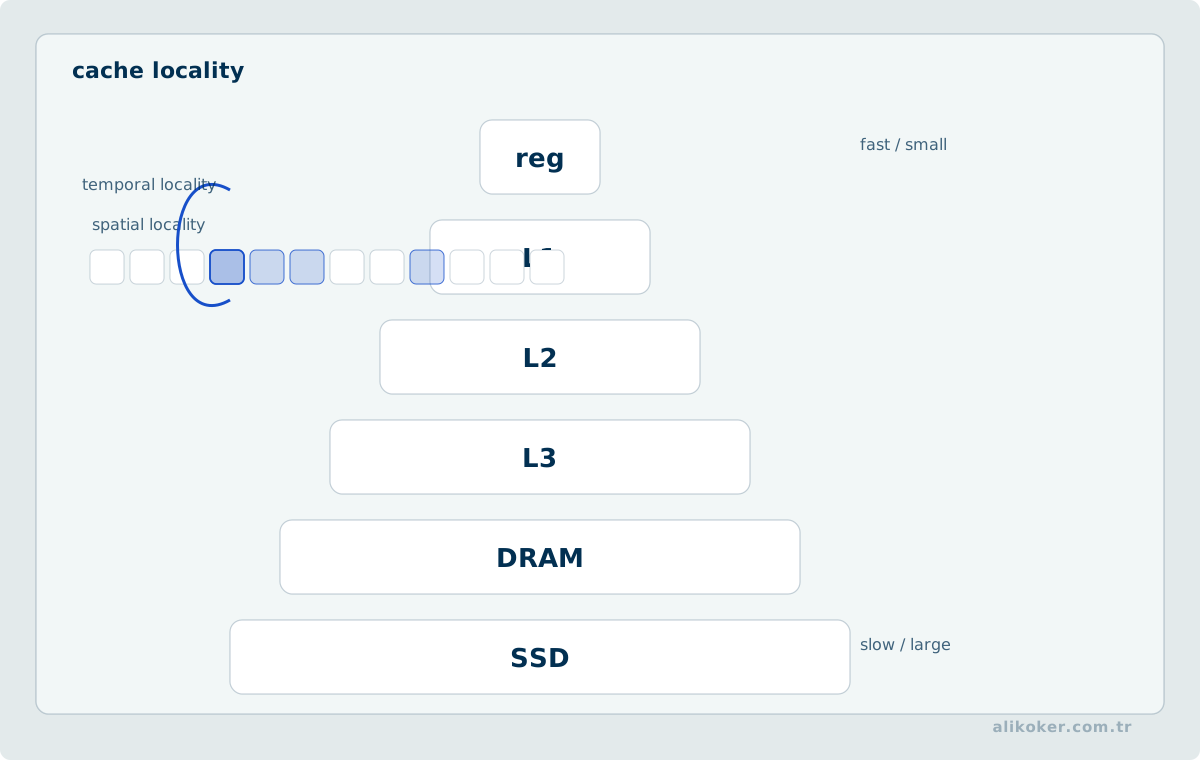
Satır öncelikli bir dizide ardışık elemanları dolaşmak önbellek satırı'ları iyi kullanır.
A[0], A[1], A[2], ...Büyük matrislerde satır ve sütun erişim sırası aynı hesap sayısına rağmen çok farklı önbellek davranışı oluşturabilir.
Bu nokta mimari ile algoritmanın doğrudan buluştuğu yerdir.
Yapılar ve dolgulama
C struct alanları doğal hizalama gereksinimi nedeniyle aralarında dolgulama taşıyabilir.
struct X {
    char  a;
    int   b;
    short c;
};
Kaynak düzeyinde görünen alan toplamı ile sizeof(X) aynı olmak zorunda değildir.
Alan sırası:
- önbellek bellek ayak izi,
- bellek bant genişliği,
- ABI uyumu,
- false sharing
üzerinde etkili olabilir.
Bağlı liste ve pointer chasing
Bağlı liste ardışık olmak zorunda değildir. Her düğüm sonraki düğümün adresini içerir.
Bu yapı:
- spatial locality'yi zayıflatabilir,
- hardware prefetcher'ın işini zorlaştırabilir,
- bellek gecikmesini gizlemeyi güçleştirebilir.
Algoritmik karmaşıklık aynı olsa bile veri düzeni performansı değiştirir.
Özyineleme
Her recursive çağrı stack frame üretir. Çok derin recursion:
- stack tüketimini,
- call/return yükünü,
- instruction-önbellek davranışını
etkiler.
Tail-call optimization uygulanabiliyorsa bazı çağrılar yeni frame oluşturmadan dönüşebilir; bunun uygulanması dil, ABI ve derleyici koşullarına bağlıdır.
Döngü açma
Loop unrolling branch ve loop-control komutlarının oranını azaltabilir ve ILP'yi artırabilir.
Bedelleri:
- code size büyür,
- instruction önbellek baskısı artabilir,
- register pressure artabilir.
Bu nedenle daha çok unroll her zaman daha hızlı değildir.
Otomatik vektörleştirme
Derleyici bağımsız iterasyonları SIMD/vector komutlarına dönüştürebilir.
Bunu engelleyen yaygın nedenler:
- alias belirsizliği,
- loop-carried dependency,
- düzensiz bellek erişimi,
- bilinmeyen iteration count,
- alignment veya istisna semantiği.
Derleyici raporları neden vectorize edilmediğini gösterebilir.
Bellek eşlemeli G/Ç
MMIO'da aygıt registerları normal adres alanındaki özel adreslerde görünür.
load/store
   ↓
adres çözme
   ↓
RAM veya aygıt
Normal bellek gibi görünse de aygıt registerı:
- yan etki üretebilir,
- önbelleğe alınmamalıdır,
- ordering gerektirebilir.
Derleyici volatile semantiği ve mimari memory barrier'ları ayrı sorunları çözer. volatile tek başına çok çekirdek synchronization mekanizması değildir.
UART
Basit UART sürücüsünde program:
- status registerı okur,
- transmitter hazırsa data registera bayt yazar,
- hazır değilse polling yapar veya interrupt bekler.
Bu küçük örnek CPU, MMIO, interrupt ve aygıt zamanlamasını aynı yerde gösterir.
Araç zinciri
RISC-V geliştirmede:
- assembler,
- linker,
objdump,- debugger,
- RARS gibi eğitim benzetimlikleri,
- QEMU gibi sistem emülatörleri,
- RTL tasarımında Verilog/SystemVerilog,
- FPGA prototipleme
kullanılabilir.
Bir yorumlayıcı yazmak ISA'yı; boru hattı simulator yazmak hazard'ları; önbellek simulator yazmak locality ve eşleme'i somutlaştırır.
Ünite 4: Sayısal Tasarım, Veri Yolu ve İşlemci Denetimi
Mantık kapılarından işlemciye
Bir işlemci, soyut komutların fiziksel devrelerde gerçekleştirilmiş halidir. En alt düzeyde:
- AND, OR, XOR, NOT,
- NAND, NOR,
- çoklayıcı,
- kod çözücü,
- kodlayıcı,
- flip-flop,
- yazmaç,
- sayaç
gibi yapı taşları bulunur.
Boole cebri aynı işlevi daha az kapıyla gerçekleştirmeyi sağlar. De Morgan kuralları, Karnaugh haritası ve Quine-McCluskey gibi yöntemler mantık sadeleştirmede kullanılır. Güncel büyük tasarımlarda bu işleri EDA araçları yapar; fakat gecikme, kapı sayısı ve mantıksal eşdeğerlik ilişkisini anlamak için temel yöntemler önemini korur.
Birleşik ve ardışıl mantık
Birleşik devre çıkışı yalnız o andaki girişlere bağlıdır.
Ardışıl devre geçmiş durumu da taşır.
birleşik: y = f(x)
ardışıl:  state_next = f(state, x)
Flip-flop bir bitlik durumun temelidir. Yazmaçlar çok sayıda flip-flopun birlikte çalışmasıyla oluşturulabilir.
Mealy ve Moore
Sonlu durum makinelerinde:
- Moore çıkışı yalnız duruma,
- Mealy çıkışı durum ve girişe
bağlıdır.
İşlemci denetim birimi, önbellek denetleyici, bus protocol ve çevre birimi denetleyicileri durum makineleriyle modellenebilir.
Veri yolu
Datapath komutu gerçekleştiren veri hareket yollarıdır.
Basit bir RISC-V veri yolu şunları içerir:
PC
↓
instruction memory
↓
decode / register file
↓
immediate generator
↓
ALU
↓
data memory
↓
write-back mux
↓
register file
Dallanma ve atlama için PC'nin birden çok yeni değer adayı olur. Çoklayıcı denetim sinyaline göre doğru adayı seçer.
Yazmaç öbeği
Basit integer boru hattı çoğu komutta aynı anda iki kaynak register okuyup bir hedef register yazmak ister. Bu nedenle register file çok portlu olabilir.
Register file küçük ve hızlıdır, fakat fiziksel port sayısı arttıkça:
- alan,
- güç,
- kablolama,
- erişim gecikmesi
artar.
Superscalar işlemciler bu yüzden mimari register sayısından çok daha karmaşık fiziksel register yapıları kullanabilir.
ALU
Aritmetik mantık birimi:
- toplama,
- çıkarma,
- AND/OR/XOR,
- karşılaştırma,
- kaydırma
gibi temel işlemleri yapar.
Bir compare işlemi ayrıca özel comparator ile veya subtract sonucundan türetilebilir. Tasarım kararı kritik yol, alan ve güç hedeflerine bağlıdır.
Tek çevrimli işlemci
Single-cycle işlemci, her mimari komutun durum değişimini tek saat aralığına sığdırır. Veri yolu ile denetim ilişkisini açık gösterdiği için öğreticidir; zamanlama açısından ise en kötü yolu bütün komutlara dayatır.
Örneğin add yalnız register read ve ALU yolunu kullanabilirken load:
fetch
→ decode/register read
→ adres hesabı
→ veri belleği
→ write back
zincirinden geçer. Clock period load gibi uzun yol için seçildiğinde basit komutların kullanılmayan zaman payı artar.
Tek çevrimli tasarım bu yüzden iyi bir referans noktasıdır; modern yüksek performanslı çekirdeklerin gerçek organizasyonu değildir.
Kritik yol
Senkron devrede saat periyodu yaklaşık en uzun register-to-register birleşik yolun gecikmesinden büyük olmalıdır:
Tclock ≥ Tcq + Tlogic,max + Tsetup + clock uncertaintyBir tasarımda performans yalnız gate sayısına bağlı değildir. En uzun zamanlama yolu belirleyicidir.
Çok çevrimli işlemci
Multi-cycle yaklaşımında bir komutun işi birkaç kısa çevrime bölünür. Böylece aynı ALU veya bellek arabirimi farklı zamanlarda yeniden kullanılabilir ve her komut gereksiz aşamalardan geçmek zorunda kalmaz.
fetch
→ decode
→ execute / adres üretimi
→ gerekirse memory
→ gerekirse write back
Aritmetik bir komutun bellek aşamasına, store komutunun ise register write-back'e ihtiyacı yoktur. Bu esneklik daha kısa saat periyodu ve daha az donanım tekrarı sağlayabilir.
Karşılığında işlemci artık yalnız opcode'a değil hangi çevrimsel durumda bulunduğuna da göre denetlenir. Ara yazmaçlar ve sonlu durum makinesi bu nedenle tasarımın temel parçası olur.
Hardwired control
Denetim sinyalleri opcode/funct alanları ve durumdan doğrudan combinational logic ile üretilebilir.
Avantajı hızlı olmasıdır.
Dezavantajı büyük ve karmaşık ISA'da denetim mantığının zor yönetilmesidir.
Mikroprogramlama
Microprogrammed control, karmaşık komutu bir dizi microinstruction ile gerçekleştirir.
machine instruction
↓
microcode address
↓
control store
↓
microinstructions
↓
datapath control signals
Yatay mikroprogramlama geniş control word ile çok sayıda sinyali doğrudan ifade eder. Paralellik yüksektir, control store büyür.
Dikey mikroprogramlama sinyalleri daha kodlanmış tutar. Alan azalır, decode eklenir.
Modern x86 işlemcilerde bazı karmaşık veya nadir komutların microcode ile desteklenmesi bu düşüncenin güncel örneğidir. Mikrocode güncellemesi belirli işlemci davranışlarını işletim sistemi/firmware aracılığıyla düzeltebilir.
Mikro mimari ile ISA sözleşmesi
Bir ADD komutunun ISA anlamı:
rd = rs1 + rs2olabilir.
Bu komutun:
- tek çevrimde,
- beş aşamalı boru hattında,
- out-of-order çekirdekte,
- farklı ALU clusterlarında
yürütülmesi ISA açısından görünür olmak zorunda değildir.
Bu ayrım bilgisayar mimarisinin merkezidir.
Ünite 5: Bilgisayar Aritmetiği ve Sayısal Veri Yolları
Sayı gösterimleri
n bitlik unsigned aralık:
0 ... 2^n - 1İki'nin tümleyeni signed aralık:
-2^(n-1) ... 2^(n-1)-1Sign-magnitude ve one's complement tarihsel öneme sahiptir; iki ayrı sıfır gibi dezavantajları vardır.
İki'nin tümleyeninde negatif değer:
~x + 1ile elde edilir. Aynı binary adder signed ve unsigned toplama için kullanılabilir; yorum ve overflow denetimi farklıdır.
Carry ve overflow
Carry unsigned genişlik taşmasını anlatır.
Signed overflow iki'nin tümleyeninde temsil aralığı aşıldığında oluşur.
Örneğin 8 bit:
127 + 1 = 10000000₂bit deseni -128 olarak yorumlanır; signed overflow vardır.
Carry ile overflow eş anlamlı değildir.
Sign extension ve zero extension
Signed küçük değer genişletilirken üst bitlere sign biti kopyalanır.
Unsigned değer genişletilirken sıfır eklenir.
Bu ayrım ISA'daki signed/unsigned load ve compare davranışında doğrudan görülür.
Toplayıcı
En basit çok bitli adder, full-adder hücrelerini zincirler. Ripple-carry adder'da carry bir bitten sonrakine ilerler. Alan küçüktür, gecikme bit sayısıyla büyür.
Carry-lookahead
Carry-lookahead, her bit için generate/propagate bilgisiyle carry değerlerini daha paralel hesaplar.
Gi = Ai Bi
Pi = Ai xor Bi
Ci+1 = Gi + Pi Ci
Amaç carry'nin bit bit dalgalanmasını beklememektir.
Daha hızlıdır; mantık ve kablolama maliyeti artar.
Carry-select ve parallel-prefix
Carry-select bir blok için carry-in 0 ve 1 sonuçlarını önceden hesaplayıp gerçek carry geldiğinde seçim yapar.
Kogge-Stone benzeri parallel-prefix aileleri çok geniş toplayıcılarda carry bilgisini ağaç biçiminde yayabilir.
Gerçek tasarımda en hızlı adder her zaman en iyi değildir. Alan, güç, wire delay ve hedef frekans birlikte düşünülür.
Çıkarma
İki'nin tümleyeninde:
A - B = A + (~B + 1)olduğundan adder/subtractor aynı toplama donanımını paylaşabilir.
Kaydırma
Logical shift boşalan bitlere sıfır koyar.
Arithmetic right shift signed sayıda sign bitini korur.
Barrel shifter, çok bitlik kaydırmayı tek combinational aşamada yapabilir. Bedeli daha fazla mux ve bağlantıdır.
Çarpma: kaydır-topla
Unsigned binary multiplication kısmi çarpımların toplanmasıdır.
multiplier biti 1 ise
multiplicand'ın kaydırılmış kopyasını ekle
Basit iteratif çarpıcı az donanım kullanabilir ama birçok çevrim sürer.
Booth algoritması
Booth signed iki'nin tümleyeni çarpmada ardışık 1 dizilerini daha az add/sub işlemiyle kodlayabilir.
Modified Booth radix-4, multiplier bitlerini daha büyük gruplar halinde ele alarak partial-product sayısını yaklaşık yarıya düşürür.
Array ve Wallace-tree multiplier
Array multiplier düzenli fiziksel yapı sunar.
Wallace/Dadda türü ağaçlar partial product'ları carry-save teknikleriyle paralel indirger. Derinliği azaltarak yüksek hızlı multiplication için uygundur.
Son aşamada carry-propagate adder gerekir.
Bölme
Restoring division ara kalan negatif olursa önceki değeri geri yükler.
Non-restoring division geri yükleme adımını sonraki iterasyonla birleştirir.
SRT division bölüm basamaklarını redundant digit set ile seçerek yüksek performanslı dividerlarda kullanılabilir.
Division genellikle addition/multiplication'dan daha uzun gecikmeye sahiptir. Bazı çekirdeklerde pipelined olmayabilir.
Sabit nokta
Fixed-point sayı gerçek değeri implicit bir scale ile temsil eder.
Örneğin Q biçimlerinde binary point fiziksel olarak saklanmaz; yazılım/donanım sözleşmesiyle konumu bilinir.
Gömülü DSP ve düşük güç çıkarımda:
- tahmin edilebilir maliyet,
- integer donanımıyla işlem,
- düşük bellek
avantajı sağlayabilir.
IEEE 754
Floating-point sayı:
sign | exponent | significandalanlarıyla temsil edilir.
IEEE 754:
- normal,
- subnormal,
- ±0,
- ±∞,
- NaN
gibi durumları tanımlar.
Floating-point reel sayıların tam kümesi değildir. Birçok ondalık değer binary biçimde tam temsil edilemez.
Floating-point toplama
Temel adımlar:
- exponentları karşılaştır,
- küçük significand'ı hizala,
- add/subtract,
- normalize,
- round,
- istisna/flag durumunu üret.
Bu işlem integer addition'dan daha karmaşıktır.
Floating-point çarpma
sign = signA xor signB
exponent = exponentA + exponentB - bias
significand = significandA × significandB
ardından normalize ve round yapılır.
Yuvarlama
Varsayılan yaygın kip:
round to nearest, ties to evendir.
Guard, round ve sticky bitleri doğru yuvarlamada kullanılabilir.
Floating-point işlemlerin birleşme özelliği yoktur:
(a+b)+cile:
a+(b+c)farklı bit sonucu üretebilir.
Paralel reduction sırasının sonuç üzerinde küçük fark oluşturabilmesinin nedeni budur.
Fused multiply-add
FMA:
a × b + cişlemini ara çarpımı ayrı yuvarlamadan yapar.
Kazanç:
- tek rounding,
- daha yüksek doğruluk,
- yüksek arithmetic işlem hacmi.
Matrix, DSP ve machine-learning çekirdeklerinde kritik bir yapı taşıdır.
FP16, BF16, TF32 ve FP8
FP16 daha dar exponent/significand ile bellek ve compute maliyetini düşürür.
**BF16** FP32'ye yakın exponent aralığını korurken significand'ı daraltır. Deep-learning eğitiminde geniş dinamik aralık avantajı sağlar.
TF32 NVIDIA tensor işlemlerinde kullanılan hesaplama formatıdır; software depolama tipi olarak FP32 ile aynı kavram değildir.
FP8 E4M3/E5M2 gibi formatlarla özellikle AI workloadlarında daha yüksek yoğunluk sağlar. Dar hassasiyet quantization, scaling ve overflow yönetimini gerekli kılar.
Mixed precision
Training'de farklı aşamalar farklı hassasiyet kullanabilir:
düşük hassasiyetli matris işlemi
↓
daha yüksek hassasiyetli accumulation
↓
gerekirse master weights
Amaç işlem hacmi ve memory bant genişliği kazanırken accuracy kaybını kontrol etmektir.
Integer quantization
INT8/INT4 gibi formatlar çıkarımda:
- model boyutunu,
- memory traffic'i,
- enerji tüketimini
azaltabilir.
Bunun karşılığında scale, zero-point, calibration ve saturation davranışı gerekir.
Sayısal format seçimi yalnız ALU konusu değildir; bellek sistemi ve model doğruluğuyla birlikte değerlendirilir.
Ünite 6: Boru Hattı, Komut Düzeyi Paralellik ve Sırasız Yürütme
Flynn sınıflandırması
Komut ve veri akışına göre klasik sınıflandırma:
- Sınıf: SISD; Komut akışı: tek; Veri akışı: tek
- Sınıf: SIMD; Komut akışı: tek; Veri akışı: çok
- Sınıf: MISD; Komut akışı: çok; Veri akışı: tek
- Sınıf: MIMD; Komut akışı: çok; Veri akışı: çok
SIMD veri düzeyi paralelliği, MIMD ise modern çok çekirdek ve çok işlemcili sistemleri anlamak için yararlıdır. MISD genel amaçlı sistemlerde nadirdir. Güncel GPU ve heterojen sistemler bu dört kutuya bütünüyle sığmayabilir; sınıflandırma yine de temel düşünceyi açıklar.
Aritmetik boru hattı
Kayan nokta toplama gibi bir işlem kendi içinde boru hattına ayrılabilir:
üs karşılaştır
→ significand hizala
→ topla/çıkar
→ normalize
→ yuvarla/paketle
Bir operand çifti normalize olurken sonraki çift toplama aşamasında, daha sonraki çift hizalama aşamasında olabilir. Fonksiyonel birimin gecikmesi birkaç cycle olsa da initiation interval bir cycle olabilir.
Işlem hattı
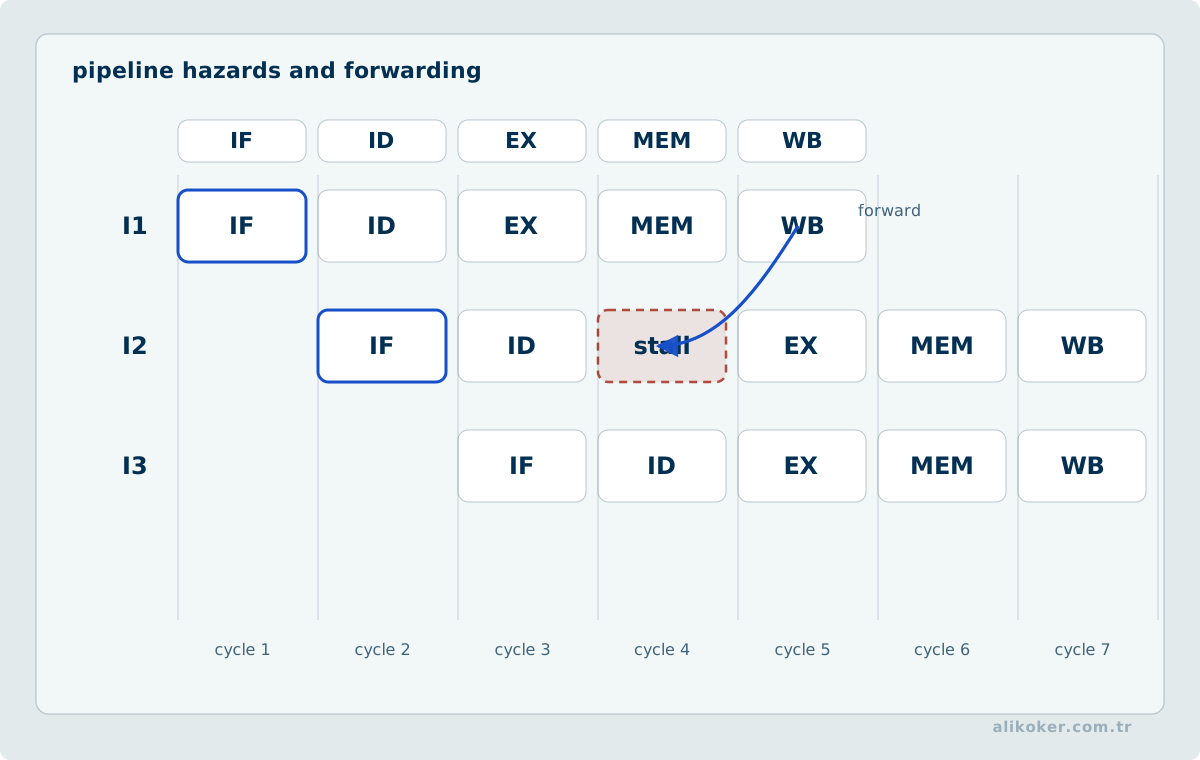
Boru hattı, veri yolunu zamansal olarak bölerek aynı anda farklı komutların farklı işlerini yürütür. Yaygın öğretim modeli beş aşamalıdır:
IF → ID → EX → MEM → WB- IF komutu getirir,
- ID komutu çözer ve operandları hazırlar,
- EX aritmetik, adres veya dal kararını üretir,
- MEM gerekiyorsa veri belleğine erişir,
- WB mimari sonucu yazmaca taşır.
Kazanç tek komutun gecikmesini ortadan kaldırmak değildir. Asıl kazanç, ardışık komutların işlerini çakıştırarak birim zamanda daha fazla komut tamamlamaktır. Işlem hattı bu nedenle gecikmeden çok işlem hacmi tekniğidir.
İdeal süre
k aşama, n komut ve her aşama t sürüyorsa:
Tpipe = (k+n-1)tİdeal uzun akışta yaklaşık bir komut/çevrim tamamlanabilir.
Gerçek CPI:
CPI ≈ ideal CPI + stall cycles / retired instructionsşeklinde düşünülür.
Işlem hattı derinliği
Aşamaları bölmek saat periyodu'u azaltabilir.
Ancak:
- boru hattı register ek yük (overhead),
- saat kayması,
- atlatma ağı,
- dal yanlış tahmini ceza,
- wakeup/select karmaşıklığı
artar.
Pentium 4 dönemi yüksek frekans için çok derin boru hattının bedellerini göstermiştir. Güncel tasarımlar frekans ile enerji/IPC arasında denge kurar.
Structural hazard
İki komut aynı fiziksel kaynağı aynı anda isterse oluşur.
Çözümler:
- ayrı instruction/data önbellek,
- çok port,
- resource replication,
- scheduling,
- stall.
RAW, WAR ve WAW
RAW gerçek veri bağımlılığıdır:
I1: R1 = ...
I2: ... = R1
WAR name dependence:
I1: ... = R1
I2: R1 = ...
WAW output dependence:
I1: R1 = ...
I2: R1 = ...
In-order basit boru hattında RAW temel sorundur. Out-of-order çekirdekte WAR/WAW da fiziksel register kullanımıyla yönetilmelidir.
Forwarding
Sonuç register file'a dönmeden tüketici'a verilebilir:
EX/MEM result → EX inputBu bypass ağı birçok RAW stall'ını kaldırır.
Load-use bağımlılığında veri önbellekten daha geç geldiği için bir veya daha çok stall gerekebilir.
Stall ve bubble
Hazard çözülemiyorsa boru hattı ilerlemesi durdurulur. Boş işlem bubble/NOP olarak düşünülebilir.
Stall correctness'i korur, işlem hacmini düşürür.
Control hazard
Branch hedefi ve yönü bilinmeden doğru next PC kesin değildir.
Branch resolution geç aşamadaysa yanlış tahmin daha çok spekülatif komutu iptal eder.
Statik tahmin
Basit politikalar:
- always not taken,
- always taken,
- backward taken/forward not taken.
Donanım maliyeti düşüktür. Veri bağımlı branchlerde sınırlıdır.
İki bitli tahminci
Saturating counter dört durum taşır:
strong NT
weak NT
weak T
strong T
Tek ters sonuç tahmini hemen tamamen çevirmeyebilir.
Yerel ve küresel history
Local predictor aynı branch'in geçmişini izler.
Global predictor son branchlerin ortak geçmişini kullanır.
gshare, global history ile branch adresinin bitlerini XOR'layarak pattern table indeksleyebilir.
Tournament predictor
Birden çok predictor çalıştırılır ve meta-predictor hangi tahmincinin o branch için daha başarılı olduğuna karar verir.
Modern ticari branch predictor ayrıntıları çoğunlukla uygulamaya özeldir; temel fikir farklı korelasyon kaynaklarını birleştirmektir.
Branch target buffer ve return predictor
Direction doğru olsa bile hedef adresin geç hesaplanması fetch'i bekletebilir.
BTB bilinen branch hedeflerini önbellekler.
Return address stack, call/return deseninde dönüş hedefini tahmin eder.
Superscalar
Superscalar çekirdek bir cycle içinde birden çok bağımsız komutu issue/execute/retire etmeyi amaçlar.
Örneğin 4-wide tasarım teorik olarak cycle başına dört komut işleyebilir. Gerçek IPC:
- dependency,
- önbellek kaçırması,
- branch,
- execution port,
- frontend bant genişliği,
- retirement width
tarafından sınırlanır.
Frontend
Modern boru hattının ilk tarafı:
fetch
→ branch prediction
→ instruction cache
→ predecode/decode
→ micro-op generation/cache
→ rename
gibi aşamalar içerebilir.
Frontend komut yetiştiremezse execution units boş kalır.
Mikro işlemler
x86 gibi karmaşık ISA'larda kod çözücü bir machine instructionı bir veya daha fazla micro-op'a dönüştürebilir.
Micro-op önbellek decode maliyetini tekrar tekrar ödememeyi sağlayabilir.
Bu iç temsil ISA tarafından zorunlu değildir.
Register renaming
Mimari register adı fiziksel registera eşlenir.
architectural R1 → physical P17Sonraki R1 yazımı başka fiziksel register kullanabilir. Böylece WAR ve WAW gibi false dependence'lar kaldırılır.
RAW kaldırılamaz; gerçek veri bağımlılığıdır.
Out-of-order execution
Komutlar program sırasında decode/rename edilebilir, fakat operandları hazır olan genç komutlar yaşlı bir komutu beklemeden yürütülebilir.
Amaç özellikle önbellek kaçırması veya uzun gecikme operation arkasındaki bağımsız işi kullanmaktır.
Temel yapılar:
- rename map,
- physical register file,
- issue kuyruk/reservation station,
- load/store kuyruk,
- reorder buffer,
- execution units.
Reorder buffer ve retirement
Komut fiziksel olarak sırasız çalışsa da mimari state çoğunlukla program sırasıyla commit/retire edilir.
ROB:
- komut sırasını,
- tamamlanma durumunu,
- istisna bilgisini
izler.
Bu, precise istisna sağlamayı kolaylaştırır: istisna olduğunda daha yaşlı komutlar tamamlanmış, daha gençlerin mimari etkisi görünür olmamış gibi bir durum kurulabilir.
Spekülatif yürütme
Branch henüz kesinleşmeden tahmin edilen yolda komutlar yürütülebilir.
Tahmin doğruysa gecikme gizlenir.
Yanlışsa:
- genç spekülatif işler squash edilir,
- rename/ROB state geri alınır,
- doğru PC'den fetch başlar.
Spekülasyon mimari doğruluğu korumalıdır; ancak mikro mimari side-effect'ler güvenlik açısından ayrıca önemlidir.
Memory disambiguation
Daha eski bir store'un adresi henüz bilinmiyorsa genç load'ın beklemesi güvenlidir ama yavaştır.
Modern çekirdek load'un bağımsız olduğunu tahmin ederek erkenden çalıştırabilir. Sonradan address conflict çıkarsa replay gerekir.
Bu teknik bellek düzeyi paralellik'i artırır.
Load/store kuyruk
LSQ:
- memory operation sırasını,
- adresleri,
- store-to-load forwarding'i,
- ordering violationları
yönetir.
CPU'nun memory consistency modeline uyması için kritik yapıdır.
Delayed branch ve delayed load
Eski MIPS/SPARC tasarımlarında branch/load gecikme ISA'ya görünür slotlarla yansıtılabiliyordu.
Derleyici slotu yararlı komutla doldurmaya çalışırdı.
Derin dinamik boru hatlarında bu yaklaşım ölçeklenmedi. Modern RISC-V temel ISA branch delay slot tanımlamaz.
SMT
Simultaneous multithreading, aynı çekirdeğin execution kaynaklarını aynı anda birden fazla hardware iş parçacığı ile doldurabilir.
Bir iş parçacığı önbellek kaçırması beklerken diğeri kaynak kullanabilir.
Bedeller:
- önbellek ve TLB paylaşımı,
- execution contention,
- güvenlik/izolasyon etkileri,
- tek-iş parçacığı performansında değişkenlik.
Ünite 7: Vektör İşleme, GPU ve Alana Özgü Hızlandırıcılar
Veri düzeyi paralellik
Aynı işlemin çok sayıda öğeye uygulanması DLP'dir.
C[i] = A[i] + B[i]her i için bağımsızsa vector/SIMD işlemeye uygundur.
SIMD ile vektör ISA farkı
Fixed-width SIMD belirli genişlikte register kullanır:
128 / 256 / 512 bitRISC-V Vector gibi vector-length-agnostic yaklaşım, uygulamanın donanımın VLEN değerini sabit varsaymamasına izin verir.
Bu ayrım portable vector code için önemlidir.
Vector register ve element width
Vector instruction:
- element width,
- vector length,
- mask,
- tail policy
gibi state ile çalışabilir.
Tek komut çok sayıda element üzerinde işlemi temsil eder. Hardware içerde işi lane'lere bölebilir.
Strip mining
Problem vektör register kapasitesinden büyükse parçalara ayrılır:
while kalan > 0:
    VL = min(kalan, donanımın_uygun_VL_değeri)
    vector_operation(VL)
    kalan -= VL
Vector-length-agnostic kodun temelidir.
Chaining
Bir vector operation'ın ilk sonuçları tüm vector tamamlanmadan sonraki unit'e aktarılabiliyorsa chaining oluşur.
V1 = A + B
V2 = V1 × C
Burada multiplier ilk V1 öğeleri çıkar çıkmaz çalışmaya başlayabilir. Üretici ile tüketici vector operation arasında bütün vektörü bekleme zorunluluğu azalır.
Bellek bankalama ve interleaving
Vektör unit yüksek element işlem hacmi üretiyorsa bellek de buna yetişmelidir.
Ardışık adresler farklı bankalara dağıtılabilir:
address 0 → bank 0
address 1 → bank 1
address 2 → bank 2
...
Bağımsız banklar overlap access sağlar. Stride ile bank sayısı arasında kötü ortak bölen ilişkisi bank conflict üretebilir.
Mask
Koşullu vector işlemde yalnız seçilen lane'ler etkilenir.
Bu, kısa branchlerden kaçınabilir; fakat maskesi seyrek iş yükünde execution verimi düşebilir.
Gather ve scatter
Ardışık load en verimli durumdur.
Gather farklı adreslerden vectora toplar.
Scatter vector öğelerini farklı adreslere yazar.
Düzensiz erişim önbellek, TLB ve memory coalescing açısından pahalı olabilir.
SIMD, SIMT ve GPU
GPU programlama modeli sıklıkla SIMT olarak açıklanır: çok sayıda iş parçacığı benzer instruction akışını gruplar halinde yürütür.
NVIDIA terminolojisinde warp, AMD'de wavefront benzeri gruplamalar bulunur.
GPU:
- çok sayıda arithmetic lane,
- yüksek memory bant genişliği,
- gecikme gizlemek için çok sayıda resident iş parçacığı
kullanır.
CPU ise büyük önbellek, gelişmiş branch predictor ve OoO ile düşük iş parçacığı gecikmesine daha çok yatırım yapar.
Warp divergence
Aynı warp içindeki iş parçacıkları farklı branch yönlerine giderse yollar maskelerle ayrı ayrı yürütülebilir.
if (cond)
  A
else
  B
cond lane'ler arasında farklıysa etkin lane oranı düşebilir.
Bu nedenle GPU'da kontrol akışının düzeni önemlidir.
Memory coalescing
Komşu iş parçacıklarıin komşu adreslere erişmesi memory transactionları birleştirmeyi kolaylaştırır.
Düzensiz erişim daha çok transaction ve bant genişliği israfı doğurabilir.
CPU'daki spatial locality ile aynı temel fikrin GPU ölçeğindeki karşılığıdır.
GPU bellek katmanları
Uygulamaya göre:
- register,
- shared/local scratchpad,
- L1,
- L2,
- global device memory,
- constant/read-only alanlar
bulunabilir.
Shared memory yazılımla yönetilen düşük gecikmeli scratchpad rolü görebilir.
HBM
High Bandwidth Memory, geniş veri yollarını 2.5D/3D paketleme ile işlemci veya hızlandırıcıya yaklaştırır.
Amaç yalnız capacity değil çok yüksek aggregate bant genişliğidir.
AI/HPC performansında compute unit sayısı kadar HBM bant genişliği ve capacity de sınır oluşturabilir.
Tensor çekirdek ve systolic array
Matrix multiply-accumulate:
D = A × B + CAI ve bilimsel hesaplamada çok baskındır.
Tensor çekirdek türü birimler küçük matris parçalarını yoğun MAC donanımıyla işler.
Systolic array, veriyi komşu processing elementlar arasında ritmik biçimde hareket ettirerek reuse artırabilir ve global data movement'ı azaltabilir.
TPU tasarımlarının klasik özelliği bu düşüncedir.
NPU
NPU genel amaçlı CPU yerine:
- convolution,
- matrix multiply,
- activation,
- quantized arithmetic,
- tensor data movement
gibi neural-network operasyonlarına optimize edilir.
Mobil/edge NPU için energy efficiency çoğu zaman peak FLOPS'tan daha önemlidir.
FPGA
FPGA LUT, flip-flop, block RAM, DSP block ve programmable interconnect üzerinden uygulamaya özel data path oluşturabilir.
CPU gibi komut fetch etmek yerine algoritmanın bir bölümünü spatial hardware olarak gerçekleştirebilir.
Kazanç:
- deterministik boru hattı,
- özel bit genişliği,
- yüksek I/O parallelism.
Bedel:
- geliştirme karmaşıklığı,
- daha düşük genel amaçlı frekans,
- kaynak sınırı.
ASIC
Application-specific integrated circuit belirli işi en yüksek verimle yapmak için özelleşebilir.
Enerji/işlem avantajı yüksektir; NRE ve tasarım süresi yüksektir.
Alana özgü mimarinin uç noktasıdır.
Roofline modeli
Performans iki temel tavanla sınırlanabilir:
compute ceiling
memory-bandwidth ceiling
Arithmetic intensity:
yapılan işlem / taşınan baytolarak düşünülür.
Düşük arithmetic intensity → memory-bound.
Yüksek arithmetic intensity → compute-bound olabilir.
Bir kernel'i optimize etmeden önce hangi çatıya çarptığını bilmek gerekir.
Süper bilgisayar
Bir HPC sistem yalnız hızlı CPU/GPU değildir:
- compute node,
- HBM/DRAM,
- high-radix low-gecikme interconnect,
- parallel depolama,
- topology-aware zamanlayıcı,
- power/cooling
birlikte tasarlanır.
GFLOPS/TFLOPS/PFLOPS/EFLOPS yalnız arithmetic işlem hacmini anlatır. Gerçek uygulama communication, memory ve synchronization maliyetini de öder.
Ünite 8: Giriş-Çıkış, Kesme, DMA ve Yüksek Hızlı Aygıtlar
G/Ç neden ayrı bir mimari problemdir?
CPU nanosecond ölçeğinde çalışırken aygıtların veri hızı ve tepki süresi büyük aralıkta değişir.
klavye          çok düşük hız
sensör          düşük/orta hız
ağ kartı        Gbit/s-Tbit/s sınıfı
NVMe SSD        GB/s sınıfı
GPU             çok yüksek yerel veri hareketi
G/Ç alt sistemi hız, veri biçimi, hata ve zamanlama farkını denetleyici katmanıyla yönetir.
Aygıt registerları
Tipik denetleyici:
- data,
- status,
- command/control
registerları sunar.
Status:
ready
busy
error
interrupt pending
gibi bilgi taşıyabilir.
Port-mapped ve memory-mapped I/O
Port-mapped I/O ayrı I/O address space ve özel komutlar kullanır.
Memory-mapped I/O aygıt registerlarını normal adres uzayında gösterir.
RISC-V gibi load/store ISA'larda MMIO doğal yaklaşımdır.
MMIO adresleri normal DRAM gibi önbelleğe alınmamalı ve speculative access davranışı mimari kurallarla denetlenmelidir.
Sistem yolu, strobe ve handshake
Klasik veri yolu modeli adres, veri ve kontrol yollarını ayırır. Modern PCIe gibi bağlantılar fiziksel olarak paket tabanlı serial fabric olsa da bu üç işlevsel sınıf öğretici olmaya devam eder.
Basit asenkron aktarımda strobe tek taraflı "veri hazır" işareti verebilir. Tarafların zamanlama varsayımlarına bağlıdır.
Handshake iki tarafın birbirini onayladığı daha güvenli akıştır:
kaynak: veri hazır
alıcı : kabul
kaynak: isteği kaldır
alıcı : onayı kaldır
Farklı hızdaki aygıtlar için bu model güvenilirdir.
Senkron ve asenkron seri iletişim
Senkron aktarım ortak clock veya türetilmiş zamanlama ilişkisi kullanır.
UART tipi asenkron serial framing:
start
data bits
optional parity
stop
kullanabilir. Taraflar baud rate üzerinde anlaşır.
Modern yüksek hızlı dış bağlantılarda serial signaling baskındır. PCIe, USB, SATA ve Ethernet clock recovery, encoding ve birden fazla lane ile yüksek bant genişliği elde eder.
FIFO
FIFO üretici ile tüketici arasındaki kısa süreli hız farkını emer.
producer → FIFO → consumerFIFO dolduğunda protokole göre geri basınç, stall veya drop gerekir. Buffer kapasitesi işlem hacmi üretmez; burstleri zaman içinde yayar.
Karakter kodlama
ASCII tarihsel 7 bit kodlama ailesidir. Güncel metin sisteminde Unicode ve UTF-8 temel önemdedir.
UTF-8 ASCII'nin ilk 128 koduyla uyumludur ancak karakter başına bayt sayısı sabit değildir. "Bir karakter = bir bayt" varsayımı G/Ç bufferı, dosya biçimi ve string işlemlerinde hataya yol açabilir.
Daisy chain ve paralel öncelik
Klasik interrupt daisy chain'de acknowledge aygıtlar üzerinden sırayla ilerler; zincirde öndeki aygıt daha yüksek sabit öncelik alabilir. Basittir, ölçeklenmesi sınırlıdır.
Paralel öncelikte requestler merkezi priority kodlayıcıya gelir. Modern programmable interrupt denetleyiciler priority, affinity ve routing'i daha esnek yönetir.
Programmed I/O ve polling
CPU status registerı sürekli kontrol eder:
while (!READY)
    ;
Basittir. Aygıt seyrek hazır oluyorsa CPU zamanı boşa gider.
Çok kısa ve deterministik gömülü akışta polling doğru seçim olabilir. Genel amaçlı işletim sisteminde interrupt veya asynchronous I/O daha uygundur.
Interrupt-driven I/O
Aygıt hazır olduğunda interrupt üretir.
aygıt
↓
interrupt controller
↓
CPU
↓
interrupt service routine
CPU arada başka iş yapabilir.
Interrupt'ın da maliyeti vardır:
- boru hattı/control transfer,
- context state,
- önbellek pollution,
- işleyici (handler) scheduling.
Çok yüksek packet rate'te her paket için interrupt üretmek verimsiz olabilir. NIC'ler interrupt moderation ve polling hibritleri kullanabilir.
Öncelik ve maskelenme
Interrupt denetleyici:
- priority,
- masking,
- routing,
- affinity
yönetebilir.
Çok çekirdekli sistemde interrupt'ın hangi CPU'ya gittiği locality ve load balancing açısından önemlidir.
DMA
Direct Memory Access aygıt ile ana bellek arasında büyük veri bloklarını CPU'nun her word için load/store yapmasına gerek kalmadan taşır.
Tipik sıra:
CPU descriptor hazırlar
↓
DMA motoruna adres/boyut verir
↓
DMA memory ↔ device transferi yapar
↓
tamamlanınca interrupt/completion üretir
CPU control plane'i yönetir; data movement donanıma bırakılır.
Scatter-gather DMA
Tek büyük bitişik buffer gerektirmek yerine descriptor listesi kullanılır:
segment 1
segment 2
segment 3
...
Aygıt bunları tek logical transfer gibi işleyebilir.
Network ve depolama stacklerinde yaygındır.
DMA ve önbellek tutarlılığı
DMA belleği CPU önbelleklerinin arkasından değiştirebilir.
Coherent I/O sistemlerinde fabric/protokol önbellek tutarlılığı'i koruyabilir.
Non-coherent platformda sürücü:
- önbellek flush/clean,
- invalidate,
- DMA eşleme API
gibi işlemleri doğru yapmalıdır.
"DMA RAM'e yazdı, CPU otomatik görür" varsayımı bütün mimarilerde güvenli değildir.
IOMMU
IOMMU aygıt DMA adresini fiziksel belleğe çevirir ve erişimi sınırlar.
device IOVA
↓
IOMMU
↓
physical address
Kazançlar:
- device isolation,
- virtualization,
- scatter physical pages için contiguous IOVA,
- hatalı/kötü niyetli DMA'nın sınırlandırılması.
CPU MMU ile IOMMU benzer adres çeviri fikrini farklı requesterlar için uygular.
Kesme vektörü, MSI ve MSI-X
Eski sistemlerde fiziksel interrupt line kullanılırdı.
PCI Express'te MSI/MSI-X, aygıtın özel bir memory write ile interrupt mesajı oluşturmasına izin verir.
MSI-X çok sayıda vector sağlar. NIC kuyrukları farklı CPU'lara farklı vectorlarla yönlendirilebilir.
PCI Express
PCIe noktadan noktaya serial linkler ve switchlerden oluşan paket tabanlı hiyerarşik interconnecttir.
Temel öğeler:
root complex
switch
endpoint
link / lanex1, x4, x8, x16 lane sayısını belirtir.
PCIe generation yükseldikçe lane başına signaling rate artar. Ağustos 2026 itibarıyla PCIe 7.0 onaylı temel şartnamedir ve 128 GT/s signaling hızını tanımlar. Fiziksel signaling rate ile uygulamanın elde ettiği veri yükü bant genişliği aynı değildir; encoding, protocol ek yük ve trafik yönü dikkate alınır.
PCIe transaction katmanı
Aygıtlar transaction layer packet ile:
- memory read/write,
- completion,
- configuration,
- message
işlemleri yapar.
Posted write cevap beklemeden ilerleyebilir. Read request completion ister. Bu fark gecikme ve kuyruk derinliği tasarımında önemlidir.
SR-IOV
Single Root I/O Virtualization bir fiziksel PCIe fonksiyonunun birden çok Virtual Function sunmasını sağlar.
PF
├── VF0
├── VF1
└── VF2
VM veya workload'a daha doğrudan aygıt yolu verilebilir.
Kazanç:
- daha az yazılım veri yolu ek yük,
- yüksek packet/I/O işlem hacmi.
Bedel:
- migration ve policy karmaşıklığı,
- fiziksel kuyruk/resource sınırı,
- IOMMU ve isolation gereksinimi.
NVMe
NVMe tabanlı flash depolamanın düşük gecikme ve yüksek paralellik özelliğini PCIe üzerinde kullanmak için tasarlanmıştır.
SATA/AHCI'nin mekanik disk kökenli kuyruk modeline göre çok daha fazla kuyruk ve command concurrency sunar.
Host memory'de submission/completion kuyrukları bulunur. Doorbell register ile yeni command bildirilir.
NAND flash, FTL ve SSD
Flash doğrudan disk sektörü gibi davranmaz.
NAND:
- page düzeyinde program,
- block düzeyinde erase,
- sınırlı program/erase ömrü
gibi özelliklere sahiptir.
SSD denetleyicisindeki Flash Translation Layer logical block address'i fiziksel flash yerleşimine çevirir.
FTL:
- wear leveling,
- garbage collection,
- bad-block management,
- over-provisioning
yapar.
Bu nedenle SSD gecikmesi her erişimde aynı olmak zorunda değildir.
TRIM
İşletim sistemi artık kullanılmayan logical blockları aygıta bildirir.
SSD bu bilgiyi garbage collection için kullanabilir.
TRIM verinin güvenli biçimde fiziksel olarak hemen silindiğini garanti eden bir kriptografik erase mekanizması değildir.
RAID
RAID farklı diskleri:
- striping,
- mirroring,
- parity
ile birleştirebilir.
RAID performans/erişilebilirlik mekanizmasıdır; yedek değildir. Denetleyici, dosya sistemi veya kullanıcı hatası bütün RAID üyelerini birlikte etkileyebilir.
SmartNIC ve DPU
Modern ağ/depoma altyapısında CPU'dan şu işler offload edilebilir:
- virtual switch,
- encryption,
- depolama protocol,
- packet classification,
- telemetry,
- RDMA,
- tenant isolation.
SmartNIC/DPU içinde kendi CPU çekirdekleri, memory ve acceleratorlar bulunabilir.
Offload CPU cycles kazandırır; debugging ve state ownership'i karmaşıklaştırır.
Ünite 9: Bellek Hiyerarşisi, Önbellek, DRAM ve Sanal Bellek
Bellek hiyerarşisi
Bellek sistemi tek bir "büyük RAM" değildir. Her seviye farklı gecikme, kapasite, enerji ve maliyet noktasında çalışır:
register
↓
L1
↓
L2
↓
LLC/L3
↓
DRAM/HBM
↓
persistent storage
Üst seviyeler küçük ve hızlı; alt seviyeler büyük ve görece yavaştır. Hiyerarşinin amacı alt seviyeyi tamamen gizlemek değil, programın yerellik davranışını kullanarak erişimlerin büyük bölümünü daha yakın seviyelerde karşılamaktır.
Tek bir teknoloji aynı anda register gecikmesini, DRAM kapasitesini ve SSD'nin bit başına maliyetini veremediği için bu katmanlı yapı zorunludur.
Temporal ve spatial locality
Temporal locality: yakın zamanda kullanılan öğe tekrar kullanılabilir.
Spatial locality: yakın adresler kullanılabilir.
Önbellek satırı, spatial locality'yi tek transferde birden çok byte getirerek kullanır.
Kod ve veri yerleşimi locality'yi belirgin biçimde etkiler.
Working set
Bir zaman aralığında aktif kullanılan kod ve veri kümesine working set denebilir.
Working set belirli önbellek seviyesine sığarsa miss oranı ciddi düşebilir.
Bir veri yapısının birkaç byte büyümesi working set'i önbellek kapasitesinin dışına taşıyıp keskin performans değişimi oluşturabilir.
CAM ve associative memory
Content Addressable Memory normal RAM'in tersine içerik üzerinden arama yapar:
RAM: adres → veri
CAM: anahtar → eşleşen giriş
Çok sayıda karşılaştırmayı paralel yaptığı için hızlıdır, fakat alan ve enerji maliyeti yüksektir.
Kullanım alanları:
- TLB tag araması,
- ağ sınıflandırma/yönlendirme yapıları,
- belirli önbellek veya predictor lookup'ları.
Genel ana bellek yerine küçük yüksek hızlı arama yapılarında anlamlıdır.
HDD ve manyetik şerit
HDD mekanik erişim içerir:
seek + rotational latency + transferBu nedenle random I/O sequential I/O'dan çok daha pahalıdır.
Manyetik şerit random access için uygun değildir; yüksek capacity, düşük bit maliyeti ve offline/uzun süreli arşiv nedeniyle güncel sistemlerde de yaşar.
Önbellek hit ve miss
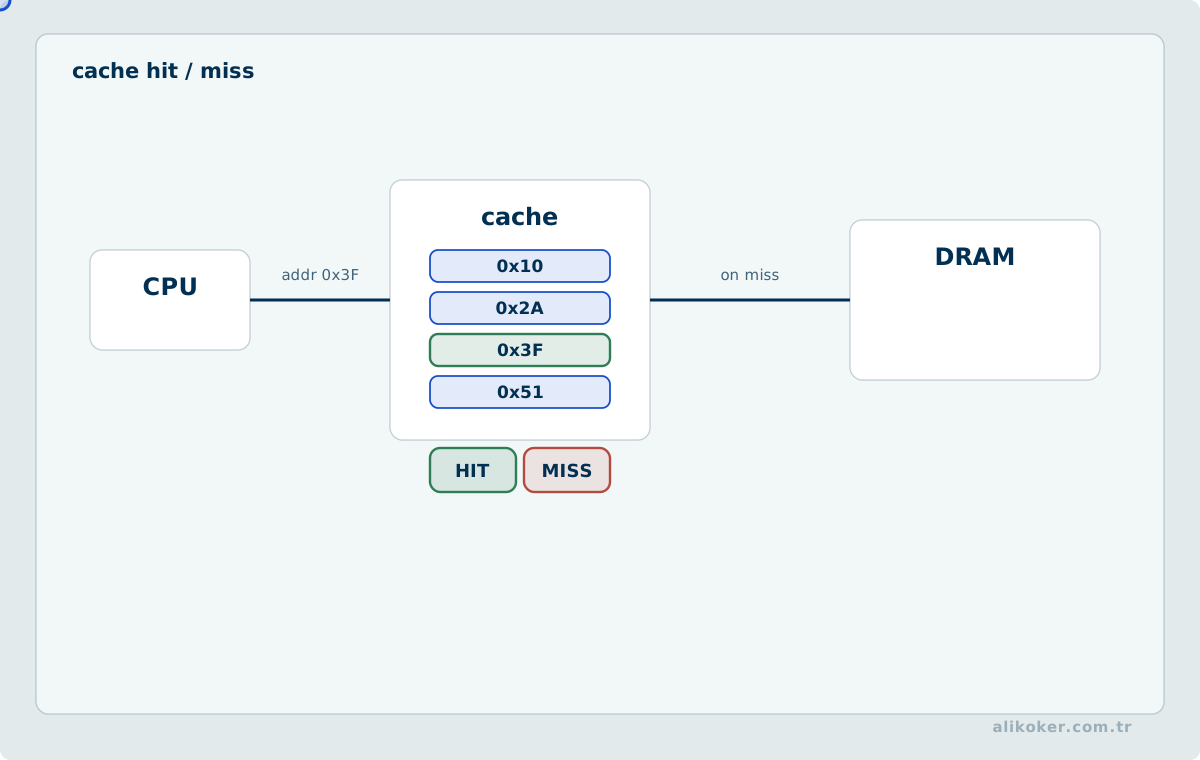
Hit: aranan line önbellekte.
Miss: daha alt seviyeden alınmalı.
Ortalama bellek erişim süresi:
AMAT = hit time + miss rate × miss penaltyÇok seviyede bu ifade iç içe uygulanır.
Düşük miss rate, çok yüksek miss ceza nedeniyle yine kritik olabilir.
Önbellek satırı
Önbellek byte byte değil block/line halinde veri taşır.
Line büyüyünce spatial locality kazancı artabilir; fakat:
- gereksiz veri taşınabilir,
- önbellek pollution artabilir,
- false sharing büyüyebilir,
- miss başına bant genişliği maliyeti artabilir.
Tek doğru line size yoktur.
Direct-mapped
Her memory block tek önbellek slotuna gider.
index = block_number mod number_of_setsHit gecikme düşük ve donanım basittir.
İki sık kullanılan block aynı index'e düşerse birbirini sürekli çıkarabilir.
Set-associative
Bir set içinde N way bulunur.
4-way:
set i → way0 | way1 | way2 | way3
Conflict miss azalır. Tag compare, mux ve replacement karmaşıklığı artar.
Fully associative
Block önbelleğin herhangi bir yerine gidebilir.
Conflict miss en aza iner; büyük önbellek için bütün tagleri paralel aramak pahalıdır.
TLB gibi küçük yapılar daha yüksek associativity kullanabilir.
Tag, index, offset
Adres kavramsal olarak:
tag | set index | block offsetbölünür.
Offset line içindeki byte'ı, index seti, tag hangi memory block olduğunu tanımlar.
Replacement
Set doluysa victim seçilir.
- LRU,
- pseudo-LRU,
- random,
- FIFO benzeri
politikalar kullanılabilir.
Tam LRU yüksek associativity'de pahalı olabilir. Gerçek CPU'lar daha karmaşık adaptif politikalar kullanabilir.
3C modeli
Klasik miss sınıflandırması:
- compulsory,
- capacity,
- conflict.
Multicore sistemde coherence kaynaklı missler ayrıca düşünülebilir.
Bu model "önbellek neden kaçırdı?" sorusunu algoritmik olarak ayırır.
Write-through ve write-back
Write-through her önbellek write'ını alt seviyeye de iletir.
Basit tutarlılık, daha yüksek yazma trafiği.
Write-back modified line'ı önbellekte tutar ve eviction olduğunda alt seviyeye yazar.
Bandwidth kazandırır; dirty state gerekir.
Write-allocate ve no-write-allocate
Write miss'te:
- write-allocate: line önbelleğe getirilir, sonra yazılır.
- no-write-allocate: önbelleğe almadan alt seviyeye yazılabilir.
Write-back çoğunlukla write-allocate ile; write-through no-write-allocate ile eşleştirilebilir, fakat bu zorunlu yasa değildir.
Write buffer
Store'un alt seviyeye tamamlanmasını CPU'nun beklememesini sağlar.
Buffer dolarsa store boru hattını yeniden stall olabilir.
Store buffer ayrıca bellek sıralaması ve store-to-load forwarding ile ilişkilidir.
Non-blocking önbellek ve MSHR
Bir önbellek kaçırması sürerken bağımsız başka erişimlerin ilerlemesine izin verilebilir.
MSHR outstanding misslerin adres ve bekleyen tüketici bilgilerini izler.
Bu yapı bellek düzeyi paralellik'in anahtarıdır.
Hardware prefetch
Prefetcher gelecekte kullanılacağını tahmin ettiği line'ı talep edilmeden getirir.
Yaygın desenler:
- sequential,
- stride,
- daha gelişmiş correlation.
İyi prefetch gecikmeyi gizler.
Yanlış/agresif prefetch:
- bant genişliği tüketir,
- önbellek pollution yapar,
- diğer çekirdekleri etkiler.
Victim önbellek
Küçük fully associative victim önbellek, ana önbellekten yeni çıkarılmış line'ları tutarak conflict missleri azaltabilir.
Özellikle direct-mapped tasarımın düşük gecikme avantajını korurken bazı çakışmaları yakalamak için tarihsel olarak önemlidir.
Inclusion
Çok seviyeli önbellek ilişkisi:
- inclusive,
- exclusive,
- non-inclusive/non-exclusive
olabilir.
Inclusive LLC snoop filtreleme gibi işleri kolaylaştırabilir; private önbellek satırı'larının LLC capacity'sini tüketmesi dezavantaj olabilir.
Instruction ve data önbellek
L1 I-önbellek ile D-önbelleğin ayrılması aynı cycle'da instruction fetch ve data access için iki bağımsız yol sunar.
Alt seviyeler unified olabilir.
Bu değiştirilmiş Harvard modelinin tipik örneğidir.
DRAM yapısı
DRAM sistemi:
memory controller
↓
channel
↓
DIMM/rank
↓
bank group/bank
↓
row
↓
column
şeklinde düşünülebilir.
Bir satır activate edildiğinde satır buffer'a gelir. Aynı satıra sonraki erişim satır hit olabilir. Farklı satır için precharge/activate gerekir.
Bu nedenle DRAM gecikme yalnız "RAM kaç ns?" tek sayısından ibaret değildir.
Memory denetleyici
Denetleyici:
- request scheduling,
- read/write turnaround,
- bank parallelism,
- refresh,
- QoS,
- ECC
yönetir.
Out-of-order memory scheduling işlem hacmini artırırken bazı requestleri daha uzun bekletebilir.
DDR
Double Data Rate bellek ckilidin iki kenarında veri aktararak pin bant genişliğini artırır.
Nesiller arttıkça signaling, burst ve channel organizasyonu değişir. "DDR frekansı" ile gerçek memory gecikme aynı ölçü değildir.
HBM
HBM çok sayıda dar DRAM kanalını yığın paketinde geniş arayüzle sunar.
GPU/AI/HPC'de yüksek bant genişliği için önemlidir.
HBM kapasitesi ve maliyeti normal DDR'dan farklı tasarım sınırları getirir.
ECC
SECDED tipi ECC tek bit düzeltme ve çift bit saptama sağlar.
ECC'nin bulunması bütün bellek hatalarını önlemez. Chip-level failure için stronger code, memory mirroring veya platform RAS mekanizmaları gerekebilir.
Sanal bellek
Süreç virtual address kullanır.
MMU:
virtual address
↓
translation
↓
physical address
eşlemesi yapar.
Amaç yalnız RAM'den büyük program çalıştırmak değildir:
- process isolation,
- protection,
- sparse address space,
- shared libraries,
- memory-mapped files,
- copy-on-write
sanal belleğin temel kullanım alanlarıdır.
Page table
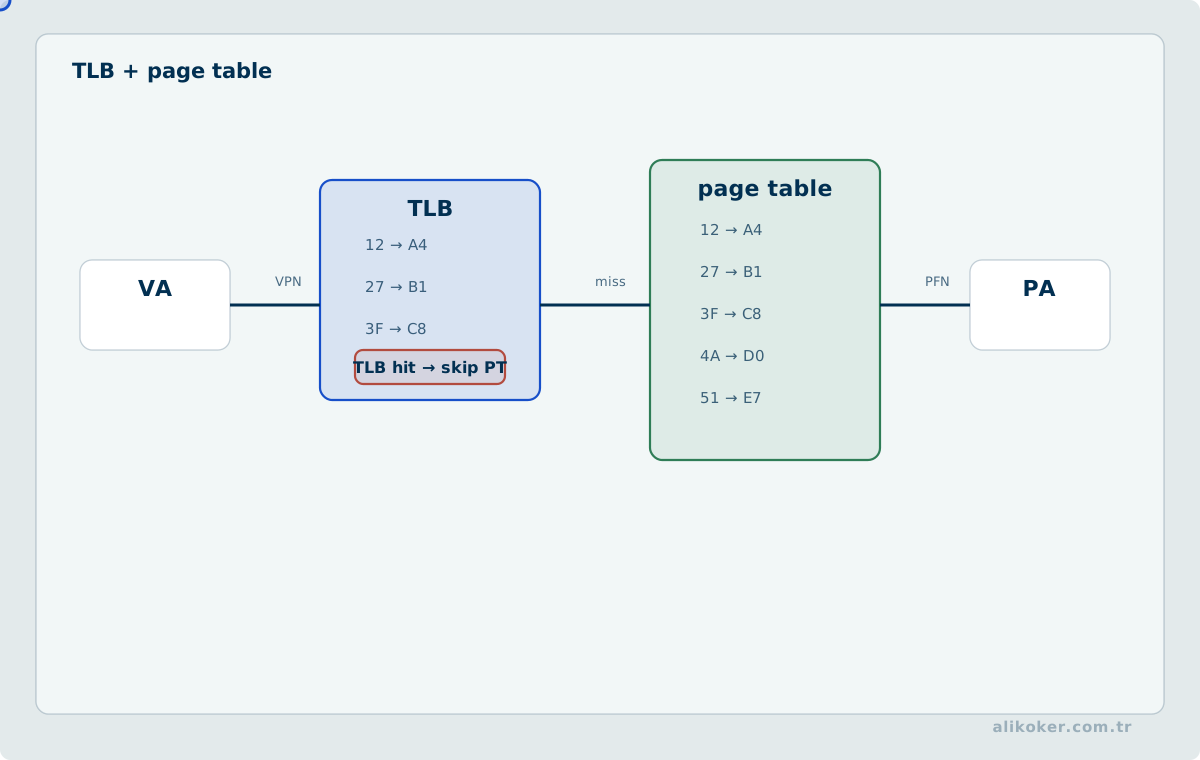
Virtual page number, sayfa tablosu entry üzerinden physical frame number'a çevrilir.
PTE:
- valid/present,
- R/W/X,
- user/supervisor,
- accessed,
- dirty
gibi state taşıyabilir.
Çok seviyeli tablo
64 bit address space için düz tek tablo çok büyük olur. Hierarchical sayfa tablosu yalnız kullanılan bölgeler için alt yapı ayırır.
RISC-V Sv39, Sv48 ve Sv57 gibi sayfalama kipleri farklı sanal adres genişlikleri ve tablo derinlikleri tanımlar.
TLB
TLB sayfa tablosu translation önbelleğidir.
TLB kaçırması sayfa tablosu walk gerektirir.
TLB kaçırması ile sayfa hatası aynı şey değildir:
- TLB kaçırması: eşleme RAM'de sayfa tablosunda bulunabilir.
- sayfa hatası: eşleme invalid/not-present/protection violation olabilir.
Huge page
Daha büyük page:
- TLB reach'i büyütür,
- sayfa tablosu ek yük'i azaltır.
Bedeller:
- iç parçalanma,
- bellek ayırma/compaction güçlüğü,
- daha büyük migration maliyeti.
Database, JVM, HPC gibi büyük memory bellek ayak izi işlerinde yararlı olabilir.
Page fault
Not-present page için OS:
- zero-fill,
- file read,
- swap/depolama read
yapabilir.
Minor fault disk I/O gerektirmeyebilir. Major fault depolama erişimi gerektirebilir ve CPU cycle ölçeğine göre çok pahalıdır.
Page replacement
Klasik teorik modeller:
- FIFO,
- LRU,
- Clock/Second Chance.
Gerçek işletim sistemleri working-set, aging ve çok sayıda ek sinyal kullanan daha karmaşık yöntemler uygular.
Belady anomalisi FIFO'nun daha çok frame ile daha çok fault üretebilmesini gösterir.
Memory protection
W^X ilkesi aynı sayfanın hem writable hem executable olmamasını hedefler.
NX/XD gibi execute-disable mekanizmaları data page'lerinden code execution riskini azaltır.
User/supervisor permission izolasyonun diğer boyutudur.
Ünite 10: Çok Çekirdek, NUMA, Tutarlılık ve Bellek Sıralaması
Çok çekirdeğe geçiş
Frekans ölçeklemesi güç ve ısı ile sınırlanınca transistor bütçesi daha çok:
- çekirdek,
- önbellek,
- accelerator,
- memory denetleyici
üzerinde kullanıldı.
Çekirdek sayısı arttıkça software parallelism gereksinimi de arttı.
SMP, UMA ve NUMA
UMA: memory erişim maliyeti bütün CPU'lar için yaklaşık tekdüzedir.
NUMA: memory belirli socket/node'a daha yakındır.
CPU0 ─ local memory0
  ╲
   remote interconnect
  ╱
CPU1 ─ local memory1
Remote memory daha yüksek gecikme ve fabric traffic yaratabilir.
NUMA sistemde memory capacity toplamı büyük olsa bile placement kötü ise uygulama yavaş olabilir.
First-touch
Birçok OS'te physical page ilk dokunan NUMA node'a yerleştirilebilir.
Parallel program memory'yi tek iş parçacığı ile initialize edip sonra bütün node'lara dağıtırsa remote access artabilir.
Data initialization da performans tasarımının parçasıdır.
Iş parçacığı affinity
Iş parçacığı migration önbellek locality'yi bozabilir.
- iş parçacığını uygun çekirdek/node'da tutabilir,
- local memory oranını artırabilir,
- başarım ölçümü varyansını azaltabilir.
Aşırı pinning zamanlayıcının load balancing esnekliğini azaltabilir.
Multicomputer ve cluster
Tek shared-memory sunucu ile dağıtık cluster aynı değildir.
Cluster node'ları explicit network communication kullanır. MPI gibi message-passing modelinde memory consistency yerine mesaj sırası ve collective communication maliyeti öne çıkar.
HPC uygulaması çoğunlukla node içinde shared memory, node'lar arasında message passing kullanır.
Interconnect
İşlemci içi ve socket arası bağlantı:
- bus,
- crossbar,
- ring,
- mesh,
- point-to-point fabric,
- Network-on-Chip
olabilir.
Bus basittir, sharer sayısı büyüdükçe bant genişliği sınırı doğar.
Crossbar yüksek connectivity verir, port sayısıyla alan hızla büyür.
Mesh many-çekirdek için kablolamayı ölçekleyebilir; hop count gecikmeyi etkiler.
NoC
Network-on-Chip packetized router/link yapısıyla:
- çekirdek,
- LLC slice,
- memory denetleyici,
- accelerator
birimlerini bağlayabilir.
On-chip topology, routing, virtual channel ve flow control kararları memory gecikme ve power üzerinde etkilidir.
Klasik bağlantı ağları
Tarihsel ve öğretici topolojiler:
- multiport memory,
- multistage interconnection network,
- Omega/butterfly,
- torus,
- hypercube.
2^n düğümlü bir hypercube'da her düğüm n komşuya sahiptir; ikili düğüm adresleri tek bit farklıysa komşudur.
Bu yapılar güncel NoC/fabric tasarımlarını anlamak için önemlidir: temel sorun uç nokta (endpoint) sayısı büyürken bant genişliği, hop count, kablolama ve arbitration maliyetini dengelemektir.
Bus arbitration
Paylaşılan bir kaynak aynı anda tek mastera verilebiliyorsa arbitration gerekir.
Politikalar:
- fixed priority,
- round-robin,
- age/dynamic priority,
- traffic-class veya real-time priority.
Fixed priority basittir ancak açlık üretebilir. Round-robin uzun vadeli adaleti artırır. Gerçek sistemler QoS ve gecikme sınıflarını birlikte kullanabilir.
Senkronizasyon
Shared data için yalnız load/store yeterli değildir.
Araçlar:
- mutex,
- semaphore,
- spinlock,
- reader-writer kilit (lock),
- condition variable,
- atomic operation,
- barrier.
Doğru seçim critical-section süresi ve contention'a bağlıdır.
Atomik işlemler
Atomic read-modify-write bölünemez görünür.
Örnek sınıflar:
- test-and-set,
- compare-and-swap,
- fetch-add,
- load-reserved/store-conditional.
RISC-V A uzantısı atomic memory operation ve LR/SC mekanizmaları sunar.
Spinlock
while atomic_exchange(lock, 1):
    spin
kısa beklemelerde sleep/wakeup maliyetini önleyebilir.
Uzun beklemede CPU ve coherence traffic tüketir.
Backoff ve kuyruk kilit tasarımları yüksek contention'da daha uygun olabilir.
False sharing
İki iş parçacığı farklı değişkenleri kullanıyor olsa bile değişkenler aynı önbellek satırı içindeyse write-invalidate trafiği oluşturabilir.
cache line:
counter0 | counter1
core0       core1
Her iki çekirdek kendi counterını yazdığında line ping-pong yapar.
Dolgulama/alignment false sharing'i azaltabilir.
Bu, algoritmik olarak shared variable olmadığı halde mikro mimaride paylaşım oluşmasının örneğidir.
Önbellek tutarlılığı
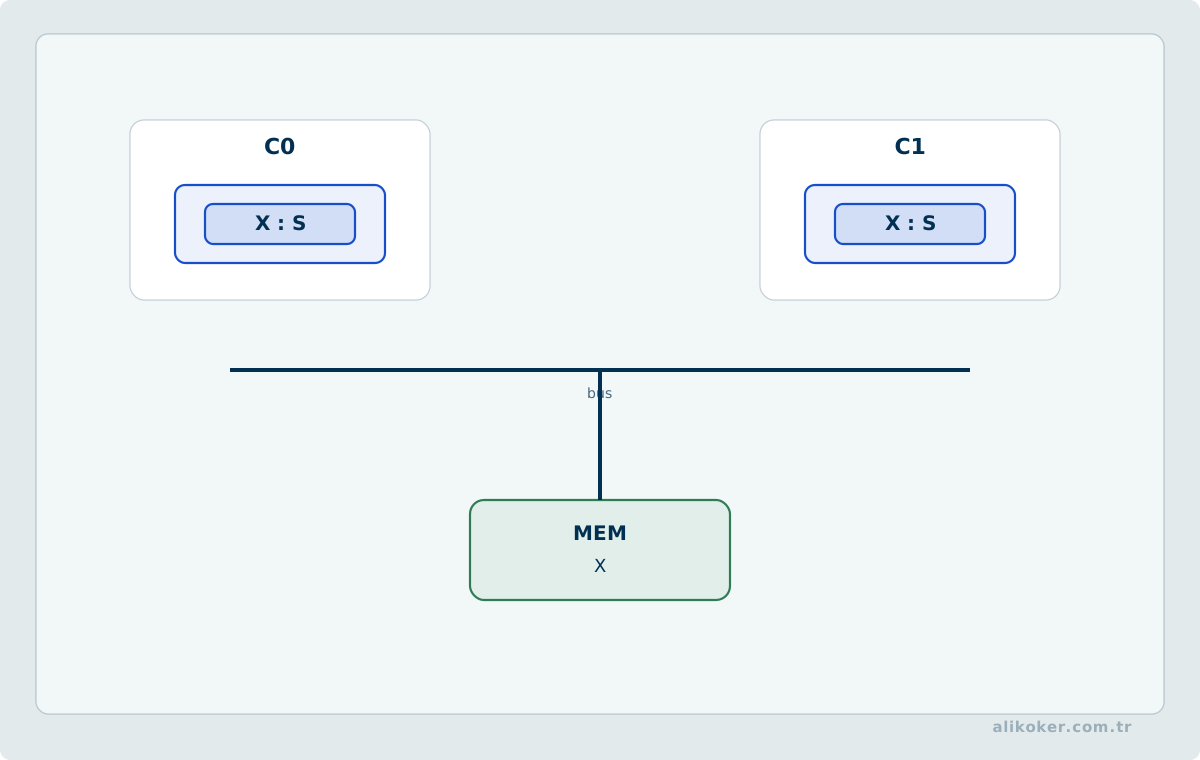
Private önbelleklerde aynı line'ın kopyaları varsa yazma sonrası görünürlük yönetilmelidir.
Coherence tek adres için temel olarak:
- write propagation,
- write serialization
sağlar.
Write-invalidate ve write-update
Invalidate: writer diğer kopyaları geçersiz kılar.
Update: yeni değer diğer kopyalara gönderilir.
Genel amaçlı sistemlerde invalidate protokolleri yaygındır; sürekli update bant genişliği maliyeti yüksek olabilir.
Snooping
Shared broadcast fabricte önbellek denetleyiciler transactionları gözleyebilir.
Çekirdek sayısı büyüdüğünde her önbelleğin bütün coherence trafiğini görmesi ölçeklenmez.
Directory
Directory hangi önbellek/node'un line'ı tuttuğunu izler.
Invalidate yalnız ilgili sharerlara gönderilebilir.
Many-çekirdek ve NUMA sistemlerde daha ölçeklenebilir.
MESI ve MOESI
MESI:
M Modified
E Exclusive
S Shared
I Invalid
MOESI Owned ekler.
Protokol durumları gerçek implementasyonda daha fazla transient state içerebilir. Dört/beş harf yalnız temel stable state modelidir.
Coherence ile consistency farklıdır
Coherence tek memory location'ın kopyalarının tutarlılığıdır.
Consistency farklı adreslerdeki load/store işlemlerinin diğer çekirdek'lar tarafından hangi sıralarda görülebileceğini tanımlar.
Coherent sistem weak memory model kullanabilir.
Sequential consistency
Basit zihinsel modelde bütün işlemcilerin memory operationları tek bir global interleaving içindeymiş gibi görünür ve her iş parçacığı program sırasını korur.
Kolaydır; agresif hardware/derleyici reordering'i sınırlar.
Modern ISA'lar daha gevşek modeller kullanabilir.
RISC-V RVWMO
RISC-V'in varsayılan weak bellek sıralaması modeli yüksek performanslı gerçekleştirimlere yeniden sıralama özgürlüğü verir.
Program doğru synchronization ile:
- acquire,
- release,
- fence,
- atomic
semantiğini ifade etmelidir.
Data race içeren programın yalnız "benim CPU'mda çalışıyor" gözlemi taşınabilirlik garantisi değildir.
Memory fence
Fence belirli memory operation sınıfları arasında ordering zorlar.
Bedeli, hardware'in reorder ve buffer özgürlüğünü azaltabilmesidir.
Bu nedenle her load/store arasına fence koymak doğru yaklaşım değildir; synchronization sınırında gerekli semantik kullanılmalıdır.
Acquire ve release
Release'ten önceki write'ların, uygun acquire ile senkronize olan iş parçacığı tarafından beklenen sırada görünmesi sağlanır.
Bu ilişki kilit ve kilit-free veri yapılarının temelidir.
kilit-free doğru olmak ile hızlı olmak aynı değildir
Atomic CAS döngüsü kilit kullanmıyor olabilir; yüksek contention altında önbellek satırı sürekli çekirdek'lar arasında hareket ederse sistem yavaşlayabilir.
İncelenmesi gereken:
- yeniden deneme oranı,
- önbellek satırı ownership,
- backoff,
- NUMA,
- fairness,
- memory-order seçimi.
Mimari ile concurrency doğrudan burada birleşir.
Ünite 11: SoC, Chiplet, CXL, UCIe ve Heterojen Sistemler
SoC
System-on-Chip tek paket/yonga içinde:
- CPU,
- GPU/NPU,
- memory denetleyici,
- media engine,
- security block,
- I/O denetleyici
gibi işlevleri birleştirebilir.
Paylaşılan on-chip fabric ve power management bütün sistemi birlikte yönetir.
Monolithic die sınırı
Tek die büyüdükçe:
- wafer verimi,
- reticle sınırı,
- farklı IP'lerin aynı process node gereksinimi,
- maliyet
sorun olur.
Her blok en yeni process node'a ihtiyaç duymaz. I/O analog blokları daha eski süreçte ekonomik olabilir.
Chiplet
Chiplet yaklaşımı sistemi birden çok die'a böler:
compute die
I/O die
cache die
accelerator die
Avantaj:
- uygun process node'u seçme,
- yield,
- reusable IP,
- ürün ailesi oluşturma.
Bedel:
- die-to-die gecikme,
- package power,
- protocol,
- test,
- thermal,
- yield'in paket düzeyine taşınması.
2.5D ve 3D
- 5D paketlemede chipletler interposer üzerinde yan yana olabilir.
3D stacking die'ları dikey bağlar.
3D bağlantı wire length'i kısaltıp bant genişliği density artırabilir; thermal dissipation zorlaşır.
UCIe
Universal Chiplet Interconnect Express paket içi die-to-die bağlantıyı standartlaştırır.
Ağustos 2026 itibarıyla UCIe 3.0:
- 48 ve 64 GT/s veri hızlarını,
- yönetim/yan bant iyileştirmelerini,
- önceki sürümlerle uyumluluğu
tanımlar.
UCIe dış kasa/slot bağlantısı değildir; aynı system-in-package içindeki chiplet ekosistemini hedefler.
PCIe ile UCIe farkı
PCIe board/system I/O fabricidir.
UCIe package-level die-to-die bağlantıdır.
UCIe protocol stack PCIe/CXL gibi protokolleri taşıyabilir, ancak fiziksel kullanım alanı farklıdır.
CXL
Compute Express Link, PCIe fiziksel altyapısından yararlanan CPU-device/memory odaklı önbellek-coherent interconnect ailesidir.
CXL'nin temel problemi klasik PCIe DMA'dan daha ileri bir ilişkidir:
- accelerator memory erişimi,
- host/device önbellek tutarlılığı,
- memory expansion,
- memory pooling.
CXL 4.0 Ağustos 2026 itibarıyla güncel şartname ailesidir.
CXL memory
CXL memory expander host address space'e daha fazla memory capacity ekleyebilir.
Bu memory'nin gecikme/bant genişliği local DDR ile aynı olmak zorunda değildir.
İşletim sistemi ve çalışma zamanı için yeni bir memory tier ortaya çıkar:
local DRAM
↓
CXL-attached memory
↓
storage
Placement yeni NUMA problemi haline gelir.
Memory pooling
Fabric üzerinden memory capacity'nin birden fazla host arasında esnek tahsisi mümkün olabilir.
Bu yaklaşım stranded memory kapasitesini azaltabilir.
Performans modelinde:
- switch hop,
- link bant genişliği,
- device gecikme,
- contention
hesaba katılmalıdır.
Heterojen compute
CPU + GPU + NPU + FPGA aynı uygulamanın farklı parçalarını yürütebilir.
Asıl maliyet yalnız compute değildir:
host-device transfer
synchronization
format conversion
memory placement
kernel launch
Amdahl Yasası bu sistemlerde de geçerlidir. Accelerator 100× hızlı olsa bile işin büyük bölümü hostta kalıyorsa toplam hızlanma sınırlıdır.
Unified/coherent memory
"Unified memory" farklı ürünlerde farklı anlam taşır.
- tek fiziksel memory pool,
- shared virtual address,
- page migration,
- coherent CPU-GPU access
aynı kavram değildir.
Bir sistemin hangi garantiyi verdiği somut platformdan doğrulanmalıdır.
Ünite 12: Güvenlik, RAS, Güç ve Gerçek Zamanlılık
Mimari güvenlik sınırı
Privilege ve page protection gerekli fakat tek başına yeterli değildir.
Güvenlik katmanları:
ISA privilege
MMU/IOMMU
memory permissions
interrupt isolation
virtualization
device isolation
microarchitectural state
birlikte düşünülür.
Spekülatif yürütme ve yan kanal
Spekülatif komut yanlış branch yolunda çalışıp daha sonra mimari olarak iptal edilebilir.
Ancak önbellek gibi mikro mimari state üzerinde iz bırakabilir.
Spectre sınıfı saldırıların temel dersi:
Mimari sonuç geri alınmış olsa bile mikro mimari zamanlama etkisi bilgi taşıyabilir.
Bu nedenle ISA correctness ile side-channel resistance aynı şey değildir.
Savunmalar donanım, derleyici ve OS düzeylerinde:
- speculation barrier,
- predictor isolation,
- bounds-check hardening,
- address-space isolation,
- microcode
gibi mekanizmalar içerebilir.
Precise istisna
Istisna alındığında mimari state'in belirli bir instruction sınırını göstermesi debugging ve OS için kritiktir.
Out-of-order çekirdek ROB ile genç işlemleri iptal edip yaşlıları retire ederek precise state oluşturabilir.
Parite ve ECC
Parity tek-bit türü birçok hatayı saptayabilir, düzeltmez.
ECC redundant check bitleriyle hata yeri hakkında bilgi üretir.
SECDED:
Single Error Correction
Double Error Detection
sunucu RAM'inde yaygındır.
Önbellek, interconnect ve register file için de parity/ECC uygulanabilir.
Machine check ve RAS
Platform:
- corrected error,
- uncorrected error,
- poison data,
- link error,
- thermal fault
gibi olayları RAS mekanizmalarıyla raporlayabilir.
Amaç mümkünse:
- hatayı saptamak,
- etki alanını sınırlamak,
- veriyi bozuk olarak işaretlemek,
- işletim sistemine bildirmek,
- sistemi kontrollü devam ettirmek veya durdurmaktır.
Fault tolerance
Redundancy biçimleri:
- spatial redundancy,
- temporal yeniden deneme,
- ECC,
- lockstep çekirdek,
- replicated system.
Uzay aracında radiation tolerance, veri merkezinde availability, otomotivde deterministik güvenlik farklı tasarım hedefleri doğurur.
En hızlı işlemci her kullanım için en iyi işlemci değildir.
Thermal design
Güç elektrik sorunu olduğu kadar ısı sorunudur.
Hotspot:
- frequency limit,
- leakage,
- reliability
üzerinde etkili olur.
Thermal throttling işlemciyi güvenli sıcaklıkta tutmak için frekans/gerilimi düşürür.
TDP gerçek her workload için sabit power consumption sayısı olarak okunmamalıdır; ürün termal tasarım sınıfıdır.
Dark silicon
Transistör bütçesi büyürken bütün birimleri aynı anda maksimum frekansta çalıştırmak güç sınırı nedeniyle mümkün olmayabilir.
Bu nedenle bazı bloklar kullanım anında etkinleştirilir, diğerleri kapatılır.
Specialized accelerator'ın bir değeri de genel amaçlı çekirdek'a göre aynı iş için daha az enerji tüketmesidir.
Gerçek zamanlılık
Real-time sistemde önemli olan yalnız ortalama hız değil deadline'dır.
ortalama 1 msdeğeri, nadiren 100 ms yüksek yüzdelik gecikme varsa 10 ms deadline'ı olan kontrol sistemi için yeterli değildir.
Determinism için:
- sınırlı interrupt gecikme,
- predictable önbellek/memory,
- priority scheduling,
- WCET analizi,
- kontrollü DVFS,
- isolation
gerekebilir.
Safety ile security
Safety istemsiz arızanın zarar vermemesini; security kötü niyetli etkene karşı korunmayı hedefler.
Aynı ECC veya isolation mekanizması iki alana da katkı verebilir, fakat threat/fault modelleri farklıdır.
Ünite 13: Ölçüm, Benzetim ve Mimari İnceleme
Önce ölç
Mimari optimizasyonun sırası:
iş yükünü tanımla
↓
baseline ölç
↓
darboğazı bul
↓
tek değişiklik yap
↓
yeniden ölç
GHz, çekirdek sayısı veya önbellek capacity tek başına tanı değildir.
Hardware performance counter
İşlemciler:
- cycles,
- retired instructions,
- branch,
- branch miss,
- önbellek event,
- TLB event
gibi sayaçlar sağlayabilir.
RISC-V'te cycle/instret ailesi temel sayım fikrini gösterir; platforma göre daha fazla event bulunabilir.
CPI:
cycles / retired instructionsIPC:
retired instructions / cyclesdir.
İkisi ters ilişkili görünse de superscalar ve stall davranışını yorumlarken ölçüm kapsamı önemlidir.
CPI stack
Toplam CPI'yı nedenlere ayırmak yararlıdır:
base
+ frontend stall
+ branch miss
+ cache/memory stall
+ resource contention
Gerçek processor eventleri bu kadar temiz ayrılmayabilir; yine de tanı modeli olarak değerlidir.
Başarım ölçümü disiplini
Doğru başarım ölçümü:
- temsilci girdi kullanır,
- warm-up etkisini bilir,
- frequency/power state'i kaydeder,
- derleyici seçeneklerini belirtir,
- tekrarlı ölçüm yapar,
- varyansı raporlar.
Tek en iyi koşuyu seçmek bilimsel ölçüm değildir.
SPEC
SPEC CPU gibi suite'ler standart workload ve sonuç kurallarıyla karşılaştırılabilirlik sağlar.
Derleyici tuning sonuçta rol oynar. Bu bir hata değildir; sistem performansı derleyici+ISA+microarchitecture+memory birleşimidir. Ancak sonuç yorumlanırken neyin ölçüldüğü açık olmalıdır.
MLPerf
AI sistemlerinde:
- model,
- accuracy hedefi,
- batch,
- training/çıkarım,
- gecikme/işlem hacmi
birlikte standardize edilmeden yalnız TOPS değeri karşılaştırma için yetersizdir.
Tepe ve sürdürülebilir performans
Peak:
units × operations/cycle × clockgibi teorik hesaplanabilir.
Sustained performans:
- data supply,
- dependency,
- occupancy,
- synchronization,
- communication
nedeniyle daha düşük olur.
Aritmetik yoğunluk ve profiler
Roofline düşüncesiyle önce kernel'in memory-bound mı compute-bound mı olduğu belirlenir.
Memory-bound code'da ALU sayısını artırmak işe yaramaz.
Compute-bound code'da memory optimization sınırlı kazanç verir.
Assembly ve disassembly
Derleyici çıktısı mimariyi anlamanın güçlü yoludur.
Bakılacaklar:
- instruction count,
- load/store oranı,
- vector instruction,
- branch,
- call,
- spill/yeniden yükleme,
- alignment,
- generated library call.
Kaynak kod "basit" diye machine code'un basit olduğu varsayılmaz.
RISC-V simulator
Eğitimde üç basamak değerlidir:
- instruction-set interpreter,
- boru hattı simulator,
- önbellek/branch predictor simulator.
Birinci ISA semantiğini, ikinci timing/hazard, üçüncü memory/control performansını öğretir.
Işlem hattı trace
Her cycle:
cycle | IF | ID | EX | MEM | WByazdırılırsa:
- forwarding,
- stall,
- flush
görünür hale gelir.
Örnek ölçüler:
- toplam cycle,
- CPI,
- forwarding count,
- stall count,
- flush count.
Önbellek simulator
Parametreler:
- capacity,
- line size,
- associativity,
- replacement.
Memory trace ile hit/miss hesaplanır.
Tek parametre değiştirilip aynı trace üzerinde etkisi ölçüldüğünde tasarım dengeleri somutlaşır.
Branch predictor simulator
1-bit, 2-bit, gshare veya tournament predictor aynı branch trace ile karşılaştırılabilir.
Sadece accuracy değil:
- depolama bits,
- aliasing,
- warm-up,
- misprediction ceza
de düşünülmelidir.
RTL ve Verilog
RTL modelinde combinational ile sequential davranış açık ayrılır.
Testbench:
- clock/reset,
- girdi sequence,
- expected output,
- assertion
ile tasarımı doğrular.
Synthesis başarılı olması tasarımın doğru olduğu anlamına gelmez; functional verification ayrı iştir.
FPGA prototipleme
Basit RISC-V çekirdek FPGA üzerinde:
- register file,
- ALU,
- control,
- BRAM,
- UART
ile gerçeklenebilir.
Gerçek donanım:
- timing closure,
- clock-domain,
- reset,
- metastability,
- I/O
gibi benzetimde gözden kaçabilen konuları gösterir.
Ünite 14: Kavramsal Ayrımlar ve Hızlı Tekrar
ISA ile mikro mimari aynı değildir. ISA sözleşmedir; boru hattı/önbellek/OoO onun gerçekleştirimidir.
Clock rate ile performans aynı değildir. Komut sayısı ve CPI da gerekir.
Gecikme ile işlem hacmi aynı değildir. Işlem hattı ikincisini artırırken ilki aynı ölçüde düşmeyebilir.
CISC ile RISC bugün siyah-beyaz sınıflar değildir. Modern x86 mikro işlemler kullanır; modern RISC ISA'ları geniş uzantılar taşır.
Makine komutu ile assembler sözde komutu aynı değildir. Bir pseudo-instruction birden çok gerçek komuta dönüşebilir.
Mimari register ile fiziksel register aynı değildir. Renaming ikisini ayırır.
RAW ile WAR/WAW aynı bağımlılık türü değildir. RAW gerçek veridir; WAR/WAW isim bağımlılığıdır ve renaming ile kaldırılabilir.
Forwarding ile out-of-order aynı şey değildir. Forwarding boru hattı içi veri yoludur; OoO hazır bağımsız komutu sıra dışı yürütür.
Execute ile retire aynı değildir. Spekülatif komut çalışmış olabilir; mimari etkisi retire edilene kadar kesin değildir.
Branch prediction doğruluk mekanizması değil performans mekanizmasıdır. Yanlış tahmin mimari sonucu bozmamalı, yalnız ceza üretmelidir.
Carry ile signed overflow aynı değildir.
Floating-point ile gerçek sayılar aynı değildir. Sonlu temsil yuvarlama üretir.
FMA iki ayrı floating-point işlem değildir. Tek ara yuvarlamayla birleşik semantik sunar.
FP16, BF16 ve TF32 aynı format değildir. Exponent/significand dengeleri farklıdır.
SIMD ile SIMT aynı programlama modeli değildir. İkisi veri paralelliğini farklı soyutlar.
GPU çekirdek ile CPU çekirdek doğrudan sayısal olarak karşılaştırılmaz. Tasarım hedefleri farklıdır.
Peak FLOPS ile uygulama performansı aynı değildir. Arithmetic intensity ve bant genişliği belirleyicidir.
MMIO ile normal RAM aynı adres alanında görünse bile aynı davranışa sahip değildir.
DMA CPU'yu tamamen devreden çıkarmaz. CPU descriptor, buffer ve completion yönetir.
CPU MMU ile IOMMU aynı requesterı yönetmez. Biri CPU virtual memory, diğeri device DMA izolasyonu içindir.
PCIe ile CXL aynı katman değildir. CXL önbellek/memory semantiği ekler ve PCIe fiziksel altyapısından yararlanır.
PCIe ile UCIe aynı fiziksel kullanım alanı değildir. UCIe paket içi die-to-die bağlantıdır.
Önbellek hit ile TLB hit aynı değildir. Biri data/instruction block, diğeri address translation önbelleğidir.
TLB kaçırması ile sayfa hatası aynı değildir.
Önbellek tutarlılığı ile memory consistency aynı değildir.
Atomic ile fence aynı değildir. Atomic read-modify-write bütünlüğü; fence ordering kısıt sağlar.
Coherent sistemde program otomatik data-race-free olmaz. Synchronization yine gerekir.
UMA ile NUMA yalnız kapasite farkı değildir. Memory gecikme requester konumuna bağlıdır.
False sharing gerçek veri paylaşımı olmayabilir. Aynı önbellek satırı paylaşımı yeterlidir.
ECC ile yedek aynı değildir. ECC bit hatasını ele alır; sistem/depoma arızası için daha geniş redundancy gerekir.
Başarım ölçümü ile gerçek workload aynı olmak zorunda değildir. Temsil gücü ölçülmeden sonuç genellenmez.
Daha çok transistor otomatik daha hızlı program demek değildir. Power, memory, parallelism ve software kullanılabilirliği sınırdır.
Uygulama Bağlantıları
IBM POWER9 AC922 üzerindeki adli bilişim ve yapay zeka çalışmalarım, SIMD, bellek hiyerarşisi, NUMA, AltiVec/VSX, OpenMP, CUDA ve heterojen CPU/GPU veri hareketinin aynı gerçek hesaplama problemi içinde değerlendirildiği uygulama bağlamıdır.
İlgili kavramlar:
Bu bağlantılar, mimari kavramların gerçek performans davranışına nasıl dönüştüğünü gösteren uygulama örnekleridir.
Bilgisayar Organizasyonu ile Kapsam Ayrımı
Temel işlemci bileşenlerinin giriş düzeyindeki organizasyonu Bilgisayar Organizasyonu ve Temel İşlemci Yapısı dersinde ele alınır. Buradaki kapsam ise ISA, işlem hattı, bellek hiyerarşisi, NUMA ve güncel sistem mimarileri üzerinden daha geniş bir mühendislik çerçevesi kurar.
Mekanik hesaplama karşılaştırması
Elektronik işlemci öncesi bir hesaplama mekanizmasının veri ve taşıma davranışı için FACIT Mekanik Hesap Makinesi ayrı bir fiziksel hesaplama örneğidir.
Teoriden Ölçülebilir Davranışa
Komut kümesi, işlem hattı ve önbellek (cache) hiyerarşisi ayrı başlıklar gibi öğrenilse de çalışan bir programda aynı gecikme zincirinin parçalarıdır. Bir döngünün daha az komut üretmesi tek başına daha hızlı olacağını göstermez; veri bağımlılıkları, branch tahmini, önbellek satırı (önbellek line) yerleşimi ve bellek bant genişliği sonucu değiştirebilir. Bu nedenle mimariyi performans ölçümüyle birleştirirken P99 gecikme (Latency), False Sharing ve CPU Affinity gibi sistem düzeyi kavramlar önem kazanır.
Özellikle çok çekirdekli kodda ortalama işlem hacmi (işlem hacmi (throughput)) ile kuyrukta bekleyen tek bir isteğin gecikmesi aynı metriğin iki görünümü değildir. Java Sistemlerinde Çalışma Zamanı Optimizasyonu bu ilişkinin sanal makine ve gerçek çalışma yükü tarafındaki karşılığını ele alır.
Mimarinin Yazılım Performansına Yansıması
Komut seti düzeyindeki özellikler, mikro mimari ve bellek hiyerarşisi yazılım performansında aynı anda görünür. SIMD yalnız bir instruction özelliği değildir; veri düzeni, hizalama, önbellek davranışı ve compiler vectorization ile birlikte etkili olur. Benzer biçimde branch prediction başarısızlığı tek bir branch maliyetinden ibaret değildir; işlem hattının yeniden doldurulması ve bağımlı komutların beklemesiyle gecikme büyür.
Bu nedenle bir performans problemini yalnız yüksek seviyeli kod satırlarına bağlamadan önce önbellek ıskası (önbellek miss), bellek bant genişliği (memory bandwidth), dallanma yanlış tahmini (branch misprediction), komut düzeyi paralellik (instruction-level parallelism) ve vektörleştirme (vectorization) sinyallerini birlikte değerlendirmek gerekir. Java sistemlerinde çalışma zamanı optimizasyonu gibi yönetilen çalışma zamanı (managed çalışma zamanı (runtime)) örneklerinde bile alttaki işlemci ve bellek davranışı kaybolmaz; yalnız JVM ve JIT katmanı üzerinden gözlenir.
Bellek duvarı, ön getirme ve bellek düzeyi paralelliği
İşlemci çekirdeklerinin yürütme kapasitesi büyürken ana bellek gecikmesi aynı ölçüde azalmadığı için birçok iş yükünde darboğaz hesaplama değil veri getirmedir. Donanım prefetcher'ları düzenli erişim örüntülerini tahmin edebilir; rastgele pointer takibi ise bu avantajı azaltır.
Tek bir cache miss'in gecikmesini saklamanın yolu yalnız daha yüksek saat frekansı değildir. Aynı anda birden çok bağımsız bellek isteğinin uçuşta olması, yani memory-level parallelism, toplam işlem hacmini artırabilir. Bağımlı pointer zinciri ise her adımı bir öncekinin sonucuna bağladığı için bu paralelliği sınırlar.
Bu nedenle veri yapısı yerleşimi mimari karardır. Array-of-structures ile structure-of-arrays arasındaki seçim, SIMD kullanımı, cache satırı doluluğu ve hangi alanların birlikte okunduğuna göre yapılmalıdır.
Mimari performans iddiasını sınamak
IPC, CPI, cache miss ve bellek gecikmesi tek başına “hız” değildir. Aynı program farklı veri yerleşimi, çekirdek sayısı, frekans politikası ve derleyici seçenekleri altında farklı darboğaza girebilir.
Mikrobenchmark, ölçmek istediği mekanizmayı izole etmelidir. Derleyicinin kodu kaldırmadığı, veri kümesinin cache düzeyini gerçekten zorladığı ve zamanlayıcı/işletim sistemi gürültüsünün kontrol edildiği doğrulanmalıdır. Hardware counter sonucu da mimari belgelerle birlikte yorumlanır.
ISA garantileri ile mikro-mimari optimizasyonları ayrıldığında sonuç daha taşınabilir olur. Bir komutun varlığı, her işlemcide aynı latency veya throughput'a sahip olacağı anlamına gelmez.
Yapay Zekâ İş Yüklerinin Mimari Karşılığı
Modern yapay zekâ hesaplamaları bilgisayar mimarisindeki birçok kavramı aynı anda görünür hale getirir: veri düzeyi paralellik, bellek hiyerarşisi, düşük hassasiyetli aritmetik, yüksek bant genişliği ve alana özgü hızlandırma. Bu ilişki çift yönlüdür. Mimari modelin ne kadar hızlı ve verimli çalışacağını sınırlar; büyük AI iş yükleri de yeni mimari yapıların geliştirilmesini hızlandırır.
Yoğun bir neural network katmanında temel işlem çoğu zaman matris çarpımıdır:
C = A × BAritmetik işlem sayısı çok yüksek olsa da performansı yalnız FLOP/s değeri belirlemez. Matris blokları zamanında çekirdeğe ulaşmıyorsa işlem birimleri bekler. Bu nedenle operasyonel yoğunluk önemlidir:
arithmetic intensity = yapılan işlem / taşınan byteAynı verinin cache veya yerel tamponda yeniden kullanılması bu oranı yükseltir. Büyük matrislerin bloklara ayrılması, tiling ve kernel fusion gibi teknikler bu yüzden yalnız yazılım optimizasyonu değildir; bellek hiyerarşisinin davranışına verilen yanıttır.
CPU tarafında SIMD/vector uzantıları bir komutla birden fazla eleman üzerinde işlem yapmayı sağlar. GPU ise çok daha fazla paralel yürütme birimi ve yüksek throughput için tasarlanmış bellek modeli kullanır. Bu iki yaklaşım aynı değildir. Küçük batch, branch ağırlıklı ön işleme veya düşük gecikmeli seri bölüm CPU'da daha uygun olabilirken yüksek paralelliğe sahip tensör işlemleri GPU'da daha verimli olabilir. Heterojen sistemde görev dağılımı ölçülerek yapılmalıdır.
Tensor core veya benzeri matris birimleri daha özel bir adım atar: sık kullanılan küçük matris çarp-topla örüntüsünü doğrudan hızlandırır. Alana özgü hızlandırıcılarda veri akışı, genel amaçlı komut yürütmeden daha belirleyici olabilir. Systolic array gibi yapılarda ağırlık ve aktivasyonların işlem elemanları arasında yeniden kullanılması, harici bellek trafiğini azaltmaya çalışır.
Düşük hassasiyet de mimari ile modelin kesişimidir. FP32 yerine BF16, FP16, INT8 veya daha dar gösterimler kullanıldığında:
- bellek tüketimi azalabilir,
- bellek bant genişliği başına daha fazla değer taşınabilir,
- aynı silikon alanında daha fazla aritmetik birim bulunabilir,
- enerji maliyeti düşebilir.
Buna karşılık nicemleme hatası ve dinamik aralık sınırlaması doğar. Donanımın desteklediği format ile modelin toleransı birlikte değerlendirilmelidir. “Daha az bit daha hızlıdır” ifadesi tek başına doğruluk veya uçtan uca gecikme garantisi değildir.
Transformer mimarileri, klasik konvolüsyon ağlarından farklı erişim örüntüleri üretebilir. Attention mekanizmasında sequence length büyüdükçe ara tensörlerin boyutu ve bellek trafiği önemli hale gelir. Autoregressive çıkarımda ise geçmiş anahtar/değer temsillerinin tutulduğu KV cache kapasitesi ve bellek bant genişliği özellikle belirleyicidir. Bu nedenle training throughput için iyi olan mimari, tek istekli düşük gecikmeli inference için aynı derecede iyi olmayabilir.
NUMA ve çok soketli sistemlerde model ağırlığının ve çalışma thread'lerinin yerleşimi de performansı etkiler. Hızlandırıcılar arası bağlantı topolojisi, dağıtık eğitim veya çoklu aygıt inference sırasında collective communication maliyetine dönüşür. Teorik toplam hesap kapasitesi, yavaş bağlantı veya kötü veri yerleşimi nedeniyle kullanılamayabilir.
Bu ilişkiyi doğru okumak için model metriği ile mimari metriği ayırmak gerekir:
model kalitesi → doğruluk / kayıp / görev metriği
mimari verim → latency / throughput / enerji / bellek / kullanım oranı
Yüksek donanım kullanım oranı tek başına iyi sistem tasarımı değildir; kullanıcının gördüğü gecikme ve iş başına kaynak maliyetiyle birlikte değerlendirilmelidir.
Bilgisayar mimarisinin yapay zekâdaki rolü bu nedenle “GPU kullanmak”tan daha geniştir. Modeldeki cebirsel işlemlerin veri hareketi, paralellik ve fiziksel kaynak sınırları altında hangi yürütme düzenine dönüştüğünü açıklar. Yapay zekâ iş yüklerinin mimariyi dönüştüren tarafı da tam burada ortaya çıkar: sık kullanılan hesap örüntüsü donanımın veri yolunu, aritmetik birimini ve bellek düzenini yeniden şekillendirir.
Performans hesabında hangi büyüklük neyi anlatır?
İşlemci frekansı, komut sayısı ve çevrim başına komut maliyeti aynı büyüklük değildir. Basitleştirilmiş bir yürütme süresi modeli:
CPU time = instruction count × CPI / clock ratebiçiminde yazılabilir. Frekansın artması ancak diğer terimler aynı kaldığında süreyi azaltır. Farklı bir ISA, derleyici veya mikro-mimari komut sayısını ve CPI değerini birlikte değiştirebilir; bu nedenle yalnız GHz karşılaştırması mimari performansı açıklamaz.
Boru hattı (pipeline) tek bir komutun bağımlılıklarını ortadan kaldırmaz; farklı komutların aşamalarını örtüştürerek toplam üretim hızını artırır. Veri, kontrol ve yapısal tehlikeler bu örtüşmeyi sınırlar. İleri besleme bazı veri bağımlılıklarının bekleme maliyetini azaltabilir, fakat gerçek bağımlılığı yok etmez. Dallanma kestirimi de yanlış tahmin edildiğinde boru hattında temizleme maliyeti oluşturur.
Önbellekte asıl soru yalnız kapasite değildir. Blok boyutu, eşleme biçimi, küme sayısı, değiştirme politikası ve erişim örüntüsü birlikte hit/miss davranışını belirler. Aynı çalışma kümesi ardışık erişimde iyi yerellik gösterirken büyük adımlı veya çakışmalı erişimde belirgin biçimde daha kötü davranabilir.
Amdahl yasası optimizasyon sorularında önemli bir sınır koyar:
S = 1 / ((1 - p) + p / s)Burada p hızlandırılan bölümün oranı, s o bölümdeki hızlanmadır. Programın küçük bir kısmını çok hızlandırmak toplam süreyi sınırlı değiştirir. Bu nedenle mimari bir iyileştirmenin değeri, hızlandırdığı birimin teorik gücünden çok toplam yürütme süresinde kapladığı payla birlikte değerlendirilmelidir.
Kaynakça
- AMD. AMD64 Architecture Programmer's Manual. Güncel çevrimiçi sürüm.
- Arm. Arm Architecture Reference Manual for A-profile Architecture. Güncel çevrimiçi sürüm.
- Behrooz Parhami. Computer Architecture: From Microprocessors to Supercomputers. Oxford University Press, 2005.
- Bruce Jacob; Spencer W. Ng; David T. Wang. Memory Systems: Cache, DRAM, Disk. Morgan Kaufmann, 2008. DOI: 10.1016/B978-0-12-379751-3.X5001-2.
- Cengiz Uğurkaya; Osman Aliefendioğlu. Modern Bilgisayar Mimarisi. Papatya Bilim Yayınevi, 2026.
- Christian Bienia et al. “The PARSEC Benchmark Suite: Characterization and Architectural Implications.” PACT, 2008.
- Compute Express Link Consortium. Compute Express Link Specification 4.0, 2025/2026 publication set. https://computeexpresslink.org/
- Daniel A. Jiménez; Calvin Lin. “Dynamic Branch Prediction with Perceptrons.” HPCA, 2001.
- David A. Patterson; David R. Ditzel. “The Case for the Reduced Instruction Set Computer.” ACM SIGARCH Computer Architecture News, 8(6), 1980.
- David A. Patterson; John L. Hennessy. Bilgisayar Mimarisi ve Tasarım. 5. baskı çevirisi. Nobel Akademik Yayıncılık, 2021.
- David A. Patterson; John L. Hennessy. Computer Organization and Design: The Hardware/Software Interface. 6th Edition, RISC-V Edition. Morgan Kaufmann, 2020.
- Gene M. Amdahl. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” AFIPS, 1967. DOI: 10.1145/1465482.1465560.
- Gordon E. Moore. “Cramming More Components onto Integrated Circuits.” Electronics, 38(8), 1965.
- IEEE. IEEE Std 754-2019: IEEE Standard for Floating-Point Arithmetic.
- Intel. Intel 64 and IA-32 Architectures Software Developer's Manual. Güncel çevrimiçi sürüm.
- John L. Gustafson. “Reevaluating Amdahl's Law.” Communications of the ACM, 31(5), 1988.
- John L. Hennessy; David A. Patterson. Computer Architecture: A Quantitative Approach. 6th Edition. Morgan Kaufmann, 2019.
- Linda Null; Julia Lobur. The Essentials of Computer Organization and Architecture. 5th Edition. Jones & Bartlett Learning, 2019.
- M. Morris Mano. Bilgisayar Sistemleri Mimarisi. 3. baskıdan Türkçe çeviri. Literatür Yayıncılık, 2002.
- M. Morris Mano. Computer System Architecture. 3rd Edition. Prentice Hall, 1992.
- Mark D. Hill; Michael R. Marty. “Amdahl's Law in the Multicore Era.” Computer, 41(7), 2008.
- Mehmet Bodur. Bilgisayar Organizasyonu: RISC Donanımına Giriş. TMMOB Elektrik Mühendisleri Odası, 2003.
- Norman P. Jouppi et al. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of ISCA, 2017. https://doi.org/10.1145/3079856.3080246
- NVIDIA. CUDA C++ Programming Guide. Güncel çevrimiçi sürüm.
- NVM Express. NVM Express Base Specification. Güncel sürüm. https://nvmexpress.org/
- OpenPOWER Foundation. Power ISA. Güncel mimari belirtimi.
- PCI-SIG. PCI Express Base Specification Revision 7.0, 11 June 2025. https://pcisig.com/
- Peter Mattson et al. “MLPerf Training Benchmark.” Proceedings of Machine Learning and Systems, 2020.
- Randal E. Bryant; David R. O'Hallaron. Computer Systems: A Programmer's Perspective. 3rd Edition. Pearson, 2016.
- RISC-V International. RISC-V Formal Memory Model / RVWMO. https://docs.riscv.org/
- RISC-V International. RISC-V Instruction Set Architecture — Ratified Specifications Library, Unprivileged and Privileged ISA, 2026 editions. https://docs.riscv.org/
- RISC-V International. RISC-V V Standard Extension for Vector Operations, Version 1.0. https://docs.riscv.org/
- Sarah L. Harris; David Harris. Digital Design and Computer Architecture: RISC-V Edition. Morgan Kaufmann, 2021.
- Scott McFarling. Combining Branch Predictors. DEC WRL Technical Note TN-36, 1993.
- Şirzat Kahramanlı. Bilgisayar Mimarisi. Nobel Akademik Yayıncılık, 2006.
- SPEC. SPEC CPU2017. https://www.spec.org/cpu2017/
- UCIe Consortium. Universal Chiplet Interconnect Express Specification 3.0, 2025. https://www.uciexpress.org/
- Vivienne Sze et al. “Efficient Processing of Deep Neural Networks: A Tutorial and Survey.” Proceedings of the IEEE, 105(12), 2017. https://doi.org/10.1109/JPROC.2017.2761740
- William Stallings. Computer Organization and Architecture: Designing for Performance. 11th Edition. Pearson, 2022.
