Java Tabanlı Veri Sistemlerinde Yüksek Başarım
Java ve Spring tabanlı veri sistemlerinde gecikme, verim, JVM, JPA/Hibernate, JDBC, HikariCP, SQL, indeksleme, önbellek, Kafka, PostgreSQL, yük testi ve kapasite planlamasını ölçüm ve azaltma ilkesiyle ele alan kapsamlı teknik not.
Java Tabanlı Veri Sistemlerinde Yüksek Başarım
Java tabanlı veri sistemlerinde başarım; veri erişim katmanı, indeksleme, Java Persistence davranışı ve veri yoğun sistem tasarımını aynı maliyet modeli içinde değerlendirmeyi gerektirir. Amaç ayar listesi vermek değil, yük arttığında hangi katmanın neden sınır olduğunu ve değişikliğin bedelini gösterebilmektir.
Temel yöntem değişmez:
ölç
darboğazı bul
tek değişken değiştir
aynı yükle yeniden ölç
Bir optimizasyon yalnız "daha hızlı" diye tanımlanamaz. İndeks okumayı hızlandırırken yazmayı pahalılaştırır, batch verimi artırırken tek kaydın bekleme süresini büyütebilir, önbellek gecikmeyi düşürürken tutarlılık yükü ekler, çoğaltma erişilebilirliği artırırken eski veri okuma riskini doğurur.
Zen yaklaşımı burada bir üslup tercihi değil mühendislik kuralıdır:
daha çok ayar değil
daha az iş

daha çok eşzamanlılık değil
ölçülmüş sınır

daha çok soyutlama değil
görünür maliyet
Bir değişiklik sistemin yaptığı işi azaltmıyor, kuyruğu görünür kılmıyor veya bir sınırı daha deterministik hale getirmiyorsa yalnız karmaşıklık ekliyor olabilir.
Ünite 1: Başarım Modeli ve Ölçüm
Bir performans incelemesinde önce yanıt süresi, işlem hacmi ve kaynak kullanımının hangi yük koşulunda ölçüleceği belirlenir. Aynı anda istek sayısı arttırılarak darboğazın işlemci, bağlantı havuzu, veritabanı veya ağ kaynaklarından hangisinde ortaya çıktığı gözlenir. Kuyrukta bekleme süresi servis süresinden ayrılmadan yapılan yorum yetersizdir. Özellikle yüksek yüzdelikli gecikmeler ve hata oranları kapasite kararında ortalama süreden daha belirleyici olabilir.
Kapsam ve Ölçüm İlkeleri
Önkoşullar
Konu; Java, SQL, ilişkisel veri tabanı temelleri, Spring/JPA ve temel işletim sistemi kavramları üzerine kuruludur. Amaç API ezberletmek değil, üretim sisteminde maliyetin hangi katmanda oluştuğunu fiziksel iş miktarıyla açıklayabilmektir.
Öğrenme hedefleri
Öğrenme hedefleri:
- gecikme, verim, doygunluk ve kuyruk ilişkisini nicel olarak kurabilmeli,
- JVM, bağlantı havuzu, JDBC, ORM ve veritabanı sürelerini birbirinden ayırabilmeli,
- transaction, MVCC, kilitleme ve idempotency kararlarını doğruluğu bozmadan değerlendirebilmeli,
- SQL yürütme planı, indeks, batch ve sayfalama kararlarını ürün semantiğiyle doğrulayabilmeli,
- önbellek, Kafka, çoğaltma ve sharding gibi dağıtık mekanizmaların gerçek sınırlarını tanımlayabilmeli,
- JFR, profil, OpenTelemetry izleri ve metrikleri ile yük testi sonuçlarından tekrarlanabilir bir performans hipotezi kurabilmeli,
- kapasiteyi tepe sayıdan değil SLO, yüksek yüzdelik gecikme ve arıza headroom'u üzerinden boyutlandırabilmelidir.
Okuma haritası
Numaralı bölümler, bağlantıları ve mevcut referansları korumak için yeniden numaralandırılmamıştır. Pedagojik olarak altı modül halinde okunabilir:
I    Başarım modeli ve ölçüm                    §1-§4
II   Eşzamanlılık, transaction ve persistence   §5-§14
III  Sorgu yolu, SQL, plan ve indeks             §15-§26
IV   Veri mimarisi, cache, akış ve dağıtım       §27-§39
V    JVM, serileştirme ve çalışma zamanı         §40-§42
VI   Test, kapasite ve karar disiplini            §43-§49
1. Başarım modeli
Yanıt süresi ve verim
Yanıt süresi tek isteğin tamamlanma süresi, verim birim zamanda tamamlanan iş miktarıdır. Aynı sistem daha yüksek verime ulaşıp tek istek için daha yavaş çalışabilir.
Little yasası kararlı sistemde eşzamanlılığı verir:
L = λ · W

L : sistemde aynı anda bulunan iş
λ : varış hızı
W : sistemde geçirilen ortalama süre
Bu bağıntı yalnız web isteği için değil bağlantı havuzu, kuyruk, işleyici ve veritabanı oturumu için de kullanılabilir.
Örnek:
1000 istek/s
istek başına DB bağlantısı tutma süresi = 5 ms

L = 1000 × 0.005 = 5
Kuramsal ortalama beş eşzamanlı bağlantıdır; dalgalanma payı ayrıca eklenir. Bu sonuç, bin eşzamanlı HTTP isteği var diye bin bağlantı gerekmediğini gösterir.
Doygunluk ve kuyruk
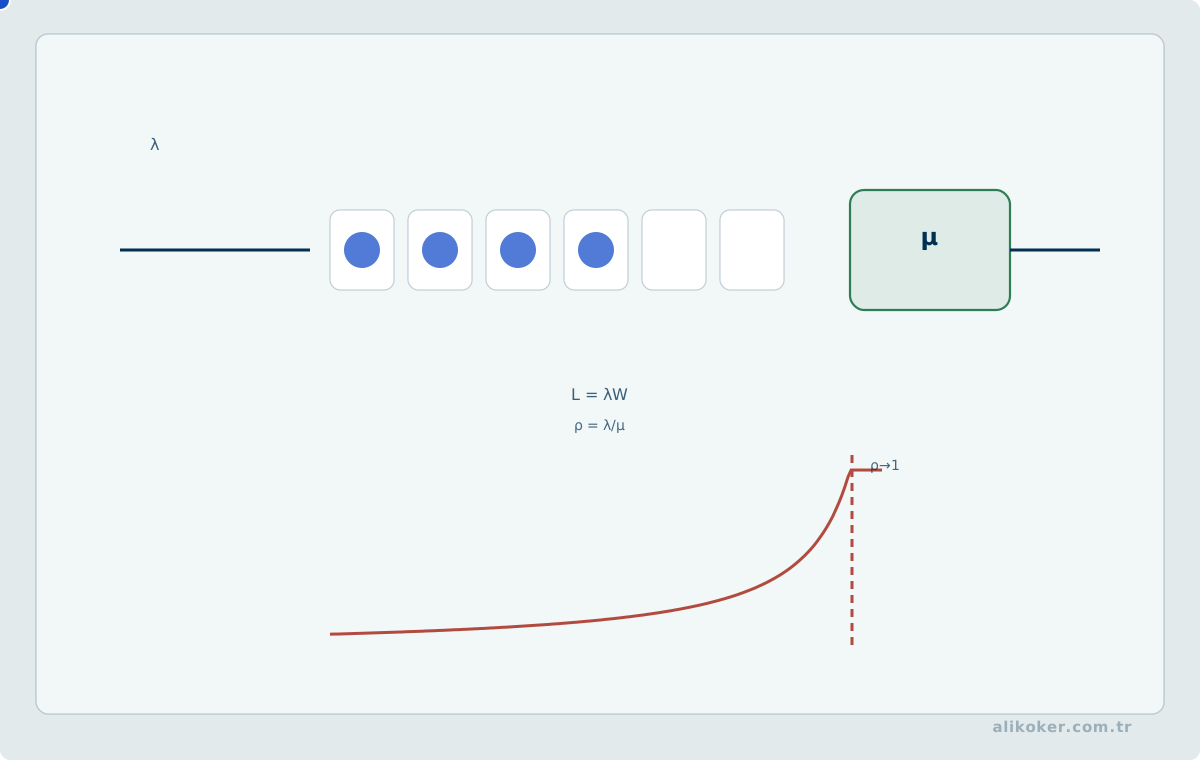
M/M/1 modeli, tek sunuculu kararlı durumda Poisson varış ve üstel hizmet süresi varsayımları altında kuyruk etkisini basitçe gösterir:
R = S / (1 - ρ)

R : bekleme dahil ortalama süre
S : ortalama hizmet süresi
ρ : kullanım oranı, 0 <= ρ < 1
Bu bağıntı bütün gerçek OLTP sistemleri için evrensel bir formül değildir. Varış ve hizmet süreleri daha değişkense aynı kullanım oranında kuyruk daha kötü olabilir. Ağır trafik bölgesinde Kingman G/G/1 yaklaşımı bu değişkenliği yaklaşık olarak görünür kılar:
Wq ≈ (ρ / (1 - ρ)) · ((Ca² + Cs²) / 2) · S

Ca : varışlar arası sürenin değişim katsayısı
Cs : hizmet süresinin değişim katsayısı
Ca² veya Cs² büyüdüğünde, ortalama hizmet süresi değişmese bile bekleme büyür. Bu nedenle yalnız CPU/DB kullanım yüzdesini değil, hizmet süresi dağılımını ve burst davranışını da ölçmek gerekir. M/M/1 bir öğretim modeli, Kingman ise ağır trafik için yaklaşık bir araçtır; üretim kararı ölçülen dağılımla doğrulanır (Kingman, 1961; Gunther, 2007).
Kaynak doygunluğa yaklaştıkça gecikme doğrusal artmaz. Yüzde 95 kullanım, yüzde 50 kullanıma göre küçük bir artış değil, kuyruk davranışının değişmesidir.
Üretim kapasitesi tepe noktasına göre değil, hata payı bırakılmış güvenli çalışma bölgesine göre seçilir. Doyma noktasında çalışan sistemin yedek kapasitesi yoktur; küçük trafik sıçraması, GC, yavaş sorgu veya ağ gecikmesi kuyruğu büyütür.
Amdahl ve koordinasyon maliyeti
Amdahl yasası seri kalan bölümün toplam hızlanmayı sınırladığını söyler:
S(N) = 1 / ((1-p) + p/N)Dağıtık sistemlerde yalnız seri bölüm yoktur; düğümler birbirleriyle de koordinasyon kurar. Evrensel ölçeklenebilirlik yasası bu maliyeti ekler:
C(N) = N / (1 + α(N-1) + βN(N-1))

α : serileşme
β : koordinasyon / tutarlılık
β sıfır değilse bir noktadan sonra düğüm eklemek toplam verimi düşürebilir. Aynı veritabanına yazan uygulama örneklerini artırmak, ortak kilit ve veri sayfaları değişmiyorsa yalnız yarışan istemci sayısını artırır.
Uç gecikme
Ortalama yanıt süresi kuyruktaki kötü davranışı saklar. P95, P99 ve P99.9 üretim davranışını daha iyi gösterir.
Bir istek birden çok arka uç çağrısına bağlıysa tek bir yavaş çağrı bütün isteği yavaşlatır. Fan-out arttıkça uç gecikme kullanıcıya daha sık yansır.
Yüzdelikler ortalanmaz. Birden çok sunucunun P99 değerlerini toplamak veya ortalamak yerine histogramlar birleştirilir ve yüzdelik birleşik dağılımdan hesaplanır.
Eşgüdümlü atlama
Yük üreteci bir isteğin bitmesini bekleyip sonra yenisini gönderiyorsa sistem yavaşladığında test de yavaşlar; gerçek hayatta kuyruğa girecek istekler hiç gönderilmez. Eşgüdümlü atlama (coordinated omission) P99'u olduğundan iyi gösterir.
Yük testi mümkün olduğunda açık döngülü varış hızını korumalı ve gecikmeyi planlanan gönderim anından ölçmelidir.
2. Güvenilirlik, ölçeklenebilirlik ve bakım kolaylığı
Veri yoğun bir sistemde başarımı; güvenilirlik, ölçeklenebilirlik ve bakım maliyetinden ayrı değerlendirmiyorum. Üç soru birlikte cevaplanır:
- Arıza olduğunda hizmet devam ediyor mu?
- Veri ve trafik büyüdüğünde davranış öngörülebilir mi?
- Sistem değiştirilebilir ve anlaşılabilir mi?
Bir bileşenin bozulması arızadır; kullanıcının beklediği hizmetin SLO dışına çıkması sistem başarısızlığıdır. Disk arızası çoğaltma ile maskelenebiliyorsa bileşen arızalanmış, hizmet başarısız olmamıştır.
Ölçeklenebilirlik "daha çok makine eklenebilir" demek değildir. Yük artışı tanımlanmalı, bu artışın hangi kaynak üzerindeki maliyeti büyüttüğü ölçülmeli ve mimarinin o maliyeti nasıl dağıttığı gösterilmelidir.
Bakım kolaylığı performansın karşıtı değildir. Anlaşılmaz bir hız hilesi, birkaç ay sonra yanlış değişiklikle kaybediliyorsa sürdürülebilir optimizasyon değildir.
3. Veri erişim yolunu bütün olarak görmek
Bir istek veritabanına tek adımda gitmez:
HTTP isteği
-> uygulama thread'i
-> işlem sınırı
-> bağlantı havuzu
-> JDBC sürücüsü
-> ağ
-> SQL parse / plan
-> kilit ve MVCC
-> tampon önbelleği
-> indeks / tablo / depolama
-> sonuç kümesi
-> ORM eşleme
-> serileştirme
-> ağ yanıtı
Her ok ayrı bir maliyet sınırıdır. ORM'de görünen "depo çağrısı" altta onlarca SQL, binlerce satır, çok sayıda ağ gidiş-dönüşü veya uzun kilit beklemesi oluşturabilir.
Optimizasyon katman seçimiyle başlar. SQL 2 ms, bağlantı bekleme 150 ms ise sorgu optimizasyonu yanlış yerdedir. Sorgu 400 ms sürüyorsa iş parçacığı sayısını artırmak aynı pahalı sorguyu daha çok eşzamanlı çalıştırır.
4. Ölçüm disiplini
Dört ölçüm katmanı ve dağıtık iz
Aynı maliyeti önce dört fiziksel katmanda görmek gerekir:
uygulama      istek, transaction, sorgu sayısı
JVM           CPU, allocation, GC, thread bekleme
veritabanı    plan, satır, blok, kilit, redo/WAL
işletim sistemi CPU, bellek, disk, ağ
Tek katman, neden-sonuç bağını kurmaya yetmez. Dağıtık tracing ise bu dört kaynak katmanına beşinci bir kaynak türü eklemekten çok, tek isteğin servis, veritabanı ve mesajlaşma sınırlarından geçerken bu katmanları birbirine bağlayan korelasyon düzlemidir.
Trace kimliğini doğrudan metrik etiketi yapmak kardinaliteyi patlatır. Bunun yerine destekleyen telemetry sistemlerinde exemplar, histogramdaki belirli bir gözlemi örnek bir trace ile ilişkilendirir. Metrik "nerede ve ne kadar" sorusunu, trace "hangi istek zincirinde" sorusunu, profil ise "hangi kod yolu maliyeti üretti" sorusunu cevaplar.
Uygulama metrikleri
İstek hızı, hata oranı ve gecikme dağılımı servis sağlığını; kaynak kullanımı, doygunluk ve hata sayısı altyapı sağlığını gösterir.
Yüksek kardinaliteli etiketler metrik sistemini bozar. Kullanıcı kimliği, ham URL, sorgu metni, istek kimliği ve serbest metin etiket yapılmaz.
Bağlantı havuzu için en az:
aktif bağlantı
boş bağlantı
bekleyen istek
bağlantı alma süresi
zaman aşımı
izlenir.
JFR ve profil
Java Flight Recorder düşük ek yükle CPU, bellek ayırma, GC, kilit, park, ağ ve sanal iş parçacığı olaylarını aynı zaman çizelgesinde gösterir. Sorun oluşmadan önce başlayan dönen kayıt, olay sonradan incelenecekse talep üzerine profilden daha değerlidir.
CPU profili yalnız çalışan kodu gösterir. Servis yavaş ama CPU düşükse duvar saati profiline bakılır; bekleme, kilit, ağ ve havuz gecikmesi burada görünür.
Bellek ayırma profili, yığın büyütmeden önce bakılacak yerdir. Gereksiz nesne üretimi düzeltilmeden GC ayarı yapmak maliyeti gizler.
SQL gözlemi
Üç ayrı veri gerekir:
- uygulamanın gerçekten gönderdiği SQL ve parametreler,
- ORM'in sorgu/varlık/flush sayıları,
- veritabanının gerçek yürütme planı ve gerçek satır sayıları.
show_sql geliştirmede yardımcı olabilir fakat süre, batch, bind ve toplam çağrı davranışını tek başına açıklamaz.
İstek başına sorgu sayısı testte sınırlandırılabilir. N+1 sorgu problemi üretimde değil testte kırılmalıdır.
İş miktarı ile süreyi ayırmak
Süre önbellek sıcaklığı, eşzamanlı yük ve depolama durumuna göre değişir. Okunan blok sayısı, döndürülen satır, ağda taşınan bayt ve gidiş-dönüş sayısı iş miktarını daha kararlı gösterir.
İyileştirme şu soruya cevap vermelidir:
daha az ne yaptık?Cevap yoksa kazanç çoğu zaman geçicidir.
Micrometer, histogram ve kardinalite
Spring Boot tarafında ölçüm yalnız bir Timer eklemek değildir. Micrometer sayaç, gauge, timer ve dağılım özeti gibi ölçüleri ortak bir modelde taşır; Prometheus gibi sistemlerde gecikmenin birleştirilebilir biçimi histogramdır.
İstemci tarafında önceden hesaplanan P95/P99 değerleri farklı örnek veya etiket kümeleri arasında matematiksel olarak toplanamaz. Histogram bucket'ları ancak aynı/uyumlu bucket sınırları ve aynı ölçüm semantiği korunuyorsa toplanabilir. Birleşik yüzdelik de ham gözlemlerden elde edilen kesin sıra istatistiği değil, bucket çözünürlüğü içinde yapılan bir tahmindir; sınırlar kaba ise kuantil de kabadır. Bu nedenle çok örnekli sistemde amaç "her örnek P99 yazsın" değil, ortak SLO sınırları ve uyumlu histogram şemasıyla birleşebilir bir dağılım üretmektir.
Histogram da bedelsiz değildir. Her bucket ve her tag birleşimi yeni zaman serisi üretir. Özellikle:
userId
requestId
ham URI
SQL metni
serbest hata mesajı
etiket yapılırsa gözlem sistemi uygulamanın kendisinden önce doygunluğa girebilir. SLO bucket'ları ve beklenen minimum/maksimum değerler gerçek iş yüküne göre sınırlandırılır.
RED servis yolunu, USE kaynak yolunu tamamlar:
RED: rate, errors, duration
USE: utilization, saturation, errors
Bir API'nin P99'u yükselirken CPU düşükse USE tarafında bağlantı havuzu, disk, ağ veya kilit (lock) doygunluğu aranır. CPU yüksek ama istek hızı sabitse bellek ayırma, serileştirme, plan değişimi veya sıcak kod yolu incelenir.
async-profiler ve flame graph
JFR olay zaman çizelgesini ve JVM bağlamını güçlü biçimde verir; async-profiler ise CPU, bellek ayırma, wall-clock ve kilit örneklemesiyle sıcak stack'leri düşük ek yükle görünür kılar. İki araç rakip değildir.
CPU flame graph çalıştırılan kodu gösterir. Wall-clock profilinde ağ, dosya, kilit, park, bağlantı bekleme ve diğer bekleme süreleri görünür. Bellek ayırma flame graph ise GC semptomundan önce hangi çağrı yolunun nesne ürettiğini gösterir.
Flame graph genişliği süre veya örnek payıdır; "üstte görünen metod kötüdür" diye okunmaz. Önce geniş taban bulunur, stack yukarı izlenir, değişiklikten sonra aynı yükle ikinci profil alınır. Diferansiyel profil, değişikliğin gerçekten hangi maliyeti azalttığını gösterir.
Sürekli kayıt ve olay anı
Üretimde yalnız sorun çıktıktan sonra profiler açmak, kazadan sonra kamera takmaya benzer. JFR'nin dönen kaydı düşük ek yükle sürekli tutulabilir; olay olduğunda son dakikalar dump edilir. Ağustos 2026 itibarıyla Oracle'ın JDK 25 belgeleri JFR'yi üretimde sürekli açık tutulabilecek kadar düşük ek yüklü bir araç olarak tanımlar.
Buna karşılık bütün araçlar sürekli açık bırakılmaz. Native Memory Tracking JVM içi native tahsisleri ayrıntılı gösterir fakat kapalı varsayılandır ve ölçülebilir ek yük getirir. NMT üçüncü taraf native kodu veya tüm JDK kütüphane tahsislerini eksiksiz izlemez. RSS büyümesi görüldüğünde:
heap mi?
metaspace mi?
thread stack mi?
direct buffer mı?
JVM native mi?
JNI / başka native kütüphane mi?
soruları ayrı ayrı cevaplanır.
Kuyruk gecikmesi, coordinated omission ve yüzdelikler
Yük testi yalnız ortalama gecikmeyi raporlarsa gerçek kullanıcı deneyimini gizleyebilir. p50 tipik davranışı, p95/p99 ise kuyruğun ve nadir duraklamaların etkisini görünür kılar. Ancak istemci, sunucu yavaşladığında yeni istek üretmeyi de yavaşlatıyorsa coordinated omission oluşabilir ve gecikme olduğundan iyi ölçülebilir.
Açık döngü yük üreticisi, hedeflenen geliş hızını sunucu cevabından bağımsız tutarak kapasite sınırını daha gerçekçi gösterebilir. Kapalı döngü istemcisi ise belirli kullanıcı etkileşim modelleri için daha uygun olabilir. Test modeli üretim trafiğiyle eşleştirilmelidir.
Throughput arttıkça gecikmenin doğrusal kalacağı varsayılmamalıdır. Doyuma yaklaşıldığında küçük ek yük kuyruk uzunluğunu ve tail latency'yi keskin biçimde artırabilir. Kapasite planı bu kırılma noktasından güvenli marjla uzakta çalışmayı hedeflemelidir.
Kuyruk gecikmesi ile eşzamanlı iş sayısını ayırmak. Kararlı bir iş akışında tamamlanma hızı λ = 120 istek/s ve ortalama sistemde kalma süresi W = 0,25 s ise Little yasası L = λW = 30 ortalama eşzamanlı sistem içi iş verir. Aynı sistem 240 istek/s hıza çıktığında ortalama süre 0,5 s olarak ölçülüyorsa L = 120 olur; iki kat istek hızı, bu örnekte dört kat sistem içi iş demektir. Buradaki W, yalnız işlemci veya SQL çalışma süresi değil, tanımlanan sistem sınırı içindeki tüm bekleme ve işleme zamanıdır. L değeri doğrudan veritabanı havuzu büyüklüğü değildir; farklı katmanların eşzamanlılık gereksinimleri ayrı ölçülür. Ortalama Little yasasından p95 veya p99 gecikmesi türetilmez. Kapasite incelemesinde önce ölçüm sınırı, kararlı durum ve zaman aralığı belirlenmeli, sonra gecikme dağılımı, kuyruk büyümesi ve darboğaz birlikte yorumlanmalıdır.
Ünite 2: Bağlantılar, Eşzamanlılık ve İşlem Sınırları
Bağlantı havuzu boyutlandırılırken eşzamanlı uygulama görevi sayısı doğrudan bağlantı sayısına eşitlenmez. Önce veritabanının etkin sorgu yürütme kapasitesi, işlem süreleri ve bağlantı bekleme kuyruğu ölçülür. Havuzu büyütmek, arka uç kapasitesi sabitse yalnız daha fazla eşzamanlı yük bindirebilir. Deneylerde kuyruk gecikmesi, zaman aşımı ve veritabanı CPU tüketimi birlikte izlenerek gereğinden fazla paralelliğin hangi noktada toplam başarımı düşürdüğü saptanır.
5. Bağlantı havuzu
Bağlantı pahalıdır
Yeni bağlantı TCP oturumu, kimlik doğrulama, veritabanı oturumu ve bellek ayırma maliyeti taşır. Havuz bu maliyeti uygulama ömrüne yayar.
Havuz bağlantıyı hızlandırmaz; pahalı bağlantı kurulumunu yeniden kullanır ve veritabanına girebilecek eşzamanlılığı sınırlar.
Havuz büyük olmak zorunda değildir
Veritabanının gerçek paralelliği CPU, depolama, kilitler ve ortak veri yapılarıyla sınırlıdır. Havuz bu sınırın çok üzerine çıkarsa kuyruk uygulamadan veritabanının içine taşınır.
Uygulama kuyruğu daha görünürdür:
küçük havuz
-> ölçülebilir bekleme
-> kontrollü zaman aşımı
Aşırı büyük havuz:
çok bağlantı
-> daha fazla eşzamanlı SQL
-> kilit / CPU / I/O çekişmesi
-> uzun kuyruk
-> uç gecikme
üretebilir.
Boyutlandırma
Yaygın çekirdek tabanlı formüller yalnız başlangıç noktasıdır. Daha doğru başlangıç, ölçülen bağlantı tutma süresi ile Little yasasıdır.
Havuz birkaç farklı boyutta yük testine sokulur; en yüksek verimi en düşük P99 ile sağlayan bölge aranır. Optimum tek sayı değil, güvenli bir aralıktır.
Zaman aşımı ve yaşam süresi
Bağlantı bekleme süresi sınırlı olmalıdır. Sonsuz bekleme, aşırı yükü istek kuyruğuna saklar.
Maksimum bağlantı ömrü, veritabanı veya ara ağ cihazlarının oturum ömründen kısa seçilebilir; bağlantıların aynı anda ölmemesi için yaşam sürelerine küçük rastgele sapma eklemek yeniden bağlanma fırtınasını azaltır.
Canlılık kontrolünde ağır SELECT yerine sürücünün desteklediği hafif doğrulama kullanılır.
Sızıntı algılama sürekli performans aracı değil, bağlantıyı gereğinden uzun tutan çağrı yollarını bulma aracıdır.
Bağlantıyı geç al, erken bırak
İşlem içinde dosya okuma, uzak HTTP çağrısı veya uzun CPU hesabı varsa bağlantı boş yere tutulur.
yanlış:
transaction başla
DB oku
uzak servis çağır
hesapla
DB yaz
commit

tercih:
gerekli veriyi kısa işlemde oku
işlem dışı hesapla / çağır
kısa işlemde yaz
Tutarlılık gereği bütün adımlar tek atomik işlem olamıyorsa çözüm bağlantıyı daha uzun tutmak değil, süreç tasarımını değiştirmektir.
Çok uygulama örneği
Toplam bağlantı:
uygulama örneği × örnek başına havuzile büyür. On uygulama örneğine ayrı ayrı yirmi bağlantı vermek veritabanında iki yüz oturum demektir.
Merkezi işlem havuzlayıcı bu sayıyı azaltabilir; bedeli oturum durumunun kaybolmasıdır. Geçici tablo, oturum değişkeni, oturuma bağlı hazırlanmış ifade veya oturum kilidi kullanan uygulamalarda işlem düzeyi havuzlama dikkat ister.
HikariCP ayarlarını amaçlarıyla okumak
HikariCP'de önemli ayarlar birbirinin yerine geçmez:
maximumPoolSize   DB'ye girebilecek üst eşzamanlılık
connectionTimeout havuz doluyken ne kadar bekleneceği
maxLifetime        bağlantının en uzun yaşamı
keepaliveTime      boş bağlantının canlı tutulma aralığı
validationTimeout  canlılık kontrolü bütçesi
maximumPoolSize uygulama iş parçacığı sayısından türetilmez. HikariCP'nin kendi kılavuzu da havuz boyutunda "daha az çoğu zaman daha fazladır" ilkesini vurgular. Çekirdek tabanlı formüller ancak ilk deney noktasıdır; I/O, kilit, SQL süresi, uygulama örnek sayısı ve veritabanı oturum maliyeti değiştikçe optimum bölge de değişir.
Havuz dolu olduğunda getConnection() sonsuza kadar beklememelidir. Bekleme bütçesi kullanıcı isteğinin toplam zaman aşımı bütçesinden küçük olmalıdır. Bağlantı alınamıyorsa bunu yeni iş parçacığı veya yeni yeniden deneme ile gizlemek yerine doygunluk olarak kabul etmek gerekir.
maxLifetime, veritabanı, güvenlik duvarı, load balancer veya ağ altyapısının bağlantı ömründen daha kısa seçilebilir. HikariCP bağlantıların aynı anda emekli olmaması için küçük bir sapma uygular. Keepalive yalnız boş bağlantılar üzerinde düşünülmeli ve maxLifetime'dan kısa olmalıdır. Sürücü JDBC4 Connection.isValid() desteği veriyorsa ağır bir test sorgusu yazmak yerine bu yol tercih edilir.
Havuz metriğinin en yararlı oranı yalnız active/maximum değildir. Aşağıdaki üç olay birlikte okunur:
pending > 0
acquisition P99 yükseliyor
DB hizmet süresi yükseliyor mu, sabit mi?
DB hizmet süresi sabitken acquisition büyüyorsa havuz/uygulama kuyruğu sınırdır. DB hizmet süresi de büyüyorsa havuzu genişletmek çoğu zaman veritabanındaki çekişmeyi artırır.
Havuz doygunluğunu teşhis ederken etkin bağlantı sayısı tek başına yeterli değildir. Bağlantı bekleyen istek sayısı, bağlantı edinme süresinin dağılımı, veritabanı sorgularının servis süresi ve zaman aşımı sayısı aynı zaman penceresinde izlenmelidir. Sorgular yavaşladığı için havuz dolmuşsa havuzu büyütmek sorunu daha fazla eşzamanlı SQL ile ağırlaştırabilir. Önce darboğazın sorgu planı, kilit beklemesi, disk erişimi veya bağlantı edinimi kaynaklı olup olmadığı ayrıştırılır; havuz boyutu bu teşhisten sonra yük deneyiyle belirlenir.
6. Sanal iş parçacığı ve gerçek eşzamanlılık sınırı
Sanal iş parçacığı, bloke edici G/Ç sırasında taşıyıcı iş parçacığını serbest bırakarak iş parçacığı başına istek modelini yüksek eşzamanlılıkta ucuzlatır. CPU işini hızlandırmaz.
Bu nedenle:
10 000 sanal thread
10 DB bağlantısı
olan sistemde gerçek veritabanı eşzamanlılığı yine yaklaşık ondur. Iş parçacığı sınırı kalkınca bağlantı havuzu görünür hale gelir.
Çözüm havuzu otomatik büyütmek değildir. Giriş hızı sınırlandırılır, işlem süresi kısaltılır, havuz beklemesi ölçülür ve veritabanının güvenli eşzamanlılığı korunur.
Yeni JDK sürümlerinde monitör tabanlı sanal iş parçacığı sabitlenmesinin önemli bölümü azaltılmış olsa da yerel çağrılar ve sürüme özgü davranışlar JFR olaylarıyla doğrulanmalıdır.
Reaktif programlama akış, yoğun fan-out ve uçtan uca geri basınç gereken yerde anlamlıdır. Bloke edici JDBC çağrısını reaktif zincire sarmak veritabanını asenkron yapmaz.
Spring Boot 4 ve sürüm sınırı
Spring Boot 4'te sanal iş parçacığı kullanımı Ağustos 2026 itibarıyla varsayılan değildir; spring.threads.virtual.enabled=true ile açılır. Açıldığında klasik görev pool boyut ayarlarının önemli bölümü artık aynı anlamı taşımaz; sanal iş parçacıkları JVM'nin ortak taşıyıcı havuzu üzerinde zamanlanır. Bu nedenle eski core-size, max-size veya Tomcat çalışan sayısını aynen taşıyıp sonucu sanal iş parçacığı davranışı sanmak yanlıştır.
Sanal iş parçacıkları daemon niteliğindedir. Uygulamanın yaşamını yalnız scheduled işlerin iş parçacıklarıine bağlayan süreçlerde Spring Boot'un spring.main.keep-alive davranışı ayrıca değerlendirilmelidir.
JDK 21 sanal iş parçacığını standartlaştırdı. JDK 24'te JEP 491, synchronized içinde bloke olan sanal iş parçacıklarıin taşıyıcı iş parçacığını bırakabilmesini sağlayarak monitör kaynaklı pinning'in önemli bölümünü ortadan kaldırdı. Bu, "pinning artık yok" demek değildir; native çağrılar, sürüme özgü kütüphane davranışı ve başka blokaj biçimleri JFR ile doğrulanır.
@Async, zamanlayıcı ve kontrolsüz fan-out
@Async bir performans özelliği değil başka bir yürütme kuyruğudur. Scheduler da aynı şekilde kapasite üretmez. Bir scheduled iş tek iş parçacığı üzerinde uzun sürüyorsa sonraki çalışmaları geciktirebilir; sanal iş parçacığı açıkken ise iş parçacığı sayısı ucuzladığı için aşağı akış kaynağını daha kolay taşırabilir.
Bu yüzden fan-out sınırı uygulama iş parçacığıyla değil hedef kaynağın kapasitesiyle konur:
10 000 ucuz sanal thread
-> 10 DB bağlantısı
-> 4 uzak servis kotası
-> 1 sıcak kilit
zincirinde en küçük güvenli sınır sistemi belirler.
Structured Concurrency
Structured Concurrency, birbirine bağlı alt görevlerin yaşam döngüsünü tek iş birimi gibi yönetmeyi; iptal, hata yayılımı ve gözlemlenebilirliği sadeleştirmeyi amaçlar. Ancak JDK 26'da dahi preview API durumundadır. Üretim API sözleşmesi olarak sürümler arası kararlı kabul edilmemeli, kullanılıyorsa preview bağımlılığı bilinçli yönetilmelidir.
WebFlux ile sanal iş parçacığı aynı problem değildir
WebFlux non-blocking event loop ve Reactive Streams geri basıncıyla özellikle akış tabanlı, çok yüksek fan-out ve uçtan uca reaktif sürücü zincirinde anlamlıdır. Spring MVC + sanal iş parçacığı ise bloke edici API'lerle iş parçacığı-per-request programlama modelini daha ucuz hale getirir.
JDBC/JPA kullanan, sınırlı DB pool'a sahip tipik OLTP serviste WebFlux'a geçmek veritabanı çağrısını non-blocking yapmaz. R2DBC farklı sürücü ve transaction modelidir. Mimari seçim çerçeve (framework) modasına göre değil bütün çağrı zincirinin bloklama modeline göre yapılır.
7. İşlem sınırları
ACID'in fiziksel karşılığı
Atomiklik undo/geri alma bilgisiyle, dayanıklılık redo veya WAL ile, yalıtım kilit veya MVCC ile uygulanır. Tutarlılık ise tanımlanan kısıtların ve doğru uygulama mantığının sonucudur.
Commit, yalnız Java metodunun bitmesi değildir; dayanıklılık garantisi isteniyorsa günlük kaydının kalıcı ortama ulaşması gerekir. Grup commit birden çok işlemin fsync maliyetini paylaşarak verimi artırır.
MVCC
MVCC okuyucuya tutarlı bir eski sürüm göstererek okuma ve yazmanın birbirini daha az engellemesini sağlar. Bedeli eski sürüm tutma ve temizleme maliyetidir.
Uzun transaction, yalnız kilit süresini değil eski sürümlerin ne kadar süre tutulacağını da artırabilir. "Salt okunur, zarar vermez" genellemesi bu nedenle doğru değildir.
Yalıtım anomalileri
Temel anomaliler:
- kirli okuma,
- kirli yazma,
- tekrarlanamayan okuma,
- hayalet okuma,
- okuma çarpıklığı,
- kayıp güncelleme,
- yazma çarpıklığı.
Anlık görüntü yalıtımı birçok okuma anomalisini çözer fakat yazma çarpıklığını garanti olarak çözmez. Aynı iş kuralına dayanıp farklı satırları güncelleyen iki işlem, tek tek doğru görünürken birlikte kısıtı bozabilir.
Gerçek serileştirilebilirlik, eşzamanlı yürütmenin sonucu seri bir sırayla aynı olacak garantisini verir. Bunun maliyeti uygulamaya göre kilit bekleme veya çakışan işlemlerin iptal edilip yeniden denenmesidir.
Yalıtım adı garanti değildir
READ COMMITTED, REPEATABLE READ veya SERIALIZABLE etiketlerinin ayrıntılı davranışı veritabanına göre değişebilir. Taşınabilir kod yalnız anotasyon adına güvenmez; gerekli iş kuralını hedef veritabanında test eder.
İşlem kısa olmalıdır
Harici servis, kullanıcı etkileşimi, dosya aktarımı ve uzun hesap işlem içinde tutulmaz.
Kısa işlem:
- bağlantıyı erken bırakır,
- kilit süresini azaltır,
- MVCC eski sürüm baskısını düşürür,
- iyimser çakışma penceresini küçültür,
- hata sonrası yeniden denenecek işi azaltır.
8. Spring işlem yönetimi
@Transactional bir sözdizimi değil proxy davranışıdır. Aynı sınıf içindeki doğrudan çağrı proxy'den geçmiyorsa beklenen işlem sınırı oluşmayabilir.
Varsayılan geri alma kuralları istisna türüne bağlıdır; iş kuralı "bu hata atomikliği bozmalı" diyorsa rollbackFor gibi politika açık yazılır.
REQUIRES_NEW yeni mantıksal işlemden fazlasını yapabilir: ikinci fiziksel bağlantı gerektirir. Dış işlemler havuzdaki tüm bağlantıları tutarken iç işlemler yeni bağlantı beklerse uygulama kendi kendini kilitleyebilir.
readOnly=true zorlayıcı bir yazma bariyeri veya veritabanı yetkisi değildir. Spring bunu JDBC bağlantısına salt-okunur ipucu olarak yayabilir; Hibernate tarafında salt-okunur varlıklar için anlık görüntü/dirty-check ve flush davranışını azaltan optimizasyonlara dönüşebilir. Sürücü bu ipucunu yok sayabilir veya farklı yorumlayabilir. Gerçek etki sağlayıcı, sürücü ve sürüme bağlıdır; güvenlik veya veri bütünlüğü kısıtı yerine geçmez.
Salt okunur işlemler, okuma kopyasına yönlendirme için de doğal işarettir; ancak kopya gecikmesi "kendi yazdığını oku" beklentisi olan akışlarda ayrıca ele alınır.
9. Eşzamanlılık denetimi
İyimser kilitleme
Sürüm sütunu güncellemeye eklenir:
UPDATE account
SET balance = ?, version = version + 1
WHERE id = ? AND version = ?;
Etkilenen satır sıfırsa veri değişmiştir. Kilit beklemesi yoktur; çakışma düşükse en ucuz yöntemlerden biridir.
İyimser kilitleme yalnız tek satırın sürümünü korur. İş kuralı birden çok satır veya koleksiyon üzerinden kuruluyorsa kök sürümünün artırılması, benzersiz kısıt, serileştirilebilir işlem veya açık kilit gerekebilir.
Kötümser kilitleme
Kötümser kilit kaynak üzerinde sıra oluşturur. Çakışma çok yüksek ve iş kısa ise yeniden deneme fırtınasından daha ucuz olabilir.
Kurallar:
kilidi geç al
işi kısa tut
her yerde aynı sırayla kilitle
bekleme süresini sınırla
kilit altında uzak çağrı yapma
Kilitlenme
Kilitlenme hata değil, eşzamanlı kilitli sistemin beklenen olayıdır. Veritabanı çevrimi bulur ve bir işlemi kurban seçer.
Uygulama:
- hatayı sınıflandırır,
- yalnız geçici hatayı yeniden dener,
- işlemi baştan çalıştırır,
- deneme sayısını sınırlar,
- üstel bekleme ve rastgele sapma kullanır.
İdempotent yeniden deneme
Bir isteği iki kez çalıştırmak dış dünyada iki etki üretmemelidir. Ödeme, mesaj, dosya veya uzak servis çağrısı gibi yan etkiler işlem yeniden denemesinden ayrılır.
İdempotency anahtarı:
aynı iş kimliği
-> ilk sonuç saklanır
-> tekrar çağrı aynı sonucu görür
modeliyle tekrar etkisini sınırlar.
10. Giden mesaj kutusu ve veritabanı dışı yan etkiler
Veritabanı işlemi ile mesaj kuyruğu veya HTTP çağrısını tek yerel transaction altında atomik yapmak genellikle mümkün değildir.
Giden mesaj kutusu (transactional outbox) yaklaşımı:
aynı DB transaction:
  iş verisini yaz
  outbox kaydını yaz

ayrı süreç:
  outbox oku
  mesajı gönder
  gönderildi olarak işaretle
şeklindedir.
Mesaj en az bir kez ulaşabilir; tüketici idempotent olmalıdır. "Tam olarak bir kez" garantisi yalnız tanımlı bir transaction sınırı içinde anlamlıdır. Kafka kendi transaction sınırı içinde exactly-once işleme sağlayabilir; ancak ilişkisel veritabanı, HTTP, dosya sistemi veya başka bir dış yan etki bu sınıra otomatik olarak katılmaz. Böyle sınırlar arasında outbox, idempotency anahtarı, yinelenen kayıtları tekilleştirme veya başka bir açık protokol gerekir.
Admission control ve bulkhead: iş parçacığı sayısı kapasite değildir
Modern Java'da çok sayıda bloklayan işi ucuz biçimde temsil edebilmek, arka uçtaki kıt kaynağın da aynı ölçüde büyüdüğü anlamına gelmez. Veritabanı bağlantısı, uzak servis eşzamanlılığı, dosya tanıtıcısı, CPU ve disk kuyruğu bağımsız kapasite sınırlarıdır. Bu nedenle yürütme modeli ile kabul edilen eşzamanlı iş miktarı ayrı tasarlanmalıdır.
istek
  |
  v
sınıflandırma
  |
  v
admission gate ---- dolu ----> hızlı ret / zaman aşımı / geri deneme
  |
  v
kıt kaynak
(DB, uzak servis, disk, CPU)
Semaphore benzeri bir izin mekanizması, belirli bir pahalı sınırın önünde açık bir concurrency bütçesi oluşturabilir. Bu yaklaşım thread pool kurmakla aynı şey değildir. Virtual thread'ler bekleyen işi ucuzlaştırabilir; semaphore ise aynı anda kıt kaynağa girebilecek iş sayısını sınırlar. İki mekanizma farklı problemi çözer.
Bulkhead yaklaşımında bütün trafik tek bir ortak kontenjana konulmaz. Farklı maliyet ve önem sınıfları bağımsız bütçelerle korunabilir. Böylece pahalı ve düşük öncelikli bir iş akışı, kısa ve kritik bir iş akışının bütün kapasitesini tüketmez. Ancak bu ayrım keyfi olmamalıdır; iş sınıfları ölçülen maliyet, güven düzeyi ve hizmet sözleşmesine göre tanımlanmalıdır.
Sınır dolduğunda sonsuz kuyruk oluşturmak genellikle en kötü seçenektir. Kuyruk büyüdükçe yeni isteklerin başlangıç gecikmesi artar ve sistem toparlanmak yerine geçmiş yükü taşımaya devam eder. Kontrollü ret, sonlu bekleme ve uygun yeniden deneme politikası çoğu zaman daha öngörülebilir bir hata biçimidir. Bu ilişki Virtual Thread Veritabanı Kapasitesini Artırmaz notundaki JDBC sınırı ve rate limiting kavramıyla birlikte okunmalıdır.
Ölçümde yalnız izin sayısı değil, izin bekleme süresi, ret oranı, kuyrukta geçirilen süre, arka uç kullanım oranı ve P95/P99 gecikme birlikte izlenmelidir. Admission control başarılıysa sistem aşırı yük altında bile sınırsız gecikmeye sürüklenmek yerine tanımlı bir kapasite zarfı içinde davranır.
Pahalı I/O'dan önce maliyet tahmini
Admission control yalnız aynı anda kaç iş parçacığının çalışabileceğini sınırlamak değildir. Veri kaynağına erişmeden önce isteğin yaklaşık maliyeti mevcut metadata üzerinden tahmin edilebiliyorsa gereksiz I/O daha başlamadan engellenebilir.
Örneğin bir işlem için şu büyüklükler ayrı ayrı değerlendirilebilir:
- aday kayıt sayısı,
- henüz yüklenmemiş kaynak sayısı,
- beklenen batch ve istek sayısı,
- tahmini toplam metin veya payload büyüklüğü,
- CPU-ağır bir operatörün ana iş parçacığında çalışıp çalışamayacağı.
Bu modelde geniş bir istek, kapasite sınırını aştığında sessizce örneklenmez. Kullanıcıdan kapsamı daraltması istenir veya işlem açık biçimde reddedilir. Sessiz örnekleme, özellikle sonuç "tam tarama" gibi sunuluyorsa performans optimizasyonunu doğruluk problemine dönüştürür.
Katmanlı bütçe kullanmak tek bir maksimum istek boyutundan daha güçlüdür. Tek batch büyüklüğü, toplam istek sayısı, toplam karakter/bayt hacmi ve CPU maliyeti farklı kaynakları tüketir; her biri kendi üst sınırına sahip olabilir.
Veri tabanı transaction'ı da aynı maliyet disiplinine tabidir. Yetkilendirme, gerekli ilişkisel okumalar ve tutarlılık kontrolü kısa transaction içinde tamamlanıp bağlantı bırakıldıktan sonra büyük dosya, metin veya CPU işlemi sürdürülebilir. Böylece:
T_transaction ≪ T_requestolması hedeflenir. Uzun süren dönüşüm veya analiz işini veritabanı bağlantısına bağlamamak; connection pool, kilit ömrü ve MVCC baskısını azaltır.
Java'da Sık Karıştırılan Eşzamanlılık ve Performans Kavramları
Java performansında en tehlikeli hatalardan biri, bir API adından garanti çıkarmaktır. ConcurrentHashMap, volatile, Stream API, virtual thread veya connection pool doğru bağlamda yararlıdır; fakat her biri yalnız belirli problemi çözer.
volatile neyi garanti eder?
volatile, ilgili değişkene yapılan yazma ve okumalar arasında Java Memory Model kapsamında görünürlük ve sıralama garantileri sağlar. count++ gibi read-modify-write işlemini atomik hâle getirmez. Sayaç gibi birleşik atomik işlem gerektiğinde AtomicLong, LongAdder, lock veya başka uygun coordination mekanizması gerekir.
ConcurrentHashMap neyi garanti eder?
Harita eşzamanlı erişim için tasarlanmıştır; fakat birden fazla ayrı çağrıdan oluşan iş kuralını otomatik atomik yapmaz. get() ardından put() iki ayrı operasyon olduğunda araya başka thread girebilir. compute, computeIfAbsent, merge, putIfAbsent gibi birleşik operasyonlar uygun problemde daha doğru semantik sağlayabilir. Bununla birlikte mapping fonksiyonlarının yan etkileri ve çalışma maliyeti kontrol edilmelidir.
Stream API paralellik garantisi değildir
Stream zinciri deklaratif veri işleme sağlar. parallelStream() kullanmak işlemi otomatik olarak hızlandırmaz. Veri boyutu, bölümleme maliyeti, fonksiyonların CPU maliyeti, shared state, common ForkJoinPool üzerindeki başka işler ve cache locality sonucu belirler. Küçük koleksiyonda paralelleştirme overhead'i kazançtan büyük olabilir.
Virtual thread kapasiteyi çoğaltmaz
Virtual thread bloklayan I/O içeren yüksek eşzamanlılıkta platform thread maliyetini azaltabilir. Ancak veritabanı connection pool'u, uzak servis QPS limiti, disk bant genişliği veya CPU çekirdeği sayısı aynı kalır. Virtual thread kullanıldığında da downstream kaynağın kaldırabileceği concurrency sınırı korunmalıdır.
Connection pool ve thread pool birlikte boyutlandırılır
Request concurrency çok yüksek, JDBC havuzu küçükse ek thread'ler çoğunlukla connection bekler. JDBC havuzunu aşırı büyütmek de veritabanında aktif session, latch/lock ve I/O contention artırabilir. Optimum değer, uygulama CPU'sundan çok veritabanı kapasitesi ve transaction süresiyle ilişkilidir.
JPA soyutlaması sorguyu ortadan kaldırmaz
Repository veya entity düzeyinde tek satır görünen kod; lazy relation, dirty checking veya cascade nedeniyle birden fazla SQL üretebilir. N+1 davranışı source code satır sayısından değil gerçek SQL ve result-set kardinalitesinden ölçülmelidir. Fetch join veya projection da körlemesine kullanılmamalı; cardinality patlaması ve pagination etkisi kontrol edilmelidir.
Prepared statement'ın rolü
Parametreli sorgu SQL injection riskini azaltmak ve sorgu/parametre ayrımını korumak için temel araçtır. Bunun performans etkisi sürücü ve DBMS plan/cache davranışına bağlıdır. “PreparedStatement her zaman daha hızlıdır” gibi evrensel sonuç doğru değildir; öncelikli değer güvenli ve doğru parametre bağlamadır.
GC'yi azaltmak ile belleği yönetmek aynı şey değildir
Daha az allocation bazı sıcak yollarda GC yükünü azaltabilir; ancak bütün nesne tahsislerini önlemek okunabilirlik ve optimizasyon fırsatlarını bozabilir. Modern JVM çok sayıda kısa ömürlü nesneyi verimli yönetebilir. Önce allocation profile ve GC pause/throughput ölçülmeli, sonra escape, pooling veya buffer reuse gibi teknikler gerekçeli uygulanmalıdır.
Performans kararı için kanıt zinciri
Sağlam sıra şöyledir:
iş yükü → SLO → ölçüm → darboğaz → hipotez → kontrollü değişiklik → yeniden ölçüm
API adını “hızlı” kabul ederek yapılan değişiklik bu zincirin yerini tutmaz.
Java Servislerinde Kuyruk, Backpressure ve Tail Latency
Java servislerinde kuyruk büyümesi, istek kabul hızı ile alt sistemlerin tamamlayabildiği iş miktarı arasındaki farkın birikmesidir. Virtual thread sayısının artırılması, veritabanı bağlantı havuzu veya uzak servis eşzamanlılık sınırını ortadan kaldırmaz. İş kabulü, bounded queue ve zaman aşımı politikasıyla sınırlandırılırken p95/p99 gecikmesi ile reddedilen istek oranı birlikte izlenmelidir. Backpressure kararı verilmeden önce bekleyen işin hangi kaynak üzerinde tutulduğu açıkça belirlenmelidir.
- Thread/virtual-thread sayısını sınırsız artırmak yerine downstream kapasitesine göre concurrency sınırı koymak.
- Connection pool, executor ve DB servis sürelerini tek kuyruk zinciri olarak değerlendirmek.
- Ortalama RPS artarken p99 ve timeout oranının bozulduğu saturation noktasını ölçmek.
Ünite 3: Kalıcılık Bağlamı, ORM ve Veri Taşıma Maliyeti
11. Persistence context
Persistence context aynı kimliğe sahip varlığı işlem içinde tek Java nesnesiyle temsil eder, değişiklikleri toplar ve kirlilik denetimi yapar.
Bu kolaylık bedelsiz değildir:
yönetilen varlık sayısı ↑
snapshot belleği ↑
flush taraması ↑
GC baskısı ↑
Uzun toplu işlerde context sınırsız büyütülmez.
Flush ve clear
for (int i = 0; i < items.size(); i++) {
    entityManager.persist(items.get(i));

    if ((i + 1) % batchSize == 0) {
        entityManager.flush();
        entityManager.clear();
    }
}
flush() SQL'i veritabanına gönderir, clear() yönetilen varlıkları ayırır, commit işlemi kalıcılaştırır. Üçü aynı kavram değildir.
Salt okunur yol
Salt okunur işte varlık değişikliği izlenmeyecekse DTO veya scalar sonuç çoğu zaman varlık yüklemekten daha ucuzdur. Varlık gerekiyorsa read-only işlem ve sağlayıcı ipuçları gereksiz anlık görüntü/flush maliyetini azaltabilir.
persist ve merge
Yeni varlık için persist, ayrık nesnenin durumunu kopyalamak için merge kullanılır. merge gerektiğinde mevcut satırı yüklediği için toplu yazmada gizli SELECT maliyeti oluşturabilir.
Katmanlar arasında detached varlık taşımak yerine açık bir DTO sözleşmesi kullanmak hem bu maliyeti hem de istemeden lazy yüklemeyi azaltır.
Stateless yaklaşım
Çok büyük ve salt toplu veri akışında birinci düzey önbellek, cascade ve kirlilik denetimi istenmiyorsa durumsuz Hibernate oturumu veya doğrudan JDBC daha uygun olabilir. Daha az sihir, daha fazla açık sorumluluk demektir.
12. Open Session in View
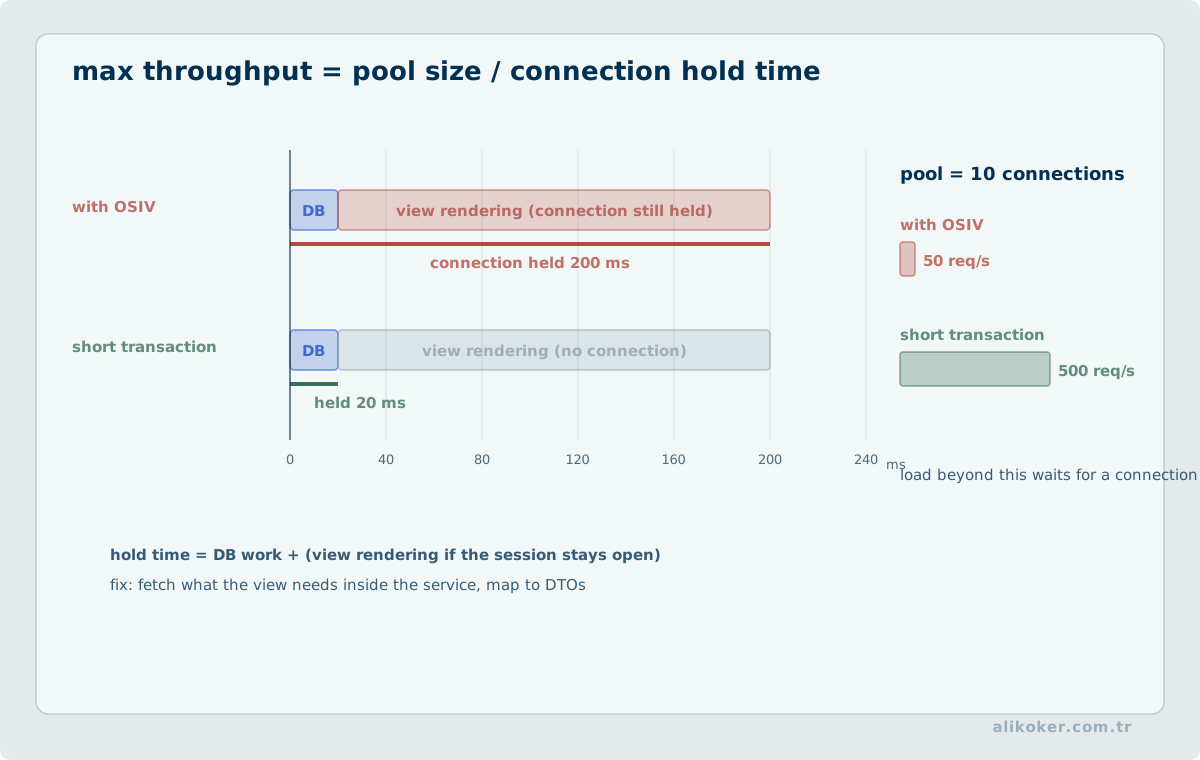
Open Session in View açık olduğunda web katmanı persistence context'e erişmeye devam edebilir. Bu kolaylık:
- transaction sınırını görünmez yapar,
- JSON serileştirme sırasında lazy sorgu başlatabilir,
- N+1'i servis testlerinden saklayabilir,
- bağlantının beklenenden uzun tutulmasına yol açabilir.
Üretim veri erişiminde tercih edilen model:
servis transaction'ı
-> gereken veriyi açıkça getir
-> DTO oluştur
-> transaction kapanır
-> web katmanı DB'ye dokunmaz
open-in-view=false tembel yükleme hatasını üretmiyorsa sistem düzgün demek değildir; hata çıkması daha önce gizlenen erişimin görünür olmasıdır.
13. Kimlik stratejileri
Primary key'in görevi
Primary key yalnız hızlı arama aracı değildir; satır kimliğini ve veri modelindeki tekilliği tanımlar. ORM kimlik haritası, ilişki çözümü ve güncelleme semantiği bu kimliğe dayanır.
Mantıksal tekilliği ayrıca korumak gerekiyorsa benzersiz kısıt uygulanır. İş kuralı yalnız uygulama koduna bırakılırsa eşzamanlı iki istek kontrolü aynı anda geçebilir.
IDENTITY
IDENTITY değeri ekleme sonrasında döndüğü için Hibernate'in insertleri geciktirip toplamasını zorlaştırır; yoğun batch yazmada uygun değildir.
SEQUENCE
Sequence kimliği eklemeden önce alınabilir. Pooled veya pooled-lo artırıcı, her kimlik için ayrı veritabanı çağrısını azaltır.
Sequence önbellek büyütmek kimliklerde boşluk bırakabilir. Anahtarın görevi sıralı muhasebe numarası olmak değil kimlik sağlamaktır; boşluksuz sıra ayrı bir iş kuralıdır.
UUID
Dağıtık üretim koordinasyon gerektirmez. Tam rastgele UUID, B-tree yaprak yerelliğini azaltabilir; zaman sıralı UUID biçimleri ekleme yerelliğini iyileştirir.
Anahtar seçimi:
tek düğüm / DB sequence       sequence
dağıtık bağımsız üretim      UUID benzeri
iş açısından anlamlı anahtar natural key + ayrı teknik PK
olarak düşünülür.
14. Eşleme maliyeti
Türler
Java türü ile veritabanı türü aynı anlamı taşımalıdır. Zaman dilimli ve zaman dilimsiz tarih-saat türlerini karıştırmak yalnız doğruluk değil indeks kullanımı ve dönüşüm maliyeti sorunu da üretir.
Enum sıra numarasıyla saklanırsa kaynak kodundaki sıra değişikliği eski verinin anlamını değiştirir. Kararlı metin veya kod değeri daha güvenlidir.
Büyük alanlar
LOB, JSON ve büyük metin her listede taşınmamalıdır. Sıcak sorguda yalnız gereken sütunlar seçilir; büyük içerik ayrı erişim yoluna alınabilir.
"Lazy LOB" davranışı sağlayıcı ve bayt kodu iyileştirmesine bağlı olabileceği için yalnız anotasyona güvenilmez, üretilen SQL doğrulanır.
Kalıtım
ORM kalıtımı nesne modelini veritabanına taşıdığı için sorgu maliyeti üretir.
- tek tablo en az join ile hızlıdır, alt sınıf kısıtları zayıflayabilir,
- joined bütünlüğü korur, her polimorfik okumada join maliyeti taşır,
- table-per-class polimorfik sorguda union üretir.
Polimorfik sorguya ihtiyaç yoksa veritabanında kalıtım kurmak zorunlu değildir.
15. İlişkiler ve N+1
Varsayılan fetch'e güvenme
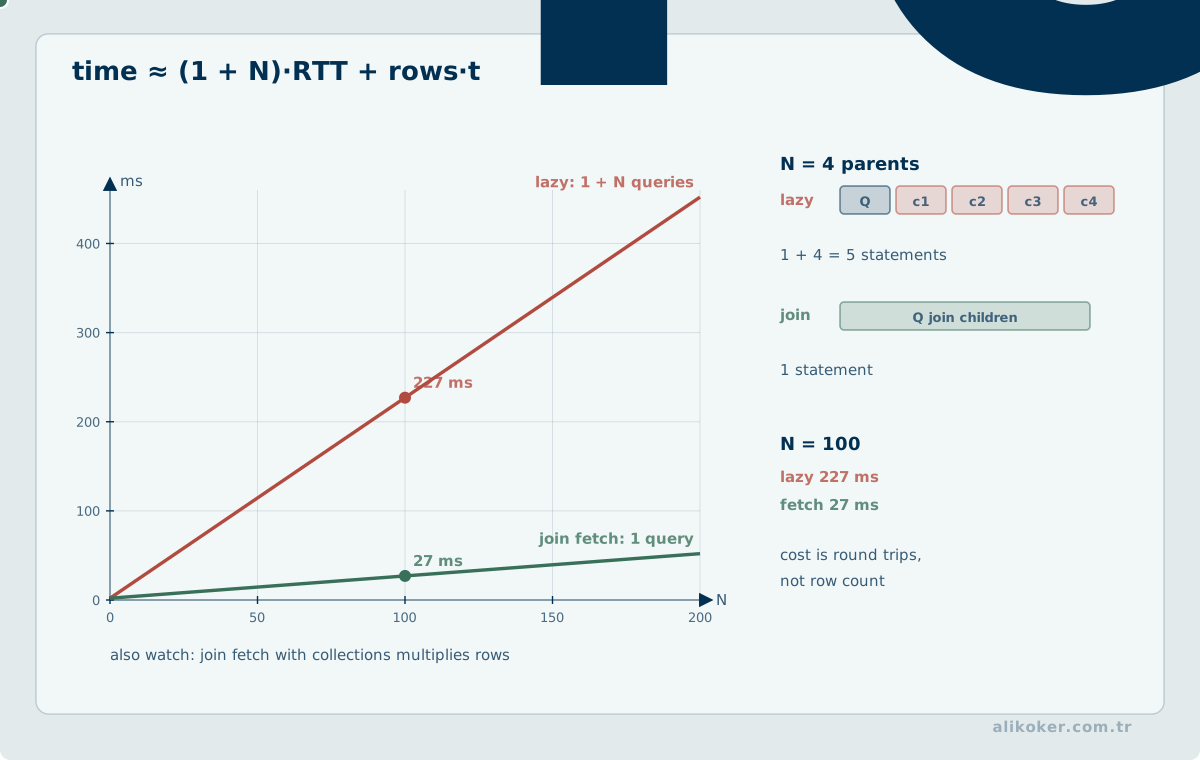
İlişkiyi EAGER yapmak N+1'i çözmez; pahalı yüklemeyi her sorguya zorlar. İlişkiler genellikle tembel tutulur ve gereken sorguda fetch planı açıkça seçilir.
N+1
1 kök sorgu
+ N ilişki sorgusu
= N+1
Her sorgu tek başına 1 ms olsa bile bin kayıt için ağ gidiş-dönüşü baskın hale gelir.
N+1'i bulmanın en güvenilir yolu istek başına sorgu sayısını veri hacmiyle birlikte izlemektir.
Çözüm sırası
Salt okunur ekranda:
DTO projectionvarlık gerekiyorsa:
JOIN FETCH / entity graphilişki yalnız bazı kayıtlarda gerekliyse:
batch fetchkullanılır.
Batch fetch, N+1 davranışını yaklaşık N/batch + 1 sorguya indirir; tek sorgu değildir fakat kartezyen büyümeyi önleyebilir.
Koleksiyon fetch ve sayfalama
Koleksiyon join edildiğinde bir kök satır çok sayıda SQL satırına dönüşür. Aynı sorguda LIMIT/OFFSET uygulamak kök varlık sayısını değil join satırını sınırlar.
Güvenli iki aşamalı yol:
1. sayfalanmış kök ID'lerini getir
2. bu ID'lerin ilişkilerini ayrı sorguda getir
olabilir.
Çok koleksiyon
İki büyük koleksiyonu tek join ile çekmek:
A satırı × B satırıkadar ara sonuç üretir. Tek SQL her zaman az iş değildir.
16. Sonuç kümesi ve taşınan veri
Projection
Liste ekranı beş alan gösteriyorsa elli sütunlu varlık çekilmez. DTO, interface projection veya scalar sonuç kullanılır.
Veritabanı performansında temel ölçü:
gereksiz satır + gereksiz sütun + gereksiz gidiş-dönüştoplamıdır.
Getirme boyutu
Getirme boyutu sonuç kümesinin toplam büyüklüğünü değil sürücünün bir ağ turunda taşıdığı satır sayısını belirler:
yaklaşık round-trip = satır / fetch sizeÇok küçük değer ağ turunu, aşırı büyük değer istemci belleğini artırır. Sürücü davranışı doğrulanır.
Akış
Çok büyük sonucu List içine almak yerine akışlı okumak belleği sınırlayabilir; fakat bağlantı akış kapanana kadar tutulur.
Kural:
stream kısa işlem + düzenli tüketim + kesin closeolmalıdır.
Saatler süren yavaş tüketicinin connection'ı işgal etmesi, öbek taşmasından farklı ama aynı derecede ciddi bir sorundur.
17. Sayfalama
Offset
SELECT ...
ORDER BY created_at, id
OFFSET 100000 ROWS FETCH NEXT 50 ROWS ONLY;
derin sayfada atlanacak kayıtların maliyetini taşır.
Anahtar tabanlı sayfalama
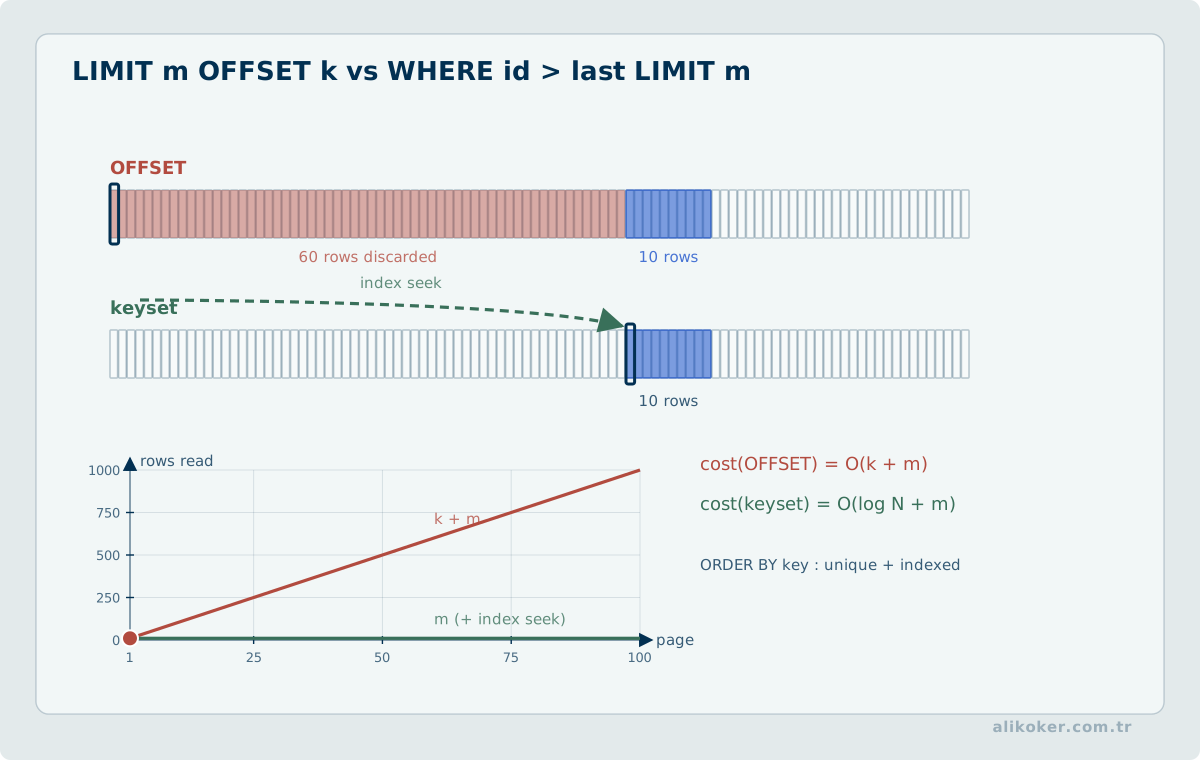
Anahtar tabanlı sayfalama son görülen tekil sıralama anahtarından devam eder. PostgreSQL ve MySQL gibi ürünlerde satır-değeri karşılaştırmasıyla kısa biçim kullanılabilir:
WHERE (created_at, id) < (?, ?)
ORDER BY created_at DESC, id DESC
Ürünler arası taşınabilirlik için aynı koşul açıkça genişletilebilir:
WHERE created_at < ?
   OR (created_at = ? AND id < ?)
ORDER BY created_at DESC, id DESC
LIMIT veya FETCH FIRST gibi satır sınırlama sözdizimi ayrıca ürüne göre seçilir. Satır-value eşitsizliği desteği ve optimizer'ın birleşik indeksi nasıl kullandığı ürün/sürüme göre farklılaşabildiğinden gerçek yürütme planı doğrulanmalıdır.
Uygun indeksle son görülen konumdan devam etmek, derin offset'in satırları bulup atma maliyetini önler. Doğrudan "sayfa 5000" atlaması zorlaşır; sonsuz kaydırma, API taraması ve batch işlerinde bu genellikle kabul edilebilir.
Sıralama tekil olmalıdır. Yalnız created_at kullanmak aynı zamana sahip satırlarda atlama veya tekrar üretebilir; sonuna benzersiz anahtar eklenir.
COUNT maliyeti
Her sayfada tam COUNT(*) gerekmez. Kullanıcı yalnız "sonraki var mı" diyorsa Slice benzeri yapı yeterlidir.
Toplam sayının iş gereksinimi olduğu yerde hesaplanır; çerçeve varsayılanı olduğu için değil.
18. Toplu yazma
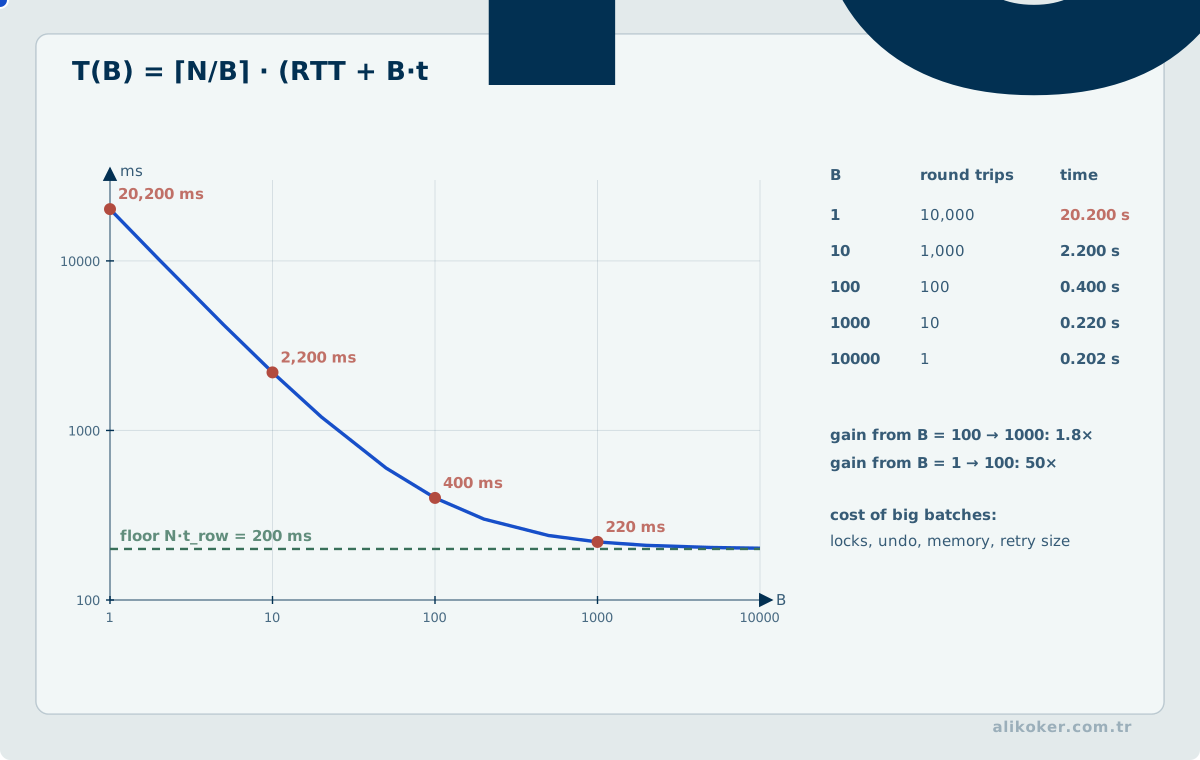
Batch'in kazancı CPU hilesi değil ağ gidiş-dönüşünü azaltmasıdır.
10 000 insert
tek tek     -> 10 000 gönderim
batch 100   -> yaklaşık 100 grup
Gerçek paket sayısı sürücü ve veritabanı protokolüne bağlıdır.
Batch boyutu büyüdükçe:
- gidiş-dönüş azalır,
- istemci/sunucu tamponu büyür,
- hata anında geri alınacak iş büyür,
- tek kaydın bekleme süresi artabilir.
Bu nedenle 50 veya 100 gibi değerler yalnız ölçüm başlangıcıdır.
Hibernate batch
Aynı SQL biçimindeki işlemler arka arkaya gelmelidir. Ekleme ve güncellemeleri sıralama, batch'in dolmasını kolaylaştırır.
Kimlik stratejisi batch'i desteklemelidir. IDENTITY ile ekleme sonrası kimlik gerektiğinden batch davranışı bozulabilir; sequence ve havuzlu artırıcı daha uygundur.
Bulk DML
Tek SQL ile yapılan toplu güncelleme, bin varlık yükleyip tek tek değiştirmekten çok daha ucuz olabilir:
UPDATE job
SET state = 'EXPIRED'
WHERE state = 'OPEN'
  AND expires_at < ?;
Ancak bulk DML persistence context durumunu es geçer; bellekteki yönetilen varlıklar veritabanındaki yeni değerlerle otomatik eşitlenmez. Context temizlenmeli, clearAutomatically benzeri politika kullanılmalı veya etkilenen varlıklar yeniden yüklenmelidir.
19. Set tabanlı SQL ve satır satır işlem
Veritabanı küme işlemleri için tasarlanmıştır. PL/SQL veya uygulama kodunda satır satır döngü, aynı işi tek SQL'in yapabileceği durumda gidiş-dönüş, context switch ve kilit süresini artırır.
Sorun "imleç kullanmak" değildir; veritabanı zaten imleç kavramıyla çalışır. Sorun, küme tabanlı işi satır tabanlı algoritmaya çevirmektir.
Tercih sırası:
tek set-based SQL
-> bulk/batch
-> zorunluysa kontrollü satır işleme
olmalıdır.
RAC gibi paylaşımlı veritabanı kümelerinde gereksiz satır gezme yalnız CPU değil düğümler arası blok koordinasyonunu da büyütebilir.
ORM İş Büyütmesini Ölçmek: Fetch Planı, Persistence Context ve Transaction Sınırı
ORM kullanılan bir sistemde kaynak kod satırı ile fiziksel iş miktarı arasında doğrudan ilişki yoktur. Tek bir repository çağrısı bir SQL çalıştırabilir, çok sayıda SQL üretebilir veya çok büyük bir sonuç kümesini entity graph içine taşıyabilir.
Bu nedenle JPA/Hibernate performans problemi önce API adıyla değil yapılan işle fiziksel olarak tanımlanmalıdır.
Basitleştirilmiş bir istek maliyeti şöyle düşünülebilir:
T_istek
≈
T_pool_bekleme
+
Σ(
    T_network_round_trip
    + T_database
    + T_mapping
)
+
T_serialization
Bu bir performans yasası değildir. Ölçümde hangi maliyetlerin birbirinden ayrılması gerektiğini gösteren teşhis modelidir.
N+1 bir kod kokusundan önce iş büyütmesidir
Bir ana sorgudan sonra her sonuç için ayrı ilişki sorgusu çalışıyorsa sorgu sayısı yaklaşık olarak:
Q(N) = 1 + Nşeklinde büyür.
Ana sorgu 1000 kayıt döndürüyorsa teorik olarak 1001 SQL çağrısı görülebilir.
Sorun yalnız SQL sayısının estetik olarak yüksek olması değildir. Her yeni çağrı JDBC invocation, network round trip, database scheduling, parse/bind/execute, result transfer ve mapping maliyetlerinin bir bölümünü yeniden üretir.
Nested ilişki erişimleri iş büyütmesini daha da artırabilir:
ana kayıtlar        = N
her ana kayıt altı  = M

iş miktarı
≈ 1 + N + N×M
Gerçek SQL sayısı fetch stratejisine ve önbellek (cache) durumuna bağlıdır; denklem yalnız büyüme biçimini görünür kılar.
Sorgu sayısını azaltmak tek başına optimizasyon değildir
N+1 problemini tek SQL ile değiştirmek her zaman kazanım değildir.
Birden fazla to-many ilişkinin aynı sorguda genişletilmesi satır çarpımına neden olabilir:
100 sipariş
× 20 satır
× 5 etiket
=
10 000 sonuç satırı
Uygulama sonunda yalnız 100 sipariş nesnesi kullanıyor olsa bile JDBC seviyesinde çok daha fazla veri taşınmış olabilir.
Bu nedenle en düşük sorgu sayısı ile en düşük toplam iş aynı kavram değildir.
Birlikte ölçülmesi gerekenler arasında SQL çağrı sayısı, sonuç satırı, taşınan byte, logical I/O, DB CPU, connection lease time, entity sayısı, allocation, serialization boyutu ve uç gecikme bulunur.
Fetch yöntemi kullanım amacından türetilmelidir
JPA/Hibernate veri erişiminde tek bir evrensel fetch stratejisi yoktur.
Projection
Ekran veya rapor yalnız birkaç alan gerektiriyorsa tam entity graph oluşturmak yerine yalnız gereken sütunları taşıyan projection daha az veri ve daha az managed state üretebilir.
Projection özellikle read-mostly sorgularda güçlüdür. Buna karşılık update yapılacak domain davranışını DTO/projection üzerinden taklit etmek yeni karmaşıklık yaratabilir.
Fetch join
Fetch join gerekli ilişkiyi aynı SQL içinde getirebilir ve round-trip sayısını düşürebilir.
Bedeli daha geniş result set ve özellikle collection ilişkilerinde satır çoğalmasıdır. Çok sayıda collection fetch veya pagination ile birlikte kullanım gerçek SQL ve sonuç cardinality üzerinden doğrulanmalıdır.
Entity graph
Entity graph, belirli use-case için hangi ilişkinin birlikte yüklenmesi gerektiğini sorgu sözleşmesine daha yakın tanımlayabilir.
Avantajı entity mapping üzerindeki global fetch varsayımını her kullanım için değiştirmeden use-case odaklı fetch planı kurabilmesidir.
Ancak entity graph da sonuç cardinality veya sorgu maliyetini ortadan kaldırmaz. Üretilen SQL yine ölçülmelidir.
Batch fetching
İlişkileri tek tek almak yerine anahtarları gruplandırarak daha az sayıda sorgu çalıştırmak bazı erişim desenlerinde N+1 maliyetini azaltabilir.
En uygun batch büyüklüğü veri hacmi, bind sınırları, plan davranışı, ağ gecikmesi ve bellek maliyetiyle birlikte ölçülmelidir.
Persistence context aynı zamanda çalışma kümesidir
Hibernate persistence context yalnız nesnelerin bulunabildiği bir first-level önbellek değildir. Managed entity durumunu takip eden bir unit-of-work alanıdır.
Uzun süren bir işlem çok sayıda entity yüklediğinde heap üzerinde canlı managed state ve dirty-checking için izlenen state büyüyebilir.
Bu nedenle büyük batch işlerinde yalnız SQL batch boyutu düşünülmemelidir. Persistence context boyutu da izlenmelidir.
Semantik izin veriyorsa kontrollü aralıklarla:
işle
flush
clear
sonraki grup
yaklaşımı managed çalışma kümesini sınırlayabilir.
Ancak flush() commit değildir. Verinin veritabanına gönderilmesi ile transaction durability aynı kavram değildir. clear() da rastgele kullanılmamalıdır; henüz gerekli olan managed state kaybedilebilir.
Batch sınırı iş kuralının atomicity gereksinimiyle birlikte tasarlanmalıdır.
Rollback nesne grafiğini zamanda geri götürmez
Database rollback kalıcı veritabanı değişikliklerini geri alabilir. Buna karşılık uygulama belleğindeki Java nesnelerinin tamamını transaction başlangıcındaki durumuna otomatik olarak döndürmez.
Bir persistence işlemi ciddi biçimde başarısız olduğunda aynı persistence context ile normal iş akışına devam etmek güvenilir bir recovery modeli değildir.
Güvenli zihinsel model:
transaction başarısız
        ↓
rollback
        ↓
başarısız unit of work sona erer
        ↓
yeni iş için temiz persistence context
Hata sonrası toparlanma yalnız exception yakalamak değil, hangi state bilgisinin artık güvenilir olduğunu belirlemektir.
Transaction sınırı annotation konumundan daha büyüktür
Spring tarafında @Transactional çoğunlukla proxy tabanlı advice ile uygulanır. Bu nedenle kaynak kodda annotation görülmesi, bütün çağrı yollarında aynı transaction sınırının oluştuğunu otomatik olarak göstermez.
Özellikle aynı nesnenin kendi metoduna yaptığı self-invocation proxy yolunu atlayabilir.
Performans açısından transaction sınırının gereğinden geniş olması da önemlidir:
transaction başlat
DB oku
uzak HTTP servisi bekle
dosya işle
uzun CPU hesabı yap
DB yaz
commit
Bu akış, veri tabanı açısından gerekli olmayan süre boyunca transaction yaşam döngüsünü uzatabilir.
Daha kısa transaction her zaman otomatik çözüm değildir. İş kuralı tek atomik işlem gerektiriyorsa sınırı yalnız performans için parçalamak doğruluğu bozar.
Doğru sıra:
önce atomicity gereksinimi
sonra transaction sınırı
sonra fiziksel kaynak maliyeti
olmalıdır.
ORM performans regresyonu için bütçe tanımlamak
ORM performans problemi üretimde fark edilmek zorunda değildir. Kritik okuma yolları için test veya yük testi sırasında davranış bütçeleri izlenebilir.
Örneğin beklenen maksimum SQL sayısı, beklenen maksimum sonuç satırı, connection acquisition P95/P99, DB service time P95/P99, connection lease süresi, oluşturulan entity sayısı, allocation byte ve response ileti yükü (payload) izlenebilir.
Bu değerlerin tamamı her unit testte kontrol edilmemelidir. Ama yüksek trafikli veya geçmişte regresyon yaşamış path için birkaç ölçülebilir bütçe güçlü bir güvenlik ağı oluşturur.
Yalnız SQL süresini ölçmek yeterli değildir:
2 ms SQL
+ 80 ms pool wait
+ 30 ms mapping
+ 20 ms serialization
≠
2 ms request
Benzer biçimde query sayısının değişmemesi de aynı iş miktarının korunduğunu kanıtlamaz.
ORM optimizasyonunda karar sırası
Pratik karar sırası şu şekilde kurulabilir:
1. İstek için gerçekten hangi veri gerekli?
2. Kaç SQL çalışıyor?
3. Her SQL kaç satır ve byte taşıyor?
4. Veritabanında gerçek plan ve I/O nedir?
5. Connection pool ne kadar bekliyor?
6. Persistence context ne kadar büyüyor?
7. Mapping ve allocation maliyeti nedir?
8. Transaction gereğinden uzun mu?
9. Değişiklik doğruluk semantiğini koruyor mu?
10. Aynı üretim benzeri yükte sonuç tekrarlandı mı?
Bu yaklaşım ORM kullanımını ortadan kaldırmaya çalışmaz. ORM ile fiziksel veri erişimi arasındaki ilişkinin görünür kalmasını sağlar.
Soyutlama üretkenlik sağlar; performans mühendisliği ise soyutlamanın altında yapılan gerçek işi tekrar ölçülebilir hale getirir.
Ünite 4: SQL, Yürütme Planları, İndeksler ve Depolama
20. SQL hazırlama ve plan yeniden kullanımı
SQL'in parse, bind, planlama ve yürütme adımları ürünler arasında aynı isim ve önbellek semantiğine sahip değildir. Bu nedenle "hard parse" veya "plan önbellek parçalanması" gibi Oracle terimleri genel veritabanı davranışı gibi kullanılmamalıdır.
Bind parametreleri
WHERE user_id = ?parametreyi SQL metninden ayırır, SQL enjeksiyonuna karşı temel savunmadır ve tekrar kullanım için kararlı bir deyim biçimi üretir. Ancak bunun planlama etkisi veritabanı ve JDBC sürücüsüne bağlıdır.
Oracle: imleç reuse ve hard parse
Oracle'da paylaşılan SQL alanı/imleç reuse, parse maliyetinin önemli parçasıdır. Literalleri metne gömmek aynı mantıksal sorgunun çok sayıda farklı SQL metnine dönüşmesine, daha fazla parse/imleç çalışmasına ve shared pool baskısına yol açabilir. Kısa OLTP sorgularında hard parse maliyeti yürütme süresine yaklaşabilir.
Bind kullanımı yine de "tek plan her değer için doğrudur" anlamına gelmez. Veri dağılımı çarpıksa bind peeking, histogramlar, adaptive imleç sharing ve gerçek cardinality davranışı hedef Oracle sürümünde incelenir.
PostgreSQL: prepared deyim, custom ve generic plan
PostgreSQL'de Oracle'daki gibi oturumlar arası ortak bir execution-plan önbellek varsayılmamalıdır. PREPARE ile oluşturulan prepared deyim oturum kapsamındadır. plan_cache_mode=auto altında parametreli prepared deyimin ilk beş yürütmesi custom plan ile yapılır; daha sonra generic plan maliyeti ortalama custom-plan maliyetiyle karşılaştırılarak yeniden planlamaya değip değmediğine karar verilir. Gerekirse force_custom_plan veya force_generic_plan ile tanı amaçlı sınanabilir (PostgreSQL 18, PREPARE).
Bu nedenle PostgreSQL'de sorun "global plan önbellek parçalandı" diye değil; parse/plan maliyeti, deyim ömrü, custom/generic plan seçimi ve bağlantı/oturum ömrü üzerinden tanımlanır.
JDBC sürücüsü düzeyi
Uygulamanın PreparedStatement kullanması ile veritabanının aynı server-side deyim/planı yeniden kullanması aynı şey değildir.
Oracle JDBC implicit deyim önbellek, prepared/callable deyim nesnelerini fiziksel bağlantı başına yeniden kullanabilir. Havuzdaki her fiziksel bağlantının kendi deyim önbelleği olduğundan, connection-pool boyutu ve deyim çeşitliliği önbellek verimini etkiler.
pgJDBC varsayılan olarak aynı PreparedStatement için prepareThreshold=5 sonrasında named server-side prepared deyime geçebilir. Sürücü ayrıca bağlantı başına varsayılan olarak 256 sorguluk ve 5 MiB sınırında prepared-deyim önbellek tutar. Bu sayılar tuning hedefi değil, sürüm varsayımlarıdır; hedef pgJDBC sürümünde doğrulanır.
uygulama PreparedStatement
-> JDBC statement cache / prepare threshold
-> fiziksel bağlantı ömrü
-> veritabanı prepared/cursor semantiği
zincirinin tamamı gözlenmeden yalnız ORM veya yalnız DB ayarıyla sonuç çıkarılmaz.
Veri dağılımı
Aynı plan her bind değeri için en iyi olmayabilir. Çok çarpık dağılımlı sütunda bir değer tek satır, başka bir değer tablonun yarısını döndürebilir.
Plan sorunu görülmeden "bind kötü" denmez. Gerçek ve tahmini satır sayıları, istatistikler ve hedef veritabanının bind-sensitive/custom-generic plan mekanizması incelenir.
IN listeleri
Değişken uzunluklu IN listeleri farklı deyim biçimleri oluşturabilir. ORM parameter dolgulama bazı iş yüklerinde biçim sayısını azaltabilir; her sorguda açılacak evrensel hız anahtarı değildir. Büyük listede geçici tablo, array/table parameter veya set tabanlı alternatif desteği ürüne göre değerlendirilir.
Transaction pooler ve hazırlanmış ifadeler
PostgreSQL önünde PgBouncer gibi bir pooler kullanılıyorsa uygulama bağlantısı ile sunucu oturumu aynı kavram olmaktan çıkar. Session pooling sunucu bağlantısını istemci oturumu boyunca tutar. Transaction pooling her transaction sonunda sunucu bağlantısını havuza geri verir; deyim pooling ise çok ifadeli transaction'ı bile engeller.
Güncel PgBouncer sürümleri protokol düzeyindeki named prepared deyimleri max_prepared_statements ile transaction/deyim pooling altında takip edebilir; buna rağmen SET/RESET, session advisory kilit, belirli temporary table davranışları ve SQL PREPARE gibi session semantiği ayrıca incelenir.
Buradaki Zen kuralı basittir: oturuma ihtiyacınız yoksa oturum durumu üretmeyin. Uygulama her istekte bilinmeyen bir önceki oturum durumuna güveniyorsa havuzlama katmanı deterministik değildir.
21. Yürütme planı
Plan, sorgunun nasıl çalışacağını gösteren ağaçtır. İlk bakılacak yer "indeks kullandı mı" değil:
tahmini satır
gerçek satır
farkıdır.
Optimizer 100 satır bekleyip 10 milyon satır görürse join türü, erişim yolu ve bellek tahsisi yanlış olabilir.
Erişim yolları
Tam tarama: Küçük tablo veya çok satır dönen sorguda doğru olabilir.
İndeks taraması: Seçicilik yüksekse az sayfa okur; çok kayıt döndürürse tablodaki rastgele erişim pahalılaşır.
Yalnız indeks: Gereken sütunların tamamı indekste ise tabloya dönüş ortadan kalkar.
Join algoritmaları
Nested loop: Dış küme küçük, iç tarafta uygun indeks varsa güçlüdür.
Hash join: Büyük eşitlik birleşimlerinde etkilidir; hash tablosu belleğe sığmazsa diske taşar.
Merge join: Girdiler sıralıysa ucuzdur; sıralama gerekiyorsa maliyet önce ödenir.
Plan okurken yalnız toplam süre değil blok okuma, spill, tekrar sayısı ve gerçek satır akışı incelenir.
EXPLAIN ile gerçek yürütmeyi ayırmak
EXPLAIN optimizer tahminini, EXPLAIN ANALYZE ise sorguyu gerçekten çalıştırarak gözlenen süre ve satır akışını verir. Üretimde yan etkili DML için bu ayrım kritiktir; "plan bakıyorum" diye veri değiştiren komutu çalıştırmak kabul edilemez.
PostgreSQL'de BUFFERS gibi seçenekler önbellek isabeti, okuma ve yazma davranışını görünür kılar. Oracle tarafında gerçek yürütme istatistikleri ve satır sayıları benzer amacı taşır. Ürün farklı, soru aynıdır:
optimizer ne bekledi?
gerçekte ne oldu?
kaç blok/sayfa taşındı?
spill oldu mu?
aynı düğüm kaç kez çalıştı?
Plan maliyet sayıları veritabanları arasında karşılaştırılacak milisaniye değildir. Aynı optimizer içindeki alternatifleri sıralayan göreli modeldir.
22. İndeksleme
İndeksleme çalışmalarından çıkan temel ders şudur: indeks, yalnız performans eklentisi değil veri erişim niyetinin fiziksel ifadesidir; primary ve unique kısıtlar ise önce doğruluğu korur.
Primary ve unique
Primary key satırın tekil kimliğidir. Unique kısıt, "aynı iş anahtarı iki kez oluşamaz" kuralını eşzamanlı isteklerde de korur.
Uygulamada:
önce SELECT var mı?
sonra INSERT
yaklaşımı yarış koşuluna açıktır. Benzersiz kısıt aynı kuralı atomik olarak veritabanında uygular.
B-tree
B-tree:
- eşitlik,
- aralık,
- sıralama,
- önek
erişiminde genel amaçlı varsayılan yapıdır.
Arama maliyeti teorik olarak logaritmik olsa da gerçek süre dallanma faktörü, önbellek, satır erişimi ve seçicilikten etkilenir.
Bileşik indeks
(a, b, c)B-tree için soldan önek ilkesi hâlâ temel tasarım heuristic'idir: öndeki eşitlik sütunları ve ilk eşitsizlik sütunu taranan indeks aralığını en doğrudan biçimde sınırlar.
Genel sıra:
eşitlik sütunları
-> aralık sütunu
-> sıralama / kapsama sütunları
şeklinde düşünülür; ancak bu mutlak "öndeki sütun yoksa indeks kullanılamaz" kuralı değildir. PostgreSQL 18, uygun kardinalitede eksik öncül sütunlar için B-tree skip scan uygulayabilir ve sonraki sütun koşullarından yararlanabilir. Skip scan her dağılımda seçilmez; çok fazla farklı öncül değer varsa tam/başka tarama daha ucuz olabilir. Gerçek planla doğrulanır (PostgreSQL 18, §11.3).
Kapsayıcı indeks
Sorgunun gereken bütün alanlarını indeks taşıyorsa tabloya geri dönme gerekmeyebilir. Okuma azalır; indeks büyür ve yazma pahalılaşır.
Kısmi / filtreli indeks
Yalnız sıcak alt kümeyi indekslemek:
WHERE active = truegibi sorgularda indeks boyutunu dramatik azaltabilir. Veritabanı desteği ve sözdizimi ürüne bağlıdır.
İfade indeksi
WHERE LOWER(code) = ?koşulunda normal code indeksi her veritabanında kullanılamayabilir; sorgudaki ifadeye uygun function-based/expression index gerekebilir.
Yabancı anahtar
Yabancı anahtar sütunları sık join ve üst satır silme/güncelleme davranışında önemlidir. İndeks eksikliği bazı veritabanlarında geniş tarama ve kilit etkisi üretir.
İndeks maliyeti
Her indeks:
INSERT
UPDATE(indexed column)
DELETE
sırasında bakım ister; WAL/redo hacmini, depolama alanını ve önbellek tüketimini artırır.
Bu yüzden:
indeks yokkadar:
her sütunda indeksde hatalıdır.
Kullanılmayan ve birbirini kapsayan indeksler düzenli ölçülür.
Tam tarama her zaman hata değildir
Düşük seçicilikli sorguda tablonun büyük bölümü zaten okunacaksa indeks:
indeks oku
-> rowid/tuple konumu bul
-> tabloya rastgele git
maliyeti yüzünden tam taramadan yavaş olabilir.
Doğru soru "indeks neden kullanılmadı" değil "bu sorgu için en az iş hangi erişim yolunda"dır.
Hash, GIN ve BRIN
B-tree genel varsayılandır, tek indeks türü değildir.
Hash indeks eşitlik erişimine özeldir. Aralık ve sıralama sağlamaz; B-tree'nin zaten iyi olduğu sıradan eşitlik sorgularında otomatik üstün kabul edilmez.
GIN ters indeks mantığıyla bir satır içinde çok sayıda anahtarın bulunduğu yapılarda güçlüdür. PostgreSQL'de array, tam metin ve uygun jsonb operatörleri bunun tipik örnekleridir. Okumayı hızlandırırken güncelleme ve indeks bakım maliyeti büyüyebilir.
BRIN her satırı ayrı indekslemek yerine fiziksel blok aralıkları için özet tutar. Çok büyük ve fiziksel sıralamayla güçlü korelasyonu olan zaman/artan kimlik verisinde çok küçük indeksle geniş aralıkları eleyebilir. Veri korelasyonu kötüyse kazanç azalır.
İndeks türü veri tipinden değil operatörden ve erişim deseninden seçilir.
PostgreSQL'te bellek ve bakım
PostgreSQL'de shared_buffers, work_mem ve effective_cache_size aynı bellek değildir. shared_buffers için dokümantasyondaki yüzde 25 değeri yalnız dedicated sunucuda başlangıç noktasıdır; performans formülü değildir. work_mem ise bağlantı başına tek sabit alan gibi düşünülmemelidir. Bir sorgu birden çok sort/hash operasyonu, bir sistem birçok eşzamanlı sorgu ve parallel çalışan çalıştırabilir; toplam bellek ayarın katlarına çıkabilir.
Autovacuum yalnız "silinen satırı temizleme" işi değildir. MVCC dead tuple geri kazanımı, planner istatistiği ve visibility map bakımı üzerinden index-only scan davranışına kadar okuma performansını etkiler. Autovacuum'u performans için kapatmak kısa başarım ölçümünü güzelleştirip uzun vadeli sistemi bozabilir.
pg_stat_statements, en pahalı tek sorguyu değil toplam sistem yükünü oluşturan SQL ailelerini görmek için kullanılır. Çağrı sayısı, toplam süre, ortalama süre ve plan/IO verileri birlikte okunur.
Read replica, @Transactional(readOnly=true) benzeri uygulama sinyaliyle yönlendirilebilir; ancak replica lag ve read-your-writes semantiği ayrıca çözülmeden yalnız routing performans optimizasyonu değildir.
23. SSD, disk ve yazma büyütmesi
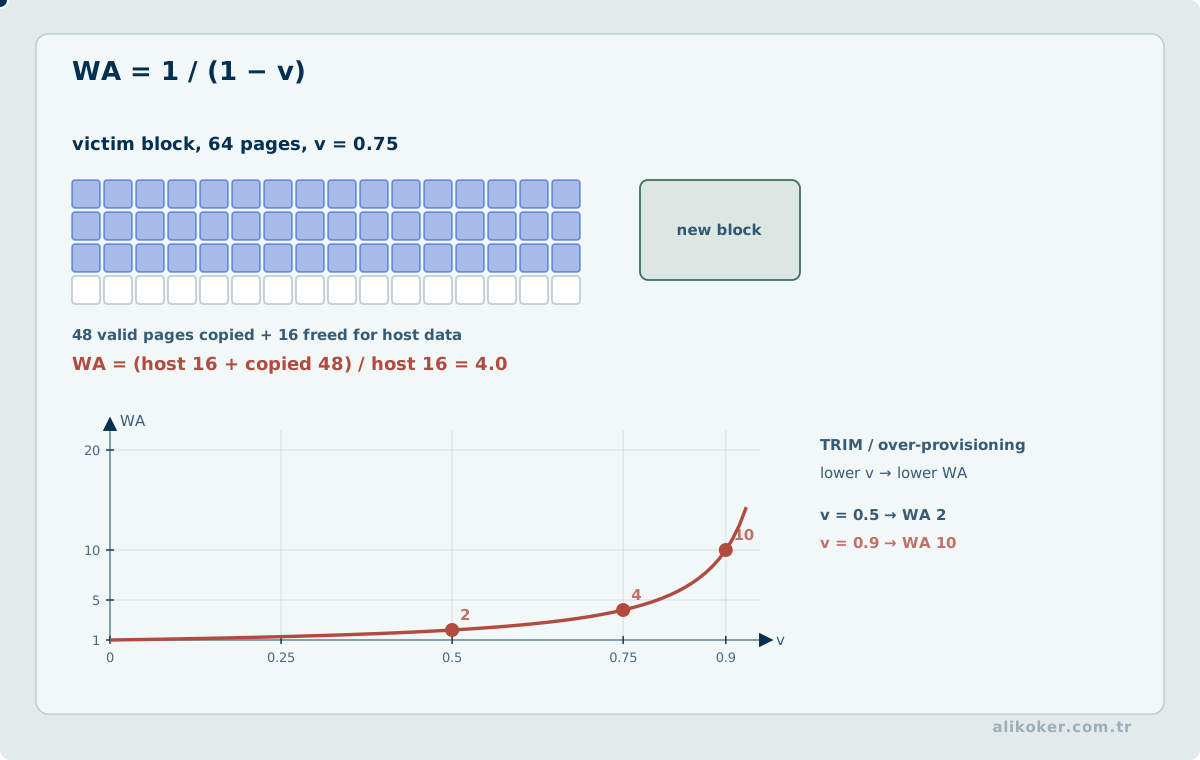
İndekssiz sorgunun temel maliyeti gereksiz okuma, CPU, tampon ve eşzamanlı kaynak tüketimidir. SSD ömrünü esas belirleyen mekanizma ise okuma sayısından çok yazılan veri miktarı ve yazma büyütmesidir.
Yazma büyütmesi:
fiziksel yazılan bayt
---------------------
mantıksal uygulama yazısı
oranıdır.
B-tree yazısı WAL ve veri sayfasına, LSM yazısı WAL, memtable flush ve compaction aşamalarına gidebilir. Her iki yapı da bir mantıksal yazıyı birden çok fiziksel yazıya dönüştürür.
Random write flash garbage collection yükünü artırabilir; sıralı yazı depolamanın iç yerelliğinden daha iyi yararlanır.
Performans testi kısa tutulursa LSM yapıda compaction henüz başlamadan ölçüm bitebilir ve gerçek sürdürülebilir yazma hızı olduğundan yüksek görünür. Yük testi kararlı duruma kadar sürmelidir.
24. B-tree ve LSM
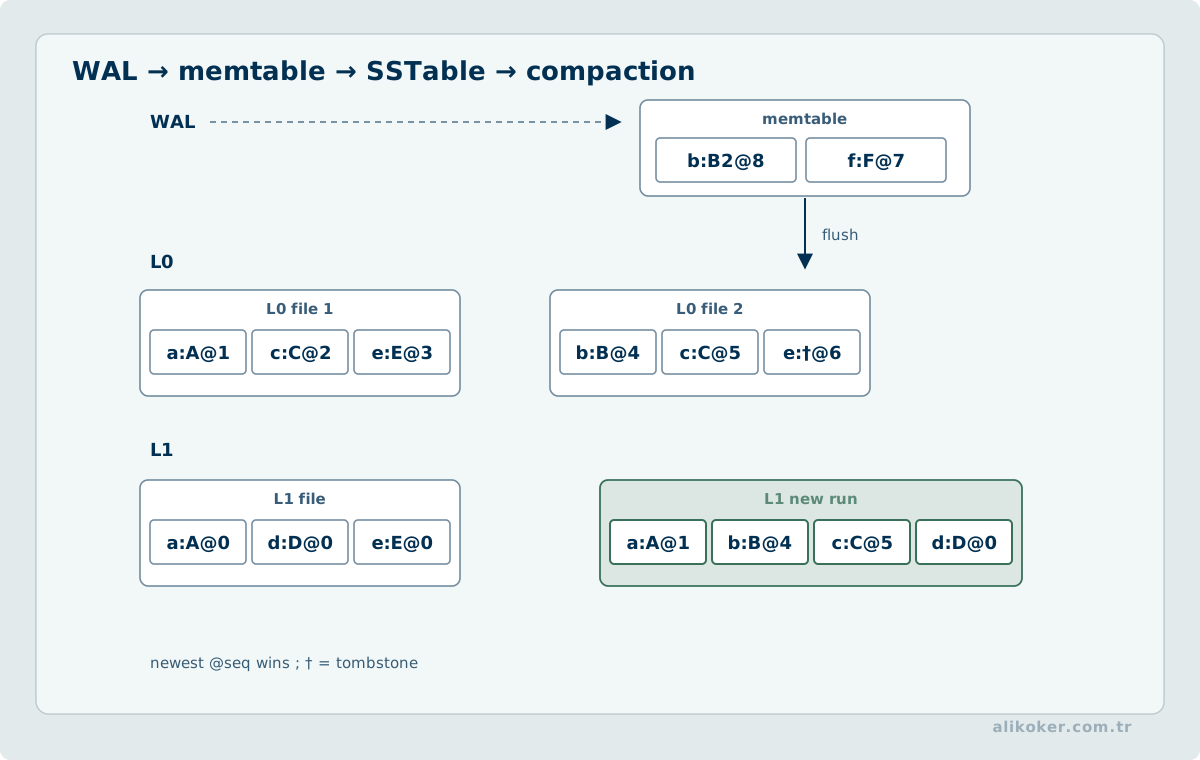
B-tree sayfaları yerinde günceller. Nokta ve aralık okumasında az ve öngörülebilir sayıda sayfa erişimi sağlar.
LSM yaklaşımı:
WAL
-> memtable
-> SSTable
-> compaction
zinciriyle yazıyı sıralı ve ardışık hale getirir. Okuma birden çok SSTable'a bakabilir; Bloom filtreleri olmayan anahtarlar için gereksiz disk erişimini azaltır.
Genel eğilim:
B-tree    okuma gecikmesi / aralık sorgusu avantajı
LSM       yüksek yazma verimi avantajı
şeklindedir; gerçek seçim veri büyüklüğü, anahtar dağılımı, overwrite oranı, compaction stratejisi ve depolamaya göre ölçülür.
Compaction geri planda çalışan "bedava" iş değildir. Yazma hızı compaction kapasitesini geçerse sistem geri basınç uygulamak zorunda kalır.
25. OLTP ve OLAP
Operasyonel sistem veri üretir; analitik sistem büyük veri kümelerini okuyup toplulaştırır.
OLTP                         OLAP
-------------------------    --------------------------
kısa işlem                   uzun tarama / agregasyon
az satır                     çok satır
sık yazma                    çoğunlukla okuma
satır odaklı                 sütun odaklı
indeksli nokta erişimi       tarama, sıkıştırma, vektörleme
düşük gecikme                yüksek toplam verim
Aynı fiziksel sistem iki yükü de taşıyabilir fakat biri diğerinin gecikmesini bozuyorsa iş yükleri ayrılmalıdır.
Satır ve sütun depolama
OLTP'de bir kaydın alanlarını birlikte tutmak tek satır okumayı ucuzlatır. Analitik sorgu yüz sütundan üçünü okuyorsa satır depolama gereksiz 97 sütunu da taşır.
Sütun depolama yalnız gereken sütunları okur, benzer değerleri iyi sıkıştırır ve SIMD/vektörleştirme ile büyük blokları düşük CPU maliyetiyle işler.
Materialized view
Sık tekrarlanan pahalı okuma sonucu önceden hesaplanabilir. Bu, okuma maliyetini yazma/yenileme maliyetine taşır.
Materialized view kaynak gerçek değildir; türetilmiş veridir. Kaynak kaybolmadan yeniden üretilebiliyorsa mimari daha güvenlidir.
OLTP'den analitiğe veri akışı
Analitik sorguları doğrudan işlem veritabanında çalıştırmak yerine:
OLTP
-> CDC / ETL
-> analitik sistem
yaklaşımı işlem yolunu korur.
ClickHouse gibi sütunlu sistemler Oracle veya PostgreSQL'in "yerine geçen" genel OLTP motoru olarak değil, farklı iş yükü için ayrı araç olarak düşünülür.
Ünite 5: Veri Mimarisi, Çoğaltma ve Dağıtık Veri
26. Sistem kaydı ve türetilmiş veri
Sistem kaydı (system of record) bir gerçeğin yetkili kopyasını tutar. Önbellek, arama indeksi, materialized view, veri ambarı ve makine öğrenmesi modeli türetilmiş veridir.
kaynak gerçek
-> dönüşüm
-> türetilmiş görünüm
Türetilmiş veri kaybolduğunda kaynaktan yeniden üretilebiliyorsa hata yönetimi basitleşir.
Bu ayrım önbellek tartışmasını da sadeleştirir: önbellek kaynak gerçek değilse kaybı veri kaybı değildir, yalnız performans kaybıdır.
27. Çoğaltma
Neden çoğaltılır
Çoğaltma üç amaç taşır:
- arızaya dayanım,
- okuma kapasitesi,
- kullanıcıya yakın veri.
Aynı mekanizma üç amacı aynı maliyetle çözmez.
Fiziksel ve mantıksal çoğaltma
Fiziksel çoğaltma WAL/depolama değişikliklerini düşük seviyede taşır. Hızlı ve depolama motoruna yakındır; sürüm uyumluluğunu zorlaştırabilir.
Mantıksal çoğaltma tablo satırı düzeyinde değişiklikleri taşır. Dış sistemlerin okuyabilmesi ve CDC için daha uygundur.
Primary key eksikliği mantıksal değişiklik kaydını da pahalılaştırabilir; güncellenen/silinen satırı tanımlamak için daha çok eski veri taşımak gerekir.
Eşzamanlı ve eşzamansız
Eşzamanlı kopya commit yoluna ek dayanıklılık, gecikme ve arıza bağımlılığı getirir. Eşzamansız kopya yazı yolunu hızlandırır fakat lider kaybında henüz çoğaltılmamış yazılar kaybolabilir.
Doğru seçim RPO ve gecikme hedefinden çıkar.
Kopya gecikmesi
Okumayı replica'ya taşımak birincil düğümü rahatlatır, fakat veri eski olabilir.
Özellikle:
yaz
hemen oku
akışında kendi yazdığını görememe kullanıcı hatası gibi görünür.
Yöntemler:
- yazı sonrası belirli süre primary'den oku,
- kullanıcının son yazı konumunu izleyip replica yetişene kadar primary kullan,
- güçlü tutarlılık gereken uç noktayı replica'ya yönlendirme.
Replica lag bir sayı olarak izlenmelidir; "eventual" gözlenemeyen bir garanti olmamalıdır.
28. CDC
Change Data Capture, değişikliği sorguyla tekrar tekrar aramak yerine veritabanı günlük akışından alır.
transaction DB
-> değişiklik günlüğü
-> CDC
-> kuyruk / arama / analitik / cache
Bu yaklaşım:
- OLTP'yi rapor sorgularından ayırır,
- yakın gerçek zamanlı veri akışı sağlar,
- türetilmiş sistemleri kaynak DB'den bağımsızlaştırır.
Oracle GoldenGate ve Debezium farklı işletim, lisans ve entegrasyon özelliklerine sahip örneklerdir; seçim "hangisi daha hızlı" sorusundan değil kaynak sistem, kapalı ağ, destek, operasyon ve hata geri kazanımı gereksinimlerinden yapılır.
CDC de tam olarak bir kez yan etki garantisi vermez. Konum, işlem kimliği ve tüketici idempotency'si tasarımın parçasıdır.
29. Bölümleme
Bölümleme tek büyük tabloyu fiziksel parçalara ayırır. Zaman eksenli veride:
2026-07
2026-08
2026-09
gibi bölümler sorgu budamasını ve eski veriyi hızlı düşürmeyi sağlar.
Eski milyarlarca satırı DELETE etmek yerine bölüm düşürmek:
- undo/redo üretimini,
- satır kilidini,
- indeks bakımını
büyük ölçüde azaltabilir.
Bölüm anahtarı sorgu koşulunda yoksa bütün bölümler taranır ve mimari kazanç kaybolur.
Yerel ve global indeks
Yerel indeks bölümle birlikte yönetilir; bölüm bakımında daha bağımsızdır. Global indeks bütün tabloyu tek erişim yapısında görür ve bölüm sınırı dışındaki sorguları kolaylaştırabilir; bölüm bakımı daha pahalı ve karmaşık hale gelir.
"Her zaman local" veya "her zaman global" kuralı yoktur; erişim yolu ve bakım şekli belirler.
30. Sharding
Bölümleme bir veritabanı içinde yapılabilir; sharding veriyi birden çok düğüm arasında dağıtır.
Aralık ve hash
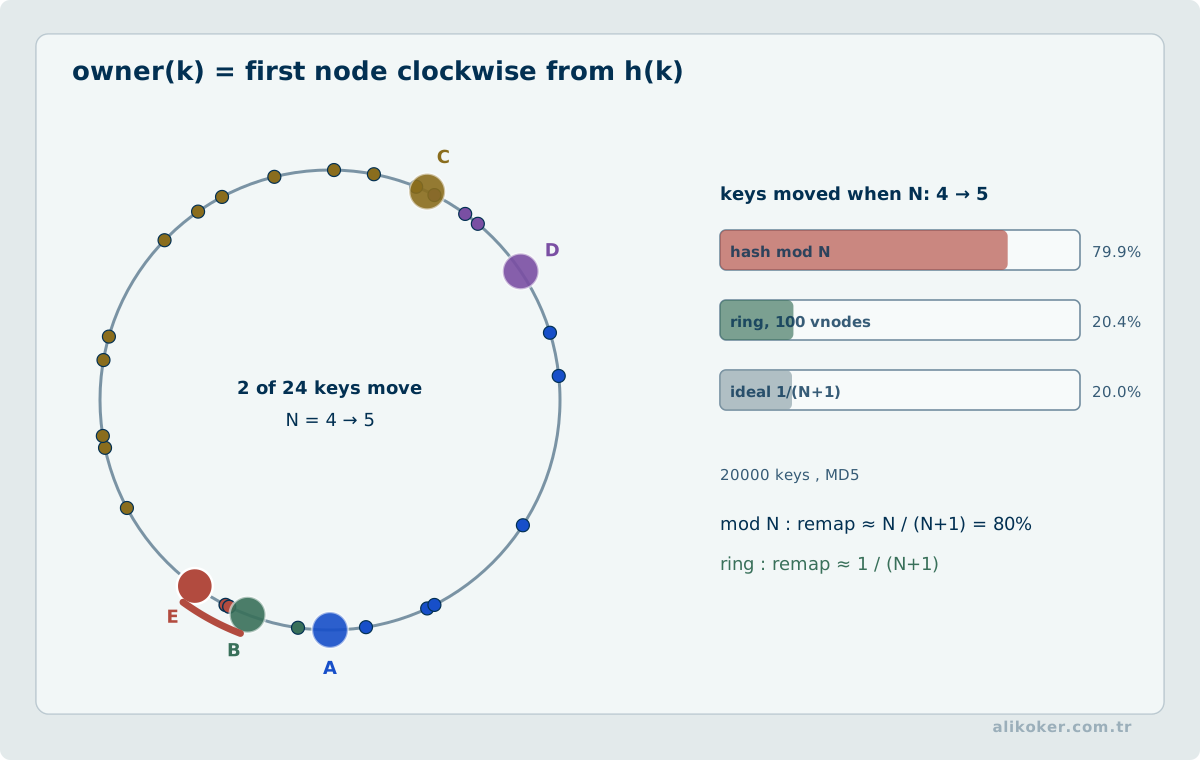
Aralık bölme range sorgularını korur fakat artan anahtar tek sıcak shard oluşturabilir.
Hash dağıtımı yükü daha dengeli yayar fakat anahtar aralığı sorgusunu bütün shard'lara saçabilir.
Birleşik anahtar:
partition key + sort keyile aynı partition içindeki aralık sorguları korunabilir.
Sıcak anahtar
Tutarlı hashing anahtarları eşit dağıtsa bile istekleri eşit dağıtmaz. Çok popüler tek kullanıcı veya kayıt, kendi shard'ını doyurabilir.
Çözüm veri dağıtımından önce yük dağılımını ölçmektir. Gerekirse sıcak anahtar alt parçalara ayrılır, okuma önbelleğe alınır veya yazılar birleştirilir.
İkincil indeks
Yerel ikincil indeks yazıda tek shard'ı etkiler fakat arama tüm shard'lara yayılabilir. Global ikincil indeks aramayı daraltır fakat yazı birden çok shard'da indeks güncellemesi gerektirir.
Yine aynı değiş tokuş vardır:
ucuz write -> pahalı read
pahalı write -> ucuz read
Dağıtık işlem
Bir iş iki shard'a yazıyorsa tek düğümlü transaction varsayımı biter. Dağıtık transaction, saga veya iş kuralını aynı shard'a yerleştirecek model seçimi değerlendirilir.
En ucuz dağıtık transaction, hiç dağıtılmayan transaction'dır.
31. Veri modeli ve erişim yolu
Normalizasyon yinelenen gerçeği tek yerde tutarak yazma tutarlılığını kolaylaştırır. Denormalizasyon join maliyetini azaltır fakat aynı gerçeğin birden çok kopyasını senkron tutma sorumluluğu getirir.
Karar:
kaynak gerçek normalize
okuma görünümü gerekirse türet
yaklaşımıyla sadeleşir.
Denormalize alan güncellenecekse güncelleme mekanizması açık olmalıdır: aynı transaction, CDC, olay işleme veya yeniden hesaplama.
"Performans için denormalize ettik" tek başına yeterli tasarım gerekçesi değildir; hangi okumanın kaç kat ucuzladığı ve tutarlılığın nasıl korunduğu ölçülmelidir.
32. Event sourcing ve CQRS
Olay kaynaklı modelde değişiklik önce değişmez bir olay olarak saklanır, okuma görünümleri bu olaylardan türetilir:
komut
-> doğrulama
-> olay
-> materialized view'lar
Avantajları:
- olayın nedenini açıkça taşır,
- denetim izi sağlar,
- farklı okuma modelleri yeniden üretilebilir,
- yeni görünüm geçmiş olaylardan kurulabilir.
Bedelleri:
- olay sırası ve şema evrimi,
- yeniden oynatmada deterministik davranış,
- dış yan etkilerin tekrar edilmemesi,
- kişisel verinin silinmesi,
- operasyonel karmaşıklık.
Bu nedenle CQRS veya event sourcing sıradan CRUD uygulamasının varsayılanı değildir. Audit, yeniden oynatma ve çok farklı okuma modelleri gerçek gereksinimse kullanılır.
Yeniden oynatılan olay dış döviz kuru, güncel saat veya değişken uzak servis sonucuna bağlıysa aynı olay farklı sonuç üretir. Gerekli dış veri olayın içinde veya tarihsel olarak tekrar sorgulanabilir biçimde saklanmalıdır.
33. Şema evrimi
Üretimde eski ve yeni uygulama sürümleri aynı anda çalışabilir. Şema değişikliği tek deploy anı değil geçiş dönemidir.
Güvenli değişim:
1. yeni alanı ekle
2. eski kod çalışmaya devam etsin
3. yeni kod iki biçimi de okusun
4. veri gerekiyorsa arka planda doldur
5. tüm okuyucular geçince eski alanı bırak
6. son olarak eski yapıyı kaldır
Bu expand-contract yaklaşımı kesintisiz değişimin temelidir.
API ve mesaj şemalarında da aynı kural geçerlidir: yeni okuyucu eski veriyi, eski okuyucu yeni veriyi mümkün olduğunca anlayabilmelidir.
Şema tabanlı ikili biçimler alan numarası ve varsayılan değerler üzerinden ileri/geri uyumluluk sağlayabilir; ancak uyumluluk kuralı yalnız biçim değil semantik için de korunmalıdır. "Alan artık metre değil santimetre" gibi anlam değişikliği tür aynı kaldığı halde uyumsuzdur.
Ünite 6: Önbellek, Mesajlaşma, JVM, Ağ ve Şema Sahipliği
34. Önbellek
Önce kaynağı düzelt
Önbellek kötü sorgunun yerine geçmez. İndeks eksikliği önbellek ile gizlenirse:
cache miss
restart
toplu expiry
anında aynı sorun geri gelir.
Katmanlar
- persistence context: transaction içi kimlik haritası,
- ORM ikinci düzey önbelleği: oturumlar arası varlık,
- uygulama önbelleği: iş sonucu,
- uzak paylaşımlı önbellek: örnekler arası veri,
- HTTP/CDN önbelleği: istemciye yakın sonuç.
Her katmanın geçersizleştirme sınırı farklıdır.
İkinci düzey ORM önbellek
Sık okunan, seyrek değişen referans verisinde değerlidir. Yoğun yazılan işlem tablosunda geçersizleştirme ve koordinasyon maliyeti kazancı yok edebilir.
Native SQL, trigger veya başka uygulama aynı tabloyu değiştiriyorsa ORM önbellek bu değişikliği otomatik bilmeyebilir.
Query önbellek
Sorgu sonucu yerine çoğu ORM kimlik listesini saklar. Varlık önbellek ile birlikte düşünülmezse isabet durumunda bile ek yüklemeler üretebilir.
Yazma yoğun tabloda her değişiklik sorgu önbellek girdilerini geçersiz kılıyorsa hit ratio tek başına anlamsızdır.
Stampede
Popüler anahtar aynı anda expire olursa yüzlerce istek kaynağa koşar.
Çözümler:
- single-flight,
- TTL jitter,
- stale-while-revalidate,
- önden yenileme,
- gerektiğinde giriş hızı sınırı.
Negatif önbellek
"Bulunamadı" sonucu pahalıysa kısa süre önbelleklenebilir. Süre uzun tutulursa yeni oluşturulan veri görünmez; negatif önbelleğin TTL'i iş semantiğine göre kısa seçilir.
Caffeine: kabul politikası ve yenileme
Yerel önbellek boyutu yalnız kayıt sayısıyla belirlenmez. Değerlerin maliyeti çok farklıysa ağırlıklandırma gerekir. Caffeine'in Window TinyLFU politikası recency ile frequency bilgisini birleştirerek tarama gibi LRU'yu kirleten iş yüklerinde daha iyi kabul/çıkarma kararı vermeyi amaçlar.
expireAfterWrite ile refreshAfterWrite aynı davranış değildir. Expire edilen kayıtta yeni istek yeniden yüklemeyi bekleyebilir. Refresh'e uygun kayıt ise ilk stale erişimde asenkron yenilenirken eski değer dönmeye devam edebilir. Bu, P99'u korumak için yararlıdır; fakat eski verinin ne kadar kabul edilebilir olduğu iş kuralıdır.
Önbellek metriklerinde yalnız hit ratio yetmez:
hit rate
miss sayısı
miss yükleme maliyeti
load failure
load P99
eviction sayısı / ağırlığı
cache boyutu
birlikte izlenir. Yüzde 99 hit rate, kalan yüzde 1 miss bütün veritabanını doyuruyorsa iyi değildir.
Redis: pipelining atomiklik değildir
Redis pipelining birden çok komutu cevap beklemeden göndererek RTT ve socket syscall maliyetini azaltır. Binlerce komutu tek dev işlem hattına koymak ise sunucuda cevapların kuyruklanacağı belleği büyütür; sınırlı batch'ler kullanılır.
Pipelining, MULTI/EXEC ile aynı şey değildir. Işlem hattı ağ optimizasyonudur; transaction komut grubunun yürütme semantiğini değiştirir. Atomiklik gereksinimi yokken transaction kullanmak, yalnız round-trip azaltmak için doğru araç değildir.
İki katmanlı önbellek:
L1 Caffeine
-> L2 Redis
-> DB
okuma gecikmesini azaltabilir fakat geçersizleştirme artık üç katmanlıdır. L1'in çok uzun yaşaması Redis güncelliğini anlamsızlaştırır. Sürüm numarası, olay tabanlı invalidation veya kısa TTL gibi politika açık tanımlanmalıdır.
35. Mesaj kuyrukları
Kuyruk yükü yok etmez, zaman içinde yeniden dağıtır.
Üretici batch boyutu ve bekleme süresi arasında seçim yapar:
büyük batch -> daha yüksek verim, daha fazla gecikme potansiyeli
küçük batch -> daha düşük bekleme, daha fazla protokol maliyeti
Bölüm sayısı tüketici paralelliğini artırır fakat sıra garantisi bölüm içindedir.
Tüketici gecikmesi (lag) yalnız kuyruk metriği değildir. Kesinti sonrası biriken milyonlarca mesaj hızla tüketilirse arka uç veritabanı normal trafiğin katlarıyla vurulabilir.
Geri kazanım:
kademeli tüketim
hız sınırı
arka uç doygunluğuna göre backpressure
ile yapılır.
İşleme en az bir kez gerçekleşebiliyorsa tüketici aynı mesajı tekrar güvenle işleyebilmelidir.
Kafka üretici yolu
Kafka üretici aynı partition'a giden kayıtları batch'leyerek protokol maliyetini azaltır. batch.size üst sınırı, linger.ms ise batch dolmadan önce beklenebilecek süreyi etkiler. Kafka 4.0 ile linger.ms varsayılanı 0'dan 5 ms'ye değişmiştir.
Bu değişiklik koşulsuz bir "5 ms daha hızlıdır" kuralı değildir. Yüksek varış hızında batch zaten kısa sürede dolduğundan daha iyi batching ağ/protokol maliyetini azaltıp benzer veya daha düşük efektif üretici gecikme üretebilir. Düşük yükte kayıtlar arası süre linger.ms'den uzunsa batch dolmaz ve bekleme çoğunlukla yalnız ek gecikme olur. Sonuç üretici başına varış hızı, partition dağılımı, batch doluluk oranı ve broker geri basınç ile birlikte ölçülür (Apache Kafka 4.0 üretici configuration).
Sıkıştırma da aynı değiş tokuştur:
daha az ağ ve broker I/O
karşılığında
producer/broker/consumer CPU
acks=all ve idempotent üretici dayanıklılık ve üretici yeniden denemelerden doğan duplicate kontrolünü güçlendirir. Bu, dış veritabanı veya HTTP yan etkisini transaction'a katmaz.
Partition sayısı paralellik kadar sıra sınırıdır. Aynı iş anahtarının sırası önemliyse partition key bunu korumalıdır. Daha çok partition broker üstveri, açık dosya, rebalance ve operasyon maliyeti de getirir.
Kafka transaction ve exactly-once sınırı
transactional.id ayarlandığında Kafka üretici transaction API'lerini kullanabilir ve idempotence de etkinleşir. Bir read-process-write akışında tüketilen offset'ler ile üretilen kayıtlar aynı Kafka transaction'ına dahil edilirse, tüketiciler isolation.level=read_committed ile yalnız commit edilmiş transactional kayıtları gördüğünde Kafka sınırı içinde exactly-once processing semantiği kurulabilir. Kafka Streams'in EOS modu da bu sınır üzerinde çalışır.
Bu garanti gerçektir fakat sınırı önemlidir:
Kafka offset + Kafka output records
aynı Kafka transaction'ı -> atomik olabilir

Kafka + Oracle/PostgreSQL + HTTP + dosya
tek Kafka transaction'ı -> atomik değildir
Dış yan etkiler için transactional outbox, idempotency key, yinelenen kayıtları tekilleştirme veya başka bir açık atomiklik protokolü gerekir (Apache Kafka 4.0 KafkaProducer/KafkaConsumer).
Kafka tüketici yolu
Tüketicide önemli soru "kaç iş parçacığı" değil bir poll ile alınan işin deadline içinde bitip bitmediğidir. max.poll.records, fetch boyutları ve max.poll.interval.ms birlikte değerlendirilir. Çok kayıt almak fetch verimini artırırken işleme süresi poll aralığını aşarsa group rebalance oluşabilir.
Offset commit, işin gerçekten tamamlandığı noktayla uyumlu olmalıdır. Mesaj işlenmeden offset kalıcılaşırsa kayıp; işlendikten sonra crash olup offset yazılamazsa tekrar doğar. Bu nedenle en az bir kez teslimde idempotent tüketici temel tasarımdır.
Tüketici lag için tek eşik yeterli değildir. Şunlar birlikte izlenir:
lag records
lag time
tüketim rate
üretim rate
rebalance
processing P99
arka uç saturation
Kesinti sonrası replay, normal trafikten daha tehlikeli olabilir. Tüketicinin teorik maksimum hızına çıkmak yerine veritabanı, uzak servis veya dosya sisteminin güvenli geri kazanım kapasitesine göre hız sınırı uygulanır.
36. Geri basınç ve aşırı yük
Sağlıklı sistem kapasite sınırını gizlemez.
Aşırı yükte tercih sırası:
sınırsız kuyruk
değil

sınırlı kuyruk
-> timeout
-> rate limit
-> load shedding
olmalıdır.
Sınırsız kuyruk, "başarılı kabul edilen ama dakikalar sonra işlenen" istekler üretir; bellek taşması veya zaman aşımı zinciri kaçınılmaz hale gelir.
Zaman aşımı bütçesi
Bir üst isteğin 500 ms bütçesi varsa üç alt servise ayrı ayrı 500 ms vermek bütçe değildir.
toplam bütçe
-> bağlantı
-> kuyruk
-> sorgu
-> alt servis
olarak bölünür.
Zaman aşımı, iş tamamlanmadıktan sonra kaynağın da bırakılmasını sağlamalıdır. İstemci vazgeçtiği halde veritabanında sorgu dakikalarca çalışıyorsa yük azalmamıştır.
Yeniden deneme fırtınası
Bir servis yavaşladığında bütün üst katmanlar aynı isteği yeniden denerse gerçek trafik katlanır.
1 kullanıcı isteği
× 3 gateway retry
× 3 servis retry
× 3 DB retry
= 27 girişim
gibi büyüme mümkündür.
Yeniden deneme tek bir katmanda sahiplenilir, geçici hata sınıflandırılır, toplam süre bütçesi korunur ve jitter kullanılır.
Hata yayılımı, izolasyon ve kararlı durum
Aşırı yük yalnız yüksek trafikle başlamaz. Tek bir bağımlılığın yavaşlaması da aynı sonuca ulaşabilir. Çağrı süresi uzadıkça istekler iş parçacığı (thread), connection, transaction veya bellek üzerinde daha uzun kalır; aynı geliş hızında sistemdeki eşzamanlı iş sayısı yükselir.
yavaş bağımlılık
-> kaynak daha uzun tutulur
-> in-flight iş artar
-> kuyruk büyür
-> P99 yükselir
-> timeout başlar
-> retry varsa yeni yük oluşur
Bu nedenle başarısız ile yavaş durumları kapasite mühendisliği açısından ayrı dünyalar değildir. Yavaşlık da kaynak tüketimini büyüterek hata yayılımı oluşturabilir.
Hata alanını küçültmek için bütün işlerin aynı kaynağı sınırsız paylaşması engellenebilir. Kritik ve pahalı iş akışlarının ayrı concurrency budget veya worker bütçeleri kullanması, bir akışın diğerini tüketmesini sınırlar. Buradaki amaç her bileşene ayrı havuz açmak değil, aynı failure mode'un hangi işlevleri birlikte düşürebileceğini bilinçli seçmektir.
Circuit breaker benzeri bir koruma da ancak bu bağlamda anlamlıdır. Amaç hata sayacını artırmak değil, zaten başarısız veya aşırı yavaş bağımlılığa yeni iş yığılmasını durdurup yerel kaynakların serbest kalmasını sağlamaktır. open durumunun ne kadar süreceği, deneme trafiğinin nasıl geri verileceği ve toparlanan bağımlılığın bir anda eski yükle ezilip ezilmeyeceği ayrıca tasarlanmalıdır.
Kararlı durum için test yalnız yük sırasında yapılmaz. Yük kaldırıldıktan sonra da:
queue -> baseline
connection wait -> baseline
heap / native memory -> beklenen çalışma bandı
consumer lag -> 0 veya normal seviye
geçici dosya / log büyümesi -> bounded
olmalıdır. Sistem test bitince normal çalışma bandına dönemiyorsa işlem hacmi (throughput) yüksek olsa bile uzun süreli üretim davranışı kararlı değildir.
Bu bakış performans ile dayanıklılığı ayırmaz: kapasite sınırı, hata izolasyonu ve toparlanma aynı kaynak bütçesinin farklı yüzleridir.
37. Oracle RAC bağlamında erişim tasarımı
RAC aynı veriyi birden çok düğümden erişilebilir kılar; ortak veri blokları üzerindeki koordinasyon maliyetini ortadan kaldırmaz. Tek örnek üzerinde ölçeklenmeyen bir sıcak anahtar veya sağ-uç indeks modeli, RAC'e taşındığında Önbellek Fusion ve global önbellek koordinasyonuyla daha görünür hale gelebilir.
Aşağıdaki kalıplar küme maliyetini büyütebilir:
- aynı sıcak satıra yoğun yazma,
- düşük seçicilikli geniş tarama,
- gereksiz indeks bakımı,
- uzun transaction,
- satır satır işlem,
- düğümler arasında sürekli taşınan sıcak bloklar.
Sequence üretimi
Primary key için sequence kullanılıyorsa ve global istek sırası iş kuralı değilse Oracle RAC belgeleri CACHE + NOORDER yaklaşımını en iyi sequence üretim performansı için önerir. Önbellek büyüklüğü ve boşluk toleransı iş gereksinimidir; ORDER global sıralama gerektiğinde koordinasyon maliyeti getirir. Güncel Oracle sürümlerindeki scalable sequence seçeneği de yoğun eşzamanlı yükte değerlendirilir.
benzersizlik gereksinimi != boşluksuz sıra
benzersizlik gereksinimi != global zaman sırası
Bu ayrım yapılmadan ORDER NOCACHE seçmek gereksiz bir serileşme noktası üretebilir (Oracle RAC Design and Dağıtım Techniques).
Sağ-uç indeks çekişmesi
Monoton artan sequence/timestamp anahtarı klasik B-tree'nin sağ uç leaf bloklarına yoğun insert yöneltebilir. Çok düğümlü yoğun yazmada aynı blokların örnekler arasında taşınması yüksek yüzdelik gecikme ve işlem hacmini bozabilir.
Çözüm tek bir reçete değildir:
- reverse-key index insert'leri leaf bloklara dağıtabilir fakat normal range scan davranışını kaybettirir,
- hash-partitioned global index sıcak sağ ucu bölümlere dağıtabilir fakat partition/range erişim bedeli getirir,
- scalable/cycling key tasarımları anahtar dağılımını değiştirebilir,
- bazı işlerde doğru çözüm sıcak anahtarı veri modelinden kaldırmaktır.
AWR/ASH ve gerçek bekleme olayları görülmeden reverse-key veya hash partitioning uygulanmaz. Amaç "RAC tuning" değil, hangi blok veya enqueue üzerinde serileşildiğini gösterebilmektir (Oracle SQL Tuning Guide; RAC documentation).
RAC'e yeni düğüm eklemek uygulama veri modelindeki serileşme noktasını çözmez. Aynı anahtar üzerinde tekil kilit varsa fiziksel düğüm sayısı artarken iş hâlâ o kilitte sıraya girer.
38. OLTP ve analitik yükü ayırma
Kurumsal sistemde ana işlem veritabanı:
- kısa,
- seçici,
- transaction gerektiren,
- doğruluk hassas
işler için korunmalıdır.
Rapor, geçmiş taraması, model eğitimi, zaman serisi agregasyonu ve büyük dışa aktarma:
- replica,
- veri ambarı,
- sütunlu OLAP,
- dosya/lakehouse
katmanına taşınabilir.
CDC, bu ayrımı sorgu tabanlı kopyalamadan daha doğal yapar. Kaynağı her dakika SELECT WHERE modified_at > ? ile taramak hem indeks hem zaman damgası doğruluğu hem silinen kayıtlar açısından kırılgandır.
39. Arama ve vektör indeksleri
B-tree her sorgunun cevabı değildir.
Tam metin araması ters indeks, coğrafi sorgular çok boyutlu indeks, benzerlik araması vektör indeksi gerektirir.
AI uygulamalarında HNSW ve IVF gibi yaklaşık en yakın komşu yapıları:
gecikme
bellek
indeks oluşturma maliyeti
recall
güncelleme maliyeti
arasında seçim yapar.
Yaklaşık vektör indeksi primary key veya transaction indeksinin yerine geçmez; farklı sorgu problemidir. Operasyonel üstveri ilişkisel, semantik arama vektör indeksli ayrı türetilmiş görünüm olabilir.
Kaynak gerçek ile arama indeksinin ayrılması, indeks bozulduğunda kaynaktan yeniden üretmeyi mümkün kılar.
40. JVM belleği ve GC
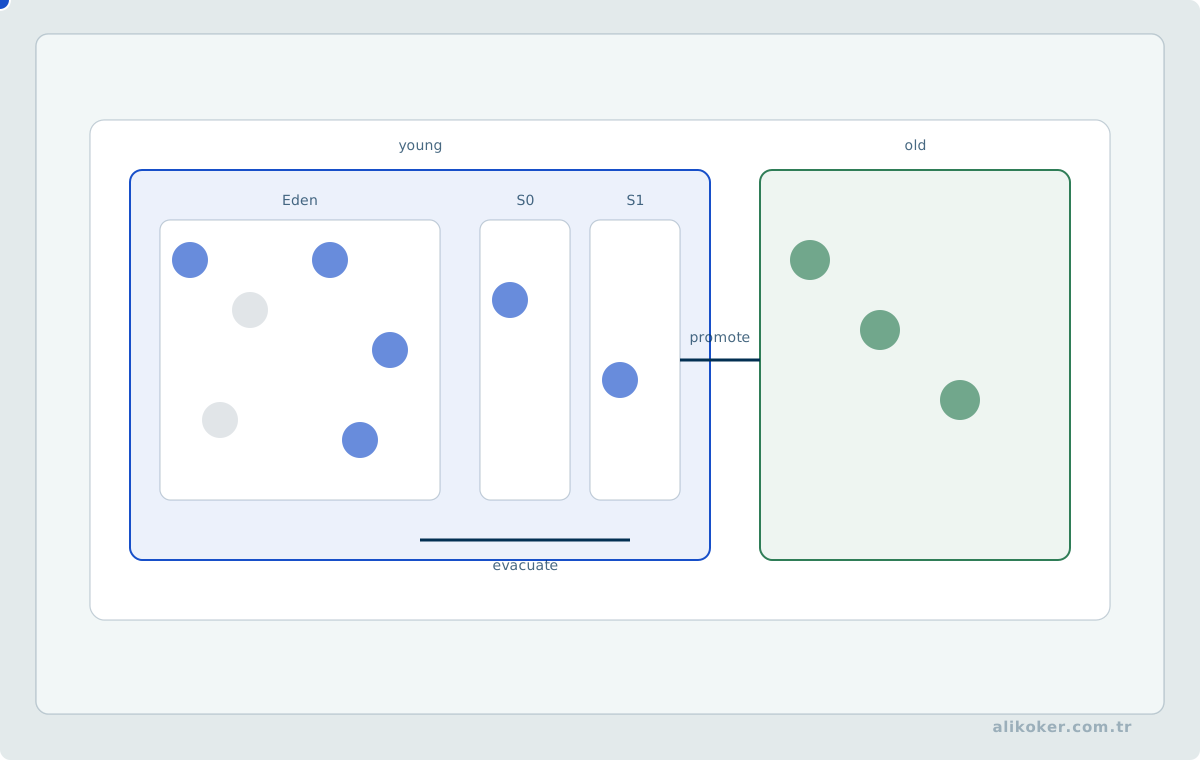
Önce bellek ayırma
Yüksek bellek ayırma:
daha sık GC
daha çok bellek bant genişliği
daha fazla cache baskısı
demektir.
Sıcak yollarda en sık kaynaklar:
- büyük DTO grafikleri,
- gereksiz ara koleksiyon,
- String birleştirme,
- JSON serileştirme,
- boxing,
- sonuç kümesini bütünüyle belleğe alma.
Yığın büyütmek bellek ayırma sorununu çözmez, yalnız bir süre erteler.
G1, ZGC ve Parallel
Toplayıcı seçimi:
verim
gecikme
bellek ayak izi
üçlüsünde yapılır.
G1 genel amaçlı dengeli seçimdir. ZGC düşük duraklama hedefli işlerde anlamlıdır. Parallel GC toplu işte toplam verim önceliği varsa güçlü olabilir.
Sürüm, öbek ve iş yükü doğrulanmadan "en hızlı GC" diye seçim yapılmaz.
G1 ayrıntısı
G1, öbeği region'lara böler ve genç/yaşlı nesneleri aynı bölgesel yapı üzerinde yönetir. Büyük nesneler humongous bellek ayırma olarak özel davranış gösterebilir; region boyutunun yarısını aşan nesneler GC yerleşimini ve boş alan kullanımını bozabilir. Çözüm region flag'ini körlemesine değiştirmek değil hangi bellek ayırmanın bu nesneyi ürettiğini bulmaktır.
Duraklama hedefi garanti değildir. GC, mevcut öbek, bellek ayırma rate ve canlı veri oranı içinde hedefe yaklaşmaya çalışır. Öbek çok sıkıysa collector'ın manevra alanı kalmaz; gereğinden büyükse RSS ve önbellek ayak izi büyür.
JDK 26'daki JEP 522, G1'de uygulama iş parçacıklarıi ile GC'nin card-table optimizasyon işi arasındaki senkronizasyonu azaltarak bazı iş yüklerinde işlem hacmini iyileştirir. Bu, G1 için yeni bir tuning bayrağı aramak gerektiği anlamına gelmez; JDK sürümü yükseltildiğinde aynı workload'un yeniden ölçülmesi gerektiğini gösterir.
ZGC'nin güncel durumu
JDK 23 ile generational ZGC varsayılan moda geçti. JDK 24'te JEP 490 ile non-generational mod kaldırıldı; dolayısıyla güncel JDK'larda eski "non-generational mı generational mı" tuning ayrımı tarihsel bilgidir (OpenJDK JEP 474, JEP 490).
ZGC'nin temel amacı çok düşük pause süreleridir; ağır işi büyük ölçüde eşzamanlı yürütür. Bu bedelsiz değildir: CPU ve bellek headroom gerekir. Batch verimi tek hedefse Parallel GC; genel amaçlı denge gerekiyorsa G1; sıkı pause bütçesi varsa ZGC adaydır. Aday, sonuç değildir; aynı yükte JFR ile doğrulanır.
Yığın dışı bellek ve öbek headroom
Süreç belleği:
heap
+ metaspace
+ thread stacks
+ direct buffers
+ code cache
+ native libraries
+ GC structures
toplamıdır.
Container-aware JVM cgroup sınırını görse de bütün sınırı -Xmx yapmak yanlış muhasebedir. İşletim sistemi ve yan süreçler de aynı bellek bütçesini paylaşabilir.
Doğru soru:
Xmx kaç olsun?değil:
canlı veri ne kadar?
allocation rate ne kadar?
GC çevrimi için ne kadar headroom gerekiyor?
native peak ne kadar?
cgroup OOM sınırına ne kadar kaldı?
sorularıdır.
CPU kotası, cgroup throttling ve JVM ergonomisi
Konteynerde host CPU sayısını görmek gerçek işlem bütçesini tek başına açıklamaz. cgroup CPU quota/period sınırı dolduğunda process hostta boş çekirdek bulunsa bile dönem sonuna kadar throttle edilebilir; bu davranış özellikle P99/P99.9'da periyodik sıçrama gibi görünebilir.
JVM'nin algıladığı etkin işlemci sayısı GC çalışan, JIT derleyici ve bazı ortak havuzların ergonomisini etkiler. -XX:ActiveProcessorCount bu algıyı gerektiğinde override edebilir; ancak yanlış değer daha çok iş parçacığı üreterek throttling'i büyütebilir. İzlenecekler birlikte ele alınır:
container CPU usage
throttled periods / throttled time
run queue
GC/JIT worker davranışı
P99 / P99.9
CPU limiti bir deploy parametresiyse performans testinde de aynı limit kullanılmalıdır.
Isınma, JIT ve deoptimization
JIT derleme nedeniyle kısa başarım ölçümü kararlı durum değildir. Test:
warm-up
-> kararlı yük
-> ölçüm
olarak ayrılır.
Uzun yaşayan HotSpot süreci aynı kodu baştan sona aynı biçimde çalıştırmaz. Yorumlayıcı ve tiered compilation çalışma zamanı profili toplar; sıcak yöntemler daha agresif derlenir, inlining kararı çağrı profilinden etkilenir. JIT varsayımı geçersiz olduğunda deoptimization yapılabilir ve kod yeniden derlenebilir; ani gecikme sıçramaları yalnız GC değildir.
PrintCompilation veya inlining günlükleri özel incelemede yararlıdır; sürekli üretim gözlemi için JFR daha bütünlüklüdür.
CDS, AppCDS ve Leyden AOT önbellek
CDS ve AppCDS geçersizleşmiş değildir; HotSpot'ın güncel AOT önbellek hattının tarihsel ve teknik temelidir. Class Data Sharing önceden hazırlanmış sınıf üstverisini archive/önbellek üzerinden yeniden kullanarak startup ve bellek ayak izi maliyetini azaltır.
Project Leyden bu hattı genişletti:
JDK 24  JEP 483  AOT Class Loading & Linking
JDK 25  JEP 514  AOT Command-Line Ergonomics
JDK 25  JEP 515  AOT Method Profiling
JDK 26  JEP 516  AOT Object Caching with Any GC
JEP 483 sınıfları yüklenmiş ve bağlanmış biçimde AOT önbelleğe taşıdı; JEP 515 önceki koşudan method profillerini startup anında kullanılabilir hale getirerek warm-up yolunu kısalttı; JEP 516 gelişmiş AOT object caching'i ZGC dahil collector'lardan bağımsız hale getirdi. Bu mekanizmalar request kritik yürütme yolunu sihirli biçimde hızlandırmaz; startup/warm-up SLO'su ve bellek ayak izi problemi varsa aynı workload ile ölçülür (OpenJDK JEP 483, 514, 515, 516).
Compact Object Headers
JEP 519, Compact Object Headers özelliğini JDK 25'te deneysel durumdan product özellik (feature) durumuna taşıdı. Amaç nesne başlığı maliyetini düşürerek yoğun nesneli öbeklerde bellek ayak izi, önbellek yerelliği ve dolaylı olarak GC baskısını azaltabilmektir. JEP 519 bunu varsayılan layout yapmayı hedeflememiştir; hedef JDK derlemesinde UseCompactObjectHeaders durumu doğrulanmalıdır.
Bu özellik bellek ayırma sorununu ortadan kaldırmaz. Kazanç nesne boyutu dağılımına bağlıdır; JOL/öbek histogramı, RSS, bellek ayırma rate, GC süresi ve uygulama P99'u aynı testte karşılaştırılır (OpenJDK JEP 519).
Direct buffer, metaspace ve classloader sızıntısı
Öbek sabitken RSS büyüyorsa yalnız -Xmx bakmak yanlıştır. Netty/NIO direct buffer'lar, JNI kütüphaneleri, iş parçacığı stack'leri ve class üstveri native alandadır. Dinamik classloader üreten uygulamada sınıflar unload edilemiyorsa metaspace büyür; kök neden öbek leak değildir.
NMT JVM'nin kendi native kategorilerini ayırır ama üçüncü taraf native bellek ayırmayı tam izlemez. Gerekirse işletim sistemi araçlarıyla RSS eşleme ve native bellek ayırıcı profili birleştirilir.
NUMA ve büyük sayfalar
Çok soketli ve büyük öbekli sunucularda uzak NUMA erişimi, TLB baskısı ve sayfa yerleşimi ölçülebilir maliyet oluşturabilir. Huge pages, Transparent Huge Pages veya NUMA ile ilgili JVM/OS ayarları evrensel performans anahtarı değildir. Remote-memory erişimi, sayfa hatası/TLB davranışı, GC ve P99 birlikte ölçülmeden bayrak açılıp kapatılmaz.
GraalVM Native Image
Native Image kapalı dünya analiziyle erişilebilir kodu AOT derler. Yansıma, resource, JNI ve serialization gibi dinamik erişimler reachability üstveri gerektirebilir. Temel kazanç düşük startup ve düşük bellek ayak izi olabilir; steady-state işlem hacminin JIT'ten otomatik yüksek olduğu varsayılmaz.
Profile-Guided Optimization temsil edici iş yükünden profil toplayıp native executable'ı yeniden derleyerek sıcak yolları AOT aşamasına taşır. Güncel GraalVM belgelerine göre PGO GraalVM Community Edition'da mevcut değildir; bu nedenle teknik karşılaştırma aynı zamanda dağıtım, lisans/tedarik ve kapalı ağda sürdürülebilir paketleme kararıdır. Özelliğin erişilebilirliği hedef GraalVM dağıtımında ayrıca doğrulanır (GraalVM Native Image PGO documentation).
Native Image özellikle kısa ömürlü process, yoğun scale-to-zero/startup SLO veya sıkı bellek ayak izi hedefinde güçlü adaydır. Uzun ömürlü, saatlerce ısınmış, yüksek verimli servis için HotSpot JIT uzun ömürlü iş yüklerinde rekabetçi olabilir. İki taraf aynı trafik ve aynı CPU/bellek bütçesiyle ölçülür.
41. Serileştirme ve ağ
Veritabanından az veri çekip API'de dev JSON grafiğine dönüştürmek optimizasyon değildir.
Yanıt maliyeti:
DB'den gelen bayt
-> Java nesnesi
-> JSON baytı
-> ağ
-> istemci parse
zincirinin toplamıdır.
Gereksiz alanı en son serileştirmede atmak yerine mümkünse veritabanından hiç çekmemek daha ucuzdur.
HTTP keep-alive, bağlantı havuzu ve HTTP/2 çoklu küçük çağrılarda el sıkışma maliyetini azaltır. Sıkıştırma büyük metin yanıtında kazançlı, küçük veya zaten sıkıştırılmış içerikte gereksiz olabilir.
HTTP/2 ve HTTP/3
HTTP/2 tek bağlantı üzerinde birden çok akışı multiplex eder ve HPACK ile başlık tekrarını azaltır. Bu, her istek için ayrı TCP/TLS kurma maliyetini düşürür; ancak TCP taşıma katmanındaki paket kaybı aynı bağlantının birden çok akışını etkileyebilir.
HTTP/3 aynı uygulama semantiğini QUIC üzerinde taşır. Bağımsız akışlar ve transport düzeyindeki davranış özellikle kayıplı/uzak ağlarda avantaj sağlayabilir. Sunucu tarafında HTTP/3'ü açmak, veritabanı veya JSON kritik yürütme yolu yavaşsa mucize yaratmaz; önce hangi katmanın bütçeyi tükettiği ölçülür.
Sıkıştırma
GZIP/Brotli seçimi yalnız sıkıştırma oranı değildir:
payload boyutu
CPU bütçesi
istemci desteği
network RTT/bandwidth
cache davranışı
birlikte değerlendirilir. Küçük veri yükünde başlık ve CPU maliyeti kazancı aşabilir. JPEG, MP4, ZIP gibi zaten sıkıştırılmış veri yeniden sıkıştırılmaz.
Jackson ve sıcak yol
Spring Boot 4 dönemi Jackson 3 geçişiyle çakışır. Jackson 3 çoğu Maven groupId ve Java package'ını tools.jackson altına taşımıştır; önemli istisna jackson-annotations olup Jackson 3.x ile hâlâ com.fasterxml.jackson.annotation/2.x annotation artifact'i kullanılır. jackson-databind içindeki bazı format/serializer annotation'ları ise yeni package'a taşınmıştır. Bu nedenle toplu "com.fasterxml -> tools.jackson" değiştirmesi istisnasız uygulanmaz. Jackson 2 için ölçülmüş Afterburner/Blackbird sonucu da yeni major sürüme körlemesine taşınmaz (FasterXML, Jackson 3 Migration Guide).
Serileştirmede önce nesne grafiği küçültülür:
az alan
az nested nesne
az String dönüşümü
az ara koleksiyon
Sonra serializer seçilir. Protobuf, Avro veya MessagePack daha küçük/ucuz olabilir; fakat şema yönetimi, insan okunabilirliği, istemci ekosistemi ve uyumluluk maliyeti ekler. JSON yeterliyse ikili biçime geçmek performans mühendisliği değildir.
42. Şema sahipliği ve ORM
ORM şemayı bilmeden doğru çalışamaz. Primary key, unique kısıt, foreign key, indeks ve sütun türleri yalnız DBA konusu değildir; uygulama erişim planının parçasıdır.
Aynı şekilde uygulama sorgu desenini bilmeden DBA doğru indeks tasarlayamaz.
İyi sınır:
uygulama ekibi:
  erişim deseni, iş kuralı, veri hacmi, SLO

DBA / veri tabanı ekibi:
  fiziksel plan, indeks, istatistik, depolama, bakım

ortak:
  ölçüm ve değişiklik sonucu
şeklindedir.
Canlı şemayı uygulamanın otomatik değiştirmesi kontrolsüz üretim ortamında risklidir. Şema değişikliği ayrı, gözden geçirilebilir ve geri dönüşü planlanmış süreç olmalıdır.
Ünite 7: Performans Testi, Kapasite ve Optimizasyon Kararları
43. Performans testi
Test verisi üretim büyüklüğüne, dağılımına ve ilişki yoğunluğuna yaklaşmalıdır. Bir milyon aynı tip kayıt, gerçek hayattaki seçicilik dağılımını temsil etmeyebilir.
Ayrı testler:
- soğuk başlangıç,
- ısınmış önbellek,
- sabit yük,
- kademeli yük,
- ani sıçrama,
- uzun süreli dayanım,
- arıza ve geri kazanım,
- replica lag,
- backlog tüketimi
için yapılır.
Başarım testi yorum değil kabul ölçütü üretmelidir:
P99 < hedef
hata oranı < hedef
DB acquisition < hedef
sorgu sayısı <= sınır
heap kararlı
backlog büyümüyor
Test bittikten sonra kaynakların normale dönmesi de doğrulanır; durmayan kuyruk veya büyüyen öbek kararlı sistem değildir.
Mikrobenchmark ve JMH
k6/Gatling gibi araçlar servis ve sistem yolunu ölçer; serializer, bellek ayırma, koleksiyon, algoritma veya sıcak bir Java metodunun mikro maliyeti için aynı araç doğru çözünürlüğü vermez. JVM mikrokıyaslama testininda yalın System.nanoTime() döngüleri dead-code elimination, constant folding, tiered compilation, inlining ve yetersiz warm-up nedeniyle yanıltıcı olabilir.
JMH; warm-up, measurement iteration, fork, state ve sonuç tüketimi gibi deney ayrıntılarını kontrollü hale getiren OpenJDK başarım ölçümü harness'idir. Yine de JMH sonucu yalnız ölçtüğü mikro davranış için geçerlidir:
JMH kazancı
!=
servis P99 kazancı
Mikro kazanç, toplam request profilinde görünür paya sahip değilse Amdahl sınırında kaybolur.
Açık ve kapalı yük modeli
Yük aracının marka adı, trafik modelinden daha az önemlidir. Kapalı modelde sanal kullanıcı önceki isteğin bitmesini bekleyip sonra yenisini gönderir. Sistem yavaşladıkça gönderim hızı da düşer ve gerçek kuyruk baskısı gizlenebilir.
Açık modelde varış hızı servis süresinden bağımsız tutulur:
hedef: 1000 istek/s
servis yavaşlasa da
1000 istek/s gelmeye devam eder
Bu, gerçek dış dünyadaki sabit/harici trafik kaynağına daha yakın davranır ve coordinated omission riskini azaltır.
k6 arrival-rate executors bu modeli doğrudan kurabilir. Gatling de sabit/kademeli arrival profilleriyle aynı yük hipotezini bağımsız araçta sınamak için kullanılabilir. İki araç aynı iş yükünde anlamlı biçimde ayrışıyorsa uygulamayı tune etmeden önce başarım ölçümü düzeni incelenir.
Trafik şekilleri
Tek bir "10 dakika 500 RPS" testi yeterli değildir:
ramp      kapasite eğrisini görür
steady    kararlı durum davranışını ölçer
spike     queue/load shedding sınırını görür
soak      leak, compaction, GC ve bakım etkisini çıkarır
recovery  backlog ve yeniden bağlanma davranışını ölçer
Think time ve pacing gerçek kullanıcı davranışını temsil etmelidir. Test verisi aynı önbellek anahtarını sürekli vuruyorsa gerçek seçiciliği değil önbellek başarım ölçümünü yapar.
Deneysel kayıt ve kanıt sınırı
Sayısal örnekler, aksi açıkça belirtilmedikçe kavramı göstermek içindir; tek bir donanım/kurum iş yükü için yayımlanmış evrensel başarım ölçümü sonucu olarak okunmamalıdır. "Bu ayar yüzde X hızlandırır" biçimindeki deneysel iddia ancak tekrarlanabilir kayıtla anlamlıdır.
Her önce/sonra deneyinde en az şu kayıt tutulur:
- Alan: Hipotez; Kaydedilecek bilgi: Hangi fiziksel işin azalması bekleniyor?
- Alan: Sürümler; Kaydedilecek bilgi: JDK, çerçeve, JDBC, DB, OS/kernel
- Alan: Kaynak bütçesi; Kaydedilecek bilgi: CPU quota/çekirdek, bellek, depolama, ağ
- Alan: Veri; Kaydedilecek bilgi: satır sayısı, dağılım/skew, önbellek durumu
- Alan: Yük modeli; Kaydedilecek bilgi: açık/kapalı, arrival rate, concurrency, pacing
- Alan: Isınma; Kaydedilecek bilgi: warm-up süresi/iterasyon ve kararlı durum ölçütü
- Alan: Sonuç; Kaydedilecek bilgi: işlem hacmi, P50/P95/P99/P99.9, hata
- Alan: İş miktarı; Kaydedilecek bilgi: CPU, bellek ayırma, GC, DB blocks/rows, round-trip, bayt
- Alan: Tekrar; Kaydedilecek bilgi: run sayısı, varyans/güven aralığı
- Alan: Bedel; Kaydedilecek bilgi: CPU, bellek, yazma, tutarlılık veya operasyon maliyeti
- Alan: Recovery; Kaydedilecek bilgi: yük bitince kuyruk/öbek/backlog normale dönüyor mu?
Üretim verisi gizlilik veya kurum politikası nedeniyle yayımlanamıyorsa bunun yerine anonimleştirilmiş yöntem, sentetik yeniden üretim veya yalnız nitel gözlem açıkça belirtilir; yayımlanmayan sayı uydurulmaz.
CI eşikleri ve regresyon
Performans testi yalnız grafik üretmez; başarısız olabilen bir kabul testi olmalıdır. Ancak threshold gürültünün altında seçilmez. Donanım, kernel, JVM, veri seti ve yük üreteci mümkün olduğunca sabitlenir; küçük farklar için birden çok run ve güven aralığı gerekir.
Kod değişikliğinden önce/sonra aynı yükte JFR veya flame graph almak, "P99 yüzde 12 düştü" sonucunun nedenini açıklar. Hızlandı ama bellek ayırma, DB blok okuma veya ağ baytı değişmediyse ölçüm varyansı veya darboğaz kayması ihtimali araştırılır.
44. Kapasite planlama
Başlangıç SLO'dur:
P99 hedefi
hata oranı
tepe istek/s
veri büyümesi
arıza senaryosu
Sonra düşük yük hizmet süresi, doyma noktası ve güvenli çalışma payı ölçülür.
Örnek sayısı:
tepe yük / tek örneğin güvenli kapasitesiile bulunur; ardından n-1 veya gerekiyorsa n-2 arıza payı eklenir.
CPU, G/Ç ağırlıklı serviste tek başına autoscaling sinyali değildir. Kuyruk uzunluğu, bağlantı bekleme, P99 ve backlog çoğu zaman daha erken sinyal verir.
USE, RED ve darboğazdan örnek sayısına
Kapasite hesabında önce servis düzeyinde RED, sonra her kritik kaynak için USE okunur. CPU yüzde 40 iken bağlantı havuzu yüzde 100 doluysa CPU'dan örnek sayısı çıkarmak yanlış kapasite modelidir.
Tek örnek güvenli kapasitesi, ilk hata veya zaman aşımı noktasından değil SLO'nun bozulmaya başladığı noktadan alınır. Peak kapasiteyle steady kapasite arasında headroom bırakılır.
Burst ve arıza bütçesi
n-1 yalnız bir sunucunun fiziksel kaybı değildir. Bir availability zone, DB node, önbellek shard veya network path kaybı da kapasiteyi azaltabilir. Failover sonrasında kalan düğümlerin yüzde 100'de çalışması "yüksek erişilebilir" değildir; yalnız arıza anını bir sonraki doygunluğa taşımaktır.
İş başına maliyet
Kaynak maliyeti yalnız bulut faturası değildir. Kapalı ağda da CPU-saniye, DB-saniye, IOPS, ağ baytı, GPU zamanı ve operasyonel bakım kapasite maliyetidir.
maliyet / iş = toplam kaynak tüketimi / tamamlanan işaynı donanımda daha çok iş yapabilmeyi ölçer. P99 düşerken iş başına CPU iki katına çıktıysa optimizasyonun bedeli kaydedilir.
Autoscaling sinyali yükün nedeni değil sonucu olmamalıdır. CPU çok geç yükseliyorsa kuyruk, pending connection, tüketici lag veya request concurrency daha erken sinyal olabilir. Scale-out süresi de modele dahildir; yeni örnek 90 saniyede hazır oluyorsa 5 saniyelik spike'ı autoscaling çözmez, headroom ve load shedding çözer.
45. Optimizasyon önceliği
En yavaş tek sorgu her zaman ilk hedef değildir.
Örnek:
A: günde 1 kez × 5 s       = 5 s/gün
B: saniyede 100 × 20 ms    = 172 800 s/gün DB süresi
B sorgusundaki küçük kazanç toplam kapasitede çok daha değerlidir.
Öncelik:
toplam tüketilen kaynak
× kullanıcı etkisi
× değişiklik riski
ile belirlenir.
46. Sık yapılan hatalar
Ayar kopyalamak
Başka sistemde maximumPoolSize=50 iyi çalıştı diye aynı değeri taşımak mühendislik değildir. Veri tabanı çekirdeği, sorgu süresi, ağ ve uygulama örnek sayısı farklıdır.
Her şeyi önbelleklemek
Önbellek miss maliyeti çözülmeden yüksek hit ratio güven vermez. Restart sonrası sistem çöküyorsa önbellek bağımlılığı kapasite borcudur.
Her şeye indeks eklemek
İndeks sayısı arttıkça yazma ve bakım maliyeti büyür. Kullanılmayan indeks de canlı bir veri yapısıdır.
Her şeyi varlık yapmak
Rapor ve liste için varlık lifecycle çoğu zaman gereksizdir. DTO projection daha açık ve ucuzdur.
Transaction'ı geniş tutmak
"Tek metot transaction olsun" bağlantı, kilit ve MVCC ömrünü iş mantığının tümüne bağlar. İşlem veri bütünlüğünün gerektirdiği en küçük sınırdır.
Çok bağlantıyı kapasite sanmak
Havuzu büyütmek DB CPU'sunu, diskini veya kilit paralelliğini artırmaz.
Yüksek iş parçacığı sayısını verim sanmak
Bekleyen iş parçacığı iş yapmaz. Sanal iş parçacığı beklemenin maliyetini azaltır, kaynağın kapasitesini büyütmez.
Full scan'i otomatik hata sanmak
Optimizer düşük seçicilikte tam taramayı bilinçli seçebilir. Plan iş miktarıyla okunur.
Native SQL'i otomatik hızlı sanmak
Native SQL ORM çeviri maliyetini aşabilir ama kötü plan, fazla satır veya fazla round-trip varsa hiçbir şey çözmez. Soyutlamayı ancak ölçülen maliyet gerekçesiyle bypass et.
47. Uygulama karar sırası
Bir okuma yavaşsa:
1. gerçekten bu veri gerekli mi?
2. gereksiz satır var mı?
3. gereksiz sütun var mı?
4. sorgu sayısı fazla mı?
5. round-trip fazla mı?
6. uygun indeks var mı?
7. tahminler doğru mu?
8. plan doğru mu?
9. kilit / replica / I/O beklemesi var mı?
10. ancak sonra cache düşün
Bir yazma yavaşsa:
1. transaction gereğinden uzun mu?
2. kaç round-trip var?
3. batch gerçekten çalışıyor mu?
4. kimlik stratejisi batch'i bozuyor mu?
5. gereksiz indeks var mı?
6. row-by-row yerine set-based olabilir mi?
7. lock contention var mı?
8. WAL/redo/fsync sınırı mı?
9. storage write amplification mı?
10. veriyi farklı iş yüküne ayırmak gerekir mi?
Sistem yük altında çöküyorsa:
1. nerede kuyruk büyüyor?
2. giriş hızı kaç?
3. hizmet hızı kaç?
4. timeout çalışıyor mu?
5. retry yükü büyütüyor mu?
6. bağlantı havuzu bekliyor mu?
7. DB doygun mu?
8. cache stampede var mı?
9. consumer backlog DB'yi eziyor mu?
10. yük azaltma mekanizması var mı?
48. Genel kavramsal çerçeve
Temel ilkeler birkaç maddede özetlenebilir.
Darboğaz hareket eder. Iş parçacığı maliyeti azalınca bağlantı havuzu, havuz iyileşince SQL, SQL iyileşince serileştirme veya ağ görünür olur. Yeni darboğaz başarısızlık değil ilerlemenin sonucudur.
Her optimizasyon maliyet taşır. İndeks yazmayı, önbellek tutarlılığı, batch gecikmeyi, replication güncelliği, partition yönetimi, denormalizasyon yeniden üretim ve senkronizasyon maliyetini artırır.
Soyutlama maliyeti kaldırmaz. JPA SQL'i görünmez kılabilir; veritabanı yine SQL, plan, blok ve kilitle çalışır.
Kaynak gerçek ile türetilmiş veriyi ayır. Önbellek, indeks, arama motoru, materialized view ve analitik kopya yeniden üretilebiliyorsa hata alanı küçülür.
Öngörülebilirlik tepe hızdan değerlidir. P99'u kararlı 40 ms olan servis, ortalaması 10 ms fakat düzenli 2 saniye sıçrayan servisten çoğu kurumsal işte daha iyidir.
Kuyruğu görünür yerde tut. Uygulama girişinde sınırlı bekleme, veritabanının içinde sınırsız kilit ve bağlantı kuyruğundan daha yönetilebilirdir.
En hızlı sorgu çalışmayan sorgudur. Gereksiz veri hiç istenmez, gereksiz ilişki yüklenmez, gereksiz COUNT çalışmaz, aynı sonuç boş yere tekrar hesaplanmaz.
Doğruluk performanstan önce gelir. Primary key, unique kısıt, isolation ve idempotency kaldırılarak elde edilen verim gerçek optimizasyon değildir.
Ölçmeden yapılan ayar varsayımdır. Profil, plan ve yük testi olmayan performans kararı doğrulanmamış hipotezdir.
49. Temel ayrımlar
- Yanıt süresi != verim.
- Ortalama != P99.
- Yüzdelik ortalaması != birleşik yüzdelik.
- Kullanım oranı != kapasite payı.
- CPU kullanımı != doygunluk.
- Iş parçacığı sayısı != gerçek paralellik.
- Sanal iş parçacığı != sınırsız DB eşzamanlılığı.
- Bağlantı havuzu != veritabanı kapasitesi.
- Bağlantı bekleme != sorgu yürütme süresi.
flush!=commit.flush!=clear.- Persistence context != ikinci düzey önbellek.
readOnly!= yazmayı mutlak yasaklayan güvenlik sınırı.IDENTITY!=SEQUENCE.- Primary key != yalnız performans indeksi.
- Unique kısıt != uygulama içi
existskontrolü. - N+1 != tek bir yavaş sorgu.
EAGER!= N+1 çözümü.JOIN FETCH!= sayfalama.- DTO != varlık.
- Getirme boyutu != toplam sonuç boyutu.
- Offset != keyset sayfalama.
COUNT(*)!= her sayfanın zorunlu parçası.- Batch API çağrısı != gerçek ağ batch'i.
- Satır-by-satır != set-based işlem.
- Bind parametresi != SQL metni birleştirme.
- Plan önbellek != sonuç önbelleği.
- Tahmini satır != gerçek satır.
- Full scan != otomatik hata.
- İndeks taraması != otomatik hızlı yol.
- İndeks != bedelsiz okuma hızlandırıcı.
- B-tree != her iş yükünün tek indeksi.
- Bölümleme != indeks.
- Bölümleme != sharding.
- Replica != her zaman güncel kopya.
- Eşzamansız çoğaltma != commit sonrası sıfır veri kaybı.
- CDC != tam olarak bir kez dış yan etki.
- Önbellek != kaynak gerçek.
- Materialized view != sanal view.
- OLTP != OLAP.
- Satır depolama != sütun depolama.
- B-tree != LSM.
- Read amplification != write amplification.
- MVCC != serileştirilebilirlik.
- Anlık görüntü isolation != write-skew koruması.
- Optimistic kilit != tüm iş kuralı tutarlılığı.
- Kilitlenme != kalıcı hata.
- Yeniden deneme != her hatanın çözümü.
- Idempotency != duplicate oluşmaz varsayımı.
- Event sourcing != her CRUD sistemi için doğru mimari.
- CQRS != yalnız read/write service sınıfı ayırmak.
- Şema değişikliği != tek dağıtım anı.
- Native SQL != otomatik en hızlı yol.
- Native image != daha hızlı veritabanı.
- Büyük öbek != daha az GC sorunu.
- Çok sunucu != doğrusal ölçek.
- Daha hızlı != daha iyi; hangi maliyet karşılığında olduğu belirtilmelidir.
Zen özeti
Not uzundur; yöntem kısadır:
ölç
-> en pahalı işi bul
-> gereksiz işi kaldır
-> eşzamanlılığı sınırla
-> aynı yükle doğrula
-> bedeli kaydet
İlk optimizasyon çoğu zaman çıkarmaktır: çalışmayan sorgu hızlandırılmış sorgudan, çekilmeyen satır hızlı serileştirilmiş satırdan, görünür küçük kuyruk gizli büyük kuyruktan daha iyidir. Zen burada doğruluğu veya gözlemlenebilirliği azaltmak değil; gereksiz işi, gizli durumu ve doğrulanmamış ayarı azaltmaktır.
Önbellek Doğruluğu: Kimlik, Tazelik ve Yetki Kapsamı
Önbellek doğruluğu yalnız TTL seçmekten ibaret değildir. Aynı kimlik farklı kullanıcı kapsamlarında farklı görünürlüğe veya farklı türetilmiş sonuca sahipse yalnız nesne kimliğini önbellek key yapmak güvenlik ve veri doğruluğu problemi oluşturabilir.
Daha gerçekçi model şöyledir:
cache doğruluğu
= doğru kimlik
+ kabul edilebilir tazelik
+ doğru yetki/çalışma kapsamı
Örneğin kullanıcıya gösterilebilen bir meta bilgi mevcut yetki kapsamına bağlıysa key tasarımında veya loader sözleşmesinde bu kapsam açık olmalıdır. önbellek, yetkilendirmeyi atlayan ikinci bir veri erişim yolu haline gelmemelidir. Bu konu Güvenli Yazılım Mühendisliği açısından da önemlidir.
Invalidation için her zaman bütün önbelleği temizlemek gerekmez. Kapsam veya veri kümesi için artan bir sürüm değeri key'in parçası yapılabilir:
entityId + scopeId + scopeVersionYetki veya kapsam değiştiğinde sürüm artırılır; eski anahtarlar artık okunmaz ve doğal eviction/TTL ile temizlenir. Bu yöntem bounded önbellek ile birlikte kullanıldığında invalidation kodunu sadeleştirebilir. Ancak sürümün kendisi sonsuz büyüyen anahtar uzayı yaratmamalı, önbellek yine boyut sınırına sahip olmalıdır.
Aynı anahtar için eşzamanlı önbellek miss'lerin tek kaynak çağrısında birleştirilmesi, önceki stampede bölümündeki single-flight ilkesinin pratik karşılığıdır:
cache hit -> dön
cache miss -> aynı key için çalışan yükleme var mı?
              varsa ona bağlan
              yoksa tek yükleme başlat
Negatif sonuç da pahalıysa kısa süre önbelleklenebilir; fakat “bulunamadı” bilgisinin yetki kapsamından mı yoksa gerçekten veri yokluğundan mı kaynaklandığı açık olmalıdır. Güvenlik kapsamı belirsiz bir negatif önbellek, farklı kullanıcılara yanlış yokluk bilgisi taşıyabilir.
Bu nedenle önbellek tasarımında hit ratio tek başına başarı ölçütü değildir. Doğru sorular şunlardır: önbellek hangi kimliği temsil ediyor, hangi yetki kapsamında geçerli, ne kadar eski veri kabul edilebilir ve miss sırasında kaynağa kaç eşzamanlı çağrı gidiyor?
İlgili Java Derinleşmeleri
Veri yolu ve üretim başarımı uçtan uca ele alındığında JVM/JIT ve GC davranışı ayrı bir inceleme katmanı oluşturur. JVM/JIT, GC ve çalışma zamanı davranışının ayrı analizi için Java Sistemlerinde Çalışma Zamanı Optimizasyonu; reflection, mapping ve veri erişim katmanının küçük ölçekte nasıl gerçeklenebileceği için Java ile Yansıma Tabanlı ORM Geliştirme daha dar iki tamamlayıcı çalışmadır.
Performans Katmanları Arasındaki Bağlantılar
Java veri sistemlerinde aynı gecikme bütçesi bağlantı havuzu, JVM çalışma zamanı, eşzamanlı veri yapıları ve akış işleme katmanları arasında bölünür. Bu katmanların ayrıntılı mühendislik problemleri şu çalışmalarda ele alınır:
- fiziksel Oracle oturum bütçesi: HikariCP ile İleri Düzey Havuz Tasarımı,
- JIT, GC ve sıcak yol maliyetleri: Java Sistemlerinde Çalışma Zamanı Optimizasyonu,
- CAS ve önbellek-coherence: Kilitsiz Kuyruklarda Gerçek Maliyet,
- akış tabanlı işlem uzantıları: Java ile NiFi Custom Processor Geliştirme.
Bu ayrım, genel kapsamı bölmeden tek bir teknik soruya cevap veren daha küçük sayfaları görünür kılar.
Java performans sonucunu tekrar üretilebilir kılmak
JVM performansı tek bir süre ölçümüyle karşılaştırılmamalıdır. JIT ısınması, GC, CPU frekansı, container/cgroup sınırı ve veri kümesi sonuç üzerinde etkilidir. Mikrobenchmark için JMH gibi bir harness, dead-code elimination ve constant folding gibi tuzakları azaltmaya yardım eder.
Üretim problemi mikrobenchmark ile aynı şey değildir. Thread dump, JFR, GC logu, veritabanı planı ve uygulama metriği birlikte okunduğunda gecikmenin JVM, SQL, kilit, ağ veya dış bağımlılık kaynaklı olup olmadığı ayrılabilir.
Bir ayarın “daha hızlı” olduğu ancak aynı throughput, hata oranı ve kaynak bütçesi altında ölçüldüğünde söylenebilir. Ortalama latency yanında p95/p99 ve allocation/GC davranışı da raporlanmalıdır.
İlgili Dersler ve Teknik Çalışmalar
Paralelleştirmede hızlanma ile iş hacmi arasındaki sınır
Paralel çalışan iş parçacığı sayısının artırılması, tek başına iş hacminin doğrusal artacağı anlamına gelmez. Paralelleştirilemeyen iş oranı s için, iletişim ve senkronizasyon giderlerinin yok sayıldığı ideal Amdahl sınırı
S(p) ≤ 1 / [s + (1−s)/p]biçimindedir. Bu sınırın gerisinde kalmak olağandır: ortak kilitler, veri tabanı bağlantı havuzu, disk G/Ç, bellek bant genişliği ve görev dağıtım maliyeti ek seri bölgeler oluşturur. Paralellik az sayıda uzun işi hızlandırırken; sınırlı kaynaklarda daha fazla eşzamanlı istek, kuyruk süresini ve kuyruk sonu gecikmesini artırabilir.
Bir istatistiksel işi veri bölmelerine dağıtmak, her bölmenin sonucunun bağımsız olarak birleştirilebildiği varsayımına dayanır. Birleştirilebilir toplam ve sayaçlar ile koordinasyon isteyen global optimizasyon aynı sınıfa girmez. Özellikle model parametreleri eşzamansız güncellendiğinde her işçi farklı yaşta bir durum görebilir. Sınırlı gecikmeli güncellemelere ilişkin yakınsama sonuçları, kısıtsız veya arızalar altında belirsiz süre geciken güncellemeler için garanti oluşturmaz. Deterministik işlem sırası gerekiyorsa eşzamansız yöntemin kazancı yanında yeniden üretilebilirlik maliyeti de kaydedilmelidir.
Bölerek çözmenin doğruluk şartı
Büyük veri üzerinde bölerek çözme, belleğe sığma sorununu azaltabilir; fakat son adımda birleştirilen alt model parametrelerinin ortalaması genel olarak tüm veri üzerinde eğitilmiş modelin çözümü değildir. Yerel amaçların farklı dağılımlardan geldiği durumda heterojenlik yanlılığa dönüşebilir. Gerçek dağıtık kazanım; bölümleme, ara sonuç boyutu, ağ transferi, birleştirme yöntemi ve doğruluk kontrolü birlikte ölçülerek değerlendirilir. Aynı girdi tekrar işlendiğinde sayısal sonucun ne kadar değiştiği, performans raporunun dışında bırakılmamalıdır.
Kaynakça
- Apache Software Foundation. Kafka 4.0 KafkaProducer and KafkaConsumer API. https://kafka.apache.org/40/javadoc/ (erişim: 25.08.2026).
- Apache Software Foundation. Kafka 4.0 Producer Configuration. https://kafka.apache.org/40/generated/producer_config.html (erişim: 25.08.2026).
- async-profiler. async-profiler. https://github.com/async-profiler/async-profiler (erişim: 25.08.2026).
- Berenson, H.; Bernstein, P.; Gray, J.; Melton, J.; O'Neil, E.; O'Neil, P. “A Critique of ANSI SQL Isolation Levels.” SIGMOD Record, 24(2), 1995. https://doi.org/10.1145/568271.223785.
- Caffeine. Design, Efficiency and Refresh. https://github.com/ben-manes/caffeine/wiki (erişim: 25.08.2026).
- Date, C. J. An Introduction to Database Systems. Addison-Wesley.
- Eclipse Foundation. Jakarta Persistence Specification. https://jakarta.ee/specifications/persistence/ (erişim: 25.08.2026).
- Elmasri, R.; Navathe, S. B. Fundamentals of Database Systems. Pearson.
- FasterXML. Jackson 3 Migration Guide. https://github.com/FasterXML/jackson/blob/main/jackson3/MIGRATING_TO_JACKSON_3.md (erişim: 25.08.2026).
- Garcia-Molina, H.; Ullman, J. D.; Widom, J. Database Systems: The Complete Book. Pearson.
- Goetz, B. et al Java Concurrency in Practice. Addison-Wesley, 2006.
- GraalVM. Native Image — Profile-Guided Optimization. https://www.graalvm.org/latest/reference-manual/native-image/optimizations-and-performance/PGO/basic-usage/ (erişim: 25.08.2026).
- Grafana Labs. k6: Open and Closed Models. https://grafana.com/docs/k6/latest/using-k6/scenarios/concepts/open-vs-closed/ (erişim: 25.08.2026).
- Gregg, B. Systems Performance: Enterprise and the Cloud. 2nd ed. Addison-Wesley, 2020.
- Gunther, N. J. Guerrilla Capacity Planning. Springer, 2007.
- HdrHistogram. HdrHistogram and Coordinated Omission. https://github.com/HdrHistogram/HdrHistogram (erişim: 25.08.2026).
- Hibernate ORM Introduction: https://docs.jboss.org/hibernate/orm/current/introduction/html_single/Hibernate_Introduction.html
- Hibernate ORM User Guide: https://docs.jboss.org/hibernate/orm/current/userguide/html_single/Hibernate_User_Guide.html
- HikariCP. About Pool Sizing. https://github.com/brettwooldridge/HikariCP/wiki/About-Pool-Sizing (erişim: 25.08.2026).
- IETF. RFC 9113: HTTP/2. https://www.rfc-editor.org/rfc/rfc9113.
- IETF. RFC 9114: HTTP/3. https://www.rfc-editor.org/rfc/rfc9114.
- İnan, U. Spring Boot 4 Performance in Practice. Leanpub, 2026. DOI: 10.5281/zenodo.20370827.
- Kingman, J. F. “The Single Server Queue in Heavy Traffic.” Mathematical Proceedings of the Cambridge Philosophical Society, 57(4), 1961, 902-904. https://doi.org/10.1017/S0305004100036094.
- Kleppmann, M.; Riccomini, C. Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. 2nd ed. O'Reilly Media, 2026.
- Köker, M. A. Kurumsal Veri Tabanı Erişim Katmanı Optimizasyonu. T.C. İçişleri Bakanlığı Arge Notları, 22.12.2025. Yayımlanmamış kurum içi çalışma notu.
- Köker, M. A. Kurumsal Veri Tabanı İndeksleme Gereksinimi. T.C. İçişleri Bakanlığı Arge Notları, 12.12.2025. Yayımlanmamış kurum içi çalışma notu.
- Micrometer. Histograms and Percentiles. https://docs.micrometer.io/micrometer/reference/concepts/histogram-quantiles.html (erişim: 25.08.2026).
- Mihalcea, V. High-Performance Java Persistence. Leanpub sürümü, 9 Haziran 2020. https://vladmihalcea.com/books/high-performance-java-persistence/
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- Nygard, M. T. Release It!: Design and Deploy Production-Ready Software. 2nd ed. Pragmatic Bookshelf, 2018.
- OpenJDK. Java Microbenchmark Harness (JMH). https://openjdk.org/projects/code-tools/jmh/ (erişim: 25.08.2026).
- OpenJDK. JEP 444: Virtual Threads. https://openjdk.org/jeps/444.
- OpenJDK. JEP 474: ZGC: Generational Mode by Default. https://openjdk.org/jeps/474.
- OpenJDK. JEP 483: Ahead-of-Time Class Loading & Linking. https://openjdk.org/jeps/483.
- OpenJDK. JEP 490: ZGC: Remove the Non-Generational Mode. https://openjdk.org/jeps/490.
- OpenJDK. JEP 491: Synchronize Virtual Threads without Pinning. https://openjdk.org/jeps/491.
- OpenJDK. JEP 514: Ahead-of-Time Command-Line Ergonomics. https://openjdk.org/jeps/514.
- OpenJDK. JEP 515: Ahead-of-Time Method Profiling. https://openjdk.org/jeps/515.
- OpenJDK. JEP 516: Ahead-of-Time Object Caching with Any GC. https://openjdk.org/jeps/516.
- OpenJDK. JEP 519: Compact Object Headers. https://openjdk.org/jeps/519.
- OpenJDK. JEP 522: G1 GC: Improve Throughput by Reducing Synchronization. https://openjdk.org/jeps/522.
- OpenJDK. JEP 525: Structured Concurrency (Sixth Preview). https://openjdk.org/jeps/525.
- Oracle. JDBC Developer's Guide — Statement and Result Set Caching. https://docs.oracle.com/en/database/oracle/oracle-database/26/jjdbc/statement-and-resultset-caching.html (erişim: 25.08.2026).
- Oracle. Oracle Database Concepts. https://docs.oracle.com/en/database/oracle/oracle-database/ (erişim: 25.08.2026).
- Oracle. Oracle Database SQL Tuning Guide. https://docs.oracle.com/en/database/oracle/oracle-database/ (erişim: 25.08.2026).
- Oracle. Oracle RAC — Design and Deployment Techniques. https://docs.oracle.com/en/database/oracle/oracle-database/26/racad/design-and-deployment-techniques.html (erişim: 25.08.2026).
- PgBouncer. Configuration. https://www.pgbouncer.org/config (erişim: 25.08.2026).
- pgJDBC. Server Prepared Statements and Driver Configuration. https://jdbc.postgresql.org/documentation/server-prepare/ (erişim: 25.08.2026).
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation. https://www.postgresql.org/docs/18/ (erişim: 25.08.2026).
- PostgreSQL Global Development Group. PostgreSQL 18 — Multicolumn Indexes. https://www.postgresql.org/docs/18/indexes-multicolumn.html (erişim: 25.08.2026).
- PostgreSQL Global Development Group. PostgreSQL 18 — PREPARE. https://www.postgresql.org/docs/18/sql-prepare.html (erişim: 25.08.2026).
- Red Hat / Hibernate. Hibernate ORM User Guide. https://hibernate.org/orm/documentation/ (erişim: 25.08.2026).
- Redis. Pipelining. https://redis.io/docs/latest/develop/using-commands/pipelining/ (erişim: 25.08.2026).
- Silberschatz, A.; Korth, H. F.; Sudarshan, S. Database System Concepts. McGraw-Hill.
- Spring çerçeve, Declarative Transaction Implementation: https://docs.spring.io/spring-framework/reference/data-access/transaction/declarative/tx-decl-explained.html
- Spring çerçeve, Proxying Mechanisms: https://docs.spring.io/spring-framework/reference/core/aop/proxying.html
- Spring. Spring Boot Reference Documentation. https://docs.spring.io/spring-boot/reference/ (erişim: 25.08.2026).
- Spring. Spring Framework Reference — Data Access and Transaction Management. https://docs.spring.io/spring-framework/reference/data-access.html (erişim: 25.08.2026).
- Yarımağan, Ü. Veri Tabanı Sistemleri.
- Walter W. Piegorsch, Richard A. Levine, Hao Helen Zhang, Thomas C. M. Lee (eds.). Computational Statistics in Data Science. Wiley, 2022. ISBN 9781119561071.