


İşletim Sistemleri: Süreç, Bellek, Dosya ve Giriş Çıkış

İşletim sistemi yapısı; süreç, iş parçacığı, CPU zamanlama, eşzamanlılık, kilitlenme, sanal bellek, dosya ve G/Ç yanında gerçek zamanlı zamanlama, öncelik terslenmesi, WCET ve modern G/Ç yolunu kapsayan ders notları.
Süreç yönetimi, bellek ve G/Ç ayrı başlıklar olmaktan çok aynı kaynak yönetimi ve yalıtım probleminin parçalarıdır. İş parçacığı, sanal bellek, dosya sistemi, sürücü ve koruma mekanizmaları bu ortak çerçevede birbirine bağlanır; tarihsel kavramlarla daha yeni tekniklerin hangi döneme ait olduğu ayrıca belirtilir.
Ünite 1: İşletim Sistemlerine Giriş
1.1. İşletim Sisteminin Temel Görevi
Bir bilgisayar sistemi işlemci, ana bellek, kalıcı depolama ve giriş/çıkış aygıtlarından oluşur. Bu kaynakları doğrudan uygulamaların yönetmesi hem güç hem de güvenli değildir. İşletim sistemi, donanım ile uygulamalar arasında çalışan temel yazılım katmanıdır.
İşletim sisteminin iki ana görevi vardır:
- Donanım ayrıntılarını soyutlamak.
- Sınırlı sistem kaynaklarını programlar arasında yönetmek.
Bir uygulama dosyadan veri okumak istediğinde diskin veya SSD'nin fiziksel çalışma ayrıntılarını bilmez. İşletim sistemine bir okuma isteği gönderir. İşletim sistemi bu mantıksal isteği dosya sistemi, önbellek, blok katmanı ve aygıt sürücüsü üzerinden fiziksel işleme dönüştürür.
Bu nedenle işletim sistemi yalnızca bir donanım denetleyicisi değildir. Aynı zamanda programlara düzenli ve güvenli bir çalışma ortamı sunan bir soyutlama katmanıdır.
1.2. Kaynak Yönetimi
İşlemci zamanı, ana bellek, depolama alanı ve giriş/çıkış aygıtları sınırlı kaynaklardır. Birden fazla program çalıştığında bu kaynaklar paylaşılmalıdır.
İşletim sistemi bu paylaşım sırasında birkaç amacı birlikte gözetir:
- işlemcinin boş kalmaması,
- görevlerin makul sürede tamamlanması,
- etkileşimli uygulamaların hızlı yanıt vermesi,
- görevlerin birbirinin belleğini bozmaması,
- depolama ve G/Ç kaynaklarının verimli kullanılması,
- yetkisiz erişimin engellenmesi,
- sistemin hata durumlarında bütünlüğünü koruması.
Bu amaçlar her zaman aynı yönde değildir. Örneğin toplam sistem verimini artıran bir planlama yöntemi tek bir görevin bekleme süresini uzatabilir. İşletim sistemi tasarımı büyük ölçüde bu tür ödünleşimlerin yönetimidir.
1.3. Bilgisayar Sisteminin Temel Modeli
İşletim sistemi açısından basitleştirilmiş bir bilgisayar sistemi üç ana bileşenle ele alınabilir:
- işlemci,
- ana bellek,
- giriş/çıkış sistemi.
Bu bileşenler veri, adres ve denetim yolları veya güncel sistemlerde bunların daha gelişmiş karşılıkları üzerinden iletişim kurar.
Adres yolu, erişilecek bellek veya aygıt konumunu belirler.
Veri yolu, işlemci, bellek ve aygıtlar arasında veriyi taşır.
Denetim yolu, okuma, yazma, kesilme ve zamanlama gibi işlemleri belirleyen sinyalleri taşır.
Modern sistemlerde fiziksel bağlantı mimarileri çok daha karmaşıktır. PCI Express, bellek denetleyicileri, NUMA topolojileri ve yüksek hızlı çevre birimi bağlantıları klasik ortak yol modelinden farklıdır. Buna rağmen adres, veri ve denetim ayrımı işletim sistemi kavramlarını anlamak için geçerli bir soyutlamadır.
1.4. Komutların İşletimi
Von Neumann modelinde program komutları ve veriler bellekte tutulur. İşlemci temel olarak şu çevrimi tekrarlar:
- komutu bellekten getirir,
- komutu çözer,
- gerekli veriyi elde eder,
- işlemi gerçekleştirir,
- sonucu yazar,
- bir sonraki komuta geçer.
Bu yapı genellikle fetch-decode-execute çevrimi olarak ifade edilir.
Bir bellek veya aygıt erişiminin doğru zamanda gerçekleşmesi gerekir. Donanım düzeyindeki bu zaman ilişkileri zaman çizelgeleri ile gösterilebilir. İşletim sistemi açısından önemli olan ayrıntı, işlemci ile çevre birimlerinin aynı hızda çalışmamasıdır.
1.5. İş Kavramı
Bir kullanıcının bilgisayar sistemine bir bütün olarak yaptırmak istediği işlem kümesine iş, yani job denir.
Bir iş tek programdan oluşabilir. Birden fazla programın belirli sırada çalıştırılması da tek iş olarak değerlendirilebilir.
Örneğin:
- kaynak kodun derlenmesi,
- bağlanması,
- testlerin çalıştırılması,
- sonuçların dosyaya yazılması
tek bir iş akışını oluşturabilir.
Günümüzde kabuk betiği (shell script), derleme işlem hattı, toplu işler (batch job) ve CI/CD işleri gibi yapılar aynı temel düşüncenin farklı uygulamalarıdır.
1.6. Tek İş ve Çok İş Düzeni
Bir sistem aynı anda yalnızca bir işi işletime alıyorsa tek iş düzeni vardır.
Bu yaklaşım basittir ancak kaynakları verimsiz kullanır. Çalışan program yavaş bir G/Ç işlemini beklediğinde işlemci de boş kalabilir.
Birden fazla işin işletimi üst üste bindirildiğinde çok iş düzeni, klasik adıyla multiprogramming ortaya çıkar.
Bir görev G/Ç beklerken işlemci başka bir göreve verilebilir. Böylece işlemci ile G/Ç aygıtlarının çalışma süreleri örtüştürülür.
Temel düşünce şudur:
Bir görevin bekleme süresi başka bir görevin çalışma süresine dönüştürülür.
Bu yaklaşım modern çok görevli işletim sistemlerinin temelidir.
1.7. Program ve Görev
Program, çalıştırılabilir komutlardan oluşan durağan bir yapıdır.
Görev, güncel terminolojiyle süreç veya process, çalışan program örneğidir.
Aynı programın aynı anda çalışan iki örneği iki ayrı süreçtir. Kodları aynı olabilir ancak çalışma durumları farklıdır.
Bir süreç için işletim sistemi en azından şu bilgileri tutar:
- süreç kimliği,
- işlemci yazmaçları,
- program sayacı,
- yığıt bilgileri,
- adres alanı,
- açık dosyalar,
- kullanıcı ve yetki bilgileri,
- planlama bilgileri,
- çalışma durumu.
Bu bilgiler süreç denetim bloğu, yani PCB - Process Control Block benzeri veri yapılarında tutulur.
1.8. Çok Görevli Çalışma
İşlemci çekirdeği aynı anda yalnızca bir komut akışını çalıştırabilir. Buna rağmen birçok süreç aynı anda ilerliyormuş gibi görünür.
İşletim sistemi işlemciyi kısa sürelerle görevler arasında değiştirir. Bu işlem yeterince hızlı olduğunda kullanıcı görevlerin eşzamanlı çalıştığını algılar.
Çok çekirdekli sistemlerde gerçek paralellik de mümkündür. Örneğin dört çekirdekli bir işlemci dört farklı komut akışını gerçekten aynı anda çalıştırabilir.
Bu nedenle iki kavram ayrılmalıdır:
Concurrency, birden fazla işin zaman bakımından örtüşerek ilerlemesidir.
Parallelism, birden fazla işin fiziksel olarak aynı anda çalışmasıdır.
1.9. Toplu İşlem
Toplu işlem, kullanıcının işletim sırasında doğrudan müdahalesine ihtiyaç duymayan işlerin sıraya alınarak çalıştırılmasıdır.
Geçmişte işler fiziksel olarak biriktirilip sisteme topluca verilirdi. Günümüzde aynı kavram zamanlanmış görevlerde, veri işleme sistemlerinde, render işlerinde, yedeklemede ve büyük hesaplama kümelerinde yaşamaktadır.
Toplu işlemin güçlü yönü yüksek kaynak verimidir. Zayıf yönü ise doğrudan kullanıcı etkileşiminin düşük olmasıdır.
1.10. Etkileşimli İşlem
Etkileşimli sistemde kullanıcı yaptığı işlemin sonucunu kısa sürede görmek ister.
Komut kabukları, masaüstü uygulamaları, editörler ve çevrim içi terminaller bu sınıfa girer.
Burada kritik ölçüt toplam tamamlanma süresinden çok yanıt süresidir.
Zaman paylaşımlı işletim sistemleri işlemciyi küçük zaman dilimleri halinde süreçler arasında paylaştırarak birçok kullanıcıya sistem kendisine aitmiş gibi bir çalışma ortamı sağlayabilir.
1.11. Gerçek Zamanlı İşlem
Gerçek zamanlı sistemde yalnızca doğru sonuç üretmek yeterli değildir. Sonucun belirli bir zaman sınırı içinde üretilmesi gerekir.
Bu sınır deadline olarak adlandırılır.
Gerçek zamanlı sistemler iki temel grupta düşünülür.
Hard real-time sistemde zaman sınırının aşılması sistem başarısızlığı anlamına gelebilir.
Soft real-time sistemde zaman sınırının aşılması istenmez ancak tek başına sistem başarısızlığı sayılmaz.
Endüstriyel kontrol, uçuş kontrolü, otomotiv sistemleri ve kimi haberleşme sistemleri gerçek zamanlı çalışma gerektirebilir.
Gerçek zamanlı olmak ile hızlı olmak aynı şey değildir. Temel ölçüt ortalama hız değil, zaman davranışının öngörülebilir olmasıdır.
1.12. İşletim Sisteminin Temel Kesimleri
Genel amaçlı bir işletim sistemi şu temel işlevleri yerine getirir:
- süreç ve iş parçacığı yönetimi,
- işlemci planlama,
- ana bellek yönetimi,
- sanal bellek yönetimi,
- giriş/çıkış yönetimi,
- dosya sistemi yönetimi,
- aygıt sürücülerinin yönetimi,
- ağ iletişimi,
- koruma ve güvenlik,
- kullanıcı ve yetki yönetimi.
Bu kesimler birbirinden bağımsız değildir. Bir dosya okuma işlemi aynı anda süreç yönetimi, bellek yönetimi, dosya sistemi, blok G/Ç ve aygıt sürücüsü katmanlarını ilgilendirebilir.
1.13. Çekirdek ve Kullanıcı Alanı
Modern işletim sistemleri ayrıcalıklı işlemleri kullanıcı programlarından ayırır.
Kernel space, işletim sisteminin çekirdek bileşenlerinin çalıştığı ayrıcalıklı alandır.
User space, sıradan uygulamaların çalıştığı daha sınırlı alandır.
Kullanıcı programı doğrudan kritik donanım kaynaklarını değiştiremez. Gerektiğinde işletim sisteminden hizmet ister.
Bu ayrım sistem bütünlüğünün temel koruma mekanizmalarından biridir.
1.14. Sistem Çağrıları
Kullanıcı programının çekirdekten hizmet istemesine olanak veren denetimli arayüze sistem çağrısı denir.
Tipik sistem çağrıları şunlarla ilgilidir:
- dosya açma,
- veri okuma ve yazma,
- süreç oluşturma,
- süreç sonlandırma,
- bellek eşleme,
- ağ bağlantısı oluşturma,
- aygıt işlemleri.
Unix benzeri sistemlerde open(), read(), write(), fork(), exec() ve mmap() bunun bilinen örnekleridir.
Sistem çağrısı sırasında işlemci kontrollü biçimde kullanıcı modundan çekirdek moduna geçer. İşlem tamamlandığında kullanıcı moduna döner.
Bu mekanizma işletim sisteminin sunduğu soyutlama ile donanımsal koruma arasında köprü oluşturur.
1.15. İşletim Sistemlerinin Evrimi
İlk sistemler tek programlı ve donanıma yakın yapılardı. Daha sonra toplu işletim, çok programlama ve zaman paylaşımı ortaya çıktı.
Gelişim çizgisi daha sonra şu yönlerde ilerledi:
- çok kullanıcılı sistemler,
- çok işlemcili sistemler,
- kişisel bilgisayarlar,
- ağ işletim sistemleri,
- sanallaştırma,
- çok çekirdekli işlemciler,
- mobil sistemler,
- konteyner tabanlı çalışma ortamları,
- dağıtık altyapılar.
Teknoloji değişse de işletim sisteminin temel sorusu değişmemiştir:
Sınırlı fiziksel kaynaklar, birden fazla yazılım bileşenine nasıl güvenli ve verimli biçimde sunulur?
Ünite 2: Giriş/Çıkış Sistemi
2.1. Giriş/çıkış Sisteminin Amacı
İşlemciler ve bellek çok hızlıdır. Çevre birimleri ise farklı hız, protokol ve veri aktarım özelliklerine sahiptir.
İşletim sisteminin G/Ç sistemi bu farklılıkları soyutlar.
Bir uygulama açısından:
oku
yaz
gönder
al
gibi birkaç mantıksal işlem yeterlidir.
Fiziksel düzeyde ise aynı işlem aygıt yazmaçlarının programlanmasını, kesilme yönetimini, DMA aktarımını, hata denetimini ve tampon kullanımını gerektirebilir.
2.2. Aygıt, Denetleyici ve Arabirim
Fiziksel aygıt ile işlemci arasında genellikle bir denetleyici bulunur.
Denetleyici şu tür yazmaçlara sahip olabilir:
- veri yazmacı,
- durum yazmacı,
- komut yazmacı,
- denetim yazmacı.
İşlemci veya aygıt sürücüsü bu yazmaçlar üzerinden donanımla haberleşir.
Modern donanımlarda aygıt yazmaçları çoğunlukla belleğe eşlenmiş G/Ç, yani **MMIO - Memory-Mapped I/O** üzerinden erişilebilir.
2.3. Seri ve Paralel İletişim
Klasik G/Ç anlatımında seri ve paralel iletişim önemli bir ayrımdır.
Seri iletişimde bitler aynı fiziksel kanal üzerinden ardışık aktarılır.
Paralel iletişimde birden fazla bit aynı anda farklı hatlardan aktarılır.
Geçmişte paralel arabirimler kısa mesafelerde yaygındı. Yüksek hızlı modern sistemlerde seri bağlantılar baskındır. PCI Express, USB, SATA ve yüksek hızlı ağ bağlantıları seri fiziksel aktarım tekniklerinden yararlanır.
Eski RS-232 ve Centronics ayrıntıları tarihsel önem taşır. Güncel işletim sistemi açısından kalıcı olan kavram protokolün kendisi değil, farklı fiziksel aygıtların ortak bir G/Ç soyutlamasına bağlanmasıdır.
2.4. Zamanuyumlu ve Zamanuyumsuz İletişim
Zamanuyumlu iletişimde taraflar ortak veya geri kazanılabilir bir zamanlama düzenine göre veri aktarır.
Zamanuyumsuz iletişimde veri aktarımının sınırlarını belirlemek için ek işaretleme mekanizmaları gerekir.
Bu ayrım yalnız fiziksel haberleşmede değil, yazılım G/Ç tasarımında da önemlidir.
Programın G/Ç işlemi tamamlanıncaya kadar beklemesi synchronous I/O olarak düşünülebilir.
İşlem başlatıldıktan sonra programın başka iş yapabilmesi ise asynchronous I/O yaklaşımına karşılık gelir.
2.5. Seçmeli G/Ç ve Polling
En basit G/Ç yönteminde işlemci aygıtın durum yazmacını sürekli denetler.
Bu yöntem polling veya programlı G/Ç olarak bilinir.
Basitleştirilmiş akış şöyledir:
while aygıt_hazır_değil:
    durumu_kontrol_et

veriyi_aktar
Yöntem basittir ancak işlemci zamanı tüketir.
Aygıt uzun süre hazır olmayacaksa işlemci milyonlarca kez aynı durumu kontrol edebilir.
Polling tamamen gereksiz değildir. Çok kısa gecikmeli aygıtlarda veya düşük seviyeli kimi yüksek performanslı veri yollarında kesilme maliyetinden kaçınmak için bilinçli olarak kullanılabilir.
Temel karar şudur:
Bekleme maliyeti mi, kesilme ve bağlam değiştirme maliyeti mi daha yüksektir?
2.6. Kesilme Düzeneği
Aygıtın işlemciye hizmet gereksinimini bildirmesine kesilme, yani interrupt denir.
Kesilme sayesinde işlemci aygıtı sürekli kontrol etmek zorunda değildir.
Genel akış şöyledir:
- işlemci aygıtta işlemi başlatır,
- başka kod çalıştırmaya devam eder,
- aygıt işlemi tamamlar,
- kesilme üretir,
- işlemci mevcut bağlamı korur,
- kesilme hizmet yordamına geçer,
- gerekli işlemi yapar,
- önceki programa döner.
Bu yöntem özellikle gecikmesi işlemci zamanına göre uzun olan aygıtlarda etkilidir.
2.7. Kesilme Maskesi
Her kesilme aynı önemde değildir.
Bazı kesilmeler geçici olarak engellenebilir. Bu işleme masking denir.
Maske mekanizması kritik kod parçalarının belirli kesilmeler tarafından bölünmesini engellemek veya kesilmeler arasında öncelik kurmak için kullanılabilir.
Buna karşılık belirli donanımsal hata sınıfları gibi bazı olaylar maskelenemeyen kesilmeler şeklinde tasarlanabilir.
Kesilmelerin uzun süre kapalı tutulması kötü bir tasarımdır. Kesilme gecikmesini artırır ve gerçek zamanlı davranışı bozar.
2.8. Kesilme Vektörü
İşlemcinin hangi kesilme için hangi hizmet yordamına gideceğini bilmesi gerekir.
Bu amaçla kesilme vektörü veya benzeri bir yönlendirme yapısı kullanılır.
Kesilme kaynağı tanındıktan sonra ilgili ISR, yani **Interrupt Service Routine**, çalıştırılır.
Modern sistemlerde kesilme denetleyicileri çok sayıda aygıt ve işlemci çekirdeği arasındaki kesilmelerin yönlendirilmesini ve önceliklendirilmesini yönetir.
2.9. Kesilme Hizmet Yordamı
Kesilme hizmet yordamı mümkün olduğunca kısa tutulmalıdır.
Tipik görevleri şunlardır:
- kesilmenin nedenini belirlemek,
- aygıt durumunu okumak,
- gerekli en kısa donanım işlemini yapmak,
- kesilmeyi doğrulamak,
- daha uzun işi sonraki bir yürütme bağlamına bırakmak.
Uzun süren işlemlerin doğrudan kesilme bağlamında yapılması diğer kesilmelerin gecikmesine neden olabilir.
2.10. Kesilmeli G/Ç
Kesilmeli G/Ç, polling yaklaşımındaki sürekli durum kontrolünü ortadan kaldırır.
Bir süreç G/Ç başlattığında bekler durumuna geçirilebilir. İşlemci başka bir sürece verilir.
Aygıt kesilme ürettiğinde işletim sistemi ilgili süreci yeniden hazır duruma getirir.
Bu ilişki işletim sistemi mimarisinin önemli bir bağlantısını gösterir:
G/Ç isteği
    ↓
süreç bekler
    ↓
işlemci başka sürece geçer
    ↓
G/Ç tamamlanır
    ↓
kesilme
    ↓
süreç hazır olur
G/Ç yönetimi ile süreç yönetimi bu nedenle doğrudan bağlantılıdır.
2.11. Doğrudan Bellek Erişimi
Büyük veri bloklarının her baytını işlemci üzerinden taşımak pahalıdır.
DMA - Direct Memory Access, aygıt ile ana bellek arasında veri aktarımının işlemcinin her veri sözcüğünü tek tek taşımasına gerek kalmadan yapılmasını sağlar.
İşlemci genel olarak:
- aktarım adresini,
- aktarım yönünü,
- veri miktarını
belirler ve DMA işlemini başlatır.
Aktarım donanım tarafından gerçekleştirilir. Tamamlandığında işlemciye kesilme gönderilebilir.
Modern sistemlerde DMA adres alanı ile işlemcinin fiziksel adres alanı aynı olmak zorunda değildir. IOMMU gibi birimler aygıt erişimlerini eşleyebilir ve sınırlandırabilir. Güncel Linux DMA API'si de sürücünün CPU sanal adresi, fiziksel adres ve aygıtın görebildiği DMA adresi arasındaki farkı dikkate almasını gerektirir. (cdn.kernel.org)
2.12. G/Ç Kanalları ve Yardımcı İşlemciler
Klasik büyük sistemlerde G/Ç kanalları, G/Ç işlemlerinin önemli bölümünü ana işlemciden bağımsız yürütmek için kullanılmıştır.
Temel düşünce bugün de geçerlidir.
Modern depolama ve ağ denetleyicileri:
- komut kuyrukları,
- DMA,
- donanımsal sıra yönetimi,
- çoklu kesilme vektörleri,
- paralel işlem kuyrukları
kullanarak işlemci üzerindeki G/Ç yükünü azaltabilir.
Buradaki genel ilke şudur:
İşlemci veri taşıyan birim olmaktan çıkarılır, işlemi başlatan ve denetleyen birim haline getirilir.
Ünite 3: Görev Yönetimi
Görev zamanlaması değerlendirilirken iş yükü önce geliş zamanları, işlem süreleri ve öncelik gereksinimleriyle tanımlanır. Seçilen zamanlayıcı için bekleme ve yanıt süreleri hesaplanır; ancak ortalamaların düşük çıkması en kötü durum gecikmesinin kabul edilebilir olduğunu göstermez. Paylaşılan kilitler ve kesmelerden doğan engelleme süreleri ayrı hesaba katılır. Gerçek zamanlı bir görev için karar, yalnız işlemci kullanımına değil, son tarihlerin doğrulanabilir biçimde karşılanmasına dayanmalıdır.
3.1. Görevin Tanımı
Çalışan program süreç, ders terminolojisindeki adıyla görev olarak ele alınır.
Program pasif bir kod ve veri bütünüdür. Süreç ise çalışma durumuna sahiptir.
Bir sürecin durumu yalnız koddan oluşmaz. İşletim sistemi süreç için ayrıca:
- işlemci bağlamı,
- adres alanı,
- açık dosyalar,
- kaynak sahipliği,
- kullanıcı kimliği,
- sinyal durumu,
- planlama bilgileri
tutar.
3.2. Görev Anahtarlama
İşlemci bir süreçten başka bir sürece geçirildiğinde **context switch**, yani bağlam anahtarlama yapılır.
Eski sürecin gerekli işlemci durumu saklanır. Yeni sürecin daha önce saklanmış durumu işlemciye yüklenir.
Bağlam tipik olarak şunları kapsar:
- program sayacı,
- yığıt göstergesi,
- genel amaçlı yazmaçlar,
- işlemci durum bilgileri,
- gerektiğinde adres alanıyla ilişkili bilgiler.
Bağlam değiştirme gerekli olsa da doğrudan kullanıcı işi üretmez. Bu nedenle işletim sistemi açısından bir yönetim maliyetidir.
Zaman dilimlerinin aşırı küçük seçilmesi çok sayıda bağlam anahtarlamasına neden olur.
3.3. Süreç Durumları
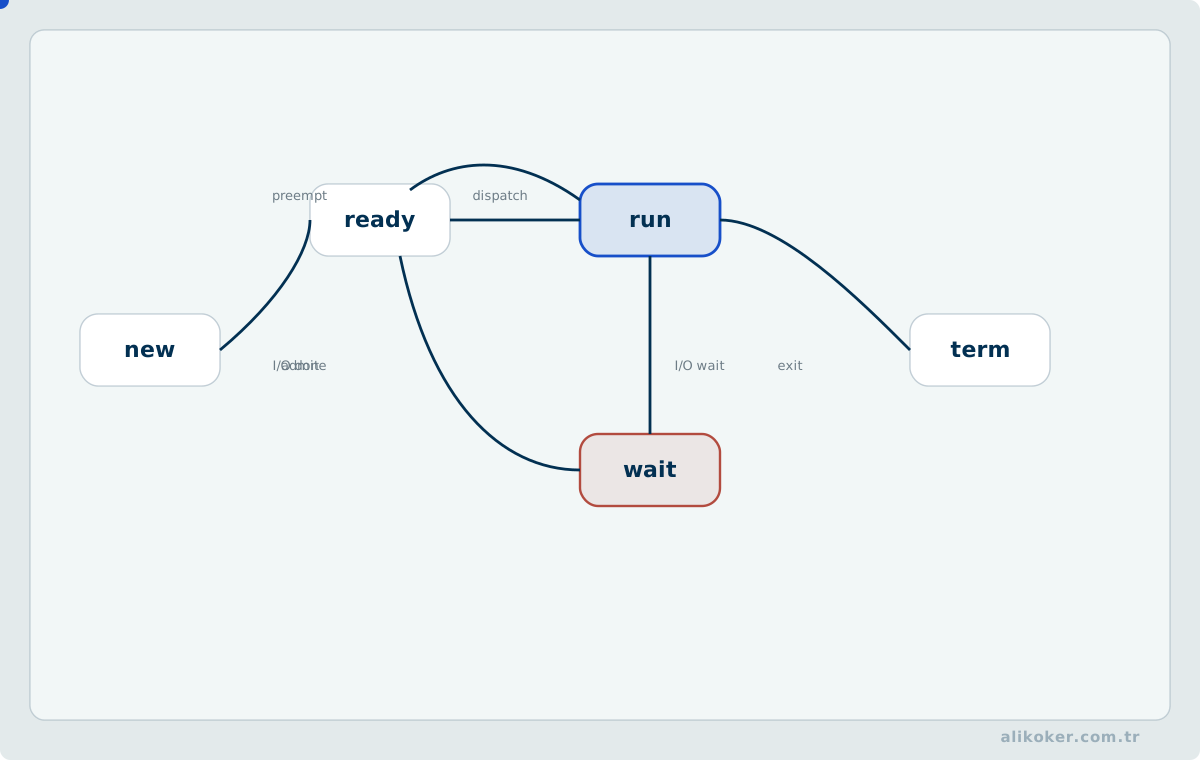
Basit bir süreç modeli üç temel durumla açıklanabilir:
Ready: Süreç çalışmaya hazırdır ancak işlemciyi bekler.
Running: Süreç işlemci üzerinde çalışmaktadır.
Blocked/Waiting: Süreç G/Ç, kilit, zamanlayıcı veya başka bir olay beklemektedir.
Tipik geçişler şöyledir:
        dispatch
READY -----------> RUNNING
  ^                   |
  |                   |
  | preemption        | wait
  |                   v
  +--------------- WAITING
          event
Süreç oluşturma ve sonlandırma durumları eklendiğinde model genişler.
3.4. Görev Kuyrukları
İşletim sistemi süreçleri durumlarına göre kuyruklarda tutabilir.
En temel kuyruk hazır kuyruğudur.
Bunun yanında:
- disk bekleme kuyruğu,
- ağ bekleme kuyruğu,
- kilit bekleme kuyruğu,
- zamanlayıcı bekleme yapıları
bulunabilir.
Bir olay tamamlandığında süreç ilgili bekleme yapısından çıkarılır ve yeniden hazır duruma alınır.
3.5. Süreç Oluşturma
Unix süreç modelinin temel işlemlerinden biri fork() çağrısıdır.
fork() çalışan sürecin yeni bir çocuk süreç oluşturmasını sağlar.
Yeni program görüntüsüne geçiş ise exec() ailesiyle yapılabilir.
Klasik kalıp şöyledir:
fork()
    ├─ ebeveyn süreç
    └─ çocuk süreç
           ↓
         exec()
           ↓
       yeni program
Bu ayrım önemlidir:
fork() yeni süreç yaratır.
exec() mevcut sürecin çalıştırdığı programı değiştirir.
POSIX ailesinde süreç ve komut çalıştırma arayüzleri bu model etrafında tanımlanır. (pubs.opengroup.org)
3.6. Süreç Sonlandırma ve Bekleme
Bir süreç tamamlandığında çıkış durumunu işletim sistemine bildirir.
Ebeveyn süreç çocuk sürecin sonucunu alabilir.
Unix modelinde çocuk süreç sonlanmış ancak ebeveyni henüz durumunu almamışsa süreç kaydı kısa süreyle zombie durumunda kalabilir.
Bu bir "çalışmaya devam eden ölü süreç" değildir. Program çalışması bitmiştir. Yalnızca ebeveynin alacağı sonlanma bilgisi süreç tablosunda tutulmaktadır.
3.7. İşlemci Planlama
Hazır durumda birden fazla süreç bulunduğunda hangi sürecin işlemciyi alacağına zamanlayıcı karar verir.
Planlama algoritmaları değerlendirilirken şu ölçütler kullanılır:
- CPU kullanımı,
- işlem hacmi,
- turnaround time,
- waiting time,
- response time,
- adalet,
- öncelik,
- gerçek zamanlı sistemlerde deadline uyumu.
Tek bir algoritma bütün ölçütleri aynı anda en iyi yapamaz.
3.8. İlk Gelen Önce
FCFS - First Come First Served, hazır kuyruğuna önce gelen süreci önce çalıştırır.
Basittir ve aç kalma sorunu düşüktür.
Ancak uzun bir CPU ağırlıklı süreç kuyruğun başına geçtiğinde kısa süreçler uzun süre bekleyebilir. Bu durum convoy effect olarak bilinir.
3.9. En Kısa İş Önce ve SRTF
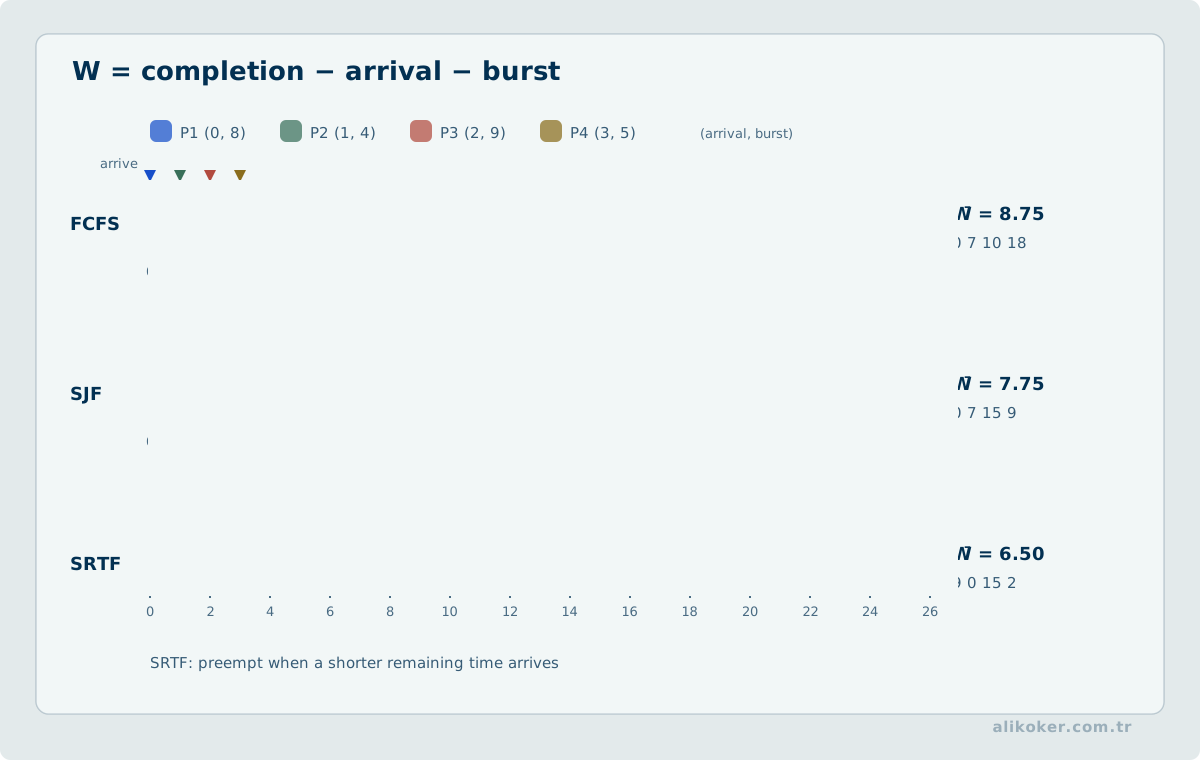
Shortest Job First, işlem süresi en kısa olan işi seçer.
Kuramsal olarak ortalama bekleme süresini düşürebilir. Ancak gelecekteki CPU süresini kesin olarak bilmek çoğu durumda mümkün değildir.
Shortest Remaining Time First, bu yaklaşımın preemptive biçimidir. Kalan çalışma süresi daha kısa bir süreç geldiğinde çalışan süreç kesilebilir.
3.10. Öncelik Tabanlı Planlama
Her sürece bir öncelik değeri verilir.
Planlayıcı daha yüksek öncelikli süreci önce çalıştırır.
Bu yöntem gerçek zamanlı ve sistem görevlerinde önemlidir.
Ancak sürekli yüksek öncelikli işler gelirse düşük öncelikli görevler uzun süre işlemci alamayabilir. Buna açlık denir.
Bir çözüm, bekledikçe süreç önceliğini yükselten aging yaklaşımıdır.
3.11. Round Robin
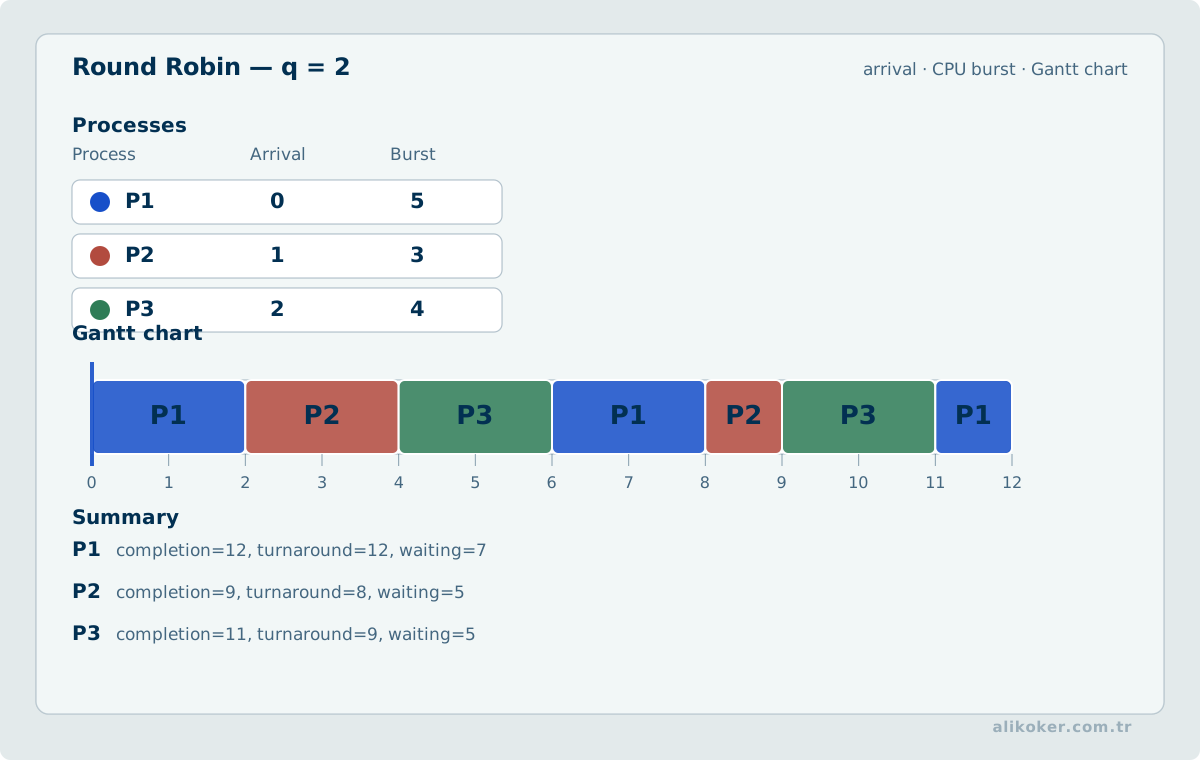
Round Robin, etkileşimli sistemlerin temel planlama yaklaşımlarındandır.
Her sürece belirli bir time quantum verilir.
Süreç zaman dilimi içinde bitmez veya bloke olmazsa kesilir ve hazır kuyruğunun sonuna alınır.
Quantum çok büyükse davranış FCFS'ye yaklaşır.
Quantum çok küçükse bağlam değiştirme maliyeti yükselir.
Bu nedenle zaman dilimi seçimi gecikme ile yönetim maliyeti arasında dengedir.
3.12. Çok Düzeyli Kuyruklar
Farklı iş türleri farklı kuyruklarda tutulabilir.
Örneğin:
- gerçek zamanlı görevler,
- etkileşimli görevler,
- toplu işler
farklı planlama politikalarına sahip olabilir.
Multilevel Feedback Kuyruk yaklaşımında süreçler davranışlarına göre kuyruklar arasında hareket edebilir.
Kısa CPU patlamaları kullanan etkileşimli süreçlere daha hızlı yanıt verilirken uzun CPU ağırlıklı süreçler daha düşük öncelikli kuyruklara taşınabilir.
3.13. Uzun, Orta ve Kısa Dönemli Planlama
Klasik işletim sistemi modeli üç planlama düzeyi tanımlar.
Uzun dönemli planlama, hangi işlerin sisteme kabul edileceğini belirler.
Orta dönemli planlama, süreçlerin bellek ile ikincil depolama arasındaki durumunu yönetebilir.
Kısa dönemli planlama, hazır süreçlerden hangisinin işlemciye verileceğine karar verir.
Modern genel amaçlı işletim sistemlerinde bu ayrımlar klasik toplu işlem sistemlerindeki kadar görünür olmayabilir. Ancak kaynak kabulü, bellek baskısı ve CPU planlama arasında farklı zaman ölçeklerinin bulunması halen geçerli bir tasarım düşüncesidir.
3.14. Iş Parçacığı Kavramı
Bir süreç içinde birden fazla komut akışı bulunabilir. Bunlara iş parçacığı, eski Türkçe kullanımda işletim dizisi denir.
Aynı sürecin iş parçacıklarıi genellikle:
- kod alanını,
- veri alanını,
- öbeği,
- açık dosyaları
paylaşır.
Her iş parçacığının ise kendi:
- program sayacı,
- yazmaç bağlamı,
- yığıtı
bulunur.
Iş parçacığı oluşturmak ve aralarında geçiş yapmak çoğu durumda ayrı süreçlerden daha düşük maliyetlidir. Bunun karşılığında paylaşılan bellek nedeniyle eşzamanlama hataları daha kolay ortaya çıkar.
Ünite 4: Birlikte Çalışan Görevler
Bir eşzamanlılık hatasını çözmek için önce paylaşılan değişkenler ve her görevin erişim sırası çıkarılır. Hata yalnız belirli sıralamalarda ortaya çıkıyorsa kritik bölge sınırı daraltılarak atomik tutulması gereken işlem belirlenir. Ardından kilit sıralaması, bekleme döngüleri ve uyandırma koşulları incelenir. Başarılı bir test tekrarının yeterli olmadığı durumlarda, farklı zamanlamaları sistematik olarak zorlayan deneyler ve durum değişmezlerinin kontrolü kullanılmalıdır.
4.1. Koşut Çalışma ve Kaynak Paylaşımı
Birden fazla süreç veya iş parçacığı aynı veri üzerinde çalıştığında yalnız işlem sırası değil, işlemlerin birbirleriyle etkileşimi de önem kazanır.
Paylaşılan kaynak:
- değişken,
- bellek bölgesi,
- dosya,
- veri yapısı,
- aygıt,
- kuyruk
olabilir.
İki çalışma akışının aynı kaynağa kontrolsüz erişmesi **yarış durumu (race condition)** oluşturabilir.
4.2. Yarış Durumu
Şu işlemi ele alalım:
sayac = sayac + 1Bu ifade işlemci açısından tek bir işlem olmak zorunda değildir.
Kabaca:
R1 = sayac
R1 = R1 + 1
sayac = R1
şeklinde yürütülebilir.
İki iş parçacığı aynı anda çalışırsa ikisi de eski değeri okuyabilir. Sonuçta iki artış yapılmasına rağmen sayaç yalnız bir artmış olabilir.
Programın sonucu yürütme sırasına bağlı hale gelmiştir.
4.3. Kritik Kesim
Paylaşılan kaynağa erişen kod bölümüne kritik kesim denir.
Doğru bir karşılıklı dışlama çözümü temel olarak şunları sağlamalıdır:
- aynı anda yalnız bir yürütme akışı kritik kesimde bulunmalıdır,
- kritik kesim boşsa uygun bir görev gereksiz yere engellenmemelidir,
- bir görev sonsuza kadar bekletilmemelidir,
- çözüm işlem hızlarına ilişkin hatalı varsayımlara dayanmamalıdır.
4.4. Kesilmeleri Kapatma
Tek işlemcili basit sistemlerde kritik bir işlem sırasında kesilmelerin geçici olarak kapatılması karşılıklı dışlama sağlayabilir.
Ancak bu yaklaşım kullanıcı programlarına bırakılamaz.
Ayrıca çok çekirdekli sistemde bir çekirdekte kesilmeyi kapatmak diğer çekirdeğin aynı belleğe erişmesini engellemez.
Bu nedenle yöntem yalnız sınırlı çekirdek içi kritik bölgelerde anlamlıdır.
4.5. Yazılımsal Karşılıklı Dışlama
Dekker ve Peterson algoritmaları karşılıklı dışlamanın yalnız paylaşılan değişkenlerle kurulabileceğini gösteren klasik çözümlerdir.
Bu algoritmalar işletim sistemi düşüncesi açısından önemlidir. Ancak modern genel amaçlı eşzamanlama mekanizmalarının doğrudan temeli olarak kullanılmazlar.
Asıl ders şudur:
Paylaşılan değişkenlere sıradan okuma ve yazma işlemleri yapmak güvenli eşzamanlama için her zaman yeterli değildir.
4.6. Atomik İşlemler
Modern işlemciler karşılıklı dışlamayı kurmak için atomik makine işlemleri sağlar.
Örnek kavramlar:
- test-and-set,
- compare-and-swap,
- atomic exchange,
- fetch-and-add.
Atomik işlem, diğer işlemcilerin araya giremeyeceği şekilde tek bir mantıksal işlem olarak görülür.
Bunlar mutex, spinlock ve daha gelişmiş eşzamanlama yapılarının temelini oluşturabilir.
4.7. Spinlock
Bir iş parçacığı kilit serbest kalana kadar döngü içinde bekliyorsa spinlock kullanımı söz konusudur.
Spinlock kısa kritik bölgelerde yararlı olabilir.
Bekleme uzun olacaksa işlemciyi sürekli tüketmek verimsizdir. Bu durumda iş parçacığının uyutulması daha uygundur.
Temel seçim:
- çok kısa bekleme: spin,
- uzun veya belirsiz bekleme: block/sleep.
4.8. Semafor
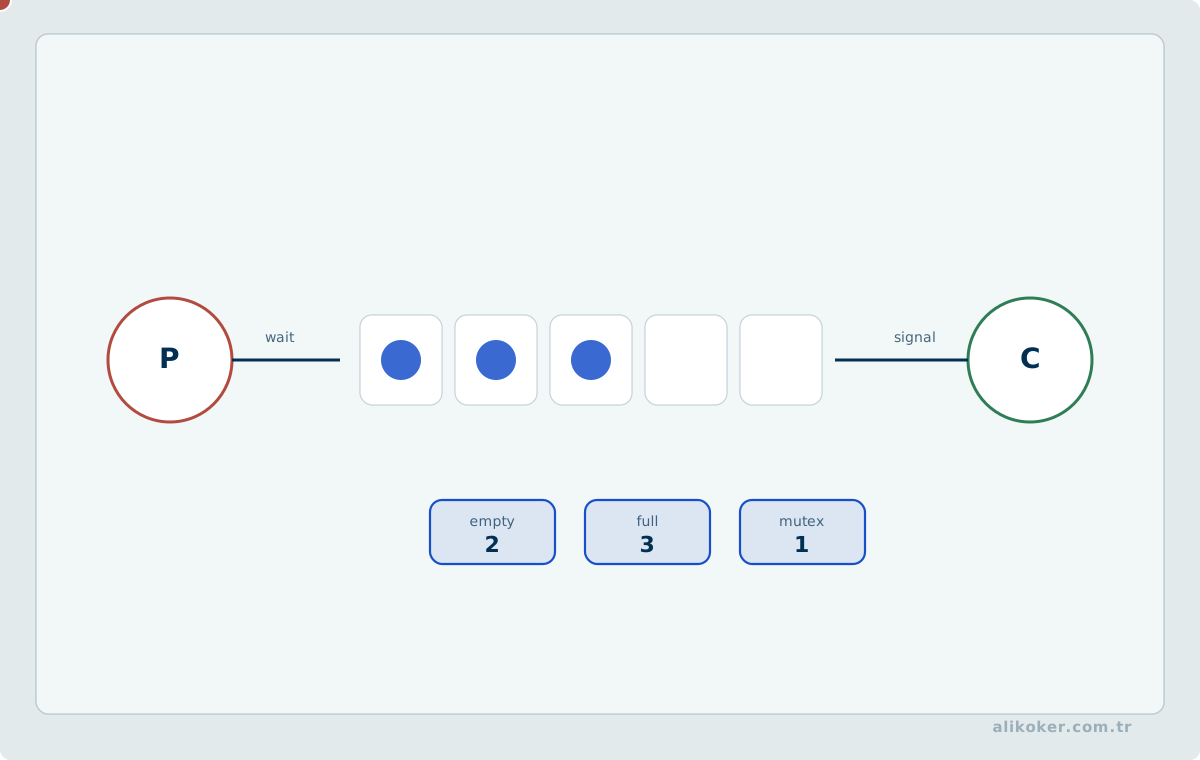
Semafor, Dijkstra tarafından ortaya konan temel eşzamanlama soyutlamalarındandır.
Klasik işlemleri:
P()veyawait(),V()veyasignal()
olarak gösterilir.
İkili semaforun değeri 0 veya 1 olabilir ve karşılıklı dışlama amacıyla kullanılabilir.
Saymalı semafor ise aynı türden birden fazla kaynağın sayısını temsil edebilir.
Örneğin havuzda dört eş kaynak varsa semafor başlangıç değeri 4 olabilir.
Bir görev kaynak aldığında değer azalır. Kaynak geri verildiğinde artar.
4.9. Mutex ve Semafor Ayrımı
Mutex özellikle bir kritik bölgenin sahipliğini denetlemek için tasarlanır.
Semafor ise kaynak sayımı veya olay bildirimi için de kullanılabilir.
Bu iki mekanizma kimi durumlarda birbirinin yerine kullanılabilse de semantik olarak aynı değildir.
Mutex'in sahiplik kavramı vardır. Kilidi alan iş parçacığının bırakması beklenir.
4.10. Monitör
Monitor, paylaşılan veri ile bu veri üzerinde çalışan işlemleri tek bir kontrollü yapı içinde birleştiren üst düzey eşzamanlama yaklaşımıdır.
Aynı anda yalnız bir iş parçacığı monitör içinde aktif olabilir.
Koşul değişkenleri belirli koşullar gerçekleşene kadar iş parçacıklarıin beklemesini sağlar.
Bu yaklaşım düşük seviyeli semafor kullanımına göre programlama hatalarını azaltabilir.
Koşul değişkeni, kendisi bir olay geçmişi tutan sayaç değildir; belirli bir paylaşılan durum değiştiğinde bekleyen iş parçacıklarını yeniden kontrol etmeye yarar. Bekleme işlemi, korunan durum koşulu sağlanmadığı sürece bir döngü içinde yapılmalıdır. Örneğin kuyruk boşken bekleyen tüketici uyandırıldığı anda başka bir tüketici öğeyi almış olabilir; uyandırma, kuyrukta mutlaka öğe bulunduğu garantisini vermez. Koşul denetimi ve durum güncellemesi aynı kilit protokolüne bağlanmazsa kayıp bildirim ve veri yarışı oluşabilir.
4.11. İleti Aktarımı
Görevlerin aynı belleği paylaşması zorunlu değildir.
Bir süreç diğerine ileti göndererek de eşgüdüm sağlayabilir.
Temel işlemler:
send(destination, message)
receive(source, message)
İleti aktarımı:
- aynı sistemde süreçler arasında,
- farklı makinelerde ağ üzerinden
kullanılabilir.
Bu nedenle ileti aktarımı hem eşzamanlama hem de dağıtık sistem tasarımının temel araçlarındandır.
4.12. Kilitlenme
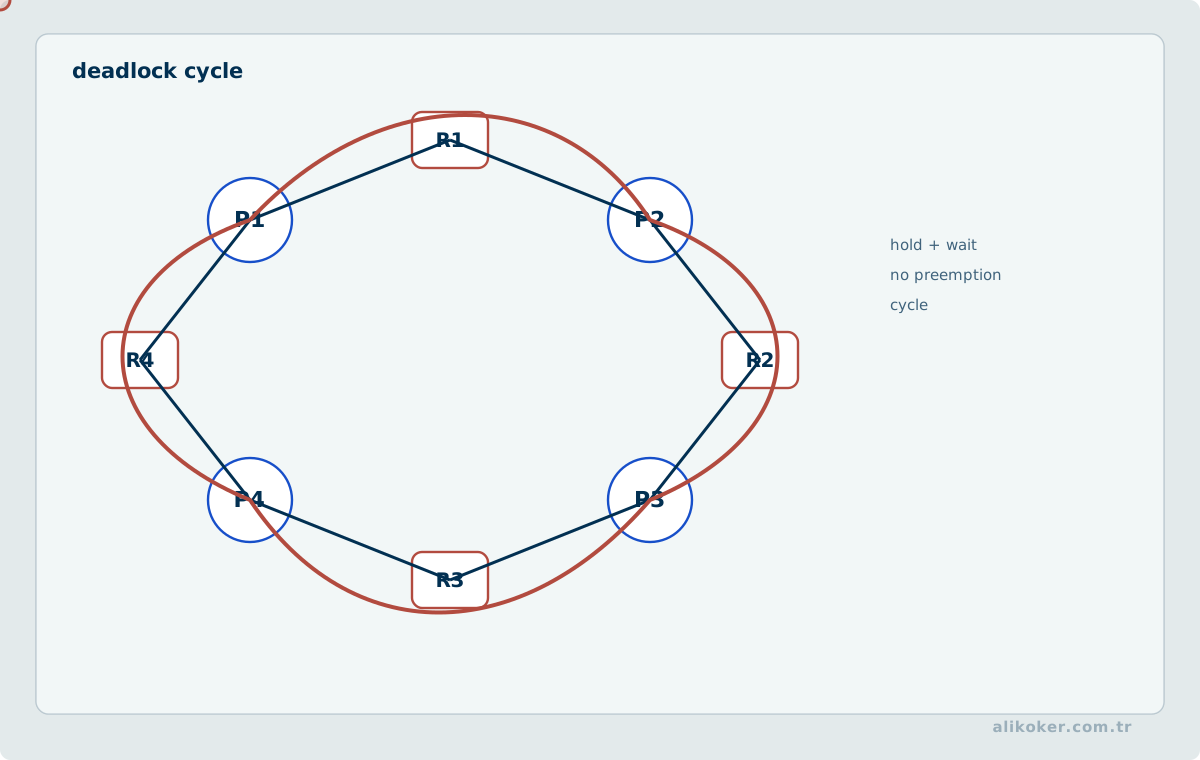
Bir grup süreç birbirinin elindeki kaynakları beklediği için hiçbirinin ilerleyemediği duruma kilitlenme, yani kilitlenme denir.
Klasik örnek:
G1:
    disk kilidini al
    yazıcı kilidini bekle

G2:
    yazıcı kilidini al
    disk kilidini bekle
Her iki görev de diğerinin kaynağı bırakmasını bekler.
4.13. Kilitlenmenin Gerekli Koşulları
Klasik kilitlenme modelinde dört koşul birlikte bulunmalıdır:
- Mutual exclusion: Kaynak aynı anda yalnız bir görev tarafından kullanılabilir.
- Hold and wait: Görev elindeki kaynağı bırakmadan başka kaynak bekler.
- No preemption: Kaynak görevden zorla alınamaz.
- Circular wait: Görevler arasında döngüsel bekleme oluşur.
Bu koşullardan en az biri sistematik olarak ortadan kaldırılırsa kilitlenme önlenebilir.
4.14. Kaynakları Sıralama
Kilitlenme önlemenin pratik yollarından biri kaynaklara global sıra vermektir.
Örneğin:
R1 < R2 < R3 < R4Tüm görevler kaynakları yalnız artan sırada alırsa dairesel bekleme oluşmaz.
Bu yöntem özellikle birden fazla kilidin birlikte kullanıldığı yazılımlarda etkilidir.
4.15. Banker Algoritması
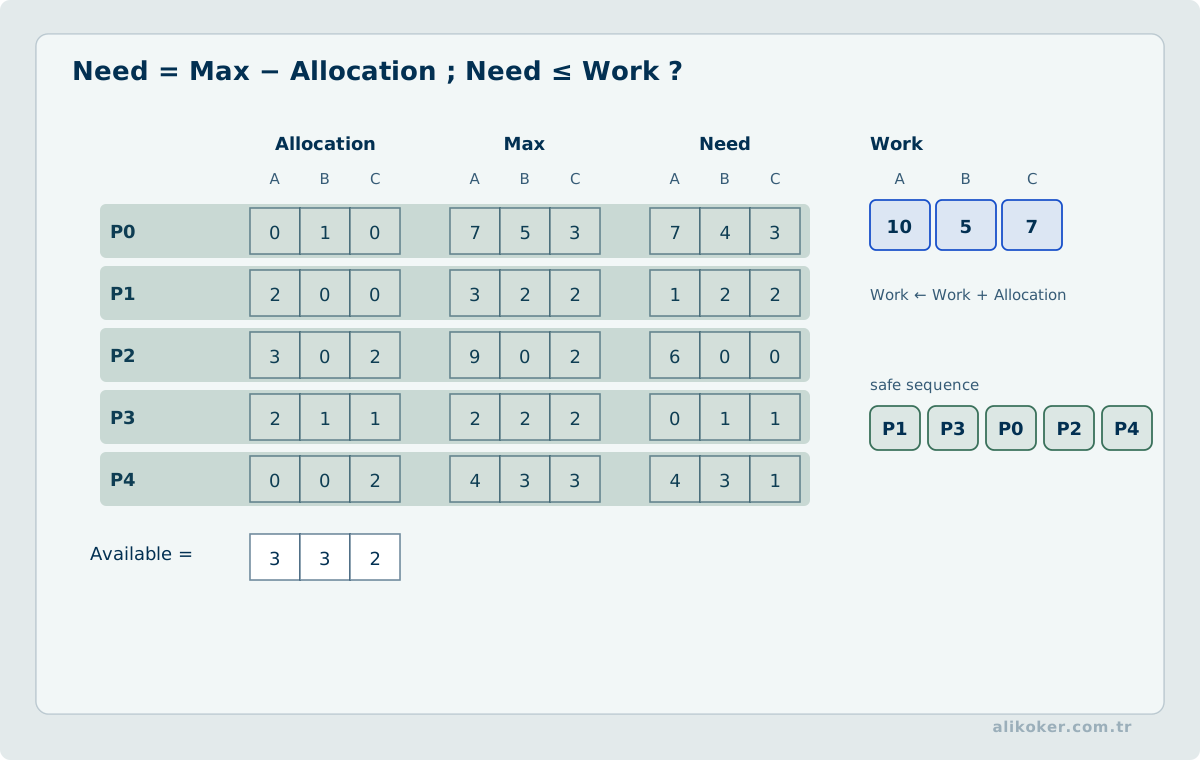
Banker algoritması kilitlenmeden kaçınmaya yönelik klasik bir yöntemdir.
Kaynak isteği ancak sistem yeni atamadan sonra güvenli durumda kalıyorsa karşılanır.
Güvenli durum, tüm görevlerin uygun bir sırayla tamamlanabileceği en az bir kaynak tahsis dizisinin bulunmasıdır.
Algoritmanın önemli sınırlaması görevlerin maksimum kaynak gereksinimlerinin önceden bilinmesini gerektirmesidir.
Bu nedenle genel amaçlı işletim sistemlerinde her kaynak için doğrudan uygulanması pratik değildir. Ancak güvenli kaynak tahsisi düşüncesini anlamak açısından önemlidir.
Ünite 5: Ana Bellek Yönetimi
5.1. Bellek Yönetiminin Amacı
Programın çalışabilmesi için komutlarının ve gerekli verilerinin işlemcinin erişebildiği bellekte bulunması gerekir.
Birden fazla süreç aynı anda çalıştığında işletim sistemi belleği süreçler arasında paylaştırır.
Bellek yönetimi şu sorunları çözmelidir:
- hangi alanın boş olduğunu bilmek,
- süreçlere yer ayırmak,
- serbest kalan alanları geri almak,
- süreçleri birbirinden korumak,
- mantıksal adresleri fiziksel adreslere dönüştürmek,
- fiziksel bellekten daha büyük adres alanları sunabilmek.
5.2. Mantıksal ve Fiziksel Adres
Programın gördüğü adres ile gerçek RAM konumu aynı olmak zorunda değildir.
Sanal veya mantıksal adres, programın kullandığı adrestir.
Fiziksel adres, bellekteki gerçek konumdur.
Adres dönüşümü işlemcinin bellek yönetim birimi, yani MMU, tarafından işletim sisteminin oluşturduğu veri yapıları yardımıyla yapılır.
Bu ayrım modern bellek yönetiminin temelidir.
5.3. Değişmez Bölümlü Bellek
En basit çok programlı bellek yönetimlerinden biri belleği önceden belirlenen bölümlere ayırmaktır.
Her bölüm bir sürece verilir.
Yöntem basittir ancak ciddi bir sorun üretir.
Bir süreç kendisine ayrılan bölümden küçükse kullanılmayan alan boşa gider.
Bu kayıp iç parçalanma olarak adlandırılır.
5.4. Değişken Bölümlü Bellek
Bellek sabit boyutlu bölümlere ayrılmak yerine süreç gereksinimine göre bölünebilir.
Bu yaklaşım iç parçalanmayı azaltır.
Ancak zaman içinde küçük boşluklar oluşur.
Toplam boş alan yeterli olmasına rağmen tek parça halinde büyük bir süreç için kullanılamayabilir.
Bu durum external fragmentation olarak bilinir.
5.5. Boş Alan Seçme Algoritmaları
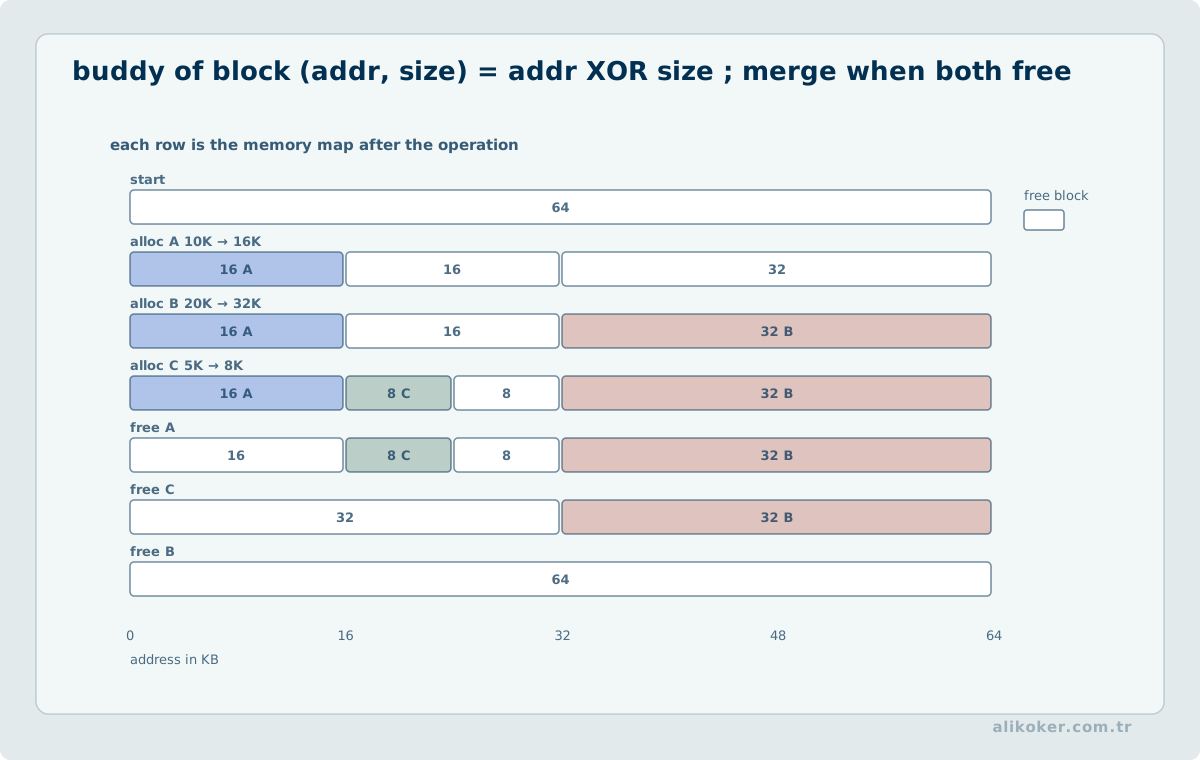
Değişken bölümlü yönetimde boş alan seçmek için klasik algoritmalar kullanılabilir.
First fit: İlk yeterli boşluğu seçer.
Best fit: İsteği karşılayan en küçük boşluğu seçer.
Worst fit: En büyük boşluğu seçer.
Hiçbiri bütün iş yüklerinde mutlak üstün değildir.
Bellek tahsis algoritmalarının davranışı iş yükündeki nesne boyutlarına ve tahsis ömürlerine bağlıdır.
5.6. Bitiştirme
Dış parçalanmayı azaltmak için kullanılan klasik yöntemlerden biri compaction işlemidir.
Kullanılan bellek bölgeleri taşınarak boş alanlar bir araya getirilir.
Bu işlem maliyetlidir. Bellekteki büyük miktarda verinin taşınmasını ve adreslerin yeniden düzenlenmesini gerektirebilir.
Sayfalama gibi modern yöntemlerin önemli avantajlarından biri fiziksel bellekte böyle bir bitişik alan zorunluluğunu büyük ölçüde ortadan kaldırmasıdır.
5.7. Yeniden Yerleştirme
Program bellekte her zaman aynı fiziksel adreste çalıştırılmak zorunda olmamalıdır.
Bu gereksinim relocation kavramını doğurur.
Mantıksal adres ile fiziksel adres arasındaki dönüşüm donanım desteğiyle yapılırsa süreç belleğin farklı bir fiziksel bölümüne yerleştirilebilir.
Sanal bellek bu düşüncenin çok daha gelişmiş biçimidir.
5.8. Swapping
Bellek baskısı oluştuğunda bir sürecin bazı veya tüm bellek içeriğinin ikincil depolamaya taşınması swapping olarak adlandırılır.
Klasik sistemlerde tüm süreç görüntüsü taşınabilirdi.
Modern sanal bellek sistemlerinde çoğunlukla süreç bütünü yerine belirli bellek sayfalarının geri kazanılması söz konusudur.
Kalıcı depolama RAM'den çok daha yavaş olduğundan yoğun swapping ciddi performans düşüşüne neden olabilir.
5.9. Sayfalama
Sayfalama fiziksel belleği sabit boyutlu frame'lere, sanal adres alanını aynı boyutlu page'lere böler.
Bir sanal adres iki parçadan oluşur:
sanal adres = sayfa numarası + sayfa içi ofsetSayfa numarası sayfa tablosunda aranır.
Elde edilen fiziksel frame numarası ofsetle birleştirilir.
virtual page
     ↓
page table
     ↓
physical frame
     +
offset
     ↓
physical address
Sayfalama fiziksel bellekte bitişik yer zorunluluğunu ortadan kaldırır.
5.10. Sayfa Tablosu
Her süreç sanal sayfaların fiziksel frame'lerle ilişkisini gösteren sayfa tablosuna sahiptir.
Bir sayfa tablosu girdisi yalnız frame numarasını içermez.
Genellikle şu tür durum bilgileri de bulunabilir:
- sayfa geçerli mi,
- okunabilir mi,
- yazılabilir mi,
- kullanıcı modundan erişilebilir mi,
- değiştirilmiş mi,
- yakın zamanda erişilmiş mi.
Bu bitler hem sanal bellek hem de koruma için kullanılır.
5.11. TLB
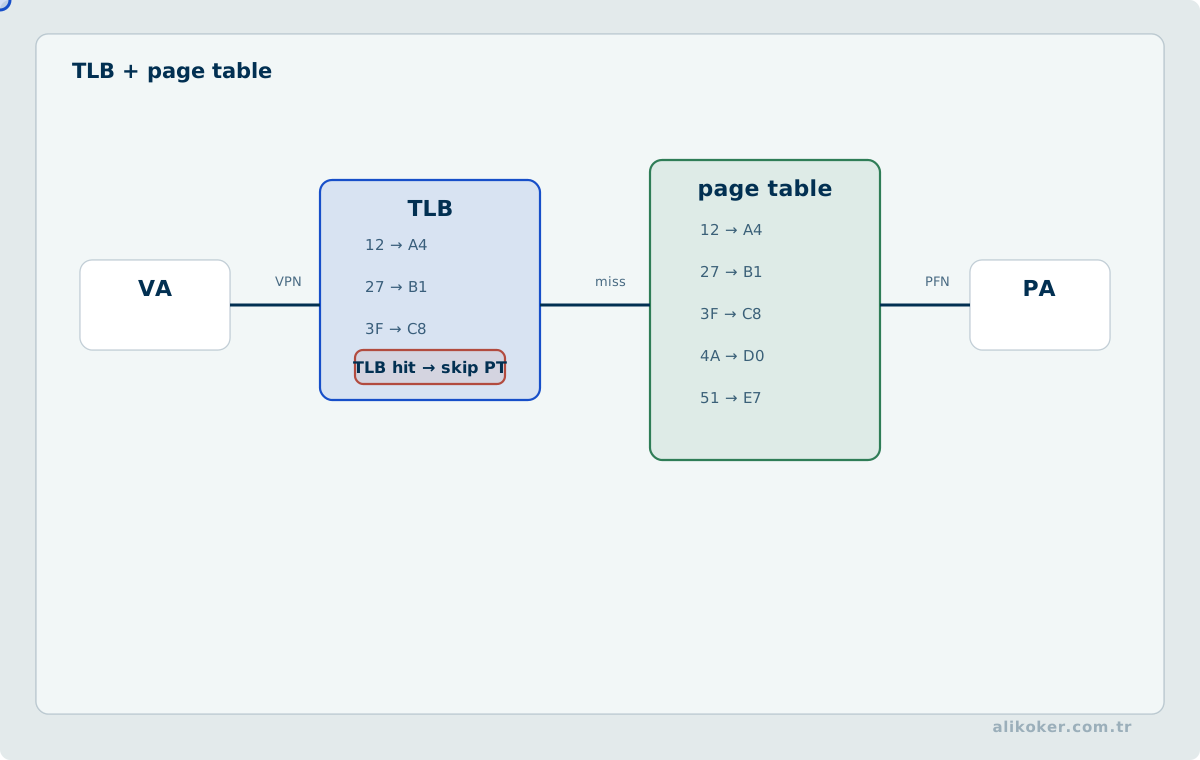
Her bellek erişiminde sayfa tablosunu RAM'den okumak pahalıdır.
Bu nedenle işlemciler son adres dönüşümlerini **TLB - Translation Lookaside Buffer** içinde saklar.
TLB isabetinde sayfa tablosuna gitmeye gerek kalmaz.
TLB kaçırıldığında gerekli adres dönüşümü sayfa tablolarından elde edilir.
Bellek erişim performansında TLB davranışı bu nedenle kritik önemdedir.
5.12. Çok Düzeyli Sayfa Tabloları
Geniş sanal adres alanlarında tek düzeyli sayfa tablosu çok büyük olabilir.
Çok düzeyli sayfa tabloları adres alanını hiyerarşik olarak böler.
Yalnız kullanılan bölümler için alt düzey tablo oluşturulabilir.
Modern 64 bit mimarilerde çok düzeyli adres dönüşümü yaygındır.
5.13. Bellek Koruması
Sayfalama yalnız adres çevrimi sağlamaz.
Her sayfaya erişim izinleri atanabilir.
Örneğin:
R   okuma
W   yazma
X   çalıştırma
Kod sayfaları salt okunur ve çalıştırılabilir tutulabilir.
Veri sayfalarının çalıştırılması engellenebilir.
Kullanıcı süreçlerinin çekirdek sayfalarına erişmesi donanım seviyesinde sınırlandırılabilir.
5.14. Kesimleme
Bölümleme, adres alanını programın mantıksal yapılarına göre değişken uzunluklu kesimlere ayırır.
Örneğin:
- kod,
- veri,
- yığıt
ayrı kesimler olabilir.
Bir mantıksal adres:
segment + offsetbiçiminde düşünülür.
Her segment için taban, sınır ve koruma bilgileri tutulabilir.
Sayfalama fiziksel bellek yönetimi açısından daha düzenli olduğu için modern genel amaçlı sistemlerde baskın mekanizmadır. Buna rağmen mantıksal bölge kavramı sanal adres alanlarında yaşamaya devam eder.
5.15. Sanal Bellek
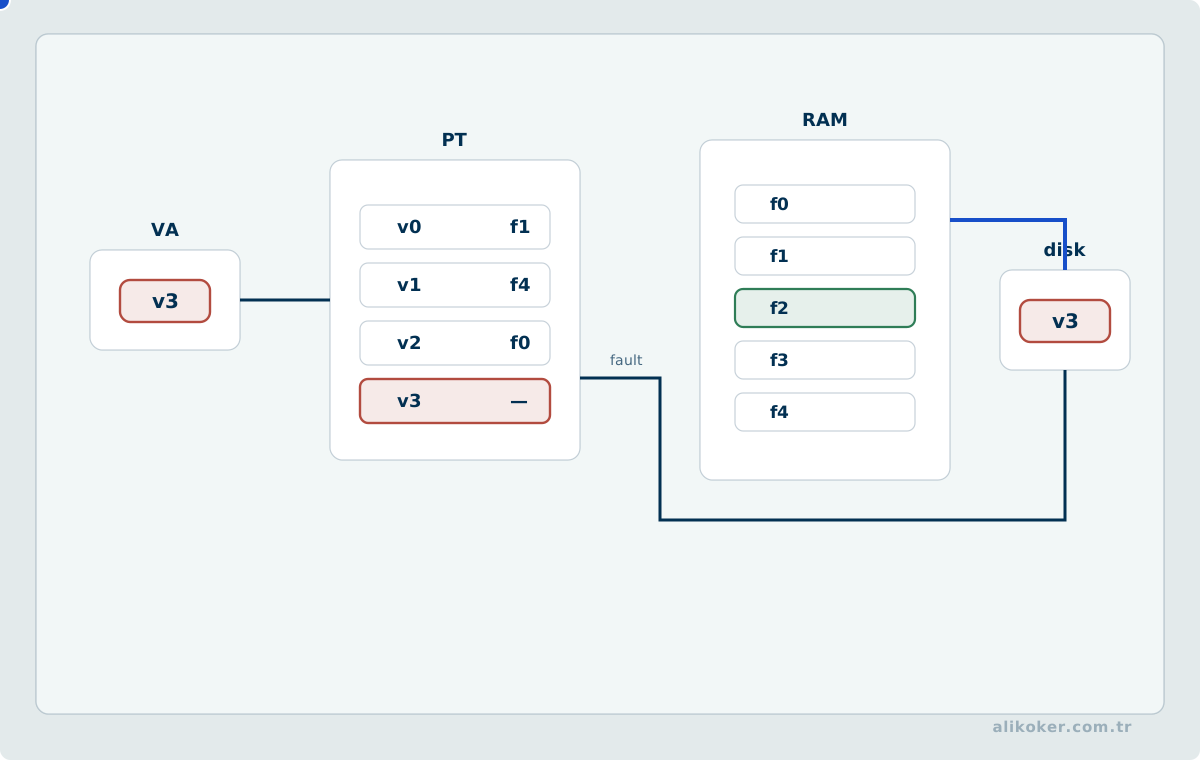
Sanal bellek, bir sürece fiziksel RAM'de aynı anda bulunandan daha büyük ve bağımsız bir adres alanı sunar.
Programın bütün sayfalarının RAM'de bulunması gerekmez.
Yalnız kullanılan sayfalar belleğe getirilebilir.
Bu yaklaşım demand paging olarak bilinir.
Linux'un güncel bellek yönetimi de süreç adres alanları, sayfa tabloları, page reclaim, swap ve page önbellek gibi mekanizmaları ayrı alt sistemler olarak yönetmektedir. (kernel.org)
Süreç oluşturulduğunda kopyala-yaz yaklaşımıyla paylaşılan sanal sayfalar, ilk yazma sırasında ayrı fiziksel sayfalara dönüşebilir. Bu nedenle büyük bir adres alanına sahip sürecin çoğaltılması ilk anda aynı büyüklükte bellek kopyası yapılacağı anlamına gelmez. Ancak çocuk ve ebeveyn süreç aynı büyük veri kümesine yazmaya başlarsa fiziksel bellek tüketimi hızla artabilir. Performans değerlendirmesinde ayrılmış sanal bellek, yerleşik fiziksel sayfalar ve paylaşılan sayfalar ayrı sayılmalıdır; tek başına adres alanı boyutu bellek baskısını göstermez.
5.16. Sayfa Hatası
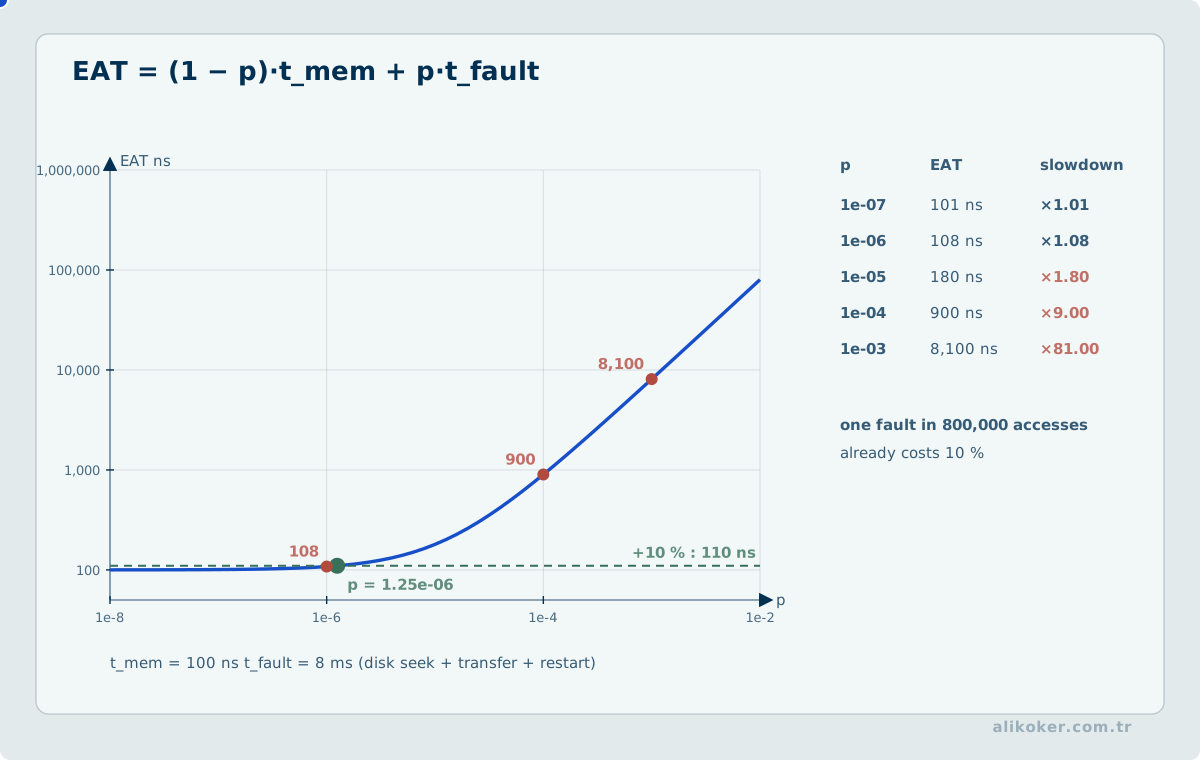
Program RAM'de bulunmayan ancak geçerli bir sanal sayfaya erişirse **sayfa hatası** oluşur.
İşletim sistemi:
- erişimin geçerli olup olmadığını denetler,
- uygun bir fiziksel frame bulur,
- gerekiyorsa başka bir sayfayı çıkarır,
- istenen sayfayı depolamadan yükler,
- sayfa tablosunu günceller,
- işlemi yeniden başlatır.
Disk veya SSD erişimi gerektiğinde sayfa hatası maliyeti sıradan RAM erişiminden çok büyüktür.
5.17. Sayfa Çıkarma Algoritmaları
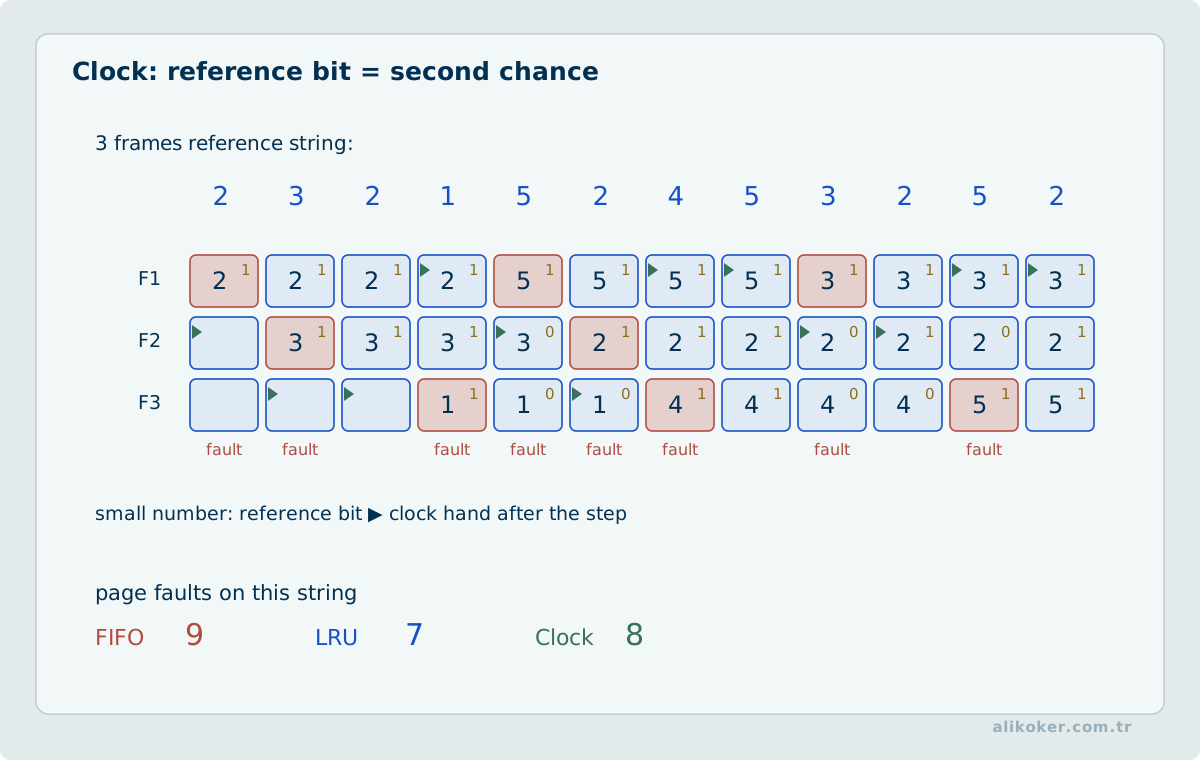
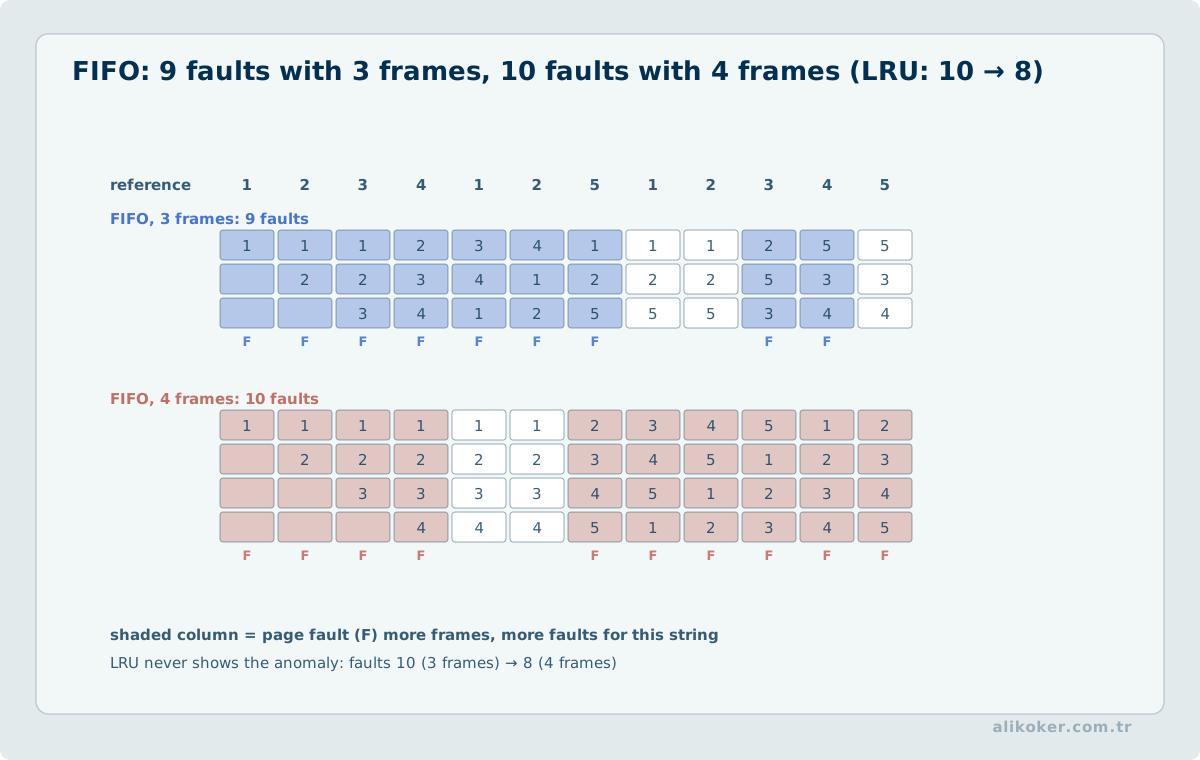
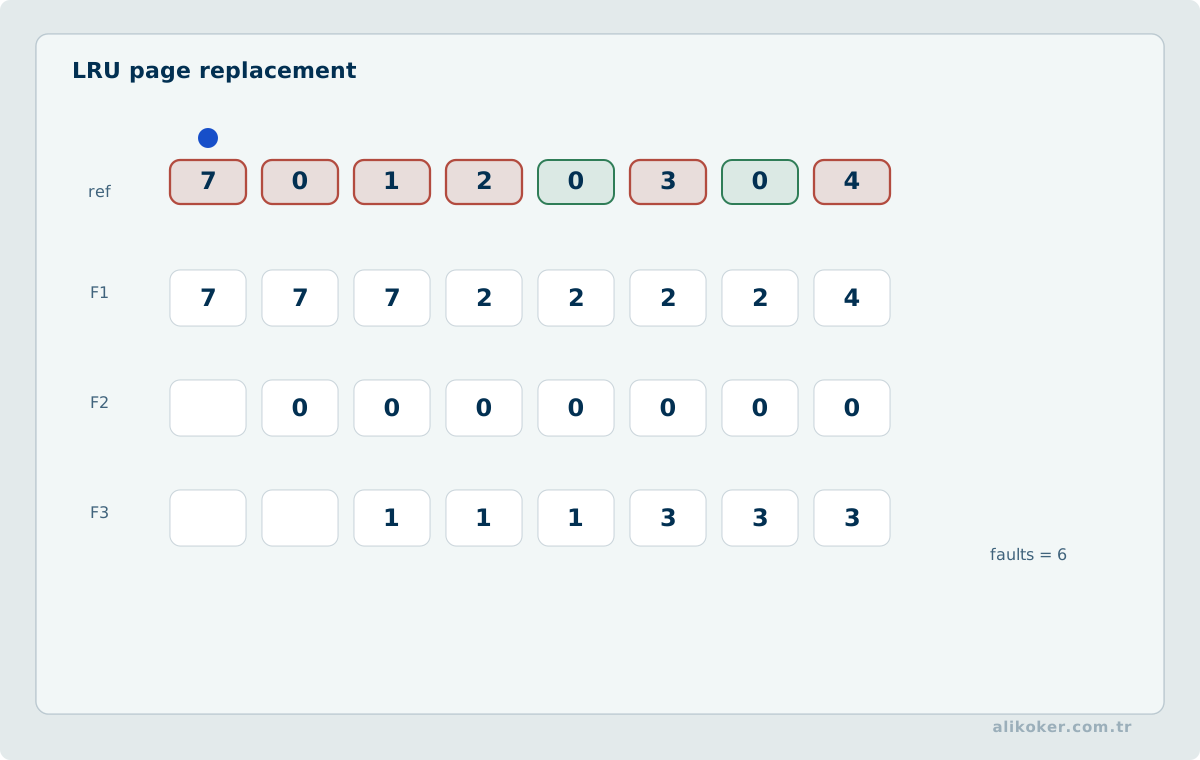
Boş frame kalmadığında hangi sayfanın çıkarılacağına karar verilmelidir.
5.17.1. FIFO
Belleğe en önce giren sayfa çıkarılır.
Uygulaması kolaydır ancak erişim davranışını dikkate almaz.
FIFO bazı durumlarda frame sayısı arttığında bile daha fazla sayfa hatası üretebilir. Bu olay Belady anomalisi olarak bilinir.
5.17.2. LRU
Least Recently Used, en uzun süredir erişilmeyen sayfayı çıkarmaya çalışır.
Programların zaman yerelliğinden yararlanır.
Tam LRU bilgisinin tutulması pahalı olabilir. Bu nedenle gerçek sistemler yaklaşık LRU davranışı sağlayan yöntemler kullanabilir.
5.17.3. Optimal
Gelecekte en uzun süre kullanılmayacak sayfa çıkarılır.
Bu yöntem en düşük mümkün sayfa hatası sayısını verir ancak gelecekteki erişimleri bilmek gerektiğinden gerçek sistemde uygulanamaz.
Karşılaştırma ölçütü olarak önemlidir.
5.18. Yerellik
Sanal belleğin çalışabilmesinin temel nedeni programların locality of reference özelliğidir.
Temporal locality: Yakın zamanda kullanılan veri tekrar kullanılma eğilimindedir.
Spatial locality: Bir adrese erişildiğinde yakın adreslere de erişilme olasılığı yüksektir.
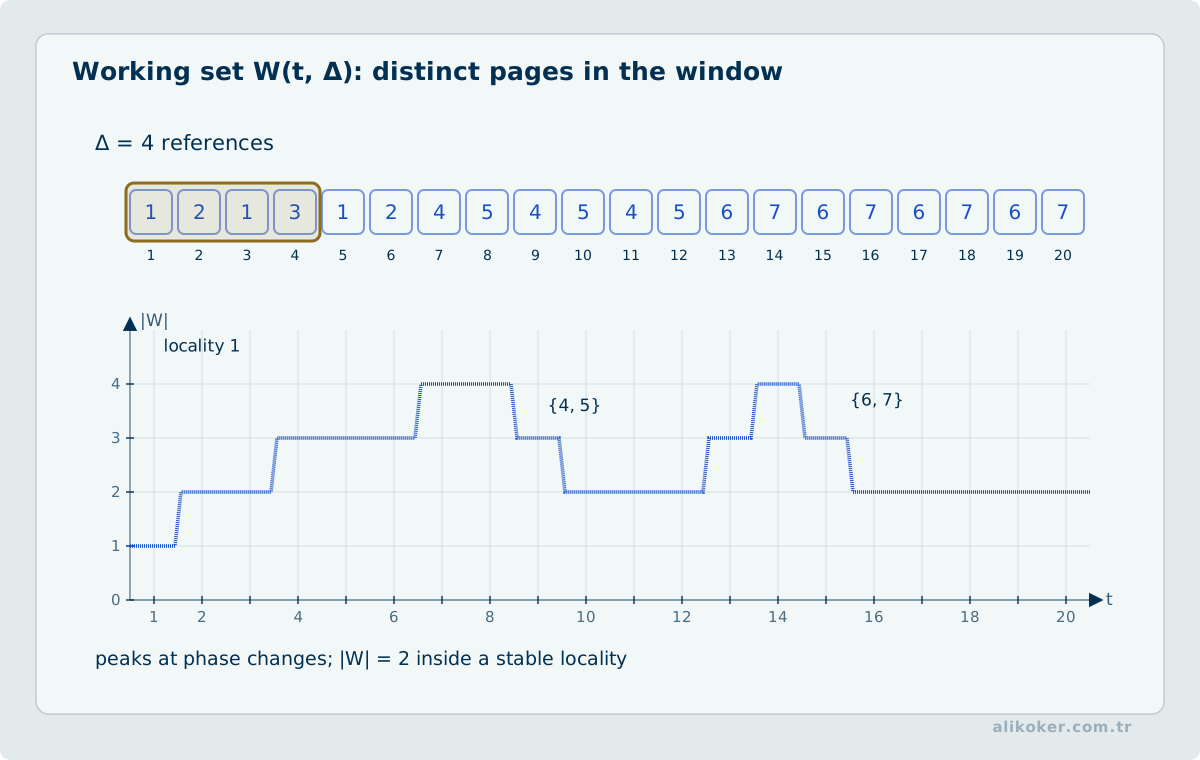
Program aktif çalışma kümesini bellekte tutabiliyorsa iyi performans gösterir.
Aktif sayfalar RAM'e sığmıyorsa sürekli sayfa değiştirme oluşabilir. Buna thrashing denir.
5.19. Kesimli ve Sayfalı Sanal Bellek
Kesimleme ile sayfalama birlikte kullanılabilir.
Mantıksal adres önce segmenti belirler. Segment içindeki sanal adres daha sonra sayfa tabloları üzerinden fiziksel frame'e çevrilir.
Bu yaklaşım kavramsal olarak:
mantıksal adres
     ↓
segment
     ↓
sanal sayfa
     ↓
page table
     ↓
physical frame
şeklinde düşünülebilir.
Modern işlemcilerde ayrıntılar mimariye bağlıdır. Kalıcı fikir, programın gördüğü adres alanının fiziksel RAM düzeninden soyutlanmasıdır.
5.20. Sayfalama ile Segmentasyonu Aynı Problem Sanmamak
Sayfalama ve segmentasyon ikisi de adres uzayını parçalara ayırır, fakat aynı soyutlamayı sağlamaz.
Sayfalama, sanal adres uzayını sabit boyutlu sayfalara ve fiziksel belleği aynı boyuttaki çerçevelere böler. Sabit boyut dış parçalanmayı önler; son sayfanın tam dolmaması gibi durumlarda iç parçalanma oluşabilir. Page table ve TLB, sanal sayfa numarasını fiziksel çerçeveye çevirmenin merkezindedir.
Segmentasyon ise programı mantıksal ve değişken boyutlu bölgelere ayırır. Kod, yığın, heap veya ayrı veri bölgeleri farklı segmentler olarak modellenebilir. Değişken boyutlu yerleştirme zaman içinde boşlukların dağılmasına ve dış parçalanmaya yol açabilir; tarihsel sistemlerde compaction bu maliyeti azaltmak için kullanılabilmiştir.
Fark şu şekilde özetlenebilir:
sayfa       -> sabit boyut, fiziksel yerleştirme ve sanal bellek mekanizmasına uygun
segment     -> değişken boyut, mantıksal bölge ve koruma/paylaşım sınırını ifade etmeye uygun
İki yaklaşım birlikte de kullanılabilir. Segment numarası ilgili sayfa tablosunu seçer, segment içindeki sanal sayfa da fiziksel çerçeveye çevrilir. Böyle bir tasarım mantıksal koruma sınırlarını sayfalamanın fiziksel yerleştirme esnekliğiyle birleştirir; karşılığında çeviri yapısı ve yönetim maliyeti artar.
Modern 64-bit genel amaçlı sistemlerde sanal bellek ağırlıklı olarak sayfalama üzerinden yürütülür. Buna rağmen segmentasyon kavramı; değişken boyutlu yerleştirme, koruma alanı ve tarihsel mimari tasarımlarını anlamak için önemini korur.
Süreç belleği ile yönetilen çalışma zamanı heap'i farklı kapsamlardır. Java örneğinde heap üst sınırı süreç için üst bellek sınırı değildir. Yerel bellek ayırmaları, thread stack'leri, bellek eşlemeleri, direct buffer'lar ve runtime metadata OS tarafından izlenen adres alanı ile fiziksel bellek kullanımını değiştirir. Konteynerde memory.max gibi cgroup sınırına ulaşılması, uygulamanın heap içindeki serbest alanı sıfırlanmadan da OOM kill ile sonuçlanabilir.
Bellek tanısında sanal adres alanı (VSZ), resident set (RSS), major/minor page fault, swap baskısı ve cgroup sayacı aynı kavram gibi okunmamalıdır. Fiziksel bellek baskısı altında yoğun page fault, uygulama CPU kullanımını artırmadan gecikmeyi büyütebilir. Bu yüzden JVM GC çizelgesi, işletim sisteminin bellek baskısı ve I/O beklemesiyle zaman bakımından ilişkilendirilerek yorumlanmalıdır.
Ünite 6: Kütük ve Dosya Yönetimi
6.1. Dosya Kavramı
Ders terminolojisindeki kütük, güncel kullanımda dosya olarak adlandırılır.
Dosya, kalıcı depolamada tutulan adlandırılmış veri bütünüdür.
İşletim sistemi fiziksel depolama ayrıntılarını kullanıcıdan gizler.
Program:
dosyayı aç
veriyi oku
veriyi yaz
konumu değiştir
dosyayı kapat
gibi mantıksal işlemler kullanır.
Dosyanın fiziksel olarak hangi bloklarda saklandığını bilmek zorunda değildir.
6.2. Dosya Öznitelikleri
Dosya sistemi dosyanın içeriği dışında üstveri da tutar.
Tipik bilgiler:
- ad,
- tür,
- boyut,
- sahip,
- grup,
- izinler,
- zaman bilgileri,
- fiziksel yer bilgileri,
- bağlantı sayısı.
Dosyanın adı ile fiziksel verisinin aynı yapı olması gerekmez. Ad genellikle dizin yapısındaki bir kayıt üzerinden dosyanın üstveri nesnesine bağlanır.
6.3. Dizin Yapısı
Dosyaların tek düzeyde tutulması büyük sistemler için yetersizdir.
Bu nedenle hiyerarşik dizin yapısı kullanılır.
Örnek:
/
├── home
│   └── user
│       ├── documents
│       └── projects
└── var
    └── log
Bir dosya absolute path veya relative path ile belirtilebilir.
Hiyerarşi ad çakışmalarını azaltır ve verilerin mantıksal olarak gruplandırılmasını sağlar.
6.4. Temel Dosya İşlemleri
Dosya sistemi tipik olarak şu işlemleri sağlar:
- create,
- open,
- close,
- read,
- write,
- seek,
- truncate,
- rename,
- delete,
- stat.
Unix benzeri sistemlerde açık dosya çoğunlukla bir file descriptor ile temsil edilir.
open() bir descriptor döndürür. Sonraki read() ve write() çağrıları bu descriptor üzerinden yapılır.
Bu yapı uygulamanın fiziksel dosya sistemi ayrıntılarından bağımsız çalışmasını sağlar.
6.5. Fiziksel Depolama
Klasik dosya sistemi anlatımı dönen manyetik diskleri temel alır.
Bu disklerde erişim süresi:
- kafa hareketi,
- döndürme gecikmesi,
- veri aktarımı
gibi bileşenlerden etkilenir.
SSD'lerde mekanik kafa ve döndürme gecikmesi yoktur. Bunun yerine flash sayfaları, silme blokları (erase blocks), denetleyici, wear leveling ve flash translation layer gibi farklı özellikler vardır.
Bu nedenle modern dosya sistemi optimizasyonunda yalnız klasik disk geometrisine göre düşünmek doğru değildir.
Buna rağmen işletim sistemi depolamayı mantıksal bloklar üzerinden yönetmeye devam eder.
6.6. Dosya Sistemi Katmanları
Dosya erişimi birkaç soyutlama düzeyinden geçebilir:
uygulama
   ↓
sistem çağrısı
   ↓
VFS
   ↓
dosya sistemi
   ↓
önbellek
   ↓
blok G/Ç
   ↓
aygıt sürücüsü
   ↓
depolama aygıtı
Linux'taki Virtual File System farklı dosya sistemi gerçekleştirimlerinin ortak open, read, write, stat gibi arayüzlerle kullanılmasını sağlayan çekirdek soyutlama katmanıdır. (docs.kernel.org)
6.7. FAT Yaklaşımı
FAT ailesinde depolama bloklarının bağlantıları merkezi bir File Bellek ayırma Table içinde tutulur.
Bir dosyanın ilk kümesi bilindiğinde zincir tablo üzerinden izlenebilir.
Yöntem basit ve taşınabilirdir.
Ancak çok büyük dosya sistemlerinde merkezi tablo ve zincir yapısı ölçeklenebilirlik açısından sınırlıdır.
FAT bugün de çeşitli çıkarılabilir depolama ortamlarında kullanılmasına rağmen modern genel amaçlı dosya sistemlerinin tek modeli değildir.
6.8. İnode
Unix ailesinin önemli kavramlarından biri inode yapısıdır.
inode dosyanın:
- türünü,
- izinlerini,
- sahibini,
- boyutunu,
- zaman bilgilerini,
- veri bloklarına erişim bilgilerini
tutar.
Dosya adı doğrudan inode'un kendisinde tutulmak zorunda değildir. Dizin kaydı adı inode benzeri üstveri nesnesine eşler.
Bu ayrım hard link kavramının da temelidir.
6.9. Bağlantılar
Bir dosyanın aynı dosya sistemi içinde birden fazla adı olabilir.
Hard link, aynı dosya nesnesine başka bir dizin girdisi oluşturur.
Symbolic link, başka bir yol adını içeren ayrı bir dosya nesnesidir.
Hard link ve symbolic link aynı mekanizma değildir.
6.10. Bitişik Yer Ayırma
Dosyanın blokları fiziksel olarak ardışık tutulabilir.
Avantajları:
- basit üstveri,
- yüksek sıralı erişim performansı,
- hızlı rastgele erişim.
Sorunları:
- dosyanın gelecekteki boyutunu tahmin etmek güçtür,
- büyüme zor olabilir,
- dış parçalanma oluşabilir.
Modern dosya sistemlerinde bunun geliştirilmiş biçimi olan extent yapıları yaygın olarak kullanılır. Tek tek blok yerine ardışık blok aralıkları tanımlanır.
6.11. Zincirli Yer Ayırma
Her blok bir sonraki bloğun adresini taşır.
Dosyanın büyümesi kolaydır.
Ancak rastgele erişim verimsizdir. Bir bloğa ulaşmak için önceki bağlantıların izlenmesi gerekebilir.
Bağlantı bilgisi bozulduğunda zincirin geri kalanı kaybedilebilir.
FAT yaklaşımı bağlantı bilgisini blokların içinden alıp merkezi tabloya taşıyarak bu modelin bir çeşidini uygular.
6.12. Dizinli Yer Ayırma
Dosyanın veri bloklarının adresleri bir dizin yapısında tutulabilir.
Bu yöntem rastgele erişimi kolaylaştırır.
Unix inode yapısındaki doğrudan ve dolaylı blok göstergeleri bunun klasik örneklerindendir.
Modern dosya sistemleri büyük dosyalar için ağaç yapıları ve extent tabanlı üstveri kullanabilir.
6.13. Dosya Önbelleği
Depolama erişimi RAM erişiminden çok daha yavaştır.
Bu nedenle sık kullanılan dosya verileri ana bellekte önbelleğe alınır.
Okuma sırasında veri önbellekte bulunursa fiziksel aygıta erişmek gerekmez.
Yazma işlemleri de bazı sistemlerde önce bellekte tutulup daha sonra depolamaya aktarılabilir.
Bu yaklaşım performansı artırır ancak güç kesintisi ve sistem çökmesi sırasında tutarlılık sorunları yaratabilir.
6.14. Yazma Stratejileri
Write-through yaklaşımında değişiklik kısa sürede kalıcı depolamaya aktarılır.
Write-back yaklaşımında değişiklik önce bellekte tutulur ve daha sonra yazılır.
Write-back daha yüksek performans sağlayabilir ancak henüz kalıcı hale gelmemiş verinin kaybedilme riski vardır.
Bu nedenle dosya sistemi güvenilirliği yalnız veri bloklarının değil üstveri güncellemelerinin de doğru sıralanmasını gerektirir.
6.15. Dosya Sistemi Tutarlılığı
Bir dosya oluşturulurken birden fazla üstveri yapısı değişebilir.
Sistem bu işlemlerin ortasında çökerse dosya sistemi kısmen güncellenmiş durumda kalabilir.
Modern dosya sistemleri bu sorunu azaltmak için:
- günlükleme,
- copy-on-write,
- sağlama toplamı,
- atomic üstveri update
gibi tekniklerden yararlanabilir.
Her teknik aynı garanti seviyesini vermez.
6.16. RAID
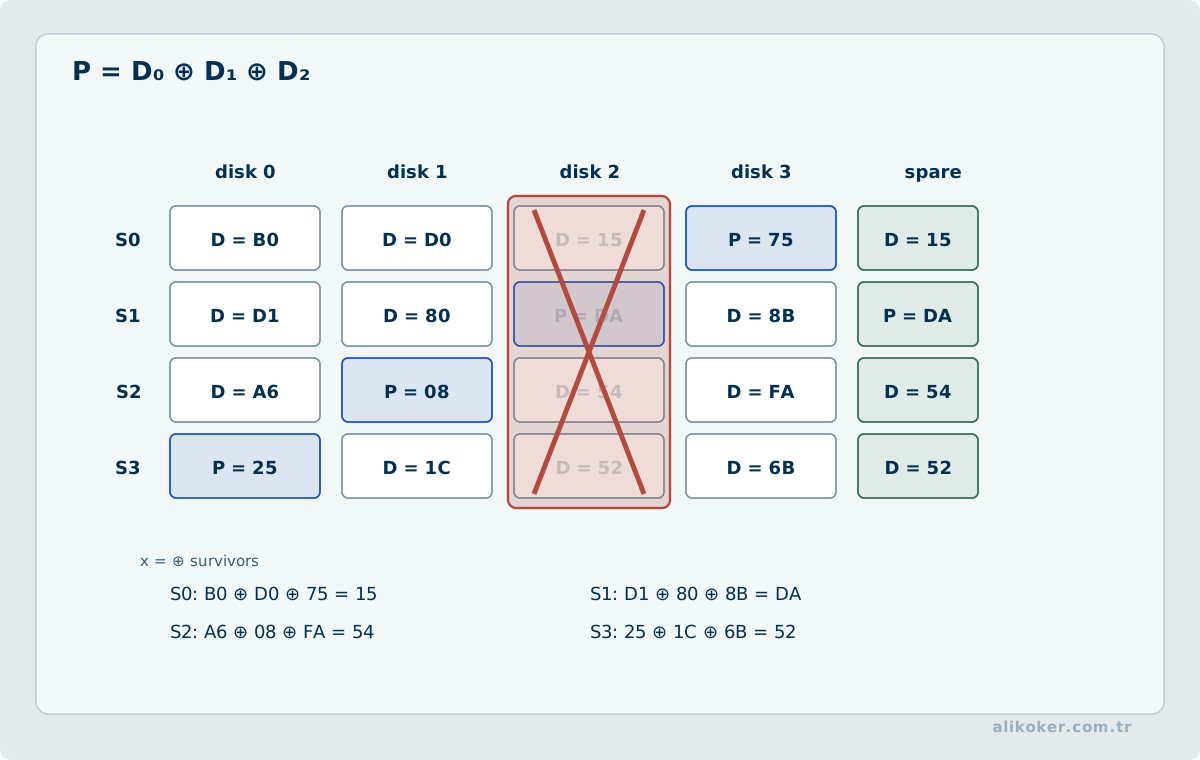
RAID birden fazla fiziksel depolama aygıtını performans veya hata toleransı amacıyla birlikte kullanma yaklaşımıdır.
Örnek düzeyler:
RAID 0: Striping. Performans ve kapasite sağlar, yedeklilik sağlamaz.
RAID 1: Mirroring. Veri iki veya daha fazla kopya halinde tutulur.
RAID 5: Dağıtılmış parity ile tek disk arızasına tolerans sağlar.
RAID 6: İki bağımsız parity bilgisiyle iki disk arızasına tolerans sağlayabilir.
RAID veri erişilebilirliğini artırabilir ancak yedekleme değildir.
Yanlışlıkla silinen, şifrelenen veya bozuk yazılan veri RAID kopyalarına da yayılabilir.
6.17. Dosya Değiştirmede Atomiklik ve Çökme Dayanıklılığı
Geçici dosyaya yazıp aynı dosya sistemi içinde hedef adına yeniden adlandırma işlemi yapmak, görünürlüğün atomik olmasını sağlayabilir; ancak bu, güç kesintisinden sonra yeni verinin kesinlikle kalacağı anlamına gelmez. Veri önce sayfa önbelleğine ulaşabilir; ardından dosya içeriğinin ve dizin girişinin kalıcılığı farklı eşitleme işlemlerine bağlı olur. POSIX benzeri yerel dosya sistemlerinde yaygın güvenli sıra, geçici dosyayı yazmak, dosyayı fsync ile eşitlemek, hedefe rename etmek ve bulunduğu dizini fsync ile eşitlemektir. Bu sıra bile aygıtın flush garantileri ve dosya sisteminin uyguladığı semantik ile sınırlıdır.
fsync başarılı döndüğünde dahi uzak depolama, NFS sunucusu, RAID denetleyicisi ve aygıt önbelleği aynı dayanıklılık sözleşmesini paylaşmayabilir. Günlükleme dosya sistemi metadata tutarlılığını hedefleyebilir; uygulamanın birden fazla dosyada gerçekleştirdiği işlevsel transaction için genel atomiklik sağlamaz. Deneysel geçerleme, süreç çökmesi ile sistem güç kaybını ayırmalı; yeniden açılış sonrasında dosya içeriklerini, adlarını ve bütünlük koşullarını doğrulamalıdır.
Ünite 7: Güvenlik ve Koruma
7.1. Güvenlik ve Koruma Ayrımı
İşletim sisteminde koruma, sistem kaynaklarının hangi süreç veya kullanıcı tarafından nasıl kullanılabileceğini sınırlar.
Güvenlik daha geniştir. Yetkisiz erişim, veri sızıntısı, kimlik taklidi ve kötü amaçlı yazılım gibi tehditleri de kapsar.
Temel güvenlik hedefleri:
- gizlilik,
- bütünlük,
- kullanılabilirliktir.
7.2. Kimlik Doğrulama
Sisteme erişmeden önce kullanıcının iddia ettiği kişi olduğunun doğrulanması gerekir.
Kimlik doğrulama faktörleri genel olarak üç gruptur:
- bildiğiniz şey,
- sahip olduğunuz şey,
- olduğunuz şey.
Parola ilk gruba, güvenlik anahtarı veya akıllı kart ikinci gruba, biyometrik özellikler üçüncü gruba girer.
Birden fazla bağımsız faktörün birlikte kullanılması çok faktörlü kimlik doğrulamadır.
7.3. Parolalar
Parola doğrulama sisteminin parolayı düz metin biçiminde saklaması doğru değildir.
Parolalar parola saklamaya uygun bir türetme işleviyle ve kullanıcıya özgü salt ile işlenmelidir.
Modern yaklaşım yalnız karmaşık karakter kuralları dayatmak değildir. Yeterli uzunluk, bilinen zayıf veya ele geçirilmiş parolaların engellenmesi ve çevrim içi deneme saldırılarına karşı koruma daha önemlidir. NIST'in güncel dijital kimlik doğrulama kılavuzu da katı karakter bileşimi kuralları yerine uzunluk ve blocklist yaklaşımını öne çıkarmaktadır. (pages.nist.gov)
Parolanın önemli bir sınırlaması phishing'e dirençli olmamasıdır.
7.4. Yetkilendirme
Kimlik doğrulama:
Siz kimsiniz?
sorusunu yanıtlar.
Yetkilendirme ise:
Neye erişebilirsiniz?
sorusunu yanıtlar.
Bu iki aşama birbirinden ayrılmalıdır.
7.5. Erişim Matrisi
Erişim denetiminin temel modellerinden biri erişim matrisidir.
Satırlar kullanıcı, süreç veya koruma alanlarını; sütunlar nesneleri gösterir.
Hücrelerde izinler bulunur.
Örneğin:
- Özne: Kullanıcı 1; Dosya A: R/W; Dosya B: R; Aygıt: -
- Özne: Kullanıcı 2; Dosya A: R; Dosya B: -; Aygıt: X
Bu matris kuramsal olarak açıktır ancak gerçek sistemlerde tamamını tutmak verimsiz olabilir.
Bu nedenle satır veya sütun yönünde seyrek gösterimler kullanılır.
7.6. Erişim Denetim Listeleri
ACL - Access Control List, nesne merkezli yaklaşımdır.
Her nesne kendisine kimlerin hangi haklarla erişebileceğini tutar.
Örneğin bir dosya:
Ali      read, write
Ayşe     read
GrupA    read
gibi bir erişim listesine sahip olabilir.
7.7. Capability Yaklaşımı
Capability tabanlı sistemde özne, erişme yetkisine sahip olduğu nesneleri ve hakları temsil eden yeteneklere sahip olur.
Bu yaklaşım erişim matrisinin satır yönünden gerçekleştirimine benzetilebilir.
Modern güvenlik mimarilerinde capability sözcüğü farklı bağlamlarda farklı teknik ayrıntılar taşıyabilir. Temel fikir yetkinin açık ve sınırlandırılmış bir nesne olarak temsil edilmesidir.
7.8. Koruma Halkaları
İşlemciler farklı ayrıcalık düzeylerini donanımsal olarak destekleyebilir.
Genel amaçlı işletim sistemlerinde en önemli ayrım:
- kullanıcı modu,
- çekirdek modu
arasındadır.
Kullanıcı modundaki uygulama kritik işlemci durumunu veya çekirdek belleğini doğrudan değiştiremez.
Sistem çağrısı kontrollü bir ayrıcalık geçişi sağlar.
Bu mekanizma hatalı bir kullanıcı programının tüm sistemi bozmasını engelleyen temel savunmalardan biridir.
7.9. En Az Ayrıcalık İlkesi
Bir bileşene yalnız görevini yerine getirmesi için gerekli yetkiler verilmelidir.
Bu ilkeye least privilege denir.
Bir medya dönüştürücü ağ yapılandırmasını değiştirmek zorunda değilse bu yetkiye sahip olmamalıdır.
Bir sunucu süreci yalnız belirli bir dizine yazacaksa bütün dosya sistemine yazma izni gereksizdir.
Sınırlı yetki bir açık bulunduğunda saldırganın elde edeceği etki alanını azaltır.
7.10. Simetrik Şifreleme
Simetrik şifrelemede aynı gizli anahtar şifreleme ve çözme işlemlerinin temelidir.
Genellikle yüksek hacimli verinin korunmasında etkilidir.
Ana sorun anahtarın taraflar arasında güvenli biçimde paylaşılmasıdır.
7.11. Asimetrik Şifreleme
Asimetrik şifrelemede matematiksel olarak ilişkili açık ve özel anahtar çifti kullanılır.
Açık anahtar paylaşılabilir. Özel anahtar gizli tutulur.
Bu yapı:
- dijital imza,
- anahtar değişimi,
- kimlik doğrulama
gibi işlemlerde kullanılır.
Pratik güvenli haberleşme protokolleri çoğunlukla asimetrik ve simetrik teknikleri birlikte kullanır.
7.12. Özet İşlevleri
Kriptografik hash işlevi girdiden sabit uzunluklu özet üretir.
Şifreleme ile hash aynı şey değildir.
Şifreleme geri çözülebilir bir dönüşüm olarak tasarlanır.
Kriptografik hash ise tek yönlü kullanım amaçlar.
Hash değerleri bütünlük denetiminde, dijital imzalarda ve parola saklama yapılarının bazı bileşenlerinde kullanılabilir.
7.13. Bilgisayar Virüsleri
Virüs başka bir çalıştırılabilir içeriğe bağlanarak veya çalışma ortamına yerleşerek çoğalmaya çalışan kötü amaçlı yazılımdır.
Virüsün yalnız dosya uzantısı veya program adı üzerinden tanımlanması yeterli değildir. Temel özellik yayılmak için başka içerik veya yürütme mekanizmasından yararlanmasıdır.
7.14. Bilgisayar Kurtları
Worm, ağ üzerinden kendini yayabilen kötü amaçlı yazılım sınıfıdır.
Virüsten önemli farkı yayılmak için kullanıcının başka bir dosyayı kopyalamasına veya virüs taşıyan bir programı dağıtmasına ihtiyaç duymayabilmesidir.
Modern tehdit ortamında ransomware, kimlik bilgisi stealing, kernel exploit ve supply-chain saldırıları gibi başka zararlı yazılım ve saldırı sınıfları da önemlidir.
İşletim sistemi bunlara karşı tek başına tam güvenlik sağlayamaz. Ancak şu mekanizmalar saldırı yüzeyini azaltır:
- süreç izolasyonu,
- bellek koruması,
- ayrıcalık ayrımı,
- erişim denetimi,
- güvenli güncelleme,
- kod imzalama,
- yürütme izinleri,
- sandbox,
- denetim kayıtları.
7.15. Sırların Bellekteki Yaşam Döngüsü
Kriptografik anahtarın disk üzerinde şifreli saklanması onu çalışmakta olan sürecin belleğinde otomatik olarak korumaz. Anahtar kullanımı sırasında nesne kopyaları, takas alanı, çökme dökümleri ve tanılama günlükleri hesaba katılmalıdır. Bellek temizleme çağrısının derleyici tarafından optimize edilmesi veya dil çalışma zamanındaki taşınabilir nesnelerin başka kopya bırakması mümkündür. Bu yüzden hassas veri için doğrulanmış kitaplık, kontrollü yaşam döngüsü ve en az ayrıcalık ilkesi birlikte uygulanır.
Rastgelelik için işletim sistemi CSPRNG arayüzü kullanılırken başlangıç/yeniden başlatma koşulları, konteyner çoğaltma ve cihaz entropisi de risk modeline dahildir. Bellek güvenliği önlemleri kriptografik güvenlik tanımının yerini almaz; Kriptoloji bu temel varsayımları açıklar.
Ünite 8: Aygıt Sürücüleri
8.1. Aygıt Sürücüsünün Görevi
Aygıt sürücüsü belirli bir donanım veya aygıt sınıfını işletim sisteminin ortak G/Ç modeline bağlayan yazılım bileşenidir.
Uygulama:
read()çağrısını yapabilir.
Dosya sistemi veya G/Ç katmanı bu isteği ilgili sürücüye kadar iletir.
Sürücü ise bunu donanımın anlayacağı:
- yazmaç işlemleri,
- DMA tanımları,
- kuyruk girdileri,
- aygıt komutları
haline dönüştürür.
Bu nedenle sürücü, genel işletim sistemi arayüzü ile donanıma özgü gerçekleştirim arasındaki sınırdır.
8.2. Sürücülerin Çekirdek İçindeki Konumu
Birçok sürücü çekirdek ayrıcalıklarıyla çalışır.
Bu durum performans ve donanım erişimi açısından gereklidir ancak hata etkisini büyütür.
Bir çekirdek sürücüsündeki:
- geçersiz bellek erişimi,
- yarış durumu,
- kilitlenme,
- yanlış DMA adresi
yalnız uygulamayı değil tüm sistemi etkileyebilir.
Bu nedenle sürücü kodunda kaynak yaşam döngüsü, eşzamanlama ve hata yolları özellikle önemlidir.
8.3. Aygıt Sınıfları
Unix/Linux geleneğinde iki temel aygıt sınıfı öne çıkar.
Character device, veriyi bayt veya akış mantığında sunar.
Block device, veriyi adreslenebilir bloklar halinde sunar.
Terminal, seri aygıt ve çeşitli denetim aygıtları karakter aygıtı olarak modellenebilir.
SSD ve disk gibi depolama aygıtları blok aygıt modeline bağlanır.
Modern Linux sürücü modeli bundan çok daha geniştir. PCI, USB, platform aygıtları, ağ, grafik, giriş, medya ve diğer alt sistemler kendi çerçevelerini kullanır. Güncel Linux çekirdek belgeleri sürücü modeli, DMA, PCI, USB, Virtio ve çeşitli veri yolu alt sistemlerini ayrı API katmanları olarak ele almaktadır. (cdn.kernel.org)
8.4. Aygıt Dosyaları
Unix geleneğinde birçok aygıt /dev altında dosya benzeri nesnelerle temsil edilir.
Örneğin kullanıcı alanındaki program bir aygıtı open() ile açabilir ve uygun olduğunda read(), write() veya ioctl() gibi işlemler kullanabilir.
Bu modelin güçlü yanı uygulamaya ortak bir arayüz sunmasıdır.
Her aygıtın sıradan dosya gibi davranması gerekmez. Ağ arabirimleri ve grafik aygıtları gibi alt sistemler daha özel API'lere sahip olabilir.
8.5. Aygıtın Sisteme Bağlanması
Modern sürücü mimarisinde sürücünün görevi yalnız modül yüklendiğinde belirli bir init işlevi çalıştırmak değildir.
Aygıt ve sürücünün eşleştirilmesi veri yolu ve aygıt modeli üzerinden yapılabilir.
Örneğin:
- PCI kimlikleri,
- USB kimlikleri,
- firmware tabloları,
- Device Tree,
- ACPI
gibi mekanizmalar donanımın tanınmasında kullanılabilir.
Sürücü uygun aygıtla eşleştiğinde kaynaklarını edinir ve aygıtı kullanıma hazırlar.
8.6. Kaynak Yönetimi
Sürücü tipik olarak şu kaynakları yönetebilir:
- MMIO bölgeleri,
- kesilmeler,
- DMA tamponları,
- saat kaynakları,
- güç durumları,
- aygıt kuyrukları,
- çekirdek belleği.
Başlatma işleminin herhangi bir aşaması başarısız olabilir.
Bu nedenle daha önce alınan kaynakların ters sırayla güvenli şekilde serbest bırakılması gerekir.
Kaynak yaşam döngüsü sürücü güvenilirliğinin temelidir.
8.7. Dinamik Bellek
Çekirdek kodu da dinamik bellek kullanabilir ancak kullanıcı alanındaki bellek kullanımından farklı kurallara tabidir.
Linux bağlamında kmalloc() ve vmalloc() gibi mekanizmalar farklı bellek özellikleri sunar.
kmalloc() ile alınan alan çekirdek sanal adres uzayında bitişiktir ve belirli kullanım türlerinde fiziksel düzen bakımından ek garantiler sağlayabilir.
vmalloc() ise sanal olarak bitişik bir alan oluşturabilir ancak fiziksel sayfaların bitişik olması gerekmez.
Bu ayrım özellikle DMA için önemlidir.
8.8. MMIO
Modern aygıtların denetim yazmaçları sıklıkla fiziksel adres uzayına eşlenir.
Sürücü bu alanı çekirdek sanal adres uzayına eşledikten sonra özel MMIO erişim yordamlarıyla kullanır.
Normal RAM erişimi ile MMIO erişimi aynı kabul edilmemelidir.
Donanım sıralaması, bariyerler ve mimariye özgü erişim kuralları önem taşıyabilir.
8.9. Kesilme Yordamları
Aygıt işlemi tamamlandığında kesilme üretebilir.
Sürücü kesilme hizmet yordamında:
- kesilme kaynağını doğrular,
- aygıt durumunu işler,
- gerekirse aktarımı tamamlar,
- bekleyen çalışmayı uyandırır.
Kesilme bağlamında uzun süren işlem yapılmaması önemlidir.
Daha ağır işler workqueue veya ilgili alt sistemin ertelenmiş çalışma mekanizmalarına aktarılabilir.
8.10. DMA
Yüksek hızlı aygıtların veri transferini CPU üzerinden kopyalamak verimsizdir.
Sürücüler DMA ile aygıtın belleğe doğrudan veri aktarmasını sağlayabilir.
Ancak sürücü doğrudan sıradan bir sanal adresi aygıta veremez.
DMA eşleme katmanı:
- CPU adres alanı,
- fiziksel bellek,
- aygıt adres alanı
arasındaki gerekli dönüşümü yönetir.
IOMMU bulunan sistemlerde aygıtın görebildiği adres ayrıca çevrilebilir. Bu yapı hem sanallaştırma hem de erişim sınırlandırması açısından önemlidir. (docs.kernel.org)
8.11. Character Driver İşlemleri
Karakter aygıtlarında tipik kullanıcı işlemleri şunlardır:
- open,
- release/close,
- read,
- write,
- poll,
- mmap,
- ioctl.
Her sürücünün bunların tümünü sağlaması gerekmez.
ioctl() standart okuma/yazma modeline uymayan aygıt denetim işlemleri için kullanılabilir. Ancak kullanıcı-çekirdek ABI'sinin dikkatli tasarlanması gerekir.
8.12. Blok Sürücüler
Blok aygıt sürücüsü dosya sisteminden gelen mantıksal blok isteklerini fiziksel depolama aygıtının komutlarına dönüştürür.
Modern depolama aygıtlarında çoklu kuyruklar ve paralel komut yürütme önemlidir.
Bu nedenle eski tek request() kuyruğu üzerine kurulmuş blok sürücüsü örnekleri güncel Linux çekirdek mimarisini temsil etmez.
Kalıcı kavram şudur:
dosya sistemi isteği
       ↓
blok katmanı
       ↓
istek kuyrukları
       ↓
aygıt sürücüsü
       ↓
donanım
8.13. Sürücülerde Eşzamanlama
Aynı sürücü kodu:
- kullanıcı süreçleri,
- kernel çalışanlar,
- kesilme yordamları,
- farklı işlemci çekirdekleri
tarafından eşzamanlı çalıştırılabilir.
Bu nedenle sürücü tasarımında:
- spinlock,
- mutex,
- atomic işlemler,
- reference counting,
- bellek sıralaması
gibi konular doğrudan önem taşır.
Bir aygıt sürücüsü bu açıdan süreç yönetimi, eşzamanlama, bellek yönetimi ve G/Ç konularının birleştiği noktadır.
Ünite 9: Dağıtılmış İşlem ve Ağ İletişimi
9.1. Dağıtılmış İşlem
Bir bilgisayarın başka bir bilgisayarın kaynaklarından ağ üzerinden yararlanması işletim sisteminin yerel kaynak yönetimini ağ ortamına genişletir.
Paylaşılan kaynak:
- dosya,
- yazıcı,
- servis,
- veri tabanı,
- hesaplama hizmeti
olabilir.
Dağıtılmış sistemlerde fiziksel konum kullanıcıdan kısmen gizlenebilir. Ancak ağ gecikmesi, bağlantı kesilmesi ve uzak düğüm arızaları yerel sistemde bulunmayan yeni hata durumları oluşturur.
9.2. TCP/IP Katmanları
İnternet iletişimi katmanlı yapı üzerine kuruludur.
Basitleştirilmiş model:
Uygulama
   ↓
TCP / UDP
   ↓
IP
   ↓
Bağlantı katmanı
   ↓
Fiziksel ağ
Her katman üst katmana belirli bir hizmet sunar.
Katmanlama ağ donanımının ayrıntılarını uygulamadan ayırır.
9.3. IP
Internet Protocol paketlerin ağlar arasında taşınmasını sağlar.
IP temel olarak:
- adresleme,
- paket yönlendirme,
- ağlar arası iletim
işlevlerini üstlenir.
IP teslim garantisi veren bir taşıma protokolü değildir.
Güncel İnternet mimarisinde hem IPv4 hem IPv6 önemlidir. IPv6, RFC 8200 ile Internet Standard olarak tanımlanmıştır. (rfc-editor.org)
9.4. TCP
TCP bağlantı yönelimli bir taşıma protokolüdür.
Uygulamaya güvenilir bir bayt akışı sunar.
Başlıca özellikleri:
- sıra denetimi,
- kayıp verinin yeniden iletilmesi,
- akış denetimi,
- tıkanıklık denetimi,
- bağlantı durumu yönetimidir.
Bir uygulama mesaj sınırlarının TCP tarafından korunacağını varsaymamalıdır. TCP bir byte akış sağlar.
TCP'nin güncel temel belirtimi RFC 9293'tür. (rfc-editor.org)
9.5. UDP
UDP bağlantısız datagram hizmeti sunar.
TCP'deki:
- bağlantı kurulumu,
- güvenilir sıralı teslim,
- yeniden iletim
mekanizmalarını aynı biçimde sağlamaz.
Bu nedenle protokol daha küçük bir taşıma katmanı mekanizmasına sahiptir.
UDP'nin kullanılması otomatik olarak "daha iyi performans" anlamına gelmez. Uygulamanın güvenilirlik, sıra, yeniden iletim veya congestion control ihtiyacı varsa bunların başka bir katmanda ele alınması gerekir.
9.6. Port Numaraları
IP adresi hedef sistemi belirler.
Port numarası ise sistem içindeki iletişim uç noktasını ayırt etmeye yardımcı olur.
Bir ağ bağlantısını düşünürken temel tanımlayıcılar arasında:
kaynak IP
kaynak port
hedef IP
hedef port
protokol
bulunur.
TCP ve UDP port alanları 16 bittir.
9.7. Socket
Socket, uygulamanın işletim sisteminin ağ iletişim hizmetlerine eriştiği temel soyutlamalardan biridir.
Unix socket API'sinde ağ iletişimi bir descriptor üzerinden ele alınabilir.
Bu yaklaşım dosya G/Ç ile ağ G/Ç arasında belirli bir arayüz benzerliği sağlar.
9.8. TCP Sunucu Yapısı
Tipik TCP sunucu akışı:
socket()
   ↓
bind()
   ↓
listen()
   ↓
accept()
   ↓
read/write
   ↓
close()
socket() iletişim uç noktası oluşturur.
bind() yerel adres ve port ile ilişki kurar.
listen() soketi bağlantı kabul eden duruma geçirir.
accept() bekleyen bağlantılardan birini kabul eder ve bu bağlantıya özgü yeni bir descriptor sağlar.
Dinleme soketi yeni istemcileri kabul etmeye devam edebilir.
9.9. TCP İstemci Yapısı
Tipik istemci akışı:
socket()
   ↓
connect()
   ↓
read/write
   ↓
close()
connect() istemcinin uzak sunucuyla bağlantı kurmasını başlatır.
Bağlantı kurulduktan sonra iki yönlü veri aktarımı yapılabilir.
9.10. Eşzamanlı Sunucular
Bir sunucu yalnız bir istemciye hizmet verirken diğer istemcileri bekletirse ölçeklenebilirliği düşer.
Klasik Unix modelinde her bağlantı için yeni süreç oluşturmak mümkündür.
Başka modeller de vardır:
- iş parçacığı-per-connection,
- iş parçacığı havuzları,
- event-driven I/O,
- asynchronous I/O.
Yüksek bağlantı sayısında her bağlantı için ayrı işletim sistemi iş parçacığını oluşturmak her zaman en iyi çözüm değildir.
Doğru model:
- bağlantı sayısı,
- iş yükü türü,
- bekleme oranı,
- gecikme hedefi,
- işlem maliyeti
gibi özelliklere bağlıdır.
9.11. UDP Soketleri
UDP bağlantısız iletişimde sunucunun TCP'deki gibi listen() ve accept() kullanması gerekmez.
Temel işlemler arasında:
sendto()
recvfrom()
bulunur.
Her datagram kendi hedef veya kaynak adres bilgisiyle işlenebilir.
Bu yapı kısa istek-yanıt protokollerinde yararlı olabilir.
9.12. DNS
İnsanların kullandığı alan adlarının ağ adreslerine çevrilmesini Domain Name System sağlar.
Örneğin uygulama:
example.orgadını kullanabilir.
İletişim kurulabilmesi için bu adın uygun ağ adreslerine çözülmesi gerekir.
DNS dağıtık ve hiyerarşik bir adlandırma sistemidir.
DNS yalnızca basit bir "alan adı -> IP" tablosu değildir. Farklı kayıt türleri, yetkili sunucular, önbellekleme ve delegasyon mekanizmaları içerir.
9.13. Ağ İletişiminde Hata Modeli
Yerel bir işlev çağrısı ile uzak sistem çağrısı aynı hata modeline sahip değildir.
Ağ iletişiminde:
- paket kaybı,
- gecikme,
- bağlantı kopması,
- uzak sistemin çökmesi,
- zaman aşımı,
- kısmi veri aktarımı
oluşabilir.
Bu nedenle dağıtık sistemlerde "yanıt gelmedi" bilgisi tek başına uzak işlemin çalışıp çalışmadığını kesin olarak söylemeyebilir.
Bu ayrım güvenilir dağıtık yazılım tasarımının temelidir.
9.14. NFS
Network File System, uzak dosya sistemlerinin ağ üzerinden kullanılmasını sağlayan dağıtık dosya sistemi ailesidir.
Amaç uzak dosyaları yerel dosya sistemi hiyerarşisinin doğal bir parçası gibi sunabilmektir.
Bu yaklaşım:
uygulama
   ↓
VFS
   ↓
yerel FS veya NFS
   ↓
ağ
   ↓
uzak dosya sunucusu
şeklinde düşünülebilir.
Modern NFS sürümleri klasik ilk NFS tasarımlarından önemli ölçüde gelişmiştir. NFSv4.1 için temel protokol belirtimlerinden biri RFC 8881'dir.
9.15. VFS ve Uzak Dosya Sistemleri
Sanal dosya sistemi katmanı yerel ve ağ tabanlı farklı dosya sistemlerini ortak bir ad uzayına bağlayabilir.
Linux VFS, kullanıcı programlarının open(), read(), write() ve benzeri işlemlerini belirli dosya sistemi gerçekleştirimlerinden soyutlar. (docs.kernel.org)
Bu soyutlama işletim sistemlerinin genel tasarım anlayışını tekrar gösterir:
Uygulamaya kararlı ve yalın bir mantıksal arayüz sunulur. Fiziksel veya protokole özgü ayrıntılar alt katmanlarda çözülür.
Ünite 10: Gerçek Zamanlı Zamanlama ve Modern G/Ç Yolu
İşletim sistemi zamanlayıcısı her iş yükü için aynı hedefi optimize etmez. Genel amaçlı sistemlerde adillik ve ortalama yanıt süresi önemliyken, gerçek zamanlı sistemlerde belirli bir işin son teslim zamanından önce tamamlanması önceliklidir.
10.1. Öncelik Terslenmesi
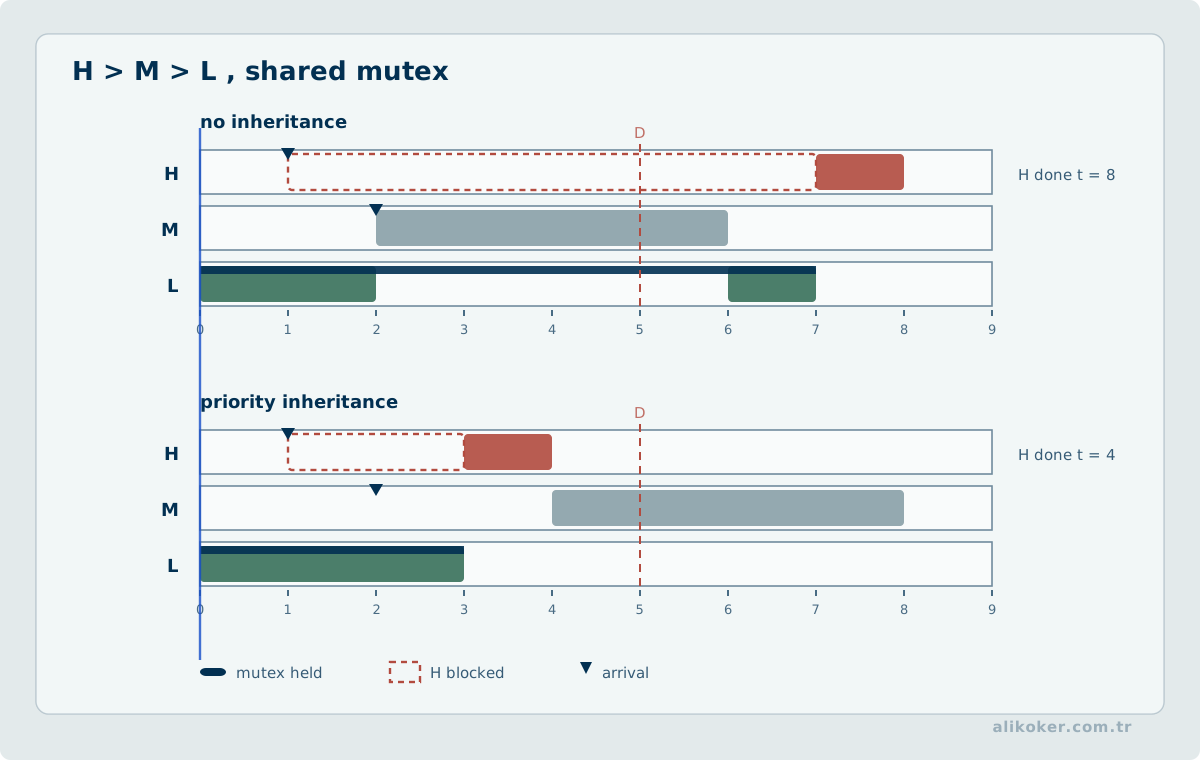
Yüksek öncelikli bir görev, düşük öncelikli görevin tuttuğu kilidi bekliyorsa ve araya orta öncelikli görevler giriyorsa yüksek öncelikli görev dolaylı biçimde düşük öncelikli görev tarafından engellenebilir. Bu durum priority inversion olarak adlandırılır.
L: kilidi alır
H: aynı kilidi bekler
M: L'yi CPU'dan uzaklaştırır
H: M yüzünden de gecikir
Priority inheritance gibi protokoller düşük öncelikli kilit sahibinin geçici olarak daha yüksek öncelikle çalışmasını sağlayarak bu gecikmeyi sınırlamaya çalışır. Bu mekanizma, kilitlerin süresiz tutulmasını veya hatalı eşzamanlılık tasarımını düzeltmez; yalnız belirli bir zamanlama patolojisini azaltır.
10.2. Deadline ve WCET Ayrımı
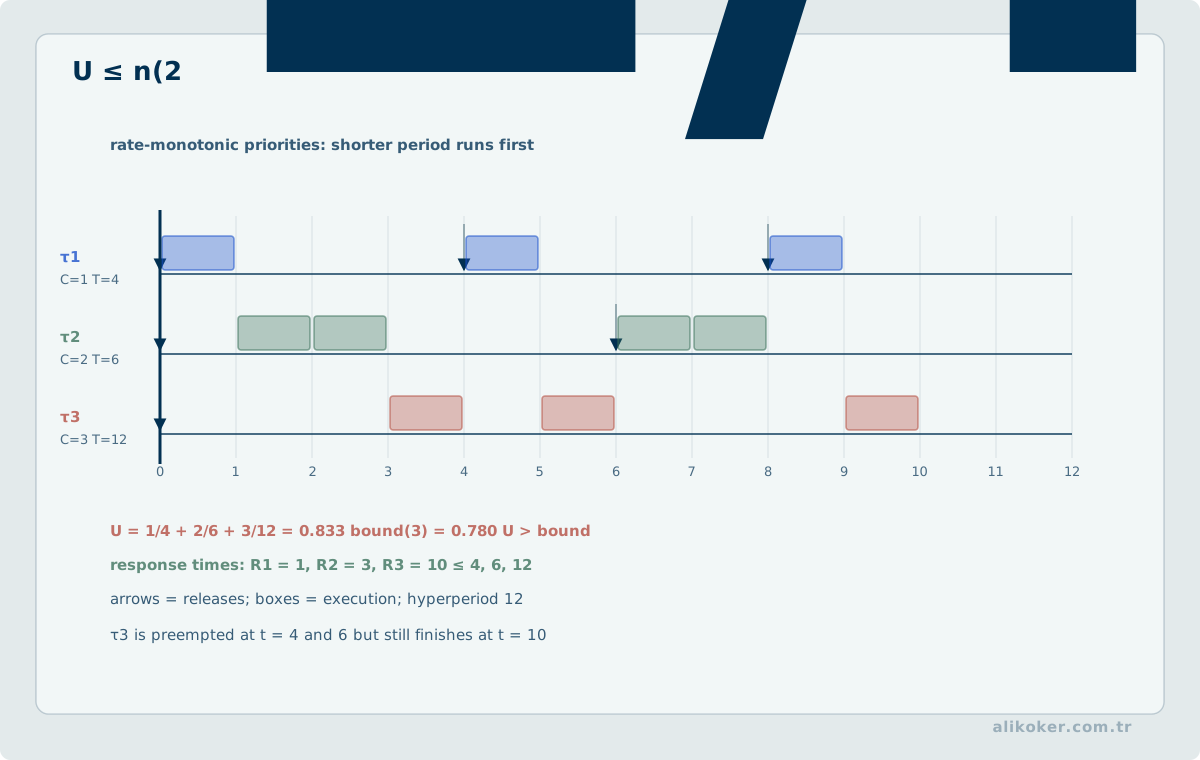
Gerçek zamanlı değerlendirmede ortalama çalışma süresi yeterli değildir. Bir işin worst-case execution time tahmini, periyodu ve deadline'ı birlikte ele alınır. Sistem yük altında hızlı görünse bile nadir bir uzun duraklama deadline ihlali yaratabilir.
release -> execution -> completion
              |
              +---- completion <= deadline ?
Bu nedenle p99 gecikme, scheduler davranışı, interrupt gecikmesi, page fault ve G/Ç beklemesi gibi kaynaklar tek zaman bütçesinde düşünülmelidir.
10.3. Modern G/Ç Yolu
Bir dosya okuması uygulamadan doğrudan depolama aygıtına giden tek adımlı işlem değildir. Tipik yol:
uygulama
  ↓
system call / async submission
  ↓
VFS ve dosya sistemi
  ↓
page cache
  ↓
block katmanı / sürücü
  ↓
depolama aygıtı
Page cache okuma ve yazmayı hızlandırabilir; fakat kirli sayfaların daha sonra depolamaya aktarılması gecikmeyi başka zamana taşır. fsync benzeri dayanıklılık sınırları bu nedenle yalnız API çağrısı değil, kalıcılık sözleşmesidir.
Asenkron G/Ç arayüzleri iş parçacığının her işlem için bloklanmasını azaltabilir. Bununla birlikte asenkronluk fiziksel aygıtın bant genişliğini artırmaz; yalnız bekleyen işleri ve yürütme kaynaklarını farklı biçimde düzenler.
10.4. Kaynak Kuyruğu ve Geri Basınç
G/Ç kuyruğu sınırsız büyütüldüğünde throughput bir süre artıyor gibi görünebilir; fakat kuyruk gecikmesi ve bellek kullanımı hızla yükselir. Güvenilir sistemde admission control, queue bound ve backpressure birlikte tasarlanır.
İşletim sistemi açısından temel ayrım şudur: scheduler CPU zamanını, G/Ç katmanı aygıt erişimini, uygulama ise kabul ettiği iş miktarını yönetir. Bu üç sınır birbirine karıştırıldığında gecikme problemleri yanlış katmanda çözülmeye çalışılır.
10.5. İşletim Sistemini Kaynak Akışı, Yalıtım ve İlerleme Garantileriyle Birlikte Okumak
İşletim sistemi konuları ilk bakışta birbirinden bağımsız görünebilir. Gerçekte tek bir kaynak yönetimi problemi etrafında birleşirler.
Bir program diskten veri okumak istediğinde şu zincir oluşabilir:
uygulama
   ↓
sistem çağrısı
   ↓
dosya sistemi
   ↓
page cache
   ↓
blok G/Ç
   ↓
aygıt sürücüsü
   ↓
DMA
   ↓
depolama aygıtı
   ↓
kesilme
   ↓
görev yöneticisi
   ↓
uygulamanın yeniden çalışması
Bu tek işlem sırasında:
- sistem çağrısı,
- kullanıcı/çekirdek modu geçişi,
- dosya sistemi,
- bellek yönetimi,
- G/Ç yönetimi,
- DMA,
- kesilme,
- süreç durumları,
- işlemci planlama
birlikte çalışır.
İşletim sistemleri dersinin asıl bütünlüğü burada ortaya çıkar.
Bellek yönetimindeki sayfa tablosu yalnız adres çevirmek için değildir. Aynı zamanda koruma sağlar.
Kesilme yalnız G/Ç konusu değildir. Süreç planlamasını tetikleyebilir.
Dosya sistemi yalnız diskte veri tutmaz. Önbellek nedeniyle ana bellek yönetimiyle doğrudan ilişkilidir.
Iş parçacığı yalnız planlama birimi değildir. Paylaşılan bellek nedeniyle eşzamanlama problemi doğurur.
Socket yalnız ağ programlama aracı değildir. İşletim sisteminin süreçlere sunduğu çekirdek hizmetlerinden biridir.
Aygıt sürücüsü yalnız donanım kodu değildir. Kesilme, DMA, bellek, eşzamanlama ve güvenlik kurallarının aynı yerde uygulanmasını gerektirir.
Bu nedenle işletim sistemi, birbirinden bağımsız yardımcı programlardan oluşan bir paket olarak değil, ortak kaynakların kontrollü kullanımını sağlayan bütünleşik bir sistem olarak düşünülmelidir.
10.6. Tarihsel Process ve Zamanlama Deneyleri
İşlem önceliği ve CPU affinity üzerine erken dönem deneylerinin tarihsel örnekleri Köker Optimizer projesinde; zamanlayıcı, dış process başlatma ve komut satırı sözleşmesi örnekleri ise Köker Zamanla! uygulamasında bulunur. Bu projelerdeki eski performans varsayımları güncel işletim sistemi davranışından ayrı değerlendirilmelidir.
10.7. Linux Üretim Yönetimine Geçiş
Süreç, bellek, dosya sistemi ve G/Ç gibi işletim sistemi mekanizmaları burada ürün bağımsız düzeyde ele alınır. Servis yönetimi, SELinux, NetworkManager, firewalld, DNF, LVM/XFS, Podman ve operasyonel sorun giderme için Red Hat Enterprise Linux Sistem Yönetimi ayrı bir sistem yönetimi kapsamı sunar.
10.8. Kaynak Tükenmesi, Geri Basınç ve Adil Paylaşım
İşletim sistemi yalnız CPU ve belleği paylaştırmaz; dosya tanıtıcıları, socket'ler, süreç tablosu girdileri, sayfa önbelleği ve G/Ç kuyrukları da sonlu kaynaklardır. Bir hizmette "bellek yetiyor" olması, diğer çekirdek kaynakların tükenmeyeceği anlamına gelmez.
Kuyruğun sınırsız büyümesi genellikle kapasite değil gecikme problemi olarak başlar. Üretici tüketiciden uzun süre hızlıysa bir yerde geri basınç kurulmalıdır. Aksi halde bellek artışı, zaman aşımı zinciri ve yeniden deneme fırtınası birlikte sistemi kararsızlaştırabilir.
Kaynak yönetiminde yararlı soru şudur: sınır aşıldığında sistem ne yapar? Yeni işi reddetmek, kuyrukta bekletmek, eski işi düşürmek veya kaliteyi azaltmak farklı hizmet sözleşmeleridir. İşletim sistemi mekanizmalarını anlamak, bu kararların uygulama katmanındaki sonuçlarını daha öngörülebilir hâle getirir.
10.9. İşletim Sistemi İddiasını Katmanına Göre Doğrulamak
POSIX, Linux çekirdeği, Windows NT ve belirli bir dosya sistemi aynı soyutlamaları farklı ayrıntılarla uygular. “İşletim sistemi böyle yapar” gibi genel bir ifade kullanılmadan önce bunun standart sözleşmesi mi, çekirdek uygulaması mı, yoksa belirli bir sürüm davranışı mı olduğu ayrılmalıdır.
Bir performans veya kaynak sorunu incelenirken CPU kullanımı, context switch, major/minor page fault, disk kuyruğu ve dosya tanıtıcısı tüketimi birlikte değerlendirilebilir. Ölçüm aracı da kendi maliyetini getirebilir; bu nedenle gözlem koşulu ve örnekleme aralığı kaydedilmelidir.
Güvenlik ve güvenilirlik açısından hata yolları önemlidir: disk dolması, dosya tanıtıcısı tükenmesi, OOM, kesintiye uğrayan sistem çağrısı ve kısmi G/Ç. Normal yol kadar bu sınır durumlarının da tanımlı davranışı bulunmalıdır.
10.10. Yapay Zekâ İş Yüklerinin İşletim Sistemi Boyutu
Yapay zekâ modeli kullanıcı uzayında çalışan başka bir programdır; ancak bellek hacmi, aygıt erişimi, yoğun paralellik ve uzun süren veri akışları nedeniyle işletim sistemi kaynaklarını belirgin biçimde zorlayabilir. Bu nedenle modelin matematiksel başarısı ile üretimdeki yürütme davranışı ayrı katmanlarda değerlendirilmelidir.
Bir çıkarım servisi için basit akış şöyledir:
istek
↓
girdi hazırlama
↓
model çalışma zamanı
↓
CPU / hızlandırıcı yürütmesi
↓
sonuç işleme
↓
yanıt
Her ok işletim sistemi açısından kuyruk, bellek, dosya, ağ veya aygıt erişimi doğurabilir. Model ağırlıklarının belleğe alınması, büyük tensörlerin ayrılması, dosya sisteminden veri okunması, paylaşılan hızlandırıcıya iş gönderilmesi ve sonuçların başka süreçlere aktarılması işletim sisteminin süreç, sanal bellek ve G/Ç mekanizmaları üzerinde yürür.
Bellek baskısı özellikle önemlidir. Model ağırlıkları, çalışma alanları, etkinleştirmeler ve uygulamanın kendi heap'i aynı fiziksel bellek için yarışabilir. Sayfalama başladığında teorik hesap kapasitesi yüksek olsa bile tail latency hızla bozulabilir. OOM oluşması ise yalnız “model çok büyük” anlamına gelmez; eşzamanlı istek sayısı, çalışma zamanı tamponları, dosya önbelleği ve diğer süreçlerin tüketimi birlikte incelenmelidir.
NUMA sistemlerde bellek yerleşimi de görünmez değildir. İş parçacığı bir NUMA düğümünde, sık kullandığı bellek başka düğümde bulunuyorsa erişim maliyeti artar. Benzer biçimde hızlandırıcıya giden veri yolunun topolojisi, CPU affinity ve kesme yerleşimi yüksek hacimli servislerde ölçülebilir fark üretebilir. İşletim sistemi bu donanım ayrıntılarını tamamen yok etmez; onları yönetilebilir soyutlamalara dönüştürür.
Eşzamanlılık tarafında temel hata, daha fazla thread veya process açmanın her zaman daha fazla throughput getireceğini varsaymaktır. Hızlandırıcı, bellek bant genişliği ya da model çalışma zamanı zaten doygunsa yeni işler yalnız kuyruğu büyütür. Bu durumda ortalama gecikme kabul edilebilir görünürken yüksek yüzdeliklerde ciddi kuyruk gecikmesi oluşabilir. Doğru sınırlandırma, backpressure ve admission control modelin kendisi kadar üretim güvenilirliğinin parçasıdır.
İşletim sistemi izolasyonu da önemlidir. cgroup benzeri mekanizmalar CPU ve bellek kaynaklarını sınırlayabilir; namespace ve izin modeli süreç sınırlarını kurabilir. Ancak kaynak sınırı gerçek kapasite yaratmaz. Örneğin bellek limiti konmuş bir model, o limit altında çalışabilecek biçimde boyutlandırılmamışsa yalnız daha deterministik biçimde başarısız olur.
Model veya çalışma zamanı bir GPU/NPU gibi aygıt kullanıyorsa sürücü katmanı, aygıt dosyaları, DMA ve kullanıcı-kernel geçişleri yürütme zincirine eklenir. Bu nedenle “GPU kullanımı yüzde 100” gibi tek bir ölçüm, darboğazın gerçekten hesapta olduğunu kanıtlamaz. CPU ön işleme, veri kopyası, senkronizasyon veya I/O gecikmesi aynı sonucu üretebilir.
İşletim sistemleri dersi yapay zekânın nasıl öğrendiğini açıklamaz. Buna karşılık öğrenilmiş modelin sınırlı fiziksel kaynaklar üzerinde nasıl süreç, bellek, G/Ç ve aygıt işi haline geldiğini açıklar. Üretim sisteminde model başarısı ile kaynak yönetimi birleştiğinde throughput, latency, hata sonrası toparlanma ve hizmet sürekliliği gerçek performans ölçütlerine dönüşür.
10.11. Mekanizma ile Gözlenen Sonucu Ayırmak
İşletim sistemi sorularında aynı kavramı farklı katmanlarda kullanmamak önemlidir. Süreç bir adres alanı ve kaynak bağlamı taşırken iş parçacıkları aynı süreç içinde belleği paylaşabilir. Bu paylaşım iletişimi ucuzlatır, fakat veri yarışını ve eşzamanlama gereksinimini de beraberinde getirir. Kilit, semafor ve koşul değişkeni aynı araç değildir; çözülmek istenen bekleme ve sahiplik problemi seçimi belirler.
Sanal bellek de fiziksel belleğin eş anlamlısı değildir. Bir sanal adresin kullanılması; TLB, sayfa tablosu ve gerektiğinde sayfa hatası üzerinden fiziksel belleğe ulaşır. Sayfa hatası her zaman hata anlamına gelmez; istenen sayfanın henüz fiziksel bellekte bulunmaması normal çalışma akışının parçası olabilir. Buna karşılık yoğun sayfa değişimi sistemin yararlı iş yerine sürekli bellek taşımasına yol açabilir.
Kilitlenme (deadlock) için klasik dört koşul birlikte düşünülmelidir: karşılıklı dışlama, elde tutup bekleme, zorla geri alamama ve çevrimsel bekleme. Bu koşullardan birini sistematik olarak bozmak kilitlenmeyi önleme stratejisidir. Açlık ise farklıdır; sistem ilerlerken belirli bir iş parçacığı sürekli kaynak dışında kalabilir.
Zamanlama sorularında dönüş süresi, bekleme süresi ve yanıt süresi birbirine karıştırılmamalıdır. Bir etkileşimli sistemde ilk yanıtın gecikmesi önemliyken, toplu işlerde toplam tamamlanma süresi daha anlamlı olabilir. Benzer biçimde CPU kullanımının yüksek olması tek başına iyi performans kanıtı değildir; işlemci yararlı iş, kilit bekleme, sayfa hatası veya yoğun sistem çağrısı nedeniyle meşgul olabilir.
Bir işletim sistemi problemini çözerken önce şu sınır çizilmelidir: sorun süreçler arası mı, aynı süreçteki iş parçacıkları arasında mı, sanal bellek katmanında mı, dosya sistemi semantiğinde mi, yoksa aygıt/GÇ tarafında mı? Doğru katman seçilmeden yapılan optimizasyon çoğu zaman yalnız belirtinin yerini değiştirir.
10.12. Sistem Programlama Katmanı: Sistem Çağrısından Kaynak Sahipliğine
İşletim sistemi dersi çekirdeğin mekanizmalarını açıklar; sistem programlama ise kullanıcı alanındaki bir programın bu mekanizmalara hangi sözleşmeler üzerinden eriştiğini inceler. Bazı bilgisayar mühendisliği programlarında bu iki alan ayrı derslerdir. Ayrım yararlıdır: zamanlayıcının nasıl çalıştığını bilmek ile fork(), execve(), read() veya mmap() çağrılarının hata ve yaşam döngüsü kurallarını doğru kullanmak aynı beceri değildir.
10.12.1. Sistem Çağrısı Sınırı
Bir kitaplık fonksiyonu her zaman sistem çağrısı değildir ve her sistem çağrısı da doğrudan uygulama kodunda görünmez. Kullanıcı alanı kitaplıkları parametre hazırlama, tamponlama veya uyumluluk işi yapabilir; çekirdek ayrıcalıklı kaynağa erişim gerektiğinde sistem çağrısı sınırından devreye girer.
uygulama
  ↓
standart kitaplık / çalışma zamanı
  ↓
sistem çağrısı arayüzü
  ↓
çekirdek
  ↓
dosya sistemi / ağ / süreç / aygıt
Bu ayrım performans ölçümünde de önemlidir. Bir printf() çağrısı uygulama tamponunda kalabilir; bir write() çekirdeğe geçebilir; çekirdeğin kabul ettiği veri ise o anda fiziksel aygıta kalıcı olarak yazılmış olmayabilir.
10.12.2. Dosya Tanımlayıcısı: Ortak bir Kaynak Tutamacı
POSIX sistemlerde dosya tanımlayıcısı (file descriptor) yalnız normal dosyalar için kullanılmaz. Borular, soketler, terminaller ve çeşitli çekirdek nesneleri de benzer okuma-yazma sözleşmeleriyle temsil edilebilir. Bu model sistem programlamasında güçlü bir bileşim sağlar.
open/socket/pipe
      ↓
   fd = 3
      ↓
read / write / poll
      ↓
    close
Buradaki kritik konu sayısal fd değerinin kendisi değil, kaynak sahipliği ve yaşam süresidir. Erken close() kullanım hatası yaratabilir; kapatılmayan tanımlayıcı süreç ömrü boyunca kaynak sızdırabilir; fork() sonrasında aynı açık dosya tanımının birden fazla süreçteki tanımlayıcılarla paylaşılması dosya ofseti ve kapanma davranışı üzerinde sonuç doğurabilir.
10.12.3. fork, exec Ve wait Ayrı İşlemlerdir
Unix süreç modelinde yeni program başlatmayı tek bir “process create” işlemi gibi düşünmek yanıltıcıdır. fork() mevcut sürecin yeni bir süreç bağlamını oluşturur; exec ailesi mevcut süreç imgesini başka bir programla değiştirir; wait ailesi ebeveynin çocuk süreç durumunu toplamasını sağlar.
parent
  │
  ├─ fork() ──→ child
  │              ↓
  │           exec(...)
  │              ↓
  │          new program
  │
  └─ wait(...) ← exit status
Bu ayrım shell pipeline'larının, süreç gözetiminin ve daemon/service yöneticilerinin temelidir.
10.12.4. Boru, Soket ve Paylaşılan Bellek Aynı IPC Değildir
Boru (pipe) bayt akışı sağlar ve özellikle akraba süreçler veya shell pipeline'ları için basittir. Unix domain socket veya ağ soketi çift yönlü iletişim ve daha farklı topolojiler sağlayabilir. Paylaşılan bellek ise veriyi çekirdek üzerinden her iletimde kopyalamak yerine ortak adreslenebilir bölge sunabilir; buna karşılık eşzamanlama sorumluluğunu artırır. Mesaj kuyruğu ve semaforlar da farklı iletişim/eşzamanlama sözleşmeleri sunar.
Bir IPC yöntemi yalnız throughput'a göre seçilmez. Mesaj sınırı, kopyalama maliyeti, hata izolasyonu, süreçlerin yaşam döngüsü, backpressure ve hata sonrası temizleme davranışı birlikte değerlendirilmelidir.
10.12.5. Blocking, non-blocking ve Hazır Olma Bildirimi
Bir dosya tanımlayıcısında read() çağrısının veri gelene kadar beklemesi blocking I/O davranışıdır. O_NONBLOCK kullanıldığında çağrı hazır olmayan kaynak için beklemek yerine uygun hata durumuyla dönebilir. select() ve poll() birden çok tanımlayıcının hazır olmasını izler; Linux'taki epoll çok sayıda tanımlayıcı için farklı ölçekleme özellikleri sunar.
Hazır olma bildirimi ile gerçek asenkron G/Ç aynı kavram değildir. Hazır olma modeli “hangi işlem şimdi bloklamadan yapılabilir?” sorusuna; completion tabanlı asenkron model ise “başlattığım işlem ne zaman tamamlandı?” sorusuna cevap verir.
10.12.6. Kısmi okuma/yazma ve Kesintiler Normal Durumdur
Sistem programlamasında bir read() veya write() çağrısının istenen bütün baytları tek seferde işleyeceği varsayılmamalıdır. Soket, pipe ve bazı aygıt türlerinde kısmi ilerleme normaldir. Benzer biçimde bir çağrı sinyal nedeniyle kesilebilir. Güvenilir kod kalan veri miktarını, hata kodunu ve tekrarın güvenli olup olmadığını açıkça yönetir.
istenen: 8192 bayt
write(): 3072 bayt
kalan : 5120 bayt
Bu ayrıntılar, işletim sisteminin teorik konularını üretim koduna bağlayan noktadır. Süreç, sanal bellek veya dosya sistemi bilgisinin gerçek değeri; kullanıcı alanındaki kodun çekirdek sözleşmelerini ihlal etmeden, kaynakları sızdırmadan ve beklenmeyen bloklanma üretmeden çalışmasını sağlayabildiğimizde ortaya çıkar.
10.13. İşletim Sisteminde Kullanım, Doygunluk ve Kuyruk
İşletim sistemi düzeyinde CPU kullanımının yüksek olması tek başına darboğazın kaynağını göstermez. Çalıştırılabilir iş kuyruğunun büyümesi işlemci rekabetine; page fault, bellek geri kazanımı ve block I/O beklemeleri ise farklı kaynak baskılarına işaret eder. Süreç, çekirdek iş parçacığı ve aygıt katmanındaki gözlemler aynı zaman aralığında ilişkilendirildiğinde gerçek bekleme noktası belirlenebilir; aksi hâlde yalnız ortalamalar üzerinden yapılan kapasite artırımı sorunu gizleyebilir.
- Run queue büyümesinin CPU kullanım yüzdesinden ayrı izlenmesi.
- Page fault ve I/O beklemesinin uygulama CPU süresinden ayrıştırılması.
- Scheduler politikasının ortalama değil p95/p99 gecikmeye etkisinin de ölçülmesi.
CPU kullanım yüzdesi her zaman çalıştırılabilirlik yüzdesi değildir. Konteynerde CPU quota uygulandığında servis, fiziksel çekirdeklerde boşluk olsa bile kota döneminin kalanı için throttling yaşayabilir. Böyle bir durumda uzun kuyruk gecikmesini yalnız CPU kullanım grafiğine bakarak açıklamak eksik kalır. Run queue uzunluğu, context switch davranışı, cgroup cpu.stat içindeki throttling sayaçları ve uygulama p99'u birlikte incelenmelidir.
Bir kaynağın yüksek kullanımı ile gerçek doygunluk arasında ayrım vardır: doygunluk, yeni işin kaynağı beklemek zorunda kalmasıdır. CPU çalıştırılabilir kuyruğu, bloklanan disk I/O, ağ soketi arabellekleri ve veritabanı bağlantı kuyruğu farklı servis merkezleridir. Her merkez için geliş hızı, hizmet kapasitesi ve bekleme konumu tanımlanmadıkça tek bir “sistem yavaş” metriği kök neden göstermez.
10.14. Öncelik Terslenmesi ve Bloke Olma Süresi
Sabit öncelikli gerçek zamanlı zamanlamada yüksek öncelikli bir görevin yürütülememesi her zaman işlemci yetersizliğinden kaynaklanmaz. Düşük öncelikli görev ortak bir kilidi tutarken yüksek öncelikli görev aynı kaynağı bekleyebilir; aradaki orta öncelikli görevler düşük öncelikli görevi sürekli keserse yüksek öncelikli görevin yanıt süresi öngörülemez biçimde artar. Bu durum öncelik terslenmesidir. Öncelik mirası veya öncelik tavanı gibi protokoller belirli kaynak paylaşımı modellerinde bloke olmayı sınırlandırabilir; bunlar hatalı kritik bölüm sınırlarını kendiliğinden düzeltmez.
Tek işlemcide bağımsız periyodik görevler için yanıt süresi analizi kabaca \(R_i=C_i+B_i+\sum_{j\in hp(i)}\lceil R_i/T_j\rceil C_j\) sabit nokta bağıntısıyla modellenebilir. Burada \(C_i\) en kötü yürütme süresi, \(B_i\) alt öncelikli görevlerden gelen en büyük bloke olma, \(T_j\) daha yüksek öncelikli görevin periyodudur. Hesaplama, görev ve kilit modelinin varsayımları altında anlamlıdır; I/O kesmeleri, paylaşılan işlemci önbelleği ve gerçek zamanlı olmayan sürücüler ayrıca incelenmelidir.
Gecikme testinde ortalama yürütme süresi yerine serbest bırakmadan tamamlanmaya kadar geçen en kötü gözlenen yanıt süresi, bloke olma süresi ve deadline ihlalleri raporlanmalıdır. Ölçülmüş üst sınır ile matematiksel olarak kanıtlanmış üst sınır eş anlamlı değildir. Kritik uygulamada yük testiyle gözlenmeyen bir yürütme yolu deadline garantisine dönüşmez.
Ünite 11: Klasik Eşzamanlılık Problemleri ve Çalışma Zamanı Ayrımları
Eşzamanlılık sorularında yalnız API adlarını bilmek yeterli değildir. Temel problem, hangi kaynağın paylaşıldığını, hangi koşulun beklenmesi gerektiğini ve ilerleme garantisinin nasıl korunacağını ayırabilmektir.
11.1. Mode Switch ile Context Switch Aynı Şey Değildir
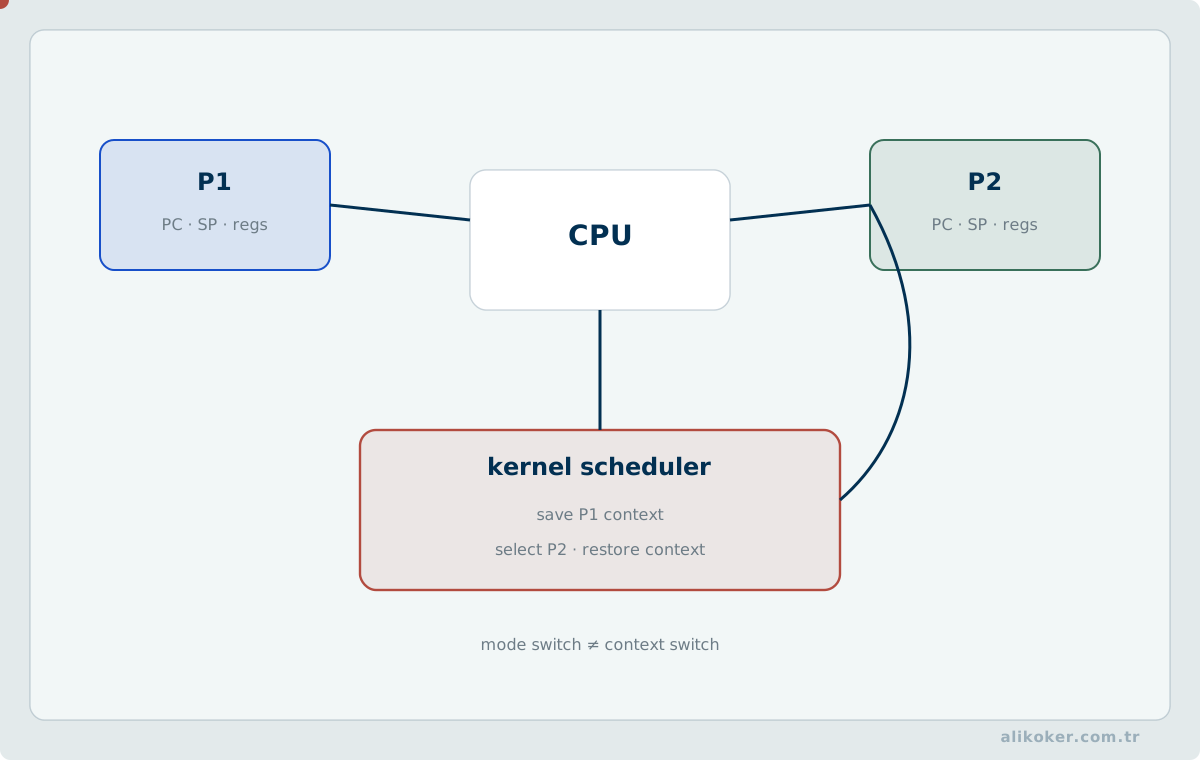
Bir sistem çağrısı veya kesme, işlemciyi kullanıcı modundan çekirdek moduna geçirebilir. Bu geçiş her zaman çalışan thread'in değiştirilmesi anlamına gelmez.
user mode
   ↓ system call / interrupt
kernel mode
   ↓
aynı thread devam edebilir
Context switch ise işlemci bağlamının başka bir yürütme birimine geçirilmesidir. Register'lar, program counter, stack göstergeleri ve scheduler'a ait durumun kaydedilip başka bağlamın yüklenmesi gerekir.
Bu nedenle:
mode switch ≠ zorunlu context switch
context switch -> daha geniş yürütme durumu değişimi
ayrımı performans analizinde önemlidir.
11.2. Producer-consumer: İki Farklı Senkronizasyon Problemi
Sınırlı tamponlu üretici-tüketici probleminde iki gereksinim vardır:
- aynı veri yapısının eşzamanlı bozulmasını önleyen mutual exclusion,
- tampon dolu veya boşken ilgili tarafı bekleten condition synchronization.
Yalnız mutex kullanmak:
buffer güvenliolmasını sağlayabilir; fakat:
buffer boşken consumer ne yapacak?
buffer doluyken producer ne yapacak?
sorularını çözmez.
Semaphore veya condition variable kullanıldığında kaynak sayısı ile kritik bölge koruması ayrı sorumluluklar olarak modellenmelidir.
11.3. Sınırlı Kuyrukta Kapasite ve Kapanış Semantiği
Kuyruk kapasitesi C, dolu hücre sayısı q olsun. Üretici eklemeden önce q < C, tüketici çıkarmadan önce q > 0 koşulunu bekler. Sayaç güncellemesi ile eleman yerleştirme/çıkarma aynı senkronizasyon sözleşmesinin parçasıdır; yalnız sayacı atomik yapmak, dizinin veya bağlı yapının güvenli olduğunu göstermez. Dolu kuyruk için kullanılan politika da algoritmanın parçasıdır: üreticiyi bekletmek, zaman aşımıyla reddetmek veya açıkça tanımlanan bir kayıp politikasını uygulamak farklı doğruluk sözleşmeleridir.
Bir koşul değişkeniyle çalışan tüketici, uyandırıldığında koşulu if ile bir kez değil while ile yeniden kontrol eder; uyandırılma, başka bir tüketicinin son elemanı almadığını garanti etmez. Kuyruk kapanırken yalnız üreticileri durdurmak yeterli değildir. Bekleyen tüketiciler uyandırılmalı, kapanış durumu boş kuyruktan ayırt edilmeli ve kabul edilmiş işlerin işlenmesi ya da iptali kararlaştırılmalıdır. Bu kurallar verilmezse tampon taşması önlenmiş olsa bile kalıcı bekleme veya sessiz iş kaybı oluşabilir.
11.4. Readers-writers ve Politikanın Önemi
Readers-writers probleminde birden çok okuyucu aynı anda ilerleyebilirken yazarın özel erişime ihtiyacı vardır.
Fakat "doğru" tek politika yoktur:
reader preference
writer preference
fair / bounded waiting
seçimleri farklı starvation riskleri oluşturur.
Bir implementasyon yalnız mutual exclusion sağlamış olabilir; buna rağmen sürekli okuyucu akışı yazarın sonsuza kadar beklemesine yol açıyorsa ilerleme özelliği zayıftır.
Bu nedenle correctness değerlendirmesi:
safety
+ liveness
+ fairness
boyutlarını birlikte ele almalıdır.
11.5. Dining Philosophers ve Kaynak Sıralaması
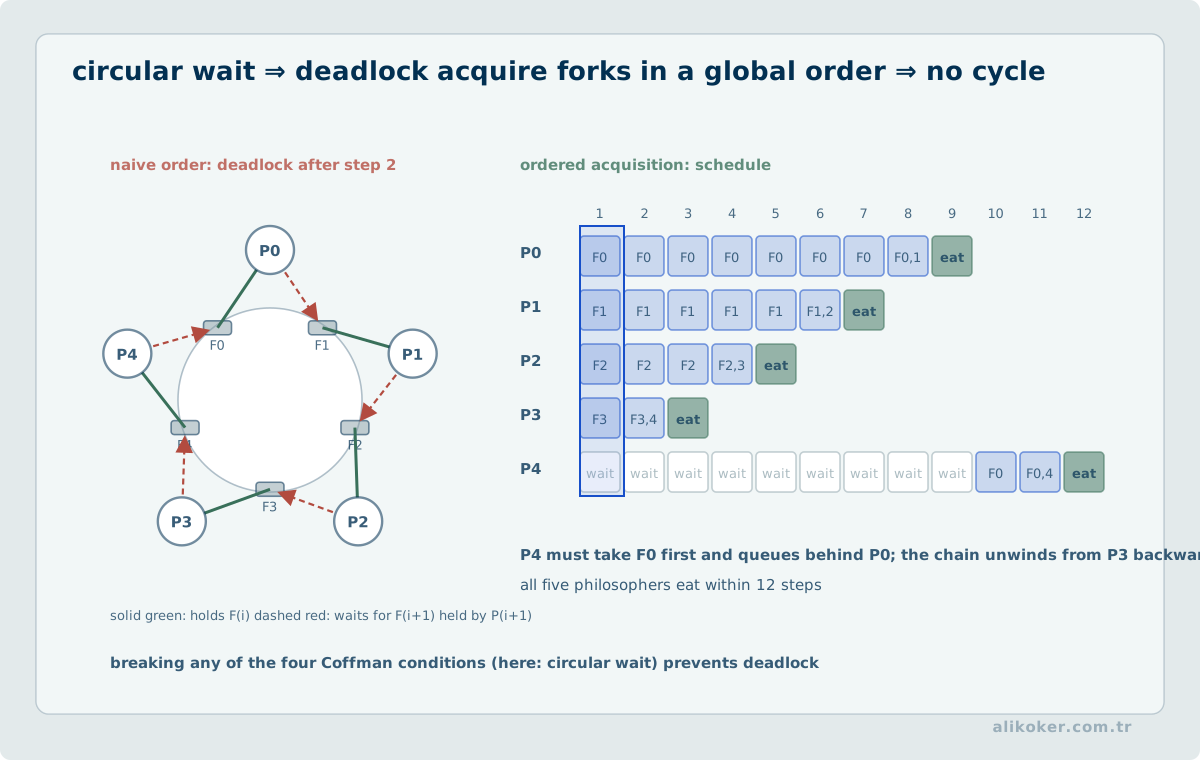
Dining philosophers problemi, birden fazla kaynağın farklı sırada edinilmesinin deadlock üretebileceğini gösteren klasik modeldir.
Deadlock döngüsünü kırmanın bir yolu bütün kaynaklara kararlı bir sıra verip her thread'in bu sıraya göre kilit almasını sağlamaktır:
lock(minResource)
lock(maxResource)
Bu yaklaşım yalnız masa/çatal örneğine özgü değildir. Gerçek yazılımda iki hesap, iki dosya, iki satır veya iki mutex aynı sorunu üretebilir.
11.6. Thread ve Process İzolasyonu
Thread'ler aynı process adres alanını paylaşır. Bu paylaşım:
- hızlı iletişim,
- daha düşük oluşturma maliyeti,
- ortak cache/veri yapılarının kolay paylaşımı
sağlayabilir; fakat bir memory corruption veya yanlış paylaşımlı state daha geniş etki yaratabilir.
Ayrı process:
- daha güçlü adres alanı izolasyonu,
- bağımsız hata sınırı,
- IPC maliyeti
getirir.
Bu nedenle "thread daha hızlıdır" veya "process daha güvenlidir" tek başına mimari karar değildir. Hata izolasyonu, veri paylaşımı, deployment ve kaynak bütçesi birlikte düşünülmelidir.
11.7. Spin, Block ve Park Ayrımı
Bir kilidi bekleyen thread sürekli dönebilir veya işletim sistemi tarafından uyutulabilir.
spin:
  CPU tüketir
  çok kısa beklemede yararlı olabilir

block / park:
  scheduler müdahalesi gerekir
  uzun beklemede CPU'yu serbest bırakır
Gerçek senkronizasyon primitifi bu iki davranışı hibrit biçimde kullanabilir.
11.8. Eşzamanlılık Sorusunu Çözerken Kontrol Listesi
Bir problemde önce şu sorular cevaplanmalıdır:
- Paylaşılan mutable state nedir?
- Atomik olması gereken işlem nedir?
- Beklenmesi gereken koşul var mı?
- Kilit sırası var mı?
- Bir taraf starvation yaşayabilir mi?
- I/O beklerken kilit tutuluyor mu?
- İptal veya hata durumunda kilit kesin bırakılıyor mu?
- Aynı iş process izolasyonu gerektiriyor mu?
Bu yaklaşım, mülakat tipi "mutex mi semaphore mu?" sorusunu ezberden çıkarıp sistem davranışını çözümleme problemine dönüştürür.
11.9. Uyuyan Berber: Sınırlı Bekleme Alanında Rendezvous
Uyuyan berber problemi, mutual exclusion bilgisinden daha fazlasını sınar: sınırlı kuyruk, bekleyen iş sayısı, boşta çalışan kaynak ve wake-up sırasının birlikte doğru yönetilmesini gerektirir.
Klasik modelde bir berber, bir servis koltuğu ve N adet bekleme koltuğu vardır. Müşteri geldiğinde:
berber boş + müşteri var -> servis başlar
berber meşgul + boş bekleme koltuğu var -> müşteri bekler
berber meşgul + bekleme alanı dolu -> müşteri ayrılır
müşteri yok -> berber uyur
Bu küçük model üretim sistemlerindeki bounded queue davranışına doğrudan benzer. waiting sayacı için temel invariant:
0 <= waiting <= Nolmalıdır. Sayaç güncellemesi ile sleep/wake sinyali farklı kritik bölgelerde kontrolsüz yürütülürse lost wake-up oluşabilir: müşteri geldiği halde berber uyumaya devam edebilir veya kaynak var olmadığı halde bir iş parçacığı ilerleyebilir.
Semafor tabanlı tipik modelde ayrı sinyaller müşteri sayısını ve hazır berberi temsil eder; bekleme sayısının değişimi bir mutex ile korunur. Ancak doğru semaphore sayısı tek başına yeterli değildir. Değerlendirme şu üç soruyu birlikte sormalıdır:
safety   -> iki müşteri aynı servis kaynağını eşzamanlı kullanabiliyor mu?
liveness -> müşteri ve kaynak varken sistem ilerliyor mu?
fairness -> sürekli yeni gelişler eski müşteriyi süresiz bekletebiliyor mu?
Bu nedenle uyuyan berber, yalnız ezberlenecek bir semaphore örneği değil; bounded admission + rendezvous + service discipline bileşiminin küçük bir modelidir. Thread pool, connection pool veya sınırlı worker kuyruğu tasarımlarında aynı sorular farklı adlarla yeniden ortaya çıkar.
Kuyruğun dolması yalnız kapasite değil politika sorunudur. Bir iş kuyruğunun sınırı belirlendiğinde sistemin bu sınıra erişince nasıl davranacağı da tasarlanmalıdır: bloklama, erken reddetme, iş birleştirme veya öncelik düşürme aynı sonuçları üretmez. Kuyruk boyutunu artırmak kısa patlamayı emebilir, ancak ortalama geliş hızı uzun süre hizmet hızını aşıyorsa birikimin tükenmesini engelleyemez. Little yasası L = λW, yalnız kararlı sistemde ve aynı iş popülasyonu için uygulanmalıdır.
Kapanış semantiği özellikle önemlidir. Consumer kapandığında producer'ın sonsuza kadar bloke kalmaması, kuyruktaki kabul edilmiş işlerin kaybolmaması ve yeniden başlatma sonrasında tekrar işlemenin nasıl ele alınacağı açık bir sözleşme olmalıdır. İşlemci sayısını artırmadan yalnız worker sayısını çoğaltmak bu sözleşmenin yerine geçmez.
11.10. İptal Edilen İşte Kaynak Sahipliği ve Sonuç Geçerliliği
İptal istemi, yürüyen işlemin derhal durmuş olduğunu kanıtlamaz. Bir worker hesaplamayı sürdürebilir, ağ isteği tamamlanabilir veya kapanmakta olan kaynağın callback'i daha sonra gelebilir. İptal bu nedenle iki sözleşmeye ayrılır: kaynakların sonlu zamanda bırakılması ve eski sonucun artık etkin durumu değiştirmemesi. İkinci koşul için sürüm/nesil doğrulaması, yalnız iptal bayrağı kullanmaktan daha güçlüdür.
Bir kaynak üzerinde tek sahiplik modeli uygulanabilir: açma, kullanma, kapatma ve kapanıştan sonra gelen bildirimlerin ele alınması aynı yaşam döngüsüne bağlanır. Özellikle event listener, timer, worker, dosya tanıtıcısı ve ağ isteği için sahiplik ayrı ayrı tanımlanmalıdır. Kapanış sırasında iki kez close() çağrılması, kısmen açılmış kaynağın bırakılması ve iptal ile normal tamamlanmanın yarışması ayrı sınır durumlarıdır.
Güvenilirlik testinde rastgele uyku yerine işlem sırasını denetleyen bariyerler kullanılır. Tamamlanma, iptal ve yeniden başlatma tüm olası sıralarda sınanır; kaynak sayısı başlangıç düzeyine dönmeli ve geç gelen callback yeni sahibin durumunu değiştirmemelidir.
11.11. Sınırlı Kuyrukta Kapanış ve Arıza Ayırımı
Sınırlı kuyrukta kapasite dolduğunda üretici davranışı önceden belirlenmelidir: bloklama, sonlu bekleme veya kontrollü reddetme. Kuyruğun boşalması ile işleyicinin kapanması aynı olay değildir. Kapanış protokolü yeni iş kabulünü durdurur, daha önce kabul edilen işleri tanımlanmış politika altında işler veya iptal eder, ardından kaynakları bırakır. Poison-pill gibi işaretleyici yöntemleri, işleyici sayısı ve kuyruk doluluğu hesaba katılmadan kullanılırsa kilitlenme oluşturabilir.
Bir işin yardımcı aşamasının başarısız olması, bağımsız işlerin ortak kuyruğunu gereksiz yere durdurmamalıdır. Ancak bu ayrım yalnız veri ve yetki sözleşmesi bağımsızsa güvenlidir. Bekleme süresi, iptal oranı, kayıp iş ve kapanış süresi birlikte değerlendirilmelidir.
11.12. İptal, Kapatma ve Kaynak Yaşam Döngüsü
İptal sinyali bir işin gerçekten sonlandığını garanti etmez. Dosya tanıtıcısı, soket ve kilit gibi kaynakların sahipliği, iptal sırasında hangi aşamanın geri alınacağı ve tamamlanan yan etkinin nasıl tanınacağıyla birlikte belirlenmelidir. Kapanış sırası gelen işin durdurulması, kabul edilmiş işlerin tamamlanması veya iptali ve kaynakların kapatılması olarak ayrı aşamalarda ele alınır.
İş kuyruğunda kapasite sınırı bulunmuyorsa geri basınç işletim sistemi bellek tüketimine dönüşebilir. Kuyruk dolu iken reddetme, bekletme veya yük azaltma kararının her biri gecikme ve iş kaybı bakımından farklıdır. Üretim sisteminde kuyruk boyu, bekleme süresi ve aktif iş sayısı ayrı gözlenmelidir.
Kaynakça
- Abraham Silberschatz; Peter B. Galvin; Greg Gagne. Operating System Concepts. Wiley, 2012.
- Andrew S. Tanenbaum; Herbert Bos. Modern Operating Systems. Pearson, 2014.
- Brendan Gregg. Systems Performance: Enterprise and the Cloud. Pearson Education, 2014.
- David A. Patterson, John L. Hennessy. Computer Organization and Design: The Hardware/Software Interface, 6th ed. Morgan Kaufmann, 2020.
- IEEE; The Open Group. POSIX.1-2008. IEEE / The Open Group, 2008.
- IETF. RFC 8881 — Network File System (NFS) Version 4 Minor Version 1 Protocol. https://www.rfc-editor.org/rfc/rfc8881
- Linux Kernel Documentation. Virtual File System (VFS). https://docs.kernel.org/filesystems/vfs.html
- Mor Harchol-Balter. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press, 2013.
- IETF. RFC 9106, Argon2, 2021. https://www.rfc-editor.org/info/rfc9106